WATCH:从按任务配对的人类视频中
学习可迁移的世界—动作模型
Learning Transferable World-Action Models from Task-Paired Human Videos
Jeongeun Park^{1,2,*}, Taekyung Kim^{1}, Dongyoon Han^{1}, Sangdoo Yun^{1,*}
^1NAVER AI Lab ^2佐治亚理工学院(Georgia Institute of Technology)
^*通讯作者
arXiv:2610.14351v1 [cs.RO],2026 年 10 月 9 日提交(38 页,26 幅图,9 张表)
项目主页:https://watch-wam.github.io
中文逐段翻译与解释
整理日期:2026 年 11 月 15 日
学习可迁移的世界—动作模型
Learning Transferable World-Action Models from Task-Paired Human Videos
Jeongeun Park^{1,2,*}, Taekyung Kim^{1}, Dongyoon Han^{1}, Sangdoo Yun^{1,*}
^1NAVER AI Lab ^2佐治亚理工学院(Georgia Institute of Technology)
^*通讯作者
arXiv:2610.14351v1 [cs.RO],2026 年 10 月 9 日提交(38 页,26 幅图,9 张表)
项目主页:https://watch-wam.github.io
中文逐段翻译与解释
整理日期:2026 年 11 月 15 日
解释
阅读方式。沿用本工作区已完成译稿的三联框:灰色框保留英文原文,蓝色框给出中文译文,橙色框解释概念、公式、设计动机和结论的边界;绿色框解读图表。覆盖范围:摘要和正文第 1–6 节(到结论为止)逐段翻译与解释,正文全部 9 幅图和 4 张表都附原注、译注和绿色解读框;附录不逐段对照,改为“附录概览”,用中文段落概述附录 A–G(局限性、数据、实现、补充分析、人类数据与机器人数据的对比、补充实验、定性 rollout),并挑选有代表性的附录图表贴出解读。图片直接使用作者源码中的矢量 PDF。章节、公式和图表编号与原文一致;引用保留原文的数字编号 [n],参考文献列表从略,见原文。解释框和译者附注是本译稿的分析,不属于作者原文。
来源与许可。原论文:https://arxiv.org/abs/2610.14351v1;PDF:https://arxiv.org/pdf/2610.14351v1。原文以知识共享署名 4.0 国际许可(CC BY 4.0)发布;本译稿是对原文的翻译和改编(增加了译文与解释),署名见上,内容以下载的 v1 源码及 PDF 为依据。
来源与许可。原论文:https://arxiv.org/abs/2610.14351v1;PDF:https://arxiv.org/pdf/2610.14351v1。原文以知识共享署名 4.0 国际许可(CC BY 4.0)发布;本译稿是对原文的翻译和改编(增加了译文与解释),署名见上,内容以下载的 v1 源码及 PDF 为依据。
目录
导读摘要(Abstract)1 引言(Introduction)2 WATCH:基于跨人类视频的世界—动作模型训练(WATCH: World-Action Model Training from Cross-Human Videos)2.1 预备知识(Preliminary)2.2 动机(Motivation)2.3 跨视频世界—动作建模(Cross-Video World-Action Modeling)3 跨视频预训练学到了什么(What Cross-Video Pre-Training Learns)4 后训练实验(Post-Training Experiments)4.1 实验设置(Experimental Setup)4.2 与先前方法的比较(Comparison with Prior Methods)4.3 消融研究(Ablation Studies)5 相关工作(Related Work)6 结论(Conclusion)附录概览(Appendix Overview)A 局限性(Limitations)B 数据细节(Dataset Details)C 实现细节(Implementation Details)D 补充分析(Additional Analyses)E 人类数据 vs. 机器人数据作为预训练数据F 补充实验结果与细节G 定性结果:机器人 rollout译者附注:原文数字核对与阅读提示汇总导读
本文解决的问题。世界—动作模型(world-action model,WAM)把视频生成模型改造成机器人策略:同一个网络既预测动作,也预测动作造成的未来画面。它的视觉和物理先验来自大规模视频预训练,而这种预训练几乎都是“视频内”的:用一段视频的前几帧去预测同一段视频的后几帧。作者认为这种目标有一个漏洞:上下文和未来共享同一个场景、视角、示范者,模型可以靠“外观的连续性”把损失降下来,不必学会那些能跨场景、跨本体迁移的“手与物体怎么交互”。本文问的是:能不能换一种预训练目标,逼模型去学交互本身,而且只用便宜的人类视频、不需要人—机器人配对数据?方法的完整链条。(1) 数据:从 EgoVerse 的三个人类采集来源(MECKA、Scale、Aria,戴头显的第一人称视频,带手部追踪)和 MimicDroid 自带的人类 play 数据中切出约 3 秒的窗口,把人手动作写进一个与机器人共享的 57 维笛卡尔任务空间(头部位姿、双手末端位姿、各五个指尖位置)。(2) 配对:对每个“查询”窗口,先按任务分类筛出同类活动的候选,再用标准化后的运动描述子做带状 DTW 排序,保留同源最多 8 个、跨源最多 7 个“参考”窗口,共得到 1099 万对。(3) 预训练:在 Cosmos Policy 的“视频 + 动作”联合预测框架上,给模型看参考示范的视频和动作,再给查询示范的当前帧和状态,让它去生成查询示范的动作块和未来帧(式 (1));参考与查询来自不同场景、不同示范者,参考的外观抄不过去,能借用的只有交互。(4) 后训练:在目标机器人上,要么保留参考槽位、放入一条人类示范(上下文内后训练),要么去掉参考槽位做普通的行为克隆(无上下文后训练),两者共享同一主干和损失。| 概念 | 本文中的具体含义 |
| 世界—动作模型(WAM) | 在视频扩散模型的潜变量序列中加入状态和动作 token,联合生成动作块与未来帧;本文以 Cosmos Policy 为模板。 |
| 视频内(within-video)训练 | 条件和预测目标来自同一段示范;本文的主要对照基线。 |
| 跨视频(cross-video)训练 | 以另一段同任务示范(参考)的视频和动作为条件,预测当前示范(查询)的动作和未来帧。 |
| 查询 / 参考 | 查询是要被预测的示范窗口;参考是从其参考集 \mathcal{R}(q) 中每步均匀抽取的一条同任务示范窗口。 |
| 槽位(slot) | 序列中的六个分区:查询状态、参考动作、参考视频、查询当前帧(条件);查询动作、查询未来视频(生成)。每个槽位带类型嵌入和以秒为单位的时间编码。 |
| 采集来源 | EgoVerse 中的 MECKA、Scale、Aria 三家,录制设备、人员、环境不同;跨源配对用来模拟“人与机器人之间”的差异。 |
| 上下文内 / 无上下文后训练 | 后训练与测试时是否给一条参考示范;前者测示范条件化控制,后者就是普通行为克隆。 |
| MimicDroid L1 / L2 / L3 | GR1 人形机器人的厨房水槽仿真基准:L1 训练场景,L2 换外观和物体,L3 换布局。无上下文版只报 L1、L2(记为 Easy、Hard)。 |
| 2 倍速不可行示范 | 参考示范以 2 倍速回放,快到机器人跟不上;用来检验模型是否只是逐帧照抄参考。 |
| match@1 | 把一个模型的特征旋转对齐到另一模型后,同一窗口在对方特征空间中的最近邻仍是它自己的比例;衡量两模型表征是否一致。 |
摘要(Abstract)
原文
World-action models inherit broad visual and physical priors from video pre-training. However, standard within-video next-frame prediction allows them to rely on appearance shared between the context and future, rather than learning interactions that transfer across scenes and embodiments.
译文
世界—动作模型(world-action model)从视频预训练中继承了广泛的视觉与物理先验。然而,标准的视频内(within-video)下一帧预测允许模型依赖上下文与未来之间共享的外观,而不必学习能够跨场景、跨本体(embodiment)迁移的交互。
解释
“世界—动作模型”(WAM)指同时生成未来画面和动作的模型:给定当前观测,它既预测接下来要执行的动作,也预测这些动作造成的画面变化。这类模型通常建在大规模预训练的视频生成模型之上(本文用的是 Cosmos-Predict2.5 上的 Cosmos Policy 和 Cosmos3),因此“继承”了视频模型对物体外观、运动和物理规律的先验。摘要第二句点出本文要解决的问题。标准视频预训练的目标是“视频内”的:上下文帧和要预测的未来帧来自同一段视频,场景、光照、相机视角、示范者的手和衣着全都一样。在这种设置下,预测未来最省力的方式是把上下文里的外观几乎原样搬到未来帧,只对变化的部分建模。模型因此不需要把“发生了什么交互”(手抓住杯子、把它放到台面上)从“这段视频长什么样”里分离出来。而部署到机器人时,外观全变了(手变成机械臂,厨房换了一个),真正能迁移过去的只有交互本身。作者认为,视频内目标没有给模型任何压力去学这种可迁移的表示。这是全文的出发点,§2.2 的动机实验(图 2)给出了初步证据。
原文
We introduce WATCH, a cross-video pre-training that learns from task-paired human demonstrations collected across diverse environments. Conditioned on the video and actions of one demonstration, the model jointly predicts another demonstration's actions and future frames from its current observation. Predicting one demonstration from another encourages the model to learn task-relevant interactions that transfer across scenes and demonstrators. Our pre-training shows that these capabilities can be learned from readily scalable human–human pairs alone, without requiring matched human–robot demonstrations.
译文
我们提出 WATCH,一种跨视频(cross-video)预训练方法,它从在多样环境中采集的、按任务配对的人类示范(task-paired human demonstrations)中学习。模型以一条示范的视频和动作为条件,从另一条示范的当前观测出发,联合预测后者的动作和未来帧。用一条示范去预测另一条示范,会促使模型学习与任务相关、能跨场景和跨示范者迁移的交互。我们的预训练表明,这些能力仅凭易于扩展的人—人配对就能学到,并不需要相互匹配的人—机示范。
解释
这一段给出方法的核心。训练样本由两条做同一任务的人类示范组成:一条作为参考(reference),提供完整的视频和动作;另一条作为查询(query),只提供当前这一帧观测。模型要输出的是查询示范接下来的动作和未来帧。注意这里人类示范也有“动作”:作者用手部和头部的位姿轨迹(§2.3 定义的 57 维笛卡尔任务空间)作为人的动作,而不是机器人的关节指令。为什么这样做能逼出可迁移的交互?参考和查询来自不同的厨房、不同的人、不同的相机,参考视频里的背景和光照对预测查询的未来毫无用处;查询自己的当前帧告诉模型物体在哪里、场景长什么样;参考能够贡献的,只剩“这个任务的手怎样运动、怎样与物体接触、先做什么后做什么”。模型想把预测做准,就得学会从参考中抽取这部分信息,再把它“套”到查询的场景上。最后一句是本文在数据上的卖点。以往做跨本体模仿的方法(如 Vid2Robot、MimicDroid)需要同一任务的人类示范和机器人示范成对出现,而机器人示范的采集要硬件和遥操作,成本高。WATCH 的论点是:两条来自不同采集来源的人类示范之间本来就有示范者、视角、环境的差异,这种差异可以充当本体差异的“替身”,所以只用人—人配对就够了。这是一个需要检验的假设(人和人之间毕竟形态相同),§3 末尾用人类配对和机器人配对训练出的表示做了直接比较(图 7)。
原文
Analyses before robot post-training show improved motion alignment across embodiments and better action and video prediction on unseen robots, with representations closer to those learned from robot pairs.
译文
在机器人后训练之前进行的分析显示:模型跨本体的运动对齐有所改善,在未见过的机器人上的动作预测和视频预测更好,其表示也更接近由机器人配对学到的表示。
解释
这一句概括 §3 的三类证据,它们都在任何机器人后训练之前测量,所以反映的是预训练本身学到了什么。“跨本体的运动对齐”对应图 5 的动作检索和留出本体回归:同一种运动在不同采集来源或不同机器人上,特征是否彼此靠近。“未见机器人上的动作和视频预测”对应表 1:在预训练从未见过的 RoboMIND 机器人数据上,WATCH 的动作 MSE 从视频内基线的 0.046 降到 0.039,生成视频的 FVD/FID 也优于原始视频模型。“更接近机器人配对学到的表示”对应图 7:把只用人类配对训练的 WATCH 与一个用 1K 小时 RoboMIND 机器人配对训练的同款模型对齐,跨模型窗口匹配的 match@1 在人类窗口上达到 0.76、机器人窗口上 0.60,原始视频模型只有约 0.2。最后这一项直接回应上一段的假设:人—人配对学到的东西,确实与人们原本想用人—机或机—机配对学到的东西相近。
原文
After robot post-training, WATCH improves MimicDroid in-context success from 40.9\% to 68.3\% with Cosmos Policy and from 59.8\% to 77.7\% with Cosmos3, with the largest gains on the unseen levels. Gains persist under context-free post-training across robot embodiments. WATCH outperforms within-video pre-training and co-training baselines, supporting cross-video prediction as a scalable approach to learning transferable world-action representations.
译文
经过机器人后训练后,WATCH 将 MimicDroid 上的上下文内(in-context)成功率在 Cosmos Policy 上从 40.9\% 提升到 68.3\%,在 Cosmos3 上从 59.8\% 提升到 77.7\%,提升最大的是未见过的难度层级。在无上下文(context-free)后训练下,这些增益在不同机器人本体上依然存在。WATCH 优于视频内预训练和联合训练(co-training)基线,这支持跨视频预测作为学习可迁移世界—动作表示的一条可扩展途径。
解释
这里的数字都来自 §4。“上下文内”指机器人策略在执行时还会拿到一条同任务的示范作为提示(与预训练时的参考—查询结构一致);“无上下文”指普通的行为克隆,训练和测试都没有参考示范。MimicDroid 是 GR1 人形机器人上的上下文内模仿基准,分 L1(训练任务、训练场景)、L2(同一布局下换外观和物体)、L3(留出布局)三层,L2/L3 就是所说的“未见层级”。两组主结果见表 2:Cosmos Policy 平均 40.9\%\to68.3\%(+27.4 个百分点),Cosmos3 平均 59.8\%\to77.7\%(+17.9)。按层看,Cosmos Policy 的 L1/L2/L3 分别提高 16.7、43.1、22.5 个点,确实是未见层级提升更大;Cosmos3 分别提高 22.5、7.1、24.2 个点,L3 提升最大,但 L2 的提升反而最小(因为基线 L2 已经很高,79.4%),所以“未见层级提升最大”对 Cosmos3 只是部分成立。无上下文结果见表 3,覆盖 GR1 人形(MimicDroid)、双臂 ALOHA(TableTop-Sim)和单臂 Franka(RoboCasa)三种本体;其中 Cosmos3 在 RoboCasa 上只提高 0.8 个点,“增益依然存在”在这一格上很微弱。与视频内预训练、联合训练的对照在表 4(同一 Cosmos Policy 主干上,MimicDroid 上下文内平均依次为 51.2、60.0、68.3)。
1引言(Introduction)
原文
Video models learn rich spatiotemporal representations by predicting how visual scenes evolve, which increasingly serve as world models [1, 2] and backbones for robot foundation models [3, 4, 5]. World-action models extend this predictive capability to robot control by jointly modeling actions and their visual consequences, providing a learning signal not only for which action to take but also for how that action changes the world. These models typically build on video backbones pretrained with next-frame prediction over large-scale datasets spanning diverse environments and embodiments [1, 6]. Ideally, such pre-training should learn action representations that preserve the motion and interaction shared across different scenes and embodiments [7, 8], rather than the appearance and execution style specific to a particular environment or demonstrator.
译文
视频模型通过预测视觉场景如何演化来学习丰富的时空表示,它们越来越多地被用作世界模型 [1, 2] 和机器人基础模型的主干 [3, 4, 5]。世界—动作模型把这种预测能力扩展到机器人控制:它联合建模动作及其视觉后果,所提供的学习信号不仅关乎“该采取哪个动作”,还关乎“这个动作如何改变世界”。这类模型通常建立在视频主干之上,这些主干以下一帧预测为目标,在横跨多样环境和本体的大规模数据集上预训练 [1, 6]。理想情况下,这样的预训练应当学到这样的动作表示:它保留不同场景、不同本体之间共享的运动与交互 [7, 8],而不是某个特定环境或示范者特有的外观和执行风格。
解释
这一段铺垫背景。[1] 是 Cosmos-Predict2.5,[2] 是 Wan,两者都是大规模视频生成模型;[3] Cosmos Policy 就是本文主要使用的世界—动作模型,它把机器人动作和本体感知状态编码成“伪帧”塞进视频扩散模型的潜变量序列,与未来画面一起去噪生成。与只输出动作的 VLA 策略相比,世界—动作模型多了一项“预测动作后果”的监督:模型不能只记住“这时该往右移”,还得知道往右移之后画面会怎样变化,这被认为能带来更扎实的物理理解。段末一句给出全文的价值判断:好的预训练应该学到“运动与交互”这类跨场景共享的东西,而不是“外观与执行风格”这类特定于某段视频的东西。前者是机器人上岗时真正能用上的;后者(这间厨房的台面颜色、这个人的手速)一换环境就失效。下一段说明为什么现行的视频预训练做不到这一点。
原文
However, standard video pre-training predicts future frames within a single demonstration [1, 6], where the context and target share scene appearance, viewpoint, and collection source. This continuity allows prediction to exploit demonstration-specific visual cues without requiring transferable interactions to be separated from those factors. Such entanglement can make post-training for robot control more difficult, as the model must learn to predict robot actions under differences in environment, embodiment, and viewpoint from the pre-training data. Even with diverse training data, the within-video objective does not explicitly encourage the model to represent similar motions and interactions consistently across different scenes and embodiments.
译文
然而,标准的视频预训练是在单条示范内部预测未来帧 [1, 6],上下文与目标共享场景外观、视角和采集来源。这种连续性使预测可以利用示范特有的视觉线索,而无需把可迁移的交互从这些因素中分离出来。这种纠缠可能使面向机器人控制的后训练变得更困难,因为模型必须在环境、本体和视角都与预训练数据不同的情况下学会预测机器人动作。即使训练数据很多样,视频内目标也不会显式地鼓励模型在不同场景和本体之间一致地表示相似的运动与交互。
解释
这一段定义了本文的“对手”——视频内(within-video)训练。设想一段“把杯子放到台面上”的视频:模型看前几帧,预测后几帧和这段时间里手的动作。上下文和目标出自同一个镜头,所以墙壁、台面、杯子、手的样子在未来帧里几乎原样出现;手的轨迹也可以从前几帧的速度直接外推。模型完全可以靠“复制外观 + 平滑外推”把损失降得很低,而不必形成一个与具体画面无关的“放杯子”概念。这就是作者所说的“纠缠”:交互信息和外观信息混在同一个表示里,没有被拆开的压力。最后一句很关键,它区分了数据多样和目标要求一致这两件事。预训练集里可以有一千间不同的厨房,但每个训练样本内部什么都不变,损失函数从来不会比较“厨房 A 里放杯子”和“厨房 B 里放杯子”的表示是否相近,所以模型没有理由让它们一致。打个比方,这有点像对比学习:只有把同一物体的两个不同视角当作正样本对,表示才会对视角不变;只做同一视角的重建,再多的数据也换不来这种不变性。作者要做的,正是给世界—动作模型构造这样的“正样本对”。
原文
A straightforward way to encourage such consistency is to condition prediction on a different demonstration of the same task. Under this cross-video training, the reference supplies the task and its motion, while the query's current observation provides the context for predicting its actions and future frames. Because the two demonstrations differ in scene, viewpoint, or demonstrator, relating the reference to the query encourages the model to capture shared motion and interaction beyond demonstration-specific visual cues. Related cross-embodiment policies learn such reference-to-query correspondences for robot control using task-matched human–robot demonstrations [9, 10, 11, 12]. Using this pairing strategy for large-scale pre-training, however, would require corresponding robot demonstrations, whose collection incurs the costs of robot hardware and teleoperation.
译文
鼓励这种一致性的一个直接办法,是让预测以同一任务的另一条示范为条件。在这种跨视频训练(cross-video training)下,参考(reference)提供任务及其运动,而查询(query)的当前观测则为预测查询的动作和未来帧提供上下文。由于两条示范在场景、视角或示范者上不同,把参考与查询关联起来会促使模型捕捉超越示范特有视觉线索的共享运动与交互。相关的跨本体策略利用按任务匹配的人—机示范 [9, 10, 11, 12],为机器人控制学习这种从参考到查询的对应关系。然而,若要把这种配对策略用于大规模预训练,就需要相应的机器人示范,而采集它们要承担机器人硬件和遥操作的成本。
解释
跨视频训练的分工可以这样理解:参考回答“做什么、手怎么动”,查询的当前帧回答“在哪里做、东西摆在哪”。这像是给一个人看一段别人在自家厨房洗碗的视频,再让他在自己的厨房里洗:视频里那间厨房的瓷砖、水槽款式对他毫无帮助,他能借鉴的只有动作的顺序和手法。对模型来说也一样——参考帧的像素不会出现在查询的未来帧里,照抄参考的外观只会让视频预测更差;参考的手部轨迹也不能原样照搬,因为查询里物体的位置不同。模型想利用参考,就只能从中抽出与外观无关的部分,即运动和交互,再与查询的场景对上号。与视频内训练相比,“走捷径”的路被堵死了。后两句交代了这一想法的来历。“参考—查询”的结构并不新:Vid2Robot [9]、MimicDroid [10]、Zero-WAM [11] 等方法已经用它做机器人的上下文内模仿(给机器人看一段人类视频,让它照着做)。但这些方法训练时需要同一任务的人类示范和机器人示范成对出现。把这种配对用在预训练的规模上,就意味着要为海量人类视频逐一采集对应的机器人示范,这在成本上不可行。下一段给出本文的解法。
原文
Human demonstrations can be collected across people and everyday environments without robot hardware or teleoperation [13, 14, 15, 7], offering a potentially more scalable and cost-effective source of pre-training data. To learn from this diversity through cross-video pre-training without matched robot demonstrations, we introduce WATCH, World-Action model Training from Cross-Human videos. Our key insight is that demonstrations of the same task from different collection sources [15, 14] already vary in demonstrator, viewpoint, and environment, and can therefore serve as cross-embodiment pairs without matched robot data. This formulation allows pre-training to scale with human demonstrations alone, reserving costly robot data collection for subsequent adaptation to the target embodiment. As shown in Fig. 1, the model conditions on one human demonstration and predicts the actions and future frames of another, improving downstream robot success in both in-context and context-free settings after robot post-training.
译文
人类示范可以在不同的人和日常环境中采集,无需机器人硬件或遥操作 [13, 14, 15, 7],因而可能是一种更可扩展、更具成本效益的预训练数据来源。为了在没有匹配机器人示范的情况下,通过跨视频预训练从这种多样性中学习,我们提出 WATCH,即 World-Action model Training from Cross-Human videos(基于跨人类视频的世界—动作模型训练)。我们的关键洞见是:来自不同采集来源 [15, 14] 的同一任务示范,本身就在示范者、视角和环境上各不相同,因此无需匹配的机器人数据就能充当跨本体配对。这一表述让预训练只靠人类示范就能扩展规模,而把昂贵的机器人数据采集留给之后对目标本体的适配。如图 1 所示,模型以一条人类示范为条件,预测另一条示范的动作和未来帧;经过机器人后训练后,它在上下文内和无上下文两种设置下都提高了下游机器人的成功率。
解释
这一段是全文的核心论证:用人—人配对替代人—机配对。论证分三步。第一,人—机配对之所以有用,是因为参考与查询之间存在一道“鸿沟”(外观、视角、形态都不同),模型必须学会跨过它。第二,不同采集来源的人类示范之间也有这样一道鸿沟:EgoVerse [15] 汇集了 MECKA、Scale、Aria 等多个来源,它们由不同的人、在不同的家庭、用不同的头戴相机和录制设备采集,画面风格、视野和手的外观差别都很明显。第三,既然模型跨过的是“示范特有的外观”这一类鸿沟,那么学会忽略来源差异的表示,也有望忽略人与机器人之间的外观差异。于是机器人数据只在后训练阶段少量使用(例如 MimicDroid 上只有 253 条 GR1 回合),预训练的规模完全由廉价的人类视频决定。读者应注意这一替代的边界。人与人之间形态相同:手指数量、关节结构、可达范围都一样,人—人配对覆盖不了机械臂与人手在运动学上的差异,也覆盖不了机器人往往比人慢得多这一事实。因此“人—人鸿沟可以替代人—机鸿沟”是一个经验性的赌注,而不是推论。作者在 §3 用三类证据为它背书:图 5(b) 检验机器人之间的动作检索,表 1 检验在没见过的 RoboMIND 机器人上的预测,图 7 直接比较人类配对与机器人配对训练出的表示。另一个细节值得留意:§2.3 构造的参考集并不全是跨来源的。每个查询最多取 8 条同来源、7 条跨来源的近邻,平均约 10.5 条参考里只有约 6.4 条跨来源,还有 9.3% 的查询完全没有跨来源参考;而且配对除了按任务类别筛选,还按手部轨迹的 DTW 距离排序,挑的是“动作形状相近”的示范,而不只是“任务名称相同”。数据规模(“10.0K 小时”)的计量口径也在 §2.3 才说明,这里不展开。
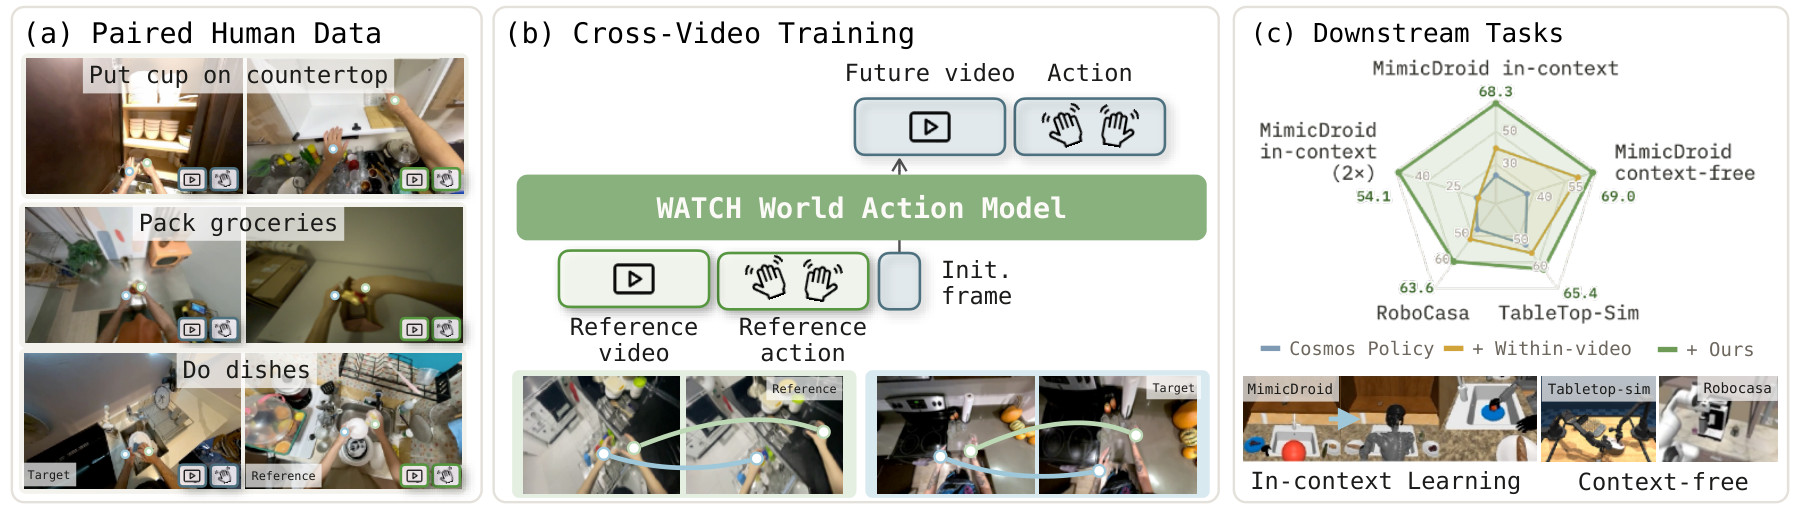
图 1:WATCH 概览。(a) 同一任务的人类视频跨采集来源、跨场景配对。(b) 以参考视频及其动作为条件,模型从目标示范的初始帧出发,预测目标的动作和未来帧。参考的外观无法迁移过去,所以它能传递的是交互。(c) 经过机器人后训练后,WATCH 在上下文内和无上下文两种设置下都较基础模型显著提高了成功率。
原图注:WATCH overview. (a) Human videos of the same task are paired across collection sources and scenes. (b) Conditioned on the reference video and actions, the model predicts the target's actions and future frames from its initial frame. The reference's appearance does not transfer, so what it can pass on is the interaction. (c) After robot post-training, WATCH substantially improves success rates over the base model in both in-context and context-free settings.
图 1 解读
(a) 配对的人类数据。三行分别是三个任务:“把杯子放到台面上”(Put cup on countertop)、“装袋杂货”(Pack groceries)、“洗碗”(Do dishes)。每行左右两张图是同一任务的两条示范,来自不同的采集来源:可以看到相机视角、厨房、光照、手臂外观都明显不同(例如“洗碗”一行,左图是俯拍的深色台面,右图是近距离的白色水槽)。手上的小圆点表示被跟踪的手部关键点,右下角的“视频”和“手”两个小图标表示每条示范都同时带有视频和人手动作。最后一行标出了 Target(目标,即正文中的查询)和 Reference(参考),提示每一对示范在训练中扮演的角色。(b) 跨视频训练。这是模型的输入输出示意。下方三个输入块里,绿框的“参考视频”和“参考动作”来自参考示范,蓝框的“初始帧”(Init. frame)来自目标示范;上方两个输出块是目标示范的“未来视频”和“动作”。最下面两张拼图分别是参考(绿底)和目标(蓝底)的片段,两只手的运动轨迹用绿色和蓝色曲线画出:两段视频在不同的厨房里,但两条轨迹的形状相似。图注的那句“参考的外观无法迁移过去,所以它能传递的是交互”正是整幅图想说明的直觉:目标的未来帧里不会出现参考的灶台和墙壁,复制参考的像素对预测毫无帮助;目标场景的外观由它自己的初始帧提供;参考里唯一对预测目标有用、又能跨场景成立的信息,就是“双手以什么形状的轨迹、按什么顺序与物体交互”。这与视频内训练形成对比:在视频内训练中,上下文和未来出自同一镜头,外观是“可以迁移”的,模型也就不必专门学交互。(c) 下游任务。雷达图的五个轴是五项后训练评测:顶部“MimicDroid in-context”(上下文内,平均成功率)、左侧“MimicDroid in-context (2×)”(参考示范以 2 倍速回放、机器人跟不上的“不可行示范”设置)、右侧“MimicDroid context-free”、右下“TableTop-Sim”(双臂 ALOHA)、左下“RoboCasa”(单臂 Franka),后三项都是无上下文设置。三条折线依次是直接后训练的 Cosmos Policy(灰蓝)、先做视频内预训练再后训练(黄,+ Within-video)、先做 WATCH 预训练再后训练(绿,+ Ours)。图上只标了 WATCH 的数值:68.3、69.0、65.4、63.6、54.1,与表 4 的 WATCH 一行完全一致;同一表中另外两条线对应的数值依次为:Cosmos Policy 40.9、49.3、59.6、56.0、30.7,视频内预训练 51.2、64.6、61.6、58.3、30.3。阅读时要注意,雷达图每个轴的刻度各不相同(顶轴标着 30、50,2× 轴标着 25、40,TableTop-Sim 轴标着 50、60),并且都不从 0 开始,所以多边形面积会夸大差距。例如 TableTop-Sim 上三者实际只差 59.6、61.6、65.4,图上看起来却拉得很开。值得一提的是 2× 这一轴:视频内预训练在这里反而略低于不预训练(30.3 对 30.7),而 WATCH 达到 54.1,§4.3 据此认为跨视频先验能帮助策略从“跟不上的参考”中提取有用信息。图底部的截图是三类评测环境:左边是 MimicDroid 上下文内学习,人类示范视频(左)作为提示,GR1 人形机器人(右)在水槽场景里照做;右边是两个无上下文环境 Tabletop-sim(ALOHA 双臂)和 Robocasa(Franka 单臂)。整幅图对论文的作用是把“数据—训练目标—效果”三件事放在一页上:(a) 说明数据从哪来、为何不需要机器人,(b) 说明训练目标为何能逼出可迁移的交互,(c) 预告后训练的收益。
原文
Our analyses (§3) suggest that cross-video pre-training learns more embodiment-invariant features through joint action–video supervision, aligning motions across collection sources while preserving motion information and focusing attention on hand–object interactions. These changes accompany improved robot post-training (§4): MimicDroid [10] success rises from 40.9\% to 68.3\% with Cosmos Policy, with gains also observed across backbones and embodiments under context-free post-training. Comparisons with within-video learning [13, 16] and co-training [15, 7], together with improvements from more paired human data, support cross-demonstration prediction as a scalable route to transferable world-action representations.
译文
我们的分析(§3)表明,跨视频预训练借助动作—视频联合监督学到了更具本体不变性的特征:它在保留运动信息的同时,让不同采集来源的运动彼此对齐,并把注意力集中到手—物交互上。伴随这些变化的,是机器人后训练效果的提升(§4):使用 Cosmos Policy 时,MimicDroid [10] 的成功率从 40.9\% 升至 68.3\%;在无上下文后训练下,不同主干和不同本体上也观察到了增益。与视频内学习 [13, 16] 和联合训练 [15, 7] 的比较,加上配对人类数据增多所带来的提升,共同支持“跨示范预测”作为通向可迁移世界—动作表示的一条可扩展途径。
解释
这一段是后文的路线图,每个说法都能在后面找到出处。“不同采集来源的运动彼此对齐”对应图 5(a)(b) 的动作检索:给定一个窗口,看模型能否在另一个来源(或另一台机器人)的数据里找到动作相同的窗口。“保留运动信息”对应图 5(c) 的留出本体回归:在两种本体上拟合一个线性回归器,看它能否预测第三种本体的未来运动量。这两项要一起看——只追求对齐,模型可以把所有窗口都映射到同一点,检索会变得没有意义;所以作者需要同时证明特征里还保留着运动本身的信息。“注意力集中到手—物交互”对应图 4(b) 和图 6 的注意力可视化;“联合监督”这个因素的作用则由 §4.3 的图 8 消融(只监督动作或只监督视频)来检验。后训练的数字:40.9\%\to68.3\% 是表 2 中 Cosmos Policy 在 MimicDroid 上下文内设置下 L1–L3 的平均成功率(引言这里没写明“上下文内”,摘要里写了);同样的数字也是表 4 中“None”和“WATCH”两行的上下文内平均值。无上下文的结果在表 3,与视频内学习、联合训练的比较在表 4(上下文内平均依次为 51.2、60.0、68.3),“配对人类数据越多越好”在图 9 的规模实验中。有两点对比值得留意。其一,联合训练基线在预训练时用到了机器人数据(EgoVerse 的机器人子集和 Humanoid Everyday),而 WATCH 只用人类数据却超过了它,这比“超过视频内基线”更有说服力。其二,作者措辞用的是“表明”“伴随”“支持”:§3 的表示分析与 §4 的成功率提升是相关关系,表示变好是否就是成功率提升的原因,文中并没有直接的因果实验。另外,视频内基线与 WATCH 训练步数相同,但 WATCH 每个样本多了参考的 latent,序列长度为 50 个 latent(视频内基线为 29 个),单步计算量更大,比较时计算量并不对等(附录 C.3)。
原文
Our main contributions are as follows: (1) We introduce WATCH, a cross-video world-action pre-training objective that conditions on one human demonstration while predicting another, together with task-matched human-to-human pairs that supply embodiment and environment variation without paired robot demonstrations. (2) We show that cross-video pre-training shifts representations from source-specific appearance toward task-relevant motion and interaction (§3). (3) We show consistent gains across video-model backbones, post-training protocols, and evaluation environments, largest on the unseen levels (§4).
译文
我们的主要贡献如下:(1) 我们提出 WATCH,一种跨视频的世界—动作预训练目标,它以一条人类示范为条件来预测另一条示范;同时提出按任务匹配的人—人配对,它在没有配对机器人示范的情况下提供本体和环境上的变化。(2) 我们表明,跨视频预训练使表示从来源特有的外观转向与任务相关的运动和交互(§3)。(3) 我们展示了在不同视频模型主干、后训练协议和评估环境上一致的增益,其中在未见层级上增益最大(§4)。
解释
三条贡献分别对应“方法 + 数据”“机理分析”“下游效果”。(1) 的方法细节在 §2.3:参考与查询的 latent 如何拼接、哪些槽位计算损失(式 (1) 给出跨视频的条件分布),以及配对如何用任务分类和 DTW 距离筛选。(2) 的证据是 §3 的图 4 至图 7 和表 1。(3) 中的“主干”指 Cosmos Policy(基于 Cosmos-Predict2.5)和 Cosmos3 Edge-2B 两种;“后训练协议”指上下文内与无上下文两种;“评估环境”指 MimicDroid(GR1)、TableTop-Sim(ALOHA)和 RoboCasa(Franka)。关于“一致”和“未见层级上最大”这两个措辞,读者可以对照表 2、表 3 自行核对。Cosmos Policy 在上下文内 MimicDroid 上 L1/L2/L3 分别提高 16.7、43.1、22.5 个百分点,符合“未见层级最大”;Cosmos3 分别提高 22.5、7.1、24.2 个百分点,L2 的提升是三层中最小的。无上下文设置下 WATCH 在所有格子上都没有低于对应基础模型,但 Cosmos3 在 RoboCasa 上只从 55.0 升到 55.8。此外,正文的每个配置都只跑了一次,没有报告多次运行的方差,不大的差距应谨慎解读。
2WATCH:基于跨人类视频的世界—动作模型训练(WATCH: World-Action Model Training from Cross-Human Videos)
原文
We introduce WATCH, a human-data-only pre-training stage that aims to learn embodiment-invariant interaction representations before robot post-training. We first review within-video world-action modeling (§2.1) and what the current video prior may miss (§2.2), then describe how task-paired human demonstrations and cross-video action–video prediction encourage the model to capture interactions shared across scenes and embodiments, and how the resulting model supports both in-context and context-free robot post-training (§2.3). We provide a detailed review of robot policy pre-training and learning from human demonstrations in Appendix 5.
译文
我们提出 WATCH,这是一个只使用人类数据的预训练阶段,目标是在机器人后训练(post-training)之前学到本体不变(embodiment-invariant)的交互表征。我们先回顾视频内(within-video)的世界—动作建模(§2.1),以及现有视频先验可能遗漏了什么(§2.2);随后说明按任务配对的人类示范和跨视频的动作—视频预测如何促使模型捕捉在不同场景、不同本体之间共享的交互,以及由此得到的模型如何同时支持上下文内(in-context)和无上下文(context-free)的机器人后训练(§2.3)。关于机器人策略预训练和从人类示范中学习的详细综述见附录 5。
解释
这一段交代了 WATCH 在整条流水线中的位置:它不是一个新的策略网络,而是插在“通用视频模型”和“机器人后训练”之间的一个额外预训练阶段,而且这一阶段只喂人类视频,不用任何机器人数据。所谓“本体不变的交互表征”,指的是模型内部对“手(或夹爪)怎样接近、抓取、移动物体”的编码,不随执行者是人手、哪种机器人、哪个相机视角而变;论文希望这种表征在后训练时能直接迁移给机器人。三个小节的分工是:§2.1 介绍作者所沿用的基线范式(Cosmos Policy 式的世界—动作模型),§2.2 用注意力可视化说明这种范式的视频先验“看错了地方”,§2.3 给出 WATCH 的具体做法:用同一任务的另一条人类示范作为参考来预测当前示范的未来。“上下文内”和“无上下文”是后训练的两种用法,前者在部署时仍给模型一条人类示范作参考,后者把参考槽位去掉,像普通策略一样只看当前观测。最后一句的“附录 5”是原文交叉引用的笔误:作者把相关工作一节的标签写成了附录标签,但这一节实际排在正文第 5 节(“相关工作”),附录里并没有编号为 5 的部分。
2.1预备知识(Preliminary)
原文
World-action models and within-video training. World-action models turn the spatiotemporal priors of video models into policies by jointly predicting actions and their visual outcomes [17, 18, 3]. Cosmos Policy [3] implements this principle by incorporating state and action representations into the latent token sequence of a pre-trained video model; we follow its recipe on Cosmos-Predict2.5 [1] (§C.2). The latent sequence is split into clean conditioning slots and target slots, the latter holding future frames and actions. Training follows the backbone's rectified-flow objective, \mathcal{L}(\theta) = \mathcal{L}_{\mathrm{visual}}(\theta) + \lambda\,\mathcal{L}_{\mathrm{action}}(\theta), where each term applies velocity matching to the corresponding target slots, with no loss on conditioning slots. These models typically follow a within-video formulation: conditioning observations and prediction targets come from the same demonstration or episode. Writing I_t for the frame, s_t for the proprioceptive state, \ell for language instruction, and a_t for the action at time t, the model learns p_{\theta}(a_{t:t+C}, I_{t+1:t+C+1} \mid I_t, s_t, \ell) over a chunk size of C steps, where x_{i:j} denotes x_i, \ldots, x_{j-1}, so that a_{t:t+C} holds C actions. The condition and target therefore share the same scene, viewpoint, and demonstrator (or embodiment).
译文
世界—动作模型与视频内训练。 世界—动作模型(world-action model)通过联合预测动作及其视觉结果,把视频模型的时空先验转化为策略 [17, 18, 3]。Cosmos Policy [3] 实现这一思路的方式,是把状态和动作表示嵌入预训练视频模型的潜在 token 序列中;我们在 Cosmos-Predict2.5 [1] 上沿用它的做法(附录 C.2)。潜在序列被分成干净的条件槽位(conditioning slot)和目标槽位(target slot),后者存放未来帧和动作。训练沿用主干网络的整流流(rectified flow)目标 \mathcal{L}(\theta) = \mathcal{L}_{\mathrm{visual}}(\theta) + \lambda\,\mathcal{L}_{\mathrm{action}}(\theta),其中每一项都对相应的目标槽位做速度匹配(velocity matching),条件槽位上不计损失。这类模型通常采用视频内(within-video)的形式:条件观测和预测目标来自同一条示范或同一个回合。记 I_t 为 t 时刻的画面帧、s_t 为本体感知状态(proprioceptive state)、\ell 为语言指令、a_t 为 t 时刻的动作,模型学习的是块长为 C 步的 p_{\theta}(a_{t:t+C}, I_{t+1:t+C+1} \mid I_t, s_t, \ell),其中 x_{i:j} 表示 x_i, \ldots, x_{j-1},因此 a_{t:t+C} 恰好包含 C 个动作。于是,条件与目标共享同一场景、同一视角和同一示范者(或本体)。
解释
什么是世界—动作模型。普通策略只输出动作;世界—动作模型同时输出“要做的动作”和“做了之后画面会变成什么样”。这样做的好处是可以直接继承大规模视频生成模型学到的物理和时序知识(“视频先验”):模型必须让预测的动作与预测的画面变化互相吻合。Cosmos Policy 的做法很直接:视频模型本来就把视频压缩成一串潜在帧(latent frame)再在潜在空间里去噪,它把机器人状态、动作向量也“铺”成与潜在帧同形的块,插进这串序列,让同一个扩散 Transformer 一起处理。槽位。序列里的每一段称为一个槽位。条件槽位放已知信息(当前帧、当前状态),保持干净、不加噪声;目标槽位放要生成的东西(未来帧、动作块),训练时被加噪,模型的任务是把它们还原。损失只在目标槽位上计算,因为条件本身是给定的,没有必要“预测”它。整流流与速度匹配。原文没有写出公式,下面是整流流的标准形式(为避免与物理时间 t 混淆,这里把扩散的噪声时间记为 \sigma\in[0,1]):设某个目标槽位的干净潜变量为 x_0,采样高斯噪声 \epsilon,构造直线插值 x_\sigma=(1-\sigma)x_0+\sigma\epsilon。沿这条直线从数据走向噪声的“速度”是常数 v=\epsilon-x_0。网络 v_\theta 读入加噪序列(连同干净的条件槽位)、噪声时间 \sigma,输出对 v 的估计,训练目标是均方误差 \|v_\theta-v\|^2,这就叫速度匹配。推理时从纯噪声出发,沿着预测的速度场反向积分常微分方程,就得到未来帧和动作。\mathcal L_{\mathrm{visual}} 是这一误差在未来视频槽位上的平均,\mathcal L_{\mathrm{action}} 是在动作槽位上的平均,\theta 是网络参数。\lambda 的作用。\lambda 平衡两项损失;§2.3 给出 \lambda=48。之所以要放大动作项,是因为在潜在序列里动作所占的 token 远少于视频:按附录 C.1、C.3 的数字推算,人类窗口的未来视频约占 23 个潜帧,而一个动作块只拼铺成 1 个潜帧。若不加权,动作误差在总损失里只占很小一份,网络会主要去优化画面。论文没有说明 48 是怎么选出来的(例如是否扫过多个取值),只能把它看作经验超参数。条件分布逐符号读。p_\theta(a_{t:t+C}, I_{t+1:t+C+1}\mid I_t,s_t,\ell) 中,竖线右边是条件:当前帧 I_t、当前本体感知状态 s_t(机器人的关节/末端位姿,在本文的人类数据里则是头、手腕、指尖位姿组成的 57 维向量)、任务的文字描述 \ell;竖线左边是要生成的目标:从 t 开始的动作块,以及这些动作造成的未来帧。下标采用类似 Python 切片的半开区间记号,x_{i:j} 含左端点、不含右端点。所以 a_{t:t+C}=(a_t,\dots,a_{t+C-1}) 是 C 个动作;帧是 I_{t+1:t+C+1}=(I_{t+1},\dots,I_{t+C}),同样是 C 帧,但整体比动作晚一步。这个错位反映了因果关系:在画面 I_t 下执行 a_t 得到 I_{t+1},执行 a_{t+C-1} 得到 I_{t+C},因此每个动作恰好对应它造成的那一帧。举例来说,若 C=4,模型输出 a_t,a_{t+1},a_{t+2},a_{t+3} 和 I_{t+1},\dots,I_{t+4}。本文人类窗口的块长按附录 C.2 是 92 帧(30 Hz 下约 3 秒),也就是一次预测约 3 秒的动作和画面。“视频内”的含义及其隐患。条件 I_t,s_t 与目标来自同一段录像,因此场景、视角、执行者都相同。最后一句点出了这件事的副作用,也是下一节的伏笔:在这种设定下,模型只要学会“把同一段画面顺着往下续”,就能把损失压得很低,不一定需要理解“手和物体之间发生了什么交互”。WATCH 的改动正是让条件和目标来自不同的示范。
2.2动机(Motivation)
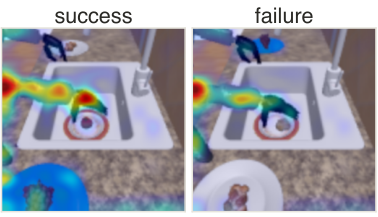
(a) 后训练后的原始模型
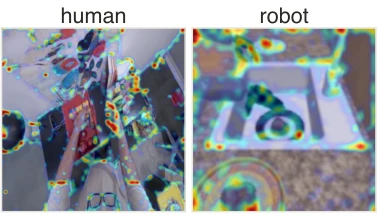
(b) 原始视频模型
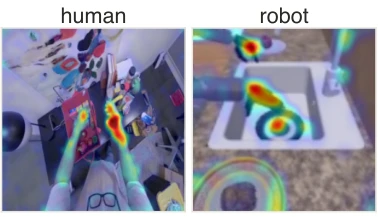
(c) 跨视频预训练(本文)
图 2:世界—动作模型在看哪里。对当前帧的注意力,按正文提及的顺序依模型分组。(a) 基线视频主干(Cosmos-Predict2.5)经机器人后训练后,在成功的执行中注意力集中在手和物体上,在失败的执行中则落在前臂上(
PnPSinkToCabinet)。(b) 原始视频模型在机器人画面和人类示范上都把注意力广泛地分散在边缘和背景上;而人类示范恰恰是可规模化获取的交互与运动线索来源,可用于机器人学习。(c) 在相同的画面上,我们的跨视频预训练把注意力移向正在动作的手和被操作的物体。原图注:Where a world-action model looks. Attention to the current frame, grouped by model in the order the text reads them. (a) After robot post-training of the baseline video backbone (Cosmos-Predict2.5), attention focuses on the hand and object in a successful rollout and on the forearm in a failed one (
PnPSinkToCabinet). (b) The original video model attends broadly to edges and background on both robot frames and human demonstrations, which offer a scalable source of interaction and motion cues for robot learning. (c) On the same frames, our cross-video pre-training shifts attention toward the acting hand and manipulated object.图 2 解读
三栏各对应一个模型,每栏两张小图,图上叠加的热力图是模型对“当前帧”各位置的注意力强度(红黄色越热表示注意力越集中)。(a) 栏的两张图分别标为 success / failure,是直接在机器人数据上后训练 Cosmos-Predict2.5 得到的策略(即 Cosmos Policy)在
PnPSinkToCabinet(把水槽里的物体放进柜子)任务上的一次成功执行和一次失败执行:成功时热点落在机械手和水槽里的物体上,失败时热点落在手腕和前臂上。(b)、(c) 两栏的小图标为 human / robot,分别是一张人类第一视角示范画面和一张机器人画面;(b) 是未经任何机器人或动作训练的原始视频模型,热点零散地分布在台面边缘、背景纹理上;(c) 是经过 WATCH 跨视频预训练的模型,在同样两张画面上热点集中到手和被操作物体上。这张图承担的是“讲故事”的角色:(a) 暗示“看对地方”与任务成败相关,(b) 说明原始视频先验本身没有这种偏好,(c) 说明 WATCH 能把注意力纠正过来。读图时要注意它的证据强度有限。第一,这是少数几帧的定性可视化,(a) 只有一次成功和一次失败,不能据此认定注意力位置是成败的原因,也可能只是失败时机械手离物体较远的结果。第二,原文没有交代注意力图的具体计算方式(取哪一层、哪些头、以哪些 token 为查询、如何归一化),而原始视频模型没有动作槽位,它与 (c) 的“注意力”是否以同一种方式读出也不清楚。附录 D.1 和 D.4 补充了更多帧(同一回合的下一帧、三路相机、四个机器人画面和三个人类查询,并加入视频内预训练基线),给出的定性结论一致:原始模型看边缘和背景,视频内预训练把注意力移到手臂上,跨视频预训练移到手和物体上。论文的定量证据在第 3 节(动作检索、线性探针等),而不是这张图。 原文
What the video prior may miss. We examine Cosmos Policy [3] obtained by directly post-training Cosmos-Predict2.5 [1] on robot data. In the rollouts of Fig. 2a, attention focuses on the hand near the manipulated object in the successful one, but on the wrist and forearm in the failed one. To assess whether the original video backbone emphasizes these cues, we inspect its attention on human demonstrations as well as robot observations. In both cases, attention is broadly distributed over edges and background rather than concentrated on the interacting hand and object (Fig. 2b). We hypothesize that this partly reflects its pre-training objective, which models visual change throughout the scene without prioritizing the interaction relevant for control. This motivates cross-video pre-training, where another demonstration of the same task guides prediction in the current scene: predicting across demonstrations with different object placements and demonstrators encourages the model to capture the shared interaction while adapting the motion to the current hand–object configuration. Consistent with this, cross-video pre-training shifts attention toward the acting hand and manipulated object in both human and robot observations (Fig. 2c).
译文
视频先验可能遗漏了什么。 我们考察 Cosmos Policy [3],即直接在机器人数据上对 Cosmos-Predict2.5 [1] 进行后训练得到的模型。在图 2a 的执行过程中,成功的那次注意力集中在被操作物体附近的手上,失败的那次则集中在手腕和前臂上。为了判断原始视频主干是否重视这些线索,我们既在机器人观测上、也在人类示范上检查它的注意力。两种情况下,注意力都广泛分散在边缘和背景上,而没有集中在发生交互的手和物体上(图 2b)。我们假设,这在一定程度上源于它的预训练目标:该目标对整个场景中的视觉变化建模,而不会优先关注与控制相关的交互。这促使我们提出跨视频预训练(cross-video pre-training):用同一任务的另一条示范来引导对当前场景的预测。在物体摆放不同、示范者不同的示范之间做预测,会促使模型捕捉其中共享的交互,同时根据当前的手—物体配置调整动作。与此一致,跨视频预训练使模型在人类和机器人观测上的注意力都移向正在动作的手和被操作的物体(图 2c)。
解释
这段的论证分三步。第一步是观察:后训练后的策略,成功时注意力在“手+物体”,失败时在前臂。第二步是诊断:原始视频模型本身就不偏好手和物体,注意力铺在边缘和背景上。作者的解释是视频生成的预训练目标对画面上所有像素的变化一视同仁,相机抖动、背景纹理、光照变化都要建模,而“手怎样碰到物体”只占画面很小一部分,所以模型没有理由优先关注它。第三步是对策:如果要求模型参照另一段示范(另一个人、另一个场景、物体摆放不同)来预测当前示范的未来,那么参考视频里的背景、边缘对当前场景毫无用处,两段视频之间唯一可以借用的就是“交互本身”(伸手、抓取、移动的方式)。这就迫使模型把注意力放到手和物体上,同时还必须根据当前画面里物体的实际位置调整动作,不能照抄参考。需要分清哪些是证据、哪些是推测。“我们假设”一句明确只是假设:作者没有做控制实验去分离“预训练目标”与其他因素(例如训练数据的构成、模型规模)的影响。“成功看手、失败看前臂”也只是两次执行的对照,不足以建立因果。最后一句用“与此一致”(consistent with)的措辞,说明图 2c 只是与动机相符的观察,而不是对动机的证明。此外,§2.1 结尾已经指出视频内训练中条件与目标来自同一段录像,模型可以“顺着画面往下续”;附录 D.4 中视频内预训练基线把注意力移到手臂而非手和物体,与这一解释相符。这一点在第 3 节有更系统的分析。
2.3跨视频世界—动作建模(Cross-Video World-Action Modeling)
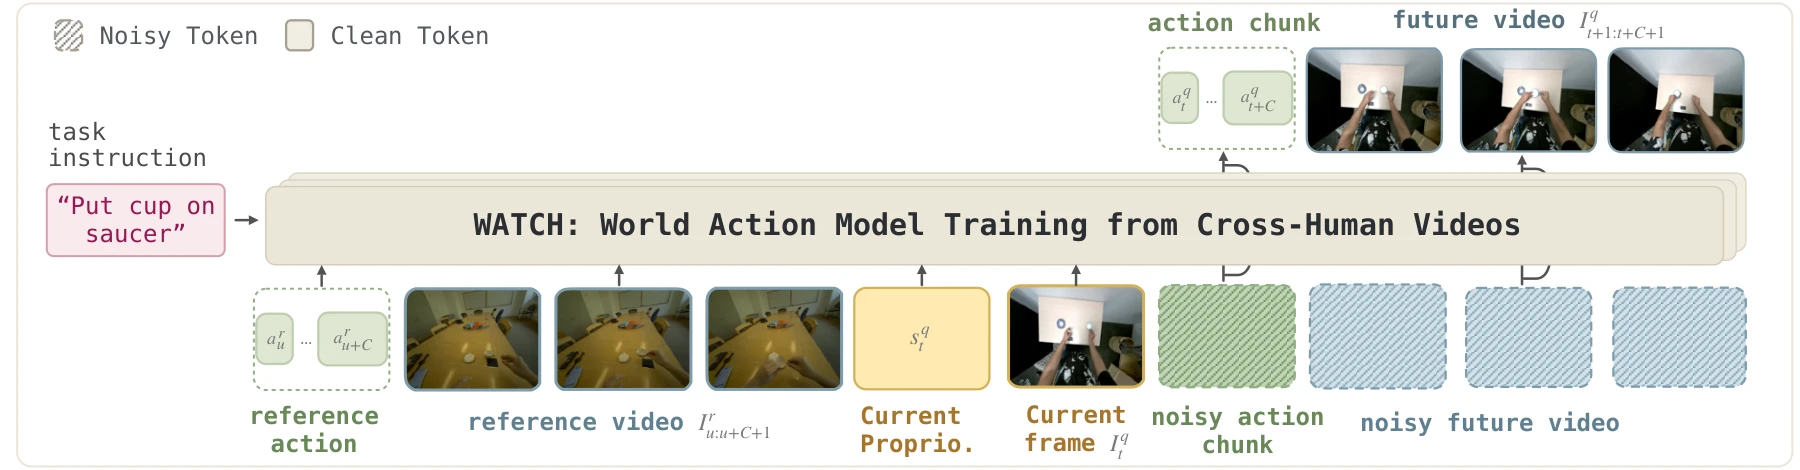
图 3:WATCH 概览。参考视频及其动作轨迹来自同一任务的另一条示范,它们作为干净的条件 token 输入,与之一起输入的还有查询的当前帧和本体感知状态;查询的动作块和未来帧是被加噪、由模型去噪的 token。每个 token 都标注了槽位类型和物理时间,因此同一套序列布局可以延续到后训练:既可以用一条人类示范作为参考,也可以去掉参考槽位。损失是 §2.1 中的联合速度匹配目标,作用于被生成的 token。
原图注:Overview of WATCH. The reference video and its action trajectory, from a different demonstration of the same task, enter as clean conditioning tokens together with the query's current frame and proprioceptive state; the query's action chunk and future frames are the noised tokens the model denoises. Every token is tagged with its slot type and physical time, so the same sequence layout carries over to post-training with a human demonstration as the reference or with the reference slots removed. The loss is the joint velocity-matching objective of §2.1, applied to the generated tokens.
图 3 解读
图的下排从左到右是输入序列:绿色虚线框里的参考动作 a^r_{u:u+C}、三张参考视频帧 I^r_{u:u+C+1}(示例是另一个人在另一张桌子上做同一任务)、黄色的当前本体感知状态 s^q_t、查询的当前帧 I^q_t,然后是带斜线阴影的“加噪动作块”和三格“加噪未来视频”。左上图例说明:斜线阴影表示加噪 token(要生成的目标),纯色表示干净 token(条件)。左侧粉色框是任务指令(示例 “Put cup on saucer”,把杯子放到碟子上),作为文本条件输入。中间的长条是 WATCH 主干(Cosmos 视频扩散 Transformer),上排是它去噪后的输出:查询的动作块 a^q_{t:t+C} 和未来视频 I^q_{t+1:t+C+1}。和 §2.1 的视频内模型相比,结构上唯一的增量是左边多了“参考视频 + 参考动作”两个条件槽位,其余(当前帧、状态、加噪动作、加噪未来帧)与 Cosmos Policy 相同。图注最后两句是设计上的关键:因为每个 token 都带“槽位类型 + 物理时间”的位置编码,而不是按在序列中的绝对下标编号,所以后训练时可以把参考槽位换成人类示范(上下文内),或者干脆删掉(无上下文),剩余 token 的位置含义都不变,预训练学到的东西可以原样接上。
原文
Human data and cross-video pairs. Human demonstrations collected from different people, with different recording rigs and in different environments, vary along the axes on which a robot differs from a human, and task-matched pairs across these sources supply this variation without requiring matched robot data. We construct query–reference pairs from different episodes of EgoVerse [15]. Human actions are derived from subsequent body configurations and expressed with states in a shared human–robot task space, using a canonical frame fixed at each episode's start. A semantic task taxonomy restricts candidates to compatible activities, which we rank by dynamic-time-warping distance between motion trajectories. Motion descriptors are standardized within each window, which reduces their sensitivity to motion magnitude so that interactions can match despite differences in reach. Each query's reference set \mathcal{R}(q) holds up to 8 nearest matches from its own source and up to 7 from other sources, the latter admitted within a fixed factor of the best score. Training samples one reference uniformly from this set at each step, from any source (§B.2).
译文
人类数据与跨视频配对。 由不同的人、用不同的录制设备、在不同环境中采集的人类示范,恰好在机器人与人不同的那些维度上存在差异;在这些来源之间按任务配对,就能提供这种差异,而不需要成对的机器人数据。我们从 EgoVerse [15] 的不同回合中构建查询—参考(query–reference)配对。人类动作由之后的身体姿态导出,并与状态一起表示在一个人与机器人共享的任务空间中,所用的规范坐标系固定在每个回合的开头。一套语义任务分类体系把候选限制在相容的活动范围内,我们再按运动轨迹之间的动态时间规整(dynamic time warping,DTW)距离对候选排序。运动描述子在每个窗口内做标准化,这降低了它们对运动幅度的敏感性,使得伸手距离不同的交互仍能匹配上。每个查询的参考集 \mathcal{R}(q) 至多包含 8 个来自同一来源的最近匹配,以及至多 7 个来自其他来源的匹配;后者只有在得分处于最佳得分的固定倍数之内时才被收入。训练时每一步从这个集合中均匀采样一个参考,来源不限(附录 B.2)。
解释
为什么只用人类数据也能谈“跨本体”。第一句是全文的核心论点之一:机器人与人的差异体现在外观(手长什么样)、视角(相机装在哪)、场景和动作幅度上;而不同人、不同头戴设备、不同环境采集的人类视频之间,也在这些维度上有差异。如果模型学会了在这些人类来源之间迁移交互,作者期望它同样能跨越“人到机器人”的差异。这是一个类比论证,“机器人与人之间的差异”和“不同人类来源之间的差异”毕竟不完全相同(例如人类数据里没有夹爪),能否成立要看后面的实验。动作怎么来。人类视频本身没有“动作”标签。作者用后续帧的身体姿态(头、两腕、指尖位置)作为当前的动作目标,并把它和状态一起写进 57 维的共享笛卡尔任务空间(附录 B.1:头 9 维 + 左右手各“末端位姿 9 维 + 五个指尖位置 15 维”,位姿 = 3 维平移 + 旋转矩阵前两列共 6 维)。坐标系固定在回合开头的腰部、竖直轴对齐重力,整段不随头部转动而动,否则人一扭头,静止的物体在坐标里也会“动起来”。机器人的平行夹爪则用“全开/全闭”两个指尖模板插值到同一组坐标,这样人手和夹爪处于同一套表示中。怎样挑参考。配对分两级:先用任务分类筛选,只在同一任务类内找候选(某任务类在其他来源都没录过时,才放宽到上一级大类);再用 DTW 距离排序。DTW 允许两段轨迹在时间轴上伸缩对齐,于是一个人做得快、一个人做得慢也能比较形状。附录式 (2) 的距离还限定了对齐带宽,并对“左手/右手使用比例”差别过大的配对加了铰链惩罚,以免把左手执行和右手执行配在一起。“窗口内标准化”是指每个通道减去窗口均值、除以窗口标准差,比较的是运动的形状而不是绝对位置和幅度。附录也承认这并非严格的尺度不变。参考集的构成是同源至多 8 个、跨源至多 7 个;跨源候选只有在距离不超过最佳得分的 1.6 倍(附录 B.2 给出的“固定倍数”)时才收入,避免为凑数塞进不相似的配对。训练时每步从整个集合里等概率抽一个,因此跨源参考被抽中的概率就等于它在集合中所占的比例。原文说配对来自“EgoVerse 的不同回合”,严格说并不完整:附录 B.3 说明预训练还包括 MimicDroid 自带的人类 play 数据(在下游 sink 环境中录制,只有 20 个回合),这部分允许同回合配对,是全部数据中唯一的同回合链接(19,802 条)。
原文
This procedure yields 10.99M query–reference pairs, 10.0K hours of paired 3-second windows counted over all pairs. Each query has 10.52 references on average, including 6.35 cross-source matches; 90.7% of queries have at least one cross-source reference. Compared with same-task random cross-source pairs, the selected matches show higher trajectory-shape cosine similarity by 0.36, indicating agreement in motion beyond task semantics (§B.3).
译文
这一流程得到 1099 万(10.99M)个查询—参考配对,按全部配对计,合计 1.00 万(10.0K)小时的成对 3 秒窗口。每个查询平均有 10.52 个参考,其中 6.35 个是跨来源匹配;90.7% 的查询至少有一个跨来源参考。与同任务、随机跨来源的配对相比,所选匹配的轨迹形状余弦相似度高出 0.36,表明二者在运动上的一致超出了任务语义层面(附录 B.3)。
解释
这几个数字的计量口径需要仔细看,否则容易高估数据规模。“10.99M 对”是查询—参考链接数,不是独立视频片段数:查询窗口一共 1,045,007 个,每个平均挂 10.5 个参考,1.045\text{M}\times10.5\approx10.99\text{M}。同一个窗口会作为很多查询的参考被反复计数。“10.0K 小时”是“窗口小时”:每个查询窗口和每条链接各按一个 3 秒窗口计,(1.045\text{M}+10.99\text{M})\times3\,\text{s}\approx3.61\times10^7\,\text{s}\approx1.00\times10^4\,\text{h}。它不是原始录像时长。附录 B.3 给出的对照是:查询窗口本身只有 871 小时(1.045\text{M}\times3\,\text{s});而且窗口以 1 秒步长滑动、相邻窗口重叠,底层不重复的录像还要更少(按“窗口数 \times 1 秒”粗估约 290 小时量级,这是译者的推算,原文未给出)。作为参照,EgoVerse 整个数据集是 1.36K 小时。因此“10.0K 小时”衡量的是训练中可见的配对组合有多丰富,而不是看了多少小时的新视频。10.52 与 6.35。平均每个查询 10.52 个参考,其中跨源 6.35 个、同源约 4.17 个(附录写作 10.5 = 4.2 + 6.4,是同一组数的舍入)。上限是 8 + 7 = 15。均匀采样下,平均约 60%(6.35/10.52)的训练步用的是跨来源参考。90.7% 的补数 9.3% 是没有任何跨源参考的查询,附录说明它们全部来自 MECKA 来源(MECKA 的跨源覆盖率只有 82.4%,其余来源为 100%);这些查询只能和同源示范配对,“跨来源”的差异就弱一些。“高出 0.36”。这是附录表 5 的结果:在 12,000 个查询上,取排名第一的跨源参考,计算它与查询的轨迹形状余弦相似度,均值为 0.36;同任务类随机配对的均值为 0.00。所以“高出 0.36”其实就是从 0 到 0.36。它说明 DTW 重排确实在任务标签之外又筛出了运动更相似的配对,不过 0.36 本身只是中等程度的相似。另外,正文说对照组是“同任务随机跨来源配对”,而表 5 的表注只写“同任务类的随机配对”,两处措辞不完全一致。
原文
Reference-conditioned joint prediction. As illustrated in Fig. 3, the model receives the current query frame and state together with the reference video and actions. For a query window q and a reference window r drawn from its reference set, we model
p_{\theta}\left( a^q_{t:t+C},\, I^q_{t+1:t+C+1} \mid I^q_t,\, s^q_{t},\, \ell,\, I^r_{u:u+C+1},\, a^r_{u:u+C} \right), \qquad r \sim \mathcal{R}(q),(1)
over a prediction horizon C, where u is the start of the reference window and the task description \ell enters as text on both backbones. The reference supplies an example of task progression while the query observation specifies the target scene and source, so predicting the query future requires transferring the demonstrated interaction into the query's visual and geometric context. Inputs and outputs are encoded as six slots: current query frame (I^q_t), query state (s^q_{t}), reference video (I^r_{u:u+C+1}), reference actions (a^r_{u:u+C}), predicted future video (I^q_{t+1:t+C+1}) and actions (a^q_{t:t+C}). Each carries its own positional encoding over slot type and physical time, so where the reference begins and where the action begins are marked by slot rather than by absolute offset, and the encoding carries over to post-training as slots are repopulated or dropped. Following the joint video-action prediction recipe of Cosmos Policy, we implement WATCH on Cosmos-Predict2.5 and Cosmos3 [19] using the joint objective of §2.1, applied only to the generated slots, which ties the predicted motion to its expected visual effect while retaining the backbone's dynamics prior. A query and its reference are 3-second windows, the action term is weighted by \lambda = 48, and post-training on the target robot keeps the same objective and slot layout (§C.1). 译文
以参考为条件的联合预测。 如图 3 所示,模型接收查询的当前帧和状态,以及参考视频和参考动作。对于查询窗口 q 和从其参考集中抽取的参考窗口 r,我们建模
p_{\theta}\left( a^q_{t:t+C},\, I^q_{t+1:t+C+1} \mid I^q_t,\, s^q_{t},\, \ell,\, I^r_{u:u+C+1},\, a^r_{u:u+C} \right), \qquad r \sim \mathcal{R}(q),(1)
预测时长为 C,其中 u 是参考窗口的起点,任务描述 \ell 在两种主干上都以文本形式输入。参考提供了任务推进过程的一个示例,而查询观测指定了目标场景和来源,因此要预测查询的未来,就必须把示范中的交互迁移到查询的视觉和几何情境中。输入和输出被编码为六个槽位:查询当前帧(I^q_t)、查询状态(s^q_{t})、参考视频(I^r_{u:u+C+1})、参考动作(a^r_{u:u+C})、预测的未来视频(I^q_{t+1:t+C+1})和动作(a^q_{t:t+C})。每个槽位都带有关于槽位类型和物理时间的位置编码,因此参考从哪里开始、动作从哪里开始是由槽位而不是绝对偏移量标记的;在后训练中重新填充或删除槽位时,这套编码可以直接沿用。我们沿用 Cosmos Policy 的视频—动作联合预测做法,在 Cosmos-Predict2.5 和 Cosmos3 [19] 上实现 WATCH,使用 §2.1 的联合目标,且只作用于被生成的槽位;这把预测的运动与其预期的视觉效果绑定在一起,同时保留主干的动力学先验。查询及其参考都是 3 秒窗口,动作项的权重为 \lambda = 48;在目标机器人上的后训练沿用同样的目标和槽位布局(附录 C.1)。 解释
式 (1) 逐符号。上标 q、r 分别标记查询和参考。与 §2.1 的视频内分布相比,竖线左边的目标完全不变(查询的 C 个动作和随后的 C 帧),右边多了两个条件:参考视频 I^r_{u:u+C+1}=(I^r_u,\dots,I^r_{u+C}),共 C+1 帧(含起始帧);参考动作 a^r_{u:u+C}=(a^r_u,\dots,a^r_{u+C-1}),共 C 个。也就是说,参考给的是一段完整的“画面 + 动作”,查询只给第一帧和状态。t 和 u 是两条不同录像各自时间轴上的下标:t 是查询窗口的当前时刻,u 是参考窗口的起点,两者没有数值关系。模型也不读 u 的具体取值,参考在序列中的时间位置由下面的时间标签统一给定。r\sim\mathcal R(q) 表示每个训练步从参考集里随机抽一个参考。同一个查询目标会与不同的参考搭配出现,而目标不随参考改变,所以模型无法靠照抄某一个参考来降低损失,只能从参考中提取“这个任务怎么做”这种共性信息,再落实到查询画面里物体的实际位置上。\ell 在 Cosmos-Predict2.5 上经 T5 交叉注意力输入,在 Cosmos3 上作为 caption token 输入(附录 C.1)。六个槽位。附录 C.1 的槽位表如下(\delta 为相邻潜帧的时间间隔,k、g 为参考视频和未来视频占用的潜帧数):
正文列举的顺序与这张表的实际排列不同,但注意力是双向的,排列顺序不影响谁能看到谁。参考视频的时间标签被放在查询当前帧之前,相当于告诉模型“先看了一段别人的示范,现在轮到你”;查询当前帧紧贴在生成段之前,以保留视频模型“接着往下续”的先验。槽位类型嵌入初始化为零,因此改造后的网络在初始化时与原网络完全相同。由附录 C.3 的数字可以反推规模:视频内基线把参考视频压到 2 个潜帧,序列共 29 个潜帧;WATCH 为 50 个,即参考视频约占 23 个潜帧,与未来视频的 23 个相当。所以 WATCH 每步计算量明显更大,而两者训练步数相同(8K 步),计算量并不匹配。其余设定。“绑定运动与视觉效果”是联合目标的直觉:动作和未来帧在同一次去噪中生成,二者必须自洽。\lambda=48 的含义见 §2.1 的解释(动作在生成槽位中只占约 1 个潜帧)。“3 秒窗口”在 30 Hz 下是 92 帧,加上当前帧共 93 帧,恰好满足视频自编码器要求的 1+4(T-1) 帧(T=24);20 Hz 来源取 60 帧(61=1+4\times15)。两种主干中,Cosmos-Predict2.5 是整流流扩散 Transformer,条件以干净潜变量给出;Cosmos3 是混合 Transformer 模型,条件通过把 token 的噪声水平固定为零来表达(附录 C.1)。
| 编号 | 内容 | 时间标签 | 角色 |
| 0 | 查询状态 s^q_t | t | 条件 |
| 1 | 参考动作 a^r_{u:u+C} | t | 条件 |
| 2 | 参考视频 I^r_{u:u+C+1} | t-k\delta,\dots,t-\delta | 条件 |
| 3 | 查询当前帧 I^q_t | t | 条件 |
| 4 | 查询动作 a^q_{t:t+C} | t | 生成 |
| 5 | 查询未来视频 I^q_{t+1:t+C+1} | t+\delta,\dots,t+g\delta | 生成 |
原文
Post-training with and without context. The model trained by WATCH supports both in-context and context-free post-training, with predicted actions expressed in the target robot's native control space. In-context post-training conditions robot action and future-video prediction on a human reference demonstration. Context-free post-training removes the reference slots and predicts robot actions and future frames from the robot's current observation, state, and task instruction. Both protocols retain the same backbone and joint prediction objective.
译文
有上下文与无上下文的后训练。 经 WATCH 训练的模型同时支持上下文内后训练和无上下文后训练,预测的动作以目标机器人自身的控制空间表示。上下文内后训练以一条人类参考示范为条件,预测机器人动作和未来视频。无上下文后训练删除参考槽位,仅根据机器人的当前观测、状态和任务指令预测机器人动作和未来帧。两种方案保留同样的主干和联合预测目标。
解释
两种用法正好对应式 (1) 的两种退化。上下文内:查询换成机器人,参考仍是人类示范,即“看人做一遍,机器人在自己的场景里照做”,这与预训练时“看另一个人做一遍”的结构完全一致,对应第 4 节的 MimicDroid 实验。无上下文:去掉槽位 1、2,式 (1) 退回 §2.1 的视频内形式 p_\theta(a_{t:t+C},I_{t+1:t+C+1}\mid I_t,s_t,\ell),模型就是一个普通的世界—动作策略,WATCH 只作为更好的初始化,对应 TableTop-Sim、RoboCasa 等实验。“目标机器人自身的控制空间”一说需要灵活理解:按附录 F.1,在 MimicDroid 上除 \pi_{0.5} 和 MolmoAct2 外的模型(包括 WATCH)都用附录 B.1 的 57 维共享表示,TableTop-Sim 上则统一用 ALOHA 的 20 维动作。
3跨视频预训练学到了什么(What Cross-Video Pre-Training Learns)
原文
Motivated by the hypothesis that cross-video prediction encourages the model to capture interactions shared across demonstrations, we examine what WATCH learns before robot post-training: how it uses task information from a reference to predict interactions in another demonstration, through reference sensitivity, motion alignment, and hand–object attention. We then assess how this learning extends to unseen human and robot demonstrations, including whether human pairs yield representations similar to those learned from robot pairs. We use held-out human pairs from EgoVerse [15], paired robot data from RoboMIND [20], and robot observations from MimicDroid [10], the post-training benchmark of §4.1. The results suggest that cross-video pre-training captures task-relevant motion and interactions across embodiments.
译文
我们的假设是:跨视频预测会促使模型捕捉不同示范之间共有的交互。基于这一假设,我们考察 WATCH 在机器人后训练之前学到了什么,即它如何利用参考示范中的任务信息来预测另一条示范中的交互;考察从三个方面入手:对参考的敏感性、动作对齐,以及手—物体注意力。随后我们评估这种学习能否推广到未见过的人类和机器人示范,包括人类配对数据学到的表征是否与机器人配对数据学到的表征相似。我们使用 EgoVerse [15] 中留出的人类配对、RoboMIND [20] 中的配对机器人数据,以及 MimicDroid [10](即 §4.1 的后训练基准)中的机器人观测。结果表明,跨视频预训练能够跨本体地捕捉与任务相关的动作和交互。
解释
这一节不做下游控制实验,而是“打开”预训练好的模型看它内部发生了什么,所有被分析的模型都只见过人类数据(最后一段的对照模型除外),还没有经过任何机器人后训练。本节共五个小分析,各对应一个粗体段首:(1) 换掉参考示范时预测误差如何变化(图 4,检验模型是否真的在“读”参考的任务内容);(2) 动作槽位特征能否把不同来源、不同机器人的相同动作对齐(图 5,动作检索与留出本体回归);(3) 同时预测动作和视频是否让注意力集中到手和物体上(图 6);(4) 在完全没见过的 RoboMIND 机器人数据上做离线动作与视频预测(表 1);(5) 只用人类数据训练的模型与用机器人数据训练的模型,表征是否一致(图 7)。用到的数据有三类:EgoVerse 中预训练时留出的 150 个人类回合(附录 B.4 从中再筛出各分析所需的子集);RoboMIND 的真实机器人数据(Franka、UR5e、TienKung 三种机器人),预训练时任何模型都没见过;MimicDroid 中 GR1 人形机器人的仿真画面。阅读时要注意,作者在结论句里用的是 “suggest”(“表明/提示”),本节大部分证据是表征层面的相关性分析或少量样例的可视化,并不直接等同于控制性能的提升;控制性能的证据在第 4 节。下文的解释会尽量区分“数据直接显示的”和“作者据此推测的”。
(a) 对参考的敏感性
(b) 动作 token 的注意力
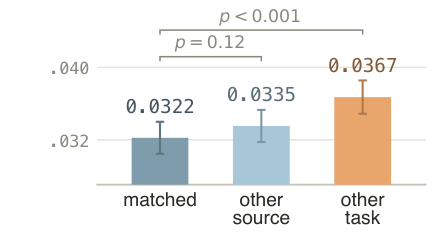
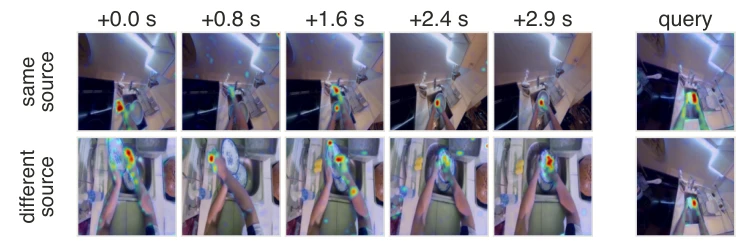
图 4:对参考示范的敏感性。(a) 在 137 个留出回合上的动作 MSE(越低越好),参考分别为:匹配的参考、来自另一采集来源但动作相似的参考、来自同一来源但任务不同的参考。括号标注的是经 Holm 校正的 p 值(按回合配对的 Wilcoxon 检验)。我们的模型对来源变化的敏感程度低于对任务变化的敏感程度,表明我们的训练促使模型关注与任务相关的动作。(b) 同一查询(洗碗)在使用同一采集来源的参考(上)和不同来源的参考(下)时,动作 token 的注意力。即使参考来自不同来源,注意力仍集中在对任务执行至关重要的交互上。
原图注:Sensitivity to the reference demonstration. (a) Action MSE (lower is better) over 137 held-out episodes using a matched reference, a similar-motion reference from a different collection source, or a different-task reference from the same source. Brackets: Holm-corrected p-values, episode-paired Wilcoxon test. Our model is less sensitive to a change of source than of task, suggesting that our training encourages a focus on task-relevant actions. (b) Action-token attention for the same query (do dishes) with references from the same collection source (top) and a different one (bottom). Even with a reference from a different source, attention concentrates on interactions central to task execution.
图 4 解读
(a) 柱状图。三根柱子是同一个预训练好的 WATCH 模型在同一批查询上、只换参考示范时的动作预测 MSE:matched(训练时那种检索出来的匹配参考)0.0322,other source(换成另一采集来源、但动作相似的示范)0.0335,other task(换成同一来源、但任务不同的示范)0.0367。误差棒的含义(标准误还是置信区间)原文没有说明。上方两个括号是两组比较的 Holm 校正后 p 值:matched 对 other source 为 p=0.12,matched 对 other task 为 p<0.001。注意纵轴不是从 0 开始的(刻度只标了 .032 和 .040),柱高的视觉差别被放大了;按数值算,换来源让 MSE 增加约 4%(0.0013/0.0322),换任务增加约 14%(0.0045/0.0322)。(b) 注意力图。左边五列是参考示范在其时间跨度内的五个时刻(+0.0 s 到 +2.9 s,即一个约 3 秒的窗口),最右一列是查询的当前帧;上下两行只差在参考的来源。热图是动作 token 对这些画面的注意力。按附录 D.3,查询来自 Scale,“不同来源”的参考是一条 MECKA 示范。两行中热度都落在手和碗盘附近。这是单个查询的定性示例,附录 D.3 又补了两个查询并加上原始视频模型做对照(原始模型的注意力散布在边缘、灯光和背景上),但总体仍是少量样例,不能当作统计证据。
原文
Conditioning is more sensitive to task changes. We compare matched references with similar-motion references from a different collection source and different-task references from the same source in Fig. 4a. Action MSE increases from 0.0322 to 0.0335 under the source change and to 0.0367 under the task change, only the latter significant after Holm correction. In the visualized examples, attention remains concentrated on the acting hands and manipulated object when the reference source changes (Fig. 4b; §D.3). Together, these observations suggest that reference conditioning tracks task-relevant interactions across collection sources.
译文
条件作用对任务变化更敏感。在图 4a 中,我们把匹配的参考与两类替换参考作比较:来自不同采集来源、动作相似的参考,以及来自同一来源、任务不同的参考。动作 MSE 在来源变化时从 0.0322 增加到 0.0335,在任务变化时增加到 0.0367,经 Holm 校正后只有后者显著。在可视化的样例中,当参考的来源改变时,注意力仍集中在正在动作的手和被操作的物体上(图 4b;§D.3)。综合来看,这些观察表明,参考条件作用跟踪的是跨采集来源的、与任务相关的交互。
解释
实验设计。这是一个“换参考”的干预实验:查询不变、模型不变,只换输入的参考示范,看动作预测误差变多少。如果模型真的在利用参考里的任务信息,那么换成另一个任务的参考应当明显变差;如果模型学到的是本体不变、来源不变的交互信息,那么换成另一来源但做相似动作的参考应当影响不大。137 个回合是附录 B.4 从 150 个留出回合中筛出的:只有同时存在“不同来源的匹配示范”和“同来源的不同任务示范”的查询才能参与比较。统计检验。因为三种条件作用在同一批回合上,误差是成对的,所以用配对检验:Wilcoxon 符号秩检验对每个回合计算两种条件下的 MSE 差,检验这些差值的分布是否以 0 为中心;它不假设误差服从正态分布,适合 MSE 这种偏态的量。同时做了两组比较,为了控制“至少一次误报”的概率,用 Holm 校正:把原始 p 值从小到大排序,最小的乘以 2,次小的乘以 1(并保证校正后单调不减),再与 0.05 比较。换任务的差异(约 14%)在校正后 p<0.001,是稳健的;换来源的差异(约 4%)校正后 p=0.12,没有达到显著。如何解读“不显著”。“不显著”只说明在 137 个回合的样本量下,没有足够证据认为换来源会增大误差,并不证明两者相等(这不是等价性检验),平均值也确实略有上升。还要注意两种替换参考并不对称:“不同来源”的参考是按动作相似度专门挑出来的,“不同任务”的参考则没有这个条件,所以这个实验比较的其实是“内容相近但来源不同”与“来源相同但内容不同”。数据直接支持的结论是:模型对参考内容(任务、动作)的变化比对来源的变化更敏感。“条件作用跟踪的是与任务相关的交互”是作者把这一结果与图 4b 的少量注意力图结合后给出的推测性解读。

(a) 检索,人类
(b) 检索,机器人
(c) 留出本体回归
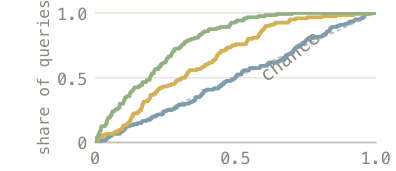
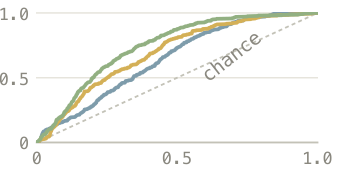
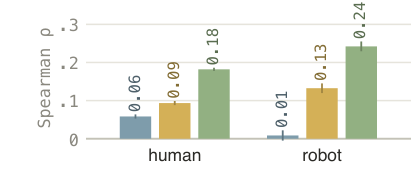
图 5:跨本体的表征对齐与动作迁移。使用第 10–27 层的动作槽位特征,检索排名和回归得分都在这些层上取平均;数据为 359 个留出的 EgoVerse 窗口(人类)和来自三种机器人的 396 个 RoboMIND 窗口(机器人)。(a, b) 动作检索:横轴为归一化排名,纵轴为“来自不同采集来源 (a) 或不同机器人 (b) 的匹配窗口落在该归一化排名以内”的查询比例;曲线越高越好,对角线为随机水平。(c) 留出本体回归:在两个本体上拟合的回归器在第三个本体上预测九个未来动作量;柱高是在各量和各折上平均的 Spearman 相关,误差棒是跨层的标准误。
原图注:Representation alignment and motion transfer across embodiments. Action-slot features from layers 10–27, with retrieval ranks and regression scores averaged over these layers, on 359 held-out EgoVerse windows (human) and 396 RoboMIND windows from three robots (robot). (a, b) Motion retrieval: share of queries whose matched window from a different collection source (a) or robot (b) falls within a normalized rank; a higher curve is better, the diagonal is chance. (c) Held-out embodiment regression: a regressor fit on two embodiments predicts nine future-motion quantities on the third; bars are the mean Spearman correlation over quantities and folds, error bars the standard error over layers.
图 5 解读
三种颜色是三个模型:蓝灰为原始视频模型(Cosmos-Predict2.5-2B,未见过 EgoVerse),黄为视频内预训练基线,绿为 WATCH。特征取自 28 层 DiT 中的第 10–27 层(靠近动作输出的后段),每层把动作槽位的隐状态在空间上取均值,得到一个 2048 维向量。(a)(b) 检索曲线怎么读。每个“对”由一个查询窗口和它的匹配窗口组成,匹配窗口来自另一个采集来源(人类集,120 对)或另一种机器人(机器人集,396 对,在同一任务内按尺寸归一化后的腕部轨迹 DTW 距离配对)。用余弦距离把匹配窗口在其所属来源(或机器人)的全部窗口中排名,再把名次除以候选总数归一化到 [0,1]:0 表示排第一,1 表示排最后。曲线上一点 (x,y) 的意思是:有比例 y 的查询,其匹配窗口的归一化排名不超过 x。如果特征与动作毫无关系,排名在 [0,1] 上均匀分布,曲线就是对角线 y=x(期望排名 0.5)。曲线越往左上鼓,说明匹配窗口越常被排在前面。附录 D.5 给出了曲线下面积:人类集上原始模型、视频内基线、WATCH 依次为 0.50、0.66、0.78,机器人集上为 0.65、0.69、0.74。原始模型在人类集上恰好是随机水平,与附录 t-SNE 中“原始模型按来源各自成团”的现象一致:它的特征主要区分的是录制来源(场景外观),而不是动作。(c) 回归柱状图。柱上数字:人类集 0.06 / 0.09 / 0.18,机器人集 0.01 / 0.13 / 0.24(依次为原始模型、视频内基线、WATCH)。误差棒是“跨层的标准误”,反映的是结果在第 10–27 层之间波动多少,并不是对窗口抽样不确定性的置信区间;相邻层的特征高度相关,所以这个误差棒会低估真实的不确定性。
原文
Embodiment-invariant motion representations from human demonstrations. Cross-embodiment motion transfer requires both alignment of corresponding movements and preservation of information about how those movements unfold. We examine both properties using action-slot features of the original video model, the within-video baseline, and WATCH on 359 held-out EgoVerse windows and 396 RoboMIND windows from three robots (Fig. 5). In motion retrieval (Fig. 5a,b), WATCH ranks matching motions from different human sources and different robots earlier than both baselines. To test whether this alignment also preserves transferable motion information, we fit a regressor on two embodiments and evaluate it on the third (Fig. 5c). It predicts future motion from WATCH's features at a Spearman correlation of 0.18 on human and 0.24 on robot windows, against 0.06 and 0.01 for the original video model. These complementary results suggest that human cross-video pre-training supports both cross-embodiment correspondence and a transferable encoding of motion, extending to unseen robots.
译文
从人类示范中学到本体不变的动作表征。跨本体的动作迁移需要两点:相互对应的动作在表征中对齐,同时保留这些动作如何展开的信息。我们用原始视频模型、视频内基线和 WATCH 的动作槽位特征,在 359 个留出的 EgoVerse 窗口和来自三种机器人的 396 个 RoboMIND 窗口上考察这两点(图 5)。在动作检索中(图 5a、b),对于来自不同人类来源和不同机器人的匹配动作,WATCH 都比两个基线排得更靠前。为了检验这种对齐是否同时保留了可迁移的动作信息,我们在两个本体上拟合回归器,并在第三个本体上评估(图 5c)。由 WATCH 的特征预测未来动作,在人类窗口上的 Spearman 相关为 0.18,在机器人窗口上为 0.24,而原始视频模型分别只有 0.06 和 0.01。这些相互补充的结果表明,人类跨视频预训练既支持跨本体的对应关系,也支持可迁移的动作编码,并能延伸到未见过的机器人。
解释
两个测量各管一件事。检索测的是“对齐”:做同一个动作的两个窗口,即使来自不同来源或不同机器人,在特征空间里是否靠得近。但仅有对齐还不够,一个把所有窗口都映射到同一点的表征也“对齐”,却不含任何动作信息;所以再用回归测“保留”:特征里是否编码了未来动作的具体量,而且这种编码在本体之间是否通用。留出本体回归的做法(附录 D.6)。标签是窗口内九个未来动作量(位移、路径长度、速度、时序和接触相关项),每个量在本体内部先做 z 标准化,消除不同本体的尺度差异。用核岭回归在两个本体的特征上训练,在第三个本体上测试,三种留出方式各做一折;每折每个量算预测值与真值的 Spearman 秩相关,再对九个量和三折取平均。Spearman 相关只看排序是否一致,取值 -1 到 1,0 表示无单调关系。对人类集来说,“本体”其实是三个采集来源(MECKA、Scale、Aria),都是人手,只是录制设备和场景不同;机器人集才是真正不同的机械本体(Franka、UR5e、TienKung)。如实看数字。相对提升很大(人类集 3 倍,机器人集从几乎为零到 0.24),但绝对值并不高:\rho=0.18 或 0.24 都只是弱相关,大致相当于秩方差的 3%–6% 能被解释,离“特征能准确预测未来动作”还很远。更公平的比较对象其实是视频内基线(0.09 / 0.13),WATCH 相对它的提升约为 0.09 / 0.11,作者正文只列了与原始模型的对比。此外附录 D.6 自己指出两点保留:Aria 只有 32 个窗口,以它为测试折的结果噪声大;WATCH 在提取特征时还会在检索动作槽位中收到一个同来源(或同机器人)匹配参考的未来动作,而两个基线这些槽位为空。这一点对“预测未来动作”的回归和检索都可能有直接帮助,所以 WATCH 的领先不能全部归于预训练改变了特征本身。结论的分寸。数据显示的是:在这两个分析集上,WATCH 的动作槽位特征比两个基线更能跨来源、跨机器人地对齐相同动作,并且含有更多可跨本体迁移的未来动作信息,而且没有任何模型见过机器人数据。“支持跨本体对应和可迁移的动作编码”是合理的概括;但这些是表征层面的相关性证据,它们能否转化为控制收益,要看第 4 节的后训练实验。
(a)
TurnOnFaucet 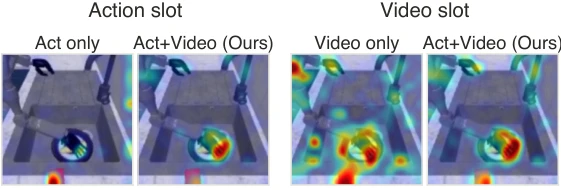
(b)
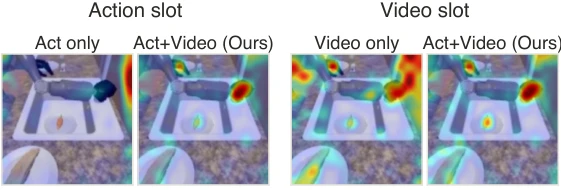
PnPSinkToRightCounterPlate 图 6:不同预训练监督下的注意力可视化。所有模型都使用跨视频配对,区别在于它们接收并预测哪些参考模态:只有动作(Act only)、只有未来帧(Video only),或两者都有(Act+Video,本文)。联合监督使动作槽位和视频槽位的注意力都集中在正在动作的手和被操作的物体上。
原图注:Attention visualizations under different pre-training supervision. All models use cross-video pairing and differ in which reference modalities they receive and predict: actions only (Act only), future frames only (Video only), or both (Act+Video, ours). Joint supervision concentrates attention on the acting hand and the manipulated object on both the action and the video slot.
图 6 解读
每个子图是一个 MimicDroid 任务的同一帧 GR1 机器人画面,从左到右四格:动作槽位注意力(Act only,Act+Video),视频槽位注意力(Video only,Act+Video)。也就是说,Act+Video 模型出现两次,分别与只有对应输出槽位的单模态模型比较。(a)
TurnOnFaucet(打开水龙头):Act only 的热点是贴着画面右边缘的一条,远离水龙头;Video only 的热点分散在画面上沿和水槽区域;Act+Video 的两个槽位都集中在水龙头附近。(b) PnPSinkToRightCounterPlate(从水槽拿起物体放到右侧台面的盘子上):Act only 的动作槽位注意力整体较弱,热点偏在画面左下角,Video only 的视频槽位铺满了水槽和周围场景,Act+Video 则集中在抓取位置。这里用的是机器人画面,而三个模型预训练时都只见过人类数据,所以这张图也顺带是一个跨本体的定性观察。需要强调,每个任务只展示一帧,属于少量样例的定性可视化;注意力热图也只是模型内部权重分布的一种视图,热点在哪里不等于模型“依据”什么作决策。三种监督在下游任务上的定量比较见图 8(§4.3 的预训练监督消融)。 原文
Joint supervision focuses attention on interactions. To understand the role of predicting both motion and its visual consequences, we compare attention under action-only, video-only, and joint training with the same cross-video pairing (§2.3), using the respective modalities as reference inputs and prediction targets. Fig. 6 shows attention from the corresponding output slots on identical query frames. Action-only attention peaks near image boundaries, away from the manipulated object, while video-only attention spreads across the interaction region and surrounding scene. Joint training concentrates both action-slot and video-slot attention on the acting hand and object, around the faucet in
TurnOnFaucet and the grasp in PnPSinkToRightCounterPlate. This shared focus suggests that jointly predicting motion and its visual consequences encourages both outputs to attend to the interaction connecting them.译文
联合监督让注意力聚焦于交互。为了理解同时预测动作及其视觉后果的作用,我们在相同的跨视频配对(§2.3)下比较仅动作、仅视频和联合训练三种情形的注意力,各自以相应的模态作为参考输入和预测目标。图 6 展示了在相同查询帧上、来自相应输出槽位的注意力。仅动作训练的注意力在图像边界附近达到峰值,远离被操作的物体;仅视频训练的注意力则铺散在交互区域和周围场景上。联合训练使动作槽位和视频槽位的注意力都集中在正在动作的手和物体上:在
TurnOnFaucet 中围绕水龙头,在 PnPSinkToRightCounterPlate 中围绕抓取处。这种共同的聚焦表明,联合预测动作及其视觉后果会促使两个输出都关注连接二者的交互。解释
对比的是什么。三个变体都用同一套跨视频配对和同样的训练流程,只改变参考槽位里放什么、要预测什么:仅动作变体只看参考的动作、只预测查询的未来动作;仅视频变体只看参考的未来帧、只预测查询的未来帧;联合变体(即 WATCH)两者都有。这样,差异可以归到监督模态上,而不是配对方式上。作者的解释思路。只预测动作时,模型输出的是一串手部/末端位姿,图像只是辅助线索,注意力未必需要落在物体上;只预测视频时,模型要重建整幅未来画面,背景、台面也都要画,注意力自然铺开。两者联合时,动作与画面变化之间的共同部分恰好是“手碰到物体、物体随之移动”这一交互,于是两个槽位都被拉到交互区域。这是一个合理的直觉,但正文给出的证据只是两个任务各一帧的可视化,“联合预测促使两个输出关注连接它们的交互”应视为作者的推测。比较硬的佐证在图 8:下游 MimicDroid 上下文内任务中,仅动作预训练优于仅视频,TableTop-Sim 上则相反,联合预训练在两者上的平均成功率都最高。
表 1:在留出机器人数据上的评估。在 RoboMIND 上进行末端执行器动作预测和视频预测,所有模型都未见过这些数据;原始模型指未经任何动作训练的视频模型。其他数据集上的结果见 §D.2。
| 动作 | 生成视频 | |||
| 模型 | MSE \downarrow | acc@0.1\uparrow | FVD \downarrow | FID \downarrow |
| 原始模型(Original model) | – | – | 290.7 | 12.48 |
| 视频内(Within-video) | 0.046 | 55.6 | 1485.1 | 53.53 |
| WATCH(本文) | 0.039 | 68.5 | 154.9 | 8.33 |
原表注:Evaluation on held-out robot data. End-effector action and video prediction on RoboMIND, unseen by every model; original model is the video model before any action training. Other sets are in §D.2.
表 1 解读
设置。三行是三个只在人类数据上(或完全没有)训练过的模型:原始模型是 Cosmos-Predict2.5 的图像到视频检查点,没有动作输出,所以动作两列为“–”;视频内基线和 WATCH 都在 EgoVerse 上预训练 8K 步,区别在于前者的参考槽位为空、只靠查询自身的上下文,后者以检索到的参考为条件。评估集是 RoboMIND 的 2,048 个片段(附录 B.4),与图 5 用的 396 个窗口、图 7 用的 300 个窗口是三个不同的集合。各列含义。动作两列只在末端执行器那部分维度上计算(不含手指等维度)。MSE 是在归一化空间中的均方误差;acc@0.1 是预测值与真值之差落在 0.1 容差以内的比例(%),原文没有说明是按单个数值还是按时间步统计,但含义是“足够准”的比例。视频两列衡量生成的未来画面:FVD(Fréchet Video Distance)用一个预训练的视频识别网络提取真实片段和生成片段的特征,分别拟合高斯分布后计算两者之间的 Fréchet 距离,同时反映单帧质量和时间上的连贯性;FID(Fréchet Inception Distance)是同样的思路,但只在单帧图像上用 Inception 网络特征计算。两者都是越低越接近真实数据的分布。关键数字。动作上,WATCH 的 MSE 比视频内基线低约 15%(0.046\to0.039),acc@0.1 高 12.9 个百分点(55.6\to68.5)。视频上最醒目的是视频内预训练造成的退化:FVD 从原始模型的 290.7 恶化到 1485.1(约 5.1 倍),FID 从 12.48 恶化到 53.53(约 4.3 倍),说明只在人类第一人称视频上做视频内训练后,模型面对机器人画面时的生成能力严重受损;附录 D.2 的样例里,视频内模型在 Humanoid Everyday 上会“漂”到另一只手臂和另一个场景。这种退化在人类数据 EgoDex 上并不出现(视频内 169.8 反而优于原始模型的 200.5),可见问题出在跨到机器人域。WATCH 则把 FVD 降到 154.9、FID 降到 8.33,都优于原始模型。
原文
The prior generalizes to unseen robot data. We evaluate whether a model pre-trained on human demonstrations generalizes to robot data unseen during pre-training, using action and video prediction on RoboMIND [20] (Table 1). Compared with the within-video baseline using query context alone, reference-conditioned WATCH lowers action MSE from 0.046 to 0.039 and raises accuracy from 55.6\% to 68.5\%. Video FVD and FID also improve over the original video model, whereas within-video pre-training worsens both. These results support generalization from human demonstrations to unseen robots in both action and video prediction.
译文
先验能泛化到未见过的机器人数据。我们评估在人类示范上预训练的模型能否泛化到预训练中未见过的机器人数据,方法是在 RoboMIND [20] 上做动作预测和视频预测(表 1)。与只使用查询上下文的视频内基线相比,以参考为条件的 WATCH 把动作 MSE 从 0.046 降到 0.039,把准确率从 55.6\% 提高到 68.5\%。视频的 FVD 和 FID 也都优于原始视频模型,而视频内预训练使这两项都变差。这些结果支持:从人类示范出发,在动作预测和视频预测两方面都能泛化到未见过的机器人。
解释
这段在检验什么。前面的分析都在看表征,这一段直接看预测输出:一个从没见过机器人的模型,能否预测真实机器人(RoboMIND)的末端动作和未来画面。这是一个“零样本”的离线评估,不涉及闭环控制。需要注意的不对称。正文自己写明了:视频内基线“只用查询上下文”,WATCH 则“以参考为条件”。也就是说,测试时 WATCH 多拿到一条相关示范作为输入,这本身就可能降低动作误差、帮助生成画面;表 1 的差距是“预训练方式不同”和“测试时多一条参考”两者叠加的结果,无法单独归因于预训练。另外,原文没有交代 RoboMIND 上 WATCH 的参考是如何检索的(来自同一机器人还是跨机器人),见附注。视频内基线每步的计算量也更小(序列 29 个 latent 对 50 个),而两者训练步数相同。视频退化值得重视。视频内预训练让 FVD 从 290.7 恶化到 1485.1,这不是小幅波动,而是生成质量的崩坏,说明“在大规模人类视频上直接微调视频模型”本身有破坏原有视觉先验的风险。WATCH 不仅避免了这种退化,还优于原始模型,作者把它解读为跨视频目标保住并强化了视频先验。这是一个有意义的观察,但每个配置只训练了一次,表中也没有误差估计,具体差距的稳定性无从判断。
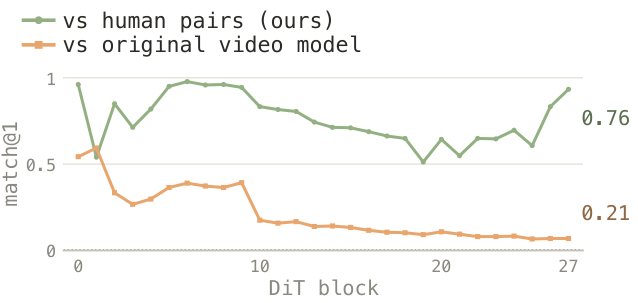
图 7:与机器人训练模型的对齐程度。以机器人数据训练的模型为参照,在 359 个 EgoVerse 窗口上测得的 match@1:绿色为人类数据训练的 WATCH,橙色为原始视频模型(机器人窗口上的结果见图 19)。右侧数字为全部层的平均值。
原图注:Alignment with a robot-trained model. Match@1 for human-trained WATCH (green) and the original video model (orange), measured against the robot-trained model on 359 EgoVerse windows (robot windows: Fig. 19). Numbers at right: mean over all layers.
图 7 解读
横轴是 DiT 的第 0–27 个块(层),纵轴是该层的 match@1;图例中“vs human pairs (ours)”指人类数据训练的模型与机器人训练模型之间的一致性,“vs original video model”指原始模型与机器人训练模型之间的一致性。绿线在前几层就接近 1,中段(约第 20–24 层)下降到 0.5 左右,最后几层又回升到 0.9 附近,全层平均 0.76;橙线在前 10 层还有 0.3–0.6,此后降到 0.2 以下并在最后几层接近 0,全层平均 0.21。前 10 层两条线都较高并不奇怪:三个模型都从同一个原始检查点出发,浅层主要是输入侧的特征,大家共享。真正有区分度的是第 10 层以后:附录 E.2(图 19)给出第 10–27 层的平均,人类训练模型在人类窗口上为 0.71、在机器人窗口上为 0.50,原始模型约为 0.11–0.13。正文报告的“全层平均”把浅层也算进去,反而抬高了原始模型的数字,所以若按第 10–27 层算,两者差距更大。随机水平是 1/N,人类窗口为 1/359\approx0.0028,机器人窗口为 1/300\approx0.0033,两条曲线都远高于随机。
原文
Human and robot pairs induce similar representations. We examine whether training on human demonstrations yields robot-motion representations similar to those learned directly from robot demonstrations. We compare WATCH trained on 1K hours of human pairs with a counterpart trained on 1K hours of RoboMIND [20] robot pairs using the same cross-video objective (§E.1). Both are evaluated on the same 359 EgoVerse and 300 RoboMIND windows, the latter seen during pre-training only by the robot-trained model. We align the human-trained and original video models' action-slot features to the robot-trained model's features on half of the windows, then measure cross-model window matching on the rest (§E). Human-trained WATCH achieves a mean match@1 of 0.76 on human and 0.60 on robot windows over all layers, compared with 0.21 and 0.19 for the original video model (Fig. 7). This correspondence supports human demonstrations as a scalable source for learning robot-relevant motion representations.
译文
人类配对与机器人配对诱导出相似的表征。我们考察:在人类示范上训练得到的机器人动作表征,是否与直接从机器人示范中学到的表征相似。我们把在 1K 小时人类配对上训练的 WATCH,与用相同跨视频目标在 1K 小时 RoboMIND [20] 机器人配对上训练的对应模型进行比较(§E.1)。两者在相同的 359 个 EgoVerse 窗口和 300 个 RoboMIND 窗口上评估,后者在预训练中只被机器人训练模型见过。我们在一半窗口上把人类训练模型和原始视频模型的动作槽位特征对齐到机器人训练模型的特征,然后在其余窗口上测量跨模型的窗口匹配(§E)。在全部层上平均,人类训练的 WATCH 在人类窗口上的 match@1 为 0.76,在机器人窗口上为 0.60,而原始视频模型分别为 0.21 和 0.19(图 7)。这种对应关系支持把人类示范作为学习与机器人相关的动作表征的一种可扩展数据来源。
解释
问题与对照。这里问的是:只看人类视频学出来的表征,离“直接用机器人数据学”有多远。为了公平,两边的数据量都控制在约 1K 小时,人类一侧取的是全部人类配对的 10% 子集(所以这里的 WATCH 不是正文主实验用的 10K 窗口小时版本),训练配方完全相同。300 个 RoboMIND 窗口(Franka 100、UR5e 71、TienKung 129)在机器人训练模型的预训练数据里出现过,对人类训练模型则完全陌生,因此一致性高意味着人类模型在“对方的主场”上也和对方看法相近。match@1 怎么算(附录 E.2)。每层把每个模型的动作槽位特征降到 50 个主成分并做尺度归一化。然后用正交 Procrustes 映射把一个模型的特征空间旋转到另一个上:只允许旋转和反射,不允许拉伸,所以只有两个空间本来就是“同一形状、换了朝向”时才能对得上。这个旋转只在一半窗口上拟合,在另一半上应用,再交换两半,保证每个窗口都由一个它没参与拟合的映射来放置。对每个放置后的窗口,在另一个模型的全部 N 个窗口中找最近邻,如果最近邻正好是同一个窗口,就算命中;match@1 是命中比例。若两空间无关,命中只能靠运气,概率约为 1/N。0.76 和 0.60 意味着大多数窗口在两个模型里有着几乎相同的“邻居关系”。证据与推测。数据直接显示:在第 10 层之后,人类训练模型与机器人训练模型的特征几何高度一致,原始模型则不然。但要注意,人类训练模型和机器人训练模型共享初始化、架构、跨视频目标和配对流程,而原始模型这些训练都没做过;一部分一致性可能来自“同一个训练目标”本身,而不完全来自人类数据与机器人数据内容相近。更严格的对照(例如一个用视频内目标在人类数据上训练的模型)没有给出。最后一句“人类示范是可扩展的数据来源”是作者的推论:“可扩展”依赖人类数据更便宜,而附录 E.3 的成本比较用的是假设的成本比(中心值 8 倍,并非实测)。
4后训练实验(Post-Training Experiments)
原文
We evaluate whether the representation properties identified in our analyses translate into improved robot control after post-training on robot demonstrations. §4.2 compares WATCH with prior policies under in-context and context-free settings. §4.3 examines how the pre-training objective, reference set, supervised modalities, and amount of human video affect downstream performance.
译文
我们评估:前面分析中发现的表征性质,在用机器人示范做后训练之后,能否转化为更好的机器人控制。§4.2 在上下文内和无上下文两种设定下,把 WATCH 与先前的策略进行比较。§4.3 考察预训练目标、参考集、受监督的模态以及人类视频的数量如何影响下游性能。
解释
第 3 节回答的是“跨视频预训练学到了什么样的特征”(动作检索、线性探针、注意力等离线分析),本节回答“这些特征对控制有没有用”。两种设定的区别在于测试时策略能否看到一条示范:上下文内(in-context)设定下,策略在后训练和评估时都以一条参考示范为条件,相当于“看一遍再做”;无上下文(context-free)设定就是普通的行为克隆,没有任何参考输入。后者用来排除一种解释,即 WATCH 的收益只是因为预训练和下游都有“参考槽位”这一相同的接口。§4.3 列出的四个因素分别对应表 4(目标与参考集)、图 8(模态)和图 9(数据量)。
4.1实验设置(Experimental Setup)
原文
In-context benchmarks. In-context learning from reference demonstrations is an emerging direction in robot learning [24, 25]. We evaluate whether task-paired human pre-training improves in-context control on MimicDroid [10] with the GR1 humanoid. The benchmark ships human demonstrations but no robot-executed trajectories or evaluation scenes: MimicGen [26] scene draws and retargeting turn its three demonstrations per task into our 253 GR1 training episodes, the 100 reference demonstrations per task and the evaluation scenes (§B.5). We follow the MimicDroid L1–L3 split: L1 is the training tasks in the training scenes, L2 changes appearance and objects within the layout, and L3 holds out the layout; each episode is conditioned on a demonstration from its test setting. To probe how the policy uses the reference, we add an infeasible-demonstration setting: since human demonstrations are often much faster than the robot can execute, we replay the reference demonstrations at 2\times speed during both post-training and evaluation, faster than the robot can follow.
译文
上下文内基准。从参考示范中进行上下文学习是机器人学习中一个新兴的方向 [24, 25]。我们在 MimicDroid [10] 上用 GR1 人形机器人评估:按任务配对的人类预训练能否改进上下文内控制。该基准只提供人类示范,不提供机器人执行的轨迹或评估场景:我们用 MimicGen [26] 式的场景采样和重定向,把每个任务的三条示范变成 253 个 GR1 训练回合、每个任务 100 条参考示范以及评估场景(§B.5)。我们沿用 MimicDroid 的 L1–L3 划分:L1 是训练场景中的训练任务,L2 在同一布局内改变外观和物体,L3 留出布局;每个回合都以来自其测试设定的一条示范为条件。为了探查策略如何使用参考,我们增加了一个不可行示范的设定:由于人类示范往往比机器人能执行的速度快得多,我们在后训练和评估中都以 2\times 速度回放参考示范,快到机器人无法跟上。
解释
附录 B.5 交代了数据是怎样“造”出来的。MimicDroid 原始发布只有人类一侧:每个任务 3 条手部追踪的示范(4 个任务共 12 条)和水槽环境里的人类 play 数据。作者在某个(布局, 风格)单元里随机重置场景,把一条人类示范的双手末端轨迹重定向到这个场景,在 GR1 上回放,回放成功才保留。于是 253 个回合(TurnOnFaucet 50、CloseLeftCabinetDoor 50、PnPSinkToCabinet 81、PnPSinkToRightCounterPlate 72)里只有 12 种人类动作,多样性全部来自场景采样。参考池的每任务 100 条示范也是这样造出来的。这意味着表 2 中的数字只能在本文内部比较,与 MimicDroid 原论文不可直接比。三个层级的任务集合并不完全相同:L2 的四个任务是两个开关柜门任务加两个抓放任务(用 CloseRightCabinetDoor 换掉了 L1 的 TurnOnFaucet),L3 则引入了训练中没有的 PnPSinkToMicrowaveTop。所以“L1 \to L3 难度递增”是整体趋势,不是同一组任务逐级加扰动。每个任务评估 30 回合(3 条标准示范各 10 回合),L2 的盘子任务有 4 条示范共 40 回合,每层大约 120(L2 为 130)回合,这决定了后面估算的噪声大小。2 倍速设定的用意是:参考示范的速度比机器人能执行的快一倍,如果策略只是逐帧照抄参考的轨迹和节奏,就会失败;只有从参考中读出“要做什么任务、动作的大致结构”,再按自己的能力执行,才能成功。按附录 B.5,2 倍速版本是参考池的另一份副本,查询一侧不变,匹配描述子去掉速度通道(否则速度会被翻倍而影响检索)。
原文
Context-free benchmarks. To test whether the representations remain useful without a reference and transfer across robots, we evaluate three settings with no reference during post-training or evaluation: context-free MimicDroid on the GR1 humanoid, with L1 and L2 reported as Easy and Hard; TableTop-Sim [27] with bimanual ALOHA; and RoboCasa [28] Kitchen-H50 with a single-arm Franka and 50 human demonstrations per task. For RoboCasa only, Cosmos3 pre-training additionally includes RoboMIND data (§C.2).
译文
无上下文基准。为了检验这些表征在没有参考时是否仍然有用、能否跨机器人迁移,我们评估三个在后训练和评估中都没有参考的设定:GR1 人形机器人上的无上下文 MimicDroid,其中 L1 和 L2 分别记为 Easy 和 Hard;双臂 ALOHA 上的 TableTop-Sim [27];以及单臂 Franka 上的 RoboCasa [28] Kitchen-H50,每个任务有 50 条人类示范。仅在 RoboCasa 上,Cosmos3 的预训练额外加入了 RoboMIND 数据(§C.2)。
解释
这三个基准覆盖了三种本体:GR1 人形(与预训练同一套 57 维笛卡尔动作空间)、双臂 ALOHA(每个模型都用 ALOHA 自己的 20 维动作,见附录 F.1)、单臂 Franka。TableTop-Sim 有 5 个任务,分可见(Easy)与不可见(Hard)两个划分;TableTop-Sim 和 RoboCasa 每个任务评估 50 回合。需要注意 RoboCasa 中的“human demonstrations”指的是人类遥操作机器人采集的示范,也就是机器人数据,不是人类视频;“H50”即每任务 50 条。最后一句是一个重要的例外:附录 C.2 说明,RoboCasa 实验里 Cosmos3 的预训练混入了两路 RoboMIND 机器人数据(Franka 11,480 回合、TienKung 2,785 回合,按样本占 12.5%),其中的 Franka 一路与 RoboCasa 是同一种机械臂。因此表 3 中 Cosmos3 在 RoboCasa 一列的结果不是“只用人类数据”的预训练。无上下文 MimicDroid 只报告 L1/L2,没有 L3。
原文
Backbones and baselines. We use Cosmos Policy [3] on the 2B Cosmos-Predict2.5 [1] backbone, with the post-training objective reduced to future-video and action prediction (§C.2). We also apply WATCH to Cosmos3 Edge-2B [19], a backbone already trained on human and robot action data under a within-video objective. In-context baselines are Vid2Robot [9], HAND [21], MimicDroid [10], \pi_{0.5} [22], and GR00T-N1.7 [23]; the context-free comparison adds MolmoAct2 [29]. All methods we train use the same robot demonstrations as WATCH; \dagger marks numbers reported by prior work under its own evaluation data.
译文
主干与基线。我们使用基于 2B 参数 Cosmos-Predict2.5 [1] 主干的 Cosmos Policy [3],并把后训练目标简化为未来视频预测和动作预测(§C.2)。我们还把 WATCH 应用到 Cosmos3 Edge-2B [19] 上,这个主干已经在视频内目标下用人类和机器人的动作数据训练过。上下文内基线为 Vid2Robot [9]、HAND [21]、MimicDroid [10]、\pi_{0.5} [22] 和 GR00T-N1.7 [23];无上下文比较另加入 MolmoAct2 [29]。我们训练的所有方法都使用与 WATCH 相同的机器人示范;\dagger 标记的是先前工作在其自身评估数据上报告的数字。
解释
两个主干的意义不同。Cosmos Policy 这一路是“纯视频先验”:Cosmos-Predict2.5 只做过视频生成预训练,没有见过动作,WATCH 在它和机器人后训练之间插入一个人类跨视频预训练阶段。附录 C.2 说明这里的 Cosmos Policy 不是原版配方:主干从 Predict2 换成 Predict2.5,去掉了辅助的未来本体感知预测和 rollout 数据增强,所以表中的 “Cosmos Policy” 行是作者简化后的版本。Cosmos3 这一路则已经在视频内目标下见过人类和机器人动作,用来检验跨视频预训练在“已有动作先验”的主干上是否还有增益;在 Cosmos3 上只更新生成专家、时间嵌入、潜变量与动作投影等部分参数。基线方面,Vid2Robot、HAND、MimicDroid 是专门的“以示范为条件”的方法,\pi_{0.5}、GR00T-N1.7、MolmoAct2 是通用 VLA。附录 F.1 补充了两点:\pi_{0.5} 和 MolmoAct2 的动作头有维数上限,在 MimicDroid 上只能用 20 维动作向量,而其他模型都用 57 维表示,这个差异可能对它们不利,也可能因为维数更低而更容易学,方向无法确定;HAND 和 MimicDroid 两行是前人论文里的数字,评估场景、机器人数据都不同,只能作为参考,不能和其他行逐项比较。原文没有交代 \pi_{0.5}、GR00T-N1.7 在上下文内设定中如何接收参考示范。
表 2:MimicDroid 上的上下文内后训练。成功率(%);平均为 L1–L3 的平均。\dagger:先前工作在其自身评估数据上报告的结果。
| 方法 | L1 | L2 | L3 | 平均 |
| 上下文学习(ICL)基线 | ||||
| Vid2Robot [9] | 90.8 | 51.0 | 0.8 | 47.6 |
| HAND^{\dagger} [21] | 29.0 | 21.0 | 1.0 | 17.0 |
| MimicDroid^{\dagger} [10] | 59.0 | 44.0 | 26.0 | 43.0 |
| VLA 基线 | ||||
| \pi_{0.5} [22] | 79.2 | 38.3 | 8.3 | 41.9 |
| GR00T-N1.7 [23] | 78.3 | 59.2 | 10.0 | 49.2 |
| 世界—动作模型 | ||||
| Cosmos Policy [3] | 75.0 | 29.4 | 18.3 | 40.9 |
| + WATCH(本文) | 91.7 | 72.5 | 40.8 | 68.3 |
| Cosmos3 [19] | 69.2 | 79.4 | 30.8 | 59.8 |
| + WATCH(本文) | 91.7 | 86.5 | 55.0 | 77.7 |
原表注:In-context post-training on MimicDroid. Success rate (%); Avg. over L1–L3. \dagger: reported by prior work under its own evaluation data.
表 2 解读
每行是一种策略,L1–L3 三列是各层 4 个任务成功率的平均,“平均”是三层的简单平均。逐行验算:\pi_{0.5} 为 (79.2+38.3+8.3)/3=41.9,GR00T-N1.7 为 147.5/3=49.2,Cosmos Policy 为 122.7/3=40.9,+WATCH 为 205.0/3=68.3,Cosmos3 为 179.4/3=59.8,+WATCH 为 233.2/3=77.7,HAND 和 MimicDroid 分别为 17.0 和 43.0,都对得上。唯一的出入是 Vid2Robot:(90.8+51.0+0.8)/3=47.5,表中为 47.6。附录表 7 给出了它的逐任务成功率(63.3 即 19/30,53.3 即 16/30,87.5 即 35/40,3.3 即 1/30),用未舍入的值算,三层分别为 90.83、51.04、0.83,平均 47.57,舍入正是 47.6。所以这 0.1 的差来自先算平均再舍入,不是错误。两个主干上 WATCH 的增益:Cosmos Policy 为 L1 +16.7、L2 +43.1、L3 +22.5、平均 +27.4,最大增益确实在 L2,其次 L3,L1 最小;Cosmos3 为 L1 +22.5、L2 +7.1、L3 +24.2、平均 +17.9,L3 最大,但 L2 的增益反而最小,所以正文说的“同样的趋势”只在 L3 和平均上成立。Cosmos3 本身 L2(79.4)高于 L1(69.2),这看起来反常,逐任务表可以解释:Cosmos3 在 L2 的两个开关门任务上都是 100,而 L1 的两个抓放任务只有 46.7 和 30.0;L2 用 CloseRightCabinetDoor 替换了 L1 的 TurnOnFaucet,两层的任务构成不同,L2 并不一定比 L1 难。这些差距有多可靠?每层约 120 回合,若把回合视为独立的伯努利试验,成功率 p 的标准误为 \sqrt{p(1-p)/n}:p=0.5 时 \sqrt{0.25/120}\approx4.6 个百分点,p=0.9 时约 2.7。两组独立结果之差的标准误约为单组的 \sqrt2 倍,即在 50% 附近约 6.5 个百分点,相差 13 个百分点左右才达到大约两个标准误。三层平均约基于 370 回合,标准误约 2.5,差值的标准误约 3.6。照此估算,Cosmos Policy 上三层的增益(分别约为 3.6、7.7、3.9 个标准误)和平均增益都稳健;Cosmos3 上 L1 和 L3 的增益稳健,L2 的 +7.1(约 1.5 个标准误)在噪声范围内。还要注意两点使真实不确定性更大:一是每个任务的 30 回合只用 3 条示范(每条 10 回合),回合之间并不独立,例如 L3 的 CloseLeftCabinetDoor 几乎所有模型都恰好是 33.3(10/30),像是“一条示范总成功、另两条总失败”,有效样本量远小于 120;二是每个配置只训练了一次,种子间方差没有计入。基线中,Vid2Robot(90.8 \to 0.8)、\pi_{0.5}(79.2 \to 8.3)、GR00T-N1.7(78.3 \to 10.0)在 L1 上与 Cosmos Policy 相当甚至更高,到 L3 却跌到 10% 以下,说明它们主要记住了训练场景。带 \dagger 的两行评估数据不同,不应拿来和其他行排名。粗体为最佳,下划线为次佳。
4.2与先前方法的比较(Comparison with Prior Methods)
原文
In-context post-training. Table 2 compares WATCH with prior demonstration-conditioned policies [9, 21, 10] and vision-language-action policies [22, 23] under the MimicDroid L1–L3 split. With Cosmos Policy [3], WATCH raises the average success rate from 40.9\% to 68.3\%, with gains at all three levels and the largest under environment shift (L2 29.4\% to 72.5\%, L3 18.3\% to 40.8\%). The same trend holds with Cosmos3 [19], where the average increases from 59.8\% to 77.7\% and L3 from 30.8\% to 55.0\%. Some baselines match or exceed Cosmos Policy on L1 but fall to 10\% or below on L3, the unseen layouts, where WATCH gains substantially.
译文
上下文内后训练。表 2 在 MimicDroid 的 L1–L3 划分下,把 WATCH 与先前以示范为条件的策略 [9, 21, 10] 和视觉—语言—动作策略 [22, 23] 进行比较。在 Cosmos Policy [3] 上,WATCH 把平均成功率从 40.9\% 提高到 68.3\%,三个层级都有增益,其中环境变化下的增益最大(L2 从 29.4\% 到 72.5\%,L3 从 18.3\% 到 40.8\%)。在 Cosmos3 [19] 上同样的趋势也成立:平均从 59.8\% 提高到 77.7\%,L3 从 30.8\% 提高到 55.0\%。一些基线在 L1 上与 Cosmos Policy 相当甚至超过它,但在 L3(未见过的布局)上降到 10\% 或更低,而 WATCH 正是在这里增益显著。
解释
这段的数字都能在表 2 中核对。Cosmos Policy 上的增益为 L1 +16.7、L2 +43.1、L3 +22.5,L2 成功率约为原来的 2.5 倍,L3 约为 2.2 倍,“环境变化下增益最大”成立。Cosmos3 上平均 +17.9、L3 +24.2,但 L2 只有 +7.1,在约 4.6 个百分点的差值标准误下并不显著(见表 2 解读),所以“同样的趋势”准确地说只是“L3 增益大”;Cosmos3 的基线 L2 本来就有 79.4,提升空间小。最后一句指的是 Vid2Robot(L1 90.8,L3 0.8)、\pi_{0.5}(79.2,8.3)和 GR00T-N1.7(78.3,10.0)。它们在训练布局里表现好,到了留出布局几乎失效;WATCH 在两个主干上的 L3 分别为 40.8 和 55.0。为什么跨视频预训练恰好在 L2/L3 帮助最大?作者的解释(§3 的分析)是:从另一条示范预测本条示范的动作和画面,迫使模型关注“手和物体怎样交互”这类跨示范共享的内容,而不是背景、外观这类只在单条示范内成立的线索;L2 改外观、L3 改布局,恰好是在破坏这类表面线索。但也要看到这里的“环境变化”仍在同一个仿真厨房套件之内,而且 L3 只有一种留出布局。
表 3:无上下文后训练。没有参考示范时的成功率(%);平均为每个基准两个层级的平均。
| 方法 | MimicDroid | TableTop-Sim | RoboCasa | ||||
| Easy | Hard | 平均 | Easy | Hard | 平均 | Kitchen-H50 | |
| VLA 基线 | |||||||
| \pi_{0.5} [22] | 78.3 | 29.8 | 54.1 | 70.4 | 34.0 | 52.2 | 54.5 |
| GR00T-N1.7 [23] | 79.2 | 45.8 | 62.5 | 66.8 | 50.8 | 58.8 | 46.4 |
| MolmoAct2 [29] | 76.7 | 28.3 | 52.5 | 66.4 | 39.6 | 53.0 | 54.3 |
| 世界—动作模型 | |||||||
| Cosmos Policy [3] | 71.7 | 26.9 | 49.3 | 69.6 | 49.6 | 59.6 | 56.0 |
| + WATCH(本文) | 90.8 | 47.1 | 69.0 | 76.8 | 54.0 | 65.4 | 63.6 |
| Cosmos3 [19] | 78.3 | 21.0 | 49.7 | 76.4 | 55.2 | 65.8 | 55.0 |
| + WATCH(本文) | 90.8 | 36.0 | 63.4 | 85.6 | 58.4 | 72.0 | 55.8 |
原表注:Context-free post-training. Success rate (%) without a reference demonstration; Avg. over the two levels of each benchmark.
表 3 解读
表分三组列:MimicDroid(Easy 即 L1,Hard 即 L2)、TableTop-Sim(Easy 为可见划分,Hard 为不可见划分)各给两个层级和平均,RoboCasa Kitchen-H50 只有一个总成功率。所有行的平均都能还原,例如 \pi_{0.5} 的 MimicDroid 为 (78.3+29.8)/2=54.05\approx54.1,Cosmos Policy + WATCH 为 (90.8+47.1)/2=68.95\approx69.0,Cosmos3 为 (78.3+21.0)/2=49.65\approx49.7,TableTop-Sim 一侧 Cosmos3 + WATCH 为 (85.6+58.4)/2=72.0。WATCH 相对各自主干的增益:Cosmos Policy 在 MimicDroid 上 Easy +19.1、Hard +20.2、平均 +19.7,TableTop-Sim 上 Easy +7.2、Hard +4.4、平均 +5.8,RoboCasa +7.6;Cosmos3 在 MimicDroid 上 +12.5、+15.0、+13.7,TableTop-Sim 上 +9.2、+3.2、+6.2,RoboCasa 只有 +0.8。用二项分布粗估噪声:MimicDroid 每层约 120 回合,差值标准误在 50% 附近约 6.5 个百分点;TableTop-Sim 每个划分 5 个任务 \times 50 回合 = 250 回合,单个划分的差值标准误约 4.5,两划分平均(500 回合)约 3.1。据此,两个主干在 MimicDroid 上的增益都在 2.7 个标准误以上,可信;TableTop-Sim 的平均增益约为 1.9(Cosmos Policy)和 2.1(Cosmos3)个标准误,处在边缘,Hard 划分上的 +4.4 和 +3.2 都在一个标准误左右,不能单独作为证据。RoboCasa 的任务数正文没有给出,无法精确估算;Cosmos3 的 +0.8 无论如何都在噪声之内。再加上每个配置只训练一次,这些边缘差距应谨慎看待。还有几处值得注意。第一,没有 WATCH 时 VLA 基线并不弱:GR00T-N1.7 在 MimicDroid 上平均 62.5,高于两个世界—动作模型主干(49.3、49.7);WATCH 之后两个主干才反超。第二,Cosmos3 + WATCH 的 MimicDroid Hard 只有 36.0,低于 GR00T-N1.7 的 45.8。附录表 8 显示,无上下文 L2 的两个开关柜门任务上,所有世界—动作模型(含 WATCH 各变体)都是 0,L2 平均因而完全由两个抓放任务决定;GR00T-N1.7 的 45.8 则主要来自它在 CloseLeftCabinetDoor 上的 76.7。其中 CloseRightCabinetDoor 不属于 L1 的训练任务,无上下文时所有模型都是 0,这意味着 Hard 的上限实际上只有约 75%。第三,Cosmos3 + WATCH 在上下文内 L2 的两个开关门任务上都是 100%,在无上下文 L2 上都是 0,说明参考示范在 L2 中提供了关键的任务信息,特别是对训练中没有的任务。粗体为最佳,下划线为次佳。
原文
Context-free post-training. Table 3 evaluates standard behavior-cloning policies without reference demonstrations during either post-training or evaluation. On MimicDroid, WATCH improves Cosmos Policy from 49.3\% to 69.0\% and Cosmos3 from 49.7\% to 63.4\%. The benefit extends to TableTop-Sim (bimanual ALOHA), where both backbones improve, and to RoboCasa (single-arm Franka), where Cosmos Policy gains 7.6 points while Cosmos3, which already saw robot data and here RoboMIND, gains 0.8. Gains with no reference during robot post-training and evaluation show that the benefit of pre-training persists without a test-time reference.
译文
无上下文后训练。表 3 评估的是在后训练和评估中都没有参考示范的标准行为克隆策略。在 MimicDroid 上,WATCH 把 Cosmos Policy 从 49.3\% 提高到 69.0\%,把 Cosmos3 从 49.7\% 提高到 63.4\%。这一收益延伸到 TableTop-Sim(双臂 ALOHA),两个主干都有提升;也延伸到 RoboCasa(单臂 Franka),其中 Cosmos Policy 提高 7.6 个百分点,而已经见过机器人数据、在这里还见过 RoboMIND 的 Cosmos3 提高 0.8。在机器人后训练和评估中都没有参考的情况下仍有增益,说明预训练的好处在测试时没有参考的情况下依然存在。
解释
这段要排除的质疑是:WATCH 预训练时模型总是以参考示范为条件,它在表 2 中的优势会不会只是因为下游也恰好有参考输入?无上下文设定把参考槽位完全去掉(附录 B.5:数据、目标和归一化与上下文内设定相同,只是丢掉参考槽位),增益依然存在,说明预训练改变的是特征本身,而不仅仅是“怎样读参考”这一接口。TableTop-Sim 用 ALOHA 的 20 维动作,与预训练的 57 维人手空间不同,这里的增益更能说明跨本体迁移,不过如表 3 解读所示,其幅度只在两个标准误左右。RoboCasa 上的对比要分开看。Cosmos Policy 从未见过机器人数据,+7.6 是人类跨视频预训练的增益。Cosmos3 一方面本身已经在人类和机器人动作数据上预训练过,另一方面这次 WATCH 预训练里还混入了 12.5% 的 RoboMIND(含 Franka)数据,结果只有 +0.8。原文把它归因于 Cosmos3 已经见过机器人数据,但没有设置“只加 RoboMIND、不做跨视频预训练”的对照,所以无法区分是主干的先验已经饱和,还是这个基准对两种预训练都不敏感。
4.3消融研究(Ablation Studies)
原文
All variants keep the Cosmos Policy [3] backbone, the robot post-training, and the human-video data fixed. Within-video [13, 16] predicts the future actions and frames of each demonstration from its own observation, without a reference. Co-training [15, 7] keeps that formulation and adds robot action data from the robot subset of EgoVerse and Humanoid Everyday [30]. Finally, same-source top-1 conditions every query on its single best-ranked reference from its own collection source, whereas WATCH (Ours) samples from the full reference set of §2.3.
译文
所有变体都固定 Cosmos Policy [3] 主干、机器人后训练和人类视频数据。视频内(Within-video)[13, 16] 从每条示范自身的观测预测它未来的动作和画面,不使用参考。联合训练(Co-training)[15, 7] 保持这一形式,并加入来自 EgoVerse 机器人子集和 Humanoid Everyday [30] 的机器人动作数据。最后,同源 top-1(same-source top-1)让每个查询只以来自其自身采集来源、排名第一的那一个参考为条件,而 WATCH(本文)从 §2.3 的完整参考集中采样。
解释
这三个变体各自隔离一个因素。视频内是“只去掉跨视频”的版本:附录 C.3 说明它保留 WATCH 的架构、槽位角色、时间轴和目标,只把参考视频与参考动作槽位清空,并把参考视频块缩短为两个槽位,序列从 50 个 latent 缩短到 29 个。联合训练在视频内的基础上增加机器人数据(EgoVerse 机器人子集 33,176 个窗口、Humanoid Everyday 92,136 个,查询总数 1,170,319),检验“多一种本体的数据”能否替代跨视频配对;因为参考被清空,加入新来源不需要配对。同源 top-1 保留跨视频预测,但把参考集缩成一个同源的最近邻,检验参考的多样性(尤其是跨来源参考)是否重要;WATCH 的参考集平均每个查询 10.5 个参考,其中跨源 6.4 个。需要记住两个不对等之处。第一,所有变体都训练 8K 步,但视频内和联合训练每步的序列更短(29 对 50 个 latent),计算量小于 WATCH;这里比较的是“相同步数”,不是“相同计算量”。第二,每个配置只训练一次。
表 4:预训练消融。在固定的 Cosmos Policy 主干上的成功率(%);各行改变预训练目标、数据混合和参考集(定义见正文):参考以录制速度和 2\times 速度给出的上下文内 MimicDroid,以及无上下文的 MimicDroid、TableTop-Sim 和 RoboCasa Kitchen-H50。None 是直接后训练的主干 [3]。
| 预训练 | 上下文内 | 无上下文 | |||||||||||||
| MimicDroid | MimicDroid, 2\times | MimicDroid | TableTop-Sim | Robo- Casa | |||||||||||
| L1 | L2 | L3 | 平均 | L1 | L2 | L3 | 平均 | Easy | Hard | 平均 | Easy | Hard | 平均 | ||
| None [3] | 75.0 | 29.4 | 18.3 | 40.9 | 73.3 | 18.8 | 0.0 | 30.7 | 71.7 | 26.9 | 49.3 | 69.6 | 49.6 | 59.6 | 56.0 |
| Within-video [13, 16] | 85.8 | 44.4 | 23.3 | 51.2 | 75.0 | 7.5 | 8.3 | 30.3 | 88.3 | 40.8 | 64.6 | 71.6 | 51.6 | 61.6 | 58.3 |
| Co-training [15, 7] | 87.5 | 58.3 | 34.2 | 60.0 | 88.3 | 25.2 | 5.0 | 39.5 | 90.0 | 42.3 | 66.1 | 69.2 | 52.8 | 61.0 | 61.7 |
| Same-source top-1 | 84.2 | 58.3 | 33.3 | 58.6 | 85.8 | 26.7 | 23.3 | 45.3 | 90.0 | 36.7 | 63.3 | 69.6 | 51.2 | 60.4 | 56.8 |
| WATCH(本文) | 91.7 | 72.5 | 40.8 | 68.3 | 84.2 | 36.5 | 41.7 | 54.1 | 90.8 | 47.1 | 69.0 | 76.8 | 54.0 | 65.4 | 63.6 |
原表注:Pre-training ablations. Success rate (%) on a fixed Cosmos Policy backbone; rows vary the pre-training objective, data mixture, and reference set (defined in the text): in-context MimicDroid with references at recorded and at 2\times speed, and context-free MimicDroid, TableTop-Sim, and RoboCasa Kitchen-H50. None is the backbone post-trained directly [3].
表 4 解读
表的左半是上下文内的两组(正常速度、2 倍速参考),右半是无上下文的三个基准;None 行和 WATCH 行分别与表 2、表 3 中的 Cosmos Policy 及其 + WATCH 行一致。平均值都能还原:Within-video 正常速度为 153.5/3=51.2,2 倍速为 (75.0+7.5+8.3)/3=30.3;Co-training 为 180.0/3=60.0 和 118.5/3=39.5;Same-source top-1 为 175.8/3=58.6 和 135.8/3=45.3;WATCH 的 2 倍速为 (84.2+36.5+41.7)/3=54.1;None 的 2 倍速为 92.1/3=30.7。无上下文一侧,Co-training 的 (90.0+42.3)/2=66.15 记为 66.1、Same-source 的 (90.0+36.7)/2=63.35 记为 63.3,是用未舍入的逐任务值计算的结果(如 36.7 实为 36.67),并非错误。目标的影响(正常速度)。相对 None,视频内 +10.3,联合训练 +19.1,同源 top-1 +17.7,WATCH +27.4。WATCH 相对视频内的差值为 L1 +5.9、L2 +28.1、L3 +17.5,相对联合训练为 L1 +4.2、L2 +14.2、L3 +6.6、平均 +8.3,差距集中在 L2/L3。按每层约 120 回合的二项标准误,WATCH 对联合训练的 L2 差距和平均差距约为 2.4 个标准误,L1 和 L3 的差距约 1.1 个标准误,在噪声范围内。2 倍速参考。从正常速度到 2 倍速,各行平均下降:None -10.2,视频内 -20.9,联合训练 -20.5,同源 top-1 -13.3,WATCH -14.2。换成“相对 None 的增益”看:视频内从 +10.3 变为 -0.4,增益全部丢失;联合训练从 +19.1 变为 +8.8,保留约 46%;同源 top-1 从 +17.7 变为 +14.6,保留约 82%;WATCH 从 +27.4 变为 +23.4,保留约 85%(23.4/27.4)。WATCH 与 None 在 2 倍速下的平均差 23.4 约为 6.6 个标准误,非常稳健。两种跨视频预训练的保留率都高,说明“从参考中预测”这一训练方式让模型更少依赖参考的逐帧时序。也有细节不完全符合这个叙事:2 倍速 L1 上 WATCH(84.2)低于联合训练(88.3)和同源 top-1(85.8),WATCH 的 2 倍速 L3(41.7)还略高于正常速度(40.8),这些都在噪声范围内;视频内的 2 倍速 L2 只有 7.5,比 None 的 18.8 还低。参考集的影响。同源 top-1 在所有列上都不如 WATCH:正常速度平均 -9.7,2 倍速 -8.8,无上下文 MimicDroid -5.7、TableTop-Sim -5.0、RoboCasa -6.8。在无上下文的三列上,它甚至不比视频内好(63.3 对 64.6、60.4 对 61.6、56.8 对 58.3)。这说明跨视频预测本身不够,参考集需要足够多样(多个参考、包含跨来源参考)。正文的消融段落没有直接讨论这一行,本解读据表补充。无上下文。WATCH 在三个基准上都是最高,但领先次佳变体的幅度都不大:MimicDroid 平均 +2.9(对联合训练),TableTop-Sim +3.8(对视频内),RoboCasa +1.9(对联合训练)。按二项分布估算,前两者分别只有约 0.7 和 1.25 个标准误;RoboCasa 的任务数(从而回合数)正文没有给出,但 1.9 个百分点很可能也在噪声之内。三个方向一致是支持性的证据,但单看每一列都不能排除噪声。
原文
Ablation on pre-training objective. Table 4 shows that within-video pre-training improves over no pre-training and co-training improves further on MimicDroid, but both leave the representation tied to cues within individual demonstrations. By predicting across demonstrations, WATCH encourages features that capture shared interactions, consistent with its larger gains on L2 and L3 and its advantage on all three context-free benchmarks. Under 2\times-speed references, within-video pre-training loses its whole gain (30.3\% against 30.7\% with none) whereas WATCH keeps most of its own, so the cross-video prior still supports learning from references the robot cannot follow. Together, these results suggest that cross-demonstration prediction, not data diversity alone, turns diverse human experience into more embodiment-invariant representations.
译文
预训练目标的消融。表 4 显示,视频内预训练比不预训练有所提升,联合训练在 MimicDroid 上提升更多,但两者都让表征依附于单条示范内部的线索。通过跨示范预测,WATCH 促使特征捕捉跨示范共享的交互,这与它在 L2 和 L3 上更大的增益、以及在全部三个无上下文基准上的优势相一致。在 2\times 速度的参考下,视频内预训练失去了全部增益(30.3\%,不预训练为 30.7\%),而 WATCH 保留了大部分增益,因此跨视频先验仍然支持从机器人无法跟随的参考中学习。综合来看,这些结果表明,是跨示范预测,而不仅仅是数据多样性,把多样的人类经验转化为更加本体不变的表征。
解释
这段的论证链是:视频内 < 联合训练 < WATCH。联合训练比视频内多了机器人数据(数据更多样),WATCH 比视频内多了跨视频配对(数据不变、目标改变),后者的增益更大,所以作者说起作用的是“跨示范预测”而不只是“数据多样性”。数字见表 4 解读:正常速度平均 51.2 \to 60.0 \to 68.3;2 倍速下视频内 30.3 对 None 30.7,WATCH 54.1 对 30.7,保留了约 85% 的增益(23.4 对 27.4)。有三点限定。其一,“在全部三个无上下文基准上的优势”方向一致,但对最强消融变体的领先,在能估算的两个基准上都不到 1.5 个标准误。其二,视频内和联合训练每步计算量小于 WATCH(29 对 50 个 latent),二者在相同步数下比较,WATCH 的优势中可能有一部分来自更多的计算;不过 2 倍速下视频内“完全没有增益”这种质的差别,很难仅用计算量解释。其三,“依附于单条示范内部的线索”“更本体不变”是对机制的解读,直接证据在 §3 的表征分析中,本表只给出与之相容的下游结果。
原文
Ablation on pre-training modalities. We evaluate the modality variants in §3, fixing post-training to joint action–video prediction (Fig. 8 and §F.4). Action-only pre-training outperforms video-only on in-context MimicDroid, particularly on L2 and L3, while the reverse holds on context-free TableTop-Sim. MimicDroid preserves the pre-training action space and reference conditioning, whereas TableTop-Sim uses a different action space and no reference input. Joint pre-training achieves the highest average success in both settings, with a small advantage over video-only on TableTop-Sim (65.4 versus 64.6). This pattern suggests that action supervision provides explicit guidance on the motion and temporal progression of interactions, yielding a prior that is readily reused when the action representation and conditioning are preserved. Video prediction complements this signal by supervising the visual consequences of motion, potentially supporting transfer across larger differences from the pre-training setup.
译文
预训练模态的消融。我们评估 §3 中的各模态变体,后训练固定为动作—视频联合预测(图 8 和 §F.4)。在上下文内 MimicDroid 上,只监督动作的预训练优于只监督视频的预训练,在 L2 和 L3 上尤其如此;而在无上下文的 TableTop-Sim 上情况相反。MimicDroid 保留了预训练的动作空间和参考条件,而 TableTop-Sim 使用不同的动作空间,也没有参考输入。联合预训练在两种设定下都取得最高的平均成功率,在 TableTop-Sim 上比只监督视频略有优势(65.4 对 64.6)。这一规律表明,动作监督为交互的运动和时间进程提供了明确的指导,产生的先验在动作表示和条件方式保持不变时容易被复用。视频预测则通过监督运动带来的视觉后果来补充这一信号,可能有助于在与预训练设置差别更大时进行迁移。
解释
这里的“模态”指跨视频预训练时目标槽位里监督什么:什么都不预训练(None)、只预测查询的未来视频、只预测查询的动作、两者都预测(即 WATCH 的默认设置)。后训练统一用“视频 + 动作”,所以差别只来自预训练。作者对“为什么两个基准上的排序相反”的解释是:MimicDroid 下游沿用了预训练的 57 维人手动作空间,而且同样以参考示范为条件,动作先验可以直接复用;TableTop-Sim 换成 ALOHA 的 20 维动作,也没有参考,动作先验难以直接接上,而视频先验(画面会怎样变化)与动作空间无关,更容易迁移。这个解释合理,但两个基准同时在“动作空间”和“有无参考”两方面不同,还换了本体和任务,本实验无法区分是哪一个因素造成的。附录 F.4 进一步把后训练目标也改成只有动作:此时 TableTop-Sim 整体崩溃,而且只用动作预训练在两种后训练目标下都低于不预训练(11 和 55,对比 19 和 60),视频 + 动作预训练在两种后训练目标、两个基准上都是最佳。

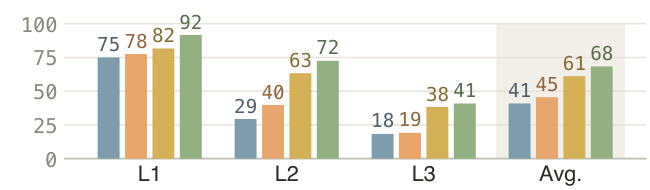
(a) MimicDroid,上下文内
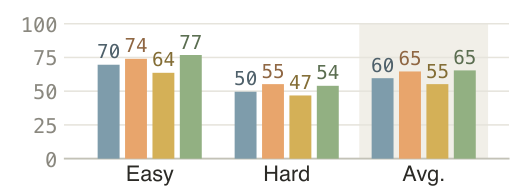
(b) TableTop-Sim,无上下文
图 8:预训练监督。后训练固定为视频 + 动作,预训练分别不监督任何内容(None)、只监督视频、只监督动作或两者都监督时的成功率(%):(a) 上下文内 MimicDroid,每层为 4 个任务的平均,Avg. 为 L1–L3 的平均;(b) 无上下文 TableTop-Sim。
原图注:Pre-training supervision. Success rate (%) with post-training fixed at video + action and pre-training supervising nothing (None), the video only, the actions only, or both, on (a) MimicDroid in-context, averaged over the four tasks per level with Avg. over L1–L3, and (b) TableTop-Sim context-free.
图 8 解读
图例四种颜色依次是 None(蓝灰)、只监督视频(橙)、只监督动作(黄)、视频 + 动作(绿,本文);每组柱对应一个层级,灰底的 Avg. 组是平均。柱顶标注的是四舍五入后的整数,下面引用的一位小数是从矢量图的柱高换算出来的,与表 4 中 None 和 WATCH 两行完全一致,可作为换算正确的检验。(a) 上下文内 MimicDroid 的 L1/L2/L3/平均:None 为 75.0/29.4/18.3/40.9;只监督视频为 77.5/39.8/19.2/45.5;只监督动作为 81.7/63.3/38.3/61.1;视频 + 动作为 91.7/72.5/40.8/68.3。相对 None 的平均增益分别为 +4.6、+20.2、+27.4。只监督动作比只监督视频在 L2 高 23.5、L3 高 19.1,L1 只高 4.2,与正文“尤其在 L2、L3”一致。联合比只监督动作再高 7.2(平均),主要来自 L1(+10.0)和 L2(+9.2),L3 只差 2.5。(b) 无上下文 TableTop-Sim 的 Easy/Hard/平均:None 为 69.6/49.6/59.6;只监督视频为 74.0/55.2/64.6;只监督动作为 63.6/46.8/55.2;视频 + 动作为 76.8/54.0/65.4。这里只监督动作的预训练比不预训练还低 4.4,是负迁移;正文只说“视频优于动作”,没有点明这一点。联合与只监督视频的平均差只有 0.8(在 Hard 上只监督视频的 55.2 还高于联合的 54.0),而两划分平均的差值标准误约 3.1 个百分点,所以两者在 TableTop-Sim 上实际上无法区分,“联合在两种设定下都最高”在 (b) 中只是名义上成立。(a) 中联合对只监督动作的 +7.2 约为 2 个标准误,较为可信。
原文
Scaling the pre-training data. We vary the amount of training data and its matched references while keeping the backbone and post-training setup fixed. The number of pre-training steps increases with the amount of data, so larger datasets also use more compute (§F.3). In in-context and context-free benchmarks, performance improves with more data (Fig. 9). With 25\% of the cross-video data, WATCH matches within-video pre-training using all the data on the unseen in-context levels (L2 and L3). It surpasses this baseline at 50\% on L3 and 75\% on L2. Under context-free post-training, it exceeds the baseline on L2 at around 50\%. These trends indicate that WATCH benefits from more paired human videos. Comparison with robot-pair pre-training further suggests that collecting human videos can be a more cost-effective way to improve performance than collecting robot videos (§E.3).
译文
扩展预训练数据。我们改变训练数据量及其匹配的参考,同时保持主干和后训练设置不变。预训练步数随数据量增加,因此更大的数据集也使用更多的计算(§F.3)。在上下文内和无上下文基准上,性能都随数据增加而提升(图 9)。只用 25\% 的跨视频数据时,WATCH 在未见过的上下文内层级(L2 和 L3)上就与使用全部数据的视频内预训练持平;在 L3 上用 50\%、在 L2 上用 75\% 时超过这一基线。在无上下文后训练下,它在 L2 上大约在 50\% 时超过基线。这些趋势表明 WATCH 能从更多配对的人类视频中获益。与机器人配对预训练的比较进一步表明,采集人类视频可能是比采集机器人视频更具成本效益的提升性能的方式(§E.3)。
解释
附录 F.3 给出了实验细节。数据量按查询所在的回合抽取 25%、50%、75%(在每个采集来源内分别抽取并向上取整),即 13,315 个带查询窗口的回合中的 3,330、6,659、9,988 个,对应 25.6%、49.7%、74.4% 的查询窗口。训练步数相应为 2K、4K、6K、8K(全局 batch 64),使每一档都看过同样约 0.49 个 epoch:8\text{K}\times64=512\text{K} 个样本,约为 104.5 万个查询窗口的 0.49;25% 档为 128\text{K}/(0.256\times1.045\text{M})\approx0.48。所以这条曲线横轴每往右一格,数据和计算同时翻倍,无法分辨收益来自更多不同的数据还是更多的训练步数;而且所有档都不到一个 epoch,每个窗口平均最多被看到一次。和虚线(视频内、100% 数据、8K 步)的比较反而对 WATCH 有利:25% 档只训练 2K 步,即便每步的序列长度是 50 对 29 个 latent,按 latent 数线性估算的计算量也只有基线的约 43%(2\text{K}\times50 对 8\text{K}\times29),按注意力的二次复杂度估算也约为基线的四分之三(2\text{K}\times50^2 对 8\text{K}\times29^2)。所以“25% 数据即持平”是在数据和计算都更少的条件下取得的,只是持平本身幅度很小(见图 9 解读)。最后一句引用的附录 E.3 中,机器人数据与人类数据的采集成本比是假设的(中心值 8 倍,敏感区间 4–16 倍,参照 RoboVQA),不是实测。在这一假设下,上下文内 L2 上人类数据从 25% 到 100% 使成功率从 45.0% 升到 72.5%,而最大的机器人配对设置约花费两倍于全部人类语料的估算预算,只达到 49.0%。

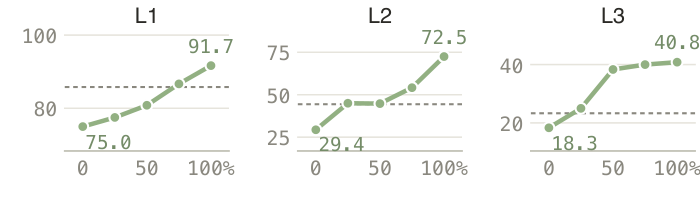
(a) 上下文内
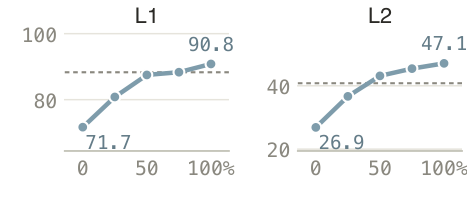
(b) 无上下文
图 9:扩展预训练数据。在固定的 Cosmos Policy 主干上,MimicDroid 成功率(%)随预训练所用配对人类视频比例的变化,从不预训练(0)到全部 EgoVerse 配对(100\%)。(a) 上下文内评估。(b) 无上下文评估。虚线:在 100\% EgoVerse 训练数据上做视频内预训练。
原图注:Scaling the pre-training data. MimicDroid success rate (%) against the portion of the paired human video used for pre-training on a fixed Cosmos Policy backbone, from no pre-training (0) to all EgoVerse pairs (100\%). (a) In-context evaluation. (b) Context-free evaluation. Dashed: within-video pre-training on the 100\% EgoVerse training data.
图 9 解读
每个小图的横轴是所用配对数据的比例,数据点在 0、25%、50%、75%、100%;纵轴是成功率,各小图的纵轴范围不同。实线是跨视频预训练(WATCH),虚线是 100% 数据上的视频内预训练。图中只标注了两端的数值,中间三个点是从矢量图的坐标换算出来的(端点和虚线都与表 4 吻合,可作为检验)。(b) 的两个小图标为 L1、L2,即表 3 中的 Easy、Hard。(a) 上下文内,依次为 0/25/50/75/100%:L1 为 75.0/77.5/80.8/86.7/91.7(虚线 85.8);L2 为 29.4/45.0/44.8/54.2/72.5(虚线 44.4);L3 为 18.3/25.0/38.3/40.0/40.8(虚线 23.3)。(b) 无上下文:L1 为 71.7/80.8/87.5/88.3/90.8(虚线 88.3);L2 为 26.9/36.7/43.1/45.4/47.1(虚线 40.8)。据此核对正文:25% 档在 L2、L3 上与虚线“持平”(45.0 对 44.4,25.0 对 23.3),差值分别只有 0.6 和 1.7 个百分点,远小于约 6 个百分点的差值标准误,说“持平”是恰当的。L3 在 50% 时超过虚线(38.3 对 23.3,高 15.0,较可信);L2 在 50% 时仍是 44.8,与虚线基本相同,到 75% 才明显超过(54.2 对 44.4,约 1.6 个标准误),与正文一致。L1 要到 75% 才越过虚线(86.7 对 85.8)。无上下文 L2 在 50% 时 43.1 对 40.8,只高 2.3,同样在噪声内;无上下文 L1 直到 100% 才高于虚线。曲线的形状并不都平滑:上下文内 L2 在 25% 到 50% 之间停滞,最大一跳出现在最后一档(54.2 \to 72.5);L3 在 50% 之后基本饱和(38.3、40.0、40.8);无上下文 L1 在 50% 后也接近饱和。每个点都是单次训练,相邻点之间的差多在噪声范围内,可靠的结论是“从 0 到 100% 整体上升”(五条曲线的总增幅为 16.7 到 43.1 个百分点),而不是某一段的斜率或是否饱和。
5相关工作(Related Work)
原文
Pre-training for robot policies. Pre-training on large-scale, cross-embodiment robot datasets enables generalist policies to acquire diverse skills and transfer across embodiments [31, 23, 22], but scaling this experience remains constrained by robot data collection. Human videos offer additional experience through inferred latent actions [8, 32] or explicit motion supervision [15, 33]. Recent approaches co-train on human and robot data to ground this experience in executable actions [34, 35]. Video-based models also incorporate action learning before target-robot adaptation: Cosmos3 introduces dynamics and policy mid-training [19], while ZimaBlue aligns video and action on heterogeneous robot trajectories after robot and human video pre-training [36]. These co-training and alignment stages require robot data before target-domain adaptation. More recent efforts explore the capabilities of large-scale human demonstrations and physical interaction data, including Dyna-2, GEN-1.5, and Skild S1 [37, 24, 25]. They study human-video pre-training for world-action models and further report that their pretrained policies can adapt to new tasks from demonstrations provided in context, highlighting the potential of pre-training to support in-context robot learning. WATCH instead uses task-matched human demonstrations alone during its proposed pre-training stage, followed by post-training on a small amount of target-domain data.
译文
机器人策略的预训练。在大规模、跨本体的机器人数据集上预训练,使通用策略能够习得多样的技能并在本体之间迁移 [31, 23, 22],但扩展这类经验仍受限于机器人数据的采集。人类视频通过推断出的潜在动作 [8, 32] 或显式的运动监督 [15, 33] 提供了额外的经验。近期的方法在人类和机器人数据上联合训练,把这些经验落实到可执行的动作上 [34, 35]。基于视频的模型也在适配目标机器人之前加入动作学习:Cosmos3 引入了动力学与策略的中期训练(mid-training)[19],ZimaBlue 则在机器人与人类视频预训练之后,在异构的机器人轨迹上对齐视频和动作 [36]。这些联合训练和对齐阶段都要求在目标域适配之前就使用机器人数据。更近期的工作探索了大规模人类示范和物理交互数据的能力,包括 Dyna-2、GEN-1.5 和 Skild S1 [37, 24, 25]。它们研究面向世界—动作模型的人类视频预训练,并进一步报告其预训练策略能够从上下文中提供的示范适应新任务,凸显了预训练支持上下文内机器人学习的潜力。WATCH 则不同:在其提出的预训练阶段只使用按任务配对的人类示范,随后在少量目标域数据上进行后训练。
解释
这一段把相关工作按“预训练阶段用不用机器人数据”来排列。第一类是 OpenVLA [31]、GR00T [23]、\pi_{0.5} [22] 这样在大规模机器人数据上训练的通用策略,瓶颈是机器人数据贵。第二类利用人类视频:LAPA [8] 和 Garrido 等 [32] 从视频中推断潜在动作(不需要动作标签,用相邻帧的变化学一个离散或连续的“伪动作”);EgoVerse [15]、EgoMimic [33] 用手部追踪得到的显式运动做监督。第三类是人类 + 机器人联合训练,如 EgoBridge [34] 和 Kareer 等 [35],本文表 4 的 Co-training 变体代表这一路。第四类是视频世界模型在适配前先学动作,Cosmos3 [19](本文的第二个主干)和 ZimaBlue [36]。作者强调这些做法都在适配目标域之前用到了机器人数据,而 WATCH 的预训练阶段只用人类数据(RoboCasa 上 Cosmos3 混入 RoboMIND 是一个例外,见 §4.1)。Dyna-2 [37]、GEN-1.5 [24]、Skild S1 [25] 是 2026 年的工业界发布(引用的是博客或技术报告),同样主打人类视频预训练和上下文内学习,与本文最接近;作者把区别归结为“只用按任务配对的人类示范”,但没有与这些系统做实验比较。
原文
Demonstration-conditioned robot learning. One- and few-shot imitation learning enables task adaptation from a small number of robot demonstrations [38] or human videos [39, 9, 40, 10, 41, 42, 12]. Most closely related, Zero-WAM learns from automatically constructed human-to-robot pairs to execute unseen tasks conditioned on human video prompts [11]. These approaches establish demonstrations as an effective interface for task adaptation; WATCH explores their role in representation learning through human-to-human pre-training. The learned representations support both in-context control and reference-free behavior cloning after robot post-training. This perspective draws on reference-conditioned learning in language modeling, image synthesis, and time-series forecasting [43, 44, 45], and examines its implications for transferable representations in robot foundation models.
译文
以示范为条件的机器人学习。单样本和少样本模仿学习使策略能够从少量机器人示范 [38] 或人类视频 [39, 9, 40, 10, 41, 42, 12] 适应新任务。最相关的是 Zero-WAM,它从自动构建的人—机器人配对中学习,以人类视频提示为条件执行未见过的任务 [11]。这些方法确立了示范作为任务适配接口的有效性;WATCH 则通过人—人预训练,探索示范在表征学习中的作用。学到的表征在机器人后训练之后,既支持上下文内控制,也支持无参考的行为克隆。这一视角借鉴了语言建模、图像合成和时间序列预测中以参考为条件的学习 [43, 44, 45],并考察它对机器人基础模型中可迁移表征的意义。
解释
这一段的要点是区分“示范作为测试时的接口”和“示范作为预训练的信号”。前者包括 Fu 等的 next-token 上下文模仿 [38],以及从人类视频模仿的 UniSkill [39]、Vid2Robot [9]、Human2Robot [40]、MimicDroid [10]、ScrewMimic [41]、R+X [42] 和同一作者团队的检索式方法 [12],它们都是在测试时给出一条示范让机器人照做;表 2 中的 Vid2Robot 和 MimicDroid 就属于此类。Zero-WAM [11] 与本文最接近,也是世界—动作模型、也以人类视频为提示,但它的训练配对是“人—机器人”,需要自动构造跨本体的对应关系;WATCH 只配对“人—人”,因此不需要机器人数据就能构造训练对。作者把 WATCH 定位为后者:配对示范的主要作用是在预训练中塑造表征,所以即使下游不提供参考(表 3 的无上下文设定)也有收益。最后一句点出思想来源:检索增强的语言模型 RETRO [43]、检索增强的图像扩散模型 [44] 和时间序列扩散模型 [45],都是“生成时把检索到的相似样本作为条件”。WATCH 把这一做法用在世界—动作模型的预训练上,参考集相当于按任务分类和 DTW 距离检索出的近邻(§2.3)。
6结论(Conclusion)
原文
We presented WATCH, a cross-video pre-training stage that turns task-paired human demonstrations into a prior over motion and interaction for world-action models, without matched human–robot data. Because the model must predict one demonstration from another, it is trained toward how a task is executed rather than how a demonstration looks: the learned features align the same motion across people, rigs, and robots, attend to the hand and the object, and place robot frames where a model trained on robot data places them. This prior carries over to control: across two backbones and three benchmarks it improves both in-context and context-free post-training, most where the scene departs from the demonstration, and it grows with paired human video, which is far cheaper to collect than robot data; extending the pairing beyond one human dataset to less structured sources is future work.
译文
我们提出了 WATCH,一个跨视频预训练阶段:它把按任务配对的人类示范转化为世界—动作模型关于运动与交互的先验,而不需要匹配的人—机器人数据。由于模型必须从一条示范预测另一条示范,它被训练去关注任务是怎样执行的,而不是示范看起来怎样:学到的特征把不同的人、不同的采集设备和不同机器人上的相同动作对齐,关注手和物体,并把机器人帧放在用机器人数据训练的模型所放的位置。这一先验能迁移到控制上:在两个主干和三个基准上,它同时改进了上下文内和无上下文的后训练,在场景偏离示范的地方改进最多;而且它随配对人类视频的增加而增长,而人类视频的采集成本远低于机器人数据。把配对从单一人类数据集扩展到结构更松散的数据来源,留作未来的工作。
解释
结论把全文压缩成三层。方法层:WATCH 是插在视频预训练和机器人后训练之间的一个阶段,训练对全部是“人—人”配对。分析层对应 §3:“把相同动作跨人、跨设备、跨机器人对齐”对应动作检索和 match@1 的结果,“关注手和物体”对应注意力可视化(图 6),“把机器人帧放在机器人数据训练的模型所放的位置”对应图 7 中人类数据训练的 WATCH 与 RoboMIND 机器人数据训练的模型之间的特征对应。控制层对应本节:表 2、表 3 的两个主干、三个基准(MimicDroid、TableTop-Sim、RoboCasa),表 4 的消融和图 9 的数据扩展。有几处措辞比实验证据更强,读者可以对照前面的解读来把握。“在两个主干和三个基准上都有改进”中,Cosmos3 在 RoboCasa 上只有 +0.8,TableTop-Sim 的增益约两个标准误,Hard 划分上的增益在噪声范围内;“场景偏离示范处改进最多”在 Cosmos Policy 上成立,在 Cosmos3 的 L2 上不成立(+7.1,为三层中最小);“随配对人类视频增长”的曲线中数据和计算同时增加,且每个点只有一次训练;“远比机器人数据便宜”所依据的成本比(8 倍,敏感区间 4–16 倍)是附录 E.3 的假设值,不是实测。另外,所有下游评估都在仿真中进行,没有真机实验,MimicDroid 的机器人数据和评估场景也是作者自建的。最后一句提到的局限(只用了 EgoVerse 这一个结构化、带任务标注的人类数据集,配对依赖任务分类)与附录 A 的局限性讨论一致:配对需要任务标签和手部追踪,扩展到无标注的网络视频是尚未解决的问题。
附录概览(Appendix Overview)
解释
本部分的处理方式。按照本工作区的翻译范围约定,正文到结论为止逐段翻译和解释;附录不再逐段对照,而是用中文段落概述 A–G 各部分讲了什么,并挑选八张有代表性的附录图表(表 5、图 10、表 6、图 19、图 21、表 7、图 22、图 24)贴出、附中文图注与原注并加以解读。图、表、公式编号沿用原文(原文附录没有重置计数器:表 5–9、图 10–26、式 (2)),其余图表只在文字中概述。附录原文请见 arXiv 原文第 14–38 页。
A 局限性(Limitations)
共享的笛卡尔动作空间。人和机器人的动作都写在同一个笛卡尔任务空间里(末端位姿 + 指尖位置,见 B.1),坐标系固定在每个回合开头。作者指出方法有三处依赖这一选择:配对距离(B.2)比较不同示范的手腕轨迹和手部项,只有当人手腕和机器人手腕用同一组量描述时才有意义;参考槽位把模型条件在参考示范的这种动作上,所以学到的“动作先验”本质上是末端运动的先验;后训练沿用同一动作表示,人类数据上训练的动作头才能直接热启动到机器人上。如果目标是关节空间动作,这三处会同时失效:人类示范没有与机器人关节对应的量,配对和动作先验都无法迁移,只能通过一个由底层控制器跟踪的笛卡尔中间目标,或者学一个关节运动与末端运动之间的映射来重新表达先验。本文的三个后训练目标(包括 TableTop-Sim 上 20 维的双臂 ALOHA 空间)都是笛卡尔的,所以方法覆盖了常见的末端控制器部署方式,但对关节空间策略尚未验证。规范坐标系还带来第二个假设:它每回合只锚定一次,因此移动底盘或移动相机需要重新锚定,或把运动表达为相对当前视角的量。配对依赖任务分类和手部追踪。候选先按任务类别筛选,再用由手部表示构造的描述子排序,所以配对需要任务标签和手部位姿;没有标签或没有手部姿态的视频,要先有免标签的筛选方式和位姿估计器才能使用。任务类别也决定了配对的粒度:一个类别若混有不同的动作,就会放进“任务一致但动作不一致”的配对,只能靠排序来区分;排序显著好于同类随机配对(表 5),但并不完美。此外,排序比较的是运动的形状而不是幅度(见式 (2) 的窗口内标准化),所以参考告诉模型“做什么”,却不告诉它“移动多远”,幅度只能从查询自身的画面和状态中得出。尚未饱和的扩展。预训练只用了一个人类数据集中的配对窗口,而第 4.3 节的扩展曲线还没有饱和:四分之一的语料就已在未见层级上追平用全部语料做视频内预训练的效果,并且在全量时各层级仍在上升。因此更多来源的配对人类视频是第一个可以加大的杠杆,配对方法本身对可跨越的来源数量没有限制。机器人数据是第二个杠杆:跨视频预测对机器人配对同样适用(图 7),所以已有的机器人示范应当是在先验之上“叠加”而不是“替代”。至于机器人数据通过同一个跨视频目标进入,是否比像联合训练那样与之并列进入更有效,作者留作未来工作。B 数据细节(Dataset Details)
B.1 动作与状态表示。57 维向量的布局是:头部位姿 9 维(下标 0:9)、左末端位姿 9 维(9:18)、左手 15 维(18:33)、右末端位姿 9 维(33:42)、右手 15 维(42:57)。一个位姿项写成 [\,p,\;R_{:,1},\;R_{:,2}\,],即 3 维平移加旋转矩阵的前两列(所谓 6D 旋转表示,两列正交向量可以经 Gram–Schmidt 恢复完整旋转,且没有欧拉角的奇异和跳变);一个手部项是在手腕坐标系下、以米为单位的五个指尖位置(5\times 3=15),这样描述抓握不需要绑定某个手部模型。对平行夹爪,用归一化的夹爪指令在“完全张开”和“完全闭合”两个指尖模板之间插值,合成同样的 15 维项,于是夹爪和人手占据同一组坐标。坐标系方面,人类示范的规范坐标系放在回合第一帧的腰部,朝向取开头若干帧头部朝向的平均,竖轴与重力对齐,并在整个回合中固定不动;作者解释说,如果改用随头部移动的坐标系,佩戴者一转头,静止的物体就会“看起来在动”。机器人示范的位姿项相对底座表达,头部项为常数(相机不随手臂运动)。每个来源的各通道用该来源窗口上一次性估计的鲁棒统计量归一化。B.2 配对构造。在同一任务分类组内,候选参考 r 相对查询 q 按下式排序:d(q,r) = \min_{\pi \in \Pi_b} \frac{1}{|\pi|} \sum_{(i,j) \in \pi} \left\| \frac{\phi_i(q) - \mu(q)}{\sigma(q)} - \frac{\phi_j(r) - \mu(r)}{\sigma(r)} \right\|_{W} \;+\; \lambda_{h}\,\max\!\left(0,\, \left| h(q) - h(r) \right| - \tau\right).(2)
解释
式 (2) 逐符号说明。\phi_{1:T_d}(w) 是窗口 w 的逐帧运动描述子,\mu(w)、\sigma(w) 是它在窗口 T_d 帧上的逐通道均值和标准差,除法按通道进行。第一项是带状动态时间规整(DTW):\pi 是把查询第 i 帧与参考第 j 帧对齐的一条单调路径,\Pi_b 限定路径满足 |i-j|\le b(不允许一方过度快进或停顿),\frac{1}{|\pi|}\sum 是沿路径的平均逐帧距离,\|\cdot\|_W 是按通道加权的范数。窗口内标准化去掉了窗口的位置偏置,并降低对运动幅度的敏感性,使“伸得远”和“伸得近”的两次执行按运动形状比较;作者也承认这不是严格的不变性,因为位置、旋转和手部通道并不都随伸展距离等比例缩放。第二项是用手习惯惩罚:h(w) 是左手运动占两手总运动的比例,|h(q)-h(r)| 衡量两者在左右手使用上的差别,铰链 \max(0,\cdot-\tau) 让小于 \tau 的差别不受罚,超过后按 \lambda_h 线性加罚,从而把左手执行与右手执行区分开。具体参数:每帧每只手的描述子拼接相对起点的位置(3)、6D 旋转(6)、末端动作增量(9)和手部项(15),每手 33 通道、每帧 66 通道;序列先降采样到 T_d=40 步;权重 W 让指尖通道相对手腕取 0.25,使轨迹而非手指细节主导对齐;带宽 b=6 步,\lambda_h=3.0,\tau=0.25。作者特意说明不用路径长度来区分左右手,因为它区分不了。举例来说,若查询主要用右手(h=0.1)而参考主要用左手(h=0.8),差值 0.7 超过阈值 0.45,惩罚为 3.0\times0.45=1.35,足以把它排到同类候选的后面。
表 5:在同一任务类别内,检索到的参考与查询的运动是一致的。查询与其排名第一的跨源参考在若干运动一致性指标上的吻合程度;这些指标并不被配对分数直接优化(描述子看到位置、旋转和动作增量,但打分用的是规整后的描述子距离,而不是这些指标)。对照为同任务类别的随机搭档和完全随机的搭档。结果为 12,000 个查询上的均值。
| 指标 | 检索到的参考 | 同类随机对照 | 完全随机对照 |
| 速度曲线相关系数 \uparrow | 0.23 | -0.01 | -0.01 |
| 轨迹形状余弦相似度 \uparrow | 0.36 | 0.00 | 0.00 |
| |\log| 路径长度比 \downarrow | 0.69 | 0.93 | 0.92 |
| 速度相差 3 倍以上的比例 \downarrow | 22.9% | 28.7% | 39.4% |
原表注:Within a task class, the retrieved reference agrees with the query's motion. Agreement between a query and its top-ranked cross-source reference on motion-agreement metrics that the pairing score does not directly optimize (the descriptor sees positions, rotations and action increments, but is scored by warped descriptor distance, not by these metrics), against a random partner of the same task class and a random partner. Means over 12{,}000 queries.
表 5 解读
三列分别是:DTW 排序后排名第一的跨源参考;从同一任务类别中随机抽一个搭档(“只用任务标签”能做到的水平);从全部数据中随机抽一个搭档。四行指标中,速度曲线相关看两段运动“何时快、何时慢”是否同步;轨迹形状余弦看位移方向序列是否相似;|\log| 路径长度比看两者走过的路程差多少倍(0 表示一样长,0.69 约相当于差 2 倍,因为 \ln 2\approx0.69);最后一行是平均速度相差 3 倍以上的配对占比。这张表的关键在于同类随机对照与完全随机对照几乎没有差别:前两行都是 0 左右,路径长度比 0.93 对 0.92。也就是说,仅凭任务标签(例如“洗碗”)配出的两段 3 秒窗口,在运动上和随便挑的两段没什么区别,一个任务里包含大量不同的子动作。DTW 重排把轨迹形状余弦从 0 提到 0.36、速度相关从 0 提到 0.23,正文第 2.3 节“轨迹形状余弦高出 0.36”说的就是这一列与同类对照之差。不过绝对水平并不高:相关 0.23、余弦 0.36 只是“中等偏弱”的一致,仍有 22.9% 的配对速度相差 3 倍以上(同类随机是 28.7%,改善有限)。这与附录 A 的说法一致:配对抓住的是运动形状,而幅度和速度的匹配并不精确。
TurnOnFaucet 50、CloseLeftCabinetDoor 50、PnPSinkToCabinet 81、PnPSinkToRightCounterPlate 72),每回合 256–302 帧、三路相机;另有每任务 100 条示范的检索池。检索池再以 2 倍速回放一份,供第 4.1 节的不可行示范测试在后训练和评估中使用(匹配描述子去掉了会被加倍的速度通道)。机器人窗口长 36 帧(32 步动作块加 4 帧余量),逐时间步抽取,共 61,686 个查询窗口。每个查询窗口有 6 个示范槽位:槽位 0 是该回合自己的规范示范,经整回合的全局 DTW 对齐;槽位 1–5 是检索池中按前 32 帧 26 维双手位姿描述子做带状 DTW 得到的 5 个最近窗口(每个回合至多一个)。由于机器人与示范共享单位和坐标系,这里直接用绝对位姿匹配,无需式 (2) 的标准化。上下文内与无上下文后训练的数据、目标和归一化完全相同,后者只是去掉参考槽位。评估方面,L2 在训练布局内留出风格和物体,L3 留出布局;评估场景是冻结的清单,种子流与训练不相交(评估种子从 1,000 开始,训练种子从 1,000,000 开始,运行时会拒绝重叠),L2、L3 场景从未参与训练。每个任务评估 30 回合,即 3 条规范示范各 10 回合;L2 的 PnPSinkToRightCounterPlate 有 4 条示范,评估 40 回合。策略以 32 步动作块执行,每块 35 步去噪、引导系数 1.5。在上下文内后训练下,每个动作块都会根据策略自身最近的本体感知重新检索示范窗口,约束为单调前进(相对上次匹配前进 8–48 帧之间)并锁定在同一条示范上,使一条示范贯穿整个回合;无上下文后训练则完全跳过检索。机器人动作头预测控制器坐标系下的指令动作而非测得状态,因为把测得状态当指令回放会把跟踪滞后计入两次(示范中一次、rollout 中一次)。解释
这一节对读正文结果的意义。第一,每任务 30 回合意味着一次成功对应 3.3 个百分点,正文表 2/3/4 中几个百分点的差别只相当于一两个回合,而且每个配置只训练一次(C.2),没有给出方差。第二,训练集只有 12 条人类动作经场景抽样放大而来,所以“L1”本质上是在测试对少数几条轨迹的复现,L2/L3 才检验泛化。第三,上下文内评估每个动作块都重新检索参考,参考是随策略进度推进的“导航”,而 2 倍速示范里的进度比机器人能达到的快一倍。
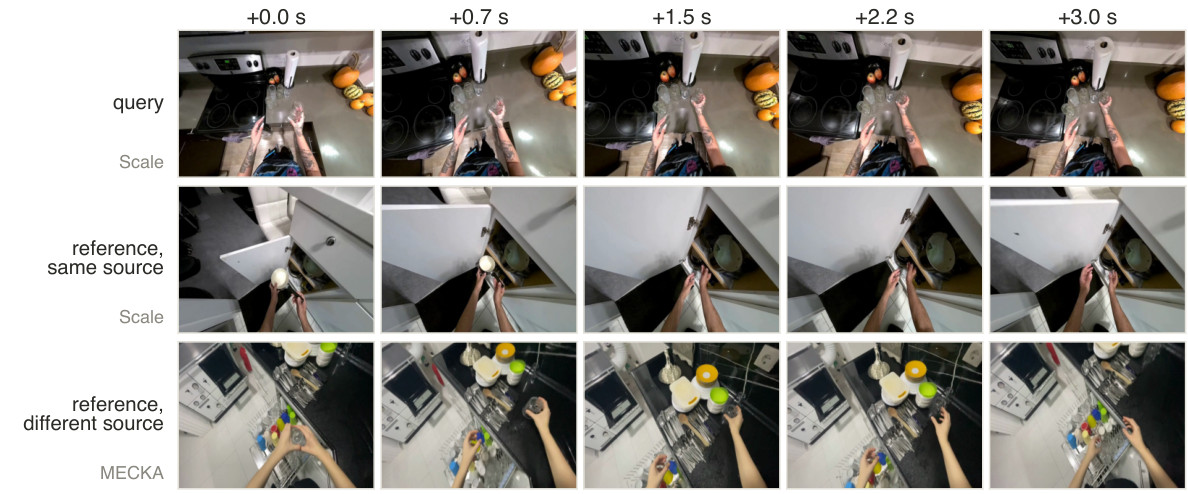
(a) 卸洗碗机(Unload dishwasher)
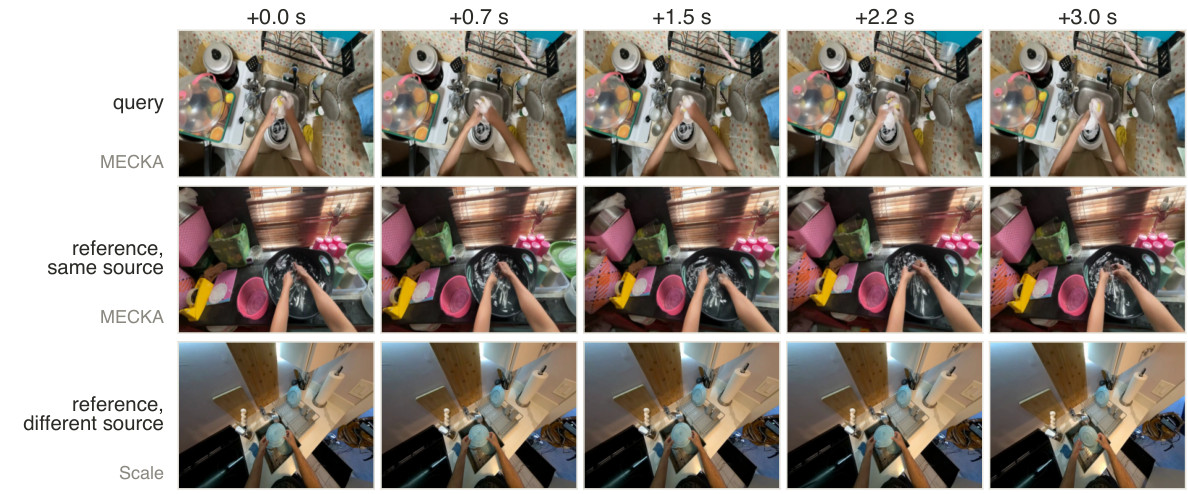
(b) 洗碗(Do dishes)
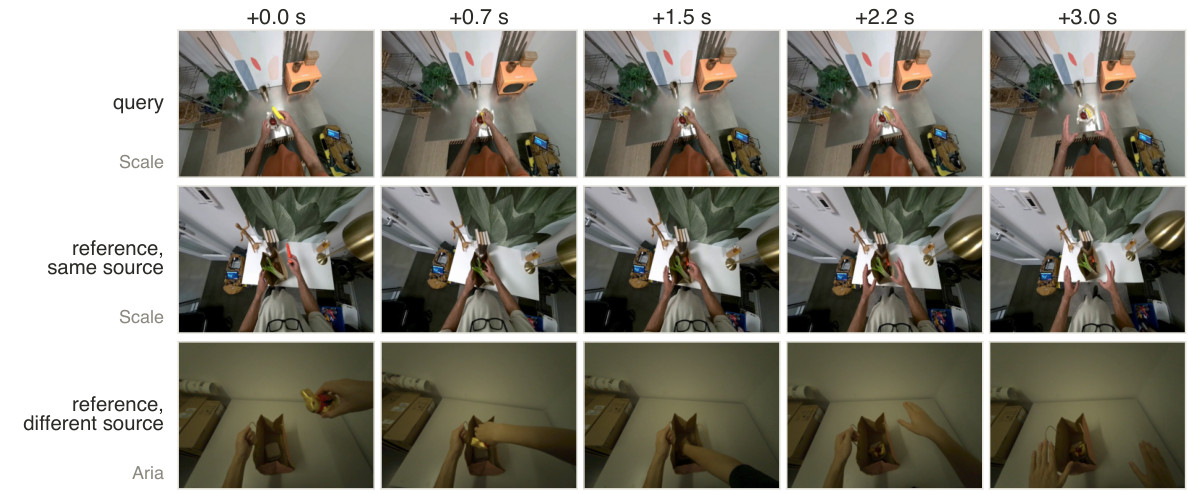
(c) 装袋(Bagging groceries)
图 10:查询—参考配对。训练配对中的三个查询,各配一个来自同一采集来源的参考和一个来自不同来源的参考,以覆盖 3 秒窗口的五帧展示。每段片段的来源标在其行标签下方。(a) 卸洗碗机:Scale 查询,MECKA 参考;(b) 洗碗:MECKA 查询,Scale 参考;(c) 装袋:Scale 查询,Aria 参考。
原图注:Query–reference pairs. Three queries from the training pairs, each with its reference from the same collection source and one from a different source, as five frames spanning the 3-second window. The source of every clip is named under its row label. (a) Unload dishwasher, a Scale query with a MECKA reference; (b) do dishes, a MECKA query with a Scale reference; (c) bagging groceries, a Scale query with an Aria reference.
图 10 解读
每个子图三行:第一行是查询,第二行是同源参考,第三行是跨源参考,五列是窗口内 +0.0 到 +3.0 秒的五个时刻。同源参考与查询共享采集设备、视角和环境风格(例如 (b) 中两段 MECKA 片段都是近距离俯视水槽),跨源参考则只共享任务和动作,人、相机和场景都不同((b) 的 Scale 参考换成了木质台面和广角镜头,(c) 的 Aria 参考是正面视角、背景简单)。这正是跨视频目标要“训练对抗”的变化:模型要从一段外观完全不同的示范里读出动作,用来预测查询的动作和未来画面。也能看出表 5 所说的“运动一致而非完全相同”:(a) 中查询是双手拿着玻璃杯从洗碗机取出,同源参考是把杯子举进吊柜,跨源的 MECKA 参考则是在台面旁的架子上伸手取放物品:任务一致、动作大致对应,但细节差别不小。
C 实现细节(Implementation Details)
C.1 架构。预训练在序列中放 6 个槽位,其中参考视频占 k 个时间位置、未来视频占 g 个:| 槽位 | 内容 | 时间标签 | 角色 |
| 0 | 查询状态 s^q_t | t | 条件 |
| 1 | 参考动作 a^r_{u:u+C} | t | 条件 |
| 2 | 参考视频 I^r_{u:u+C+1} | t-k\delta \ldots t-\delta | 条件 |
| 3 | 查询当前帧 I^q_t | t | 条件 |
| 4 | 查询动作 a^q_{t:t+C} | t | 生成 |
| 5 | 查询未来视频 I^q_{t+1:t+C+1} | t+\delta \ldots t+g\delta | 生成 |
D 补充分析(Additional Analyses)
D 扩展第 3 节的分析。D.1(图 12)给出图 2a 中两条PnPSinkToCabinet rollout 再晚一帧、三路相机下的注意力:成功的一条关注物体处的手,失败的一条关注前臂。D.3(图 14)在另两个查询上重复图 4b 的“换参考”实验,并加入原视频模型:主干的注意力散在边缘、顶灯和背景上,换参考来源后几乎不变;WATCH 的注意力落在手和被操作物体上,换成异地异源的参考后依然如此。D.4(图 15)在四帧机器人画面和三个人类查询上比较三个模型,结论一致:原模型看边缘背景,视频内预训练把注意力移到手臂,跨视频预训练移到手和物体。D.5 只记录表示分析的协议:取去噪第 0 步、动作槽位在每层的空间均值(2048 维),在第 10–27 层上平均;检索曲线下面积在人类集上依次为 0.50、0.66、0.78,在机器人集上为 0.65、0.69、0.74(原模型、视频内、WATCH);作者也承认 WATCH 在分析时额外得到了一个同源参考的未来动作,这部分信息会抬高其检索和探针得分。图 16 的 t-SNE 显示原模型下每个来源在任务内自成一岛,WATCH 下同一任务的两个来源合为一岛。D.6(图 17)的线性探针在两个集合的四个属性上都是 WATCH 最好;留出本体回归的 Spearman 相关在人类集 0.18、机器人集 0.24,原模型仅 0.06 和 0.01。D.2 把表 1 扩展到三个留出集,见表 6。 表 6:在三个留出集上的预测。把表 1 扩展到 Humanoid Everyday [30](人形机器人遥操作数据集)和 EgoDex(第二个人类数据集),每个集合 2,048 个片段,并加入 C.3 的联合训练变体。动作指标只算末端执行器部分:归一化空间中的 MSE,以及容差 0.1 下的准确率。原模型只生成视频。最好为粗体,次好加下划线。
| 动作(末端) | 生成视频 | |||||
| 留出集 | 模型 | MSE \downarrow | acc@0.1 \uparrow | FVD \downarrow | FID \downarrow | LPIPS \downarrow |
| Humanoid Everyday | 原模型 | – | – | 325.7 | 31.81 | 0.422 |
| 视频内 | 0.077 | 51.5 | 610.4 | 31.22 | 0.366 | |
| 联合训练 | 0.045 | 66.2 | 105.1 | 12.70 | 0.267 | |
| WATCH | 0.023 | 71.4 | 137.6 | 10.01 | 0.215 | |
| EgoDex | 原模型 | – | – | 200.5 | 8.18 | 0.243 |
| 视频内 | 0.024 | 69.0 | 169.8 | 9.82 | 0.242 | |
| 联合训练 | 0.033 | 65.8 | 220.1 | 14.17 | 0.299 | |
| WATCH | 0.019 | 73.4 | 142.7 | 8.53 | 0.211 | |
| RoboMIND | 原模型 | – | – | 290.7 | 12.48 | 0.247 |
| 视频内 | 0.046 | 55.6 | 1485.1 | 53.53 | 0.370 | |
| 联合训练 | 0.056 | 56.7 | 418.7 | 31.10 | 0.291 | |
| WATCH | 0.039 | 68.5 | 154.9 | 8.33 | 0.154 | |
原表注:Prediction on three held-out sets. Table 1 extended to Humanoid Everyday [30], a humanoid teleoperation dataset, and EgoDex, a second human set, 2{,}048 clips per set, with the co-training variant of § C.3 added. Action metrics are on the end-effector subset of the action: MSE in normalization space and accuracy at tolerance 0.1. The original model generates video only. Best in bold, second underlined.
表 6 解读
acc@0.1 是末端误差在 0.1(归一化单位)以内的比例;FVD、FID、LPIPS 分别衡量视频整体、单帧质量和与真实帧的感知距离。RoboMIND 三行与正文表 1 一致。作者提醒,联合训练在 Humanoid Everyday 上不是留出比较(它的机器人查询就取自该数据集),即便如此 WATCH 除 FVD 外都更好,末端 MSE 约为其一半(0.023 对 0.045);在都未见过的 RoboMIND 上,WATCH 的 acc@0.1 比次好高约 12 个点(68.5 对 56.7)。另一个醒目现象是视频内预训练会严重损坏机器人数据上的视频生成:RoboMIND 上 FVD 从原模型的 290.7 恶化到 1485.1,Humanoid Everyday 上从 325.7 到 610.4,而 WATCH 在三个集合上都低于原模型。
E 人类数据 vs. 机器人数据作为预训练数据
E.1 设置。两组使用同一配方和相当数量的配对视频:WATCH 用约 10% 的人类配对(约 1K 窗口小时);“机器人组”只用 RoboMIND 配对(也约 1K 小时)。比较在机器人组见过、人类组没见过的 RoboMIND 窗口上进行,共 300 个窗口,三种机器人任务相同。E.2 分析。图 18(未贴出)把三个模型的特征旋转对齐后联合做 t-SNE:人类组与机器人组的同一窗口平均相距 0.03–0.06,原模型为 0.12–0.31。图 19(未贴出)逐层计算 Procrustes 对齐后的 match@1(最近邻恰为自身的比例,随机约 0.3%):人类组与机器人组在第 10–27 层均值为 0.50(机器人窗口)和 0.71(人类窗口),原模型为 0.13 和 0.11。正文图 7 报告的 0.60/0.76(人类组)与 0.19/0.21(原模型)是全部 28 层的平均;译者从矢量图读数重算,两种口径都与文中数字吻合。图 20(未贴出)显示两组在 Franka 查询和 MECKA 查询上都把注意力放在夹爪/手和物体上,即使是没见过的本体。E.3 下游迁移与采集成本。作者参照 RoboVQA [46]比较两种预训练的“性价比”。关键在于成本比是假设的:以“机器人数据每小时成本是人类视频的 8 倍”为中心设定,并给出 4–16 倍的敏感区间,预算以整个人类语料的估计采集成本为 1 个单位。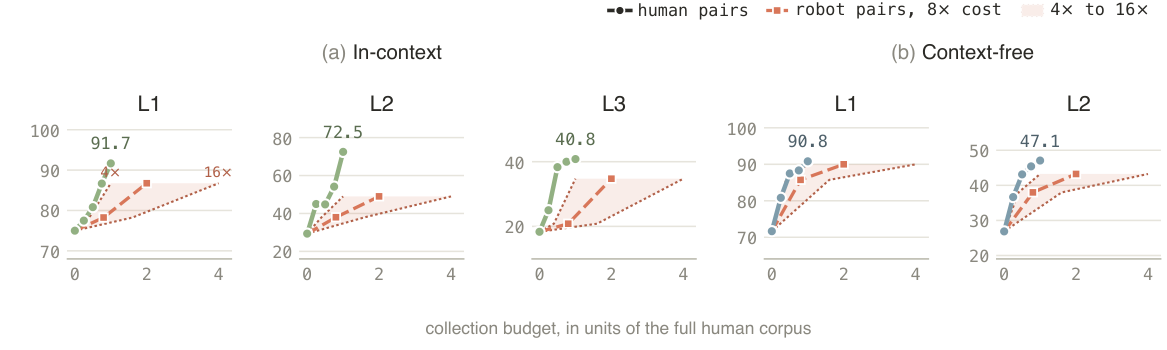
图 21:采集预算约束下的下游迁移。图 9 的人类数据扫描(绿、蓝)与机器人配对组(红),后训练同为 MimicDroid。一组的预算等于其配对视频量乘以采集单位视频的成本,以人类视频为单位;两者的成本比在本文中并未测量,因此色带扫过 4–16 倍,实线取 8 倍。每条机器人曲线止于作者跑过的最大机器人设置。两组都从同一个未经此预训练阶段的模型(预算 0)出发。(a) 上下文内,L1–L3;(b) 无上下文,L1 和 L2。各子图纵轴范围不同。
原图注:Downstream transfer under a collection budget. The human-data sweep of Figure 9 (green, blue) and the robot-pairs arm (red), under the same MimicDroid post-training. An arm's budget is its amount of paired video times the cost of collecting a unit of that video, in units of human video; the ratio between the two is not measured here, so the band sweeps 4\times to 16\times and the line draws 8\times. Each robot line ends at the largest robot setting we ran. Both arms start at 0 from the same model without this pre-training stage. (a) In-context, L1 to L3; (b) context-free, L1 and L2. Each panel has its own y range.
图 21 解读
人类曲线的点位于预算 0–1(使用 0–100% 的人类配对),与正文图 9、表 4 一致;红色方块是机器人组在 8 倍成本下的位置 0.8 和 2.0(约 1K 和 2.5K 窗口小时 RoboMIND 配对),色带上下沿对应 4 倍和 16 倍。L2 上最大机器人设置为 49.0,与文字一致。要分清“数据效率”和“成本效率”。译者从矢量图读出机器人组 2.5K 窗口小时的成功率约为 86.7、49.0、35、90、43,而数据量相当的 25% 人类组只有 77.5、45.0、25.0、80.8、36.7:按同等数据量,RoboMIND 机器人配对在五个子图上都更好。人类数据胜出全靠假设的成本比:取 4 倍时,同预算 1.0 下全量人类组仍更高,但无上下文 L1 已接近持平(90.8 对约 90);成本比再低,结论就可能翻转。此外,预算按窗口小时折算(对原始录像约有 7 倍重复计数,B.3),而 RoboVQA 的成本比按原始采集时长;人类语料还含有 MimicDroid 同一 sink 环境中的 play,机器人组没有这种域内数据。
F 补充实验结果与细节
F.1 基线都在与 WATCH 相同的机器人示范上后训练,TableTop-Sim 和 RoboCasa 每任务评估 50 回合。\pi_{0.5} 和 MolmoAct2 的动作头有维度上限,所以在 MimicDroid 上用 20 维动作,其他模型用 57 维;TableTop-Sim 上所有模型都用 ALOHA 的 20 维目标。HAND 与 MimicDroid 两行是前人在各自评估数据上报告的数字。F.2 给出逐任务结果,下表重排上下文内 MimicDroid 部分。表 7:上下文内 MimicDroid,逐任务结果。表 2 和表 4 中各模型在每个层级四个任务上的成功率(%);Avg. 为层级内四个任务的均值,最后一列为 L1–L3 均值。粗体最好,下划线次好。缩写:CLD/CRD = Close Left/Right CabinetDoor,Fct = TurnOnFaucet,S2C = PnPSinkToCabinet,S2P = PnPSinkToRightCounterPlate,S2M = PnPSinkToMicrowaveTop。
| L1 | L2 | L3 | ||||||||||||||
| 方法 | CLD | Fct | S2C | S2P | Avg. | CLD | CRD | S2C | S2P | Avg. | CLD | Fct | S2M | S2P | Avg. | Avg. |
| Vid2Robot | 100.0 | 100.0 | 63.3 | 100.0 | 90.8 | 53.3 | 0.0 | 63.3 | 87.5 | 51.0 | 0.0 | 0.0 | 0.0 | 3.3 | 0.8 | 47.6 |
| \pi_{0.5} | 100.0 | 100.0 | 80.0 | 36.7 | 79.2 | 43.3 | 0.0 | 70.0 | 40.0 | 38.3 | 33.3 | 0.0 | 0.0 | 0.0 | 8.3 | 41.9 |
| GR00T-N1.7 | 100.0 | 100.0 | 33.3 | 80.0 | 78.3 | 100.0 | 0.0 | 66.7 | 70.0 | 59.2 | 33.3 | 6.7 | 0.0 | 0.0 | 10.0 | 49.2 |
| Cosmos Policy | 100.0 | 100.0 | 40.0 | 60.0 | 75.0 | 0.0 | 33.3 | 6.7 | 77.5 | 29.4 | 0.0 | 70.0 | 0.0 | 3.3 | 18.3 | 40.9 |
| + 视频内 | 100.0 | 100.0 | 63.3 | 80.0 | 85.8 | 100.0 | 0.0 | 40.0 | 37.5 | 44.4 | 33.3 | 56.7 | 0.0 | 3.3 | 23.3 | 51.2 |
| + 联合训练 | 100.0 | 100.0 | 53.3 | 96.7 | 87.5 | 100.0 | 33.3 | 70.0 | 30.0 | 58.3 | 33.3 | 66.7 | 0.0 | 36.7 | 34.2 | 60.0 |
| + 同源 top-1 | 100.0 | 100.0 | 70.0 | 66.7 | 84.2 | 86.7 | 0.0 | 66.7 | 80.0 | 58.3 | 33.3 | 66.7 | 0.0 | 33.3 | 33.3 | 58.6 |
| + WATCH | 100.0 | 86.7 | 100.0 | 80.0 | 91.7 | 66.7 | 66.7 | 86.7 | 70.0 | 72.5 | 33.3 | 66.7 | 30.0 | 33.3 | 40.8 | 68.3 |
| Cosmos3 | 100.0 | 100.0 | 46.7 | 30.0 | 69.2 | 100.0 | 100.0 | 60.0 | 57.5 | 79.4 | 33.3 | 0.0 | 6.7 | 83.3 | 30.8 | 59.8 |
| + WATCH | 86.7 | 100.0 | 90.0 | 90.0 | 91.7 | 100.0 | 100.0 | 73.3 | 72.5 | 86.5 | 33.3 | 80.0 | 40.0 | 66.7 | 55.0 | 77.7 |
原表注:In-context MimicDroid, per task. Success rate (%) of every model of Table 2 and Table 4 on the four tasks of each level; Avg. is the mean over the tasks of a level, and the last column the mean over L1–L3. Best in bold, second best underlined.
表 7 解读
译者逐行验算:各层级 Avg. 都等于四个任务的简单平均,最后一列等于三个层级均值的平均,全部与正文表 2、表 4 一致。表中数值都是 3.3 的倍数(每任务 30 回合;L2 的 S2P 为 40 回合,是 2.5 的倍数)。L1 的开门和水龙头几乎都是 100%;L3 的 CLD 几乎所有模型恰为 33.3%(30 回合中 10 次,正好是一条示范的全部回合),像是三条示范中只有一条在 L3 布局下可行,这一列基本不区分模型。原文说“只有跨视频模型在 L3 的 S2M 上达到两位数”,但同源 top-1 变体同样是跨视频预训练,在该任务上是 0.0,准确说只有完整的 WATCH(30.0、40.0)做到。WATCH 也非逐任务领先:Cosmos3 基线在 L3 S2P 上 83.3,高于 Cosmos3 + WATCH 的 66.7。

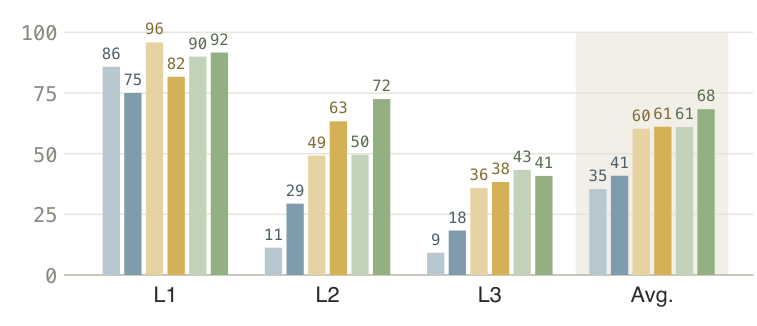
(a) MimicDroid,上下文内
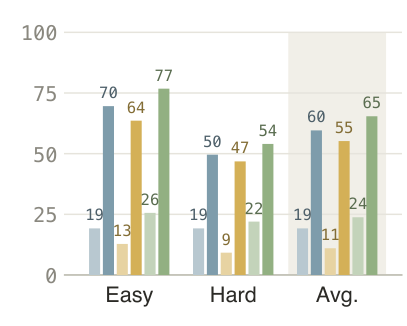
(b) TableTop-Sim,无上下文
图 22:监督消融的全部配置。成功率(%)。色相表示预训练目标(无、动作、视频 + 动作);浅色为仅动作后训练,深色为视频 + 动作后训练。(a) MimicDroid 上下文内,仅动作后训练时参考只以动作形式给出;(b) TableTop-Sim 无上下文。
原图注:Supervision ablation, all configurations. Success rate (%). Hue: pre-training target (none, action, video + action); pale: action-only post-training, full: video + action. (a) MimicDroid, in-context, the reference given as actions only under action-only post-training; (b) TableTop-Sim, context-free.
图 22 解读
每根柱子读作“预训练目标 \to 后训练目标”。MimicDroid 上 L1/L2/L3/均值依次为:无\to动作 86/11/9/35,无\to视频+动作 75/29/18/41,动作\to动作 96/49/36/60,动作\to视频+动作 82/63/38/61,视频+动作\to动作 90/50/43/61,视频+动作\to视频+动作(WATCH)92/72/41/68;TableTop-Sim 上 Easy/Hard/均值依次为 19/19/19、70/50/60、13/9/11、64/47/55、26/22/24、77/54/65。仅动作后训练在 L2 上全面落后(11、49、50 对 29、63、72),在 TableTop-Sim 上崩溃到 11–24,但在 L1 上反而更高(86、96 对 75、82)。视频+动作预训练在两种后训练下均值都最高,但在仅动作后训练下只领先 1 个点(61 对 60)。仅动作预训练在 TableTop-Sim 上低于不预训练(11、55 对 19、60)。
G 定性结果:机器人 rollout
附录 G 用四组 rollout 图做定性展示(均未贴出),对比不预训练的 Cosmos Policy 与 WATCH。图 23 是 MimicDroid 上下文内的四个任务,插图为当前动作块检索到的参考帧:WATCH 的插图随进度推进,不预训练的策略在抓取后悬停或停滞。图 24 和图 25 是 2 倍速示范下的CloseLeftCabinetDoor(L3)和 PnPSinkToCabinet(L2),逐个 1.6 秒动作块展示参考帧、生成帧和块末实际帧。示范的手在一个块内就关上了门,不预训练时生成帧停在“伸手”阶段、手臂停滞,WATCH 把动作分摊到多个块中完成,即跟随示范的进度而非其节奏。图 26 是 TableTop-Sim 上五个任务的无上下文 rollout:不预训练时策略能够到或拿起物体,却在收尾步骤失败(盘子掉落、交接前掉盒、鞋子不松手等),WATCH 在相同时间内完成。译者附注:原文数字核对与阅读提示汇总
以下各条大多已在正文对应位置的解释框中说明,这里集中列出。总体而言,原文的数字是自洽的:表 2、3、4 各行的平均值都能还原(少数 0.1 的出入来自先用未舍入的逐任务分数求平均再舍入,可由附录表 7 验证),正文与附录的配对统计(10.52/6.35 对 10.5/6.4,90.7% 对 9.3%)彼此一致,图 8、9 从矢量图中换算出的数值也与表 4 吻合。问题主要不在数字本身,而在三方面:比较条件不完全对等(计算量、测试时信息、动作维数、评估数据来源),统计精度有限(单次训练、每层约 120 个评估回合),以及若干表述比证据更强(“未见场景增益最大”“人类视频更便宜”“表征与机器人训练模型一致”)。| 位置 | 说明 |
| 一、数据与配对 | |
| §2.3 / 附录 B.3 | “10.0K 小时”是窗口小时:每个查询窗口和每条参考链接各按一个 3 秒窗口计,(1{,}045{,}007 + 10.99\text{M}) \times 3\,\text{s} \approx 10{,}029 小时。查询窗口本身只有 871 小时,且窗口以 1 秒步长滑动、彼此重叠,不重复的底层录像按“窗口数 \times 1 秒”粗估约 290 小时(译者推算,原文未给出);EgoVerse 整个发布版为 1.36K 小时。正文的说法容易被读成一万小时的独立人类视频。 |
| §2.3 / 附录 B.3 | 正文说配对“来自 EgoVerse 的不同回合”,但预训练语料还包括 MimicDroid 自带的人类 play 数据(16,195 个查询窗口),它是在下游评估所用的水槽环境中录制的,其 19,802 条链接也是全部数据中仅有的同回合链接。视频内、联合训练基线使用同一语料,内部对比是公平的;但相对 \pi_{0.5}、GR00T 等外部基线,这是额外的领域内数据。 |
| §1 / §2.3 | 引言把配对描述为“不同采集来源的同任务示范”,实际参考集同时含同源近邻(平均同源 4.2、跨源 6.4),9.3% 的查询(全为 MECKA)没有跨源参考,且配对按 DTW 轨迹距离排序,并非只按任务匹配。 |
| §2.3 / 表 5 | “选出的配对比同任务随机跨源配对的轨迹形状余弦高 0.36”:对照组均值为 0.00,所以就是 0 \to 0.36,属于中等相似度;正文称对照组为“跨源”,表 5 表注只写“同类随机”。 |
| §2.1 / §2.3 | \lambda=48 没有给出选取依据。按附录 C 推算,生成槽位中未来视频约 23 个潜帧、动作块只占 1 个潜帧,加大权重是为了平衡两项损失(译者推断)。 |
| 二、第 3 节表征分析 | |
| 图 4(a) | 纵轴不从 0 开始,视觉上放大了差别(换来源 MSE +4%,换任务 +14%);两种替换参考不对称(跨源参考按动作相似度挑选,跨任务参考没有这一条件);“不显著”不等于“无差别”,原文也没有做等价性检验;误差棒含义未说明。 |
| 图 5 | 提取特征时,只有 WATCH 的参考槽位放入了匹配参考(含其未来动作),两个基线这些槽位为空,作者在附录 D.6 也承认这对未来动作回归有利。人类检索对是用训练配对描述子本身定义的“相同动作”,可能偏向 WATCH。留出本体回归的 Spearman 0.18/0.24 属弱相关;误差棒是跨层标准误,不是抽样误差。正文只与原视频模型比较,没有点出与视频内基线(0.09/0.13)的较小差距。 |
| 表 1 | 测试时信息不对称:视频内基线只用查询上下文,WATCH 以参考为条件;原文未交代 RoboMIND 评估中 WATCH 的参考如何检索。单次运行、无误差估计。 |
| §3 / 附录 E | 正文先后用了三个不同的 RoboMIND 集合(表 1 的 2,048 个片段、图 5 的 396 个窗口、图 7 的 300 个窗口),没有提醒读者。 |
| 图 7 / 附录 E.2 | match@1 的平均口径不一致:正文与图 7 用全层平均(0.76/0.60 对 0.21/0.19),附录 E.2 用第 10–27 层(0.71/0.50 对 0.13/0.11),图 5 也用第 10–27 层;浅层特征三个模型共享,全层平均抬高了原视频模型的数字。对齐方向在正文、图 18、图 19 的图注中三种说法。两个模型共享初始化、架构和跨视频目标,缺少“人类数据 + 视频内目标”这样的对照;图 7 的人类模型是 1K 小时子集版本。 |
| 图 2、图 6 | 都是少数帧的定性注意力图(图 2(a) 只有一次成功和一次失败,图 6 每任务一帧),原文没有说明注意力如何计算(层、头、查询 token、归一化);“我们假设这部分源于预训练目标”没有对照实验验证。 |
| 三、第 4 节后训练实验 | |
| 表 2 / §4.2 | “最大增益在未见层级”对 Cosmos Policy 成立(L1 +16.7、L2 +43.1、L3 +22.5);对 Cosmos3 只部分成立(L1 +22.5、L2 +7.1、L3 +24.2),正文“同样的趋势”只对 L3 和平均成立。Cosmos3 基线 L2(79.4)高于 L1(69.2),原因是两层任务集不同(L2 用 CloseRightCabinetDoor 替换了 TurnOnFaucet),L1–L3 并非同一组任务逐级变难。 |
| 表 2、3、4 | 统计精度:每任务 30 回合(L2 盘子任务 40),每层约 120 回合,每个配置只训练一次;50% 附近单层成功率标准误约 4.6 个百分点,两组之差约 6.5,且回合按每任务 3 条示范成簇,真实不确定性更大。稳健的差距:Cosmos Policy 的各层增益、2 倍速下 WATCH 对不预训练的 +23.4。在噪声内的差距:Cosmos3 L2 的 +7.1、TableTop-Sim Hard 上的增益、表 4 无上下文一侧 WATCH 对最强变体的领先(+1.9 至 +3.8)、图 8(b) 的 +0.8。 |
| 表 2、3 | \pi_{0.5} 和 MolmoAct2 在 MimicDroid 上用 20 维动作,其他模型用 57 维;HAND、MimicDroid 两行(\dagger)用的是前人自己的评估数据;原文没有说明 \pi_{0.5}、GR00T-N1.7 在上下文内设定下如何接收参考示范。MimicDroid 的机器人训练集(253 回合,只有 12 种人类动作)、参考池和评估场景都是作者自建的,表 2 与 MimicDroid 原论文不可比。“Cosmos Policy”行是作者的简化配方(换用 Predict2.5,去掉辅助本体感知预测和 rollout 数据增强)。 |
| 表 3 / 附录 B.5 | 附录说同一场景为每个可行任务各录一个回合,“只有示范决定要做什么”,但式 (1) 和无上下文后训练都输入了任务描述 \ell,上下文内评估是否同时给语言指令原文没说清。L2 的 CloseRightCabinetDoor 不在训练任务中,无上下文时所有模型在该任务上都是 0(详见下文表 8 一条)。RoboCasa Kitchen-H50 的任务数未给出,无法估算标准误;Cosmos3 在 RoboCasa 上的预训练混入了 12.5% 的 RoboMIND 机器人数据,增益只有 +0.8,且没有“只加 RoboMIND”的对照。 |
| 表 4 / 附录 C.3 | 视频内与联合训练基线每步序列 29 个潜变量,WATCH 50 个,三者同为 8K 步,计算量不匹配,正文消融没有提及。同源 top-1 一行在正文中没有讨论:它在所有列上都低于 WATCH,在无上下文三列上甚至不如视频内预训练。WATCH 在 2 倍速下 L3(41.7)反而高于正常速度(40.8)。 |
| 图 8 / 附录 F.4 | 只监督动作的预训练在 TableTop-Sim 上(55.2)低于不预训练(59.6),属于负迁移,正文未提;联合预训练对只监督视频只高 0.8(65.4 对 64.6),Hard 划分上反而更低(54.0 对 55.2)。 |
| 图 9 / 附录 F.3 | 训练步数随数据量增加(2K/4K/6K/8K,均约 0.49 个 epoch),数据与计算同时增长,无法分离;25% 档只训练 2K 步,计算量反而低于虚线基线。图 9(b) 标 L1/L2,表 3 标 Easy/Hard,命名不统一。附录 A 称“每一层在全量语料时仍在上升”,但上下文内 L3 在 50% 后基本持平(38.3/40.0/40.8)。 |
| §4.3 / §6 / 附录 E.3 | “人类视频比机器人数据便宜得多、扩展更具成本效益”依据的是假设的成本比(中心值 8 倍,敏感区间 4–16 倍,参照 RoboVQA),不是实测。全部下游评估都在仿真中进行,没有真机实验。 |
| 四、附录 | |
| 图 21 / 附录 E.3 | 按同等窗口小时比较,约 2.5K 小时的 RoboMIND 配对在五个子图上都优于 25% 的人类配对(上下文内 L1/L2/L3 约 86.7/49.0/35 对 77.5/45.0/25.0;无上下文 L1/L2 约 90/43 对 80.8/36.7),即单位数据量下机器人配对更有效。“人类视频更具成本效益”完全取决于假设的成本比:取 4\times 时无上下文 L1 已接近持平,更低时结论可能翻转。预算按窗口小时折算(相对原始录像约 7 倍重复计数),而 RoboVQA 的成本比按原始采集时长计;机器人组的训练步数未说明。 |
| 表 7 | L3 的 CloseLeftCabinetDoor 一栏几乎所有模型都恰好是 33.3%(30 回合中 10 次),像是三条示范中只有一条在 L3 布局下可行,这一列基本不区分模型。原文称“只有跨视频模型在 L3 S2M 上达到两位数”,但同为跨视频的同源 top-1 在这一栏为 0,准确说法是只有完整的 WATCH 达到。WATCH 并非逐任务领先:Cosmos3 在 L3 S2P 上加 WATCH 后从 83.3 降到 66.7;Cosmos Policy + WATCH 在 L2 CLD 上为 66.7,低于视频内与联合训练的 100。 |
| 表 8 | 无上下文 L2 中 CloseRightCabinetDoor 所有模型都是 0(Hard 上限 75%);CloseLeftCabinetDoor 上所有 Cosmos 系模型也都是 0,三个 VLA 基线却有 10/76.7/70,所以 Cosmos 系模型在 Hard 上的实际上限是 50%。原文“对多数模型接近 0”的描述偏轻。 |
| 图 22 / 附录 F.4 | 仅动作后训练在 L1 上反而更好(无预训练 86 对 75,动作预训练 96 对 82);在仅动作后训练下,视频 + 动作预训练只比动作预训练高 1 个点(61 对 60),“两种后训练下都是最好的预训练目标”优势很小。 |
| 表 6 | 视频内预训练在机器人数据上明显破坏视频生成:RoboMIND 上 FVD 290.7 \to 1485.1,Humanoid Everyday 上 325.7 \to 610.4,正文未讨论其原因。 |
| 表 5 | 同类随机对照与完全随机对照几乎没有差别,说明任务标签本身几乎不提供运动对应;检索配对的一致性也只是中等(速度相关 0.23、轨迹余弦 0.36,22.9% 的配对速度相差 3 倍以上)。 |
| 附录 C.2 | 余弦学习率周期为 50K 步、下限 0.3,但只训练 8K 步,结束时学习率仍约为峰值的 96%,调度实际上接近恒定。“1 秒步长”只对 30 Hz 来源成立,对 20 Hz 的 play 数据是 1.5 秒。 |
| 表 9 | 笔误“MolmoAct2 [29])”多一个右括号。 |
| 五、措辞与交叉引用 | |
| §2 节首段 | “详见附录 5”是错误的交叉引用:相关工作在正文第 5 节(源码标签仍叫 app:related,像是从附录移回正文后漏改)。 |
| §2.3 | 正文列举六个槽位的顺序与附录 C.1 表中的实际排列不同(注意力双向,不影响模型);“\ell 在两种主干上都以文本输入”出现在两种主干被介绍之前;“目标机器人的原生控制空间”与附录 F.1 不符(MimicDroid 上 WATCH 用 57 维共享表示,TableTop-Sim 上统一用 ALOHA 的 20 维)。 |
| 图 1 | 图中称“target”,正文称“query”,指同一角色;图 1(c) 雷达图各轴刻度不同且不从 0 开始,多边形面积会夸大差距。 |