前沿视觉-语言模型能否充当
记忆依赖型操作任务的机器人策略?
Can a Frontier VLM Serve as a Robot Policy for Memory-Dependent Manipulation?
Jack B. Jedlicki^{1*},Amish Sethi^{1},Heng Yang^{1}
^{1}哈佛大学(Harvard University),Harvard Computational Robotics Group
^{*}通讯作者:
arXiv:2610.17350v2 [cs.RO],2026 年 10 月 16 日(预印本)
项目主页:https://embodied-astra.github.io 代码与日志:https://github.com/jackbjed/embodied-astra-robomme
中文译文与逐段解读
记忆依赖型操作任务的机器人策略?
Can a Frontier VLM Serve as a Robot Policy for Memory-Dependent Manipulation?
Jack B. Jedlicki^{1*},Amish Sethi^{1},Heng Yang^{1}
^{1}哈佛大学(Harvard University),Harvard Computational Robotics Group
^{*}通讯作者:
jackbjed@g.harvard.eduarXiv:2610.17350v2 [cs.RO],2026 年 10 月 16 日(预印本)
项目主页:https://embodied-astra.github.io 代码与日志:https://github.com/jackbjed/embodied-astra-robomme
中文译文与逐段解读
目录
导读摘要(Abstract)1 引言(Introduction)2 相关工作(Related Work)基础模型作为机器人策略(Foundation models as robot policies)RoboMME 上的记忆(Memory on RoboMME)3 实验设置(Setup)回合与观测(Episodes and observations)上下文(Context)路点接口(Waypoint interface)神谕规划器接口(Oracle-planner interface)评测协议(Protocol)4 路点策略结果(Waypoint-Policy Results)总体结果(Overall)资源消耗(Resources)5 失败分析(Failure Analysis)标注方法(Labelling)提前宣布完成(Premature completion,25 例)无意的按钮接触(Unintended button contact,12 例)与按晚(late press,11 例)超出可达范围的路点(Out-of-reach waypoint,4 例)与运动规划失败(motion planning failures,5 例)不可用回答(Unusable answers,3 例)与其他操作错误(other manipulation errors,3 例)6 RoboMME 神谕规划器设置下的诊断校准(Calibration)GPT-6-Astra 作为规划器(GPT-6-Astra as a planner)接口修正(Interface corrections)配对对照(Paired control)7 局限性与后续实验(Limitations and Next Experiments)证据没有表明什么(What the evidence does not show)混杂因素(Confounds)开发过程、可复现性与范围(Development, reproducibility and scope)8 结论(Conclusion)参考文献(References)A 失败审计规则(Failure Audit Rules)B 神谕规划器设置下的逐任务结果(Per-Task Oracle-Planner Results)导读
这篇论文要回答什么问题? 很多机器人操作任务仅凭“当前这一帧画面”是做不成的:机器人要记住自己已经做了几次某个动作(计数),要追踪一个被盖住、又被挪动过的物体在哪(物体恒存性),要按照之前看过的演示视频复现同样的动作方式(模仿)。这类任务被称为记忆依赖型操作(memory-dependent manipulation)。RoboMME 是专门为测试这种能力设计的仿真基准,包含 16 个桌面任务,分成计数(Counting,时间记忆)、恒存(Permanence,空间记忆)、指代(Reference,物体记忆)、模仿(Imitation,程序/过程记忆)四个套件。在这篇论文之前,RoboMME 排行榜上最好的学习型策略只有 60.8% 的成功率,而人类玩家(借助一个“神谕”技能接口)能达到 90.5%。核心方法:极简的“全上下文”配置。 作者没有设计任何新网络,也没有在 RoboMME 数据上训练任何参数,而是直接把一个冻结(frozen,即参数不更新)的前沿视觉-语言模型(VLM)GPT-6-Astra 当作机器人策略来用: (1) 整个回合(episode)的所有历史——任务目标、任务视频、按步长 k 抽样的相机帧、模型自己之前的回答——都保留在同一个对话上下文中,不做任何摘要或丢弃; (2) 模型每一步直接输出下一个末端执行器(end-effector)路点:三维位置、姿态(滚转/俯仰/偏航)和夹爪开合指令,再交给 RoboMME 自带的运动规划器去执行。这就是论文所说的“路点策略”(waypoint policy)设置,也是排行榜认可的动作空间。作为对照,作者还在 RoboMME 原论文使用的“神谕规划器”(oracle planner)设置下做了诊断实验:模型只需选择一个技能和一个图像点,由拥有仿真器特权信息的规划器去执行。主要结论。- 在 800 个测试回合上,单次运行成功 737 个,即 92.1%(95% Wilson 置信区间 [90.1, 93.8]),在数值上超过此前报告的人类成绩 90.5%(人类用的是更容易的神谕接口),远高于排行榜最佳的 60.8% 以及“同一模型做规划 + RoboMME 训练的 VLA 做执行”的三层系统 79.1%;16 个任务中有 13 个达到或超过人类分数。
- 63 个失败回合高度集中在 MoveCube 与 StopCube 两个任务(共 46 个)。逐回合审计显示:MoveCube 的失败主要是“提前宣布完成”且夹爪仍闭合/仍握着棍子(不满足推动变体的成功判据);StopCube 的失败主要是“定位时无意碰到按钮”和“按得太晚”。作者强调这些类别只描述可观察行为,不断言存在“记忆失败”。
- 在神谕规划器设置下,更密集的帧(D)和修正后的提示词(G)让 GPT-6-Astra 在 300 个受影响回合上净增 116 个成功,而同样的修正对 GPT-4o 几乎无效,两者差异的交互效应约 35.7 个百分点。这说明修正本身并不是在“喂答案”,而是只有能力足够强的模型才能利用更多信息。
- 作者也非常坦诚地列出了局限:没有做消融实验来区分“图像历史”“文字历史”“动作记录”哪一个通道承载了记忆;部分配置在测试集上调过;API 模型没有固定版本快照,复现性受限。
- VLM / VLA:视觉-语言模型(Vision-Language Model)能同时理解图像和文字;视觉-语言-动作模型(Vision-Language-Action, VLA,如 RT-2、OpenVLA、\pi_0、\pi_{0.5})是在机器人数据上训练、直接输出底层动作的模型。
- 策略(policy):在强化学习/机器人学中,策略 \pi 是从“观测(及历史)”到“动作”的映射,常写作 a\sim\pi(\cdot\mid o)。
- 末端执行器、TCP 与路点:末端执行器是机械臂末端的夹爪;TCP(tool center point,工具中心点)是夹爪上的参考点;路点(waypoint)是要求 TCP 到达的一个目标位姿。路点控制比关节角控制更“高层”,因为从路点到关节轨迹的求解交给了运动规划器。
- 神谕规划器(oracle planner):利用仿真器内部的真实物体状态(特权信息)来执行技能的模块,例如“抓起离某像素点最近的物体”,它能精确完成动作,把“控制难度”从任务里剥离掉。
- 上下文窗口与对话链:大模型一次请求能看到的全部输入;本文把一个回合的所有轮次串在同一个对话里,模型因此能“看到”完整历史。
- 统计工具:Wilson 区间是二项比例的置信区间;精确 McNemar 检验用于比较同一批样本在两种条件下的成败(只看结果发生翻转的样本);分层自助法(stratified bootstrap)通过有放回重抽样估计统计量的置信区间。
摘要(Abstract)
原文
We use a frozen frontier vision-language model, GPT-6-Astra, directly as the robot policy on RoboMME, a benchmark of 16 memory-dependent manipulation tasks spanning temporal, spatial, object, and procedural memory. The model keeps the whole episode in context and outputs every end-effector waypoint and gripper command, with no RoboMME-specific training. On the 800 test episodes it succeeds in 92.1%, above the previously reported human score of 90.5%, which was obtained with an oracle skill interface, and far ahead of the best leaderboard entry (60.8%) and of a hierarchical system that pairs the same model with a RoboMME-trained policy (79.1%). It matches or exceeds the human score on 13 of the 16 tasks. Its 63 failures concentrate in two tasks and are mostly premature completions and mistimed or unintended button presses. These results blur the usual division between long-horizon planning, memory and end-effector control, and raise the question of how much of this stack a single general-purpose model can take over in embodied systems. Project website: https://embodied-astra.github.io. Code, prompts and all episode logs: https://github.com/jackbjed/embodied-astra-robomme.
译文
我们将一个冻结的前沿视觉-语言模型(vision-language model, VLM)GPT-6-Astra 直接用作 RoboMME 上的机器人策略(robot policy)。RoboMME 是一个包含 16 个记忆依赖型操作(memory-dependent manipulation)任务的基准,涵盖时间记忆、空间记忆、物体记忆和程序记忆。该模型把整个回合(episode)保留在上下文中,输出每一个末端执行器路点(end-effector waypoint)和夹爪指令,且未进行任何针对 RoboMME 的训练。在 800 个测试回合上,它的成功率为 92.1%,高于此前报告的人类成绩 90.5%(该成绩是借助神谕技能接口(oracle skill interface)取得的),并远远领先排行榜最佳条目(60.8%)以及一个将同一模型与在 RoboMME 上训练的策略相结合的分层系统(79.1%)。它在 16 个任务中的 13 个上达到或超过了人类成绩。它的 63 次失败集中在两个任务中,主要是提前宣布完成(premature completion)以及时机不对或无意的按钮按压。这些结果模糊了长时程规划、记忆与末端执行器控制之间的惯常分工,并提出了一个问题:在具身系统中,单个通用模型能接管这一技术栈的多大部分?项目网站:https://embodied-astra.github.io。代码、提示词和全部回合日志:https://github.com/jackbjed/embodied-astra-robomme。
解释
摘要按“做了什么—结果多好—失败在哪—意味着什么”的顺序组织。
- “冻结”与“直接用作策略”:模型参数不做任何微调,只通过提示词和上下文工作;它不是给另一个控制器出主意的“规划器”,而是自己给出每一个动作。
- 四类记忆:时间(数次数)、空间(被遮挡物体的位置)、物体(记住哪个物体被指定过)、程序(记住演示的动作方式),分别对应 RoboMME 的四个任务套件。
- 人类 90.5% 的限定:人类玩家使用的是“神谕技能接口”——只需点选“对哪个物体做什么技能”,抓取放置由带特权信息的规划器自动完成。因此 92.1% 与 90.5% 不是同一接口下的比较,作者在摘要里就把这一点写清楚了。
- 79.1% 的分层系统:该系统同样使用 GPT-6-Astra,但只让它规划子任务,再交给在 RoboMME 上训练过的 VLA 执行。本文用同一个大模型、不训练任何东西却更高,暗示“规划层 + 学习型执行层”的分工未必必要。
- 最后一句的立意:传统具身系统把“长时程规划”“记忆”“底层控制”拆成不同模块,本文的结果说明一个通用大模型可能同时承担其中好几层,这是全文想引发的讨论。
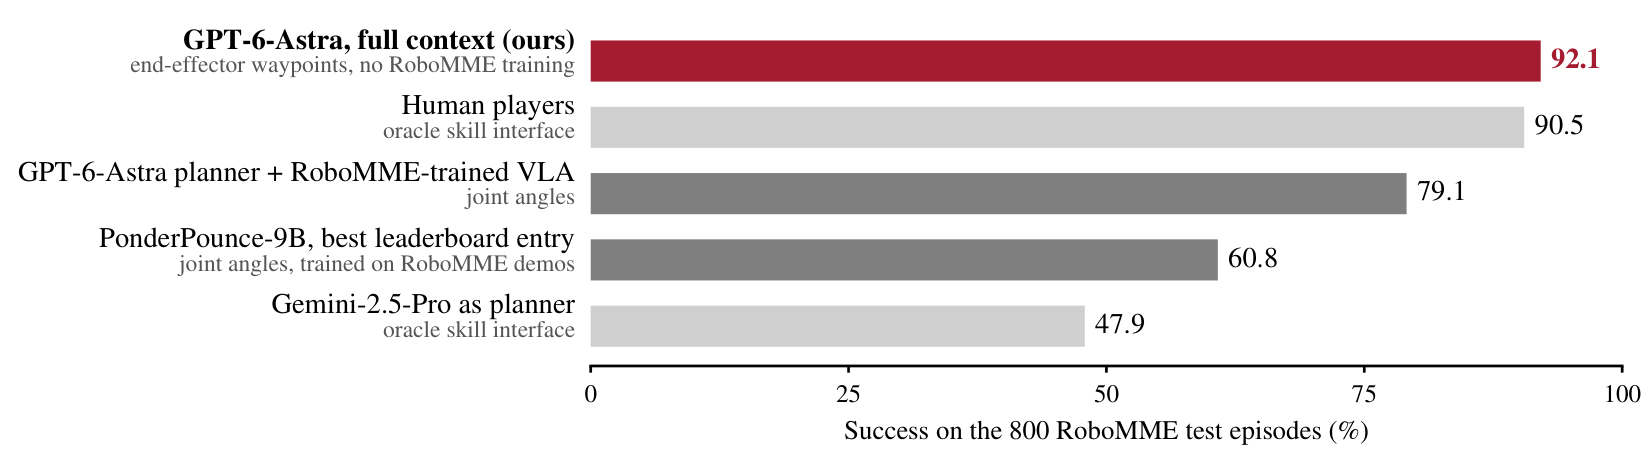
图 1:各方报告的 RoboMME 800 个测试回合上的成功率。GPT-6-Astra 将整个回合保留在上下文中,并给出每一个末端执行器路点,未进行任何针对 RoboMME 的训练。浅灰色条形使用 RoboMME 的神谕技能接口,即由一个拥有特权信息的规划器执行所选技能。详见表 1 和表 3。
原图注:Figure 1 Success on the 800 RoboMME test episodes, as reported by each source. GPT-6-Astra keeps the whole episode in context and commands every end-effector waypoint, with no RoboMME-specific training. Light grey bars use RoboMME's oracle skill interface, in which a privileged planner executes chosen skills. Details in Tables 1 and 3.
图 1 解读
这是一张横向条形图,横轴是 800 个 RoboMME 测试回合上的成功率(0–100%),每一行是一个系统,行标签下方的灰色小字说明它使用的动作接口和训练情况。
作用:这张图是全文的“结论先行”,用一眼可读的方式给出头条数字,但作者在图注里刻意标出接口差异,避免读者把它误读成严格同条件的对比。
- 红色条(92.1):本文方法,GPT-6-Astra 全上下文,输出末端执行器路点,未在 RoboMME 上训练。
- 浅灰色条:使用神谕技能接口的系统——人类玩家(90.5)和把 Gemini-2.5-Pro 当规划器(47.9,来自 RoboMME 原论文)。浅灰色意在提醒读者:这两者的执行由特权规划器代劳,任务难度比底层控制低。
- 深灰色条:输出关节角的系统——“GPT-6-Astra 规划器 + RoboMME 训练的 VLA”(79.1)和排行榜第一的 PonderPounce-9B(60.8,用 RoboMME 演示数据训练)。
作用:这张图是全文的“结论先行”,用一眼可读的方式给出头条数字,但作者在图注里刻意标出接口差异,避免读者把它误读成严格同条件的对比。
1引言(Introduction)
原文
Many manipulation tasks cannot be solved from the current observation alone: a robot must count how often it has done something, track an object hidden and moved while out of view, or reproduce a motion it saw demonstrated. RoboMME [9] turns these requirements into 16 simulated tabletop tasks in four suites (counting, permanence, reference and imitation). Policies on its public leaderboard remain well below its human reference [19], and in its own evaluation of VLMs as high-level planners the best model, Gemini-2.5-Pro, reaches 47.9%, against 90.5% for human players using the same oracle skill interface [9].
译文
许多操作任务无法仅凭当前观测完成:机器人必须数清自己做某件事做了多少次,追踪一个在视野之外被藏起并移动的物体,或者复现它看过的演示动作。RoboMME [9] 将这些需求转化为 16 个仿真桌面任务,分为四个套件:计数(counting)、恒存(permanence)、指代(reference)和模仿(imitation)。其公开排行榜上的策略仍远低于人类参考成绩 [19];而在它自己对“VLM 作为高层规划器”的评测中,最好的模型 Gemini-2.5-Pro 达到 47.9%,而使用同一神谕技能接口的人类玩家为 90.5% [9]。
解释
这一段交代问题背景和现状差距。
- 三个例子分别对应三类记忆:“数次数”是时间记忆,“追踪被藏起并移动的物体”是空间记忆/物体恒存性(object permanence,心理学术语,指物体看不见时仍知道它存在),“复现演示动作”是程序记忆。这些任务的共同点是:当前画面不包含做出正确决策所需的全部信息,即任务是非马尔可夫的(non-Markovian),策略必须依赖历史。
- 现状有两条差距:一是学习型策略(排行榜)离人类很远;二是 VLM 当规划器(只需选技能,执行由神谕完成)也只有 47.9%,离人类 90.5% 差距更大。这为后文“本文的 92.1%”提供了对照基线。
- 方括号数字为参考文献编号(与原文一致),参考文献列表本文档从略。
原文
We ask how far a simple configuration gets on this benchmark: a frozen frontier VLM whose context window holds the whole episode and whose outputs are the robot's actions. We use GPT-6-Astra without RoboMME-specific parameter updates and keep all sampled observations and its previous responses in one conversation. At every step it outputs the next end-effector pose and gripper command, which RoboMME's motion planner executes; this is RoboMME's waypoint action space, which the leaderboard accepts.
译文
我们要问的是:一个简单的配置在这个基准上能走多远——一个冻结的前沿 VLM,其上下文窗口(context window)容纳整个回合,其输出就是机器人的动作。我们使用 GPT-6-Astra,不做任何针对 RoboMME 的参数更新,并把所有抽样得到的观测以及它之前的回答保存在同一个对话中。在每一步,它输出下一个末端执行器位姿和夹爪指令,由 RoboMME 的运动规划器(motion planner)执行;这就是 RoboMME 的路点动作空间(waypoint action space),排行榜接受这种提交。
解释
这一段给出本文的研究问题和方法配置,关键词是“简单”。
- 记忆怎么实现?没有专门的记忆模块,靠的是“把所有东西都塞进上下文”。大模型的上下文本身就充当了记忆。
- 动作怎么输出?模型直接写出“TCP 去哪个坐标、什么朝向、夹爪开/合/保持”。从路点到关节运动的求解由 RoboMME 自带的运动规划器完成(这是基准提供的标准工具,不含特权物体信息)。
- 为什么强调“排行榜接受”?因为神谕规划器接口使用了仿真器特权状态,排行榜不收;而路点接口是合规提交方式,所以本文的 92.1% 可以和排行榜上的系统放在一起比较。
原文
Neither ingredient is new. Frozen VLMs have recently been used as direct robot policies with interaction histories [7, 10, 16, 20], and on RoboMME a pretrained multimodal model already keeps the episode in context for a learned controller [8]. A hierarchical system has already used GPT-6-Astra to plan subtasks for a RoboMME-trained policy [5]. Our contribution is a measurement and its explanation:
- a full-context baseline, in which the frozen model directly commands Cartesian waypoints, reaches 92.1% (737/800) in a single run, compared with prior systems that differ in interface, training and context (Figure 1 and Table 1);
- an episode-level audit of all 63 failures (Figures 4 and 5). In the largest groups, the model named the demonstrated manner or explicitly stated the arrival it was waiting for, and the observable failures are completion conditions, unintended contact and timing;
- paired diagnostics in RoboMME's oracle-planner setting, where denser frames and a corrected prompt help GPT-6-Astra far more than GPT-4o on the same episodes.
译文
这两个要素都不是新的。冻结的 VLM 最近已被用作带交互历史的直接机器人策略 [7, 10, 16, 20];在 RoboMME 上,也已有一个预训练多模态模型把回合保存在上下文中,为一个学习型控制器服务 [8]。还有一个分层系统已经用 GPT-6-Astra 为一个在 RoboMME 上训练的策略规划子任务 [5]。我们的贡献是一次测量及其解释:
- 一个全上下文基线(full-context baseline):冻结模型直接给出笛卡尔路点(Cartesian waypoints),单次运行达到 92.1%(737/800);并与在接口、训练和上下文上各不相同的已有系统进行了对比(图 1 和表 1);
- 对全部 63 次失败的逐回合审计(图 4 和图 5)。在最大的几组失败中,模型说出了演示的操作方式,或明确说出了它在等待的那一次到达;可观察到的失败在于完成条件、无意接触和时机;
- 在 RoboMME 神谕规划器设置下的配对诊断:在相同回合上,更密集的帧和修正后的提示词对 GPT-6-Astra 的帮助远大于对 GPT-4o 的帮助。
解释
这一段先主动承认新颖性有限,再界定贡献。这种写法在当下的大模型具身研究中很典型:方法本身(VLM 当策略、长上下文当记忆)已有人做过,本文的价值在于“在一个专门隔离记忆能力的基准上做了一次干净、透明的测量,并解释了结果”。
- 与 [8] 的区别:PonderPounce 用多模态大模型做“上下文引擎”,但实际动作由一个在 RoboMME 演示上训练的快速控制器输出;本文由大模型直接输出动作,不训练任何部件。
- 与 [5] 的区别:三层系统用 GPT-6-Astra 规划、VLA 执行;本文完全不需要 VLA。
- 贡献 1 是头条数字。“单次运行”(single run)意味着没有多次采样取最好,作者后面给出置信区间来刻画随机性。
- 贡献 2 是失败审计。“模型说出了演示的方式/等待的到达次数”这句话很关键:它暗示失败往往不是“忘了”,而是在执行层面(完成判据、碰到按钮、时机)出了问题——不过作者措辞小心,只说“可观察的失败”是什么。图 4、图 5 在第 5 节给出。
- 贡献 3 是配对诊断:用同一批回合比较两个模型在同一修正下的变化,排除“修正本身就把答案告诉了模型”这一解释。
原文
We do not claim to have solved robot memory or to identify an internal memory mechanism; Section 7 lists the controlled ablations needed for those claims.
译文
我们并不声称已经解决了机器人记忆问题,也不声称找到了某种内部记忆机制;第 7 节列出了支撑这类结论所需的受控消融实验。
解释
这是一句预先划定结论边界的声明。92.1% 只说明“这套系统在这个基准上做得很好”,并不能说明模型“在内部是怎么记住的”,也不能说明是哪部分上下文(旧图像、自己的文字描述、动作记录)在起作用。要回答这些问题需要消融(ablation,即有控制地去掉某个组成部分看性能如何变化),作者在第 7 节给出了实验设计但没有做。读者在理解全文时应始终记得这个边界。
表 1:各方报告的 RoboMME 800 个测试回合上的结果(%);排行榜快照日期 2026-09-29,访问于 2026-10-10 [19]。只有人类参考使用神谕技能接口;其余各行都发出底层动作或路点动作。RoboMME 排行榜还列出了一个执行真实子目标(ground-truth subgoals)的基线(84.1%)。
| System | Decision model | Action interface | RoboMME-trained parameters | Status | Runs | Success |
| Human players [9] | 18 participants | skill selection, oracle planner | – | reference | 1 | 90.5 |
| PonderPounce-9B [8] | Qwen3.5-9B context engine + \pi_{0.5}-initialized controller | joint angles | yes (1,587 demos) | leaderboard | 3 | 60.8 |
| 9\times data | same | joint angles | yes (14,400 episodes) | paper only | 3 | 75.5 |
| Three-tier [5] | GPT-6-Astra planner + RoboMME VLA + learned monitor | joint angles (VLA) | yes (VLA, monitor) | project report | 1 | 79.1 |
| Ours | GPT-6-Astra, full episode context | Cartesian waypoints, RoboMME motion planner | none | leaderboard | 1 | 92.1 |
原表注:Table 1 Results on the 800 RoboMME test episodes (%), as reported by each source; leaderboard snapshot of 2026-09-29, accessed 2026-10-10 [19]. Only the human reference uses the oracle skill interface; all other rows issue low-level or waypoint actions. RoboMME's leaderboard also lists a baseline that executes ground-truth subgoals (84.1%).
表 1 解读
各列含义:System(系统名称及来源文献);Decision model(做决策的模型是什么);Action interface(输出的动作形式:技能选择、关节角或笛卡尔路点);RoboMME-trained parameters(是否有参数在 RoboMME 数据上训练过,以及数据量);Status(成绩来源:参考值、排行榜正式提交、仅论文报告、项目报告);Runs(独立运行次数);Success(800 个测试回合的平均成功率)。
各行含义:
作者的提醒:这些系统在动作接口、训练、运行次数、成绩来源上都不同,所以表中的差距是“系统对系统”的差距,不能归因到某个单一设计(如“全上下文”或“路点接口”)。这是第 2 节末尾与第 4 节反复强调的一点。
各行含义:
- Human players:18 名受试者通过神谕接口操作,90.5%,作为参考上限。
- PonderPounce-9B:用 Qwen3.5-9B 作上下文引擎,控制器由 \pi_{0.5} 初始化后在 1,587 条演示上训练,输出关节角,排行榜第一,3 次运行平均 60.8%;其 9\times data 变体用 14,400 个回合训练,提升到 75.5%,但未提交排行榜。
- Three-tier:GPT-6-Astra 规划 + RoboMME 训练的 VLA 执行 + 学习型完成监视器,79.1%。
- Ours:GPT-6-Astra 全上下文,笛卡尔路点 + RoboMME 运动规划器,无任何训练参数,92.1%。
作者的提醒:这些系统在动作接口、训练、运行次数、成绩来源上都不同,所以表中的差距是“系统对系统”的差距,不能归因到某个单一设计(如“全上下文”或“路点接口”)。这是第 2 节末尾与第 4 节反复强调的一点。
2相关工作(Related Work)
基础模型作为机器人策略(Foundation models as robot policies)
原文
Language and vision-language models have served as high-level planners that choose among skills [1, 11, 13, 18], write programs [15] or compose spatial objectives [12], while vision-language-action models map observations to low-level actions after robot training [3, 4, 14, 17]. Several recent works use a frozen frontier VLM, often GPT-6-Astra, as the policy itself through a compact action interface. RoboICL conditions frozen GPT-6-Astra on demonstrations and a bounded observation–action–outcome history and outputs action chunks [16]. Zhang et al. evaluate off-the-shelf GPT-6-Astra on RoboDojo with end-effector target tools, keeping images from only the last two turns, and report 38.7% success in its memory category [20]. GPT-Policy selects Cartesian waypoint and gripper tools using task references and online interaction history [7]. Show-Harness and RoboDawn connect VLMs to robots through discrete semantic or motion commands [6, 10]. These works evaluate other benchmarks or real robots; we study one benchmark designed to isolate memory, keep the full episode in context, and analyse its failures episode by episode.
译文
语言模型和视觉-语言模型曾被用作高层规划器(high-level planner),在技能之间进行选择 [1, 11, 13, 18]、编写程序 [15] 或组合空间目标 [12];而视觉-语言-动作模型(vision-language-action model, VLA)则在机器人数据上训练后,把观测映射为底层动作 [3, 4, 14, 17]。最近有若干工作通过紧凑的动作接口,把冻结的前沿 VLM(通常是 GPT-6-Astra)本身当作策略。RoboICL 以演示和有界长度的“观测—动作—结果”历史为条件驱动冻结的 GPT-6-Astra,并输出动作块(action chunks) [16]。Zhang 等人在 RoboDojo 上评测了开箱即用的 GPT-6-Astra,使用末端执行器目标工具,只保留最近两轮的图像,并报告其在记忆类别中的成功率为 38.7% [20]。GPT-Policy 利用任务参考和在线交互历史来选择笛卡尔路点工具和夹爪工具 [7]。Show-Harness 和 RoboDawn 通过离散的语义命令或运动命令把 VLM 与机器人连接起来 [6, 10]。这些工作评测的是其他基准或真实机器人;我们研究的是一个专为隔离记忆而设计的基准,将完整回合保留在上下文中,并逐回合分析其失败。
解释
这一段把已有工作分成三条脉络,并定位本文:
- 大模型当高层规划器:如 SayCan [1](“Do as I can”)、Inner Monologue [11] 让模型挑技能;Code as Policies [15] 让模型写控制代码;VoxPoser [12] 让模型组合三维价值图。共同点是底层执行由别的模块完成。
- VLA:RT-2 [4]、OpenVLA [14]、\pi_0 [3]、\pi_{0.5} [17],需要大量机器人数据训练,直接输出底层动作。
- 冻结前沿 VLM 直接当策略:这是与本文最接近的一类。值得注意的是 Zhang 等人 [20]:同样是 GPT-6-Astra 和末端执行器接口,但只保留最近两轮图像,在 RoboDojo 的记忆类任务上只有 38.7%。这与本文“保留完整回合”形成对照,暗示上下文长度可能很重要——但由于基准不同,这只是旁证。
RoboMME 上的记忆(Memory on RoboMME)
原文
RoboMME's leaderboard compares memory designs for learned policies, from frame sampling and token dropping to recurrent memory [9]. Learned latent memories continue to be proposed [2]. PonderPounce uses a pretrained multimodal LLM as an episode context engine for a fast controller trained on RoboMME demonstrations [8]. Chen et al. use GPT-6-Astra to plan grounded subtasks that a RoboMME-trained VLA executes, with a learned completion monitor [5]. Table 1 sets these systems side by side. They differ in more than one factor, so the score differences cannot be attributed to the model, the context policy or the interface alone.
译文
RoboMME 排行榜比较了学习型策略的各种记忆设计,从帧采样、token 丢弃到循环记忆(recurrent memory) [9]。学习得到的隐式记忆(latent memory)方法也在不断被提出 [2]。PonderPounce 使用一个预训练多模态大语言模型作为回合上下文引擎(episode context engine),服务于一个在 RoboMME 演示上训练的快速控制器 [8]。Chen 等人用 GPT-6-Astra 规划落地的子任务,由一个在 RoboMME 上训练的 VLA 执行,并配有一个学习得到的完成监视器(completion monitor) [5]。表 1 将这些系统并列展示。它们在不止一个因素上存在差异,因此分数差异不能单独归因于模型、上下文策略或接口。
解释
这一段聚焦“在 RoboMME 上,别人是怎么处理记忆的”。
- 帧采样 / token 丢弃 / 循环记忆:这是学习型策略处理长历史的三种常见手段——要么只取部分帧,要么丢掉部分视觉 token 以节省计算,要么用 RNN 式的状态把历史压缩成固定长度的向量。它们都是在“记多少”和“算得起”之间折中。
- 本文的做法则是“不折中”:除了步长 k 的抽帧外,什么都不丢,靠前沿模型的长上下文能力硬扛。
- 最后一句再次强调混杂因素(confounds):模型、上下文策略、接口同时不同,单看分数无法说明到底是哪一个因素起作用。这是严谨的实验写作习惯。
3实验设置(Setup)
回合与观测(Episodes and observations)
原文
Each RoboMME episode provides a language goal g and, for 9 of the 16 tasks, a video V that specifies the task or shows a scene that later changes (a demonstration, or objects that are later hidden). At decision step i the simulator returns the frames recorded since the previous decision, F_i = (f_{i,0}, \dots, f_{i,n_i-1}), from a fixed front camera (256\times256), together with a wrist-camera image and the robot's proprioception. The simulator records one frame per control step, at 20 steps per second of simulated time.
译文
每个 RoboMME 回合提供一个语言目标 g;对于 16 个任务中的 9 个,还提供一段视频 V,用来说明任务,或展示一个之后会发生变化的场景(一段演示,或之后会被藏起来的物体)。在决策步 i,仿真器返回自上一次决策以来记录的帧 F_i = (f_{i,0}, \dots, f_{i,n_i-1}),它们来自一个固定的前置相机(分辨率 256\times256),同时返回一张腕部相机(wrist camera)图像和机器人的本体感知(proprioception)信息。仿真器每个控制步记录一帧,仿真时间中每秒 20 个控制步。
解释
这一段定义了模型能拿到的输入,并引入后文公式要用的符号:
- g:自然语言任务目标,例如“按下按钮,让方块在第二次到达目标时停下”。
- V:任务视频,只有 9 个任务有。它可能是演示(模仿类任务需要学“怎么做”),也可能是一段“之后会被遮挡”的场景(恒存类任务需要记住“东西原来在哪”)。
- i:决策步编号。注意“决策步”和“控制步”不同:模型每做一次决策,运动规划器可能要执行几十到上千个控制步才能走到目标路点。
- F_i:第 i 次决策时新增的一段帧序列,f_{i,j} 是其中第 j 帧,n_i 是这一段的帧数(取决于上一个动作执行了多少控制步)。
- 本体感知:机器人自身状态,例如关节角、夹爪开合度、TCP 位姿。
- 20 步/秒:一帧对应 0.05 秒仿真时间,这个换算在下一段计算“每隔多少秒看到一帧”时会用到。
上下文(Context)
原文
We subsample each clip F = (f_0, \dots, f_{n-1}) with stride k,
S_k(F) = \{ f_j : j \equiv 0 \pmod{k} \} \cup \{ f_{n-1} \}, \tag{1}
always including the latest frame, and condition the model on all sampled observations and its previous responses, a_i \sim \pi\bigl(\,\cdot \mid g,\ S_k(V),\ S_k(F_1),\ y_1,\ \dots,\ S_k(F_i)\bigr), \tag{2}
where y_j is the model's answer at step j, which includes a free-text description of what happened as well as the action. The policy \pi is GPT-6-Astra queried through the Responses API, with all turns of an episode chained in one conversation. The harness uses the API's default sampling settings, which every response records as medium reasoning effort, temperature 1, top-p 0.98 and truncation disabled. Apart from the subsampling S_k, nothing is summarized or dropped. With k = 3, the model sees one front-camera frame every 0.15 s of simulated time; with k = 30, one every 1.5 s. RoboMME's VLM pipeline encodes the frames as 30 fps video and samples it at 1 frame/s for Gemini, so its effective spacing is also 30 frames, or 1.5 s of simulated time. 译文
我们以步长(stride)k 对每一段片段 F = (f_0, \dots, f_{n-1}) 进行子采样:
S_k(F) = \{ f_j : j \equiv 0 \pmod{k} \} \cup \{ f_{n-1} \},(1)
即始终包含最新一帧;并让模型以所有采样得到的观测及其之前的回答为条件: a_i \sim \pi\bigl(\,\cdot \mid g,\ S_k(V),\ S_k(F_1),\ y_1,\ \dots,\ S_k(F_i)\bigr),(2)
其中 y_j 是模型在第 j 步的回答,既包括对所发生事情的自由文本描述,也包括动作本身。策略 \pi 就是通过 Responses API 调用的 GPT-6-Astra,一个回合的所有轮次串联在同一个对话中。测试框架(harness)使用 API 的默认采样设置;每次响应记录的设置均为:中等推理强度(medium reasoning effort)、温度(temperature)1、top-p 0.98、截断(truncation)关闭。除子采样 S_k 外,没有任何内容被摘要或丢弃。当 k = 3 时,模型每隔 0.15 s 仿真时间看到一帧前置相机图像;当 k = 30 时,每隔 1.5 s 看到一帧。RoboMME 的 VLM 流水线把帧编码为 30 fps 的视频,并以每秒 1 帧的频率为 Gemini 采样,因此其有效间隔同样是 30 帧,即 1.5 s 仿真时间。 解释
这是全文唯一的两个公式,定义了“模型看到什么”和“模型怎么决策”。 公式 (1):抽帧规则。
- F 是一段帧序列,下标从 0 到 n-1;k 是步长。
- j \equiv 0 \pmod{k} 表示“j 能被 k 整除”,即取第 0, k, 2k, \dots 帧。
- \cup\{f_{n-1}\}:无论最后一帧的下标是不是 k 的倍数,都强制加入。这样模型总能看到动作执行完后的最新状态,不会因为抽样恰好漏掉最后一帧而“看不到现在”。
- 例子:若某段有 n = 10 帧、k = 3,则取 f_0, f_3, f_6, f_9;若 n = 8,则取 f_0, f_3, f_6 再加上 f_7。
- a_i:第 i 步的动作;“\sim”表示从分布中采样(温度为 1,所以模型输出带随机性)。
- \pi(\cdot \mid \dots):竖线右边是条件,也就是喂给模型的全部上下文:目标 g、抽样后的任务视频 S_k(V)、每一步的抽样帧 S_k(F_1),\dots,S_k(F_i),以及模型自己之前的回答 y_1,\dots,y_{i-1}(公式中用省略号表示,按时间交错排列)。
- y_j 不只是动作,还含有模型对“刚才发生了什么”的文字描述。这些描述相当于模型给自己写的“笔记”,会成为后续步骤的上下文,是一种潜在的记忆通道。第 7 节指出,目前还没法分辨记忆到底来自旧图像还是这些文字笔记。
- “所有轮次串联在同一个对话中”:每次请求都会把完整历史一起发出去(借助 API 的会话链),因此模型看到的是真正的全历史,而不是框架挑选后的片段。
- 默认采样参数(温度 1、top-p 0.98):作者没有调采样超参数,也没有为了稳定性把温度调成 0,这让结果更像“开箱即用”的能力。
- 时间换算:每帧 0.05 s,所以 k=3 对应 3\times0.05=0.15 s,k=30 对应 1.5 s。RoboMME 原论文给 Gemini 的设置等效于 k=30。这为第 6 节“更密集的帧(D)”这一修正埋下伏笔:在神谕设置下沿用 k=30 时,很多短暂事件(如容器交换)会被漏掉。
路点接口(Waypoint interface)
原文
Each action is a waypoint a_i = (x, r, \gamma): a tool-center-point (TCP) position x \in \mathbb{R}^3, an orientation r (roll, pitch, yaw) and a gripper command \gamma \in \{-1, 0, 1\} (-1 close, 0 keep, 1 open), all in the world frame. RoboMME's motion planner moves the arm to the commanded pose, with no snapping to objects and no privileged state. This is control at the level of end-effector waypoints, not joint or actuator commands. Besides the images, the model receives the TCP pose, finger positions, elapsed control steps and the camera intrinsics and extrinsics, which RoboMME exposes as optional observations; it never receives depth, privileged object state or the benchmark's oracle subgoal annotations. Its system prompt, ours since RoboMME provides none for this setting, is shared by all tasks apart from one sentence stating the robot's hardware in PatternLock and RouteStick (it holds a stick, so the gripper command is ignored). The prompt describes the action format, the world frame, general properties of the robot interface (motion timing, gripper behaviour) and one convention: left and right in task instructions are the robot's, and the front camera, which faces the robot, shows them mirrored. RoboMME's instructions do not say whose left is meant, while its own oracle-planner prompts state such conventions for individual tasks; we state it once for all tasks. We use stride k = 3 for the front camera and add the current wrist-camera frame at each step.
译文
每个动作是一个路点 a_i = (x, r, \gamma):工具中心点(tool-center-point, TCP)位置 x \in \mathbb{R}^3、姿态 r(滚转 roll、俯仰 pitch、偏航 yaw)以及夹爪指令 \gamma \in \{-1, 0, 1\}(-1 闭合,0 保持,1 张开),全部在世界坐标系(world frame)下表示。RoboMME 的运动规划器把机械臂移动到指令位姿,不会自动吸附(snap)到物体上,也不使用特权状态。这是末端执行器路点层级的控制,而非关节或执行器层级的指令。除图像外,模型还接收 TCP 位姿、手指位置、已经过的控制步数以及相机内参和外参(camera intrinsics and extrinsics),这些是 RoboMME 提供的可选观测;模型从不接收深度信息、特权物体状态或基准的神谕子目标标注。其系统提示词(system prompt)由我们编写(因为 RoboMME 在此设置下没有提供),所有任务共用,只是在 PatternLock 和 RouteStick 中多一句说明机器人硬件的话(机器人握着一根棍子,因此夹爪指令被忽略)。提示词描述了动作格式、世界坐标系、机器人接口的一般特性(运动时序、夹爪行为)以及一条约定:任务指令中的“左”和“右”是指机器人的左右,而面朝机器人的前置相机所显示的左右是镜像的。RoboMME 的指令并没有说明是谁的左边,而它自己的神谕规划器提示词会针对个别任务说明此类约定;我们则为所有任务统一说明一次。前置相机使用步长 k = 3,并在每一步加入当前的腕部相机帧。
解释
这一段定义动作空间和信息边界,是判断“这个 92.1% 有没有作弊”的关键。
- 动作 a_i=(x,r,\gamma):x 是 TCP 在三维空间中的坐标(单位米);r 是用欧拉角表示的朝向;\gamma 是三值夹爪指令。模型输出的就是“一组数字”,例如“x=(0.12,-0.05,0.03),r=(\pi,0,0),\gamma=-1”。
- “不会自动吸附到物体”:运动规划器只是忠实地把手臂移到指定位置,如果坐标差几厘米,就会抓空或碰到东西。也就是说,精确定位物体完全靠模型从二维图像 + 相机内外参中推断。
- 相机内参/外参:内参描述相机的焦距和光心,外参描述相机在世界中的位置与朝向。有了它们,模型才可能把图像上的像素位置换算到世界坐标——这是一个需要“心算”的几何推理过程。
- 明确不给的信息:深度图、物体真实位姿、神谕子目标。这保证了它与神谕接口有本质区别。
- 左右约定:前置相机面对机器人,所以图像中的左边是机器人的右边。这一句看似细节,第 7 节透露它非常关键:早期一次没有这条说明的完整运行中,模型在 SwingXtimes 的 50 个回合上全部失败。
- 腕部相机只给当前帧,不保留历史,因此“记忆”主要来自前置相机的历史帧和文字描述。
神谕规划器接口(Oracle-planner interface)
原文
For comparison with RoboMME's VLM evaluation, the model can instead output a_i = (c, p): a skill c from the task's fixed option list and an image point p \in [0, 1000]^2. RoboMME's oracle planner then executes c on the object nearest p using privileged simulator state. This is the setting of RoboMME's Table 11 and of its human players. The leaderboard does not accept it. Here we use RoboMME's own task prompts and query templates, the front camera only, and k = 30 (Figure 2).
译文
为了与 RoboMME 的 VLM 评测进行比较,模型也可以改为输出 a_i = (c, p):从任务固定选项列表中选出的一个技能 c,以及一个图像点 p \in [0, 1000]^2。随后 RoboMME 的神谕规划器利用仿真器的特权状态,在距离 p 最近的物体上执行 c。这正是 RoboMME 论文表 11 及其人类玩家所用的设置。排行榜不接受这种设置。在此我们使用 RoboMME 自己的任务提示词和查询模板,只用前置相机,并取 k = 30(图 2)。
解释
这是第二种动作接口,仅用于诊断和与 RoboMME 原论文对齐。
- c:一个高层技能名,例如“pick up”“press button”“remain static”,从任务提供的固定列表中选。
- p\in[0,1000]^2:归一化的图像坐标(把图像宽高都缩放到 0–1000),模型只需指出“大概在哪里”,神谕规划器会自动找到最近的物体并精确执行。
- 与路点接口相比,这里的控制难度几乎为零,模型只负责“决定做什么、对谁做”。因此它更纯粹地考察高层决策与记忆,但也会引入神谕接口自身的怪癖(第 6 节会看到 PickHighlight 和 StopCube 的问题都源于此)。
- 为与原论文可比,作者刻意沿用其提示词、只用前置相机、k=30,代价是这一设置与路点设置在多个因素上不同。
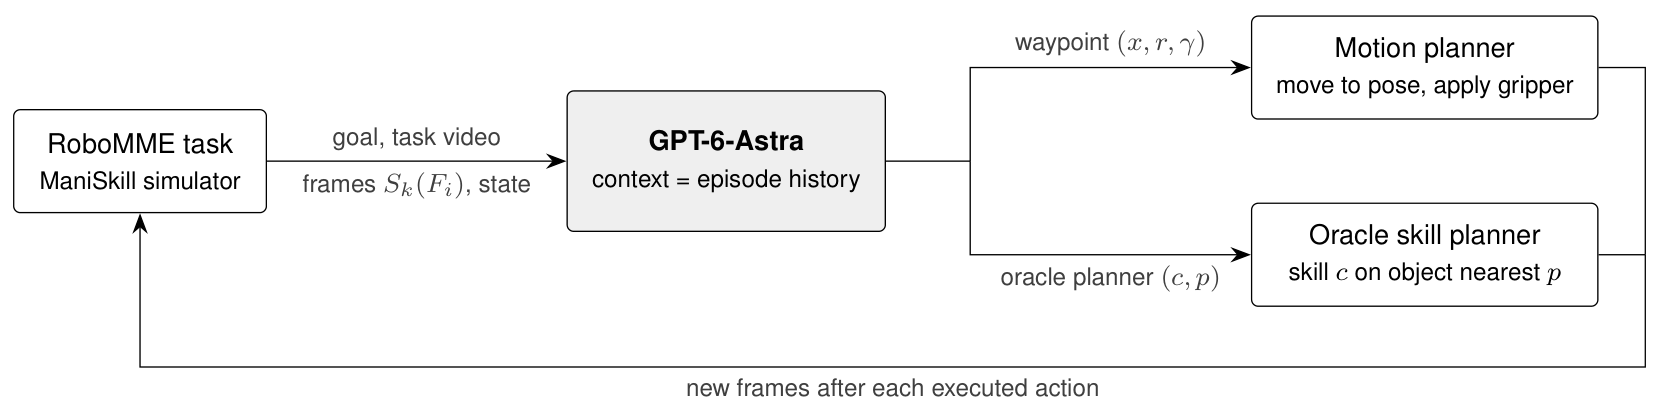
图 2:模型接收目标、任务视频以及所发生一切的子采样帧,并把自己之前的回答保留在上下文中。在路点设置(排行榜)下,它给出每一个末端执行器位姿;在 RoboMME 的神谕规划器设置(仅用于诊断)下,它选择一个由神谕执行的技能。
原图注:Figure 2 The model receives the goal, the task video and subsampled frames of everything that happens, and keeps its own previous answers in context. In the waypoint setting (leaderboard) it commands every end-effector pose; in RoboMME's oracle-planner setting (diagnostic only) it selects a skill that an oracle executes.
图 2 解读
这是系统框图,从左到右读:
- RoboMME task(ManiSkill simulator):任务环境,基于 ManiSkill 物理仿真器。
- 中间箭头上方“goal, task video”是回合开始时一次性提供的信息;下方“frames S_k(F_i), state”是每一步提供的抽样帧和本体状态,对应公式 (2) 的条件项。
- GPT-6-Astra(context = episode history):灰色方框强调模型的上下文就是整个回合的历史——这是全文方法的核心。
- 右侧分为两条支路:上方 Motion planner,接收路点 (x,r,\gamma),执行“移动到位姿、操作夹爪”;下方 Oracle skill planner,接收 (c,p),执行“对 p 最近的物体施加技能 c”。两条支路是互斥的两种实验设置,不是同时使用。
- 底部回环“new frames after each executed action”:每执行完一个动作,新帧回到模型,形成闭环。
表 2:每个任务 50 个测试回合上的成功率(%)。^\dagger此前报告的人类参考成绩 [9],使用的是神谕技能接口而非路点。^\ddaggerPonderPounce-9B 的排行榜条目,关节角控制,3 次运行的均值 [8]。GPT-6-Astra 为单次运行。粗体表示达到或高于人类参考的成绩。
| Suite(套件) | Task(任务) | Human^\dagger | PP-9B^\ddagger | GPT-6-Astra |
| Counting(计数) | BinFill | 96 | 50.7 | 98 |
| PickXtimes | 100 | 93.3 | 100 | |
| SwingXtimes | 80 | 72.0 | 98 | |
| StopCube | 78 | 82.7 | 54 | |
| Permanence(恒存) | VideoUnmask | 90 | 94.7 | 94 |
| VideoUnmaskSwap | 92 | 25.3 | 96 | |
| ButtonUnmask | 92 | 97.3 | 100 | |
| ButtonUnmaskSwap | 90 | 34.0 | 98 | |
| Reference(指代) | PickHighlight | 92 | 85.3 | 98 |
| VideoRepick | 92 | 40.7 | 100 | |
| VideoPlaceButton | 98 | 83.3 | 100 | |
| VideoPlaceOrder | 90 | 79.3 | 98 | |
| Imitation(模仿) | MoveCube | 90 | 81.3 | 54 |
| InsertPeg | 98 | 6.0 | 92 | |
| PatternLock | 84 | 12.7 | 100 | |
| RouteStick | 86 | 34.7 | 94 | |
| Average(平均) | 90.5 | 60.8 | 92.1 |
原表注:Table 2 Success rate (%) on the 50 test episodes of each task. ^\daggerPreviously reported human-reference score [9], obtained with the oracle skill interface rather than waypoints. ^\ddaggerPonderPounce-9B leaderboard entry, joint-angle control, mean of 3 runs [8]. GPT-6-Astra is a single run. Bold marks scores at or above the human reference.
表 2 解读
各列:Suite 是任务套件(对应记忆类型);Task 是任务名;Human 是人类参考(神谕接口);PP-9B 是排行榜第一 PonderPounce-9B(关节角控制,3 次平均,所以有小数);GPT-6-Astra 是本文(路点接口,单次运行,每个任务 50 回合,所以成绩都是 2 的倍数)。
各行:16 个任务按 4 个套件分组,最后一行是 16 个任务的平均。任务名大致可以望文生义:BinFill(往箱子里放指定数量的物体)、PickXtimes(抓起放下若干次)、SwingXtimes(左右摆动若干次)、StopCube(在方块第 N 次经过目标时按按钮)、VideoUnmask/ButtonUnmask(记住被容器盖住的方块,Swap 变体中容器还会交换位置)、PickHighlight(抓起曾被高亮的物体)、VideoRepick(重新抓起视频中被抓过的那个)、VideoPlaceButton/VideoPlaceOrder(按视频的顺序放置/按按钮)、MoveCube(以演示的方式移动方块)、InsertPeg(以演示的方式插销)、PatternLock/RouteStick(用棍子复现演示的轨迹)。
关键数字:
各行:16 个任务按 4 个套件分组,最后一行是 16 个任务的平均。任务名大致可以望文生义:BinFill(往箱子里放指定数量的物体)、PickXtimes(抓起放下若干次)、SwingXtimes(左右摆动若干次)、StopCube(在方块第 N 次经过目标时按按钮)、VideoUnmask/ButtonUnmask(记住被容器盖住的方块,Swap 变体中容器还会交换位置)、PickHighlight(抓起曾被高亮的物体)、VideoRepick(重新抓起视频中被抓过的那个)、VideoPlaceButton/VideoPlaceOrder(按视频的顺序放置/按按钮)、MoveCube(以演示的方式移动方块)、InsertPeg(以演示的方式插销)、PatternLock/RouteStick(用棍子复现演示的轨迹)。
关键数字:
- 粗体共 13 个,即 13/16 个任务达到或超过人类。没有加粗的三个是 StopCube(54)、MoveCube(54)和 InsertPeg(92,低于人类 98)。
- 与 PP-9B 对比,差距最大的是需要“看过一次就记住细节”的任务:InsertPeg(6.0 \to 92)、PatternLock(12.7 \to 100)、VideoUnmaskSwap(25.3 \to 96)、ButtonUnmaskSwap(34.0 \to 98)。这些正是学习型策略最难泛化的类型。
- 反过来,在 StopCube 和 MoveCube 上 PP-9B 更好(82.7、81.3 vs. 54),说明本文方法的短板集中在这两项上——这正是第 5 节失败分析的重点。
评测协议(Protocol)
原文
We follow RoboMME's evaluation script: the 50 test episodes of each task with their fixed seeds, a limit of 1300 control steps, and success as judged by the environment, with one run per episode. The main configurations cover all 800 episodes; the oracle-setting corrections of Section 6 rerun only the tasks they affect and reuse the outcomes of the others. Simulator errors and unusable answers count as failures, as do episodes in which the model declares the task complete before the environment judges success, three consecutive actions that execute no steps, and a cap of 150 model calls (never reached; the maximum was 31). No episode is excluded or retried. We use RoboMME at commit
856bc3a. We report 95% Wilson intervals and compare configurations on the same episodes with exact McNemar tests. These intervals describe sampling over episodes only. They do not account for adaptive development on the test split (Section 7), for API drift, or for generalization to new tasks.译文
我们遵循 RoboMME 的评测脚本:每个任务 50 个测试回合,使用其固定随机种子;控制步上限为 1300;成功与否由环境判定;每个回合运行一次。主要配置覆盖全部 800 个回合;第 6 节中神谕设置下的修正只重跑受影响的任务,其他任务沿用原结果。仿真器错误和不可用的回答都计为失败;以下情形也计为失败:模型在环境判定成功之前就宣布任务完成、连续三个动作都没有执行任何控制步、以及达到 150 次模型调用的上限(从未达到;最大值为 31)。没有任何回合被排除或重试。我们使用 RoboMME 的提交版本
856bc3a。我们报告 95% Wilson 置信区间,并用精确 McNemar 检验(exact McNemar test)在相同回合上比较不同配置。这些区间只描述了对回合进行抽样所带来的不确定性,并未考虑在测试集上的自适应开发(第 7 节)、API 漂移(API drift)或对新任务的泛化。解释
这一段是实验严谨性的基础,规定了什么算成功、什么算失败、统计怎么做。
- 固定种子 + 单次运行 + 不重试:每个回合的初始布局是确定的,模型只有一次机会,避免了“多跑几次挑最好”的偏差。
- 从严计失败:模型自己说“做完了”但环境不认可,直接算失败;这条规则正是 MoveCube 23 个失败的来源(第 5 节)。连续三个“空动作”算失败,是为了防止模型卡死。
- Wilson 区间:对成功率 \hat p 的置信区间,比常见的正态近似 \hat p \pm 1.96\sqrt{\hat p(1-\hat p)/n} 在 \hat p 接近 0 或 1 时更可靠。本文 92.1% 的区间是 [90.1, 93.8]。
- 精确 McNemar 检验:比较两种配置在同一批回合上的结果时,只有“结果翻转”的回合有信息量——设 b 为“原来失败、现在成功”的数量,c 为“原来成功、现在失败”的数量,在“两配置无差别”的原假设下,b 服从参数为 (b+c, 0.5) 的二项分布,由此算出精确 p 值。第 6 节的 119/3 和 26/17 就是 b/c。
- 最后两句是自我约束:置信区间只反映“回合抽样”的随机性,不反映作者在测试集上调参带来的乐观偏差,也不反映 API 背后模型悄悄更新(漂移)的影响。
4路点策略结果(Waypoint-Policy Results)
总体结果(Overall)
原文
Commanding the end effector itself, GPT-6-Astra succeeds in 737 of 800 episodes, 92.1% [90.1, 93.8] (Table 2). This is 31.3 points above the best leaderboard entry (60.8%), a learned policy trained on RoboMME demonstrations. The same entry's authors report 75.5% with nine times more training data [8], and the three-tier system that uses GPT-6-Astra as a planner reports 79.1% [5], 13.0 points below our run. Because these systems also differ in execution stack, training and number of runs, these gaps measure systems rather than any single design choice. The aggregate is numerically above the previously reported human reference of 90.5%, which lies inside our interval and was obtained with a different interface. Per task, the score is at or above the human reference on 13 of 16 tasks: three counting tasks, every permanence and reference task, and two imitation tasks, PatternLock and RouteStick. On these two and on InsertPeg, where it reaches 92% against 98% for humans, the best leaderboard entry reaches 6.0–34.7%. Two tasks account for 46 of the 63 failures: MoveCube and StopCube (54% each). Figure 3 shows the same results by suite and by task.
译文
在亲自控制末端执行器的情况下,GPT-6-Astra 在 800 个回合中成功 737 个,即 92.1% [90.1, 93.8](表 2)。这比排行榜最佳条目(60.8%,一个在 RoboMME 演示上训练的学习型策略)高出 31.3 个百分点。该条目的作者报告,使用九倍训练数据时可达 75.5% [8];而把 GPT-6-Astra 用作规划器的三层系统报告了 79.1% [5],比我们的运行低 13.0 个百分点。由于这些系统在执行栈、训练和运行次数上也各不相同,这些差距衡量的是系统整体,而非任何单一的设计选择。总成绩在数值上高于此前报告的人类参考 90.5%,但后者落在我们的置信区间之内,且是用不同接口取得的。按任务看,在 16 个任务中的 13 个上成绩达到或超过人类参考:三个计数任务、全部恒存任务和指代任务,以及两个模仿任务 PatternLock 和 RouteStick。在这两个任务以及 InsertPeg(本文 92%,人类 98%)上,排行榜最佳条目只有 6.0%–34.7%。63 次失败中有 46 次来自两个任务:MoveCube 和 StopCube(各 54%)。图 3 按套件和按任务展示了同样的结果。
解释
这一段是主结果的解读,充满了细致的限定。
- 数字核对:737/800 = 92.125\%;92.1-60.8=31.3;92.1-79.1=13.0。
- “超过人类”要打折扣:90.5 落在 [90.1, 93.8] 区间内,统计上不能说显著高于人类;再加上接口不同,作者只说“数值上高于”。
- 失败高度集中:50\times(1-0.54)=23,两个任务各 23 次失败,合计 46 次,占 63 次的 73%。其余 14 个任务总共只失败 17 次。这意味着如果能修好这两个任务的特定问题,成绩还能大幅提高,也引出第 5 节的深入分析。
- 模仿类任务的对比最醒目:PatternLock、RouteStick、InsertPeg 需要从一段演示视频中提取精确的轨迹或操作方式,学习型策略几乎无法泛化(6.0%–34.7%),而大模型能“看一遍就照做”。
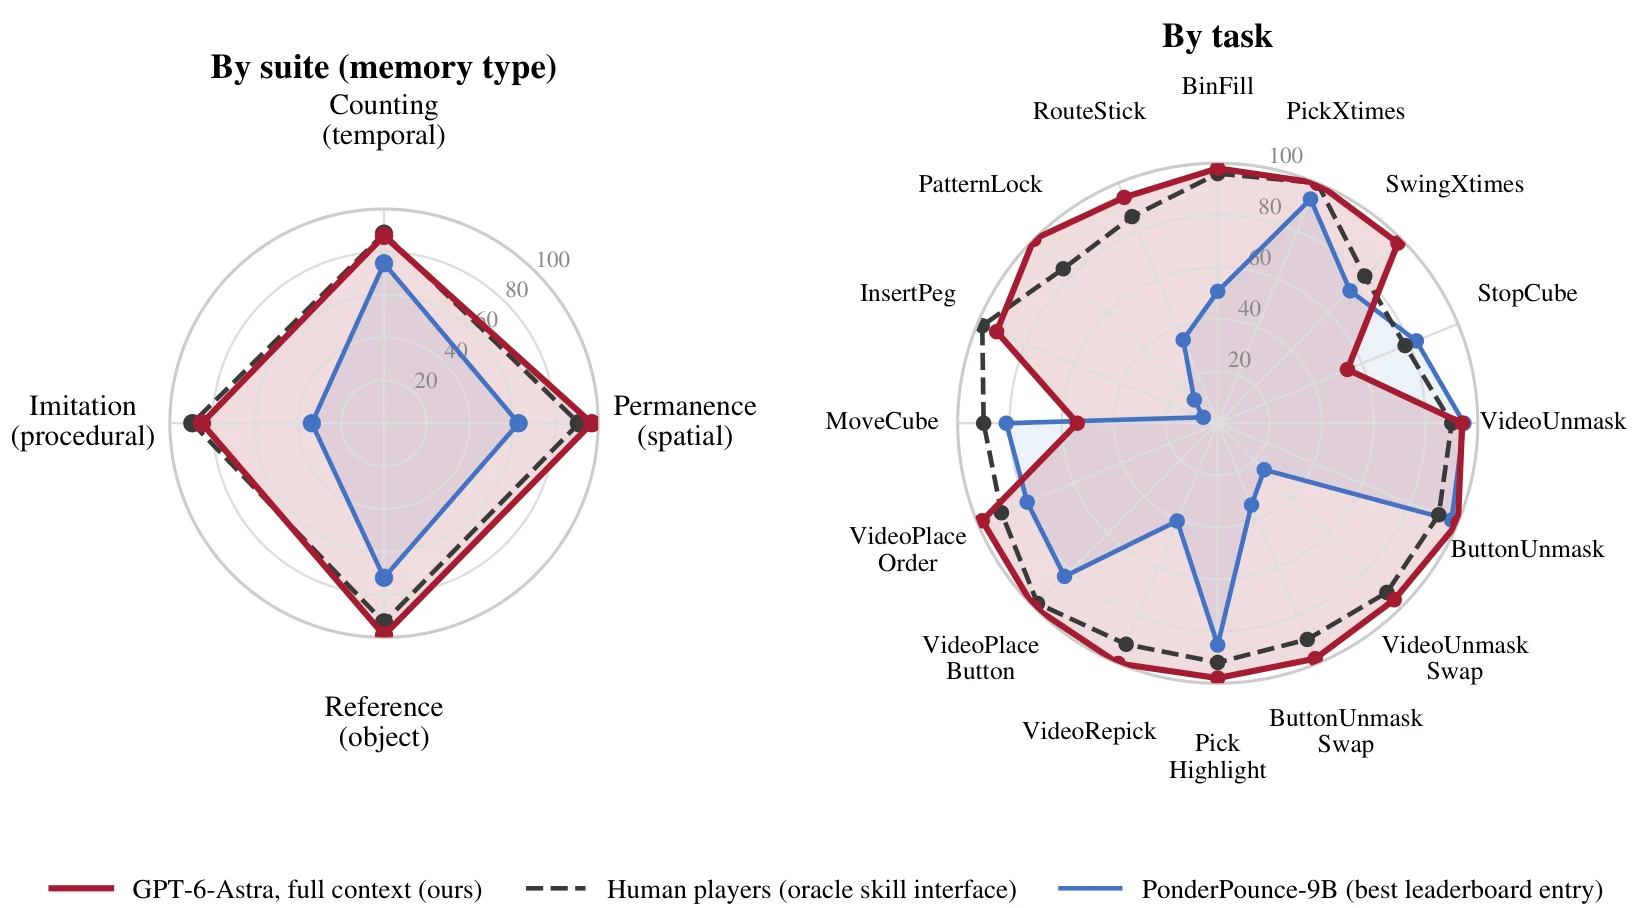
图 3:RoboMME 测试集上的成功率(%):左图按套件统计,并标出各套件针对的记忆类型(每个套件取其四个任务的均值);右图按任务统计。GPT-6-Astra 为单次运行;人类成绩使用神谕技能接口取得;PonderPounce-9B 是排行榜最佳条目(关节角控制,3 次运行的均值)。数值与表 2 一致。
原图注:Figure 3 Success rate (%) on the RoboMME test split by suite, with the memory type each suite targets (left; mean of its four tasks), and by task (right). GPT-6-Astra is a single run; the human score was obtained with the oracle skill interface; PonderPounce-9B is the best leaderboard entry (joint-angle control, mean of 3 runs). Values as in Table 2.
图 3 解读
两张雷达图(极坐标图),径向轴是成功率,从圆心 0 到外圈 100,同心圆刻度为 20、40、60、80、100。三条曲线:红色实线为本文 GPT-6-Astra,黑色虚线为人类(神谕接口),蓝色实线为 PonderPounce-9B。
- 左图(按套件):四个顶点是 Counting(时间记忆)、Permanence(空间记忆)、Reference(物体记忆)、Imitation(程序记忆)。红线和黑虚线几乎重合且都接近外圈,蓝线明显内缩,尤其在 Imitation 方向上缩得最厉害——模仿类是学习型策略最大的短板。红线在 Counting 和 Imitation 上略低于其他两个方向,正是被 StopCube 和 MoveCube 拉低的。
- 右图(按任务):16 个顶点对应 16 个任务。红线大多贴着外圈,只在 StopCube 和 MoveCube 两处向内凹(都到 54 左右),形成两个明显的“缺口”;而在这两处,蓝线反而更靠外。蓝线则在 InsertPeg、PatternLock、RouteStick、VideoUnmaskSwap、ButtonUnmaskSwap、VideoRepick 等方向深深凹陷。
资源消耗(Resources)
原文
The model made 7,563 calls, 9.5 per episode on average (median 8, 95th percentile 20, maximum 31). Each call took 18.3 s on average as measured by the client. The server-reported generation time had a median of 14 s, a 90th percentile of 33 s, a 95th percentile of 45 s and a maximum of 77 s. An episode used a median of 148 images (maximum 518). Its final request carried a median of 16.5k input tokens (maximum 49.9k). From the API-reported token counts, at $10, $1, $12.50 and $50 per million fresh-input, cached-input, cache-write and output tokens, the run cost $309 ($0.39 per episode); nearly all input tokens were cache reads or writes. The simulator waits during each call, so this is a capability baseline, not a real-time controller.
译文
模型共调用了 7,563 次,平均每回合 9.5 次(中位数 8,第 95 百分位数 20,最大值 31)。按客户端测量,每次调用平均耗时 18.3 s。服务器报告的生成时间中位数为 14 s,第 90 百分位数为 33 s,第 95 百分位数为 45 s,最大值为 77 s。每个回合使用的图像数中位数为 148 张(最多 518 张)。每个回合最后一次请求携带的输入 token 数中位数为 16.5k(最多 49.9k)。根据 API 报告的 token 计数,按每百万新输入 token、缓存输入 token、缓存写入 token 和输出 token 分别为 10 美元、1 美元、12.50 美元和 50 美元计算,本次运行共花费 309 美元(每回合 0.39 美元);几乎所有输入 token 都是缓存读取或缓存写入。仿真器在每次调用期间处于等待状态,因此这是一个能力基线,而不是实时控制器。
解释
这一段回答“代价有多大、能不能实用”。
- 调用次数少:平均每回合只有 9.5 次决策,因为每个路点往往对应一个完整的子动作(如“移到方块上方”),由运动规划器执行很多控制步。核对:7563/800\approx 9.45。
- 延迟很高:每次十几秒到一分多钟。真实机器人上这样等待是不可接受的,所以作者明确说这是“能力基线”——仿真器在模型思考时暂停时间,相当于给了模型无限的思考时间。这一点在评价“超过人类”时也应考虑。
- 上下文并不算大:最后一次请求中位数 16.5k token,最大约 5 万,远在前沿模型上下文上限之内,说明“全上下文”在这个基准上是可负担的。
- 提示缓存(prompt caching)降低了成本:因为每次请求都会重发完整历史,而历史前缀不变,API 可以缓存它;缓存读取的单价只有新输入的 1/10。总计 309 美元、每回合约 0.39 美元(309/800\approx0.386)。
5失败分析(Failure Analysis)
标注方法(Labelling)
原文
We label each of the 63 failed episodes with one primary class from its records: the logged terminal reason, the executed waypoints and their outcomes, the model's own descriptions, and task parameters read back from the environment after reset (the cube's schedule in StopCube, the MoveCube variant). Classes describe observable behaviour, not internal causes; no class asserts a “memory failure”. Every failure received exactly one class under the rules listed in Appendix A. Figure 4 shows the result, and Figure 5 shows one recorded rollout for each of the three most frequent tasks.
译文
我们根据每个失败回合的记录为全部 63 个失败回合各标注一个主类别。这些记录包括:日志中的终止原因、已执行的路点及其结果、模型自己的描述,以及在环境重置后从环境中读回的任务参数(StopCube 中方块的运动时间表、MoveCube 的变体类型)。类别描述的是可观察的行为,而非内部原因;没有任何类别断言存在“记忆失败”。每次失败都按照附录 A 列出的规则恰好获得一个类别。图 4 展示了结果,图 5 为三个失败最多的任务各展示了一次记录下来的执行过程(rollout)。
解释
这一段说明失败审计的方法论,重点是“只描述行为,不推断原因”。
- 证据来源:终止原因(如
unparseable、env_error)、路点执行情况、模型自述、环境的真实参数。其中“从环境读回参数”很关键——例如 StopCube 中方块何时到达目标,只有从环境里读出来才能判断按钮是早按还是晚按。 - 为什么不说“记忆失败”?因为从外部观察无法确定模型内部到底是“忘了”还是“记得但执行出错”。作者宁可用“提前宣布完成”“无意碰到按钮”这类中性标签。
- 互斥且穷尽:每个失败恰好一个类别,规则按固定顺序判定(附录 A),保证可复现,代码仓库中的脚本可以重新算出这些计数。
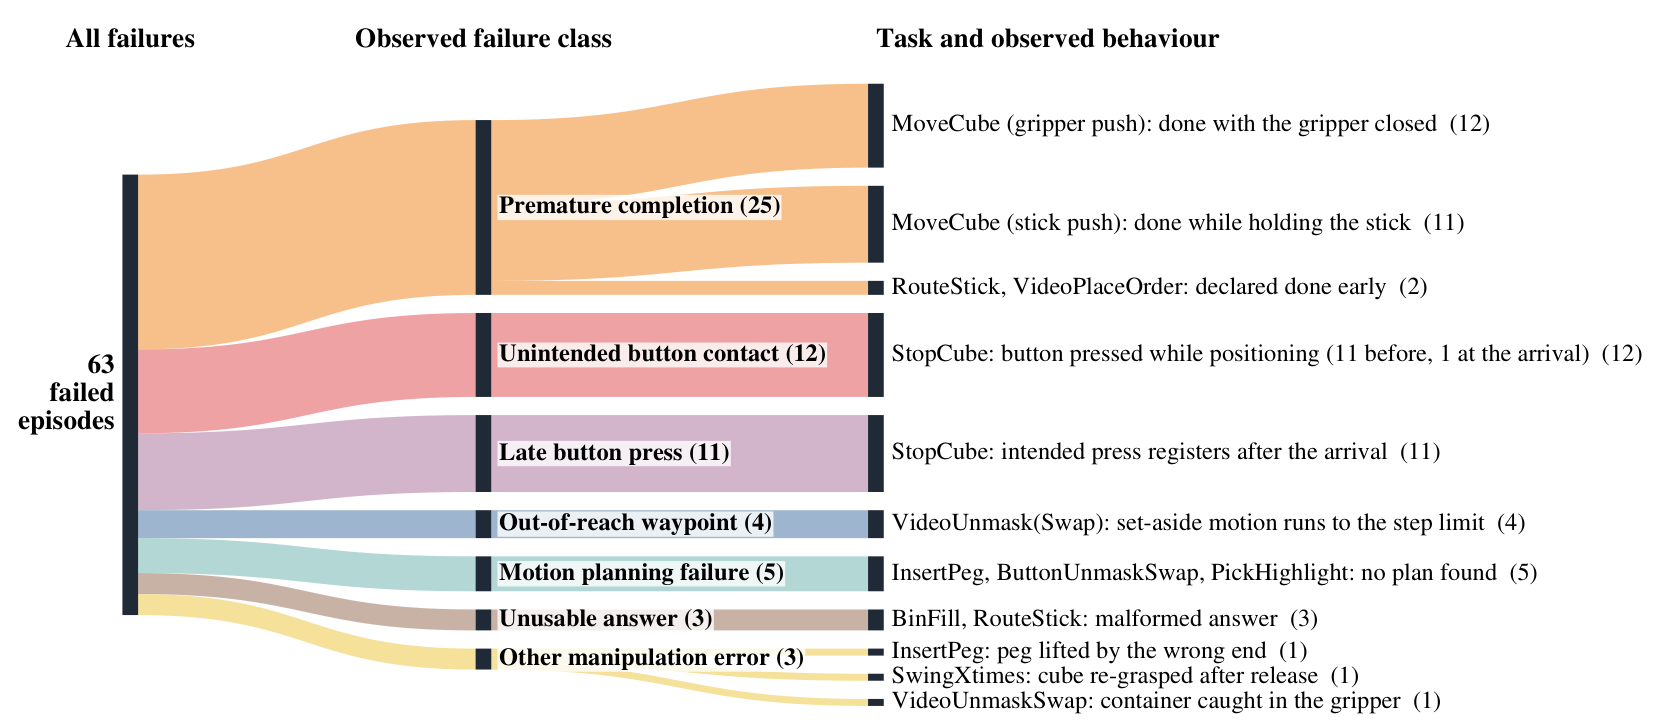
图 4:本次运行的全部 63 次失败(800 个回合中 737 个成功),按观察到的类别以及发生该失败的任务与行为分类。流带宽度与回合数成正比。类别依据回合记录确定(附录 A);它们描述的是行为,而非内部原因。
原图注:Figure 4 All 63 failures of the run (737 of 800 episodes succeeded), by observed class and by the task and behaviour in which they occur. Widths are proportional to episode counts. Classes are assigned from episode records (Appendix A); they describe behaviour, not internal causes.
图 4 解读
这是一张三列的桑基图(Sankey diagram),流带宽度与回合数成正比。
作用:用一张图同时呈现“失败是什么类型”和“发生在哪里”,直接支撑引言中贡献 2 的说法。
- 第一列 All failures:一根竖条代表全部 63 个失败回合。
- 第二列 Observed failure class:分成 7 个类别——提前宣布完成 Premature completion(25)、无意按钮接触 Unintended button contact(12)、按钮按晚 Late button press(11)、超出可达范围的路点 Out-of-reach waypoint(4)、运动规划失败 Motion planning failure(5)、不可用回答 Unusable answer(3)、其他操作错误 Other manipulation error(3)。
- 第三列 Task and observed behaviour:每个类别再细分到具体任务和行为。例如“提前宣布完成”分成 MoveCube 夹爪推动变体“夹爪闭合时宣布完成”(12)、MoveCube 棍子推动变体“仍握着棍子时宣布完成”(11)、RouteStick 和 VideoPlaceOrder“过早宣布完成”(2);“无意接触”全部来自 StopCube(定位时按下按钮,11 次在到达前、1 次恰在到达时);“按晚”全部来自 StopCube(有意按下但在到达之后才生效);“超出可达范围”来自 VideoUnmask(Swap)(放置动作一直执行到步数上限);“运动规划失败”来自 InsertPeg、ButtonUnmaskSwap、PickHighlight(找不到运动规划);“不可用回答”来自 BinFill、RouteStick(格式错误);“其他”三个各为 1 例。
作用:用一张图同时呈现“失败是什么类型”和“发生在哪里”,直接支撑引言中贡献 2 的说法。
提前宣布完成(Premature completion,25 例)
原文
In 25 episodes the model declared the task complete before the environment judged success. Twenty-three are in MoveCube, which has three variants: grasping and placing the cube, pushing it with the closed gripper, or pushing it with a stick. The model solved all 21 grasp-and-place episodes but only 5 of 17 gripper-push and 1 of 12 stick-push episodes. RoboMME's success check for the pushing variants requires the gripper to be open at the end. In all 23 failures, the model's first description names the demonstrated manner (pushing with the bar, or sliding the cube along the table without lifting it), and its last gripper command before declaring completion was to close: in 11 stick-push episodes it still held the stick (Figure 5, top), and in 12 gripper-push episodes the gripper was still closed. The remaining two are one RouteStick and one VideoPlaceOrder episode.
译文
在 25 个回合中,模型在环境判定成功之前就宣布任务已完成。其中 23 个属于 MoveCube。MoveCube 有三种变体:抓取并放置方块、用闭合的夹爪推动方块、或用棍子推动方块。模型解决了全部 21 个抓取放置回合,但在 17 个夹爪推动回合中只成功 5 个,在 12 个棍子推动回合中只成功 1 个。RoboMME 对推动类变体的成功判定要求最后夹爪处于张开状态。在全部 23 次失败中,模型的第一条描述都说出了演示的操作方式(用棍子推,或让方块沿桌面滑动而不抬起),而它在宣布完成之前的最后一个夹爪指令都是闭合:在 11 个棍子推动回合中它仍握着棍子(图 5 上),在 12 个夹爪推动回合中夹爪仍是闭合的。剩下的两例分别是一个 RouteStick 回合和一个 VideoPlaceOrder 回合。
解释
这是最大的失败类别,揭示了一个很有意思的现象:模型“懂了要怎么做”,却栽在一个隐含的成功判据上。
- 数字核对:21+5+1=27 个成功,50-27=23 个失败,即 MoveCube 的 54%。抓取放置变体 21/21 全对,推动变体合计 6/29。
- 为什么失败?推动变体的判定要求“最后夹爪张开”,而人在演示视频里推完方块后会松手(或放下棍子)。模型把方块推到了目标上(图 5 上排最后一帧中方块确实在靶心),但没有松开夹爪就宣布完成。
- 这算不算记忆失败?模型第一条描述就正确说出了演示方式(“用棍子推”“沿桌面滑动”),说明它记住了“怎么做”;问题在于没有把“结束时松手”当成任务的一部分。这更像是对完成条件的理解偏差,作者因此不把它归为记忆失败。
- 这也提示了一个容易修复的方向:在提示词中说明“完成后应松开夹爪”,或修改成功判据。但作者没有这样做,以免在测试集上继续调参。
无意的按钮接触(Unintended button contact,12 例)与按晚(late press,11 例)
原文
StopCube asks the robot to press a button so that a cube oscillating across a target stops on it at a given arrival. The model's last action separates two behaviours among the 23 failures. In 12, it was described as positioning (“move closer to the button without pressing yet”), with a commanded TCP height of 3.2–4.0 cm, yet the fingertips depressed the button (Figure 5, middle); in 11 of these the press registered before the required arrival, read from the environment, and in one exactly at it. In the other 11, the model intended to press, with commanded heights of 0.8–1.8 cm, and the press registered after the arrival. In all 23 failures, the model's last description names an arrival (“its next crossing will be the second”). We did not check these statements against the cube's state, so they show what the model intended to do, not that its count was right. The dominant StopCube failures are therefore, as observed behaviour, unintended contact and mistimed presses; because the stated arrivals were not checked, these observations do not rule out counting or perception errors.
译文
StopCube 要求机器人按下一个按钮,让一个在目标处来回摆动的方块在指定的那一次到达时停在目标上。模型的最后一个动作把 23 次失败区分为两种行为。在其中 12 次中,最后动作被描述为定位(“靠近按钮但先不按下”),指令 TCP 高度为 3.2–4.0 cm,但指尖却压下了按钮(图 5 中);根据从环境读出的数据,其中 11 次的按压在规定到达之前就被登记,另有 1 次恰好在到达时。在另外 11 次中,模型有意按下按钮,指令高度为 0.8–1.8 cm,但按压在到达之后才被登记。在全部 23 次失败中,模型的最后一条描述都说出了某一次到达(“它的下一次经过将是第二次”)。我们没有将这些陈述与方块的真实状态进行核对,因此它们只表明模型打算做什么,而不表明它的计数是正确的。因此,从可观察行为来看,StopCube 的主要失败是无意接触和时机错误的按压;由于没有核对模型所说的到达次数,这些观察并不能排除计数错误或感知错误。
解释
StopCube 是另一个“重灾区”,这一段的分析尤其体现了作者的谨慎。
- 任务机制:方块在目标附近来回摆动,任务要求“在第 N 次到达时按按钮让它停下”。模型需要(1)数清已经到达了几次(时间记忆),(2)在正确时刻按下(时机控制)。
- 两类失败如何区分?看最后一个动作的“意图”与“高度”:
- 无意接触:模型说“先靠近,不按”,指令高度 3.2–4.0 cm,但手指实际压到了按钮——可能是按钮的触发行程比模型预想的大,或夹爪几何比 TCP 低。于是按压提前发生。
- 按晚:模型说“现在按”,高度 0.8–1.8 cm,但从下发指令到手臂实际压下需要时间,等按下时方块已经过了目标。
- 为什么会按晚?一个可能原因是延迟:模型每次思考要十几秒,但仿真器在此期间暂停,所以真正的延迟来自“运动执行时间”——手臂从当前高度移动到按下位置需要若干控制步,而模型可能没有准确估计这段时间。第 6 节提到神谕设置下“按压约需 1.5 s”,也印证了运动时间不可忽略。
- 为什么不下结论说“计数是对的”?模型嘴上说“下一次是第二次”,但作者没有把这句话和方块真实的到达次数对照,所以不能排除模型其实数错了。作者明确承认这一漏洞,这是负责任的写法。
超出可达范围的路点(Out-of-reach waypoint,4 例)与运动规划失败(motion planning failures,5 例)
原文
In four VideoUnmask(Swap) episodes the model lifted the correct first container and commanded a set-aside pose far forward (x = 0.22–0.23 m, |y| = 0.23–0.25 m). RoboMME's executor did not report the pose as unreachable: it ran for 1,096–1,453 control steps, the arm stopping 6–7 cm short of the commanded x (Figure 5, bottom), and the episodes reached the 1300-step limit. Across the run, 10 of the 11 executed waypoints with x \ge 0.18 m took 581–1,453 steps each; five of those ten episodes still succeeded. In five other episodes (three InsertPeg, one ButtonUnmaskSwap, one PickHighlight) the planner reported that no motion plan to the commanded pose was found.
译文
在四个 VideoUnmask(Swap) 回合中,模型抬起了正确的第一个容器,并指令了一个位置很靠前的放置位姿(x = 0.22–0.23 m,|y| = 0.23–0.25 m)。RoboMME 的执行器并没有报告该位姿不可达:它运行了 1,096–1,453 个控制步,机械臂停在离指令 x 还差 6–7 cm 的位置(图 5 下),这些回合最终达到了 1300 步的上限。在整个运行中,x \ge 0.18 m 的 11 个已执行路点中有 10 个各自耗费了 581–1,453 步;这十个回合中仍有五个成功。在另外五个回合中(三个 InsertPeg、一个 ButtonUnmaskSwap、一个 PickHighlight),规划器报告找不到通往指令位姿的运动规划。
解释
这两类失败都与运动执行层相关,而不是决策层。
- 超出可达范围:模型选对了容器(说明记住了绿色方块在哪),但把容器挪开时选了一个太远的位置(x 大、|y| 也大,接近机械臂工作空间边缘)。执行器没有直接报错,而是一直尝试逼近,耗光了步数预算。这暴露了执行器的一个缺陷:它对“几乎不可达”的目标缺少超时或报错机制;同时也说明模型对机械臂工作空间的边界没有准确概念。
- 旁证统计:x\ge0.18 m 的路点普遍很慢(581–1,453 步),但其中一半回合仍成功了,说明“远”本身不一定致命,致命的是“远到用光步数”。
- 运动规划失败:规划器直接报告“找不到路径”(可能是姿态不可解或会发生碰撞),回合以
env_error终止。按评测协议,这也计为失败。
不可用回答(Unusable answers,3 例)与其他操作错误(other manipulation errors,3 例)
原文
Three answers could not be parsed: two contained a number partly written in words (
0. seventeen, -0. eighteen); the third contained a digit in another script and then text imitating a harness message. The other three failures are single cases: in InsertPeg the model lifted the demonstrated peg by its other end, which the environment treats as a failure; in SwingXtimes, with left and right correct, the cube slid off the target after release and the model picked it up again, which the environment judged a failure; in VideoUnmaskSwap the first container stayed caught between the fingers after a long set-aside motion, and the episode failed 16 actions later, after repeated attempts to release it and grasp the second container.译文
有三个回答无法被解析:其中两个包含部分用英文单词写出的数字(
0. seventeen、-0. eighteen);第三个包含一个其他文字体系中的数字字符,随后还出现了一段模仿测试框架消息的文本。另外三次失败都是单例:在 InsertPeg 中,模型抓起了演示中的那根销钉,但抓的是另一端,环境将此视为失败;在 SwingXtimes 中,左右方向是正确的,但方块在松开后滑出了目标,模型又把它捡了起来,环境判定为失败;在 VideoUnmaskSwap 中,经过一次长距离放置动作后,第一个容器一直卡在手指之间,在多次尝试松开它并抓取第二个容器之后,该回合在 16 个动作后失败。解释
剩下的 6 个失败是零散的“长尾”。
- 不可用回答:大模型偶尔会生成奇怪的格式,例如把 0.17 写成“0. seventeen”,或者混入其他书写系统的数字(如全角或其他语言的数码)。最后一例更有趣:模型输出了一段“假装是测试框架发来的消息”的文字,这是长对话中角色混淆的典型表现。这类错误可以用更严格的结构化输出(如 JSON schema 约束)来避免。
- InsertPeg 抓错端:模型记住了“哪根销钉”,但没注意到“抓哪一端”这个细节,而环境要求与演示一致。
- SwingXtimes 重抓:方块滑出目标后模型试图补救,却违反了任务规则(环境认为重抓是错误行为)。
- 容器卡在夹爪里:纯粹的物理接触问题,与记忆无关。
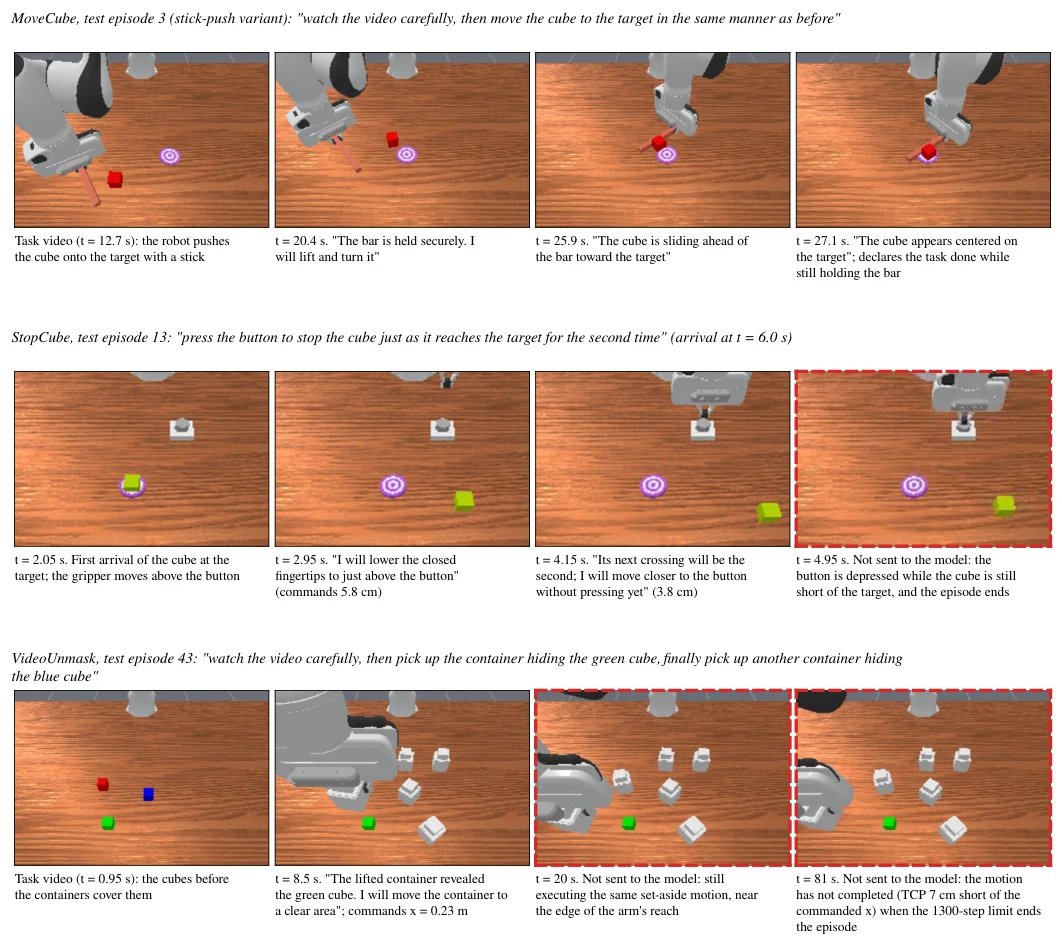
图 5:三个失败最多的组中失败执行过程的前置相机记录帧;t 为仿真时间,引号中是模型自己的描述。普通边框的帧作为观测发送给了模型;红色虚线边框的帧是回合录像中的执行帧或终止帧,模型从未收到过,因为回合在它下一次请求之前就结束了。上:MoveCube(棍子推动变体),仍握着棍子就提前宣布完成。中:StopCube,在定位时无意碰到了按钮。下:VideoUnmask,一个超出机械臂可达范围的放置路点,执行器一直执行到步数上限。
原图注:Figure 5 Recorded front-camera frames of failed rollouts from the three most frequent groups; t is simulated time and quotes are the model's own descriptions. Frames with a plain border were sent to the model as observations; frames with a dashed red border are execution or terminal frames from the episode recording that the model never received, because the episode ended before its next request. Top: MoveCube (stick-push variant), premature completion while still holding the stick. Middle: StopCube, unintended button contact while positioning. Bottom: VideoUnmask, a set-aside waypoint beyond the arm's reach that the executor runs until the step limit.
图 5 解读
三行,每行四帧,每行上方斜体字是任务名、测试回合号和任务指令;每帧下方是仿真时间 t 和模型的原话(或作者说明)。普通边框 = 模型看到过的帧;红色虚线边框 = 模型从未看到的帧(回合在模型下一次决策前就结束了)。
- 上排:MoveCube 第 3 回合(棍子推动),指令为“仔细看视频,然后以与之前相同的方式把方块移到目标”。第 1 帧是任务视频(t=12.7 s),演示中机器人用棍子把红色方块推到紫色靶心上。第 2 帧(t=20.4 s)模型说“棍子已握牢,我将抬起并转动它”;第 3 帧(t=25.9 s)“方块正在棍子前方向目标滑动”;第 4 帧(t=27.1 s)“方块看起来位于目标中央”,随即宣布完成——但它仍握着棍子。画面上方块确实在靶心,说明模型记住了方式、也做到了位置,只是没有松手。
- 中排:StopCube 第 13 回合,指令为“在方块第二次到达目标时按下按钮让它停下”,第二次到达发生在 t=6.0 s。第 1 帧(t=2.05 s)方块第一次到达靶心,夹爪移到按钮上方;第 2 帧(t=2.95 s)模型说“我将把闭合的指尖降到按钮上方一点”(指令 5.8 cm);第 3 帧(t=4.15 s)模型说“它的下一次经过将是第二次;我将再靠近按钮但先不按”(3.8 cm);第 4 帧(t=4.95 s,红框)按钮已被压下,而方块离目标还差一段,回合结束。可见模型的计数与意图都合理,失败源于“定位高度 3.8 cm 也会压到按钮”这一物理细节。
- 下排:VideoUnmask 第 43 回合,指令为“仔细看视频,然后抬起盖住绿色方块的容器,再抬起另一个盖住蓝色方块的容器”。第 1 帧(任务视频,t=0.95 s)展示被盖住前红、蓝、绿三个方块的位置;第 2 帧(t=8.5 s)模型说“抬起的容器露出了绿色方块,我要把容器挪到空处”,指令 x=0.23 m——它选对了容器;第 3 帧(t=20 s,红框)手臂仍在执行同一个放置动作,已接近可达边缘;第 4 帧(t=81 s,红框)动作仍未完成(TCP 离指令 x 差 7 cm),1300 步上限到了,回合结束。
6RoboMME 神谕规划器设置下的诊断(Diagnostics in RoboMME's Oracle-Planner Setting)
校准(Calibration)
原文
To compare with RoboMME's VLM evaluation, we run GPT-4o (
gpt-4o-2024-08-06) through our oracle-planner harness with RoboMME's prompts and seeds. It reaches 30.8% [27.7, 34.0], against 30.6% reported by RoboMME, so the harness approximately recovers the reported aggregate. The protocols still differ. RoboMME's released code sampled GPT-4o's frames more densely than we do (every 8th frame, at most 20 per message, against one in 30), and we count invalid actions as failures. Per-task differences exceed sampling noise on StopCube and SwingXtimes, and the agreement of the aggregates does not establish identical evaluation semantics.译文
为了与 RoboMME 的 VLM 评测进行比较,我们使用 RoboMME 的提示词和随机种子,通过我们的神谕规划器测试框架运行 GPT-4o(
gpt-4o-2024-08-06)。它达到 30.8% [27.7, 34.0],而 RoboMME 报告的是 30.6%,因此我们的测试框架大致复现了已报告的总成绩。但两者的协议仍有差异:RoboMME 发布的代码对 GPT-4o 的帧采样比我们更密(每 8 帧取 1 帧,每条消息最多 20 帧,而我们是每 30 帧取 1 帧),并且我们把无效动作计为失败。在 StopCube 和 SwingXtimes 上,逐任务的差异超出了抽样噪声;总成绩的一致并不意味着评测语义完全相同。解释
在用自己的框架评测 GPT-6-Astra 之前,作者先做了一次“校准”:用同一框架跑 RoboMME 原论文评过的 GPT-4o,看能否复现原数字。
- 30.8% vs. 30.6% 几乎一致,说明框架没有系统性地“放水”或“加难”,后续 GPT-6-Astra 在该框架下的分数可以和原论文的 Gemini 等模型大致比较。
- 但作者马上指出差异:帧密度不同、无效动作的处理不同,且个别任务的差异已超出随机波动。也就是说,“总分一致”可能是不同方向的差异相互抵消的结果。这种“不过度解读一致性”的态度贯穿全文。
- 固定模型版本号(
gpt-4o-2024-08-06)是为了可复现;相比之下 GPT-6-Astra 没有带日期的快照(第 7 节会提到)。
表 3:神谕规划器设置:800 个测试回合上的平均成功率(%)。修正只作用于表 4 中的任务;其余任务保持不变。
| Setting | GPT-6-Astra | GPT-4o | Gemini-2.5-Pro | Qwen3-VL-32B | Human |
| RoboMME's evaluation [9] | – | 30.6 | 47.9 | 27.9 | 90.5 |
| Our harness | 77.8 | 30.8 | – | – | – |
| + D, G | 92.3 | 31.9 | – | – | – |
| + D, G, F+T (diagnostic) | 94.6 | 32.4 | – | – | – |
原表注:Table 3 Oracle-planner setting: average success rate (%) over the 800 test episodes. Corrections apply to the tasks of Table 4 only; all other tasks are unchanged.
表 3 解读
各行:第一行是 RoboMME 原论文的评测结果;第二行是作者的测试框架(未修正);第三、四行依次叠加修正 D(更密的帧)、G(PickHighlight 提示词说明),以及仅作诊断用的 F+T(StopCube 的反馈与时间提示)。
各列:被评测的模型/人类。“–”表示该设置下没有评测。
关键数字:
各列:被评测的模型/人类。“–”表示该设置下没有评测。
关键数字:
- 未修正时,GPT-6-Astra 作规划器为 77.8%,远高于原论文中最好的 Gemini-2.5-Pro(47.9%),但仍低于人类 90.5%。
- 加上 D、G 后,GPT-6-Astra 跃升至 92.3%,GPT-4o 只从 30.8% 升到 31.9%。同样的修正,对强模型提升 14.5 个点,对弱模型只提升 1.1 个点——这正是第 6 节“配对对照”要论证的核心现象。
- F+T 再带来 2.3 个点(94.6%),但作者明确标注为“诊断性”,因为它把神谕接口的时间信息“泄露”给了模型(见下文)。
表 4:神谕规划器设置下的配对对照。在相同测试回合上,加入每项修正之前与之后的成功回合数(每个任务 50 个回合)。“gained / lost”统计结果发生翻转的回合数。
| GPT-6-Astra | GPT-4o | ||||||
| Variant | Tasks | base | variant | gained / lost | base | variant | gained / lost |
| D | 5 video-memory tasks | 159 | 239 | 83 / 3 | 32 | 37 | 19 / 14 |
| G | PickHighlight | 14 | 50 | 36 / 0 | 20 | 24 | 7 / 3 |
| D and G (300 episodes) | 173 | 289 | 119 / 3 | 52 | 61 | 26 / 17 | |
| McNemar exact p | 1\times10^{-31} | 0.22 | |||||
| F+T | StopCube (with D, diagnostic) | 24 | 43 | 23 / 4 | 21 | 25 | 12 / 8 |
原表注:Table 4 Paired control in the oracle-planner setting. Successful episodes (of 50 per task) without and with each correction, on the same test episodes. “Gained / lost” counts episodes that switch outcome.
表 4 解读
各列:对 GPT-6-Astra 和 GPT-4o 分别给出三列——base(修正前成功回合数)、variant(修正后成功回合数)、gained / lost(失败\to成功的回合数 / 成功\to失败的回合数)。注意 \text{variant} = \text{base} + \text{gained} - \text{lost},例如 159+83-3=239。
各行:
各行:
- D:作用于 5 个视频记忆任务(VideoUnmaskSwap、ButtonUnmaskSwap、VideoRepick、PatternLock、RouteStick,共 250 回合)。GPT-6-Astra 从 159 升到 239(+80),GPT-4o 从 32 升到 37(+5),且 GPT-4o 的翻转是双向的(19 得 14 失),更像随机波动。
- G:只作用于 PickHighlight(50 回合)。GPT-6-Astra 从 14 升到满分 50,零损失;GPT-4o 从 20 升到 24。
- D and G 合计(300 回合):GPT-6-Astra 119 得 3 失,McNemar 精确 p=1\times10^{-31},极其显著;GPT-4o 26 得 17 失,p=0.22,不显著。
- F+T:作用于 StopCube(在 D 的基础上),GPT-6-Astra 从 24 升到 43,GPT-4o 从 21 升到 25。单独列出并标注“诊断性”。
GPT-6-Astra 作为规划器(GPT-6-Astra as a planner)
原文
With execution delegated to the oracle, GPT-6-Astra succeeds in 77.8% [74.7, 80.5] of episodes, against 47.9% for Gemini-2.5-Pro, 30.6% for GPT-4o and 27.9% for Qwen3-VL-32B in RoboMME's evaluation (Table 3; per-task results in Appendix B). This number is not directly comparable to the waypoint result. The two settings differ in executor, in frame density (k = 30 vs. k = 3) and in access to the wrist camera, so 77.8% versus 92.1% does not isolate the difficulty of control. Its weakest tasks fall into two groups. On tasks that hinge on brief events (container swaps, a cube re-picked from a shuffled set, demonstrated stick trajectories), one frame per 1.5 s misses information. On PickHighlight and StopCube, the failures follow from the oracle interface. RoboMME's prompt says the gripper reopens after a button press, which the oracle's press skill never does, so the model repeats the press. On StopCube, the oracle's “remain static” skill waits only until a fixed checkpoint just before the press time and then stops advancing time.
译文
在执行交给神谕的情况下,GPT-6-Astra 在 77.8% [74.7, 80.5] 的回合中成功;相比之下,在 RoboMME 的评测中 Gemini-2.5-Pro 为 47.9%,GPT-4o 为 30.6%,Qwen3-VL-32B 为 27.9%(表 3;逐任务结果见附录 B)。这个数字不能与路点结果直接比较。两种设置在执行器、帧密度(k = 30 对 k = 3)以及能否使用腕部相机上都不同,因此 77.8% 对 92.1% 并不能单独反映控制的难度。它表现最弱的任务分为两组。在依赖短暂事件的任务上(容器交换、从打乱的一组中重新抓起某个方块、演示中的棍子轨迹),每 1.5 s 一帧会漏掉信息。在 PickHighlight 和 StopCube 上,失败源于神谕接口本身。RoboMME 的提示词说按下按钮后夹爪会重新张开,但神谕的按压技能从不这样做,于是模型会重复按压。在 StopCube 上,神谕的“保持静止”(remain static)技能只等待到按压时刻之前的一个固定检查点,然后就不再推进时间。
解释
这一段解释了一个反直觉的现象:神谕接口理应更容易,为什么 GPT-6-Astra 在这里只有 77.8%,反而低于自己控制路点时的 92.1%?
- 首先,不能直接比:两种设置同时改变了执行器、帧密度和腕部相机三个因素,差值不能归因于“控制难度”。
- 原因一:帧太稀疏。k=30 即每 1.5 s 一帧。容器交换、物体打乱等事件可能只持续零点几秒,在稀疏采样下根本看不到,模型无从记忆。这不是模型的记忆问题,而是“没有被看到的东西无法被记住”。
- 原因二:神谕接口的“怪癖”。
- PickHighlight:提示词说“按完按钮夹爪会张开”,但神谕实现中夹爪保持闭合。模型相信了提示词,以为还没按成功,于是反复按,导致失败。提示词与实际行为不一致,模型越“听话”越吃亏。
- StopCube:神谕的“等待”技能只能等到一个固定时间点,之后时间不再前进,模型无法通过等待来观察方块的下一次到达。
- 这两类原因直接对应下一段的三项修正:D 解决帧稀疏,G 解决提示词错误,F+T 解决 StopCube 的接口问题。
接口修正(Interface corrections)
原文
We evaluate three corrections as labelled variants: D, denser frames (k = 3 instead of 30, as in the waypoint setting), on the five tasks above; G, a note in the PickHighlight prompt that the press-button skill ends with the gripper closed; F+T, for StopCube and together with D, a message when an action executes no steps and a note that pressing takes about 1.5 s and that the button must be pressed once waiting has no effect. F+T is an oracle-interface diagnostic, not a neutral fix. The oracle's waiting skill stops a fixed 1.5 s before the cube must be stopped, which is exactly when the button must be pressed, and the note's 1.5 s is that interval, so F+T passes timing information through the executor. RoboMME's released human-evaluation interface uses the same waiting skill. D was evaluated directly on the test episodes. G and F+T were first checked on RoboMME's separate validation episodes (PickHighlight 2/10\to10/10, StopCube 1/10\to10/10) and then run once on the test set. With D and G the model reaches 92.3% [90.2, 93.9]; adding F+T gives 94.6% [92.8, 96.0], a gain that should not be read as evidence of visual timing.
译文
我们以带标签的变体形式评测三项修正:D,更密的帧(k = 3 而非 30,与路点设置相同),作用于上述五个任务;G,在 PickHighlight 的提示词中加一句说明:按按钮技能结束时夹爪是闭合的;F+T,用于 StopCube 且与 D 一起使用:当某个动作没有执行任何控制步时给出一条消息(反馈,feedback),并附一句说明:按压大约需要 1.5 s,一旦等待不再起作用就必须按下按钮(时间,timing)。F+T 是一项神谕接口诊断,而非中立的修正。神谕的等待技能会在方块必须被停下之前固定 1.5 s 处停止,而这恰恰就是必须按下按钮的时刻;说明中的 1.5 s 正是这个间隔,因此 F+T 通过执行器传递了时间信息。RoboMME 发布的人类评测界面也使用了同一个等待技能。D 直接在测试回合上评测。G 和 F+T 先在 RoboMME 单独的验证回合上检查(PickHighlight 从 2/10 到 10/10,StopCube 从 1/10 到 10/10),然后在测试集上运行一次。使用 D 和 G 时,模型达到 92.3% [90.2, 93.9];再加上 F+T 则为 94.6% [92.8, 96.0],但这一提升不应被解读为模型具备视觉计时能力的证据。
解释
这一段定义三项修正,并对它们的“公平性”做了非常细致的区分。
- D(Dense frames):只是把帧间隔从 1.5 s 缩到 0.15 s,不增加任何任务相关知识,属于“给模型更多原始观测”。
- G(Gripper note):纠正提示词中与实际行为不符的描述,属于“修 bug”,同样不提供答案。
- F+T(Feedback + Timing):这一项有问题。“等待技能停下来的时刻”恰好就是“应该按按钮的时刻”,而提示词又告诉模型“等待不起作用时就按”,等于把正确时机通过接口行为间接告诉了模型。因此模型的提升可能并非来自它真的看懂了方块的运动节奏。作者坦白地把它标为“诊断”,并单独报告。
- 验证集使用:G 和 F+T 先在验证集上确认有效、再在测试集上只跑一次,减少了在测试集上反复调参的嫌疑;D 则直接在测试集上评测(它本身就是路点设置使用的参数)。
- 有趣的旁注:人类评测界面使用同一个等待技能,这意味着人类在 StopCube 上可能也受益于这个时间线索。
配对对照(Paired control)
原文
A correction derived from one model's failures might help every model. We therefore apply identical corrections to GPT-4o on the same episodes (Table 4, Figure 6). With D and G, GPT-6-Astra gains 119 episodes and loses 3 (p = 1 \times 10^{-31}). GPT-4o gains 26 and loses 17 (p = 0.22), a change that is not statistically significant in this sample; non-significance does not show that the corrections have no effect on GPT-4o. To test the difference between the two models directly, we estimate the interaction \Delta = (S_{\mathrm{A,corr}} - S_{\mathrm{A,base}}) - (S_{\mathrm{4o,corr}} - S_{\mathrm{4o,base}}) over the 300 affected episodes: \hat\Delta = 35.7 points, with a 95% percentile interval of [29.0, 42.3] from a task-stratified bootstrap that resamples episodes jointly across both models and both conditions (20,000 resamples, fixed seed). The per-episode outcomes of all oracle-planner runs and the script that recomputes Tables 3, 4 and 5 and this interval are released with the code. The corrections help the model that can use the additional frames and the corrected description far more than the weaker model, which argues against their simply supplying answers. F+T is the exception: it carries the oracle's timing, and we report it only as a diagnostic.
译文
一项根据某个模型的失败推导出的修正,可能对所有模型都有帮助。因此我们在相同回合上对 GPT-4o 施加完全相同的修正(表 4,图 6)。使用 D 和 G 时,GPT-6-Astra 获得 119 个回合、失去 3 个(p = 1 \times 10^{-31})。GPT-4o 获得 26 个、失去 17 个(p = 0.22),这一变化在本样本中不具统计显著性;但不显著并不表明这些修正对 GPT-4o 没有效果。为了直接检验两个模型之间的差异,我们在 300 个受影响回合上估计交互效应(interaction)
\Delta = (S_{\mathrm{A,corr}} - S_{\mathrm{A,base}}) - (S_{\mathrm{4o,corr}} - S_{\mathrm{4o,base}}),
得到 \hat\Delta = 35.7 个百分点,其 95% 百分位区间为 [29.0, 42.3]。该区间由按任务分层的自助法(task-stratified bootstrap)得到,重抽样时对两个模型、两种条件联合地抽取同一组回合(20,000 次重抽样,固定随机种子)。所有神谕规划器运行的逐回合结果,以及重新计算表 3、4、5 和该区间的脚本,都随代码一同发布。这些修正对能够利用额外帧和更正描述的模型的帮助远大于对较弱模型的帮助,这反驳了“修正只是在直接提供答案”的说法。F+T 是例外:它携带了神谕的时间信息,我们只把它作为诊断结果报告。解释
这一段是第 6 节的核心论证,回答一个关键质疑:“你们是看着 GPT-6-Astra 的失败去设计修正的,会不会修正本身就把答案塞给了模型?” 论证逻辑。 如果修正本身就“泄露答案”,那么任何模型加了修正都应该大幅提升。作者用 GPT-4o 作对照:同样的修正下 GPT-4o 几乎没提升,说明修正只是“去掉障碍”,能否跨过去仍取决于模型本身的能力。 交互效应 \Delta 的含义。
- S_{\mathrm{A,corr}}、S_{\mathrm{A,base}}:GPT-6-Astra(A 表示 Astra)在修正后、修正前的成功率;S_{\mathrm{4o,corr}}、S_{\mathrm{4o,base}}:GPT-4o 对应的成功率。均在这 300 个受影响回合上计算。
- 第一个括号是 Astra 的提升,第二个括号是 GPT-4o 的提升,二者之差就是“修正的效果在两个模型之间相差多少”,这是统计学中典型的“差中差”(difference-in-differences)形式。
- 代入数字:Astra 提升 (289-173)/300 = 38.7\%,GPT-4o 提升 (61-52)/300 = 3.0\%,\hat\Delta = 38.7-3.0 = 35.7 个百分点,与原文一致。
- 自助法:从 300 个回合中有放回地抽样 300 个,重新计算 \hat\Delta,重复 20,000 次,取第 2.5 和第 97.5 百分位数作为区间 [29.0, 42.3]。
- 按任务分层:每个任务内部单独重抽样,保持各任务的回合数不变,避免因任务构成变化引入额外方差。
- 联合重抽样:同一个被抽中的回合,四个结果(两模型 \times 两条件)一起被带走,保留了配对结构。
- 区间完全不含 0,说明两个模型在修正收益上的差异是稳健的。
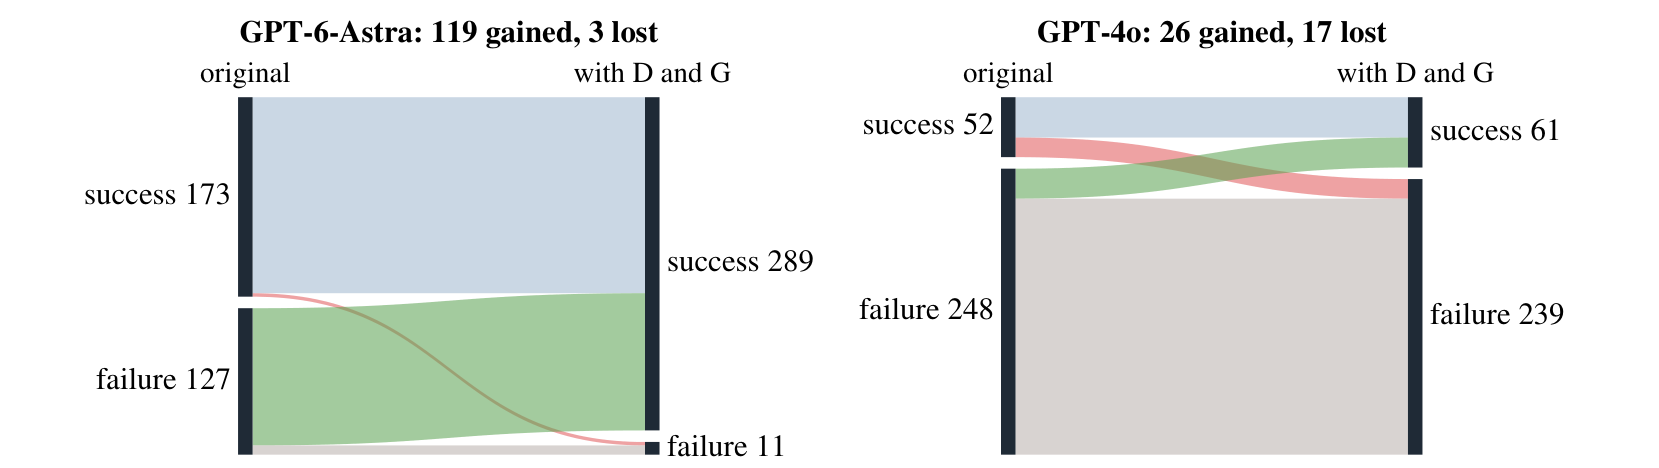
图 6:受 D 和 G 影响的 300 个测试回合的配对结果,分别给出 GPT-6-Astra 和 GPT-4o,两图按相同比例绘制。与两根汇总柱状条不同,这些流带同时显示了被挽回的失败(绿色)和新出现的失败(红色)。F+T 未包含在内。
原图注:Figure 6 Paired outcomes of the 300 test episodes affected by D and G, for GPT-6-Astra and GPT-4o, drawn to the same scale. Unlike two aggregate bars, the flows show both recovered failures (green) and new failures (red). F+T is not included.
图 6 解读
两张并排的桑基图(冲积图),比例相同。每张图左侧竖条是“original”(修正前)的成功/失败回合数,右侧竖条是“with D and G”(修正后)的成功/失败回合数。流带颜色:蓝灰为始终成功,浅灰为始终失败,绿色为失败\to成功(挽回),红色为成功\to失败(新失败)。
作用:这是表 4 中 D and G 一行的图形化,为“修正的收益取决于模型能力”提供直观证据。
- 左图 GPT-6-Astra:修正前成功 173、失败 127;修正后成功 289、失败 11。宽大的绿色流带(119)从失败流向成功,只有一根细红线(3)从成功流向失败。
- 右图 GPT-4o:修正前成功 52、失败 248;修正后成功 61、失败 239。绿色(26)和红色(17)流带粗细接近、相互交叉,大部分回合(浅灰)始终失败。
作用:这是表 4 中 D and G 一行的图形化,为“修正的收益取决于模型能力”提供直观证据。
7局限性与后续实验(Limitations and Next Experiments)
证据没有表明什么(What the evidence does not show)
原文
The model sees past images, its own earlier descriptions and the record of its actions. Our experiments do not separate these channels, so they do not show which carries the information that history-dependent tasks need, nor do they identify a memory mechanism. The controlled test is to hold the task specification (goal and task video) fixed and remove online history selectively: latest observation only, visual history without earlier descriptions, textual history without older images, and a recent window. Each condition must rebuild its requests from its permitted records, so that removed history cannot persist through a chained conversation. Counterfactual episodes with identical current observations but different relevant histories, and tasks that vary delay and interference, would further separate memory demands from current-state shortcuts.
译文
模型能看到过去的图像、它自己早先的描述以及它的动作记录。我们的实验没有把这些通道分开,因此既不能说明是哪一个通道承载了依赖历史的任务所需的信息,也不能确定某种记忆机制。受控的检验方法是:保持任务说明(目标和任务视频)不变,有选择地移除在线历史——只保留最新观测;保留视觉历史但去掉早先的描述;保留文本历史但去掉较早的图像;只保留最近的一个窗口。每种条件都必须仅用其允许的记录重新构造请求,以免被移除的历史通过串联的对话残留下来。此外,构造当前观测完全相同但相关历史不同的反事实回合(counterfactual episodes),以及改变延迟和干扰的任务,可以进一步把真正的记忆需求与“利用当前状态的捷径”区分开。
解释
这一段是全文最重要的自我限定,并给出了具体的后续实验设计。
- 三个可能的记忆通道:(1)旧图像——模型可以“回看”过去的画面;(2)自己写的文字描述——如“绿色方块在左边的容器下”,相当于笔记;(3)动作记录——自己做过什么。92.1% 的结果无法区分哪个在起作用。
- 四种消融条件:只看当前帧(检验任务是否真的需要记忆);有图无文(检验视觉记忆);有文无旧图(检验文字笔记是否足够);最近窗口(检验需要多长的历史)。
- “重新构造请求”的技术细节:本文用 API 的会话链,历史保存在服务端。如果只是“不再发送”旧内容,服务端链条里可能仍然保留着,导致消融不干净。所以每种条件都要从头构造请求,确保被删的东西真的不在上下文中。
- 反事实回合:例如两段回合的最后一帧一模一样,但之前方块被藏在不同的容器下。如果模型在两种情况下都能答对,就证明它真的用了历史;如果它只能答对其中一种,说明它可能在利用当前画面中的某些线索(捷径)。
- 改变延迟和干扰:让“看到信息”和“需要使用信息”之间间隔更长、中间插入更多干扰事件,可以测出记忆的容量和鲁棒性。
混杂因素(Confounds)
原文
The waypoint and oracle-planner settings differ in executor, frame density and camera access; a factorial comparison of {waypoint, oracle} \times {dense, sparse} with matched observations would isolate the executor. No other model was evaluated under the waypoint harness, so the interface notes and the left/right convention in its prompt are not paired with another model in that setting.
译文
路点设置与神谕规划器设置在执行器、帧密度和相机使用上都不同;在观测匹配的前提下进行 {路点, 神谕} \times {密集, 稀疏} 的析因比较(factorial comparison),才能把执行器的影响单独分离出来。在路点测试框架下没有评测其他模型,因此其提示词中的接口说明和左右约定并没有在该设置下与另一个模型进行配对对照。
解释
析因设计:把两个因素(执行器类型、帧密度)的所有组合都跑一遍,共 2\times2=4 种条件,就能分别估计每个因素的主效应及其交互作用。当前论文只有“路点 + 密集”和“神谕 + 稀疏”两个角,外加“神谕 + 密集”(修正 D),还缺“路点 + 稀疏”。
第二句的含义:第 6 节用 GPT-4o 做了配对对照,证明神谕设置下的修正不是在泄露答案;但在路点设置下,提示词里的接口说明和左右约定是否也在“帮” GPT-6-Astra,没有类似的对照证据。读者应当意识到,路点设置下的 92.1% 部分依赖于这些人工设计的提示词。
第二句的含义:第 6 节用 GPT-4o 做了配对对照,证明神谕设置下的修正不是在泄露答案;但在路点设置下,提示词里的接口说明和左右约定是否也在“帮” GPT-6-Astra,没有类似的对照证据。读者应当意识到,路点设置下的 92.1% 部分依赖于这些人工设计的提示词。
开发过程、可复现性与范围(Development, reproducibility and scope)
原文
Configuration choices were made during development that included evaluations on the test split: frame density, the interface notes in the system prompt, the oracle-setting corrections, and a pilot of an earlier harness version on two test episodes. In particular, the left/right convention was added to the shared prompt after an earlier full run of the same harness without it, in which the model failed all 50 SwingXtimes episodes by reading left and right from the mirrored front image; the note was then run on SwingXtimes alone, on 10 validation episodes (9/10) and on its 50 test episodes (50/50), before the full run reported here. The logs of the earlier run and of these checks are at https://github.com/jackbjed/astra-robomme. On the other 15 tasks the two runs differ in 37 of 750 episodes, in both directions (13 gained, 24 lost; exact McNemar p = 0.10); since the runs differ in the prompt as well as in sampling, this mixes the effect of the note with sampling variability.
译文
一些配置选择是在包含测试集评测的开发过程中做出的:帧密度、系统提示词中的接口说明、神谕设置下的修正,以及在两个测试回合上对早期版本测试框架进行的试运行。特别是,左右约定是在同一测试框架的一次早期完整运行之后才加入共用提示词的;在那次没有该约定的运行中,模型因为依据镜像的前置相机图像判断左右,在 SwingXtimes 的全部 50 个回合上都失败了。随后,在报告于此的完整运行之前,这条说明先单独在 SwingXtimes 上运行:在 10 个验证回合上为 9/10,在其 50 个测试回合上为 50/50。早期运行和这些检查的日志位于 https://github.com/jackbjed/astra-robomme。在其余 15 个任务上,两次运行在 750 个回合中有 37 个结果不同,且方向是双向的(13 个变好、24 个变差;精确 McNemar p = 0.10);由于两次运行既在提示词上不同又存在采样差异,这一结果混合了该说明的效应与采样的随机波动。
解释
这一段坦白了测试集污染(test-set contamination / adaptive overfitting)的风险,这在大模型评测中往往被忽略。
- 问题所在:如果根据测试集结果去调整提示词,再在同一测试集上报告成绩,成绩会偏乐观。作者列出了所有在开发中可能受测试集影响的选择。
- 左右约定的故事:没有这条说明时,SwingXtimes 0/50;加上之后 50/50。这说明一句简单的提示词能让一个任务从全错变为全对,也说明前沿模型在“镜像视角下判断左右”这种空间推理上并不可靠,需要外部明确告知。
- 其他 15 个任务的变化:早期运行与正式运行在其余任务上相差 37 个回合,变好 13、变差 24,p=0.10 不显著。这表明正式运行并未因“挑了一次好运气”而整体偏高——如果说有偏差,其余任务在正式运行中反而略差。不过作者指出,这一比较同时混入了提示词变化和采样随机性,不能做强结论。
- 将早期运行的日志也公开,是非常透明的做法,让读者可以自行核查。
原文
We made no RoboMME-specific parameter updates, but GPT-6-Astra's pretraining data are unknown. The model is served through an API without dated snapshots (we used the identifier
gpt-6-astra on 2026-10-11), so exact reproduction depends on its availability, and costs are computed from token counts at assumed prices, not billing records. RoboMME's tasks are simulated tabletop tasks with a fixed camera; longer horizons, mobile manipulation and physical robots remain open.译文
我们没有进行任何针对 RoboMME 的参数更新,但 GPT-6-Astra 的预训练数据是未知的。该模型通过不提供带日期快照的 API 提供服务(我们于 2026-10-11 使用了标识符
gpt-6-astra),因此精确复现取决于它是否仍然可用;成本则是根据 token 计数按假定价格计算的,而非来自账单记录。RoboMME 的任务是使用固定相机的仿真桌面任务;更长的时程、移动操作以及实体机器人仍是有待解决的问题。解释
这一段列出三类外部限制:
- 数据泄露的可能:虽然没有在 RoboMME 上微调,但无法排除 GPT-6-Astra 预训练时见过 RoboMME 的论文、代码或视频。闭源模型的这一不确定性无法消除。
- 可复现性:没有带日期的模型快照,意味着 API 背后的模型随时可能被更新或下线,日后无法保证得到同样结果(这就是第 3 节提到的“API 漂移”)。
- 适用范围:仿真、桌面、固定相机。真实世界中的长时程任务、移动机器人(视角不断变化)和实体机器人(存在噪声、延迟、安全问题)都尚未验证。结合第 4 节每次调用十几秒的延迟,实际部署还有很长的路。
8结论(Conclusion)
原文
A frozen frontier VLM that keeps the whole episode in context and commands Cartesian waypoints directly is a strong baseline for RoboMME. In a single run it succeeds in 92.1% of test episodes, above the previously reported human score of 90.5% obtained with an oracle skill interface, and above prior systems that train on RoboMME data. Its failures concentrate in MoveCube and StopCube. In MoveCube, the model named the demonstrated way of moving the cube but declared completion with the gripper closed, which the success check of the pushing variants does not accept; in StopCube, it pressed the button too late or touched it while positioning, although its descriptions named the intended arrival, which we did not verify against the cube's state. In the oracle-planner setting, denser frames and a corrected prompt help GPT-6-Astra far more than GPT-4o. These results point to the need for harder memory benchmarks that push vision-language models to their limits as embodied agents, for example with mobile manipulation, changing viewpoints and more demanding physical interaction. They also raise the question of where to draw the boundaries between high-level planning, memory and low-level control. Code, prompts, configuration and per-episode logs for the waypoint evaluation, the failure-audit script, and the per-episode outcomes of the oracle-planner runs with the script that recomputes their statistics are available at https://github.com/jackbjed/embodied-astra-robomme; the images sent to the model are available on request.
译文
一个将整个回合保留在上下文中、直接给出笛卡尔路点的冻结前沿 VLM,是 RoboMME 上的一个强基线。它在单次运行中成功完成了 92.1% 的测试回合,高于此前借助神谕技能接口取得的人类成绩 90.5%,也高于此前在 RoboMME 数据上训练的系统。它的失败集中在 MoveCube 和 StopCube。在 MoveCube 中,模型说出了演示中移动方块的方式,却在夹爪闭合的状态下宣布完成,而推动类变体的成功判定不接受这种情况;在 StopCube 中,它按按钮太晚,或在定位时碰到了按钮,尽管它的描述中说出了预定的那一次到达(我们没有将其与方块的真实状态核对)。在神谕规划器设置下,更密的帧和修正后的提示词对 GPT-6-Astra 的帮助远大于对 GPT-4o 的帮助。这些结果表明,需要更难的记忆基准,把视觉-语言模型作为具身智能体(embodied agent)的能力推向极限,例如引入移动操作、变化的视角以及要求更高的物理交互。它们也提出了一个问题:应当在何处划定高层规划、记忆与底层控制之间的边界。路点评测的代码、提示词、配置和逐回合日志,失败审计脚本,以及神谕规划器运行的逐回合结果与重新计算其统计量的脚本,均可在 https://github.com/jackbjed/embodied-astra-robomme 获取;发送给模型的图像可应要求提供。
解释
结论段重述了三项贡献,并给出两点展望:
- “强基线”的定位:作者没有说自己提出了“最好的方法”,而是说这是一个“强基线”——以后任何在 RoboMME 上提出的复杂记忆架构,都应该先和这个“什么都不训练、只把历史塞进大模型”的方案比一比。这对领域的评价标准是一个提醒。
- 基准需要升级:既然一个通用模型已经接近或超过人类参考,RoboMME 对前沿模型来说可能已经“饱和”。下一代基准应引入移动操作、变化视角和更复杂的物理接触,这些恰好是本文失败分析中暴露出的薄弱环节(接触控制、可达性)。
- 系统架构的边界:传统机器人系统把规划、记忆、控制分层设计;本文显示一个模型可以同时承担规划与记忆,甚至一部分控制(路点级)。但底层控制(关节、力控)仍交给运动规划器,所以“边界该划在哪里”是开放问题。
- 最后列出全部开源内容,强调可复现性与可审计性。
参考文献(References)
参考文献从略,见原文(原文第 10–11 页,共 20 条)。正文中的方括号编号与原文参考文献编号一致。A失败审计规则(Failure Audit Rules)
原文
Each failed episode of the run receives one primary class, assigned in the following order.
译文
本次运行中的每个失败回合都获得一个主类别,按以下顺序判定。
解释
“按顺序判定”意味着这是一套优先级规则:先检查是否满足第一条,满足就归入该类,不再往下看;不满足才检查第二条,以此类推。这保证了每个回合恰好属于一个类别,而且结果不依赖人的主观判断。
原文
- Unusable answer: terminal reason
unparseable(BinFill ep. 30, RouteStick ep. 20 and 47). - Motion planning failure: terminal reason
env_error; all five report that motion planning was exhausted (ButtonUnmaskSwap ep. 11, InsertPeg ep. 2, 11 and 16, PickHighlight ep. 39). - Premature completion: the model returned no waypoint and declared the task complete before the environment judged success (23 MoveCube episodes, RouteStick ep. 24, VideoPlaceOrder ep. 46). MoveCube cases are split by the variant read from the environment: 11 stick-push episodes (3, 4, 5, 8, 11, 15, 25, 31, 32, 33, 47) and 12 gripper-push episodes (7, 12, 14, 20, 22, 23, 26, 29, 37, 38, 41, 49); in all 23 the last gripper command was to close.
- Out-of-reach waypoint: the episode reached the step limit after a single waypoint that ran for more than 1,000 control steps and ended more than 5 cm short of its commanded position (VideoUnmask ep. 11, 43 and 47, VideoUnmaskSwap ep. 39).
- Unintended button contact and late press: StopCube episodes judged failed by the environment, which ends an episode when the button registers a press while the cube is not on the target. The class follows the model's last action: described as positioning, with a commanded TCP height of 3.2–4.0 cm, is unintended contact (ep. 0, 2, 9, 11, 12, 13, 14, 25, 27, 32, 35, 40); described as a press, with 0.8–1.8 cm, is a late press (ep. 1, 5, 7, 18, 21, 24, 30, 36, 42, 44, 45). Against the arrival step read from the environment, every late press registered after it and every unintended contact before it, except ep. 11, which registered exactly at it.
- Other manipulation error: the remaining environment-judged failures, each described in Section 5 (InsertPeg ep. 30, SwingXtimes ep. 44, VideoUnmaskSwap ep. 0).
analysis/audit.py in the code repository from the released episode records and the task parameters read back from the environment. 译文
- 不可用回答:终止原因为
unparseable(无法解析)(BinFill 第 30 回合,RouteStick 第 20 和 47 回合)。 - 运动规划失败:终止原因为
env_error(环境错误);五例均报告运动规划已穷尽仍无解(ButtonUnmaskSwap 第 11 回合,InsertPeg 第 2、11、16 回合,PickHighlight 第 39 回合)。 - 提前宣布完成:模型没有返回路点,并在环境判定成功之前宣布任务完成(23 个 MoveCube 回合,RouteStick 第 24 回合,VideoPlaceOrder 第 46 回合)。MoveCube 的案例按从环境读出的变体类型划分:11 个棍子推动回合(第 3、4、5、8、11、15、25、31、32、33、47 回合)和 12 个夹爪推动回合(第 7、12、14、20、22、23、26、29、37、38、41、49 回合);在全部 23 例中,最后一个夹爪指令都是闭合。
- 超出可达范围的路点:回合在某一个路点之后达到步数上限,该路点运行了超过 1,000 个控制步,结束时距离其指令位置仍超过 5 cm(VideoUnmask 第 11、43、47 回合,VideoUnmaskSwap 第 39 回合)。
- 无意的按钮接触与按晚:被环境判定为失败的 StopCube 回合;当按钮登记到一次按压而方块不在目标上时,环境就会结束回合。类别依据模型的最后一个动作确定:被描述为定位、指令 TCP 高度为 3.2–4.0 cm 的,归为无意接触(第 0、2、9、11、12、13、14、25、27、32、35、40 回合);被描述为按压、高度为 0.8–1.8 cm 的,归为按晚(第 1、5、7、18、21、24、30、36、42、44、45 回合)。对照从环境读出的到达步:每次按晚都在到达之后登记,每次无意接触都在到达之前登记,只有第 11 回合恰好在到达时登记。
- 其他操作错误:其余被环境判定的失败,均已在第 5 节中描述(InsertPeg 第 30 回合,SwingXtimes 第 44 回合,VideoUnmaskSwap 第 0 回合)。
analysis/audit.py 根据发布的回合记录以及从环境读回的任务参数复现。 解释
附录 A 把第 5 节的分类操作化为可执行的判定规则,并列出了每个失败回合的编号。
- 判定顺序的设计:先排除“技术性”失败(回答无法解析、规划器报错),因为这些有明确的终止原因代码,最容易判断;再看“模型主动宣布完成”;然后是“步数耗尽 + 单个路点卡住”;接着是 StopCube 特有的两类;剩下的归入“其他”。越往后的类别越依赖对行为的解读,把它们放在后面可以减少歧义。
- 量化阈值:“超过 1,000 个控制步且差距超过 5 cm”、“TCP 高度 3.2–4.0 cm vs. 0.8–1.8 cm”这些数值让分类不依赖主观判断。注意两种按钮失败的高度区间没有重叠,模型在“定位”和“按下”时给出的高度有清晰分界,说明它确实有不同的意图,只是对按钮行程的估计有误。
- 第 11 回合的特例:按压恰好发生在到达那一刻,却仍被环境判为失败(可能是因为方块在那一帧尚未完全处于目标上)。作者没有掩盖这个边界情况,而是单独标出。
- 计数校验:3+5+25+4+12+11+3=63,与图 4 完全一致。
- 公开审计脚本
audit.py,使得任何人都可以从原始日志重现这些数字,这是“可审计”研究的良好实践。
B神谕规划器设置下的逐任务结果(Per-Task Oracle-Planner Results)
表 5:神谕规划器设置下每个任务 50 个测试回合上的成功率(%)。人类与 Gemini-2.5-Pro(\dagger)的数据取自原报告 [9];GPT-4o 是我们在同一测试框架中的运行结果(RoboMME 报告为 30.6%)。“+corr.”表示仅对该任务施加最后一列所列的修正。^*F+T 是一项神谕接口诊断;不计入它时平均为 92.3%。粗体表示 GPT-6-Astra 达到或高于人类成绩的结果。
| Suite | Task | Human | Gemini^\dagger | GPT-4o | GPT-6-Astra | +corr. | corr. |
| Counting | BinFill | 96 | 78 | 58 | 98 | 98 | – |
| PickXtimes | 100 | 80 | 56 | 96 | 96 | – | |
| SwingXtimes | 80 | 58 | 18 | 100 | 100 | – | |
| StopCube | 78 | 32 | 42 | 48 | 86 | F+T^* | |
| Permanence | VideoUnmask | 90 | 86 | 34 | 100 | 100 | – |
| VideoUnmaskSwap | 92 | 18 | 20 | 78 | 100 | D | |
| ButtonUnmask | 92 | 82 | 58 | 100 | 100 | – | |
| ButtonUnmaskSwap | 90 | 12 | 32 | 64 | 100 | D | |
| Reference | PickHighlight | 92 | 78 | 40 | 28 | 100 | G |
| VideoRepick | 92 | 28 | 4 | 36 | 78 | D | |
| VideoPlaceButton | 98 | 50 | 16 | 86 | 86 | – | |
| VideoPlaceOrder | 90 | 60 | 18 | 90 | 90 | – | |
| Imitation | MoveCube | 90 | 66 | 76 | 86 | 86 | – |
| InsertPeg | 98 | 32 | 12 | 94 | 94 | – | |
| PatternLock | 84 | 4 | 6 | 70 | 100 | D | |
| RouteStick | 86 | 2 | 2 | 70 | 100 | D | |
| Average | 90.5 | 47.9 | 30.8 | 77.8 | 94.6 |
原表注:Table 5 Oracle-planner success rate (%) on the 50 test episodes of each task. Human and Gemini-2.5-Pro (\dagger) are as reported [9]; GPT-4o is our run in the same harness (RoboMME reports 30.6%). “+corr.” applies the correction in the last column to that task only. ^*F+T is an oracle-interface diagnostic; without it the average is 92.3%. Bold marks GPT-6-Astra results at or above the human score.
表 5 解读
各列:Suite、Task 同表 2;Human 为人类(神谕接口);Gemini 为 RoboMME 原论文报告的 Gemini-2.5-Pro;GPT-4o 为作者在自己框架下的运行结果;GPT-6-Astra 为未修正时的结果;+corr. 为施加修正后的结果;corr. 列出施加的是哪项修正(“–”表示该任务未修正,+corr. 沿用原值)。
关键观察:
关键观察:
- 修正命中的正是最弱的任务:未修正时 GPT-6-Astra 最低的几个任务是 PickHighlight(28)、VideoRepick(36)、StopCube(48)、ButtonUnmaskSwap(64)、PatternLock 和 RouteStick(各 70)、VideoUnmaskSwap(78),全部对应第 6 节分析的两类原因(帧太稀疏 \to D;神谕接口问题 \to G、F+T)。
- 修正效果:D 让 VideoUnmaskSwap、ButtonUnmaskSwap、PatternLock、RouteStick 全部达到 100,VideoRepick 从 36 升到 78;G 让 PickHighlight 从 28 到 100;F+T 让 StopCube 从 48 到 86。
- 与路点设置对照:神谕设置下 MoveCube 为 86,远高于路点设置下的 54。原因很可能是神谕技能会自动处理“松开夹爪”等细节,从而绕过了路点设置中“握着棍子宣布完成”的失败模式。反过来 StopCube 在两种设置下都是难点。
- 平均值核对:D+G 后为 92.3(表 3),再加 F+T 的 StopCube 提升 (86-48)/16 \approx 2.4 个点,即 92.25+2.375=94.625\approx 94.6(表 3 中的 92.3 本身是 92.25 四舍五入的结果;16 个任务 +corr. 列不计 F+T 时之和为 1476,1476/16=92.25)。
- Gemini 与 GPT-4o:两者在 PatternLock、RouteStick 这类需要复现轨迹的任务上几乎为零(2–6),说明上一代模型在稀疏帧下无法从演示中提取轨迹。