SuperMimic:用一个可微世界模型扩展人形机器人全身控制 SuperMimic: Scaling Humanoid Whole-Body Control with One Differentiable World Model Qiayuan Liao Yiyang Shao^{*} Junfeng Long^{*} Kevin Zakka
Roberto Horowitz Pieter Abbeel^{\dagger} Koushil Sreenath^{\dagger}
加州大学伯克利分校(UC Berkeley)
^{*}共同一作(Equal contribution) ^{\dagger}共同指导(Equal advising)
arXiv:2610.28480v1 [cs.RO],2026 年 10 月 20 日 第 10 届机器人学习会议(CoRL 2026,美国奥斯汀)
项目主页:https://supermimic.github.io
本文档说明。每段按“原文 / 译文 / 解释”三框排列。“原文”为该段完整英文(各段首句中的公式已用 LaTeX 重写,其余部分由脚本从原 PDF 抽取,行内数学符号可能以纯文本形式出现,如 ot、gt,请以原论文为准);译文完整翻译整段,解释框讲解动机、符号和数字。图片均裁自原论文。Roberto Horowitz Pieter Abbeel^{\dagger} Koushil Sreenath^{\dagger}
加州大学伯克利分校(UC Berkeley)
^{*}共同一作(Equal contribution) ^{\dagger}共同指导(Equal advising)
arXiv:2610.28480v1 [cs.RO],2026 年 10 月 20 日 第 10 届机器人学习会议(CoRL 2026,美国奥斯汀)
项目主页:https://supermimic.github.io
目录
导读一、这篇论文要解决什么问题二、核心思路三、主要结论四、读懂本文需要的背景知识五、阅读建议1 图 1 与摘要摘要2 引言(Introduction)3 相关工作(Related Work)4 方法4.1 SuperMimic 训练循环4.2 学习可微世界模型4.3 通过世界模型学习策略5 实验结果5.1 SuperMimic 以远少的 GPU 小时达到 SONIC 级别的追踪5.2 学到的世界模型的性质5.3 评论家使更短的时域和推搡恢复成为可能5.4 实机迁移5.5 下游任务:RL 编码器 vs. 蒸馏基线6 结论7 局限与未来工作8 致谢参考文献附录A 实例化:观测、动作、奖励与仿真上下文B 跨目标接口的联合训练C 网络结构D 训练循环与超参数D.1 算法(Algorithm)D.2 超参数(Hyperparameters)E 动作数据过滤F 评估F.1 基准指标(Benchmark metrics)F.2 失败动作(Failed motions)F.3 实验协议(Experiment protocols)G 速度指令任务G.1 训练设置(Training setup)G.2 阶跃测试(Step test)导读
一、这篇论文要解决什么问题
人形机器人“全身控制”(whole-body control)指同时协调腿、躯干、手臂等全部约 29 个关节,让机器人做出走、跑、跳、翻滚、跳舞、倒地后爬起等各种动作。当前最主流、效果最好的路线是动作模仿 / 动作追踪(motion imitation / motion tracking):先用动作捕捉(mocap)采集大量人类动作,把它“重定向”(retarget)到机器人骨架上,得到参考动作片段;再在物理仿真器里训练一个策略网络,让机器人在遵守物理规律的前提下尽量贴合参考动作。只要参考动作库够大、够多样,训练出的“通用追踪器”就能做几乎任何人类动作,再把速度指令、手柄、VR 等上层接口接到它上面。问题在于代价。这一路线几乎都用无模型强化学习(model-free RL,主要是 PPO)。作者对比的 SOTA 基线 SONIC 用 128 张 L40 GPU 训练约 168 小时(7 天),合计约 21,000 GPU 小时。动作库每扩大一次,算力就得跟着加。普通实验室很难承受,更谈不上系统研究“数据量—性能”的缩放规律(scaling law)。二、核心思路
作者的出发点是:参考动作千差万别,但执行这些动作的始终是同一台机器人、同一套刚体 + 接触动力学。无模型 RL 没有利用这一共享结构,每次都靠从仿真器采大量带噪声的轨迹,统计“这个动作好不好”。SuperMimic 的做法分三步,在同一个循环里交替进行:- 采数据:当前策略在 GPU 仿真器(MuJoCo Warp)里运行,把转移 (s_t,a_t,s_{t+1},r,d) 存入回放缓冲区。
- 拟合世界模型:用一个大 MLP f_\omega 学习“当前状态 + 动作 \to 下一状态”,它是可微的神经网络,充当仿真器的可微替身(surrogate)。
- 通过世界模型训练策略:从缓冲区里取一个真实状态作起点,用 f_\omega“想象”向前推演 H=32 步,把这 32 步的奖励加起来,再用评论家(critic)估计第 32 步之后的回报;然后对整条链随时间反向传播(BPTT),直接得到回报对策略参数的解析梯度(analytic policy gradient)。
三、主要结论
- 单张 H100 训练 3 小时,归一化回报就超过 SONIC 发布的检查点(0.90)。GPU 小时减少 1000 倍以上(约 21{,}504/3\approx 7200 倍),墙钟时间减少 50 倍以上(168/3=56)。
- 在 129,514 条动作的基准上,SuperMimic 只失败 25 条(SONIC 失败 179 条);两张 GPU 训练 9.8 小时后失败数为 0。
- 数据量从 1 小时增加到 264 小时(264 倍),世界模型的预测误差基本不变,达到目标回报所需的 GPU 小时只缓慢增长。
- 在 Unitree G1 实物上,侧滚、90° 空翻、原地 360° 空翻等高难度动作可直接部署。
- 作者把收益拆成三个来源:世界模型精度不随数据增多而下降;想象推演比仿真器快 10 倍以上;解析梯度比 PPO 的似然比梯度更省样本(同在世界模型上,所需想象步数少约 64 倍)。
四、读懂本文需要的背景知识
动作追踪的 RL 形式。 DeepMimic(2018)开创了这一范式:奖励按机器人各刚体的位置、朝向、线速度、角速度与参考动作的误差,用 \exp(-\text{误差}^2/\sigma^2) 计算;误差越小,奖励越接近 1。BeyondMimic、SONIC 和本文都沿用这种奖励(见附录表 A.2)。策略输出通常不是力矩,而是 PD 控制器的关节目标角,由低层 PD 控制器转换成力矩。无模型 RL 与 PPO。 策略梯度定理给出 \nabla_\theta J=\mathbb{E}[\nabla_\theta\log\pi_\theta(a|s)\,\hat A]:先采样动作,再看结果比平均好多少(优势 \hat A),据此调高或调低这个动作的概率。这叫似然比(likelihood-ratio,又称 REINFORCE / score function)估计。它把环境当黑箱,不需要知道动力学,但方差大,需要海量样本。PPO 在此基础上加裁剪,使更新更稳定,是机器人 RL 的默认算法;配合 IsaacGym 等 GPU 并行仿真,一次可跑上万个环境。基于模型的 RL(MBRL)与世界模型。 MBRL 先学一个动力学模型(“世界模型”),再利用它做规划或训练策略。Dyna(Sutton 1991)的思想是:用真实数据训练模型,再用模型生成“想象数据”训练策略;MBPO(Janner 等 2019)进一步提出从真实状态出发做短分支推演,以免模型误差随推演长度累积。Dreamer 系列在隐空间里学世界模型,再做想象中的 actor–critic;TD-MPC 把短程规划和终端价值结合。可微仿真与解析策略梯度。 如果动力学 s_{t+1}=f(s_t,a_t) 可微,就可以把整条轨迹的回报看成策略参数的可微函数,用链式法则直接求 \mathrm{d}J/\mathrm{d}\theta。这是路径式(pathwise / reparameterization)梯度,通常方差远小于似然比梯度。代价有两点:一是长时域上雅可比连乘会爆炸或消失;二是接触、碰撞让真实动力学不光滑,梯度可能失真。SHAC(2022)的解法是只做短时域 BPTT,再用评论家值函数“接上”时域之后的回报。SuperMimic 继承这一结构,但它的可微动力学来自学到的神经网络,而不是可微仿真器,因此可以搭配任何标准(不可微)的刚体仿真器。部分可观测与特权信息。 真实机器人只能看到本体感知(关节角、角速度、IMU 等,带噪声),看不到摩擦系数、质心偏移这类仿真参数。所以问题被建模为 POMDP。本文的世界模型和评论家可以使用“仿真上下文” \xi(域随机化参数)等特权信息,策略(actor)只看带噪声的观测,这样训练好的策略才能直接上真机。域随机化与 sim-to-real。 在仿真里随机化摩擦、标定误差、质量分布等参数,让策略对这些不确定性鲁棒,从而缩小“仿真—现实差距”,把策略零样本迁移到实物上。蒸馏与下游接口。 通用追踪器训好以后,常把“参考动作”换成更简单的指令,例如由 v_x、v_y、\omega_z 组成的速度指令。传统做法是蒸馏:让新接口模仿追踪器的行为,或用追踪奖励训练。本文还尝试直接用下游任务自己的奖励(速度追踪奖励),通过世界模型做 RL 训练,初步结果更好。五、阅读建议
先看图 2 掌握三阶段循环,再读 §3.2–3.3 的式 (1)–(3),这是全文的数学核心。§4 的实验按“总体对比 \to 原因分析 \to 评论家消融 \to 实物 \to 下游接口”展开。附录给出了奖励、网络结构、超参数和数据过滤等实现细节,复现时很有用。1图 1 与摘要
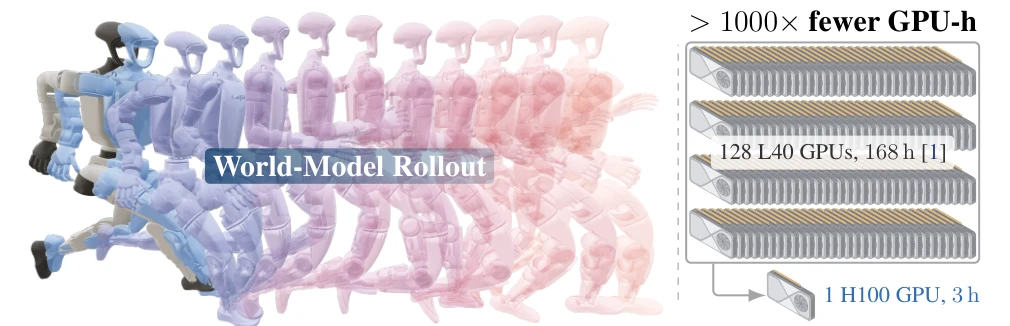
图 1 解读
左半部分是一串半透明的 Unitree G1 机器人残影,颜色从蓝渐变到粉红,表示一次“世界模型推演”在时间上展开:最左边(实色、蓝色)是从回放缓冲区取出的真实初始状态,往右每一帧都是世界模型 f_\omega 预测出来的“想象”状态,越往后颜色越淡,暗示越靠后的预测越“虚”。这些帧里没有调用仿真器,全部由神经网络算出,因此整条轨迹对策略参数可微,梯度可以从后面的奖励一路传回前面的动作。右半部分用 GPU 卡片的数量做直观对比:上方四排密密麻麻的显卡代表 SONIC 的 128 张 L40 \times 168 h,下方一张卡代表 SuperMimic 的 1 张 H100 \times 3 h。标题“>1000\times fewer GPU-h”是全文最核心的数字:128\times168=21{,}504 GPU 小时,除以 3 约为 7200 倍。注意这里比较的是“超过 SONIC 发布检查点回报”所需的算力,而不是两者训练到收敛的总算力(§4.1 有详细的算力核算)。这张图在论文中的作用是“一图概括”:方法是世界模型推演,卖点是算力下降三个数量级。
摘要
原文
Tracking large human-motion datasets has become the dominant route to general, expressive humanoid whole-body control, but scaling across many motions is expensive. Current pipelines use model-free reinforcement learning, either merging per-motion specialists through lossy distillation, or brute-forcing a single policy with cluster-scale compute. SuperMimic amortizes learning across all motions with one differentiable world model of their shared dynamics, fit from logged transitions of a standard rigid-body simulator. The world model and the tracking policy train together in one loop, and backpropagation-through-time over short imagined rollouts gives the policy analytic gradients. Fast imagined rollouts and analytic gradients make policy learning efficient. In 3 hours on a single GPU, SuperMimic surpasses the return of a state-of-the-art motion tracker baseline trained for 7 days on 128 GPUs. It reduces GPU-hours by more than 1000\times and fails on only 25 of 129,514 benchmark motions, versus 179 failures for the baseline. After 9.8 hours on two GPUs, SuperMimic achieves zero failures. From 1 to 264 hours of motion, the world model's prediction error stays stable, and GPU-hours to a target return grow slowly. Our policy transfers to a physical Unitree G1 across diverse and acrobatic motions. SuperMimic removes compute as the bottleneck to scaling humanoid whole-body control, making it practical to measure motiontracking scaling laws.
译文
追踪大规模人类动作数据集,已成为实现通用、富有表现力的人形机器人全身控制的主流路线,但要扩展到大量动作,代价高昂。现有流水线使用无模型强化学习(model-free reinforcement learning):要么通过有损的蒸馏(distillation)合并针对单个动作的专家策略,要么用集群规模的算力硬训出单一策略。SuperMimic 用一个刻画所有动作共享动力学的可微世界模型(differentiable world model),把学习成本摊销(amortize)到所有动作上;该模型由标准刚体仿真器记录下来的转移数据拟合而成。世界模型与追踪策略在同一个循环中联合训练,对短的想象推演做随时间反向传播(backpropagation-through-time, BPTT),为策略提供解析梯度(analytic gradients)。快速的想象推演和解析梯度共同使策略学习变得高效。SuperMimic 在单张 GPU 上训练 3 小时,回报就超过了一个在 128 张 GPU 上训练 7 天的 SOTA 动作追踪基线。它把 GPU 小时减少了 1000 倍以上,在 129,514 条基准动作中只失败 25 条,而基线失败 179 条。在两张 GPU 上训练 9.8 小时后,SuperMimic 实现零失败。动作数据从 1 小时增加到 264 小时,世界模型的预测误差保持稳定,达到目标回报所需的 GPU 小时增长缓慢。我们的策略可迁移到实体 Unitree G1,完成多种动作,包括杂技动作。SuperMimic 消除了算力这一扩展人形全身控制的瓶颈,使测量动作追踪的缩放规律(scaling laws)变得切实可行。
解释
摘要按“问题—现有方案的缺陷—本文方法—数字结果—意义”展开。
- “两种现有方案”:BeyondMimic 一类先为每段动作单独训专家,再蒸馏成一个策略(蒸馏会损失性能,所以说“有损”);SONIC 一类直接在整个动作库上训练一个通用策略,靠堆 GPU。
- “摊销”是本文的关键词:模型学到的是机器人本身的物理,与具体哪段动作无关。新加入的动作不用重新学物理,只需让策略学会新目标,所以边际成本低。
- “由标准刚体仿真器的转移数据拟合”:说明它不需要可微仿真器,任何能跑的仿真器都行。
- 数字核对:128 GPU \times 7 天 =128\times168=21{,}504 GPU 小时;SuperMimic 用 3 GPU 小时,比值约 7200,远大于 1000。两卡 9.8 小时即 19.6 GPU 小时,仍比 SONIC 少约 1100 倍。
- 最后一句的“缩放规律”:在大模型领域,人们通过大量不同规模的实验拟合“性能—数据—算力”曲线。若每次实验要 2 万 GPU 小时,这种研究在机器人领域做不起;降到每次一张卡几小时,就有可能做了。
原文
Keywords: Humanoid Robot, Whole-Body Control, Model-Based Reinforcement Learning
译文
关键词:人形机器人,全身控制,基于模型的强化学习
解释
三个关键词点明了领域(人形机器人)、任务(全身控制)和方法类别(MBRL)。值得注意的是,本文把 MBRL 用在了长期由 PPO 主导的人形动作追踪领域。
2引言(Introduction)
原文
Humanoid robots hold the promise of operating in environments designed for people, but doing so requires whole-body controllers that span diverse human motion, from locomotion and dance to crouching and balance recovery. Physics-based motion imitation addresses this by training RL *Equal contribution. †Equal advising.
译文
人形机器人有望在为人类设计的环境中工作,但这需要能覆盖多样人类动作的全身控制器:从行走、跳舞,到下蹲和失衡恢复。基于物理的动作模仿(physics-based motion imitation)通过训练 RL 策略去追踪参考动作片段 [2] 来解决这一问题,这些片段取自大规模动作捕捉(motion-capture, mocap)数据集 [1]。现有系统沿两种方式扩展这一思路:要么把许多针对单个片段的专家蒸馏成一个控制器 [3],要么在大型动作库上训练一个通用策略 [1]。两种方式下,动作库越多样,得到的控制器能力越强。但随着动作覆盖面扩大,两者的计算代价也越来越高:例如 SOTA 追踪器 SONIC [1] 在 128 张 GPU 上训练约 168 小时,合计约 21,000 GPU 小时。尽管参考动作各不相同,它们共享同一套人形机器人的混合刚体动力学(hybrid rigid-body dynamics)。无模型 RL 没有显式建模这种共享结构,而是反复从带噪声的仿真推演中估计动作的后果。因此,扩展到更多动作就等于扩大算力。
解释
这一段是全文的动机论证,逻辑链很清楚:
- 想要通用人形控制 \to 动作模仿是有效路线;
- 动作库越大越好 \to 但算力随之暴涨;
- 根因:所有动作共享同一个身体的物理,而无模型 RL 没利用这点,每次都“从头”用采样去估计“这个动作会导致什么后果”。
原文
SuperMimic addresses this inefficiency with a single learned, differentiable world model fit from logged simulator transitions. Backpropagation-through-time (BPTT) through short imagined rollouts provides analytic policy gradients through the learned model, allowing one dynamics model to amortize learning across the entire mocap library. Because these gradients come from the learned model rather than from differentiating the simulator, SuperMimic remains compatible with rigidbody simulators, including those with non-smooth contacts and non-differentiable implementations.
译文
SuperMimic 用一个从仿真器记录的转移数据中学到的可微世界模型来解决这种低效。通过对短的想象推演做随时间反向传播(BPTT),可以经由学到的模型得到解析策略梯度,从而让一个动力学模型把学习成本摊销到整个 mocap 动作库上。由于这些梯度来自学到的模型,而不是对仿真器求导,SuperMimic 仍兼容各类刚体仿真器,包括接触不光滑、实现上不可微的仿真器。在一张 GPU 上,SuperMimic 在 3 小时内超过 SONIC 发布检查点的归一化回报,并把 GPU 小时减少 1000 倍以上(§4.1)。在一个包含 129,514 条动作的基准上,SuperMimic 在单 GPU 训练 3 小时后失败 25 条,在双 GPU 训练 9.8 小时后零失败,而 SONIC 的发布检查点失败 179 条(附录 F)。数据集时长增加 264 倍,世界模型的预测误差保持稳定,SuperMimic 达到固定回报所需的算力增长缓慢。学到的策略可以迁移到实体 Unitree G1。在一项关于下游接口的初步研究中,用 RL 训练的速度编码器优于蒸馏基线。
解释
这段是方法与结果的总览。需要特别理解“梯度来自学到的模型,而非仿真器”这一设计选择:
- 方案 A:可微仿真器(如 SHAC 用的 dflex、Brax 等)。直接对物理引擎求导,梯度“精确”,但仿真器必须专门写成可微的;而且接触碰撞处的真实梯度是不连续的(一个微小的动作变化可能让脚从“刚好没碰地”变成“碰地”,状态突变),直接求导反而会得到无用甚至有害的梯度。
- 方案 B(本文):学一个神经网络替身。网络天然光滑可微,相当于对真实不光滑动力学做了一个“平滑近似”,梯度反而更有用。仿真器只负责产生训练数据,可以用任何成熟的非可微仿真器(本文用 MuJoCo Warp)。
原文
Contributions.
译文
贡献。
- 面向可部署人形控制的基于模型的 RL(MBRL)。我们证明:在长期由无模型近端策略优化(proximal policy optimization, PPO)[4] 主导的场景中,通过学到的可微世界模型做 BPTT,能够训练出全身追踪策略,并且得到的控制器能迁移到实体 Unitree G1。
- 算力不再是扩展的瓶颈。SuperMimic 在单张 GPU 上超过集群规模 PPO 流水线 SONIC 的回报,并把 GPU 小时减少 1000 倍以上(§4.1)。随着动作库扩大,其训练成本增长缓慢,使扩展人形全身控制不再依赖庞大的 GPU 基础设施。
- 对收益来源的分析。我们找出了带来算力下降的三个世界模型性质:数据集时长增加 264 倍时预测误差保持稳定;推演速度比仿真器快 10 倍以上;以及解析梯度——借助它,策略达到“在世界模型上跑 PPO”的最佳回报时,所需想象步数少约 64 倍。
- 超越蒸馏、由 RL 训练的下游控制。作为初步研究,同一个学到的世界模型用接口自身的任务奖励训练下游目标编码器。在速度指令上,使用该编码器的策略比蒸馏基线追踪得更准。
解释
四条贡献分别对应后文:第一条对应 §3 方法和 §4.4 实物部署;第二条对应 §4.1 和图 3;第三条对应 §4.2 和图 3(c)、图 5;第四条对应 §4.5、附录 B/G 和图 7。第三条是理解本文的关键。它把 1000 倍的加速拆成相互独立的因素:(i) 精度不随数据退化,说明“一个模型通吃”成立;(ii) 每步推演更便宜(>10\times);(iii) 每步推演的信息利用效率更高(同样在世界模型上,BPTT 比 PPO 少用约 64 倍的想象步数)。粗略地说,(ii) 与 (iii) 相乘已经是数百倍量级,再加上不用多卡通信、样本复用等因素,就不难理解总体上千倍的差距。“PPO on the world model”(PPO-WM)这个对照实验很巧妙:它让 PPO 也在同一个世界模型里跑,排除“推演快”这个因素,单独衡量“解析梯度”的贡献。
3相关工作(Related Work)
原文
Large-scale physics-based motion tracking. Physics-based motion imitation learns controllers that reproduce reference motions under contact-rich rigid-body dynamics. DeepMimic [2] demonstrated expressive character skills through model-free reinforcement learning, and PHC [11] extended this paradigm to large motion sets with robust recovery. SONIC [1] further demonstrated that scaling motion data, policy capacity, and training compute produces generalist controllers that transfer to humanoid hardware. These results establish motion tracking as a practical route to broad wholebody behavior coverage. However, training these large-scale motion trackers requires extensive simulator rollouts and substantial computation. SuperMimic addresses this bottleneck by learning a differentiable dynamics model shared across all motions, so policy improvement can exploit analytic gradients rather than model-free rollout estimates.
译文
大规模基于物理的动作追踪。基于物理的动作模仿学习控制器,使其在接触丰富的刚体动力学下复现参考动作。DeepMimic [2] 通过无模型强化学习展示了富有表现力的角色技能,PHC [11] 把这一范式扩展到大规模动作集合,并具备稳健的恢复能力。SONIC [1] 进一步证明:扩大动作数据、策略容量和训练算力,可以得到能迁移到人形机器人硬件的通用控制器。这些结果确立了动作追踪作为覆盖广泛全身行为的实用路线。然而,训练这些大规模动作追踪器需要大量仿真推演和可观的计算。SuperMimic 通过学习一个在所有动作间共享的可微动力学模型来解决这一瓶颈,使策略改进可以利用解析梯度,而不是无模型的推演估计。
解释
这段梳理了动作追踪这条技术线的演进:
- DeepMimic(2018):用 PPO 为每段动作训练一个策略,奖励是与参考姿态的相似度,同时提出参考状态初始化(从参考动作中随机一帧开始)和提前终止等技巧,是这一领域的奠基工作。
- PHC(2023):“永续人形控制”,一个策略追踪 AMASS 等大规模动作数据集,摔倒后还能自己爬起来继续追踪。
- SONIC(2026):把“扩大数据、模型、算力”这一大模型思路搬到人形机器人上,证明规模化有效,代价是巨大的算力。
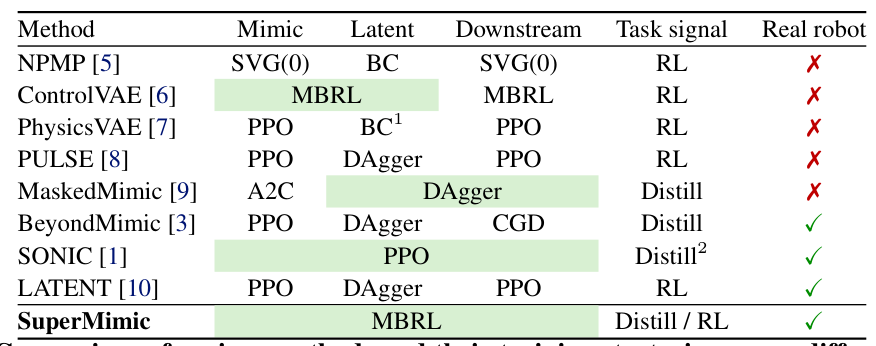
表 1 解读
列的含义。典型的“可复用运动控制器”分三个阶段:
- Mimic:训练一个(或多个)追踪参考动作的控制器;
- Latent:学习一个运动隐空间(latent space),把各种动作压缩成隐变量 z,再由解码器把 z 变成关节动作;
- Downstream:在隐空间之上训练下游接口(速度指令、目标点、文本等)。
- NPMP、PhysicsVAE、PULSE、LATENT:三阶段依次训练(单元格未合并),每一步冻结前一步。多数用 PPO 训追踪器,再用 BC / DAgger 把多个专家压进隐空间,最后在隐空间上做 RL。
- ControlVAE:前两阶段合并为 MBRL,即用学到的世界模型联合训练追踪与隐空间,下游也用 MBRL。它是本文最接近的前驱,但只在仿真角色上做,没有上真机。
- MaskedMimic:Latent 和 Downstream 合并,用 DAgger 一起训练(掩码动作补全)。
- BeyondMimic:PPO 追踪 \to DAgger 蒸馏 \to 扩散模型加分类器引导做下游,下游信号是蒸馏式的;有真机。
- SONIC:三个阶段全部合并成一个 PPO 训练,下游编码器用追踪奖励加隐变量对齐损失(脚注 2),不用任务奖励。
- SuperMimic:三个阶段合并为一次 MBRL 训练;下游接口既可蒸馏也可 RL(Distill / RL);有真机。
原文
Learned differentiable dynamics for motion control. SuperTrack [12] optimizes motion-control policies through a learned differentiable surrogate of the simulator. ControlVAE [6] jointly learns a dynamics model, latent skill representation, and generative controller, while MoConVQ [13] extends learned-model training to discrete motion representations over tens of hours of data. SuperDyno [14] scales differentiable neural dynamics to tens of thousands of motion clips. These methods establish the effectiveness of learned dynamics and analytic policy gradients for scalable simulated-character control. SuperMimic extends this direction to single-GPU training of a large-scale humanoid tracker and to its sim-to-real deployment: its world model conditions on simulator context, while the deployed actor uses noisy proprioceptive observations and a goal input (§3.2). We evaluate how model accuracy, rollout throughput, and differentiable policy updates contribute to training efficiency, and how prediction error behaves as motion coverage grows (§4.1–4.2), and demonstrate physical deployment of the resulting controller (§4.4).
译文
用于运动控制的学习型可微动力学。SuperTrack [12] 通过学到的、可微的仿真器替身(surrogate)来优化运动控制策略。ControlVAE [6] 联合学习动力学模型、隐技能表示和生成式控制器;MoConVQ [13] 把基于学习模型的训练扩展到离散动作表示,数据量达数十小时。SuperDyno [14] 把可微神经动力学扩展到数万个动作片段。这些方法确立了学到的动力学与解析策略梯度在可扩展的仿真角色控制中的有效性。SuperMimic 把这一方向推进到大规模人形追踪器的单 GPU 训练及其 sim-to-real 部署:其世界模型以仿真上下文为条件,而部署的执行器(actor)使用带噪声的本体感知观测和目标输入(§3.2)。我们评估了模型精度、推演吞吐量和可微策略更新各自对训练效率的贡献,研究了预测误差随动作覆盖增长如何变化(§4.1–4.2),并展示了所得控制器在实体上的部署(§4.4)。
解释
这段介绍最直接的前人工作,它们来自计算机图形学(角色动画)领域:
- SuperTrack(2021,育碧):首次提出“学一个世界模型 \to 通过它反传训练追踪策略”,称之为“监督学习式”的动作追踪。本文名字“SuperMimic”显然向它致敬。
- ControlVAE / MoConVQ:在此基础上加入 VAE / VQ 隐空间,学可复用技能。
- SuperDyno:已扩展到数万段动作,与本文规模接近,但限于仿真。
原文
Model-based policy optimization and robot deployment. Dreamer [15] and DreamerV3 [16] learn latent dynamics for imagination-based actor–critic learning, while TD-MPC [17] combines short-horizon planning with terminal-value prediction. DayDreamer [18] demonstrates world-model learning directly on physical robots. SHAC [19] uses differentiable simulation for short-horizon actor–critic updates, motivating SuperMimic's critic-bootstrapped objective. Analytic-gradient robot control can also combine a simplified differentiable surrogate with a high-fidelity forward simulator, as demonstrated for quadruped locomotion [20]. SuperMimic learns its surrogate from simulator transitions and backpropagates through short imagined rollouts, retaining compatibility with standard rigid-body simulators.
译文
基于模型的策略优化与机器人部署。Dreamer [15] 和 DreamerV3 [16] 学习隐空间动力学,用于基于想象的 actor–critic 学习;TD-MPC [17] 把短时域规划与终端价值预测相结合。DayDreamer [18] 展示了直接在实体机器人上学习世界模型。SHAC [19] 利用可微仿真做短时域 actor–critic 更新,启发了 SuperMimic 用评论家自举(bootstrap)的目标函数。解析梯度机器人控制也可以把简化的可微替身与高保真前向仿真器结合,这一点已在四足行走上得到展示 [20]。SuperMimic 从仿真器转移中学习替身,并通过短的想象推演反向传播,从而保持与标准刚体仿真器的兼容性。
解释
这段把本文放进更广的 MBRL 谱系:
- Dreamer 系列:在隐空间学世界模型,在“梦”里训练 actor–critic;DreamerV1 的 actor 也是通过隐空间动力学反传价值梯度,思想与本文一致,但它面向像素输入、通用任务。
- TD-MPC:在线规划(MPC)+ 时序差分学到的终端价值。
- SHAC:本文策略优化目标(式 2)的直接来源:短时域 H 内对可微仿真器做 BPTT,时域末端用评论家 V 截断。区别在于 SHAC 对仿真器求导,本文对学到的模型求导。
- 文献 [20](Song 等,四足):前向用高保真仿真器,反向用简化可微模型的梯度,是另一种“混合”方案。
原文
RWM [21] and RWM-U [22] demonstrate that policies trained in learned neural simulators can transfer to physical robots. Both optimize policies using PPO on imagined rollouts; RWM-U additionally uses uncertainty-penalized offline optimization. SuperMimic instead optimizes the policy by differentiating the return through its learned dynamics. RWM and RWM-U pretrain the world model on trajectories from other policies. In contrast, SuperMimic fits its world model during training on data its own policy collects.
译文
RWM [21] 和 RWM-U [22] 证明,在学到的神经仿真器中训练的策略可以迁移到实体机器人。两者都在想象推演上用 PPO 优化策略;RWM-U 还采用了带不确定性惩罚的离线优化。SuperMimic 则通过学到的动力学对回报求导来优化策略。RWM 与 RWM-U 用其他策略产生的轨迹预训练世界模型;相比之下,SuperMimic 在训练过程中、用其自身策略采集的数据拟合世界模型。
解释
这段与 RWM 系列(ETH 的 Hutter 组)做两点区分:
- 怎么用世界模型:RWM 只把它当“快速仿真器”,上面照样跑 PPO(似然比梯度);SuperMimic 利用了它的可微性,直接求解析梯度。§4.2 的 PPO-WM 对照实验正是在检验这一区别的价值。
- 数据从哪来:RWM 先用别的策略收集数据离线预训练模型;SuperMimic 在线(on-the-fly)边训练边用当前策略收集数据,模型始终覆盖当前策略会访问的状态分布,避免分布偏移导致模型在关键区域失准。
原文
Reusable motion representations and downstream control. Reusable controllers connect motion tracking to downstream goal interfaces (Table 1). NPMP [5] and PhysicsVAE [7] learn latent motor representations from expert behavior; PULSE [8] and LATENT [10] use learned motion representations for downstream reinforcement learning. MaskedMimic [9] supports partial-body and multimodal goals through motion inpainting, while BeyondMimic [3] uses guided diffusion for goal (1) Collect data (2) Fit world model (3) Improve policy
译文
可复用的动作表示与下游控制。可复用控制器把动作追踪与下游目标接口连接起来(表 1)。NPMP [5] 和 PhysicsVAE [7] 从专家行为中学习隐式运动表示;PULSE [8] 和 LATENT [10] 利用学到的动作表示做下游强化学习。MaskedMimic [9] 通过动作补全(motion inpainting)支持局部身体与多模态目标,BeyondMimic [3] 用引导扩散实现目标跟随。SONIC [1] 用追踪奖励和隐变量对齐损失,把目标编码器与追踪器联合训练。ControlVAE [6] 在冻结技能控制器的同时,通过其学到的模型优化下游任务策略。SuperMimic 通过同一个动力学模型联合训练各目标专属的编码器和一个共享解码器(附录 B)。目标接口既可以优化参考追踪奖励,也可以优化自身的任务奖励。我们的初步研究分别以这两种目标,各训练一次与动作追踪接口并行的速度接口(§4.5)。
解释
这段对应表 1 的“Latent / Downstream”两列。核心问题是:通用追踪器需要完整参考动作作为输入,但实际使用时用户往往只给出部分信息(速度、手的位置、一段文字……),如何把这些“不完整的目标”接到追踪器上?
- 隐空间路线(NPMP/PULSE/LATENT):先学一个运动隐空间,下游策略只需在隐空间里输出 z。
- 补全路线(MaskedMimic):把缺失部分当作“被掩码”的参考动作来补全。
- 生成路线(BeyondMimic):扩散模型生成轨迹,再用分类器引导满足目标。
- SuperMimic:编码器—解码器结构,每种接口一个编码器 \mathrm{enc}_{\theta,i},共享一个解码器 \mathrm{dec}_\theta,全部通过同一个世界模型联合训练。由于有可微世界模型,下游接口可以直接最大化自己的任务奖励(RL),而不必只做蒸馏。
4方法(Method)
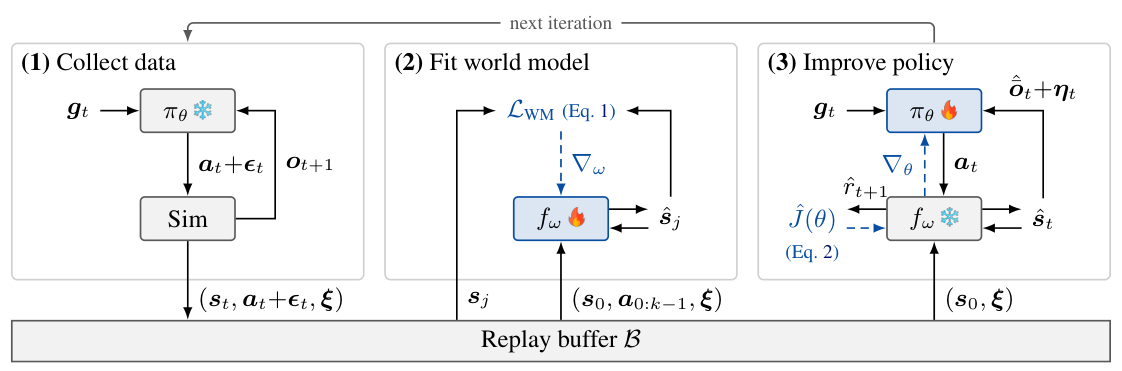
图 2 解读
图分三块,对应一次迭代的三个阶段,底部横条是三者共用的回放缓冲区 \mathcal{B},顶部箭头“next iteration”表示循环往复。
- (1) 采数据:策略 \pi_\theta(雪花 = 此阶段不更新)接收目标 \boldsymbol{g}_t 和观测 \boldsymbol{o}_{t+1}(闭环反馈),输出动作 \boldsymbol{a}_t,叠加探索噪声 \boldsymbol{\epsilon}_t 后送入仿真器 Sim。写入缓冲区的是三元组 (\boldsymbol{s}_t,\boldsymbol{a}_t+\boldsymbol{\epsilon}_t,\boldsymbol{\xi}):真实状态、实际执行的带噪动作、本回合的仿真参数。
- (2) 拟合世界模型:从缓冲区取出起点 \boldsymbol{s}_0 和一段 k 步动作序列 \boldsymbol{a}_{0:k-1},让 f_\omega(火焰 = 此阶段训练)自回归地预测 \hat{\boldsymbol{s}}_j(右侧小回路表示预测结果再喂回自己),与缓冲区里的真实 \boldsymbol{s}_j 比较,算出 \mathcal L_{\mathrm{WM}}(式 1),梯度 \nabla_\omega(蓝色虚线)只更新 f_\omega。
- (3) 改进策略:这次 f_\omega 冻结,\pi_\theta 被训练。从缓冲区只取起点 (\boldsymbol{s}_0,\boldsymbol{\xi}),之后完全在模型里推演:f_\omega 输出预测状态 \hat{\boldsymbol{s}}_t 与无噪声观测 \hat{\bar{\boldsymbol{o}}}_t,加上传感器噪声 \boldsymbol{\eta}_t 喂给策略,策略输出 \boldsymbol{a}_t 再进入 f_\omega……同时产生预测奖励 \hat r_{t+1},汇总成目标 \hat J(\theta)(式 2)。蓝色虚线 \nabla_\theta 表示梯度从 \hat J 沿着 f_\omega 反向流回 \pi_\theta。
4.1SuperMimic 训练循环(SuperMimic training loop)
原文
SuperMimic trains one goal-conditioned whole-body controller across a multi-skill motion library and supports multiple goal interfaces. It captures the shared humanoid dynamics in a differentiable world model and improves the policy through short imagined rollouts. Training alternates between three phases in one loop (Figure 2). First, the current policy collects simulator transitions into a replay buffer. Second, we fit the differentiable world model to short replay windows. Third, the policy is improved by backpropagating an imagined return through the frozen world model, with each rollout seeded from a replay-buffer state in the Dyna style [23, 24]. The buffer, model, and policy are updated throughout training, so dynamics learning and control improve together rather than in separate stages (Algorithm A.1, Appendix D). Transitions from earlier policies remain valid for fitting the world model, because the dynamics do not depend on the policy that collected them.
译文
SuperMimic 在一个多技能动作库上训练单个以目标为条件(goal-conditioned)的全身控制器,并支持多种目标接口。它在一个可微世界模型中刻画人形机器人共享的动力学,并通过短的想象推演改进策略。训练在一个循环里交替执行三个阶段(图 2)。第一,当前策略把仿真器转移收集到回放缓冲区(replay buffer)。第二,在短的回放窗口上拟合可微世界模型。第三,通过冻结的世界模型反向传播想象回报来改进策略,每条推演都以 Dyna 风格 [23, 24] 从回放缓冲区中的某个状态出发。缓冲区、模型和策略在整个训练中持续更新,因此动力学学习与控制改进是同步推进的,而非分阶段进行(算法 A.1,附录 D)。由早期策略产生的转移仍可用于拟合世界模型,因为动力学并不依赖于收集数据的策略。
解释
Dyna 风格:Sutton 1991 年提出“真实经验训练模型、模型生成模拟经验训练策略”的统一框架;MBPO(文献 [24])进一步提出:想象推演要从真实状态分支出来,并且只推几步,以控制模型误差累积。本文正是这样做:起点 \boldsymbol{s}_0 永远来自缓冲区中的真实仿真状态。同步而非分阶段:如果先收集数据、训练好模型、再训练策略(分阶段),模型只见过旧策略访问的状态;策略一旦进步,就会进入模型没见过的区域,模型误差被策略“钻空子”。交替训练能让模型持续覆盖当前策略的状态分布。最后一句很重要:动力学 p(s_{t+1}\mid s_t,a_t) 是物理规律,与“谁选的动作”无关,所以世界模型的训练是 off-policy 的,旧数据不会“过期”。这与 PPO 截然不同:PPO 是 on-policy 算法,每批数据用几轮就必须丢弃。数据复用是 MBRL 样本效率高的一个基本原因。
原文
We denote the goal-conditioned partially observable Markov decision process (POMDP) by \mathcal{M} and use compact notation with state \boldsymbol{s}_t, goal \boldsymbol{g}_t, and action \boldsymbol{a}_t. State st gives the proprioceptive observation ot and the termination dt, which is 1 if st is terminal. Action at in state st yields the reward rt+1 and the next state st+1. The policy is deterministic, at = \pi\theta(ot, gt), and at parameterizes a normalized joint setpoint; for motion tracking, gt is read from a reference motion. During data collection, the simulator executes the noisy action at + ϵt with action noise ϵt \sim\rhoϵ, and the replay buffer stores this executed noisy action. The noise widens the range of actions on which the world model is fit; it serves only the model fit and is optional. Returns use a soft survival weight, c0 = 1 and ct+1 = ct(1-dt+1), giving J(\theta) = E[P t\ge0 \gammatctrt+1] with discount \gamma \in[0, 1). The simulator logs hard terminations, while the learned model predicts a termination probability ˆdt \in[0, 1], which keeps the survival weight differentiable in imagined rollouts. Throughout, a hat marks the world-model counterpart of a simulator quantity. We also factor the observation as ot = ¯ot + \etat, with ¯ot the noise-free observation and known observation noise \etat \sim\rho\eta sampled outside the world model. Appendix A gives the full spaces and reward.
c_0=1,\qquad c_{t+1}=c_t(1-d_{t+1}),\qquad J(\theta)=\mathbb{E}\Big[\sum_{t\ge 0}\gamma^t c_t\, r_{t+1}\Big],\quad \gamma\in[0,1).
译文
我们用 \mathcal M 表示以目标为条件的部分可观测马尔可夫决策过程(partially observable Markov decision process, POMDP),并采用紧凑记号:状态 \boldsymbol{s}_t、目标 \boldsymbol{g}_t、动作 \boldsymbol{a}_t。由状态 \boldsymbol{s}_t 可得到本体感知观测 \boldsymbol{o}_t 和终止标志 d_t;若 \boldsymbol{s}_t 为终止状态则 d_t=1。在状态 \boldsymbol{s}_t 下执行动作 \boldsymbol{a}_t,得到奖励 r_{t+1} 和下一状态 \boldsymbol{s}_{t+1}。策略是确定性的:\boldsymbol{a}_t=\pi_\theta(\boldsymbol{o}_t,\boldsymbol{g}_t),\boldsymbol{a}_t 参数化一个归一化的关节设定点(joint setpoint);对动作追踪而言,\boldsymbol{g}_t 从参考动作中读取。数据收集时,仿真器执行带噪声的动作 \boldsymbol{a}_t+\boldsymbol{\epsilon}_t,动作噪声 \boldsymbol{\epsilon}_t\sim\rho_\epsilon,回放缓冲区存储这个实际执行的带噪动作。噪声扩大了世界模型拟合时覆盖的动作范围;它只服务于模型拟合,并且是可选的。回报使用软生存权重(soft survival weight):c_0=1,c_{t+1}=c_t(1-d_{t+1}),从而 J(\theta)=\mathbb E[\sum_{t\ge0}\gamma^t c_t r_{t+1}],折扣因子 \gamma\in[0,1)。仿真器记录的是硬终止,而学到的模型预测终止概率 \hat d_t\in[0,1],这使生存权重在想象推演中保持可微。全文中,带“帽子”的量表示仿真器量在世界模型中的对应物。我们还把观测分解为 \boldsymbol{o}_t=\bar{\boldsymbol{o}}_t+\boldsymbol{\eta}_t,其中 \bar{\boldsymbol{o}}_t 是无噪声观测,\boldsymbol{\eta}_t\sim\rho_\eta 是已知的观测噪声,在世界模型外部采样。附录 A 给出完整的空间定义与奖励。
解释
这段是全文的符号表,逐个解释:
- \boldsymbol{s}_t:完整仿真状态(各关节角、速度、根节点位姿等);\boldsymbol{o}_t:机器人实际能测到的本体感知(附录表 A.1,共 93 维),是 \boldsymbol{s}_t 的函数加噪声。
- \boldsymbol{g}_t:目标,动作追踪时是参考动作未来 10 帧(附录 A);速度接口时是 (v_x,v_y,\omega_z)。
- \pi_\theta 确定性:输出就是动作本身,没有概率分布。这对 BPTT 很自然:\partial\boldsymbol{a}_t/\partial\theta 直接可求。PPO 则必须用随机策略(高斯分布)才能计算 \log\pi。
- 动作噪声 \boldsymbol{\epsilon}_t 只用于采数据:让缓冲区里包含当前策略附近的动作,使世界模型在“策略稍微偏一点会怎样”上也准确。这很关键:BPTT 要用 \partial f/\partial \boldsymbol{a},模型只有见过动作的邻域,这个导数才可信。
- 软生存权重 c_t:c_t=\prod_{k=1}^{t}(1-d_k),表示“活到第 t 步”的指示。在仿真器中 d\in\{0,1\},一旦摔倒 c 变为 0,之后奖励全部清零。在世界模型中 \hat d\in[0,1] 是概率,于是 \hat c_t=\prod(1-\hat d_k) 就是“存活概率”,它对状态可微。梯度会推动策略降低 \hat d(远离摔倒)。若用硬阈值,梯度为 0,策略无法从“摔倒”中学到任何东西。
- 回报下标约定:r_{t+1} 是在 t 时刻执行动作后得到的奖励,所以 c_t 乘 r_{t+1}:只有 t 时刻还活着,才能拿到这一步的奖励。
- 观测分解 \boldsymbol{o}=\bar{\boldsymbol{o}}+\boldsymbol{\eta}:传感器噪声分布 \rho_\eta 是人为设定的(表 A.1 的均匀分布),没必要让网络去学。世界模型只预测干净观测,噪声在外面另加。这样模型是确定性的,训练更简单;策略在想象中也能看到“带噪观测”,与真机条件一致。
原文
The default interface is full-reference motion tracking. Other goal interfaces, such as velocity, share the same learned dynamics and train jointly with motion tracking (Appendix B).
译文
默认接口是完整参考动作追踪。其他目标接口(如速度)共享同一个学到的动力学模型,并与动作追踪联合训练(附录 B)。
解释
“接口”(interface)指策略接受何种形式的目标输入。默认接口给出完整参考动作;速度接口只给期望速度。由于身体物理相同,同一个 f_\omega 可服务所有接口,这一点在附录 B 中形式化。
4.2学习可微世界模型(Learning a differentiable world model)
原文
The simulator's articulated multi-rigid-body dynamics are known, but the simulator need not provide gradients, so SuperMimic learns a differentiable surrogate to obtain policy gradients: it supplies the predictions and Jacobians for the BPTT update in §3.3. The resulting analytic policy gradient is the gradient of a surrogate for the expected return in simulation. Since the simulator's randomness has known sources, the world model stays deterministic: it conditions on the per-episode sim context \xi (friction, calibration offsets, and torso center-of-mass) and predicts the noise-free observation ¯ot.
译文
仿真器的多刚体铰接动力学是已知的,但仿真器不一定提供梯度,因此 SuperMimic 学习一个可微替身来获得策略梯度:它为 §3.3 中的 BPTT 更新提供预测和雅可比矩阵(Jacobian)。由此得到的解析策略梯度,是仿真中期望回报的一个替身目标的梯度。由于仿真器的随机性来源已知,世界模型保持确定性:它以每个回合的仿真上下文 \boldsymbol{\xi}(摩擦、标定偏移和躯干质心)为条件,并预测无噪声观测 \bar{\boldsymbol{o}}_t。
解释
“动力学已知但没有梯度”:MuJoCo 的方程是公开的,但 MuJoCo Warp 并未针对反向传播设计,接触求解也不光滑。所以作者绕道:训练一个网络来模仿它,网络的导数就是“近似雅可比” \partial\hat{\boldsymbol{s}}_{t+1}/\partial\hat{\boldsymbol{s}}_t、\partial\hat{\boldsymbol{s}}_{t+1}/\partial\boldsymbol{a}_t。“替身目标的梯度”:作者严谨地说明,得到的是 \nabla_\theta\hat J,不是真实 \nabla_\theta J。两者之差取决于模型误差,这正是 §4.2 关注模型精度的原因。为什么可以是确定性的:仿真器中的随机性只有三个来源:(1) 每回合的域随机化参数 \boldsymbol{\xi};(2) 观测噪声 \boldsymbol{\eta};(3) 动作噪声 \boldsymbol{\epsilon}。物理引擎本身是确定性的。(1) 作为输入喂给模型;(2) 在模型外部加;(3) 被记录在执行的动作里。于是给定 (\boldsymbol{s},\boldsymbol{a},\boldsymbol{\xi}),下一状态是唯一的,模型不必学概率分布(这与 Dreamer 等需要随机隐变量的方法不同)。这也是附录 A 删除“随机推搡”的原因:推搡是无法从输入预测的突变。
原文
The world model contains a learned dynamics model and reward, observation, and termination heads; each head is either learned or computed analytically, st+1 = f\omega(ˆst, at, \xi), ˆrt+1 = r\omega(ˆst, at, gt), ˆ¯ot = g\omega(ˆst, \xi), ˆdt = d\omega(ˆst, gt).
\hat{\boldsymbol{s}}_{t+1}=f_\omega(\hat{\boldsymbol{s}}_t,\boldsymbol{a}_t,\boldsymbol{\xi}),\qquad \hat r_{t+1}=r_\omega(\hat{\boldsymbol{s}}_t,\boldsymbol{a}_t,\boldsymbol{g}_t),\qquad \hat{\bar{\boldsymbol{o}}}_t=g_\omega(\hat{\boldsymbol{s}}_t,\boldsymbol{\xi}),\qquad \hat d_t=d_\omega(\hat{\boldsymbol{s}}_t,\boldsymbol{g}_t).
\mathcal L_{\mathrm{WM}}(\omega)=\mathbb E_{\mathcal B}\sum_{j=1}^{k}\Big[\|\hat{\boldsymbol{s}}_j-\boldsymbol{s}_j\|^2+(\hat r_j-r_j)^2+\|\hat{\bar{\boldsymbol{o}}}_j-\bar{\boldsymbol{o}}_j\|^2+\mathrm{BCE}(\hat d_j,d_j)\Big]\tag{1}
译文
世界模型包含一个学到的动力学模型,以及奖励、观测和终止三个“头”(head);每个头要么是学出来的,要么是解析计算的:
\hat{\boldsymbol{s}}_{t+1}=f_\omega(\hat{\boldsymbol{s}}_t,\boldsymbol{a}_t,\boldsymbol{\xi}),\quad \hat r_{t+1}=r_\omega(\hat{\boldsymbol{s}}_t,\boldsymbol{a}_t,\boldsymbol{g}_t),\quad \hat{\bar{\boldsymbol{o}}}_t=g_\omega(\hat{\boldsymbol{s}}_t,\boldsymbol{\xi}),\quad \hat d_t=d_\omega(\hat{\boldsymbol{s}}_t,\boldsymbol{g}_t).
我们在 k 步自回归回放窗口(k=8)上拟合网络权重 \omega:窗口以记录的状态为起点 \hat{\boldsymbol{s}}_0=\boldsymbol{s}_0,沿记录的动作向前推演,最小化 \mathcal L_{\mathrm{WM}}(\omega)=\mathbb E_{\mathcal B}\sum_{j=1}^{k}\Big[\|\hat{\boldsymbol{s}}_j-\boldsymbol{s}_j\|^2+(\hat r_j-r_j)^2+\|\hat{\bar{\boldsymbol{o}}}_j-\bar{\boldsymbol{o}}_j\|^2+\mathrm{BCE}(\hat d_j,d_j)\Big],\tag{1}
其中解析计算的头没有损失项。这里 r_j 是仿真器奖励,d_j\in\{0,1\} 是仿真器终止标签,BCE 为二元交叉熵(binary cross-entropy)。 解释
四个组件。
- f_\omega:核心动力学网络,3 层 2048 宽的 MLP(表 A.4),输入当前(预测)状态、动作和仿真上下文,输出下一状态。
- r_\omega,\ g_\omega,\ d_\omega:分别从状态算奖励、观测、终止。“可学可解析”:例如追踪奖励(表 A.2)是刚体位置/朝向与参考的误差的显式函数,只要状态里含有足够信息(可通过正运动学得到刚体位姿),就能直接用公式计算,无需学习,也就没有损失项;观测中的关节角等也可直接从状态里取。论文没有逐一说明哪个头是学的、哪个是解析的。
\hat{\boldsymbol{s}}_1=f_\omega(\boldsymbol{s}_0,\boldsymbol{a}_0,\boldsymbol{\xi}),\ \hat{\boldsymbol{s}}_2=f_\omega(\hat{\boldsymbol{s}}_1,\boldsymbol{a}_1,\boldsymbol{\xi}),\ \dots,\ \hat{\boldsymbol{s}}_8=f_\omega(\hat{\boldsymbol{s}}_7,\boldsymbol{a}_7,\boldsymbol{\xi}),
第 8 步的损失会反传穿过前 7 次调用,于是模型学会“纠正自己的误差”。注意这里用的动作 \boldsymbol{a}_{0:k-1} 是记录的带噪动作,而不是让策略重新输出。这是标准的监督学习,和策略无关。数字感受。k=8,控制频率 50 Hz,即 0.16 s 的窗口。§3.3 的想象时域 H=32 步(0.64 s),是训练窗口的 4 倍,下一段会解释为何仍然可行。 4.3通过世界模型学习策略(Learning the policy through the world model)
原文
During each policy update, we hold the world-model weights \omega fixed and optimize \pi_\theta and V_\psi on imagined rollouts of H{=}32 steps. The critic Vψ estimates the return beyond step H, so the model must be accurate only within these H steps. This imagination horizon exceeds the k-step replay windows on which we fit the model (§3.2). In practice, the learned model remains stable over indefinitely long rollouts, because the k-step autoregressive fit trains it to correct its own prediction errors.
译文
在每次策略更新中,我们固定世界模型权重 \omega,在 H=32 步的想象推演上优化 \pi_\theta 和 V_\psi。评论家 V_\psi 估计第 H 步之后的回报,因此模型只需在这 H 步内准确。这一想象时域长于拟合模型所用的 k 步回放窗口(§3.2)。实践中,学到的模型在任意长的推演中都保持稳定,因为 k 步自回归拟合训练它纠正自身的预测误差。
解释
分工:近处(H 步内)的回报由模型精确推演并提供梯度;远处(H 步之后)的回报交给评论家 V_\psi 概括。这样模型误差只在短窗口内累积。H=32>k=8 是否矛盾?直觉上,只用 8 步训练的模型推 32 步可能发散。作者的经验是:自回归训练让模型具有“吸引子”性质,小误差会被拉回合理状态流形,而不是指数放大,因此推演“不会爆”。不过这里的“任意长推演仍稳定”指数值上不发散,并不保证 32 步后仍精确;精度由图 3(c) 的 8 步误差另行刻画。这一说法在正文中没有给出专门的定量证据。
原文
Each imagined rollout starts from a replay-buffer state \boldsymbol{s}_0\sim\rho_0 with its recorded sim context \boldsymbol{\xi}. At step t, the model emits ˆ¯ot, we re-add sensor noise, and the policy acts: at = \pi\theta(ˆ¯ot + \etat, gt), \etat \sim\rho\eta. The policy objective over imagined rollouts is \gammatˆct ˆrt+1 + \gammaHˆcH Vψ(ˆsH, gH, \xi)
\hat J(\theta)=\mathbb E_{\boldsymbol{s}_0\sim\rho_0,\,\pi_\theta}\Big[\sum_{t=0}^{H-1}\gamma^t\hat c_t\,\hat r_{t+1}+\gamma^H\hat c_H\,V_\psi(\hat{\boldsymbol{s}}_H,\boldsymbol{g}_H,\boldsymbol{\xi})\Big]\tag{2}
译文
每条想象推演从回放缓冲区中的一个状态 \boldsymbol{s}_0\sim\rho_0 出发,并带上该状态记录的仿真上下文 \boldsymbol{\xi}。在第 t 步,模型输出 \hat{\bar{\boldsymbol{o}}}_t,我们重新加上传感器噪声,然后策略行动:\boldsymbol{a}_t=\pi_\theta(\hat{\bar{\boldsymbol{o}}}_t+\boldsymbol{\eta}_t,\boldsymbol{g}_t),\boldsymbol{\eta}_t\sim\rho_\eta。想象推演上的策略目标为
\hat J(\theta)=\mathbb E_{\boldsymbol{s}_0\sim\rho_0,\,\pi_\theta}\Big[\sum_{t=0}^{H-1}\gamma^t\hat c_t\,\hat r_{t+1}+\gamma^H\hat c_H\,V_\psi(\hat{\boldsymbol{s}}_H,\boldsymbol{g}_H,\boldsymbol{\xi})\Big].\tag{2}
对动作追踪而言,奖励 r_{t+1} 是去掉自碰撞惩罚的 BeyondMimic 动作追踪奖励 [3](附录 A)。 解释
符号。\rho_0:起始状态分布,即缓冲区里的真实状态;\gamma=0.99;\hat c_t=\prod_{k=1}^{t}(1-\hat d_k) 是预测存活概率;V_\psi(\hat{\boldsymbol{s}}_H,\boldsymbol{g}_H,\boldsymbol{\xi}) 是评论家对第 H 步之后折扣回报的估计。评论家输入完整状态和 \boldsymbol{\xi}(特权信息),策略只看带噪观测,这是“非对称 actor–critic”。第一项是 H 步内的折扣、按存活加权的奖励之和;第二项是终端价值,乘 \gamma^H(0.99^{32}\approx0.72)和存活概率 \hat c_H。若机器人在想象中“很可能摔倒”,\hat c_H\to0,终端价值也随之消失。梯度怎么流。把 \hat J 看作 \theta 的函数。前向计算图为
\theta\to\boldsymbol{a}_0\to\hat{\boldsymbol{s}}_1\to(\hat r_1,\hat d_1,\hat{\bar{\boldsymbol{o}}}_1)\to\boldsymbol{a}_1\to\hat{\boldsymbol{s}}_2\to\cdots\to\hat{\boldsymbol{s}}_H\to V_\psi.
定义 \boldsymbol{x}_t:=\mathrm d\hat{\boldsymbol{s}}_t/\mathrm d\theta(状态对参数的全导数),由链式法则: \frac{\mathrm d\boldsymbol{a}_t}{\mathrm d\theta}=\frac{\partial\pi_\theta}{\partial\theta}+\frac{\partial\pi_\theta}{\partial\boldsymbol{o}}\,\frac{\partial g_\omega}{\partial\hat{\boldsymbol{s}}_t}\,\boldsymbol{x}_t,\qquad \boldsymbol{x}_{t+1}=\frac{\partial f_\omega}{\partial\hat{\boldsymbol{s}}_t}\,\boldsymbol{x}_t+\frac{\partial f_\omega}{\partial\boldsymbol{a}_t}\,\frac{\mathrm d\boldsymbol{a}_t}{\mathrm d\theta}.
每个奖励的贡献为 \frac{\mathrm d}{\mathrm d\theta}(\hat c_t\hat r_{t+1}),\hat r 与 \hat c(经由 \hat d)都依赖 \hat{\boldsymbol{s}} 和 \boldsymbol{a};终端项通过 \partial V_\psi/\partial\hat{\boldsymbol{s}}_H\cdot\boldsymbol{x}_H 提供“H 步之后会怎样”的梯度信号。这里有三点值得注意: - \omega 冻结,但 \partial f_\omega/\partial\hat{\boldsymbol{s}}、\partial f_\omega/\partial\boldsymbol{a} 这些雅可比照样参与计算(图 2 中所谓“通过冻结的模型反传”)。
- 第 t 步的动作通过 \hat{\boldsymbol{s}}_{t+1},\hat{\boldsymbol{s}}_{t+2},\dots 影响之后所有的奖励,BPTT 自动把这些长程影响累加起来,这就是“信用分配”。
- 噪声 \boldsymbol{\eta}_t 从外部采样后作为常数加入,梯度从中“穿过”(重参数化),所以确定性策略在想象中也面对带噪输入,鲁棒性得以保留。
loss.backward()(对 -\hat J)。 原文
The world model is differentiable, so BPTT computes a first-order gradient \nabla_\theta\hat J through the H imagined steps via the world model's Jacobians with respect to \hat{\boldsymbol{s}}_t and \boldsymbol{a}_t. In contrast, PPO treats the dynamics as a black box: it weights the score \nabla\theta log \pi\theta of a stochastic policy by the advantages of sampled actions, a likelihood-ratio estimate. BPTT instead differentiates the return with respect to each action, so over short horizons its gradient has much lower variance.
译文
世界模型可微,因此 BPTT 借助世界模型关于 \hat{\boldsymbol{s}}_t 和 \boldsymbol{a}_t 的雅可比矩阵,在 H 个想象步上计算一阶梯度 \nabla_\theta\hat J。与之相对,PPO 把动力学当作黑箱:它用采样动作的优势对随机策略的得分函数(score)\nabla_\theta\log\pi_\theta 加权,这是一种似然比估计。BPTT 则对回报关于每个动作求导,因此在短时域上其梯度方差要低得多。
解释
这段对比两类梯度估计器,是理解本文效率来源的理论核心。
- 似然比(PPO):\nabla_\theta J\approx\frac1N\sum\nabla_\theta\log\pi_\theta(\boldsymbol{a}|\boldsymbol{o})\,\hat A。它只知道“这个动作比平均好/差多少”(一个标量),然后沿“让这个动作更可能/更不可能”的方向推。动作维度为 29,一个标量要在 29 维空间里指明方向,只能靠大量样本平均,方差随维度和时域增长。
- 路径式(BPTT):\nabla_\theta J=\sum_t\frac{\partial J}{\partial\boldsymbol{a}_t}\frac{\partial\boldsymbol{a}_t}{\partial\theta}。\partial J/\partial\boldsymbol{a}_t 是一个 29 维向量,直接告诉策略“每个关节往哪边调、调多少回报会上升”。一条轨迹就能给出高质量方向。
原文
The critic V_\psi is fit to generalized advantage estimation returns [25] computed backward in time over the imagined transitions only,
\mathcal L_V(\psi)=\mathbb E\sum_{t=0}^{H-1}\big(V_t-\hat R_t\big)^2,\qquad \hat R_t=\hat r_{t+1}+\gamma(1-\hat d_{t+1})\big[(1-\lambda)V_{t+1}+\lambda\hat R_{t+1}\big]\tag{3}
译文
评论家 V_\psi 拟合的是广义优势估计(generalized advantage estimation, GAE)回报 [25],该回报仅在想象转移上沿时间反向计算:
\mathcal L_V(\psi)=\mathbb E\sum_{t=0}^{H-1}\big(V_t-\hat R_t\big)^2,\qquad \hat R_t=\hat r_{t+1}+\gamma(1-\hat d_{t+1})\big[(1-\lambda)V_{t+1}+\lambda\hat R_{t+1}\big],\tag{3}
其中 V_t=V_\psi(\hat{\boldsymbol{s}}_t,\boldsymbol{g}_t,\boldsymbol{\xi})。递推从 \hat R_H=V_H 开始,即评论家对时域之外回报的估计。目标 \hat R_t 每条推演只计算一次,在拟合 \psi 期间保持固定。 解释
这就是 TD(\lambda) 回报。从末端 \hat R_H=V_H 开始倒推,每一步把“即时奖励 + 折扣后的下一步价值”混合:方括号内是两种下一步价值估计的加权平均,(1-\lambda)V_{t+1} 是“直接相信评论家”,\lambda\hat R_{t+1} 是“相信后面推演出来的回报”。
- \lambda=0:\hat R_t=\hat r_{t+1}+\gamma(1-\hat d_{t+1})V_{t+1},即单步 TD 目标,偏差大、方差小;
- \lambda=1:\hat R_t=\sum_{k}\gamma^{k}(\cdots)\hat r+\gamma^{H-t}(\cdots)V_H,即 H-t 步蒙特卡洛回报加终端自举,偏差小、方差大;
- 本文 \lambda=0.95(表 A.5),偏向后者。
原文
The policy and critic updates together form a short-horizon actor–critic in the spirit of SHAC [19], which backpropagates through a differentiable simulator. SuperMimic replaces SHAC's hard episode termination with the survival weight ˆct, and its critic has no exponential-moving-average target network. Prior motion-tracking controllers trained with analytic gradients often omit a critic and optimize only the H-step reward sum [12, 6]. Without a critic, training can reach a similar nominal tracking return, but this unbootstrapped objective is more myopic. The critic matters after perturbations, where recovery or balance rewards can lie beyond the imagination window (§4.3).
译文
策略更新与评论家更新共同构成一个 SHAC [19] 风格的短时域 actor–critic;SHAC 是对可微仿真器做反向传播。SuperMimic 用生存权重 \hat c_t 取代了 SHAC 的硬回合终止,且其评论家不使用指数移动平均(EMA)目标网络。以往用解析梯度训练的动作追踪控制器常常不用评论家,只优化 H 步奖励之和 [12, 6]。没有评论家时,训练也能达到相近的名义追踪回报,但这种不做自举的目标更加短视。评论家在受到扰动后发挥作用:此时恢复或平衡相关的奖励可能落在想象窗口之外(§4.3)。
解释
与 SHAC 的两点不同:(1) SHAC 遇到终止就截断轨迹(硬),本文用可微的存活概率加权(软),让“避免摔倒”本身也能产生梯度;(2) SHAC 用一个慢速更新的 EMA 目标评论家来稳定 TD 学习,本文去掉它,结构更简单。为什么前人不用评论家?SuperTrack、ControlVAE 只优化 \sum_{t<H}\hat r_{t+1}。对“贴着参考动作走”这种任务,每一步都有稠密奖励,短视的目标已足以把动作学好,所以“名义回报”差不多。评论家的价值体现在哪里?设想机器人被猛推一把:最优反应可能是先迈一大步、牺牲眼前几步的追踪奖励,等站稳后再慢慢回到参考。如果只看 32 步(0.64 s),可能看不到“站稳”的回报,策略就会选择硬扛,结果摔倒。评论家把远期回报折算进来,策略才能“眼光放长”。§4.3 的推搡实验验证了这一点。
5实验结果(Experimental Results)
原文
We show that SuperMimic scales favorably relative to PPO pipelines, identify the world-model properties behind this scaling, demonstrate transfer on a real Unitree G1, and report a preliminary study of downstream goal interfaces. The simulator is MuJoCo Warp, a GPU implementation of MuJoCo [26]. All our reported costs are measured on NVIDIA H100 (80 GB SXM5) GPUs of Lambda on-demand instances. We ran several random seeds and found training very stable, which we attribute to the dense reward that motion tracking gives at every step. The figures therefore do not report seed variation. Normalized return, return for short, is the undiscounted sum of the per-step reward over the full episode, divided by the largest value this sum can take. A policy that terminates early therefore scores low.
译文
我们展示:相对于 PPO 流水线,SuperMimic 具有更好的扩展性;我们找出这种扩展性背后的世界模型性质,在实体 Unitree G1 上展示迁移,并报告一项关于下游目标接口的初步研究。仿真器是 MuJoCo Warp,即 MuJoCo [26] 的 GPU 实现。我们报告的所有成本都在 Lambda 按需实例的 NVIDIA H100(80 GB SXM5)GPU 上测得。我们跑了多个随机种子,发现训练非常稳定,我们将其归因于动作追踪在每一步都提供稠密奖励。因此图中不报告种子间的波动。归一化回报(normalized return,简称回报)是整个回合中每步奖励的不折扣总和,除以该总和可能取到的最大值。因此,提前终止的策略得分会很低。
解释
这段交代实验设置与评价指标:
- MuJoCo Warp:Google DeepMind 与 NVIDIA 用 Warp(NVIDIA 的 GPU 内核 Python 框架)重写的 MuJoCo,可在 GPU 上并行成千上万个环境。它不为反向传播设计,这正是本文“学替身”的用武之地。
- 不报种子方差:作者给出的理由是稠密奖励使训练稳定。读者应注意,这意味着图中曲线均为单次运行,细小差异不宜过度解读。
- 归一化回报:设一段动作长 T 步,每步奖励最大为 r_{\max},则回报 =\sum_t r_t/(T\,r_{\max})\in[0,1]。若机器人在一半处摔倒,即使前一半完美,得分也不超过 0.5。所以这一指标同时衡量“追得准”和“不摔倒”。
5.1SuperMimic 以远少的 GPU 小时达到 SONIC 级别的追踪(SuperMimic reaches SONIC-level tracking with far fewer GPU-hours)
原文
We compare against SONIC, a published PPO pipeline trained on a 128-GPU cluster. r. Both methods build on the BeyondMimic motion-tracking formulation [3], making SONIC the closest available published comparison. Within 3 h on one GPU, SuperMimic surpasses the normalized return of the released SONIC checkpoint (Figure 3(a)). On a shared benchmark of 129,514 motions, it also fails on fewer motions than SONIC: 25 after 3 h on one GPU and 0 after 9.8 h on two GPUs, against 179 for SONIC's released checkpoint (Appendix F). We state the 3 h conservatively: from then on, every checkpoint is ahead of SONIC by at least half of the gap between SONIC and SuperMimic's best result, in both return and failed motions. SuperMimic thus uses more than 50\times less wall-clock time and more than 1000\times fewer GPU-hours than SONIC.
译文
我们与 SONIC 对比,它是一个已发表、在 128 GPU 集群上训练的 PPO 流水线。两种方法都建立在 BeyondMimic 的动作追踪表述 [3] 之上,因此 SONIC 是目前可得的最接近的已发表对照。在一张 GPU 上训练 3 小时内,SuperMimic 就超过了 SONIC 发布检查点的归一化回报(图 3(a))。在一个包含 129,514 条动作的共同基准上,它失败的动作也比 SONIC 少:单 GPU 3 小时后失败 25 条,双 GPU 9.8 小时后失败 0 条,而 SONIC 发布检查点失败 179 条(附录 F)。我们对“3 小时”的表述是保守的:从那以后,每个检查点在回报和失败动作数两方面都领先 SONIC,领先幅度至少为 SONIC 与 SuperMimic 最佳结果之差的一半。因此,SuperMimic 所用的墙钟时间比 SONIC 少 50 倍以上,GPU 小时少 1000 倍以上。
解释
“保守”的含义:只是某个检查点碰巧略超 SONIC 不足为凭,因为曲线有波动。作者要求从 3 小时起所有检查点都“明显”超过 SONIC,标准是领先幅度 \ge\frac12(SuperMimic 最佳值 - SONIC 值)。例如 SONIC 回报 0.90,若 SuperMimic 最佳为约 0.95,则 3 小时之后所有检查点都 \ge 0.925。失败数同理:SONIC 179、最佳 0,则 3 小时后每个检查点失败数都 \le 89.5。这样“3 小时”是一个稳健的说法。两种比例:墙钟时间 168/3=56 倍(>50);GPU 小时 128\times168/(1\times3)\approx7200 倍(>1000)。
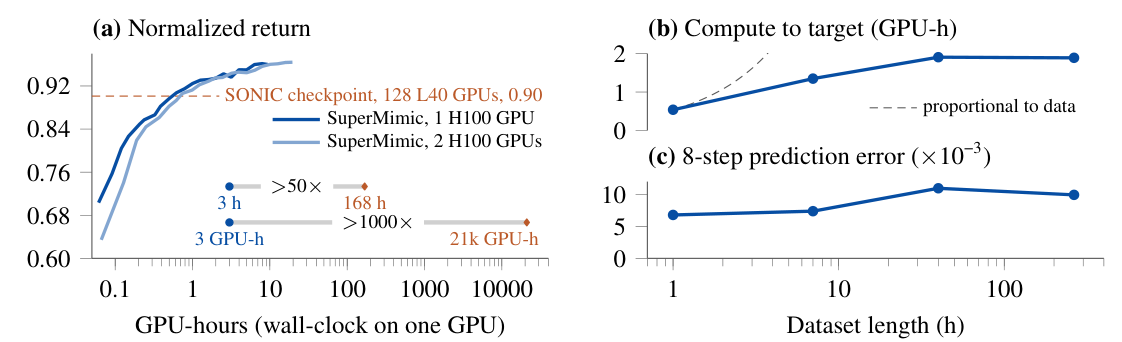
图 3 解读
(a) 归一化回报 vs. GPU 小时。横轴是对数刻度的 GPU 小时(单卡时等于墙钟时间),从 0.1 到 10^4;纵轴是归一化回报(0.60–0.92+)。深蓝实线为 1 张 H100,浅蓝为 2 张 H100(横轴按 GPU 小时计,因此双卡曲线在同一墙钟时间下会往右挪一倍)。橙色虚线是 SONIC 检查点的回报 0.90。两条曲线在约 3 GPU 小时处越过虚线,最终升到约 0.95 以上。图内两条“预算标尺”:上一条比较墙钟时间(SuperMimic 3 h 圆点 vs. SONIC 168 h 菱形,>50\times),下一条比较 GPU 小时(3 vs. 21k,>1000\times)。在对数轴上,两个点之间约隔 3.9 个数量级,非常直观。(b) 达到目标回报所需算力 vs. 数据集时长。横轴(对数)为训练用动作数据时长:1、7、40、264 h(附录 F.3)。纵轴为 GPU 小时:约 0.5、1.3、1.9、1.9。灰色虚线是“与数据量成正比”的参考线:若算力与数据量成正比,从 1 h 到 264 h 应增长 264 倍(在图中会迅速冲出上界)。实际只增长约 4 倍,而且 40 h 到 264 h 几乎持平。注意:正文没有明确说明这里的“目标回报”具体取何值。(c) 8 步预测误差 vs. 数据集时长。纵轴单位 \times10^{-3},数值约 7、7.5、11、10,即 0.007–0.011,基本平坦。在数据增加 264 倍、动作类型极大丰富的情况下,同样大小的模型并没有“学不下”,说明不同动作背后的物理是共享的。误差是“在线”测的,即在当前策略真正访问的状态上评估,这比在固定测试集上评估更能反映策略优化时模型是否可靠。对论点的作用。(a) 支撑“1000 倍算力节省”;(b)(c) 支撑“扩展性”:数据越多,边际成本越低,而且原因可以追溯到模型精度不退化。
原文
Compute accounting. The ratios compare SONIC's reported 128 NVIDIA L40 GPUs for 7 days (about 21,000 GPU-hours) with 3 h on one NVIDIA H100, 00, within which SuperMimic surpasses the return of SONIC's released checkpoint. They are about 56\times (> 50\times) in wall-clock time and about 7200\times (> 1000\times) in GPU-hours. The 3 h cover the full training loop; checkpoint evaluations run after training and are not counted. SuperMimic trains on 264.56 h of motion from BONES- SEED [27], the public subset of SONIC's data, about 2.3\times less than SONIC's 611 h. The GPU models also differ: in peak throughput, an H100 delivers 0.74\times the fp32 and 5.5\times the tensor-core performance of an L40; how much of that peak either run used is unknown. Nonetheless, 2.3\times in data and at most 5.5\times in peak GPU throughput cannot account for a 1000\times gap in GPU-hours.
译文
算力核算。上述比例比较的是:SONIC 报告的 128 张 NVIDIA L40 GPU 训练 7 天(约 21,000 GPU 小时),与 SuperMimic 在一张 NVIDIA H100 上训练 3 小时(在这 3 小时内 SuperMimic 超过了 SONIC 发布检查点的回报)。墙钟时间约为 56 倍(>50\times),GPU 小时约为 7200 倍(>1000\times)。这 3 小时覆盖完整的训练循环;检查点评估在训练后运行,不计入。SuperMimic 在 BONES-SEED [27] 的 264.56 h 动作上训练,这是 SONIC 数据的公开子集,比 SONIC 的 611 h 约少 2.3 倍。GPU 型号也不同:按峰值吞吐量,H100 的 fp32 性能是 L40 的 0.74 倍,张量核性能是 L40 的 5.5 倍;两次运行各自用到了多少峰值性能未知。尽管如此,2.3 倍的数据差和至多 5.5 倍的峰值 GPU 吞吐差,不足以解释 GPU 小时上 1000 倍的差距。
解释
这段主动讨论比较的公平性,值得肯定:
- 数据量:611/264.56\approx2.31。SONIC 的数据多 2.3 倍。即使训练成本与数据成正比,也只能解释 2.3 倍。
- 硬件:H100 是比 L40 更强的数据中心卡。L40 的 fp32 峰值约 90 TFLOPS,H100 SXM 约 67 TFLOPS,所以 fp32 上 H100 反而更弱(0.74 倍);但张量核(TF32/BF16)上 H100 强得多(5.5 倍)。本文世界模型以 TF32 运行(图 5 图注),能吃到张量核红利。
- 最坏情况:2.3\times5.5\approx12.7 倍,而观测差距约 7200 倍,剩下的约 570 倍仍需由方法本身解释。
原文
Figure 4(a) gives a controlled comparison on LAFAN1 [28]. The baseline, PPO-Sim, is PPO trained in the simulator. PPO-Sim shares SuperMimic's motions, observations, reward, termination, domain randomization, actor and critic network sizes, and evaluation protocol. It uses BeyondMimic's PPO hyperparameters [3] and 8192 parallel environments per GPU, twice SuperMimic's. PPO-Sim estimates its policy gradient from sampled simulator rollouts; SuperMimic backpropagates its imagined return through world-model rollouts. SuperMimic reaches a return of 0.82 in evaluation within 1.2 h on one GPU. Within the 18 h budget, PPO-Sim does not reach it. Its final return is 0.60 on one GPU, 0.70 on four, and 0.72 on eight, so going from four to eight GPUs barely helps.
译文
图 4(a) 给出了在 LAFAN1 [28] 上的受控比较。基线 PPO-Sim 是在仿真器中训练的 PPO。PPO-Sim 与 SuperMimic 共享动作、观测、奖励、终止条件、域随机化、actor 和 critic 的网络规模以及评估协议。它使用 BeyondMimic 的 PPO 超参数 [3],每张 GPU 8192 个并行环境,是 SuperMimic 的两倍。PPO-Sim 从采样的仿真推演中估计策略梯度;SuperMimic 则通过世界模型推演反传其想象回报。SuperMimic 在一张 GPU 上 1.2 h 内评估回报就达到 0.82。在 18 h 的预算内,PPO-Sim 达不到这个值。它的最终回报在 1 张 GPU 上为 0.60,4 张为 0.70,8 张为 0.72,可见从 4 张增加到 8 张 GPU 几乎没有帮助。
解释
与 SONIC 的比较是“跨论文”的,变量很多;这里做了严格的受控实验:除了优化方式(PPO 在仿真中 vs. BPTT 在世界模型中)外,其余全部相同,还给了 PPO 两倍的并行环境和多达 8 张卡。LAFAN1 是育碧发布的小型动作数据集(40 段,约 2.45 h),常用于人形追踪研究。关键数字:SuperMimic 1 卡 1.2 h 达到 0.82;PPO-Sim 8 卡 18 h(144 GPU 小时)仍只有 0.72。“4 卡 \to 8 卡几乎没帮助”说明 PPO 的瓶颈不在采样量:更多并行环境只是让每批数据更大,而 PPO 的更新步数和每步可信步长有限,梯度估计质量的提升存在收益递减。
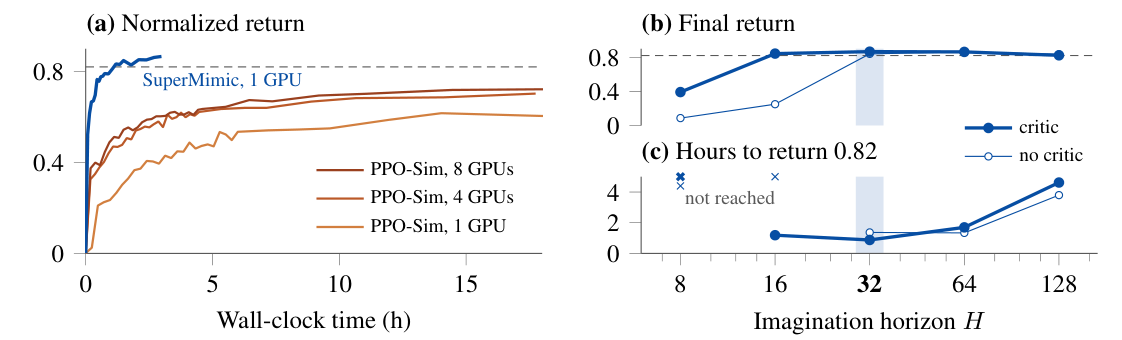
图 4 解读
(a):横轴墙钟时间 0–18 h,纵轴归一化回报。蓝色 SuperMimic(1 GPU)在不到半小时内冲到约 0.75,约 1.2 h 越过 0.82 虚线,3 h 时约 0.86,曲线在约 3 h 处结束(实验只跑到这里)。三条橙棕色 PPO-Sim 曲线爬升缓慢:8 卡和 4 卡在 18 h 时分别约 0.72、0.70,1 卡约 0.60。SuperMimic 单卡最初几分钟的回报就已超过 PPO 8 卡 18 h 的最终值。(b) 最终训练回报 vs. H(横轴为对数刻度的 8、16、32、64、128):实心粗线(有评论家)在 H\ge16 时都约为 0.84–0.86,H=8 时只有约 0.40;空心细线(无评论家)在 H=8 时约 0.08,H=16 时约 0.24,要到 H=32 才追上。(c) 达到 0.82 的小时数 vs. H:有评论家时 H=16 约 1.2 h,H=32 约 0.9 h(最快),H=64 约 1.7 h,H=128 约 4.6 h;无评论家时 H=32 约 1.4 h,H=64 约 1.4 h,H=128 约 3.8 h。叉号表示没达到。读出的规律:H 太短,看不到足够远的后果,学不会(评论家可以弥补一部分,把可行的最短 H 从 32 降到 16);H 太长,每次更新计算量与 H 成正比,而且雅可比连乘带来梯度噪声,反而更慢、最终回报略降。因此存在一个“甜点” H=32(0.64 s)。注意图 (b)(c) 用的是“训练回报”,因起始状态分布偏向困难片段(附录 D.1),数值与 (a) 的评估回报不能直接对比。
原文
Figure 3(b, c) shows that, for SuperMimic, GPU-hours to the target return grow slowly as dataset length increases, s, while on the same sweep the world model's prediction error stays stable; §4.2 traces both trends to one world model amortizing the dynamics shared across motions.
译文
图 3(b, c) 表明,对 SuperMimic 而言,随着数据集时长增加,达到目标回报所需的 GPU 小时增长缓慢;在同一组扫描中,世界模型的预测误差保持稳定。§4.2 把这两种趋势都归结为一个世界模型摊销了各动作之间共享的动力学。
解释
这是承上启下的一句:§4.1 给出现象(算力增长慢),§4.2 解释机制(模型精度稳定、推演快、梯度好)。
5.2学到的世界模型的性质(Properties of the learned world model)
原文
These results rest on three properties of the learned world model f_\omega: its accuracy holds as the motion library grows, and its rollouts are fast and differentiable.
译文
上述结果依赖于学到的世界模型 f_\omega 的三个性质:其精度在动作库增长时保持不变,其推演速度快,且推演可微。
解释
三个性质对应下面三个小标题,分别回答:(1) 为什么数据越多不越贵?(精度不退化)(2) 为什么每一步更便宜?(推演快)(3) 为什么需要的步数更少?(可微、梯度质量高)。
原文
One model amortizes the motion library. In Figure 3(c), the world model's 8-step prediction error stays between 0.007 and 0.011 as the dataset grows from 1 to 264 h. Every motion is executed by the same humanoid, so added clips supply more evidence about the shared body and contact dynamics rather than demanding new capacity. This is consistent with the slow growth of the compute needed to reach the target return (§4.1).
译文
一个模型摊销整个动作库。在图 3(c) 中,数据集从 1 h 增长到 264 h 时,世界模型的 8 步预测误差保持在 0.007 到 0.011 之间。每个动作都由同一台人形机器人执行,所以新增片段提供的是关于共享身体与接触动力学的更多证据,而不是要求模型具备新的容量。这与达到目标回报所需算力的缓慢增长(§4.1)相一致。
解释
类比:学开车。每多开一条新路线,你的“车辆操控模型”(踩油门车会怎样)并不需要额外学一套,反而更熟练;需要新记的只是“路线”(对应策略的目标条件部分)。更深一层:动作多样性体现在“状态空间被访问的区域”上,而不是“物理规律”上。翻滚、空翻访问了新的状态区域(倒立、躯干着地),模型需要覆盖这些区域,但其中的物理(重力、关节、接触)是同一套。数据多了,模型“看过”的状态更全面,预测误差反而可能更均匀。图中误差在 40 h 时略升至 0.011,可能是因为新增了更难的动作;在 264 h 时又略降。
原文
Imagination accelerates rollouts. During policy optimization, rollout speed sets the update cost. Figure 5(a) shows that the world model runs more than 10\times faster than MuJoCo Warp at the batch sizes used in practice, and up to 62\times at 64k parallel environments.
译文
想象加速推演。在策略优化中,推演速度决定了更新成本。图 5(a) 显示,在实际使用的批大小下,世界模型比 MuJoCo Warp 快 10 倍以上,在 64k 个并行环境时可达 62 倍。
解释
为什么神经网络比物理引擎快?物理引擎每步要做碰撞检测、接触约束求解(迭代算法)、多个子步积分,分支多、内存访问不规则,很难充分利用 GPU;MLP 前向就是几次大矩阵乘法,正好是 GPU(尤其张量核)最擅长的。并行规模越大,矩阵乘法越能“吃满”GPU,而仿真器在约 16k 环境后就饱和了,所以差距随批大小扩大。
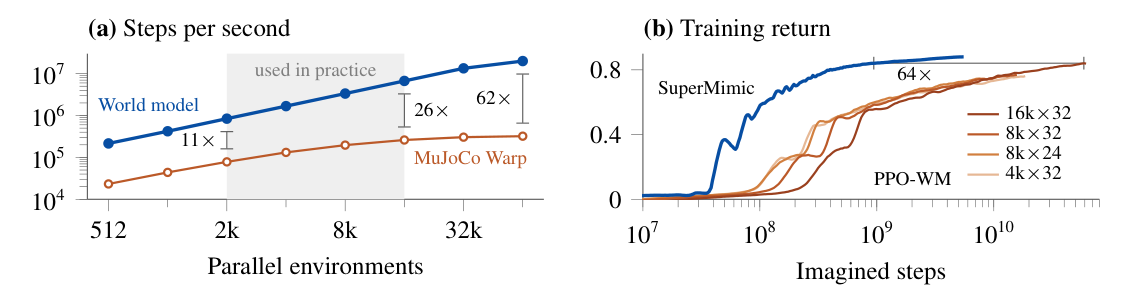
图 5 解读
(a) 每秒步数 vs. 并行环境数(双对数坐标)。横轴 512 到 64k,纵轴 10^4 到 10^7 步/秒。蓝色实心(世界模型)近似一条斜率为 1 的直线:并行数翻倍,吞吐量几乎翻倍,在 64k 时约 1.3\times10^7 步/秒。橙色空心(MuJoCo Warp)起初也在增长,但在 8k 后明显变平,约 2\times10^5 步/秒。三个竖线标注了在 2k、16k、64k 处的倍数:11\times、26\times、62\times。灰色阴影是实际使用的区间(本文每卡 4096 个仿真环境、4096 条想象推演,见表 A.5)。注意比较口径:一个“步”是 20 ms 的控制步,仿真器内部算 4 个 5 ms 子步,世界模型一次前向直接跳 20 ms。这是神经替身的一个天然优势。(b) 训练回报 vs. 想象步数(横轴对数,10^7 到 10^{10} 以上)。这是“机制消融”:PPO-WM 与 SuperMimic 都在同一个世界模型里推演,速度相同,唯一区别是梯度估计方式。蓝线 SuperMimic 在约 5\times10^7 步开始上升,约 3\times10^8 步就到 0.8 左右;橙色系的四条 PPO-WM 曲线要到 10^9 至 10^{10} 步才接近同一水平,最好的配置 16\mathrm{k}\times32 约在 2\times10^{10} 步达到其最佳。标注的“64\times”即两者达到同一回报所需步数之比。结论:算力节省 = 每步更便宜(a,约 10–26 倍)\times 所需步数更少(b,约 64 倍)。两者相乘就是数百到上千倍的量级,与 §4.1 的观测吻合。
原文
First-order gradients need fewer imagined steps. As a mechanism ablation, Figure 5(b) isolates the benefit of first-order policy updates: SuperMimic reaches the best PPO-WM return with about 64\times fewer imagined steps, so the gain is not just rollout speed.
译文
一阶梯度需要更少的想象步数。作为机制消融,图 5(b) 单独隔离出一阶策略更新的好处:SuperMimic 达到 PPO-WM 最佳回报所需的想象步数少约 64 倍,因此收益并不只是来自推演速度。
解释
“消融”(ablation)指去掉某个组件看效果变化。这里把“世界模型推演”保留、只把“BPTT”换成“PPO”,从而把“快”与“可微”两种贡献分开。结果说明,即使给 PPO 同样快的世界模型,它仍需多花 64 倍的样本。这回应了一个自然的质疑:“是不是只要把仿真器换成神经网络,PPO 也能一样快?”答案是否定的。
5.3评论家使更短的时域和推搡恢复成为可能(A critic enables shorter horizons and push recovery)
原文
Figure 4(b, c) sweeps H with and without the critic. Without the critic, training fails at H\le16. With it, H=16 matches the critic-free H=32, and H=32 reaches a return of 0.82 fastest. Raising H from 64 to 128 nearly triples the time to that return and lowers the final return; H=128 is the longest horizon that fits on an H100. At matched return, the critic still changes behavior. Under 0.5–4 m/s velocity pushes while holding a static T-pose in simulation, the critic policy settles within 0.5–2.4 s. The critic-free policy never settles: it keeps stumbling even at 0.5 m/s and falls at 4 m/s.
译文
图 4(b, c) 在有和无评论家两种情况下扫描 H。没有评论家时,训练在 H\le16 时失败。有评论家时,H=16 与无评论家的 H=32 相当,H=32 最快达到回报 0.82。把 H 从 64 提高到 128,达到该回报的时间几乎变为三倍,最终回报也下降;H=128 是 H100 上能放下的最长时域。在回报相当时,评论家仍会改变行为。在仿真中让机器人保持静态 T 字姿势,并施加 0.5–4 m/s 的速度推搡,有评论家的策略在 0.5–2.4 s 内恢复稳定;无评论家的策略始终无法稳定:即使在 0.5 m/s 下也不停踉跄,在 4 m/s 下摔倒。
解释
显存限制:BPTT 需要保存整条展开链的中间激活,显存随 H 线性增长。H=128 已到 80 GB 上限,这也是长时域 BPTT 的现实约束。“时间几乎变为三倍”:从图 4(c) 读,H=64 约 1.7 h,H=128 约 4.6 h,比值约 2.7。推搡实验的设计很巧妙:T 字站立在追踪意义上是“简单”的,有无评论家的名义回报差不多。但推搡后,最优恢复策略需要多步规划(比如先迈步卸力)。速度推搡相当于在某一时刻给根节点突加一个速度。0.5 m/s 已是明显推力,4 m/s 是相当猛烈的冲击。有评论家的策略能在 0.5–2.4 s 内站稳,说明它学会了“为远期平衡牺牲近期追踪”;无评论家的策略只看 0.64 s,看不到这种取舍。这直接印证了 §3.3 末段的论断:评论家不改变“名义表现”,但显著提升“扰动下的鲁棒性”,而后者对真机部署至关重要。
5.4实机迁移(Real-robot transfer)
原文
One general motion tracker deploys on a real Unitree G1 without per-motion tuning (Figure 6). 6). The four motions cover locomotion (a skipping jump), contact-rich whole-body motion with the torso and limbs on the floor (a side roll), and acrobatics (a 90◦flip and an in-place 360◦flip).
译文
一个通用动作追踪器无需针对单个动作调参,即可部署到真实的 Unitree G1 上(图 6)。这四个动作涵盖了移动(跳步跳)、躯干和四肢着地的接触丰富全身动作(侧滚),以及杂技动作(90° 空翻和原地 360° 空翻)。
解释
Unitree G1 是宇树科技的一款约 1.3 m 高、29 自由度的人形机器人,广泛用于学术研究。“无需针对单个动作调参”很重要:BeyondMimic 等方法往往为每个高难度动作单独训练或微调一个策略再部署;这里是同一个通用策略、同一组参数,只换输入的参考动作。动作选择有代表性:侧滚涉及躯干、手臂与地面的大面积接触(这类接触最难建模);空翻涉及腾空阶段和高速着陆冲击。能在真机上完成,说明世界模型虽然只学仿真数据,其梯度训练出的策略在域随机化帮助下仍能跨越 sim-to-real 差距。
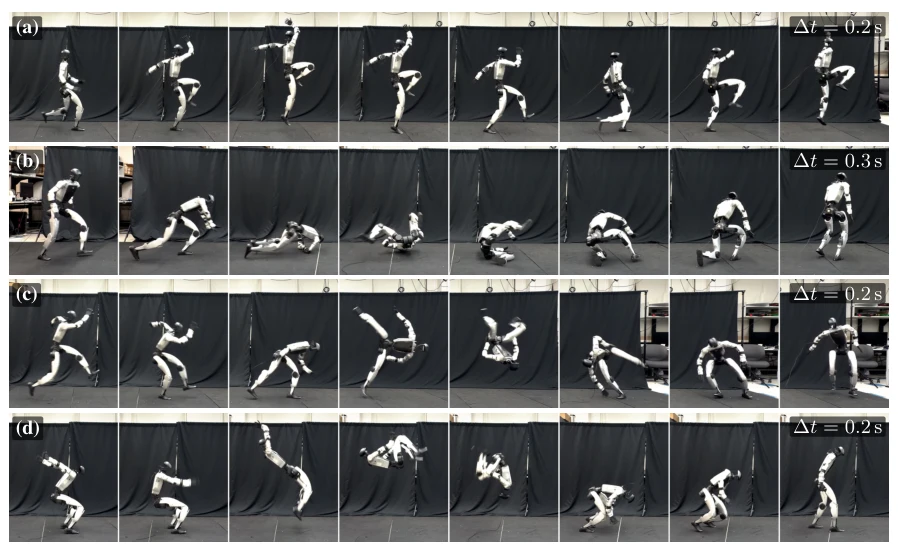
图 6 解读
四行各为一个动作的实拍序列,每行 8 帧,右上角标注相邻帧时间间隔 \Delta t。
- (a) 跳步跳(skipping jump),\Delta t=0.2 s,共约 1.4 s:单腿起跳、空中换腿,高抬膝,属于动态移动。
- (b) 侧滚(side roll),\Delta t=0.3 s,约 2.1 s:从站立侧身倒地,在地面上翻滚,再爬起站立。全过程躯干、肩、手臂、腿都与地面接触,是典型的“接触丰富”动作。SONIC 在全部 22 个侧滚动作上都失败(表 A.8)。
- (c) 90° 空翻,\Delta t=0.2 s:机器人腾空后身体翻转约 90°(大致是侧手翻或半翻)后落地。
- (d) 原地 360° 空翻,\Delta t=0.2 s:完整后空翻,第 3–5 帧可见机器人倒立腾空。这是最难的杂技动作,要求起跳冲量、空中姿态和落地缓冲都很精确。
5.5下游任务:RL 编码器 vs. 蒸馏基线(Downstream tasks: RL encoder vs. distillation baseline)
原文
SuperMimic trains downstream goal encoders jointly with the motion-tracking interface, sharing one decoder and world model (Appendix B). Our study of downstream interfaces is preliminary. We train one velocity encoder on a velocity-tracking reward through the world model. We compare it with a distillation baseline: a velocity encoder trained on the motion-tracking reward, with commands read from the reference motions. Figure 7 evaluates both on 672 step responses spanning the velocity space (Appendix G). The RL encoder has the lower steady-state error on 650 of them, and the distillation encoder on 15. Only the distillation encoder falls, on seven fast turns with almost no motion-library data.
译文
SuperMimic 将下游目标编码器与动作追踪接口联合训练,两者共享一个解码器和世界模型(附录 B)。我们对下游接口的研究是初步的。我们通过世界模型,用速度追踪奖励训练一个速度编码器,并将其与一个蒸馏基线比较:后者是用动作追踪奖励训练的速度编码器,其指令从参考动作中读取。图 7 在覆盖速度空间的 672 次阶跃响应上评估两者(附录 G)。RL 编码器在其中 650 次上稳态误差更低,蒸馏编码器在 15 次上更低。只有蒸馏编码器出现摔倒,发生在七个动作库中几乎没有数据的快速转向指令上。
解释
两种训练方式的区别:
- 蒸馏:给编码器输入的速度指令是从参考动作里“算”出来的(参考动作本身的平均速度),奖励仍然是“追踪参考动作”。所以编码器学的是“看到这个速度,就产生和参考动作一样的隐变量”。它只能覆盖动作库里出现过的速度组合。
- RL:奖励直接是“实际速度与指令速度有多接近”(表 A.6),指令也可以是随机采样的任意值。编码器可以学到动作库里没有的组合,比如“边快速转弯边侧移”。
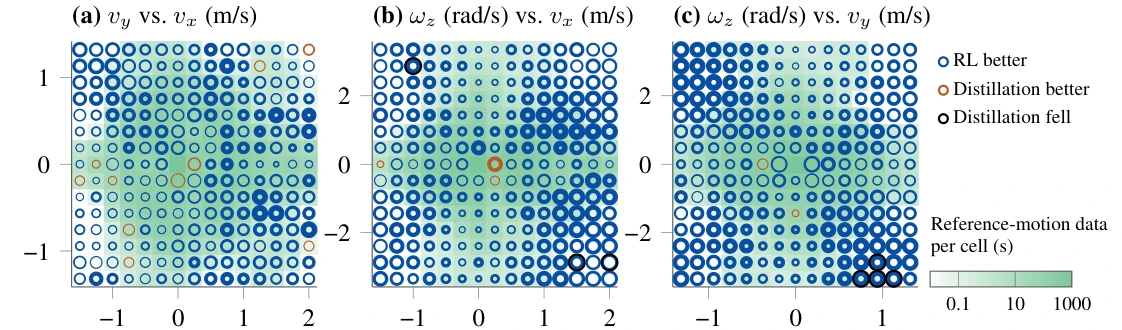
图 7 解读
坐标:速度指令是三维的 (v_x,v_y,\omega_z):前进速度、侧向速度、偏航角速度。三维空间画不清,于是取三个正交切面:(a) v_y–v_x 平面(\omega_z=0,纯平移);(b) \omega_z–v_x 平面(v_y=0,前进 + 转向);(c) \omega_z–v_y 平面(v_x=0,侧移 + 转向)。每个平面 15\times15 个格点。圆环编码:这是一种很紧凑的双变量可视化。每个格点画一个圆环:外圆面积 \propto\max(e_{\mathrm{RL}},e_{\mathrm{Distill}}),内孔面积 \propto\min(\cdot)。因此环越粗,两者差距越大;环细说明两者接近。颜色:蓝色 = RL 更好,橙色 = 蒸馏更好,黑色 = 蒸馏摔倒(误差按封顶值 0.9 画)。背景色:绿色深浅表示该格附近动作库中参考动作的数据量(秒,对数色标 0.1–1000)。中心附近(低速)数据最多,颜色最深;角落(高速 + 转向)几乎没有数据。读图:几乎全是蓝色粗环,说明 RL 编码器几乎处处更好,而且在远离中心、数据稀少的地方,环更粗、差距更大。少数橙色环集中在中心附近(数据丰富区,蒸馏有优势)。黑色环出现在 (b)(c) 的右下角,即“平移 + 大角速度(|\omega_z|\ge2.8 rad/s)转向”,动作库里没有这类数据,蒸馏编码器完全不会,导致摔倒。结论:蒸馏的能力受限于数据覆盖,RL 可以通过任务奖励在世界模型中“外推”到数据没覆盖的指令。
6结论(Conclusion)
原文
SuperMimic removes compute as the bottleneck to scaling humanoid whole-body control. making it practical to measure motiontracking scaling laws.
译文
SuperMimic 消除了算力这一扩展人形全身控制的瓶颈。一个学到的可微世界模型刻画了所有动作共享的动力学,通过它做随时间反向传播,可以把整个数据集摊销进一个策略。该策略在单张 GPU 上训练,回报超过在 128 GPU 集群上训练的策略,并能迁移到真实 Unitree G1。在受控的数据集时长扫描中,其训练成本增长缓慢。同一个模型还能直接用接口自身的任务奖励训练下游速度接口。测量动作追踪的缩放规律如今已负担得起:每次运行只需一张 GPU。
解释
结论重申三层主张:(1) 机制:共享动力学 + BPTT = 摊销;(2) 证据:单卡胜集群、成本随数据缓慢增长、真机可用、下游 RL 可行;(3) 意义:把人形控制研究从“拼算力”转向“可做系统实验”,为后续研究数据规模、模型规模与性能之间的定量关系铺路。需要客观看待的是:“消除瓶颈”是相对于当前约 264 h 数据规模而言的。若数据规模再增长几个数量级、或扩展到地形和物体交互,世界模型是否仍能保持精度,有待验证(见下节局限)。
7局限与未来工作(Limitations and Future Work)
原文
Multi-interface training is understudied. We train the velocity encoder concurrently with the motion tracker, but the velocity-tracking reward updates only the velocity encoder and not the shared decoder (Appendix B). Concurrent training is therefore the same as training the velocity encoder after the motion tracker, and might not be necessary. Whether concurrent training helps once the velocity-tracking reward also updates the decoder is untested.
译文
多接口训练研究不足。我们将速度编码器与动作追踪器并行训练,但速度追踪奖励只更新速度编码器,不更新共享解码器(附录 B)。因此并行训练等同于在动作追踪器之后再训练速度编码器,可能并无必要。当速度追踪奖励也更新解码器时,并行训练是否有帮助,尚未验证。
解释
作者坦率地指出:由于解码器对下游奖励做了 stop-gradient,解码器只被动作追踪目标训练,所以“联合训练”在数学上等价于“先训追踪器、再在冻结的解码器上训编码器”(除了训练时解码器还在变化这一点)。真正的“多任务互相促进”需要让下游奖励也能塑造解码器,但这可能导致解码器为速度任务牺牲追踪质量,因此需要权衡。
原文
Simulator-only dynamics. The world model learns only from simulator transitions.
译文
仅限仿真器动力学。世界模型只从仿真器转移中学习。真实机器人数据可以对它进行细化,而它的可微性还能支持系统辨识(system identification)。
解释
这是 MBRL 天然的延伸方向:用少量真机数据微调世界模型,可以直接缩小 sim-to-real 差距(类似 DayDreamer)。“系统辨识”指从数据中估计物理参数(摩擦、质量等)。因为世界模型以 \boldsymbol{\xi} 为输入且可微,可以固定网络、对 \boldsymbol{\xi} 做梯度下降,找到最能解释真机数据的参数。
原文
No terrain or object interaction. SuperMimic trains only on flat ground.
译文
没有地形或物体交互。SuperMimic 只在平地上训练。将其扩展到地形与物体交互是正在进行的工作。
解释
这也是附录 E 要过滤掉上楼梯、搬箱子、坐椅子等动作片段的原因。引入地形和物体后,世界模型需要感知环境(高度图、物体位姿),状态空间与接触种类都大幅增加,“一个模型摊销一切”的论断能否成立是开放问题。
8致谢(Acknowledgments)
原文
We thank Bike Zhang, Sangli Teng, Nima Rahmanian, and Songbo Hu for helpful discussions and help with the experiments. This work was supported in part by Komatsu, the BAIR Center for Humanoid Intelligence, Apple, and the RAI Institute. We thank Lambda for sponsoring compute for this project. Motion Data by Bones Studio (https://bones.studio/). Pieter Abbeel and Koushil Sreenath hold concurrent appointments as Professors at UC Berkeley and as Amazon Scholars. This paper describes work performed at UC Berkeley and is not associated with Amazon.
译文
作者感谢 Bike Zhang、Sangli Teng、Nima Rahmanian 和 Songbo Hu 的讨论与实验协助。本工作部分由 Komatsu、BAIR 人形智能中心(BAIR Center for Humanoid Intelligence)、Apple 和 RAI Institute 资助;感谢 Lambda 赞助算力。动作数据来自 Bones Studio。Pieter Abbeel 和 Koushil Sreenath 同时担任 UC Berkeley 教授和 Amazon Scholar;本文所述工作在 UC Berkeley 完成,与 Amazon 无关。
解释
致谢部分以名单和资助信息为主,此处简要转述。值得一提的是算力由 Lambda 赞助,这与正文“所有成本均在 Lambda 按需 H100 实例上测得”相对应。
参考文献
参考文献从略,见原文(共 28 条,原文第 10–12 页)。正文中的引用编号 [1]–[28] 与原文一致,主要有:[1] SONIC,[2] DeepMimic,[3] BeyondMimic,[4] PPO,[6] ControlVAE,[12] SuperTrack,[14] SuperDyno,[15][16] Dreamer/DreamerV3,[19] SHAC,[21][22] RWM/RWM-U,[23] Dyna,[24] MBPO,[25] GAE,[26] MuJoCo,[27] BONES-SEED,[28] LAFAN1。附录
A实例化:观测、动作、奖励与仿真上下文(Instantiation: observation, action, reward, and sim context)
原文
This appendix instantiates the shared spaces of the POMDP of §3.1. The motion-tracking interface follows the BeyondMimic formulation [3]; the changes we make are noted inline.
译文
本附录给出 §3.1 中 POMDP 各个共享空间的具体实例。动作追踪接口沿用 BeyondMimic 的表述 [3],我们所做的修改在文中随处注明。
解释
§3 只给出抽象记号 \boldsymbol{o},\boldsymbol{g},\boldsymbol{a},r,d,\boldsymbol{\xi},这里逐一给出具体内容。读这一附录时可以留意作者相对 BeyondMimic 做的几处改动:去掉自碰撞惩罚、降低关节限位惩罚、目标改为未来 10 帧、不按末端执行器偏差终止、去掉随机推搡。这些改动大多是为了配合“确定性世界模型 + 确定性策略”的设计。
原文
Observation. The proprioceptive observation \boldsymbol{o}_t comprises the joint positions relative to the default pose \boldsymbol{q}-\boldsymbol{q}^0, the joint velocities ˙q, the base angular velocity from the inertial measurement unit (IMU), the projected gravity in the base frame, and the previous action at-1 (Table A.1); the policy receives the last 10 observations.
译文
观测。本体感知观测 \boldsymbol{o}_t 包括:相对默认姿态的关节位置 \boldsymbol{q}-\boldsymbol{q}^0、关节速度 \dot{\boldsymbol{q}}、来自惯性测量单元(inertial measurement unit, IMU)的基座角速度、基座坐标系下的投影重力,以及上一步动作 \boldsymbol{a}_{t-1}(表 A.1);策略接收最近 10 帧观测。
解释
这些量全部是真机上能直接读到的:关节编码器给出 \boldsymbol{q},\dot{\boldsymbol{q}};IMU 给出角速度和姿态,“投影重力”是把世界坐标系的重力方向 (0,0,-1) 转到机器人基座坐标系后的单位向量,它编码了机器人的倾斜程度(站直时约为 (0,0,-1))。注意观测里没有基座线速度和全局位置,这两个量在真机上难以准确测量。策略用最近 10 帧(0.2 s)历史,可以隐式估计速度、接触状态等不可观测量。单帧维度 29+29+3+3+29=93,10 帧共 930 维。
| 观测项(Observation Term) | 维度 | 噪声 \boldsymbol{\eta}_t | 单位 |
| 关节位置 \boldsymbol{q}-\boldsymbol{q}^0 | 29 | \mathcal U[-0.01,\,0.01] | rad |
| 关节速度 \dot{\boldsymbol{q}} | 29 | \mathcal U[-0.5,\,0.5] | rad/s |
| 基座角速度(IMU) | 3 | \mathcal U[-0.2,\,0.2] | rad/s |
| 投影重力 | 3 | \mathcal U[-0.05,\,0.05] | – |
| 上一步动作 \boldsymbol{a}_{t-1} | 29 | – | – |
表 A.1 解读
每行是一个观测分量。“维度”一列:G1 有 29 个关节,因此关节位置、速度、上一步动作各 29 维;角速度和投影重力是三维向量。“噪声”一列是 §3.1 中 \rho_\eta 的具体形式:每个维度独立地从对应区间均匀采样后加到干净值上。例如关节角噪声 \pm0.01 rad(约 \pm0.57^\circ),模拟编码器误差;关节速度噪声 \pm0.5 rad/s 相对较大,因为真机上速度通常由位置差分得到,噪声大;上一步动作是策略自己输出的,没有测量误差,所以无噪声。与正文的联系:这些噪声分布是人为指定、已知的,所以世界模型只预测 \bar{\boldsymbol{o}}_t,噪声在外部按此表采样后再加(式 2 前的 \boldsymbol{a}_t=\pi_\theta(\hat{\bar{\boldsymbol{o}}}_t+\boldsymbol{\eta}_t,\boldsymbol{g}_t))。
原文
Goal. For the motion-tracking interface, the goal \boldsymbol{g}_t is read from the reference motion. Compared with BeyondMimic [3], we condition the encoder on a K = 10 future reference sequence rather than a single-frame target. Other goal interfaces replace gt with their corresponding command representation, such as target velocity commands (Appendix B).
译文
目标。对动作追踪接口而言,目标 \boldsymbol{g}_t 从参考动作中读取。与 BeyondMimic [3] 相比,我们让编码器以未来 K=10 帧的参考序列为条件,而不是单帧目标。其他目标接口则用各自的指令表示替换 \boldsymbol{g}_t,例如目标速度指令(附录 B)。
解释
单帧目标只告诉策略“下一刻应该在哪”;未来 10 帧(0.2 s)还告诉它“接下来要往哪去、多快”,让策略能提前准备,比如起跳前先下蹲蓄力。这对空翻等高动态动作尤其有用。
原文
Action. The action \boldsymbol{a}_t maps to a joint setpoint \boldsymbol{q}^{\mathrm{sp}}=\boldsymbol{\alpha}\,\boldsymbol{a}_t+\boldsymbol{q}^0 about the default pose \boldsymbol{q}^0. Following BeyondMimic, the low PD gains make this setpoint a proxy for joint torque rather than a desired position.
译文
动作。动作 \boldsymbol{a}_t 映射为围绕默认姿态 \boldsymbol{q}^0 的关节设定点 \boldsymbol{q}^{\mathrm{sp}}=\boldsymbol{\alpha}\,\boldsymbol{a}_t+\boldsymbol{q}^0。沿用 BeyondMimic 的做法,较低的 PD 增益使这个设定点成为关节力矩的代理量,而不是期望位置。
解释
\boldsymbol{\alpha} 是逐关节的缩放系数(向量,与 \boldsymbol{a}_t 逐元素相乘),把归一化的网络输出映射到弧度。低层 PD 控制器计算力矩 \tau=K_p(\boldsymbol{q}^{\mathrm{sp}}-\boldsymbol{q})-K_d\dot{\boldsymbol{q}}。当 K_p 很小时,关节并不会真的到达 \boldsymbol{q}^{\mathrm{sp}},设定点与当前角之差基本线性地决定力矩,因此策略实际上是在“间接输出力矩”。这样关节柔顺,更利于接触和冲击,也降低了 sim-to-real 时对执行器精度的依赖。
原文
Reward. We use BeyondMimic's motion-tracking reward (Table A.2), removing its self-collision penalty. That penalty guards against reward hacking by a stochastic policy. When the reference brings two bodies close without contact, pressing them together suppresses the action noise and raises the velocity-tracking reward. Our policy is deterministic in imagined rollouts (§3.3), so the exploit has no payoff and the term is unnecessary. The joint-limit penalty is lowered from -10 to -2.
译文
奖励。我们使用 BeyondMimic 的动作追踪奖励(表 A.2),但去掉了其中的自碰撞惩罚。该惩罚用于防止随机策略的奖励投机(reward hacking):当参考动作让两个身体部件靠近但不接触时,把它们压在一起可以抑制动作噪声,从而提高速度追踪奖励。我们的策略在想象推演中是确定性的(§3.3),因此这种投机没有收益,该项也就不必要了。关节限位惩罚从 -10 降到 -2。
解释
这里描述的投机现象很有意思:PPO 的随机策略每步都带高斯噪声,噪声会让肢体抖动,降低速度追踪奖励。如果两只手在参考中本就靠得很近,策略可以干脆让它们“顶住”彼此,接触力把抖动压下去,速度奖励就上去了。这在真机上会造成部件互相挤压,所以 BeyondMimic 加了自碰撞惩罚。SuperMimic 在想象中用确定性策略,没有噪声需要“压”,动机消失,这一项就可以删掉。需要注意的是:数据收集时仍有动作噪声 \boldsymbol{\epsilon}_t(§3.1),但它不参与策略优化的目标,因此不会诱发这种投机。
原文
Termination. An episode terminates when the root body deviates from the reference beyond a height or tilt threshold (|ep,z| > 0.25 m or etilt > 0.8). The tilt error etilt is the absolute difference between the z-components of the gravity direction expressed in the reference and robot root (pelvis) frames. For an upright reference, etilt reaches 0.8 at about 78◦of tilt. Unlike BeyondMimic, we do not terminate on end-effector deviation.
译文
终止。当根节点(root body)相对参考的偏离超过高度或倾斜阈值(|e_{p,z}|>0.25 m 或 e_{\mathrm{tilt}}>0.8)时,回合终止。倾斜误差 e_{\mathrm{tilt}} 定义为:重力方向分别在参考根坐标系和机器人根(骨盆)坐标系中表示后,两者 z 分量之差的绝对值。对直立的参考姿态,e_{\mathrm{tilt}} 在约 78^\circ 倾斜时达到 0.8。与 BeyondMimic 不同,我们不因末端执行器偏离而终止。
解释
验算 78^\circ。直立参考下,重力在参考根坐标系中的 z 分量为 -1;机器人倾斜角 \theta 时,该分量为 -\cos\theta。于是 e_{\mathrm{tilt}}=|{-1}+\cos\theta|=1-\cos\theta。令 1-\cos\theta=0.8,得 \cos\theta=0.2,\theta\approx78.5^\circ,与原文一致。|e_{p,z}| 是根节点高度误差,超过 25 cm 视为“掉队”。去掉“末端执行器偏离”终止,使侧滚、空翻这类手脚轨迹大幅变化的动作不至于被过早判死。这些终止条件对应世界模型的终止头 d_\omega;在想象中,它们以概率 \hat d 的形式进入软生存权重。
原文
Sim context and domain randomization. The per-episode sim context \boldsymbol{\xi} collects the domain-randomization parameters fed to the world model (§3.2); Table A.3 lists them. We omit Beyond- Mimic's root-velocity perturbations: such pushes inject state discontinuities that the deterministic world model cannot capture, and we find randomization over the physical parameters alone suffices for transfer to hardware.
译文
仿真上下文与域随机化。每个回合的仿真上下文 \boldsymbol{\xi} 汇集了输入世界模型的域随机化参数(§3.2),表 A.3 列出了它们。我们省略了 BeyondMimic 的根节点速度扰动:这种推搡会给状态注入不连续的跳变,确定性世界模型无法刻画;我们发现仅对物理参数做随机化就足以迁移到硬件。
解释
这与 §3.2“世界模型保持确定性”的设计一致:摩擦、标定偏移、质心偏移在整个回合中固定,作为 \boldsymbol{\xi} 输入后,下一状态仍由 (\boldsymbol{s},\boldsymbol{a},\boldsymbol{\xi}) 唯一决定;而随机推搡在随机时刻发生,无法由输入预测。若保留推搡,模型会把“突然被推”当成噪声去平均拟合,导致预测失真。有趣的是,训练时没有推搡,但 §4.3 的推搡测试中,有评论家的策略仍能恢复,说明鲁棒性部分来自评论家的长远视角,而非来自推搡训练。
| 奖励项(Reward Term) | 公式 | 权重 |
| 任务(追踪) | ||
| 刚体位置 | \exp\!\Big(-\big(\tfrac{1}{|\mathcal T|}\sum_{b\in\mathcal T}\|\mathbf p_b^{\mathrm{des}}-\mathbf p_b\|^2\big)/0.3^2\Big) | 1.0 |
| 刚体朝向 | \exp\!\Big(-\big(\tfrac{1}{|\mathcal T|}\sum_{b\in\mathcal T}\|\log(R_b^{\mathrm{des}}R_b^{\top})\|^2\big)/0.4^2\Big) | 1.0 |
| 刚体线速度 | \exp\!\Big(-\big(\tfrac{1}{|\mathcal T|}\sum_{b\in\mathcal T}\|\mathbf v_b^{\mathrm{des}}-\mathbf v_b\|^2\big)/1.0^2\Big) | 1.0 |
| 刚体角速度 | \exp\!\Big(-\big(\tfrac{1}{|\mathcal T|}\sum_{b\in\mathcal T}\|\boldsymbol{\omega}_b^{\mathrm{des}}-\boldsymbol{\omega}_b\|^2\big)/3.14^2\Big) | 1.0 |
| 根节点位置 | \exp\!\big(-\|\mathbf p_{\mathrm{root}}^{\mathrm{des}}-\mathbf p_{\mathrm{root}}\|^2/0.3^2\big) | 0.5 |
| 根节点朝向 | \exp\!\big(-\|\log(R_{\mathrm{root}}^{\mathrm{des}}R_{\mathrm{root}}^{\top})\|^2/0.4^2\big) | 0.5 |
| 正则项 | ||
| 动作平滑 | \|\boldsymbol{a}_t-\boldsymbol{a}_{t-1}\|^2 | -0.1 |
| 关节限位 | \sum_j\big[\max(0,q_j-q_j^{\max})+\max(0,q_j^{\min}-q_j)\big] | -2 |
表 A.2 解读
结构。总奖励 = 各项“公式值 \times 权重”之和(再乘控制周期 \Delta t=0.02 s,见表 A.6 图注)。任务项都是 \exp(-\text{均方误差}/\sigma^2) 形式,取值在 (0,1]:误差为 0 时为 1,误差等于 \sigma 时为 e^{-1}\approx0.37。\sigma 规定了“容忍尺度”:
- 刚体位置 \sigma=0.3 m;朝向 \sigma=0.4 rad(约 23^\circ),其中 \log(R^{\mathrm{des}}R^\top) 是旋转误差的轴角向量,其范数即误差角;
- 线速度 \sigma=1.0 m/s,角速度 \sigma=3.14 rad/s,速度量本身较大,容忍度也放宽;
- 根节点(骨盆)的位置和朝向单独再计一次,权重 0.5。
| 域随机化项 | 采样分布 |
| 摩擦系数 | \mu\sim\mathcal U[0.3,\,1.2] |
| 关节标定偏移 [rad] | \Delta q_j^0\sim\mathcal U[-0.01,\,0.01] |
| 躯干质心偏移 [m] | \Delta x\sim\mathcal U[-0.025,0.025], |
| \Delta y\sim\mathcal U[-0.05,0.05],\Delta z\sim\mathcal U[-0.05,0.05] |
表 A.3 解读
三类参数,均在每回合开始时采样一次、整回合固定:
- 摩擦系数 0.3–1.2:覆盖从较滑(如光滑地板)到高摩擦(如橡胶垫)的地面。
- 关节标定偏移 \pm0.01 rad:模拟真机关节零位标定误差,即编码器读数与真实角度之间的固定偏差,每个关节独立采样。
- 躯干质心偏移:前后 \pm2.5 cm,左右、上下 \pm5 cm,模拟电池、线缆等造成的质量分布误差。
B跨目标接口的联合训练(Joint training across goal interfaces)
原文
In §3, the goal \boldsymbol{g}_t is read from a full reference motion. Downstream goal interfaces specify the motion only in part or in another form. The same dynamics model can train several goal interfaces because the body physics is shared. We instantiate one POMDP Mi per goal interface (for example, a full-reference motion target, a velocity command, end-effector poses, or an SMPL body-pose target), each with its own goal space Gi, reward ri, and termination di, and train each with its own Reward Term Equation Weight Task (tracking) Body Position exp
译文
在 §3 中,目标 \boldsymbol{g}_t 从完整参考动作读取。下游目标接口只部分地或以其他形式指定动作。由于身体物理是共享的,同一个动力学模型可以训练多个目标接口。我们为每个目标接口实例化一个 POMDP \mathcal M_i(例如完整参考动作目标、速度指令、末端执行器位姿或 SMPL 身体姿态目标),各自有自己的目标空间 \mathcal G_i、奖励 r_i 和终止条件 d_i,并各自用自己的评论家 V_{\psi_i} 训练。
解释
形式上,一个“接口”就是一个任务:它和其他接口共享状态、动作、动力学(即 f_\omega),只是目标空间、奖励和终止条件不同。SMPL 是计算机视觉中常用的参数化人体模型,“SMPL 身体姿态目标”指直接用人体姿态参数(例如从视频估计得到的)驱动机器人。每个接口配一个独立的评论家,因为不同奖励下的价值函数完全不同。
原文
A single policy network uses per-interface goal encoders \mathrm{enc}_{\theta,i} and a shared decoder \mathrm{dec}_\theta, z = enc\theta,i(g) \inZ, a = dec\theta(z, o), g \inGi, (A.1)
\boldsymbol{z}=\mathrm{enc}_{\theta,i}(\boldsymbol{g})\in\mathcal Z,\qquad \boldsymbol{a}=\mathrm{dec}_\theta(\boldsymbol{z},\boldsymbol{o}),\qquad \boldsymbol{g}\in\mathcal G_i,\tag{A.1}
译文
单个策略网络使用每个接口专属的目标编码器 \mathrm{enc}_{\theta,i} 和一个共享解码器 \mathrm{dec}_\theta:
\boldsymbol{z}=\mathrm{enc}_{\theta,i}(\boldsymbol{g})\in\mathcal Z,\qquad \boldsymbol{a}=\mathrm{dec}_\theta(\boldsymbol{z},\boldsymbol{o}),\qquad \boldsymbol{g}\in\mathcal G_i,\tag{A.1}
训练优化的是提升后的目标 \max_\theta\mathbb E_{i\sim p(\mathcal I)}[\hat J_i(\theta)],其中 p(\mathcal I) 是接口集合 \mathcal I 上的分布。因此每个接口 i 都有自己的策略 \boldsymbol{a}=\pi_i(\boldsymbol{o},\boldsymbol{g}):=\mathrm{dec}_\theta(\mathrm{enc}_{\theta,i}(\boldsymbol{g}),\boldsymbol{o});速度编码器还额外接收观测历史的一个特征(表 A.4)。每个 \hat J_i 都是式 (2) 的目标,只是把 \pi_\theta 换成 \pi_i,并使用 \mathcal M_i 的奖励和终止条件以及评论家 V_{\psi_i}。所有接口都通过同一个动力学模型 f_\omega 训练,不为每个接口重新训练该模型。 解释
结构。编码器把各种形式的目标(参考动作、速度、末端位姿……)翻译成同一个 32 维隐变量 \boldsymbol{z}(表 A.4),解码器根据 \boldsymbol{z} 和本体观测输出关节动作。\boldsymbol{z} 相当于“通用运动指令语言”:解码器只懂这种语言,各个编码器负责把自己的指令翻译成它。“提升后的目标”(lifted objective):把多任务问题写成对任务分布的期望。实现上,每次更新随机抽一个接口 i(或在一个批次中混合多个接口,附录 G),算它的 \hat J_i 并反传。参数共享。\theta 包含所有编码器和解码器的参数;每个接口的梯度只会落到它用到的那部分(自己的编码器 + 解码器),且下一段会说明,下游接口对解码器做了 stop-gradient。f_\omega 在所有接口间完全共享,这是“一个世界模型”的另一层含义:换一个任务不用重学物理。
原文
A downstream interface is trained by distillation or by RL, depending on its reward. Distillation uses the motion-tracking reward (§3.3), with the command read from the reference motion. The reward gradient then trains that interface to reproduce the reference motion from this command. RL optimizes the interface's own task reward, such as velocity tracking, directly through the world model. On a downstream interface's rollouts, the return gradient passes through the shared decoder to that interface's encoder, with a stop-gradient on the decoder's weights; the decoder is still trained by the motion-tracking objective. The RL-trained velocity encoder of §4.5 also has a latent-alignment loss toward the motion encoder's latent on rollouts with reference commands (Appendix G).
译文
下游接口用蒸馏或 RL 训练,取决于它使用的奖励。蒸馏使用动作追踪奖励(§3.3),指令从参考动作中读取。奖励梯度于是训练该接口根据这条指令复现参考动作。RL 则直接通过世界模型优化接口自身的任务奖励,例如速度追踪。在下游接口的推演中,回报梯度穿过共享解码器传到该接口的编码器,同时对解码器权重做 stop-gradient;解码器仍只由动作追踪目标训练。§4.5 中由 RL 训练的速度编码器,还有一个隐变量对齐损失:在使用参考指令的推演上,把它的隐变量拉向动作编码器的隐变量(附录 G)。
解释
梯度路径细节:下游回报 \hat J_i 对编码器参数的梯度为 \frac{\partial\hat J_i}{\partial\boldsymbol{a}}\frac{\partial\mathrm{dec}}{\partial\boldsymbol{z}}\frac{\partial\boldsymbol{z}}{\partial\theta_{\mathrm{enc},i}},需要用到解码器关于输入 \boldsymbol{z} 的雅可比(梯度“穿过”解码器),但不对解码器权重求导(stop-gradient)。这样做可以保护解码器:它是所有接口共用的“运动技能库”,若被速度奖励随意改动,可能破坏动作追踪的质量。局限一节也指出了这一设计的后果。“蒸馏”在这里的含义与通常的“模仿教师输出”略有不同:它不是让编码器去匹配教师网络的输出,而是在“追踪参考”的奖励下训练,指令只是参考动作的摘要。效果上,编码器学会把“速度”翻译成“产生对应参考动作的隐变量”。隐变量对齐:给 RL 编码器加的辅助损失,让它在“有参考动作可对照”时输出与动作编码器相近的 \boldsymbol{z}。直觉是让速度编码器的输出落在解码器熟悉的隐空间区域,产生自然的步态,而不是钻解码器的空子。
C网络结构(Network architectures)
原文
Table A.4 lists the world-model dynamics network of §3.2 and the policy and critic networks of Appendix B.
译文
表 A.4 列出了 §3.2 中的世界模型动力学网络,以及附录 B 中的策略网络和评论家网络。
解释
全部是普通 MLP,没有 Transformer、RNN 或隐空间随机模型等复杂结构。这说明本文的收益来自训练范式,而不是网络架构上的技巧。
| 网络 | 输入 | 输出 | 结构 |
| 动力学 f_\omega | \hat{\boldsymbol{s}}_t,\ \boldsymbol{a}_t,\ \boldsymbol{\xi} | \hat{\boldsymbol{s}}_{t+1} | MLP (2048, 2048, 2048) |
| 动作编码器 \mathrm{enc}_{\theta,\mathrm{motion}} | 未来 K=10 帧参考 | \boldsymbol{z} | MLP (2048, 1024, 512, 256) |
| 速度编码器 \mathrm{enc}_{\theta,\mathrm{vel}}(附录 G) | 归一化指令 (v_x,v_y,\omega_z),最近 10 帧 \boldsymbol{o} 的特征 | \boldsymbol{z} | MLP (256, 256) |
| 共享解码器 \mathrm{dec}_\theta | \boldsymbol{z},最近 10 帧 \boldsymbol{o} | \boldsymbol{a}_t | MLP (2048, 1024, 512, 256) |
| 评论家 V_{\psi_i} | \hat{\boldsymbol{s}}_t,\ \boldsymbol{g}_t,\ \boldsymbol{\xi} | 标量 | MLP (256, 128);每个接口一个评论家 |
表 A.4 解读
- 动力学 f_\omega:三层 2048 宽,是最大的网络(约 2\times2048^2\approx8.4M 个隐藏层间参数,再加输入输出层)。它要刻画全部接触动力学,容量最大是合理的。图 3(c) 表明这个容量在 264 h 数据下仍够用。
- 动作编码器 + 共享解码器:两者都是 2048-1024-512-256 的“漏斗”结构,合起来就是动作追踪策略 \pi_\theta。
- 速度编码器:很小(256, 256),因为它只需把 3 维指令加上历史特征映射到 32 维 \boldsymbol{z}。
- 评论家:意外地小(256, 128),且输入特权信息 \hat{\boldsymbol{s}}_t 和 \boldsymbol{\xi}。由于它只需估计 32 步之后的回报,又有完整状态,小网络就够用。
- 隐变量 \boldsymbol{z}:32 维、tanh 限幅到 [-1,1],限幅防止下游编码器输出解码器没见过的极端值。
D训练循环与超参数(Training loop and hyperparameters)
D.1算法(Algorithm)
算法 A.1:SuperMimic 训练(原文 Algorithm A.1: SuperMimic training)。\omega 和 \theta 在每次迭代中都会更新;只有在策略的反向传播内部,\omega 才保持固定(stop-gradient)。对于下游接口,\hat J_i 只更新其编码器 \mathrm{enc}_{\theta,i}。
Require: 世界模型 f_\omega;在各接口 \{\mathcal M_i\}_{i\in\mathcal I} 间共享的策略 \pi_\theta;回放缓冲区 \mathcal B
1:for 每次迭代 do
2: 采集。在仿真中带动作噪声运行 \pi_\theta;把转移推入 \mathcal B,替换最旧的转移
3: 按基于回报的采样选取重置起点 ▷ 附录 D.1
4: 拟合世界模型。从 \mathcal B 采样一个记录的 k 步窗口,在记录的动作上自回归推演 f_\omega,执行 \omega\leftarrow\omega-\alpha_\omega\nabla_\omega\mathcal L_{\mathrm{WM}} ▷ 式 1
5: 改进策略。采样一个接口 i\sim p(\mathcal I),并从 \mathcal B 采样一个起始状态
6: 通过固定的 f_\omega 在策略下想象 H 步:\hat{\boldsymbol{s}}_{t+1}=f_\omega\big(\hat{\boldsymbol{s}}_t,\ \pi_i(\hat{\bar{\boldsymbol{o}}}_t+\boldsymbol{\eta}_t,\boldsymbol{g}_t),\ \boldsymbol{\xi}\big)
7: 执行 \theta\leftarrow\theta+\alpha_\theta\nabla_\theta\hat J_i ▷ 式 2;穿过 f_\omega 的解析梯度;评论家 V_{\psi_i}
8: 将评论家 V_{\psi_i} 拟合到该想象推演的 GAE 目标 ▷ 式 3
9:end for
算法 A.1 解读
算法是图 2 的伪代码版,三个加粗步骤与图 2 的三块一一对应。几处值得注意:
- 第 2–3 行(采集):只用仿真器做前向,带动作噪声 \boldsymbol{\epsilon}_t。缓冲区是先进先出的环形结构(表 A.5:每环境 1000 步)。第 3 行决定仿真环境重置时从动作库的哪个时刻开始,详见下文。
- 第 4 行(拟合模型):普通的梯度下降,最小化式 (1)。
- 第 5–7 行(改进策略):梯度上升,最大化式 (2)。第 6 行把整条想象链写在一个公式里,清楚地显示策略 \pi_i 嵌在动力学 f_\omega 的输入中,这就是梯度能从 f_\omega 流回 \theta 的原因。
- 第 8 行(评论家):用本次想象推演计算的 GAE 目标做回归(式 3)。
- 图注中的 stop-gradient:两个网络都在每次迭代中更新,但更新策略时不把梯度写进 \omega。否则世界模型会被“训练成让策略看起来回报高”,而不再忠实于物理。
原文
Algorithm A.1 summarizes the SuperMimic training loop of §3.1; its three steps correspond one-to-one to the panels of Figure 2.
译文
算法 A.1 总结了 §3.1 的 SuperMimic 训练循环;其三个步骤与图 2 的三个面板一一对应。
解释
见上方算法 A.1 解读。
原文
Return-based reset sampling. Simulator episodes reset to points of the motion library, favoring those where the policy currently earns low return. The motion timeline is divided into 1 s bins, and each bin b keeps a running estimate Gb of the discounted return from it, updated on the policy's own rollouts. Resets mix three distributions: 50% uniform over bins, 40% from softmaxb(-25 Gb/Gmax), where Gmax is the largest attainable discounted return, and 10% in proportion to each bin's past softmax weight, so a hard motion keeps some practice after it is learned.
\text{40\%}:\ \mathrm{softmax}_b\!\left(-25\,G_b/G_{\max}\right)
译文
基于回报的重置采样。仿真回合重置到动作库中的某些时间点,并偏向策略当前回报较低的位置。动作时间轴被切成 1 s 的区间(bin),每个区间 b 维护一个从该区间出发的折扣回报的滑动估计 G_b,用策略自身的推演更新。重置混合三种分布:50% 在各区间上均匀采样;40% 按 \mathrm{softmax}_b(-25\,G_b/G_{\max}) 采样,其中 G_{\max} 是可达到的最大折扣回报;10% 按各区间过去的 softmax 权重成比例采样,这样一个难动作即使学会了,也仍能得到一些练习。
解释
这是一种自适应课程(curriculum),与 BeyondMimic 的自适应采样思路相近。softmax 项:G_b/G_{\max}\in[0,1] 是归一化回报,乘以 -25 后做 softmax,回报越低的区间权重越大。温度很“尖锐”:两个区间的归一化回报差 0.1,权重比就是 e^{2.5}\approx12 倍;差 0.2 时为 e^5\approx148 倍。所以这 40% 几乎都集中在最难的地方。三种成分的作用:均匀部分(50%)保证所有动作都被持续覆盖,防止已学会的动作被遗忘;困难部分(40%)集中火力攻克难点;“历史权重”部分(10%)是一种记忆:某个空翻曾经很难、现在学会了,它的当前 softmax 权重会降低,但历史权重仍高,因而仍会被时不时练习,防止再次退化。与世界模型的关系:重置位置决定了缓冲区里存什么状态,也就决定了想象推演从哪里出发(\boldsymbol{s}_0\sim\rho_0)。所以这一采样同时影响模型训练数据和策略训练的起点分布,这也是图 4(b,c) 中“训练回报”随时间漂移的原因。
D.2超参数(Hyperparameters)
原文
Table A.5 lists the hyperparameters. Where they differ, values are given for the one-GPU and the two-GPU run of Table A.8.
译文
表 A.5 列出了超参数。对于取值不同的项,分别给出表 A.8 中单 GPU 与双 GPU 运行的值。
解释
单卡与双卡唯一的区别是学习率:双卡按 \sqrt2 放大(见下表)。
| 超参数 | 符号 | 取值 |
| 世界模型 | ||
| 窗口长度 | k | 8 |
| 优化器 | Adam | |
| 学习率 | \alpha_\omega | 1 GPU:2\times10^{-4};2 GPU:\sqrt2\times2\times10^{-4} |
| 批大小 | 每次更新 10 个批次,每批 2048 个窗口 | |
| 梯度裁剪 | 全局范数 1.0 | |
| 想象与策略 | ||
| 想象时域 | H | 32 |
| 优化器 | Adam,\beta=(0.9,0.95) | |
| 学习率 | \alpha_\theta | 与 \alpha_\omega 相同 |
| 批大小 | 每次更新 4096 条想象推演 | |
| 梯度裁剪 | 先按全局范数 1.0,再逐元素裁剪到 0.1 | |
| 折扣 | \gamma | 0.99 |
| 传感器噪声 | \boldsymbol{\eta}_t\sim\rho_\eta | 见表 A.1 |
| 评论家 | ||
| GAE 参数 | \lambda | 0.95 |
| 优化器 | Adam | |
| 学习率 | 与 \alpha_\omega 相同 | |
| 梯度裁剪 | 全局范数 1.0 | |
| 每次更新的评论家轮数 | 5 轮,每轮 4 个打乱的小批量 | |
| 数据采集 | ||
| 每 GPU 仿真环境数 | 4096 | |
| 动作噪声 | \boldsymbol{\epsilon}_t\sim\rho_\epsilon | 每个动作维度 \mathcal N(0,0.1^2) |
| 回放缓冲区大小 | 每个环境 1000 步 | |
| 调度 | ||
| 更新数据比(update-to-data) | 0.4 | |
| 每次世界模型更新对应的策略更新数 | 1 | |
| 学习率调度 | 在 250,000 次迭代内余弦衰减到 0.03\times,之后保持不变 | |
| 训练长度 | 320,000 次迭代 | |
| 多 GPU | 数据并行;梯度在各 GPU 间平均 | |
表 A.5 解读
世界模型:每次更新 10 个批次 \times 2048 个 8 步窗口,约 16 万步自回归预测。双卡时有效批量翻倍,学习率按 \sqrt2 放大,这是常见的“平方根缩放”经验法则。策略:两处设置体现 BPTT 的特殊性。(1) Adam 的 \beta_2=0.95(默认 0.999),让二阶矩估计更快适应变化,应对 BPTT 梯度幅度的剧烈波动;(2) 双重梯度裁剪:先把整体范数压到 1.0,再把每个元素压到 \pm0.1。BPTT 穿过 32 步雅可比连乘,偶尔会出现梯度爆炸,裁剪是稳定训练的必要手段。评论家:\lambda=0.95、每次更新 5 轮,与 PPO 中价值函数的常见设置相近。数据采集:动作噪声标准差 0.1(归一化动作空间中),每环境保留最近 1000 步(20 s),4096 个环境共约 410 万条转移。调度:“更新数据比”0.4 的确切含义原文没有展开,大致是“梯度更新次数 / 新采集数据量”的某种比例;余弦衰减到 0.03\times 后保持。320,000 次迭代对应单卡约十余小时(图 A.1 中单卡曲线约在 9.4 h 结束,双卡约 9.8 h),而“3 小时超越 SONIC”是训练中途的检查点。
E动作数据过滤(Motion data filtering)
原文
We train on the publicly available G1-retargeted BONES-SEED motion set [27]. The raw release contains 142,220 clips, s, ladders, chairs) or carry retargeting artifacts that make them infeasible for a free-standing humanoid on flat ground. We remove these in two passes and keep 129,514 clips (Table A.7).
译文
我们在公开的、已重定向到 G1 的 BONES-SEED 动作集 [27] 上训练。原始发布包含 142,220 个片段,但其中许多涉及机器人无法利用的地形或物体(楼梯、箱子、梯子、椅子),或者带有重定向伪影,使其对平地上自由站立的人形机器人不可行。我们分两轮去除这些片段,保留 129,514 个(表 A.7)。
解释
重定向(retarget)把人类动捕骨架映射到机器人骨架。人与 G1 的身高、肢体比例、关节限位不同,映射可能产生脚穿地、悬空等伪影。动作中若有人坐椅子、爬梯子,而仿真里没有这些物体,机器人就会“坐在空气上”,物理上不可能追踪。这些片段会污染训练和评估,必须剔除。
原文
Name filter. Each clip is named by its action. We drop any clip whose name contains a term denoting contact with terrain or an object the robot cannot use e.g. stair, ladder, box, chair, Hyperparameter Symbol Value World model Window length k 8 Optimizer Adam Learning rate \alpha\omega 1 GPU: 2 \times 10-4; 2 GPUs: √
译文
名称过滤。每个片段以其动作命名。我们丢弃名称中包含表示与机器人无法利用的地形或物体接触的词语的片段,例如 stair、ladder、box、chair、sit、climb、jump off 50cm、look over fence。这一轮(改编自 SONIC 公开的数据处理代码中的关键词列表 [1],并补充了它遗漏的几个词)去除了 12,553 个片段。
解释
简单的关键词匹配。142{,}220-12{,}553=129{,}667,与表 A.7 一致。沿用 SONIC 的关键词列表,使两者的数据集尽量可比。
| 阶段(Stage) | 片段数(Clips) |
| 原始 BONES-SEED(G1 重定向) | 142,220 |
| 名称过滤后 | 129,667 |
| 可行性过滤后 | 129,514 |
表 A.7 解读
三行依次为原始数量、名称过滤后、可行性过滤后。名称过滤去掉 12,553 个(约 8.8%),可行性过滤再去掉 153 个(约 0.12%)。最终 129,514 个片段既是训练集,也是 §4.1 与附录 F 的评测基准(因此评测衡量的是对训练动作的覆盖程度,而非泛化)。
原文
Feasibility filter. The name filter misses clips whose names do not reveal the problem (e.g. a routine that walks onto a box). We run each motion through MuJoCo forward kinematics and flag it from the resulting body-link and foot-geometry trajectories, writing zmin(t) = minb zb(t) for the height of the lowest body link at time t with the floor at z = 0:
z_{\min}(t)=\min_b z_b(t)
译文
可行性过滤。名称过滤会漏掉那些名称看不出问题的片段(例如一段走上箱子的动作)。我们用 MuJoCo 正运动学运行每段动作,并根据所得的刚体连杆和脚部几何体轨迹进行标记。记 z_{\min}(t)=\min_b z_b(t) 为 t 时刻最低刚体连杆的高度,地面位于 z=0:
- 抬高支撑。z_{\min} 保持在 0.20 m 以上至少 0.6 s(站在或爬上箱子)。
- 穿地。z_{\min} 低于 -0.12 m,或在超过 80% 的片段时长内低于 -0.08 m(错误重定向把腿压进地面)。
- 脚悬空。在骨盆直立、处于站立高度且身体几乎静止时,双脚离地都超过 0.02 m 并持续至少 0.5 s。离地距离用 MuJoCo 从脚部碰撞几何体算出的精确几何体—平面距离(
mj_geomDistance)测量,而不是用连杆原点做近似。自由站立的人形机器人不可能在静止站立时让双脚都离地,因此无论原因如何(矮平台、重定向导致的漂浮或缓慢抬升),这在平地上都不可行;“静止”这一门限排除了弹道式跳跃。干净的地面站立姿态位于 -0.004\pm0.004 m,因此 0.02 m 的门限距离地面有好几个 \sigma。
解释
三条规则对应三种物理上不可能的情形:
- 抬高支撑:身体最低点长时间离地 20 cm 以上,又不是跳跃(0.6 s 远超一般跳跃的低点停留),说明它“站在”某个仿真里不存在的物体上。
- 穿地:最低点深入地下 12 cm,或长期在地下 8 cm 以上,是重定向错误。短暂小幅穿地(如脚跟落地时几厘米)则被容忍。
- 脚悬空:最细致的一条。条件是“直立 + 站立高度 + 近乎静止 + 双脚离地 2 cm 以上 0.5 s”,这在物理上只能是被什么东西托着。用几何体到平面的精确距离,是因为脚连杆原点在脚踝附近,用它判断会误差很大。
F评估(Evaluation)
F.1基准指标(Benchmark metrics)
原文
We evaluate SONIC and SuperMimic on the same filtered BONES-SEED training-set benchmark, containing 129,514 evaluated motions. For SONIC we evaluate its released checkpoint and its v1.1 checkpoint [1]. Each motion plays once from its first frame, with the same simulation for every policy: foot friction 1.0, no domain randomization or observation noise, and deterministic physics. Each policy uses its own actuator gains and action scale, and receives its observations as its training environment builds them. A motion is marked as failed if the rollout triggers SuperMimic's training termination (Appendix A). SONIC's own success criterion fails a motion on root and end-effector height deviations above 0.25 m, without an orientation term [1].
译文
我们在同一个经过过滤的 BONES-SEED 训练集基准上评估 SONIC 和 SuperMimic,该基准包含 129,514 条被评估的动作。对 SONIC,我们评估其发布的检查点和 v1.1 检查点 [1]。每条动作从第一帧开始播放一次,所有策略使用相同的仿真设置:脚部摩擦 1.0,无域随机化,无观测噪声,物理过程确定。每个策略使用各自的执行器增益和动作缩放,并按其训练环境的构造方式接收观测。若推演触发了 SuperMimic 的训练终止条件(附录 A),该动作即判为失败。SONIC 自己的成功判据是:根节点和末端执行器的高度偏差超过 0.25 m 即判失败,不含朝向项 [1]。
解释
公平性设计:(1) 同一批动作、同一仿真条件;(2) 关闭所有随机性,结果可复现;(3) 每个策略用它自己训练时的执行器参数和观测格式,避免因接口不匹配而冤枉 SONIC。失败判据的差异:本文用自己的终止条件(根高度偏差 >0.25 m 或倾斜误差 >0.8)判失败;SONIC 原本的判据只看高度、不看朝向,但同时检查末端执行器。两种判据各有宽严:本文多了倾斜条件,SONIC 多了末端执行器条件。由于用的是 SuperMimic 的判据,读者应意识到判据选择可能对 SuperMimic 略有利,但作者明确交代了这一点。
F.2失败动作(Failed motions)
原文
Table A.8 counts failed motions per motion group. SONIC fails whole groups (all 44 flips, all 22 side rolls, and all 8 motions of one dance routine) and 15 of the 24 broad jumps. Its v1.1 checkpoint fails 239 motions, among them the same flips and dance motions and 19 of the 22 side rolls. After 3 h on one GPU, SuperMimic's failures concentrate in a few small groups of hard motions: the first five groups of Table A.8, 195 motions, hold 14 of its 25 failures. In no group does it fail more motions than SONIC. After 9.8 h on two GPUs, SuperMimic fails on none. Figure A.1 shows the count over training. The benchmark motions are training motions for both methods, so the counts measure how fully each policy covers these training motions, not generalization to new motions.
译文
表 A.8 按动作组统计失败动作数。SONIC 在若干组上全军覆没(全部 44 个空翻、全部 22 个侧滚、某个舞蹈套路的全部 8 个动作),24 个立定跳远中失败 15 个。其 v1.1 检查点失败 239 条,其中包括同样的空翻和舞蹈动作,以及 22 个侧滚中的 19 个。单 GPU 训练 3 h 后,SuperMimic 的失败集中在少数几个由困难动作组成的小组:表 A.8 前五组共 195 条动作,占了其 25 次失败中的 14 次。在任何一组中,它的失败数都不多于 SONIC。双 GPU 训练 9.8 h 后,SuperMimic 零失败。图 A.1 展示了失败数在训练过程中的变化。基准动作对两种方法而言都是训练动作,因此这些计数衡量的是各策略对这些训练动作的覆盖程度,而不是对新动作的泛化。
解释
关键观察:SONIC 的失败是“结构性”的,整类高难度动作完全不会;SuperMimic 3 h 时的失败则是零散的,各组只错少数几条。这说明 PPO 的大规模训练会在多样性上“取平均”,冷门的高难度类别被牺牲;而 SuperMimic 借助基于回报的重置采样(附录 D.1)和高效梯度,能把这些难点逐一攻克。v1.1 比初版检查点失败更多(239 vs. 179),可能是 SONIC 后续版本在其他方面做了权衡,原文没有解释。最后一句是重要的诚实声明:这里比的是“训练集上学得全不全”,不是“没见过的动作能否追踪”。
| SuperMimic | |||
| 动作组(动作数) | SONIC | 1 GPU \times 3 h | 2 GPU \times 9.8 h |
| 侧滚 side rolls (22) | 22 | 2 | 0 |
| 空翻 flips:360^\circ、180^\circ、90^\circ (44) | 44 | 1 | 0 |
| fire-in-the-hole 转身 (20) | 3 | 3 | 0 |
| 交叉腿 crossed legs (10) | 9 | 0 | 0 |
| 躺下、休息与站起 (99) | 28 | 8 | 0 |
| 立定跳远 broad jumps (24) | 15 | 0 | 0 |
| 舞蹈套路 dance routine (8) | 8 | 0 | 0 |
| 其余所有动作 (129,287) | 50 | 11 | 0 |
| 合计 (129,514) | 179 | 25 | 0 |
表 A.8 解读
列:第一列是动作组及其动作数;第二列是 SONIC 发布检查点的失败数;后两列是 SuperMimic 单卡 3 h 与双卡 9.8 h 的失败数。行:前五组是作者归类的“困难小组”(共 22+44+20+10+99=195 条),中间两组是 SONIC 表现差的另两类,最后是其余约 12.9 万条普通动作。“fire-in-the-hole turns”是动作库中的一类转身动作的名称(源自口令式动作名),这里保留原名。关键数字:
- SONIC 在侧滚(22/22)、空翻(44/44)、舞蹈(8/8)三组全部失败(粗体),交叉腿 9/10、立定跳远 15/24 也很差;
- SuperMimic 3 h:前五组失败 2+1+3+0+8=14,其余组 11,合计 25;唯一与 SONIC 持平的是 fire-in-the-hole 转身(3 vs. 3),其余各组都更少;
- 普通动作上,SONIC 失败 50 条,SuperMimic 11 条,即使在“简单”动作上也有优势;
- 双卡 9.8 h:全部为 0。
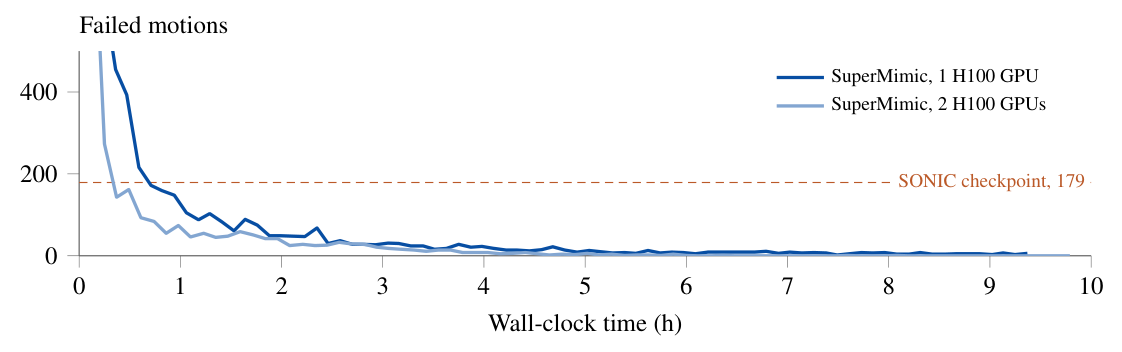
图 A.1 解读
横轴是墙钟时间(0–10 h),纵轴是 129,514 条动作中的失败数(截断在 500 附近,初期实际更高)。深蓝为单张 H100,浅蓝为两张 H100,橙色虚线是 SONIC 的 179。读图:两条曲线在第一个小时内急剧下降。双卡约 0.4 h、单卡约 0.7 h 就降到 179 以下;约 2.5 h 后都进入几十条的低位,此后缓慢逼近 0。单卡曲线在约 9.4 h 结束,双卡在约 9.8 h 达到 0。双卡在同一墙钟时间下明显更低,说明数据并行能有效加速(虽然按 GPU 小时算并不更省)。与图 3(a) 的关系:同一组运行,图 3(a) 看回报,本图看失败数,两者共同支撑“3 h 超越 SONIC”的论断。注意按 §4.1 的保守标准,3 h 后失败数需一直不超过约 89,图中曲线在 3 h 后确实稳定在 30 以下。
F.3实验协议(Experiment protocols)
原文
Figure 3. SuperMimic trains on the filtered BONES-SEED set (Appendix E). The dataset-length sweep in (b, c) uses subsets of 1, 7, 40, and 264 h.
译文
图 3。SuperMimic 在过滤后的 BONES-SEED 集合(附录 E)上训练。(b, c) 中的数据集时长扫描使用 1、7、40 和 264 h 的子集。
解释
补充了图 3(b,c) 横轴四个点的具体取值。四个点在对数轴上大致均匀分布(相邻比例约 7、5.7、6.6),覆盖了两个多数量级。原文未说明子集如何抽取(随机还是按类别)。
G速度指令任务(Velocity-command task)
G.1训练设置(Training setup)
原文
The velocity encoder of §4.5 maps the command (v_x,v_y,\omega_z) and a feature of the last 10 frames of \boldsymbol{o} to the shared latent.
译文
§4.5 的速度编码器把指令 (v_x,v_y,\omega_z) 和最近 10 帧 \boldsymbol{o} 的一个特征映射到共享隐空间。
解释
与动作编码器不同,速度编码器还要看观测历史:同样的“以 1 m/s 前进”,机器人当前处于什么步态相位、是否刚起步,所需的隐变量不同。动作编码器不需要这个,因为参考动作本身已包含完整的时序信息。
原文
Each encoder is trained from scratch in its own run, jointly with the motion-tracking interface, for 100,000 iterations. Both runs use a walking and running library filtered from LAFAN1 and BONES- SEED. Half of the 4096 simulator environments and half of each imagined batch use the velocity interface, so p(I) is uniform; unlike Algorithm A.1, which samples one interface per update, each imagined batch mixes both.
译文
每个编码器在各自独立的运行中从零开始训练,与动作追踪接口联合训练 100,000 次迭代。两次运行都使用从 LAFAN1 和 BONES-SEED 中筛选出的步行与跑步动作库。4096 个仿真环境中的一半、以及每个想象批次中的一半使用速度接口,因此 p(\mathcal I) 是均匀分布;与算法 A.1 每次更新只采样一个接口不同,这里每个想象批次同时混合两种接口。
解释
“两次运行”指 RL 编码器一次、蒸馏编码器一次,每次都同时从零训练动作追踪器(编码器 + 解码器)。动作库只含走跑动作,比主实验小得多,因此是一个受控的小规模实验。每个批次各占一半,相当于两种接口的梯度在每一步都被平均,比轮流采样更平稳。
原文
Commands. The command \boldsymbol{g}_t=(v_x,v_y,\omega_z) stacks the target planar root velocity in the heading (yaw-only) frame and the target world-frame yaw rate. A reference command is the centered 25frame mean of the reference root velocity in the reference's heading frame. For the RL encoder, each environment resamples its command source at every reset and every 250 control steps (5 s): with probability 0.5 it reads the command from the reference clip at every step, and otherwise it holds a command drawn uniformly from vx \in[-1.5, 2] m/s, vy \in[-1.32, 1.32] m/s and \omegaz \in [-3.35, 3.35] rad/s, zeroed (standing) with probability 0.1.
译文
指令。指令 \boldsymbol{g}_t=(v_x,v_y,\omega_z) 由航向(仅偏航)坐标系中的目标平面根节点速度和世界坐标系中的目标偏航角速度拼接而成。参考指令是参考动作根节点速度在参考航向坐标系中的居中 25 帧均值。对于 RL 编码器,每个环境在每次重置时以及每 250 个控制步(5 s)重新选择指令来源:以 0.5 的概率在每一步从参考片段读取指令;否则保持一个从 v_x\in[-1.5,2] m/s、v_y\in[-1.32,1.32] m/s、\omega_z\in[-3.35,3.35] rad/s 中均匀采样的指令,并以 0.1 的概率置零(站立)。
解释
坐标系:“航向坐标系”是只保留机器人偏航角、把俯仰和横滚去掉的坐标系,这样 v_x 总是“机器人面朝的水平方向”,v_y 是“向左”,不受身体前倾等影响。参考指令:从参考动作中提取速度。取 25 帧(0.5 s)居中平均,是为了滤掉步态周期内的速度起伏(走路时质心速度本身是波动的)。指令来源混合:一半时间用参考片段的速度(此时也可以计算与动作编码器的隐变量对齐损失),一半时间用随机均匀采样的指令(探索动作库未覆盖的组合)。最大速度 2 m/s 前进、1.5 m/s 后退、1.32 m/s 侧移、3.35 rad/s 转向(约 192^\circ/s)。10% 的站立指令教会机器人停下。蒸馏基线只用参考指令(因为它的奖励需要参考动作)。
原文
Encoder. On rollouts with reference commands, a mean-squared loss of weight 0.1 pulls the velocity latent toward the motion encoder's latent at the same step, with a stop-gradient on the motion latent.
译文
编码器。在使用参考指令的推演上,一个权重为 0.1 的均方损失把速度隐变量拉向同一时刻动作编码器的隐变量,并对动作隐变量做 stop-gradient。
解释
即 \mathcal L_{\mathrm{align}}=0.1\,\|\boldsymbol{z}_{\mathrm{vel}}-\mathrm{sg}(\boldsymbol{z}_{\mathrm{motion}})\|^2,sg 表示 stop-gradient。只让速度编码器向动作编码器靠拢,而不反过来影响动作编码器,以保护动作追踪性能。这是附录 B 提到的“隐变量对齐损失”的具体形式,与 SONIC 的做法相似(表 1 脚注 2)。
原文
Rollouts, reward, and termination. Each interface's imagined rollouts start from states logged by its own simulator environments. Velocity rollouts of the RL encoder use the velocity-tracking reward and a fall-only termination (Table A.6); those of the distillation baseline use the motiontracking reward and termination of Appendix A.
译文
推演、奖励与终止。每个接口的想象推演都从其自身仿真环境记录的状态出发。RL 编码器的速度推演使用速度追踪奖励和仅判摔倒的终止条件(表 A.6);蒸馏基线的推演使用附录 A 中的动作追踪奖励和终止条件。
解释
RL 版本只在真正摔倒时终止,不要求贴合任何参考,所以机器人可以自由选择步态;蒸馏版本仍按偏离参考判终止。两者唯一的实质差别就是奖励与终止条件,这使 §4.5 的对比是干净的。
| 奖励项 | 公式 | 权重 |
| 任务(速度追踪) | ||
| 线速度 | \exp\!\big(-\|\mathbf v_{xy}-\mathbf v_{xy}^{\mathrm{cmd}}\|^2/0.5^2\big) | 2.0 |
| 偏航角速度 | \exp\!\big(-(\omega_z-\omega_z^{\mathrm{cmd}})^2/0.5\big) | 2.0 |
| 正则项 | ||
| 动作平滑 | \|\boldsymbol{a}_t-\boldsymbol{a}_{t-1}\|^2 | -0.3 |
| 关节限位 | \sum_j\big[\max(0,q_j-q_j^{\max})+\max(0,q_j^{\min}-q_j)\big] | -2 |
| 躯干侧倾 | \sin^2\phi_{\mathrm{torso}} | -4 |
| 躯干横滚与俯仰角速度 | \omega_{\mathrm{roll}}^2+\omega_{\mathrm{pitch}}^2 | -0.05 |
| 终止(摔倒) | h_{\mathrm{root}}<0.35 m 或 1+u_z>0.7 | |
表 A.6 解读
任务项:线速度误差容忍尺度 0.5 m/s;偏航角速度项的分母写作 0.5(而非 0.5^2),相当于 \sigma=\sqrt{0.5}\approx0.71 rad/s。原文如此,这里照录,不确定是有意为之还是笔误。两项权重都是 2.0,每步任务奖励最大为 4。正则项:
- 动作平滑的惩罚(-0.3)比追踪任务的(-0.1)更重:速度任务没有参考动作约束,更容易出现抖动步态。
- 躯干侧倾 -4:防止机器人“歪着身子走”。只惩罚侧倾不惩罚前倾,因为快跑时前倾是自然的。
- 躯干横滚/俯仰角速度 -0.05:抑制躯干晃动。
G.2阶跃测试(Step test)
原文
Protocol. From standing, the policy receives a fixed command for 5 s; each command is tested in four trials. The relative steady-state error is the norm of the mean velocity error over the last 2 s, divided by the norm of the command, with the root velocity measured in the heading frame. The per-command value is the median over the trials that did not fall. The 672 step responses form a 15\times15 grid on each of three planes, spanning the uniform command range above, with the standing command left out. In Figure 7, errors above 0.9 are drawn at 0.9, and a policy that fell in all four trials is drawn at the cap.
译文
协议。从站立状态开始,策略接收一个固定指令,持续 5 s;每个指令测试四次。相对稳态误差定义为最后 2 s 内平均速度误差的范数除以指令的范数,根节点速度在航向坐标系中测量。每个指令的取值是未摔倒试验的中位数。672 次阶跃响应构成三个平面上各 15\times15 的网格,覆盖上述均匀指令范围,并去掉站立指令。在图 7 中,大于 0.9 的误差按 0.9 绘制,四次试验全部摔倒的策略按封顶值绘制。
解释
阶跃响应是控制理论里的经典测试:突然给一个恒定目标,看系统能否稳定跟上。前 3 s 视为过渡过程,只用最后 2 s 计算稳态误差。相对误差 e=\|\overline{\boldsymbol{v}}-\boldsymbol{v}^{\mathrm{cmd}}\|/\|\boldsymbol{v}^{\mathrm{cmd}}\|:例如指令 1 m/s 前进,实际平均 0.84 m/s,则 e=0.16。这里的“速度向量”包括 (v_x,v_y,\omega_z) 三个分量,把线速度与角速度混在一个范数里,单位并不一致,原文没有说明是否做了归一化。格点计数:每个平面 15\times15=225 个,去掉原点(站立)剩 224 个,三个平面共 672 个。三个平面在坐标轴上会有重合的指令(例如 (v_x,0,0) 同时属于 (a)(b) 两个平面),原文按 672 计数,说明重合点被分别计入。
原文
Results. The RL encoder has the lower error on 650 of the 672 step responses, and the distillation encoder on 15. Their median relative errors are 0.16 and 0.49. Distillation falls in every trial on seven commands, all combining translation with a turn of at least 2.8 rad/s, where the motion library has almost no data. Each policy has one training seed.
译文
结果。在 672 次阶跃响应中,RL 编码器在 650 次上误差更低,蒸馏编码器在 15 次上更低。两者的相对误差中位数分别为 0.16 和 0.49。蒸馏在七个指令上每次试验都摔倒,这些指令都是平移加至少 2.8 rad/s 的转向,而动作库在这些区域几乎没有数据。每个策略只有一个训练种子。
解释
数字:650+15+7=672。中位误差 0.16 vs. 0.49,RL 编码器约为蒸馏的三分之一。摔倒的 7 个指令都在“平移 + 快速转向”的角落,对应图 7(b)(c) 右下角的黑圈。局限:每种方法只有一个种子,作者也承认这是初步研究。不过 650:15 的悬殊比例很难用种子随机性解释。