Robota-Embed:面向机器人上下文学习与演化的
统一 VLA 嵌入
Robota-Embed: Unified VLA Embeddings for Robot In-Context Learning and Evolution
Yunze Liu^{1,*}, Jing Wang^{1,*}, Shenrui Wu^{3}, Wenkun He^{2}, Guanqi Zhan^{1}, Xianzheng Ma^{4}, Junyu Chen^{1},
Wenhang Ge^{1}, Haozhan Tang^{5}, Yuchao Gu^{1}, Zhuoyang Zhang^{2}, Zekai Wang^{3}, Dantong Niu^{3},
Zhen Dong^{1}, Yuke Zhu^{1}, Trevor Darrell^{3}, Linxi “Jim” Fan^{1}, Song Han^{2}, Han Cai^{1,\dagger}
^1NVIDIA ^2MIT ^3加州大学伯克利分校(UCB) ^4牛津大学 ^5卡内基梅隆大学(CMU)
^*共同第一作者 ^\dagger通讯作者
arXiv:2610.19495v1 [cs.RO],2026 年 10 月 14 日提交(NVIDIA 技术报告,34 页,14 幅图,33 张表)
项目主页:https://robota-ai.github.io/robota-embed/
中文逐段翻译与解释
整理日期:2026 年 11 月 7 日
统一 VLA 嵌入
Robota-Embed: Unified VLA Embeddings for Robot In-Context Learning and Evolution
Yunze Liu^{1,*}, Jing Wang^{1,*}, Shenrui Wu^{3}, Wenkun He^{2}, Guanqi Zhan^{1}, Xianzheng Ma^{4}, Junyu Chen^{1},
Wenhang Ge^{1}, Haozhan Tang^{5}, Yuchao Gu^{1}, Zhuoyang Zhang^{2}, Zekai Wang^{3}, Dantong Niu^{3},
Zhen Dong^{1}, Yuke Zhu^{1}, Trevor Darrell^{3}, Linxi “Jim” Fan^{1}, Song Han^{2}, Han Cai^{1,\dagger}
^1NVIDIA ^2MIT ^3加州大学伯克利分校(UCB) ^4牛津大学 ^5卡内基梅隆大学(CMU)
^*共同第一作者 ^\dagger通讯作者
arXiv:2610.19495v1 [cs.RO],2026 年 10 月 14 日提交(NVIDIA 技术报告,34 页,14 幅图,33 张表)
项目主页:https://robota-ai.github.io/robota-embed/
中文逐段翻译与解释
整理日期:2026 年 11 月 7 日
解释
阅读方式。沿用本工作区已完成译文的三联框:灰色框保留英文原文,蓝色框给出中文译文,橙色框解释概念、设计动机、数字核对和结论边界。图片使用原论文源码中的矢量图,表格全部重排,均附原注、译注和绿色解读框。保留原章节、公式和图表编号(本文附录不重置图表编号,图 8–14、表 7–33 均在附录中)。原 PDF 使用数字编号引用,译稿按原文参考文献表改写为“作者,年份”格式(同作者同年的文献补上 a/b 字母),参考文献列表从略。解释框是本译稿的分析,不属于作者原文。
来源与许可。原论文:https://arxiv.org/abs/2610.19495v1;PDF:https://arxiv.org/pdf/2610.19495v1。本文以 arXiv 默认的非独占分发许可(arXiv.org perpetual, non-exclusive license)发布,不是知识共享许可;本译稿仅供个人学习研究,不宜公开再分发。英文内容以下载的 v1 源码及 PDF 为依据。
来源与许可。原论文:https://arxiv.org/abs/2610.19495v1;PDF:https://arxiv.org/pdf/2610.19495v1。本文以 arXiv 默认的非独占分发许可(arXiv.org perpetual, non-exclusive license)发布,不是知识共享许可;本译稿仅供个人学习研究,不宜公开再分发。英文内容以下载的 v1 源码及 PDF 为依据。
目录
导读摘要(Abstract)1 引言(Introduction)2 相关工作(Related Work)3 Robota-Embed3.1 问题形式化(Problem Formulation)3.2 动作原生的预测式 VLA 嵌入(Action-Native Predictive VLA Embeddings)3.3 训练数据与检索基准(Training Data and Retrieval Benchmark)4 嵌入评测(Embedding Evaluation)4.1 Robota-Embed-Bench 上的统一 VLA 检索(Unified VLA Retrieval on Robota-Embed-Bench)4.2 预测式检索为什么有效?(What Makes Predictive Retrieval Work?)4.3 基准检索示例(Benchmark Retrieval Examples)5 从嵌入到机器人上下文(From Embeddings to Robot Context)5.1 Embed2ICL:由嵌入引导的机器人上下文学习(Embedding-Guided Robot In-Context Learning)5.2 Embed2Evolve:由嵌入引导的上下文演化(Embedding-Guided Context Evolution)6 讨论(Discussion)7 结论(Conclusion)附录(Appendix)A Robota-Embed 方法细节(Robota-Embed Method Details)A.1 结构与优化(Architecture and Optimization)A.2 Robota-Embed 的训练目标(Robota-Embed Objective)A.3 训练数据与整理(Training Data and Curation)B Robota-Embed-Bench 的评测与诊断B.1 Robota-Embed-Bench 的构成与评测(Composition and Evaluation)B.2 分来源结果(Per-Domain Results)B.3 候选语言与候选库对照(Candidate Language and Gallery Controls)B.4 受控的 Robota-Embed 消融实验(Controlled Robota-Embed Ablations)B.4.1 检索适配(Retrieval Adaptation)B.4.2 可训练范围(Trainable Scope)B.4.3 目标组(Objective Groups)B.4.4 视觉输入(Visual Input)B.4.5 训练时的模态(Training-Time Modalities)B.4.6 推理时的模态可用性(Inference-Time Modality Availability)B.5 受控 DROID 查询遮挡(Controlled DROID Query Masking)B.6 索引规模扩展与检索延迟(Index-Size Scaling and Retrieval Latency)B.7 跨本体的定性分析(Qualitative Cross-Embodiment Analysis)C Embed2ICL 的实现与补充结果C.1 DreamZero-DROID 的参考预热(Reference Warm-Up)C.2 DreamZero 参考与接口分析(Reference and Interface Analysis)C.3 YAM 机器人上的免训练 Embed2ICL(Training-Free Embed2ICL on the YAM Robot)C.4 Fast-WAM 接入细节(Fast-WAM Integration Details)C.5 LIBERO 补充对照(LIBERO Supplementary Controls)C.6 需训练接入方式的消融(Training-Based Integration Ablation)D Embed2Evolve:外壳、开发与评测D.1 策略与记忆接口(Policy and Memory Interfaces)D.2 开发过程与选定的外壳(Development and Selected Harnesses)D.3 开发轨迹(Development Trajectories)D.4 嵌入模型对比(Embedding-Model Comparison)D.5 全新测试的协议与效率(Fresh-Test Protocol and Efficiency)D.6 token 用量与参考费用(Token Usage and Reference Cost)E 相关检索协议译者附注:原文数字核对与阅读提示汇总导读
本文要解决的问题。越来越多的机器人策略可以读取“上下文”:一段示范视频、一段历史轨迹、一组过去的尝试记录。于是“给策略看哪段经验”本身成了控制问题的一部分。现有的通用嵌入(CLIP、Gemini Embedding 等)只对齐图像和文本,能找到“同一个任务”的经验,却分不清“同一任务的哪个阶段”:机械臂伸向碗和放完东西撤手,画面和指令几乎一样,接下来该做的事却完全不同。本文认为,能区分阶段的关键线索是动作,因此提出一个在检索两端都编码视觉、语言、原生动作的嵌入模型 Robota-Embed,检索目标不是“相似的场景”,而是“与当前状态相匹配的那段经验之后发生了什么”,即预测式检索。方法链条。(1) 模型:以 NVIDIA 的 4B 视频—语言基座 Cosmos3-Edge 为骨干,查询端输入“指令 + SAM3 交互区域放大图 + 当前动作”,候选端输入“指令 + 未来 4 秒的 16 帧视频 + 未来动作”,两端共享 Transformer、各有一个残差适配器,在动作 token 位置读出并平均成一个 1,024 维单位向量,用余弦相似度检索。各数据源的动作格式不同,由各自的投影层接入。(2) 训练:以双向 InfoNCE 的“预测对齐”为主,只把规则判定为“确实冲突”的样本当负样本;辅以“模态交换”和“硬负样本”边距损失,强迫模型用上每种模态;再加防塌缩的正则化。训练数据是 EgoDex(人手)、DROID、LIBERO、RoboMIND 四个来源共约 170 万个锚点。(3) 基准:Robota-Embed-Bench,4,000 条查询、8,000 个候选,候选中混入同回合的邻近片段,用“片段级 R@1”衡量阶段定位、“回合级 R@1”衡量找对经验。(4) 两个应用:Embed2ICL 把检索结果交给两种世界动作模型,DreamZero 走免训练的视觉缓存预热,Fast-WAM 走需训练的 Context Tokens 交叉注意力;Embed2Evolve 让冻结的 GPT-6 Astra 在 ManiSkill 中反复尝试、积累记忆,并按固定规则搜索“检索几条、多久刷新、保留多少历史”的配置。| 概念 | 本文中的具体含义 |
| 预测式检索 | 查询描述“现在”,候选记录“之前某次交互之后 4 秒发生了什么”;目标是找到合适的后续,而不是相似的场景。 |
| 锚点(anchor) | 轨迹中的一个时刻 t:t 时刻的指令、裁剪图和动作构成查询,t 之后 4 秒的视频和动作构成配对的正确候选。 |
| 原生动作 | 各数据源自身格式的动作(EgoDex 57 维人手姿态,DROID/LIBERO 10 维,RoboMIND 双臂 20 维),分位数归一化后由按来源区分的投影层接入。 |
| 片段级 / 回合级 R@1 | 排名第一的候选恰好是配对片段 / 来自同一回合即可。两者之差反映“认出经验”与“定位阶段”的差距。 |
| 有效性掩码 | InfoNCE 只把任务、物体、动作或其组合确实冲突的样本当负样本;兼容、不确定、近似重复的样本被忽略。 |
| 模态交换 | 把查询中的一种模态换成另一个样本的,要求相似度至少下降一个边距,迫使模型不能忽略该模态。 |
| 重新训练 vs. 查询遮挡 | 去掉一种模态后重新训练,测“剩下的输入够不够”;对固定模型遮掉一种输入,测“模型依赖多少”。 |
| Embed2ICL | 检索结果作为策略上下文:DreamZero 用参考视频预热视觉 KV 缓存(免训练);Fast-WAM 读取 32\times1024 的 Context Tokens(需微调)。 |
| Context Tokens | 目标端隐状态按时间池化到 32 段、经同样的投影和逐 token 归一化得到的序列,是检索向量“展开回时间维”的版本。 |
| 外壳(harness) | 冻结策略之外的上下文配置:记忆库 + 检索条数 k、刷新间隔 \delta、历史对数 H、成功/效率奖励 \alpha,\beta。 |
| Embed2Evolve | 开发阶段反复试跑、扩充记忆、按“成功优先”规则选配置;测试阶段冻结外壳,在全新种子上评估 GPT-6 Astra。 |
| Direct | 不加检索、只用回合内自身历史的 GPT-6 Astra,是 Embed2Evolve 效率比较的基线。 |
摘要(Abstract)
原文
Retrieving useful context for a robot requires matching not only its task, but also its current stage of execution and the continuation that should follow. We introduce Robota-Embed, to our knowledge the first vision–language–action (VLA) embedding model to jointly encode all three modalities in both current-state queries and recorded future continuations. Predictive retrieval training aligns these endpoints for physical-experience retrieval, and the resulting representation retrieves historical continuations as context at inference time.
译文
要为机器人检索到有用的上下文,不仅要匹配它的任务,还要匹配它当前所处的执行阶段,以及接下来应当发生的后续过程(continuation)。我们提出 Robota-Embed。据我们所知,这是第一个在“当前状态查询”和“记录下来的未来后续片段”两端同时联合编码视觉、语言、动作三种模态的视觉—语言—动作(VLA)嵌入模型。预测式检索训练(predictive retrieval training)把这两端对齐,用于物理经验检索;训练得到的表示可以在推理时把历史上的后续片段检索出来,作为上下文使用。
解释
这一段交代全文的核心问题和核心主张。“上下文”指喂给机器人策略的参考经验,例如一段示范视频或一段历史轨迹。作者认为好的参考必须同时满足三层匹配:任务相同(“把盒子放进碗里”);阶段相同(机器人此刻是在伸手、在抓取还是已经放下);后续合适(参考里接下来发生的事,正是机器人现在该做的事)。只做图文匹配的通用嵌入只能保证第一层。“两端”是理解全文的关键:检索里的查询端(query)描述“现在”,即当前图像、指令和最近的动作;候选端(candidate/target)是一段“已经发生过的未来”,即历史数据中某个时刻之后约 4 秒的视频和动作。查询和候选在时间上错开,检索的目标是“给定现在,找到合适的未来”,所以叫预测式检索。作者强调两端都含有动作,这是他们声称“第一个”的依据。
原文
We construct a multi-source corpus of 1,695,684 cleaned training anchors and introduce Robota-Embed-Bench, which evaluates 4,000 queries against a shared 8,000-entry gallery. Our model achieves 47.33% clip-level and 81.77% episode-level R@1, surpassing action-free Gemini Embedding 2 by 22.09 and 33.47 percentage points. Across controlled retrieval studies, removing native action degrades retrieval more than removing vision, indicating that execution information is a central part of the retrieval key.
译文
我们构建了一个多来源语料库,包含 1,695,684 个清洗后的训练锚点(anchor),并提出 Robota-Embed-Bench 基准:用 4,000 条查询在一个共享的 8,000 条目候选库(gallery)中检索。我们的模型取得 47.33% 的片段级(clip-level)R@1 和 81.77% 的回合级(episode-level)R@1,比不使用动作的 Gemini Embedding 2 分别高出 22.09 和 33.47 个百分点。在一系列受控检索实验中,去掉原生动作(native action)对检索的损害大于去掉视觉,说明执行信息是检索键(retrieval key)的核心组成部分。
解释
锚点是从一条轨迹里取出的一个时间点:锚点时刻的观测、指令和此前的动作构成查询,锚点之后 4 秒构成配对的正确候选。两种 R@1 的区别后文会反复用到。片段级 R@1 要求排第一的候选恰好是与查询配对的那段未来;回合级 R@1 只要求排第一的候选来自同一条轨迹(回合)。同一回合里相邻时刻的片段非常相似,所以片段级要求模型分辨“同一条轨迹里的哪个阶段”,比回合级难得多,47.33% 与 81.77% 的差距反映的正是这种阶段定位的难度。数字验算:47.33-22.09=25.24,81.77-33.47=48.30,即 Gemini Embedding 2 的两项 R@1 约为 25.2% 和 48.3%,与图 1 左下角的 25.2、48.3 一致。原生动作指各数据源自己格式的动作(关节角、末端位姿、人手姿态等),不经过统一重定向,由按来源区分的投影层读入。“去掉动作比去掉视觉损害更大”是全文最主要的表示学习结论,证据在第 4.2 节和附录 B.4。
原文
We then study how this shared retrieval space transfers beyond retrieval metrics through two complementary applications. Embed2ICL uses retrieved experience for training-free and training-based policy conditioning, increasing success from 47.0% to 56.3% in DROID-Sim and from 86.4% to 92.8% on the LIBERO difficult subset. Both interfaces also improve task progress in real-robot evaluations.
译文
接着,我们通过两个互补的应用,研究这个共享检索空间能否在检索指标之外发挥作用。Embed2ICL 把检索到的经验用于免训练和需训练两种策略条件化方式:在 DROID-Sim 中把成功率从 47.0% 提高到 56.3%,在 LIBERO 困难子集上从 86.4% 提高到 92.8%。两种接口在真机评测中也都提高了任务进度。
解释
ICL 即上下文学习(in-context learning):不改策略权重,或只做一次性适配,靠输入里附带的示例改善行为。这里有两条路线。免训练(training-free)路线用 DreamZero:把检索到的参考视频先“喂”进它的视觉缓存(第 5.1 节称为 warm-up),策略本身不动;47.0%\to56.3% 即这条路线在 DROID-Sim 仿真中的结果。需训练(training-based)路线用 Fast-WAM:微调策略,让它学会读取由检索示范预先编码得到的 Context Tokens;86.4%\to92.8% 是 LIBERO 中 5 个困难任务的平均成功率。“困难子集”是作者从 LIBERO 中挑出的、官方模型成功率较低的任务,后文表 3 有具体任务列表。需要注意,摘要里写的是“成功率”,真机部分只说“任务进度”提高,没有给成功率;真机进度分数是按任务自定义的 0–100 分(表 5)。
原文
Embed2Evolve uses execution feedback to grow task-local memory and refine how retrieved context is used around a frozen GPT-6 Astra policy. Across five ManiSkill tasks, it achieves 68% success, compared with 24% for GPT-6 Astra Direct and 33% for a harness independently evolved with Omni-Embed-Nemotron-3B under the same protocol. Relative to the latter, it uses approximately 79.5% fewer policy tokens per test rollout. Together, these results show that a unified, action-aware retrieval space can support both robot in-context learning and task-local context evolution.
译文
Embed2Evolve 利用执行反馈,围绕一个冻结的 GPT-6 Astra 策略不断扩充任务内(task-local)记忆,并改进检索上下文的使用方式。在五个 ManiSkill 任务上,它取得 68% 的成功率;相比之下,直接使用 GPT-6 Astra(Direct)为 24%,在相同协议下用 Omni-Embed-Nemotron-3B 独立演化出的外壳(harness)为 33%。与后者相比,它每次测试执行(rollout)消耗的策略 token 约少 79.5%。综合来看,这些结果表明,一个统一的、感知动作的检索空间既能支撑机器人上下文学习,也能支撑任务内的上下文演化。
解释
第二个应用面向“智能体式”机器人:GPT-6 Astra 是一个可以直接输出机器人动作的前沿大模型(工作区 RoboICL 译稿研究的正是它的具身上下文学习能力)。harness(外壳)指包在冻结策略外面的一整套上下文配置:记忆库里存哪些历史回合、每隔多少步检索一次、检索几条、保留多长的历史等。Embed2Evolve 在“开发阶段”反复试跑任务,把执行结果写进记忆,并按成功率挑选更好的外壳配置;“测试阶段”冻结外壳,在新的初始化上评估。三组数字的含义:Direct(24%)是不加任何检索上下文的 GPT-6 Astra;用 Omni-Embed-Nemotron-3B(一个不含动作的通用多模态嵌入模型)替换 Robota-Embed,按同一套搜索规则从同一初始记忆独立演化,得到 33%;用 Robota-Embed 演化得到 68%。这个对比把检索模型作为唯一变量,用来说明嵌入质量对上下文演化的作用。token 节省按全部测试执行平均,包括失败的执行(失败的执行往往更长、更费 token),不包括开发阶段的花费。
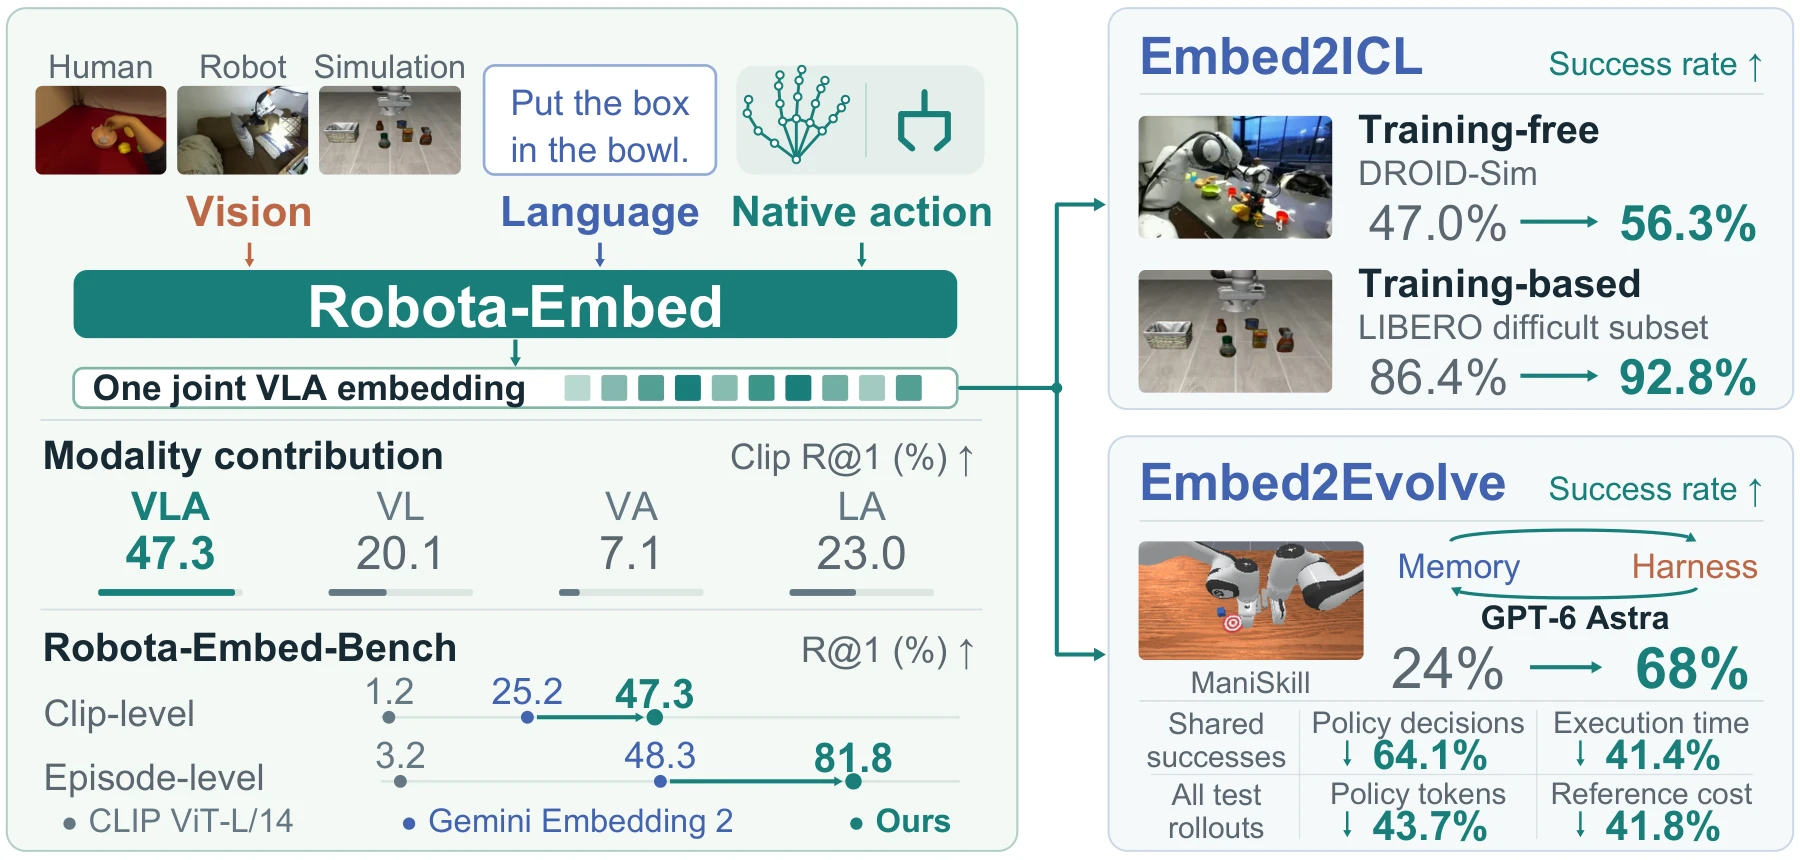
图 1:一个联合 VLA 嵌入,两类上下文应用。Robota-Embed 联合编码来自人类、机器人和仿真经验的视觉、语言与原生动作,用来检索记录下来的后续片段。左:在 Robota-Embed-Bench 上的检索准确率和各模态的贡献。右:在 Embed2ICL 中,检索到的示范为机器人策略提供条件;在 Embed2Evolve 中,任务内记忆和上下文用法围绕一个固定的 GPT-6 Astra 策略不断演化。token 节省包含失败的最终测试、不包含开发阶段;决策次数和时间的节省使用匹配的成功配对计算。这些效率比较都以 Direct 为基线。
原图注:One joint VLA embedding, two context applications. Robota-Embed jointly encodes vision, language, and native action from human, robot, and simulated experience to retrieve recorded continuations. Left: retrieval accuracy and modality contributions on Robota-Embed-Bench. Right: retrieved demonstrations condition robot policies in Embed2ICL; task-local memory and context use evolve around a fixed GPT-6 Astra policy in Embed2Evolve. Token savings include failed final tests and exclude development; decision/time savings use matched successful pairs. These efficiency comparisons use Direct as the baseline.
图 1 解读
左上是模型的输入结构:三类数据源(人类第一视角视频、真实机器人、仿真)提供视觉,一条指令(如“Put the box in the bowl”)提供语言,人手或机械臂的动作轨迹提供原生动作;三者一起进入 Robota-Embed,输出一个联合 VLA 向量。左中“模态贡献”比较同一基准上不同输入组合的片段级 R@1:完整 VLA 为 47.3,只用视觉+语言(VL)为 20.1,视觉+动作(VA)为 7.1,语言+动作(LA)为 23.0。这是推理时对已训练模型屏蔽某一模态的结果(附录表 20),不是重新训练。读法是:去掉动作(VL)掉 27.2 点,去掉视觉(LA)掉 24.3 点,去掉语言(VA)掉 40.2 点。所以语言最关键,动作次之,视觉的边际贡献最小,这与摘要“去掉动作比去掉视觉损害更大”一致。左下把三个模型放在同一数轴上:CLIP ViT-L/14 片段级 1.2、回合级 3.2;Gemini Embedding 2 为 25.2 和 48.3;本文为 47.3 和 81.8。右上 Embed2ICL 汇总两条策略接口的仿真结果(47.0%\to56.3%,86.4%\to92.8%)。右下 Embed2Evolve 是 ManiSkill 中的演化结果:成功率从 24% 提高到 68%;在双方都成功的那部分初始化上,策略决策次数减少 64.1%,执行时间减少 41.4%;按全部测试执行计算,策略 token 减少 43.7%,参考费用减少 41.8%。图注特意说明了两种口径:token 和费用按全部执行平均,决策次数和时间只在“双方都成功”的配对上比较,因为失败执行的步数没有可比性。这里的效率对比都是相对 Direct,摘要里的“79.5%”则是相对 Omni-Embed-Nemotron-3B 外壳,二者不要混淆。
1引言(Introduction)
原文
Robot policies increasingly use experience supplied in context. GEN-1.5 (Team, 2026) and S1 (AI, 2026) demonstrate Robot In-Context Learning from sensorimotor or video examples. In our experiments, GPT-6 Astra (OpenAI, 2026) generates robot actions from observations and execution history. These capabilities make experience selection part of the control problem. Demonstration-conditioned world action models (WAMs) need useful existing examples; policies acting repeatedly must organize accumulated experience. Both raise a representation question: how should physical experience be represented for task- and stage-sensitive retrieval?
译文
机器人策略越来越多地使用通过上下文提供的经验。GEN-1.5(Team, 2026)和 S1(AI, 2026)展示了基于感知运动示例或视频示例的机器人上下文学习(Robot In-Context Learning)。在我们的实验中,GPT-6 Astra(OpenAI, 2026)根据观测和执行历史生成机器人动作。这些能力使“选择哪段经验”成为控制问题的一部分。以示范为条件的世界动作模型(world action model, WAM)需要有用的现成示例;反复执行任务的策略则必须组织好不断积累的经验。两者都引出同一个表示问题:物理经验应当如何表示,才能支持对任务和执行阶段都敏感的检索?
解释
第一段把“检索”放到控制问题里。过去的策略只看当前观测和指令;如今不少模型能读取上下文里的示例,于是“给它看哪段示例”直接影响动作质量。作者区分了两种需求:一是 WAM 这类以示范为条件的策略,需要从已有数据集里挑示范;二是像 GPT-6 Astra 这样反复尝试任务的智能体,需要管理自己逐渐积累的经验。这两种需求分别对应后文的 Embed2ICL 和 Embed2Evolve。WAM 指同时预测未来画面和动作的模型(本工作区的 OpenWAM、InternW0-Delta 译稿都属于这一类),DreamZero 和 Fast-WAM 都是 WAM。引用格式说明:原文用作者—年份格式,“Team, 2026”“AI, 2026”是 bibtex 对机构作者(Generalist AI Team、Skild AI)的截断写法,并非笔误。
原文
Task similarity alone is insufficient. Reaching toward a bowl and withdrawing after placement can share objects and an instruction yet require different continuations. Language specifies the goal, vision the interaction state, and native action the ongoing motion. The retrieval endpoints have different temporal roles: the query describes the present, whereas a candidate records what followed an earlier interaction. Predictive retrieval therefore requires sensitivity to task intent and execution stage: the goal is an appropriate recorded continuation, not simply a similar scene.
译文
仅靠任务相似性是不够的。“伸手去碗那里”和“放下之后把手撤回”可以涉及同样的物体、同一条指令,却需要截然不同的后续动作。语言指明目标,视觉指明交互状态,原生动作指明正在进行的运动。检索的两端在时间上扮演不同角色:查询描述的是现在,而候选记录的是某次更早的交互之后发生了什么。因此,预测式检索(predictive retrieval)需要同时对任务意图和执行阶段敏感:目标是找到一段合适的、被记录下来的后续过程,而不仅仅是一个相似的场景。
解释
这是全文的动机例子。“伸向碗”和“放完撤手”两帧画面可能都是机械臂悬在碗上方,指令也一样,图文嵌入会认为它们高度相似;但前者接下来要下降、松爪,后者接下来要抬起、离开。能把两者区分开的线索主要是运动方向,这正是动作模态提供的信息。作者给三种模态各分配了一个角色:语言管“做什么”,视觉管“现在到哪一步了”,动作管“正在往哪动”。“预测式”强调查询和候选的时间错位:如果只是把当前帧与历史帧做相似度匹配,那是“状态检索”;本文要找的是“与当前状态相匹配的那段历史之后发生了什么”,供策略参考接下来怎么做。
原文
General-purpose embeddings align vision and language (Radford et al., 2021; Girdhar et al., 2023; Xu et al., 2025), while action-aware metric learning connects perception or language with behavior (Sung et al., 2017; Rana et al., 2023). We introduce Robota-Embed, a unified vision–language–action (VLA) embedding model for physical-experience retrieval. To our knowledge, it is the first to jointly encode all three modalities in both current-state queries and recorded continuations. Each endpoint yields one vector, so native action informs retrieval itself. Source-specific projectors handle heterogeneous action formats.
译文
通用嵌入模型对齐视觉和语言(Radford et al., 2021; Girdhar et al., 2023; Xu et al., 2025),而感知动作的度量学习则把感知或语言与行为联系起来(Sung et al., 2017; Rana et al., 2023)。我们提出 Robota-Embed,一个用于物理经验检索的统一视觉—语言—动作(VLA)嵌入模型。据我们所知,它是第一个在当前状态查询和记录的后续片段两端都联合编码三种模态的模型。每一端各输出一个向量,因此原生动作直接参与检索本身。按来源区分的投影层负责处理格式各异的动作。
解释
这里把本文定位在两条已有路线之间。CLIP(Radford et al., 2021)、ImageBind(Girdhar et al., 2023)等通用嵌入有很强的图文对齐能力,但不认识动作;Sung et al.(2017)、Rana et al.(2023)等机器人领域的度量学习把动作纳入了表示,但规模和模态覆盖有限。本文的区别有两点:一是三种模态在两端都编码;二是每端压成一个向量,于是检索就是普通的余弦最近邻搜索,可以用现成的向量索引在大库上快速运行(附录 B.6 给出延迟)。“动作直接参与检索本身”针对的是另一类做法:先用图文嵌入检索,再拿检索结果里的动作去用。那种做法里动作只是被取回的内容,不影响“取回哪一条”。
原文
Retrieval training combines predictive alignment, multimodal grounding and discrimination, and representation regularization.
译文
检索训练由三组目标组成:预测对齐、多模态落地与判别,以及表示正则化。
解释
这三组目标在第 3.2 节和附录 A.2 详细展开。粗略地说,预测对齐把查询向量拉向它真正的未来片段向量;多模态落地与判别确保每种模态都被实际用到,并能分辨相近阶段;表示正则化防止向量空间塌缩到少数方向。
原文
We construct a multi-source training corpus and introduce Robota-Embed-Bench, with 4,000 queries and 8,000 gallery candidates spanning human, simulated, and real-robot experience. Nearby same-episode clips distinguish finding the right experience from locating its recorded continuation. Across four sources, Robota-Embed achieves 47.33% clip-level and 81.77% episode-level R@1. Native action adds information beyond text and images: with backbone, data, and training budget matched on DROID, adding action raises clip-level R@1 from 59.8% to 78.7%. Complementary retraining and query-masking studies examine which information the representation learns and uses.
译文
我们构建了一个多来源训练语料库,并提出 Robota-Embed-Bench:4,000 条查询、8,000 个候选,涵盖人类、仿真和真实机器人的经验。库中同一回合里相邻的片段,把“找到对的经验”和“定位到它被记录下来的那段后续”区分开来。在四个来源上,Robota-Embed 取得 47.33% 的片段级 R@1 和 81.77% 的回合级 R@1。原生动作提供了文本和图像之外的信息:在 DROID 上保持骨干网络、数据和训练预算一致时,加入动作把片段级 R@1 从 59.8% 提高到 78.7%。互补的“重新训练”和“查询掩码”两类实验,分别考察表示学到了哪些信息、实际用到了哪些信息。
解释
“同回合相邻片段”是基准设计的要点:候选库里不仅有正确的配对片段,还有同一条轨迹里时间上相邻的片段。如果模型只认出“是这条轨迹”,就能拿到回合级分数,但要拿到片段级分数,必须定位到正确的时刻。59.8%\to78.7% 来自附录表 19 的受控实验:在 DROID 子集上从头训练两个模型,一个只有视觉+语言,一个有视觉+语言+动作,其余条件相同,提升 18.9 个点。注意这是 DROID 单一来源的受控划分,数值高于四来源基准上的 47.33%,两者不可直接比较。“重新训练”和“查询掩码”的区别:前者去掉一个模态后重新训练,模型可以用剩下的模态补偿,测的是“这些输入够不够”;后者让训练好的模型在推理时缺一个模态,测的是“模型依赖多少”。两者回答的问题不同,第 6 节讨论时会再次强调。
原文
Figure 1 connects retrieval to demonstration conditioning and memory-based interaction. Embed2ICL supports robot in-context learning through two policy interfaces. For DreamZero (Ye et al., 2026), retrieved videos initialize the visual cache without policy updates. For Fast-WAM (Yuan et al., 2026), we fine-tune the policy to condition on precomputed Context Tokens from retrieved demonstrations. Both interfaces improve simulation task success and real-robot task progress. Random-reference controls show that useful context depends on reference selection.
译文
图 1 把检索与示范条件化、基于记忆的交互联系起来。Embed2ICL 通过两种策略接口支持机器人上下文学习。对 DreamZero(Ye et al., 2026),检索到的视频在不更新策略的情况下初始化其视觉缓存;对 Fast-WAM(Yuan et al., 2026),我们微调策略,使其以检索示范预先计算出的 Context Tokens 为条件。两种接口都提高了仿真中的任务成功率和真机上的任务进度。随机参考对照实验表明,上下文是否有用取决于参考的选择。
解释
两种接口代表两种使用上下文的成本。DreamZero 是自回归的视频—动作模型,内部有一个缓存保存已看过的画面;把参考视频预先“播放”进缓存,相当于让模型先看一遍示范再开始执行,完全不需要训练。Fast-WAM 本身没有读示范的入口,所以要加一个交叉注意力通道并微调,让它学会利用参考。“随机参考对照”很重要:给策略任意一段同领域的视频,也可能因为多了一些上下文而略有提升;只有当“检索到的参考”明显好于“随机参考”时,才能把增益归功于检索质量。这些对照见表 4 和附录表 25。
原文
Embed2Evolve extends retrieval to context management for agentic robots. Repeated attempts grow task-local memory, while execution feedback refines retrieval, refresh, and retained-history settings around a frozen GPT-6 Astra policy. Policy and embedding weights remain fixed. Across five ManiSkill tasks, the selected context harness raises success from 24% with Direct to 68%, using 43.7% fewer policy tokens per test rollout. To examine the retrieval model's role, we independently repeat evolution with Omni-Embed-Nemotron-3B from the same initial memory under the same search protocol. Its harness reaches 33% success; Embed2Evolve uses approximately 79.5% fewer tokens than this baseline. Token averages include failed tests and exclude development.
译文
Embed2Evolve 把检索扩展到智能体式机器人的上下文管理。反复尝试使任务内记忆不断增长,执行反馈则围绕冻结的 GPT-6 Astra 策略,调整检索、刷新和保留历史的设置。策略和嵌入模型的权重始终固定。在五个 ManiSkill 任务上,选出的上下文外壳把成功率从 Direct 的 24% 提高到 68%,每次测试执行的策略 token 减少 43.7%。为考察检索模型的作用,我们以相同的初始记忆、在相同的搜索协议下,用 Omni-Embed-Nemotron-3B 独立重复了演化过程。它得到的外壳成功率为 33%;Embed2Evolve 消耗的 token 比这一基线约少 79.5%。token 平均值包含失败的测试,不包含开发阶段。
解释
“演化”在这里不是梯度训练,而是对配置的搜索:每一轮开发尝试改动检索间隔、检索条数、历史长度等超参数,同时把新的执行回合加入记忆库,然后按成功率(成功率相同时比决策次数)选出最佳配置。所有模型权重都冻结,因此提升完全来自“给策略看什么、什么时候看”。两个 token 数字要分开:相对 Direct 省 43.7%,相对 Omni-Embed 外壳省 79.5%。后者省得更多,说明 Omni-Embed 演化出的外壳不仅成功率低,而且很费 token。按表 6 验算:Direct 每次执行约 0.921M token,Omni-Embed 外壳约 2.531M,Embed2Evolve 0.518M;1-0.518/0.921\approx43.7\%,1-0.518/2.531\approx79.5\%,Omni-Embed 外壳的消耗约为 Direct 的 2.75 倍。
原文
We make four contributions.
- Robota-Embed. A unified embedding model that jointly encodes vision, language, and native action at both endpoints for predictive physical-experience retrieval.
- Data and evaluation. A multi-source training corpus, Robota-Embed-Bench, and controlled studies of temporal precision, representation learning, and native action's contribution beyond vision and language.
- Embed2ICL. Training-free and training-based interfaces that turn retrieved demonstrations into useful policy context, evaluated in simulation and on real robots.
- Embed2Evolve. Embedding-guided memory and context evolution around a frozen policy, improving success and token efficiency under matched comparisons of retrieval embedding models.
译文
本文有四项贡献。
- Robota-Embed。一个统一的嵌入模型,在两端都联合编码视觉、语言和原生动作,用于预测式物理经验检索。
- 数据与评测。一个多来源训练语料库、Robota-Embed-Bench 基准,以及关于时间精度、表示学习和原生动作在视觉与语言之外的贡献的受控研究。
- Embed2ICL。免训练和需训练两种接口,把检索到的示范转化为对策略有用的上下文,并在仿真和真机上评测。
- Embed2Evolve。围绕冻结策略、由嵌入引导的记忆与上下文演化;在检索嵌入模型的匹配比较下,同时提高成功率和 token 效率。
解释
四项贡献对应论文的四个部分:第 3 节(模型)、第 3.3 节与第 4 节及附录 B(数据与评测)、第 5.1 节与附录 C(Embed2ICL)、第 5.2 节与附录 D(Embed2Evolve)。前两项是表示学习本身,后两项是下游验证。阅读时可以把后两项看作对“检索质量能否转化为控制收益”的检验:检索指标再高,如果换成策略的成功率没有变化,这个嵌入对机器人就没有实际意义。
2相关工作(Related Work)
原文
Multimodal and action-aware embeddings. CLIP aligns images with language (Radford et al., 2021); Perception Encoder and InternVideo2 extend vision–language representation learning to video (Bolya et al., 2026; Wang et al., 2024). Unified vision–language embeddings support image and video retrieval in one space (Meng et al., 2025; Xu et al., 2025; Zhou et al., 2026a; Shanbhogue et al., 2026; Li et al., 2026a); ImageBind (Girdhar et al., 2023) includes additional sensory modalities. Deep Multimodal Embedding (Sung et al., 2017) and CLASP (Rana et al., 2023) align language or perception with action. VLA-R (Seong et al., 2025) embeds visual–language queries and action-token candidates in a shared space, while RADAR (Gao et al., 2026) reuses VLA-policy features for retrieval. Robota-Embed jointly encodes vision, language, and native action at both retrieval endpoints: the current state and the recorded future clip.
译文
多模态嵌入与感知动作的嵌入。CLIP 把图像与语言对齐(Radford et al., 2021);Perception Encoder 和 InternVideo2 把视觉—语言表示学习扩展到视频(Bolya et al., 2026; Wang et al., 2024)。统一的视觉—语言嵌入在同一个空间中支持图像检索和视频检索(Meng et al., 2025; Xu et al., 2025; Zhou et al., 2026a; Shanbhogue et al., 2026; Li et al., 2026a);ImageBind(Girdhar et al., 2023)还纳入了更多感官模态。Deep Multimodal Embedding(Sung et al., 2017)和 CLASP(Rana et al., 2023)把语言或感知与动作对齐。VLA-R(Seong et al., 2025)把视觉—语言查询与动作 token 候选嵌入同一空间,而 RADAR(Gao et al., 2026)复用 VLA 策略的特征做检索。Robota-Embed 则在检索的两端(当前状态与记录下来的未来片段)都联合编码视觉、语言和原生动作。
解释
这一段按“是否含动作、动作在哪一端”梳理嵌入模型。第一类(CLIP、Perception Encoder、InternVideo2)是对比学习得到的图文/视频—文本双塔,第 4 节表 1 把它们归为“CLIP 风格”基线,表现很差(片段级 R@1 只有 1–2%),因为它们只做“文本找视频”,不支持把图像和文本合成一个查询。第二类是基于多模态大模型的统一嵌入(Meng et al. 对应 VLM2Vec-V2,Xu et al. 对应 Omni-Embed-Nemotron,Zhou et al. 2026a、Shanbhogue et al.、Li et al. 2026a 分别对应 WeMM-Embedding、Gemini Embedding 2 和 Qwen3-VL-Embedding),可以接收“图像+文本”的组合输入,是表 1 中最强的一组基线。第三类把动作纳入表示:VLA-R 只在候选端放动作 token,查询端仍是图文;RADAR 借用 VLA 策略的中间特征,动作信息是隐含的。本文的定位是“两端都显式编码原生动作”。
原文
Physical-experience retrieval. Action can enter the retrieval key or the content returned to the policy. ROSER (Rahman et al., 2026) searches proprioceptive sequences; RAEA (Zhu et al., 2024), REGENT (Sridhar et al., 2025a), and RICL (Sridhar et al., 2025b) return actions selected through action-free keys. Zeva (Chen et al., 2026a) indexes action–effect evidence, whereas RADAR (Gao et al., 2026) uses policy features. MemER (Sridhar et al., 2026) selects rollout keyframes; Retrieve-Reason-Act (Temiraliev et al., 2026) indexes visual manuals. Robota-Embed includes native action in both query and candidate keys, so motion informs the similarity comparison itself (Table 33).
译文
物理经验检索。动作可以作为检索键的一部分,也可以只是返回给策略的内容。ROSER(Rahman et al., 2026)在本体感知序列上做检索;RAEA(Zhu et al., 2024)、REGENT(Sridhar et al., 2025a)和 RICL(Sridhar et al., 2025b)用不含动作的键选出样本,再把其中的动作返回。Zeva(Chen et al., 2026a)索引“动作—效果”证据,而 RADAR(Gao et al., 2026)使用策略特征。MemER(Sridhar et al., 2026)挑选执行过程中的关键帧;Retrieve-Reason-Act(Temiraliev et al., 2026)索引视觉说明书。Robota-Embed 在查询键和候选键中都包含原生动作,因此运动信息直接参与相似度比较本身(表 33)。
解释
“检索键”与“返回内容”的区分是这一段的主线。以 REGENT、RICL 为例:它们用图像或图文特征找最近邻,找到后把近邻的动作塞进策略上下文;动作是被取回的东西,但“谁是近邻”与动作无关。ROSER 正相反,只用本体感知(关节状态序列)检索,没有语言和视觉。本文主张把三者都放进键里。附录 E 的表 33 把这些方法的查询端、候选端模态和动作的角色逐一列出,可以与这段对照阅读。
原文
Robot In-Context Learning and Evolution. GEN-1.5 (Team, 2026) conditions on a sensorimotor example; S1 (AI, 2026), Zero-WAM (Zhou et al., 2026b), and HOST (Chen et al., 2026b) use supplied video. R+X (Papagiannis et al., 2025) retrieves human-video clips and converts them into keypoint and hand-trajectory context. Embed2ICL uses Robota-Embed to select experience for training-free and training-based WAM conditioning.
译文
机器人上下文学习与演化。GEN-1.5(Team, 2026)以一条感知运动示例为条件;S1(AI, 2026)、Zero-WAM(Zhou et al., 2026b)和 HOST(Chen et al., 2026b)使用提供的视频。R+X(Papagiannis et al., 2025)检索人类视频片段,并把它们转换成关键点和手部轨迹形式的上下文。Embed2ICL 用 Robota-Embed 为免训练和需训练两种 WAM 条件化方式挑选经验。
解释
这几项工作都回答“策略如何使用示例”,示例通常由人手动指定。R+X 是少数自带检索环节的方法,但它检索的是人类视频、返回的是关键点轨迹。本文的分工是:示例由嵌入模型自动选,策略接口沿用 DreamZero 和 Fast-WAM 已有的结构,所以 Embed2ICL 的贡献主要在“选”而不在“用”。
原文
Reflexion (Shinn et al., 2023) stores verbal reflections in episodic memory, using feedback to improve later trials without updating model weights. In robotics, Zeva (Chen et al., 2026a) retrieves action–effect evidence across retries within an episode, resetting memory for each new episode. Embed2Evolve performs in-context evolution: it grows task-local memory across development episodes and refines retrieval, refresh, and history settings around a frozen policy. Evaluation uses the selected memory and context settings without further changes on fresh task initializations.
译文
Reflexion(Shinn et al., 2023)把语言形式的反思存进情景记忆,利用反馈改进后续尝试,而不更新模型权重。在机器人领域,Zeva(Chen et al., 2026a)在同一回合的多次重试之间检索“动作—效果”证据,每个新回合开始时记忆都会被重置。Embed2Evolve 执行的是上下文内演化(in-context evolution):它在多个开发回合之间积累任务内记忆,并围绕冻结的策略改进检索、刷新和历史设置。评测时使用选定的记忆和上下文设置,不再做任何改动,在全新的任务初始化上进行。
解释
这一段区分了三种“不改权重的自我改进”。Reflexion 存的是文字反思;Zeva 存的是回合内的试错证据,回合结束即清空;Embed2Evolve 存的是跨回合的执行片段,并且还会改“怎么用记忆”的配置。最后一句交代了评测的公平性:开发阶段结束后记忆和配置全部冻结,测试用的是开发时没见过的初始化(附录 D.5 称为 fresh test),避免在测试集上继续调参。
3Robota-Embed
3.1问题形式化(Problem Formulation)
原文
Physical AI experience combines language, vision, and source-native motion or control from human, simulated, or robotic interaction. Given a current VLA state, Robota-Embed retrieves the video and actions that followed an anchor in a recorded trajectory.
译文
物理 AI 经验(physical AI experience)由语言、视觉以及来源原生的运动或控制信号组成,这些数据来自人类、仿真或机器人的交互。给定一个当前的 VLA 状态,Robota-Embed 检索的是:在一条已记录的轨迹中,某个锚点之后发生的视频和动作。
解释
“来源原生的运动或控制”强调动作不做统一化:EgoDex 是人手和身体的跟踪姿态,DROID 是 Franka 机械臂的控制量,LIBERO 是仿真器里的末端增量,RoboMIND 是双臂机器人的关节量(附录表 7 列出了各自的维度和频率)。检索输出的不是“相似状态”本身,而是相似状态之后的那段视频和动作。
原文
For sample i from source d_i, the query combines instruction \ell_i, an interaction-region image z_{i,t}, and synchronized native action a_{i,t}. The paired target combines the same instruction with a four-second video clip V_i^+ and aligned actions A_i^+ recorded strictly after t:
x_i^q=(\ell_i,z_{i,t},a_{i,t},d_i),\qquad x_i^k=(\ell_i,V_i^+,A_i^+,d_i).(1)
译文
对来自数据源 d_i 的样本 i,查询由指令 \ell_i、交互区域图像 z_{i,t} 和同步的原生动作 a_{i,t} 组成。与之配对的目标由同一条指令、一段严格在时刻 t 之后记录的 4 秒视频片段 V_i^+ 以及与之对齐的动作 A_i^+ 组成:
x_i^q=(\ell_i,z_{i,t},a_{i,t},d_i),\qquad x_i^k=(\ell_i,V_i^+,A_i^+,d_i).(1)
解释
式 (1) 定义检索的两端。上标 q 表示查询(query),k 表示键(key,即候选)。逐个看符号:\ell_i 是自然语言指令,两端相同;z_{i,t} 是时刻 t 的一张交互区域图像,由 SAM3 检测出交互物体后放大裁剪得到(见图 3 和附录 A.3),不是整幅画面;a_{i,t} 是与 t 时刻同步的原生动作(附录 A.1 称为与当前时刻同步的动作,查询端没有未来动作);d_i 是数据源编号,用来选择对应的动作投影层;V_i^+ 和 A_i^+ 是 t 之后 4 秒内的视频和动作,上标 + 表示“正样本、未来”。“严格在 t 之后”保证查询里不泄露目标的内容。两端共享 \ell_i 意味着语言本身就是很强的匹配线索,这也是后文要专门做“候选端去掉文字”和“同指令候选库”对照实验(附录 B.3)的原因:需要证明模型不是只靠文字就能找到答案。
3.2动作原生的预测式 VLA 嵌入(Action-Native Predictive VLA Embeddings)
原文
We train Robota-Embed for current-to-future retrieval using Cosmos3-Edge 4B (Agarwal et al., 2026) as the base model (Figure 2). Query and target share the Transformer, video tokenizer, and head, with separate adapters A_q,A_k. Source-specific projectors P_{d_i} map native actions into the backbone. Each endpoint jointly encodes language, vision, and action into one normalized vector. For retrieval, we rank candidates by the cosine similarity between the current-state query q_i=f_\theta^q(x_i^q;P_{d_i}) and the future-clip target k_i=f_\theta^k(x_i^k;P_{d_i}).
译文
我们以 Cosmos3-Edge 4B(Agarwal et al., 2026)为基座模型(图 2),训练 Robota-Embed 完成“由当前到未来”的检索。查询端和目标端共享 Transformer、视频分词器和输出头,各自有独立的适配器 A_q、A_k。按来源区分的投影层 P_{d_i} 把原生动作映射进骨干网络。每一端都把语言、视觉和动作联合编码成一个归一化向量。检索时,我们按当前状态查询 q_i=f_\theta^q(x_i^q;P_{d_i}) 与未来片段目标 k_i=f_\theta^k(x_i^k;P_{d_i}) 之间的余弦相似度对候选排序。
解释
结构上这是一个“共享主干、两端各有适配器”的双塔模型。共享主干让两端处在同一个表示空间;独立适配器 A_q,A_k 承认两端的输入性质不同,一端是“单帧+短动作”,另一端是“4 秒视频+动作序列”。f_\theta^q 和 f_\theta^k 的参数 \theta 大部分共享,只有适配器部分不同。因为每端只输出一个单位向量,候选可以离线编码并建索引,查询时只需编码一次再做最近邻搜索,这让检索可以扩展到百万量级的库(附录 B.6)。代价是查询和候选之间没有细粒度的交叉注意力,所有匹配信息都必须压进一个向量里。Cosmos3-Edge 是 NVIDIA 的视频—语言基座模型,本身能读视频和文本,动作需要另外通过 P_{d_i} 接入。
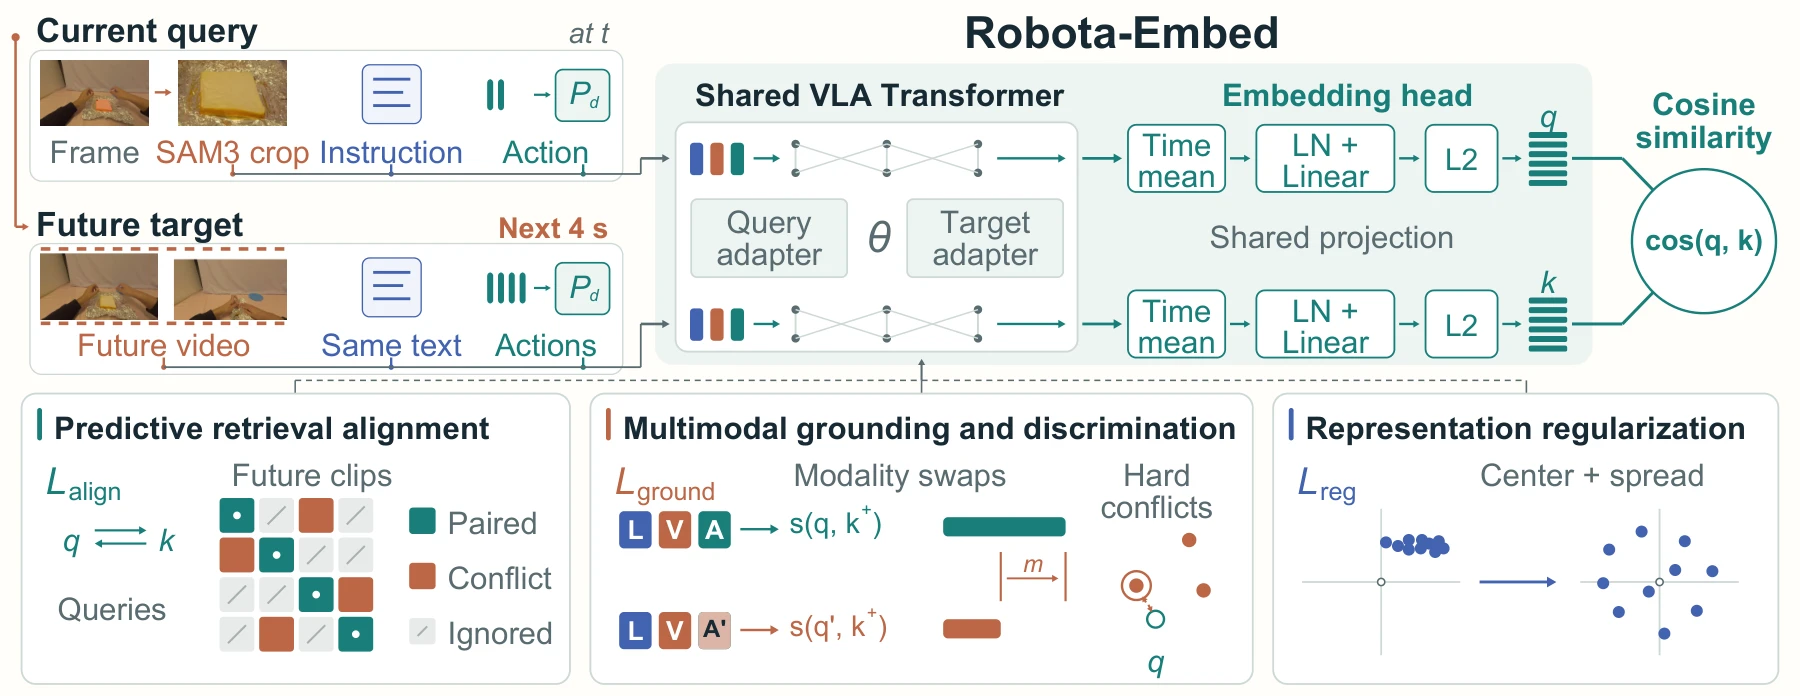
图 2:Robota-Embed 的结构与训练目标。每条查询都与其后 4 秒内记录的视频和动作配对。三组训练目标共同训练一个联合 VLA 空间。
原图注:Robota-Embed architecture and objectives. Each query is paired with the next four seconds of recorded video and actions. Three objective groups train a joint VLA space.
图 2 解读
上半部分是结构。左上的“当前查询”(Current query, at t)由三部分组成:原始帧经 SAM3 裁剪出的物体特写(SAM3 crop)、指令(Instruction)、经投影层 P_d 映射的动作(Action)。左下的“未来目标”(Future target, Next 4 s)是未来视频、同一条文本和未来动作序列。两路输入进入中间的“共享 VLA Transformer”,参数记为 \theta,查询和目标各走自己的适配器(Query adapter / Target adapter)。输出后经过“嵌入头”:对时间维取平均(Time mean)、层归一化加线性层(LN + Linear)、L2 归一化,得到向量 q 和 k;最右边用余弦相似度 \cos(q,k) 打分。“Shared projection”表示嵌入头在两端共享。下半部分是三组目标。左:预测检索对齐 \mathcal L_{\text{align}},画成一个查询 \times 未来片段的矩阵,对角线绿色为配对正样本(Paired),橙色为确认冲突的负样本(Conflict),灰色为被忽略的样本(Ignored)。这张掩码图说明并非所有非配对样本都当负样本。中:多模态落地与判别 \mathcal L_{\text{ground}},“模态交换”(Modality swaps)把查询中的某个模态换成别的样本的(图中把 A 换成 A'),要求真实组合的得分 s(q,k^+) 比交换后的 s(q',k^+) 高出至少边距 m;“硬冲突”(Hard conflicts)则把语义冲突的样本推离查询 q。右:表示正则化 \mathcal L_{\text{reg}},把挤在一起的嵌入(左边一团点)“居中并散开”(Center + spread),防止维度塌缩。
原文
Retrieval-oriented training. We train with predictive alignment, multimodal grounding, and representation regularization. Structured parsing and deterministic rules supply weak labels. The supervision distinguishes exact continuation identity from broader task compatibility; a different clip ID alone does not establish a valid negative. Native action is learned within the fused representation, with modality swaps encouraging sensitivity to motion without requiring action-only matching to an exact future clip.
译文
面向检索的训练。我们用预测对齐、多模态落地和表示正则化进行训练。弱标签由结构化解析和确定性规则提供。监督信号把“恰好是这段后续”与“更宽泛的任务兼容”区分开来:仅仅片段编号不同,并不足以构成一个有效的负样本。原生动作在融合表示内部学习,模态交换促使模型对运动敏感,但并不要求单靠动作就能匹配到确切的未来片段。
解释
这一段讲的是负样本怎么定。标准对比学习把同一批次里所有非配对样本都当负样本,但在机器人数据里,同一任务、同一阶段的另一条示范,其后续可能同样合理;把它当负样本会惩罚正确的相似性。所以作者用“结构化解析”从指令中抽取任务、物体、动作等字段,再用规则判断两个样本是否确实冲突(例如物体不同或动作类型不同),只有冲突的才当负样本,其余忽略。“不要求单靠动作匹配”是指:作者不训练一个“只看动作也能检索”的模型,动作只作为融合表示的一部分。这与表 20 的结果一致:只用动作查询时 R@1 只有 0.53%,动作单独几乎没有检索能力,但与语言、视觉结合时贡献很大。
原文
Predictive retrieval alignment (\mathcal{L}_{\mathrm{align}}) uses bidirectional InfoNCE with exact future-clip positives and task, object, action, or joint conflicts as negatives. Compatible, uncertain, or potentially duplicate non-positives are ignored. Figure 2 shows the validity mask. We optimize:
\mathcal{L}=\mathcal{L}_{\mathrm{align}}+\mathcal{L}_{\mathrm{ground}}+\mathcal{L}_{\mathrm{reg}}.(2)
Multimodal grounding and discrimination (\mathcal{L}_{\mathrm{ground}}) combines task/object auxiliaries with margins against modality swaps and hard semantic conflicts, so that similarity responds to changes in the inputs. Representation regularization (\mathcal{L}_{\mathrm{reg}}) centers query and target batches and discourages low-variance, low-rank embeddings. Section A.1–A.2 detail the architecture, native-action preprocessing, optimization schedule, and individual training losses. 译文
预测检索对齐(\mathcal{L}_{\mathrm{align}})采用双向 InfoNCE:正样本是确切的那段未来片段,负样本是在任务、物体、动作或其组合上存在冲突的样本。兼容的、不确定的或可能重复的非正样本一律忽略。图 2 展示了这种有效性掩码。我们优化的目标是:
\mathcal{L}=\mathcal{L}_{\mathrm{align}}+\mathcal{L}_{\mathrm{ground}}+\mathcal{L}_{\mathrm{reg}}.(2)
多模态落地与判别(\mathcal{L}_{\mathrm{ground}})结合了任务/物体辅助目标,以及针对模态交换和硬语义冲突的边距约束,使相似度会随输入的变化而变化。表示正则化(\mathcal{L}_{\mathrm{reg}})对查询批次和目标批次做中心化,并抑制低方差、低秩的嵌入。附录 A.1–A.2 详细介绍结构、原生动作预处理、优化日程和各项训练损失。 解释
InfoNCE 是对比学习的标准损失:对每条查询 q_i,把它与正样本 k_i 的相似度放在分子,与所有候选的相似度之和放在分母,取负对数。“双向”指同时做“查询找目标”和“目标找查询”两个方向。本文的改动是分母只包含被判为冲突的负样本,被忽略的样本不进分母(附录式 (5) 给出精确形式)。式 (2) 把总损失写成三项相加,但这只是分组记号,每组内部有多个子项,各有系数和边距(附录表 8)。\mathcal L_{\text{ground}} 中的“模态交换边距”可以这样理解:把查询的动作换成另一个样本的动作,相似度应该明显下降;如果不下降,说明模型忽略了动作。这一项直接对抗“模型偷懒只看文字”的倾向。\mathcal L_{\text{reg}} 中“低秩”指所有嵌入都落在少数几个方向上,这会让余弦相似度失去区分度;附录 A.2 用有效秩(participation ratio)来度量。
3.3训练数据与检索基准(Training Data and Retrieval Benchmark)
原文
Our training corpus contains 1,695,684 filtered current–future pairs from EgoDex (Hoque et al., 2026), DROID (Khazatsky et al., 2024), LIBERO (Liu et al., 2023), and RoboMIND–Franka-dual (Wu et al., 2024). EgoDex records tracked human motion; the other sources record robot controls. We sample sources equally and form within-source pairs (Figure 3; Section A.3).
译文
我们的训练语料包含 1,695,684 个经过过滤的“当前—未来”配对,来自 EgoDex(Hoque et al., 2026)、DROID(Khazatsky et al., 2024)、LIBERO(Liu et al., 2023)和 RoboMIND–Franka-dual(Wu et al., 2024)。EgoDex 记录的是被跟踪的人体运动,其余数据源记录的是机器人控制量。我们对各数据源等概率采样,并且只在同一数据源内部构造配对(图 3;附录 A.3)。
解释
四个来源的规模差别很大:附录表 9 显示 EgoDex 占 1,345,160 条(约 79%),DROID 只有 26,563 条(约 1.6%)。“等概率采样”意味着训练时每个来源被抽到的机会相同,小来源会被重复采样很多次,否则模型几乎只学人手数据。“只在来源内部配对”是因为不同来源的动作格式不同,跨来源的动作没有直接可比性;对比学习的负样本也因此主要来自同一来源。
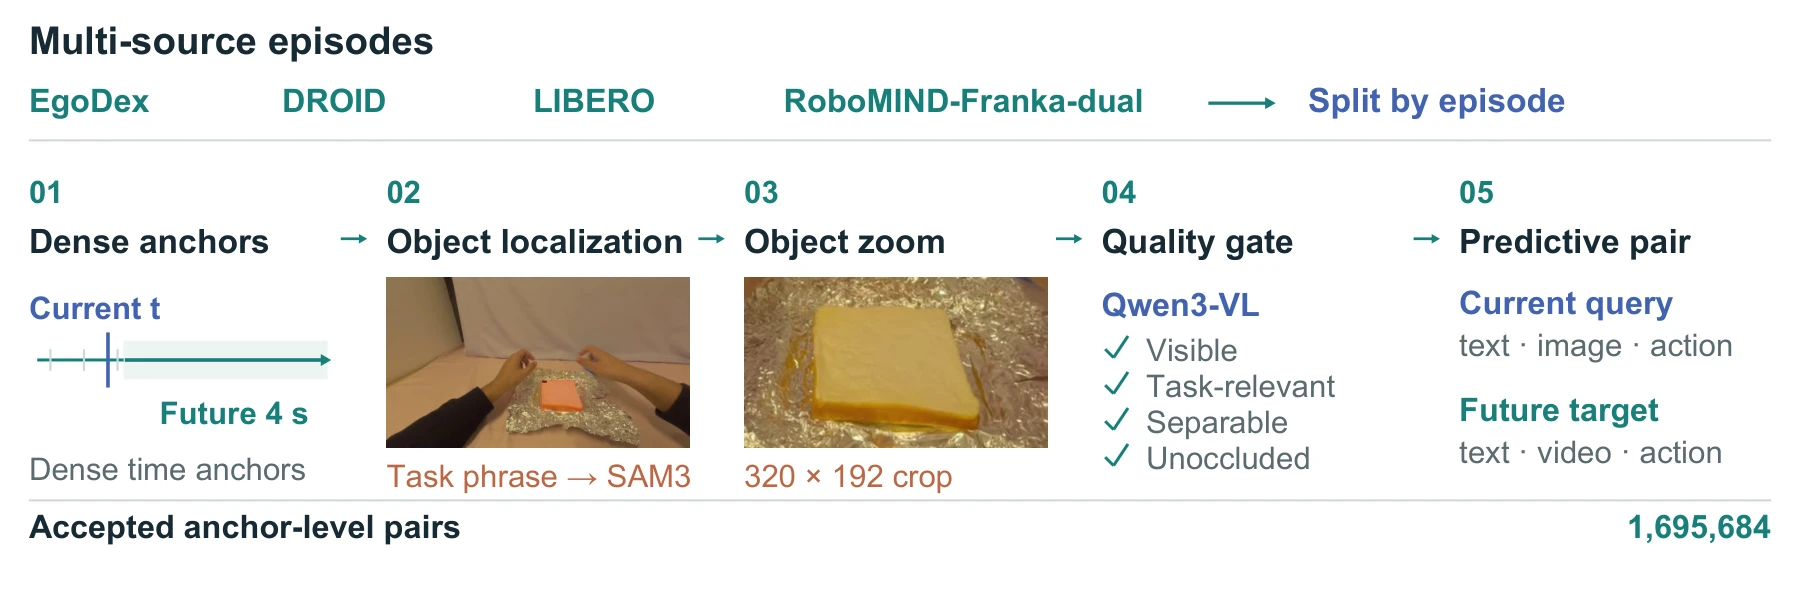
图 3:多来源训练数据整理流程。我们在采样锚点之前先按回合划分数据,定位并核验交互区域裁剪图,再把通过检查的锚点与其后 4 秒的视频和动作配对。查询端的过滤只使用指令和当前观测。
原图注:Multi-source training-data curation. We split episodes before sampling anchors, localize and verify interaction crops, and pair accepted anchors with video and actions from the next four seconds. Query filtering uses only the instruction and current observations.
图 3 解读
图从左到右是五个步骤,顶部一行表示四个来源的回合先“按回合划分”(Split by episode),保证同一回合不会同时出现在训练集和测试集。01 密集锚点:在时间轴上密集地取锚点 t,每个锚点向后看 4 秒(Future 4 s)。02 物体定位:用指令里的任务短语提示 SAM3,在画面中找到交互物体(示例是一只手和一块三明治)。03 物体放大:按检测框裁剪出 320\times192 的特写。04 质量闸门:用 Qwen3-VL 检查裁剪图是否满足四个条件,即物体可见(Visible)、与任务相关(Task-relevant)、能与其他实例区分(Separable)、没有被遮挡(Unoccluded)。05 预测配对:通过检查的锚点构成“当前查询”(文本、图像、动作)和“未来目标”(文本、视频、动作)。底部给出最终通过的锚点级配对数 1,695,684。图注最后一句是防止信息泄露的说明:判断一个锚点能否入选,只看指令和当前观测,不看未来片段,否则“能否入选”本身就会携带关于未来的信息。
原文
Robota-Embed-Bench. All 4,000 held-out queries search one shared 8,000-clip gallery from the four source datasets. Each source contributes 1,000 queries from 800 episodes, 1,000 paired future clips, and 1,000 nearby same-episode clips. Queries follow Equation 1. Clip-level retrieval treats only the paired clip as positive; episode-level retrieval accepts all clips from the same source episode. Downstream experiments test whether retrieved context helps control.
译文
Robota-Embed-Bench。全部 4,000 条留出查询都在同一个共享的 8,000 片段候选库中检索,候选来自四个源数据集。每个来源贡献来自 800 个回合的 1,000 条查询、1,000 个配对的未来片段,以及 1,000 个同回合的邻近片段。查询的形式遵循式 (1)。片段级检索只把配对片段视为正确;回合级检索接受来自同一源回合的所有片段。下游实验则检验检索到的上下文是否有助于控制。
解释
候选库的构成可以算清楚:4 个来源 \times(1,000 个配对片段 + 1,000 个邻近片段)= 8,000。每条查询在 8,000 个候选里只有 1 个片段级正确答案;回合级正确答案至少有 2 个(配对片段和它的同回合邻近片段),而 800 个回合出 1,000 条查询,说明约 200 个回合贡献了两条查询,这些回合在库里有更多同回合片段。随机猜测的片段级 R@1 约为 1/8000=0.0125\%。邻近片段是“干扰项”:它与正确答案来自同一回合、时间相近,画面和指令几乎相同,只能靠阶段信息区分。这正是图 4(b) 展示的失败类型。
原文
We split episodes, sessions, and content identities before sampling anchors; task, object, and embodiment categories may recur. Clip-level metrics weight sources equally. Episode-level metrics aggregate within episodes, then equally over each source's 800 episodes and the four sources. We use cosine similarity without reranking (Section B.1).
译文
我们在采样锚点之前就按回合、采集会话(session)和内容身份做划分;任务、物体和本体(embodiment)类别则可能在训练和测试之间重复出现。片段级指标对各来源等权平均。回合级指标先在回合内部汇总,再对每个来源的 800 个回合等权平均,最后对四个来源等权平均。我们直接使用余弦相似度,不做重排序(附录 B.1)。
解释
这段交代泛化的边界。测试回合本身没被训练见过,但“把杯子放进碗里”这类任务类别、同样的物体、同样的机器人在训练中都出现过,所以基准测的是同分布内对新回合的检索,不是对新任务或新机器人的泛化。回合级指标的三层平均值得注意:先把同一回合的多条查询合并为一个分数,再在回合间平均。这样贡献两条查询的回合不会被重复计权。“不做重排序”说明表 1 的数字是纯嵌入模型的能力;第 5.1 节 DreamZero 实验中额外引入的“重排序智能体”属于下游应用,不计入基准分数。
4嵌入评测(Embedding Evaluation)
表 1:Robota-Embed-Bench 上的检索结果。在共享的 8,000 片段候选库上,四个来源平均的召回率和 MRR(%)。粗体为每列最优。
| 片段级(Clip-level) | 回合级(Episode-level) | |||||||
| 模型 | R@1 | R@5 | R@10 | MRR | R@1 | R@5 | R@10 | MRR |
| CLIP 风格的文本—视频嵌入 | ||||||||
| CLIP ViT-L/14 | 1.2 | 5.8 | 9.8 | 4.06 | 3.2 | 7.7 | 11.6 | 5.98 |
| Perception Encoder B16 | 2.0 | 8.1 | 12.8 | 5.52 | 5.0 | 10.1 | 15.2 | 8.01 |
| InternVideo2 | 1.6 | 7.3 | 11.4 | 4.82 | 4.1 | 9.1 | 13.2 | 6.94 |
| 统一视觉—语言(VL)嵌入 | ||||||||
| Qwen3-VL-Embedding-2B | 23.3 | 51.6 | 57.3 | 36.20 | 45.1 | 55.9 | 61.0 | 50.71 |
| VLM2Vec-V2 | 24.1 | 51.9 | 57.6 | 36.67 | 47.3 | 58.1 | 63.3 | 52.88 |
| WeMM-Embedding-2B | 24.1 | 52.2 | 58.2 | 36.78 | 45.1 | 57.3 | 63.2 | 51.08 |
| Omni-Embed-Nemotron-3B | 24.5 | 54.5 | 60.1 | 38.10 | 48.6 | 59.1 | 64.4 | 53.84 |
| Gemini Embedding 2 | 25.2 | 52.3 | 57.5 | 37.68 | 48.3 | 58.2 | 64.7 | 53.69 |
| 统一视觉—语言—动作(VLA)嵌入 | ||||||||
| Robota-Embed(本文) | 47.3 | 91.9 | 97.0 | 67.05 | 81.8 | 94.9 | 98.1 | 86.96 |
原表注:Retrieval on Robota-Embed-Bench. Four-source average recall and MRR (%) on the shared 8,000-clip gallery. Bold marks column-wise best results.
表 1 解读
列:左半是片段级(只有配对的那段未来算对),右半是回合级(同一回合的任何片段都算对)。R@k 是正确答案出现在前 k 名的查询比例;MRR(mean reciprocal rank)是正确答案排名倒数的平均,例如排第 1 记 1、排第 2 记 0.5,它同时反映“排第一”和“排得靠前”的情况。行分三组:CLIP 风格模型只能用文本检索视频;统一 VL 嵌入能把图像和文本合成查询;最后一行是本文模型。关键数字。CLIP 风格模型全面失效,片段级 R@1 只有 1–2%。它们只用指令文本检索,而同一指令下有许多回合、每个回合又有多个时刻,文本根本无法区分。五个统一 VL 模型彼此非常接近:片段级 R@1 在 23.3–25.2 之间,回合级在 45.1–48.6 之间,说明不管用哪个大模型,“不含动作的图文嵌入”都卡在同一个水平。Robota-Embed 的片段级 R@1 是最强基线的约 1.9 倍(47.3 对 25.2)。最显著的差别在 R@5 和 R@10:本文为 91.9 和 97.0,基线只有 52–60。也就是说,本文模型几乎总能把正确片段排进前 10,难点只剩在相邻时刻之间分出第一名;基线则有约 40% 的查询连前 10 都进不了。注意口径。每列最优的基线并不相同:片段级最强的是 Gemini Embedding 2(R@1 25.2),回合级最强的是 Omni-Embed-Nemotron-3B(R@1 48.6)。摘要中的“比 Gemini Embedding 2 高 22.09 和 33.47 个百分点”两项都以 Gemini 为参照;正文下面的“22.09 和 33.18”则是对每列最强基线的差距。两种说法都没错,但摘要选择的回合级参照不是最强基线。另外,基线都不使用动作,而且各自按“所支持的接口”使用,例如 CLIP 类只用文本,所以这张表比较的是“完整系统”,不是在相同输入下比较表示能力;输入相同的受控比较在第 4.2 节和附录 B.4。
4.1Robota-Embed-Bench 上的统一 VLA 检索(Unified VLA Retrieval on Robota-Embed-Bench)
原文
Protocol and models. Eight action-free baselines search the shared gallery (Section 3.3). CLIP-style models retrieve video from text; unified VL models also use visual queries (Table 1). We use each model's supported interface. The retraining studies in Section B.4 use the same DROID data splits and training budgets for the compared model variants.
译文
协议与模型。八个不含动作的基线在共享候选库中检索(第 3.3 节)。CLIP 风格模型由文本检索视频;统一 VL 模型还使用视觉查询(表 1)。每个模型都按它所支持的接口使用。附录 B.4 中的重新训练实验,对所比较的模型变体使用相同的 DROID 数据划分和训练预算。
解释
“按所支持的接口使用”是公平性的关键限定:基线与本文模型的输入不同,表 1 的差距混合了“输入多了动作”和“针对该任务训练过”两个因素。要单独说明“动作有用”,必须看输入以外条件都相同的重新训练实验,所以作者在这里就提示读者去看附录 B.4。
原文
Main results. Robota-Embed achieves 47.33% clip-level and 81.77% episode-level R@1. The strongest baselines, Gemini Embedding 2 and Omni-Embed-Nemotron-3B, reach 25.24% and 48.59%, respectively. Robota-Embed improves on them by 22.09 and 33.18 percentage points.
译文
主要结果。Robota-Embed 取得 47.33% 的片段级 R@1 和 81.77% 的回合级 R@1。最强的基线 Gemini Embedding 2 和 Omni-Embed-Nemotron-3B 分别达到 25.24% 和 48.59%。Robota-Embed 比它们分别高出 22.09 和 33.18 个百分点。
解释
验算:47.33-25.24=22.09,81.77-48.59=33.18,无误。这里的“分别”指片段级最强为 Gemini、回合级最强为 Omni-Embed,与摘要“对 Gemini 高 33.47 点”的回合级口径不同(Gemini 的回合级 R@1 为 48.30)。
原文
Gains over unified VL baselines are largest on LIBERO and RoboMIND-FD (Section B.2). Episode retrieval does not resolve temporal localization: on EgoDex, episode/clip R@1 is 87.06/36.70%, versus 99.88/74.10% on DROID. Finding a relevant experience is easier than locating its paired continuation, the target of predictive retrieval.
译文
相对统一 VL 基线的提升在 LIBERO 和 RoboMIND-FD 上最大(附录 B.2)。回合级检索并不能解决时间定位问题:在 EgoDex 上,回合级/片段级 R@1 为 87.06%/36.70%,而在 DROID 上为 99.88%/74.10%。找到一段相关的经验,比定位到它配对的那段后续要容易;而后者才是预测式检索的目标。
解释
这里的数字来自附录表 10。EgoDex 的回合级与片段级差了 50 个点:模型几乎总能找到正确的人类视频回合,但在回合内部选错时刻的情况超过一半。EgoDex 是人手的长时连续操作,相邻 4 秒窗口的画面和动作都很相似,所以阶段定位最难。DROID 在两个层级上都最高,与附录表 13 一致:DROID 中每条指令平均只对应 2.71 个候选,指令本身已经几乎唯一地确定了回合。
原文
Benchmark validity. Masking candidate text before fusion and recomputing embeddings lowers clip-level R@1 from 47.33% to 12.78%, confirming that the model uses language. Restricting candidates to the same instruction still gives 47.62% R@1, so the model also distinguishes continuations that share an instruction. Within same-instruction galleries, Robota-Embed achieves 38.60% and 40.10% R@1 on LIBERO and RoboMIND-FD, compared with random-ranking rates of 1.90% and 0.24%, respectively. High-k recall approaches saturation in the smaller EgoDex and DROID pools.
译文
基准有效性。在融合之前把候选端的文本遮掉、重新计算嵌入,片段级 R@1 从 47.33% 降到 12.78%,证实模型确实用到了语言。把候选限制为同一指令时,R@1 仍为 47.62%,说明模型也能区分共享同一条指令的不同后续。在同指令候选库内,Robota-Embed 在 LIBERO 和 RoboMIND-FD 上分别取得 38.60% 和 40.10% 的 R@1,而随机排序的对应比率仅为 1.90% 和 0.24%。在规模较小的 EgoDex 和 DROID 候选池中,大 k 的召回率接近饱和。
解释
这两项对照分别回应两种质疑。质疑一:模型是否只是做文本匹配?由于两端共享指令,如果模型只靠文本,遮掉候选端文本后应当降到接近随机。实际降到 12.78%,远高于随机(约 0.01%),说明视频和动作本身也携带了大量匹配信息;同时下降了 34.6 个点,说明语言很重要。质疑二:模型是否只是在区分指令?同指令候选库是原候选库的子集:对每条查询,只保留与它指令相同的候选。删掉候选只会让正确答案的排名不变或上升,所以 47.62% \ge 47.33% 是必然的,这一数字本身并不能证明什么。真正有信息量的是两点。其一,两者只差 0.29 个点,说明在原候选库中排在正确答案之前的候选,几乎全部与查询指令相同,模型犯的错基本都是“同指令、不同阶段”的错。其二,与随机排序比较:LIBERO 和 RoboMIND-FD 每条指令对应的候选多(附录表 13,均值 54.5 和 473.6),随机 R@1 很低,模型高出 37–40 个点,证明它确实在区分阶段。EgoDex 和 DROID 每条指令只有约 4 个和 2.7 个候选,随机 R@1 就有 29.76% 和 54.64%,模型(37.60%、74.20%)高出得不多,这种小池子里的对照说服力有限,作者用“接近饱和”一笔带过。
原文
Tables 12 and 13 give the full aggregate results, per-source candidate counts, and random baselines.
译文
表 12 和表 13 给出完整的汇总结果、各来源的候选数量和随机基线。
解释
这两张表在附录 B.3。
原文
Index-size scaling. Expanding the precomputed gallery from 1M to 15M entries increases query encoding plus retrieval latency from 160.36 to 195.17 ms on one NVIDIA A100 (Table 22). At 15M, Top-10 search alone takes 37.47 ms. These timings exclude time spent on SAM3 preprocessing, reference reranking, and downstream policy execution (Section B.6).
译文
索引规模扩展。把预先计算好的候选库从 100 万条扩大到 1,500 万条,在一张 NVIDIA A100 上,“查询编码 + 检索”的延迟从 160.36 ms 增加到 195.17 ms(表 22)。在 1,500 万条时,仅 Top-10 搜索就需要 37.47 ms。这些计时不包括 SAM3 预处理、参考重排序和下游策略执行所花的时间(附录 B.6)。
解释
从表 22 可以拆出两部分:查询编码约 157.7 ms(160.36-2.66),基本不随库大小变化;搜索时间随库大小线性增长,约每百万条 2.5 ms(37.47/15)。所以延迟的大头是 4B 模型编码一次查询,而不是向量搜索。这对控制回路的含义是:每次检索约 0.16–0.2 秒,适合每隔若干步检索一次(Embed2Evolve 就是这样做的),不适合每个控制步都检索。
4.2预测式检索为什么有效?(What Makes Predictive Retrieval Work?)
原文
The controlled studies separate representation adaptation from input use. On the shared four-source benchmark, a frozen Cosmos3-Edge readout reaches only 0.65% clip-level R@1, whereas retrieval training reaches 47.33% (Table 15). On the matched DROID split, a learned head over frozen features reaches 13.8%, compared with 78.7% when the backbone and head are adapted (Table 16). Predictive alignment already places the paired continuation near the top at 75.6% R@1 and 100.0% R@10; representation regularization raises R@1 to 77.0%, and multimodal grounding and discrimination further raise it to 78.7% (Table 17). The added objectives therefore refine top-rank ordering rather than merely broad recall.
译文
这些受控研究把“表示的适配”和“输入的使用”分开考察。在共享的四来源基准上,冻结的 Cosmos3-Edge 直接读出只能达到 0.65% 的片段级 R@1,而检索训练后达到 47.33%(表 15)。在匹配的 DROID 划分上,在冻结特征之上学习一个检索头只能达到 13.8%,而同时适配骨干和检索头时为 78.7%(表 16)。仅用预测对齐就已经把配对的后续排到很靠前,R@1 为 75.6%、R@10 为 100.0%;加入表示正则化后 R@1 升到 77.0%,再加入多模态落地与判别后升到 78.7%(表 17)。因此,新增的目标改进的是排在最前面的顺序,而不只是宽泛的召回。
解释
三组实验回答三个问题。基座模型本身能不能检索?不能:0.65% 说明 Cosmos3-Edge 的原始特征对这个任务几乎没用,能力来自检索训练。只训练一个头够不够?不够:13.8% 对 78.7%,必须让骨干网络也适应。值得注意的是,附录 A.1 给骨干设的学习率只有 3\times10^{-7},非常小,但即便是这样小幅度的更新也带来了巨大差别。三组目标各贡献多少?主要靠 \mathcal L_{\text{align}}(75.6%),另外两组合计只加 3.1 个点。作者的解读是:对齐目标已经让 R@10 达到 100%,后两组目标只是在前 10 名内部把正确答案往第 1 名推。这些 DROID 实验的绝对数值(约 78%)高于四来源基准,因为 DROID 是最容易的来源(表 10 中片段级 74.1%),而且是单来源的受控划分,与四来源基准不可直接比较。
原文
Action is the most consequential non-language input in both controlled views. Retraining without action lowers R@1 by 18.9 percentage points, versus 1.9 points without vision (Table 19); with the final model and gallery fixed, masking query action or vision lowers clip R@1 by 27.25 or 24.33 points (Table 20). These interventions answer different questions: retraining measures what the remaining modalities can relearn, whereas masking measures reliance under an input shift. Thus the small no-vision retraining gap does not imply that the final model ignores vision. SAM3 interaction crops provide a further, modest localization gain over full frames, 78.7% versus 77.9% R@1 (Table 18). Appendix B reports each intervention as a separate table and conclusion.
译文
在两种受控视角下,动作都是除语言之外影响最大的输入。去掉动作重新训练,R@1 下降 18.9 个百分点,而去掉视觉只下降 1.9 个点(表 19);固定最终模型和候选库,在查询端遮掉动作或视觉,片段级 R@1 分别下降 27.25 或 24.33 个点(表 20)。这两种干预回答的是不同的问题:重新训练衡量剩下的模态能重新学到多少,而遮挡衡量模型在输入变化下对某个模态的依赖程度。因此,“去掉视觉重新训练只差一点”并不意味着最终模型忽略了视觉。SAM3 交互区域裁剪相对整帧画面带来进一步的、幅度不大的定位增益,R@1 为 78.7% 对 77.9%(表 18)。附录 B 把每种干预单独成表并给出结论。
解释
“除语言之外”这个限定很重要:两种视角下去掉语言的损失都最大(表 19 中 -58.5,表 20 中 -40.20),语言仍是最强的单一线索。两种视角的差异值得细看。重新训练时,去掉视觉几乎无损(-1.9),说明在 DROID 上“语言 + 动作”已经足以完成检索,视觉提供的信息大部分是冗余的;但遮挡时去掉视觉损失很大(-24.33),说明训练好的完整模型确实依赖视觉,突然拿掉会出问题。作者据此提醒:前者测“能否不用”,后者测“是否在用”。还有一点:表 19 是 DROID 单来源,表 20 是四来源平均,两者的数据范围也不同,不宜直接比较大小。SAM3 裁剪只比整帧高 0.8 个点(表 18),属于小幅收益,而且来自 DROID 单一划分,没有给出方差,这个差异是否稳定无法判断。
4.3基准检索示例(Benchmark Retrieval Examples)
原文
Figure 4 contrasts a paired-clip hit with a temporal near-miss. The latter retrieves a nearby window from the correct episode rather than the paired continuation, illustrating why episode matching and clip localization require separate metrics.
译文
图 4 对比了一次命中配对片段的检索和一次“时间上的险中”(temporal near-miss)。后者检索到的是正确回合中一个邻近的时间窗口,而不是配对的那段后续,这说明了为什么回合匹配和片段定位需要用不同的指标衡量。
解释
near-miss 直译是“险些命中”,这里指回合对了、时刻错了。
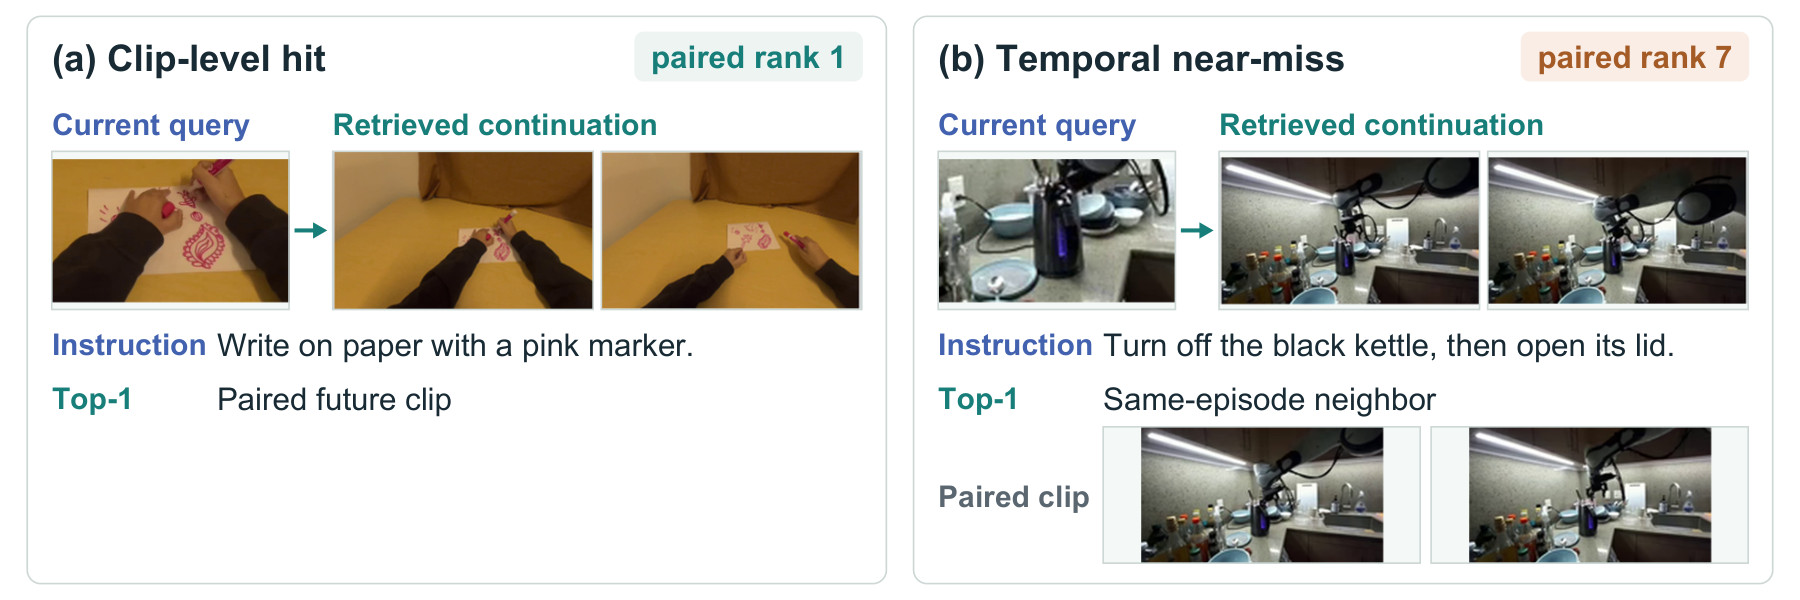
图 4:检索诊断示例。(a) 配对的未来片段排在第一。(b) 同一回合中的一个邻近片段排在第一,而配对片段排在第七。两个 top-1 结果都是回合级命中,只有 (a) 同时是片段级命中。
原图注:Selected retrieval diagnostics. (a) The paired future clip ranks first. (b) A nearby clip from the same episode ranks first, while the paired clip ranks seventh. Both top-1 returns are episode-level matches; only (a) is also a clip-level match.
图 4 解读
(a) 片段级命中(右上角标“paired rank 1”):EgoDex 的人类第一视角数据,指令为“用粉色马克笔在纸上写字”。左边是当前查询(手正拿着笔靠近纸面),右边是检索到的后续(两帧,手在纸上书写)。Top-1 正是配对的未来片段。(b) 时间险中(“paired rank 7”):机器人数据,指令为“关掉黑色水壶,然后打开它的盖子”。这是一条两步指令,同一回合里有“关开关”和“开盖”两个阶段。Top-1 是“同回合邻居”(Same-episode neighbor),下方给出真正的配对片段供对照。两组画面几乎一样,差别只在机械臂处于两步中的哪一步,模型选错了阶段,正确答案排到第 7。这张图把表 1 的抽象数字落到具体情形:(b) 这种错误在回合级指标下算对,在片段级下算错,正是两种 R@1 相差 30 多个点的来源。对下游使用而言,(b) 的错误可能有实际后果:如果策略拿到的参考是“开盖”阶段,而它此刻应该去“关开关”,参考就会把策略引向错误的下一步。
5从嵌入到机器人上下文(From Embeddings to Robot Context)
5.1Embed2ICL:由嵌入引导的机器人上下文学习(Embedding-Guided Robot In-Context Learning)
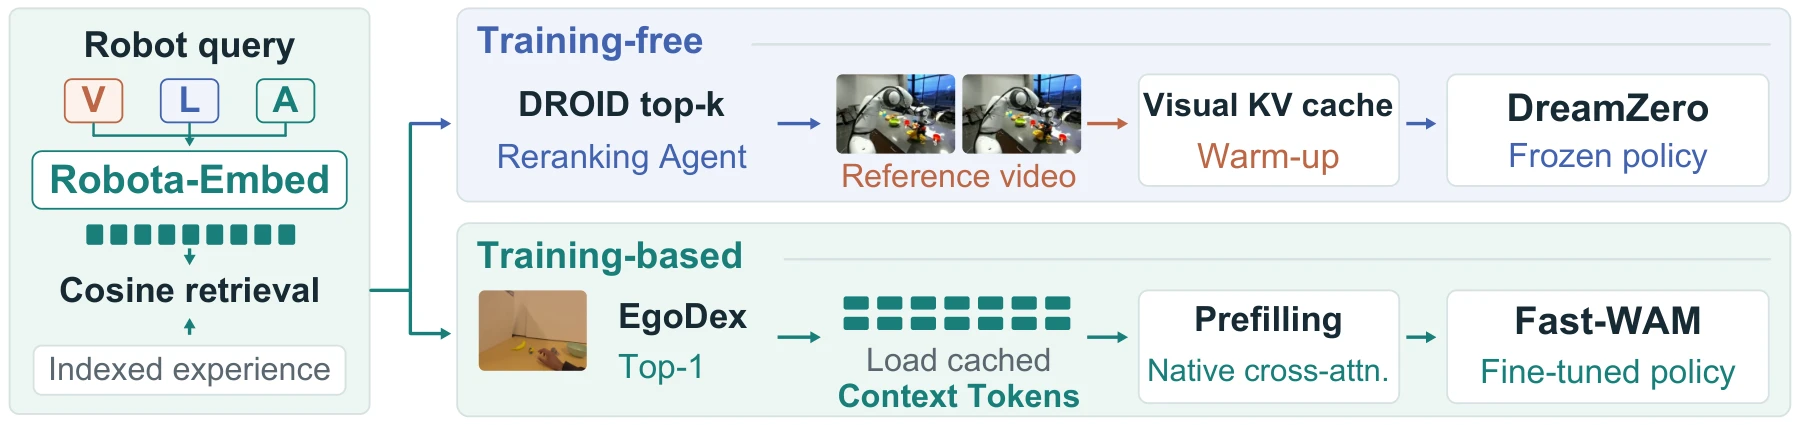
图 5:Embed2ICL:一个检索器,两种策略接口。经过重排序的 DROID 视频用于预热 DreamZero 的视觉缓存;top-1 的 EgoDex 匹配结果为 Fast-WAM 原生的交叉注意力提供 Context Tokens。检索向量负责挑选经验,视频或 token 负责为策略提供条件。
原图注:Embed2ICL: one retriever, two policy interfaces. Reranked DROID videos warm up DreamZero's visual cache; top-1 EgoDex matches supply Context Tokens for Fast-WAM's native cross-attention. Retrieval vectors select experience; videos or tokens condition the policy.
图 5 解读
左栏是共用的检索部分:机器人的查询由视觉(V)、语言(L)、动作(A)组成,经 Robota-Embed 编码成一个向量,与“已索引的经验”(Indexed experience)做余弦检索。右上(免训练):在 DROID 库中取 top-k 候选,交给“重排序智能体”(Reranking Agent,一个大语言模型)选出一段参考视频,用它对 DreamZero 的视觉 KV 缓存做预热(Warm-up),DreamZero 本身是冻结策略(Frozen policy)。右下(需训练):在 EgoDex 人类视频库中取 top-1,读取预先缓存好的 Context Tokens,通过 Fast-WAM 原生的交叉注意力做“预填充”(Prefilling,见附录 C.4),Fast-WAM 是微调过的策略(Fine-tuned policy)。两条路线的差别有三点:参考来源不同(机器人数据 DROID 对人类数据 EgoDex);是否经过重排序(是对否);交给策略的形式不同(原始视频对嵌入模型内部的 token)。图注最后一句概括了分工:检索向量只负责“选哪段”,真正进入策略的是视频或 Context Tokens。值得注意的是,Fast-WAM 路线用 EgoDex 的人类视频作为 LIBERO 仿真和真机任务的参考,跨越了本体差异。
原文
Training-free ICL with DreamZero. Embed2ICL initializes the visual cache of frozen DreamZero-DROID (Ye et al., 2026) with a retrieved video. Table 2 compares top-1 and reranked retrieval on three DROID-Sim tasks. Both retrievers use the same GPT-5.6 sol Reranking Agent to select task-relevant four-second references with completion evidence. All six conditions use 100 trials per task, including the random-reference control. Embed2ICL uses one fixed reference video per task across all evaluation trials (Section C.1).
译文
基于 DreamZero 的免训练 ICL。Embed2ICL 用一段检索到的视频初始化冻结的 DreamZero-DROID(Ye et al., 2026)的视觉缓存。表 2 在三个 DROID-Sim 任务上比较 top-1 检索和重排序后的检索。两个检索器使用同一个 GPT-5.6 sol 重排序智能体,挑选与任务相关、且包含“任务完成”证据的 4 秒参考片段。全部六种条件(包括随机参考对照)每个任务各做 100 次试验。Embed2ICL 对每个任务在所有评测试验中都使用同一段固定的参考视频(附录 C.1)。
解释
DreamZero-DROID 是在 DROID 数据上训练的自回归世界动作模型,DROID-Sim 是 DROID 场景的仿真版本。“初始化视觉缓存”可以理解为:正式执行前,先把参考视频的帧当作“已经看过的历史”送进模型,模型生成后续画面和动作时会受这段历史影响。两个实验设计细节决定了结论的范围。第一,“每个任务一段固定参考”:参考不是每次试验根据当前状态重新检索,而是每个任务挑一次,所以这里实际检验的是“能否挑到一段好示范”,而不是“随执行阶段动态检索”。第二,重排序智能体(一个大语言模型)参与了挑选,它会看候选内容并选出“有完成证据”的片段。因此表 2 中“Embed2ICL”一行是“Robota-Embed 检索 + LLM 重排”的组合效果;单看 Robota-Embed 的贡献,要比较两行 top-1,或者比较两行“+ 重排序”。
表 2:免训练的 DreamZero-DROID 在 DROID-Sim 中的结果。成功率(%);括号内是相对“无预热”的百分点变化。两种重排序条件使用同一个智能体。
| 参考条件 | Cube \rightarrow Bowl | Can \rightarrow Mug | Banana \rightarrow Bin | 平均 |
| 无预热(No warm-up) | 61 | 13 | 67 | 47.0 |
| 随机参考(Random reference) | 50 (-11) | 7 (-6) | 51 (-16) | 36.0 (-11.0) |
| Omni-Embed-Nemotron-3B | ||||
| Top-1 | 57 (-4) | 5 (-8) | 68 (+1) | 43.3 (-3.7) |
| + 重排序 | 62 (+1) | 19 (+6) | 72 (+5) | 51.0 (+4.0) |
| Robota-Embed Top-1 | 63 (+2) | 16 (+3) | 72 (+5) | 50.3 (+3.3) |
| Embed2ICL | 65 (+4) | 24 (+11) | 80 (+13) | 56.3 (+9.3) |
原表注:Training-free DreamZero-DROID in DROID-Sim. Success rates (%); parentheses show percentage-point changes from no warm-up. Reranked conditions share the same agent.
表 2 解读
列是三个 DROID-Sim 抓放任务(方块放进碗、易拉罐放进马克杯、香蕉放进垃圾桶)及其平均,每格是 100 次试验的成功率。行从上到下:不预热(DreamZero 原样运行);随机参考;用 Omni-Embed-Nemotron-3B 检索的 top-1 及其重排序版本;用 Robota-Embed 检索的 top-1;Robota-Embed 加重排序,即本文的 Embed2ICL。平均值可以逐行验算:(61+13+67)/3=47.0,(65+24+80)/3=56.3,其余各行也一致。三个读法:(1) 随机参考在三个任务上都低于不预热,平均掉 11 个点,说明一段不相关的视频会误导策略,“有参考”本身并不是好事;(2) 在同等条件下 Robota-Embed 都优于 Omni-Embed:只用 top-1 时为 50.3 对 43.3,加重排序后为 56.3 对 51.0;Omni-Embed 的 top-1 甚至比不预热还差;(3) 重排序对两者都有帮助,分别加 6.0 和 7.7 个点,幅度与换嵌入模型的效果相当。统计上要谨慎:每格 100 次试验,成功率在 50% 附近时标准误约 5 个点,所以单个任务上 \pm4 以内的差异(如 Cube\toBowl 的 61、62、63、65)不足以区分。平均值基于 300 次试验,标准误约 2.9 个点,Embed2ICL 对不预热的 9.3 个点差距比较可靠,而 Robota-Embed top-1 对 Omni-Embed + 重排序(50.3 对 51.0)则可以视为持平。Can\toMug 是最难的任务,基线只有 13%,这里的相对提升最大(13\to24)。
原文
Embed2ICL performs best on all three tasks, averaging 56.3% success versus 47.0% without warm-up and 36.0% with random references. Reranking improves both retrievers. Robota-Embed exceeds Omni-Embed-Nemotron-3B before reranking (50.3% versus 43.3%) and with the same reranker (56.3% versus 51.0%; Section C.2). Random references underperform no warm-up: adding a demonstration is not sufficient. Selected references preserve placement relations despite changes in objects or receptacles, suggesting that useful context need not reproduce the target scene exactly.
译文
Embed2ICL 在全部三个任务上表现最好,平均成功率 56.3%,而不预热为 47.0%,随机参考为 36.0%。重排序对两个检索器都有提升。无论是重排序之前(50.3% 对 43.3%),还是使用同一个重排序器之后(56.3% 对 51.0%;附录 C.2),Robota-Embed 都优于 Omni-Embed-Nemotron-3B。随机参考的表现低于不预热:仅仅加入一段示范是不够的。被选中的参考即便物体或容器有所变化,也保留了“放置”这一关系,这表明有用的上下文不必精确重现目标场景。
解释
最后一句对应附录图 10:为三个任务选中的 DROID 参考分别是“积木放进碗”“瓶盖放进容器”“香蕉放进碗”,物体或容器与目标任务不同,但“拿起一个东西放进一个容器”的动作结构相同。这说明 DreamZero 从参考中借用的主要是运动模式和阶段结构,而不是具体外观。这也从侧面解释了为什么动作模态对检索有用:两段视频外观不同、动作结构相同时,仍然是好参考。
原文
On YAM, Embed2ICL raises Banana-to-Bowl mean task progress from 21.67 to 40.00 (Table 5). Both conditions use the same DreamZero-AgiBot policy adapted to YAM, with no further policy updates for reference warm-up (Section C.3).
译文
在 YAM 机器人上,Embed2ICL 把 Banana-to-Bowl 的平均任务进度从 21.67 提高到 40.00(表 5)。两种条件使用同一个已适配到 YAM 的 DreamZero-AgiBot 策略,为参考预热不再做任何策略更新(附录 C.3)。
解释
YAM 是另一种机械臂平台(原文没有详细介绍)。这里用的策略是 DreamZero-AgiBot(在 AgiBot 数据上训练)适配到 YAM 后的版本,参考仍来自 DROID,即参考的机器人(Franka)与执行的机器人(YAM)不同。21.67 和 40.00 都是 12 次执行的平均进度分(0–100),不是成功率,换算成总分为 260 和 480。按附录 C.3 的计分(5 个阶段各 20 分),12 次执行合计完成的阶段数从 13 个增加到 24 个;成功率从 0% 升到 16.7%(12 次中成功 2 次)。
原文
Training-based ICL with Fast-WAM. For Fast-WAM (Yuan et al., 2026), Robota-Embed retrieves the top-ranked EgoDex demonstration. Cached Context Tokens from its multimodal temporal states condition the policy (Figure 5). We train the policy to use this context while keeping the offline embedding encoder fixed (Section C.4).
译文
基于 Fast-WAM 的需训练 ICL。对 Fast-WAM(Yuan et al., 2026),Robota-Embed 检索排名第一的 EgoDex 示范。由该示范的多模态时间状态得到、并预先缓存的 Context Tokens 为策略提供条件(图 5)。我们训练策略去利用这一上下文,同时保持离线嵌入编码器固定(附录 C.4)。
解释
Context Tokens 不是检索向量本身,而是嵌入模型内部、在时间池化之前的逐时刻隐状态,经共享投影和逐 token 归一化得到(附录式 (3) 后的说明)。一段参考对应一串 token,保留了时间结构,所以比单个检索向量信息更丰富。“嵌入编码器固定”说明 Fast-WAM 微调时不回传梯度到 Robota-Embed,Context Tokens 可以全部离线算好。
原文
LIBERO difficult subset. Before ICL evaluation, an independent pilot selected five tasks on which the official release succeeded in at most 46 of 50 trials. In 50 trials per task and condition, Embed2ICL improves every task and raises average success from 86.4% to 92.8% (Table 3).
译文
LIBERO 困难子集。在 ICL 评测之前,一次独立的预实验选出了五个任务,官方发布版本在这些任务上 50 次中至多成功 46 次。在每个任务、每种条件各 50 次试验中,Embed2ICL 在每个任务上都有提升,并把平均成功率从 86.4% 提高到 92.8%(表 3)。
解释
“独立预实验”是为了回应选择偏差:如果先跑完 ICL 再挑“提升最大的任务”,结论会被高估;先用官方模型挑出“本来就不太好”的任务,再评测 ICL,至少挑选标准与 ICL 结果无关。但仍有一个隐患:挑选依据是预实验中的低分,而正式评测时官方模型重新跑一遍,可能因为均值回归而自然回升。表 3 中官方版本的成绩(40–46)是正式评测的数字,与预实验的选择标准“至多 46”相符。
表 3:LIBERO 困难子集上的需训练 ICL。每个任务 50 次中的成功次数;最后一行为平均成功率(%)。括号内为相对官方发布版本的百分点增益。
| 套件 / 编号 | 任务(简写) | 官方发布版本 | Embed2ICL |
| Spatial / S4 | Black bowl \rightarrow plate | 46 | 49 (+6) |
| Goal / G3 | Bowl \rightarrow top drawer | 42 | 50 (+16) |
| Goal / G9 | Wine bottle \rightarrow rack | 45 | 47 (+4) |
| LIBERO-10 / L4 | Two mugs \rightarrow plates | 43 | 44 (+2) |
| LIBERO-10 / L6 | Mug–pudding arrangement | 40 | 42 (+4) |
| 五任务平均(%) | 86.4 | 92.8 (+6.4) | |
原表注:Training-based ICL on the LIBERO difficult subset. Successes out of 50 per task; last row: average success (%). Parentheses give percentage-point gains over the official release.
表 3 解读
列:LIBERO 套件名与任务编号、任务简写、官方发布的 Fast-WAM 检查点的成功次数、Embed2ICL 的成功次数(括号内是换算成百分点的增益,每多成功 1 次为 2 个点)。五个任务分别来自 LIBERO-Spatial、LIBERO-Goal 和 LIBERO-10(长时程任务)。验算:官方 46+42+45+43+40=216,216/250=86.4\%;Embed2ICL 49+50+47+44+42=232,232/250=92.8\%;括号中的增益 +6,+16,+4,+2,+4 都等于成功次数差乘以 2。增益主要来自 G3(“把碗放进最上层抽屉”,42\to50,满分),它贡献了总增量 16 次中的 8 次;其余四个任务各只多 1–3 次。单个任务在 50 次试验下,2–3 次的差异在统计上很难与噪声区分,“每个任务都有提升”成立,但其中三项的幅度很小。附录图 12 专门分析了 G3。
表 4:LIBERO 对照实验。五任务平均成功率(%);每个任务、每种条件 50 次试验。
| 官方发布版本(无 ICL) | 随机 Context Tokens | Embed2ICL(检索得到) |
| 86.4 | 88.0 | 92.8 |
原表注:LIBERO controls. Five-task average success (%); 50 trials per task and condition.
表 4 解读
三列使用的策略权重不同:第一列是官方检查点,不读上下文;后两列是同一个经过 ICL 训练的检查点,区别只在输入的 Context Tokens 来自检索到的参考,还是来自随机参考。因此“92.8 对 88.0”这 4.8 个点才是检索质量本身的贡献;“88.0 对 86.4”这 1.6 个点混合了额外训练和“有上下文”两个因素。正文紧接着补充了另一个对照:不加 ICL、但同样多训练 21,700 步的检查点仍为 86.4%,说明增益不是来自多训练。
原文
With the same policy checkpoint, retrieved Context Tokens outperform tokens from random references by 4.8 percentage points (Table 4). After the same 21,700 training updates as Embed2ICL, the no-ICL continuation still achieves 86.4% (Section C.5), versus 92.8% with retrieved context. Figure 12 illustrates a retrieved human reference and robot execution.
译文
在同一个策略检查点下,检索得到的 Context Tokens 比来自随机参考的 token 高出 4.8 个百分点(表 4)。不加 ICL、但与 Embed2ICL 同样继续训练 21,700 次更新的版本仍然只有 86.4%(附录 C.5),而使用检索上下文时为 92.8%。图 12 展示了一段检索到的人类参考和机器人的执行情况。
解释
这里有三个检查点:官方版本(86.4)、无 ICL 继续训练 21,700 步(也是 86.4)、ICL 训练 21,700 步(检索参考 92.8,随机参考 88.0)。两个 86.4 恰好相同:附录 C.5 说明继续训练的版本是单独评测的,结果恰好也是 216/250。综合起来,最干净的归因是:额外训练本身贡献约 0,学会读上下文并给随机参考贡献约 1.6,换成检索参考再贡献约 4.8。
原文
Both interfaces improve task progress on real robots (Table 5). With partial-credit scoring inspired by T-Rex (Niu et al., 2026), Fast-WAM gains more on Split Cup than on Pick Fruit. Split Cup requires one hand to stabilize a stack while the other separates a cup; Pick Fruit scores each arm's grasp and placement into the center basket.
译文
两种接口都在真机上提高了任务进度(表 5)。采用受 T-Rex(Niu et al., 2026)启发的部分计分方式,Fast-WAM 在 Split Cup 上的增益大于 Pick Fruit。Split Cup 要求一只手稳住一摞杯子,另一只手把一个杯子分出来;Pick Fruit 则对每只手臂的抓取以及放入中央篮子的动作分别计分。
解释
部分计分(partial credit)把任务拆成若干阶段,完成一个阶段得一部分分数,所以“进度”可以在 0 到 100 之间连续取值。作者对两个任务增益差异的解释是:Split Cup 需要双臂协同,一只手固定、一只手操作,参考示范中的人手协同方式对它帮助更大;Pick Fruit 两只手各自独立完成抓放,原策略已经做得不错(75 分),提升空间小。
表 5:Embed2ICL 在真机上的结果。按各任务自定义的 0–100 分制计算的平均任务进度,每个任务、每种条件 12 次执行。括号内的增益在四舍五入之前计算。
| 任务 | 无 ICL | Embed2ICL |
| 免训练:DreamZero | ||
| Banana \rightarrow Bowl | 21.67 | 40.00 (+18.33) |
| 需训练:Fast-WAM | ||
| Pick Fruit | 75.00 | 79.17 (+4.17) |
| Split Cup | 66.67 | 87.50 (+20.83) |
原表注:Embed2ICL on real robots. Mean task progress on task-specific 0–100 scales over 12 rollouts per task and condition. Parentheses show gains computed before rounding.
表 5 解读
每格是 12 次真机执行的平均进度分。所有数值都是 1/12 的整倍数乘以 100 再按任务分值换算,例如 21.67\approx260/12,40.00=480/12,79.17\approx950/12,87.50=1050/12,说明单次得分是较粗的离散档位。三个读法:(1) DreamZero 的免训练路线在 YAM 上把进度几乎翻倍(21.67\to40.00),但起点很低,40 分仍意味着多数执行没有完成任务;(2) Fast-WAM 在 Split Cup 上提升 20.83 分,在 Pick Fruit 上只提升 4.17 分,相当于 12 次执行中总分多 50 分,可能只是一两次执行多完成了一个阶段;(3) 表中没有随机参考对照,也没有给出方差或成功率,所以真机结果只能说明“方向一致”,不足以单独支撑定量结论。作者在下面一段也承认这些进度分不能跨任务比较。
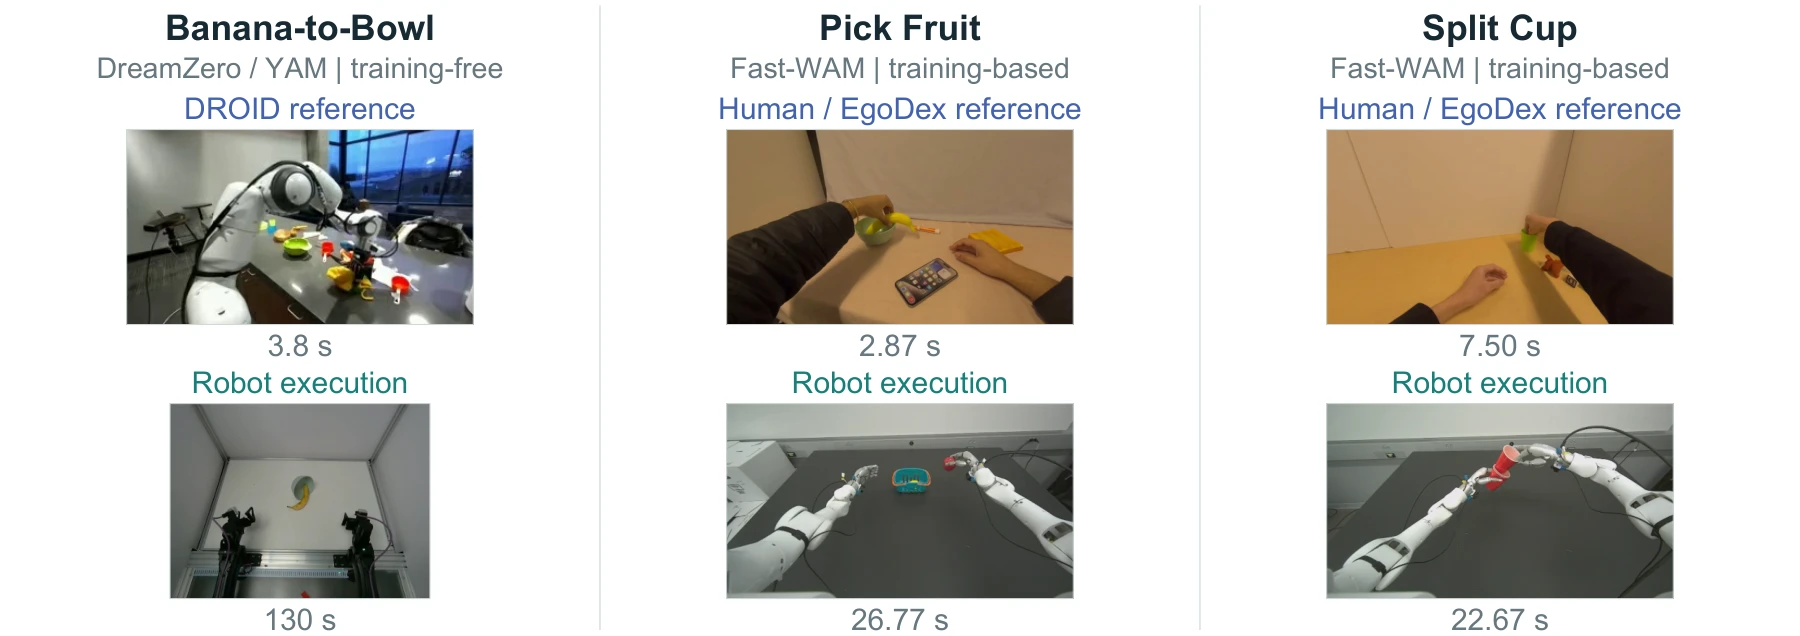
图 6:检索到的参考与真机执行。每个任务把一段检索到的参考(上)与真机执行(下)配对展示。DreamZero/YAM 的参考来自 DROID,Fast-WAM 的参考来自 EgoDex。时间戳是相对各片段起点的时间。
原图注:Retrieved references and real-robot execution. Each task pairs a retrieved reference (top) with real-robot execution (bottom). References come from DROID for DreamZero/YAM and EgoDex for Fast-WAM. Timestamps are relative to each clip's start.
图 6 解读
三列对应表 5 的三个真机任务。Banana-to-Bowl(DreamZero / YAM / 免训练):上方是 DROID 中检索到的参考(3.8 s 时刻,一台 Franka 臂在桌面上操作杂物),下方是 YAM 执行到 130 s 时的俯视画面,香蕉已在碗旁。Pick Fruit 和 Split Cup(Fast-WAM / 需训练):上方是 EgoDex 中检索到的人类第一视角参考(2.87 s 和 7.50 s),下方是双臂机器人的执行(26.77 s 和 22.67 s)。这张图主要说明参考与执行之间的差距:参考的本体(Franka 臂、人手)与执行的机器人不同,场景布置也不同。这与正文“有用的上下文不必重现目标场景”的观点一致。130 s 与 3.8 s 的对比也显示,参考只是 4 秒片段,而真机执行要长得多,参考提供的是任务开头或某一阶段的提示,而不是完整的逐步指导。
原文
These progress gains complement binary LIBERO success rates but are not directly comparable across tasks: each real-robot score reflects task-specific completion stages. The references span robot and human experience, while each policy retains its own conditioning interface. Retrieval quality and the form of policy context therefore need to be evaluated together.
译文
这些进度提升与 LIBERO 的二元成功率相互补充,但不能在任务之间直接比较:每个真机分数反映的是该任务特有的完成阶段。参考同时涵盖机器人经验和人类经验,而每个策略都保留了自己的条件化接口。因此,检索质量和策略上下文的形式需要放在一起评估。
解释
最后一句是整个 Embed2ICL 小节的结论,也是一种谨慎的限定:同一个检索器在两种接口下都有效,但效果大小取决于策略如何使用参考,所以不能只凭检索指标推断下游收益,反过来也不能把下游收益全部归功于检索。
5.2Embed2Evolve:由嵌入引导的上下文演化(Embedding-Guided Context Evolution)
原文
Embed2Evolve builds task-local memory and refines how it is used through repeated attempts. This memory and context recipe form a harness; GPT-6 Astra and Robota-Embed remain fixed (Figure 7).
译文
Embed2Evolve 通过反复尝试建立任务内记忆,并改进记忆的使用方式。这份记忆加上上下文配方(context recipe)构成一个外壳(harness);GPT-6 Astra 和 Robota-Embed 都保持固定(图 7)。
解释
“外壳”借用了智能体工程中的说法,指包在模型外面、决定“喂什么、什么时候喂”的那层程序。这里外壳 = 记忆库 M + 配方 \theta(检索方式、条数、刷新间隔、保留多少历史等),图 7 中记为 M^*+\theta^*。所有学习都发生在外壳上。
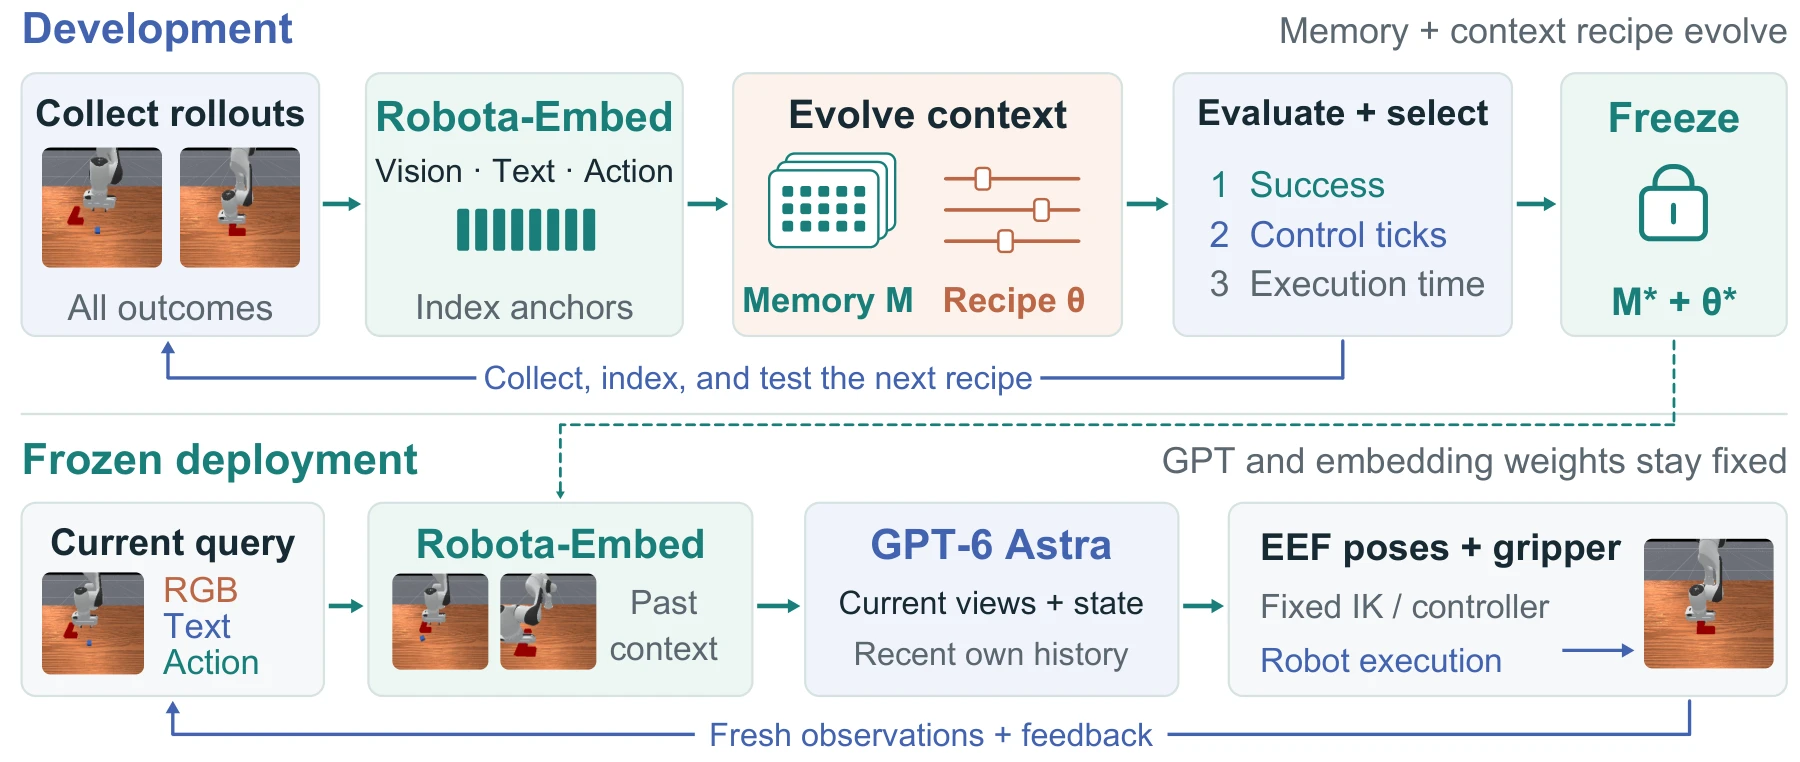
图 7:Embed2Evolve。开发阶段扩充记忆并优化其用法;测试阶段两者都固定。GPT-6 Astra 为一个固定的控制器提出动作。嵌入模型对比实验在两个阶段都替换掉 Robota-Embed。图中画面为 PullCubeTool 任务。
原图注:Embed2Evolve. Development grows memory and optimizes its use; testing fixes both. GPT-6 Astra proposes actions for a fixed controller. The model comparison replaces Robota-Embed in both phases. Images show the PullCubeTool task.
图 7 解读
上半“开发”(Development)是一个循环,右上角注明“记忆与上下文配方在演化”。从左到右:收集执行(Collect rollouts,成功和失败的结果都要,All outcomes);用 Robota-Embed 以视觉、文本、动作为键为锚点建索引(Index anchors);演化上下文(Evolve context),即同时调整记忆 M 和配方 \theta(图中用滑块表示超参数);评估并选择(Evaluate + select),按优先级依次比较 1 成功率、2 控制步数(control ticks)、3 执行时间;最后冻结(Freeze)得到 M^*+\theta^*。底部的回环箭头写着“收集、索引并测试下一个配方”。下半“冻结部署”(Frozen deployment),注明“GPT 与嵌入模型权重保持固定”:当前查询(RGB、文本、动作)\to Robota-Embed 检索过去的上下文(Past context)\to GPT-6 Astra 读取当前视角与状态(Current views + state)以及自己最近的历史(Recent own history)\to 输出末端执行器位姿和夹爪指令(EEF poses + gripper),交给固定的逆运动学/控制器(Fixed IK / controller)在机器人上执行;新的观测和反馈再回到查询。要点是 GPT-6 Astra 不直接输出关节力矩,而是输出末端位姿这种较高层的指令,由固定控制器执行;检索内容只是放进它的提示词里。所以 Embed2Evolve 的全部作用都通过“改变 GPT-6 Astra 看到的上下文”来实现。
原文
Memory and context search. Completed attempts, successful or failed, add indexed continuations of up to four seconds. Deterministic search varies retrieval ranking and count, refresh cadence, and retained history, prioritizing success before successful-execution efficiency. The selected memory and recipe are frozen for fresh-test initializations (Figure 13; Section D.2). Along PullCubeTool's R4\rightarrowR5\rightarrowR8 path, memory grows from 938 to 1,667 anchors while retained history shrinks from eight to four pairs. The current VLA query retrieves historical RGB, actions, and feedback to guide GPT-6 Astra within an unchanged action interface (Section D.1).
译文
记忆与上下文搜索。每一次完成的尝试,无论成功还是失败,都会加入若干段已建索引的、最长 4 秒的后续片段。确定性的搜索过程会改变检索的排序方式和条数、刷新频率以及保留的历史长度,优先考虑成功率,其次才是成功执行的效率。选定的记忆和配方被冻结,用于全新的测试初始化(图 13;附录 D.2)。在 PullCubeTool 的 R4\rightarrowR5\rightarrowR8 路径上,记忆从 938 个锚点增长到 1,667 个,而保留的历史从 8 对缩减到 4 对。当前的 VLA 查询检索历史上的 RGB 图像、动作和反馈,在不改变动作接口的前提下引导 GPT-6 Astra(附录 D.1)。
解释
为什么失败的尝试也要存?失败片段带有“这样做会失败”的反馈,检索到它们可以帮助策略避开同样的错误;另外,失败往往发生在特定阶段,存下来可以覆盖更多状态。“确定性搜索”指搜索规则是固定的,不是让大模型自由改代码(附录 D.2 有具体的提议与停止规则),这样两个嵌入模型可以在相同的搜索协议下比较。R4、R5、R8 是开发轮次编号,“路径”指被选中外壳的父子关系:R8 是在 R5 的基础上改出来的,R5 又来自 R4。这条路径上记忆变大、保留的历史变短,反映的趋势是:有了更多可检索的相关经验,就不需要把很长的自身历史塞进提示词,这也是 token 节省的来源(后文“大部分节省来自输入”)。“一对”历史指一次观测与一次决策。
原文
Evaluation. Five development-selected ManiSkill tasks (Tao et al., 2025) use 20 fresh matched initializations per condition. GPT-6 Astra Direct (Direct) uses within-episode history; GPT-6 Astra + random history adds a fixed random same-task RGB clip. These conditions use the same policy, current observations, controller, and per-rollout control budgets.
译文
评测。五个经开发阶段选出的 ManiSkill 任务(Tao et al., 2025),每种条件使用 20 个全新的、相互匹配的初始化。GPT-6 Astra Direct(Direct)使用回合内的历史;GPT-6 Astra + random history 额外加入一段固定的、随机选取的同任务 RGB 片段。这些条件使用相同的策略、当前观测、控制器和每次执行的控制预算。
解释
“匹配的初始化”指各条件使用同一组 20 个随机种子,同一个种子下物体的初始摆放相同,所以可以做逐对比较(后文“19 个共同成功的配对”就是基于这种匹配)。两处需要留意。第一,任务是“经开发阶段选出”的,具体规则见附录 D,读者无法确定是否存在偏向 Embed2Evolve 的任务选择。第二,随机历史对照只加RGB 片段,而 Embed2Evolve 检索的内容包括 RGB、动作和反馈,两者在内容形式上并不对等。所以“随机历史 20% 低于 Direct 24%”说明随便加一段画面没有帮助,但不能完全排除“只要加入动作和反馈文本就有帮助”的可能;更严格的对照是用同样格式的随机检索结果。
原文
Embedding-model comparison. We replace only Robota-Embed with Omni-Embed-Nemotron-3B (Xu et al., 2025) and independently repeat evolution. Both conditions share the policy, prompt, initial memory, seeds, proposal and stopping rules, and eight-round cap per task. Both retrieve actions and feedback, but their resulting memory banks and context recipes may differ.
译文
嵌入模型对比。我们只把 Robota-Embed 换成 Omni-Embed-Nemotron-3B(Xu et al., 2025),并独立地重复整个演化过程。两种条件共享策略、提示词、初始记忆、随机种子、提议与停止规则,以及每个任务最多 8 轮的上限。两者都会检索动作和反馈,但它们最终得到的记忆库和上下文配方可能不同。
解释
这个对照的设计是“换检索模型,重跑整个流程”,而不是“固定外壳只换检索模型”。好处是给 Omni-Embed 同样的机会找到适合它的配置;代价是两边最终的外壳不同(附录表 29 列出两边各完成了几轮、最终选中了第几轮:Omni-Embed 在 Pull Cube with Tool 上只完成 3 轮、在 Stack Cube 上完成 6 轮就按停止规则结束,Robota-Embed 在多数任务上跑满 8 轮),差异中既有“检索得准不准”的成分,也有“演化过程走向哪里”的成分。注意 Omni-Embed 的索引键不含动作,但检索出来的内容同样包括动作和反馈,所以两者的差别在“用什么找”,不在“找回什么”。每任务最多 8 轮意味着两边的开发预算相同。
表 6:Embed2Evolve 在 ManiSkill 仿真中的结果。成功率(%),每个任务、每种条件 20 次试验;以及每次测试执行的平均策略 token 数(含失败的执行)。
| 任务 | GPT-6 Astra Direct | GPT-6 Astra + 随机历史 | Evolve + Omni-Embed- Nemotron-3B | Embed2Evolve |
| Poke Cube | 45 | 15 | 45 | 80 |
| Stack Cube | 10 | 20 | 20 | 60 |
| Lift Peg Upright | 30 | 40 | 55 | 65 |
| Pull Cube with Tool | 10 | 10 | 20 | 50 |
| Two-Robot Stack Cube | 25 | 15 | 25 | 85 |
| 平均(%) | 24.0 | 20.0 | 33.0 | 68.0 |
| token/次执行(M) | 0.921 | – | \approx2.531 | 0.518 |
原表注:Embed2Evolve in ManiSkill simulation. Success (%) over 20 trials per task and condition; mean policy tokens per test rollout, including failures.
表 6 解读
行是五个 ManiSkill 任务:用工具推方块(Poke Cube)、叠方块(Stack Cube)、把木桩立起来(Lift Peg Upright)、用工具把方块拉过来(Pull Cube with Tool)、两台机器人协作叠方块(Two-Robot Stack Cube)。列是四种条件。每格是 20 次试验的成功率,所以只能取 5 的倍数。平均值验算:(45+10+30+10+25)/5=24,(15+20+40+10+15)/5=20,(45+20+55+20+25)/5=33,(80+60+65+50+85)/5=68,都正确。token 一行:Embed2Evolve 相对 Direct 节省 1-0.518/0.921=43.8\%(正文按未舍入的值算得 43.7%),相对 Omni-Embed 外壳节省 1-0.518/2.531=79.5\%。随机历史一列没有给 token 数。读法:Embed2Evolve 在每个任务上都最高,最大的差距在 Two-Robot Stack Cube(85 对 25)和 Stack Cube(60 对 20)。Omni-Embed 外壳在 Lift Peg Upright 上达到 55,接近 Embed2Evolve 的 65,其余任务则接近 Direct。每格 20 次试验,成功率 50% 时标准误约 11 个点,所以 Lift Peg Upright 上 55 对 65 的差距在噪声范围内;五任务平均基于 100 次试验,68 对 33 的差距(标准误约 6.6 个点)是可靠的。Omni-Embed 的 token 写作“\approx2.531”,说明这个数是估计值;附录 D.6 提到它没有输入/输出 token 的拆分。
原文
The Omni-Embed-Nemotron-3B harness raises success from Direct's 24% to 33%, while mean policy tokens rise from 0.921M to approximately 2.531M per test rollout (Table 6). Embed2Evolve reaches 68% at 0.518M tokens, improving success on every task while using approximately 79.5% fewer tokens than this independently evolved baseline. Under matched evolution settings, the embedding model affects the resulting harness's success and token use.
译文
Omni-Embed-Nemotron-3B 外壳把成功率从 Direct 的 24% 提高到 33%,同时每次测试执行的平均策略 token 从 0.921M 增加到约 2.531M(表 6)。Embed2Evolve 以 0.518M token 达到 68%,在每个任务上都提高了成功率,并且比这个独立演化出的基线少用约 79.5% 的 token。在匹配的演化设置下,嵌入模型会影响最终外壳的成功率和 token 消耗。
解释
Omni-Embed 外壳为什么更费 token?原文没有给出解释。一种可能是:检索质量差时,搜索过程倾向于选择“多塞上下文”的配方(更多检索条数、更长历史)来弥补,结果 token 增加而成功率提升有限;但附录只给出了 Robota-Embed 外壳的具体配置(表 28),没有列出 Omni-Embed 外壳的配置,这一推测无法从文中核实。作者的结论措辞是“嵌入模型会影响”,没有声称完全是检索精度的作用,这与上面“两边外壳不同”的设计局限相符。
原文
Tool use and dual-arm coordination. Within the same action interface, retrieved continuations may narrow GPT-6 Astra's effective decision space through task- and stage-specific examples of tool contact, motion direction, and arm coordination. Against Omni-Embed-Nemotron-3B, success rises from 20% to 50% on Pull Cube with Tool and from 25% to 85% on Two-Robot Stack Cube.
译文
工具使用与双臂协调。在相同的动作接口下,检索到的后续片段可能通过与任务和阶段相关的示例(工具接触、运动方向、手臂协调)缩小 GPT-6 Astra 实际面对的决策空间。与 Omni-Embed-Nemotron-3B 相比,Pull Cube with Tool 的成功率从 20% 升到 50%,Two-Robot Stack Cube 从 25% 升到 85%。
解释
“缩小决策空间”是一种解释性假说(原文用了“may”):GPT-6 Astra 每一步要从连续的末端位姿中选一个,检索到同一阶段的成功示例,相当于给出“此刻大致往哪动”的先验。工具使用和双臂协调都依赖精确的运动方向和时序,恰恰是只看图文难以区分、需要动作信息的情形,这与第 1 节“动作指明正在进行的运动”的论点呼应。不过这只是两个任务上的相关性,没有专门的机制实验。
原文
Test-time efficiency. Compared with Direct, Embed2Evolve uses 43.7% fewer tokens across all test rollouts and reduces reference API cost by 41.8%, from $9.9641 to $5.7980 (Section D.6). Most savings come from inputs. On 19 shared-success pairs, policy decisions fall by 64.1% and observed client execution time by 41.4%. Both reductions average task-wise percentages equally across the five tasks; the mean task-wise Direct-to-Embed2Evolve time ratio is 1.90\times. Execution time includes API waits and is affected by actual caller and scheduling differences (Section D.5); the time savings are observational, not an isolated method speedup. Fewer policy calls need not reduce physical control ticks (Table 31).
译文
测试时效率。与 Direct 相比,Embed2Evolve 在全部测试执行上少用 43.7% 的 token,参考 API 费用降低 41.8%,从 9.9641 美元降到 5.7980 美元(附录 D.6)。大部分节省来自输入。在 19 个双方都成功的配对上,策略决策次数减少 64.1%,观测到的客户端执行时间减少 41.4%。这两项降幅都是先按任务计算百分比、再对五个任务等权平均得到的;按任务计算的 Direct 与 Embed2Evolve 用时之比,其平均值为 1.90\times。执行时间包括等待 API 的时间,并受实际调用方和调度差异影响(附录 D.5);时间上的节省是观测结果,不代表方法本身的独立加速。策略调用次数减少,并不一定意味着物理控制步数减少(表 31)。
解释
费用验算:1-5.7980/9.9641=41.8\%,正确。费用按每百万输入 token 10 美元、输出 token 50 美元计算(附录 D.6),用表 32 的五任务平均也能复核:Direct 为 (10\times902{,}121.60+50\times18{,}858.16)/10^6=9.964。“大部分节省来自输入”:输入 token 从 902K 降到 503K,减少约 399K;输出 token 只从 18.9K 降到 15.4K。两种口径要分清:token 和费用按全部 100 次测试执行平均;决策次数和时间只在 19 个“同一初始化下 Direct 和 Embed2Evolve 都成功”的配对上比较。Direct 只成功 24 次,所以共同成功的配对最多 24 个,实际 19 个,样本量不大。“时间比 1.90\times”与“时间减少 41.4%”看起来不一致:若用时减少 41.4%,比值应为 1/(1-0.414)\approx1.71。原因是两者都是按任务先算再平均,“百分比的平均”与“比值的平均”不能相互换算(比值的平均会被个别任务的大比值拉高)。作者特意说明时间节省是“观测性的”:API 排队等因素会影响墙钟时间,不能把它当作方法带来的加速。最后一句提醒:决策次数少了,可能是每次决策让控制器执行更长的动作,物理上走的控制步数不一定减少,表 31 分开报告了这两个量。
6讨论(Discussion)
原文
Retrieval quality has two levels. Episode recall measures experience identification; clip recall measures continuation localization. Their gap shows that matching a task and embodiment need not identify the execution phase. Same-instruction evaluation and candidate-text masking probe temporal discrimination and target-language use beyond episode identification.
译文
检索质量有两个层次。回合召回衡量的是“认出是哪段经验”,片段召回衡量的是“定位到哪段后续”。两者之间的差距表明,匹配上任务和本体,并不意味着识别出了执行阶段。同指令评测和候选文本遮挡,则在回合识别之外考察时间上的判别能力和对目标端语言的使用。
解释
这是对第 4 节的总结。从表 10 看,四个来源上回合级与片段级 R@1 的差距从 25.8(DROID)到 50.4(EgoDex)个点不等,平均 34.4 个点,这就是“认出经验”与“定位阶段”之间的距离。对下游应用而言,哪一层更重要取决于用法:Embed2ICL 的 DreamZero 路线每个任务只用一段固定参考,回合级匹配可能就够了;Embed2Evolve 每隔几步重新检索,就需要片段级的阶段定位。
原文
The modalities play complementary roles. Language specifies the task, action supplies motion and phase, and vision localizes the interaction. Action adds information beyond vision and language. However, retraining permits adaptation to remaining inputs, whereas masking perturbs learned fusion. The no-vision retraining/masking gap supports a joint VLA key, not a universal modality ranking. Accordingly, masking characterizes the trained model's use of each input, not the attainable performance of separately trained unimodal systems.
译文
各模态扮演互补的角色。语言指明任务,动作提供运动和阶段信息,视觉定位交互。动作提供了视觉和语言之外的信息。不过,重新训练允许模型适应剩下的输入,而遮挡扰动的是已学到的融合方式。“去掉视觉”在重新训练与遮挡两种做法下结果差异很大,这支持的是“使用联合 VLA 键”,而不是一个普适的模态重要性排序。相应地,遮挡刻画的是训练好的模型如何使用每种输入,而不是单独训练的单模态系统所能达到的性能。
解释
作者在这里收敛了自己的结论。前文“动作比视觉更重要”的说法,严格来说只在特定口径下成立:重新训练时去掉视觉只损失 1.9 点,遮挡时却损失 24.33 点。如果只看前者,会得出“视觉没用”的结论;只看后者,又会觉得视觉和动作差不多重要。作者的立场是不去排“哪个模态最重要”,只主张三者联合构成检索键。这一立场比摘要中“去掉动作比去掉视觉损害更大”的表述更为谨慎。还要注意,表 19(重新训练)是 DROID 单来源,而表 20(遮挡)是四来源平均。DROID 中指令几乎唯一确定回合(表 13 中每条指令平均只有 2.71 个候选),视觉在这里本就冗余,所以重新训练时去掉视觉影响很小,这可能部分是 DROID 的特殊性,不一定能推广到其他来源。
原文
Retrieved context is useful only through a compatible interface. Random references hurt DreamZero relative to no warm-up (36.0% versus 47.0%), whereas Robota-Embed's raw retrieval and reranked Embed2ICL reach 50.3% and 56.3%. Fast-WAM gains from retrieved rather than random Context Tokens under fixed policy weights (92.8% versus 88.0%). More context is not inherently better: reference selection, temporal content, and conditioning jointly matter, without isolating each component's causal contribution.
译文
检索到的上下文只有通过相容的接口才有用。随机参考使 DreamZero 的表现低于不预热(36.0% 对 47.0%),而 Robota-Embed 的原始检索和经重排序的 Embed2ICL 分别达到 50.3% 和 56.3%。在固定策略权重的情况下,Fast-WAM 从检索得到的(而非随机的)Context Tokens 中获益(92.8% 对 88.0%)。上下文并非越多越好:参考的选择、时间上的内容以及条件化方式共同起作用,而本文并未分离出每个组成部分各自的因果贡献。
解释
最后半句是作者主动承认的局限:例如 DreamZero 实验里,Robota-Embed 与 LLM 重排序是组合在一起的;Fast-WAM 实验里,Context Tokens 的形式是本文设计的,换一种上下文形式效果可能不同。“相容的接口”指策略必须有读取参考的通道,并且这个通道要与参考的形式匹配,比如 DreamZero 读视频,Fast-WAM 读 token。
原文
Memory size and policy context are different resources. Embed2Evolve can grow memory while retaining less history and refreshing less often. Independent evolution with Omni-Embed-Nemotron-3B compares discovered memories and harnesses, not a fixed-harness encoder swap. Token and reference-cost metrics cover all test rollouts; decision/time comparisons use shared successes. Fewer policy calls need not mean fewer control ticks or shorter robot motion.
译文
记忆规模与策略上下文是两种不同的资源。Embed2Evolve 可以在保留更少历史、刷新更不频繁的同时扩大记忆。用 Omni-Embed-Nemotron-3B 独立演化,比较的是各自发现的记忆和外壳,而不是在固定外壳下更换编码器。token 和参考费用指标覆盖全部测试执行;决策次数和时间的比较只使用双方都成功的执行。策略调用次数减少,不一定意味着控制步数更少或机器人运动更短。
解释
“两种资源”的意思是:记忆库存在外部,大小不直接影响 token 消耗;真正花 token 的是每次放进提示词的上下文。好的检索让系统可以“库越来越大、每次放进去的越来越少”,这正是 PullCubeTool 路径上记忆从 938 增至 1,667、历史从 8 对减到 4 对的含义。最后一句与表 31 对应:Poke Cube 和 Two-Robot Stack Cube 上,决策次数减少了,控制步数反而分别增加 36.4% 和 51.8%。也就是说,策略“想”得少了,机器人“动”得未必少。
原文
Future work. Future work will extend Robota-Embed to more robot embodiments with diverse kinematics, native action spaces, and control interfaces. We will also explore variable-length retrieval that adapts the temporal extent of recorded continuations to the task and execution stage, rather than using a fixed four-second window. The goal is to retrieve only the duration of experience needed for the current interaction.
译文
未来工作。未来的工作将把 Robota-Embed 扩展到更多运动学结构、原生动作空间和控制接口各不相同的机器人本体上。我们还将探索变长检索,使记录下来的后续片段的时间跨度能随任务和执行阶段自适应,而不是固定使用 4 秒窗口。目标是只检索当前交互所需的那段经验时长。
解释
两点未来工作对应两个当前限制。其一,训练数据只有四个来源,每个来源一个专用动作投影层(附录表 7),新本体需要新投影层和新数据,目前的模型无法零样本接入新机器人。其二,4 秒是固定超参数:对于“拧瓶盖”这类精细动作,4 秒可能包含太多阶段;对于“移动到另一个房间”这类长动作,4 秒又太短。
7结论(Conclusion)
原文
Robota-Embed jointly encodes task intent, visual state, and native action for physical-experience retrieval; action improves retrieval beyond language and vision. This shared space supports Embed2ICL conditioning and Embed2Evolve memory evolution. Under matched settings, Embed2Evolve's success and efficiency gains show that representation shapes both retrieved context and the harness around a frozen policy.
译文
Robota-Embed 为物理经验检索联合编码任务意图、视觉状态和原生动作;动作在语言和视觉之外进一步提升了检索。这个共享空间同时支持 Embed2ICL 的条件化和 Embed2Evolve 的记忆演化。在匹配的设置下,Embed2Evolve 在成功率和效率上的提升表明,表示既塑造了检索到的上下文,也塑造了围绕冻结策略的外壳。
解释
结论的最后一句是全文最强的论断:嵌入模型不仅决定“取回什么”,还通过演化过程决定“外壳长什么样”。支撑它的证据是表 6 中两个嵌入模型独立演化的对比(68% 对 33%)。正如第 5.2 节所述,这一对比只在 5 个任务、每任务 20 次试验上进行,而且两边的外壳配置不同,所以它是一个有力的案例,但还不是对“表示如何塑造外壳”的机制性解释。原文在结论之后是参考文献列表。参考文献从略,见原文。正文中的引用已按原文参考文献表改写为“作者,年份”格式(原 PDF 使用数字编号引用)。
附录(Appendix)
解释
原文附录共五节:A 介绍 Robota-Embed 的方法细节(结构、优化、各项损失、训练数据整理);B 介绍 Robota-Embed-Bench 的构成与各类诊断实验;C 介绍 Embed2ICL 的实现与补充结果;D 介绍 Embed2Evolve 的外壳、开发过程与评测;E 对比相关检索方法的协议。原文附录没有重置图表编号,图 8–14、表 7–33 都在附录中,本译稿保持一致。
ARobota-Embed 方法细节(Robota-Embed Method Details)
A.1结构与优化(Architecture and Optimization)
原文
Paired inputs. Queries use instructions, synchronized current actions, and SAM3 (Carion et al., 2026) interaction crops. Targets pair instructions with 16 frames and native-rate actions from strictly future four-second windows. We favor less-occluded third-person views; EgoDex is egocentric.
译文
配对输入。查询使用指令、同步的当前动作和 SAM3(Carion et al., 2026)交互区域裁剪图。目标把指令与严格位于未来的 4 秒窗口中的 16 帧画面和原生频率的动作配对。我们优先选用遮挡较少的第三人称视角;EgoDex 则是第一人称视角。
解释
两端的视觉粒度不对称:查询只有一张裁剪图,目标有 16 帧完整画面(4 秒内约每 0.25 秒一帧)。目标端的动作保留原生频率,所以不同来源的目标动作序列长度不同:按表 7,EgoDex 30 Hz 下 4 秒是 120 步,DROID 15 Hz 是 60 步,LIBERO 和 RoboMIND 10 Hz 是 40 步。
原文
Shared backbone and endpoint adapters. Robota-Embed uses Cosmos3-Edge 4B, with 28 Transformer layers and hidden width 2,048. The Transformer, shared retrieval head, endpoint adapters, and temperature are initialized from its pretrained checkpoint. Query and target share the Transformer, video tokenizer, and embedding projection head. Separate bias-free residual linear adapters specialize the current-state and future-clip endpoints. Each source retains its native action projector, trained jointly with the Transformer. For endpoint r\in\{q,k\}, let H^r\in\mathbb{R}^{T_r\times2048} denote the multimodally fused hidden states at native action-token positions, after the generation RMSNorm following layer 28. These states jointly encode the endpoint's language, vision, and action. Let g_r denote the endpoint readout, comprising the shared LayerNorm and projection W\in\mathbb{R}^{1024\times2048} together with the endpoint-specific residual adapter. Temporal pooling and normalization give
\bar h^r=\frac{1}{T_r}\sum_{t=1}^{T_r}H^r_t,\qquad z^r=\frac{g_r(\bar h^r)}{\|g_r(\bar h^r)\|_2}.(3)
The shared projection is bias-free. Benchmark retrieval uses cosine similarity; only training-free Embed2ICL reranks. Temporal pooling of the target states, shared projection, and per-token normalization yield Embed2ICL's cached Context Tokens (Section C.4). 译文
共享骨干与两端适配器。Robota-Embed 使用 Cosmos3-Edge 4B,含 28 层 Transformer,隐藏宽度 2,048。Transformer、共享检索头、两端适配器和温度参数都从其预训练检查点初始化。查询端和目标端共享 Transformer、视频分词器和嵌入投影头。各自独立的、无偏置的残差线性适配器分别专门处理当前状态端和未来片段端。每个数据源保留自己的原生动作投影层,与 Transformer 联合训练。对于端点 r\in\{q,k\},记 H^r\in\mathbb{R}^{T_r\times2048} 为第 28 层之后、经过生成用 RMSNorm 的、位于原生动作 token 位置上的多模态融合隐状态。这些状态联合编码了该端的语言、视觉和动作。记 g_r 为该端的读出函数,它由共享的 LayerNorm、投影矩阵 W\in\mathbb{R}^{1024\times2048} 以及该端专有的残差适配器组成。经过时间池化和归一化得到
\bar h^r=\frac{1}{T_r}\sum_{t=1}^{T_r}H^r_t,\qquad z^r=\frac{g_r(\bar h^r)}{\|g_r(\bar h^r)\|_2}.(3)
共享投影没有偏置项。基准检索使用余弦相似度;只有免训练的 Embed2ICL 做重排序。对目标端隐状态做时间池化、共享投影和逐 token 归一化,就得到 Embed2ICL 缓存的 Context Tokens(附录 C.4)。 解释
式 (3) 说明一个端点的向量怎么来。H^r 不是所有 token 的隐状态,而是“动作 token 位置”上的隐状态:动作经投影层变成若干 token 插入序列,Transformer 的自注意力让这些位置同时看到语言和视觉,所以它们的输出是三模态融合的结果。T_r 是该端动作 token 的个数(查询端少、目标端多)。\bar h^r 是对时间维取平均,得到一个 2,048 维向量;g_r 把它投影到 1,024 维;再除以 L2 范数得到单位向量 z^r,两个单位向量的内积就是余弦相似度。读出位置选在动作 token 上是一个关键设计,它让动作 token 成为汇聚三模态信息的位置,也说明了动作在这个模型中不是可有可无的附加输入。由此带来一个实现上的问题:附录 B.4 的查询遮挡实验去掉了动作,此时读出位置上放的是什么(零向量、占位 token 还是别的处理),原文没有说明。Context Tokens 与检索向量的差别在于:检索向量把时间维平均掉了;Context Tokens 按附录 C.4 的式 (7) 只做时间方向的局部池化,保留一串 token,再逐个归一化,用作 Fast-WAM 的交叉注意力输入。
原文
Native actions. Table 7 specifies the native action interfaces. For each source, we compute per-coordinate quantiles q_{01} and q_{99} using its training partition and normalize actions as
\hat a=2\frac{a-q_{01}}{\max(q_{99}-q_{01},10^{-8})}-1.(4)
Values remain unclipped, and zero-padding to 64 dimensions standardizes tensor shape. The source identifier selects the native projector; future actions retain their native sampling rate. 译文
原生动作。表 7 给出各来源的原生动作接口。对每个来源,我们在其训练划分上逐坐标计算 1% 分位数 q_{01} 和 99% 分位数 q_{99},并把动作归一化为
\hat a=2\frac{a-q_{01}}{\max(q_{99}-q_{01},10^{-8})}-1.(4)
数值不做截断,并补零到 64 维以统一张量形状。来源标识决定使用哪个原生投影层;未来动作保留其原生采样频率。 解释
式 (4) 是常见的分位数归一化:把每个坐标的 1%–99% 区间线性映射到 [-1,1]。例如某关节的 q_{01}=-0.2、q_{99}=0.6,原始值 0.2 映射为 2\times(0.4/0.8)-1=0。分母里的 \max(\cdot,10^{-8}) 防止某个坐标几乎恒定时除以零。“不截断”意味着落在 1%–99% 之外的极端值会映射到 [-1,1] 之外,保留了异常运动的信息。补零到 64 维是为了让各来源的张量形状一致;最大的 EgoDex 是 57 维,所以 64 足够。
表 7:原生动作接口。维度和频率描述的是归一化和补零之前的原生动作。域编号(Domain ID)把动作路由到各自的 Cosmos3-Edge 投影层。
| 来源 | 域编号 | 动作维度 | 频率(Hz) |
| EgoDex | 3 | 57 | 30 |
| DROID | 8 | 10 | 15 |
| LIBERO | 5 | 10 | 10 |
| RoboMIND–Franka-dual | 12 | 20 | 10 |
原表注:Native action interfaces. Dimensions and rates describe native actions before normalization and padding. Domain IDs route actions to their Cosmos3-Edge projectors.
表 7 解读
四个来源的动作差别很大。EgoDex 是 57 维的人手与上身姿态(例如多个关节点的位置或旋转),频率 30 Hz;DROID 和 LIBERO 都是 10 维单臂控制量(通常为末端位置、姿态与夹爪的组合),频率分别为 15 Hz 和 10 Hz;RoboMIND–Franka-dual 是双臂 Franka,20 维正好是两条 10 维单臂控制量拼接。域编号不连续(3、5、8、12),加上图注说动作被“路由到各自的 Cosmos3-Edge 投影层”,可以推测它们沿用了 Cosmos3-Edge 预训练时已有的动作域编号和投影层(附录 A.1 也说投影层“保留”并与 Transformer 联合训练),而不是为这四个来源从零新建。表中没有给出每一维的具体语义,上面对维度构成的解读是根据维数做的推断。
原文
Optimization. We use AdamW with \beta=(0.9,0.95) and gradient clipping at 1.0. The Transformer learning rate is 3\times10^{-7}, and the projection head and endpoint adapters use 10^{-4}. Training runs for 26,275 optimizer steps, with 1,314 steps of linear warm-up followed by cosine decay, global batch size 512, and equal sampling of EgoDex, DROID, LIBERO, and RoboMIND–Franka-dual (1{:}1{:}1{:}1). The optimizer and scheduler are reinitialized for retrieval training. Both parameter groups use weight decay 0.05; the video VAE is frozen. We use the final-step checkpoint (26,275).
译文
优化。我们使用 AdamW,\beta=(0.9,0.95),梯度裁剪阈值为 1.0。Transformer 的学习率为 3\times10^{-7},投影头和两端适配器的学习率为 10^{-4}。训练共 26,275 个优化步:先线性预热 1,314 步,然后余弦衰减;全局批大小为 512;EgoDex、DROID、LIBERO 和 RoboMIND–Franka-dual 等比例采样(1{:}1{:}1{:}1)。检索训练开始时重新初始化优化器和学习率调度器。两个参数组都使用 0.05 的权重衰减;视频 VAE 保持冻结。我们使用最后一步(第 26,275 步)的检查点。
解释
几个数字值得算一下。预热步数 1,314 约为总步数的 5%。总共见过的样本数为 26{,}275\times512\approx1{,}345 万,约为语料总量 169.6 万的 7.9 倍。由于四个来源等比例采样,每个来源各被抽到约 336 万次:EgoDex 有 134.5 万条,平均每条只用约 2.5 次;DROID 只有 2.66 万条,平均每条被重复约 127 次,存在过拟合风险,这可能也是 DROID 上检索分数最高的原因之一。Transformer 学习率 3\times10^{-7} 比头部低三个多数量级,几乎是在“轻微扰动”预训练权重,但表 16 显示这一点更新就让 R@1 从 13.8% 升到 78.7%,说明骨干网络适配不可或缺。“使用最后一步检查点”而不是在验证集上挑最好的,可以避免在测试集上间接调参。
A.2Robota-Embed 的训练目标(Robota-Embed Objective)
原文
The objective (Eq. 2) combines predictive retrieval alignment, multimodal grounding and discrimination, and representation regularization. Table 8 lists term coefficients and ranking margins.
译文
训练目标(式 (2))结合了预测检索对齐、多模态落地与判别,以及表示正则化。表 8 列出各项的系数和排序边距。
解释
下面依次展开表 8 的每一行。
表 8:Robota-Embed 的训练目标。各项的损失系数和排序边距,按式 (2) 中的三组目标组织。
| 目标项 | 约束或正样本关系 | 权重 | 边距 |
| 预测检索对齐 | |||
| 片段级检索 | 确切的未来片段身份;双向 InfoNCE | 1.00 | – |
| 多模态落地与判别 | |||
| 文本辅助 | 仅文本查询;匹配任务 | 0.15 | – |
| 图像辅助 | 仅图像查询;匹配交互物体 | 0.20 | – |
| 动作辅助 | 停用;未来身份需要依靠多模态上下文 | 0.00 | – |
| 文本交换 | 替换查询文本必须降低相似度 | 0.25 | 0.08 |
| 图像交换 | 替换查询的放大图必须降低相似度 | 0.35 | 0.10 |
| 动作交换 | 替换当前动作必须降低相似度 | 0.20 | 0.06 |
| 硬任务 | 物体角色相同;操作/关系/方向冲突 | 0.25 | 0.08 |
| 硬物体 | 任务关系相同;交互物体类别冲突 | 0.35 | 0.10 |
| 硬动作 | 任务与物体相同;动作基元/阶段冲突 | 0.20 | 0.06 |
| 融合优势 | 融合查询必须胜过每一个单模态查询 | 0.20 | 0.02 |
| 表示正则化 | |||
| 各向同性 | 方差、参与率秩和中心化 | 0.05 | – |
| 查询中心 | 直接的查询中心化惩罚 | 0.10 | – |
| 目标中心 | 直接的目标中心化惩罚 | 0.10 | – |
原表注:Robota-Embed training objective. Loss coefficients and ranking margins for each term, organized into the three objective groups in Eq. 2.
表 8 解读
表的四列是:目标项名称、它约束的关系、在总损失中的权重、排序损失的边距(只有铰链形式的损失才有边距)。主项“片段级检索”权重为 1,其余各项的权重都在 0.05–0.35 之间,说明对齐损失主导训练,其他项是辅助。有三点值得注意。(1) 三种模态的处理是对称的:文本、图像、动作各有一个“交换”项和一个“硬负样本”项,而且同一模态的两项用相同的边距(文本/任务 0.08,图像/物体 0.10,动作 0.06),动作的边距最小。(2) 动作辅助项被停用(权重 0),理由是单个当前动作无法唯一确定未来轨迹,这与第 3.2 节“不要求单靠动作匹配”一致。(3) 融合优势项要求三模态融合的查询比任何单模态查询更接近正确目标,边距只有 0.02,是一个很宽松的约束。所以式 (2) 的三组目标实际包含 14 个子项(1 + 10 + 3)。第 4.2 节表 17 的消融是按组加减,没有逐项消融,因此无法判断例如“动作交换”这一项单独贡献多少。
原文
Positive, negative, and ignored pairs. Positive pairs share the exact future-clip ID. For query q_i, k_i is the paired positive (k^+ in Figure 2). Each pair links a current state to its recorded future clip within the same source. Let s(q,k) be cosine similarity and \mathcal{N}(i) contain only candidates with a different clip ID and an explicit semantic conflict. The query-to-target term is
\mathcal{L}_{q\rightarrow k}=-\frac{1}{|\mathcal{B}|}\sum_{i\in\mathcal{B}}\log\frac{\exp(s(q_i,k_i)/\tau)}{\exp(s(q_i,k_i)/\tau)+\sum_{j\in\mathcal{N}(i)}\exp(s(q_i,k_j)/\tau)}.(5)
We independently build the reverse validity mask and average the directions: \mathcal{L}_{\mathrm{align}}=\tfrac12(\mathcal{L}_{q\rightarrow k}+\mathcal{L}_{k\rightarrow q}). The global pool contains 512 entries before masking; each denominator retains only the positive and valid negatives. We optimize the inherited Cosmos3-Edge temperature \tau within [0.01,0.2]. 译文
正样本、负样本与被忽略的配对。正样本配对共享确切的未来片段编号。对于查询 q_i,k_i 是与之配对的正样本(图 2 中的 k^+)。每个配对都把同一来源内的一个当前状态与它记录下来的未来片段联系起来。记 s(q,k) 为余弦相似度,\mathcal{N}(i) 只包含片段编号不同并且存在明确语义冲突的候选。查询到目标方向的损失项为
\mathcal{L}_{q\rightarrow k}=-\frac{1}{|\mathcal{B}|}\sum_{i\in\mathcal{B}}\log\frac{\exp(s(q_i,k_i)/\tau)}{\exp(s(q_i,k_i)/\tau)+\sum_{j\in\mathcal{N}(i)}\exp(s(q_i,k_j)/\tau)}.(5)
我们独立地构建反方向的有效性掩码,并对两个方向取平均:\mathcal{L}_{\mathrm{align}}=\tfrac12(\mathcal{L}_{q\rightarrow k}+\mathcal{L}_{k\rightarrow q})。掩码之前的全局候选池包含 512 个条目;每个分母只保留正样本和有效的负样本。我们在 [0.01,0.2] 范围内优化从 Cosmos3-Edge 继承来的温度 \tau。 解释
式 (5) 的符号:\mathcal B 是一个批次(512 个配对),|\mathcal B| 是批大小;s(q_i,k_i) 是查询与其正样本的余弦相似度;\tau 是温度,越小分布越尖锐;\mathcal N(i) 是查询 i 的有效负样本集合。与标准 InfoNCE 的唯一区别是分母只对 \mathcal N(i) 求和,而不是对批内所有 j\ne i 求和。直观上,每个查询要在“正样本 + 确认冲突的负样本”这个小集合里把正样本挑出来;那些“可能也合理”的样本既不当正样本也不当负样本,不受约束。“反方向独立构建掩码”是因为冲突关系不一定对称:判断目标 k_i 与查询 q_j 是否冲突,用到的是 q_j 的当前动作基元和 k_i 的未来阶段等信息,与反过来比较时用到的信息不同。温度 \tau\in[0.01,0.2] 是可学习的,但被限制在一个区间内,防止它塌缩到极小值导致训练不稳定。
原文
Semantic conflict rules. We generate weak labels through structured parsing and deterministic rules. Qwen3-VL-8B-Instruct (Bai et al., 2025) parses task instructions into operation names and object roles using non-sampling decoding. From this output, we construct signatures for task relations, object identities, and object categories. The resulting labels are rule-driven weak supervision, not human annotations. Before similarity-based mining, we determine eligibility for \mathcal{N}(i) using four pairwise conflicts: Task conflict preserves object roles but changes the operation, relation, or direction. Object conflict preserves the task relation but changes a valid interaction-object category. Action conflict shares task and objects but differs in the current-action primitive or future-action phase. Joint conflict changes both task and objects.
译文
语义冲突规则。我们通过结构化解析和确定性规则生成弱标签。Qwen3-VL-8B-Instruct(Bai et al., 2025)以非采样解码的方式,把任务指令解析为操作名称和物体角色。根据这一输出,我们为任务关系、物体身份和物体类别构造“签名”。由此得到的标签是规则驱动的弱监督,而不是人工标注。在基于相似度挖掘负样本之前,我们用四种两两冲突来判定一个候选能否进入 \mathcal{N}(i):任务冲突保持物体角色不变,但改变操作、关系或方向;物体冲突保持任务关系不变,但改变一个有效的交互物体类别;动作冲突共享任务和物体,但当前动作基元或未来动作阶段不同;联合冲突同时改变任务和物体。
解释
举例说明四种冲突。设查询指令为“把杯子放到盘子上”。“把杯子从盘子上拿起来”是任务冲突:物体角色相同(杯子、盘子),操作方向相反。“把碗放到盘子上”是物体冲突:关系相同(放到……上),被操作物体的类别不同。同为“把杯子放到盘子上”、但一个正在伸手、另一个正在下放,是动作冲突:任务和物体都相同,阶段不同。“打开抽屉”是联合冲突:任务和物体都不同。“非采样解码”即贪心解码,保证同一条指令每次解析出相同的结果,使标签可复现。注意这些标签全部来自一个 8B 视觉语言模型对指令的解析,解析错误会直接变成错误的负样本,作者没有报告解析准确率。
原文
For same-episode action negatives, future windows with temporal intersection-over-union greater than 0.25 are treated as near-duplicates and excluded. Cross-episode action negatives must additionally differ in future gripper phase. These checks filter the action-conflict class; semantically compatible, uncertain, or potentially duplicate candidates are masked out of the negative set. A different clip ID alone is therefore insufficient to make a pair negative.
译文
对于同一回合内的动作负样本,未来窗口在时间上的交并比(IoU)大于 0.25 的视为近似重复并予以排除。跨回合的动作负样本还必须在未来夹爪阶段上有所不同。这些检查用于过滤动作冲突类;语义上兼容的、不确定的或可能重复的候选都从负样本集合中被掩蔽掉。因此,仅仅片段编号不同,不足以使一个配对成为负样本。
解释
时间 IoU 的算法:两个 4 秒窗口,如果起点相差 1 秒,重叠 3 秒、并集 5 秒,IoU =0.6>0.25,视为重复,不能当负样本;起点相差 2.5 秒时重叠 1.5 秒、并集 6.5 秒,IoU \approx0.23,可以当负样本。换算下来,同回合的两个窗口起点至少要相差约 2.4 秒(IoU =(4-d)/(4+d)\le0.25 解得 d\ge2.4)。跨回合的负样本要求夹爪阶段不同(例如一个即将闭合、另一个即将张开),这是更严格的条件,因为不同回合中“同一阶段”的片段很可能是合理的替代参考。
原文
Current-action primitives are obtained by scale-standardizing the domain-normalized action and discretizing each coordinate at thresholds -0.5 and +0.5. Future-action phase combines the dominant motion direction, the timing of peak motion, and changes in gripper state. To compare future actions, we sample 16 time points and concatenate the per-coordinate means, standard deviations, and first-to-last differences. We compare these descriptors using scale-normalized RMS distances.
译文
当前动作基元的获得方式是:把经过域内归一化的动作再做尺度标准化,然后在阈值 -0.5 和 +0.5 处把每个坐标离散化。未来动作阶段综合了主导运动方向、运动峰值出现的时刻以及夹爪状态的变化。为比较未来动作,我们采样 16 个时间点,把每个坐标的均值、标准差和首末差值拼接起来。这些描述子之间用尺度归一化的均方根(RMS)距离进行比较。
解释
“动作基元”是把连续动作粗略离散成符号:每个坐标按 <-0.5、[-0.5,0.5]、>0.5 分成三档,记为负、零、正,于是一个 10 维动作变成一个 10 位的三进制串。两个动作只要有一位不同,就算基元不同。未来动作的描述子是一个统计摘要:对每个坐标取均值(往哪走)、标准差(动得多剧烈)、首末差(总位移),维度为坐标数的 3 倍。这些都是手工设计的规则,用来生成弱标签,不参与推理。
原文
Auxiliary alignment. Text-only and image-only auxiliary queries align with targets sharing task and interaction-object identity, respectively. We disable standalone action-only alignment to exact future clips: a single current action does not uniquely determine a future trajectory. Action remains an input to fused retrieval alignment, with action swaps discouraging the model from ignoring it.
译文
辅助对齐。仅文本和仅图像的辅助查询,分别与共享任务身份、共享交互物体身份的目标对齐。我们停用了“仅动作”查询与确切未来片段之间的单独对齐:单个当前动作并不能唯一确定一条未来轨迹。动作仍作为融合检索对齐的输入之一,而动作交换项会阻止模型忽略它。
解释
辅助项的正样本定义比主项宽:文本查询只要找到“同一任务”的目标就算对,图像查询只要找到“同一物体”的目标就算对,因为单一模态本来就不足以定位到确切时刻。这些辅助项让每种模态单独也能产生有意义的嵌入,避免融合表示完全被某一种模态主导。
原文
Modality comparisons. Each swapped query replaces exactly one modality while keeping its paired target fixed. Text donors share object identity but differ in task relation; image donors share the task relation but differ in valid object category. Action donors share the action domain, task, and object identity, but differ in both current-action primitive and future-action phase. The standardized RMS distances between their current actions and between their future descriptors must each be at least 0.75. These donor conditions are stricter than the action-conflict eligibility rules.Let q' encode a valid swapped query. We use the cosine hinge loss
\ell_{\mathrm{swap}}(q,q',k^+)=\max\!\left\{0,\,m-s(q,k^+)+s(q',k^+)\right\},(6)
with m=0.08 (text), 0.10 (image), and 0.06 (action). We skip only the corresponding swap loss when no valid donor exists. A 0.02 margin favors the fused query over each unimodal query. 译文
模态比较。每个交换查询恰好替换一种模态,同时保持其配对目标不变。文本供体(donor)与原样本共享物体身份但任务关系不同;图像供体共享任务关系但有效物体类别不同。动作供体共享动作域、任务和物体身份,但当前动作基元和未来动作阶段都不同;而且它们当前动作之间、未来描述子之间的标准化 RMS 距离都必须至少为 0.75。这些供体条件比动作冲突的资格规则更严格。记 q' 为一个有效交换查询的编码。我们使用余弦铰链损失
\ell_{\mathrm{swap}}(q,q',k^+)=\max\!\left\{0,\,m-s(q,k^+)+s(q',k^+)\right\},(6)
其中边距 m=0.08(文本)、0.10(图像)、0.06(动作)。当不存在有效供体时,只跳过对应的那一项交换损失。另有一个 0.02 的边距,使融合查询优于每一个单模态查询。 解释
式 (6) 的含义:原查询 q 与正确目标 k^+ 的相似度,必须比“换掉一种模态后的查询” q' 与 k^+ 的相似度至少高 m;做到了损失为 0,做不到就按差额惩罚。例如 s(q,k^+)=0.70、s(q',k^+)=0.66、m=0.06,则损失为 \max\{0,0.06-0.70+0.66\}=0.02。“供体”就是提供替换模态的另一个样本。它的条件设计得很讲究:被换掉的那个模态必须真的不同(否则 q' 本该和 q 一样相似),而其余模态必须相同(否则相似度下降可能来自别的差异)。动作供体要求同任务、同物体、但动作明显不同,这正好对应第 1 节“伸向碗”与“放完撤手”的例子:如果模型忽略动作,q 和 q' 的得分就会一样,损失为正。
原文
Hard-negative constraints. The contrastive denominator uses all valid negatives. For the hard-task, hard-object, and hard-action terms, we select the highest-similarity candidate from the corresponding nonempty conflict class c after validity masking: j_c^*(i)=\arg\max_{j\in\mathcal{N}_c(i)}s(q_i,k_j). Their margins are 0.08, 0.10, and 0.06, respectively. Conditional hinge losses are averaged over valid samples within each rank, then averaged across ranks.
译文
硬负样本约束。对比损失的分母使用全部有效负样本。对于硬任务、硬物体、硬动作三项,我们在有效性掩码之后,从对应的非空冲突类 c 中选出相似度最高的候选:j_c^*(i)=\arg\max_{j\in\mathcal{N}_c(i)}s(q_i,k_j)。它们的边距分别为 0.08、0.10 和 0.06。这些条件铰链损失先在每个计算进程(rank)内对有效样本取平均,再在各进程之间取平均。
解释
\mathcal N_c(i) 是 \mathcal N(i) 中属于冲突类 c 的那部分。InfoNCE 对所有负样本“平均用力”,而硬负样本项专门盯住最难的那一个(与查询最相似的冲突样本),要求正样本比它高出边距。这是度量学习中常见的“最难负样本挖掘”。“rank”指分布式训练中的各 GPU 进程;因为每个进程上有效样本数不同,先在进程内平均再跨进程平均,相当于给每个进程等权。
原文
Representation regularization. We encourage near-zero batch centers, a per-dimension standard-deviation floor near 0.02, and participation-ratio effective ranks of at least 16 for query batches and 18 for target batches. Center losses weighted at 0.10 per side reinforce isotropy-based centering.
译文
表示正则化。我们鼓励批次中心接近零、每个维度的标准差不低于约 0.02,并要求查询批次的参与率有效秩至少为 16,目标批次至少为 18。两端各有权重为 0.10 的中心损失,进一步加强基于各向同性的中心化。
解释
参与率(participation ratio)有效秩定义为 (\sum_i\lambda_i)^2/\sum_i\lambda_i^2,其中 \lambda_i 是批次嵌入协方差矩阵的特征值。所有方差集中在一个方向时它等于 1,平均分布在 d 个方向时等于 d。要求有效秩至少 16 或 18,相对 1,024 维的嵌入空间是很低的门槛,作用只是防止塌缩,而不是追求各向同性。标准差下限 0.02 起同样的作用:任何一维都不能在整个批次上几乎恒定。
A.3训练数据与整理(Training Data and Curation)
原文
Our training dataset contains 1,695,684 filtered anchor-level examples from EgoDex (Hoque et al., 2026), DROID (Khazatsky et al., 2024), LIBERO (Liu et al., 2023), and RoboMIND–Franka-dual (Wu et al., 2024). Table 9 gives the source composition. EgoDex contributes tracked human hand and body pose trajectories, encoded by its source-specific native-action projector. Before constructing dense anchors, we assign complete episodes, sessions, and content identities to disjoint training, validation, and original test partitions.
译文
我们的训练数据集包含 1,695,684 个经过过滤的锚点级样本,来自 EgoDex(Hoque et al., 2026)、DROID(Khazatsky et al., 2024)、LIBERO(Liu et al., 2023)和 RoboMIND–Franka-dual(Wu et al., 2024)。表 9 给出各来源的构成。EgoDex 提供被跟踪的人手和身体姿态轨迹,由它专用的原生动作投影层编码。在构造密集锚点之前,我们把完整的回合、采集会话和内容身份分配到互不相交的训练、验证和原始测试划分中。
解释
“内容身份”大概指同一段原始内容的不同副本或不同视角(例如同一次操作被多个相机记录),把它们放在同一个划分里,可以防止“训练时见过同一次操作的另一个视角”造成泄露。
表 9:训练数据构成。按来源统计的、经过过滤的锚点级训练样本。
| 来源域 | 训练样本数 | 占比(译者计算) |
| EgoDex (Hoque et al., 2026) | 1,345,160 | 79.3% |
| DROID (Khazatsky et al., 2024) | 26,563 | 1.6% |
| LIBERO (Liu et al., 2023) | 136,671 | 8.1% |
| RoboMIND–Franka-dual (Wu et al., 2024) | 187,290 | 11.0% |
| 合计 | 1,695,684 | 100% |
原表注:Training-data composition. Filtered anchor-level training examples by source.
表 9 解读
原表只有前两列,第三列占比是译者计算的。四项相加 1{,}345{,}160+26{,}563+136{,}671+187{,}290=1{,}695{,}684,与总数一致。人类数据 EgoDex 占近八成,DROID 只占 1.6%。由于训练时四个来源等比例采样(附录 A.1),实际训练中每个来源的权重各为 25%,与这里的数量比例完全不同。DROID 本身是一个大规模机器人数据集,这里只有 2.66 万个锚点,说明经过 SAM3 定位和 Qwen3-VL 质量闸门之后,DROID 中大部分锚点被过滤掉了,原文没有报告各来源的过滤通过率。
原文
Anchor enumeration and object localization. For a source sequence with N frames, let a be a frame index and h the future horizon in frames. We enumerate dense anchors satisfying a+h+1<N. We prompt SAM3 with phrases naming the instruction's physical interaction objects, using a proposal threshold of 0.35. We retain detections with a final score of at least 0.40 that cover at least 0.08% of the source image, and permit a zoom ratio of at least 1.10. We independently recompute each accepted crop at 320\times192.
译文
锚点枚举与物体定位。对于一条有 N 帧的源序列,记 a 为帧索引,h 为以帧计的未来时域长度。我们枚举所有满足 a+h+1<N 的密集锚点。我们用指令中所涉及的物理交互物体的名称短语提示 SAM3,候选阈值为 0.35。我们保留最终得分至少为 0.40、覆盖源图像面积至少 0.08% 的检测结果,并允许不小于 1.10 的放大倍率。每个通过的裁剪图都以 320\times192 的分辨率独立重新计算。
解释
a+h+1<N 保证锚点之后还有完整的 h 帧未来(4 秒),序列末尾不足 4 秒的位置不能当锚点。面积下限 0.08% 很小:在 1280\times720 的画面中约为 737 个像素,大约 27\times27 的方块,所以很小的物体也能被保留。放大倍率至少 1.10 表示裁剪框至少比原图小一些,确保“放大”确实发生。
原文
Visual quality gate. Qwen3-VL-8B-Instruct (Bai et al., 2025) verifies each crop deterministically. A crop passes only if the model confirms with high confidence that the interaction object is visible, matches the instruction, is separable from other instances, and is unoccluded. If verification fails, we resample an earlier neighboring timestamp, updating the image, synchronized action, and temporal anchor together. Selection uses only the instruction and current observations.
译文
视觉质量闸门。Qwen3-VL-8B-Instruct(Bai et al., 2025)以确定性方式核验每张裁剪图。只有当模型以高置信度确认交互物体可见、与指令相符、能与其他实例区分开且未被遮挡时,裁剪图才算通过。如果核验失败,我们就重新采样一个更早的相邻时间戳,同时更新图像、同步动作和时间锚点。这一选择只使用指令和当前观测。
解释
“往前退一帧”而不是“往后退”,是为了不让锚点越过原定的未来窗口起点;同时更新图像、动作和锚点三者,保证查询内部始终是同一时刻的数据。最后一句再次强调防泄露:如果用未来片段来决定是否保留锚点,被保留的样本就会系统性地偏向某种未来,从而让检索任务变得不真实。
原文
Future target construction. We pair each accepted anchor with the strictly future four-second action sequence and 16 video frames from that interval. The window starts after the accepted timestamp, including when resampling selects an earlier one. Figure 3 shows the pipeline.
译文
未来目标的构造。我们把每个通过的锚点与严格位于其未来的 4 秒动作序列,以及该区间内的 16 帧视频配对。窗口从被接受的时间戳之后开始,即使重采样选中了一个更早的时间戳也是如此。图 3 展示了整个流程。
解释
这一段与第 3.3 节的图 3 对应,原文附录没有重复放这张图(源码中附录版本的图被条件编译跳过),这里同样不重复。
BRobota-Embed-Bench 的评测与诊断(Robota-Embed-Bench Evaluation and Diagnostics)
B.1Robota-Embed-Bench 的构成与评测(Composition and Evaluation)
原文
EgoDex, DROID, LIBERO, and RoboMIND–Franka-dual each contribute 1,000 held-out queries from 800 unique episodes. The shared 8,000-item gallery contains 2,000 candidates per source: 1,000 paired future clips and 1,000 nearby same-episode clips. Nearby clips often share the positive's instruction, objects, and visual content, requiring precise temporal localization.
译文
EgoDex、DROID、LIBERO 和 RoboMIND–Franka-dual 各自贡献 1,000 条留出查询,来自 800 个不同的回合。共享的 8,000 条目候选库中每个来源有 2,000 个候选:1,000 个配对的未来片段和 1,000 个同回合的邻近片段。邻近片段往往与正样本共享指令、物体和视觉内容,因此需要精确的时间定位。
解释
这是第 3.3 节基准描述的展开。每个来源的 1,000 个邻近片段与 1,000 个配对片段一一对应,可以理解为每个配对片段都有一个“同回合、时间相近”的孪生干扰项。
原文
The four sources contain 591, 800, 39, and 5 distinct task-instruction strings, respectively, covering human experience, simulation, and single- and dual-arm robots. DROID and LIBERO also support the downstream ICL studies, evaluated separately from retrieval.
译文
四个来源分别包含 591、800、39 和 5 条不同的任务指令字符串,覆盖人类经验、仿真以及单臂和双臂机器人。DROID 和 LIBERO 还用于下游的 ICL 研究,后者与检索评测分开进行。
解释
这组数字是理解各来源难度差异的关键,正文没有提到。DROID 的 800 个回合有 800 条不同的指令,即指令与回合一一对应,只要文本匹配上就能确定回合;这解释了为什么 DROID 回合级 R@1 高达 99.88%,也解释了为什么遮掉候选文本后 DROID 的片段级 R@1 从 74.1% 跌到 4.4%(表 14)。RoboMIND-FD 只有 5 条指令,每条指令对应约 400 个候选,文本几乎不提供回合信息,必须靠视觉和动作来区分;这正是不含动作的 VL 基线在 RoboMIND-FD 上几乎完全失败(R@1 不到 0.5%,表 11)的原因。LIBERO 的 39 条指令介于两者之间。EgoDex 有 591 条指令、800 个回合,大部分指令也接近唯一。因此四个来源测的其实是不同的能力:DROID、EgoDex 主要测“同一回合内的时间定位”,LIBERO、RoboMIND-FD 还要测“同一任务的多个回合之间的区分”。
原文
Clip-level retrieval assigns one positive to each query: its uniquely paired future four-second window. Episode-level retrieval treats any indexed window from the same source-scoped episode as relevant. Episode-level metrics average query outcomes within each episode, then equally over the 800 episodes per source and the four sources, giving each episode equal weight regardless of its query count. In total, the benchmark contains 4,000 queries and 3,200 episodes. Training, validation, and original test partitions are separated by complete episode, session, and content identity before dense anchoring. Benchmark episodes are excluded from training; task, object, and embodiment categories may overlap across partitions. Every target is strictly later than its paired query anchor. Ranking uses cosine similarity on L2-normalized embeddings, without reranking. We evaluate the final Robota-Embed checkpoint at training step 26,275, the last step of retrieval training.
译文
片段级检索为每条查询指定唯一一个正样本:与它唯一配对的那个未来 4 秒窗口。回合级检索把同一来源内、同一回合的任何已索引窗口都视为相关。回合级指标先在每个回合内对查询结果取平均,再对每个来源的 800 个回合、以及四个来源等权平均,因此无论一个回合有几条查询,它的权重都相同。整个基准共有 4,000 条查询、3,200 个回合。训练、验证和原始测试划分在密集锚点构造之前,就按完整的回合、会话和内容身份分开。基准中的回合不参与训练;任务、物体和本体类别可以在各划分之间重叠。每个目标都严格晚于其配对的查询锚点。排序使用 L2 归一化嵌入上的余弦相似度,不做重排序。我们评测的是第 26,275 步,即检索训练最后一步的 Robota-Embed 检查点。
解释
“source-scoped episode”强调回合编号限定在来源内部,不同来源之间不会出现同一回合。4\times800=3{,}200 个回合。“3.3 节的三层平均”在这里说得更清楚:查询多的回合不会占更大权重。这一段大多是重复正文,作用是把协议写完整,方便复现。
原文
Baseline input interfaces. Robota-Embed queries combine instruction, a SAM3 object zoom, and synchronized action; gallery entries combine instruction, future video, and future action. Omni-Embed-Nemotron-3B and Qwen3-VL-Embedding-2B use instruction and the uncropped current frame as the query, and instruction and the 16-frame future clip as the candidate. CLIP, Perception Encoder, and InternVideo2 use the instruction to retrieve the future video clip. Gemini Embedding 2 and VLM2Vec-V2 likewise use instruction plus the original, uncropped current image as the query, without action input, and instruction plus the future four-second video as the gallery entry. For Gemini Embedding 2, we upload a video assembled from 16 frames and obtain normalized 768-dimensional vectors. VLM2Vec-V2 receives the 16 frames directly and uses last-token pooling followed by L2 normalization, producing 1,536-dimensional vectors. Both are evaluated on all 4,000 queries and 8,000 gallery entries.
译文
基线的输入接口。Robota-Embed 的查询由指令、SAM3 物体放大图和同步动作组成;候选条目由指令、未来视频和未来动作组成。Omni-Embed-Nemotron-3B 和 Qwen3-VL-Embedding-2B 以指令加未裁剪的当前帧作为查询,以指令加 16 帧未来片段作为候选。CLIP、Perception Encoder 和 InternVideo2 用指令去检索未来视频片段。Gemini Embedding 2 和 VLM2Vec-V2 同样以指令加原始的未裁剪当前图像作为查询(不含动作输入),以指令加未来 4 秒视频作为候选条目。对 Gemini Embedding 2,我们上传由 16 帧拼成的视频,得到归一化的 768 维向量。VLM2Vec-V2 直接接收 16 帧,使用最后一个 token 的池化再做 L2 归一化,得到 1,536 维向量。两者都在全部 4,000 条查询和 8,000 个候选上评测。
解释
这一段说明了基线与本文模型在输入上的三处不同:(1) 基线没有动作;(2) 基线的查询图像是未裁剪的整帧,本文用的是 SAM3 放大图;(3) CLIP 类模型的查询只有文本,候选只有视频,候选端没有文本。第 (3) 点很关键:对 CLIP 类模型而言,DROID 这种“指令唯一确定回合”的文本捷径并不存在,所以它们的分数极低,部分原因是接口限制,而不完全是表示能力差。统一 VL 基线的候选端则带有指令文本,可以利用这一捷径,这也是它们在 DROID 上回合级 R@1 接近 100% 的原因(表 11)。
原文
The released WeMM-Embedding-2B model is evaluated zero-shot with instruction and the uncropped current frame as the query, instruction and the 16-frame future clip as the candidate, and L2-normalized 2,048-dimensional outputs. Each external baseline is evaluated through its supported input interface. The controlled DROID study isolates modality choices with matched training data, backbone architecture, and optimization budget.
译文
已发布的 WeMM-Embedding-2B 模型以零样本方式评测:查询为指令加未裁剪的当前帧,候选为指令加 16 帧未来片段,输出为 L2 归一化的 2,048 维向量。每个外部基线都通过其支持的输入接口评测。受控的 DROID 研究则在训练数据、骨干结构和优化预算都匹配的条件下,单独考察模态的选择。
解释
“零样本”意味着所有外部基线都没有在本文的训练数据上微调。因此表 1 的对比是“专门训练的检索模型”对“通用嵌入模型”,差距中有一部分来自领域适配,而不只是动作。要单独衡量动作的作用,就要看受控的 DROID 研究。
原文
Frozen Cosmos3-Edge feature baseline. The frozen Cosmos3-Edge control uses the same query and target fields and native action projectors as Robota-Embed. We extract dense action-token features after the final RMSNorm of layer 28, before the action-output projection. Temporal averaging and L2 normalization produce a 2,048-dimensional VLA-conditioned backbone readout.
译文
冻结的 Cosmos3-Edge 特征基线。冻结 Cosmos3-Edge 对照使用与 Robota-Embed 相同的查询和目标字段以及原生动作投影层。我们在第 28 层最后的 RMSNorm 之后、动作输出投影之前,提取密集的动作 token 特征。经时间平均和 L2 归一化,得到一个 2,048 维、以 VLA 为条件的骨干读出向量。
解释
这个基线与 Robota-Embed 的唯一区别是“有没有经过检索训练”:输入、读出位置都相同,只是没有 1,024 维的投影头和适配器,直接用 2,048 维的骨干特征。它在表 15 中只有 0.65%,说明 Cosmos3-Edge 作为生成模型学到的特征并不适合做“当前对未来”的检索。
B.2分来源结果(Per-Domain Results)
原文
Tables 10 and 11 report retrieval on the shared 8,000-item gallery. Recall and MRR are percentages; lower ranks are better. Average weights sources equally. Episode-level metrics first average within episodes, then over 800 episodes per source.
译文
表 10 和表 11 报告在共享 8,000 条目候选库上的检索结果。召回率和 MRR 以百分比表示;排名越低越好。平均对各来源等权。回合级指标先在回合内平均,再对每个来源的 800 个回合平均。
解释
表 10 是本文模型分来源的结果,表 11 是两个代表性 VL 基线分来源的结果。
原文
For Robota-Embed, EgoDex episode-level R@1 reaches 87.06%, while clip-level R@1 is 36.70%; the corresponding DROID scores are 99.88% and 74.10%. The larger gap on EgoDex shows that identifying the episode often leaves the paired window unresolved, as in the near-miss in Figure 4. VLM2Vec-V2 and WeMM-Embedding-2B both perform best on DROID and EgoDex, with markedly lower recall on LIBERO and RoboMIND-FD.
译文
对 Robota-Embed 而言,EgoDex 的回合级 R@1 达到 87.06%,而片段级 R@1 为 36.70%;DROID 的对应数字为 99.88% 和 74.10%。EgoDex 上更大的差距表明,认出回合之后,往往仍无法确定配对的时间窗口,正如图 4 中的险中案例。VLM2Vec-V2 和 WeMM-Embedding-2B 都在 DROID 和 EgoDex 上表现最好,在 LIBERO 和 RoboMIND-FD 上的召回率明显更低。
解释
结合上面的指令数统计,基线的分来源表现可以完全解释:它们在“指令近乎唯一”的 DROID、EgoDex 上表现好,是因为文本几乎就能确定回合;在“指令很少”的 LIBERO、RoboMIND-FD 上崩溃,是因为它们没有动作,而整帧图像又区分不了同一任务的不同回合和阶段。本文模型在后两个来源上的优势(38.5 对 4.7,40.0 对 0.4)是全文最能体现动作价值的数字之一。
表 10:Robota-Embed 分来源的检索结果。召回率和 MRR 为百分比;平均排名越低越好。总体中位排名为:片段检索 2,回合检索 1。
| 来源 | R@1 | R@5 | R@10 | MRR | 中位排名 | 平均排名 |
| 片段级检索 | ||||||
| EgoDex | 36.70 | 96.60 | 99.30 | 62.22 | 2 | 2.68 |
| DROID | 74.10 | 99.00 | 100.00 | 85.27 | 1 | 1.41 |
| LIBERO | 38.50 | 87.00 | 96.60 | 60.33 | 2 | 2.92 |
| RoboMIND-FD | 40.00 | 85.00 | 91.90 | 60.39 | 2 | 3.87 |
| 平均 | 47.33 | 91.90 | 96.95 | 67.05 | – | 2.72 |
| 回合级检索 | ||||||
| EgoDex | 87.06 | 98.94 | 99.44 | 90.98 | 1 | 1.54 |
| DROID | 99.88 | 100.00 | 100.00 | 99.94 | 1 | 1.00 |
| LIBERO | 67.62 | 91.81 | 98.19 | 77.42 | 1 | 2.17 |
| RoboMIND-FD | 72.50 | 88.88 | 94.62 | 79.50 | 1 | 2.80 |
| 平均 | 81.77 | 94.91 | 98.06 | 86.96 | – | 1.88 |
原表注:Robota-Embed retrieval by source. Recall and MRR are percentages; lower mean ranks are better. Overall median ranks are 2 for clip retrieval and 1 for episode retrieval.
表 10 解读
上半是片段级,下半是回合级;每行一个来源,最后是四来源等权平均。平均值可验算:片段级 (36.70+74.10+38.50+40.00)/4=47.33,回合级 (87.06+99.88+67.62+72.50)/4=81.77,与表 1 一致。中位排名 2 意味着在三个来源上,至少一半查询的正确片段排在第 2 名或更前;平均排名 2.72 说明错位通常只有一两名。几个细节:EgoDex 的 R@5 高达 96.6%,但 R@1 只有 36.7%,这是“同回合相邻窗口”干扰最典型的样子,正确答案几乎总在前 5 名,却常常输给邻居。RoboMIND-FD 的 R@10 只有 91.9%,平均排名 3.87 也是最差的,说明在指令很少的来源上,确实有约 8% 的查询连前 10 都进不去。
表 11:不含动作的 VL 基线分来源结果。共享候选库上的召回率和 MRR(%)。平均对各来源等权;回合级指标先在每个回合内平均。
| 片段级 | 回合级 | |||||||
| 来源 | R@1 | R@5 | R@10 | MRR | R@1 | R@5 | R@10 | MRR |
| VLM2Vec-V2 | ||||||||
| EgoDex | 32.40 | 92.00 | 99.20 | 56.90 | 78.13 | 97.81 | 99.88 | 86.04 |
| DROID | 58.70 | 97.80 | 99.90 | 75.15 | 99.19 | 100.00 | 100.00 | 99.51 |
| LIBERO | 4.70 | 16.20 | 28.10 | 12.68 | 10.75 | 30.44 | 46.25 | 22.01 |
| RoboMIND-FD | 0.40 | 1.40 | 3.00 | 1.96 | 1.19 | 3.94 | 6.94 | 3.95 |
| 平均 | 24.05 | 51.85 | 57.55 | 36.67 | 47.31 | 58.05 | 63.27 | 52.88 |
| WeMM-Embedding-2B | ||||||||
| EgoDex | 30.80 | 90.20 | 98.50 | 54.54 | 70.31 | 96.25 | 99.63 | 80.22 |
| DROID | 61.10 | 98.40 | 100.00 | 77.18 | 99.69 | 100.00 | 100.00 | 99.84 |
| LIBERO | 4.30 | 18.30 | 30.30 | 13.31 | 9.00 | 28.56 | 44.31 | 20.05 |
| RoboMIND-FD | 0.30 | 1.70 | 3.80 | 2.09 | 1.25 | 4.44 | 8.75 | 4.20 |
| 平均 | 24.13 | 52.15 | 58.15 | 36.78 | 45.06 | 57.31 | 63.17 | 51.08 |
原表注:Action-free VL baselines by source. Recall and MRR are percentages on the shared gallery. Average weights sources equally; episode-level metrics first average within each episode.
表 11 解读
两个基线的结构完全相同,可以和表 10 逐格对照。在 EgoDex 和 DROID 上,基线与本文模型相差不大:EgoDex 片段级 R@1 为 32.4/30.8 对 36.7,DROID 为 58.7/61.1 对 74.1,回合级 DROID 都在 99% 以上。在 LIBERO 和 RoboMIND-FD 上,基线几乎失效:RoboMIND-FD 片段级 R@1 只有 0.3–0.4%,R@10 也只有 3–4%;而 RoboMIND-FD 上与查询同指令的候选平均有 473.6 个(表 13),随机排序的 R@10 约为 10/473.6\approx2\%,基线只比随机略好。所以表 1 中“基线约 24%、本文 47%”的平均差距主要来自后两个来源:以 VLM2Vec-V2 为例,四个来源上的差距分别为 4.3、15.4、33.8、39.6 个点,平均 23.3,其中约八成来自 LIBERO 和 RoboMIND-FD;在 EgoDex 上本文的优势很小。平均值验算:VLM2Vec-V2 片段级 (32.40+58.70+4.70+0.40)/4=24.05,与表 1 中的 24.1 一致。
B.3候选语言与候选库对照(Candidate Language and Gallery Controls)
原文
Two evaluation-time controls on Robota-Embed-Bench test reliance on candidate language and discrimination among clips with the same instruction. Queries and targets come from held-out episodes excluded from training, but retain within-episode visual continuity.
译文
在 Robota-Embed-Bench 上,我们用两种评测时对照来检验模型对候选端语言的依赖,以及在同一指令的片段之间做区分的能力。查询和目标来自未参与训练的留出回合,但保留了回合内部的视觉连续性。
解释
“保留回合内部的视觉连续性”是在提醒:同一回合的查询与候选在画面上天然相似(同一场景、同一光照),所以即使没有文本,视觉也能提供“同一回合”的线索。这是表 14 中遮掉文本后仍有一定回合级召回的原因之一。
原文
Both controls use the same fixed Robota-Embed model. Candidate text masking replaces each gallery instruction with an empty prompt before multimodal fusion, then recomputes embeddings while preserving candidate video and action. Same-instruction gallery restricts each query to candidates with the same instruction, testing within-instruction ranking. The original protocol and candidate-text masking both retain the full shared 8,000-item cross-source gallery.
译文
两种对照使用同一个固定的 Robota-Embed 模型。候选文本遮挡在多模态融合之前把每个候选的指令替换为空提示,然后在保留候选视频和动作的情况下重新计算嵌入。同指令候选库把每条查询的候选限制为与其指令相同的那些,用来检验同一指令内部的排序能力。原始协议和候选文本遮挡都保留完整的、跨来源共享的 8,000 条目候选库。
解释
两种对照都只改评测,不重新训练。注意遮挡的是候选端文本,查询端仍有文本;因此“遮挡后 12.78%”测的是“只用候选的视频和动作,能否与带文本的查询对上”,模型训练时从未见过这种不对称的输入,分数下降中有一部分来自分布偏移。
表 12:汇总的基准有效性对照。候选文本遮挡和同指令检索都使用固定的模型。召回率和 MRR(%)为四个来源的等权平均。
| 片段级 | 回合级 | |||||||
| 设定 | R@1 | R@5 | R@10 | MRR | R@1 | R@5 | R@10 | MRR |
| 原始协议 | 47.33 | 91.90 | 96.95 | 67.05 | 81.77 | 94.91 | 98.06 | 86.96 |
| 遮挡候选文本 | 12.78 | 33.65 | 43.10 | 23.06 | 23.17 | 36.83 | 46.69 | 30.32 |
| 同指令候选库 | 47.62 | 92.45 | 97.25 | 67.46 | 82.53 | 95.23 | 98.20 | 87.55 |
原表注:Aggregate benchmark-validity controls. Candidate-text masking and same-instruction retrieval use a fixed model. Recall and MRR (%) are averaged equally across four sources.
表 12 解读
三行分别是原始协议、遮挡候选文本、只在同指令候选中检索。遮挡文本使所有指标大幅下降,片段级 R@1 从 47.33 降到 12.78,回合级从 81.77 降到 23.17,说明候选端的语言是模型最依赖的线索。同指令候选库的各项指标都略高于原始协议(R@1 高 0.29,R@5 高 0.55),这是预料之中的,因为它的候选集是原始候选集的子集,正确答案的排名只可能上升或不变。这么小的差距说明:在原始协议下排在正确答案前面的干扰项,几乎全是与查询同指令的候选。
原文
Candidate text masking lowers clip-level R@1 from 47.33% to 12.78% and episode-level R@1 from 81.77% to 23.17%. The model relies on candidate language for current-to-future alignment: masked and original candidate embeddings have a mean cosine similarity of 0.506.
译文
遮挡候选文本使片段级 R@1 从 47.33% 降到 12.78%,回合级 R@1 从 81.77% 降到 23.17%。模型在“当前到未来”的对齐中依赖候选语言:遮挡后的候选嵌入与原始候选嵌入之间的平均余弦相似度只有 0.506。
解释
余弦相似度 0.506 意味着遮掉文本后,候选向量的方向偏转了约 60 度(\arccos0.506\approx59.6^\circ),表示发生了很大变化。这从另一个角度说明语言在融合表示中占的比重很大。
原文
Restricting the gallery to the same instruction yields 47.62% clip-level R@1, approximately 0.3 percentage points above the original protocol after removing different-instruction distractors. The retained candidates share the instruction, so ranking them depends on their visual and action content. Nearby same-episode distractors further require precise localization of the paired future clip.
译文
把候选库限制为同一指令后,片段级 R@1 为 47.62%,在去掉不同指令的干扰项后比原始协议高约 0.3 个百分点。保留下来的候选共享同一条指令,因此对它们的排序取决于视觉和动作内容。同回合的邻近干扰项还要求精确定位到配对的未来片段。
解释
作者在这里如实说明了“高 0.3 点是因为去掉了干扰项”,与正文第 4.1 节“仍然得到 47.62%”的措辞相比,这里更准确。
表 13:同指令候选库的难度。按查询划定的候选库中的候选数量,以及片段级召回率(%)。随机召回使用同样受限的候选。最后一行对各来源的均值和召回率等权平均;其候选中位数是跨来源汇总的中位数。RoboMIND-FD 即 RoboMIND–Franka-dual。
| 候选数 | R@1 | R@5 | ||||
| 来源 | 均值 | 中位数 | 模型 | 随机 | 模型 | 随机 |
| EgoDex | 4.06 | 4 | 37.60 | 29.76 | 98.40 | 95.09 |
| DROID | 2.71 | 2 | 74.20 | 54.64 | 99.20 | 97.46 |
| LIBERO | 54.51 | 50 | 38.60 | 1.90 | 87.00 | 9.50 |
| RoboMIND-FD | 473.59 | 342 | 40.10 | 0.24 | 85.20 | 1.19 |
| 全部来源 | 133.72 | 25 | 47.62 | 21.63 | 92.45 | 50.81 |
原表注:Same-instruction gallery difficulty. Candidate counts and clip-level recall (%) within query-specific galleries. Random recall uses the same restricted candidates. The final row averages source means and recalls equally; its candidate median is the cross-source aggregate. RoboMIND-FD denotes RoboMIND–Franka-dual.
表 13 解读
“候选数”是每条查询的同指令候选库大小。随机 R@1 是对每条查询取 1/n 再平均,所以 EgoDex 的随机 R@1(29.76%)略高于 1/4.06\approx24.6\%。这张表把四个来源分成了两类。EgoDex、DROID:每条查询只有 2–4 个同指令候选,通常就是正确片段、它的邻居,再加上同回合的另一两段;随机就能拿到 30–55% 的 R@1,R@5 随机也有 95% 以上,模型只比随机高 8–20 个点。LIBERO、RoboMIND-FD:候选多达几十到几百个,随机 R@1 只有 1.9% 和 0.24%,模型达到 38.6% 和 40.1%,这才是“在同一指令内部区分不同后续”能力的有力证据。全部来源一行的均值 133.72 =(4.06+2.71+54.51+473.59)/4,随机 R@1 21.63 =(29.76+54.64+1.90+0.24)/4,可以验算。
原文
Same-instruction pools are small in EgoDex and DROID, so R@5 approaches saturation. LIBERO and RoboMIND-FD have larger pools, averaging 54.51 and 473.59 candidates. Their R@1 scores of 38.60% and 40.10% exceed the corresponding random rates of 1.90% and 0.24%.
译文
EgoDex 和 DROID 的同指令候选池很小,所以 R@5 接近饱和。LIBERO 和 RoboMIND-FD 的候选池更大,平均分别有 54.51 和 473.59 个候选。它们 38.60% 和 40.10% 的 R@1 远超对应的随机比率 1.90% 和 0.24%。
解释
作者只用后两个来源论证,前两个来源的同指令对照基本不提供信息,这一点在表 13 的解读中已说明。
表 14:分来源的基准有效性对照。召回率和 MRR 为百分比。候选文本遮挡保留了视频和动作;同指令检索限制每条查询的候选库。原始协议的结果见表 10。回合级指标采用第 3.3 节的回合内与来源内汇总方式。
| 片段级 | 回合级 | |||||||
| 来源 | R@1 | R@5 | R@10 | MRR | R@1 | R@5 | R@10 | MRR |
| 遮挡候选文本 | ||||||||
| EgoDex | 4.00 | 14.30 | 21.40 | 9.73 | 9.00 | 16.81 | 24.75 | 13.62 |
| DROID | 4.40 | 13.30 | 21.20 | 9.69 | 6.50 | 16.81 | 25.25 | 12.57 |
| LIBERO | 13.40 | 36.40 | 49.30 | 25.03 | 23.19 | 39.56 | 53.87 | 32.09 |
| RoboMIND-FD | 29.30 | 70.60 | 80.50 | 47.77 | 54.00 | 74.12 | 82.88 | 63.01 |
| 同指令候选库 | ||||||||
| EgoDex | 37.60 | 98.40 | 100.00 | 63.59 | 89.69 | 100.00 | 100.00 | 92.99 |
| DROID | 74.20 | 99.20 | 100.00 | 85.34 | 100.00 | 100.00 | 100.00 | 100.00 |
| LIBERO | 38.60 | 87.00 | 96.80 | 60.41 | 67.69 | 91.81 | 98.19 | 77.47 |
| RoboMIND-FD | 40.10 | 85.20 | 92.20 | 60.51 | 72.75 | 89.12 | 94.62 | 79.73 |
原表注:Benchmark-validity controls by source. Recall and MRR are percentages. Candidate-text masking preserves video and action; same-instruction retrieval restricts each query's gallery. Original-protocol results are in Table 10. Episode-level metrics use the within-episode and per-source reducer from Section 3.3.
表 14 解读
上半部分最有信息量。遮挡候选文本后,四个来源的下降幅度相差悬殊:EgoDex 片段级 R@1 从 36.7 降到 4.0,DROID 从 74.1 降到 4.4,几乎归零;LIBERO 从 38.5 降到 13.4;RoboMIND-FD 只从 40.0 降到 29.3。这与各来源的指令数(591、800、39、5)正好对应:指令越多样,文本携带的“回合身份”信息越多,模型就越依赖它;RoboMIND-FD 只有 5 条指令,文本本来就提供不了多少区分信息,模型主要靠视频和动作,所以遮掉文本影响最小。由此可以得出一个正文没有明说的结论:在 EgoDex 和 DROID 上,模型的高分很大程度上依赖候选文本这一捷径;真正考验视频与动作匹配能力的是 RoboMIND-FD,模型在那里不靠文本也有 29.3% 的片段级 R@1。下半部分的同指令结果每一格都不低于表 10 的对应值,符合“子集只会让排名上升”的预期。
B.4受控的 Robota-Embed 消融实验(Controlled Robota-Embed Ablations)
原文
Retraining tests how well each input set supports retrieval; query masking tests a fixed model's reliance on its inputs. Retraining uses matched DROID splits and budgets, with clip-level metrics (%). Tables 15 and 20 report four-source averages for frozen-feature adaptation and final-model masking.
译文
重新训练检验每种输入组合能在多大程度上支持检索;查询遮挡检验一个固定模型对其输入的依赖。重新训练使用匹配的 DROID 划分和预算,报告片段级指标(%)。表 15 和表 20 报告的是四来源平均,分别对应冻结特征的适配和最终模型的遮挡。
解释
本节的六张表口径不同,阅读时要分清:表 15 和表 20 是四来源基准上的最终模型;表 16–19 是在 DROID 单来源的受控划分上重新训练的变体。两组数字的绝对值不可直接比较。
B.4.1检索适配(Retrieval Adaptation)
表 15:检索适配。在共享的 Robota-Embed-Bench 候选库上的四来源平均检索结果(%)。冻结读出与 Robota-Embed 使用相同的 VLA 查询/目标字段。
| 设定 | 片段 R@1 | 回合 R@1 |
| Cosmos3-Edge 4B(冻结读出) | 0.65 | 1.17 |
| Robota-Embed | 47.33 | 81.77 |
原表注:Retrieval adaptation. Four-source average retrieval (%) on the shared Robota-Embed-Bench gallery. The frozen readout and Robota-Embed use the same VLA query/target fields.
表 15 解读
冻结的 Cosmos3-Edge 特征只有 0.65% 的片段级 R@1,大约是随机水平(1/8000=0.0125\%)的 50 倍,但远低于任何统一 VL 基线(约 24%),甚至低于只用文本的 CLIP(1.2%)。也就是说,一个生成式世界模型的内部特征虽然“看到”了三种模态,却完全不适合直接拿来比较相似度。所有检索能力都来自检索训练。
原文
Frozen Cosmos3-Edge features provide 0.65% clip-level R@1 and 1.17% episode-level R@1. Retrieval training raises these scores to 47.33% and 81.77%, respectively. The pretrained features contain all three modalities, but retrieval training is needed to compare present states with recorded continuations effectively.
译文
冻结的 Cosmos3-Edge 特征给出 0.65% 的片段级 R@1 和 1.17% 的回合级 R@1。检索训练把它们分别提升到 47.33% 和 81.77%。预训练特征包含全部三种模态,但要有效地比较当前状态与记录下来的后续,需要检索训练。
解释
这里的两端都用相同的读出方式,但查询端是“单帧+短动作”,目标端是“16 帧+长动作序列”,两者在冻结的骨干中形成的表示分布不同,余弦相似度自然无法对齐。这正是需要两端适配器和对比训练的原因。
B.4.2可训练范围(Trainable Scope)
表 16:可训练范围。受控 DROID 划分上的片段级检索(%)。两行都使用一个学习得到的检索头;第二行还更新骨干网络。
| 可训练范围 | R@1 | MRR |
| 仅检索头 | 13.8 | 24.00 |
| 骨干 + 检索头 | 78.7 | 88.00 |
原表注:Trainable scope. Clip-level retrieval on the controlled DROID split (%). Both rows use a learned retrieval head; the second also updates the backbone.
表 16 解读
两行的差别只在骨干网络是否参与训练。只训练检索头时 R@1 为 13.8%,比冻结读出好得多,但仍远低于全模型训练的 78.7%。结合附录 A.1 中骨干学习率只有 3\times10^{-7} 这一事实,说明骨干参数的微小调整对检索至关重要:仅在顶层加线性映射,无法把“当前”和“未来”两种表示对齐到同一空间。
原文
Training a retrieval head over the frozen backbone reaches 13.8% R@1, whereas training the backbone and head reaches 78.7%. Under matched DROID training, adapting the shared representation is much more effective than learning a readout from fixed features.
译文
在冻结骨干之上训练检索头达到 13.8% 的 R@1,而同时训练骨干和检索头达到 78.7%。在匹配的 DROID 训练下,适配共享表示远比在固定特征上学习一个读出有效。
解释
这一结论对实际使用有指导意义:想把一个现成的视频—动作模型改造成检索器,不能只加一个头,必须端到端地微调。
B.4.3目标组(Objective Groups)
表 17:目标组。受控 DROID 划分上的片段级检索(%)。每一行在上一行基础上加入式 (2) 中的一组目标。
| 目标(式 (2)) | R@1 | MRR |
| \mathcal{L}_{\mathrm{align}} | 75.6 | 86.20 |
| \mathcal{L}_{\mathrm{align}}+\mathcal{L}_{\mathrm{reg}} | 77.0 | 87.10 |
| \mathcal{L}_{\mathrm{align}}+\mathcal{L}_{\mathrm{ground}}+\mathcal{L}_{\mathrm{reg}} | 78.7 | 88.00 |
原表注:Objective groups. Clip-level retrieval on the controlled DROID split (%). Each row adds an objective group from Equation 2.
表 17 解读
这是累加式消融:先只用对齐损失,再加正则化,再加落地与判别。每一步分别加 1.4 和 1.7 个点。表中没有给出“只加 \mathcal L_{\text{ground}} 不加 \mathcal L_{\text{reg}}”的组合,所以无法判断两组目标之间是否有交互作用。另外没有报告随机种子间的方差;在 DROID 测试集上,1–2 个点的差异是否稳定无从判断。值得注意的是,第 1 节和第 3.2 节花了很多篇幅介绍 \mathcal L_{\text{ground}} 的各种交换与硬负样本设计,但它在这一划分上只带来 1.7 个点,主要的检索能力来自最朴素的对齐损失。
原文
Predictive retrieval alignment alone reaches 75.6% R@1. Adding representation regularization raises R@1 to 77.0%, and adding multimodal grounding and discrimination reaches 78.7%. R@10 is 100.0% throughout these three runs. Predictive alignment already places the correct clip near the top; the added objective groups improve its rank among those closest candidates.
译文
仅用预测检索对齐就达到 75.6% 的 R@1。加入表示正则化后 R@1 升到 77.0%,再加入多模态落地与判别后达到 78.7%。三次运行的 R@10 都是 100.0%。预测对齐已经把正确片段排到很靠前的位置;新增的目标组改善的是它在那些最接近的候选之间的排名。
解释
R@10 始终为 100% 说明在 DROID 上,正确片段总能进入前 10;这与 DROID“每条指令只对应 2–3 个候选”的特点有关(表 13),前 10 名里通常只有几个同指令的候选需要区分。
B.4.4视觉输入(Visual Input)
表 18:视觉输入。受控 DROID 划分上的片段级检索(%)。每一行都针对其所述的视觉接口重新训练。
| 视觉输入 | R@1 | MRR |
| 无视觉(重新训练) | 76.8 | 86.69 |
| 整帧画面 | 77.9 | 87.40 |
| SAM3 物体放大图 | 78.7 | 88.00 |
原表注:Visual input. Clip-level retrieval on the controlled DROID split (%). All rows are retrained for their stated visual interface.
表 18 解读
三行都是重新训练的模型,只改变查询端的视觉输入。三者之间的差距很小:无视觉 76.8,整帧 77.9,SAM3 放大图 78.7,相邻两行之间只差约 1 个点。这张表最重要的读法其实是第一行:在 DROID 上,完全不用视觉也能达到 76.8%,说明视觉在这个划分上几乎是冗余的。SAM3 放大图的增益(0.8 点)是“小而一致”的方向性证据,作者自己的措辞也是“modest”。
原文
The no-vision, full-frame, and SAM3 object-zoom settings reach 76.8%, 77.9%, and 78.7% R@1, respectively. Their MRR values are 86.69%, 87.40%, and 88.00%. SAM3 object zoom gives the highest R@1 and MRR among these matched DROID retrieval variants, with a modest 0.8-point R@1 gain over the full frame. Cropping to the interaction region gives a small improvement in clip localization.
译文
无视觉、整帧和 SAM3 物体放大三种设定的 R@1 分别为 76.8%、77.9% 和 78.7%,MRR 分别为 86.69%、87.40% 和 88.00%。在这些匹配的 DROID 检索变体中,SAM3 物体放大的 R@1 和 MRR 都最高,比整帧画面高出幅度不大的 0.8 个点。裁剪到交互区域对片段定位有小幅改善。
解释
SAM3 放大的代价是推理时多一个检测模型的调用(附录 B.6 的延迟不包括这部分)。0.8 个点的收益与这一额外开销相比是否值得,取决于应用场景,原文没有讨论。
B.4.5训练时的模态(Training-Time Modalities)
表 19:训练时的模态。去掉一种模态后,在匹配的 DROID 设置下重新训练的结果(%)。V/L/A 分别表示视觉、语言和动作。
| 设定 | 输入 | 片段 R@1 | \Delta 片段 R@1 |
| 完整 VLA | VLA | 78.7 | — |
| 去掉动作 | VL | 59.8 | -18.9 |
| 去掉视觉 | LA | 76.8 | -1.9 |
| 去掉语言 | VA | 20.2 | -58.5 |
原表注:Training-time modalities. Matched DROID retraining after removing one modality (%). V/L/A denote vision, language, and action.
表 19 解读
这是全文“动作有用”最直接的受控证据:同样的数据、骨干和训练预算,去掉动作后 R@1 从 78.7 降到 59.8。按重要性排序:语言(-58.5)> 动作(-18.9)> 视觉(-1.9)。“去掉视觉”一行与表 18 第一行是同一个模型(76.8)。需要结合 DROID 的特点理解:DROID 的 800 个回合各有一条独特的指令,语言几乎能直接确定回合,所以去掉语言损失最大;在确定回合之后,还要在同一回合的相邻窗口中选出正确的那个,此时动作(运动方向和阶段)比画面更有区分力,这就是动作排第二、视觉几乎冗余的原因。在指令很少的 RoboMIND-FD 上,三种模态的相对重要性可能完全不同,但原文只在 DROID 上做了重新训练。
原文
Removing action lowers R@1 from 78.7% to 59.8%, a drop of 18.9 percentage points. Removing language has the largest effect, while retraining without vision lowers R@1 by 1.9 points. Native action supplies retrieval signal beyond vision and language in this controlled DROID study.
译文
去掉动作使 R@1 从 78.7% 降到 59.8%,下降 18.9 个百分点。去掉语言的影响最大,而去掉视觉重新训练只让 R@1 下降 1.9 个点。在这一受控的 DROID 研究中,原生动作提供了视觉和语言之外的检索信号。
解释
作者把结论限定在“这一受控的 DROID 研究中”,措辞是准确的。
B.4.6推理时的模态可用性(Inference-Time Modality Availability)
表 20:推理时的模态可用性。固定最终检查点和候选库,四来源平均的检索结果(%)。只改变查询端的输入。V/L/A 表示视觉/语言/动作;\Delta 为相对完整 VLA 的片段级 R@1 百分点变化。
| 查询输入 | 片段 R@1 | 回合 R@1 | \Delta 片段 R@1 |
| 完整 VLA | 47.33 | 81.77 | — |
| VL(无动作) | 20.08 | 37.36 | -27.25 |
| LA(无视觉) | 23.00 | 39.50 | -24.33 |
| VA(无语言) | 7.13 | 14.73 | -40.20 |
| L(仅文本) | 16.23 | 31.09 | -31.10 |
| V(仅图像) | 1.68 | 3.66 | -45.65 |
| A(仅动作) | 0.53 | 1.58 | -46.80 |
原表注:Inference-time modality availability. Four-source average retrieval (%) with the final checkpoint and gallery fixed. Only the query inputs are changed. V/L/A denote vision/language/action; \Delta gives the percentage-point change in clip-level R@1 from Full VLA.
表 20 解读
这是图 1 左中“模态贡献”的完整版。上面三行是去掉一种模态,下面三行是只保留一种模态。几个值得注意的现象:(1) 去掉任何一种模态,R@1 都至少减半,说明最终模型高度依赖三者的组合;(2) 只用文本(16.23)比“视觉+动作”(7.13)还高,再次说明语言是最强的单一线索;(3) 只用图像(1.68)或只用动作(0.53)几乎无法检索,与附录 A.2 停用“仅动作”辅助项的设计一致;(4) VL 与 LA 的差距只有 2.9 个点,“去掉动作比去掉视觉更糟”的结论在四来源平均上成立,但幅度不大。还有一个反直觉的现象:“L(仅文本)”为 16.23,而“VL(无动作)”为 20.08、“LA(无视觉)”为 23.00,三者差距不大,说明在动作或视觉缺失时,模型基本退化成主要依赖文本的检索。作者提醒,这些下降中有一部分来自遮挡造成的输入分布偏移,模型训练时从未见过缺模态的查询。
原文
Withholding query action, image, or text lowers clip-level R@1 by 27.25, 24.33, or 40.20 percentage points, respectively. Full VLA ranks highest at both clip and episode levels. The final model uses all three query modalities; the drops also reflect the input distribution shift caused by masking. Text alone reaches 16.23% clip-level R@1; image-only and action-only queries yield 1.68% and 0.53%. No single query modality reproduces the fused VLA representation under this fixed-model protocol.
译文
拿掉查询中的动作、图像或文本,片段级 R@1 分别下降 27.25、24.33 和 40.20 个百分点。完整 VLA 在片段和回合两个层级上都最高。最终模型使用了全部三种查询模态;这些下降也反映了遮挡带来的输入分布偏移。仅用文本时片段级 R@1 为 16.23%;仅用图像和仅用动作的查询分别只有 1.68% 和 0.53%。在这种固定模型的协议下,没有任何单一查询模态能重现融合的 VLA 表示。
解释
这里的“下降”与表 19 的“下降”含义不同:表 19 是重新训练后的能力上限,这里是同一个模型突然缺了输入。最后一句的限定语“在这种固定模型的协议下”很重要,它并不否认单独训练一个单模态模型可能做得更好。
B.5受控 DROID 查询遮挡(Controlled DROID Query Masking)
原文
We mask inputs to the fixed DROID Full VLA model and compare its response with the retrained variants in Table 19. This test uses the controlled DROID checkpoint and split, whereas Table 20 uses the final checkpoint across four sources.
译文
我们对固定的 DROID 完整 VLA 模型遮挡输入,并把它的反应与表 19 中重新训练的变体进行比较。这个测试使用受控的 DROID 检查点和划分,而表 20 使用的是四来源上的最终检查点。
解释
这一节补上了一个“对齐口径”的对照:表 19(重新训练)和表 20(遮挡)原本数据范围不同,无法直接比较;这里在同一个 DROID 模型、同一个划分上做遮挡,就能与表 19 一一对应。
表 21:DROID 仅查询端遮挡。在模型和候选嵌入都固定的情况下,片段级召回率和 MRR(%)。\Delta R@1 为相对完整查询的百分点变化。
| 查询设定 | 输入 | R@1 | R@5 | R@10 | MRR | \Delta R@1 |
| 完整查询 | VLA | 78.7 | 99.4 | 100.0 | 88.00 | \mathbf{0.0} |
| 遮挡动作 | VL | 50.7 | 90.3 | 94.9 | 67.60 | -28.0 |
| 遮挡图像 | LA | 60.9 | 91.8 | 96.1 | 74.17 | -17.8 |
| 遮挡文本 | VA | 1.9 | 7.2 | 12.0 | 5.41 | -76.8 |
原表注:DROID query-only masking. Clip-level recall and MRR (%) with the model and gallery embeddings fixed. \Delta R@1 gives the percentage-point change from the full VLA query.
表 21 解读
与表 19 逐行对照:去掉动作,重新训练为 59.8,遮挡为 50.7;去掉视觉,重新训练为 76.8,遮挡为 60.9;去掉语言,重新训练为 20.2,遮挡为 1.9。遮挡的损失总是大于重新训练,因为重新训练的模型能用剩余模态补偿,而遮挡后的模型只能面对训练时没见过的输入。两种口径下“动作比视觉更重要”的排序都成立,这是作者所说的“两种视角下一致”的依据。遮挡文本几乎让检索完全失效(1.9%),与 DROID 指令唯一对应回合的特点一致。
原文
Conclusion. Masking action, image, or text lowers clip-level R@1 from 78.7% to 50.7%, 60.9%, or 1.9%, respectively. Removing text has the largest effect, followed by action and image. The larger effect of removing action than vision is shared by the retraining and masking studies. No-vision retraining reaches 76.8% R@1, whereas masking vision in the full model yields 60.9%. Retraining permits adaptation to the remaining inputs; masking tests the fixed model's reliance on its inputs, including sensitivity to distribution shift. The small no-vision retraining gap therefore does not imply that the full model ignores vision.
译文
结论。遮挡动作、图像或文本,片段级 R@1 分别从 78.7% 降到 50.7%、60.9% 和 1.9%。去掉文本的影响最大,其次是动作,再次是图像。“去掉动作的影响大于去掉视觉”这一点在重新训练和遮挡两类研究中是一致的。去掉视觉重新训练可达 76.8% 的 R@1,而在完整模型中遮挡视觉只有 60.9%。重新训练允许模型适应剩余的输入;遮挡检验的是固定模型对其输入的依赖,包括对分布偏移的敏感性。因此,去掉视觉重新训练的差距很小,并不意味着完整模型忽略了视觉。
解释
这一段重复了第 4.2 节和第 6 节的论证,但这里有了同一划分上的数字,论证更完整。
B.6索引规模扩展与检索延迟(Index-Size Scaling and Retrieval Latency)
原文
Table 22 measures query encoding and Top-10 search over precomputed galleries on one NVIDIA A100. Timings exclude SAM3 preprocessing, reranking, policy inference, and robot execution. Throughput is the reciprocal of total latency; GPU memory is estimated. Encoding takes 157.70 ms at every scale, while expanding the gallery from one million to 15 million entries adds 34.81 ms to search latency. Retrieval quality is evaluated separately on the 8,000-entry benchmark.
译文
表 22 在一张 NVIDIA A100 上测量查询编码和在预先计算好的候选库上做 Top-10 搜索的时间。计时不包括 SAM3 预处理、重排序、策略推理和机器人执行。吞吐量是总延迟的倒数;GPU 显存是估计值。在所有规模下,编码都需要 157.70 ms;把候选库从 100 万条扩大到 1,500 万条,搜索延迟增加 34.81 ms。检索质量则另外在 8,000 条目的基准上评测。
解释
验算:37.47-2.66=34.81 ms,与原文一致;每个规模下“编码 + 检索”减去“Top-10 搜索”都等于 157.70 ms。最后一句很重要:这里只测了速度,没有测在 1,500 万条的大库里检索准确率会下降多少;基准只有 8,000 条,大库中的干扰项会多得多。
表 22:在一张 NVIDIA A100 上的检索扩展。测量的延迟包括“仅 Top-10 搜索”和“查询编码加搜索”两项。吞吐量由后者推出;GPU 显存为估计值。
| 候选库规模 | Top-10 搜索 (ms) | 编码 + 检索 延迟(ms) | 单流 QPS | 估计 GPU 显存(GB) |
| 1M | 2.66 | 160.36 | 6.24 | 11.29 |
| 2M | 5.14 | 162.84 | 6.14 | 15.39 |
| 5M | 12.60 | 170.30 | 5.87 | 27.69 |
| 10M | 25.04 | 182.74 | 5.47 | 48.19 |
| 15M | 37.47 | 195.17 | 5.12 | 68.69 |
原表注:Retrieval scaling on one NVIDIA A100. Measured latencies cover Top-10 search alone and query encoding plus search. Throughput is derived from the latter; GPU memory is estimated.
表 22 解读
QPS(每秒查询数)=1000/延迟,例如 1000/160.36=6.24。搜索时间与库大小成正比,约每百万条 2.5 ms,说明使用的是暴力(精确)最近邻搜索,而不是近似索引。显存的增长约为每百万条 4.1 GB:1,024 维、每维 4 字节的向量每百万条约 4.1 GB,正好吻合(10^6\times1024\times4 字节 \approx4.1 GB);1M 时的 11.29 GB 中约有 7.2 GB 是模型本身。按这个斜率,15M 条需要约 68.7 GB,接近 A100 80 GB 显存的上限。
B.7跨本体的定性分析(Qualitative Cross-Embodiment Analysis)
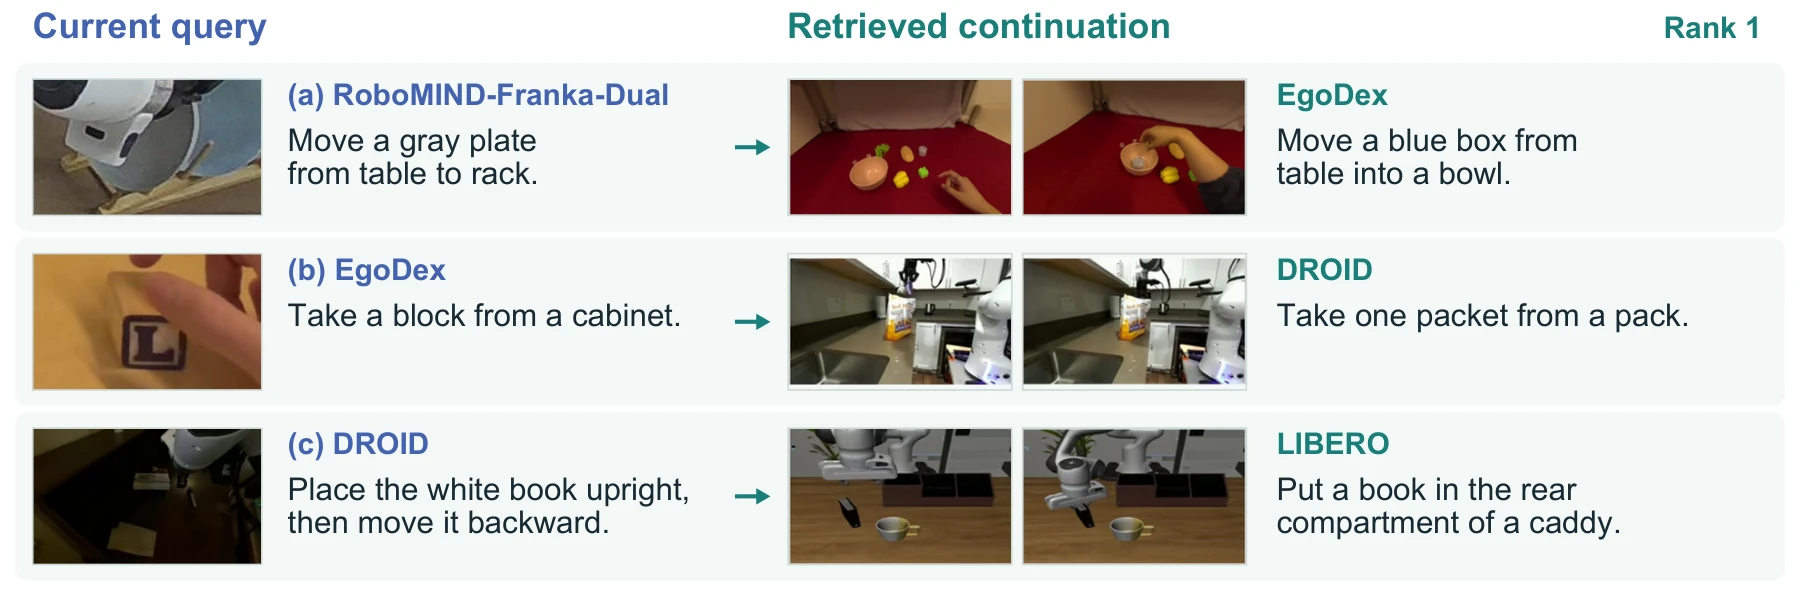
图 8:跨本体的定性证据(精选)。每条查询只在图中所示的目标来源中检索。排名第一的片段与查询在“放置”或“取出”这一角色上相同。
原图注:Selected qualitative evidence across embodiments. Each query searches only the illustrated target source. The top-ranked clips share placement or removal roles with their queries.
图 8 解读
三行三个例子,左边是当前查询,中间是检索到的后续片段(两帧),右边标出来源和指令。(a) RoboMIND 双臂 Franka 的查询“把灰色盘子从桌上放到架子上”,在 EgoDex 中检索到人手“把蓝色盒子从桌上放进碗里”,两者都是“从桌上拿起并放进某处”。(b) EgoDex 的查询“从柜子里拿一个积木”,在 DROID 中检索到“从包里拿出一个小包装”,都是“从容器中取出”。(c) DROID 的查询“把白色书立起来,然后往后移”,在 LIBERO 中检索到“把书放进收纳盒的后格”,都涉及书和“往后放”。这张图的意义在于:基准评测都是来源内部的检索,而这里展示的是跨来源(人\leftrightarrow机器人\leftrightarrow仿真)检索,排名第一的结果在“操作角色”上与查询一致,尽管物体和本体都不同。但正文和下面一段都强调,这是“精选”的例子,来自一个单独的诊断检查点,并不是最终模型,也没有任何定量的跨来源准确率。
原文
Figure 8 presents three selected cases from a diagnostic checkpoint. Each query searches only the illustrated target source, excluding its own. The top-ranked clips share placement or removal roles with their queries across human, robot, and simulated experience.
译文
图 8 展示了来自一个诊断检查点的三个精选案例。每条查询只在图中所示的目标来源中检索,排除它自己的来源。排名第一的片段在人类、机器人和仿真经验之间,与各自的查询共享“放置”或“取出”的角色。
解释
训练时配对只在来源内部构造(第 3.3 节),模型从未被要求把人手动作与机器人动作对齐;跨来源检索能找到语义一致的结果,主要依靠共享的语言和视觉表示。图中三例都有清楚的语义对应,但不知道它们在所有跨来源查询中有多大代表性。
原文
The three cases provide selected qualitative evidence from a separate diagnostic checkpoint. Aggregate cross-source accuracy, prevalence, robustness, and source invariance are outside this analysis.
译文
这三个案例是来自一个独立诊断检查点的精选定性证据。跨来源的总体准确率、此类现象的普遍程度、稳健性以及对来源的不变性,都不在本分析的范围之内。
解释
作者在这里明确划定了结论边界:图 8 只能说明“存在这样的例子”,不能说明模型具有跨本体检索能力。这种如实的限定值得肯定,但也意味着摘要和引言中“统一的检索空间覆盖人类、机器人和仿真经验”的说法,在跨来源层面并没有定量证据。
CEmbed2ICL 的实现与补充结果(Embed2ICL Implementation and Supplementary Results)
原文
This section covers DreamZero's training-free video-cache warm-up and Fast-WAM's training-based Context Tokens, followed by integration controls.
译文
本节介绍 DreamZero 免训练的视频缓存预热和 Fast-WAM 需训练的 Context Tokens,随后给出接入方式的对照实验。
解释
C.1–C.3 对应免训练路线(仿真与 YAM 真机),C.4–C.6 对应需训练路线(接口细节、LIBERO 对照、接入方式消融)。
C.1DreamZero-DROID 的参考预热(Reference Warm-Up)
原文
Embed2ICL initializes frozen DreamZero-DROID's cache with a retrieved and reranked video (Figure 9). Both retrievers use the same GPT-5.6 sol Reranking Agent. All reference conditions use four-second videos. Each Embed2ICL reference contains three synchronized streams at 15 Hz for four seconds (60 frames per view): 45 frames before the detected final gripper release, the release frame, and 14 frames after it. All three streams serve as video-only policy input. Embed2ICL performs one warm-up per applicable task phase and issues eight reference-conditioned policy requests. Live observations then update the rolling cache.
译文
Embed2ICL 用一段经检索和重排序得到的视频初始化冻结的 DreamZero-DROID 的缓存(图 9)。两个检索器使用同一个 GPT-5.6 sol 重排序智能体。所有参考条件都使用 4 秒视频。每段 Embed2ICL 参考包含三路同步的视频流,帧率 15 Hz、时长 4 秒(每个视角 60 帧):检测到的最后一次夹爪松开之前的 45 帧、松开那一帧,以及之后的 14 帧。三路视频流都只作为视频输入提供给策略。Embed2ICL 在每个适用的任务阶段做一次预热,并发出 8 次以参考为条件的策略请求。此后,实时观测会更新滚动缓存。
解释
参考片段的截取方式很有讲究:以“最后一次夹爪松开”为中心,前 3 秒、后约 1 秒(45+1+14=60 帧 =4 秒 \times15 Hz)。这样参考总是包含“把东西放下”的关键时刻,即图注所说的“完成证据”。三路视频流对应 DROID 的三个相机(通常是两个外部相机加一个腕部相机)。“发出 8 次以参考为条件的策略请求”原文没有进一步解释,一种理解是:预热之后的前 8 次推理,缓存里仍有参考帧;之后随着实时观测不断进入,参考帧按先进先出被挤出缓存(图 9 标注缓存长度为 6.6 秒),策略逐渐回到只看自身观测的状态。所以参考只影响执行的开头一段。
原文
The source episode and temporal window remain fixed across all trials for a task, so the experiment evaluates conditioning on a selected task reference. We evaluate the three tasks in Table 2. No warm-up, random reference, both retrievers' top-1, and both reranked conditions each use 100 trials per task, totaling 300 per condition. All share the released DreamZero-DROID policy; only the test-time video reference changes. The top-1 conditions select an episode and recut a four-second reference from its successful stage.
译文
对一个任务的所有试验,参考所来自的源回合和时间窗口都是固定的,因此这个实验评估的是“以一段选定的任务参考为条件”的效果。我们在表 2 的三个任务上评测。无预热、随机参考、两个检索器的 top-1 以及两种重排序条件,每种都是每个任务 100 次试验,每种条件合计 300 次。所有条件共享已发布的 DreamZero-DROID 策略,只有测试时的参考视频不同。top-1 条件选出一个回合,再从其成功阶段重新截取一段 4 秒参考。
解释
最后一句透露了一个容易忽略的细节:top-1 条件并不直接使用检索返回的那个 4 秒片段,而是取它所在的回合,再从该回合的“成功阶段”(夹爪松开附近)重新截取。也就是说,top-1 条件实际利用的是回合级检索结果,片段级的阶段定位在这里不起作用。这与第 4 节强调的“片段级定位是预测式检索的目标”之间存在一定距离:DreamZero 实验检验的主要是“找对回合”的能力。
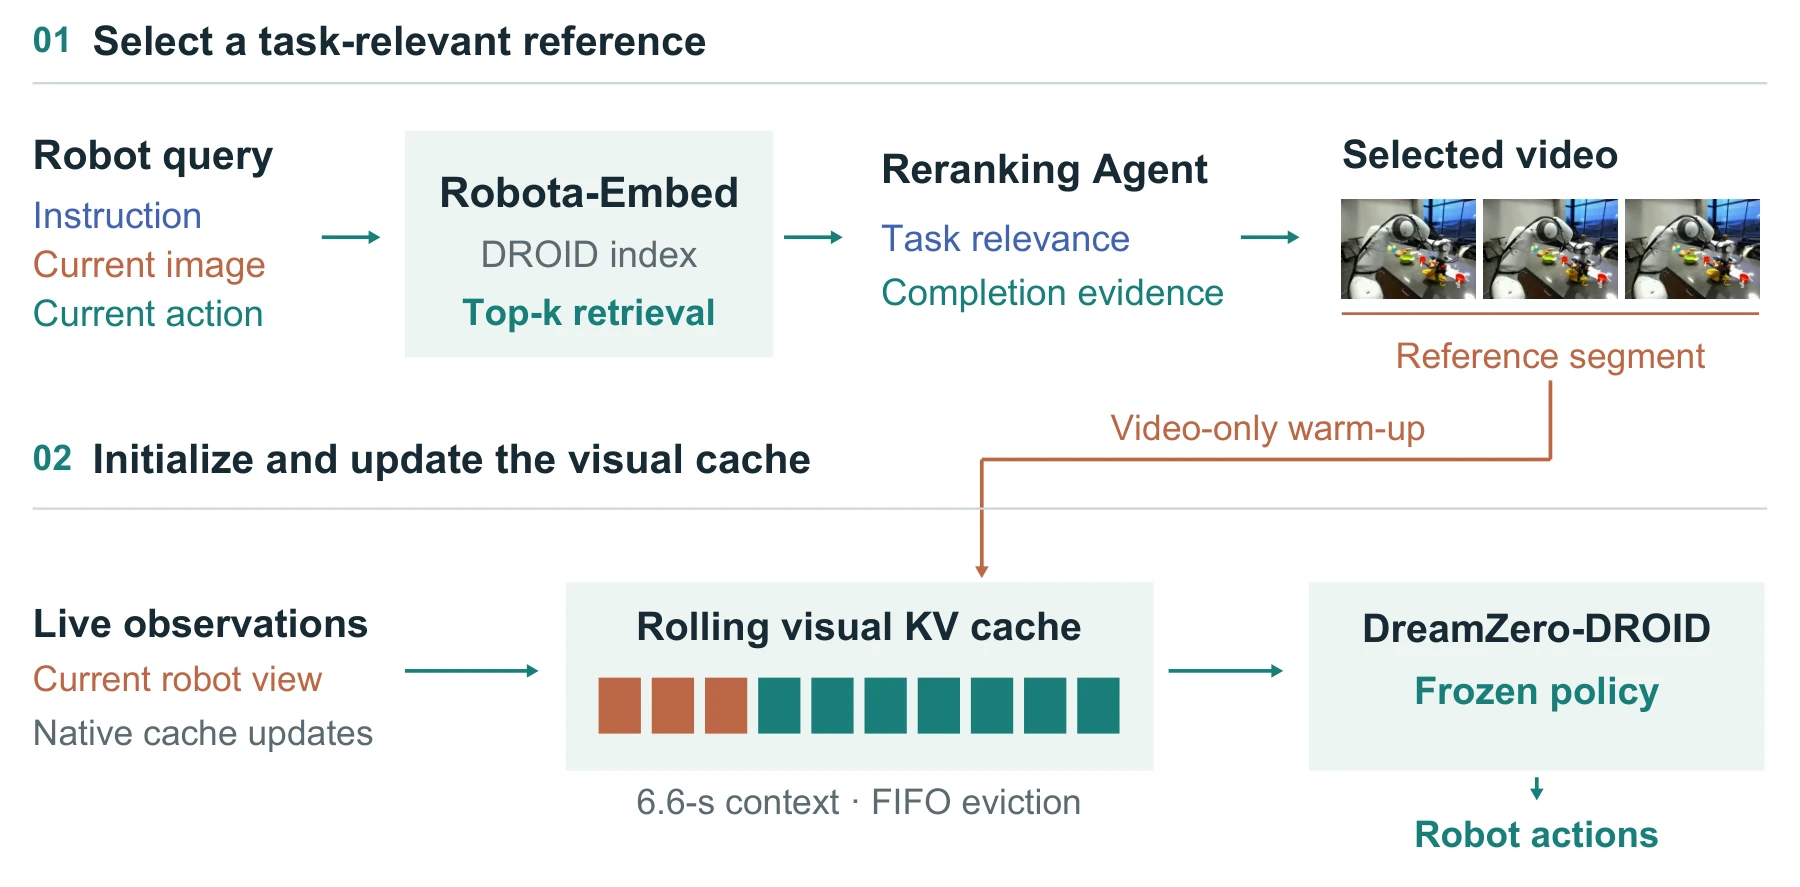
图 9:免训练的 Embed2ICL。Robota-Embed 检索候选 VLA 片段,重排序智能体从中选出一段与任务相关、含有完成证据的参考。参考的视频用于初始化 DreamZero-DROID 的视觉键值(KV)缓存。策略保持冻结,执行过程中实时观测不断更新缓存。
原图注:Training-free Embed2ICL. Robota-Embed retrieves candidate VLA clips, and the Reranking Agent selects a task-relevant reference containing completion evidence. Its video initializes DreamZero-DROID's visual key–value cache. The policy remains frozen while live observations update the cache during execution.
图 9 解读
图分两步。01 选择与任务相关的参考:机器人查询(指令、当前图像、当前动作)\to Robota-Embed 在 DROID 索引中做 top-k 检索 \to 重排序智能体按“任务相关性”和“完成证据”两条标准挑选 \to 得到选中的视频(参考片段)。02 初始化并更新视觉缓存:参考片段以“仅视频预热”(Video-only warm-up)的方式写入滚动视觉 KV 缓存,图中橙色方块是参考帧,绿色方块是实时观测;缓存长 6.6 秒、先进先出(FIFO eviction)。实时观测(当前机器人视角)以原生方式不断写入缓存,冻结的 DreamZero-DROID 读取缓存输出机器人动作。从缓存示意图可以看出,参考帧只占缓存的前一部分,随着执行推进会被挤出。这解释了为什么只用 4 秒参考:缓存总共只有 6.6 秒,参考太长会挤占实时观测的位置。
C.2DreamZero 参考与接口分析(Reference and Interface Analysis)
原文
Figure 10 shows the task-specific DROID warm-up references for full Embed2ICL (Table 2). All three preserve the placement relation while changing the object or receptacle: Cube\rightarrowBowl uses a block-to-bowl example; Can\rightarrowMug uses a cap-to-container analogue; and Banana\rightarrowBin preserves the manipulated object but changes the receptacle. Reranking selects references using completion evidence among other criteria; Table 2 evaluates their usefulness as policy context.
译文
图 10 展示了完整 Embed2ICL(表 2)为每个任务选用的 DROID 预热参考。三者都保留了“放置”关系,同时更换了物体或容器:Cube\rightarrowBowl 用的是“积木放进碗”的例子;Can\rightarrowMug 用的是一个“瓶盖放进容器”的类比;Banana\rightarrowBin 保留了被操作的物体,但换了容器。重排序在选择参考时,“完成证据”是其采用的标准之一;表 2 评估的是这些参考作为策略上下文的实用性。
解释
三个参考都不是目标任务的原样示范:DROID 中没有完全相同的任务,但有结构相同的任务。这正是“检索”而非“查表”的价值所在。“among other criteria”说明重排序智能体还用了别的标准,原文没有全部列出。
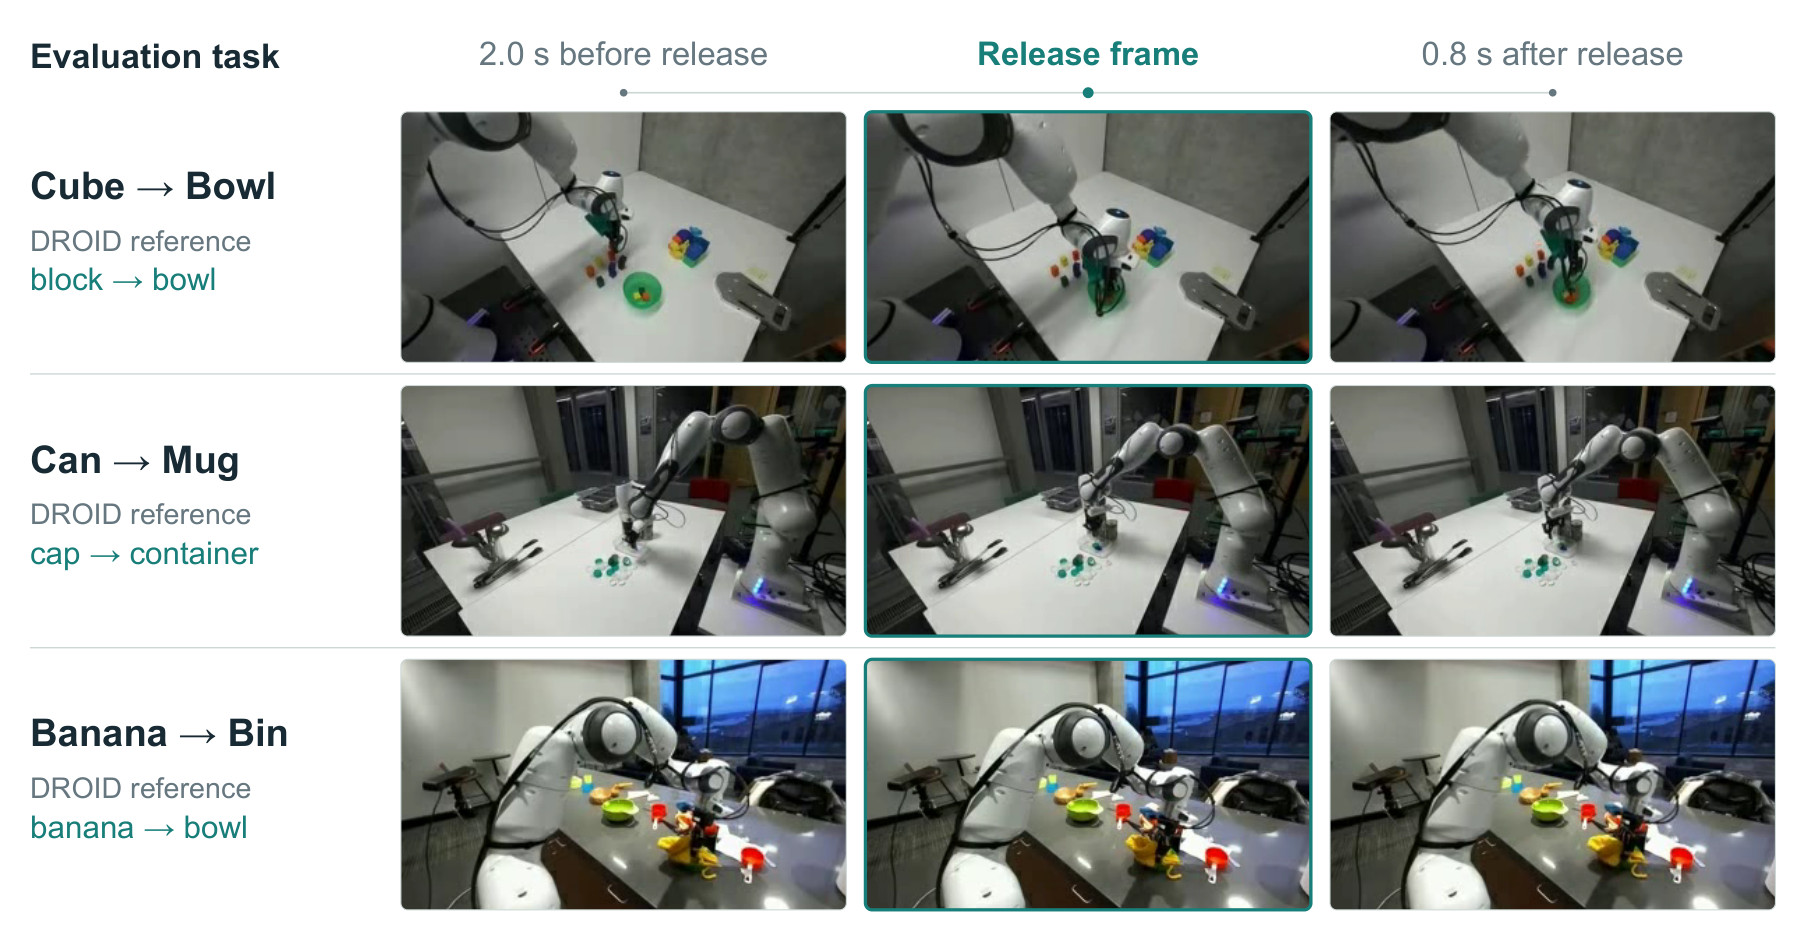
图 10:免训练 Embed2ICL 使用的 DROID 参考。每行展示一个任务的固定参考在单个相机下的画面,分别取在检测到的最后一次夹爪松开之前、之时和之后。DreamZero-DROID 接收全部三路同步的 4 秒视频流。
原图注:DROID references for training-free Embed2ICL. Each row shows one task's fixed reference from a single camera, before, at, and after the detected final gripper release. DreamZero-DROID receives all three synchronized four-second video streams.
图 10 解读
三行对应三个评测任务,左侧标注 DROID 参考的实际内容:Cube\toBowl 的参考是 block\tobowl,Can\toMug 的参考是 cap\tocontainer,Banana\toBin 的参考是 banana\tobowl。三列分别是松开前 2.0 秒、松开那一帧(绿框高亮)、松开后 0.8 秒。每段参考都是真实 Franka 机械臂在杂乱桌面上把东西放进容器的过程。这张图支持正文“有用的上下文不必重现目标场景”的论点:参考的场景、物体、容器都与 DROID-Sim 中的评测任务不同,共同之处只有“抓取—移动—放入”的动作结构和“松开”这一关键时刻。
原文
Reference-cache compatibility. DreamZero-DROID (Ye et al., 2026) supports video warm-up through its rolling 6.6-second visual KV cache and stateless VAE. LingBot-VA (Li et al., 2026b) (CauVA in the proceedings) instead requires synchronized initialization of video/action positions and streaming VAE state. Fast-WAM (Yuan et al., 2026) resets visual KV state at each policy call; Embed2ICL therefore supplies its trained Context-Token interface (Section C.4).
译文
参考与缓存的兼容性。DreamZero-DROID(Ye et al., 2026)借助其 6.6 秒的滚动视觉 KV 缓存和无状态的 VAE 支持视频预热。LingBot-VA(Li et al., 2026b;会议版本中称为 CauVA)则需要同步初始化视频与动作的位置以及流式 VAE 的状态。Fast-WAM(Yuan et al., 2026)在每次策略调用时都会重置视觉 KV 状态;因此 Embed2ICL 为它提供经过训练的 Context Token 接口(附录 C.4)。
解释
这一段解释“为什么免训练路线只用在 DreamZero 上”。免训练预热要求策略的缓存可以直接写入外部视频:DreamZero 的 VAE 无状态,每帧独立编码,写入参考帧不会破坏内部状态;LingBot-VA 的 VAE 是流式的,带有跨帧状态,并且视频与动作的位置要同步,单独塞入一段视频很麻烦;Fast-WAM 每次调用都清空缓存,预热的内容根本留不下来。所以 Fast-WAM 只能走训练路线。这说明“免训练 ICL”并不通用,依赖于策略的具体架构。
C.3YAM 机器人上的免训练 Embed2ICL(Training-Free Embed2ICL on the YAM Robot)
原文
Policy and reference. We adapt DreamZero-AgiBot (Ye et al., 2026) to YAM for 20 epochs on 55 play trajectories, comprising approximately 30 minutes of interaction. Both conditions share this adapted policy; Embed2ICL adds retrieved video through visual KV-cache warm-up without further policy updates. It reuses the banana-placement reference selected by Robota-Embed and the Reranking Agent for the DROID-Sim Banana-to-Bin task. This DROID reference depicts placement into a bowl; the real-robot task is Banana-to-Bowl.
译文
策略与参考。我们用 55 条自由交互(play)轨迹、约 30 分钟的交互数据,把 DreamZero-AgiBot(Ye et al., 2026)在 YAM 上适配训练了 20 个轮次(epoch)。两种条件共享这个适配后的策略;Embed2ICL 通过视觉 KV 缓存预热加入检索到的视频,不再做任何策略更新。它复用了 Robota-Embed 和重排序智能体为 DROID-Sim 的 Banana-to-Bin 任务选出的香蕉放置参考。这段 DROID 参考描绘的是放进碗里;真机任务是 Banana-to-Bowl。
解释
这里有一个值得注意的细节:真机实验没有为 YAM 重新检索参考,而是直接沿用仿真任务 Banana-to-Bin 的参考。这段参考恰好是“香蕉放进碗”,与真机任务 Banana-to-Bowl 正好吻合。因此真机结果检验的是“这段参考对另一台机器人是否有用”,而不是“Robota-Embed 能否为真机查询检索到合适的参考”。“play 轨迹”指不针对特定任务、自由操作采集的数据,常用于低成本地让策略适应新本体。只用 30 分钟数据适配,策略本身较弱(基线进度 21.67),给参考留下了较大的提升空间。
原文
Evaluation. We evaluate each condition over 12 real-robot rollouts. Success requires the banana to remain inside the bowl while the bowl stays upright. We also report mean cumulative task progress on a 0–100 scale, awarding 20 points for each completed stage: (1) gripper contact with the banana; (2) grasping and lifting it from the table; (3) transporting it above the bowl; (4) releasing it into the bowl; and (5) stable placement with the bowl upright. Embed2ICL raises mean progress from 21.67 to 40.00 (Table 5); success increases from 0.0% to 16.7%.
译文
评测。每种条件做 12 次真机执行。成功要求香蕉留在碗里,且碗保持直立。我们还报告 0–100 分制的平均累计任务进度,每完成一个阶段得 20 分:(1) 夹爪接触到香蕉;(2) 抓住并把它从桌上提起;(3) 把它运送到碗的上方;(4) 把它松开放进碗里;(5) 稳定放置且碗保持直立。Embed2ICL 把平均进度从 21.67 提高到 40.00(表 5);成功率从 0.0% 提高到 16.7%。
解释
换算:12 次执行、每次最多 5 个阶段。21.67 分对应总计 13 个阶段,平均每次约 1.1 个,即大多只做到“接触香蕉”;40.00 分对应 24 个阶段,平均每次 2 个。成功率 16.7% 即 12 次中成功 2 次。正文只报告了进度,成功率只在这里出现。0/12 与 2/12 的差异在统计上并不显著(Fisher 精确检验的 p 约为 0.48),所以真机结果只能作为方向性的佐证。
C.4Fast-WAM 接入细节(Fast-WAM Integration Details)
原文
Context Tokens from target states. The target encoder jointly encodes task text, future video, and native actions. From valid action slots after layer 28's generation RMSNorm, we extract fused states H_i^k\in\mathbb{R}^{T_i\times2048} used by the global retrieval branch (Eq. 3). Adaptive temporal average pooling retains at most 32 positions; standard windows from all four sources yield 32. Pooled states pass through shared LayerNorm, 2048\!\rightarrow\!1024 projection W, and target residual adapter A_k:
\begin{aligned} \widetilde H_i&=\operatorname{Pool}_{32}(H_i^k),\qquad u_{i,j}=A_k\!\left(W\operatorname{LN}(\widetilde H_{i,j})\right),\\ C_{i,j}&=u_{i,j}/\|u_{i,j}\|_2,\qquad C_i\in\mathbb{R}^{32\times1024}. \end{aligned}(7)
Standard windows yield 32 independently L2-normalized tokens from temporally pooled states, not copies of the global retrieval vector. Cosine search uses k_i; Fast-WAM consumes C_i. 译文
由目标端状态得到 Context Tokens。目标端编码器联合编码任务文本、未来视频和原生动作。我们在第 28 层的生成用 RMSNorm 之后,从有效的动作槽位上提取融合状态 H_i^k\in\mathbb{R}^{T_i\times2048},这些状态也被全局检索分支使用(式 (3))。自适应时间平均池化最多保留 32 个位置;四个来源的标准窗口都得到 32 个。池化后的状态依次经过共享的 LayerNorm、2048\!\rightarrow\!1024 的投影 W 和目标端残差适配器 A_k:
\begin{aligned} \widetilde H_i&=\operatorname{Pool}_{32}(H_i^k),\qquad u_{i,j}=A_k\!\left(W\operatorname{LN}(\widetilde H_{i,j})\right),\\ C_{i,j}&=u_{i,j}/\|u_{i,j}\|_2,\qquad C_i\in\mathbb{R}^{32\times1024}. \end{aligned}(7)
标准窗口得到 32 个各自做过 L2 归一化的 token,它们来自时间池化后的状态,而不是全局检索向量的复制。余弦搜索使用 k_i;Fast-WAM 读取的是 C_i。 解释
式 (7) 与式 (3) 的对比:式 (3) 把 T_r 个时刻全部平均成 1 个向量;式 (7) 只把时间轴压缩到 32 段(\operatorname{Pool}_{32}),每段单独经过同样的 LN、投影和适配器,再各自归一化,得到 32\times1024 的矩阵。下标 j=1,\dots,32 是池化后的时间位置。\operatorname{Pool}_{32} 是自适应平均池化:若原来有 120 个动作 token(EgoDex 30 Hz \times 4 秒),每段约平均 3.75 个;若不足 32 个,则保留原长度,并用掩码 m_i 标出有效位置。这样做的好处是不需要额外训练任何“token 提取器”:Context Tokens 完全复用检索训练学到的参数,相当于把检索向量“展开”回时间维。代价是这些 token 从未被专门训练成适合策略读取的形式,策略需要通过微调去适应它们。
原文
Retrieval-trained parameters. Context Tokens reuse the Transformer, shared projection, and endpoint adapters learned during retrieval training. The video VAE remains frozen. Token extraction adds no separate head or token-level alignment or reconstruction loss.
译文
检索训练得到的参数。Context Tokens 复用检索训练学到的 Transformer、共享投影和两端适配器。视频 VAE 保持冻结。token 的提取不增加单独的输出头,也不引入 token 级的对齐或重建损失。
解释
即 Robota-Embed 只训练了一次(为检索),Context Tokens 是它的副产品。
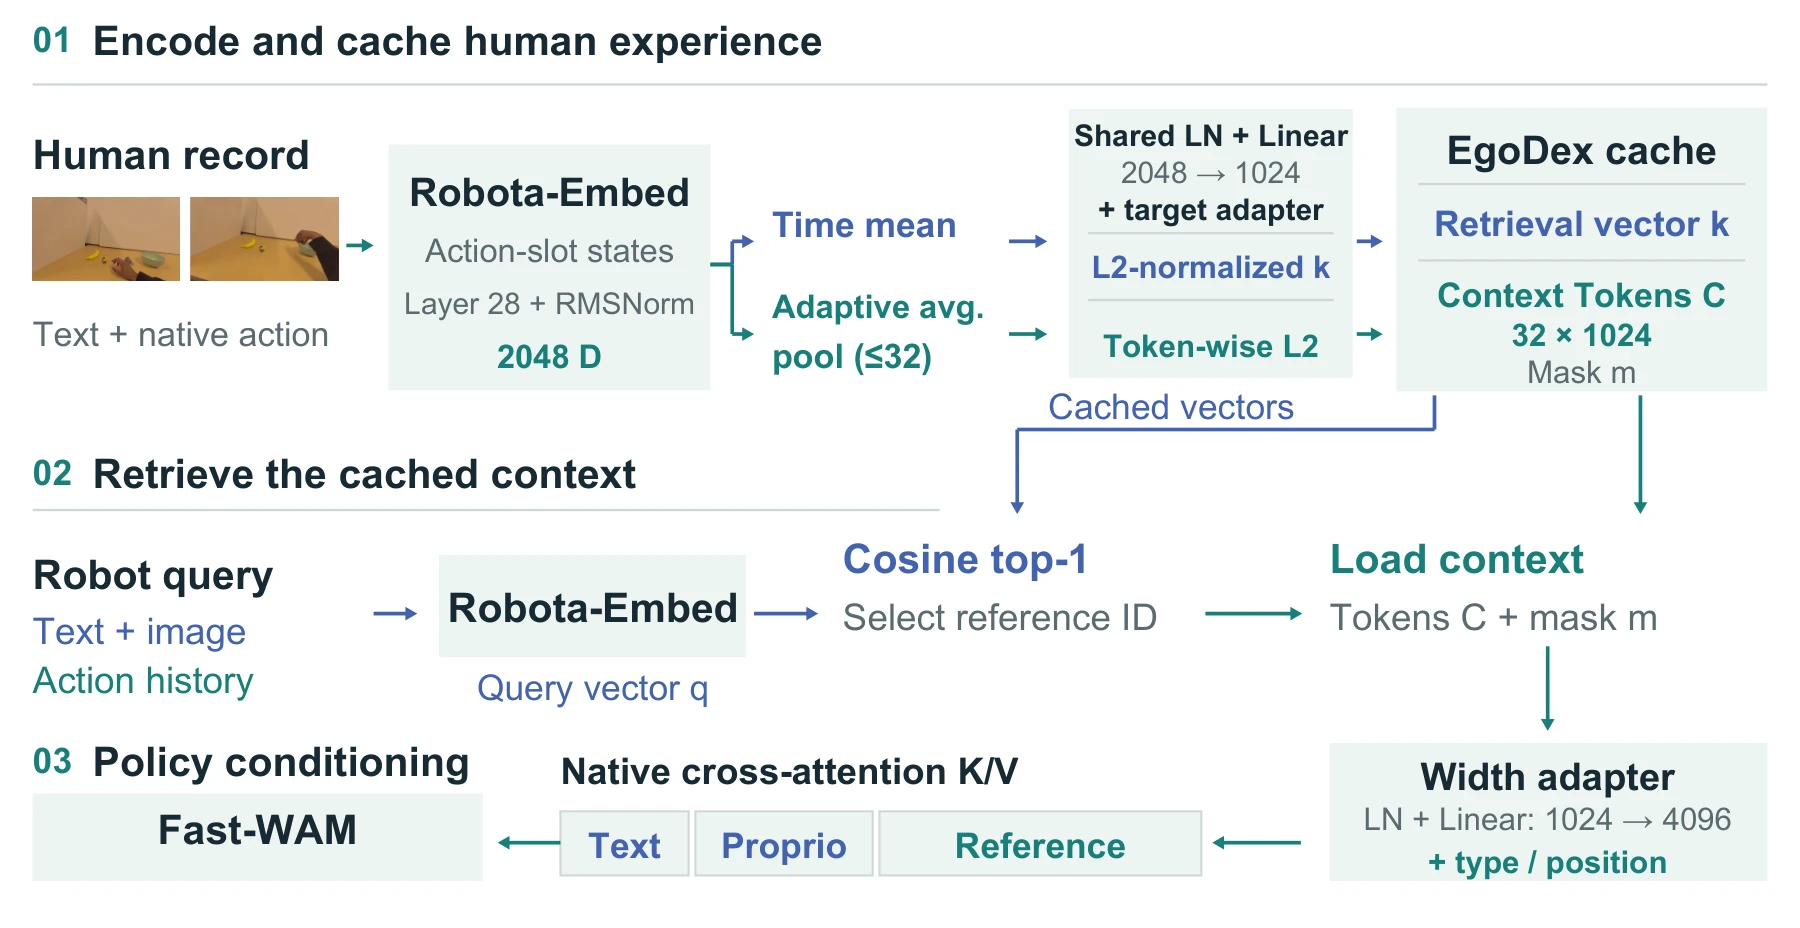
图 11:需训练的 Embed2ICL。离线编码为每个候选缓存其检索向量、Context Tokens 和上下文掩码。在线时,余弦 top-1 搜索选出一个参考,并加载它的 token 和掩码。预填充适配器把这些 token 投影到 Fast-WAM 的上下文宽度,并附加在原生的文本和本体感知条件之后,供交叉注意力读取。
原图注:Training-based Embed2ICL. Offline encoding caches each candidate's retrieval vector, Context Tokens, and context mask. Online cosine top-1 search selects a reference and loads its tokens and mask. The prefilling adapter projects the tokens to Fast-WAM's context width and appends them to the native text and proprioceptive conditioning for cross-attention.
图 11 解读
图分三行。01 编码并缓存人类经验:人类记录(EgoDex 视频帧、文本和原生动作)进入 Robota-Embed,取第 28 层 RMSNorm 后动作槽位的 2,048 维状态,然后分两路:上路“时间平均”\to 共享 LN + 线性层(2048\to1024)+ 目标适配器 \to L2 归一化,得到检索向量 k;下路“自适应平均池化(\le32)”\to 同样的投影 \to 逐 token L2 归一化,得到 Context Tokens C(32\times1024)和掩码 m。三者都存进 EgoDex 缓存。02 检索缓存的上下文:机器人查询(文本、图像、动作历史)经 Robota-Embed 得到查询向量 q,做余弦 top-1 选出参考编号,加载对应的 C 和 m。03 策略条件化:宽度适配器(LN + 线性层 1024\to4096,加类型与位置嵌入)把 token 映射到 Fast-WAM 的宽度,与文本(Text)和本体感知(Proprio)一起组成交叉注意力的 K/V。从图中可以看出,在线阶段只需编码一次查询,不需要重新编码候选,这是“离线缓存”设计的意义。
原文
Offline cache and online lookup. Offline, we cache each candidate's retrieval vector, Context Tokens, and context mask m_i. Online, we encode the robot query as q, find i^*=\arg\max_i q^\top k_i, and load (C_{i^*},m_{i^*}) without re-encoding the candidate. Each rollout starts without reference context. After the first successful retrieval, that reference stays active until the rollout ends. Task-progress metadata is excluded from conditioning.
译文
离线缓存与在线查找。离线时,我们为每个候选缓存其检索向量、Context Tokens 和上下文掩码 m_i。在线时,我们把机器人查询编码为 q,找到 i^*=\arg\max_i q^\top k_i,并加载 (C_{i^*},m_{i^*}),无需重新编码候选。每次执行开始时都没有参考上下文。第一次成功检索之后,该参考一直保持生效,直到这次执行结束。任务进度的元数据不用于条件化。
解释
由于 q 和 k_i 都是单位向量,内积 q^\top k_i 就是余弦相似度。“每次执行只在开头检索一次,之后固定使用”这一点很重要:与 DreamZero 路线一样,Fast-WAM 路线也没有随执行阶段动态更换参考,所以片段级的阶段定位能力在这里同样没有被充分利用。“第一次成功检索”暗示开头几步可能因为某些原因(例如查询需要积累动作历史)还不能检索,原文没有解释。最后一句说明参考只提供视觉、语言和动作信息,不会把“这段参考处于任务的第几阶段”这种标注泄露给策略。
原文
Prefilling. Embed2ICL projects C=C_{i^*} to Fast-WAM's conditioning width:
R=\operatorname{Linear}_{1024\rightarrow4096}\!\left(\operatorname{LN}(C)\right)+E_{\mathrm{type}}+E_{\mathrm{pos}},\quad R\in\mathbb{R}^{32\times4096}.(8)
The projected sequence extends native conditioning [H_{\mathrm{text}};h_{\mathrm{proprio}}]; E_{\mathrm{type}} and E_{\mathrm{pos}} are learned type and position embeddings. Native cross-attention reads it in all 30 video-expert and 30 action-expert layers, at every action-diffusion denoising step, and during video KV-cache prefilling. 译文
预填充。Embed2ICL 把 C=C_{i^*} 投影到 Fast-WAM 的条件宽度:
R=\operatorname{Linear}_{1024\rightarrow4096}\!\left(\operatorname{LN}(C)\right)+E_{\mathrm{type}}+E_{\mathrm{pos}},\quad R\in\mathbb{R}^{32\times4096}.(8)
投影后的序列接在原生条件 [H_{\mathrm{text}};h_{\mathrm{proprio}}] 之后;E_{\mathrm{type}} 和 E_{\mathrm{pos}} 是可学习的类型嵌入和位置嵌入。原生的交叉注意力在全部 30 个视频专家层和 30 个动作专家层中、在动作扩散的每一个去噪步骤中,以及在视频 KV 缓存预填充时,都会读取这段序列。 解释
式 (8) 是一个很轻的适配器:LN 后接一个 1024\to4096 的线性层,参数约 1024\times4096\approx4.2M,加上 LN 和嵌入,与下文“4.34M 参数的投影适配器”一致。E_{\text{type}} 告诉模型“这一段是参考 token,不是文本也不是本体感知”;E_{\text{pos}} 给 32 个 token 编上时间顺序。[H_{\text{text}};h_{\text{proprio}}] 表示把文本隐状态和本体感知向量按序列方向拼接,参考 token 再接在后面,所以 Fast-WAM 原有的交叉注意力不需要改结构就能“看到”参考。Fast-WAM 是视频专家与动作专家各 30 层的混合结构,两类专家都读取这段条件。
原文
Policy-adaptation scope. Video and action flow-matching losses update approximately 5.00B video-expert parameters, 1.02B action-expert parameters, the proprioception encoder, and a 4.34M-parameter projection adapter: approximately 6.02B trainable parameters in total. The text encoder and VAE remain frozen. The context adapter inserts cached tokens into native conditioning, with no gradient propagation to the offline Robota-Embed encoder.
译文
策略适配的范围。视频与动作的流匹配(flow-matching)损失更新约 5.00B 的视频专家参数、1.02B 的动作专家参数、本体感知编码器,以及一个 4.34M 参数的投影适配器,可训练参数合计约 6.02B。文本编码器和 VAE 保持冻结。上下文适配器把缓存的 token 插入原生条件中,梯度不会传到离线的 Robota-Embed 编码器。
解释
这里的“训练”几乎是对整个 Fast-WAM 做全量微调(6.02B 参数),而不只是训练一个适配器。这决定了 C.6 节消融的意义:只训练 158.74M 参数的旁路分支效果明显差一些。训练损失仍是 Fast-WAM 原本的视频与动作流匹配损失,没有为“利用参考”设计额外的目标,策略是否用上参考,完全取决于参考是否有助于降低原有的预测损失。
原文
LIBERO training schedule. The retrieved-context condition starts from the official Fast-WAM LIBERO checkpoint and trains on 1,712 trajectories comprising 277,713 samples across the four LIBERO suites. Five epochs yield 21,700 parameter updates with an effective batch size of 64. We use AdamW with a learning rate of 10^{-4}, a 5% warm-up, and cosine decay to 10^{-6}. The random-reference condition evaluates this same policy checkpoint. A separate no-ICL control uses the same 21,700 training updates (Section C.5).
译文
LIBERO 训练日程。检索上下文条件从官方的 Fast-WAM LIBERO 检查点出发,在四个 LIBERO 套件的 1,712 条轨迹(共 277,713 个样本)上训练。5 个轮次共 21,700 次参数更新,有效批大小为 64。我们使用 AdamW,学习率 10^{-4},5% 的预热,余弦衰减到 10^{-6}。随机参考条件评测的是同一个策略检查点。另有一个不加 ICL 的对照,使用同样的 21,700 次训练更新(附录 C.5)。
解释
验算:277{,}713\times5/64\approx21{,}696,与 21,700 次更新一致。这里有一个值得注意的设计:LIBERO 训练时,每条轨迹配的参考是从 EgoDex 人类视频中检索的 top-1,而不是 LIBERO 自身的机器人示范。这让策略学会读取“人类示范”形式的上下文。不过,Robota-Embed 的检索向量本身就在 LIBERO 数据上训练过,所以 LIBERO 查询在 EgoDex 库中检索属于跨来源检索;附录 B.7 说过跨来源检索没有定量评估,这里的检索质量无从直接衡量,只能通过下游成功率间接判断。
原文
Real-robot evaluation. Pick Fruit and Split Cup each use 12 rollouts per task and condition. Following T-Rex's partial-credit approach (Niu et al., 2026), we report 100\,\frac{1}{12}\sum_{i=1}^{12}s_i, where s_i\in[0,1] is a rollout's normalized task-progress score.
译文
真机评测。Pick Fruit 和 Split Cup 每个任务、每种条件各做 12 次执行。沿用 T-Rex 的部分计分方法(Niu et al., 2026),我们报告 100\,\frac{1}{12}\sum_{i=1}^{12}s_i,其中 s_i\in[0,1] 是一次执行归一化后的任务进度分数。
解释
即 12 次执行进度分数的平均值乘以 100。
原文
Additive scoring. Pick Fruit and Split Cup award 0.25 independently for each completed sub-step, up to a total of 1. For Pick Fruit, the four sub-steps are: the left hand grasps a fruit from the left side; the left hand places that fruit in the center basket; the right hand grasps a fruit from the right side; and the right hand places that fruit in the center basket. For Split Cup, they are: the left hand grasps and stabilizes the cup stack; the right hand separates exactly one cup; the right hand grasps the separated cup; and the separated cup is placed upright on the table.
译文
累加计分。Pick Fruit 和 Split Cup 每完成一个子步骤各独立得 0.25 分,满分为 1。Pick Fruit 的四个子步骤是:左手从左侧抓起一个水果;左手把这个水果放进中央的篮子;右手从右侧抓起一个水果;右手把这个水果放进中央的篮子。Split Cup 的四个子步骤是:左手抓住并稳住一摞杯子;右手恰好分出一个杯子;右手抓住分出来的杯子;把分出来的杯子直立放在桌上。
解释
有了这个计分规则,表 5 的数字可以还原成子步骤数:每种条件 12 次执行,共 48 个子步骤。Pick Fruit 从 36/48(75.00)到 38/48(79.17),只多完成 2 个子步骤;Split Cup 从 32/48(66.67)到 42/48(87.50),多完成 10 个。Pick Fruit 的提升在 12 次执行的样本量下很可能只是噪声,Split Cup 的提升比较明显。“独立”计分意味着后面的子步骤不以前面的为前提,例如右手的抓放可以在左手失败时单独得分。
原文
Table 5 reports mean task progress and gains computed before rounding. Figure 6 pairs retrieved references with illustrative executions for these two tasks and DreamZero/YAM.
译文
表 5 报告平均任务进度以及在四舍五入之前计算的增益。图 6 把检索到的参考与这两个任务及 DreamZero/YAM 的示例执行配对展示。
解释
这是对正文表 5 和图 6 的指引。“在四舍五入之前计算增益”解释了表 5 括号中的数字为什么与两列直接相减可能差 0.01。
C.5LIBERO 补充对照(LIBERO Supplementary Controls)
原文
Table 4 compares retrieved and random Context Tokens with the official release without ICL. The retrieved- and random-reference conditions evaluate the same policy checkpoint, changing only the source of Context Tokens at inference. For the random-context condition, a fixed seed deterministically selects a pseudorandom real reference window from the EgoDex gallery. Its precomputed 32\times1024 Context Tokens replace the retrieved window's tokens; the control neither injects noise nor shuffles token order. Each condition uses 50 binary-success trials per task across the five-task LIBERO difficult subset. Retrieved tokens reach 92.8% success, compared with 88.0% for tokens from random references. This isolates reference selection at fixed policy weights.
译文
表 4 把检索得到的与随机的 Context Tokens,同不加 ICL 的官方发布版本进行比较。检索参考与随机参考两种条件评测的是同一个策略检查点,只在推理时改变 Context Tokens 的来源。对于随机上下文条件,用一个固定的随机种子,从 EgoDex 候选库中确定性地选出一个伪随机的真实参考窗口。它预先计算好的 32\times1024 Context Tokens 替换掉检索窗口的 token;这一对照既不注入噪声,也不打乱 token 的顺序。每种条件在五任务的 LIBERO 困难子集上,每个任务做 50 次二元成功试验。检索得到的 token 达到 92.8% 的成功率,随机参考的 token 为 88.0%。这在固定策略权重的情况下分离出了参考选择的作用。
解释
随机对照的设计是合理的:随机参考是一段真实的 EgoDex 片段,格式、分布与检索结果完全相同,只是内容与任务无关。这样,4.8 个点的差距就只能归因于“选得对不对”。一个未说明的细节是:“固定种子”是对所有试验选同一段随机参考,还是每次试验选不同的?如果是前者,随机对照的结果会依赖于这一段参考碰巧是什么。
原文
Separately, continuing the official release without ICL for 21,700 updates, matching Embed2ICL's update count, yields 216/250 successes (86.4%). Success remains unchanged from the official release and 6.4 percentage points below Embed2ICL. Thus, continuation for the same number of updates does not reproduce the gain from retrieved-context conditioning.
译文
另外,在不加 ICL 的情况下把官方发布版本继续训练 21,700 次更新(与 Embed2ICL 的更新次数相同),得到 216/250 次成功(86.4%)。成功率与官方发布版本相同,比 Embed2ICL 低 6.4 个百分点。因此,相同次数的继续训练并不能复现检索上下文条件化带来的增益。
解释
这排除了“增益只是因为多训练了一会儿”的解释。不过这个对照只在 LIBERO 上做了,真机实验(表 5)没有对应的“继续训练但不加 ICL”对照,表 5 中的“无 ICL”是否也经过同样的继续训练,原文没有交代。
原文
Retrieved human context. Figure 12 pairs the G3 bowl-to-drawer task with a top-1 EgoDex clip of a human moving an object toward a bowl. Both depict placement into a receptacle. The selected Embed2ICL rollout completes G3, whereas the rollout from the official release does not.
译文
检索到的人类上下文。图 12 把 G3“把碗放进抽屉”任务与一段 top-1 的 EgoDex 片段配对展示,片段中一个人把物体移向一只碗。两者描绘的都是“放进容器”。选出的 Embed2ICL 执行完成了 G3,而官方发布版本的那次执行没有完成。
解释
这是一个有趣但需要谨慎看待的例子:检索到的人类片段中,碗是接收物体的容器;而 G3 中碗是被放进抽屉的物体。两者共享的只是“放进某处”的抽象结构,物体角色并不一致。“选出的执行”说明这是挑出的示例,不代表典型情况。
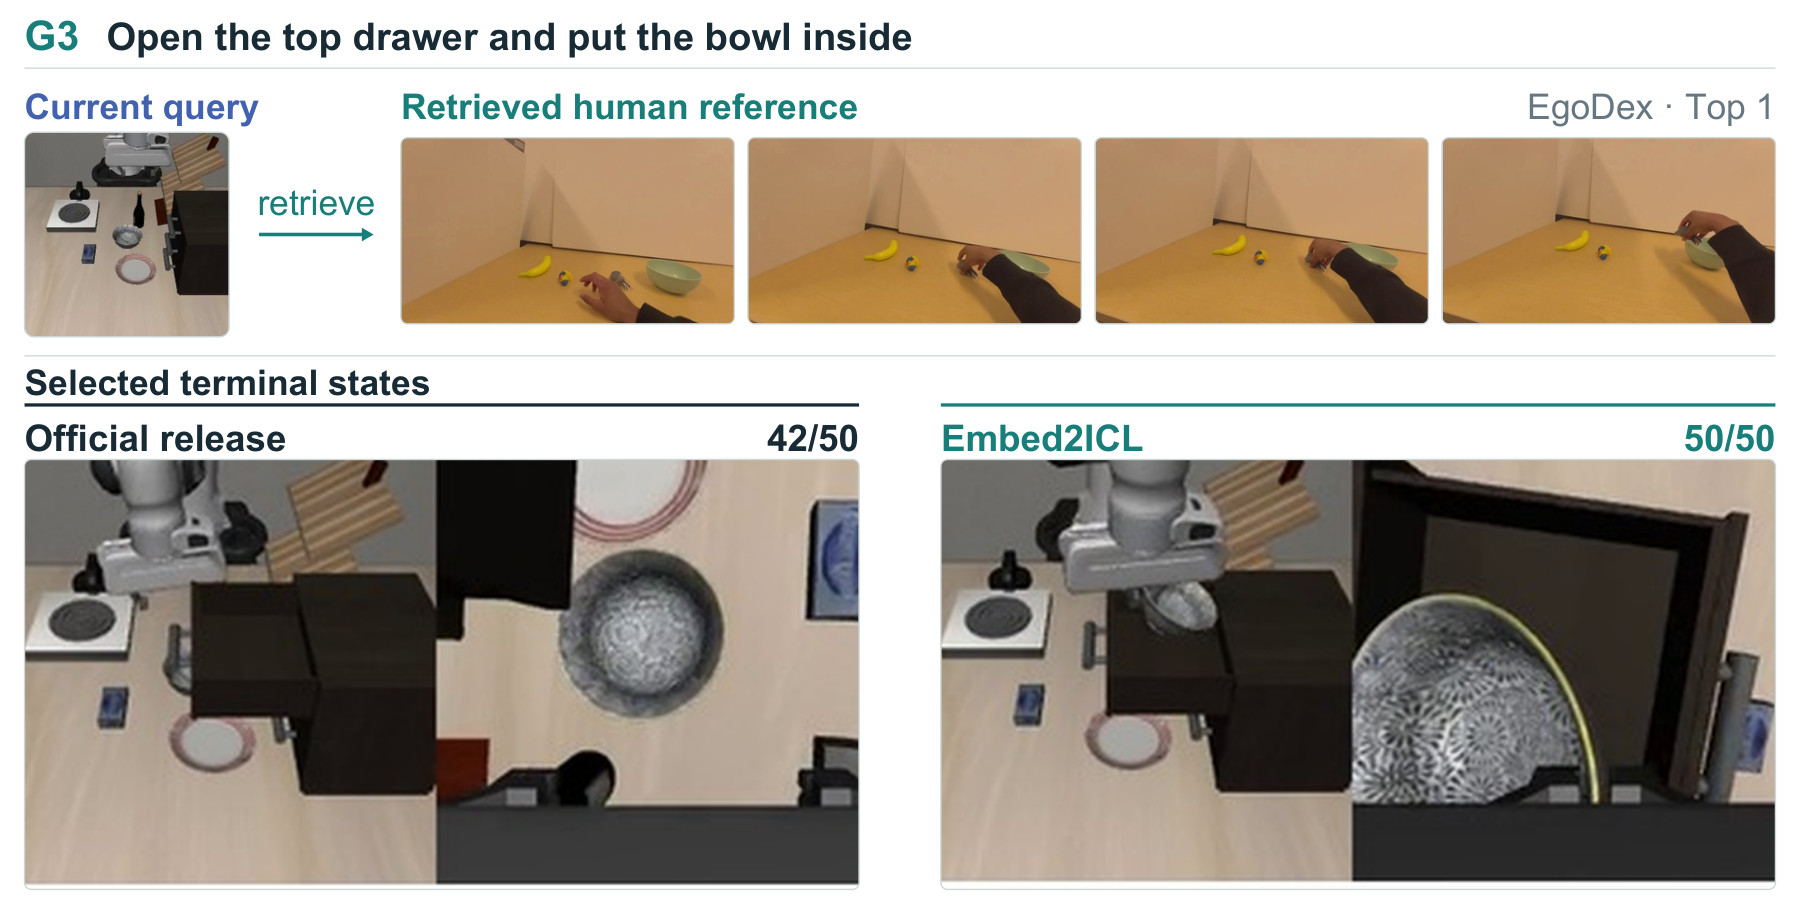
图 12:LIBERO G3:参考与终止状态。每种条件 50 次中的成功次数。
原图注:LIBERO G3: reference and final states. Successes out of 50 per condition.
图 12 解读
上方:任务 G3“打开最上层抽屉并把碗放进去”。左边是当前查询(LIBERO 仿真的俯视画面),右边是检索到的 EgoDex 人类参考(top-1,四帧),画面中一只手把一个小物体推向桌上的碗。下方“选出的终止状态”:左边是官方版本的一次执行结束时的画面,碗没有进入抽屉(该条件 42/50 成功);右边是 Embed2ICL 的一次执行,碗已在抽屉中(50/50 成功)。这张图说明人类视频可以作为机器人仿真任务的上下文,尽管两者在本体、视角、场景上完全不同。但它同样只是定性示例:参考与任务之间只有“放进容器”这一粗略的语义对应,图中看不出参考如何具体影响了策略的行为。G3 是五个任务中提升最大的一个(+8 次成功),选它作为示例本身带有选择性。
C.6需训练接入方式的消融(Training-Based Integration Ablation)
原文
We compare two complete integration settings: Embed2ICL's native-context prefilling with policy fine-tuning, and a frozen-backbone reference side branch. Both use the Robota-Embed retriever, EgoDex index, cosine top-1 selection, and complete 32\times1024 Context Tokens. They differ in both the conditioning path and trainable scope.
译文
我们比较两种完整的接入设定:Embed2ICL 的“原生上下文预填充 + 策略微调”,以及“冻结骨干 + 参考旁路分支”。两者都使用 Robota-Embed 检索器、EgoDex 索引、余弦 top-1 选择和完整的 32\times1024 Context Tokens。它们在条件化路径和可训练范围两方面都不同。
解释
作者坦承两种设定同时改变了两个因素(接入路径、训练多少参数),所以结果差异不能单独归因于其中任何一个。
原文
Side-branch setting. A shared reference encoder projects the cached tokens to width 512. Each of the 30 video-expert and 30 action-expert layers receives an eight-head reference cross-attention block, inserted after self-attention and before native text/proprioception cross-attention. Channel-wise residual gates are initialized to zero, preserving the original policy at initialization. Training updates the reference encoder, added attention blocks, and gates (approximately 158.74M parameters), while freezing the original Fast-WAM backbone and proprioception encoder. Standard Embed2ICL instead fine-tunes approximately 6.02B parameters with its prefilling interface (Section C.4).
译文
旁路分支设定。一个共享的参考编码器把缓存的 token 投影到 512 维。30 个视频专家层和 30 个动作专家层中的每一层都插入一个 8 头的参考交叉注意力模块,位置在自注意力之后、原生的文本/本体感知交叉注意力之前。逐通道的残差门控初始化为零,使初始化时的策略与原策略完全相同。训练只更新参考编码器、新增的注意力模块和门控(约 158.74M 参数),原有的 Fast-WAM 骨干和本体感知编码器保持冻结。标准的 Embed2ICL 则通过其预填充接口微调约 6.02B 参数(附录 C.4)。
解释
零初始化门控是一种常见做法(类似 Flamingo 的门控交叉注意力):训练开始时新模块的输出被乘以 0,策略行为与原来完全一致,之后再逐渐“打开”门控。这样可以避免新增模块在训练初期破坏预训练策略。旁路分支的可训练参数只有标准方案的约 2.6%(158.74M 对 6.02B)。
表 23:LIBERO 接入方式消融。每个任务、每种条件 50 次试验中的成功次数;最后一行为五任务平均(%)。括号内为相对官方发布版本的百分点变化;粗体标出两种 ICL 设定中较好的一个。
| 套件 / 编号 | 官方发布版本 | 旁路分支 | Embed2ICL |
| Spatial / S4 | 46 | 46 (0) | 49 (+6) |
| Goal / G3 | 42 | 44 (+4) | 50 (+16) |
| Goal / G9 | 45 | 44 (-2) | 47 (+4) |
| LIBERO-10 / L4 | 43 | 43 (0) | 44 (+2) |
| LIBERO-10 / L6 | 40 | 43 (+6) | 42 (+4) |
| 五任务平均(%) | 86.4 | 88.0 (+1.6) | 92.8 (+6.4) |
原表注:LIBERO integration ablation. Successes from 50 trials per task and condition; the final row gives the five-task average (%). Parentheses show percentage-point changes from the official release; bold marks the better ICL setting.
表 23 解读
官方与 Embed2ICL 两列与表 3 相同,新增的是中间的旁路分支。验算:旁路分支 46+44+44+43+43=220,220/250=88.0\%。旁路分支在 S4 和 L4 上与官方持平,在 G9 上还少 1 次成功,只在 G3(+1 次)和 L6(+3 次)上有提升,总共只多 4 次成功。Embed2ICL 在四个任务上优于旁路分支,旁路分支只在 L6 上领先 1 次。一个巧合值得注意:旁路分支用检索 token 的平均成功率是 88.0%,与 Embed2ICL 用随机 token 时的 88.0%(表 4)完全相同。也就是说,冻结骨干、只加旁路的方案,即使用上了正确的参考,效果也只相当于全量微调方案拿到随机参考。这说明在这个实验里,“策略能否充分适应上下文”比“上下文选得好不好”影响更大。
原文
Conclusion: LIBERO. The side branch reaches 88.0% average success, compared with 86.4% for the official release and 92.8% for Embed2ICL (Table 23). Embed2ICL performs better on four tasks; the side branch performs better on L6 (43 versus 42 successes). The side branch uses fewer trainable parameters, but Embed2ICL reaches higher average success.
译文
结论(LIBERO)。旁路分支的平均成功率为 88.0%,官方发布版本为 86.4%,Embed2ICL 为 92.8%(表 23)。Embed2ICL 在四个任务上表现更好;旁路分支在 L6 上更好(43 对 42 次成功)。旁路分支的可训练参数更少,但 Embed2ICL 的平均成功率更高。
解释
作者的结论措辞很克制,只说“参数少、成功率低”,没有声称哪种接入方式本质上更优,因为两种方案同时改变了路径和训练规模。
表 24:真机接入方式消融。每个任务、每种条件 12 次执行的平均归一化任务进度(%)。括号内为相对不加 ICL 的 Fast-WAM 的百分点变化。
| 任务 | 无 ICL | 旁路分支 | Embed2ICL |
| Pick Fruit | 75.00 | 77.08 (+2.08) | 79.17 (+4.17) |
| Split Cup | 66.67 | 75.00 (+8.33) | 87.50 (+20.83) |
原表注:Real-robot integration ablation. Mean normalized task progress (%) from 12 rollouts per task and condition. Parentheses show percentage-point changes from Fast-WAM without ICL.
表 24 解读
按附录 C.4 的计分(每任务 12 次执行共 48 个子步骤,每个 0.25),可以换算成子步骤数:Pick Fruit 为 36、37、38 个,Split Cup 为 32、36、42 个。Pick Fruit 上三种条件依次只差 1 个子步骤,完全在噪声范围内;Split Cup 上 Embed2ICL 比旁路分支多 6 个、比无 ICL 多 10 个子步骤,差距相对明显。表中没有真机的随机参考对照。
原文
Conclusion: Real robots. Both settings improve mean normalized task progress over no ICL (Table 24). Embed2ICL reaches 79.17% on Pick Fruit and 87.50% on Split Cup, compared with 77.08% and 75.00% for the side branch. The larger gap occurs on Split Cup.
译文
结论(真机)。两种设定都比不加 ICL 提高了平均归一化任务进度(表 24)。Embed2ICL 在 Pick Fruit 上达到 79.17%,在 Split Cup 上达到 87.50%;旁路分支分别为 77.08% 和 75.00%。差距较大的是 Split Cup。
解释
与 LIBERO 的结论方向一致:全量微调方案优于旁路方案,差距集中在需要双臂协调的 Split Cup 上。
表 25:检索得到的与随机的 Context Tokens。每种接入方式都在 LIBERO 困难子集上评测,每个任务、每种条件 50 次试验。结果为五任务平均成功率(%)。
| 接入方式 | 随机 token | 检索 token |
| 旁路分支 | 85.6 | 88.0 |
| Embed2ICL | 88.0 | 92.8 |
原表注:Retrieved versus random Context Tokens. Each integration is evaluated on the LIBERO difficult subset with 50 trials per task and condition. Results are five-task average success rates (%).
表 25 解读
这张 2\times2 表把“接入方式”和“参考来源”两个因素交叉。两行中,检索都优于随机:旁路分支 +2.4 点,Embed2ICL +4.8 点。两列中,Embed2ICL 都优于旁路分支:随机时 +2.4 点,检索时 +4.8 点。旁路分支用随机 token 时为 85.6%,比官方版本(86.4%)还低,说明给一个只训练了旁路的策略喂无关参考会略微有害,这与 DreamZero 中随机参考低于不预热(表 2)的现象一致。每个数字基于 250 次试验,标准误约 2 个点,2.4 个点的差距只是边缘显著。
原文
Conclusion: Retrieved versus random context. Retrieved tokens yield higher success than random tokens within each setting (Table 25): 88.0% versus 85.6% for the side branch and 92.8% versus 88.0% for Embed2ICL. In the Embed2ICL comparison, both reference conditions use the same policy checkpoint. Retrieved context helps in both the frozen-backbone and fine-tuned settings.
译文
结论(检索与随机上下文)。在每种设定下,检索得到的 token 都比随机 token 带来更高的成功率(表 25):旁路分支为 88.0% 对 85.6%,Embed2ICL 为 92.8% 对 88.0%。在 Embed2ICL 的比较中,两种参考条件使用同一个策略检查点。检索到的上下文在冻结骨干和微调两种设定下都有帮助。
解释
“两种参考条件使用同一个策略检查点”只针对 Embed2ICL 一行明确说明;旁路分支一行是否也是同一个检查点,原文没有明说,按常理应当如此。
DEmbed2Evolve:外壳、开发与评测(Embed2Evolve: Harnesses, Development, and Evaluation)
原文
Embed2Evolve accumulates completed attempts in task-local memory and searches for a recipe for using that memory during control. Online retrieval ranks individual memory anchors; development compares entire context configurations. The two decisions use different criteria. The policy and embedding models remain fixed throughout.
译文
Embed2Evolve 把完成的尝试积累在任务内记忆中,并搜索一种在控制中使用这份记忆的配方。在线检索对单个记忆锚点排序;开发阶段比较的是整套上下文配置。这两种决策使用不同的标准。策略模型和嵌入模型始终固定。
解释
这里点出两个层次的“选择”:执行时每次检索要给记忆中的锚点打分排序(式 (9),相似度加成功奖励),开发时要在多套配置之间选出最好的一套(式 (10),先比成功次数再比效率)。下面 D.1 讲前者,D.2 讲后者。
D.1策略与记忆接口(Policy and Memory Interfaces)
原文
Matched embedding-model design. We compare Robota-Embed with Omni-Embed-Nemotron-3B (Xu et al., 2025) by replacing only the retrieval embedding model and developing each condition independently. Both use the same GPT-6 Astra policy, prompt, initial memory, development and test seeds, candidate-generation rules, and stopping criteria. Retrieved memories supply the same RGB, action, and feedback fields to the policy. Both evolved systems use the full memory interface; the random-history baseline supplies only RGB.
译文
匹配的嵌入模型设计。我们只替换检索用的嵌入模型,把 Robota-Embed 与 Omni-Embed-Nemotron-3B(Xu et al., 2025)进行比较,两种条件各自独立开发。两者使用相同的 GPT-6 Astra 策略、提示词、初始记忆、开发与测试种子、候选生成规则和停止准则。检索到的记忆向策略提供相同的 RGB、动作和反馈字段。两个演化出的系统都使用完整的记忆接口;随机历史基线只提供 RGB。
解释
最后一句证实了第 5.2 节解释中提到的不对等:随机历史基线只给 RGB,而两个演化系统都给 RGB、动作和反馈。所以“随机历史”并不是“随机检索”的严格对照。
原文
At each decision, GPT-6 Astra receives all current RGB views, robot state, execution feedback, recent action/feedback history, and external context when available. It proposes end-effector target poses and gripper commands, which are validated and executed by a fixed IK/controller. Table 26 gives the runtime and budgets. The four single-arm tasks use
base_camera, vision_side, vision_top, and vision_wrist; TwoRobotStackCube uses base, side, top, and separate left/right wrist cameras. The policy observes all four or five views, respectively, at every decision.译文
每次决策时,GPT-6 Astra 接收全部当前 RGB 视角、机器人状态、执行反馈、最近的动作/反馈历史,以及(如果有的话)外部上下文。它提出末端执行器的目标位姿和夹爪指令,由一个固定的 IK/控制器验证并执行。表 26 给出运行时配置与预算。四个单臂任务使用
base_camera、vision_side、vision_top 和 vision_wrist 四个相机;TwoRobotStackCube 使用基座、侧面、顶部相机以及左右两个独立的腕部相机。策略在每次决策时分别观察全部四个或五个视角。解释
每次决策要输入 4–5 张 256\times256 的图像,加上历史和检索上下文,这解释了为什么每次执行的输入 token 高达数十万到上百万(表 32):图像 token 是主要开销。检索上下文中的历史图像同样会消耗大量 token,所以“保留更少的历史”能显著减少输入 token。
表 26:Embed2Evolve 的运行时与观测接口。仿真时间不同于客户端执行时间,后者包含等待 API 的时间。
| 组件 | 配置 |
| 策略 | GPT-6 Astra,推理强度(reasoning effort)设为 low |
| 仿真器 | ManiSkill 3.0.1;SAPIEN 3.0.3 |
| 当前 RGB | 每次决策每个相机一张 256\times256 图像 |
| 相机 | 单臂任务 4 个;TwoRobotStackCube 5 个 |
| 控制频率 | 20 Hz;每个原语 2 个控制步(0.1 s 仿真时间) |
| 决策预算 | 每次 GPT 决策至多 8 个原语 |
| 执行预算 | 100 次决策、300 个原语、600 个策略控制步 |
| 目标变化限制 | 每个控制步:平移 0.026 m,旋转 0.1 rad |
原表注:Embed2Evolve runtime and observation interface. Simulation time is distinct from client execution time, which includes API waiting.
表 26 解读
这张表定义了 GPT-6 Astra 控制机器人的“粒度”。一次 GPT 决策最多输出 8 个原语(primitive,即一个目标位姿加夹爪指令),每个原语执行 2 个控制步(20 Hz 下 0.1 秒)。所以一次决策最多推动 0.8 秒的仿真时间。一次执行最多 100 次决策、300 个原语、600 个控制步(30 秒仿真时间),先达到哪个上限就停止。目标变化限制(每步最多移动 2.6 cm、转 0.1 rad)保证每个原语只做小幅移动,防止大模型给出跳跃式目标。这些预算对理解表 31 很重要:决策次数少了,可能是每次决策输出更多原语,所以控制步数不一定减少。推理强度设为 low,意味着 GPT-6 Astra 在每次决策时只做很少的内部推理,以控制延迟和成本。
原文
Action execution and observation constraints. Each primitive specifies one arm's world-frame end-effector position in metres, unit XYZW quaternion, and gripper open/close command. Targets are transformed to that robot's base frame and executed by the native IK/PD controller. In the two-arm task, the other arm holds its measured pose at the start of the primitive. The shared prompt requires explicit targets, without hidden tool calls or automatic execution until a target is reached. It restricts observations to RGB, the robot's own state, the instruction, and public actions and feedback; object poses, private simulator state, and task code are excluded. A gripper command does not establish grasp success, nor does an IK target establish arrival. The
joint_eff field estimates the robot's own PD drive effort, not contact ground truth or measured torque. Native environment feedback determines task success.译文
动作执行与观测约束。每个原语指定一条手臂在世界坐标系下的末端执行器位置(单位为米)、XYZW 形式的单位四元数,以及夹爪开/合指令。目标被变换到该机器人的基座坐标系,由原生的 IK/PD 控制器执行。在双臂任务中,另一条手臂保持原语开始时测得的位姿。共享的提示词要求给出明确的目标,不允许隐藏的工具调用,也不允许“一直执行到到达目标为止”这种自动执行。它把观测限制为 RGB、机器人自身状态、指令以及公开的动作和反馈;物体位姿、仿真器私有状态和任务代码都被排除在外。夹爪指令并不代表抓取成功,IK 目标也不代表已经到达。
joint_eff 字段估计的是机器人自身 PD 驱动的出力,而不是接触的真值或测得的力矩。任务是否成功由环境原生的反馈决定。解释
这一段的重点是“防作弊”:大模型不能读物体的真实位姿(那会让任务变得很容易),只能像真实机器人一样看图像和自身状态;也不能调用“自动移动到目标”的工具。最后几句提醒,反馈中的信息都是“机器人自己的估计”,比如发了“闭合夹爪”不代表抓住了东西,GPT 必须从图像中判断。这些约束让 ManiSkill 实验更接近真实部署的信息条件。
原文
Historical-context prompt. Both conditions retain the Direct system prompt except that “This condition is Direct: no memory or retrieval.” is replaced by “A historical RGB video excerpt may accompany the current observations.” Both use this fixed preamble for historical video: “This reference is a uniformly random four-second excerpt from a retrieved historical video. The images are historical, not current observations.” Here, “uniformly random” is inherited prompt wording: both conditions use the clip associated with the retrieved anchor, not a randomly drawn excerpt from the selected video.
译文
历史上下文提示词。两种条件都保留 Direct 的系统提示词,只是把“This condition is Direct: no memory or retrieval.”(本条件为 Direct:无记忆、无检索)替换为“A historical RGB video excerpt may accompany the current observations.”(当前观测可能附带一段历史 RGB 视频摘录)。两者都为历史视频使用如下固定的前言: “This reference is a uniformly random four-second excerpt from a retrieved historical video. The images are historical, not current observations.(这段参考是从一段检索到的历史视频中均匀随机截取的 4 秒片段。这些图像是历史图像,不是当前观测。)” 这里的“uniformly random”(均匀随机)是沿用下来的提示词措辞:两种条件实际使用的都是与检索锚点相关联的那段片段,而不是从选中视频中随机抽取的片段。
解释
这是作者主动披露的一处“提示词与实际不符”:提示词告诉 GPT-6 Astra 参考片段是随机截取的,实际上却是检索锚点对应的片段。这个措辞可能让策略低估参考与当前阶段的相关性,因此如果有影响,大概率是让结果偏保守。两种嵌入条件用的是同一份提示词,所以不影响两者之间的比较。
原文
Anchor index and query. For Robota-Embed, the query combines the instruction, current main-camera RGB, and an endpoint-error action proxy derived from the most recent acknowledged active-arm command, rather than achieved displacement. Applying the LIBERO action codec to ManiSkill is an out-of-distribution adaptation.
译文
锚点索引与查询。对 Robota-Embed,查询由指令、当前主相机 RGB,以及一个“末端误差”动作代理量组成;这个代理量来自最近一次被确认的当前活动手臂指令,而不是实际达到的位移。把 LIBERO 的动作编码方式用于 ManiSkill,是一种分布外(out-of-distribution)的适配。
解释
这是理解 Embed2Evolve 的一个关键细节,正文没有提到:Robota-Embed 的训练数据里没有 ManiSkill,也没有 ManiSkill 对应的动作投影层。作者借用 LIBERO 的动作编码方式(LIBERO 同样是单臂仿真、10 维动作),把 ManiSkill 的动作“冒充” LIBERO 动作输入模型。而且输入的不是真实动作,而是“上一条指令的目标与当前位置之差”这样一个代理量。所以 Embed2Evolve 中 Robota-Embed 面对的是新仿真器、新任务、近似的动作表示,相当于一次跨域使用。在这种条件下依然明显优于 Omni-Embed,说明表示具有一定的迁移能力;但也意味着这里的检索质量无法用基准指标衡量。
原文
Omni-Embed-Nemotron-3B runs in BF16 with eager attention. Its query uses the
query: prefix, task text, and current RGB, without native actions; its target uses passage:, task text, and historical video. Retrieved context supplied to GPT includes the clip's public actions, execution feedback, relative timestamps, and robot state after command acknowledgement. These policy-context fields are distinct from the embedding model's inputs.译文
Omni-Embed-Nemotron-3B 以 BF16 精度、eager 注意力运行。它的查询使用
query: 前缀、任务文本和当前 RGB,不含原生动作;它的目标使用 passage: 前缀、任务文本和历史视频。提供给 GPT 的检索上下文包括该片段公开的动作、执行反馈、相对时间戳以及指令被确认后的机器人状态。这些策略上下文字段与嵌入模型的输入是两回事。解释
query:/passage: 前缀是这类检索嵌入模型的标准用法,用来区分查询和文档。最后一句再次强调“用什么检索”与“检索后给策略看什么”是分开的:两个条件给 GPT 看的内容格式完全一样,差别只在挑选哪些片段。原文
Memory indexes completed development episodes, including successes and failures. Each key represents a current-state anchor linked to at most four seconds of recorded RGB, commands, robot state, feedback, and timestamps. Retrieval matches the task and active arm, excludes episodes with the current seed, and selects anchors from distinct source episodes.
译文
记忆为已完成的开发回合建立索引,包括成功和失败的回合。每个键代表一个当前状态锚点,关联着至多 4 秒的已记录 RGB、指令、机器人状态、反馈和时间戳。检索时要求任务和活动手臂相匹配,排除与当前种子相同的回合,并从不同的源回合中挑选锚点。
解释
“排除与当前种子相同的回合”很关键:开发阶段在种子 0–9 上反复试跑,如果检索时允许取到同一种子(同一初始摆放)的历史回合,就等于直接拿到了这个初始状态的“答案”。测试种子是 40–59,与开发种子不重叠,所以测试时这一条自动成立;它主要约束开发阶段,避免开发分数虚高。
原文
Ranking and refresh. For candidate anchor j, let S_j\in\{0,1\} be its source episode's native success label and L_j its total control ticks, with budget 600. For normalized query and anchor vectors q,z_j from the chosen embedding model, the score uses success/efficiency bonuses \alpha,\beta:
R(q,j)=\operatorname{cos}(q,z_j)+\alpha S_j+\beta S_j\left(1-\frac{L_j}{600}\right).(9)
Candidates are ranked in descending order, with at most one anchor retained per source episode. The efficiency bonus rewards successful episodes that use fewer control ticks; tokens, cost, and policy decision counts do not enter the score. For example, 300 ticks with \alpha=0.10,\beta=0.03 adds 0.115 to cosine similarity. The episode-level label records the outcome of the whole attempt, so it does not establish that every local action was correct. Decision zero uses no retrieved context. Retrieval starts at decision one, refreshes at the selected cadence and upon an active-arm change, and caches context between refreshes. 译文
排序与刷新。对候选锚点 j,记 S_j\in\{0,1\} 为其源回合的环境原生成功标签,L_j 为该回合的总控制步数(预算为 600)。对由所选嵌入模型得到的归一化查询向量 q 和锚点向量 z_j,得分使用成功奖励 \alpha 和效率奖励 \beta:
R(q,j)=\operatorname{cos}(q,z_j)+\alpha S_j+\beta S_j\left(1-\frac{L_j}{600}\right).(9)
候选按得分降序排列,每个源回合至多保留一个锚点。效率奖励偏向使用控制步数更少的成功回合;token、费用和策略决策次数都不进入得分。例如,当 \alpha=0.10、\beta=0.03 时,一个用了 300 个控制步的成功回合会在余弦相似度上加 0.115。回合级标签记录的是整次尝试的结果,因此并不能说明每一个局部动作都是正确的。第 0 次决策不使用检索上下文。检索从第 1 次决策开始,按选定的频率刷新,并在活动手臂切换时刷新,两次刷新之间缓存上下文。 解释
式 (9) 的三项:余弦相似度衡量“状态有多像”;\alpha S_j 给成功回合一个固定加分;\beta S_j(1-L_j/600) 给成功且用时短的回合额外加分,最快(L_j\to0)时加 \beta,用满预算时加 0。失败回合(S_j=0)两项奖励都是 0,只靠相似度竞争。验算原文的例子:0.10\times1+0.03\times1\times(1-300/600)=0.10+0.015=0.115。这个加分相对余弦相似度的尺度不算小:如果候选之间的相似度差异只有百分之几,0.1 的成功奖励足以让成功回合压过更相似的失败回合。所以 \alpha 实际上控制着“偏好成功经验”与“偏好相似经验”之间的权衡,这也是它被纳入搜索空间(表 27)的原因。
原文
Failed attempts. Ordinary task failures and budget-exhausted episodes count as unsuccessful trials and can enter memory. With S_j=0, their anchors receive neither a bonus nor a penalty and remain retrievable by similarity. Exhausted repairs of malformed policy output also count as valid failures, but the memory builder does not admit these episodes. Audited infrastructure interruptions are excluded from the valid-trial denominator and memory; replacement runs complete the trial budget. The policy receives failed attempts as execution records under the fixed prompt; these records are not rewritten as prompt advice.
译文
失败的尝试。普通的任务失败和预算耗尽的回合都算作不成功的试验,可以进入记忆。由于 S_j=0,它们的锚点既不加分也不扣分,仍可凭相似度被检索到。策略输出格式错误、修复尝试用尽的回合也算作有效失败,但记忆构建器不收录这些回合。经过审核的基础设施中断不计入有效试验的分母,也不进入记忆;用补跑的回合补足试验数。策略在固定提示词下以执行记录的形式接收失败的尝试;这些记录不会被改写成提示建议。
解释
最后一句与相关工作中的 Reflexion 形成对照:Reflexion 会把失败总结成文字反思(“下次应该先……”),而这里失败回合只以原始执行记录的形式出现,由 GPT-6 Astra 自己从中判断。“基础设施中断”指 API 超时、仿真器崩溃等与策略无关的故障,排除它们是合理的,但具体排除了多少次原文没有报告。
D.2开发过程与选定的外壳(Development and Selected Harnesses)
原文
Search varies retrieval count k, refresh cadence \delta, history pairs H, and success/efficiency bonuses \alpha,\beta. Models, prompt prose, controller, and episode budgets stay fixed. Every candidate uses development seeds 0–9 and retains historical images. The history window keeps the most recent 2H messages, corresponding to H action/feedback pairs; \delta counts policy decisions. Each task begins with the three presets in Table 27.
译文
搜索改变的是检索条数 k、刷新间隔 \delta、历史对数 H,以及成功/效率奖励 \alpha,\beta。模型、提示词文字、控制器和回合预算都保持不变。每个候选配置都在开发种子 0–9 上评测,并保留历史图像。历史窗口保留最近的 2H 条消息,对应 H 个“动作/反馈”对;\delta 以策略决策次数计。每个任务都从表 27 中的三个预设配置开始。
解释
搜索空间只有 5 个超参数,规模很小。“外壳演化”在这里就是在这 5 个维度上做局部搜索,并不涉及修改提示词或代码。每个候选只在 10 个开发种子上评估,成功率的分辨率只有 10%。
表 27:初始上下文配置。所有预设都启用历史图像,并在同样的 10 个开发种子上评测。
| 预设 | k | 刷新间隔 \delta | 历史 H | \alpha | \beta |
| A | 2 | 2 | 12 | 0.10 | 0.03 |
| B | 1 | 4 | 6 | 0.10 | 0.10 |
| C | 2 | 1 | 8 | 0.15 | 0.05 |
原表注:Initial context configurations. All presets enable historical images and are evaluated on the same ten development seeds.
表 27 解读
三个预设代表三种风格:A 检索 2 条、每 2 次决策刷新一次、保留 12 对历史(“长历史”);B 只检索 1 条、每 4 次决策刷新、6 对历史,效率奖励较大(“省资源”);C 检索 2 条、每次决策都刷新、8 对历史,成功奖励较大(“频繁检索”)。对照表 28 可以看到,最终选中的外壳全部是 k=2,历史 H 多在 4–6(只有 Stack Cube 保留了预设 A 的 12),刷新间隔为 1–3。
原文
Memory expands between rounds, so development changes both available experience and its retrieval recipe. Search round r need not equal the numbered report round \ell: earlier transport-version rounds can contribute memory but are excluded from current-version configuration selection.
译文
记忆在轮次之间不断扩充,因此开发过程同时改变了可用的经验和检索配方。搜索轮次 r 不一定等于报告中编号的轮次 \ell:早期“传输版本”下的轮次可以贡献记忆,但不参与当前版本的配置选择。
解释
“传输版本”(transport version)大概指客户端与 API 之间的通信实现。实验进行中改过通信实现,旧版本下跑出的轮次结果不再用于选配置,但这些回合仍留在记忆里。这说明开发过程不是一次干净地跑完的,而是在工程迭代中进行的;附录 D.5 也提到评测中途改过 API 调用方式。这些细节不影响主要结论,但增加了复现难度。
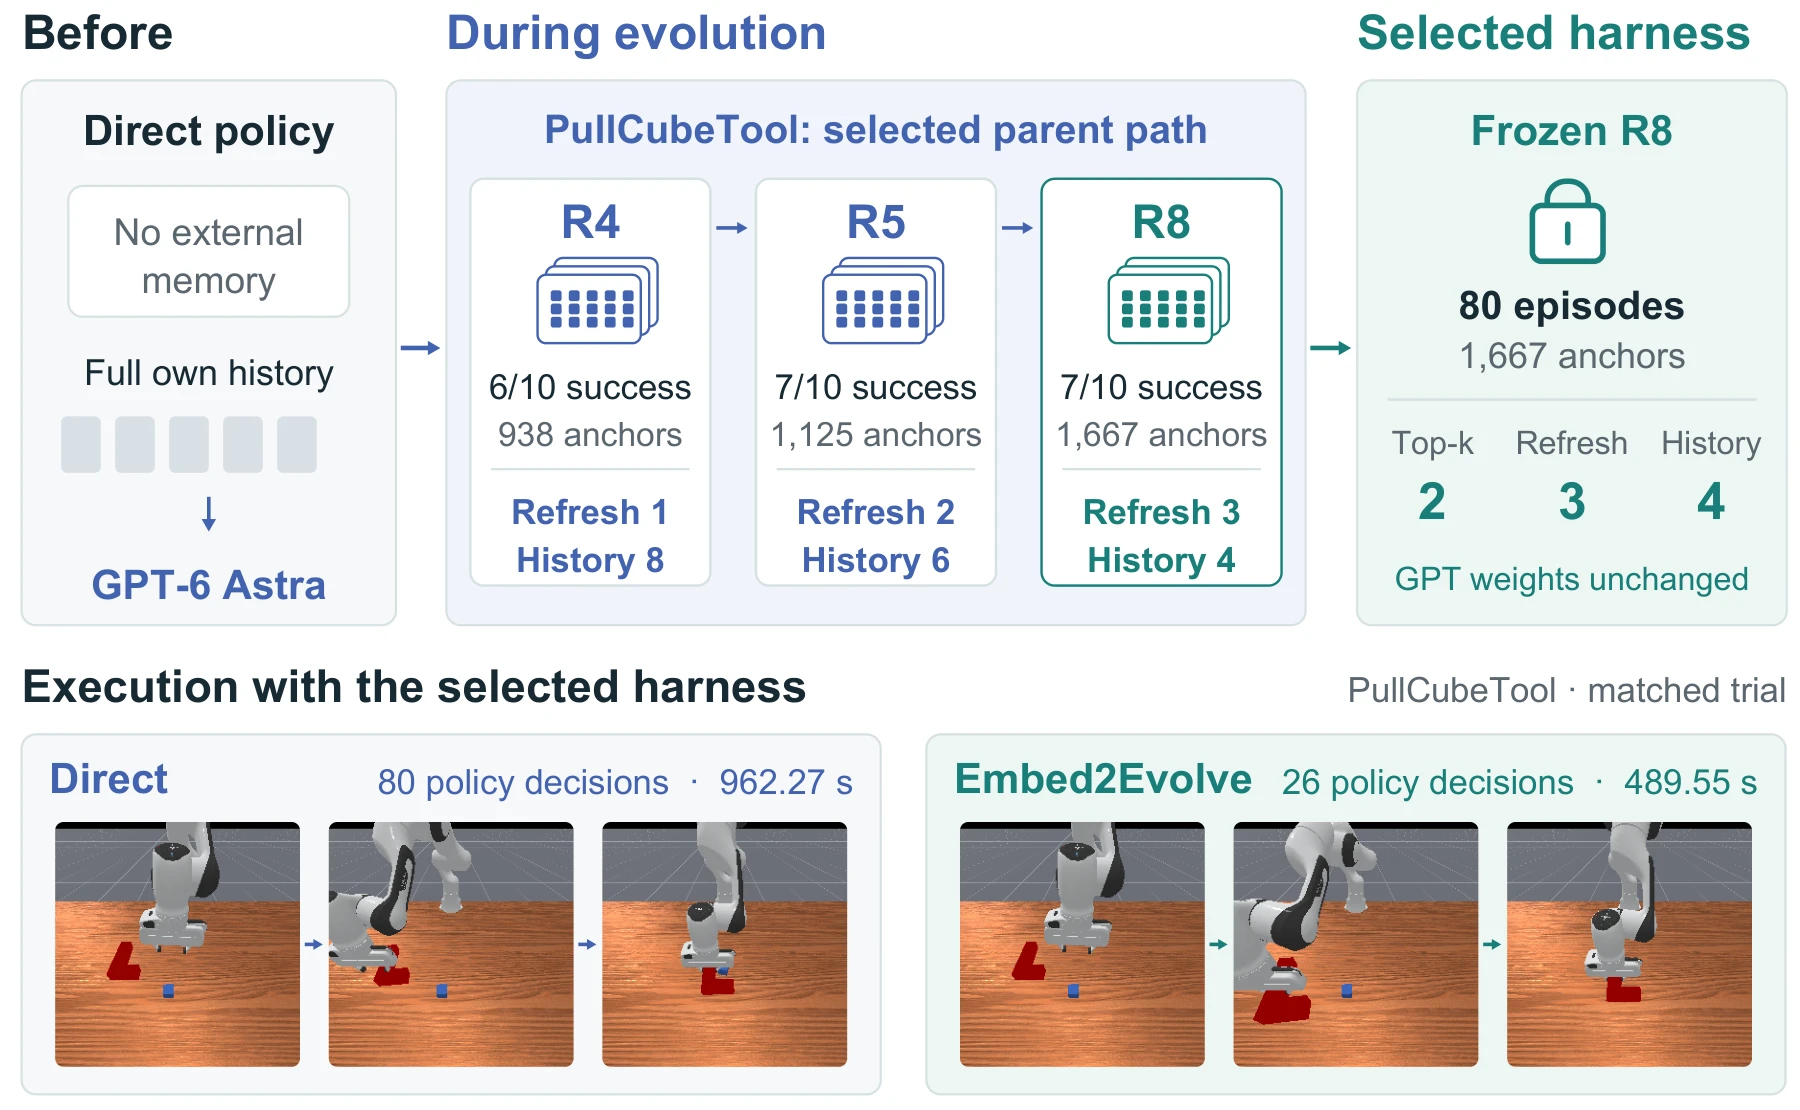
图 13:从 Direct 控制到选定的外壳。PullCubeTool 的 R4 \rightarrow R5 \rightarrow R8 父子序列在记忆增长的同时,减少了保留的历史和检索频率。底部的胶片条展示两个系统都成功完成的同一个全新测试初始化。任务执行时间包含 API 等待。
原图注:From Direct control to a selected harness. PullCubeTool's R4 \rightarrow R5 \rightarrow R8 parent–child sequence grows memory while reducing retained history and retrieval frequency. The bottom filmstrips show the same fresh-test initialization completed successfully by both systems. Task execution time includes API waits.
图 13 解读
上排三栏。“之前”(Before):Direct 策略没有外部记忆,只用完整的自身历史,交给 GPT-6 Astra。“演化中”(During evolution):PullCubeTool 被选中的父子路径 R4\toR5\toR8。R4 开发成功率 6/10、938 个锚点、每 1 次决策刷新、历史 8 对;R5 为 7/10、1,125 个锚点、刷新间隔 2、历史 6 对;R8 为 7/10、1,667 个锚点、刷新间隔 3、历史 4 对。“选定的外壳”(Selected harness):冻结的 R8,80 个回合、1,667 个锚点,top-k=2、刷新 3、历史 4,GPT 权重不变。下排是同一个测试初始化下的两次成功执行:Direct 用了 80 次策略决策、962.27 秒;Embed2Evolve 用了 26 次决策、489.55 秒。这正是表 31 中 Pull Cube with Tool 唯一的那一个配对(n=1)。从 R5 到 R8,开发成功率都是 7/10,没有提高;R8 胜出是因为在成功数相同时控制步数更少(式 (10) 的第二优先级)。这条路径展示的主要是“同样的成功率下更省资源”的演化,而不是成功率的持续提升。此外,R4 与 R5 的锚点数之差(187)与 R5 到 R8 之差(542)对应着轮次之间新增的开发回合。
原文
Success-first selection. Let \mathcal E contain the eligible numbered development rounds. For round \ell, write N_\ell for its number of successful trials, and \overline L_\ell,\overline T_\ell for mean control ticks and client execution time over its successful trials. We select lexicographically:
\ell^\star=\mathop{\operatorname{arg\,min}}_{\ell\in\mathcal E}\left(-N_\ell,\overline L_\ell,\overline T_\ell,\ell\right).(10)
We first maximize successes, then break ties by fewer control ticks, shorter time, and the earlier round. Every round contains ten valid trials. If none succeeds, both successful-trial means are +\infty, so rapid failure confers no efficiency advantage. Configuration selection thus ranks success and efficiency in order of priority; online retrieval combines them in a weighted score. 译文
成功优先的选择。记 \mathcal E 为符合条件的、已编号的开发轮次集合。对轮次 \ell,记 N_\ell 为其成功试验次数,\overline L_\ell,\overline T_\ell 为其成功试验的平均控制步数和平均客户端执行时间。我们按字典序选择:
\ell^\star=\mathop{\operatorname{arg\,min}}_{\ell\in\mathcal E}\left(-N_\ell,\overline L_\ell,\overline T_\ell,\ell\right).(10)
即先最大化成功次数,再依次按更少的控制步数、更短的时间和更早的轮次打破平局。每一轮都包含 10 次有效试验。如果一轮全部失败,两个“成功试验均值”都记为 +\infty,因此快速失败不会带来任何效率上的优势。所以,配置选择是按优先级依次比较成功与效率;而在线检索则是把两者合成一个加权分数。 解释
式 (10) 的“字典序最小化”:把每轮表示成四元组 (-N_\ell,\overline L_\ell,\overline T_\ell,\ell),先比第一个分量(成功次数取负,所以成功越多越小),相同再比第二个,依此类推。最后的 \ell 表示完全打平时取更早的一轮。一个统计上的隐患:每轮只有 10 次试验,在多达 7–8 个候选轮次中挑成功次数最多的,选中的那一轮的开发成功率会系统性地偏高(“赢家诅咒”)。图 14 与表 6 对照可以看到这一点:Two-Robot Stack Cube 选中轮次的开发成功率为 100%,测试为 85%。不过测试用的是与开发不重叠的种子,所以表 6 的测试成功率本身是无偏的。
原文
Local proposals. After the presets, search round r copies the current winner and makes one deterministic local proposal; all unlisted settings are inherited:
- If r\bmod 3=1, set \delta\leftarrow\min(4,\delta+1) and H\leftarrow6 if H>6, or H\leftarrow4 otherwise.
- If r\bmod 3=2, set \delta\leftarrow\max(1,\delta-1), k\leftarrow2, and \alpha\leftarrow\min(0.25,\alpha+0.05).
- If r\bmod 3=0, set k\leftarrow1 and \beta\leftarrow\min(0.20,\beta+0.05).
译文
局部提议。在三个预设之后,第 r 轮搜索复制当前的最优配置,并做一次确定性的局部改动;未列出的设置都沿用:
- 若 r\bmod 3=1:令 \delta\leftarrow\min(4,\delta+1);若 H>6 则令 H\leftarrow6,否则令 H\leftarrow4。
- 若 r\bmod 3=2:令 \delta\leftarrow\max(1,\delta-1),k\leftarrow2,\alpha\leftarrow\min(0.25,\alpha+0.05)。
- 若 r\bmod 3=0:令 k\leftarrow1,\beta\leftarrow\min(0.20,\beta+0.05)。
解释
三种改动循环出现:第一种“少刷新、短历史”(省 token),第二种“多刷新、多检索、更偏好成功经验”(加强检索),第三种“只检索 1 条、更偏好高效经验”。这是一套手工设计的、固定顺序的坐标式搜索,没有用大模型去提议配置,也没有随机性,因此“演化”的含义比较朴素。用图 13 验证:R4(\delta=1,H=8)\to R5(\delta=2,H=6)符合第一种改动(\delta+1,H>6 时降到 6);R5 \to R8 的 \delta 从 2 到 3、H 从 6 到 4,也符合第一种改动(H\le6 时降到 4)。所以 PullCubeTool 的选中路径上两次被采纳的改动都是“少刷新、短历史”,这解释了正文所说“记忆变大、历史变短”的趋势:并不是模型“学会”了用更少的历史,而是搜索规则只会朝这个方向改动,并且改动后成功率没有下降。
原文
Stopping and freezing. Stopping tracks the Pareto frontier of (N_\ell,-\overline L_\ell,-\overline T_\ell). A point dominates another when it is no worse in all three coordinates and better in at least one. A candidate adds a frontier point only if no existing point dominates it and its coordinates are not already present.
译文
停止与冻结。停止条件追踪 (N_\ell,-\overline L_\ell,-\overline T_\ell) 的帕累托前沿。若一个点在三个坐标上都不差、且至少在一个坐标上更好,就称它支配另一个点。只有当一个候选不被任何已有点支配、且其坐标尚未出现过时,它才为前沿增加一个新点。
解释
帕累托前沿是“成功次数多、控制步数少、用时短”三个目标下所有不被支配的配置的集合。新一轮如果在任何一个维度上带来了新的权衡,就算“有进展”。
原文
After at least three eligible rounds under the current transport version, two consecutive rounds without a new frontier point trigger stopping. A separate cap allows at most eight numbered development rounds per task, including earlier transport versions; baseline collection and formal testing do not count toward it. Any started round must complete ten valid trials.
译文
在当前传输版本下至少完成三个符合条件的轮次之后,若连续两轮都没有产生新的前沿点,就触发停止。另有一个单独的上限:每个任务至多八个编号的开发轮次,包括早期传输版本下的轮次;基线收集和正式测试不计入这一上限。任何已开始的轮次都必须完成 10 次有效试验。
解释
由于执行时间 \overline T_\ell 受 API 负载影响很大,几乎每一轮都可能在时间维度上产生“新的权衡”,从而成为新的前沿点。这可能解释了为什么多数任务都跑满了 8 轮。
原文
For each embedding model, formal testing freezes the winning configuration and the memory bank from that round. Test outcomes do not enter selection. The two conditions develop independently and can produce different banks and recipes. The comparison measures the embedding model's contribution through evolution, not a replacement within one final harness.
译文
对每个嵌入模型,正式测试冻结胜出的配置以及该轮的记忆库。测试结果不参与选择。两种条件各自独立开发,可能得到不同的记忆库和配方。这一比较衡量的是嵌入模型通过演化过程所做的贡献,而不是在同一个最终外壳中替换嵌入模型。
解释
“冻结该轮的记忆库”意味着如果选中的是第 5 轮,那么第 6–8 轮新增的回合不会进入测试用的记忆。这与表 28 中各任务的回合数(= 选中轮次 \times10)一致。
原文
With Robota-Embed, StackCube stops by the frontier rule after four rounds and TwoRobotStackCube after eight. PokeCube, LiftPegUpright, and PullCubeTool each reach the eight-round cap. The 36 recorded configurations and 360 trials include historical first rounds that are ineligible for selection. Table 28 lists the selected harnesses, and the trajectories below show eligible candidates.
译文
使用 Robota-Embed 时,StackCube 在四轮后按前沿规则停止,TwoRobotStackCube 在八轮后停止。PokeCube、LiftPegUpright 和 PullCubeTool 都达到了八轮上限。记录下来的 36 个配置和 360 次试验,包括不符合选择条件的早期第一轮。表 28 列出选中的外壳,下面的轨迹图展示符合条件的候选。
解释
验算:4+8+8+8+8=36 轮,每轮 10 次试验,共 360 次。“TwoRobotStackCube 在八轮后按前沿规则停止”恰好与八轮上限重合,两种停止原因此时无法区分。图 14 的横轴从第 2 轮开始,正是因为第 1 轮属于不参与选择的早期轮次。
表 28:选定的 Embed2Evolve 外壳。记忆库大小以开发回合数和已索引锚点数计。刷新间隔以 GPT 决策次数计;H 为保留的“动作/反馈”对数。
| 任务 | 轮次 | 回合数 | 锚点数 | k | 刷新间隔 | H | \alpha/\beta |
| Poke Cube | 8 | 80 | 1,610 | 2 | 2 | 6 | .15/.05 |
| Stack Cube | 2 | 20 | 454 | 2 | 2 | 12 | .10/.03 |
| Lift Peg Upright | 6 | 60 | 1,116 | 2 | 1 | 6 | .20/.05 |
| Pull Cube with Tool | 8 | 80 | 1,667 | 2 | 3 | 4 | .15/.05 |
| Two-Robot Stack Cube | 5 | 50 | 1,126 | 2 | 3 | 6 | .10/.03 |
原表注:Selected Embed2Evolve harnesses. Bank sizes count development episodes and indexed anchors. Cadence counts GPT decisions; H counts retained action/feedback pairs.
表 28 解读
每行是一个任务最终冻结的外壳。回合数恰好等于轮次乘以 10,说明记忆库收录了截至该轮的全部开发回合。平均每个回合贡献约 20 个锚点(例如 1{,}667/80\approx20.8)。Stack Cube 选中的是第 2 轮,配置与预设 A 完全相同(k=2,\delta=2,H=12,\alpha/\beta=.10/.03),也就是说在这个任务上演化没有带来比初始预设更好的配置;Two-Robot Stack Cube 的 \alpha/\beta 同样是预设 A 的值。只有 Robota-Embed 的外壳给出了具体配置,Omni-Embed 外壳的配置没有列出,无法比较两者演化出的配方有何不同。
D.3开发轨迹(Development Trajectories)
原文
Figure 14 traces Robota-Embed's candidate performance. Decision counts average each round's successful trials; test-time efficiency uses matched initializations (Section D.5). Hollow diamonds mark selected harnesses, which need not come from the final round.
译文
图 14 追踪 Robota-Embed 各候选配置的表现。决策次数是对每轮成功试验取平均;测试时的效率则使用匹配的初始化(附录 D.5)。空心菱形标出选中的外壳,它不一定来自最后一轮。
解释
开发阶段的决策次数只在“本轮成功的试验”上平均,不同轮次的成功试验集合不同,所以这条曲线只能粗略比较,不是配对比较。
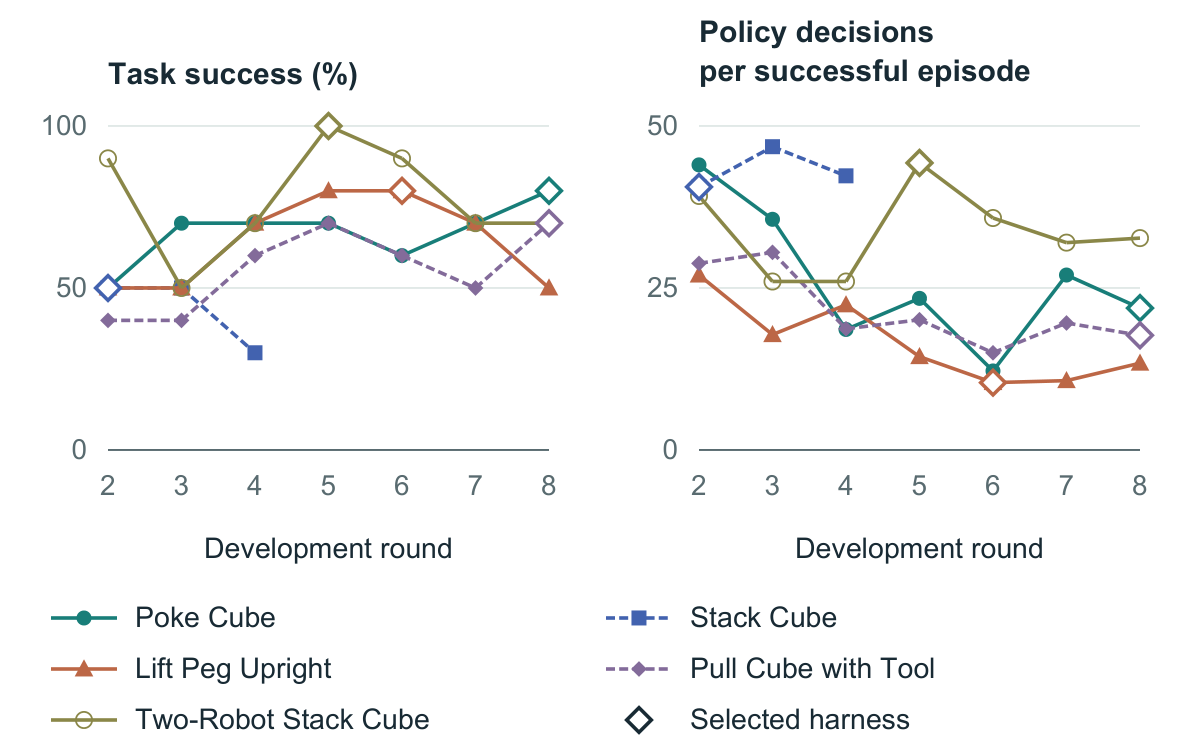
图 14:各任务的开发轨迹。成功率基于每轮 10 次试验;决策次数是该轮成功试验的平均值。空心菱形标出选中的外壳。连线只是把评测过的候选按轮次连起来,不一定代表父子配置关系。
原图注:Task-wise development trajectories. Success uses ten trials per round; decisions average that round's successful trials. Hollow diamonds mark selected harnesses. Lines connect evaluated candidates, not necessarily parent–child configurations.
图 14 解读
左图是每轮的开发成功率(%),右图是每轮成功回合的平均策略决策次数,横轴都是开发轮次 2–8。五条线对应五个任务,空心菱形是最终选中的轮次。读图:Two-Robot Stack Cube(橄榄色空心圆)在第 5 轮达到 100% 并被选中,之后几轮回落到 90%、70%、70%,说明同一套配置附近的成功率波动可达 30 个点,10 次试验的估计噪声很大。Stack Cube(蓝色虚线方块)只有第 2–4 轮,成功率 50%、50%、30%,选中第 2 轮,开发成功率只有 50%,测试却达到 60%。Poke Cube(绿色实心圆)和 Pull Cube with Tool(紫色虚线菱形)都选中第 8 轮,成功率分别为 80% 和 70%。Lift Peg Upright(橙色三角)在第 5、6 轮都是 80%,选中第 6 轮,说明它在控制步数上更少。右图显示多数任务随轮次推进,成功回合的决策次数有下降趋势(例如 Lift Peg Upright 从约 27 降到 10 左右),这与“记忆增长、历史缩短”的演化方向一致。但曲线起伏很大,不宜解读为单调的改进过程。
D.4嵌入模型对比(Embedding-Model Comparison)
原文
Table 29 lists the completed and selected rounds for each embedding model. Both stay within the eight-round cap and produce their own memory banks and context configurations.
译文
表 29 列出每个嵌入模型完成的轮次和选中的轮次。两者都在八轮上限之内,并各自产生了自己的记忆库和上下文配置。
解释
“都在八轮上限之内”说明两边的开发预算上限相同,但实际用掉的轮数不同(见表 29 的解读)。
表 29:匹配搜索规则下的独立开发。完成轮次统计所有编号的轮次;选中轮次标明冻结用于测试的配置和记忆所在的轮次。
| Omni-Embed-Nemotron-3B | Robota-Embed | |||
| 任务 | 完成 | 选中 | 完成 | 选中 |
| Poke Cube | 8 | 6 | 8 | 8 |
| Stack Cube | 6 | 3 | 4 | 2 |
| Lift Peg Upright | 8 | 4 | 8 | 6 |
| Pull Cube with Tool | 3 | 1 | 8 | 8 |
| Two-Robot Stack Cube | 7 | 5 | 8 | 5 |
原表注:Independent development under matched search rules. Completed rounds count all numbered rounds; selected rounds identify the configuration and memory frozen for testing.
表 29 解读
两个嵌入模型在同样的搜索规则下走出了不同的开发路径。Omni-Embed 在 Pull Cube with Tool 上只完成了 3 轮,选中第 1 轮;在 Stack Cube 上完成 6 轮,比 Robota-Embed 多 2 轮。Robota-Embed 在四个任务上跑满或接近 8 轮。两者合计完成的轮次分别为 32 和 36,开发预算大体相当。有一处与正文描述不太协调:附录 D.2 说第一轮属于“不符合选择条件的早期轮次”,图 14 的横轴也从第 2 轮开始,但 Omni-Embed 在 Pull Cube with Tool 上选中的恰恰是第 1 轮。可能两个条件的轮次编号方式不同,例如 Omni-Embed 的开发没有经历传输版本的变更,因此第 1 轮也有资格被选中,但原文没有说明。此外,Omni-Embed 在这个任务上只跑了 3 轮就按“连续两轮无新前沿点”的规则停止,而 D.2 要求“至少三个符合条件的轮次”之后才检查停止条件,3 轮正好是最少需要的轮数。
原文
The selected Omni-Embed-Nemotron-3B releases' frozen banks contain 182 rollout videos: 49 from the original Direct collection and 133 from that condition's own development, with 30 successful and 152 failed rollouts. These are the selected-round snapshots, not a post-hoc merge of all development trajectories. Video counts differ from indexed-anchor counts; failed rollouts remain retrievable by similarity under the scoring rule in Section D.1.
译文
选定的 Omni-Embed-Nemotron-3B 版本冻结的记忆库共包含 182 段执行视频:49 段来自最初的 Direct 收集,133 段来自该条件自己的开发过程;其中 30 段成功、152 段失败。这些是选中轮次的快照,而不是事后把所有开发轨迹合并的结果。视频数量不同于已索引锚点的数量;在附录 D.1 的打分规则下,失败的执行仍可以凭相似度被检索到。
解释
这组数字提供了一个重要的背景:Omni-Embed 外壳的记忆中成功经验只占 30/182\approx16\%。由于式 (9) 中成功回合有加分,记忆中成功样本少时,检索结果中失败经验的比例就高,这可能是 Omni-Embed 外壳效果较差的一个机制性原因。原文没有给出 Robota-Embed 外壳记忆库中成功与失败的比例,无法直接对比。另外,“初始记忆”包含 49 段 Direct 收集的视频(五个任务各约 10 段),这说明两种条件的开发都不是从空记忆开始,而是从同一批 Direct 执行记录开始的。表 28 中 Robota-Embed 外壳的“回合数”恰为轮次乘以 10,与这里“Direct 收集 + 自身开发”的计数方式之间的关系,原文没有交代清楚。
原文
The two context systems evolve independently; the embedding-model replacement changes both input modalities and retrieval training. It is neither an action-only ablation nor an encoder swap within one fixed final harness. Fewer high-level decisions can coexist with more physical control ticks (Table 31): these metrics measure different aspects of execution.
译文
两个上下文系统各自独立演化;替换嵌入模型同时改变了输入模态和检索训练。它既不是只针对动作的消融,也不是在一个固定的最终外壳中更换编码器。高层决策次数的减少可以与物理控制步数的增加同时出现(表 31):这些指标衡量的是执行的不同方面。
解释
这段把对照实验的局限说得很清楚:Robota-Embed 与 Omni-Embed 的差别不只是“有没有动作”,还包括模型结构、训练数据(Robota-Embed 在机器人数据上训练过)和检索目标。所以表 6 中 68% 对 33% 的差距不能直接归因于动作模态。
D.5全新测试的协议与效率(Fresh-Test Protocol and Efficiency)
原文
The five tasks—PokeCube, StackCube, LiftPegUpright, PullCubeTool, and TwoRobotStackCube—were selected from earlier development results. All four conditions use the same 20 test seeds (40–59) per task, disjoint from development seeds 0–9, yielding 400 valid test episodes. We measure native task success; budget exhaustion and policy failures count as failures. Audited infrastructure interruptions are excluded.
译文
这五个任务(PokeCube、StackCube、LiftPegUpright、PullCubeTool 和 TwoRobotStackCube)是根据较早的开发结果选出的。四种条件在每个任务上都使用同样的 20 个测试种子(40–59),与开发种子 0–9 不重叠,共得到 400 个有效测试回合。我们衡量环境原生的任务成功;预算耗尽和策略失败都算作失败。经过审核的基础设施中断不计入。
解释
验算:5 个任务 \times 4 种条件 \times 20 个种子 =400。“根据较早的开发结果选出”是一个选择偏差的来源:如果当初是因为某些任务上检索效果好才选它们,表 6 的提升就会偏高。原文没有说明选择标准,也没有报告被淘汰的任务。
原文
System comparisons. GPT-6 Astra Direct (Direct) uses its original prompt and full within-episode action/feedback history without external memory. GPT-6 Astra + random history adds one randomly sampled same-task development clip with up to eight ordered RGB frames. This RGB-only reference remains fixed within the episode. The harnesses evolved with Omni-Embed-Nemotron-3B and Robota-Embed use their selected memories, bounded histories, ranking, and context refresh. Table 6 compares these four context systems.
译文
系统比较。GPT-6 Astra Direct(Direct)使用其原始提示词和完整的回合内动作/反馈历史,没有外部记忆。GPT-6 Astra + random history 额外加入一段随机抽取的同任务开发片段,含至多 8 帧按顺序排列的 RGB 图像。这段只含 RGB 的参考在整个回合内保持不变。用 Omni-Embed-Nemotron-3B 和 Robota-Embed 演化出的外壳,则使用各自选定的记忆、有界的历史、排序规则和上下文刷新。表 6 比较了这四种上下文系统。
解释
随机历史基线只有一段、至多 8 帧、只有 RGB、全程不刷新;两个演化外壳每次检索 k 段、带动作和反馈、按间隔刷新、历史有界。两者在信息量和形式上差别很大,所以随机历史基线只能说明“随便加一段画面没有用”,不能作为检索质量的严格对照。真正有说服力的对照是 Omni-Embed 外壳。
原文
Success rates and token-use means include all test trials; decision-count and execution-time comparisons use shared successes. Table 30 specifies each metric's population and aggregation rule.
译文
成功率和 token 用量的均值包含全部测试试验;决策次数和执行时间的比较只使用双方都成功的试验。表 30 规定了每个指标所用的样本总体和汇总规则。
解释
这是第 5.2 节已经强调过的两种口径,下表把它们正式列出。
表 30:Embed2Evolve 测试指标的统计口径。五个任务等权。配对比较和参考 API 费用只针对 Direct 与 Embed2Evolve。
| 指标 | 测试样本 | 五任务汇总方式 |
| 任务成功率 | 四种条件下每个任务的全部 20 次试验 | 各任务成功率的平均。 |
| 策略决策次数与执行时间 | 在 Direct 和 Embed2Evolve 下都成功的匹配初始化 | 各任务相对降幅的平均;加速比为 Direct/Embed2Evolve 时间比的平均。 |
| 策略 token | Direct、Omni-Embed-Nemotron-3B 演化外壳和 Embed2Evolve 每个任务的全部 20 次试验,包括失败 | 先按任务求每次执行的均值并等权平均,再计算相对降幅。 |
| 参考 API 费用 | Direct 和 Embed2Evolve 每个任务的全部 20 次试验,包括失败 | 在固定输入/输出单价下,对等权的每次执行均值计算相对降幅。 |
原表注:Embed2Evolve test-metric accounting. All five tasks receive equal weight. Paired comparisons and reference API costs use Direct and Embed2Evolve.
表 30 解读
这张表的价值在于把每个数字的口径写清楚。要注意两种不同的平均顺序:决策次数和时间是“先算每个任务的降幅,再平均降幅”;token 和费用是“先把五个任务的均值平均,再算一次降幅”。前者让每个任务的降幅等权,后者让每个任务的绝对 token 数等权。两种方法得到的数字不能互相换算,例如时间的“平均降幅 41.4%”与“平均加速比 1.90\times”就互不对应(见第 5.2 节的解释)。另外,token 比较中包括了 Omni-Embed 外壳,费用比较中却没有,因为它没有输入/输出 token 的拆分(附录 D.6)。
原文
Efficiency accounting. Direct and Embed2Evolve both succeed on 7, 2, 5, 1, and 4 matched initializations in task order. Here, Evolve denotes Embed2Evolve. Per task, we compute the reduction 100(1-\overline{x}_{\rm Evolve}/\overline{x}_{\rm Direct}) on this paired set. Averaging the five task-wise reductions equally gives 64.1% fewer policy decisions and 41.4% less task execution time.Observed mean speedup is \frac{1}{5}\sum_{j=1}^{5}\overline{T}_{{\rm Direct},j}/\overline{T}_{{\rm Evolve},j}\approx 1.90, where each mean uses that task's shared successful trials. The 1.90\times speedup and 41.4% reduction average task-wise time ratios and relative savings, respectively.
译文
效率的计算方式。按任务顺序,Direct 和 Embed2Evolve 都成功的匹配初始化分别有 7、2、5、1、4 个。这里 Evolve 指 Embed2Evolve。对每个任务,我们在这一配对集合上计算降幅 100(1-\overline{x}_{\rm Evolve}/\overline{x}_{\rm Direct})。把五个任务的降幅等权平均,得到策略决策次数减少 64.1%、任务执行时间减少 41.4%。观测到的平均加速比为 \frac{1}{5}\sum_{j=1}^{5}\overline{T}_{{\rm Direct},j}/\overline{T}_{{\rm Evolve},j}\approx 1.90,其中每个均值都只用该任务双方共同成功的试验。1.90\times 的加速比和 41.4% 的降幅,分别是对各任务时间比和相对节省取平均的结果。
解释
用表 31 逐项验算。决策次数的五个任务降幅:1-22.71/34.86=34.9\%,1-10/45=77.8\%,1-12.4/57.2=78.3\%,1-26/80=67.5\%,1-33/87.25=62.2\%,平均 64.1%,与原文一致。执行时间的降幅:8.9%、62.7%、57.8%、49.1%、28.7%,平均 41.4%。时间比:1.10、2.68、2.37、1.97、1.40,平均 1.90。三个数字都能复现。但这种“任务等权”的平均对样本量极不均衡:Pull Cube with Tool 只有 1 个配对、Stack Cube 只有 2 个,它们与有 7 个配对的 Poke Cube 权重相同。恰好降幅最大的两个任务(Stack Cube 77.8%、Lift Peg Upright 78.3%)中有一个只有 2 个配对;若按配对数加权,决策次数的降幅约为 (7\times34.9+2\times77.8+5\times78.3+1\times67.5+4\times62.2)/19\approx58.3\%,时间降幅约为 33.7%,都比原文报告的等权平均低。全部结论都建立在 19 个配对之上,样本量有限。
原文
Task execution time includes context preparation, API waiting, and execution overhead, but excludes embedding-model cold-start time. It varies with API load, whereas replay videos show simulation time without API waits.
译文
任务执行时间包括上下文准备、API 等待和执行开销,但不包括嵌入模型的冷启动时间。它会随 API 负载变化,而回放视频显示的是不含 API 等待的仿真时间。
解释
表 26 中一个原语对应 0.1 秒仿真时间;而 Direct 在 Poke Cube 上的平均执行时间约 419 秒,控制步数只有 133(约 6.7 秒仿真时间),说明墙钟时间几乎全部花在 API 调用和等待上,与机器人实际运动的快慢关系不大。
原文
During this evaluation, rate-limit recovery changed API caller handling mid-batch, and Direct was added after the batch began. Concurrency, CPU placement, and API load were not controlled across conditions. These differences confound wall-time attribution: the reported time ratios describe observed execution, not an isolated method-induced speedup.
译文
在这次评测过程中,为了从速率限制中恢复,API 调用方的处理方式在批次中途有所改变,而且 Direct 是在批次开始之后才加入的。各条件之间的并发度、CPU 分配和 API 负载都没有加以控制。这些差异混淆了墙钟时间的归因:报告的时间比描述的是观测到的执行情况,而不是方法本身带来的独立加速。
解释
作者主动披露了一个严重的实验控制问题:Direct 和 Embed2Evolve 不是在同样的系统条件下运行的。因此 41.4% 的时间节省和 1.90\times 的加速比只能作为参考,不能作为方法优势的证据。相比之下,决策次数和 token 数不受系统负载影响,是更可靠的效率指标。
原文
Table 31 reports physical control ticks separately from GPT decisions.
译文
表 31 把物理控制步数与 GPT 决策次数分开报告。
解释
控制步数反映机器人实际“动了多久”,决策次数反映大模型“想了几次”。
表 31:双方都成功时的效率与物理控制。三项指标都是在同样 n 个匹配的成功初始化上的均值,Direct \rightarrow Embed2Evolve。执行时间包含 API 等待。控制步数变化为 100(\mathrm{Evolve}/\mathrm{Direct}-1);正值表示尽管 GPT 决策更少,物理控制步数却更多。
| 任务 | 配对 n | 策略 决策次数 | 执行 时间(s) | 控制 步数 | 步数变化 (%) |
| Poke Cube | 7 | 34.86 \rightarrow22.71 | 419.30 \rightarrow382.16 | 133.0 \rightarrow 181.4 | +36.4 |
| Stack Cube | 2 | 45.00 \rightarrow10.00 | 499.03 \rightarrow186.35 | 90.0 \rightarrow 65.0 | -27.8 |
| Lift Peg Upright | 5 | 57.20 \rightarrow12.40 | 556.06 \rightarrow234.46 | 152.0 \rightarrow 149.6 | -1.6 |
| Pull Cube with Tool | 1 | 80.00 \rightarrow26.00 | 962.27 \rightarrow489.55 | 347.0 \rightarrow 337.0 | -2.9 |
| Two-Robot Stack Cube | 4 | 87.25 \rightarrow33.00 | 1054.67 \rightarrow751.59 | 206.0 \rightarrow 312.8 | +51.8 |
原表注:Efficiency and physical control on shared successes. Direct \rightarrow Embed2Evolve means over the same n matched successful initializations for all three metrics. Execution time includes API waiting. Tick change is 100(\mathrm{Evolve}/\mathrm{Direct}-1); positive values indicate more physical control ticks despite fewer GPT decisions.
表 31 解读
每行是一个任务在共同成功的配对上的三项均值(箭头左边 Direct,右边 Embed2Evolve)。步数变化可验算:Poke Cube 181.4/133.0-1=+36.4\%,Two-Robot Stack Cube 312.8/206.0-1=+51.8\%。最值得注意的是步数一列:五个任务中有两个的控制步数明显增加(+36.4%、+51.8%),两个几乎不变,只有 Stack Cube 明显减少(但只有 2 个配对)。结合决策次数大幅下降,可以推断 Embed2Evolve 让 GPT-6 Astra 在每次决策中输出更多原语(每次最多 8 个),也就是“每次想得更远、动得更多”。例如 Poke Cube 上每次决策的平均控制步数从 133.0/34.86\approx3.8 增至 181.4/22.71\approx8.0。所以 Embed2Evolve 节省的是大模型调用,而不是机器人的运动时间;在需要实时控制的真实场景中,物理执行时间可能并不会缩短。另一个细节:Direct 在 Pull Cube with Tool 上用了 80 次决策、347 个控制步,平均每次决策约 4.3 步(约 2 个原语),远低于每次 8 个原语的上限,说明 Direct 时 GPT 倾向于小步试探。
D.6token 用量与参考费用(Token Usage and Reference Cost)
原文
Table 32 reports mean policy input, output, and total tokens across all 20 test rollouts per task and condition, including successes and failures, for GPT-6 Astra Direct and Embed2Evolve. We average the five task means equally before comparing methods: total tokens fall from 920,979.76 to 518,216.15 per rollout, a 43.7% reduction. Reference API cost falls from $9.9641 to $5.7980, or 41.8%. Both reductions use 100(1-\overline{x}_{\rm Evolve}/\overline{x}_{\rm Direct}) on these five-task means. They measure resource use per attempt, including failures; timing in Section D.5 uses initializations on which both Direct and Embed2Evolve succeed.
译文
表 32 报告 GPT-6 Astra Direct 和 Embed2Evolve 在每个任务、每种条件全部 20 次测试执行(包括成功和失败)上的平均策略输入 token、输出 token 和总 token。比较方法之前,我们先对五个任务的均值等权平均:每次执行的总 token 从 920,979.76 降到 518,216.15,降幅 43.7%。参考 API 费用从 9.9641 美元降到 5.7980 美元,降幅 41.8%。两个降幅都是在这些五任务均值上用 100(1-\overline{x}_{\rm Evolve}/\overline{x}_{\rm Direct}) 计算的。它们衡量的是每次尝试(包括失败)的资源消耗;附录 D.5 中的时间比较则使用 Direct 和 Embed2Evolve 都成功的初始化。
解释
验算:1-518{,}216.15/920{,}979.76=1-0.5627=43.7\%;1-5.7980/9.9641=41.8\%。费用的降幅比 token 小,是因为节省主要来自输入 token(单价较低),输出 token(单价是输入的 5 倍)降得较少。一个解读上的注意:token 按全部执行平均,而失败的执行往往会耗尽预算、消耗更多 token。Embed2Evolve 成功率高得多(68% 对 24%),失败执行少,这本身就会拉低平均 token。所以 43.7% 的节省中,一部分来自“更少失败”,一部分来自“每次决策的上下文更短”,原文没有把这两部分分开。
原文
Reference costs use fixed rates of $10 per million input tokens and $50 per million output tokens, giving (10I+50O)/10^6 USD for input count I and output count O. This fixed-rate estimate of test-time policy cost excludes cache discounts, retrieval, simulation, and memory/harness development.
译文
参考费用使用固定单价:每百万输入 token 10 美元,每百万输出 token 50 美元;对输入数 I、输出数 O,费用为 (10I+50O)/10^6 美元。这种固定单价的估计只覆盖测试时的策略费用,不包括缓存折扣、检索、仿真以及记忆/外壳的开发。
解释
用 Poke Cube 的 Direct 一行验算:(10\times693{,}733.05+50\times16{,}052.50)/10^6=6.937+0.803=7.740 美元,与表 32 一致。“不包括开发”是重要的限定:Embed2Evolve 每个任务要先跑多达 80 次开发回合,开发阶段的花费原文没有报告。如果按每次约 0.5–1M token 估算,开发成本相当于几十到上百次测试执行,需要在多次部署中才能摊薄。
表 32:每次执行的策略 token 用量与参考费用。均值包含每个任务、每种条件全部 20 次测试执行,不论结果如何。Direct 即 GPT-6 Astra Direct;最后一组为各任务均值的等权平均。美元估计采用上文的固定输入/输出单价。
| 方法 | 输入 token | 输出 token | 总 token | 参考费用 (美元) |
| Poke Cube | ||||
| Direct | 693,733.05 | 16,052.50 | 709,785.55 | 7.7400 |
| Embed2Evolve | 375,759.60 | 12,903.40 | 388,663.00 | 4.4028 |
| Stack Cube | ||||
| Direct | 935,086.30 | 18,401.05 | 953,487.35 | 10.2709 |
| Embed2Evolve | 656,130.60 | 19,000.10 | 675,130.70 | 7.5113 |
| Lift Peg Upright | ||||
| Direct | 839,705.25 | 16,225.95 | 855,931.20 | 9.2083 |
| Embed2Evolve | 380,229.95 | 13,087.65 | 393,317.60 | 4.4567 |
| Pull Cube with Tool | ||||
| Direct | 955,384.05 | 20,302.90 | 975,686.95 | 10.5690 |
| Embed2Evolve | 399,519.65 | 15,041.75 | 414,561.40 | 4.7473 |
| Two-Robot Stack Cube | ||||
| Direct | 1,086,699.35 | 23,308.40 | 1,110,007.75 | 12.0324 |
| Embed2Evolve | 702,461.85 | 16,946.20 | 719,408.05 | 7.8719 |
| 五任务平均 | ||||
| Direct | 902,121.60 | 18,858.16 | 920,979.76 | 9.9641 |
| Embed2Evolve | 502,820.33 | 15,395.82 | 518,216.15 | 5.7980 |
原表注:Policy token usage and reference cost per rollout. Means include all 20 test rollouts per task and condition, regardless of outcome. Direct denotes GPT-6 Astra Direct; the final group averages task means equally. USD estimates use the fixed input/output rates above.
表 32 解读
每个任务两行,最后是五任务平均。输出 token 只占总量的约 2%,费用主要由输入决定。各任务总 token 的降幅:Poke Cube 45.2%,Stack Cube 29.2%,Lift Peg Upright 54.0%,Pull Cube with Tool 57.5%,Two-Robot Stack Cube 35.2%。五任务平均的输入 token 可验算:(693{,}733.05+935{,}086.30+839{,}705.25+955{,}384.05+1{,}086{,}699.35)/5=902{,}121.60,与表中一致。Stack Cube 上 Embed2Evolve 的输出 token 反而略增(18,401\to19,000),但输入 token 大降,总量仍减少。降幅最大的 Pull Cube with Tool 和 Lift Peg Upright 恰好是选中外壳 H 较小(4 和 6)的任务;Stack Cube 的外壳保留了 12 对历史,降幅也最小。这支持“节省主要来自缩短历史”的解释。即便是 Embed2Evolve,每次执行仍要消耗约 50 万 token、约 5.8 美元(按参考单价),这意味着用前沿大模型直接控制机器人的成本仍然很高。
原文
Total token use decreases on every task, most on Pull Cube with Tool (57.5%). Input tokens account for most of the savings. Even on Stack Cube, where output usage increases, the reduction in input tokens lowers total consumption.
译文
总 token 用量在每个任务上都有所减少,降幅最大的是 Pull Cube with Tool(57.5%)。节省的大部分来自输入 token。即使在输出用量增加的 Stack Cube 上,输入 token 的减少也降低了总消耗。
解释
验算:1-414{,}561.40/975{,}686.95=57.5\%。
原文
Token use after matched context evolution. The Omni-Embed-Nemotron-3B comparison in Table 6 uses all final test rollouts of the independently evolved, frozen harnesses, including failures, and excludes development consumption. Its aggregate total-token comparison does not establish a wall-time or monetary-cost ratio: neither an Omni-Embed-Nemotron-3B input/output split nor matched-success timing is available.
译文
匹配的上下文演化之后的 token 用量。表 6 中与 Omni-Embed-Nemotron-3B 的比较,使用的是各自独立演化并冻结的外壳的全部最终测试执行(包括失败),不包括开发阶段的消耗。这一总 token 比较并不能给出墙钟时间或费用上的比值:Omni-Embed-Nemotron-3B 既没有输入/输出 token 的拆分,也没有双方都成功时的计时。
解释
这解释了表 6 中 Omni-Embed 的 token 数为什么带“\approx”:只有总量的估计。摘要中“约少 79.5% 的策略 token”指的就是这个总量比较,它不能换算成费用节省。
E相关检索协议(Related Retrieval Protocols)
原文
Table 33 compares retrieval inputs, the role of action, gallery scope, and policy dependence. Action can enter the retrieval key, a retrieved record, or the consuming policy's output. Policy coupling specifies how the retrieval interface depends on that policy; lifetime specifies the scope over which retrieved experience is stored or reused. In Zeva, both phase keys encode recurrent interaction history, including executed actions and observed effects. RADAR's row follows its observation–language retrieval formulation. Embed2ICL and Embed2Evolve share Robota-Embed's retrieval space.
译文
表 33 比较各方法的检索输入、动作所扮演的角色、候选库的范围以及对策略的依赖。动作可以进入检索键、被检索出的记录,或者使用检索结果的策略的输出。策略耦合(policy coupling)说明检索接口在多大程度上依赖于那个策略;生命周期(lifetime)说明检索到的经验在什么范围内被存储或复用。在 Zeva 中,两个阶段键都编码了循环的交互历史,包括已执行的动作和观察到的效果。RADAR 一行按照其“观测—语言”检索的表述填写。Embed2ICL 和 Embed2Evolve 共享 Robota-Embed 的检索空间。
解释
这一节是第 2 节相关工作的表格化总结。“策略耦合”区分了两类设计:独立(Independent)的检索器可以服务任何策略,例如本文的 Robota-Embed 同时服务 DreamZero、Fast-WAM 和 GPT-6 Astra;耦合(Coupled)的检索器则与某个特定策略一起设计,例如 REGENT、RICL 把检索到的动作与策略输出混合。
表 33:有代表性的物理经验检索接口。V/L/A/S/P 分别表示视觉、语言、原生动作、状态和本体感知;3D 表示点云。仅在训练时使用动作的情况列在“动作角色”下;跨来源候选库指跨越多个数据集或接口的候选库。
| 方法 | 模态 | 查询 \rightarrow 候选 | 动作角色 | 跨来源 | 策略耦合 | 生命周期 |
| Deep Multimodal | 3D/L/A | 3D+L \rightarrow 轨迹 | 候选键 | 否 | 独立 | 离线语料 |
| CLASP | L/S/A | L \rightarrow 状态+动作 | 候选键 | 否 | 独立 | 离线语料 |
| VLA-R | V/L/A | 场景 V/L \rightarrow 动作 token | 候选键 | 否 | 直接控制 | 动作词表 |
| ROSER | P | 原型 \rightarrow 窗口 | 无 | 否 | 独立 | 离线语料 |
| RAEA | V/L | V/L \rightarrow V/L 记录 | 仅被返回 | 是 | 耦合 | 持久记忆库 |
| REGENT | S | 状态 \rightarrow 示范状态 | 返回并混合 | 否 | 耦合 | 任务缓冲区 |
| RICL | V | 图像 \rightarrow 示范帧 | 返回并混合 | 否 | 耦合 | 任务缓冲区 |
| Zeva | V/A | 任务阶段 \rightarrow 存储的阶段 | 循环键 | 否 | 耦合 | 回合内 |
| RADAR | V/L | 评测 V/L \rightarrow 训练 V/L | 策略先验 | 否 | 仅用于分析 | 离线语料 |
| Robota-Embed | V/L/A | 当前 VLA \rightarrow 未来 VLA | 查询 + 候选 | 是 | 独立 | 持久索引 |
原表注:Representative physical-experience retrieval interfaces. V/L/A/S/P denote vision, language, native action, state, and proprioception; 3D denotes point clouds. Training-only action use is listed under action role; cross-source galleries span datasets or interfaces.
表 33 解读
表分三组。第一组(Deep Multimodal、CLASP、VLA-R)是“感知动作的嵌入”,动作只出现在候选端,查询端是 3D/语言/视觉。第二组(ROSER 到 RADAR)是“机器人检索增强”方法:ROSER 只用本体感知,动作完全不参与;RAEA、REGENT、RICL 的检索键不含动作,动作只是被取回的内容(后两者还把取回的动作与策略输出混合);Zeva 的键包含动作,但只在回合内使用;RADAR 用于分析而非控制。最后一行是本文:三种模态俱全,动作同时出现在查询和候选两端,跨来源,独立于策略,索引持久保存。“动作角色”一列最能体现本文的定位:只有 Robota-Embed 一行是“查询 + 候选”。“跨来源”一列中,本文与 RAEA 都标为“是”。不过附录 B.7 已经说明,本文的跨来源检索只有精选的定性例子,基准评测是在共享候选库上进行的,候选库跨越四个来源,但每条查询的正确答案都在它自己的来源内。这张表由作者根据自己对各方法的理解整理,其他方法的作者未必认同这种归类,例如 RADAR 一行注明“按其观测—语言检索的表述填写”。
译者附注:原文数字核对与阅读提示汇总
以下各条已在正文对应位置的解释框中说明,这里集中列出。总体而言,原文的数字内部高度自洽:表 2、表 3、表 6、表 23 的平均值,表 9 的合计,表 10、表 11、表 13 的四来源平均,表 22 中恒定的 157.70 ms 编码时间,表 31 推出的 64.1%、41.4% 与 1.90\times,表 32 的五任务平均、57.5% 的最大降幅以及按单价计算的费用,译者都逐一复算过,均与原文一致。作者也主动披露了不少局限(时间计量未受控、提示词措辞与实际不符、跨来源例子来自单独的检查点等)。问题主要不在算错,而在三个方面:措辞所涵盖的范围大于证据,部分对照实验并不对等,以及若干实验细节只在附录中出现、正文没有提及,读者容易据正文高估结论的普适性。| 位置 | 说明 |
| 引用格式 | 原 PDF 用数字编号引用;译稿按原文参考文献表改写为“作者,年份”,并补上 natbib 的 a/b 区分字母(如 REGENT 为 Sridhar et al., 2025a,RICL 为 2025b;Zeva 为 Chen et al., 2026a,HOST 为 2026b)。arXiv 摘要页上的摘要是 PDF 摘要的精简版,数字一致。 |
| 摘要 / 第 4.1 节 | 摘要说“比 Gemini Embedding 2 高 22.09 和 33.47 个百分点”,两项都以 Gemini 为参照;但回合级最强的基线是 Omni-Embed-Nemotron-3B(48.59),正文给出的差距是 33.18。说法不算错,但摘要的回合级对比没有选最强基线。 |
| 表 1 / 附录 B.1 | 基线全部零样本使用、各按“所支持的接口”评测:CLIP 类只用文本查询、候选端没有文本;VL 基线用未裁剪的整帧,没有动作。表 1 的差距混合了“多了动作”“有领域训练”“接口不同”三个因素,单独衡量动作要看 DROID 上的受控重新训练(表 19)。 |
| 附录 B.1(各来源指令数) | 四个来源分别有 591、800、39、5 条不同指令。DROID 的 800 个回合各有一条独特指令,文本几乎直接确定回合:回合级 R@1 达 99.88%,遮掉候选文本后片段级 R@1 从 74.1% 跌到 4.4%(表 14)。基线在 RoboMIND-FD(5 条指令)上 R@1 只有 0.3–0.4%,以 VLM2Vec-V2 为例,本文对它约 23.3 个点的平均优势中,约八成来自 LIBERO 和 RoboMIND-FD(两者分别差 33.8 和 39.6 个点,EgoDex 只差 4.3 个点)。正文没有提到这组指令数。 |
| 第 4.1 节 / 表 12–13 | “同指令候选库仍有 47.62%”是必然结果:它是原候选库的子集,正确答案的排名只升不降。有信息量的是与随机排序的比较:LIBERO、RoboMIND-FD 上模型远超随机(38.6 对 1.9,40.1 对 0.24);EgoDex、DROID 每条指令只有约 4 个和 2.7 个候选,模型只比随机高 8–20 个点(37.6 对 29.8,74.2 对 54.6)。附录 B.3 对“高 0.3 点”的解释是准确的。 |
| 摘要 / 第 4.2 节 / 第 6 节:模态 | “去掉动作比去掉视觉损害更大”:重新训练只在 DROID 上做(-18.9 对 -1.9),而 DROID 的指令近乎唯一,视觉本就冗余;四来源遮挡的差距只有 2.9 个点(-27.25 对 -24.33)。第 6 节已收回为“不是普适的模态排序”,比摘要谨慎。语言在两种口径下都是最重要的单一模态。表 17 中 \mathcal L_{\text{ground}} 只带来 1.7 个点,没有方差。 |
| 附录 A.1 | 读出位置是“动作 token 位置”上的隐状态;查询遮挡实验去掉动作时,这些位置如何处理,原文没有说明。训练四来源等比例采样,而 DROID 只有 26,563 个锚点(占 1.6%),按 26{,}275\times512 个样本推算,每个 DROID 锚点平均被重复约 127 次。 |
| 附录 B.7 / 图 8 | 跨来源检索只有三个精选例子,而且来自一个“单独的诊断检查点”,不是最终模型;作者明确说跨来源准确率不在分析范围内。引言、摘要中“统一空间覆盖人类、机器人、仿真经验”的说法,在跨来源层面没有定量证据。基准的正确答案也总在查询自己的来源内。 |
| 第 5.1 节 / 附录 C.1–C.3:DreamZero | 每个任务只用一段固定参考,而且 top-1 条件是取检索结果所在回合、再从“成功阶段”重新截取,片段级定位并未发挥作用;Embed2ICL 一行是“Robota-Embed + LLM 重排序”的组合效果。YAM 真机没有重新检索,直接沿用仿真任务 Banana-to-Bin 的参考;成功率 0/12 对 2/12,Fisher 精确检验 p\approx0.48。正文只报告进度分,成功率只在附录出现。 |
| 第 5.1 节 / 附录 C.4–C.6:Fast-WAM | 每次执行只在开头检索一次,参考随后固定。LIBERO 的增益集中在 G3(16 次增量中占 8 次),其余四任务各多 1–3 次。真机 Pick Fruit 的提升只相当于 48 个子步骤中多完成 2 个;真机没有随机参考对照,也没有“继续训练但不加 ICL”的对照。图 12 中检索到的人类片段里碗是“容器”,而 G3 中碗是被放入抽屉的“物体”,且该执行是挑选出的示例。旁路分支用检索 token(88.0%)恰好等于全量微调方案用随机 token(88.0%)。 |
| 第 5.2 节 / 附录 D.1:跨域 | ManiSkill 不在 Robota-Embed 的训练数据中;查询借用 LIBERO 的动作编码,输入的还是“上一条指令目标与当前位置之差”这一代理量,作者自称“分布外适配”。正文没有提到这一点。 |
| 第 5.2 节 / 附录 D.1、D.5:对照 | 随机历史基线只给一段至多 8 帧的 RGB、全程不刷新,而两个演化外壳给 RGB、动作和反馈并定期刷新,二者不对等。五个任务是“根据较早的开发结果选出的”,选择标准与被淘汰的任务都未报告。与 Omni-Embed 的比较同时改变了模型、训练数据、输入模态和演化路径,作者承认这不是只针对动作的消融;Omni-Embed 外壳的具体配置没有列出。 |
| 附录 D.1 | 提示词告诉 GPT-6 Astra 参考是“从检索到的历史视频中均匀随机截取的 4 秒片段”,实际用的是检索锚点对应的片段;作者已说明这是沿用的措辞,两个条件相同,不影响二者比较。 |
| 附录 D.2–D.4:开发记录 | 附录 D.2 说第一轮是不参与选择的早期轮次(图 14 横轴也从第 2 轮开始),而 Omni-Embed 在 Pull Cube with Tool 上选中的恰是第 1 轮。表 28 的“回合数”恰为轮次 \times10,而 Omni-Embed 的记忆库被描述为“49 段 Direct 收集 + 133 段自身开发”,两者的计数关系没有交代清楚。每轮只有 10 次试验,选出的轮次存在“赢家诅咒”:Two-Robot Stack Cube 开发 100%,测试 85%。Stack Cube 选中的第 2 轮配置与预设 A 完全相同。 |
| 第 5.2 节 / 附录 D.5:效率 | 64.1% 和 41.4% 都是五个任务等权平均,而配对数分别为 7、2、5、1、4;按配对数加权,两者约为 58.3% 和 33.7%。1.90\times 是时间比的平均,与 41.4% 的平均降幅不能互相换算(若直接换算应约为 1.71\times)。Direct 是在评测批次开始后才加入的,并发度和 API 负载都没有控制,作者已声明时间节省“只是观测结果”。决策次数减少的同时,Poke Cube 和 Two-Robot Stack Cube 的物理控制步数分别增加 36.4% 和 51.8%。 |
| 附录 D.6:token | 43.7% 的 token 节省按全部执行平均,其中一部分来自“失败更少”(失败执行往往耗尽预算),一部分来自“上下文更短”,原文没有拆开。测试费用不包括多达 80 个开发回合的消耗。Omni-Embed 外壳的 2.531M token 是带“\approx”的估计值,没有输入/输出拆分,所以摘要的“约少 79.5% token”不能换算成费用。 |
| 统计口径 | 全文没有报告任何方差、置信区间或多随机种子结果。DROID-Sim 每格 100 次、LIBERO 每任务 50 次、ManiSkill 每任务 20 次、真机每条件 12 次;单任务上 2–5 个点的差异大多在噪声范围内,可靠的是各实验的平均值层面的差距。 |