LTM:基于潜在转移的
视觉—语言—动作模型上下文内记忆
LTM: Latent Transition Based In-Context Memory for Vision-Language-Action Models
Qixin Sun^{1,2}, WenLong Gao^{2}, Xiansheng Chen^{2}, Zhongyuan Wang^{2}, Si Liu^{1,*}, Pengwei Wang^{2,*}
^1北京航空航天大学(Beihang University) ^2北京智源人工智能研究院(BAAI)
^*通讯作者
arXiv:2610.21362v1 [cs.RO],2026 年 10 月 15 日提交(19 页,4 幅图,10 张表,2 个算法)
代码与数据:https://github.com/buaa-colalab/LTM-pi
中文逐段翻译与解释
整理日期:2026 年 11 月 15 日
视觉—语言—动作模型上下文内记忆
LTM: Latent Transition Based In-Context Memory for Vision-Language-Action Models
Qixin Sun^{1,2}, WenLong Gao^{2}, Xiansheng Chen^{2}, Zhongyuan Wang^{2}, Si Liu^{1,*}, Pengwei Wang^{2,*}
^1北京航空航天大学(Beihang University) ^2北京智源人工智能研究院(BAAI)
^*通讯作者
arXiv:2610.21362v1 [cs.RO],2026 年 10 月 15 日提交(19 页,4 幅图,10 张表,2 个算法)
代码与数据:https://github.com/buaa-colalab/LTM-pi
中文逐段翻译与解释
整理日期:2026 年 11 月 15 日
解释
阅读方式。沿用本工作区已完成译稿的三联框:灰色框保留英文原文,蓝色框给出中文译文,橙色框解释概念、公式、设计动机和结论的边界;绿色框解读图表和算法。覆盖范围:摘要和正文第 1–6 节(到结论为止)逐段翻译与解释,正文全部 4 幅图、9 张表和 2 个算法都附原注、译注和绿色解读框;附录(A:Cup Swap 诊断实验细节;B:真机逐次试验结果)不逐段对照,改为“附录概览”,用中文段落概述,并贴出表 10 加以解读。图片直接使用作者源码中的矢量 PDF,表格全部重排。章节、图表和算法编号与原文一致(原文公式均不编号);引用保留原文的“作者,年份”格式,参考文献列表从略,见原文。解释框和译者附注是本译稿的分析,不属于作者原文。
来源与许可。原论文:https://arxiv.org/abs/2610.21362v1;PDF:https://arxiv.org/pdf/2610.21362v1。原文以知识共享署名 4.0 国际许可(CC BY 4.0)发布;本译稿是对原文的翻译和改编(增加了译文与解释),署名见上,内容以下载的 v1 源码及 PDF 为依据。
来源与许可。原论文:https://arxiv.org/abs/2610.21362v1;PDF:https://arxiv.org/pdf/2610.21362v1。原文以知识共享署名 4.0 国际许可(CC BY 4.0)发布;本译稿是对原文的翻译和改编(增加了译文与解释),署名见上,内容以下载的 v1 源码及 PDF 为依据。
目录
导读摘要(Abstract)1 引言(Introduction)2 相关工作(Related Work)3 方法(Method)3.1 基于潜在转移的 VLA 上下文内记忆(Latent-Transition-Based In-Context Memory for VLAs)3.2 LTM-\pi4 实验(Experiment)4.1 仿真评估(Evaluation in Simulation)4.1.1 实验设置(Settings)4.1.2 主要结果(Main Results)4.1.3 消融实验(Ablations)4.1.4 RoboMME 上的数据扩展(Data Scaling on RoboMME)4.1.5 诊断研究:潜在转移能表示“交换”吗?(Diagnostic Study: Can Latent Transitions Represent “Swap”?)4.1.6 Token 压缩:转移记忆能否在固定预算下保持有效?(Token Compression: Can Transition Memory Remain Effective Under a Fixed Budget?)4.2 真实世界评估(Real-World Evaluation)4.2.1 实验设置(Settings)4.2.2 结果(Results)5 局限性(Limitation)6 结论(Conclusion)附录概览(Appendix Overview)附录 A:Cup Swap 诊断实验细节附录 B:真实世界评估的逐次结果译者附注:原文数字核对与阅读提示汇总导读
本文解决的问题。主流 VLA(如 \pi_{0.5})每一步只看当前画面,但很多操作任务的正确动作取决于“之前发生过什么”:已经往袋子里放了几个物体、被杯子盖住的方块在哪个杯子下面、示范视频里先按了哪个按钮。现有的记忆方案大致三类:保留历史帧(贵,抽稀又会漏掉中间过程)、让大模型把历史总结成文字(丢掉细粒度运动,还要外部推理模型或额外标注)、维护一个循环状态(要不断决定丢掉什么)。作者换了一个角度提问:VLA 到底该记住什么?他们的回答是记住“变化”:每两帧相邻观测之间发生了什么,用一个现成的潜在动作模型(LAM)压成一个 32 维向量,一帧变化只占一个 token。方法的完整链条。(1) 编码:冻结的 LAM 编码器(DreamDojo 或 CD-LAM)读入相邻两帧 (o_{i-1},o_i),输出转移码 z_i\in\mathbb R^{32};LAM 原本是为“给定前一帧和 z_i 重建后一帧”训练的,因此 z_i 倾向于只编码变化、不编码外观。(2) 投影:数据集统计量归一化后,经两层 MLP 映射为 PaliGemma 的 2048 维隐藏向量,即一个记忆 token。(3) 拼接:在 \pi_{0.5} 的输入前缀里按 [\text{语言};\ m_1,\dots,m_{\tau_t};\ \text{当前图像}] 排列,语言—记忆前缀内部用因果注意力,这样旧 token 的 KV 缓存可以一直复用,每步只需追加新 token。(4) 延迟:只放入 k 步之前的转移(\tau_t=\max(0,t-k)),让 LAM 编码可以和机器人执行动作同时进行,不挡在推理关键路径上。(5) 视频示范类任务额外放两个“锚帧”(示范首帧、本回合首帧)和示范的整串转移 token。训练只用普通示范数据做行为克隆,不需要任何关于记忆的语义标注。| 概念 | 本文中的具体含义 |
| 潜在动作模型(LAM) | 编码器 E_\phi(o_{i-1},o_i)\to z_i、解码器 D_\psi(o_{i-1},z_i)\to\hat o_i,用重建损失无监督训练;z_i 是“从前一帧到后一帧的变化”的压缩码。本文只用冻结的编码器。 |
| 潜在转移(latent transition) | 一对相邻观测经 LAM 编码得到的 32 维向量 z_i;本文的记忆单元。 |
| 记忆 token m_i | z_i 归一化后经 MLP 投影到 2048 维、再做 LayerNorm 的结果,与文字、图像 token 同处一个序列。 |
| 延迟 k(lag) | 决策步 t 只用到第 \tau_t=\max(0,t-k) 个转移为止;最近 k 个转移暂不放入,给 LAM 留出异步计算时间。 |
| 视觉锚帧(anchor) | 示范视频首帧与本回合首帧的图像 token,为转移序列提供“从哪个场景出发”的参照。 |
| 持久 KV 缓存 | 语言—记忆前缀因果排列,旧 token 的键值对在整个回合中复用;当前图像的 KV 每步用完即丢。 |
| RoboMME | 16 个依赖历史的仿真任务,分 Counting(计数)、Permanence(物体恒存)、Reference(指代)、Imitation(模仿)四组,每组 4 个任务。 |
| LIBERO-Mem | 10 个以物体为中心的长时程记忆任务(T0–T9),每任务 20 个布局。 |
| RoboMME-10x | 作者用 RoboMME 的生成流程把每个任务族的示范从 100 条扩到 1000 条后的数据集。 |
| Cup Swap 诊断 | 合成的“六杯藏球、随机交换”视频任务,用来检验转移序列中是否保留了交换信息;用的是另一套 Qwen3-VL-2B 架构,不是 LTM-\pi。 |
| Token 压缩 | 执行记忆超过 Q=200 个 token 时,反复把余弦相似度最高的一对相邻 token 合并成均值。 |
摘要(Abstract)
原文
Robotic manipulation often requires remembering interactions that are no longer visible. We introduce Latent Transition Memory (LTM), which stores history as compact latent transitions between consecutive observations. Instantiated on \pi_{0.5} as LTM-\pi, our method uses a frozen latent action encoder, a lightweight adapter, and causal KV caching for incremental inference without memory-specific semantic annotations or external reasoning-model calls. With DreamDojo transitions, LTM-\pi achieves 58.54% success on RoboMME and 80.5% on LIBERO-Mem, performing best among baselines without external reasoning models or memory-specific annotations. Ablations support the contribution of transition content beyond temporal cues and the efficiency of delayed memory admission. Scaling RoboMME demonstrations tenfold improves success from 57.67% to 87.50%, while a Cup Swap diagnostic highlights the role of process supervision in temporal composition. Under a 200-token memory budget, success remains 84.00%, versus 87.50% without compression. Finally, real-robot counting success improves from 11.25% to 82.50%. Together, these results demonstrate the effectiveness, scalability, and efficiency of latent transition memory, highlighting its capacity for complex temporal information, bounded-context operation, and real-world robotic control. Our dataset, training code, and inference code have been publicly released at: https://github.com/buaa-colalab/LTM-pi.
译文
机器人操作常常需要记住那些已经看不见的交互。我们提出潜在转移记忆(Latent Transition Memory,LTM),它把历史存储为相邻观测之间紧凑的潜在转移(latent transition)。我们在 \pi_{0.5} 上将其实例化为 LTM-\pi:该方法使用一个冻结的潜在动作编码器、一个轻量级适配器,以及支持增量推理的因果 KV 缓存,既不需要针对记忆的语义标注,也不需要调用外部推理模型。使用 DreamDojo 的转移表示时,LTM-\pi 在 RoboMME 上取得 58.54% 的成功率,在 LIBERO-Mem 上取得 80.5%,在不使用外部推理模型或记忆标注的基线中表现最好。消融实验表明,转移的内容在时间线索之外还有额外贡献,延迟写入记忆则提高了效率。把 RoboMME 的示范数据扩大十倍,成功率从 57.67% 提升到 87.50%;一项 Cup Swap(换杯)诊断实验则凸显了过程监督(process supervision)在时间组合中的作用。在 200 个 token 的记忆预算下,成功率仍有 84.00%,不压缩时为 87.50%。最后,在真实机器人的计数任务上,成功率从 11.25% 提升到 82.50%。这些结果共同证明了潜在转移记忆的有效性、可扩展性和效率,显示出它承载复杂时间信息、在有界上下文中运行以及用于真实机器人控制的能力。我们的数据集、训练代码和推理代码已公开发布于 https://github.com/buaa-colalab/LTM-pi。
解释
一句话概括。不存历史画面,只存“相邻两帧之间变了什么”,每次变化压成一个 token,按时间顺序排在 VLA 的输入里当记忆。几个关键词。“潜在转移”是潜在动作模型(latent action model,LAM)对一对相邻帧的编码:LAM 训练时要从“前一帧 + 这个编码”重建出后一帧,所以编码里主要装的是变化而不是外观,一个 32 维向量就够。“冻结的编码器”说明 LAM 不参与训练,直接拿 DreamDojo、CD-LAM 这些现成模型来用;“轻量级适配器”是把 32 维码映射到 VLM 隐藏空间的两层 MLP;“因果 KV 缓存”指记忆 token 只看自己前面的 token,所以算过的键值对可以一直复用,新来一个转移只需增量计算一次。“外部推理模型”指像 Gemini、Qwen-VL 这类单独运行的大模型,在别的方法里负责读历史、写子任务描述;“记忆标注”指为了训练记忆专门标注的子任务文字、关键帧等。作者把“两者都不用”当作自己的主要卖点,后面表 1 也按这个标准把基线分成两组。数字的对应关系。摘要里有两套 RoboMME 基准分:58.54% 是 DreamDojo 编码器的结果,57.67% 是 CD-LAM 编码器的结果(见表 1)。“十倍数据从 57.67% 到 87.50%”的起点是 CD-LAM 版,而 87.50% 按正文 §4.1.6 和表 8 的说法是 DreamDojo 版,两者之间还改了训练步数和延迟 k,详见 §4.1.4 的解释和译者附注。“200 个 token 预算下 84.00%”是在十倍数据(RoboMME-10x)上做的,所以对比对象是 87.50% 而不是 58.54%。真机实验只有一个“抓放 x 次”的计数任务。
1引言(Introduction)
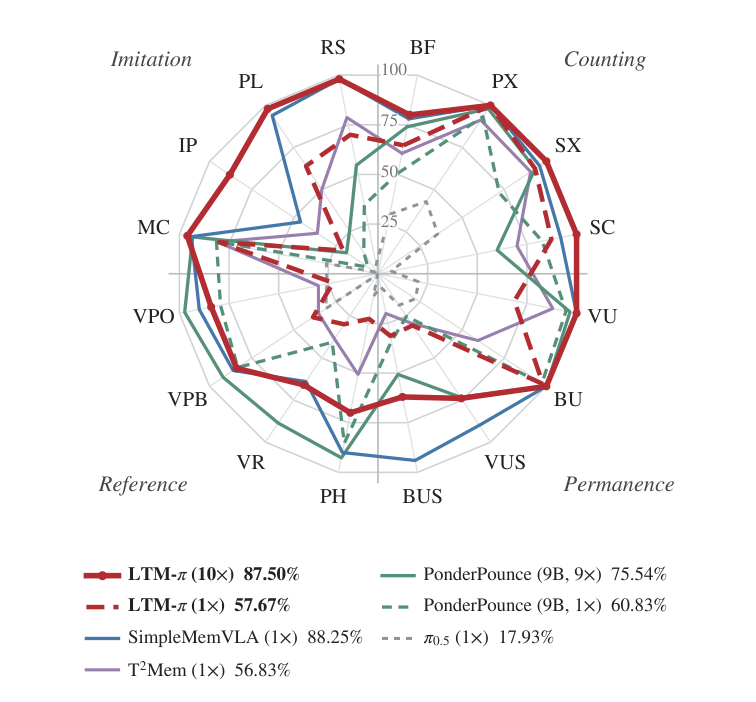
图 1:RoboMME 全部 16 个任务上的成功率(%),按赛道分组。图例给出数据规模和总体成功率;数值与表 1 和表 5 一致。
原图注:Success rates (%) on the 16 RoboMME tasks, grouped by track. The legend shows data scales and overall success rates; scores follow Tables 1 and 5.
图 1 解读
这是一张雷达图:16 条辐射轴对应 RoboMME 的 16 个任务,按四个赛道(track)分成四个扇区——右上 Counting(BF、PX、SX、SC),右下 Permanence(VU、BU、VUS、BUS),左下 Reference(PH、VR、VPB、VPO),左上 Imitation(MC、IP、PL、RS);任务缩写的全称见表 1 的表注。离中心越远成功率越高,同心圆刻度为 25/50/75/100。六条曲线分别是:红色实线 LTM-\pi(10\times 数据,87.50%)、红色虚线 LTM-\pi(1\times,57.67%)、蓝色 SimpleMemVLA(1\times,88.25%)、紫色 T^2Mem(1\times,56.83%)、绿色实线和虚线 PonderPounce(9B,9\times 75.54%、1\times 60.83%)、灰色虚线 \pi_{0.5}(1\times,17.93%)。读图要点有三。第一,灰色的 \pi_{0.5} 圈得很小,说明没有记忆时这些任务基本做不成。第二,红色虚线(LTM 1\times)在 Counting 和 Imitation 扇区已经很靠外,但在 Reference 扇区明显内缩(四个任务都只有 22.67–38.67%),这是原始数据规模下的主要短板。第三,扩到 10\times 数据后,红色实线几乎在所有扇区都贴近外圈,与 SimpleMemVLA(用了云端 VLM 生成的子任务标注)的蓝线相当;只有 Reference 扇区仍略低于 PonderPounce 9\times,Permanence 中的两个交换任务(VUS、BUS)也有凹陷——这正是后文 §4.1.5 诊断实验要追问的地方。需要注意:图中把不同数据规模、不同监督资源的方法画在一起,图例里的 1\times/9\times/10\times 正是为了提醒这一点;而 LTM 的 1\times 曲线是 CD-LAM 版,10\times 曲线按正文是 DreamDojo 版。
原文
Vision-language-action (VLA) models combine pretrained visual and linguistic representations with action generation to follow diverse manipulation instructions (Brohan et al., 2023; Kim et al., 2024; Black et al., 2024; Physical Intelligence et al., 2025). Yet the current observation may omit information needed for the next action. A robot placing three objects into a bag must remember completed transfers; one tracking an occluded object must retain the effects of earlier interactions. Similar scenes can therefore require different actions depending on the preceding history, motivating explicit memory for robotic control (Dai et al., 2026; Chung et al., 2026).
译文
视觉—语言—动作(vision-language-action,VLA)模型把预训练的视觉和语言表征与动作生成结合起来,以执行各种操作指令(Brohan et al., 2023; Kim et al., 2024; Black et al., 2024; Physical Intelligence et al., 2025)。然而,当前观测可能缺少决定下一步动作所需的信息。一个要把三个物体放进袋子的机器人,必须记住已经放过几个;一个追踪被遮挡物体的机器人,必须记住先前交互造成的影响。因此,相似的场景可能因为之前的历史不同而需要不同的动作,这促使人们为机器人控制引入显式记忆(Dai et al., 2026; Chung et al., 2026)。
解释
这一段提出问题:VLA 的输入通常只有“当前画面 + 指令”,这在数学上相当于假设任务是马尔可夫的——当前观测足以决定最优动作。两个例子说明这个假设何时失效。第一个是计数:放了一个和放了两个之后,桌面看起来可能差不多(被放进袋子的物体看不见了),只有记得“已经放了几个”才知道该继续还是该停。第二个是遮挡:物体被杯子盖住后,画面上只剩杯子,要知道它在哪个杯子下面,必须记得盖上之后杯子怎么移动过。“相似场景需要不同动作”是这类问题的本质,术语叫部分可观测(partial observability)。这里引用的两篇(Dai et al., 2026 即 RoboMME;Chung et al., 2026 即 LIBERO-Mem)正是本文主实验用的两个基准,它们专门设计成“不看历史就做不对”的任务。
原文
Existing memory designs retain visual observations, summarize experience in language, or update a recurrent state (Shi et al., 2025; Qu et al., 2026; Torne et al., 2026; Cherepanov et al., 2026). Dense visual histories consume substantial context, whereas sparse sampling can omit intermediate interactions. Language summaries abstract away visual detail but may miss fine-grained motion. Recurrent representations support compact updates but must continually decide what to preserve in a bounded state.
译文
现有的记忆设计要么保留视觉观测,要么用语言总结经验,要么更新一个循环状态(Shi et al., 2025; Qu et al., 2026; Torne et al., 2026; Cherepanov et al., 2026)。稠密的视觉历史会占用大量上下文,而稀疏采样又可能遗漏中间的交互。语言总结抽象掉了视觉细节,但可能漏掉细粒度的运动。循环表征支持紧凑的更新,却必须在一个有界的状态中不断决定保留什么。
解释
作者把已有方法归成三类,并各指出一个弱点。存帧:一张图在 PaliGemma 里要 256 个 token,存几十帧上下文就爆了;若只每隔几秒存一帧,两帧之间发生的“交换了两个杯子”这类事件就丢了。存文字:让一个 VLM 把历史写成“已经放了两个物体”之类的句子,很省空间,但“杯子从左边绕到右边”这种运动细节很难用语言精确描述,而且通常需要额外的推理模型或标注。存循环状态:像 RNN 一样把历史滚动压进固定大小的向量,更新便宜,但状态容量有限,模型必须学会取舍,而取舍错了就无法挽回。这三点也就是 LTM 要同时满足的设计目标:比存帧省、比存文字细、又不像循环状态那样做有损压缩(至少在不做 §4.1.6 的压缩时如此)。
原文
These trade-offs raise a representational question: what should a VLA remember about its past interactions?
译文
这些权衡引出了一个关于表征的问题:VLA 应该记住关于过去交互的什么?
解释
这是全文的核心问题。前面三类方法回答的都是“怎么存”(存多少帧、怎么压缩),作者把问题转到“存什么”:与其存外观,不如存发生了什么变化。下一段给出答案。
原文
For many manipulation tasks, the relevant history is the sequence of changes induced by robot–environment interactions. Latent action models encode an observation pair into a compact code from which the later observation can be reconstructed conditioned on the earlier one (Bruce et al., 2024; Ye et al., 2024). This objective encourages the code to capture temporal changes. While latent actions have been used for policy pretraining and world-model control (Ye et al., 2024; Bu et al., 2025; Gao et al., 2026a), we study their use as an ordered episodic memory for action generation.
译文
对许多操作任务而言,相关的历史就是机器人与环境交互所引起的一系列变化。潜在动作模型(latent action model)把一对观测编码为一个紧凑的码,以前一个观测为条件,可以从这个码重建出后一个观测(Bruce et al., 2024; Ye et al., 2024)。这一目标促使编码捕捉时间上的变化。潜在动作此前已被用于策略预训练和世界模型控制(Ye et al., 2024; Bu et al., 2025; Gao et al., 2026a),而我们研究的是把它们用作动作生成所需的、有序的情景记忆(episodic memory)。
解释
为什么 LAM 的码会只装“变化”。LAM 的解码器在重建后一帧 o_i 时已经能看到前一帧 o_{i-1},所以场景外观、背景、物体颜色这些两帧共有的信息,解码器从 o_{i-1} 里就能拿到,不需要码 z_i 再传一遍;z_i 又被限制得很小(本文用的是 32 维),容量有限,最“划算”的做法就是只编码两帧之间的差别——机械臂往哪里动了、哪个物体被移动了。这就是所谓“信息瓶颈”。Genie(Bruce et al., 2024)和 LAPA(Ye et al., 2024)是这类模型的代表。新意在哪里。以前人们拿潜在动作做两件事:一是当作没有动作标签的视频的“伪动作”来预训练策略(LAPA、UniVLA),二是作为世界模型的控制输入(DreamDojo)。这两种用法里,潜在动作都是要预测或输出的东西;本文则把它当作输入,把一回合内所有的转移码按时间排成一串,作为策略的记忆。“情景记忆”一词借自认知科学,指对本回合(episode)内具体发生过的事件的记忆,与长期的知识性记忆相对。需要补充的一点(作者在这里没有说):LAM 的码“只编码变化”只是倾向而不是保证。工作区《Delta 表示调研》中提到,已有理论工作证明在存在机器人控制不了的外部变化时,纯重建目标的最优解里 z 会携带未来外观信息;本文选用的 CD-LAM 正是为减少这种视觉混杂而设计的。
原文
We introduce Latent Transition Memory (LTM), which encodes consecutive observations with a frozen latent action model and projects each code into one memory token. The policy receives a delayed transition prefix alongside the instruction and current observation. Each code depends only on an adjacent observation pair, allowing encoding to overlap action execution. We instantiate LTM on \pi_{0.5} as LTM-\pi, with a lightweight adapter and causal attention that permits persistent KV caching. Sparse initial-frame anchors provide visual grounding for video-conditioned tasks. The policy and adapter learn from robot demonstrations without memory-specific semantic annotations. At inference, the frozen encoder supplies transition codes directly to the policy, without an external reasoning model or intermediate language generation.
译文
我们提出潜在转移记忆(LTM):它用一个冻结的潜在动作模型编码相邻观测,并把每个码投影为一个记忆 token。策略除了接收指令和当前观测外,还接收一段带延迟的转移前缀。每个码只依赖一对相邻观测,因此编码可以与动作执行重叠进行。我们在 \pi_{0.5} 上将 LTM 实例化为 LTM-\pi,它带有一个轻量级适配器,并采用允许持久 KV 缓存的因果注意力。对以视频为条件的任务,稀疏的首帧锚点提供视觉上的参照(grounding)。策略和适配器从机器人示范中学习,不需要针对记忆的语义标注。推理时,冻结的编码器把转移码直接提供给策略,不需要外部推理模型,也不需要生成中间语言。
解释
这段把方法的所有零件一次列出,后面 §3 逐个展开。可以按“数据流”来理解:相机每来一帧,就和上一帧配成一对送进冻结的 LAM,得到一个 32 维码;MLP 适配器把它变成一个与文字 token 同维度的记忆 token;这些 token 按时间顺序排在指令之后、当前图像之前,构成策略的输入前缀。三个工程细节值得先记住。带延迟:决策时只用 k 步以前的转移,最近 k 步的转移先放着不用,这样 LAM 有 k 步的时间在后台慢慢算,不会让策略等它。只依赖相邻两帧:每个码独立计算,来一帧算一个,不必回头重新编码整段历史,这是“可增量”的前提。因果注意力 + 持久 KV 缓存:\pi_{0.5} 原本在前缀内部用双向注意力,每步都得重算整个前缀;改成因果后,旧 token 的计算结果不受新 token 影响,可以缓存一整回合。“首帧锚点”只用于 RoboMME 中需要先看一段示范视频再执行的任务:转移序列只记录变化,不知道起点长什么样,所以额外放示范和本回合各自的第一帧图像作为参照。最后两句再次强调训练和推理都不依赖语言中间层,这是与 MemER、SimpleMemVLA、PonderPounce 等方法的主要区别。
原文
We evaluate LTM-\pi with two frozen latent encoders, CD-LAM and DreamDojo, on RoboMME and LIBERO-Mem. With the original benchmark data, the DreamDojo variant reaches 58.54% average success on RoboMME, compared with 17.93% for the reported memory-free \pi_{0.5} baseline, and 80.5% on LIBERO-Mem, compared with 42.5% for the strongest baseline included in our comparison. We then isolate the effects of memory content and inference lag. Replacing observation-dependent latent transitions with fixed random representations reduces RoboMME success from 57.67% to 44.50%, supporting the contribution of transition-specific content beyond temporal-progress cues. Using a five-step lag reduces estimated latent-encoder blocking from 114.25 ms to 9.47 ms relative to zero lag, with a small change in success (57.88% to 57.67%).
译文
我们使用 CD-LAM 和 DreamDojo 两个冻结的潜在编码器,在 RoboMME 和 LIBERO-Mem 上评估 LTM-\pi。使用基准的原始数据时,DreamDojo 版本在 RoboMME 上达到 58.54% 的平均成功率,而已报告的无记忆 \pi_{0.5} 基线为 17.93%;在 LIBERO-Mem 上达到 80.5%,而我们对比中最强的基线为 42.5%。随后我们分别考察记忆内容和推理延迟的影响。把依赖观测的潜在转移换成固定的随机表示,RoboMME 成功率从 57.67% 降到 44.50%,说明转移本身的内容在时间进度线索之外还有贡献。使用 5 步延迟时,相对于零延迟,潜在编码器的估计阻塞时间从 114.25 ms 降到 9.47 ms,而成功率变化很小(57.88% 到 57.67%)。
解释
这一段预告第 4 节的前两组结果,数字对应表 1–4。有两处需要读者自己对齐。第一,57.67% 是 CD-LAM 版的主结果,消融(随机转移、延迟 k)都是在 CD-LAM 版上做的;正文没有明说这一点,但表 3 的 Full 行、表 4 的 k=5 行与表 1 中 CD-LAM 一行逐项相同。第二,“固定随机表示”这个对照非常关键:它保留了“记忆里有多少个 token、按什么顺序排”这一结构,只去掉内容。于是模型仍能从 token 个数推断“已经过去了多少步”,这就是所谓“时间进度线索”。随机版仍有 44.50%,说明光知道“过了多久”就能解决相当一部分任务(例如按固定节奏完成的计数任务);真实转移比它再高 13.17 个点,这一部分才可以归功于“变化的内容”。“阻塞时间”指策略决策时因为等 LAM 编码完成而额外停顿的时间,是按表 4 的公式估算的,并非实测的端到端延迟。
原文
We next test how LTM benefits from broader demonstration coverage. We expand RoboMME from 100 to 1,000 episodes per task family and increase training from 40K to 120K steps. With the same encoder and policy architecture, success rises from 57.67% to 87.50% (Figure 1). All four tracks improve; Reference, the weakest base-data track, gains 47.50 percentage points. Extending training to 120K steps on the original data alone yields no appreciable gain, supporting the benefit of broader demonstration coverage. LTM-\pi exceeds the reported PonderPounce result with 9\times data by 11.96 points overall, under different data budgets and supervision assumptions.
译文
接着我们测试更广的示范覆盖如何使 LTM 受益。我们把 RoboMME 每个任务族的回合数从 100 扩充到 1,000,并把训练从 40K 步增加到 120K 步。在相同的编码器和策略架构下,成功率从 57.67% 升至 87.50%(图 1)。四个赛道全部提升;原始数据下最弱的 Reference 赛道提升了 47.50 个百分点。只在原始数据上把训练延长到 120K 步,则没有明显提升,这支持了更广示范覆盖的益处。在数据预算和监督假设不同的前提下,LTM-\pi 的总体成绩比已报告的使用 9\times 数据的 PonderPounce 高 11.96 个点。
解释
这一段的结论需要打折扣地读。“相同的编码器”一说与正文后面的描述不一致:57.67% 是 CD-LAM 版的成绩,而 §4.1.6 和表 8 明确说 87.50% 是“基于 DreamDojo 的 LTM-\pi”的结果;此外延迟 k 也从 5 变成了 10(§4.1.1)。所以 57.67% \to 87.50% 同时改变了数据量、训练步数、延迟,可能还有编码器。作者用“原数据训练 120K 步无明显提升”来排除训练步数的影响,但论文没有报告这个对照的具体数字(arXiv 源码中留有作者自己的批注,要求在投稿前补上该数字及评估种子数)。考虑到编码器换成 DreamDojo 在原始数据上只多 0.87 个点、k 从 5 到 10 在原始数据上反而少 1.29 个点,主要提升来自数据扩充这一结论大体可信,但精确的增益不能全部归给数据。PonderPounce 的对比同理:它用 9 倍数据、单独的 9B 上下文模型和额外的推理监督,LTM 用 10 倍数据,二者的条件并不对等,作者自己也加了“不同数据预算和监督假设”的限定语。
原文
Scaling does not fully resolve the challenge of composing local transitions into persistent object states: VideoUnmaskSwap and ButtonUnmaskSwap reach 74% and 62%, versus 100% for their non-swap counterparts. In a Cup Swap diagnostic, process supervision achieves 97.93% final-state recovery from latent transitions, compared with 2.40% under final-state-only supervision. These results demonstrate that latent transitions preserve recoverable multi-step interaction information and highlight the importance of intermediate supervision, motivating language-guided reasoning and process supervision to address remaining temporal-composition challenges.
译文
数据扩展并没有完全解决“把局部转移组合成持久的物体状态”这一难题:VideoUnmaskSwap 和 ButtonUnmaskSwap 只达到 74% 和 62%,而它们不含交换的对应任务都达到 100%。在 Cup Swap 诊断实验中,过程监督能从潜在转移中以 97.93% 的准确率恢复最终状态,而只监督最终状态时只有 2.40%。这些结果说明潜在转移保留了可恢复的多步交互信息,也凸显了中间监督的重要性,从而促使我们用语言引导的推理和过程监督去解决剩余的时间组合难题。
解释
“时间组合”是什么意思。每个转移 token 只描述一小段局部变化(“左边的杯子往右挪了一点”)。要回答“球现在在哪个杯子下”,模型得把一长串局部变化串起来,推演出每次交换后物体的位置——这就是把局部转移“组合”成持久的物体状态。Unmask 类任务只需记住“物体最初在哪个遮挡物下”;UnmaskSwap 类任务还要在遮挡后跟踪若干次交换,难度明显更高,两者 100% 对 62–74% 的差距正好暴露了这一点。诊断实验的逻辑。作者想区分两种可能:是转移 token 里根本没有交换信息,还是信息在里面、只是策略没学会用。Cup Swap 实验用一个单独的识别模型去读转移序列:如果训练时逐步监督“每一次交换是哪两个杯子”,最终状态可以恢复到 97.93%;只监督最终答案时几乎学不会。由此得出“信息在、需要中间监督才能学会组合”的结论。不过要注意,这个识别模型是另一套架构(详见 §4.1.5 和附录 A),它证明的是信息“可恢复”,并不直接说明 LTM-\pi 策略内部发生了什么。
原文
To bound execution-memory growth, we merge the most similar adjacent projected tokens under the same quota during training and inference. On RoboMME-10x, a 200-token budget retains 84.00% success versus 87.50% uncompressed and reduces mean transition-token count by at least 38.26% on profiled training queries.
译文
为了限制执行记忆的增长,我们在训练和推理中使用同样的配额,合并最相似的相邻投影 token。在 RoboMME-10x 上,200 个 token 的预算保持了 84.00% 的成功率(不压缩时为 87.50%),并在统计过的训练查询上把平均转移 token 数减少了至少 38.26%。
解释
一帧一个 token 虽然便宜,但回合越长 token 越多(§4.1.6 统计到最长 1789 个)。压缩规则很简单:超过配额 Q=200 时,找出余弦相似度最高的一对相邻 token,用二者的平均替换。“至少 38.26%”来自 1-200/323.93:不压缩时平均每次查询有 323.93 个转移 token,压缩后不超过 200 个;由于有些查询本来就不到 200 个,压缩后的真实均值小于 200,所以只能给出下界。这里说的是 token 数,不是实测的推理加速。
原文
Finally, we evaluate LTM-\pi on a Galbot G1 robot in a real-world repeated pick-and-place counting task. LTM-\pi improves average success from 11.25% for the memory-free \pi_{0.5} baseline to 82.50%, demonstrating that transition memory also helps track completed interactions during physical manipulation.
译文
最后,我们在 Galbot G1 机器人上,用一个真实世界中重复抓放的计数任务评估 LTM-\pi。LTM-\pi 把平均成功率从无记忆 \pi_{0.5} 基线的 11.25% 提升到 82.50%,表明转移记忆在实体操作中同样有助于跟踪已完成的交互。
解释
真机实验是“把 x 个物体逐个放进包装袋”,x\in\{1,2,3,4\},正好对应第一段“放三个物体进袋子”的例子。这个任务的难点在于:已经放进袋子的物体看不见了,当前画面无法告诉机器人放了几个。只有一个任务、一个机器人平台,因此它更像是概念验证,而不是全面的真机评测。
原文
Our contributions are threefold:
- We propose Latent Transition Memory (LTM), a memory representation that uses compact latent transitions between consecutive observations as historical context instead of retaining the full visual history. This focuses memory on interaction-induced changes and enables the policy to use past experience without external reasoning-model calls or memory-specific semantic annotations.
- We develop LTM-\pi, integrating transition memory into \pi_{0.5}'s inference context through a lightweight adapter. Causal attention, persistent KV caching, and asynchronous transition encoding support efficient online control. Experiments on RoboMME and LIBERO-Mem demonstrate strong memory-dependent manipulation performance, with a measured policy inference time of 66.71 ms on an H100.
- We characterize transition-memory information, data scaling, and context-budget trade-offs. Ablations distinguish transition content from temporal cues; tenfold RoboMME data expansion raises success from 57.67% to 87.50%; process-supervised Cup Swap decoding recovers final states with 97.93% accuracy; and a 200-token budget retains 84.00% success. Finally, real-robot counting experiments improve success from 11.25% to 82.50%.
译文
我们的贡献有三点:
- 我们提出潜在转移记忆(LTM),这种记忆表征用相邻观测之间紧凑的潜在转移作为历史上下文,而不是保留完整的视觉历史。它使记忆聚焦于交互引起的变化,并使策略能够在不调用外部推理模型、不需要记忆语义标注的情况下利用过去的经验。
- 我们开发了 LTM-\pi,通过一个轻量级适配器把转移记忆接入 \pi_{0.5} 的推理上下文。因果注意力、持久 KV 缓存和异步转移编码支持高效的在线控制。在 RoboMME 和 LIBERO-Mem 上的实验展示了很强的记忆依赖型操作性能,在 H100 上实测的策略推理时间为 66.71 ms。
- 我们刻画了转移记忆所含的信息、数据扩展以及上下文预算之间的权衡。消融实验把转移内容与时间线索区分开;把 RoboMME 数据扩大十倍使成功率从 57.67% 升至 87.50%;经过程监督的 Cup Swap 解码以 97.93% 的准确率恢复最终状态;200 个 token 的预算保持了 84.00% 的成功率。最后,真实机器人计数实验把成功率从 11.25% 提升到 82.50%。
解释
三条贡献分别是:一种记忆表征(存变化而不是存画面)、一个具体实现(接到 \pi_{0.5} 上,并解决在线推理的效率问题)、一组分析实验(内容与时间线索、数据扩展、可恢复性、预算)。第三条里的数字都是前面几段已经出现过的,这里不再重复。66.71 ms 是“策略本身”的一次前向时间,不含 LAM 编码;表 4 的说明里作者专门强调过这一点。按 RoboMME 每次推理后执行 10 步、LIBERO-Mem 执行 5 步来算,这个速度足以支撑闭环控制,但真实的端到端控制延迟论文没有测量。
2相关工作(Related Work)
原文
Vision-language-action models. VLA models transfer pretrained visual and linguistic representations to robotic control. RT-2 (Brohan et al., 2023) predicts tokenized actions, and OpenVLA (Kim et al., 2024) provides an open-source generalist policy. \pi_0 (Black et al., 2024) introduces flow matching for continuous action generation; \pi_{0.5} (Physical Intelligence et al., 2025) and LingBot-VLA (Wu et al., 2026) extend generalization through heterogeneous co-training and multi-embodiment data. These advances do not remove partial observability: the appropriate action may depend on events absent from the current observation. RoboMME (Dai et al., 2026) and LIBERO-Mem (Chung et al., 2026) evaluate this need for execution memory.
译文
视觉—语言—动作模型。 VLA 模型把预训练的视觉和语言表征迁移到机器人控制上。RT-2(Brohan et al., 2023)预测离散化(token 化)的动作,OpenVLA(Kim et al., 2024)提供了一个开源的通用策略。\pi_0(Black et al., 2024)引入流匹配(flow matching)来生成连续动作;\pi_{0.5}(Physical Intelligence et al., 2025)和 LingBot-VLA(Wu et al., 2026)通过异构数据联合训练和多本体数据进一步提升泛化能力。这些进展并没有消除部分可观测性:合适的动作可能取决于当前观测中看不到的事件。RoboMME(Dai et al., 2026)和 LIBERO-Mem(Chung et al., 2026)专门评估这种对执行记忆的需求。
解释
这一段简要交代 VLA 的发展脉络,目的是引出最后一句:无论模型多大、数据多杂,只要输入只有当前观测,就解决不了部分可观测问题。LTM-\pi 所用的 \pi_{0.5} 有两部分:一个 PaliGemma-3B 视觉语言主干(论文图 2 中的 “\pi_{0.5} Backbone”),负责读文字和图像;一个“动作专家”(action expert),用流匹配把噪声逐步去噪成连续动作块。“流匹配”与扩散模型同族,训练一个速度场把高斯噪声沿直线搬运到真实动作分布。理解后文只需要知道:主干输出的上下文(KV)被动作专家用来生成动作,所以只要把记忆 token 塞进主干的输入序列,动作专家就能间接“看到”历史。LingBot-VLA 在工作区已有译稿。
原文
Memory mechanisms for VLAs. RoboFlamingo (Li et al., 2023) models history through a sequential policy head; HAMLET (Koo et al., 2025) and \muVLA (Cherepanov et al., 2026) use learned memory tokens. MemoryVLA (Shi et al., 2025) and LaMem-VLA (Qu et al., 2026) retrieve evidence from explicit memory banks. SAM2Act+ (Fang et al., 2025) extends a multi-view manipulation policy with a spatial memory bank, encoder, and memory attention. Object-centric approaches retain a different unit of history: SlotVLA (Hanyu et al., 2025) models object slots and their relations, while E-SlotSSM (Chung et al., 2026) studies the progression of object-centric memory states. GMP (Gao et al., 2026b) learns when to activate cross-attention over cached image and action tokens. RoboMME also compares symbolic, sampled-frame, and recurrent memories with several policy interfaces (Dai et al., 2026). LTM instead retains an ordered sequence of changes between observations, rather than appearance tokens or a recurrent summary of the episode. Temporal prediction also informs memory-based control: HiF-VLA (Lin et al., 2025) incorporates motion representations, MemoryVLA++ (Shi et al., 2026) combines retrieved history with imagined futures, and MemoryVAM (Jiang et al., 2026) injects compressed visual memory into both video prediction and action decoding.
译文
VLA 的记忆机制。 RoboFlamingo(Li et al., 2023)通过一个序列式策略头对历史建模;HAMLET(Koo et al., 2025)和 \muVLA(Cherepanov et al., 2026)使用可学习的记忆 token。MemoryVLA(Shi et al., 2025)和 LaMem-VLA(Qu et al., 2026)从显式的记忆库中检索证据。SAM2Act+(Fang et al., 2025)为一个多视角操作策略加上了空间记忆库、记忆编码器和记忆注意力。以物体为中心的方法保留的是另一种历史单元:SlotVLA(Hanyu et al., 2025)对物体槽位(slot)及其关系建模,E-SlotSSM(Chung et al., 2026)则研究以物体为中心的记忆状态如何演变。GMP(Gao et al., 2026b)学习何时对缓存的图像和动作 token 启用交叉注意力。RoboMME 还在多种策略接口下比较了符号记忆、采样帧记忆和循环记忆(Dai et al., 2026)。与这些方法不同,LTM 保留的是观测之间的一个有序变化序列,而不是外观 token 或对整个回合的循环式总结。时间预测也为基于记忆的控制提供了思路:HiF-VLA(Lin et al., 2025)融入了运动表征,MemoryVLA++(Shi et al., 2026)把检索到的历史与想象的未来结合起来,MemoryVAM(Jiang et al., 2026)则把压缩后的视觉记忆同时注入视频预测和动作解码。
解释
这一段按“记忆单元是什么”给已有工作分类,可以整理成几条线索:(1)记忆 token / 序列头:RoboFlamingo、HAMLET、\muVLA,把历史压进少量可学习 token 或一个循环头,属于“循环状态”一类;(2)记忆库 + 检索:MemoryVLA、LaMem-VLA、SAM2Act+,存大量历史特征,按需取回;(3)以物体为中心:SlotVLA、E-SlotSSM,把场景拆成若干物体槽位,记忆的是每个物体的状态;(4)门控:GMP 学习什么时候需要回看缓存;(5)预测未来:HiF-VLA、MemoryVLA++、MemoryVAM,把记忆与“想象未来”结合。RoboMME 论文本身也提供了一组系统的记忆基线:符号记忆(SimpleSG/GroundSG,用 VLM 写子目标)、采样帧记忆(TokenDrop、FrameSamp)、循环记忆(TTT、RMT),每种又搭配三种接入方式(Context、Modul、Expert),这些就是表 1 中那一长串组合名的来历。LTM 的定位句是“保留有序的变化序列,而不是外观 token 或循环总结”:它不压缩历史(每一步都保留一个 token),也不存外观(只存变化)。这个划分在逻辑上清楚,但要注意 LTM 实际上仍保留了少量外观信息——视频示范任务中的首帧锚点。
原文
MEM (Torne et al., 2026) combines recent video with long-term textual memory, HiMe (Ji et al., 2026) separates working memory from long-term planning, and WeaveLA (Zhu et al., 2026) passes latent summaries of completed segments to subsequent subtasks. MemER (Sridhar et al., 2025) retrieves keyframes for a high-level vision-language model that generates instructions for a low-level policy. PonderPounce (Choi et al., 2026) uses a separate pretrained multimodal context model to asynchronously supply continuous cognition tokens to its action model. Its RoboMME training recipe includes transition, subgoal, and demonstration-reasoning supervision. In 2AM (Hu et al., 2026), an agent maintains episodic memory and guides an episodically stateless action model through subtask language and optional 2D spatial hints. These designs delegate historical interpretation to a higher-level model or interface. LTM instead exposes observed transitions directly to the action policy, without invoking a separate reasoning model or generating intermediate language during control.
译文
MEM(Torne et al., 2026)把近期视频与长期文本记忆结合起来,HiMe(Ji et al., 2026)把工作记忆和长期规划分开,WeaveLA(Zhu et al., 2026)把已完成片段的潜在摘要传递给后续子任务。MemER(Sridhar et al., 2025)为一个高层视觉语言模型检索关键帧,再由该模型为低层策略生成指令。PonderPounce(Choi et al., 2026)使用一个单独的预训练多模态上下文模型,异步地向其动作模型提供连续的“认知 token”(cognition token);它在 RoboMME 上的训练方案包含转移监督、子目标监督和示范推理监督。在 2AM(Hu et al., 2026)中,一个智能体(agent)维护情景记忆,并通过子任务语言和可选的二维空间提示来引导一个在回合层面无状态的动作模型。这些设计都把“解读历史”这件事交给一个更高层的模型或接口。LTM 则把观测到的转移直接交给动作策略,在控制过程中既不调用单独的推理模型,也不生成中间语言。
解释
这一段讨论的是“分层”方案:高层模型(通常是大 VLM)负责读历史、做推理,再把结论以文字指令、子目标或特殊 token 的形式交给底层动作模型。它们的共同代价是推理时要多跑一个大模型(PonderPounce 的上下文模型是 9B),训练时往往还需要额外的中间标注(PonderPounce 用了转移、子目标和示范推理三种监督)。“回合层面无状态”(episodically stateless)指 2AM 的动作模型本身不保存任何历史,每一步只按高层给的当前指令行动,所有记忆都在上层智能体里。LTM 的对比点是:历史不经过任何“翻译”,直接以转移 token 的形式进入动作策略。这样做省掉了大模型调用和标注,但也意味着“理解历史”的工作完全落在 3B 的 \pi_{0.5} 主干身上——§4.1.5 的交换任务分析会显示,这种理解在需要多步组合时仍然吃力。
原文
SimpleMemVLA (Yin et al., 2026) retains timestamped video in its VLM's native context and reuses the prefix cache through streaming prefill. Its action head receives representations of generated subtask text, with subtask annotations produced offline by a cloud VLM. This is a training-time annotation dependency, rather than a requirement for cloud-model calls during control. T^2Mem (Liu et al., 2026) places a fast-weight memory between the VLM and action expert and updates it through self-supervised test-time gradients. Like LTM, it learns from action demonstrations without an external reasoning model or memory-specific annotations. Our distinction is therefore the memory representation and update rule: LTM appends frozen pairwise transition codes to a persistent sequence, without test-time gradient updates. Its causal attention and delayed prefix support incremental inference while preserving access to the current observation.
译文
SimpleMemVLA(Yin et al., 2026)在其 VLM 的原生上下文中保留带时间戳的视频,并通过流式预填充(streaming prefill)复用前缀缓存。它的动作头接收所生成的子任务文本的表征,而子任务标注由一个云端 VLM 离线生成。这属于训练时对标注的依赖,而不是在控制过程中需要调用云端模型。T^2Mem(Liu et al., 2026)在 VLM 和动作专家之间放置一个快速权重(fast-weight)记忆,并通过自监督的测试时梯度来更新它。与 LTM 一样,它从动作示范中学习,不使用外部推理模型或记忆标注。因此,我们与它的区别在于记忆表征和更新规则:LTM 把冻结的成对转移码追加到一个持久序列中,不做测试时梯度更新。它的因果注意力和延迟前缀支持增量推理,同时保留对当前观测的访问。
解释
这一段专门处理两个在表 1 中最强的对手,并说明为什么把它们放在不同的组里。SimpleMemVLA(表 1 中 88.25%,远高于 LTM 的 58.54%)的思路其实和 LTM 的工程部分很像:把历史帧直接放在 VLM 的上下文里,用缓存避免重复计算。它的优势来自两点:存的是完整视频而非压缩的转移;训练时有云端 VLM 离线生成的子任务标注作为额外监督。作者特意澄清“推理时不调用云端模型”,以示公允,但仍把它归入“使用记忆标注”的一组。T^2Mem(56.83%)与 LTM 处于同一组(都不用外部模型和标注),是 LTM 最直接的竞争者。“快速权重记忆”是一小组参数,推理时用自监督损失对它做梯度更新,相当于把历史“写进权重”;LTM 则把历史“写进上下文”,不做任何测试时训练。两者在表 1 上只差 1.71 个点,但特点不同:T^2Mem 在 VideoUnmask、PickHighlight、InsertPeg、RouteStick 上更强,LTM 在 Counting 的 StopCube 和 Permanence 的 ButtonUnmask 上更强。
原文
Latent action models. LAMs infer compact transition codes from observation pairs, typically using reconstruction without action labels (Bruce et al., 2024; Ye et al., 2024). Genie (Bruce et al., 2024) uses discrete codes for controllable video generation, LAPA (Ye et al., 2024) uses them for policy pretraining, and CLAM (Liang et al., 2025) and UniVLA (Bu et al., 2025) extend latent actions to continuous and cross-embodiment control. DreamDojo (Gao et al., 2026a) uses latent actions for world-model pretraining; CD-LAM (Wei et al., 2026) reduces visual confounding in such codes. We use pretrained LAMs only to encode observed transitions into episodic memory; the deployed policy does not need to reconstruct past frames or generate future videos.
译文
潜在动作模型。 LAM 从观测对中推断紧凑的转移码,通常在没有动作标签的情况下用重建目标训练(Bruce et al., 2024; Ye et al., 2024)。Genie(Bruce et al., 2024)用离散码实现可控的视频生成,LAPA(Ye et al., 2024)用它们做策略预训练,CLAM(Liang et al., 2025)和 UniVLA(Bu et al., 2025)把潜在动作扩展到连续控制和跨本体控制。DreamDojo(Gao et al., 2026a)用潜在动作做世界模型预训练;CD-LAM(Wei et al., 2026)减少了这类编码中的视觉混杂(visual confounding)。我们只用预训练好的 LAM 把观测到的转移编码进情景记忆;部署的策略不需要重建过去的帧,也不需要生成未来的视频。
解释
两个被选中的编码器。本文实际使用的是 DreamDojo 和 CD-LAM。DreamDojo 是一个从大规模人类视频学来的通用机器人世界模型,它的 LAM 用来给没有动作标签的人类视频提供“动作”条件;CD-LAM 的目标是让码少受与动作无关的视觉变化(光照、背景、相机抖动、其他物体的运动)干扰,即“去混杂”。两者都输出 32 维连续向量(不是 Genie、LAPA 那样的离散码本)。视觉混杂为什么重要。如果 LAM 的码里混进了大量外观信息,那么作为记忆,它就退化成了一种“压缩的帧”,失去了“只记变化”的意义;如果码里漏掉了重要的变化(比如新物体出现),记忆就不完整。第 5 节的局限性讨论正是后一种情况。最后一句点明本文对 LAM 的用法是“只用编码器”:LAM 的解码器(重建帧)和世界模型部分在部署时完全不用,因此不会带来生成视频的计算开销。
3方法(Method)
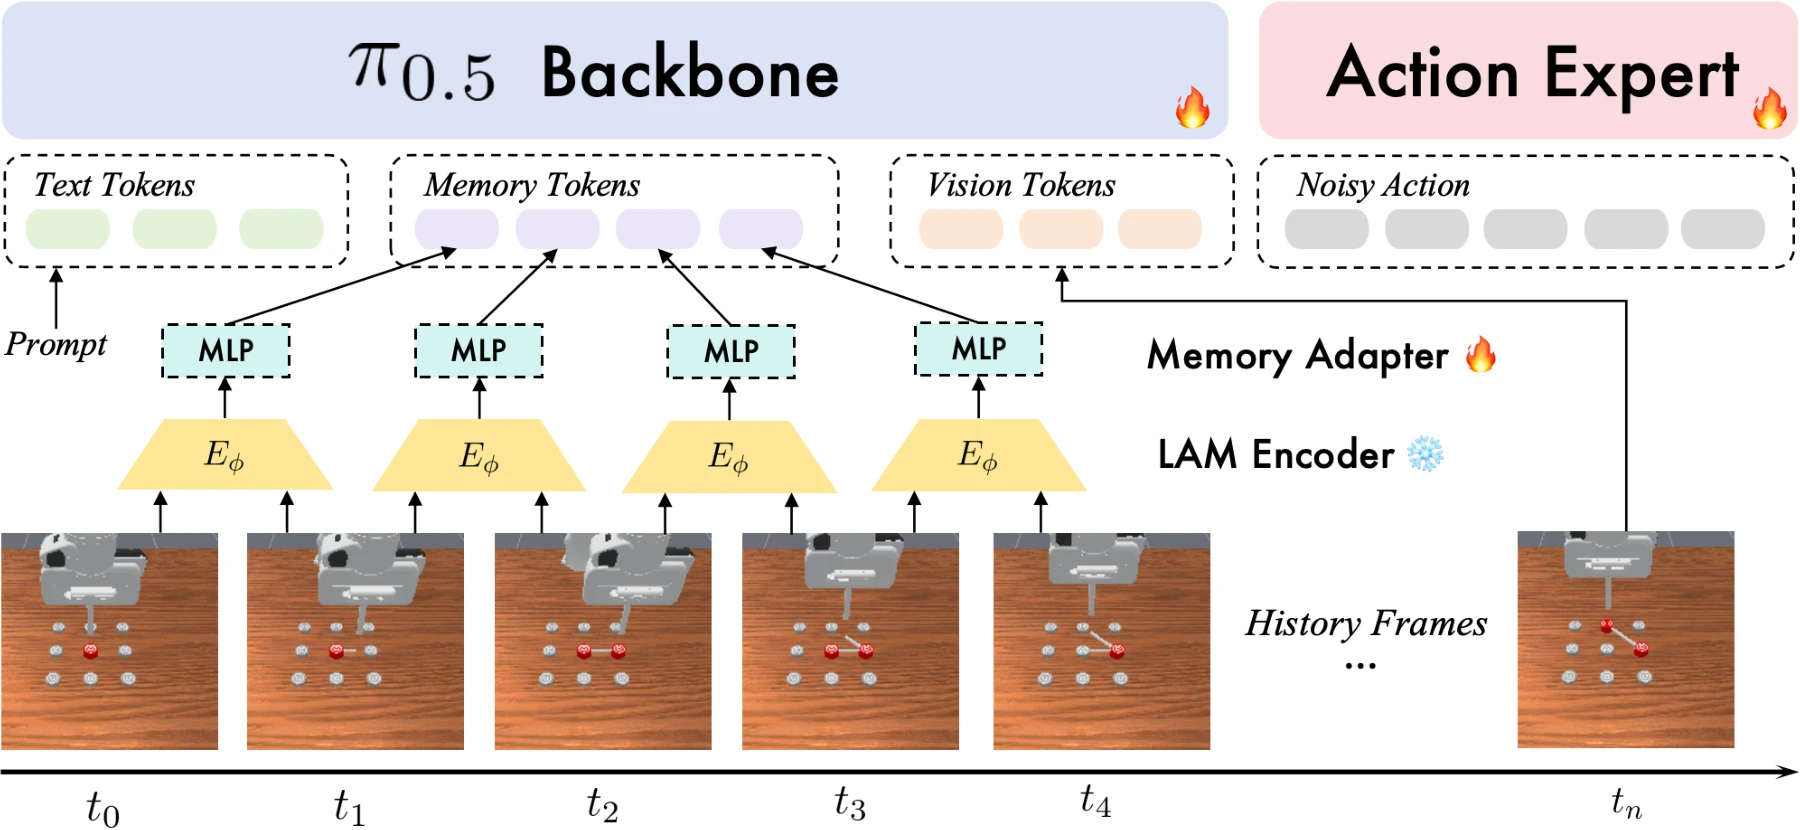
图 2:LTM-\pi 用一个冻结的潜在动作模型编码相邻观测,并把每个转移映射为一个记忆 token。可训练的策略以指令、转移历史和当前观测为条件。示意图省略了固定延迟,以及用于视频示范的视觉锚点。
原图注:LTM-\pi encodes consecutive observations with a frozen latent action model and maps each transition to a memory token. The trainable policy conditions on the instruction, transition history, and current observation. The schematic omits the fixed lag and the visual anchors used for video demonstrations.
图 2 解读
从下往上读。最底部是时间轴 t_0,t_1,\dots,t_n 和对应的“历史帧”(History Frames),画面来自 RoboMME 的一个桌面任务。每两张相邻帧一起送入一个黄色梯形 E_\phi(LAM 编码器,旁边的雪花图标表示冻结、不训练),输出一个转移码;码再经过一个 MLP(“记忆适配器”,火焰图标表示参与训练),变成一个紫色的“记忆 token”。最右边的当前帧 t_n 不经过 LAM,而是直接作为“视觉 token”(橙色)输入。上方是 \pi_{0.5} 的两部分:左边蓝色的“\pi_{0.5} 主干”(PaliGemma VLM,可训练)读入一条序列,依次是文本 token(由提示词得到,绿色)、记忆 token(紫色)、视觉 token(橙色);右边红色的“动作专家”(Action Expert,可训练)读入带噪声的动作(灰色)并去噪成动作块,它通过注意力读取主干的上下文。这张图要传达的是“记忆的位置”:记忆 token 被夹在文字和当前图像之间,作为主干输入的一部分,而不是另开一个模块。图注提醒有两件事没画:一是延迟 k(最近 k 个转移实际上还没进入记忆),二是视频示范任务额外加入的两个首帧锚点。另外,图中每个转移都画了一个独立的 MLP,实际上是同一个共享参数的 MLP。
3.1基于潜在转移的 VLA 上下文内记忆(Latent-Transition-Based In-Context Memory for VLAs)
原文
We represent interaction history using compact latent transitions between consecutive observations. A latent action model (LAM) encodes each transition from o_{i-1} to o_i into a latent code z_i, from which a decoder reconstructs o_i conditioned on o_{i-1}:
z_i = E_\phi(o_{i-1},o_i), \qquad \hat{o}_i = D_\psi(o_{i-1},z_i), \qquad \mathcal{L}_{\mathrm{LAM}} = d(\hat{o}_i,o_i),
where E_\phi and D_\psi are the transition encoder and decoder, respectively, and d is a reconstruction distance. Conditioning the decoder on the preceding observation encourages the compact latent bottleneck to capture temporal changes rather than redundant appearance information. 译文
我们用相邻观测之间紧凑的潜在转移来表示交互历史。潜在动作模型(LAM)把从 o_{i-1} 到 o_i 的每个转移编码为一个潜在码 z_i,解码器以 o_{i-1} 为条件,可以由它重建 o_i:
z_i = E_\phi(o_{i-1},o_i), \qquad \hat{o}_i = D_\psi(o_{i-1},z_i), \qquad \mathcal{L}_{\mathrm{LAM}} = d(\hat{o}_i,o_i),
其中 E_\phi 和 D_\psi 分别是转移编码器和解码器,d 是一种重建距离。让解码器以前一个观测为条件,会促使紧凑的潜在瓶颈去捕捉时间上的变化,而不是冗余的外观信息。 解释
逐个符号。o_{i-1},o_i 是相邻两个时刻的观测(图像)。E_\phi 是编码器,参数为 \phi,同时看两帧,输出码 z_i;D_\psi 是解码器,参数为 \psi,只看前一帧和码,输出对后一帧的重建 \hat o_i;d 是重建距离,例如像素空间的均方误差或特征空间的距离。\mathcal L_{\mathrm{LAM}} 是 LAM 预训练时的损失。注意下标约定:z_i 是“到达第 i 帧的那次转移”,所以第一个转移是 z_1(从 o_0 到 o_1),回合开头的 o_0 没有对应的码。为什么瓶颈会过滤外观。可以把它想成一个通信问题:发送方(编码器)看到两帧,要通过一个很窄的信道(z_i)告诉接收方(解码器)后一帧长什么样;接收方手上已经有前一帧。显然,最高效的消息是“和前一帧相比有什么不同”,而不是把整张图重新描述一遍。举例:机械臂向右移动了 2 厘米、夹爪合上,这几个数就足以让解码器在前一帧的基础上画出后一帧。这个公式是 LAM 的通用定义,LTM 本身并不训练它;LTM 只用训练好的 E_\phi,也就是只取第一个等式。
原文
Two properties make these representations useful for VLA memory: (i) Compactness. Each transition is represented by a low-dimensional vector, reducing the context budget required to retain interaction history. (ii) Locality. Each code depends only on two consecutive observations, allowing incremental memory construction without re-encoding earlier frames.
译文
有两个性质使这些表征适合作为 VLA 的记忆: (i) 紧凑性。每个转移由一个低维向量表示,减少了保留交互历史所需的上下文预算。 (ii) 局部性。每个码只依赖两个相邻观测,因此可以增量地构建记忆,无需重新编码之前的帧。
解释
紧凑性的量级:一张图像在 PaliGemma 中是 256 个 token,一个转移只占 1 个 token,存同样长的历史,上下文开销约为存帧的 1/256(不考虑抽帧)。但要看清“低维”指的是 LAM 输出的 32 维;进入 VLM 后每个转移仍是一个完整的 2048 维 token,开销按 token 数算。由于是每个控制步都存一个,长回合的 token 总数仍然可观(§4.1.6 中最多 1789 个),这正是作者后来要做压缩的原因。局部性对应于在线系统的需求:新的一帧到来时,只需把它和上一帧配对算一次,旧的码一个都不用动。对比之下,如果用一个“看整段视频”的编码器做记忆,每多一帧就要重新编码全部历史,代价随时间平方增长。局部性也带来一个隐患:每个码只看两帧,对跨越很多帧的慢变化(例如物体被缓慢推远)或需要“全局”理解的事件,单个码看不全,必须依靠策略把一串码组合起来理解。
原文
Let \mathbf A_t denote an action chunk, s_t the robot state, and \ell the language instruction. A current-observation policy predicts \mathbf A_t \sim \pi_\theta(\cdot \mid o_t,s_t,\ell). Existing memory mechanisms augment this policy in different ways: frame-based memory uses sampled observations, \mathbf A_t \sim \pi_\theta(\cdot \mid o_t,s_t,\ell, \{o_i\}_{i \in \mathcal I_t}), where \mathcal I_t \subseteq \{0,\ldots,t-1\}; language-based memory uses a summary m_t^{\mathrm{lang}} = f_{\mathrm{LLM}}(o_{<t}), giving \mathbf A_t \sim \pi_\theta(\cdot \mid o_t,s_t,\ell,m_t^{\mathrm{lang}}); and recurrent memory updates h_t = f_{\mathrm{rec}}(h_{t-1},o_t), giving \mathbf A_t \sim \pi_\theta(\cdot \mid o_t,s_t,\ell,h_t).
译文
记 \mathbf A_t 为一个动作块,s_t 为机器人状态,\ell 为语言指令。只看当前观测的策略预测 \mathbf A_t \sim \pi_\theta(\cdot \mid o_t,s_t,\ell)。现有的记忆机制以不同方式扩充这一策略:基于帧的记忆使用采样的观测,\mathbf A_t \sim \pi_\theta(\cdot \mid o_t,s_t,\ell, \{o_i\}_{i \in \mathcal I_t}),其中 \mathcal I_t \subseteq \{0,\ldots,t-1\};基于语言的记忆使用一段总结 m_t^{\mathrm{lang}} = f_{\mathrm{LLM}}(o_{<t}),得到 \mathbf A_t \sim \pi_\theta(\cdot \mid o_t,s_t,\ell,m_t^{\mathrm{lang}});循环记忆则做更新 h_t = f_{\mathrm{rec}}(h_{t-1},o_t),得到 \mathbf A_t \sim \pi_\theta(\cdot \mid o_t,s_t,\ell,h_t)。
解释
这段用统一的条件分布记号,把引言里的三类记忆写成公式,便于和 LTM 对比。基线策略。\pi_\theta(\cdot\mid o_t,s_t,\ell) 读作“在给定当前图像 o_t、机器人状态 s_t(关节角、夹爪开合等本体感知量)和指令 \ell 的条件下,动作块的分布”,\theta 是策略参数。\mathbf A_t 是一个动作块:一次预测未来若干步的动作(RoboMME 上 50 步、LIBERO-Mem 上 10 步),执行其中一部分后再重新预测。“\sim”表示从分布中采样,因为 \pi_{0.5} 的动作专家是生成式的。三种扩充。(1) 帧记忆:额外给出一组历史帧,下标集合 \mathcal I_t 是从过去时刻 0,\dots,t-1 中挑出的子集,挑法可以是均匀抽帧、按重要性丢弃等。(2) 语言记忆:用一个大语言模型 f_{\mathrm{LLM}} 读入全部过去观测 o_{<t}(即 o_0,\dots,o_{t-1}),写出一段文字摘要 m_t^{\mathrm{lang}}。(3) 循环记忆:维护一个隐状态 h_t,每来一帧就用更新函数 f_{\mathrm{rec}} 把新观测揉进去,和 RNN 完全一样。三者的区别可以归结为“历史以什么形式进入策略”:原始帧、文字、固定大小的向量。下一段给出 LTM 的第四种形式。
原文
Our approach instead conditions the policy on an ordered sequence of latent transitions:
\mathcal M_t^{\mathrm{LAM}} = (z_i)_{1 \leq i \leq \tau_t}, \qquad \mathbf A_t \sim \pi_\theta(\cdot \mid o_t,s_t,\ell,\mathcal M_t^{\mathrm{LAM}}).
Here, \tau_t=\max(0,t-k) excludes the latest k transitions, while o_t remains the current visual input. This representation retains transition-level information without dense historical RGB tokens or recurrent compression; video-conditioned tasks additionally use the sparse anchors described below. 译文
我们的方法则让策略以一个有序的潜在转移序列为条件:
\mathcal M_t^{\mathrm{LAM}} = (z_i)_{1 \leq i \leq \tau_t}, \qquad \mathbf A_t \sim \pi_\theta(\cdot \mid o_t,s_t,\ell,\mathcal M_t^{\mathrm{LAM}}).
其中 \tau_t=\max(0,t-k) 排除了最近的 k 个转移,而 o_t 仍作为当前的视觉输入。这种表征保留了转移层面的信息,既不需要稠密的历史 RGB token,也不做循环压缩;以视频为条件的任务还会额外使用下文所述的稀疏锚点。 解释
逐个符号。\mathcal M_t^{\mathrm{LAM}} 是时刻 t 的记忆,是一个按时间排列的序列(圆括号表示有序,区别于上一段帧记忆中的集合花括号):z_1,z_2,\dots,z_{\tau_t}。\tau_t 是记忆中最后一个转移的编号。用数字走一遍。设延迟 k=5。在 t=3 时,\tau_3=\max(0,3-5)=0,记忆为空,策略只看当前帧——回合刚开始,确实没有什么需要记的。在 t=20 时,\tau_{20}=15,记忆是 z_1,\dots,z_{15},即到达第 15 帧为止的所有转移;第 16–20 帧之间的 5 个转移暂时不放进记忆。这 5 步的信息并没有完全丢失:它们发生在最近 5 个控制步内,当前画面 o_{20} 通常还能直接看出来。与上一段三种方案的对照。和帧记忆比,它保留了每一个转移(不抽稀),但每个只占一个 token;和语言记忆比,它不需要 LLM;和循环记忆比,它不做压缩,序列随时间线性增长,历史信息原样保留,由策略的注意力自己决定看哪里。最后半句交代了一个例外:需要模仿示范视频的任务,还会加入两张首帧图像作为“锚点”,详见 §3.2。
3.2LTM-\pi
原文
We instantiate this memory mechanism on \pi_{0.5} and refer to the resulting model as LTM-\boldsymbol{\pi}. The policy and memory projector are trained on demonstration data using a frozen LAM encoder, without requiring language summaries or intermediate semantic supervision. The architecture of LTM-\boldsymbol{\pi} is shown in Figure 2.
译文
我们在 \pi_{0.5} 上实例化这一记忆机制,并把得到的模型称为 LTM-\boldsymbol{\pi}。策略和记忆投影器在示范数据上训练,LAM 编码器保持冻结,不需要语言总结或中间语义监督。LTM-\boldsymbol{\pi} 的架构见图 2。
解释
训练中参与更新的是两部分:\pi_{0.5} 本身(主干和动作专家,从 \pi_{0.5} 的预训练权重出发微调)和新加的记忆投影器(MLP 适配器,从头训练);LAM 编码器不动。训练目标就是 \pi_{0.5} 原来的流匹配动作损失,没有为记忆另加任何损失。换句话说,记忆 token 有没有用、怎么用,完全由“预测示范动作”这一个目标间接驱动。
原文
Training Phase. For each training sample, we use a fixed lag k, shared with inference, and set \tau_t=\max(0,t-k). Frozen DreamDojo (Gao et al., 2026a) or CD-LAM (Wei et al., 2026) encodes the retained observation pairs into 32-dimensional transition vectors:
z_i = E_{\phi}(o_{i-1},o_i) \in \mathbb R^{32}, \qquad \tilde z_i = \mathtt{stopgrad} \left( \frac{z_i-\mu_{\mathcal D}}{\sigma_{\mathcal D}}\right), \quad 1 \leq i \leq \tau_t,
where E_{\phi} denotes the LAM encoder, and \mu_{\mathcal D} and \sigma_{\mathcal D} are dataset-level normalization statistics. 译文
训练阶段。 对每个训练样本,我们使用一个与推理时相同的固定延迟 k,并令 \tau_t=\max(0,t-k)。冻结的 DreamDojo(Gao et al., 2026a)或 CD-LAM(Wei et al., 2026)把保留下来的观测对编码为 32 维的转移向量:
z_i = E_{\phi}(o_{i-1},o_i) \in \mathbb R^{32}, \qquad \tilde z_i = \mathtt{stopgrad} \left( \frac{z_i-\mu_{\mathcal D}}{\sigma_{\mathcal D}}\right), \quad 1 \leq i \leq \tau_t,
其中 E_{\phi} 表示 LAM 编码器,\mu_{\mathcal D} 和 \sigma_{\mathcal D} 是数据集层面的归一化统计量。 解释
训练样本怎么构造。从一条示范中取一个时刻 t,作为一个训练样本:目标是该时刻开始的示范动作块 \mathbf A_t,输入是指令、当前帧 o_t,以及前 \tau_t 个转移。延迟 k 在训练和推理中必须一致,否则模型在训练时习惯了“记忆截止到 t-5”,推理时却拿到截止到 t 的记忆(或反过来),记忆与当前帧之间的时间缺口对不上。归一化。\mu_{\mathcal D},\sigma_{\mathcal D} 是在整个训练集上统计的 32 维均值和标准差(逐维),\frac{z_i-\mu_{\mathcal D}}{\sigma_{\mathcal D}} 是常见的 z-score 标准化,让每一维大致均值为 0、方差为 1,避免某些维度数值过大主导 MLP 的输入。不同 LAM 输出的数值范围差别很大,这一步让同一个适配器设计可以接两种编码器。stopgrad。\mathtt{stopgrad} 表示反向传播时梯度在此截断,不回传到 E_\phi。由于编码器本来就冻结,这主要是一种明确的写法,同时也意味着这些码可以离线预先算好、存进数据集,训练时不必在线跑 LAM,这对节省训练开销很重要。
原文
We use a lightweight memory adapter to align latent actions with the semantic space of the VLM. A two-layer MLP projector maps each normalized transition into a memory token in the 2048-dimensional hidden space of the PaliGemma-3B backbone of \pi_{0.5}:
m_i = \mathrm{LN}\!\left( W_2\,\mathrm{GELU}(W_1\tilde z_i+b_1)+b_2 \right), \qquad W_1 \in \mathbb R^{512 \times 32}, \quad W_2 \in \mathbb R^{2048 \times 512}.
译文
我们用一个轻量级的记忆适配器,把潜在动作对齐到 VLM 的语义空间。一个两层 MLP 投影器把每个归一化后的转移映射为一个记忆 token,其维度与 \pi_{0.5} 的 PaliGemma-3B 主干的 2048 维隐藏空间一致:
m_i = \mathrm{LN}\!\left( W_2\,\mathrm{GELU}(W_1\tilde z_i+b_1)+b_2 \right), \qquad W_1 \in \mathbb R^{512 \times 32}, \quad W_2 \in \mathbb R^{2048 \times 512}.
解释
逐层看形状。\tilde z_i 是 32 维;W_1\tilde z_i+b_1 把它升到 512 维,经过 GELU 非线性;W_2(\cdot)+b_2 再升到 2048 维;最后做层归一化 LN(LayerNorm),把这个向量的尺度调到与 PaliGemma 中其他 token 嵌入相近。参数量约为 32\times512+512+512\times2048+2048\approx 1.07M(再加 LN 的 4096 个参数),相对 3B 的主干可以忽略,所以叫“轻量级”。为什么需要适配器。LAM 的码空间和 VLM 的词嵌入空间毫无关系;适配器的作用和多模态模型里“把视觉特征投影到语言空间”的 projector 相同。MLP 对每个转移独立作用(共享参数),不在转移之间混合信息;转移之间的关系完全交给后面 Transformer 的注意力去建模。末尾的 LN。如果没有它,新加的 token 数值可能远大于或远小于预训练模型熟悉的范围,训练初期容易破坏 \pi_{0.5} 原有的能力。这是一个常见而必要的稳定性设计。
原文
We insert these tokens between the language and current visual tokens:
X_t = \big[ X^{\mathrm{lang}}(\ell); m_1,\ldots,m_{\tau_t}; X^{\mathrm{vis}}(o_t) \big].
The resulting context conditions the action expert. We apply causal attention within the language–memory prefix and allow the current visual tokens to attend to this prefix. Each prefix token therefore depends only on itself and preceding prefix tokens, enabling its KV representations to be reused when new memory tokens and visual inputs arrive. 译文
我们把这些 token 插在语言 token 和当前视觉 token 之间:
X_t = \big[ X^{\mathrm{lang}}(\ell); m_1,\ldots,m_{\tau_t}; X^{\mathrm{vis}}(o_t) \big].
所得的上下文作为动作专家的条件。我们在语言—记忆前缀内部使用因果注意力,并让当前视觉 token 可以关注(attend to)这一前缀。这样,每个前缀 token 只依赖它自身和它之前的前缀 token,因此当新的记忆 token 和视觉输入到来时,它的 KV 表示可以复用。 解释
序列布局。X^{\mathrm{lang}}(\ell) 是指令文本的 token,X^{\mathrm{vis}}(o_t) 是当前图像的视觉 token(PaliGemma 的 SigLIP 编码器输出),分号表示沿序列方向拼接。顺序“语言 \to 记忆 \to 当前图像”有讲究:语言在整个回合中不变,放最前;记忆只在末尾追加;当前图像每步都换,放最后。这恰好是一个“越靠后越常变”的排列,配合因果注意力就能最大化缓存复用。因果注意力为什么能缓存。在 Transformer 里,每个 token 在每一层的 K、V 由它能看到的那些 token 决定。若前缀用双向注意力(\pi_{0.5} 原本的做法),新加入一个记忆 token 会改变前面所有 token 的表示,KV 必须全部重算;改成因果注意力后,第 i 个 token 只看第 1..i 个,后来者不影响它,它的 KV 一经算出就永远有效。于是每一步只需为新增的记忆 token 和当前图像 token 计算 KV。视觉 token 的注意力。当前视觉 token 能看到整个语言—记忆前缀(原文没有明说视觉 token 之间是双向还是因果,\pi_{0.5} 中图像 token 内部通常是双向的)。动作专家再通过注意力读取整个上下文的 KV 生成动作。代价是:把原先双向的前缀改成因果,改变了 \pi_{0.5} 预训练时的注意力模式,需要通过微调来适应——论文没有单独消融“双向 vs 因果”对成功率的影响。
原文
Inference Phase. Algorithm 1 summarizes online inference. At decision step t, the policy consumes transitions only through \tau_t=\max(0,t-k). Each transition is encoded once, asynchronously after its observation pair becomes available, and stored in a latent buffer; the lag delays only when it is admitted to policy memory. Thus, a transition has up to k observation steps of computation slack before it is required. At each decision, newly eligible latents are appended to the persistent language–memory KV cache, after which o_t is processed and an action chunk is generated. This overlaps LAM computation with action execution and reduces critical-path blocking.
译文
推理阶段。 算法 1 概述了在线推理过程。在决策步 t,策略只使用到 \tau_t=\max(0,t-k) 为止的转移。每个转移在其观测对就绪后被异步编码一次,存入一个潜变量缓冲区;延迟只推迟它被写入策略记忆的时间。因此,一个转移在被需要之前,最多有 k 个观测步的计算余量。每次决策时,新近符合条件的潜变量被追加到持久的语言—记忆 KV 缓存中,随后处理 o_t 并生成一个动作块。这使 LAM 计算与动作执行重叠进行,减少了关键路径上的阻塞。
解释
“关键路径”与“余量”。机器人控制循环的关键路径是“拿到新观测 \to 算出动作 \to 开始执行”,这条路径上的每一毫秒都会推迟动作。如果每次决策前都要先把最新的转移编码完(k=0),LAM 的耗时就直接加在关键路径上。有了延迟 k,第 i 个转移最早在第 i 步就可以开始编码,但直到第 i+k 步才会被用到,这中间的 k 步里机器人正在执行上一个动作块,LAM 可以在后台并行计算。只要 LAM 算一个转移的时间小于执行 k 步的时间,它就完全不阻塞。两个缓冲区。“潜变量缓冲区”存已经算好但还没轮到进入记忆的码;“KV 缓存”存已经进入记忆的 token 的键值对。每次决策时,把缓冲区里编号 \le\tau_t 的码取出、投影、追加到 KV 缓存。代价。最近 k 步的变化不在记忆里,策略对它们只能靠当前画面推断。若某个关键事件恰好发生在最后 k 步而当前画面又看不出来,就可能出错。表 4 显示 k 在 0–10 之间影响很小,说明在 RoboMME 上这种情况不多。
原文
For n cached prefix tokens and b newly processed memory and visual tokens, caching reduces the per-chunk backbone self-attention cost from \mathcal O((n+b)^2) to \mathcal O(nb+b^2). For fixed b, this cost is linear in the cached history length. In the append-only variant, the cache itself also grows linearly with the number of retained transitions. Section 4.1.6 evaluates an optional compression rule that bounds execution-memory length; merging existing tokens requires refreshing the affected cache entries.
译文
设缓存中有 n 个前缀 token,新处理 b 个记忆 token 和视觉 token,那么缓存把每个动作块的主干自注意力开销从 \mathcal O((n+b)^2) 降到 \mathcal O(nb+b^2)。对固定的 b,这个开销与缓存的历史长度成线性关系。在只追加(append-only)的版本中,缓存本身也随保留的转移数线性增长。§4.1.6 评估了一种可选的压缩规则,用来限制执行记忆的长度;合并已有的 token 需要刷新受影响的缓存项。
解释
复杂度怎么来。不缓存时,每次决策要对全部 n+b 个 token 做一遍自注意力,两两相互作用,开销 \propto(n+b)^2。缓存后,旧的 n 个 token 不再重算,只需计算新来的 b 个 token 的查询(query)对全部 n+b 个键的注意力:新 token 看旧 token,开销 nb;新 token 互相看,开销 b^2。举例。一张图像约 256 个视觉 token,每次决策新增 10 个记忆 token(RoboMME 上每 10 步决策一次),b\approx266。若历史已有 n=1000 个 token:不缓存约 (1266)^2\approx1.6\times10^6,缓存后约 1000\times266+266^2\approx3.4\times10^5,约省 4.8 倍。随着 n 增大,节省倍数约为 n/b 级别,越长越划算。两个限制。第一,开销虽是线性的,但仍随回合变长而增长,显存中的 KV 缓存也线性增长;第二,若用 §4.1.6 的合并压缩,被合并 token 之后的所有缓存项都会失效(因为因果注意力下后面的 token 依赖前面的 token),需要重算。作者在 §4.1.6 末尾承认,压缩版本实际上放弃了一部分缓存收益。
原文
Algorithm 1 Online Inference of LTM-\pi The algorithm shows the execution-memory path without a video demonstration. For video-conditioned tasks, the fixed demonstration tokens and initial-frame anchors are included in the persistent prefix as described in the method. We use h=10 on RoboMME and h=5 on LIBERO-Mem; s_t is omitted on RoboMME.
Require: Instruction \ell, frozen encoder E_{\mathrm{LAM}}, projector P, policy \pi_\theta, statistics (\mu_{\mathcal D},\sigma_{\mathcal D}), lag k, replanning interval h
1: j,c\gets0; \mathcal C\gets\operatorname{Prefill}(X^{\mathrm{lang}}(\ell))
2: Receive o_0
3:while task is not terminated do
4: t\gets j; \tau_t\gets\max(0,t-k); receive state s_t
5: Wait only for unfinished z_i with c<i\leq\tau_t
6:for i=c+1,\ldots,\tau_t do
7: m_i\gets P((z_i-\mu_{\mathcal D})/\sigma_{\mathcal D}); \mathcal C\gets\operatorname{AppendKV}(\mathcal C,m_i); c\gets i
8:end for
9: \mathcal C_t\gets\operatorname{AppendKV}(\mathcal C,X^{\mathrm{vis}}(o_t))
10: \mathbf A_t\sim\pi_\theta(\cdot\mid\mathcal C_t,s_t)
11:while executing the first h actions of \mathbf A_t do
12: Receive o_{j+1}; j\gets j+1
13: LaunchAsync z_j\gets E_{\mathrm{LAM}}(o_{j-1},o_j) ▷ store in latent buffer
14:end while
15: Discard temporary visual KV entries; retain \mathcal C
16:end while
算法 1:LTM-\pi 的在线推理
Require: 指令 \ell,冻结的编码器 E_{\mathrm{LAM}},投影器 P,策略 \pi_\theta,统计量 (\mu_{\mathcal D},\sigma_{\mathcal D}),延迟 k,重规划间隔 h
1: j,c\gets0;\mathcal C\gets\operatorname{Prefill}(X^{\mathrm{lang}}(\ell))
2: 接收 o_0
3:while 任务未结束 do
4: t\gets j;\tau_t\gets\max(0,t-k);接收状态 s_t
5: 只等待满足 c<i\leq\tau_t 且尚未算完的 z_i
6:for i=c+1,\ldots,\tau_t do
7: m_i\gets P((z_i-\mu_{\mathcal D})/\sigma_{\mathcal D});\mathcal C\gets\operatorname{AppendKV}(\mathcal C,m_i);c\gets i
8:end for
9: \mathcal C_t\gets\operatorname{AppendKV}(\mathcal C,X^{\mathrm{vis}}(o_t))
10: \mathbf A_t\sim\pi_\theta(\cdot\mid\mathcal C_t,s_t)
11:while 执行 \mathbf A_t 的前 h 个动作期间 do
12: 接收 o_{j+1};j\gets j+1
13: 异步启动 z_j\gets E_{\mathrm{LAM}}(o_{j-1},o_j) ▷ 存入潜变量缓冲区
14:end while
15: 丢弃临时的视觉 KV 项;保留 \mathcal C
16:end while
译文
该算法展示的是没有视频示范时的执行记忆路径。对以视频为条件的任务,固定的示范 token 和首帧锚点按方法部分所述被纳入持久前缀。我们在 RoboMME 上使用 h=10,在 LIBERO-Mem 上使用 h=5;在 RoboMME 上省略 s_t。
算法 1 解读
变量。j 是“已经收到的最新观测”的编号,c 是“已经写入记忆的最后一个转移”的编号,\mathcal C 是持久的语言—记忆 KV 缓存,\mathcal C_t 是本次决策临时加上当前图像后的缓存。P 是 MLP 投影器,h 是每次决策后实际执行的动作步数(动作块更长,只执行前 h 步就重新决策)。逐行。第 1 行:回合开始时把指令文本预填充(prefill)进缓存,这部分整回合只算一次。第 4 行:当前决策时刻 t 就是最新观测的编号,算出本次需要的记忆截止编号 \tau_t。第 5 行:只有记忆需要、但后台还没算完的码才需要等待;这一行就是“阻塞”的来源。第 6–8 行:把新近“到期”的转移(编号 c+1 到 \tau_t)逐个归一化、投影、追加进 KV 缓存,并更新 c。第 9–10 行:临时追加当前图像的 KV,生成动作块。第 11–14 行:在执行 h 个动作的同时,每收到一帧新观测就立即在后台启动它与前一帧的 LAM 编码。第 15 行:当前图像只对本次决策有用,其 KV 丢弃,持久缓存只保留语言和记忆。用 RoboMME 的设置走一遍(h=10,k=5)。假设上一次决策在 t=20,执行 10 步期间收到 o_{21},\dots,o_{30},依次启动 z_{21},\dots,z_{30} 的编码。下一次决策在 t=30,\tau_{30}=25,需要的新转移是 z_{21}..z_{25}(第 5 行只等这 5 个),z_{26}..z_{30} 留在缓冲区里到下一次再用。z_{25} 在第 25 步才启动,离第 30 步只剩 5 步执行时间,所以等待主要来自它;若 k=10,需要的是 z_{11}..z_{20},它们在上一整个执行周期里早已算完,等待为零。这正是表 4 中三种 k 的阻塞时间差异的来历。注意原文的循环条件写成“执行前 h 个动作期间”,即每执行一步收到一帧;所以“观测步”“执行步”“转移”在本文里是一一对应的,每个控制步产生一个记忆 token。
原文
Visual Anchors for Video Demonstrations. For tasks conditioned on video demonstrations, the initial scene layout may differ between the demonstration and execution environments. To improve visual–semantic alignment, we complement latent transitions with sparse visual features from both sequences, inspired by frame-based memory sampling. A minimal choice uses the first frame of each sequence as a visual anchor:
X_t = \big[X^{\mathrm{lang}}(\ell); X^{\mathrm{vis}}(o_0^{\mathrm{demo}}); m_1^{\mathrm{demo}},\ldots,m_{T_{\mathrm{demo}}}^{\mathrm{demo}}; X^{\mathrm{vis}}(o_0); m_1,\ldots,m_{\tau_t}; X^{\mathrm{vis}}(o_t)\big].
Here, o_0^{\mathrm{demo}} and o_0 are the initial demonstration and execution observations, respectively, and m_i^{\mathrm{demo}} encodes the transition from o_{i-1}^{\mathrm{demo}} to o_i^{\mathrm{demo}}. We add distinct learnable type embeddings to the demonstration and execution segments to distinguish their roles; these embeddings are omitted from the formula for clarity. The fixed visual anchors and demonstration tokens are retained in the persistent KV cache alongside the language and execution memory tokens. 译文
视频示范的视觉锚点。 对于以视频示范为条件的任务,示范环境和执行环境的初始场景布局可能不同。为了改善视觉与语义的对齐,受基于帧的记忆采样启发,我们用来自两段序列的稀疏视觉特征来补充潜在转移。一个最简单的选择是把每段序列的第一帧作为视觉锚点:
X_t = \big[X^{\mathrm{lang}}(\ell); X^{\mathrm{vis}}(o_0^{\mathrm{demo}}); m_1^{\mathrm{demo}},\ldots,m_{T_{\mathrm{demo}}}^{\mathrm{demo}}; X^{\mathrm{vis}}(o_0); m_1,\ldots,m_{\tau_t}; X^{\mathrm{vis}}(o_t)\big].
其中 o_0^{\mathrm{demo}} 和 o_0 分别是示范和执行的初始观测,m_i^{\mathrm{demo}} 编码从 o_{i-1}^{\mathrm{demo}} 到 o_i^{\mathrm{demo}} 的转移。我们为示范段和执行段分别加上不同的可学习类型嵌入(type embedding),以区分它们的角色;为简洁起见,公式中省略了这些嵌入。固定的视觉锚点和示范 token 与语言 token、执行记忆 token 一起保留在持久 KV 缓存中。 解释
哪些任务需要它。RoboMME 中名字带 Video 的任务(VideoUnmask、VideoRepick、VideoPlaceButton/Order 等)和 Imitation 组的任务,开始时先给机器人看一段示范视频(例如“示范中按了哪几个按钮、按什么顺序”),然后在一个布局可能不同的场景里执行。为什么只有转移不够。转移 token 描述的是“发生了什么变化”,比如“机械臂向左下移动并按下”。但“左下”相对于什么?哪个按钮在那里?如果没有一张参照图,策略不知道这些变化发生在怎样的场景里,也就无法把示范中的动作对应到执行场景中的物体。首帧锚点给出了起点的完整外观,加上随后的一串变化,原则上就可以“推演”出每一时刻的状态。这和工作区《Delta 表示调研》中“作为输入时一定要配锚点”的结论是一致的。序列的结构。整个前缀依次是:指令、示范首帧图像、示范的全部 T_{\mathrm{demo}} 个转移、本回合首帧图像、本回合到 \tau_t 为止的转移、当前图像。前五部分都是持久的(示范部分整个回合不变,执行记忆只追加),只有最后的当前图像每步更换。类型嵌入是两个可学习向量,分别加到示范段和执行段的 token 上,告诉模型“这是别人做的”还是“这是我自己做的”,否则两段转移 token 在形式上没有区别。一处细节。示范视频的所有转移都被保留(T_{\mathrm{demo}} 个,没有延迟,因为整段视频一开始就已给出)。在 §4.1.6 的压缩实验中,作者明确说配额只针对执行转移,示范上下文不计入。
4实验(Experiment)
原文
Our experiments examine the effectiveness, information content, and memory cost of LTM-\pi. In simulation (Section 4.1), we introduce the benchmarks and evaluation protocol (Section 4.1.1), report results on RoboMME and LIBERO-Mem (Section 4.1.2), and isolate the effects of memory components and lag (Section 4.1.3). We then examine demonstration scaling (Section 4.1.4), probe whether latent transitions encode swap information (Section 4.1.5), and test manipulation under a fixed token budget (Section 4.1.6). Finally, Section 4.2 presents the real-robot setup and repeated pick-and-place evaluation.
译文
我们的实验考察 LTM-\pi 的有效性、信息内容和记忆开销。在仿真部分(§4.1),我们介绍基准和评估协议(§4.1.1),报告 RoboMME 和 LIBERO-Mem 上的结果(§4.1.2),并分离出记忆各组成部分和延迟的影响(§4.1.3)。随后我们考察示范数据的扩展(§4.1.4),探究潜在转移是否编码了交换信息(§4.1.5),并测试固定 token 预算下的操作表现(§4.1.6)。最后,§4.2 介绍真实机器人的设置和重复抓放评估。
解释
实验部分的结构可以看成一条问题链:LTM 有没有用(§4.1.2)\to 有用是因为哪个部分(§4.1.3)\to 更多数据能否进一步提升(§4.1.4)\to 扩数据后仍做不好的交换任务,问题出在信息缺失还是不会用(§4.1.5)\to 记忆太长能否压缩(§4.1.6)\to 真机上是否成立(§4.2)。读的时候注意每一节用的是哪个编码器、哪个数据规模、几个评估种子,这几项在各节之间并不相同。
4.1仿真评估(Evaluation in Simulation)
4.1.1实验设置(Settings)
原文
Benchmarks. We evaluate memory-dependent robotic control on two complementary benchmarks, RoboMME (Dai et al., 2026) and LIBERO-Mem (Chung et al., 2026). RoboMME contains 16 history-dependent manipulation tasks organized into four suites: Counting, Permanence, Reference, and Imitation, targeting temporal, spatial, object, and procedural memory, respectively. These tasks require the policy to retain information from earlier observations or demonstrations that may no longer be recoverable from the current observation. LIBERO-Mem further evaluates long-horizon memory under object-level partial observability. It contains 10 tasks spanning four object-centric memory dimensions: Object Motion (OM), Object Sequence (OS), Object Relations (OR), and Object Occlusion (OO). The benchmark introduces temporally dependent subgoals and visually ambiguous objects, requiring the policy to track object identities, interactions, and state changes over trajectories of up to several hundred frames.
译文
基准。 我们在两个互补的基准 RoboMME(Dai et al., 2026)和 LIBERO-Mem(Chung et al., 2026)上评估依赖记忆的机器人控制。RoboMME 包含 16 个依赖历史的操作任务,分为四个套件:Counting(计数)、Permanence(恒存)、Reference(指代)和 Imitation(模仿),分别针对时间记忆、空间记忆、物体记忆和过程记忆。这些任务要求策略保留来自先前观测或示范的信息,而这些信息可能已无法从当前观测中恢复。LIBERO-Mem 进一步评估在物体层面部分可观测条件下的长时程记忆。它包含 10 个任务,涵盖四个以物体为中心的记忆维度:物体运动(Object Motion,OM)、物体序列(Object Sequence,OS)、物体关系(Object Relations,OR)和物体遮挡(Object Occlusion,OO)。该基准引入了在时间上相互依赖的子目标和外观难以区分的物体,要求策略在长达数百帧的轨迹中追踪物体身份、交互和状态变化。
解释
RoboMME 的四组任务(任务全名见表 1 表注): Counting 要求记住“做了几次”或“发生了几次”,如 PickXtimes(抓放 X 次)、SwingXtimes(来回摆动 X 次)、BinFill(往箱中放入指定数量的物体),以及 StopCube:一个方块在目标附近来回摆动,机器人要按下按钮,让它恰好在第 N 次到达目标时停住,既要数清到达次数,也要把握按下的时机。 Permanence 考“物体恒存”:物体被遮住后仍知道它在哪,如 VideoUnmask / ButtonUnmask(先看视频或按按钮让物体露出又被盖住,再去揭开正确的遮挡物),以及带 Swap 的版本(盖住后遮挡物还会交换位置)。 Reference 考指代:记住“哪一个”,如 PickHighlight(抓之前被高亮过的那个物体)、VideoRepick(重新抓视频中被抓过的那个)、VideoPlaceButton/Order(按视频中的按钮或顺序放置)。 Imitation 考过程:照着示范视频的做法去做,如 MoveCube(按示范所用的方式移动方块:抓起放下、用闭合夹爪推、或用棍子推)、InsertPeg(插入示范中用过的那根销钉)、PatternLock 和 RouteStick(复现示范中的图案或路线)。LIBERO-Mem 是在 LIBERO 仿真框架上构造的记忆任务:从表 2 表注中的简称看,任务包括:把碗或瓶子放回原来的盘子(要记住原位置)、对碗或瓶子重复操作 3/5/7 次(要计数)、交换两只碗、轮换三只碗(要追踪位置变化),以及与奶酪和篮子中心有关的两个任务。原文只给了简称,更具体的任务定义见 LIBERO-Mem 原论文。“外观难以区分的物体”是关键设计:如果几只碗长得一样,策略无法靠外观认出“刚才那只”,只能靠记忆。
原文
Training and Evaluation Configuration. We train the model on 8 H100 GPUs with a batch size of 128, using 40K steps on the original RoboMME data and 30K steps on LIBERO-Mem. The RoboMME-10x experiment uses 120K steps (Section 4.1.4). The learning rate decays from 2.5\times10^{-5} to 2.5\times10^{-6}, with 1K warm-up steps. Unless otherwise specified, we use a fixed lag k=5 during training and inference. For the RoboMME data-scaling and token-compression experiments, we use k=10. The policy predicts action chunks of 50 steps on RoboMME and 10 steps on LIBERO-Mem, and replans after executing the first 10 and 5 steps, respectively. We do not use proprioceptive inputs on RoboMME. Following the official evaluation protocols, we evaluate each task on 20 layouts in LIBERO-Mem and over 50 rollouts in RoboMME. For the base-data RoboMME results in Table 1, we evaluate with three random seeds and report mean success rates. The Full and k=5 rows in the ablation tables reproduce these reference scores; the remaining ablations use a single seed.
译文
训练与评估配置。 我们在 8 块 H100 GPU 上训练模型,批大小为 128;在 RoboMME 原始数据上训练 40K 步,在 LIBERO-Mem 上训练 30K 步。RoboMME-10x 实验训练 120K 步(§4.1.4)。学习率从 2.5\times10^{-5} 衰减到 2.5\times10^{-6},预热 1K 步。除非另有说明,训练和推理都使用固定延迟 k=5;RoboMME 的数据扩展和 token 压缩实验使用 k=10。策略在 RoboMME 上预测 50 步的动作块,在 LIBERO-Mem 上预测 10 步的动作块,分别在执行前 10 步和前 5 步后重新规划。在 RoboMME 上我们不使用本体感知输入。按照官方评估协议,LIBERO-Mem 上每个任务在 20 个布局上评估,RoboMME 上每个任务评估 50 次 rollout。对于表 1 中原始数据规模下的 RoboMME 结果,我们用三个随机种子评估并报告平均成功率。消融表中的 Full 行和 k=5 行复用的就是这些参考分数;其余消融只用一个种子。
解释
几个容易忽略的配置差异。(1) 延迟 k:主结果、消融默认 k=5;数据扩展(10\times)和压缩实验用 k=10。因此 §4.1.4 中 1\times 与 10\times 的比较也隐含了 k 的变化。(2) 动作块:RoboMME 一次预测 50 步只执行 10 步,即每 10 步重新决策一次,期间产生 10 个新转移;LIBERO-Mem 每 5 步决策一次。(3) RoboMME 上不给机器人状态 s_t,策略只能从图像和记忆中推断机械臂位置。评估量与统计误差。RoboMME 每个任务 50 次 rollout,单个任务成功率的粒度是 2 个百分点;表 1 中出现 64.67、99.33 这类数字,正是三个种子(共 150 次)取平均的结果(如 97/150 = 64.67%)。LIBERO-Mem 每任务 20 个布局,粒度是 5 个百分点,所以表 2 中 LTM 的数字都是 5 的倍数。按二项分布估计,成功率 50% 附近时单任务 50 次的标准误约 7 个百分点、20 次约 11 个百分点;16 个任务平均后(800 次)约 1.8 个百分点。因此单种子消融中 1–2 个点的平均差异和单任务上 10 个点以内的差异都不宜过度解读。两处未交代清楚的地方。一是 10\times 实验的评估种子数没有给出(源码中留有作者“投稿前补充”的批注);二是“Full 行复用三种子参考分数”意味着消融中的完整模型是三种子平均,而被比较的消融变体是单种子,两者的方差并不相同。
原文
Baselines. For RoboMME, we compare against DP-Unet, OpenVLA-OFT, \pi_{0.5} with and without past actions, and its symbolic, perceptual, and recurrent memory variants (Dai et al., 2026). We also include MemoryVLA (Shi et al., 2025), SAM2Act+ (Fang et al., 2025), and MemER (Sridhar et al., 2025) as reported in RoboMME, alongside WeaveLA (Zhu et al., 2026), PonderPounce (9B) (Choi et al., 2026), SimpleMemVLA (Yin et al., 2026), and T^2Mem (Liu et al., 2026). To make the resource assumptions explicit, Table 1 separates methods that use neither an external reasoning model nor memory-specific annotations from methods that use either resource. All baseline results are taken directly from published reports, with oracle-assisted methods and human performance listed separately for reference. Table 1 uses the original data scale; Table 5 additionally includes PonderPounce with 9\times data. These comparisons retain the reported methods' different training and supervision resources. For LIBERO-Mem, we compare against \pi_{0.5}, SlotVLA (Hanyu et al., 2025), and Naive E-SlotSSM as reported by Chung et al. (2026), MemoryVLA (Shi et al., 2025), GMP (Gao et al., 2026b), MemoryVAM with UNet and DiT backbones (Jiang et al., 2026), and 2AM together with its \pi_0 reimplementation (Hu et al., 2026).
译文
基线。 在 RoboMME 上,我们与 DP-Unet、OpenVLA-OFT、带与不带过去动作的 \pi_{0.5},以及 \pi_{0.5} 的符号记忆、感知记忆和循环记忆变体(Dai et al., 2026)进行比较。我们还纳入了 RoboMME 中报告的 MemoryVLA(Shi et al., 2025)、SAM2Act+(Fang et al., 2025)和 MemER(Sridhar et al., 2025),以及 WeaveLA(Zhu et al., 2026)、PonderPounce(9B)(Choi et al., 2026)、SimpleMemVLA(Yin et al., 2026)和 T^2Mem(Liu et al., 2026)。为了明确各方法的资源假设,表 1 把既不用外部推理模型、也不用记忆标注的方法,与使用了其中任一资源的方法分开列出。所有基线结果都直接取自已发表的报告;借助了特权信息(oracle)的方法和人类表现单独列出,仅供参考。表 1 使用原始数据规模;表 5 额外纳入了使用 9\times 数据的 PonderPounce。这些比较保留了各方法在报告中所用的不同训练和监督资源。在 LIBERO-Mem 上,我们与 Chung et al. (2026) 报告的 \pi_{0.5}、SlotVLA(Hanyu et al., 2025)和 Naive E-SlotSSM,以及 MemoryVLA(Shi et al., 2025)、GMP(Gao et al., 2026b)、使用 UNet 和 DiT 主干的 MemoryVAM(Jiang et al., 2026)、2AM 及其 \pi_0 复现版本(Hu et al., 2026)进行比较。
解释
“直接取自已发表的报告”意味着什么。作者没有重跑任何基线,所有数字都是抄来的。好处是避免了“复现不好”的争议;坏处是各方法的评估种子、rollout 次数、甚至训练数据可能都不一样(例如表 2 中 2AM 的报告没有说明 rollout 次数)。因此表 1、表 2 中的差距应看作“大致的量级对比”,而不是严格对照实验。分组标准。作者把表 1 分成三块:(1) 特权信息与人类参考(不参与排名)——其中“+Oracle”指测试时给了正确的子目标等真值信息;(2) 用了外部推理模型或记忆标注的方法,例如 SimpleSG/GroundSG 调用 Gemini 或 QwenVL 生成子目标,MemER 用高层 VLM,PonderPounce 用单独的 9B 上下文模型,SimpleMemVLA 用云端 VLM 离线标注;(3) 两者都不用的方法,LTM 属于这一组。这样分组对 LTM 是有利的,因为它在第 (3) 组排第一,而在第 (2) 组面前(SimpleMemVLA 88.25%)明显落后。不过分组标准本身是合理的:外部大模型和人工/云端标注都是实际部署时的额外成本。\pi_{0.5} “带过去动作”是 RoboMME 提供的一个最简单的记忆基线:把之前执行过的动作作为额外输入。符号/感知/循环记忆变体即表 1 中 SimpleSG/GroundSG、TokenDrop/FrameSamp、TTT/RMT 那些行。
4.1.2主要结果(Main Results)
表 1:RoboMME 全部 16 个任务上的成功率(%,\uparrow)。可部署的方法按是否同时避免调用外部推理模型和使用记忆标注分为两块。每一块内,粗体和下划线分别表示最好和第二好的结果。特权信息(oracle)和人类参考不参与排名。
| 方法 | Counting | Permanence | Reference | Imitation | 平均 | ||||||||||||
| BF | PX | SX | SC | VU | BU | VUS | BUS | PH | VR | VPB | VPO | MC | IP | PL | RS | ||
| 特权信息与人类参考(不参与排名) | |||||||||||||||||
| SimpleSG+Oracle | 85.78 | 99.78 | 100.00 | 44.67 | 33.11 | 22.00 | 15.56 | 15.56 | 44.00 | 27.78 | 31.33 | 26.00 | 87.33 | 10.00 | 95.33 | 55.11 | 49.58 |
| GroundSG+Oracle | 85.78 | 100.00 | 100.00 | 49.67 | 98.78 | 95.00 | 99.22 | 80.22 | 83.33 | 97.33 | 100.00 | 100.00 | 87.78 | 15.56 | 97.00 | 55.56 | 84.08 |
| WeaveLA (oracle) | 28.00 | 34.00 | 50.00 | 12.00 | 24.00 | 28.00 | 22.00 | 4.00 | 12.00 | 2.00 | 22.00 | 14.00 | 16.00 | 2.00 | 8.00 | 12.00 | 18.12 |
| Human | 96.00 | 100.00 | 80.00 | 78.00 | 90.00 | 92.00 | 92.00 | 90.00 | 92.00 | 92.00 | 98.00 | 90.00 | 90.00 | 98.00 | 84.00 | 86.00 | 90.50 |
| 使用外部推理模型和/或记忆标注 | |||||||||||||||||
| SimpleSG+Gemini | 46.00 | 63.00 | 45.00 | 2.00 | 29.00 | 9.00 | 14.00 | 2.00 | 20.00 | 15.00 | 26.00 | 29.00 | 61.00 | 4.00 | 7.00 | 0.00 | 23.25 |
| SimpleSG+QwenVL | 77.56 | 95.33 | 5.11 | 0.44 | 34.22 | 19.33 | 15.33 | 9.56 | 17.11 | 25.33 | 33.33 | 25.11 | 82.00 | 3.78 | 12.67 | 7.78 | 29.00 |
| GroundSG+Gemini | 26.00 | 18.00 | 4.00 | 3.00 | 36.00 | 14.00 | 13.00 | 0.00 | 9.00 | 17.00 | 12.00 | 7.00 | 17.00 | 0.00 | 7.00 | 2.00 | 11.56 |
| GroundSG+QwenVL | 52.00 | 92.67 | 7.33 | 0.00 | 88.67 | 24.00 | 30.67 | 14.00 | 15.11 | 25.33 | 54.00 | 31.78 | 71.56 | 3.33 | 6.67 | 6.00 | 32.70 |
| MemER | 56.67 | 79.33 | 59.33 | 0.00 | 81.33 | 72.00 | 38.00 | 21.33 | 70.67 | 25.33 | 30.00 | 26.00 | 82.67 | 6.67 | 16.67 | 12.00 | 42.38 |
| WeaveLA | 26.00 | 44.00 | 46.00 | 2.00 | 28.00 | 14.00 | 14.00 | 4.00 | 10.00 | 4.00 | 26.00 | 18.00 | 22.00 | 4.00 | 8.00 | 8.00 | 17.38 |
| PonderPounce (9B) | 50.67 | 93.33 | 72.00 | 82.67 | 94.67 | 97.33 | 25.33 | 34.00 | 85.33 | 40.67 | 83.33 | 79.33 | 81.33 | 6.00 | 12.67 | 34.67 | 60.83 |
| SimpleMemVLA | 78.00 | 100.00 | 96.00 | 92.00 | 100.00 | 100.00 | 90.00 | 94.00 | 90.00 | 64.00 | 86.00 | 90.00 | 94.00 | 46.00 | 94.00 | 98.00 | 88.25 |
| 不用外部推理模型、不用记忆标注 | |||||||||||||||||
| DP-Unet | 32.00 | 2.67 | 6.67 | 0.00 | 16.00 | 4.00 | 4.00 | 0.00 | 0.00 | 0.00 | 22.00 | 5.67 | 8.67 | 0.00 | 2.00 | 10.00 | 7.11 |
| OpenVLA-OFT | 8.00 | 8.00 | 2.00 | 2.00 | 16.00 | 0.00 | 18.00 | 0.00 | 10.00 | 0.00 | 28.00 | 20.00 | 18.00 | 4.00 | 6.00 | 8.00 | 9.25 |
| \pi_{0.5} | 30.00 | 42.89 | 35.56 | 6.67 | 20.44 | 22.22 | 18.67 | 6.67 | 11.33 | 0.44 | 31.11 | 25.78 | 26.00 | 1.56 | 2.89 | 4.67 | 17.93 |
| \pi_{0.5} w/ past actions | 26.67 | 58.33 | 26.67 | 4.67 | 30.67 | 23.67 | 20.67 | 16.00 | 12.33 | 8.67 | 24.00 | 18.67 | 34.00 | 1.00 | 4.00 | 5.67 | 19.73 |
| TokenDrop+Context | 48.67 | 85.11 | 94.67 | 3.11 | 33.78 | 31.56 | 26.22 | 16.00 | 20.67 | 17.78 | 31.11 | 25.33 | 81.33 | 4.00 | 12.67 | 20.00 | 34.50 |
| TokenDrop+Modul | 34.44 | 83.56 | 86.00 | 5.33 | 28.22 | 29.33 | 28.44 | 21.33 | 21.33 | 22.00 | 59.56 | 36.00 | 62.00 | 7.11 | 32.44 | 51.56 | 38.04 |
| TokenDrop+Expert | 54.22 | 87.56 | 91.78 | 4.22 | 26.67 | 30.44 | 18.44 | 18.89 | 19.33 | 20.89 | 36.44 | 24.67 | 87.56 | 2.22 | 16.22 | 18.22 | 34.86 |
| FrameSamp+Context | 41.22 | 72.00 | 73.67 | 13.67 | 26.89 | 30.22 | 20.89 | 15.22 | 17.67 | 15.22 | 30.00 | 20.89 | 77.22 | 1.22 | 15.22 | 19.67 | 30.68 |
| FrameSamp+Modul | 39.56 | 87.33 | 92.00 | 42.00 | 32.67 | 25.11 | 24.44 | 18.22 | 22.89 | 30.44 | 60.00 | 32.00 | 77.78 | 7.56 | 53.56 | 66.67 | 44.51 |
| FrameSamp+Expert | 57.33 | 86.22 | 94.67 | 28.89 | 31.78 | 25.78 | 22.89 | 20.22 | 19.11 | 23.11 | 30.00 | 24.22 | 83.11 | 2.00 | 13.56 | 17.11 | 36.25 |
| TTT+Context | 35.56 | 62.89 | 42.44 | 3.33 | 29.78 | 22.89 | 18.44 | 14.44 | 20.44 | 13.11 | 34.22 | 20.22 | 32.44 | 1.11 | 1.56 | 3.56 | 22.28 |
| TTT+Modul | 34.22 | 65.11 | 36.67 | 2.11 | 27.22 | 22.11 | 25.22 | 14.11 | 14.56 | 12.11 | 32.67 | 22.33 | 31.22 | 1.11 | 3.56 | 7.00 | 21.96 |
| TTT+Expert | 34.89 | 63.78 | 41.33 | 4.00 | 31.78 | 22.44 | 19.56 | 18.00 | 12.22 | 9.56 | 34.00 | 22.89 | 33.56 | 0.89 | 3.11 | 5.56 | 22.35 |
| RMT+Context | 32.44 | 56.89 | 33.56 | 5.78 | 31.33 | 10.89 | 17.33 | 2.00 | 14.00 | 3.78 | 32.00 | 29.11 | 25.78 | 2.00 | 5.56 | 8.89 | 19.46 |
| RMT+Modul | 33.33 | 60.78 | 37.78 | 4.67 | 31.11 | 11.78 | 17.78 | 2.44 | 17.11 | 4.22 | 32.00 | 31.11 | 24.67 | 2.21 | 3.78 | 8.00 | 20.17 |
| RMT+Expert | 35.78 | 60.22 | 36.00 | 5.56 | 28.00 | 17.11 | 15.78 | 2.00 | 11.78 | 0.22 | 24.22 | 22.67 | 20.00 | 1.89 | 4.22 | 4.89 | 18.15 |
| MemoryVLA | 10.00 | 17.33 | 1.33 | 0.00 | 16.00 | 8.00 | 4.67 | 4.67 | 7.33 | 0.00 | 13.33 | 4.00 | 14.00 | 0.00 | 12.00 | 1.33 | 7.12 |
| SAM2Act+^{\dagger} | 40.00 | 76.00 | 25.33 | 0.00 | 27.33 | 32.00 | 18.00 | 26.67 | 17.33 | 5.33 | 24.67 | 20.00 | 29.33 | 0.00 | 0.00 | 0.00 | 21.37 |
| T^2Mem | 60.67 | 91.33 | 90.67 | 70.00 | 88.00 | 59.33 | 29.33 | 20.00 | 50.67 | 38.67 | 35.33 | 30.00 | 80.67 | 36.00 | 50.00 | 78.67 | 56.83 |
| LTM-\boldsymbol{\pi} (CD-LAM) | 64.67 | 100.00 | 93.33 | 87.33 | 68.67 | 98.00 | 30.67 | 31.33 | 22.67 | 30.00 | 38.67 | 22.67 | 80.00 | 20.67 | 64.00 | 70.00 | 57.67 |
| LTM-\boldsymbol{\pi} (DreamDojo) | 66.00 | 99.33 | 96.00 | 100.00 | 72.67 | 86.67 | 34.00 | 36.00 | 38.67 | 42.67 | 38.00 | 30.67 | 77.33 | 20.00 | 60.00 | 38.67 | 58.54 |
原表注:Success rates (%, \uparrow) on all 16 RoboMME tasks. Deployable methods are divided into two blocks according to whether they avoid both external reasoning-model calls and memory-specific annotations. Within each block, bold and underline indicate the best and second-best results, respectively. Oracle and human references are excluded from ranking. [Footnote] BF: BinFill; PX: PickXtimes; SX: SwingXtimes; SC: StopCube; VU/BU: Video/ButtonUnmask; VUS/BUS: Video/ButtonUnmaskSwap; PH: PickHighlight; VR: VideoRepick; VPB/VPO: VideoPlaceButton/Order; MC: MoveCube; IP: InsertPeg; PL: PatternLock; RS: RouteStick. ^{\dagger}SAM2Act+ uses an external motion planner, but not an external reasoning model; its keyframe actions are control targets rather than memory-specific semantic annotations. An integrated VLM backbone is treated as part of a single policy, whereas a separate inference-time planner or reasoner is treated as an external reasoning model.
表 1 解读
怎么读。每行一个方法,16 列是 16 个任务(按四个赛道分组,每组 4 个),最后一列是 16 个任务的简单平均。三块分别是:不参与排名的参考(含真值信息的 oracle 方法和人类)、用了外部推理模型或记忆标注的方法、两者都不用的方法;LTM-\pi 的两行(绿色底)在最后一块。粗体/下划线只在块内比较,所以同一列可能出现两个粗体(例如 PX 列 SimpleMemVLA 和 LTM CD-LAM 都是 100.00 且都加粗)。我们逐行核算过,所有“平均”列都等于 16 个任务的简单平均。参考行说明了什么。人类 90.50% 是上限参考。GroundSG+Oracle(84.08%)在给出真值子目标后仍在 Imitation 组只有 63.98%(IP 只有 15.56%),说明有些任务难点在动作执行而不全在记忆。WeaveLA (oracle) 只有 18.12%,比 \pi_{0.5} 高不了多少,与它不带 oracle 的 17.38% 接近。LTM 在本组的位置。同组内,第三名 T^2Mem 56.83%,之后是 FrameSamp+Modul 44.51%,再往下的 TokenDrop、FrameSamp、TTT、RMT 系列都在 18–38% 之间,\pi_{0.5} 17.93%。按赛道平均(四任务平均,我们由表中数字算得):DreamDojo 版 Counting 90.33、Permanence 57.34、Reference 37.50、Imitation 49.00;CD-LAM 版 86.33、57.17、28.50、58.67;T^2Mem 78.17、49.16、38.67、61.34。可见 LTM 的优势主要集中在 Counting(尤其 StopCube:100/87.33,对 T^2Mem 70.00),Reference 与 T^2Mem 相当或略低,Imitation 不占优(DreamDojo 版的 RouteStick 只有 38.67,CD-LAM 版 70.00,T^2Mem 78.67)。两个编码器的差异在单任务上可以很大(RS 相差 31 个点,PH 相差 16 个点),平均下来却只差 0.87。与上一块的比较。SimpleMemVLA(88.25%)在几乎所有任务上都领先,它保留完整的带时间戳视频并利用离线子任务标注;PonderPounce(60.83%)总体略高于 LTM,强在 Permanence 中的非交换任务和整个 Reference 组,弱在 Imitation(IP 6.00、PL 12.67)。LTM 在 Imitation 的 PL(60–64)和 IP(20–21)上明显好于大多数基于 VLM 推理的方法,这符合直觉:模仿示范的运动细节,语言总结很难传达,而转移序列直接编码了运动。一个值得注意的现象。交换类任务(VUS、BUS)对所有不用 oracle 的方法都很难:本组最好的就是 LTM 的 30–36%;只有 SimpleMemVLA 达到 90/94。这是 §4.1.5 诊断实验的出发点。
原文
As shown in Table 1, LTM-\pi achieves average success rates of 57.67% with CD-LAM and 58.54% with DreamDojo, improving over \pi_{0.5} by 39.74 and 40.61 percentage points, respectively. Within the block that uses neither external reasoning-model calls nor memory-specific annotations, the DreamDojo and CD-LAM variants rank first and second overall; DreamDojo exceeds the strongest baseline in this block, T^2Mem (56.83%), by 1.71 percentage points. Both variants also outperform baselines, suggesting that compact transition representations provide an effective alternative to sampled-frame memory. The DreamDojo variant is particularly strong on Counting, achieving 90.33% on average and solving StopCube with 100% success. For context, SimpleMemVLA reaches 88.25% using cloud-VLM-generated sub-task annotations, while PonderPounce reaches 60.83% using a separate 9B context model and additional grounding and demonstration-reasoning supervision. LTM-\pi achieves its results without external reasoning-model calls or memory-specific annotations. Reference tasks remain a target for improving fine-grained object identity and visual correspondence. In terms of inference efficiency, the average latency of a LTM-\pi policy inference on an H100 is 66.71 ms. Figure 1 compares task-level success rates.
译文
如表 1 所示,LTM-\pi 使用 CD-LAM 和 DreamDojo 时的平均成功率分别为 57.67% 和 58.54%,比 \pi_{0.5} 分别高出 39.74 和 40.61 个百分点。在既不调用外部推理模型、也不使用记忆标注的这一块中,DreamDojo 版和 CD-LAM 版分别位列总体第一和第二;DreamDojo 版比该块中最强的基线 T^2Mem(56.83%)高 1.71 个百分点。两个版本也都优于各基线,说明紧凑的转移表征可以有效替代采样帧记忆。DreamDojo 版在 Counting 上尤其强,平均达到 90.33%,并以 100% 的成功率解决了 StopCube。作为参照,SimpleMemVLA 借助云端 VLM 生成的子任务标注达到 88.25%,PonderPounce 借助单独的 9B 上下文模型以及额外的定位(grounding)和示范推理监督达到 60.83%。LTM-\pi 则在不调用外部推理模型、不使用记忆标注的情况下取得了上述结果。Reference 类任务仍是需要改进的方向,涉及细粒度的物体身份识别和视觉对应。推理效率方面,LTM-\pi 在 H100 上一次策略推理的平均延迟为 66.71 ms。图 1 比较了任务级的成功率。
解释
数字核对。57.67 - 17.93 = 39.74,58.54 - 17.93 = 40.61,58.54 - 56.83 = 1.71,Counting 平均 (66.00 + 99.33 + 96.00 + 100.00)/4 = 90.33,均与表 1 一致。“优于各基线”要限定范围。这句话只在“不用外部模型和标注”这一块内成立;放到整张表里,SimpleMemVLA 和 PonderPounce 都更高。而且对 T^2Mem 的 1.71 个点优势(CD-LAM 版只有 0.84 个点)落在跨论文比较的误差范围内:T^2Mem 的数字来自它自己的报告,种子数和评估细节未必一致。比较稳妥的说法是:LTM 与 T^2Mem 处于同一水平,二者都显著好于 RoboMME 自带的各种帧记忆和循环记忆基线(最好的 FrameSamp+Modul 为 44.51%)。“可以替代采样帧记忆”的依据。TokenDrop 和 FrameSamp 都是“存历史帧”的方案(前者丢弃部分 token,后者抽帧),它们与 LTM 同样基于 \pi_{0.5},最好的组合只有 44.51%。这一对比相对公平,因为基础模型相同,且都不用外部模型。不过数据和训练步数是否与 RoboMME 原论文一致,原文没有说明。Reference 是短板。这组任务要求记住“哪一个物体”(被高亮的、被抓过的),也就是物体身份。转移 token 编码的是“发生了什么运动”,对“动的是哪个外观相似的物体”可能区分不清;作者在第 5 节局限性中也承认 LAM 对外观和语义变化不敏感。
表 2:LIBERO-Mem 上的成功率(SR,%)。粗体表示每列的最好结果。
| 方法 | T0 | T1 | T2 | T3 | T4 | T5 | T6 | T7 | T8 | T9 | 平均 |
| \pi_{0.5} (original) | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 |
| SlotVLA (h=8) | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 |
| Naive E-SlotSSM (oracle) | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 |
| MemoryVLA | 55.0 | 0.0 | 35.0 | 0.0 | 5.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 9.5 |
| GMP | 85.0 | 45.0 | 20.0 | 5.0 | 40.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 19.5 |
| MemoryVAM (Pathway 1 only) | 85.0 | 40.0 | 35.0 | 10.0 | 15.0 | 0.0 | 5.0 | 0.0 | 30.0 | 65.0 | 28.5 |
| MemoryVAM (Pathway 2 only) | 45.0 | 10.0 | 5.0 | 0.0 | 5.0 | 5.0 | 0.0 | 0.0 | 5.0 | 0.0 | 7.5 |
| MemoryVAM (UNet) | 85.0 | 65.0 | 90.0 | 10.0 | 35.0 | 0.0 | 25.0 | 5.0 | 40.0 | 70.0 | 42.5 |
| MemoryVAM (DiT) | 75.0 | 65.0 | 65.0 | 15.0 | 55.0 | 35.0 | 10.0 | 10.0 | 25.0 | 50.0 | 40.5 |
| \pi_0 (2AM reimplementation)^{\dagger} | 30.83 | 13.33 | 14.17 | 21.67 | 11.67 | 10.00 | 6.67 | 8.33 | 0.00 | 5.83 | 12.25 |
| 2AM^{\dagger} | 1.67 | 5.00 | 5.00 | 6.67 | 6.67 | 2.50 | 7.50 | 10.00 | 47.50 | 25.83 | 11.83 |
| LTM-\pi(本文) | |||||||||||
| CD-LAM | 95.0 | 75.0 | 90.0 | 70.0 | 70.0 | 45.0 | 80.0 | 20.0 | 100.0 | 100.0 | 74.5 |
| DreamDojo | 95.0 | 75.0 | 100.0 | 90.0 | 90.0 | 65.0 | 65.0 | 25.0 | 100.0 | 100.0 | 80.5 |
原表注:Success rates (SR, %) on LIBERO-Mem. Bold indicates the best result in each column. [Footnote] T0: Bowl back on plate; T1: Bottle back on plate; T2: Bowl \times 3; T3: Bottle \times 3; T4: Bowl \times 5; T5: Bowl \times 7; T6: Swap 2 bowls; T7: Rotate 3 bowls; T8: Cheese + basket center; T9: Cheese + empty basket center. ^{\dagger} Their \pi_0 reimplementation uses Qwen3-VL-4B; the rollout count is unspecified in the cited report, so a matched evaluation budget cannot be established.
表 2 解读
结构。10 列对应 T0–T9(简称见表注),最后一列为平均。第一块是 LIBERO-Mem 原论文报告的三个方法,全为 0:原版 \pi_{0.5}、SlotVLA(历史窗口 h=8)、Naive E-SlotSSM(oracle)——即便给了 oracle 信息的物体槽位模型也一个都做不成,说明这个基准对现有方法极难。第二块是其他记忆方法:MemoryVLA 9.5%、GMP 19.5%、MemoryVAM 的几种变体(只用通路 1 / 只用通路 2 / UNet 主干 / DiT 主干)7.5–42.5%、2AM 及其 \pi_0 复现版约 12%。第三块是 LTM-\pi 的两个编码器版本。关键数字。LTM 两版平均 74.5% / 80.5%,比最强基线 MemoryVAM (UNet) 的 42.5% 高 32.0 / 38.0 个点(我们核算过所有平均值均为 10 项简单平均)。分任务看:T0、T1、T8、T9 两版都很高(75–100%);T2–T5(重复 3/5/7 次)DreamDojo 版明显更好,T3、T4、T5 都比 CD-LAM 高 20 个点;T6(交换两只碗)CD-LAM 更好(80 对 65);T7(轮换三只碗)两版都只有 20–25%,仍是难点。读数注意。LTM 每任务只有 20 个布局,单任务数字的粒度是 5 个百分点、标准误可达 10 个点以上,两版之间 T6、T3–T5 的差异并不都显著。2AM 一行的数字是 1.67、30.83 这类(可能是 120 次 rollout 的结果),与其他行的评估量不同,表注已说明无法对齐。另外,MemoryVAM 的通路 1/2 消融行本身就是 MemoryVAM 论文的结果,被原样搬来,不是本文所做的消融。
原文
Results on LIBERO-Mem. As shown in Table 2, LTM-\pi achieves average success rates of 74.5% with CD-LAM and 80.5% with DreamDojo, exceeding the strongest baseline included in this comparison, MemoryVAM (UNet), by 32.0 and 38.0 percentage points, respectively. DreamDojo improves over CD-LAM by 6.0 points overall, with particularly large gains on repeated-interaction tasks T3–T5, while both variants achieve 100% success on T8 and T9. These results support the effectiveness of latent-transition memory for history-dependent manipulation across different LAM encoders. The encoder choice nevertheless affects individual tasks: CD-LAM performs better on swapping two bowls (T6), achieving 80.0% versus 65.0%. Rotating three bowls (T7) remains challenging for both variants (20.0% and 25.0%), suggesting that tracking multiple objects through sequential interactions remains a limitation.
译文
LIBERO-Mem 上的结果。 如表 2 所示,LTM-\pi 使用 CD-LAM 和 DreamDojo 时的平均成功率分别为 74.5% 和 80.5%,比本次对比中最强的基线 MemoryVAM (UNet) 分别高出 32.0 和 38.0 个百分点。DreamDojo 版总体比 CD-LAM 版高 6.0 个点,在重复交互任务 T3–T5 上提升尤其大,两个版本都在 T8 和 T9 上达到 100% 的成功率。这些结果支持了潜在转移记忆在不同 LAM 编码器下对依赖历史的操作任务都有效。不过编码器的选择仍会影响单个任务:CD-LAM 在交换两只碗(T6)上表现更好,达到 80.0%,而 DreamDojo 为 65.0%。轮换三只碗(T7)对两个版本都仍有难度(20.0% 和 25.0%),说明在连续交互中追踪多个物体仍是一个局限。
解释
为什么重复交互任务 LTM 特别强。T2–T5 要求“同一动作重复 N 次”,几乎是纯计数。转移序列天然记录了每一次“抓起—放下”的事件,再加上序列长度本身携带的时间信息,计数类任务正是 LTM 最擅长的(这与表 1 中 Counting 赛道的优势一致)。不过表 3 的随机转移对照也提示我们:计数任务有一部分可以靠“已经过去多少步”来完成,未必全部依赖转移内容;LIBERO-Mem 上没有做这个对照。为什么交换/轮换难。T6、T7 与 RoboMME 的 Swap 任务同类:外观相同的碗被调换位置后,要知道哪只是哪只,必须把一连串局部运动正确地“串”起来。两个物体交换(T6)尚可,三个物体轮换(T7)就只剩 20–25%。这与引言中“把局部转移组合成持久物体状态”的难题是同一个问题,也是 §4.1.5 诊断实验的出发点。对比是否公平。LTM 的基线数字全部来自各自论文。最强的 MemoryVAM 用的是视频—动作模型(VAM)路线,训练资源与 LTM 不同;LIBERO-Mem 原论文里的 \pi_{0.5} 是 0%,而 LTM 正是在 \pi_{0.5} 上加记忆,所以“0 \to 80.5”大体可以看作记忆带来的增益,但本文自己没有重跑无记忆的 \pi_{0.5} 作为同条件对照。
4.1.3消融实验(Ablations)
原文
We first isolate the contributions of transition content and visual anchors, then test how delaying memory admission affects success and online computation.
译文
我们先分离出转移内容和视觉锚点各自的贡献,再测试延迟写入记忆如何影响成功率和在线计算。
解释
两组消融对应方法中的两个设计:记忆里放什么(转移 / 锚点),以及什么时候放(延迟 k)。从表 3、表 4 的数字可以确认,两组消融都是在 CD-LAM 版上做的(Full 行和 k=5 行与表 1 中 CD-LAM 一行逐项相同),原文没有明说。
原文
Effect of Latent Transitions and Visual Anchors. In Table 3, we ablate the two sources of historical information in LTM-\pi: latent-transition memory and sparse visual anchors. We compare the full model with LT-only, which removes visual anchors; Anchor-only, which removes latent transitions; and Fixed Random LT, which replaces observation-dependent latent transitions with fixed random representations while preserving the temporal structure of the memory sequence.
译文
潜在转移与视觉锚点的作用。 在表 3 中,我们对 LTM-\pi 的两种历史信息来源做消融:潜在转移记忆和稀疏视觉锚点。我们把完整模型与以下三种变体比较:LT-only,去掉视觉锚点;Anchor-only,去掉潜在转移;Fixed Random LT,把依赖观测的潜在转移换成固定的随机表示,同时保留记忆序列的时间结构。
解释
Fixed Random LT 的设计是这组消融的精华。它的含义是:每个时刻仍然往记忆里放一个 token,个数、顺序、位置都与完整模型相同,但 token 的内容是固定的随机向量,与观测无关。原文没有说明“固定”的具体含义(是所有位置用同一个随机向量,还是每个位置各有一个固定随机向量),但无论哪种,这些 token 都不携带“发生了什么变化”的信息,只携带“记忆有多长”的信息。由于每个控制步加一个 token,记忆长度就等于“已经过去了多少步”(减去 k),模型可以据此推断任务进度。因此 Fixed Random LT 与 Full 的差距,才是转移内容的真实贡献;而 Fixed Random LT 与“无记忆”的差距,是时间信息的贡献。需要注意的是,Anchor-only 去掉转移的同时也去掉了这种时间信息(只剩两张首帧),所以“Full 对 Anchor-only”的差距混合了内容和时间两种效应。
表 3:RoboMME 上潜在转移与视觉锚点作用的消融实验。报告全部 16 个任务上的成功率(%,\uparrow)。Fixed Random LT 去掉了转移特有的语义,同时保留记忆序列中的时间信息。
| 方法 | Counting | Permanence | Reference | Imitation | 平均 | ||||||||||||
| BF | PX | SX | SC | VU | BU | VUS | BUS | PH | VR | VPB | VPO | MC | IP | PL | RS | ||
| Full(完整模型) | 64.67 | 100.00 | 93.33 | 87.33 | 68.67 | 98.00 | 30.67 | 31.33 | 22.67 | 30.00 | 38.67 | 22.67 | 80.00 | 20.67 | 64.00 | 70.00 | 57.67 |
| LT-only(仅转移) | 66.00 | 100.00 | 94.00 | 90.00 | 24.00 | 44.00 | 30.00 | 16.00 | 26.00 | 30.00 | 40.00 | 36.00 | 90.00 | 14.00 | 46.00 | 40.00 | 49.13 |
| Anchor-only(仅锚点) | 34.00 | 32.00 | 42.00 | 0.00 | 66.00 | 58.00 | 24.00 | 8.00 | 12.00 | 2.00 | 26.00 | 10.00 | 32.00 | 2.00 | 12.00 | 10.00 | 23.13 |
| Fixed Random LT(固定随机转移) | 72.00 | 74.00 | 98.00 | 58.00 | 82.00 | 94.00 | 30.00 | 38.00 | 18.00 | 26.00 | 26.00 | 20.00 | 60.00 | 2.00 | 10.00 | 4.00 | 44.50 |
原表注:Ablation study on the effect of latent transitions and visual anchors on RoboMME. Success rates (%, \uparrow) are reported on all 16 tasks. Fixed Random LT removes transition-specific semantics while retaining temporal information from the memory sequence.
表 3 解读
四行的含义。Full:转移 + 锚点(即表 1 的 CD-LAM 版,三种子平均)。LT-only:只有转移,没有两张首帧锚点。Anchor-only:只有锚点,没有转移序列。Fixed Random LT:锚点 + 内容随机但长度和顺序不变的“伪转移”。后三行都是单种子。按赛道平均(我们由表中数字算得,顺序为 Counting / Permanence / Reference / Imitation): Full 86.33 / 57.17 / 28.50 / 58.67; LT-only 87.50 / 28.50 / 33.00 / 47.50; Anchor-only 27.00 / 39.00 / 12.50 / 14.00; Fixed Random LT 75.50 / 61.00 / 22.50 / 19.00。能读出的结论。(1) 转移是主力:去掉转移(Anchor-only)跌到 23.13%,几乎回到无记忆 \pi_{0.5} 的水平(17.93%);去掉锚点(LT-only)还有 49.13%。(2) 锚点的作用集中在 Permanence:LT-only 在 VU、BU 上从 68.67/98.00 跌到 24.00/44.00,因为揭开遮挡物这类任务需要知道“物体最初在哪”,单靠变化序列推不出初始位置;而 Anchor-only 在 VU、BU 上还有 66/58,说明首帧本身就提供了大部分所需信息。在 Counting 和 Reference 上,去掉锚点几乎无影响甚至略好。(3) 时间信息很强:Fixed Random LT 平均 44.50%,在 Counting 上 75.50%,在 Permanence 上 61.00%,甚至高于 Full 的 57.17%(VU 82 对 68.67、BUS 38 对 31.33)。(4) 转移内容的贡献集中在 Imitation:Fixed Random LT 在 Imitation 上只有 19.00%(IP 2、PL 10、RS 4),Full 为 58.67%,差 39.67 个点;PickXtimes(74 对 100)和 StopCube(58 对 87.33)也明显依赖内容。统计上的提醒。单种子、每任务 50 次,单任务差异在 10 个点以内(例如 LT-only 在 MC 上 90 对 80)基本属于噪声;平均值的差异(如 57.67 对 49.13、对 44.50)则远大于约 1.8 个点的标准误,是可信的。
原文
Removing latent transitions reduces average success from 57.67% to 23.13%, while LT-only retains 49.13%, showing that the transition sequence is the stronger historical component and anchors mainly provide complementary visual grounding.
译文
去掉潜在转移后,平均成功率从 57.67% 降到 23.13%,而 LT-only 仍保持 49.13%,说明转移序列是更强的历史成分,锚点主要提供互补的视觉参照。
解释
这句话的结论成立,但“互补”二字掩盖了一个任务层面的分工:锚点几乎只在 Permanence 组(尤其 VU、BU)起作用,而且作用很大(BU 从 44 到 98)。换言之,对“记住物体最初在哪”这类任务,一张首帧比整串转移更关键。这也印证了《Delta 表示调研》中的观察:变化表示作为输入时需要搭配一个锚点状态,否则模型不知道变化是“相对于什么”的。
原文
Fixed Random LT still reaches 44.50%, indicating that the ordered memory sequence itself provides useful cues about elapsed time and trajectory progress. Replacing these random tokens with observation-dependent latent transitions further improves performance to 57.67%, demonstrating that transition-specific content contributes beyond temporal cues. This gain is limited on swap-dependent tasks, motivating the diagnostic study below.
译文
Fixed Random LT 仍能达到 44.50%,说明有序的记忆序列本身就提供了关于已用时间和轨迹进度的有用线索。把这些随机 token 换成依赖观测的潜在转移,性能进一步提升到 57.67%,证明转移特有的内容在时间线索之外还有贡献。这一增益在依赖交换的任务上有限,这促使我们进行下文的诊断研究。
解释
这是全文最值得重视的一组数字之一。它说明 LTM 相对 \pi_{0.5} 的 39.74 个点提升中,约 26.6 个点(17.93 \to 44.50)可以由“记忆的长度 + 锚点”解释,约 13.2 个点(44.50 \to 57.67)才归功于转移的内容。这并不否定 LTM:13 个点仍然很显著,而且在需要复现运动细节的 Imitation 组,内容的作用是决定性的。但它提醒读者,在记忆任务上“加一串 token”本身就是一个强基线,任何声称“某种记忆内容有用”的工作都应当做类似的对照。(需要说明,Fixed Random LT 一行保留了锚点,所以 44.50% 中还包括锚点的贡献;更干净的“纯时间”对照应是“无锚点 + 固定随机转移”,论文没有做。)交换任务上的增益为何有限。VUS:Full 30.67、Fixed Random 30.00;BUS:Full 31.33、Fixed Random 38.00。也就是说,在交换任务上真实转移没有比随机 token 更好。这有两种可能:转移里没有交换的信息,或者有但策略没学会用。§4.1.5 的诊断实验就是为了区分这两种可能。
表 4:RoboMME 上延迟 k 的消融实验。报告全部 16 个任务上的成功率(%,\uparrow)。表中的 LAM 阻塞是估计的关键路径开销 \max(0,T_{\mathrm{LAM}}-T_{\mathrm{overlap}})。
| k | Counting | Permanence | Reference | Imitation | 平均 | 运行时间(ms,\downarrow) | |||||||||||||||
| BF | PX | SX | SC | VU | BU | VUS | BUS | PH | VR | VPB | VPO | MC | IP | PL | RS | 策略 | 仿真 | LAM 更新 | LAM 阻塞 | ||
| 0 | 62.00 | 98.00 | 94.00 | 90.00 | 70.00 | 94.00 | 30.00 | 34.00 | 28.00 | 26.00 | 38.00 | 24.00 | 82.00 | 20.00 | 66.00 | 70.00 | 57.88 | 66.71 | 117.01 | 114.25 (10 对,同步) | 114.25 |
| 5 | 64.67 | 100.00 | 93.33 | 87.33 | 68.67 | 98.00 | 30.67 | 31.33 | 22.67 | 30.00 | 38.67 | 22.67 | 80.00 | 20.67 | 64.00 | 70.00 | 57.67 | 66.71 | 117.01 | 67.97 (5 对,异步) | 9.47 |
| 10 | 58.00 | 98.00 | 90.00 | 86.00 | 68.00 | 96.00 | 28.00 | 32.00 | 20.00 | 30.00 | 36.00 | 24.00 | 76.00 | 24.00 | 64.00 | 72.00 | 56.38 | 66.71 | 117.01 | 114.25 (10 对,异步) | 0.00 |
原表注:Ablation study on lag k on RoboMME. Success rates (%, \uparrow) are reported on all 16 tasks. Reported LAM blocking is an estimated critical-path cost, \max(0,T_{\mathrm{LAM}}-T_{\mathrm{overlap}}).
表 4 解读
左半部分是三个延迟取值下的 16 个任务成功率与平均:k=0 为 57.88%,k=5 为 57.67%(即表 1 的 CD-LAM 版,三种子),k=10 为 56.38%(单种子)。三者的差距(最多 1.5 个点)与约 1.8 个点的标准误同量级,可以认为在 0–10 范围内 k 对成功率没有可分辨的影响。右半部分是四个时间量:“策略”是 \pi_{0.5} 一次前向(66.71 ms,与 k 无关);“仿真”是仿真器执行一个重规划周期(10 步)所需的时间 117.01 ms,也就是 LAM 可以与之重叠的最大时间窗;“LAM 更新”是本次决策需要等待编码的转移对数及其耗时;“LAM 阻塞”是按表注公式 \max(0,T_{\mathrm{LAM}}-T_{\mathrm{overlap}}) 估算的、实际挡在关键路径上的时间。三个数怎么来的。k=0:每次决策都要用到刚刚收到的 10 对观测,编码只能同步进行,没有重叠,阻塞 = 114.25 ms,几乎和策略本身的推理时间相当(甚至更长)。k=5:需要等的只有较早的 5 对(见算法 1 解读),耗时 67.97 ms;它们可以与剩下 5 步的执行重叠,重叠窗口约为 117.01/2 \approx 58.5 ms,所以阻塞 \approx 67.97 - 58.5 = 9.47 ms(与表中数字吻合,说明作者正是按一半的仿真时间计重叠)。k=10:需要的 10 对在上一整个周期里早已开始编码,114.25 < 117.01,阻塞为 0。需要注意。这是一个估计:仿真时间被当作重叠窗口,而真机上执行 10 步的时间(按 §4.2 的 0.05 s 控制间隔为 500 ms)远长于仿真,LAM 阻塞在真机上会更小。另外,5 对耗时 67.97 ms 而 10 对 114.25 ms,并非线性,说明有批处理的固定开销。
原文
Effect of Lag k. On RoboMME, we replan every 10 execution steps and use the same k for training and inference. As shown in Table 4, lag creates computation slack between observing a transition and admitting it to policy memory. Increasing k from 0 to 5 changes average success only from 57.88% to 57.67%, while reducing the estimated LAM blocking cost from 114.25 ms to 9.47 ms. At k=10, the measured LAM update fits within the available execution overlap, giving an estimated zero blocking cost, with 56.38% success. These point estimates indicate that a small non-zero lag can reduce blocking with a small change in success. The 66.71 ms policy time excludes LAM work; the blocking column is an overlap estimate, not a measured end-to-end control latency.
译文
延迟 k 的作用。 在 RoboMME 上,我们每执行 10 步重新规划一次,并在训练和推理中使用相同的 k。如表 4 所示,延迟在“观测到一个转移”与“把它写入策略记忆”之间创造了计算余量。把 k 从 0 增加到 5,平均成功率只从 57.88% 变为 57.67%,而估计的 LAM 阻塞开销从 114.25 ms 降到 9.47 ms。当 k=10 时,实测的 LAM 更新可以完全放进可用的执行重叠窗口内,估计阻塞开销为零,成功率为 56.38%。这些点估计表明,一个较小的非零延迟可以在成功率变化很小的情况下减少阻塞。66.71 ms 的策略时间不含 LAM 计算;阻塞一列是重叠估计,而不是实测的端到端控制延迟。
解释
为什么延迟几乎不伤性能。最近 k 步发生的变化,大多还能从当前画面中直接看出来(机械臂的位置、刚放下的物体),真正需要“记住”的往往是更早的、已经看不见的事件。因此推迟几步写入记忆,丢掉的信息很少。如何权衡。k=0 时每次决策的总耗时约为 66.71 + 114.25 \approx 181 ms,k=5 时约 76 ms,k=10 时约 67 ms。在需要快速响应的场景中,这 100 多毫秒的差别是实质性的。作者措辞谨慎(“点估计”“小的变化”“不是实测端到端延迟”),读者也应如此理解:这组实验说明了延迟设计在工程上可行,但没有给出端到端的实测延迟。
4.1.4RoboMME 上的数据扩展(Data Scaling on RoboMME)
原文
The ablations support the contribution of transition content beyond temporal cues. We next ask whether broader demonstration coverage helps the policy use this information across diverse task families. RoboMME provides 100 episodes per task family, each spanning multiple scenes and language instructions. Following the data-expansion setting explored by PonderPounce (Choi et al., 2026), we use RoboMME's generation pipeline to increase this to 1,000 episodes per family, yielding RoboMME-10x. Training-generation seeds are kept disjoint from validation and test seeds. We increase training from 40K to 120K steps and use a fixed lag k=10 during both training and inference. To assess whether longer training alone explains the improvement, we also train on the original data for 120K steps under the same configuration.
译文
消融实验支持了转移内容在时间线索之外的贡献。接下来我们要问:更广的示范覆盖能否帮助策略在多样的任务族中利用这些信息?RoboMME 为每个任务族提供 100 个回合,每个任务族涵盖多个场景和语言指令。沿用 PonderPounce(Choi et al., 2026)探索过的数据扩充设置,我们使用 RoboMME 的生成流程把每个任务族的回合数增加到 1,000,得到 RoboMME-10x。用于生成训练数据的随机种子与验证、测试种子互不重叠。我们把训练从 40K 步增加到 120K 步,并在训练和推理中都使用固定延迟 k=10。为了检验仅仅延长训练能否解释性能提升,我们还在原始数据上以相同配置训练了 120K 步。
解释
RoboMME-10x 怎么来的。RoboMME 是仿真基准,示范由脚本化的专家(运动规划器)自动生成,所以可以按需生成更多。作者用官方生成流程,把每个任务族从 100 条扩到 1000 条,并保证生成训练数据用的随机种子与评估用的种子不重叠,避免训练时见过测试场景。PonderPounce 也做过类似扩充(9 倍),这也是表 5 把它作为对照的原因。对照设计与其不足。作者意识到“数据多了”和“训练久了”是混在一起的,所以加了一个“原始数据 + 120K 步”的对照。这个设计是对的,但有两点没有交代:(1) 这个对照的成功率数字没有在任何地方报告,只在下文用文字说“没有明显提升”(arXiv 源码中作者留有批注,提醒自己投稿前补上实测数字和种子数,并特别注明“不要拿 1\times/40K 的分数当作对照”);(2) 表 5 中 1\times 一行实际是 40K 步、k=5、CD-LAM 编码器的结果,而 10\times 一行是 120K 步、k=10,编码器按 §4.1.6 的说法是 DreamDojo。所以表 5 中两行之间并不只差数据量。
表 5:RoboMME 上任务级的数据扩展结果(成功率,%,\uparrow)。我们报告使用 1\times 和 9\times 数据的 PonderPounce(9B),以及使用 1\times 和 10\times 数据的 LTM-\pi。增益比是平均成功率的增量除以相对 1\times 额外增加的数据倍数,单位为“每增加 1\times 数据的百分点数”。各方法的数据、训练和监督预算不同;增益比只是描述性的,不是对样本效率的受控估计。
| 方法 | 数据规模 | Counting | Permanence | Reference | Imitation | 平均 | 增益比 | ||||||||||||
| BF | PX | SX | SC | VU | BU | VUS | BUS | PH | VR | VPB | VPO | MC | IP | PL | RS | (pp/\times) | |||
| PonderPounce (9B) | 1\times | 50.67 | 93.33 | 72.00 | 82.67 | 94.67 | 97.33 | 25.33 | 34.00 | 85.33 | 40.67 | 83.33 | 79.33 | 81.33 | 6.00 | 12.67 | 34.67 | 60.83 | – |
| PonderPounce (9B) | 9\times | 74.00 | 98.00 | 93.33 | 60.00 | 96.67 | 100.00 | 73.33 | 50.67 | 92.67 | 88.67 | 92.00 | 97.33 | 93.33 | 18.67 | 25.33 | 54.67 | 75.54 | 1.84 |
| LTM-\pi(本文) | 1\times | 64.67 | 100.00 | 93.33 | 87.33 | 68.67 | 98.00 | 30.67 | 31.33 | 22.67 | 30.00 | 38.67 | 22.67 | 80.00 | 20.67 | 64.00 | 70.00 | 57.67 | – |
| LTM-\pi(本文) | 10\times | 80.00 | 100.00 | 100.00 | 100.00 | 100.00 | 100.00 | 74.00 | 62.00 | 70.00 | 66.00 | 84.00 | 84.00 | 96.00 | 88.00 | 98.00 | 98.00 | 87.50 | 3.31 |
原表注:Task-level data-scaling results on RoboMME (success rate, %, \uparrow). We report PonderPounce (9B) with 1\times and 9\times data and LTM-\pi with 1\times and 10\times data. Gain ratio is the increase in average success rate divided by the additional data multiple relative to 1\times, measured in percentage points per additional 1\times data. The data, training, and supervision budgets differ between methods; gain ratio is descriptive, not a controlled estimate of sample efficiency.
表 5 解读
结构。四行:PonderPounce 的 1\times 与 9\times,LTM-\pi 的 1\times 与 10\times;16 列任务、平均、增益比。PonderPounce 的两行和 LTM 1\times 一行都与表 1 中的对应行一致(LTM 1\times 即 CD-LAM 版)。增益比的算法。增益比 = (扩展后平均 - 1\times 平均)/(倍数 - 1)。LTM:(87.50-57.67)/9=3.31;PonderPounce:(75.54-60.83)/8=1.84。直观含义是“每多一份原始规模的数据,平均成功率涨几个点”。表注明确说它只是描述性的:两个方法从不同起点出发,接近上限时提升本来就会变慢,所以这个比值不能当作“样本效率”的严格比较。10\times 后的格局(赛道平均,我们算得):LTM 10\times 为 95.00 / 84.00 / 76.00 / 95.00;PonderPounce 9\times 为 81.33 / 80.17 / 92.67 / 48.00。LTM 在 Counting 和 Imitation 上大幅领先(IP 88 对 18.67、PL 98 对 25.33),PonderPounce 在 Reference 的四个任务上全部领先(PH 92.67 对 70、VR 88.67 对 66)。Permanence 两者接近,但都没能解决交换任务(LTM 的 VUS/BUS 为 74/62,PonderPounce 为 73.33/50.67)。这一格局与两者的设计吻合:LTM 记录运动,擅长计数和模仿;PonderPounce 依靠大 VLM 的语义推理和定位监督,擅长“哪一个物体”这类指代问题。一个反常值。PonderPounce 的 StopCube 在 9\times 数据下反而从 82.67 降到 60.00;LTM 10\times 达到 100。
原文
Table 5 shows that LTM-\pi improves from 57.67% to 87.50%, a gain of 29.83 percentage points. Counting, Permanence, Reference, and Imitation rise from 86.33%, 57.17%, 28.50%, and 58.67% to 95%, 84%, 76%, and 95%, respectively. Reference gains the most (+47.50 points), showing that the weakest base-data track benefits substantially from the expanded training set. The scaled model reaches at least 88% on every Imitation task and 100% on three of four Counting tasks. At the original 1\times data scale, extending training from 40K to 120K steps yields no appreciable improvement. This control indicates that longer training alone does not account for the gain at 10\times data, supporting the contribution of additional demonstrations.
译文
表 5 显示,LTM-\pi 从 57.67% 提升到 87.50%,增益为 29.83 个百分点。Counting、Permanence、Reference 和 Imitation 分别从 86.33%、57.17%、28.50% 和 58.67% 升至 95%、84%、76% 和 95%。Reference 提升最多(+47.50 个点),说明原始数据下最弱的赛道从扩充的训练集中获益很大。扩展后的模型在每个 Imitation 任务上都至少达到 88%,在四个 Counting 任务中的三个上达到 100%。在原始 1\times 数据规模下,把训练从 40K 步延长到 120K 步没有带来明显提升。这一对照表明,单靠延长训练不能解释 10\times 数据下的增益,支持了额外示范的贡献。
解释
数字核对。我们逐项复算:1\times 四个赛道平均为 86.33、57.17、28.50、58.67;10\times 为 95.00、84.00、76.00、95.00;Reference 增益 76.00 - 28.50 = 47.50;总增益 87.50 - 57.67 = 29.83,全部无误。如何理解 Reference 的大幅提升。在原始数据下 Reference 最弱,作者在 §4.1.2 把原因归于“细粒度的物体身份和视觉对应”。10 倍数据后它涨到 76%,说明问题至少有一部分是数据不足——策略没见过足够多的场景变化来学会“把转移序列中被操作的物体”和“当前画面中的物体”对应起来——而不全是转移表征本身缺少信息。结论的强度。“额外示范的贡献”这一结论方向上可信,但正如上文所说,对照组数字没有报告,1\times 与 10\times 之间还有 k 和编码器的差异。根据本文自己的其他实验,编码器从 CD-LAM 换成 DreamDojo 在 1\times 下只多 0.87 个点(表 1),k 从 5 到 10 在 1\times 下少 1.29 个点(表 4),都远小于 29.83 个点,所以把绝大部分增益归于数据是合理的推断,但这是读者根据其他表推出来的,不是这组实验本身证明的。
原文
For comparison, PonderPounce improves from 60.83% to 75.54% with 9\times data (+14.71 points). At 10\times data, LTM-\pi is 11.96 points higher overall, leading on 11 tasks and tying on ButtonUnmask; PonderPounce remains higher on the four Reference tasks. The descriptive gain ratios are 3.31 versus 1.84 percentage points per additional data multiple, respectively, under different training and supervision budgets. LTM-\pi also comes within 0.75 points of SimpleMemVLA's reported 88.25%, without memory-specific annotations but using more demonstrations (Table 1).
译文
作为对比,PonderPounce 使用 9\times 数据从 60.83% 提升到 75.54%(+14.71 个点)。在 10\times 数据下,LTM-\pi 总体高出 11.96 个点,在 11 个任务上领先,在 ButtonUnmask 上持平;PonderPounce 在四个 Reference 任务上仍然更高。在训练和监督预算不同的前提下,描述性的增益比分别为每增加一倍数据 3.31 和 1.84 个百分点。LTM-\pi 也与 SimpleMemVLA 报告的 88.25% 只差 0.75 个点——它不用记忆标注,但用了更多示范(表 1)。
解释
逐项核对。我们逐任务比较了 LTM 10\times 与 PonderPounce 9\times:LTM 领先的是 BF、PX、SX、SC、VU、VUS、BUS、MC、IP、PL、RS,共 11 个;BU 都是 100;PH、VR、VPB、VPO 四个 Reference 任务 PonderPounce 领先。87.50 - 75.54 = 11.96,与正文一致。与 SimpleMemVLA 的比较需要注意数据量。SimpleMemVLA 的 88.25% 是在原始 1\times 数据上取得的(但用了离线云端标注和完整视频历史),LTM 的 87.50% 用了 10 倍数据。作者在句末自己点明了“用了更多示范”。所以这句话的准确含义是:用 10 倍的仿真示范数据,可以替代 SimpleMemVLA 所用的子任务标注,达到相近的总体水平。在仿真中生成示范几乎没有成本,这种替代是划算的;在真机上则未必。
原文
Despite the broad gains, VideoUnmaskSwap and ButtonUnmaskSwap reach only 74% and 62%, compared with 100% on both non-swap counterparts. Expanded demonstration coverage therefore reduces, but does not remove, the difficulty of tracking state through swaps. We therefore turn to a controlled diagnostic to test whether the required swap information can be recovered from the transition sequence (Section 4.1.5).
译文
尽管提升很普遍,VideoUnmaskSwap 和 ButtonUnmaskSwap 只达到 74% 和 62%,而它们对应的非交换任务都达到 100%。因此,扩充示范覆盖减轻了、但没有消除“在交换过程中追踪状态”的困难。于是我们转向一个受控的诊断实验,检验所需的交换信息能否从转移序列中恢复(§4.1.5)。
解释
同一类任务,有交换和无交换相差 26–38 个点,这是一个非常干净的信号:困难正是来自“交换”本身。交换任务要求把多次移动正确地组合起来(第一次 A、B 互换,第二次 B、C 互换……),任一步跟错,最终答案就错。这种组合推理对一个只用模仿学习、没有任何中间监督的策略来说很难。
4.1.5诊断研究:潜在转移能表示“交换”吗?(Diagnostic Study: Can Latent Transitions Represent “Swap”?)
原文
Problem. The scaling results show that broader demonstration coverage improves overall performance, yet swap-dependent state tracking remains difficult. At 10\times data, the non-swap Video/ButtonUnmask tasks reach 100%, while their swap counterparts reach 74% and 62% (Table 5). Our qualitative inspection also finds swap-related failures in VideoRepick. These results motivate a narrower question: is information needed to track swaps recoverable from the latent sequence under controlled conditions?
译文
问题。 数据扩展的结果表明,更广的示范覆盖提升了总体性能,但依赖交换的状态追踪仍然困难。在 10\times 数据下,不含交换的 Video/ButtonUnmask 任务达到 100%,而它们的交换版本只有 74% 和 62%(表 5)。我们的定性检查还在 VideoRepick 中发现了与交换相关的失败。这些结果引出一个更窄的问题:在受控条件下,追踪交换所需的信息能否从潜在序列中恢复?
解释
这一段把一个模糊的问题(“LTM 为什么做不好交换任务”)收窄成一个可检验的问题:信息是否在转移序列里。这个区分很重要,因为两种答案指向完全不同的改进方向——如果信息不在,需要换更好的编码器;如果信息在但没被用上,需要改训练方式(例如加中间监督)。“受控条件”指脱离机器人控制:不让策略去抓、去揭开杯子,只问“读完这串转移之后,你能不能说出球在哪”。这样排除了动作执行失败带来的干扰。
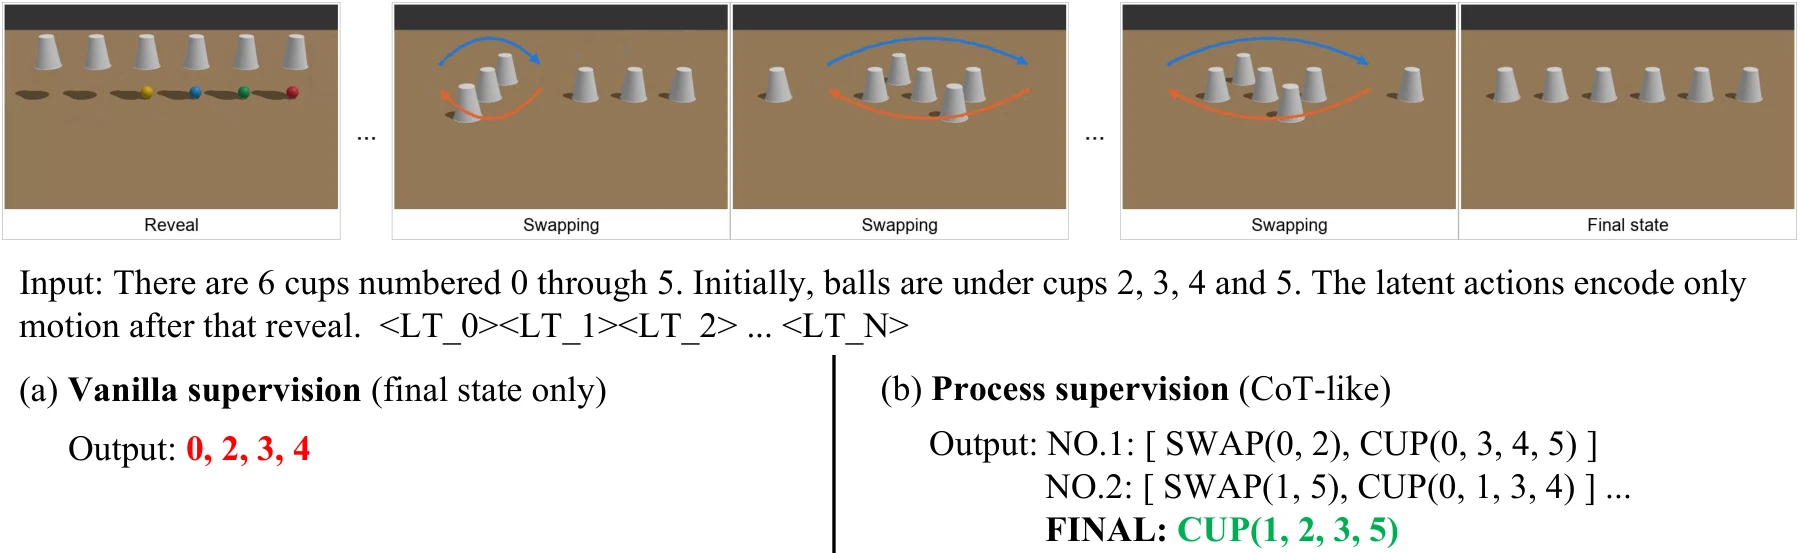
图 3:我们的 Cup Swap 诊断基准和两种监督方法。箭头仅为示意,实际数据集中没有。
<LT_i> 表示一个潜在转移;示意图中的潜在标签从 0 开始编号。原图注:Our Cup Swap diagnostic benchmark and two supervision methods. The arrows are for illustration only and are not included in the actual dataset.
<LT_i> denotes a latent transition; the illustration uses zero-indexed latent labels.图 3 解读
上排:一段视频的关键帧。第一帧“Reveal(揭示)”:六个杯子倒扣在桌上,杯子下方露出若干彩色小球,表示初始时哪些杯子下面有球。之后是多帧“Swapping(交换)”:每次两个杯子沿弧线互换位置(蓝色、橙色箭头只是示意交换路径,真实视频中没有)。最后一帧“Final state(最终状态)”:所有杯子静止,看不到球。中间:模型的输入。一句文字说明“有 6 个杯子,编号 0 到 5;初始时球在 2、3、4、5 号杯子下;潜在动作只编码揭示之后的运动”,后面接一串转移 token
<LT_0><LT_1>...<LT_N>。也就是说,初始状态直接用文字告诉模型,转移序列只负责描述交换过程。下排:两种监督方式。(a) Vanilla(只监督最终状态):模型直接输出最终哪些杯子下有球;图中的红色答案 “0, 2, 3, 4” 是错误示例。(b) Process supervision(类思维链的过程监督):模型逐次输出每一次交换及交换后的状态,例如第 1 次 SWAP(0,2)(0 号与 2 号位置交换),球从 2 号移到 0 号,状态变为 CUP(0,3,4,5);第 2 次 SWAP(1,5),5 号的球移到 1 号,状态变为 CUP(0,1,3,4);……最后输出绿色的正确答案 CUP(1,2,3,5)。我们按图中给出的两步验证过,状态更新是自洽的。这张图的要点是两种监督的“粒度”差异:(a) 只告诉模型最终答案,模型必须自己发现“要逐次跟踪交换”这一解题结构;(b) 把每一步中间状态都作为监督目标,相当于手把手教模型怎么推演。 原文
To test recoverability separately from robotic control, we construct the Cup Swap diagnostic shown in Figure 3. Each sequence contains six cups and one to five hidden balls, followed by 5–20 randomly generated cup swaps. The initial ball locations are provided explicitly, while only the post-reveal motion history is represented by latent transitions. We inject these transitions into a Qwen3-VL-2B backbone and compare two supervision schemes: Vanilla, which directly predicts the final cup occupancy without intermediate supervision, and Process supervision (CoT-like), which explicitly supervises swap tracking and the resulting intermediate/final state. The initial state is supplied as text, and this diagnostic uses a separate latent-fusion architecture rather than the LTM-\pi policy. Details are provided in Appendix A.
译文
为了把“可恢复性”与机器人控制分开检验,我们构造了图 3 所示的 Cup Swap 诊断任务。每段序列包含六个杯子和一到五个藏起来的球,随后是 5–20 次随机生成的杯子交换。初始的球位置被明确给出,只有揭示之后的运动历史用潜在转移表示。我们把这些转移注入一个 Qwen3-VL-2B 主干,并比较两种监督方案:Vanilla,不加中间监督,直接预测最终的杯子占用情况;过程监督(类思维链,CoT-like),显式监督对交换的追踪以及由此得到的中间和最终状态。初始状态以文本形式提供,并且这个诊断实验使用的是一个单独的潜变量融合架构,而不是 LTM-\pi 策略。细节见附录 A。
解释
任务难度。6 个杯子、1–5 个球,状态空间是 6 选 b 的组合(b=3 时有 20 种);每次交换随机选两个位置,5–20 次交换后最终状态接近随机。由于文字输入已经告诉了模型球的个数,随机猜一个合法状态的期望准确率在 5%(3 个球,20 种可能)到 16.7%(1 或 5 个球,6 种可能)之间,按球数均匀分布平均约 10%。所以 Vanilla 的 2.40% 不仅是“没学会”,甚至低于随机猜测;它在训练集上约 12.5% 的准确率也只在随机水平附近(附录 A)。为什么初始状态用文字给。如果让模型从揭示画面中自己看出球在哪,失败时就分不清是“没看清初始状态”还是“没跟住交换”。作者还特意只保留揭示帧之后的转移,避免“揭示”这个事件本身把初始状态泄露进转移序列(附录 A)。这样转移序列中唯一的信息就是交换过程。这个实验能证明什么、不能证明什么。它用的是 Qwen3-VL-2B + 专门设计的潜变量融合模块(附录 A:每 4 个转移合并为 1 个 token,再经 8 层自注意力和 8 层交叉注意力),不是 LTM-\pi 的 \pi_{0.5} 加 MLP 适配器;而且场景是合成的杯子视频,不是 RoboMME 的场景。所以它证明的是“同一族 LAM 编码器输出的转移序列中,交换信息原则上可以恢复”,并不能说明 LTM-\pi 内部是否用到了这些信息,也不能直接推广到 RoboMME 的交换任务。
原文
As shown in Table 6, the process-supervised model recognizes individual swaps with 99.78% accuracy and recovers final states with 97.93% accuracy using a frozen VLM backbone, while the final-state-only model reaches 2.40% best exact accuracy. These results demonstrate that latent transitions contain recoverable multi-step swap information and that structured intermediate supervision enables accurate temporal-state recovery in the diagnostic. The final-state-only model also has low training accuracy (approximately 12.5%; Appendix A), so optimization differences may contribute to the observed gap. The findings motivate process-guided temporal reasoning in future transition-memory control policies.
译文
如表 6 所示,在冻结 VLM 主干的情况下,过程监督模型识别单次交换的准确率为 99.78%,恢复最终状态的准确率为 97.93%,而只监督最终状态的模型最好的完全正确率只有 2.40%。这些结果证明,潜在转移包含可恢复的多步交换信息,而结构化的中间监督能够在该诊断任务中实现准确的时间状态恢复。只监督最终状态的模型在训练集上的准确率也很低(约 12.5%;附录 A),因此优化上的差异可能也是造成这一差距的原因之一。这些发现促使我们在未来的转移记忆控制策略中引入由过程引导的时间推理。
解释
99.78% 的单次交换识别率说明了什么。每一个转移序列片段都能被准确解读为“哪两个位置交换了”,说明 LAM 的转移码里确实编码了足够精确的运动信息(至少在这种干净的合成场景中)。最终状态 97.93% 略低于单次识别率,因为最多 20 次交换中任何一次出错都会导致最终状态错误:若每次独立出错率为 0.22%,20 次全对的概率约为 0.9978^{20}\approx95.7\%,与观测到的 97.93%(平均交换次数少于 20)量级一致。作者自己承认的混杂因素。Vanilla 模型在训练集上也只有约 12.5% 的准确率,说明它根本没“学进去”,而不是“学会了但泛化不好”。这意味着两者的差距不完全是“过程监督让模型学会了组合推理”,也可能是“只监督最终状态时,这个模型架构/优化设置训不动”。更公平的对照应当调整 Vanilla 的训练(更多步数、不同学习率)直到训练集拟合,再看测试表现,论文没有做。附录 A 还提到,在更简单的 3 杯 1 球 5 次交换任务上,不用过程监督的分类器也能达到 99.40%,说明“只监督最终状态”并非原则上不可行,而是在 6 杯多球、最多 20 次交换这种组合空间更大的设定下难以优化。对 LTM-\pi 的启示。LTM-\pi 的训练只有动作监督,相当于这里的“只监督最终结果”。作者由此推测,给控制策略加入类似的过程监督(例如要求它在行动前先输出“当前物体在哪”)可能解决交换任务,但这一推测在本文中没有被验证。
表 6:六杯、多球 Cup Swap 任务上的诊断结果(%)。最终状态准确率要求杯子占用情况完全正确。Vanilla 的数值是其报告的最佳检查点结果;其最终检查点为 1.75%。
| 监督方式 | 单次交换准确率 | 最终状态准确率 |
| Vanilla 监督(仅最终状态) | – | 2.40 |
| 过程监督(类思维链) | 99.78 | 97.93 |
原表注:Diagnostic results (%) on the six-cup, multi-ball Cup Swap task. Final-state accuracy requires exact cup occupancy. The Vanilla value is its best reported checkpoint result; its final checkpoint reaches 1.75%.
表 6 解读
两行两列。“单次交换准确率”只对过程监督有意义(Vanilla 不输出中间交换,所以记为“–”),衡量模型能否正确识别每一次交换涉及的两个位置;“最终状态准确率”要求 6 个杯子的有球/无球情况全部正确。Vanilla 的 2.40% 是训练过程中挑出的最好检查点,最后一个检查点只有 1.75%——挑最好的检查点对 Vanilla 已经是有利的处理,它仍然几乎完全失败。过程监督的 97.93% 则接近完美。两者相差约 95 个点,差距大到不需要统计检验;但如上文所述,这个差距中混有“Vanilla 训不动”的优化因素。测试集共 1,449 个样本(附录 A),97.93% 对应约 1,419 个正确。
4.1.6Token 压缩:转移记忆能否在固定预算下保持有效?(Token Compression: Can Transition Memory Remain Effective Under a Fixed Budget?)
原文
The diagnostic demonstrates that process-supervised decoding recovers multi-swap state from the latent-transition sequence. We now return to LTM-\pi control and ask whether a bounded context can retain enough information for effective manipulation. Although each transition occupies only one token, append-only execution memory still grows with episode duration. We evaluate DreamDojo-based LTM-\pi on RoboMME-10x with a quota of Q=200 execution-transition tokens and a fixed lag k=10, using the same quota and compression rule during training and inference. The quota applies to execution transitions only; language, current visual inputs, and any fixed demonstration context are outside this count.
译文
诊断实验表明,经过程监督的解码可以从潜在转移序列中恢复多次交换后的状态。现在我们回到 LTM-\pi 的控制问题,探究有界的上下文能否保留足够的信息来完成有效操作。虽然每个转移只占一个 token,只追加的执行记忆仍会随回合时长增长。我们在 RoboMME-10x 上评估基于 DreamDojo 的 LTM-\pi,执行转移 token 的配额为 Q=200,固定延迟 k=10,训练和推理使用相同的配额和压缩规则。配额只针对执行转移;语言、当前视觉输入以及任何固定的示范上下文都不计入。
解释
为什么要压缩。LTM 每个控制步追加一个 token,没有上限。下文表 7 显示,RoboMME-10x 中每次策略查询平均有 324 个、最多 1789 个执行转移 token。对更长的真实任务(几分钟到几十分钟),序列会长到无法承受。实验设置的几个要点。(1) 这组实验是在 10\times 数据、DreamDojo 编码器、k=10 上做的,对照是表 5 中 87.50% 的那一行。(2) 训练时也用同样的压缩规则,这样策略学会读“压缩过的记忆”,避免训练与推理分布不一致。(3) 配额 200 只限制本回合执行产生的转移,示范视频的转移(视频类任务)和锚点不受限,所以视频类任务的实际上下文会更长。这句话也说明了表 5 中 10\times 一行用的是 DreamDojo 编码器(表 8 的表注称“未压缩一行复用表 5 的 10\times 参考”),而表 5 中 1\times 一行是 CD-LAM 的数字。
原文
Online adjacent-token merging. Let \mathcal U=(u_1,\ldots,u_n) denote the ordered list of retained tokens in the projector output space. When a new eligible transition token m=P(\tilde z) arrives, we append it to \mathcal U. If the length exceeds Q, we select the most similar adjacent pair and replace it with its arithmetic mean:
j^*=\underset{1\leq j<n}{\arg\max}\;\operatorname{cos}(u_j,u_{j+1}), \qquad \bar u=\frac{u_{j^*}+u_{j^*+1}}{2}.
Here, n is the length after appending, and \operatorname{cos} is cosine similarity. The merged token occupies the earlier position and the later token is removed. We repeat this operation until the budget is satisfied (Algorithm 2). Restricting merges to adjacent tokens preserves the order of the remaining temporal segments, while similarity guides compression toward locally redundant representations. The rule operates after projection and before the policy backbone, without an additional learned compressor. During training, each eligible history prefix is constructed by replaying these updates in chronological order; inference applies the same updates as transitions become eligible under the lag. 译文
在线相邻 token 合并。 记 \mathcal U=(u_1,\ldots,u_n) 为投影器输出空间中保留下来的 token 的有序列表。当一个新的、已符合条件的转移 token m=P(\tilde z) 到来时,我们把它追加到 \mathcal U 末尾。如果长度超过 Q,我们选出最相似的一对相邻 token,并用它们的算术平均替换:
j^*=\underset{1\leq j<n}{\arg\max}\;\operatorname{cos}(u_j,u_{j+1}), \qquad \bar u=\frac{u_{j^*}+u_{j^*+1}}{2}.
其中 n 是追加后的长度,\operatorname{cos} 是余弦相似度。合并后的 token 占据较早的那个位置,较晚的 token 被删除。我们重复这一操作直到满足预算(算法 2)。把合并限制在相邻 token 之间,可以保持剩余时间片段的顺序,而相似度则引导压缩去处理局部冗余的表示。该规则作用于投影之后、策略主干之前,不需要额外学习一个压缩器。训练时,每个符合条件的历史前缀都按时间顺序重放这些更新来构造;推理时,随着转移在延迟规则下逐个符合条件,应用同样的更新。 解释
符号。u_j 是记忆中第 j 个 token(2048 维,已经过 MLP 投影,但还没进入 \pi_{0.5} 主干);\cos(u_j,u_{j+1})=\frac{u_j\cdot u_{j+1}}{\|u_j\|\|u_{j+1}\|} 衡量两个相邻 token 的方向有多接近,取值 -1 到 1;j^* 是最相似的那一对的位置;\bar u 是这对 token 的逐维平均。直觉。机器人在一段时间里做同样的事(例如匀速向前移动、静止等待)时,连续的转移 token 会很相似,把它们合成一个几乎不丢信息;而“夹爪闭合”“物体被放下”这类突变时刻,前后 token 差别大,不太可能被合并。所以这条规则的设想是:压掉“平稳段”、保留“事件边界”。只合并相邻 token,保证了记忆仍然是按时间排列的片段序列,不会把相隔很远的两个事件混在一起。例子。设 Q=3,当前记忆 (u_1,u_2,u_3),新来 m 后变成 4 个。若相邻相似度为 \cos(u_1,u_2)=0.2、\cos(u_2,u_3)=0.9、\cos(u_3,m)=0.5,则 j^*=2,把 u_2,u_3 替换为 (u_2+u_3)/2,记忆变为 (u_1,\bar u,m),长度回到 3。训练时怎么做。训练样本是随机抽取的时刻 t,它的记忆应当等于“从回合开始逐步追加并压缩到 \tau_t”的结果,因为压缩结果依赖于合并的先后顺序,不能直接对整段做一次性压缩。所以作者在构造每个训练样本时,按时间顺序重放这个过程。这保证了训练和推理看到的记忆完全一致。
原文
Algorithm 2 Online Adjacent-Token Compression
Require: Ordered projector-output tokens \mathcal U with |\mathcal U|\leq Q, new projected token m, quota Q\geq1
1: \mathcal U\gets\mathcal U\mathbin{\|}[m] ▷ append in temporal order
2:while |\mathcal U|>Q do
3:for j=1,\ldots,|\mathcal U|-1 do
4: s_j\gets\operatorname{cos}(u_j,u_{j+1})
5:end for
6: j^*\gets\arg\max_j s_j
7: u_{j^*}\gets(u_{j^*}+u_{j^*+1})/2
8: Delete u_{j^*+1} from \mathcal U
9:end while
10:
11:return \mathcal U
算法 2:在线相邻 token 压缩
Require: 投影器输出的有序 token 列表 \mathcal U(满足 |\mathcal U|\leq Q),新投影的 token m,配额 Q\geq1
1: \mathcal U\gets\mathcal U\mathbin{\|}[m] ▷ 按时间顺序追加
2:while |\mathcal U|>Q do
3:for j=1,\ldots,|\mathcal U|-1 do
4: s_j\gets\operatorname{cos}(u_j,u_{j+1})
5:end for
6: j^*\gets\arg\max_j s_j
7: u_{j^*}\gets(u_{j^*}+u_{j^*+1})/2
8: 从 \mathcal U 中删除 u_{j^*+1}
9:end while
10:
11:return \mathcal U
算法 2 解读
第 1 行把新 token 接在末尾(\| 表示列表拼接)。第 2–9 行:只要超出配额,就计算所有相邻对的余弦相似度(第 3–5 行),找最大的一对(第 6 行),把前一个替换成两者的平均(第 7 行)并删掉后一个(第 8 行)。因为输入时 |\mathcal U|\le Q,追加一个后最多超出 1,所以 while 循环实际上最多执行一次。复杂度。每次更新要扫一遍 Q 个相邻对,每对算一次 d 维余弦,开销 \mathcal O(Qd);Q=200、d=2048 时约 40 万次乘加,相对 3B 模型的一次前向可以忽略。实现上还可以缓存上一步的相似度,只更新受影响的两对,但论文给出的是直接扫描的版本。
原文
Each update preserves a representative of every temporal segment instead of discarding the oldest tokens. However, the merge is lossy: it removes an event boundary and replaces two vectors with one. Repeated merges use equal weights for the two current representatives, without tracking their constituent transition counts, so the result is generally not the uniform mean of all original transitions in a segment. For a stream that is already within budget, appending one token triggers at most one merge; a direct scan costs \mathcal O(Qd) per update for projector dimension d, and retained projected-token storage is \mathcal O(Qd).
译文
每次更新都为每个时间片段保留一个代表,而不是丢弃最旧的 token。不过合并是有损的:它去掉了一个事件边界,用一个向量替换了两个。反复合并时,对当前两个代表使用相等的权重,并不记录它们各自包含了多少个原始转移,因此结果一般不等于片段内所有原始转移的均匀平均。对于已经处在预算内的数据流,追加一个 token 最多触发一次合并;直接扫描的开销是每次更新 \mathcal O(Qd)(d 为投影器维度),保留的投影 token 所需存储为 \mathcal O(Qd)。
解释
与“滑动窗口”的区别。最简单的有界记忆是只保留最近 Q 个 token(先进先出)。那样最早的事件会被完全丢掉,而记忆任务恰恰常常依赖很早的事件(例如回合开始时物体在哪)。相邻合并保证“每一段时间都还有一个代表”,最早的片段不会消失,只是变得更粗糙。等权平均的副作用。举例:片段 A 已经由 8 个原始转移合并而成,片段 B 只有 1 个原始转移;如果 A 和 B 被合并,新 token 是 (A+B)/2,B 的权重与 A 中 8 个转移的总权重相同。结果是,刚刚合并进来的 token 会被“过度代表”,较老的片段被稀释。作者明确指出了这一点,并在本节末尾建议用“显式记录片段时长”的方式改进。另一个隐含的信息损失。合并后记忆的长度不再等于时间步数。表 3 显示“记忆长度携带的时间信息”本身很有用(Fixed Random LT 有 44.50%),而压缩恰恰破坏了这一线索:回合进行到第 300 步和第 1000 步时,记忆都是 200 个 token。这可能是计数类任务(如 StopCube)在压缩后掉点的原因之一,原文对此没有讨论。
表 7:每次查询的执行转移 token 数(k=10)。未压缩的数值是实测的;压缩后的数量按 \min(N,200) 计算。压缩后的均值是一个上界。
| 统计量 | 未压缩 | 压缩后 (Q=200) |
| 均值 | 323.93 | \leq200 |
| 中位数 | 265 | 200 |
| P90 | 747 | 200 |
| P95 | 893 | 200 |
| 最大值 | 1,789 | 200 |
| 超过 200 的查询(%) | 61.98 | 0.00 |
原表注:Execution-transition tokens per query (k=10). Uncompressed values are measured; compressed counts follow \min(N,200). The compressed mean is an upper bound.
表 7 解读
统计对象是训练数据中的策略查询(即训练样本所对应的决策时刻),每次查询的记忆中有多少个执行转移 token。左列是不压缩时的实测值,右列是压缩后的值:压缩规则保证 token 数恰好是 \min(N,200),所以中位数、P90、P95、最大值都变成 200,超过 200 的比例变为 0。几个数字的含义:中位数 265 小于均值 323.93,说明分布右偏,少数很长的回合把均值拉高;P90 = 747 表示 10% 的查询记忆长度超过 747;最长达 1,789(按 k=10 推算,对应回合已进行约 1,800 步)。61.98% 的查询超过 200,说明配额 200 对大多数决策都会触发压缩,并非只影响极少数长回合。压缩后的均值写成“\le200”是因为作者没有统计完整分布:本来不足 200 的那 38% 查询保持原值,所以真实均值严格小于 200。
原文
Token budget. We profile uncompressed execution memory at policy queries under the execution-only, fixed-k=10 training convention. The mean is 323.93 transition tokens/query, the median is 265, and the P90/P95 values are 747/893; the maximum is 1,789. In total, 61.98% of queries exceed 200 tokens. After applying the rule, a prefix containing N eligible transitions has exactly \min(N,Q) retained tokens. Table 7 gives the resulting bounds for the same query population. The compressed mean is at most 200, implying a reduction of at least 1-200/323.93=38.26\% in mean execution-memory length; its exact value requires the full count distribution. At the uncompressed P95 and maximum, the counts fall from 893 and 1,789 to 200, reductions of 77.60% and 88.82%, respectively. These are token-count reductions, rather than measured inference speedups.
译文
Token 预算。 我们按“只计执行转移、固定 k=10”的训练约定,统计了策略查询时未压缩的执行记忆。均值为每次查询 323.93 个转移 token,中位数为 265,P90/P95 分别为 747/893,最大值为 1,789。总计有 61.98% 的查询超过 200 个 token。应用压缩规则后,含有 N 个符合条件转移的前缀恰好保留 \min(N,Q) 个 token。表 7 给出了同一批查询在压缩后的界。压缩后的均值至多为 200,意味着平均执行记忆长度至少减少 1-200/323.93=38.26\%;其精确值需要完整的数量分布才能算出。在未压缩的 P95 和最大值处,token 数分别从 893 和 1,789 降到 200,减少了 77.60% 和 88.82%。这些是 token 数量的减少,而不是实测的推理加速。
解释
数字核对。1-200/323.93=0.3826,1-200/893=0.7760,1-200/1789=0.8882,与原文一致。为什么不直接给出压缩后的均值。作者只记录了未压缩分布的几个分位数,没有保存每个查询的具体长度,所以只能给下界。其实只要有完整分布,\mathbb E[\min(N,200)] 很容易算出——这是一个可以轻松补全的遗漏。“不是推理加速”的提醒很重要。token 数减少不等于时间减少,原因有二:一是每次决策的主要计算量来自约 256 个当前图像 token 和策略本身,记忆只占一部分;二是压缩会使 KV 缓存失效(见本节最后一段),需要重算前缀,可能反而增加计算。论文没有报告压缩前后的实测延迟。
原文
Manipulation results. Table 8 compares the compressed model with the uncompressed RoboMME-10x reference from Table 5. Compression achieves 672 successes over 800 rollouts, or 84.00% average success, compared with 87.50% without compression. This is a decrease of 3.50 percentage points, retaining 96.00% of the reference success rate. Counting, Permanence, Reference, and Imitation average 91.50%, 80.00%, 74.00%, and 90.50%, respectively, versus 95.00%, 84.00%, 76.00%, and 95.00% without compression.
译文
操作结果。 表 8 把压缩模型与表 5 中未压缩的 RoboMME-10x 参考结果进行比较。压缩模型在 800 次 rollout 中成功 672 次,平均成功率 84.00%,不压缩时为 87.50%。这一下降为 3.50 个百分点,保留了参考成功率的 96.00%。Counting、Permanence、Reference 和 Imitation 的平均分别为 91.50%、80.00%、74.00% 和 90.50%,不压缩时分别为 95.00%、84.00%、76.00% 和 95.00%。
解释
数字核对。16 个任务 \times 50 次 = 800 次,672/800=84.00\%;84.00/87.50=0.96;四个赛道的平均我们由表 8 复算,全部一致。3.5 个点是否显著。800 次 rollout 下,84% 附近的标准误约为 \sqrt{0.84\times0.16/800}\approx1.3 个百分点;两个模型的差 3.5 个点约为差值标准误(约 1.75 个点)的 2 倍,处在勉强显著的边缘。考虑到压缩模型只有一个种子、训练过程本身的随机性也没计入,比较稳妥的结论是“压缩带来了小幅但可能真实的下降”。
表 8:基于 DreamDojo 的 LTM-\pi 在 RoboMME-10x 上有无执行 token 压缩的对比(成功率,%)。未压缩一行复用表 5 中的 10\times 参考结果;压缩模型在训练和推理中都使用 Q=200,每个任务评估 50 次 rollout。\Delta 为压缩减去未压缩的成功率,单位为百分点。任务缩写同表 1。
| 记忆 | Counting | Permanence | Reference | Imitation | 平均 | ||||||||||||
| BF | PX | SX | SC | VU | BU | VUS | BUS | PH | VR | VPB | VPO | MC | IP | PL | RS | ||
| 未压缩 | 80.00 | 100.00 | 100.00 | 100.00 | 100.00 | 100.00 | 74.00 | 62.00 | 70.00 | 66.00 | 84.00 | 84.00 | 96.00 | 88.00 | 98.00 | 98.00 | 87.50 |
| 压缩(Q=200) | 84.00 | 100.00 | 100.00 | 82.00 | 100.00 | 100.00 | 62.00 | 58.00 | 74.00 | 56.00 | 86.00 | 80.00 | 94.00 | 76.00 | 96.00 | 96.00 | 84.00 |
| \Delta(百分点) | +4.00 | 0.00 | 0.00 | -18.00 | 0.00 | 0.00 | -12.00 | -4.00 | +4.00 | -10.00 | +2.00 | -4.00 | -2.00 | -12.00 | -2.00 | -2.00 | -3.50 |
原表注:DreamDojo-based LTM-\pi on RoboMME-10x with and without execution-token compression (success rate, %). The uncompressed row reproduces the 10\times reference in Table 5; the compressed model uses Q=200 during training and inference and is evaluated over 50 rollouts per task. \Delta is compressed minus uncompressed success in percentage points. Task abbreviations follow Table 1.
表 8 解读
三行:未压缩(即表 5 中 LTM 10\times 一行)、压缩(Q=200,绿色底)、两者之差 \Delta。逐列看 \Delta。持平(0):PX、SX、VU、BU——这四个任务在两种设置下都是 100%。下降最多:StopCube -18、VideoUnmaskSwap -12、InsertPeg -12、VideoRepick -10。小幅上升:BinFill +4、PickHighlight +4、VideoPlaceButton +2。其余都在 \pm4 以内。能读出的规律。(1) StopCube 掉得最多。这个任务要数清方块第几次到达并精确把握按下时机;合并会抹平“每一次到达”这样的周期性事件,也会让记忆长度不再反映经过的时间,两方面都伤害计数和时机。(2) 交换任务 VUS 掉 12 个点,BUS 掉 4 个点,而对应的非交换任务保持 100%:交换的关键信息就藏在一两次快速移动里,若被与相邻的平稳段合并,交换的方向和对象就模糊了。(3) InsertPeg 掉 12 个点,可能与需要复现示范中的精细运动有关。注意:单任务每格只有 50 次,\pm4 以内的变化完全可能是噪声,-10 到 -18 才比较可信。
原文
PickXtimes, SwingXtimes, VideoUnmask, and ButtonUnmask remain at 100%, indicating that a bounded context can support these tasks despite substantial compression. The largest decreases occur on StopCube (-18 points), VideoUnmaskSwap and InsertPeg (-12 each), and VideoRepick (-10). This pattern is consistent with sensitivity to precise temporal boundaries or interaction details that averaging may weaken. In particular, the two swap tasks decline while their non-swap counterparts remain saturated. Cosine similarity measures representation similarity, rather than task relevance, so a locally similar pair can still contain an important state change. BinFill and PickHighlight improve by 4 points and VideoPlaceButton by 2, although single-seed evaluation does not resolve these smaller differences. Overall, a 200-token budget retains 96.00% of the uncompressed success rate. Together with the swap diagnostic, they motivate preserving informative event boundaries through event-aware merging or explicit segment-duration information.
译文
PickXtimes、SwingXtimes、VideoUnmask 和 ButtonUnmask 保持在 100%,说明尽管压缩幅度很大,有界的上下文仍能支撑这些任务。降幅最大的是 StopCube(-18 个点)、VideoUnmaskSwap 和 InsertPeg(各 -12)以及 VideoRepick(-10)。这一模式符合“对精确的时间边界或交互细节敏感、而取平均会削弱这些信息”的解释。特别是,两个交换任务都下降了,而它们的非交换对应任务仍保持饱和。余弦相似度衡量的是表示上的相似,而不是与任务的相关性,因此一对局部相似的 token 仍可能包含重要的状态变化。BinFill 和 PickHighlight 提升了 4 个点,VideoPlaceButton 提升了 2 个点,不过单种子评估无法分辨这些较小的差异。总体而言,200 个 token 的预算保留了未压缩成功率的 96.00%。结合交换诊断实验,这些结果促使我们通过事件感知的合并或显式的片段时长信息来保留有信息量的事件边界。
解释
“表示相似”不等于“任务无关”。这是对余弦合并规则最关键的批评,作者自己提了出来。举例:机械臂在两个杯子上方平移、然后交换它们,在 LAM 的 32 维空间里可能与“单纯平移”差别不大,投影后余弦相似度很高,于是被合并;但对任务来说,这恰恰是最关键的一步。理想的合并规则应当根据“这段变化对后续决策重不重要”来决定,而这需要任务相关的信号(例如注意力权重、或学一个打分器)。提出的两个改进方向。(1) 事件感知的合并:先检测事件边界(夹爪开合、接触变化、速度突变),禁止跨越边界合并。(2) 显式记录片段时长:给每个合并后的 token 附带“它代表了多少个原始转移”,既修正等权平均的偏差,也把被压缩掉的时间信息还给模型。这两点都是本文没有实现的未来工作。
原文
Compatibility with KV caching. The fixed token budget bounds execution-memory length independently of episode duration, making persistent KV caching less critical for computational efficiency. Although merging modifies existing prefix tokens and invalidates subsequent cached entries under causal attention, the bounded context allows these entries to be recomputed at a limited cost. Therefore, our compression strategy prioritizes bounded memory and context length over KV-cache reuse, which remains an optional optimization rather than a necessity.
译文
与 KV 缓存的兼容性。 固定的 token 预算使执行记忆的长度与回合时长无关,从而降低了持久 KV 缓存对计算效率的重要性。虽然合并会修改已有的前缀 token,并在因果注意力下使其后的缓存项失效,但有界的上下文使这些缓存项能以有限的开销重新计算。因此,我们的压缩策略优先保证记忆和上下文长度有界,而不是 KV 缓存的复用;后者仍是一个可选的优化,而不是必需品。
解释
这一段坦承了压缩与 §3.2 缓存设计之间的冲突。在因果注意力下,第 j 个 token 的 KV 依赖于第 1..j 个 token;一旦第 j^* 个 token 被替换,第 j^* 个及其后所有 token 的 KV 都必须重算。由于合并的位置 j^* 可能在记忆的任何地方(最相似的一对可能在很早的位置),最坏情况下每一步都要重算几乎整个 200 个 token 的前缀。作者的论点是:既然记忆被限制在 200 个,重算 200 个 token 的代价是有上界的、可以接受的,所以缓存不再必要。这在逻辑上成立,但等于说“压缩版本放弃了 §3.2 中强调的增量推理优势”。两种设计各有适用场景:短回合用只追加 + 缓存,长回合用压缩 + 重算。本文没有给出两者的实测延迟对比。
4.2真实世界评估(Real-World Evaluation)
4.2.1实验设置(Settings)
原文
Platform. We use the Galbot G1 humanoid robot as the physical platform for real-world evaluation. During all experiments, only the two arms and grippers are actuated, while the remaining joints and body components are kept fixed.
译文
平台。 我们使用 Galbot G1 人形机器人作为真实世界评估的实体平台。在所有实验中,只驱动两条手臂和夹爪,其余关节和身体部件保持固定。
解释
Galbot G1 是银河通用(Galbot)的轮式双臂人形机器人。这里把它当作一台固定底座的双臂机器人使用:腰、头、底盘都不动,只控制双臂和两个夹爪,降低了任务的控制难度,使实验集中在“记忆”这一变量上。
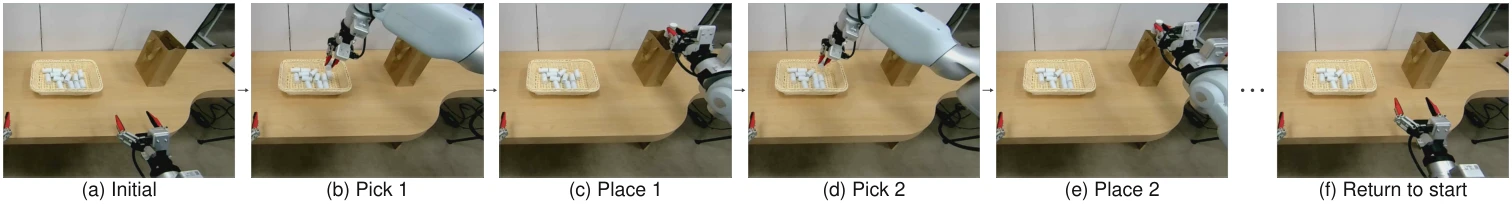
图 4:真实世界实验的任务与环境。
原图注:Task and environment for real-world experiments.
图 4 解读
六张关键帧展示一次 x=2 的试验:(a) 初始状态:桌上一个装有多个白色小物体的源箱,右侧立着一个牛皮纸包装袋,机械臂位于起始姿态;(b) 抓第 1 个物体;(c) 放入袋中;(d) 抓第 2 个;(e) 放入第 2 个;省略号之后 (f) 回到起始位置。这个任务对记忆的需求很明确:物体放进纸袋后就看不见了,而源箱里还剩很多外观相同的物体,从画面上无法判断已经放了几个。机器人只能靠记住“已经完成了几次抓放”来决定是继续还是收手。成功判定还要求机器人回到初始位姿并保持静止 10 秒,所以“放够了还继续抓”和“放够了却不停下”都算失败。
原文
Task and Data. We consider a pick-and-place x times task shown in Figure 4, where the robot is required to sequentially pick up x objects and place them into a packaging bag. We collect teleoperated demonstrations for x\in\{1,2,3,4\}, with 50 trajectories for each setting, resulting in 200 trajectories in total. The dataset contains 222,834 frames recorded at 30 FPS, corresponding to 2.06 hours of real-world data.
译文
任务与数据。 我们考虑图 4 所示的“抓放 x 次”任务:机器人需要依次抓起 x 个物体,放入一个包装袋中。我们为 x\in\{1,2,3,4\} 采集遥操作示范,每种设置 50 条轨迹,共 200 条。数据集包含以 30 FPS 记录的 222,834 帧,相当于 2.06 小时的真实世界数据。
解释
数字核对。222{,}834/30/3600\approx2.06 小时,一致;平均每条轨迹约 1,114 帧,约 37 秒。任务设计。四种 x 共用一个场景,只靠语言指令中的数字区分。这正好对应引言中“相似的场景需要不同的动作”:在放完第 2 个物体时,x=2 应该收手,x=3,4 应该继续,而画面几乎一样。每种 x 50 条示范,规模不大,但足以训练一个在 \pi_{0.5} 基础上微调的策略。
原文
Implementation Details. We run inference on a single RTX 4090 GPU. The robot is controlled with a control interval of \Delta t=0.05\,\mathrm{s} per step. For real-world evaluation, we do not use anchor frames. A trial is considered successful only if the robot transfers exactly the instructed number of objects, returns to its initial pose, and remains stationary for at least 10 s.
译文
实现细节。 我们在一块 RTX 4090 GPU 上运行推理。机器人的控制间隔为每步 \Delta t=0.05\,\mathrm{s}。真实世界评估中我们不使用锚帧。只有当机器人恰好转移了指令要求数量的物体、回到初始位姿、并保持静止至少 10 s 时,一次试验才算成功。
解释
控制频率与记忆长度。0.05 s 一步即 20 Hz。录制是 30 FPS,控制是 20 Hz,原文没有说明训练时如何对齐两者(例如是否降采样到 20 Hz 再计算转移)。按 20 Hz、一条轨迹约 37 秒估算,一个回合约有 700–800 个控制步,也就意味着约 700–800 个记忆 token——这在没有压缩的情况下已经是一段不短的上下文。不用锚帧。这个任务不涉及示范视频,也没有“初始时物体藏在哪”的问题,只需要计数,所以锚帧没有用处。这与表 3 中 Counting 任务对锚帧不敏感的结果一致。严格的成功标准。“恰好 x 个 + 回到原位 + 静止 10 秒”三个条件缺一不可,其中“静止 10 秒”专门用来检验策略是否真的“知道任务已经完成”,而不是恰好在某个时刻停顿了一下。
4.2.2结果(Results)
表 9:真实世界中抓放 x 个物体的成功率(%,\uparrow)。“平均”是四个目标数量上的不加权平均。
| 方法 | x=1 | x=2 | x=3 | x=4 | 平均 |
| \pi_{0.5}(无记忆) | 5.0 | 20.0 | 20.0 | 0.0 | 11.25 |
| LTM-\pi(本文) | 95.0 | 90.0 | 70.0 | 75.0 | 82.50 |
原表注:Real-world success rate (%, \uparrow) for picking and placing x objects. Avg. is the unweighted mean across the four target quantities.
表 9 解读
两行两种策略,四列四个目标数量,最后一列为四者的简单平均:(5+20+20+0)/4=11.25,(95+90+70+75)/4=82.50,均与表中一致。按附录表 10,LTM-\pi 每个 x 做 20 次试验;\pi_{0.5} 在 x=1,2 时做 20 次,在 x=3,4 时只做了 10 次(原因见附录概览)。所以 \pi_{0.5} 的 20%(x=3)是 2/10,统计上很不稳定。LTM 的 70%、75% 对应 14/20、15/20,二项分布的 95% 置信区间大约是 \pm20 个点。尽管如此,两者在每个 x 上的差距都足够大(x=1:19/20 对 1/20),总体结论是可靠的。一个值得注意的趋势:LTM 在 x=1,2 上接近完美,x=3,4 下降到 70–75%。目标数越大,回合越长、需要记住的事件越多,这与仿真中“计数越多越难”的规律一致。
原文
Table 9 shows that LTM-\pi improves success rate across all four target quantities, achieving a success rate of 82.50% compared with 11.25% for the memory-free \pi_{0.5}, a gain of 71.25 percentage points. Qualitatively, the memory-free policy tends to continue picking until approximately N objects remain in the source box, where N is the mean remaining-object count observed during data collection, suggesting reliance on a familiar scene configuration rather than tracking completed transfers. By retaining interaction history, LTM-\pi more reliably executes the requested number of transfers and stops accordingly. Per-trial transferred-object counts and a link to representative real-robot videos are provided in Appendix B.
译文
表 9 显示,LTM-\pi 在全部四个目标数量上都提高了成功率,总体成功率达到 82.50%,而无记忆的 \pi_{0.5} 为 11.25%,提升了 71.25 个百分点。从定性上看,无记忆策略倾向于一直抓取,直到源箱中大约剩下 N 个物体为止,其中 N 是数据采集期间观察到的平均剩余物体数,这表明它依赖的是熟悉的场景外观,而不是追踪已完成的转移次数。LTM-\pi 通过保留交互历史,更可靠地执行了所要求的转移次数并随之停下。每次试验的转移物体数量以及代表性真机视频的链接见附录 B。
解释
无记忆策略的“捷径”。这是本节最有意思的观察。没有记忆的 \pi_{0.5} 无法知道自己放了几个,于是学到了一个统计捷径:示范数据里,机器人停下时源箱里通常还剩大约 N 个物体(四种 x 平均下来的剩余量),所以它就“抓到源箱看起来像那样为止”。这个捷径与指令中的数字 x 无关,因此对所有 x 都会抓差不多数量的物体。附录表 10 印证了这一点:\pi_{0.5} 在 x=1,2,3,4 时平均实际放入 2.8、2.6、4.4、6.6 个——前两种基本相同,都偏多;后两种更多,原因可能是某些试验中源箱初始物体数更多,或者策略停不下来(附录提到 x=3,4 时它多次停不下来)。LTM 的失败模式不同。根据表 10,LTM 在 x=3 时 6 次失败中有 4 次多放(4 个)、2 次少放(2 个);x=4 时 5 次失败全部是少放(3 个)。它的错误集中在“差一个”,说明它确实在计数,只是偶尔数错或提前停止,而不是像 \pi_{0.5} 那样根本不看指令中的数字。
原文
Additional Findings. We also observe shorter motion-onset delays for LTM-\pi than for the memory-free policy in trials with long static segments at the start of demonstrations. This qualitative pattern is consistent with temporal-progress cues from the memory sequence; onset latency was not measured separately.
译文
其他发现。 在示范开头有较长静止段的试验中,我们还观察到 LTM-\pi 开始运动的延迟比无记忆策略更短。这一定性现象与记忆序列提供时间进度线索的解释相符;起动延迟没有单独测量。
解释
为什么无记忆策略会“发呆”。遥操作示范的开头常常有一段机器人静止不动的时间(操作员还没开始操作)。无记忆策略看到静止的初始画面时,无法区分“这是开头静止段的第 1 帧还是第 50 帧”,而示范中这两种情况都对应“继续保持静止”,于是它可能在起点停留很久。LTM 的记忆长度随时间增长(即使静止时的转移内容接近零,token 个数也在增加),策略就能知道“已经等了一段时间,该动了”。这与表 3 中固定随机转移仍有用的发现是同一个机制:记忆的长度本身就是一个时钟。作者对这个发现的表述很克制(“定性”“未单独测量”),读者也应当把它当作观察而非结论。
5局限性(Limitation)
原文
Our method relies on a pretrained latent action model (LAM) to provide transition representations, making memory quality dependent on the information preserved by the encoder. While latent transitions effectively capture local interaction dynamics, they may not adequately represent substantial changes in scene content, such as the appearance of new objects, where visual appearance and semantic information become important. Although sparse visual anchors provide complementary information, they may not fully address this limitation. A promising direction is to combine latent transition memory with visual memory, exploring how to effectively integrate dynamic changes and visual context for more robust long-horizon manipulation.
译文
我们的方法依赖一个预训练的潜在动作模型(LAM)来提供转移表征,因此记忆的质量取决于编码器保留了多少信息。虽然潜在转移能有效捕捉局部的交互动态,但它们可能无法充分表示场景内容的大幅变化,例如新物体的出现——此时视觉外观和语义信息变得很重要。稀疏的视觉锚点虽然提供了互补信息,但可能无法完全解决这一局限。一个有前景的方向是把潜在转移记忆与视觉记忆结合起来,探索如何有效整合动态变化与视觉上下文,以实现更稳健的长时程操作。
解释
为什么“新物体出现”难以表示。LAM 的码只有 32 维,训练目标是“在前一帧基础上重建后一帧”。若后一帧中凭空多出一个物体(例如从画面外拿进来、或揭开盖子露出下面的东西),解码器需要从 32 维码里“画”出这个物体的完整外观,这远超码的容量;LAM 训练时也会倾向于把这类罕见的大变化当作重建误差忍受掉。于是转移码可能只记录“某处发生了一个大变化”,而记不住“出现的是什么”。这正对应 Reference 赛道(需要识别具体物体)的弱点。本文没有列出的其他局限(译者补充):(1) 记忆长度随时间线性增长,只追加版本在长任务中不可持续,而压缩版本又牺牲了缓存和部分精度;(2) 训练只有动作监督,§4.1.5 表明多步组合可能需要中间监督;(3) 实验以仿真为主,真机只有一个计数任务;(4) LAM 编码器冻结,无法针对下游任务调整“记什么”;(5) 两个编码器之间的差异在单任务上很大(表 1、表 2),但论文没有分析原因。
6结论(Conclusion)
原文
We introduced Latent Transition Memory, which retains observed interactions as an ordered sequence of compact transition tokens. LTM-\pi combines frozen latent action encoders with a lightweight adapter and cache-compatible causal attention, learning from action demonstrations without memory-specific semantic annotations or an external reasoning model during control. With DreamDojo transitions, it reaches 58.54% success on RoboMME and 80.5% on LIBERO-Mem at the original data scale. Ablations support the value of observation-dependent transition content beyond temporal-progress cues, with sparse visual anchors providing complementary grounding. Delayed memory admission also reduces estimated encoder blocking while largely preserving success.
译文
我们提出了潜在转移记忆(LTM),它把观测到的交互保存为一个由紧凑转移 token 组成的有序序列。LTM-\pi 把冻结的潜在动作编码器、轻量级适配器和与缓存兼容的因果注意力结合在一起,从动作示范中学习,不需要记忆语义标注,控制时也不需要外部推理模型。使用 DreamDojo 转移表示时,它在原始数据规模下于 RoboMME 上达到 58.54% 的成功率,于 LIBERO-Mem 上达到 80.5%。消融实验支持了依赖观测的转移内容在时间进度线索之外的价值,稀疏视觉锚点则提供了互补的参照。延迟写入记忆还在基本保持成功率的同时减少了估计的编码器阻塞。
解释
结论第一段概括方法和主结果,与摘要一致。值得记住的是三个“去掉什么、剩多少”的对照数字:去掉记忆(\pi_{0.5})17.93%,只保留记忆长度(Fixed Random LT)44.50%,完整模型 57.67%(均为 CD-LAM 版,表 1、表 3)。“转移内容在时间线索之外的价值”指的就是 44.50 到 57.67 这一段。
原文
We then examined the effect of demonstration scaling. Increasing RoboMME data tenfold and training from 40K to 120K steps raises success from 57.67% to 87.50%, with gains across all four tracks and the largest improvement on Reference. Extending training on the original data to 120K steps yields no appreciable gain, indicating that the improvement is not explained by longer training alone. These results support the benefit of broader demonstration coverage for learning to use compact transition memory.
译文
随后我们考察了示范数据扩展的影响。把 RoboMME 数据扩大十倍、训练从 40K 步增加到 120K 步,成功率从 57.67% 提升到 87.50%,四个赛道全部提升,其中 Reference 提升最大。在原始数据上把训练延长到 120K 步没有带来明显提升,说明这一改进不能仅由更长的训练来解释。这些结果支持了“更广的示范覆盖有助于学会使用紧凑转移记忆”。
解释
这里再次出现了 57.67%(CD-LAM,1\times,k=5)与 87.50%(DreamDojo,10\times,k=10)的对比;如 §4.1.4 解释框所述,两者之间同时变化了数据、步数、延迟和编码器,“原数据 120K 步”的对照数字也未给出。结论方向可信,具体增益的归因需要打折扣。
原文
Swap-dependent state tracking remains challenging after data scaling. The Cup Swap diagnostic shows that process-supervised decoding recovers final states from latent transitions with 97.93% accuracy, compared with 2.40% under final-state-only supervision. This demonstrates the recoverability of complex interaction information from transition memory and highlights intermediate supervision as a promising direction for temporal composition.
译文
数据扩展之后,依赖交换的状态追踪仍然具有挑战性。Cup Swap 诊断实验表明,经过程监督的解码能以 97.93% 的准确率从潜在转移中恢复最终状态,而只监督最终状态时只有 2.40%。这证明了复杂交互信息可以从转移记忆中恢复,也凸显了中间监督是解决时间组合问题的一个有前景的方向。
解释
“可恢复”是准确的措辞:诊断实验证明信息在转移序列里,但用的是另一个模型(Qwen3-VL-2B + 专门的融合模块),而且 Vanilla 基线连训练集都拟合不了。所以它支持“给控制策略加中间监督可能有帮助”这一假设,但没有在 LTM-\pi 上验证。
原文
We next addressed execution-memory growth. Merging similar adjacent projected tokens with the same rule during training and inference caps execution memory at 200 tokens. This retains 84.00% success on RoboMME-10x versus 87.50% without compression, a decrease of 3.50 percentage points, while reducing mean transition-token count by at least 38.26% on profiled training queries. These results demonstrate a trade-off between bounded context and manipulation performance. Cache refresh costs must also be considered when translating token-count reductions into runtime gains.
译文
接着我们处理了执行记忆的增长问题。在训练和推理中用同一规则合并相似的相邻投影 token,可把执行记忆限制在 200 个 token 以内。这在 RoboMME-10x 上保持了 84.00% 的成功率(不压缩时为 87.50%,下降 3.50 个百分点),同时在统计过的训练查询上把平均转移 token 数减少了至少 38.26%。这些结果展示了有界上下文与操作性能之间的权衡。在把 token 数的减少转化为运行时收益时,还必须考虑缓存刷新的开销。
解释
最后一句是对 §4.1.6 “与 KV 缓存的兼容性”一段的回应:压缩后 token 少了,但每次合并都可能使缓存失效、需要重算,所以“token 少 38%”并不等于“快 38%”。论文没有测量压缩前后的实际延迟。
原文
Finally, real-world experiments on a repeated pick-and-place counting task improve average success from 11.25% with memory-free \pi_{0.5} to 82.50% with LTM-\pi. Together, these results establish compact latent transitions as an effective form of episodic memory for the evaluated history-dependent manipulation tasks. Improving temporal composition and preserving informative event boundaries are promising directions for further development.
译文
最后,在一个重复抓放的计数任务上,真实世界实验把平均成功率从无记忆 \pi_{0.5} 的 11.25% 提升到 LTM-\pi 的 82.50%。这些结果共同确立了紧凑的潜在转移是一种有效的情景记忆形式,适用于所评估的依赖历史的操作任务。改进时间组合能力、保留有信息量的事件边界,是进一步发展的有前景的方向。
解释
作者在总结时加了限定语“所评估的”任务,措辞恰当。两个未来方向分别对应两处暴露的问题:“时间组合”对应交换任务(§4.1.4、§4.1.5),“事件边界”对应压缩规则把关键时刻合并掉(§4.1.6)。整体评价(译者观点):本文的核心贡献是把“记什么”这个问题明确提出来,并用一个简单、工程上干净的方案(冻结 LAM + MLP + 因果前缀 + 延迟)给出了有竞争力的答案。最有价值的实验是 Fixed Random LT 对照,它诚实地揭示了“记忆长度即时钟”这一强混杂因素;最需要补强的是数据扩展实验的控制变量,以及在控制策略本身上验证过程监督。
附录概览(Appendix Overview)
解释
说明。按本工作区的约定,附录不逐段对照翻译,下面用中文概述原文附录 A、B 的内容,并贴出表 10 加以解读。原文附录很短,只有两节(原文第 18–19 页),下面的概述基本覆盖了其中所有的数字信息。原文附录没有重置图表计数器,表 10 的编号与原文一致。
附录 A:Cup Swap 诊断实验细节
任务与数据。作者合成了一个“杯子藏球”视频数据集,用于把“运动记忆和时间状态追踪”与机器人控制分离开来。每段视频有 6 个杯子和 1–5 个球,初始时各球位于不同的杯子下;第 42 帧揭示初始配置,此后进行 5–20 次随机交换,视频为 30 FPS。数据集共 14,000 段视频,用固定随机种子 42 划分为训练 11,176、验证 1,375、测试 1,449 段(合计正好 14,000)。任务目标是在组合完整个交换序列后,恢复最终的球位置。潜在转移的提取。使用与 LTM-\pi 相同族的冻结编码器(原文没有说明具体是 DreamDojo 还是 CD-LAM),以步长 1 把每对相邻帧编码为 32 维转移。为了防止“揭示”事件本身把初始状态泄露到运动表征里,只保留源帧编号 \ge r=42 的转移,即 \operatorname{src}(z_i)\ge r;揭示转移本身被排除,初始占用情况另以文本提供(reveal_mode=text)。这一设计保证转移序列只包含交换信息,使诊断结论更干净。输入与潜在记忆融合。主干是 Qwen3-VL-2B-Instruct。每 4 个连续的转移被压缩为 1 个记忆 token,并直接投影到 Qwen 的隐藏维度;加上正弦时间嵌入后,先经过 8 层潜变量自注意力(16 头),再让语言状态通过 8 层交叉注意力(16 头)读取潜在记忆;注意力 dropout 为 0,训练使用 bfloat16 和梯度检查点。这里需要强调:这个架构与 LTM-\pi 有三点重要差别——(1) 4 合 1 的时间压缩,(2) 专门的 8+8 层注意力模块,而不是 MLP 直接拼进前缀,(3) Qwen 主干被冻结(见下)。因此正文中“转移序列包含可恢复的交换信息”这一结论,严格来说是在一个容量更大、专门为读取潜在序列设计的模块下得到的。两种监督。Vanilla(只监督最终状态)用一个杯子占用分类目标,直接预测 6 个杯子中各自有没有球,不对交换序列或中间状态做任何监督。过程监督(类思维链)用一个“过程查询追踪”目标,在预测最终状态之前,先监督模型恢复交换过程和不断演变的状态。它并不生成自然语言的思维链,但显式监督了中间推理,因此作者称其“在功能上类似思维链”。训练配置。过程监督的版本在 8 块 H100 80GB 上训练,每卡批大小 4(全局 32);主学习率 1\times10^{-4},分类头学习率 3\times10^{-4},权重衰减 1\times10^{-2},梯度裁剪 1.0;Qwen 主干冻结。原文没有给出 Vanilla 版本的训练配置,也没有给出两者的训练步数,这使得“Vanilla 是否训够了”无从判断。补充指标。过程监督模型:token 准确率 99.67%,交换准确率 99.78%,交换次数准确率 100.00%,最终状态准确率 97.93%,“完全正确”准确率(中间过程与最终状态全对)97.52%。Vanilla 六杯任务:最佳完全正确率 2.40%(最终检查点 1.75%),训练集完全正确率约 12.5%。作者还提到一个简单得多的 3 杯、1 球、固定 5 次交换的分类器,不用过程监督就能达到 99.40%,但因为其状态空间和难度小得多,没有与上述结果直接比较。这一补充很有价值:它说明“只监督最终状态”在简单设定下并非学不会,六杯任务中 Vanilla 的失败更可能是组合空间大带来的优化困难。附录 B:真实世界评估的逐次结果
附录 B 给出了真机实验中每一次试验实际放入包装袋的物体数(表 10)。判定规则与正文相同:放入数量恰好等于指令中的 x,且机器人随后回到初始位姿并静止至少 10 s,才算正确。每个模型在每个目标数量上做 20 次试验,唯一的例外是无记忆的 \pi_{0.5} 在 x=3 和 x=4 时各只做了 10 次:该策略反复在达到要求数量后停不下来、继续抓取,使单次试验耗时过长。未执行的试验记为“–”,不计入准确率的分母。附录最后说明,代表性的真机视频(包括 LTM-\pi 的成功抓放和无记忆 \pi_{0.5} 的一个典型失败)可在项目仓库 https://github.com/buaa-colalab/LTM-pi 中找到。表 10:真实世界评估中每次试验转移的物体数。粗体表示与指令数量相符;“–”表示未执行的试验。试验编号在每个“模型—数量”设置内部独立编号。
| \pi_{0.5}(无记忆) | LTM-\pi(本文) | |||||||
| 试验 | x=1 | x=2 | x=3 | x=4 | x=1 | x=2 | x=3 | x=4 |
| 1 | 0 | 1 | 4 | 5 | 1 | 2 | 3 | 4 |
| 2 | 2 | 1 | 5 | 7 | 1 | 2 | 3 | 3 |
| 3 | 2 | 2 | 5 | 8 | 1 | 1 | 3 | 3 |
| 4 | 2 | 3 | 4 | 6 | 1 | 2 | 4 | 4 |
| 5 | 3 | 3 | 6 | 8 | 1 | 2 | 4 | 4 |
| 6 | 4 | 3 | 3 | 5 | 1 | 2 | 3 | 4 |
| 7 | 4 | 5 | 4 | 7 | 1 | 2 | 3 | 4 |
| 8 | 3 | 4 | 3 | 6 | 1 | 2 | 2 | 4 |
| 9 | 3 | 3 | 6 | 6 | 2 | 2 | 3 | 3 |
| 10 | 4 | 3 | 4 | 8 | 1 | 2 | 3 | 3 |
| 11 | 3 | 2 | – | – | 1 | 2 | 3 | 4 |
| 12 | 2 | 3 | – | – | 1 | 2 | 3 | 4 |
| 13 | 3 | 1 | – | – | 1 | 2 | 2 | 4 |
| 14 | 1 | 1 | – | – | 1 | 2 | 4 | 4 |
| 15 | 2 | 2 | – | – | 1 | 2 | 3 | 4 |
| 16 | 3 | 3 | – | – | 1 | 2 | 3 | 4 |
| 17 | 3 | 3 | – | – | 1 | 2 | 3 | 4 |
| 18 | 5 | 4 | – | – | 1 | 2 | 3 | 4 |
| 19 | 4 | 2 | – | – | 1 | 1 | 3 | 3 |
| 20 | 3 | 3 | – | – | 1 | 2 | 4 | 4 |
| 正确 / 试验数 | 1/20 | 4/20 | 2/10 | 0/10 | 19/20 | 18/20 | 14/20 | 15/20 |
| 准确率(%) | 5.0 | 20.0 | 20.0 | 0.0 | 95.0 | 90.0 | 70.0 | 75.0 |
原表注:Per-trial transferred-object counts in real-world evaluation. Bold entries match the instructed quantity; “–” denotes an unperformed trial. Trial indices are local to each model–quantity setting.
表 10 解读
结构。左边四列是无记忆 \pi_{0.5} 在 x=1,2,3,4 下每次试验实际放入的物体数,右边四列是 LTM-\pi;每行是一次试验(编号只在各自那一列内有意义,不同列的同一行不是同一次试验)。粗体为“数量正确”。最后两行汇总正确次数和准确率,与表 9 一致。注意粗体只表示数量对了,正式的“正确”还要求回到原位并静止 10 秒;从汇总行看,粗体个数与“正确”次数完全相等,说明本实验中数量对了的试验都满足了另两个条件。无记忆 \pi_{0.5} 的行为(我们由表中数字统计):x=1 时 20 次中 18 次多放(最多放了 5 个),平均放入 2.8 个;x=2 时平均 2.6 个,12 次多放、4 次少放;x=3 时平均 4.4 个,8 次多放;x=4 时平均 6.6 个,10 次全部多放(5–8 个)。它在 x=1 和 x=2 时放入的数量几乎相同,说明它基本不看指令中的数字,印证了正文“抓到场景看起来眼熟为止”的分析。x=3,4 时放得更多,可能与这两种设置下源箱初始物体数不同有关,也可能是附录所说的“停不下来”,论文没有给出初始物体数,无法区分。LTM-\pi 的行为:x=1 时 19/20 正确,唯一的错误多放了 1 个;x=2 时 18/20,两次错误都是少放 1 个;x=3 时 14/20,4 次多放 1 个、2 次少放 1 个;x=4 时 15/20,5 次错误都是少放 1 个(放了 3 个)。所有错误都是“差一个”,说明 LTM-\pi 确实在跟踪次数,只是偶尔多数或少数一次。x=4 的错误全是少放,可能是策略在回合较长时更倾向提前结束,也可能与示范中 x=4 的轨迹较少被完整覆盖有关,原文没有分析。统计上的提醒。\pi_{0.5} 在 x=3,4 只有 10 次试验,且未执行的试验被排除在分母之外,而不是计为失败。由于未执行的原因正是“策略停不下来”,若把它们计为失败,\pi_{0.5} 的成功率只会更低,所以这种处理对基线是有利的,不影响结论。
译者附注:原文数字核对与阅读提示汇总
以下各条大多已在正文对应位置的解释框中说明,这里集中列出。总体而言,原文的数字本身是自洽的:我们逐行复算了表 1、2、3、4、5、8、9、10 的平均值和赛道平均,正文中引用的所有差值(39.74、40.61、1.71、29.83、47.50、11.96、0.75、3.50、71.25 等)、增益比(3.31、1.84)、token 减少比例(38.26%、77.60%、88.82%)和真机逐次计数都能还原,没有发现算错的地方。问题主要在三方面:实验配置在各节之间悄悄变化(编码器、延迟 k、训练步数、种子数),比较对象的资源不对等(全部基线数字取自他人论文),以及几处结论比证据更强(“相同编码器”的数据扩展、诊断实验对控制策略的推论)。| 位置 | 说明 |
| 一、编码器与配置的不一致 | |
| §1 / §4.1.4 / 表 5 / 表 8 | 引言称数据扩展“在相同的编码器和策略架构下”从 57.67% 升至 87.50%。但 57.67% 及表 5 的 1\times 一行与表 1 的 CD-LAM 一行逐项相同,而 §4.1.6 正文和表 8 表注都说 87.50%(“复用表 5 的 10\times 参考”)是基于 DreamDojo 的模型。两者之间还同时改变了训练步数(40K \to 120K)和延迟(k=5\to10)。若 10\times 实为 CD-LAM,则表 8 表注和 §4.1.6 有误;若为 DreamDojo,则引言有误、1\times 起点应为 58.54%。原文没有澄清。 |
| 摘要 / 图 1 | 摘要先报告 DreamDojo 的 58.54%,紧接着用 CD-LAM 的 57.67% 作为数据扩展的起点;图 1 中 “LTM-\pi (1\times) 57.67%” 也是 CD-LAM 版,而图例未注明编码器。 |
| 表 3、表 4 | 两组消融都是在 CD-LAM 版上做的(Full 行、k=5 行与表 1 的 CD-LAM 行逐项相同),原文没有明说。 |
| §4.1.4 | “原始数据训练 120K 步无明显提升”这一关键对照没有给出数字。arXiv 源码中留有作者批注,要求投稿前“填入实测的 1\times/120K 成功率和评估种子数,不要把 1\times/40K 的分数当作精确对照”,说明 v1 发布时该数字尚未就绪。按本文其他表推算,编码器差异(+0.87)和 k 差异(-1.29)都远小于 29.83 个点,主要增益来自数据仍是合理推断,但不是这组实验本身证明的。 |
| §4.1.1 | RoboMME-10x(含表 5 的 10\times 行)的评估种子数未给出(源码中同样有作者批注)。压缩实验在正文中说明是单种子。 |
| 二、比较的公平性 | |
| 表 1、表 2 | 所有基线数字都直接取自已发表的报告,未重跑;各方法的种子数、rollout 次数、训练数据量未必一致。表 2 中 2AM 的 rollout 次数未知(数值形如 30.83,可能是 120 次的结果)。 |
| 表 1 | “在不用外部模型和标注的方法中排名第一”:DreamDojo 版对 T^2Mem 只领先 1.71 个点,CD-LAM 版只领先 0.84 个点,属于跨论文比较的误差范围。“两个版本也都优于各基线”只在本组内成立。 |
| 表 5 | 与 PonderPounce 的比较:数据 10\times 对 9\times,PonderPounce 另有 9B 上下文模型和三种额外监督;增益比只是描述性的(作者已注明)。与 SimpleMemVLA 88.25% “只差 0.75 个点”的比较中,SimpleMemVLA 用的是 1\times 数据,LTM 用的是 10\times。 |
| 表 2 | LIBERO-Mem 上没有在相同条件下重跑无记忆的 \pi_{0.5},0% 来自 LIBERO-Mem 原论文。 |
| 三、消融的解读 | |
| 表 3 | Fixed Random LT(44.50%)保留了锚点,所以它与 Full 的差距(13.17 个点)是转移内容的贡献,而它与 \pi_{0.5} 的差距(26.57 个点)混合了“记忆长度即时钟”和锚点两种效应;缺少“无锚点 + 固定随机转移”的对照。“固定随机”的具体含义(所有位置同一向量还是各位置不同)未说明。 |
| 表 3 | Fixed Random LT 在 Permanence 组(61.00%)反而高于 Full(57.17%),在交换任务上也不差于 Full(VUS 30.00 对 30.67、BUS 38.00 对 31.33);转移内容的增益主要集中在 Imitation 组(19.00 对 58.67)。正文只笼统地说“在交换任务上增益有限”。 |
| 表 4 | k=0,5,10 三者的平均差异(最多 1.5 个点)与单种子评估的标准误(约 1.8 个点)同量级,且 k=5 是三种子、另两个是单种子。“LAM 阻塞”是估计值:以仿真 10 步的时间 117.01 ms 为重叠窗口,k=5 时按一半(约 58.5 ms)计(由 67.97 - 9.47 反推);真机上执行 10 步需 500 ms,阻塞会更小。没有端到端实测延迟。 |
| §3.2 | 前缀从 \pi_{0.5} 原本的双向注意力改为因果注意力,以换取 KV 缓存复用;这一改动对成功率的影响没有消融。 |
| 四、Cup Swap 诊断实验 | |
| §4.1.5 / 附录 A | 诊断模型不是 LTM-\pi:Qwen3-VL-2B(冻结)+ 每 4 个转移合并为 1 个 token + 8 层自注意力 + 8 层交叉注意力。它证明的是转移序列中的交换信息“可恢复”,不能说明 LTM-\pi 是否用到这些信息;“过程监督能帮助控制策略”在本文中没有验证。所用编码器只说是“同一族”,未指明 DreamDojo 还是 CD-LAM。 |
| 表 6 / 附录 A | Vanilla 在训练集上只有约 12.5%,测试集最佳 2.40%(最终检查点 1.75%)。已知球数时随机猜测的期望准确率为 5%–16.7%(按球数均匀分布平均约 10%),所以 Vanilla 测试结果甚至低于随机猜测。作者承认优化差异可能造成差距;附录只给出过程监督版本的训练配置,未给出 Vanilla 的配置和两者的训练步数。 |
| 五、Token 压缩 | |
| 表 7 | 压缩后的平均 token 数只给出上界 \le200,原因是未保存完整分布;实际上 \mathbb E[\min(N,200)] 很容易算出。 |
| §4.1.6 | 3.50 个点的下降约为差值标准误的 2 倍,处在勉强显著的边缘;单任务 \pm4 以内的变化(包括作者提到的 +4、+2)属于噪声。压缩后记忆长度不再等于经过的时间步数,削弱了表 3 揭示的“长度即时钟”线索,这可能是 StopCube 掉 18 个点的原因之一(译者推断,原文未讨论)。token 数减少不等于加速,且合并会使 KV 缓存失效,压缩前后的实测延迟未报告。 |
| 六、真机实验 | |
| §4.2 | 只有一个计数任务、一个平台,属于概念验证。示范以 30 FPS 录制、控制间隔 0.05 s(20 Hz),训练时如何对齐两者未说明。源箱初始物体数未给出,因此无法解释 \pi_{0.5} 在 x=3,4 时放入更多(平均 4.4、6.6 个)的原因。 |
| 表 9 / 表 10 | \pi_{0.5} 在 x=3,4 只做了 10 次试验,未执行的试验不计入分母(对基线有利,不影响结论)。LTM-\pi 的 11 次失败全部是“差一个”。 |
| 七、其他 | |
| 图 2 | 示意图中每个转移画了一个独立的 MLP,正文描述的是同一个共享的两层 MLP 投影器。 |
| §2 / §5 | 作者把 LTM 的定位表述为“不保留外观 token”,但视频示范任务中仍保留了两张首帧锚点;表 3 显示 Permanence 组的性能很大程度上依赖它们。 |