从基础模型到实际应用:在实践中改进 VLA 模型
From Foundation to Application: Improving VLA Models in Practice
(LingBot-VLA 2.0 技术报告 · 中文译文与逐段解读)
Wei Wu^*, Fangjing Wang^*, Fan Lu, He Sun, Shi Liu, Yunnan Wang, Yibin Yan, Yong Wang, Shuailei Ma, Xinyang Wang, Yibin Liu, Shuai Yang, Tianxiang Zhou, Kejia Zhang, Lei Zhou, Cheng Su, Nan Xue, Bin Tan, Han Zhang, Youchao Zhang, Fei Liao, Xing Zhu, Yujun Shen, Kecheng Zheng^\dagger
^*共同第一作者(Equal Contribution) ^\dagger项目负责人(Project Lead)
机构:Robbyant(蚂蚁集团旗下具身智能团队,LingBot 系列模型发布方;原文首页未单列机构名,此处据项目网址 robbyant.com 推断)
arXiv: 2607.06403v1 [cs.RO],2026 年 7 月 7 日
项目主页:https://technology.robbyant.com/lingbot-vla-v2
代码:https://github.com/robbyant/lingbot-vla-v2
模型权重:https://huggingface.co/collections/robbyant/lingbot-vla-v2
From Foundation to Application: Improving VLA Models in Practice
(LingBot-VLA 2.0 技术报告 · 中文译文与逐段解读)
Wei Wu^*, Fangjing Wang^*, Fan Lu, He Sun, Shi Liu, Yunnan Wang, Yibin Yan, Yong Wang, Shuailei Ma, Xinyang Wang, Yibin Liu, Shuai Yang, Tianxiang Zhou, Kejia Zhang, Lei Zhou, Cheng Su, Nan Xue, Bin Tan, Han Zhang, Youchao Zhang, Fei Liao, Xing Zhu, Yujun Shen, Kecheng Zheng^\dagger
^*共同第一作者(Equal Contribution) ^\dagger项目负责人(Project Lead)
机构:Robbyant(蚂蚁集团旗下具身智能团队,LingBot 系列模型发布方;原文首页未单列机构名,此处据项目网址 robbyant.com 推断)
arXiv: 2607.06403v1 [cs.RO],2026 年 7 月 7 日
项目主页:https://technology.robbyant.com/lingbot-vla-v2
代码:https://github.com/robbyant/lingbot-vla-v2
模型权重:https://huggingface.co/collections/robbyant/lingbot-vla-v2
目录
导读一、这篇报告要解决什么问题二、三项主要改进三、MoE 动作专家四、主要结论五、背景知识速览六、阅读提示摘要(Abstract)1 引言(Introduction)2 相关工作(Related Work)2.1 通用机器人操作策略(Generalist Robot Manipulation Policies)2.2 混合专家 VLA 模型(Mixture-of-Experts VLA Model)3 预训练数据集(Pre-training Dataset)3.1 数据整理与预处理(Data Curation and Pre-Processing)3.1.1 机器人数据(Robotic Data)3.1.2 第一视角数据(Egocentric Data)3.1.3 统一动作表示(Unified Action Representation)3.2 数据标注(Data Annotation)4 方法(Method)4.1 基于 MoE 的 VLA 模型(MoE-based VLA model)4.2 通过双查询蒸馏实现时空感知的 VLA(Spatiotemporal-Aware VLA via Dual-Query Distillation)5 实验(Experiments)5.1 实验设置(Experimental Settings)5.2 双臂操作实验结果(Bimanual Manipulation Experiment Results)5.3 长时程移动操作实验结果(Long-Horizon Mobile Manipulation Experiment Results)6 消融研究(Ablation Studies)6.1 动作空间(Action Space)6.2 双查询蒸馏的感知结果(Perceptual Results of Dual-query Distillation)7 结论(Conclusion)参考文献附录导读
一、这篇报告要解决什么问题
视觉–语言–动作(Vision-Language-Action, VLA)模型把预训练视觉语言模型(VLM)的语义理解能力接到机器人控制上:输入相机图像、自然语言指令和机器人本体状态,直接输出关节或末端的连续动作。过去两年,\pi_0/\pi_{0.5}、GR00T、OpenVLA 以及作者团队自己的 LingBot-VLA 1.0 已经证明“大模型 + 大数据”能训练出可以跨任务泛化的机器人策略。但作者指出,实验室基准和真实部署之间仍有明显落差,主要体现在三点:- 真实场景的机器人形态五花八门(单臂、双臂、半人形、人形、带灵巧手),数据来源也很杂(遥操作、人类第一视角视频),模型要能跨本体泛化,而不仅仅是跨任务泛化;
- 许多实际平台除了两条手臂,还有头部、腰部、移动底盘和灵巧手的自由度,标准“双臂 + 夹爪”的动作空间覆盖不了;
- 真实环境是动态的,机器人最好能“预想”场景接下来如何变化、自己的动作会带来什么后果,而不只是对当前帧做反应。
二、三项主要改进
(1) 数据规模与质量:约 6 万小时预训练数据。作者重做了数据处理流水线:从 20 种机器人构型上收集约 9 万小时原始轨迹,经平滑性检测(加加速度 jerk、速度/加速度 Z 分数)、静止片段检测、URDF 重投影校验、人工剔除模糊/遮挡/掉帧/多视角不同步视频,保留约 5 万小时高质量机器人数据;另外从约 2 万小时人类第一视角(egocentric)视频池中,经 VLM 预筛、SLAM 与手部姿态重建、轨迹质控,保留约 1 万小时带手部轨迹的数据。所有数据再用 Qwen3.6-27B 自动切分子任务、打上 18 类原子动作标签和语言指令。(2) 全身扩展动作空间。定义一个 55 维的统一状态/动作向量:双臂关节 14 维、双臂末端位姿 14 维、夹爪 2 维、灵巧手 12 维、腰部 4 维、头部 2 维、移动底盘 3 维,外加 4 维保留位。任何本体都把自己有的部件填进对应槽位,没有的部件补零(padding)。这样单臂、双臂、人形和人手视频都能用同一个动作头训练,而且模型天然具备控制头、腰、底盘、灵巧手的能力。(3) 预测性动力学建模(双查询蒸馏)。在 VLM 输入序列末尾追加两组可学习查询 Q_t 与 Q_{t+T},分别要求它们预测当前帧和一个动作块之后的未来帧的特征。监督信号来自两个冻结的“教师”:LingBot-Depth(深度估计模型,提供几何线索)和作者自训的 DINO-Video(因果视频表征模型,提供语义与运动先验)。“预测未来”作为代理任务(proxy task),迫使 VLM 的内部表征包含对场景演化的预期,从而帮助动作生成。三、MoE 动作专家
动作专家(action expert)是负责生成连续动作的 Transformer。作者把其中每一层的前馈网络(FFN)替换成稀疏混合专家(Mixture-of-Experts, MoE)层:1 个共享专家 + N_r 个路由专家,每个 token 用 sigmoid 打分选 Top-K 个专家。负载均衡采用 DeepSeek-V3 的“无辅助损失”方案——给每个专家维护一个偏置,只在选择专家时加上偏置、加权时仍用原始分数,按负载偏差符号调整偏置,因而不会往动作损失里掺入额外的均衡损失。在激活参数量相同(0.6B)的条件下,1.6B 总参数的 MoE 比 0.6B 稠密模型训练损失和验证动作误差都更低。四、主要结论
- GM-100 中 9 个双臂任务、通才(generalist,所有任务混合训练一个策略)设置下:在 AgileX Cobot Magic 上进度分/成功率达 66.2/34.4,比 LingBot-VLA 1.0 高 8.0/4.4,比 \pi_{0.5} 高 7.1/2.2;在 Galaxea R1 Pro 上为 34.6/15.6,比 \pi_{0.5} 高 7.2/6.7。不过逐任务看并非全面领先。
- 两个长时程移动操作任务(Astribot S1 放冰箱、Cobot Magic-ARX X5 清洁灶台)上,域内与分布外设置下都优于 \pi_{0.5}。
- 消融表明:相对关节动作明显好于绝对关节动作(平均成功率 55.0 vs 33.7);MeanStd 归一化好于 MinMax 与 Q01–Q99;L2 损失好于 L1;末端(EEF)与关节动作空间平均成绩接近,但各任务偏好不同。
- 双查询蒸馏部分只给出了定性的深度/特征预测可视化,没有给出“去掉蒸馏后动作成功率如何”的定量消融,这是本报告证据链上较薄弱的一环。
五、背景知识速览
- VLA 模型 以预训练 VLM 为主干,把图像与语言编码成 token,再由动作头输出机器人动作。常见结构是“理解专家 + 动作专家”双塔(如 \pi_0 的 Mixture-of-Transformers):理解专家就是 VLM 本身,动作专家是一个较小的 Transformer,通过注意力读取 VLM 的中间特征。
- 动作分块(Action Chunking) 模型一次预测未来 T 步(例如 T=50 步,对应 30 Hz 下约 1.7 秒)的动作序列,而不是只预测下一步。好处是动作更平滑、推理频率可以降低、能表达多步的意图。本文中“未来查询”的预测时距 T 恰好取动作块长度。
- 流匹配(Flow Matching) 一种生成模型训练方法:在纯噪声 \epsilon 和真实动作 a 之间做插值 a_\tau=\tau a+(1-\tau)\epsilon,训练网络预测速度场 v=a-\epsilon;推理时从噪声出发沿速度场积分若干步得到动作。图 1 中输入的 “Noised Actions” 正是这一机制的体现(LingBot-VLA 1.0 与 \pi_0 均采用流匹配;本报告未重新写出该损失)。它适合表达连续、多峰的动作分布。
- 混合专家(MoE) 把一个大 FFN 拆成许多小 FFN(专家),每个 token 只经过路由器挑出的少数几个专家。总参数量大、但每个 token 实际计算量(激活参数)小。核心难题是负载均衡:若路由器总挑同几个专家,其余专家就学不到东西。
- 深度估计与视频表征蒸馏 知识蒸馏是让学生网络去拟合教师网络的输出。这里教师是冻结的深度模型(输出每个像素离相机多远,携带三维几何信息)与视频自监督模型(DINO 系列的 patch 特征携带物体、部件等语义,视频版再加入时间与运动信息)。学生(VLA 的查询 token)通过一个投影头去回归教师特征,相当于给 VLM 加一个“看懂几何与运动”的辅助任务。
- GM-100 基准 The Great March 100,由 Ziyu Wang、Yong-Lu Li 等人(文献 [36])提出的 100 个细节导向的真机操作任务集合,涵盖分拣、取放、铰接物体、柔性物体等,LingBot-VLA 1.0 即在其上做过大规模真机评测。评测通常同时报告“进度分”(按子步骤给分的累计得分)和“成功率”(整个任务完成与否)。
- \pi_{0.5} 与 GR00T N1.7 分别是 Physical Intelligence 与 NVIDIA 发布的通用 VLA 基础模型,是本文的主要对比基线。
六、阅读提示
本文是一篇偏工程的技术报告:方法部分(MoE 公式、双查询蒸馏损失)写得较完整,数据部分篇幅很大;实验部分则以真机评测为主,样本量较小(每个设置 10 或 15 次试验),一次试验的成败就会让成功率变动 6.7–10 个百分点,阅读数字时应留意这一点。下文每段按“原文—译文—解释”三框排列,图表放在首次引用处附近。摘要(Abstract)
原文
Despite recent progress of VLA foundation models, the disparity between laboratory conditions and real-world applications continues to impede their practical implementation. To bridge this gap, we present LingBot-VLA 2.0, which advances LingBot-VLA through improvements in three functional domains.
译文
尽管 VLA 基础模型近来取得了进展,实验室条件与真实世界应用之间的差距仍在阻碍其落地实施。为弥合这一差距,我们提出 LingBot-VLA 2.0,它在三个功能领域上对 LingBot-VLA 加以改进。
解释
摘要开门见山地给出全文定位:这不是提出一个全新范式,而是对已有的 LingBot-VLA(1.0 版,文献 [38] “A Pragmatic VLA Foundation Model”)做面向落地的系统性升级。“三个功能领域”就是后文反复出现的三条主线:泛化、动作空间、预测性动力学。读者可以把它理解为一份“版本更新说明 + 实验验证”的技术报告。
原文
(1) Generalization across tasks and embodiments. Compared to the previous version, we revamp the data processing pipeline and curate around 60,000 hours of data for pretraining, including 50,000 hours of robot trajectories spanning 20 robot configurations and 10,000 hours of egocentric human videos.
译文
(1) 跨任务与跨本体(embodiment)的泛化。与前一版本相比,我们重构了数据处理流水线,整理出约 60,000 小时的预训练数据,其中包括覆盖 20 种机器人构型的 50,000 小时机器人轨迹,以及 10,000 小时人类第一视角(egocentric)视频。
解释
“本体”(embodiment)指机器人的具体物理形态:手臂数量与自由度、末端是夹爪还是灵巧手、有没有腰和底盘、相机装在哪里等。跨本体泛化要求同一个模型能控制不同形态的机器人。第一项改进的抓手是数据:5 万小时机器人数据 + 1 万小时人类视频。作为对照,据 1.0 版技术报告,上一版使用的是约 2 万小时、9 种双臂构型的数据,因此 2.0 版在时长上约为 3 倍,在构型数量上也扩大了一倍多,并首次引入了人类第一视角视频。
原文
(2) Expanded action space in addition to dual-arm hardware platforms. In particular, our system accommodates degrees of freedom for the heads, waists, mobile bases, and dexterous hands, thereby empowering the robots to tackle more complex tasks in practical scenarios.
译文
(2) 在双臂硬件平台之外扩展动作空间。具体而言,我们的系统可以容纳头部、腰部、移动底盘以及灵巧手的自由度(degrees of freedom, DoF),使机器人能够应对实际场景中更复杂的任务。
解释
1.0 版只处理“两条机械臂 + 两个夹爪”的动作。2.0 版把头(调整视角)、腰(扩大工作空间、弯腰取物)、底盘(在房间里移动)和灵巧手(多指抓握)都纳入动作向量。这直接决定了模型能否做“走到冰箱前、开门、放东西”这类移动操作任务——第 5.3 节的长时程实验正是为此设计的。
原文
(3) Predictive dynamics modeling for improved temporal reasoning. Specifically, we formulate future prediction as a proxy task, facilitated by a video representation model for semantic priors and a depth estimation model for geometric cues.
译文
(3) 通过预测性动力学建模(predictive dynamics modeling)改进时间推理。具体来说,我们把“预测未来”形式化为一个代理任务(proxy task),借助视频表征模型提供语义先验、借助深度估计模型提供几何线索。
解释
“代理任务”意味着预测未来本身不是目的,最终要的是更好的动作;预测未来只是训练时附加的辅助目标,用来塑造 VLM 内部表征。这里没有去生成未来的像素图像(那是世界模型/视频生成的做法,代价很高),而是让模型预测未来帧在两个冻结教师模型下的特征:深度特征(几何)和 DINO-Video 特征(语义与运动)。在特征空间里预测比在像素空间里预测便宜得多,也更聚焦于对决策有用的信息。
原文
Evaluations on the GM-100 benchmark, conducted in a generalist setting, validate the beneficial impact of these proposed modifications. Furthermore, benefiting from the expanded pretraining data that covers whole-body degrees of freedom, LingBot-VLA-2.0 demonstrates strong cross-embodiment long-horizon mobile manipulation capability across the two robotic platforms.
译文
在通才(generalist)设置下于 GM-100 基准上的评测,验证了上述改进的积极作用。此外,得益于覆盖全身自由度的扩展预训练数据,LingBot-VLA-2.0 在两个机器人平台上展现出很强的跨本体长时程移动操作能力。
解释
“通才设置”指同一平台上所有任务的数据混在一起训练一个策略,而不是每个任务单独微调一个模型,它更考验模型在多任务之间共享技能的能力。“长时程移动操作”(long-horizon mobile manipulation)指需要底盘移动 + 多个操作步骤串联的任务,例如第 5.3 节中“把桌上的饮料和水果收进篮子、走到冰箱前、开门、逐一放入、关门”,共 11 个子步骤。
原文
译文
项目主页、代码仓库与模型权重链接如上(权重托管在 Hugging Face 的 robbyant 合集中)。
1引言(Introduction)
原文
Vision-language-action (VLA) models [4–6, 16] have recently emerged as a promising paradigm for building generalist robot policies. A key advantage of this paradigm is that pretrained vision-language models provide rich multimodal alignment and semantic representations, enabling VLA models to better understand complex scenes and generalize across diverse tasks. Beyond such model-level priors, recent advances [5, 31] further show that scaling up robot data in both quantity and diversity can substantially improve the capability of VLA systems. Together, these developments have established VLA as a compelling foundation for robot learning.
译文
视觉–语言–动作(Vision-Language-Action, VLA)模型 [4–6, 16] 近来已成为构建通用机器人策略(generalist robot policy)的一种有前景的范式。这一范式的关键优势在于:预训练视觉语言模型提供了丰富的多模态对齐与语义表征,使 VLA 模型能更好地理解复杂场景,并在多样任务之间泛化。除了这种模型层面的先验,近期进展 [5, 31] 进一步表明,在数量与多样性两方面扩大机器人数据规模,可以显著提升 VLA 系统的能力。这些进展共同使 VLA 成为机器人学习颇具吸引力的基础。
解释
第一段交代背景的两根支柱。其一是模型先验:VLM 在互联网图文上学到了“杯子长什么样”“把 A 放进 B 是什么意思”,VLA 可以直接继承这种理解力(引用的 [4] GR00T N1、[5] \pi_{0.5}、[6] \pi_0、[16] OpenVLA 都是代表作)。其二是数据规模:[5] \pi_{0.5} 和 [31] Generalist 的 GEN-1 都显示,机器人数据越多、越多样,模型越强,这与大语言模型的规模定律思路一致。本文后面的“6 万小时数据”就是沿着第二根支柱继续加码。
原文
However, despite this rapid progress, a substantial gap remains between laboratory benchmarks and real-world deployment. In practice, robots are expected to operate under broader embodiment diversity, richer action spaces, and more dynamic environments than those considered in many existing VLA settings. First, generalization in practice is not only about transferring across tasks, but also about handling heterogeneous robot configurations and data sources. Another point is that many real-world platforms involve substantially more degrees of freedom than standard dual-arm manipulation setups, including head movement, waist, mobile-base control, and dexterous hands. Subsequently, real-world execution often requires anticipating future scene evolution and action consequences, rather than reacting only to current observations. These challenges collectively limit the practical utility of current VLA foundation models.
译文
然而,尽管进展迅速,实验室基准与真实世界部署之间仍存在相当大的差距。在实际中,机器人需要面对比许多现有 VLA 设定所考虑的更广泛的本体多样性、更丰富的动作空间以及更动态的环境。首先,实践中的泛化不仅是跨任务迁移,还包括处理异构的机器人构型与数据来源。其次,许多真实平台的自由度远多于标准的双臂操作配置,包括头部运动、腰部、移动底盘控制以及灵巧手。再次,真实世界中的执行往往需要预判场景的未来演化与动作后果,而不仅仅是对当前观测作出反应。这些挑战共同限制了当前 VLA 基础模型的实用价值。
解释
这一段把“实验室–现实差距”拆成三个具体问题,与摘要的三项改进一一对应:异构本体与数据源 \to 数据扩展;更多自由度 \to 扩展动作空间;需要预判未来 \to 预测性动力学建模。举例来说,一个只对当前帧做反应的策略在“推球入盒”任务中,看到球在滚动时并不知道它下一秒会滚到哪里;若模型内部能对未来场景有所预期,就更可能提前调整推力方向。
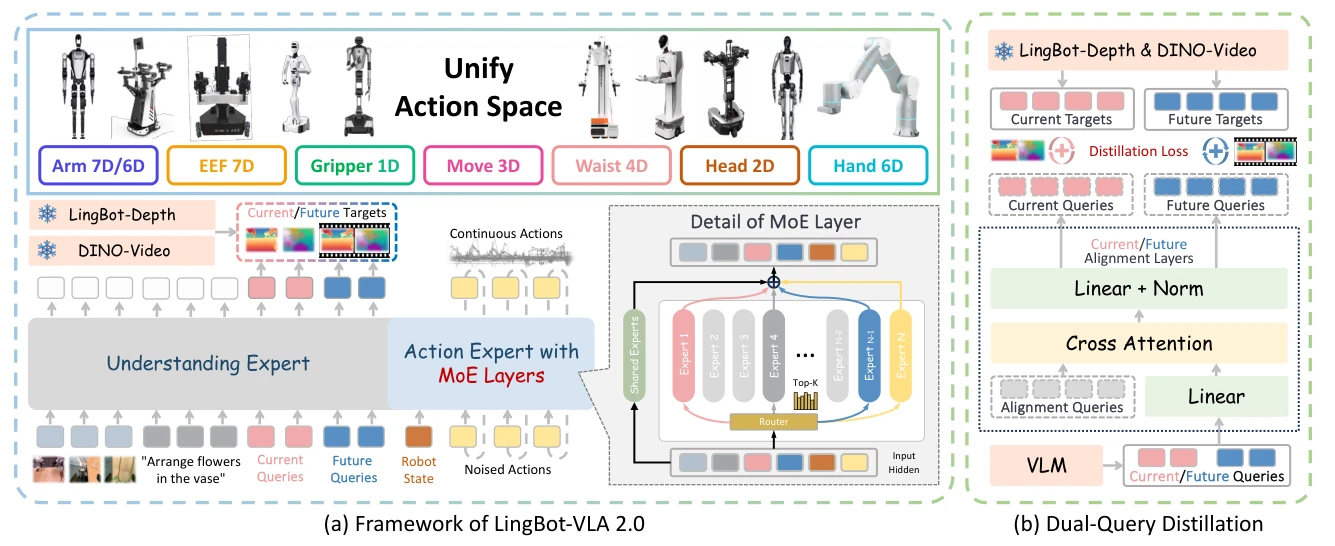
原图注:Figure 1. Overview of LingBot-VLA 2.0. We revamp the data processing pipeline and curate 60,000 hours of pretraining data, including 50,000 hours of robot trajectories across 20 robot configurations and 10,000 hours of egocentric human videos. Moreover, our model supports degrees of freedom for the head, waist, mobile base, and dexterous hands, enabling robots to handle more complex real-world tasks. We formulate future prediction as a proxy task, leveraging a video representation model for semantic priors and a depth estimation model for geometric cues.
译文图注:图 1:LingBot-VLA 2.0 概览。我们重构了数据处理流水线并整理出 60,000 小时预训练数据,其中包括覆盖 20 种机器人构型的 50,000 小时机器人轨迹和 10,000 小时人类第一视角视频。此外,我们的模型支持头部、腰部、移动底盘和灵巧手的自由度,使机器人能处理更复杂的真实世界任务。我们把未来预测形式化为代理任务,利用视频表征模型提供语义先验、深度估计模型提供几何线索。图 1 解读
(a) 整体框架。最上方的“Unify Action Space(统一动作空间)”一栏列出 7 类动作分量:手臂关节 7D/6D、末端执行器(EEF)位姿 7D、夹爪 1D、移动 3D、腰部 4D、头部 2D、灵巧手 6D,上面配了不同形态的机器人图片,表示它们都被映射到同一个向量空间(详见第 3.1.3 节和图 4)。中部是模型主体:左侧灰色的 Understanding Expert(理解专家)即 VLM,底部输入依次为多视角图像、语言指令(例:“Arrange flowers in the vase”,把花插进花瓶)、粉色的 Current Queries(当前查询)与蓝色的 Future Queries(未来查询);右侧蓝色的 Action Expert with MoE Layers(带 MoE 层的动作专家)的输入为橙色的机器人状态(Robot State)和黄色的加噪动作(Noised Actions),输出为去噪后的连续动作(Continuous Actions)。两个专家通过共享的注意力交互(一种 Mixture-of-Transformers 结构)。左上角标雪花图标的 LingBot-Depth 与 DINO-Video 是冻结的教师模型,它们从当前帧和未来帧中提取 Current/Future Targets(彩色的深度图与特征图),用来监督查询 token 的输出。右下方 “Detail of MoE Layer(MoE 层细节)”放大展示了动作专家中的一层:输入隐藏状态经 Router(路由器)打分,按 Top-K 选出若干路由专家(Expert 1 到 Expert N,图中彩色的是被激活的,灰色的未被激活),再与左侧常驻的 Shared Experts(共享专家)的输出相加(\oplus)。(b) 双查询蒸馏。自下而上:VLM 输出当前/未来查询的隐状态,经 Linear 映射后,与一组可学习的 Alignment Queries(对齐查询)做 Cross Attention(交叉注意力),再经 Linear + Norm,得到与教师特征维度对齐的 Current Queries 与 Future Queries;最上方是冻结教师给出的 Current Targets 与 Future Targets,二者之间计算 Distillation Loss(蒸馏损失)。这一整块就是式 (9)(10) 中的投影模块 \mathrm{Proj}(\cdot)。对论点的作用:这张图把三项改进放在一张图里:顶部对应扩展动作空间,中部 MoE 对应模型容量扩展,(b) 与教师模型对应预测性动力学建模。数据扩展部分在图 2、图 3 中单独展示。
原文
A growing body of work has started to address these issues from different perspectives. Some approaches [21, 31, 38] scale robot pretraining data to improve cross-task and cross-embodiment robustness. Others incorporate embodiment-aware architectural designs [13] to better handle heterogeneous robots. Another line of research augments VLA models with latent action model [11, 23] to improve decision making in dynamic environments. Meanwhile, recent system-oriented efforts have emphasized that practical VLA deployment depends not only on model scale, but also on data quality, action coverage, and training objectives that better align pretraining with downstream execution. These trends indicate that improving VLA models in practice requires a coordinated treatment of data, embodiment, and predictive capability.
译文
越来越多的工作开始从不同角度处理这些问题。一些方法 [21, 31, 38] 扩大机器人预训练数据,以提升跨任务与跨本体的鲁棒性;另一些方法引入具有本体感知的架构设计 [13],以更好地处理异构机器人;还有一条研究路线用潜在动作模型(latent action model)[11, 23] 来增强 VLA,以改进动态环境中的决策。与此同时,近期面向系统的工作强调,VLA 的实际部署不仅取决于模型规模,还取决于数据质量、动作覆盖范围,以及能让预训练与下游执行更好对齐的训练目标。这些趋势表明,要在实践中改进 VLA 模型,需要对数据、本体与预测能力进行协同处理。
解释
这段是引言内部的小型相关工作综述,目的是论证“三管齐下”的必要性:已有工作各自只抓了一个方面(数据 / 架构 / 预测),而作者主张三者要一起做。“潜在动作模型”指从视频中无监督地学出一个压缩的“动作编码”(例如两帧之间发生了什么变化),可以利用没有动作标签的视频,也能让模型对“接下来会发生什么”有所表征,这与本文用未来特征做代理任务的思路是近亲。
原文
In this work, we build on this perspective and present LingBot-VLA 2.0, an improved version of LingBot-VLA aimed at bridging foundation-level VLA capabilities with practical robotic deployment. Rather than focusing on a single improvement, LingBot-VLA 2.0 advances the system along three functional domains that we find particularly critical for real-world deployment. First, to improve generalization across tasks and embodiments, we redesign the data processing pipeline and curate a large-scale pretraining corpus of around 60,000 hours, including 50,000 hours of robot trajectories spanning 20 robot configurations and 10,000 hours of egocentric human videos. This design aims to provide broader coverage over both embodiment patterns and interaction scenarios.
译文
本文沿着这一视角提出 LingBot-VLA 2.0——LingBot-VLA 的改进版本,旨在把基础层面的 VLA 能力与实际的机器人部署连接起来。LingBot-VLA 2.0 并不聚焦单一改进,而是在我们认为对真实部署尤为关键的三个功能领域上推进系统。第一,为了提升跨任务与跨本体的泛化,我们重新设计了数据处理流水线,整理出约 60,000 小时的大规模预训练语料,包括覆盖 20 种机器人构型的 50,000 小时机器人轨迹和 10,000 小时人类第一视角视频。这一设计旨在对本体形态与交互场景两方面都提供更广的覆盖。
解释
引言重复摘要中的数字,同时补充了动机:机器人数据覆盖“本体形态”,人类视频则以低成本覆盖大量“交互场景”(人在厨房、车间、桌面上做各种事),后者在机器人上很难大规模采集。
原文
Second, to support a wider range of practical robots, we extend the model to an expanded action space beyond standard dual-arm platforms, enabling control over the head, waist, mobile base, and dexterous hands. This expanded control interface allows the system to address more complex tasks that require coordinated whole-body interaction.
译文
第二,为了支持更多类型的实用机器人,我们把模型扩展到超越标准双臂平台的扩展动作空间,使其能控制头部、腰部、移动底盘和灵巧手。这一扩展的控制接口使系统能处理需要协调全身交互的更复杂任务。
解释
“全身交互”(whole-body interaction)指多个身体部件协同完成任务,例如一边移动底盘靠近冰箱一边抬起手臂、或弯腰从低处拿东西时腰和手臂同时动作。统一的动作向量让这些部件在同一个动作块里被联合预测,而不是由多个独立控制器各管一块。
原文
Third, to improve temporal reasoning in dynamic environments, as shown in Fig. 1, we introduce predictive dynamics modeling as a proxy objective. Concretely, we formulate future prediction using a video representation model to provide semantic priors and a depth estimation model to provide geometric cues, encouraging the VLA model to reason about future scene evolution and action consequences.
译文
第三,为了提升在动态环境中的时间推理能力,如图 1 所示,我们引入预测性动力学建模作为代理目标。具体而言,我们利用视频表征模型提供语义先验、深度估计模型提供几何线索来构建未来预测,促使 VLA 模型推理场景的未来演化与动作后果。
解释
“动力学”在这里指世界状态随时间(和机器人动作)的变化规律。模型被要求预测一个动作块之后的场景特征,等价于在隐空间里学习一个“观测 + 指令 \to 未来观测”的映射。由于未来帧本身取决于机器人接下来做什么,这个预测任务会迫使模型把“我打算怎么动”和“世界会怎样变”联系起来。
原文
Our central hypothesis is that practical VLA systems should not only scale in model and data size, but also become better aligned with the demands of real-world robotics: broader embodiment support, richer controllable action spaces, and stronger predictive understanding of dynamic scenes. Under this view, LingBot-VLA 2.0 is intended as a step from foundation-level capability toward application-oriented usability.
译文
我们的核心假设是:实用的 VLA 系统不仅应在模型与数据规模上扩展,还应与真实机器人学的需求更好地对齐——更广泛的本体支持、更丰富的可控动作空间,以及对动态场景更强的预测性理解。在这一视角下,LingBot-VLA 2.0 被定位为从基础层面能力迈向面向应用的可用性的一步。
解释
这一段是全文的“论点陈述”。值得注意的是作者用了“hypothesis(假设)”一词:后文实验是在检验这个假设,但实验设计以整体对比为主(2.0 vs 1.0 / \pi_{0.5}),三项改进各自贡献了多少并没有被逐一拆开量化,读者应把结论理解为“整体组合有效”。
原文
We evaluate LingBot-VLA 2.0 in a generalist setting on nine tasks from the GM-100 dual-arm manipulation benchmark [36], as well as on two long-horizon mobile manipulation tasks. The results show that the proposed modifications consistently improve practical capability, validating the importance of jointly enhancing generalization, action-space coverage, and predictive dynamics modeling. Overall, our work highlights a pragmatic direction for advancing VLA foundation models from laboratory success toward real-world applicability.
译文
我们在通才设置下,用 GM-100 双臂操作基准 [36] 中的 9 个任务以及两个长时程移动操作任务评估 LingBot-VLA 2.0。结果表明,所提出的改进持续提升了实际能力,验证了同时增强泛化、动作空间覆盖与预测性动力学建模的重要性。总体而言,我们的工作为推动 VLA 基础模型从实验室成功走向真实世界可用指明了一个务实的方向。
解释
评测分两块:9 个 GM-100 双臂桌面任务(在 AgileX Cobot Magic 和 Galaxea R1 Pro 两个平台上,见第 5.2 节)和 2 个移动操作任务(Astribot S1 与 Cobot Magic-ARX X5,见第 5.3 节)。此外第 6 节还有动作表示方面的消融,用的是 GM-100 中另外 4 个任务。“consistently improve”这一说法在平均分层面成立,但第 5.2 节逐任务看存在若干退步,后文会具体指出。
2相关工作(Related Work)
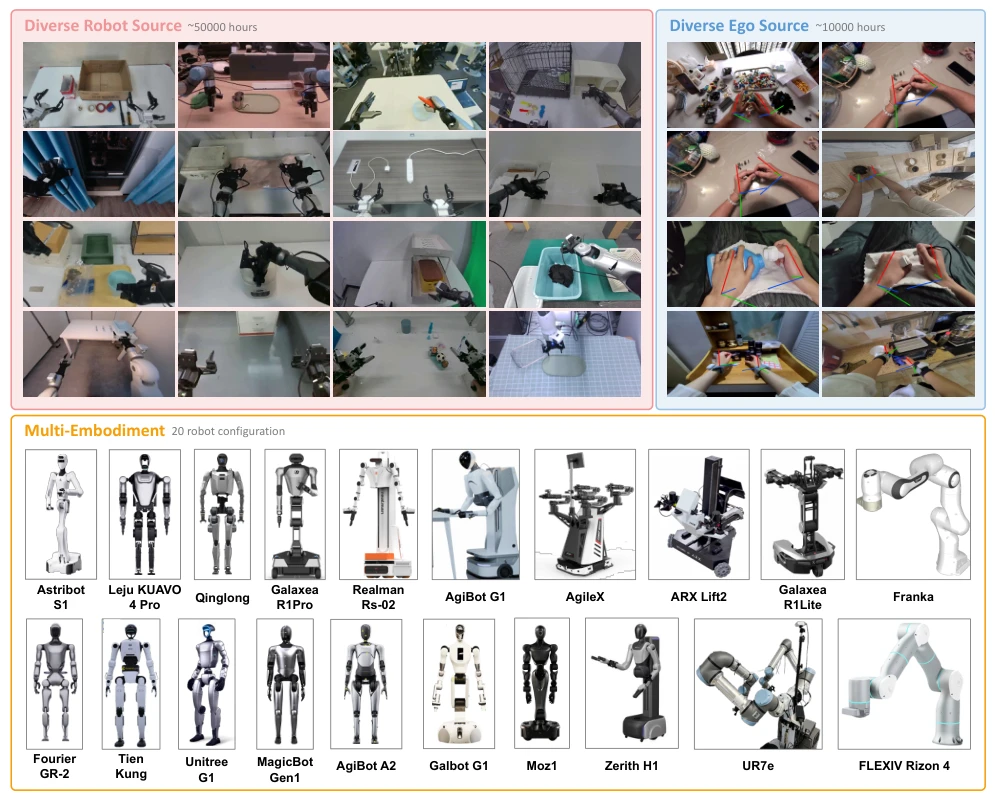
原图注:Figure 2. Visualization of the pre-training dataset used by LingBot-VLA-2.0. The dataset includes 20 robot embodiments with degrees of freedom in the arms, heads, waists, mobile bases, and dexterous hands.
译文图注:图 2:LingBot-VLA-2.0 所用预训练数据集的可视化。数据集包含 20 种机器人本体,涵盖手臂、头部、腰部、移动底盘与灵巧手的自由度。图 2 解读
图 2 在原文中位于第 3 页(第 3 节首次引用),这里按版面位置放在相关工作之前。
- 左上粉框 “Diverse Robot Source \sim50000 hours”:16 张机器人视角采样帧,可以看到俯视/头部相机与腕部相机画面、不同颜色的桌面与夹爪,任务涵盖整理箱子、操作抽屉、开微波炉、放置物品等。
- 右上蓝框 “Diverse Ego Source \sim10000 hours”:8 张人类第一视角画面,部分帧上叠加了彩色线条,表示重建出的手部骨架/轨迹(第 3.1.2 节)。
- 下方橙框 “Multi-Embodiment 20 robot configuration”:20 种机器人的产品照,从左上起依次为 Astribot S1、乐聚 KUAVO 4 Pro、青龙、星海图 R1 Pro、睿尔曼 Rs-02、智元 G1、松灵 AgileX、方舟 ARX Lift2、星海图 R1 Lite、Franka;第二行为傅利叶 GR-2、天工、宇树 G1、MagicBot Gen1、智元 A2、银河通用 Galbot G1、Moz1、Zerith H1、UR7e、Flexiv Rizon 4。形态覆盖单臂工业臂、轮式双臂、半人形到全尺寸人形。
2.1通用机器人操作策略(Generalist Robot Manipulation Policies)
原文
Recent vision-language-action (VLA) models [4–8, 10, 14, 30, 32–34, 39, 41, 42, 47] have established foundation VLA model as a promising paradigm for generalist robot control. Existing efforts have improved VLA systems along several complementary directions, including scaling heterogeneous robot data and unified pretraining recipes for generalization across tasks and embodiments [34, 43, 46, 47], leveraging human-centric data such as egocentric videos and hand motion to learn transferable embodied priors [20–22], introducing embodiment-aware architectures or unified action spaces to better support cross-platform transfer [18], and incorporating predictive or world-modeling objectives to improve temporal reasoning and future-aware decision making [11, 23].
译文
近期的视觉–语言–动作(VLA)模型 [4–8, 10, 14, 30, 32–34, 39, 41, 42, 47] 已经确立了基础 VLA 模型作为通用机器人控制的一种有前景的范式。现有工作沿着若干互补方向改进 VLA 系统,包括:扩大异构机器人数据规模并采用统一的预训练配方,以实现跨任务与跨本体的泛化 [34, 43, 46, 47];利用以人为中心的数据(如第一视角视频与手部运动)学习可迁移的具身先验 [20–22];引入本体感知架构或统一动作空间,以更好地支持跨平台迁移 [18];以及引入预测或世界建模目标,以改进时间推理和面向未来的决策 [11, 23]。
解释
这段把相关工作按四个方向归类,正好对应本文的设计取舍: (i) 异构数据 + 统一预训练 \to 本文第 3 节的 6 万小时数据; (ii) 人类第一视角视频与手部运动([20–22] 为 Being-H0 系列,主张从大规模人类视频学 VLA)\to 本文的 1 万小时 egocentric 数据; (iii) 统一动作空间([18] HoloBrain-0)\to 本文的 55 维规范向量; (iv) 预测/世界模型目标 \to 本文的双查询蒸馏。被引的基线中,[4] GR00T N1、[5] \pi_{0.5}、[6] \pi_0、[8] GR-3、[30] Gemini Robotics、[32] GR00T N1.6 等均是业界知名的 VLA 基础模型。
原文
Other works further enhance VLA models through geometry-aware supervision [49], autoregressive reasoning-action unification [13], or deployment-oriented system design for real-world execution [15, 47]. Together, these studies demonstrate the rapid progress of foundation VLA models, while also highlighting that practical deployment still requires jointly addressing large-scale generalization, richer embodiment, and action-space support.
译文
另一些工作通过几何感知监督 [49]、自回归的推理–动作统一 [13],或面向部署的系统设计以支持真实世界执行 [15, 47],进一步增强 VLA 模型。这些研究共同展示了基础 VLA 模型的快速进步,同时也凸显出:实际部署仍需同时解决大规模泛化、更丰富的本体以及动作空间支持等问题。
解释
“几何感知监督”([49] GEM)与本文用 LingBot-Depth 做深度蒸馏思路相近:VLM 原本主要在 2D 图文上训练,缺乏精确的三维空间感,而机器人抓取需要知道物体离多远、朝向如何,因此要额外注入几何信息。“自回归推理–动作统一”指像语言模型那样先生成思考文本再生成动作 token。本段最后一句再次落到本文的三个关键词,作为过渡。
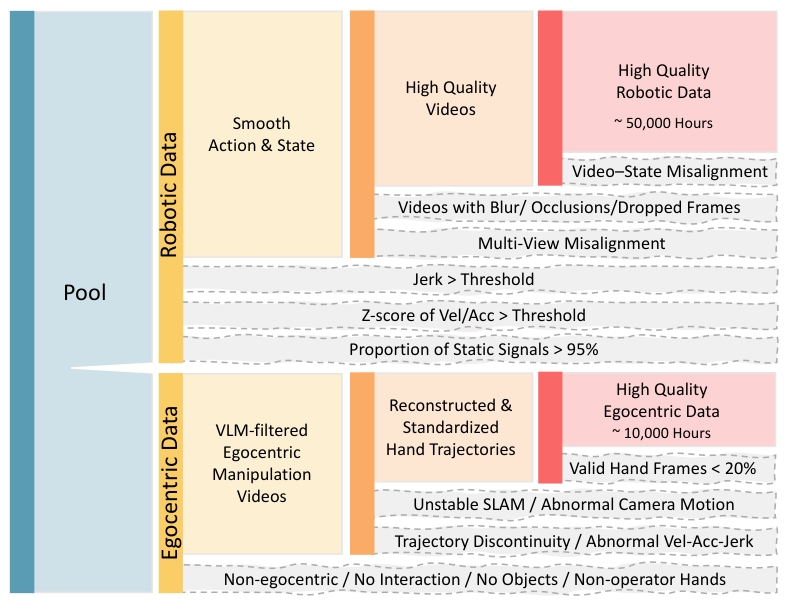
原图注:Figure 3. Data processing pipeline.
译文图注:图 3:数据处理流水线。图 3 解读
这是一张“漏斗/冰柱图”:从左到右是数据逐级被过滤的过程,每一级下方带虚线边框的灰条表示在这一级被剔除的数据类型。
- 最左侧 Pool(数据池)被分成上下两路:上方黄色竖条 Robotic Data(机器人数据),下方 Egocentric Data(第一视角数据)。
- 机器人数据一路:第一级保留 “Smooth Action & State(平滑的动作与状态)”,剔除 “Jerk > Threshold(加加速度超阈值)”“Z-score of Vel/Acc > Threshold(速度/加速度 Z 分数超阈值)”“Proportion of Static Signals > 95%(静止信号占比超 95%)”;第二级保留 “High Quality Videos(高质量视频)”,剔除 “Videos with Blur/Occlusions/Dropped Frames(模糊/遮挡/掉帧)”和 “Multi-View Misalignment(多视角不同步)”;第三级剔除 “Video–State Misalignment(视频与状态不一致)”,最终得到约 5 万小时高质量机器人数据。
- 第一视角一路:第一级保留 “VLM-filtered Egocentric Manipulation Videos(经 VLM 筛选的第一视角操作视频)”,剔除 “Non-egocentric / No Interaction / No Objects / Non-operator Hands(非第一视角/无交互/无物体/出现非操作者的手)”;第二级得到 “Reconstructed & Standardized Hand Trajectories(重建并标准化的手部轨迹)”,剔除 “Unstable SLAM / Abnormal Camera Motion(SLAM 不稳定/相机运动异常)”和 “Trajectory Discontinuity / Abnormal Vel-Acc-Jerk(轨迹不连续/速度–加速度–加加速度异常)”;第三级剔除 “Valid Hand Frames < 20%(有效手部帧不足 20%)”,最终得到约 1 万小时高质量第一视角数据。
2.2混合专家 VLA 模型(Mixture-of-Experts VLA Model)
原文
Mixture-of-Experts (MoE) has emerged as a pivotal mechanism for scaling action modeling capacity in VLA systems. For contact-rich manipulation, ForceVLA [45] and ForceVLA2 [17] introduce force-aware MoE modules to fuse sparse but critical force feedback with visual-language representations, while MoDE-VLA [29] further exploits force and tactile signals for dexterous bimanual manipulation. For long-horizon tasks, AtomicVLA [48] structures experts around atomic skills to mitigate inter-stage interference, while SAMoE-VLA [44] conditions expert routing on scene-level representations rather than token-level features alone. Other works [3, 12, 21] introduce MoE structures to address humanoid body-part and motion-phase specialization, and embodiment-level heterogeneity.
译文
混合专家(Mixture-of-Experts, MoE)已成为扩展 VLA 系统中动作建模容量的关键机制。针对接触丰富(contact-rich)的操作,ForceVLA [45] 和 ForceVLA2 [17] 引入力感知的 MoE 模块,把稀疏但关键的力反馈与视觉–语言表征相融合;MoDE-VLA [29] 进一步利用力觉与触觉信号进行灵巧的双臂操作。针对长时程任务,AtomicVLA [48] 围绕原子技能组织专家,以缓解不同阶段之间的干扰;SAMoE-VLA [44] 则让专家路由以场景级表征为条件,而不仅仅依赖 token 级特征。其他工作 [3, 12, 21] 引入 MoE 结构,用于处理人形机器人的身体部位与运动阶段专门化,以及本体层面的异构性。
解释
这段梳理已有 MoE-VLA 工作的共同特点:专家的分工是人为预设的——按模态(力/触觉)、按技能(原子动作)、按场景、按身体部位([3] HEX 按人形机器人的部件分专家)或按本体。这种设计的好处是可解释,代价是分工维度单一,而且需要额外信息(如技能标签、本体 ID)来引导路由。
原文
In large-scale VLA pretraining, action representations are jointly shaped by multiple entangled factors, including embodiment-specific dynamics, task-dependent control logic, and deployment scenario diversity. Rather than prescribing expert semantics based on any single dimension of variation, we instantiate token-level sparse MoE layers within the action expert, enabling each action token to adaptively select experts based on its intrinsic features. Furthermore, we adopt an auxiliary-loss-free load-balancing mechanism [19] that promotes balanced expert utilization via routing correction biases, eliminating the need to inject an explicit load-balancing loss into the primary action learning objective.
译文
在大规模 VLA 预训练中,动作表征同时受到多种相互纠缠的因素影响,包括本体特定的动力学、依赖任务的控制逻辑,以及部署场景的多样性。我们并不基于某一个单一的变化维度来预先规定专家的语义,而是在动作专家内部实例化 token 级的稀疏 MoE 层,使每个动作 token 能根据其自身特征自适应地选择专家。此外,我们采用一种无辅助损失(auxiliary-loss-free)的负载均衡机制 [19],通过路由修正偏置来促进专家使用的均衡,从而无需在主要的动作学习目标中注入显式的负载均衡损失。
解释
这里点出本文与上段工作的区别:不预设专家分工,让路由器根据每个 token 的特征自行决定,分工维度可以是本体、任务、动作阶段的任意混合——这与大语言模型中的 MoE 做法一致。“token 级”指动作块里的每一个时间步 token 都独立选择专家,所以同一动作块里“伸手”阶段和“抓取”阶段的 token 可能走不同专家。“无辅助损失负载均衡”来自 DeepSeek-V3 [19]:传统做法会加一个惩罚专家使用不均的辅助损失,但这个损失的梯度会干扰主任务;DeepSeek-V3 改用一个不参与梯度的偏置项来调节路由,细节见第 4.1 节式 (6)–(8)。
3预训练数据集(Pre-training Dataset)
原文
To improve VLA models for strong generalization and practicality across diverse embodiments and dynamic environments, we redesign the data processing pipeline and curate a large-scale pretraining dataset of approximately 60,000 hours, as illustrated in Fig. 2. The redesigned data processing pipeline is shown in Fig. 3.
译文
为了让 VLA 模型在多样的本体与动态环境中具备强泛化能力和实用性,我们重新设计了数据处理流水线,并整理出约 60,000 小时的大规模预训练数据集,如图 2 所示。重新设计的数据处理流水线见图 3。
解释
本节是全文篇幅最大的部分之一,分三块:3.1.1 机器人数据清洗、3.1.2 第一视角数据清洗与重建、3.1.3 统一动作表示,然后 3.2 讲自动标注。图 2、图 3 已在前文给出。
3.1数据整理与预处理(Data Curation and Pre-Processing)
3.1.1机器人数据(Robotic Data)
原文
We collect approximately 90,000 hours of data from 20 embodiments, spanning single-arm, dual-arm, and mobile robotic platforms equipped with dexterous hands or grippers. Based on the collected data, we employ a redesigned data processing pipeline to filter noisy samples, yielding 50,000 hours of high-quality robotic data.
译文
我们从 20 种本体上收集了约 90,000 小时的数据,涵盖配备灵巧手或夹爪的单臂、双臂和移动机器人平台。在此基础上,我们使用重新设计的数据处理流水线过滤噪声样本,最终得到 50,000 小时的高质量机器人数据。
解释
保留率约为 50{,}000/90{,}000\approx 56\%,也就是说有 4 万小时被判为低质量而丢弃。这一比例本身就说明真实采集(多为遥操作)数据中问题轨迹相当普遍:操作员犹豫停顿、传感器丢帧、时间戳不同步等都会产生“有害样本”,训练时会把模型往错误方向拉。
原文
We first compute the third-order finite difference (jerk) of the action and state signals, along with the Z-scores of their first-order derivatives (velocity) and second-order derivatives (acceleration), to assess trajectory smoothness. An episode is discarded if either the jerk or any derivative Z-score exceeds a predefined threshold. These thresholds are set separately for each embodiment.
译文
我们首先计算动作与状态信号的三阶有限差分(即加加速度,jerk),以及它们一阶导数(速度)和二阶导数(加速度)的 Z 分数,用以评估轨迹的平滑性。若加加速度或任一导数的 Z 分数超过预设阈值,则丢弃该回合(episode)。这些阈值针对每种本体分别设定。
解释
有限差分:对采样间隔为 \Delta t 的离散信号 q_k,速度近似为 v_k=(q_{k+1}-q_k)/\Delta t,加速度 a_k=(v_{k+1}-v_k)/\Delta t,加加速度 j_k=(a_{k+1}-a_k)/\Delta t。真实机械臂的运动受电机力矩限制,jerk 不可能无限大;若 jerk 出现尖峰,多半是传感器跳变、掉帧或数据拼接错误。 Z 分数:z=(x-\mu)/\sigma,衡量某个值偏离均值多少个标准差。例如某关节速度的均值为 0.1 rad/s、标准差 0.2 rad/s,某一时刻速度为 1.5 rad/s,则 z=7,远超常见阈值(如 3–5),说明这个点是异常跳变。 按本体设阈值的原因:工业臂(UR、Franka)与人形机器人的手臂在速度范围、控制频率(30 Hz 或 15 Hz,见表 1)上差异很大,用统一阈值要么误杀正常数据,要么漏掉异常。
原文
Moreover, we measure the duration within an episode during which all state and action signals exhibit only small variations or remain unchanged. If this duration accounts for more than 95% of the entire episode, the episode is also discarded.
译文
此外,我们统计一个回合中所有状态与动作信号都只有微小变化或保持不变的时长。若这段时长占整个回合的 95% 以上,该回合同样被丢弃。
解释
这条规则针对“几乎没动”的数据:例如一段 60 秒的录像里机器人只在最后 3 秒动了一下(静止占 95%),这类数据多来自采集失误或操作员忘记停止录制。若大量混入,模型会学到“什么都不做”也是合理动作,导致部署时机器人原地发呆。注意阈值很宽松(95%),正常任务中短暂的停顿不会被误删。
原表 Table 1. Statistical overview of robot manipulation data in LingBot-VLA-2.0.
译:表 1 LingBot-VLA-2.0 中机器人操作数据的统计概览。
译:表 1 LingBot-VLA-2.0 中机器人操作数据的统计概览。
| Robot Type | EE type | Hand/Gripper DoF | Arm DoF | Body DoF^* | Total DoF | Policy Freq. |
| Single-Arm Robots(单臂) | ||||||
| Franka | Gripper | 1 | 7 | 0 | 8 | 30 |
| Flexiv Rizon 4 | Gripper | 1 | 7 | 0 | 8 | 30 |
| Dual-Arm Robots(双臂) | ||||||
| AgileX | Gripper | 2 | 12 | 0 | 14 | 30 |
| ARX Lift2 | Gripper | 2 | 12 | 0 | 14 | 30 |
| UR7e | Gripper | 2 | 12 | 0 | 14 | 30 |
| Half-Humanoid(半人形) | ||||||
| AgiBot G1 | Gripper | 2 | 14 | 4 | 20 | 30 |
| Galbot G1 | Gripper | 2 | 14 | 6 | 22 | 30 |
| Moz1 | Gripper | 2 | 14 | 0 | 16 | 30 |
| Realman Rs-02 | Gripper | 2 | 14 | 1 | 17 | 30 |
| Galaxea R1Pro | Gripper | 2 | 14 | 7 | 23 | 15 |
| Galaxea R1Lite | Gripper | 2 | 12 | 3 | 17 | 15 |
| Astribot S1 | Gripper | 2 | 14 | 9 | 25 | 30 |
| Zerith H1 | Gripper | 2 | 14 | 7 | 23 | 30 |
| Humanoid(人形) | ||||||
| Leju KUAVO 4 Pro | Gripper/Hand | 2/12 | 14 | 5 | 21/31 | 30 |
| Tienkung | Gripper | 2 | 14 | 0 | 16 | 30 |
| QingLong | Gripper | 2 | 14 | 0 | 16 | 30 |
| MagicBot Gen1 | Gripper | 2 | 14 | 4 | 20 | 30 |
| Unitree G1 | Hand | 12 | 14 | 0 | 26 | 30 |
| Fourier GR-2 | Hand | 12 | 14 | 6 | 32 | 30 |
| AgiBot A2 | Hand | 12 | 14 | 2 | 28 | 30 |
| Humanoid(人类第一视角) | ||||||
| Ego | – | – | 14 | – | 14 | 30\sim60 |
| Total: 20 embodiments | 60000h | |||||
表 1 解读
列含义:Robot Type 为机器人型号;EE type 为末端执行器类型(Gripper 夹爪 / Hand 灵巧手);Hand/Gripper DoF 为末端自由度(夹爪每只 1 维开合,灵巧手每只 6 维,故双夹爪为 2、双灵巧手为 12);Arm DoF 为双臂关节总数(7 自由度臂 \times 2=14,6 自由度臂 \times 2=12);Body DoF 为手臂以外参与训练的躯体自由度(腰、头、底盘之和);Total DoF 为前三项之和;Policy Frequency 为策略输出频率(Hz)。行分组:单臂(2 种)、双臂(3 种)、半人形(8 种,有躯干/底盘但无腿)、人形(7 种)共 20 种本体;最后一行 Ego 为人类第一视角数据,不计入“20 种本体”。关键数字与验算:
- 合计列可逐行验证,如 Astribot S1:2+14+9=25;Fourier GR-2:12+14+6=32;KUAVO 4 Pro 两种末端:2+14+5=21 与 12+14+5=31。
- Astribot S1 的 Body DoF 为 9,正好等于图 9 中标注的“4 自由度躯干 + 2 自由度头部 + 3 自由度全向轮底盘”,也与 55 维规范向量中腰 4 + 头 2 + 移动 3 的槽位完全对应——它是唯一把这三类躯体槽位全部用满的本体。
- 星海图 R1Pro/R1Lite 的策略频率是 15 Hz,其余为 30 Hz;人类视频为 30–60 Hz(取决于原视频帧率)。频率不同意味着同样长度的动作块覆盖的真实时长不同,这也是需要按本体设定平滑阈值的原因之一。
- Ego 行的 14 维写在 “Arm DoF” 列,但从图 4 看,人类数据实际使用的是双手腕的末端位姿(EEF 7D\times2),而非关节角——人手视频无法得到机械臂意义上的关节角。表中归列可能只是排版上的简化。
原文
To verify consistency between the videos and state signals, we project the robot onto the image plane using the corresponding URDF and replay the recorded states. Human annotators are employed to identify discrepancies between the projected robot and the videos to ensure that the state signals and videos are correctly recorded, and samples with such misalignment are removed. Meanwhile, videos with blur, severe occlusions, dropped frames, or misalignment across multiple views are filtered out by human annotators during the annotation process.
译文
为了核验视频与状态信号之间的一致性,我们利用相应的 URDF 将机器人投影到图像平面上,并回放记录的状态。我们雇用人工标注员识别投影出的机器人与视频之间的差异,以确保状态信号和视频被正确记录,存在此类不一致的样本会被移除。同时,在标注过程中,标注员还会过滤掉存在模糊、严重遮挡、掉帧或多视角之间不同步的视频。
解释
URDF(Unified Robot Description Format)是描述机器人连杆、关节和几何外形的标准文件。已知每个关节角后,通过正运动学可以算出每个连杆在三维空间的位置,再用相机内外参投影到图像上,就得到“按记录状态应该出现在画面中的机器人轮廓”。如果投影出的轮廓与视频中真实机器人错位(例如手臂已经抬起而投影还停在桌面),说明状态与视频的时间戳没对齐或记录有误。这种错误对 VLA 尤其致命:模型学的是“看到这个画面 \to 做这个动作”,若画面和动作错开几百毫秒,模型学到的因果关系就是错的。这一步需要人工判断,成本较高,但作者认为值得。
3.1.2第一视角数据(Egocentric Data)
原文
We construct an egocentric human video pool of approximately 20,000 hours and retain around 10,000 hours of high-quality training data after filtering, reconstruction, standardization, and quality control. We first apply a unified video-level VLM pre-filter to all candidate videos, regardless of source. This step removes videos that do not satisfy the egocentric manipulation assumption, such as third-person observation videos, scene-walking videos, videos without clear hand-object interaction, or videos without manipulable objects.
译文
我们构建了一个约 20,000 小时的人类第一视角视频池,经过过滤、重建、标准化与质量控制后,保留约 10,000 小时的高质量训练数据。我们首先对所有候选视频(无论来源)施加统一的视频级 VLM 预筛选。这一步会移除不满足“第一视角操作”假设的视频,例如第三人称观察视频、在场景中行走的视频、没有清晰手–物交互的视频,或者没有可操作物体的视频。
解释
人类第一视角视频(头戴相机拍摄,画面里是拍摄者自己的双手)是机器人数据的廉价补充:人戴个相机做家务就能采集,规模远大于机器人遥操作。但网上和公开数据集中的视频质量参差不齐,所以第一步用 VLM 对整段视频做“是否符合要求”的判断,只保留“我在看我自己的手在操作物体”的视频。“走路视频”被排除是因为其中几乎没有手部操作,对学习操作技能贡献有限。
原文
We also filter out videos where non-operator hands appear prominently, since such clips can break the association between the camera wearer's observation and the corresponding hand motion. Applying this VLM filtering stage before downstream processing reduces unnecessary annotation and reconstruction cost, especially for action-free videos that would otherwise require SLAM and hand pose estimation.
译文
我们还会过滤掉非操作者的手显著出现的视频,因为这类片段会破坏“相机佩戴者的观测”与“相应手部运动”之间的对应关系。在下游处理之前进行这一 VLM 过滤,可以减少不必要的标注与重建成本——尤其是那些没有动作标签、否则就需要运行 SLAM 和手部姿态估计的视频。
解释
两点理由:(1) 语义一致性:模型要学“看到这幅画面 \to 我的手该怎么动”,画面里若同时出现别人的手,手部检测可能把别人的手当成自己的,生成错误的动作标签;(2) 成本:SLAM 与手部重建是逐帧的重计算,先用便宜的 VLM 判断扔掉不合格视频,再对剩下的做重建,是典型的“先粗筛后精处理”的流水线设计。
原文
After VLM pre-filtering, we process the remaining data according to whether action or hand trajectory labels are available. For data with existing action or hand trajectory labels, including action-labeled open-source datasets and in-house data, we perform metadata organization, timestamp alignment, coordinate transformation, and trajectory completeness checking, converting all samples into a standardized hand trajectory format. For action-free egocentric human videos, we run egocentric SLAM to estimate camera intrinsics and per-frame camera extrinsics, and then apply hand pose estimation to recover MANO parameters in the camera coordinate frame. By combining the estimated hand poses with camera poses, we lift the hand motion into the world coordinate frame and obtain temporally continuous hand trajectories.
译文
VLM 预筛之后,我们根据是否有动作或手部轨迹标签来处理剩余数据。对于已有动作或手部轨迹标签的数据(包括带动作标注的开源数据集和内部数据),我们进行元数据整理、时间戳对齐、坐标变换和轨迹完整性检查,把所有样本转换为标准化的手部轨迹格式。对于没有动作标签的人类第一视角视频,我们运行第一视角 SLAM 来估计相机内参和逐帧的相机外参,然后进行手部姿态估计,恢复相机坐标系下的 MANO 参数。将估计的手部姿态与相机位姿结合,我们把手部运动提升到世界坐标系中,得到时间上连续的手部轨迹。
解释
两条处理路径:有标签的(例如用动捕手套或 VR 设备采集的数据)只需做格式统一;无标签的纯视频要“从像素中恢复动作”。
- SLAM(同步定位与建图):从视频中估计相机在每一帧的位置与朝向(外参),以及焦距、主点等内参。头戴相机随头转动,必须知道相机自身怎么动,才能把“手在画面里的移动”和“头在转”区分开。
- MANO:一种参数化手部模型,用约 45 维关节旋转 + 10 维形状参数 + 全局位姿描述一只手的完整三维形态。手部姿态估计网络从图像回归出 MANO 参数,得到手在相机坐标系下的位姿。
- 提升到世界坐标系:手在世界中的位姿 = 相机位姿 \times 手在相机中的位姿。这样即使头在晃动,世界系里的手部轨迹仍然平滑连续。
原文
We then apply trajectory-level quality control to the reconstructed and standardized data. We filter out videos with insufficient valid hand pose coverage, using a 20% valid-frame ratio as the minimum threshold. We also remove clips with unstable SLAM trajectories, identified by abnormal second-order changes in the estimated camera motion, such as sudden translational or rotational acceleration. In addition, we reject hand trajectories with sudden discontinuities, abnormal displacement, velocity, acceleration, or jerk, as well as samples that violate human physiological constraints, such as unreasonable hand positions, inter-hand distances, motion ranges, or poses.
译文
接着,我们对重建与标准化后的数据施加轨迹级质量控制。我们以 20% 的有效帧比例作为最低阈值,过滤掉有效手部姿态覆盖不足的视频。我们还移除 SLAM 轨迹不稳定的片段,即估计的相机运动出现异常二阶变化(例如突然的平移或旋转加速度)的片段。此外,我们剔除存在突变不连续,或位移、速度、加速度、加加速度异常的手部轨迹,以及违反人体生理约束的样本,例如不合理的手部位置、双手间距、运动范围或姿态。
解释
三类质控规则: (1) 覆盖率:若一段视频中能成功检测到手的帧不到 20%(例如手经常出画或被遮挡),就整段丢弃。这个阈值相当宽松,说明作者更看重“别丢太多数据”,有效帧之外的部分可能通过插值或掩码处理(原文未说明)。 (2) SLAM 稳定性:人头的运动有惯性,相机位姿的二阶导(加速度)不会突然很大;若出现,往往是 SLAM 跟踪丢失后重定位造成的“跳变”,此时整个世界坐标系都不可信。 (3) 生理约束:例如双手间距超过 2 米、手腕关节弯折超出人体极限,这类结果必然是估计错误。用物理/生理常识做“合理性检查”,是从噪声估计中筛出可信数据的常用手段。
原文
Finally, all valid samples are stored as hand trajectories in the world coordinate frame. During training, when a frame is sampled as the current observation, we transform the future hand trajectory from the world coordinate frame into the current camera coordinate frame using the camera extrinsic of that frame:
译文
最后,所有有效样本都以世界坐标系下的手部轨迹形式存储。训练时,当某一帧被采样为当前观测,我们利用该帧的相机外参,把未来的手部轨迹从世界坐标系变换到当前相机坐标系:
解释
这里引出一个关键设计:存储用世界系,训练用当前相机系。下面的式 (1) 给出具体变换。
原文
\mathbf{p}^{C_t}_{\tau} = \mathbf{T}_{C_t\leftarrow W}\,\mathbf{p}^{W}_{\tau}. \qquad (1)
Here, \mathbf{p}^{W}_{\tau} denotes the hand trajectory in the world coordinate frame, and \mathbf{T}_{C_t\leftarrow W} denotes the transformation from the world coordinate frame to the camera coordinate frame of the sampled frame t. With this design, the world coordinate frame serves as the unified trajectory storage space, while the current camera coordinate frame serves as the training-time action representation. This unifies trajectory formats across open-source and in-house egocentric human videos, and decouples hand motion from egocentric camera motion during training. 译文
\mathbf{p}^{C_t}_{\tau} = \mathbf{T}_{C_t\leftarrow W}\,\mathbf{p}^{W}_{\tau}. \qquad (1)
其中,\mathbf{p}^{W}_{\tau} 表示世界坐标系下的手部轨迹,\mathbf{T}_{C_t\leftarrow W} 表示从世界坐标系到所采样帧 t 的相机坐标系的变换。借助这一设计,世界坐标系充当统一的轨迹存储空间,而当前相机坐标系充当训练时的动作表示。这统一了开源与内部第一视角人类视频的轨迹格式,并在训练中将手部运动与第一视角相机运动解耦。 解释
符号:\tau 是未来时间步(\tau=t, t+1,\dots,t+T,覆盖一个动作块);\mathbf{p}^{W}_{\tau} 是第 \tau 步手腕在世界系下的位姿(位置 + 朝向,对应图 4 中 EGO 的 7D 末端位姿);\mathbf{T}_{C_t\leftarrow W}\in SE(3) 是 4\times 4 齐次变换矩阵,即第 t 帧相机外参(相机到世界变换)的逆。关键点:变换矩阵用的是当前帧 t 的相机位姿,并对整段未来轨迹都用同一个矩阵。也就是说,未来的手部位置被表达在“此刻我眼睛看出去”的坐标系里,而不是“未来每一刻的眼睛”坐标系里。为什么这样做: (1) 机器人的动作通常表达在机器人基座或头部相机坐标系下,用“当前相机系”表达人手动作,使其在形式上接近机器人的“相对于当前观测的末端目标”; (2) 若在每一帧各自的相机系下表示,头一转,手的坐标就跟着变,模型会把“头动”误读为“手动”,这就是所说的“解耦手部运动与相机运动”; (3) 世界系存储一次,训练时任意帧都可当作当前帧现场变换,节省存储并便于灵活采样。小例子:设当前帧相机位于世界原点、朝向 +z;未来 1 秒手从世界坐标 (0.1, 0, 0.5) 移到 (0.1, 0, 0.3)(向自己拉近 20 cm)。即使这 1 秒内人把头向左转了 30°,在当前相机系下这段轨迹仍是“沿视线方向后退 20 cm”,干净地描述了手的意图。
3.1.3统一动作表示(Unified Action Representation)
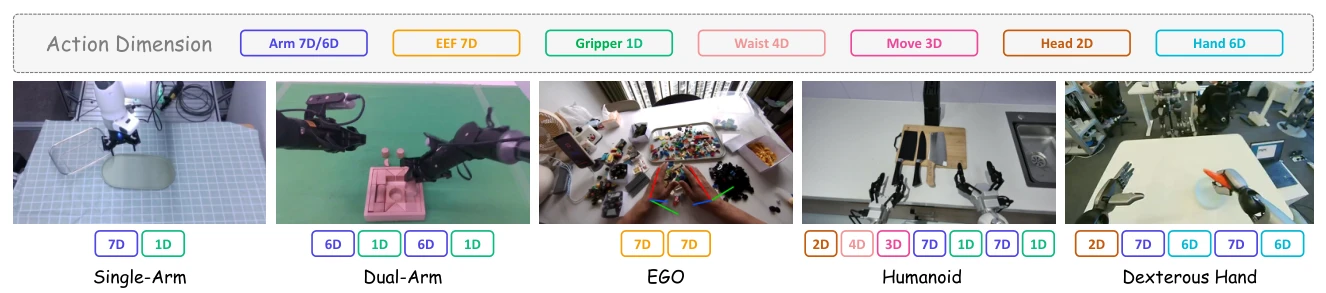
原图注:Figure 4. Unified action representation. We map heterogeneous embodiment controls into compact action vectors composed of shared body-part components.
译文图注:图 4:统一动作表示。我们把异构本体的控制量映射为由共享身体部件分量组成的紧凑动作向量。图 4 解读
顶部 “Action Dimension(动作维度)”一行是 7 类分量的图例:Arm 7D/6D(手臂关节)、EEF 7D(末端位姿)、Gripper 1D(夹爪)、Waist 4D(腰)、Move 3D(底盘移动)、Head 2D(头)、Hand 6D(灵巧手)。下方 5 张示例画面及其下的彩色小框表示该类本体用到哪些分量:
- Single-Arm(单臂):7D 关节 + 1D 夹爪;
- Dual-Arm(双臂):6D 关节 + 1D 夹爪,左右各一组(共 14 维);
- EGO(人类第一视角):只有两个 7D 末端位姿(左右手腕,橙色),画面中彩色线条即重建出的手腕坐标轴;
- Humanoid(人形/半人形):2D 头 + 4D 腰 + 3D 移动 + 左右各 7D 关节 + 1D 夹爪;
- Dexterous Hand(灵巧手):2D 头 + 左右各 7D 关节 + 6D 灵巧手。
原文
To jointly learn state and action representations from egocentric data and robotic data collected across multiple embodiments, we use a 55-dimensional canonical vector representation for both states and actions. This representation consists of 14 dimensions for arm joint position, 14 dimensions for end-effector pose, 2 dimensions for gripper position, 12 dimensions for hand joint position, 4 dimensions for waist position, 2 dimensions for head position, and 3 dimensions for mobility signal, as shown in Fig. 4. The remaining 4 dimensions are reserved.
译文
为了从第一视角数据和跨多种本体采集的机器人数据中联合学习状态与动作表示,我们对状态和动作都采用一个 55 维的规范向量(canonical vector)表示。该表示包括 14 维手臂关节位置、14 维末端执行器位姿、2 维夹爪位置、12 维灵巧手关节位置、4 维腰部位置、2 维头部位置,以及 3 维移动信号,如图 4 所示。其余 4 维保留备用。
解释
维度验算:14+14+2+12+4+2+3=51,加 4 维保留共 55 维。各项拆解:手臂关节 7\times2;末端位姿 7\times2(见下段);夹爪 1\times2;灵巧手 6\times2;腰 4(例如俯仰、偏航、升降等组合);头 2(俯仰 + 偏航);移动 3(平面底盘的 v_x, v_y, \omega_z,即前后、左右速度与转向角速度——全向底盘三者都用,差速底盘没有 v_y)。 状态和动作用同一个向量格式,便于模型把“当前在哪”和“要去哪”放在同一坐标体系里比较,也方便使用相对动作(动作 = 目标 - 当前状态,见第 6.1 节)。保留 4 维是为将来扩展(如新的身体部件)预留接口,无需改变网络输入输出维度。
原文
The arm joint position and end-effector pose fields are defined to accommodate the maximum dimensionality of a dual-arm embodiment. Specifically, the end-effector pose of each arm is represented by XYZ coordinates and a rotation quaternion, resulting in 7 dimensions per arm. For single-arm data, only 6 or 7 dimensions are used for arm joint positions and 7 dimensions for the end-effector pose, while the remaining arm-related dimensions are padded. Similarly, for robot embodiments that do not include specific body parts or have lower-dimensional signals, the corresponding dimensions are also padded. The dimensional configurations for each embodiment are shown in Tab. 1.
译文
手臂关节位置与末端执行器位姿两个字段按双臂本体的最大维度来定义。具体而言,每条手臂的末端位姿由 XYZ 坐标和一个旋转四元数表示,因此每条手臂占 7 维。对于单臂数据,手臂关节位置只使用 6 或 7 维、末端位姿使用 7 维,其余与手臂相关的维度进行填充(padding)。类似地,对于不具备某些身体部件或信号维度较低的机器人本体,相应维度也会被填充。各本体的维度配置见表 1。
解释
四元数(q_x,q_y,q_z,q_w) 是表示三维旋转的 4 个数(满足 \|q\|=1),比欧拉角没有万向锁问题,3 维位置 + 4 维四元数 = 7 维。 填充:6 自由度臂(如 AgileX、UR7e)的关节只填 6 个槽位,第 7 个槽位补零;单臂机器人的“右臂”整段补零。训练时通常还会配合一个掩码(mask),使填充维度不计入损失,否则模型会白白学习预测一堆零。原文没有明说是否使用掩码,但这是此类统一动作空间的常规做法。 代价:同一个槽位在不同本体上的物理含义并不完全一致(例如 Franka 第 4 关节和天工第 4 关节的运动学作用不同),模型需要通过视觉和状态上下文来分辨当前是哪种本体。这也是作者采用 MoE 增加容量的动机之一。
3.2数据标注(Data Annotation)
原文
VLA pretraining benefits from manipulation videos paired with temporally aligned language supervision at both the task and subtask levels. We generate these annotations with a fully automated pipeline built on a vision–language model, and apply this pipeline across the pretraining dataset.
译文
VLA 预训练受益于这样的操作视频:它们在任务级和子任务级两个层面都配有时间对齐的语言监督。我们用一个基于视觉–语言模型的全自动流水线生成这些标注,并将该流水线应用于整个预训练数据集。
解释
为什么需要子任务级标注:一个长任务(例如“整理桌面”)往往持续几十秒到几分钟,只给一句总指令时,模型很难知道当前这一秒该做哪一步。把视频切成“拿起杯子 \to 放进柜子 \to 关柜门”等带时间边界的子段,并给每段配一句短指令,相当于给模型提供了更细粒度的“当前目标”。6 万小时数据人工逐段标注成本过高,因此采用 VLM 全自动标注。
原表 Table 2. Closed vocabulary for subtask annotation. The vocabulary consists of 15 primitive manipulation actions and three auxiliary labels: transit for empty-hand motion, idle for stationary arms, and other for out-of-vocabulary actions.
译:表 2 子任务标注所用的封闭词表。词表包括 15 个原子操作动作和 3 个辅助标签:transit 表示空手移动,idle 表示手臂静止,other 表示词表之外的动作。
译:表 2 子任务标注所用的封闭词表。词表包括 15 个原子操作动作和 3 个辅助标签:transit 表示空手移动,idle 表示手臂静止,other 表示词表之外的动作。
| Action | Description(释义) | Action | Description(释义) |
| Primitive manipulation actions(原子操作动作) | |||
| move | Relocate an object(移动物体到新位置) | fold | Shrink flexible material(折叠柔性材料) |
| pour | Tilt a container to dispense contents(倾倒容器内容物) | unfold | Expand flexible material(展开柔性材料) |
| push | Slide an unheld object(推动未被握持的物体) | wipe | Move a tool across a surface(用工具擦拭表面) |
| pull | Draw an object closer(把物体拉近) | stir | Move a tool circularly in a container(在容器内搅拌) |
| rotate | Turn an object in place(原地旋转物体) | cut | Sever a target with a blade(用刀切开目标) |
| open | Open a hinged or articulated object(打开铰接物体) | press | Press a button, switch, or surface(按压按钮/开关/表面) |
| close | Close a hinged or articulated object(关闭铰接物体) | attach | Insert or connect an object to a fitting(插入/连接到配件) |
| detach | Remove or disconnect an object from a fitting(从配件上取下/断开) | ||
| Auxiliary labels(辅助标签) | |||
| transit | Move the gripper without object interaction(夹爪空载移动) | idle | Keep the arms stationary(手臂静止) |
| other | Action outside the vocabulary(词表外的动作) | ||
表 2 解读
结构:左右两栏并排排列“动作名 + 释义”,上半部分是 15 个原子操作动作,下半部分是 3 个辅助标签,合计 18 类。 设计思路:
- 动词按“物体发生了什么变化”来划分,而不是按“手怎么动”。例如 move(换位置)、rotate(换朝向)、open/close(铰接关节状态改变)、fold/unfold(柔性物体形状改变)、attach/detach(与配件的连接关系改变)。这种划分对语言指令生成更友好。
- 成对出现的动作(open/close、fold/unfold、attach/detach、push/pull)互为逆操作,便于覆盖“做 + 撤销”的完整技能空间。
- 辅助标签解决“非操作时段”的归属:transit 是两次操作之间的空手移动(例如手伸向下一个物体),idle 是静止,other 兜底处理罕见动作。
原文
Specifically, we employ Qwen3.6-27B [25] to segment each manipulation video into a sequence of temporally contiguous subtasks and to generate the corresponding language instructions. For robotic platforms with multiple cameras, the overhead and wrist views are processed jointly to disambiguate gripper–object interactions. Each subtask is assigned an atomic action from a closed vocabulary of 18 categories (Tab. 2), together with the primary object of interaction and a concise instruction. In addition, a single video-level instruction summarizes the overall task. The annotated objects form a diverse, open vocabulary, as visualized in Fig. 6.
译文
具体而言,我们使用 Qwen3.6-27B [25] 把每段操作视频切分为一系列时间上连续的子任务,并生成相应的语言指令。对于配有多个相机的机器人平台,俯视视角与腕部视角会被联合处理,以消除夹爪–物体交互的歧义。每个子任务被赋予一个来自 18 类封闭词表(表 2)的原子动作,并附上主要交互物体和一句简洁的指令。此外,还有一条视频级指令概括整体任务。标注出的物体构成一个多样的开放词表,如图 6 所示。
解释
每个子任务的标注内容可以理解为一个三元组 + 一句话:\langle动作类别, 主物体, 时间区间\rangle + 自然语言指令,例如 \langle
open, microwave door, 3.2–7.8 s\rangle +“打开微波炉门”。 多视角联合:俯视相机看得到全局布局,但夹爪是否真的夹住物体常被遮挡;腕部相机近距离能看清接触细节但缺乏全局信息。两者一起喂给 VLM,才能可靠判断“抓到了没有”,从而准确定位子任务边界。 “时间上连续”:子任务段首尾相接,覆盖整个视频,不留空隙——空隙部分由 transit/idle 等辅助标签填补。原文
To keep the segmentation granularity consistent, the model groups the grasp, carry, and release phases of a single interaction into one subtask, and introduces a temporal boundary only when the manipulated object changes, the action type changes, or a sustained pause marks a transition to a new sub-goal. As summarized in Fig. 5, move and transit dominate in frequency, whereas fine-grained manipulations such as cut, fold, and stir are rare but have considerably longer mean durations.
译文
为了保持切分粒度的一致性,模型把一次交互中的抓取、搬运和释放阶段归为一个子任务,只有在被操作物体改变、动作类型改变,或出现持续停顿标志着转向新的子目标时,才引入时间边界。如图 5 所总结,move 和 transit 在频次上占主导,而 cut、fold、stir 等精细操作虽然罕见,但平均时长明显更长。
解释
粒度规则:VLM 标注最常见的问题是切分粒度忽粗忽细——同一个“把杯子放到盘子上”,有时被切成“伸手/抓取/抬起/移动/放下”五段,有时只有一段。作者明确规定“抓–运–放”算一个子任务,只在三种情况下切分:换物体、换动作、长时间停顿。这样相同语义的操作在不同视频里长度可比,便于模型学习。 分布特点:move 占全部子任务的 46%,transit 占 42%,二者合计近九成,说明真实操作数据以“搬东西”为主体;cut、fold、stir 等长尾动作样本少、单次耗时长,是模型最难学好的部分。这类长尾不平衡也解释了后文实验中部分精细任务成功率偏低的现象。
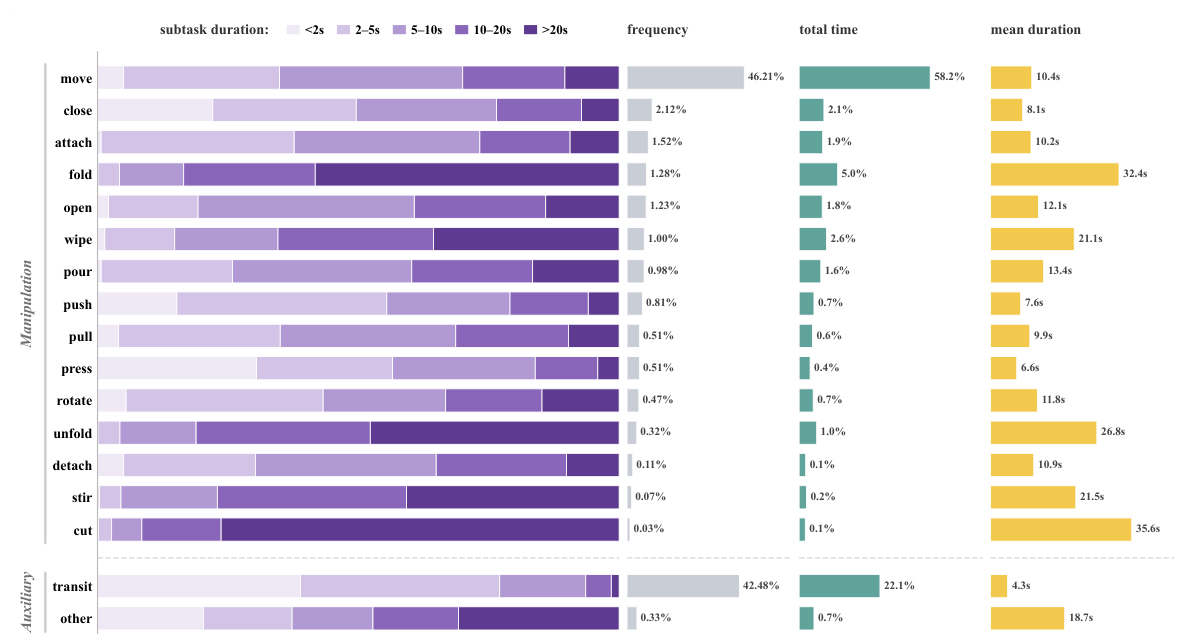
原图注:Figure 5. Per-action statistics of the subtask annotations: duration composition, frequency (fraction of all subtasks), total time (fraction of the total annotated time), and mean duration. Actions are grouped as in Tab. 2; idle is filtered out of the training data and omitted here.
译文图注:图 5:子任务标注的逐动作统计,包括时长构成、频次(占全部子任务的比例)、总时长(占全部已标注时长的比例)和平均时长。动作分组同表 2;idle 已从训练数据中过滤,此处未列出。图 5 解读
图由左至右四个并排面板,纵轴为 17 个动作类别(上方 15 个为 Manipulation 原子操作,下方 2 个为 Auxiliary 辅助标签;idle 已剔除)。
- 时长构成(紫色堆叠条,横轴 0–100%):每个动作的子任务按时长分成 <2 s、2–5 s、5–10 s、10–20 s、>20 s 五档,颜色由浅到深。例如 cut、fold、unfold、stir 的深紫(>20 s)段占一半以上;transit、press、close 则以浅色短时段为主。
- 频次(灰条):move 46.21%、transit 42.48% 遥遥领先,其余依次为 close 2.12%、attach 1.52%、fold 1.28%、open 1.23%、wipe 1.00% 等,最少的 cut 只有 0.03%。
- 总时长占比(绿条):move 58.2%、transit 22.1%、fold 5.0%、wipe 2.6%。transit 的频次占比(42.5%)远高于时长占比(22.1%),因为它的单段很短;fold 恰相反,频次 1.28% 却占了 5.0% 的时间。
- 平均时长(黄条):cut 35.6 s、fold 32.4 s、unfold 26.8 s、stir 21.5 s、wipe 21.1 s 最长;transit 4.3 s、press 6.6 s、push 7.6 s 最短;move 为 10.4 s。
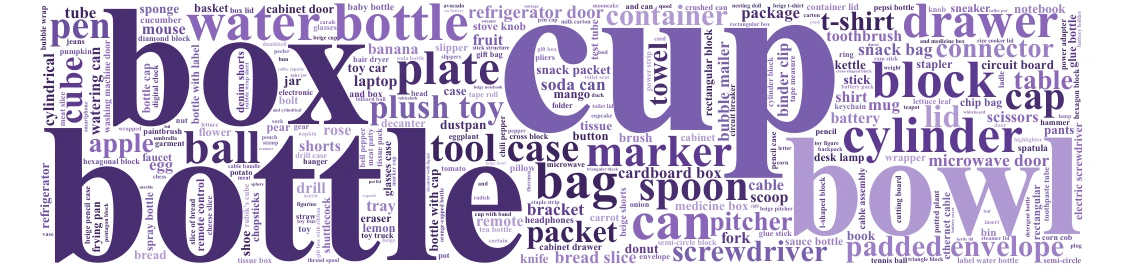
原图注:Figure 6. Word cloud of the manipulated objects in the subtask annotations, sized by frequency.
译文图注:图 6:子任务标注中被操作物体的词云,字号按出现频率缩放。图 6 解读
词云中字号越大表示该物体在子任务标注里出现越频繁。最大的几个词是 box(盒子)、cup(杯子)、bottle(瓶子)、bowl(碗),其次是 water bottle、plate、block(积木块)、drawer(抽屉)、cylinder、can(罐子)、bag、marker、spoon、towel、t-shirt、screwdriver 等;小字号区域还有 refrigerator door、microwave door、egg、scissors、knife、cable、laptop 等上百种物体。 读出的信息:(1) 日常家居与桌面物体占主体,与 GM-100 及长时程实验中的物体(积木、钥匙扣、勺子、鸡蛋、冰箱门、微波炉门等)高度重叠;(2) 同时包含刚体(杯、盒)、柔性物体(毛巾、T 恤、裤子)、铰接物体(抽屉、冰箱门)、工具(螺丝刀、剪刀、刀),覆盖面较广;(3) 原始标签中能看到 “and box”“beige”“and”等残片,说明自动标注的物体名存在少量切分噪声,作者未做进一步清洗。
4方法(Method)
4.1基于 MoE 的 VLA 模型(MoE-based VLA model)
原文
Vision-Language-Action (VLA) models pretrained on real-world cross-embodiment robot data must learn from heterogeneous trajectories characterized by misaligned action spaces, varying embodiment dynamics, and task distributions. Although the Mixture-of-Experts (MoE) mechanism provides a natural way to scale model capacity, the underlying reasons for its effectiveness in VLA pretraining remain poorly understood.
译文
在真实世界跨本体机器人数据上预训练的视觉–语言–动作(VLA)模型,必须从异构轨迹中学习,这些轨迹的特点是动作空间不对齐、本体动力学各异、任务分布不同。尽管混合专家(MoE)机制为扩展模型容量提供了一种自然途径,但它在 VLA 预训练中为何有效,其深层原因仍缺乏充分理解。
解释
这一段交代动机:第 3 节的数据把 20 种机器人和人手视频混在一起,同一个 55 维槽位在不同本体上动力学含义不同,单个稠密网络要用同一组参数拟合所有本体,容易相互干扰(“负迁移”)。MoE 允许不同 token 走不同参数子集,有望缓解干扰。作者也坦承“为什么有效”尚不清楚,本节后面的缩放实验只是经验证据。
原文
In this report, we introduce a token-level loss-free MoE architecture for large-scale multi-embodiment VLA pretraining. By decoupling expert load balancing from the primary action-learning objective, and employing sigmoid-based routing confidence to allow each token to independently activate multiple experts, our design enables sparse experts to capture general representations and control logic shared across embodiments.
译文
在本报告中,我们为大规模多本体 VLA 预训练引入一种 token 级、无(辅助)损失的 MoE 架构。通过将专家负载均衡与主要的动作学习目标解耦,并采用基于 sigmoid 的路由置信度,使每个 token 能独立地激活多个专家,我们的设计让稀疏专家能够捕获跨本体共享的通用表征与控制逻辑。
解释
两个关键词: (1) loss-free:指“不使用辅助负载均衡损失”,并不是没有训练损失; (2) sigmoid 路由:softmax 打分时所有专家的分数之和为 1,一个专家分数高必然压低其他专家,彼此“竞争”;sigmoid 对每个专家独立打 0–1 的分,一个 token 可以同时对多个专家都有高亲和度,所以说“独立地激活多个专家”。作者希望的效果是:专家不按本体硬切分,而是学出跨本体可复用的“控制逻辑”(例如“接近物体时减速”这类规律)。
原文
Sparse MoE Architecture. To facilitate convergence during cross-embodiment pretraining, we instantiate sparse MoE layers inside the action expert, which replace the feed-forward network (FFN) in the action expert. In our default configuration, all action-expert transformer blocks are equipped with MoE FFNs. Furthermore, we adopt fine-grained expert segmentation and shared expert isolation, in which a lightweight shared expert preserves universal priors, while a set of routed experts provides specialized modeling capacity.
译文
稀疏 MoE 架构。为了促进跨本体预训练的收敛,我们在动作专家内部实例化稀疏 MoE 层,用它替换动作专家中的前馈网络(FFN)。在默认配置下,动作专家的所有 Transformer 块都配备 MoE FFN。此外,我们采用细粒度专家切分(fine-grained expert segmentation)与共享专家隔离(shared expert isolation):一个轻量的共享专家保留通用先验,而一组路由专家提供专门化的建模容量。
解释
放在哪里:MoE 只加在动作专家里,理解专家(VLM)保持稠密。原因是本体异构性主要体现在动作端,VLM 处理图像和语言,不同本体之间差异较小。 替换什么:Transformer 块 = 注意力 + FFN,MoE 只替换 FFN,注意力层不变。 两个来自 DeepSeekMoE 的技巧: 细粒度切分——把一个大专家拆成多个更窄的小专家,同样的激活参数下可以组合出更多种专家组合(例如从 64 个小专家中选 8 个,组合数远多于从 8 个大专家中选 1 个),分工更灵活; 共享专家隔离——留一个所有 token 都必经的共享专家,负责公共知识,这样路由专家不必各自重复学习公共部分,能更专注于差异化的部分。 “modulated FFN input(被调制的 FFN 输入)”在下一段出现,指 FFN 的输入经过了与流匹配时间步相关的调制(如 adaLN),这是扩散/流匹配动作头的常见做法。
原文
Given the modulated FFN input u_{\ell,t}\in\mathbb{R}^d of token t at layer \ell, the MoE layer computes
m_\ell(u_{\ell,t}) = E^{(s)}_\ell(u_{\ell,t}) + \lambda \sum_{j\in\mathcal{R}(u_{\ell,t})} g_{\ell,j}(u_{\ell,t})\,E^{(r)}_{\ell,j}(u_{\ell,t}), \qquad (2)
where E^{(s)}_\ell(\cdot) denotes the shared expert, E^{(r)}_{\ell,j}(\cdot) denotes the j-th routed expert, \mathcal{R}(u_{\ell,t}) is the selected top-K routed expert set, and \lambda is a routed-output scaling factor. Each shared or routed expert is implemented as a SwiGLU MLP: E(u) = W_{\mathrm{down}}\left(\mathrm{SiLU}(W_{\mathrm{gate}}u)\odot W_{\mathrm{up}}u\right). \qquad (3)
译文
给定第 \ell 层 token t 的被调制 FFN 输入 u_{\ell,t}\in\mathbb{R}^d,MoE 层计算
m_\ell(u_{\ell,t}) = E^{(s)}_\ell(u_{\ell,t}) + \lambda \sum_{j\in\mathcal{R}(u_{\ell,t})} g_{\ell,j}(u_{\ell,t})\,E^{(r)}_{\ell,j}(u_{\ell,t}), \qquad (2)
其中 E^{(s)}_\ell(\cdot) 表示共享专家,E^{(r)}_{\ell,j}(\cdot) 表示第 j 个路由专家,\mathcal{R}(u_{\ell,t}) 是被选中的 top-K 路由专家集合,\lambda 是路由输出的缩放因子。每个共享专家或路由专家都实现为一个 SwiGLU MLP: E(u) = W_{\mathrm{down}}\left(\mathrm{SiLU}(W_{\mathrm{gate}}u)\odot W_{\mathrm{up}}u\right). \qquad (3)
解释
式 (2) 逐项:输出 = 共享专家输出(每个 token 必经) + \lambda\times(被选中的 K 个路由专家输出的加权和)。权重 g_{\ell,j} 由式 (6) 给出,对选中的专家归一化到和为 1。\lambda 用来平衡共享路径与路由路径的量级:若 \lambda 偏小,模型主要依赖共享专家,路由专家形同虚设;偏大则路由部分主导,初期训练可能不稳。DeepSeek-V3 中类似的因子称为 routed scaling factor。式 (3) SwiGLU:W_{\mathrm{gate}},W_{\mathrm{up}}\in\mathbb{R}^{h\times d} 把 d 维输入升到中间宽度 h,W_{\mathrm{down}}\in\mathbb{R}^{d\times h} 再降回 d 维;\mathrm{SiLU}(x)=x\cdot\sigma(x) 是平滑激活函数;\odot 是逐元素乘法。“门控”分支 \mathrm{SiLU}(W_{\mathrm{gate}}u) 决定“上行”分支 W_{\mathrm{up}}u 中每一维放行多少。这是 LLaMA、Qwen 等模型的标准 FFN 形式,参数量为 3dh。计算量直觉:若稠密 FFN 中间宽度为 H,MoE 中每个专家宽度为 h<H,每个 token 只经过 1+K 个专家,则激活计算量约为 (1+K)h 对比 H。只要 (1+K)h\approx H,就能做到“激活参数相同、总参数更多”,这正是后面缩放实验中“1.6B 总参数、0.6B 激活”的含义。
原文
Compared with the dense FFN counterpart, both the shared and routed experts employ a smaller intermediate width, encouraging shared experts to capture general principles and routed experts to provide stronger specialization. In practice, we use one shared expert and N_r routed experts per MoE layer; only K routed experts are activated for each token. For token-choice routing, we compute router logits with a linear router in FP32:
z_{\ell,j}(u_{\ell,t}) = u_{\ell,t}^{\top} e_{\ell,j}, \qquad (4)
where e_{\ell,j} is the learnable router embedding of the j-th routed expert. To avoid the strong competition among experts induced by softmax normalization, we apply a sigmoid-activated function to the router logits following DeepSeek-V3 [19], the token-to-expert affinity is defined as s_{\ell,j}(u_{\ell,t}) = \mathrm{Sigmoid}\big(z_{\ell,j}(u_{\ell,t})\big). \qquad (5)
译文
与对应的稠密 FFN 相比,共享专家和路由专家都采用更小的中间宽度,以促使共享专家捕获通用规律、路由专家提供更强的专门化。实践中,我们在每个 MoE 层使用 1 个共享专家和 N_r 个路由专家;每个 token 只激活 K 个路由专家。对于 token 选择专家(token-choice)的路由方式,我们用一个 FP32 精度的线性路由器计算路由 logit:
z_{\ell,j}(u_{\ell,t}) = u_{\ell,t}^{\top} e_{\ell,j}, \qquad (4)
其中 e_{\ell,j} 是第 j 个路由专家的可学习路由嵌入。为了避免 softmax 归一化带来的专家间强竞争,我们遵循 DeepSeek-V3 [19],对路由 logit 施加 sigmoid 激活函数,token 对专家的亲和度定义为 s_{\ell,j}(u_{\ell,t}) = \mathrm{Sigmoid}\big(z_{\ell,j}(u_{\ell,t})\big). \qquad (5)
解释
token-choice vs. expert-choice:token-choice 是每个 token 挑自己的 K 个专家(可能导致某些专家过载);expert-choice 是每个专家挑自己处理的 token(天然均衡,但一个 token 可能被零个专家选中,且在自回归/因果设置下不便使用)。本文用前者,因此需要额外的负载均衡机制。式 (4):路由器就是一个无偏置的线性层,e_{\ell,j}\in\mathbb{R}^d 可以看作专家 j 的“代表向量”,logit 是 token 表征与它的内积——越相似,越倾向于选这个专家。用 FP32 计算是因为训练通常在 BF16 下进行,而路由 logit 的微小差异会决定 Top-K 排名,低精度舍入可能导致路由抖动、训练不稳。式 (5) 为什么用 sigmoid:softmax 下 \sum_j s_j=1,假设有 64 个专家,平均每个分数只有约 0.016,而且一个专家分数升高会压低其余专家;sigmoid 下每个 s_j\in(0,1) 独立,不存在“零和”关系。注意 sigmoid 输出并不归一化,所以需要式 (6) 在选中的专家上重新归一化得到混合权重。
原文
To preserve the primary objective of action control learning in VLA models, we adopt an auxiliary-loss-free strategy inspired by DeepSeek-V3 [19] to promote load balancing within the MoE architecture. Under auxiliary-loss-free balancing, each expert maintains a routing correction bias b_{\ell,j}. The actual mixture weights are still computed from the original unbiased affinities:
g_{\ell,j}(u_{\ell,t}) = \frac{s_{\ell,j}(u_{\ell,t})}{\sum_{k\in\mathcal{R}(u_{\ell,t})} s_{\ell,k}(u_{\ell,t})}, \quad j\in\mathcal{R}(u_{\ell,t}), \qquad (6)
while the selected routed expert set is determined by biased affinities: \mathcal{R}(u_{\ell,t}) = \mathrm{TopK}_j\big(s_{\ell,j}(u_{\ell,t}) + b_{\ell,j},\ K\big). \qquad (7)
译文
为了保住 VLA 模型中动作控制学习这一主要目标,我们受 DeepSeek-V3 [19] 启发,采用无辅助损失策略来促进 MoE 架构内的负载均衡。在无辅助损失均衡下,每个专家维护一个路由修正偏置 b_{\ell,j}。实际的混合权重仍然由原始的、未加偏置的亲和度计算:
g_{\ell,j}(u_{\ell,t}) = \frac{s_{\ell,j}(u_{\ell,t})}{\sum_{k\in\mathcal{R}(u_{\ell,t})} s_{\ell,k}(u_{\ell,t})}, \quad j\in\mathcal{R}(u_{\ell,t}), \qquad (6)
而被选中的路由专家集合由加了偏置的亲和度决定: \mathcal{R}(u_{\ell,t}) = \mathrm{TopK}_j\big(s_{\ell,j}(u_{\ell,t}) + b_{\ell,j},\ K\big). \qquad (7)
解释
核心思想:偏置只管“选谁”,不管“权重多大”。
- 式 (7):用 s_{\ell,j}+b_{\ell,j} 排序取前 K 名。若专家 j 近期过载,就把 b_{\ell,j} 调低,让它在排名中吃亏,部分 token 会转投其他专家;若欠载则调高。
- 式 (6):选定之后,混合权重只用原始 s 计算,偏置不进入前向输出,因此也不进入梯度——它是一个纯粹的“调度旋钮”。
原文
This bias-based balancing mechanism decouples expert assignment from expert routing. Specifically, the correction bias is employed to promote load balancing, while the routing confidence remains weighted by the model's original, unbiased affinity scores. During training, we accumulate the number of tokens assigned to each expert across micro-batches and distributed ranks. At each load-balancing update, the correction bias is adjusted according to the sign of the deviation from the mean expert load:
b_{\ell,j} \leftarrow b_{\ell,j} - \gamma\cdot\mathrm{sign}\!\left(n_{\ell,j} - \frac{1}{N_r}\sum_{k=1}^{N_r} n_{\ell,k}\right), \qquad (8)
where n_{\ell,j} is the accumulated load of expert j in layer \ell, and \gamma is the bias update speed. Optionally, the bias vector is centered after each update to prevent cumulative drift. The MoE output is then injected back through the original FFN residual branch of the action expert transformer. 译文
这种基于偏置的均衡机制把专家分配与专家路由(加权)解耦。具体来说,修正偏置用于促进负载均衡,而路由置信度仍按模型原始的、无偏置的亲和度分数加权。训练中,我们跨微批次(micro-batch)和分布式进程(rank)累计分配给每个专家的 token 数。在每次负载均衡更新时,根据该专家负载相对平均负载的偏差符号来调整修正偏置:
b_{\ell,j} \leftarrow b_{\ell,j} - \gamma\cdot\mathrm{sign}\!\left(n_{\ell,j} - \frac{1}{N_r}\sum_{k=1}^{N_r} n_{\ell,k}\right), \qquad (8)
其中 n_{\ell,j} 是第 \ell 层专家 j 的累计负载,\gamma 是偏置更新速度。可选地,在每次更新后对偏置向量做中心化,以防止累积漂移。随后,MoE 的输出经由动作专家 Transformer 原有的 FFN 残差分支注回。 解释
式 (8) 解读:括号里是“该专家负载 - 平均负载”。高于平均 \Rightarrow sign =+1 \Rightarrow 偏置减小 \gamma;低于平均 \Rightarrow 偏置增加 \gamma。只看符号、不看大小,所以每次调整幅度固定为 \gamma,类似一个简单的“砰砰控制”,稳定且不需要调节比例系数。 例:N_r=4,某次累计负载 n=(400, 300, 200, 100),平均 250;则 b_1,b_2 各减 \gamma,b_3,b_4 各加 \gamma。若 \gamma=0.001,经过若干次更新后专家 4 的排名优势逐渐累积,被选中的次数上升。 跨 micro-batch 和 rank 累计:单个小批次里 token 数太少,统计噪声大;汇总所有 GPU 后的全局负载更可靠。 中心化:若所有偏置一起向某方向漂移(例如都变大),对 Top-K 排名没有影响但数值会无界增长,减去均值即可消除。 残差注回:x\leftarrow x+m_\ell(u_{\ell,t}),与原 FFN 的残差连接方式相同,MoE 层是对 FFN 的“即插即用”替换。
原文
Scaling Experiments. To validate the efficacy of the sparse architecture under an identical compute budget, we conduct a comprehensive comparison between MoE and Dense models with strictly matched active parameter counts. Experimental results shown in Fig. 7 indicate that MoE consistently achieves lower training loss and validation error than its dense counterpart. This advantage is observed across both optimization and generalization metrics, indicating that the performance gain of MoE does not merely arise from increased total parameter count, but from a more effective allocation of model capacity through sparse activation. These results demonstrate that, under a fixed compute budget, the sparse MoE architecture achieves more efficient scaling with reduced training loss and validation error, establishing it as a more effective scaling strategy for VLA pre-training.
译文
缩放实验。为了验证稀疏架构在相同计算预算下的效果,我们在严格匹配激活参数量的条件下,对 MoE 模型与稠密(Dense)模型进行了全面比较。图 7 的实验结果表明,MoE 始终取得比稠密对照更低的训练损失和验证误差。这一优势同时体现在优化指标和泛化指标上,说明 MoE 的性能提升并不仅仅来自总参数量的增加,而是来自通过稀疏激活对模型容量进行更有效的分配。这些结果表明,在固定计算预算下,稀疏 MoE 架构以更低的训练损失和验证误差实现了更高效的扩展,是 VLA 预训练中更有效的扩展策略。
解释
实验设计:两个动作专家的激活参数都是 0.6B(每个 token 的计算量相同),MoE 的总参数为 1.6B。这是 MoE 论文中标准的“等计算量”比较。 训练损失 vs. 验证误差:训练损失低可能只是更大容量带来的拟合能力(可能过拟合);而验证误差(在 GM-100 任务上预测动作与真实动作的误差)同样更低,说明增加的容量转化为了泛化。 需要注意的局限:(1) 作者说“不仅仅来自总参数量增加”,但实验中并未与 1.6B 稠密模型比较,严格说只证明了“等激活计算量下 MoE 更好”,没有证明稀疏激活本身优于等总参数的稠密模型;(2) 验证指标是离线动作误差,不是真机成功率;(3) 只有一个规模点(0.6B 激活),“缩放”的趋势尚待更多规模点验证。
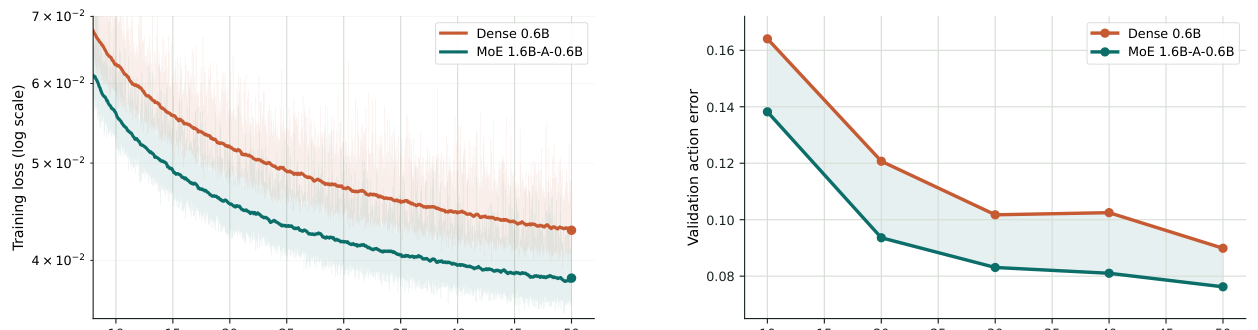
原图注:Figure 7. Comparable active-parameter scaling comparison between Dense model and MoE model using training loss on pre-training data and validation action error on GM-100 tasks.
译文图注:图 7:在激活参数量可比的条件下,稠密模型与 MoE 模型的缩放比较:左为预训练数据上的训练损失,右为 GM-100 任务上的验证动作误差。图 7 解读
左图:横轴为训练步数(单位千步,10k–50k),纵轴为训练损失(对数刻度,约 4\times10^{-2} 到 7\times10^{-2})。橙色为 Dense 0.6B,青色为 MoE 1.6B-A-0.6B(总参数 1.6B、激活 0.6B)。浅色锯齿是逐步原始损失,深色线为平滑曲线。MoE 曲线全程低于 Dense,在 50k 步时约为 0.038 对比 0.043,相对降低约 12%。右图:横轴同为训练步数,在 10k、20k、30k、40k、50k 处取检查点;纵轴为 GM-100 上的验证动作误差。读数约为:Dense 0.164 / 0.121 / 0.102 / 0.102 / 0.090,MoE 0.138 / 0.094 / 0.083 / 0.081 / 0.076。阴影区域表示两者差距。每个检查点 MoE 都更低;50k 步时相对降低约 (0.090-0.076)/0.090\approx16\%。另一个角度:MoE 在 20k 步时(0.094)已接近 Dense 在 50k 步时的水平(0.090),即达到同等误差所需的训练量大约少一半。对论点的作用:这是本文支持 MoE 动作专家的唯一定量证据。Dense 在 30k–40k 出现平台(0.102 不变),MoE 则持续下降,暗示稠密模型在多本体数据上更早遇到容量瓶颈。
4.2通过双查询蒸馏实现时空感知的 VLA(Spatiotemporal-Aware VLA via Dual-Query Distillation)
原文
To promote both geometric awareness and causal temporal understanding in the LingBot-VLA 2.0, we adopt a dual-query distillation framework inspired by recent works [35], where LingBot-Depth and our robotics-aware DINO-Video serve as complementary teachers. Specifically, we append two learnable queries, [Q_t, Q_{t+T}], to the visual and textual tokens, where Q_t targets the current observation and Q_{t+T} targets the future observation at horizon T (i.e., the action chunk size). These contextualized query states are then distilled from two complementary teachers: a depth teacher, LingBot-Depth [28], which provides explicit geometric supervision, and a causal video teacher, DINO-Video, which provides temporally grounded visual representations.
译文
为了同时增强 LingBot-VLA 2.0 的几何感知与因果时间理解,我们受近期工作 [35] 启发,采用一种双查询蒸馏框架,其中 LingBot-Depth 与我们自研的面向机器人的 DINO-Video 作为互补的教师。具体而言,我们在视觉与文本 token 之后追加两组可学习查询 [Q_t, Q_{t+T}],其中 Q_t 以当前观测为目标,Q_{t+T} 以时距 T(即动作块长度)之后的未来观测为目标。这些经过上下文化的查询状态随后从两个互补的教师处蒸馏:深度教师 LingBot-Depth [28] 提供显式的几何监督,因果视频教师 DINO-Video 提供具有时间依据的视觉表征。
解释
机制:查询 Q 是一组可学习的嵌入向量(每组包含若干个 token,图 1 中各画了 2 个),拼在 VLM 输入序列末尾。由于 VLM 是因果注意力,排在最后的查询可以“看到”前面所有图像和指令 token,经过多层 Transformer 后,其输出就成了对整个上下文的“摘要”——即“上下文化的查询状态”。 监督:让 Q_t 的输出去复现当前帧的教师特征(一种“看懂当前”的重建任务),让 Q_{t+T} 的输出去复现 T 步之后帧的教师特征(“预想未来”)。 为什么 T 取动作块长度:模型一次输出 T 步动作,执行完后场景会变成 t+T 时刻的样子;让模型同时预测那一刻的场景,就把“动作计划”和“动作执行后的结果”联系了起来。 推理时:教师模型只在训练时使用,推理时不需要运行深度模型或 DINO-Video,开销仅是多了几个查询 token。[35] 是作者团队之前在多模态大模型上提出的“以视觉为中心的激活与协调”方法,此处迁移到 VLA。
原文
LingBot-Depth for geometric supervision. To inject explicit spatial and geometric priors into LingBot-VLA 2.0, we align the dual-query states with depth tokens extracted from LingBot-Depth. Specifically, the current and future queries, [Q_t, Q_{t+T}], are trained to predict the corresponding depth representations [D_t, D_{t+T}] from the current and future manipulation frames, respectively. The depth distillation objective is
译文
用 LingBot-Depth 进行几何监督。为了向 LingBot-VLA 2.0 注入显式的空间与几何先验,我们把双查询状态与从 LingBot-Depth 提取的深度 token 对齐。具体而言,当前查询与未来查询 [Q_t, Q_{t+T}] 被训练去分别预测当前与未来操作帧对应的深度表征 [D_t, D_{t+T}]。深度蒸馏目标为
解释
LingBot-Depth [28] 是作者团队发布的深度估计模型。注意蒸馏目标是它的深度 token(中间特征),而不是最终的逐像素深度图;不过图 13 中展示了可以解码为深度图的预测结果,说明这些 token 足以还原深度。
原文
\mathcal{L}_{\mathrm{depth}} = \mathbb{E}\Big[\big\|\mathrm{Proj}_{\mathrm{depth}}(Q_t) - D_t\big\|_1 + \big\|\mathrm{Proj}_{\mathrm{depth}}(Q_{t+T}) - D_{t+T}\big\|_1\Big], \qquad (9)
where \mathrm{Proj}_{\mathrm{depth}}(\cdot) denotes a projection module with cross-attention for dimensional alignment. Within the causal VLM architecture, Q_t captures the immediate scene geometry, while Q_{t+T} learns to anticipate future geometric configurations relevant to upcoming manipulation. 译文
\mathcal{L}_{\mathrm{depth}} = \mathbb{E}\Big[\big\|\mathrm{Proj}_{\mathrm{depth}}(Q_t) - D_t\big\|_1 + \big\|\mathrm{Proj}_{\mathrm{depth}}(Q_{t+T}) - D_{t+T}\big\|_1\Big], \qquad (9)
其中 \mathrm{Proj}_{\mathrm{depth}}(\cdot) 表示一个带交叉注意力、用于维度对齐的投影模块。在因果 VLM 架构中,Q_t 捕获当前的场景几何,而 Q_{t+T} 学习预判与即将进行的操作相关的未来几何构型。 解释
符号:\mathbb{E} 对训练样本(及采样的时刻 t)取期望;\|\cdot\|_1 是 L1 范数,即逐元素绝对差之和;D_t 是冻结的 LingBot-Depth 对第 t 帧提取的深度 token。 投影模块:查询只有寥寥几个 token,而教师输出是成百上千个 patch token(空间网格),数量和维度都对不上。图 1(b) 给出了结构:先 Linear 变换查询状态,再让一组与教师 patch 数量相同的可学习“对齐查询”(Alignment Queries)通过交叉注意力从中读取信息,最后 Linear + Norm 输出与 D_t 同形状的张量。这样少量查询 token 被“展开”成完整的空间特征图。 为什么用 L1:深度特征中存在物体边缘处的跳变,L1 对少量大误差不如 L2 敏感,回归结果更清晰、不易被边缘异常值拉偏。 作用:Q_t 那一项是“看懂当前三维结构”的辅助任务;Q_{t+T} 那一项是“预想手臂和物体移动之后的三维结构”,例如预测抽屉被拉开后的深度布局。
原文
Causal DINO-Video for temporal supervision. While depth supervision provides geometric structure, it does not capture the causal temporal dynamics required for robotic control. Motivated by the success of latent visual representations across a broad range of action and robotics applications [9, 11, 22–24, 27], we introduce DINO-Video, a robotics-aware video representation model built on top of the DINOv3 [26] image backbone. Unlike image-level features extracted independently for each frame, DINO-Video produces motion-aware visual representations with causal temporal attention, such that the feature at each time step depends only on the current and past observations.
译文
用因果 DINO-Video 进行时间监督。深度监督提供了几何结构,但并不能捕获机器人控制所需的因果时间动态。受潜在视觉表征在大量动作与机器人应用中取得成功的启发 [9, 11, 22–24, 27],我们提出 DINO-Video——一个构建在 DINOv3 [26] 图像主干之上的面向机器人的视频表征模型。不同于对每帧独立提取的图像级特征,DINO-Video 通过因果时间注意力产生具有运动感知的视觉表征,使每个时间步的特征只依赖当前及过去的观测。
解释
为什么还需要视频教师:深度图描述“东西在哪”,但不描述“东西是什么”和“正在怎么动”。DINO 系列自监督特征以语义区分度强著称(同类物体部件特征相似),视频版进一步把时间信息编码进特征,例如“杯子正在被提起”与“杯子静止在桌上”的特征会有区别。 因果性:第 t 帧的特征只看第 1..t 帧,不偷看未来。这很关键:若教师特征 Z_t 本身已包含未来信息,让 Q_t 去拟合它就会产生信息泄漏;因果设计保证当前目标只含“截至现在可知”的信息,而未来目标 Z_{t+T} 则代表“截至 t+T 的历史”,让学生必须真正去预测。
原文
Given the contextualized query states [Q_t, Q_{t+T}], the current query is trained to predict the DINO-Video feature of the current frame, while the future query is trained to predict the feature of the future frame at horizon T. Denoting the teacher targets by [Z_t, Z_{t+T}], extracted from a single causal forward pass of DINO-Video over the corresponding observation clip, the video distillation objective is
\mathcal{L}_{\mathrm{video}} = \mathbb{E}\Big[\big\|\mathrm{Proj}_{\mathrm{video}}(Q_t) - Z_t\big\|_F^2 + \big\|\mathrm{Proj}_{\mathrm{video}}(Q_{t+T}) - Z_{t+T}\big\|_F^2\Big], \qquad (10)
where \mathrm{Proj}_{\mathrm{video}}(\cdot) maps the query states into the patch-level feature space of DINO-Video. This objective encourages LingBot-VLA 2.0 to recover both the current motion-aware representation and its future counterpart, complementing the geometric supervision from depth distillation. 译文
给定上下文化的查询状态 [Q_t, Q_{t+T}],当前查询被训练去预测当前帧的 DINO-Video 特征,未来查询被训练去预测时距 T 处未来帧的特征。将教师目标记为 [Z_t, Z_{t+T}](由 DINO-Video 对相应观测片段做一次因果前向计算得到),视频蒸馏目标为
\mathcal{L}_{\mathrm{video}} = \mathbb{E}\Big[\big\|\mathrm{Proj}_{\mathrm{video}}(Q_t) - Z_t\big\|_F^2 + \big\|\mathrm{Proj}_{\mathrm{video}}(Q_{t+T}) - Z_{t+T}\big\|_F^2\Big], \qquad (10)
其中 \mathrm{Proj}_{\mathrm{video}}(\cdot) 把查询状态映射到 DINO-Video 的 patch 级特征空间。该目标促使 LingBot-VLA 2.0 同时恢复当前的运动感知表征及其未来对应物,与深度蒸馏提供的几何监督互为补充。 解释
符号:Z_t\in\mathbb{R}^{P\times c} 是第 t 帧的 P 个 patch 特征(每个 c 维);\|\cdot\|_F^2 是 Frobenius 范数的平方,即矩阵所有元素平方和,等价于逐元素 L2(均方误差的未归一化形式)。 “单次因果前向”:把从过去到 t+T 的整段片段一次性送入 DINO-Video,由于因果注意力,第 t 帧位置的输出自然只依赖 \le t 的帧,第 t+T 帧位置的输出依赖 \le t+T 的帧。一次计算就能同时得到两个目标,省去两次前向。 深度用 L1、视频用 L2 的差别:DINO 特征是平滑的高维语义向量,L2 更合适;深度特征边界锐利,L1 更合适。这是工程上的经验选择,原文未给出对比实验。 总训练目标:原文没有写出总损失的形式,可推测为 \mathcal{L}=\mathcal{L}_{\mathrm{action}}+\alpha\mathcal{L}_{\mathrm{depth}}+\beta\mathcal{L}_{\mathrm{video}},其中 \mathcal{L}_{\mathrm{action}} 为流匹配动作损失;系数 \alpha,\beta 原文未给出。
原文
Details of robotics-aware DINO-Video. We initialize DINO-Video from DINOv3 and extend it with block-wise causal temporal attention and 3D rotary positional embeddings (3D-RoPE) [37], enabling causal video modeling while preserving the spatial semantics and geometry priors inherited from DINOv3. We train DINO-Video on 5M video clips spanning Internet, egocentric, and robotic data, using video-adapted DINO and iBOT self-distillation objectives [40]. For each sample, we uniformly sample 16 frames and assign an absolute temporal encoding based on the effective frame rate to distinguish clips with different real-time spans [1]. On LARYBench [24] (see Tab. 3), DINO-Video achieves the best performance on three of four benchmarks, supporting its effectiveness as a robotics-aware temporal teacher.
译文
面向机器人的 DINO-Video 细节。我们用 DINOv3 初始化 DINO-Video,并为其扩展块级(block-wise)因果时间注意力与三维旋转位置编码(3D-RoPE)[37],从而在保留继承自 DINOv3 的空间语义与几何先验的同时,实现因果视频建模。我们在涵盖互联网、第一视角与机器人数据的 500 万个视频片段上训练 DINO-Video,使用适配视频的 DINO 与 iBOT 自蒸馏目标 [40]。对每个样本,我们均匀采样 16 帧,并基于有效帧率赋予绝对时间编码,以区分真实时间跨度不同的片段 [1]。在 LARYBench [24] 上(见表 3),DINO-Video 在四项基准中的三项上取得最佳表现,支持了它作为面向机器人的时间教师的有效性。
解释
块级因果注意力:同一帧内的 patch 之间双向注意(保持 DINOv3 的空间理解),跨帧时只能看过去帧(因果)。“块”即一帧的所有 patch。 3D-RoPE:把旋转位置编码从图像的 (行, 列) 二维扩展到 (时间, 行, 列) 三维,使注意力能感知 token 的时空相对位置。 DINO / iBOT 自蒸馏:一种无标签自监督训练:教师网络(学生的指数滑动平均)看完整视图,学生看裁剪或掩码后的视图,学生要输出与教师一致的特征——DINO 在全局 [CLS] 特征上对齐,iBOT 在被掩码的 patch 特征上对齐。无需标注即可学到语义特征。 绝对时间编码:同样 16 帧,若原视频是 60 fps 抽帧则只覆盖约 0.27 秒,若是 2 fps 则覆盖 8 秒。把真实时间戳编码进去,模型才能分辨“快动作”和“慢动作”,这对估计运动速度很重要。
原表 Table 3. Results of DINO-Video on LARYBench Classification and Regression Evaluation.
译:表 3 DINO-Video 在 LARYBench 分类与回归评测上的结果。
译:表 3 DINO-Video 在 LARYBench 分类与回归评测上的结果。
| Classification(分类) | Regression(回归) | ||||
| Model | Params(M) | Composite Human\uparrow | Composite Robot\uparrow | RoboCOIN\downarrow | AgiBotWorld-Beta\downarrow |
| V-JEPA 2 [2] | 303.89 | 80.35 | 70.43 | 0.32 | 0.33 |
| DINOv3 [26] | 303.13 | 76.19 | 69.06 | 0.22 | 0.24 |
| DINO-Video | 303.13 | 80.21 | 71.97 | 0.20 | 0.19 |
表 3 解读
背景:LARYBench [24] 是评估“潜在动作表征”(latent action representation)质量的基准:冻结视觉编码器,在其特征上训练轻量探针,看特征里蕴含多少动作信息。 列含义:Params 为编码器参数量(约 3 亿,均为 ViT-L 规模);Classification 两列为动作分类准确率(%,越高越好),分别在人类视频综合集(Composite Human)和机器人视频综合集(Composite Robot)上评测;Regression 两列为从视觉特征回归机器人动作的误差(越低越好),数据来自 RoboCOIN 与 AgiBotWorld-Beta 两个机器人数据集。 行与关键数字:
- V-JEPA 2(Meta 的视频自监督模型):人类动作分类最好(80.35),但机器人回归误差最大(0.32/0.33),说明它的特征对精细机器人动作的编码不足。
- DINOv3(纯图像模型,DINO-Video 的初始化来源):分类偏弱(76.19/69.06),回归 0.22/0.24。
- DINO-Video:参数量与 DINOv3 完全相同(303.13M,说明新增的时间注意力未引入额外参数,或复用了原有注意力权重),机器人分类 71.97、回归 0.20/0.19 均为最佳;人类分类 80.21 仅比 V-JEPA 2 低 0.14。相对 DINOv3,回归误差在 AgiBotWorld-Beta 上下降约 21%(0.24\to0.19)。
5实验(Experiments)
5.1实验设置(Experimental Settings)
原文
Scoring criteria. Table 4 summarizes the scoring criteria for a subset of GM-100 benchmark tasks. Each task is decomposed into a sequence of fine-grained manipulation steps, and a partial score is assigned to each step according to task completion. These criteria cover diverse bimanual capabilities, including sorting, retrieval, scooping, replacement, packing, pushing, squeezing, and coordinated object handling. Such stepwise annotations enable a more fine-grained evaluation than binary success alone, capturing partial progress on long-horizon manipulation tasks.
译文
评分标准。表 4 汇总了 GM-100 基准中部分任务的评分标准。每个任务被分解为一系列细粒度操作步骤,并根据完成情况为每一步分配部分得分。这些标准覆盖了多样的双臂能力,包括分拣、取回、舀取、更换、打包、推动、挤压以及协同的物体操作。这种逐步标注比单纯的二值成功率提供了更细粒度的评估,能够反映长时程操作任务中的部分进展。
解释
进度分(progress score)与成功率(success rate):每个任务满分 100,拆成若干步骤并给定分值;一次试验的进度分 = 已完成步骤分值之和。成功率则只看是否完成全部步骤(或最后一步)。例如“取出钥匙扣”四步各 25 分,若机器人拉开抽屉、抓到钥匙扣但没放到抽屉前方,本次进度分为 50、记为失败。进度分能区分“差一点成功”与“一开始就失败”,在成功率普遍不高的真机评测中更具信息量。 表 4 中的任务分工:BM-19/20/45/47/69/75/97/105 以及 BM-39 共 9 个任务用于第 5.2 节主实验(表 5);BM-25(舀米)、BM-82(挤番茄酱)、BM-107(扫码)再加上 BM-97(从微波炉取碗)共 4 个任务用于第 6.1 节消融(图 10)。
原表 Table 4. Scoring criteria for the part of GM-100 benchmark tasks.
译:表 4 GM-100 基准部分任务的评分标准(括号内为该步分值)
译:表 4 GM-100 基准部分任务的评分标准(括号内为该步分值)
| Task ID | Task(任务) | Scoring Criteria(评分标准,原文 / 译文) |
| BM-19 | Block Sorting 积木排序 | 1. Pick up the largest block on the table (16). 拿起桌上最大的积木(16) 2. Place the largest block on the far left (12). 把最大的积木放在最左边(12) 3. Pick up the second-largest block on the table (12). 拿起第二大的积木(12) 4. Place the second-largest block to the right of the largest block (12). 放在最大积木的右侧(12) 5. Pick up the third-largest block on the table (12). 拿起第三大的积木(12) 6. Place the third-largest block to the right of the second-largest block (12). 放在第二大积木右侧(12) 7. Pick up the smallest block on the table (12). 拿起最小的积木(12) 8. Place the smallest block on the far right (12). 把最小的积木放在最右边(12) |
| BM-20 | Retrieve Keychain 取出钥匙扣 | 1. Pull open the drawer (25). 拉开抽屉(25) 2. Grasp the keychain (25). 抓住钥匙扣(25) 3. Move the keychain to the front of the drawer (25). 把钥匙扣移到抽屉前方(25) 4. Put down the keychain (25). 放下钥匙扣(25) |
| BM-25 | Scoop Rice 舀米 | 1. Pick up the spoon with the right hand (20). 右手拿起勺子(20) 2. Scoop rice from the bowl with the spoon (30). 用勺子从碗里舀米(30) 3. Pour the rice into the cup (30). 把米倒进杯子(30) 4. Place the spoon back onto the plate (20). 把勺子放回盘子(20) |
| BM-39 | Replace Paper Roll 更换纸卷 | 1. Remove the empty paper-roll core (22). 取下空纸芯(22) 2. Place the core on the tray (22). 把纸芯放到托盘上(22) 3. Pick up the new paper roll (22). 拿起新纸卷(22) 4. Install the new paper roll onto the holder (34). 把新纸卷装到纸架上(34) |
| BM-45 | Sort Snacks 零食分类 | 1. Pick up the first type of snack (18). 拿起第一种零食(18) 2. Place it into the corresponding container (16). 放入对应容器(16) 3. Pick up the second type of snack (17). 拿起第二种零食(17) 4. Place it into the corresponding container (16). 放入对应容器(16) 5. Pick up the third type of snack (17). 拿起第三种零食(17) 6. Place it into the corresponding container (16). 放入对应容器(16) |
| BM-47 | Pack Eggs 装鸡蛋 | 1. Pick up the first egg (16). 拿起第一个鸡蛋(16) 2. Place the egg into a tray slot (12). 把鸡蛋放进蛋托格(12) 3–8. 对第二、三、四个鸡蛋重复“拿起(12)/ 放入蛋托格(12)”(原文:Pick up the second/third/fourth egg (12); Place the egg into a tray slot (12)) |
| BM-69 | Pick Out Toy Bones 挑出玩具骨头 | 1. Pick up the first toy bone (25). 拿起第一根玩具骨头(25) 2. Move the bone out of the plate (25). 把骨头移出盘子(25) 3. Pick up the second toy bone (25). 拿起第二根玩具骨头(25) 4. Move the bone out of the plate (25). 把骨头移出盘子(25) |
| BM-75 | Push Ball into Box 把球推进盒子 | 1. Push the ball toward the box (30). 把球朝盒子推(30) 2. Push the ball into the box (70). 把球推进盒子(70) |
| BM-82 | Squeeze Ketchup 挤番茄酱 | 1. Pick up the ketchup bottle with the left hand and hold it above the plate (25). 左手拿起番茄酱瓶并举到盘子上方(25) 2. Tilt the bottle so that the nozzle points toward the plate (25). 倾斜瓶子使瓶嘴对准盘子(25) 3. Squeeze the bottle with both hands to dispense ketchup (25). 双手挤压瓶身挤出番茄酱(25) 4. Put down the ketchup bottle (25). 放下番茄酱瓶(25) |
| BM-97 | Take Bowl out of Microwave 从微波炉取碗 | 1. Open the microwave door (25). 打开微波炉门(25) 2. Grasp the bowl inside the microwave (25). 抓住微波炉内的碗(25) 3. Move the bowl onto the table and place it down (25). 把碗移到桌上放下(25) 4. Close the microwave door (25). 关上微波炉门(25) |
| BM-105 | Tool Packing 工具装箱 | 1. Pick up the tape and place it into the toolbox (20). 拿起胶带放进工具箱(20) 2. Pick up the measuring tape and place it into the toolbox (20). 拿起卷尺放进工具箱(20) 3. Pick up the screwdriver and place it into the toolbox (20). 拿起螺丝刀放进工具箱(20) 4. Pick up the cutter and place it into the toolbox (20). 拿起美工刀放进工具箱(20) 5. Close the toolbox (20). 关上工具箱(20) |
| BM-107 | Barcode Scan 扫条形码 | 1. Lift the medicine box and hold it up with the left hand (20). 左手拿起药盒并举起(20) 2. Pick up the barcode scanner with the right hand (20). 右手拿起扫码枪(20) 3. Scan the barcode on the medicine box with the scanner (20). 用扫码枪扫描药盒上的条形码(20) 4. Put down the barcode scanner (20). 放下扫码枪(20) 5. Put the medicine box back down (20). 放回药盒(20) |
表 4 解读
结构:三列依次为任务编号(BM-xx 为 GM-100 中的编号)、任务名、按顺序排列的评分步骤,括号中为该步分值。每个任务的分值之和均为 100。 分值验算:BM-19 为 16+12\times7=100;BM-39 为 22\times3+34=100;BM-45 为 18+16+17+16+17+16=100;BM-47 为 16+12\times7=100。 分值设计的含义:
- 首个“拿起”步骤往往分值略高(BM-19、BM-47 中为 16),反映“首次接近并抓取”最难——机器人需要从初始姿态定位目标。
- BM-75 推球任务中“推进盒子”占 70 分,“推向盒子”仅 30 分,说明最后的精确入盒才是难点;因此进度分 30 往往意味着推了但没进。
- BM-39 中“安装新纸卷”占 34 分,需要把纸卷套到纸架杆上,是高精度插接动作。
- BM-82 挤番茄酱、BM-107 扫码要求左右手分工协作,是典型的双臂协同任务。
5.2双臂操作实验结果(Bimanual Manipulation Experiment Results)
原表 Table 5. Performance on the bimanual GM-100 benchmark under the generalist setting. We report progress score (Prog., %) and success rate (Succ., %) for each task. The shaded row in each platform block reports the average over the nine tasks.
译:表 5 通才设置下双臂 GM-100 基准上的性能。我们报告每个任务的进度分(Prog.,%)和成功率(Succ.,%)。每个平台区块中的阴影行(此处为“Overall average”行)为九个任务的平均值。
译:表 5 通才设置下双臂 GM-100 基准上的性能。我们报告每个任务的进度分(Prog.,%)和成功率(Succ.,%)。每个平台区块中的阴影行(此处为“Overall average”行)为九个任务的平均值。
| Task | GR00T N1.7 | \pi_{0.5} | LingBot-VLA-1.0 | LingBot-VLA-2.0 | ||||
| Prog. | Succ. | Prog. | Succ. | Prog. | Succ. | Prog. | Succ. | |
| Agilex Cobot Magic | ||||||||
| Overall average | 36.3 | 17.8 | 59.1 | 32.2 | 58.2 | 30.0 | 66.2 | 34.4 |
| Block sorting(积木排序) | 40.0 | 10.0 | 90.4 | 60.0 | 59.2 | 10.0 | 56.8 | 0.0 |
| Retrieve keychain(取钥匙扣) | 12.5 | 10.0 | 20.0 | 20.0 | 67.5 | 60.0 | 100.0 | 100.0 |
| Replace paper roll(换纸卷) | 52.8 | 0.0 | 62.8 | 10.0 | 59.6 | 20.0 | 55.2 | 20.0 |
| Sort snacks(零食分类) | 91.9 | 70.0 | 82.4 | 30.0 | 74.4 | 10.0 | 66.2 | 10.0 |
| Pack eggs(装鸡蛋) | 14.4 | 0.0 | 72.4 | 20.0 | 42.4 | 10.0 | 44.4 | 0.0 |
| Pick out toy bone(挑骨头) | 70.0 | 60.0 | 100.0 | 100.0 | 77.5 | 70.0 | 95.0 | 90.0 |
| Push ball into box(推球入盒) | 18.0 | 0.0 | 38.0 | 20.0 | 6.0 | 0.0 | 41.0 | 20.0 |
| Take bowl out of microwave(微波炉取碗) | 15.0 | 10.0 | 0.0 | 0.0 | 77.5 | 70.0 | 77.5 | 70.0 |
| Tool packing(工具装箱) | 12.0 | 0.0 | 66.0 | 30.0 | 60.0 | 20.0 | 60.0 | 0.0 |
| Galaxea R1 Pro | ||||||||
| Overall average | 16.4 | 5.6 | 27.4 | 8.9 | 32.7 | 15.6 | 34.6 | 15.6 |
| Block sorting(积木排序) | 8.4 | 0.0 | 12.4 | 0.0 | 28.0 | 0.0 | 33.2 | 0.0 |
| Retrieve keychain(取钥匙扣) | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 |
| Replace paper roll(换纸卷) | 6.6 | 0.0 | 72.0 | 50.0 | 44.0 | 0.0 | 57.6 | 40.0 |
| Sort snacks(零食分类) | 31.3 | 0.0 | 28.1 | 0.0 | 10.6 | 0.0 | 26.1 | 0.0 |
| Pack eggs(装鸡蛋) | 1.6 | 0.0 | 6.7 | 0.0 | 19.2 | 0.0 | 4.4 | 0.0 |
| Pick out toy bone(挑骨头) | 77.5 | 50.0 | 72.5 | 30.0 | 62.5 | 40.0 | 87.5 | 70.0 |
| Push ball into box(推球入盒) | 9.0 | 0.0 | 21.0 | 0.0 | 3.0 | 0.0 | 18.0 | 0.0 |
| Take bowl out of microwave(微波炉取碗) | 7.5 | 0.0 | 7.5 | 0.0 | 97.5 | 100.0 | 65.0 | 30.0 |
| Tool packing(工具装箱) | 6.0 | 0.0 | 26.0 | 0.0 | 30.0 | 0.0 | 20.0 | 0.0 |
表 5 解读
列:四个模型——NVIDIA 的 GR00T N1.7、Physical Intelligence 的 \pi_{0.5}、上一版 LingBot-VLA-1.0 与本文的 2.0——各给出进度分与成功率。 行:两个平台区块(AgileX Cobot Magic 双臂平台、Galaxea R1 Pro 半人形平台),各含 9 个任务和 1 行平均值。成功率均为 10 的整数倍,可推断每个任务每个模型做了 10 次试验,一次试验的成败就意味着 10 个百分点。平均值验算:AgileX 上 2.0 的进度分 (56.8+100+55.2+66.2+44.4+95+41+77.5+60)/9=596.1/9\approx66.2,成功率 (0+100+20+10+0+90+20+70+0)/9=310/9\approx34.4,与表中一致。关键结论:
- 平均层面 2.0 在两个平台都排第一;但在 Galaxea 上,2.0 与 1.0 的成功率同为 15.6,进度分只高 1.9,差距很小。
- 最大的提升出现在“取钥匙扣”(AgileX:67.5/60 \to 100/100)和“挑骨头”(两平台都有明显提高)。
- 也有明显退步(正文只部分提及):AgileX 上“积木排序”成功率 0,而 \pi_{0.5} 为 60;“工具装箱”与“装鸡蛋”成功率均为 0,低于 1.0 与 \pi_{0.5};Galaxea 上“微波炉取碗”从 1.0 的 97.5/100 降到 65/30,“装鸡蛋”从 19.2 降到 4.4。
- Galaxea 上“取钥匙扣”所有模型均为 0,说明该任务在此平台上存在共性难点(可能与抽屉相对 R1 Pro 的可达性或视角有关)。
- GR00T N1.7 在通才设置下整体最弱,但 AgileX 上“零食分类”却是最好的(91.9/70),说明不同模型的任务偏好差异很大。
原文
Experiment settings. We evaluate bimanual manipulation on nine tasks from the GM-100 benchmark under a generalist mixed-training setting. Unlike task-specific training, a single policy is jointly trained on all tasks for each embodiment, requiring the model to share manipulation primitives across diverse bimanual skills, including sorting, retrieval, packing, pushing, and articulated-object interaction. We report the progress score and success rate for each task.
译文
实验设置。我们在通才式的混合训练设置下,用 GM-100 基准中的 9 个任务评估双臂操作。不同于针对单个任务的训练,每种本体只联合训练一个覆盖所有任务的策略,这要求模型在分拣、取回、打包、推动以及铰接物体交互等多样的双臂技能之间共享操作基元。我们报告每个任务的进度分与成功率。
解释
通才设置的难点:9 个任务的数据混在一起训练,模型必须仅凭语言指令和视觉画面分辨当前该做哪个任务,并在不同任务间复用“抓取”“放置”“开门”等基元。相比单任务微调,它更接近实际部署中“一个模型干多种活”的需求,但每个任务分到的训练容量更少,绝对分数通常也更低。每个平台训练一个策略,所以表 5 中两个平台的结果来自两个不同的微调模型。
原文
Results analysis. As shown in Tab. 5, LingBot-VLA-2.0 achieves the best overall performance under the generalist setting. On Agilex Cobot Magic, it reaches 66.2 / 34.4 in progress score / success rate, surpassing LingBot-VLA-1.0 by 8.0 / 4.4 points and \pi_{0.5} by 7.1 / 2.2 points. On Galaxea R1 Pro, it achieves 34.6 / 15.6, outperforming \pi_{0.5} by 7.2 / 6.7 points. These results demonstrate that LingBot-VLA-2.0 benefits from mixed-task training and acquires more generalizable bimanual manipulation behaviors.
译文
结果分析。如表 5 所示,LingBot-VLA-2.0 在通才设置下取得了最佳的总体表现。在 Agilex Cobot Magic 上,其进度分 / 成功率达到 66.2 / 34.4,比 LingBot-VLA-1.0 高 8.0 / 4.4 个百分点,比 \pi_{0.5} 高 7.1 / 2.2 个百分点。在 Galaxea R1 Pro 上,它达到 34.6 / 15.6,比 \pi_{0.5} 高 7.2 / 6.7 个百分点。这些结果表明,LingBot-VLA-2.0 能从混合任务训练中受益,并习得更具泛化性的双臂操作行为。
解释
数字验算:66.2-58.2=8.0,34.4-30.0=4.4;66.2-59.1=7.1,34.4-32.2=2.2;34.6-27.4=7.2,15.6-8.9=6.7,均正确。 值得注意的省略:Galaxea 上作者只与 \pi_{0.5} 比较,没有提与 1.0 的比较——实际上 2.0 相对 1.0 仅高 1.9 / 0.0。 统计显著性:AgileX 上成功率 34.4 vs 32.2 的差距相当于 90 次试验中多成功 2 次,在这样的样本量下难以认为有显著差异;进度分的差距(7–8 分)更有说服力一些。
原文
The improvements are most pronounced on tasks that demand accurate object grounding and goal-directed action execution. For instance, on Agilex Retrieve keychain, LingBot-VLA-2.0 improves over LingBot-VLA-1.0 from 67.5 / 60.0 to 100.0 / 100.0, and on Agilex Pick out toy bone, from 77.5 / 70.0 to 95.0 / 90.0. A similar gain is observed on the Galaxea Pick out toy bone task, where the performance increases from 62.5 / 40.0 to 87.5 / 70.0. These improvements align well with the design of LingBot-VLA-2.0, which adopts a stronger VLM backbone with enhanced grounding capability and conditions action prediction on future information, together enabling more object-centric and goal-consistent manipulation.
译文
提升在需要精确物体定位(grounding)和目标导向动作执行的任务上最为显著。例如,在 Agilex 的“取出钥匙扣”上,LingBot-VLA-2.0 相比 LingBot-VLA-1.0 从 67.5 / 60.0 提升到 100.0 / 100.0;在 Agilex 的“挑出玩具骨头”上,从 77.5 / 70.0 提升到 95.0 / 90.0。Galaxea 的“挑出玩具骨头”任务上也观察到类似提升,从 62.5 / 40.0 提升到 87.5 / 70.0。这些提升与 LingBot-VLA-2.0 的设计相吻合:它采用了定位能力更强的 VLM 主干,并让动作预测以未来信息为条件,二者共同促成了更以物体为中心、更目标一致的操作。
解释
grounding(定位/指代落地):把语言中的物体名(“钥匙扣”“玩具骨头”)准确对应到图像中的具体位置。钥匙扣小、放在抽屉里,挑骨头需要从盘中区分出骨头,二者都依赖精确的视觉定位。 一个新信息:这里首次提到 2.0 “采用了更强的 VLM 主干”,但正文其他部分(包括方法节)都没有说明换成了哪个 VLM、规模多大。因此表 5 中的提升可能有相当一部分来自更换主干,而非三项主要改进——这是解读结果时需要注意的混杂因素。 “以未来信息为条件”:指双查询蒸馏中未来查询 Q_{t+T} 的表征可被动作专家通过注意力读取,从而影响动作预测。
原文
Nevertheless, the gains are not uniform across tasks. Several tasks still exhibit a substantial gap between progress score and success rate, indicating that the model often makes partial progress but fails at the final precise placement, release, or completion step. Moreover, the performance disparity between Agilex Cobot Magic and Galaxea R1 Pro suggests that embodiment-specific factors, such as kinematics, camera viewpoints, and action-space alignment, remain challenging. Overall, LingBot-VLA-2.0 delivers consistent improvements in generalist bimanual manipulation, particularly on tasks requiring strong visual grounding and future-aware action planning.
译文
然而,提升在各任务间并不均匀。若干任务的进度分与成功率之间仍存在较大差距,说明模型常常取得部分进展,却在最后的精确放置、释放或收尾步骤上失败。此外,Agilex Cobot Magic 与 Galaxea R1 Pro 之间的性能差异表明,本体特定的因素(如运动学、相机视角和动作空间对齐)仍是挑战。总体而言,LingBot-VLA-2.0 在通才双臂操作上带来了一致的提升,尤其是在需要强视觉定位和面向未来的动作规划的任务上。
解释
进度分–成功率差距的例子:AgileX 积木排序 56.8 / 0、工具装箱 60.0 / 0——平均每次完成了一半以上的步骤,却没有一次全部完成。这类“最后一步”失败通常源于需要毫米级精度的放置,或累积误差导致后期姿态偏移。 平台差异:同一模型在 AgileX 上平均 66.2,在 R1 Pro 上仅 34.6。R1 Pro 策略频率为 15 Hz(表 1),比 AgileX 的 30 Hz 低一半;同时它有 7 自由度躯干,动作空间更复杂。作者把原因归于运动学、视角与动作空间对齐,但未做进一步分析。 结论措辞:最后一句再次用了“consistent improvements”,从平均值看成立,但如表 5 解读所示,逐任务并非一致提升。
5.3长时程移动操作实验结果(Long-Horizon Mobile Manipulation Experiment Results)
原表 Table 6. Long-horizon mobile manipulation benchmark results, reported as progress score / success rate (%).
译:表 6 长时程移动操作基准结果,以“进度分 / 成功率(%)”报告。
译:表 6 长时程移动操作基准结果,以“进度分 / 成功率(%)”报告。
| Embodiment(本体) | Task(任务) | Setting(设置) | LingBot-VLA-2.0 | \pi_{0.5} |
| Astribot S1 | Sort objects into refrigerator (物品分拣入冰箱) | In-domain(域内) | 77.1 / 60.0 | 65.3 / 46.7 |
| Out-of-distribution(分布外) | 37.0 / 13.3 | 30.3 / 6.7 | ||
| Cobot Magic-ARX X5 | Stove cleaning (灶台清洁) | In-domain(域内) | 84.3 / 66.7 | 79.9 / 60.0 |
| Out-of-distribution(分布外) | 67.5 / 40.0 | 62.5 / 33.3 |
表 6 解读
结构:两个本体各对应一个任务,每个任务在域内(ID)与分布外(OOD)两种设置下评测;单元格为“进度分 / 成功率”。加粗为本译文所加。 样本量:每个设置 15 次试验,成功率必为 1/15\approx6.7\% 的整数倍:60.0 = 9/15,46.7 = 7/15,13.3 = 2/15,6.7 = 1/15,66.7 = 10/15,40.0 = 6/15,33.3 = 5/15。 关键对比:
- 四个单元格中 2.0 全部领先 \pi_{0.5};冰箱任务域内的差距最大(进度分 +11.8,成功 9 次对 7 次)。
- OOD 下两者都大幅下滑:冰箱任务 2.0 进度分从 77.1 跌到 37.0(约减半),成功率从 60% 跌到 13.3%(15 次只成功 2 次);灶台任务下滑较温和(84.3 \to 67.5)。
- OOD 下成功率的差距仅为 1 次试验(2 vs 1、6 vs 5),统计上很难与随机波动区分;进度分差距(6.7、5.0)相对更可靠。
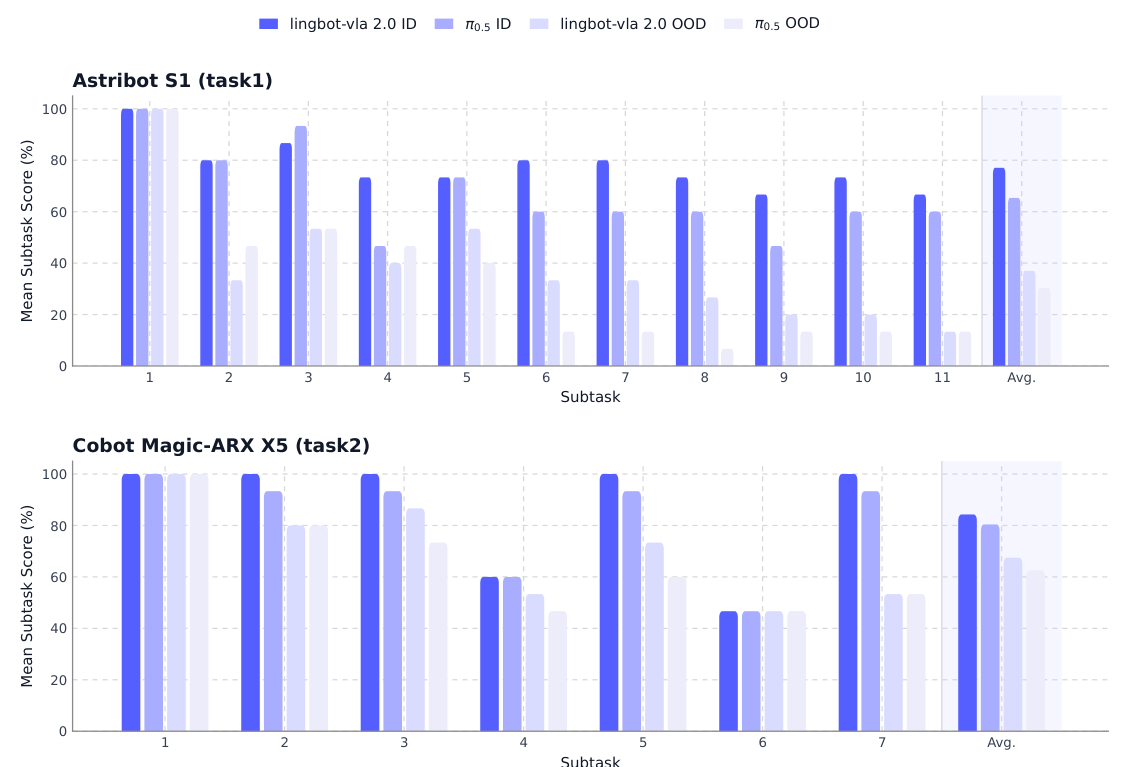
原图注:Figure 8. Per-subtask performance on the long-horizon mobile manipulation benchmark. Bars report the mean subtask completion score (%) across 15 trials under both in-domain (ID) and out-of-distribution (OOD) settings.
译文图注:图 8:长时程移动操作基准上的逐子任务表现。柱高为 15 次试验中各子任务的平均完成得分(%),分域内(ID)和分布外(OOD)两种设置。图 8 解读
坐标与图例:横轴为子任务编号(对应表 7 的步骤)及最右的平均值(Avg.,浅紫底色区域);纵轴为子任务平均得分(%,即 15 次试验中完成该步的比例)。每组 4 根柱,从深到浅依次为:LingBot-VLA 2.0 ID、\pi_{0.5} ID、LingBot-VLA 2.0 OOD、\pi_{0.5} OOD。上图 Astribot S1(冰箱任务,11 个子任务):子任务 1(移动到中岛台)四种情况都是 100%;ID 下 2.0 在子任务 4(拿第二个水果)、6(移动到冰箱前)、7(开冰箱门)、9 等处明显高于 \pi_{0.5}(如子任务 4 约 73% 对 47%);OOD 下从子任务 2 开始就跌到 30–50%,后半程(子任务 6–11)普遍只有 10–30%,说明 OOD 中换成未见过的物体后,抓取环节最先崩溃,后续步骤随之连锁失败。下图 Cobot Magic-ARX X5(灶台任务,7 个子任务):ID 下 2.0 在子任务 1、2、3、5、7 均达 100%,子任务 4(用海绵擦泡沫)只有约 60%,子任务 6(把黑色架子放回灶台)约 47%,两模型在这两步表现相同,是共同瓶颈;OOD 下降幅相对较小。验算:平均值是按表 7 分值加权的。以冰箱任务 2.0 ID 为例,各子任务得分约为 (100, 80, 86.7, 73.3, 73.3, 80, 80, 73.3, 66.7, 73.3, 66.7)%,乘以分值 (6, 9, 9, 11, 8, 10, 12, 9, 11, 9, 6) 后求和 \approx 6+7.2+7.8+8.07+5.87+8+9.6+6.6+7.33+6.6+4=77.1,与表 6 的 77.1 吻合。灶台任务 2.0 ID:8+16+12+0.6\times18+16+0.467\times16+14\approx84.3,同样吻合。结论:2.0 的优势在 ID 设置下主要体现在中后段子任务(长链条上的后续步骤),符合“更擅长完成完整轨迹”的说法;擦拭和精确放回架子是两模型共同的短板。
原文
Experiment settings. We evaluate long-horizon mobile manipulation performance on two robotic embodiments, as illustrated in Fig. 9. Each embodiment is associated with one representative task: Astribot S1 is evaluated on the object sorting task, where objects are collected and placed into a refrigerator, while Cobot Magic-ARX X5 is evaluated on the stove cleaning task. The detailed sub-task decomposition and corresponding scoring criteria for each task are listed in Tab. 7. For each task, we evaluate each model under two settings: in-domain (ID) and out-of-distribution (OOD).
译文
实验设置。我们在两种机器人本体上评估长时程移动操作性能,如图 9 所示。每种本体对应一个代表性任务:Astribot S1 评测物品分拣任务,即收集物品并放入冰箱;Cobot Magic-ARX X5 评测灶台清洁任务。每个任务的详细子任务分解及相应评分标准列于表 7。对于每个任务,我们在两种设置下评估每个模型:域内(in-domain, ID)与分布外(out-of-distribution, OOD)。
解释
两个平台的差异见图 9:Astribot S1 是带 4 自由度躯干、2 自由度头部和全向轮底盘的轮式人形;Cobot Magic-ARX X5 是差速底盘上装两条 6 自由度臂的移动双臂平台。两个任务都要求“先移动、再操作”,冰箱任务还涉及打开冰箱门这种铰接物体操作,以及“先放篮子里、提着篮子走”的多阶段规划。
原文
Each task-setting pair is evaluated with 15 independent trials. In the in-domain setting, both the robot initial position and the manipulated objects are drawn from the training distribution. In the out-of-distribution setting, the robot initial position is perturbed within \pm10 cm along the forward, backward, left, and right directions around the nominal initial pose. In addition, for the refrigerator sorting task, the two fruits and the water bottle to be placed into the refrigerator are replaced with unseen object categories. This setting is designed to evaluate the model's generalization ability under unseen object and position conditions.
译文
每个“任务–设置”组合进行 15 次独立试验。在域内设置中,机器人的初始位置和被操作物体都取自训练分布。在分布外设置中,机器人的初始位置在名义初始位姿附近沿前、后、左、右方向扰动 \pm10 厘米。此外,对于冰箱分拣任务,需要放进冰箱的两个水果和一瓶水被替换为未见过的物体类别。该设置旨在评估模型在未见物体与位置条件下的泛化能力。
解释
两类扰动:(1) 位置扰动 \pm10 cm——对移动操作而言,起点偏移会使后续每一步的相对位置都发生变化,考验闭环纠偏能力;(2) 物体替换——仅在冰箱任务中使用,考验语义泛化(例如从“苹果、橙子”换成训练中没出现过的水果)。灶台任务的 OOD 只有位置扰动,因此两个任务的 OOD 难度并不对等,这一点在下段被作者用来解释降幅差异。
原文
Results analysis. As shown in Tab. 6, LingBot-VLA-2.0 consistently outperforms \pi_{0.5} across both robotic embodiments and both evaluation settings. In the in-domain setting, LingBot-VLA-2.0 achieves a progress score / success rate of 77.1 / 60.0 on the refrigerator sorting task and 84.3 / 66.7 on the stove cleaning task, improving over \pi_{0.5} by 11.8 / 13.3 and 4.4 / 6.7 points, respectively. These results indicate that LingBot-VLA-2.0 can better execute long-horizon task sequences that require coordinated base movement, object manipulation, and interaction with articulated objects.
译文
结果分析。如表 6 所示,LingBot-VLA-2.0 在两种机器人本体和两种评估设置下都稳定优于 \pi_{0.5}。在域内设置中,LingBot-VLA-2.0 在冰箱分拣任务上取得 77.1 / 60.0 的进度分 / 成功率,在灶台清洁任务上取得 84.3 / 66.7,分别比 \pi_{0.5} 高 11.8 / 13.3 和 4.4 / 6.7 个百分点。这些结果表明,LingBot-VLA-2.0 能更好地执行需要协调底盘移动、物体操作以及铰接物体交互的长时程任务序列。
解释
验算:77.1-65.3=11.8,60.0-46.7=13.3;84.3-79.9=4.4,66.7-60.0=6.7,均正确。换算成试验次数:冰箱任务 9/15 对 7/15,灶台任务 10/15 对 9/15。
原文
Under the OOD setting, both models exhibit performance degradation, reflecting the increased difficulty introduced by perturbed initial robot poses and unseen manipulated objects. Nevertheless, LingBot-VLA-2.0 maintains a clear advantage over \pi_{0.5}, achieving 37.0 / 13.3 on the refrigerator-sorting task and 67.5 / 40.0 on the stove-cleaning task. Compared with \pi_{0.5}, this corresponds to improvements of 6.7 / 6.6 and 5.0 / 6.7 points, respectively. The performance gap is especially meaningful in terms of success rate, suggesting that LingBot-VLA-2.0 is more robust in completing full task trajectories rather than only making partial progress.
译文
在分布外设置下,两个模型都出现性能下降,反映出扰动的初始位姿和未见过的被操作物体带来了更高难度。尽管如此,LingBot-VLA-2.0 仍保持对 \pi_{0.5} 的明显优势,在冰箱分拣任务上取得 37.0 / 13.3,在灶台清洁任务上取得 67.5 / 40.0。与 \pi_{0.5} 相比,分别提升了 6.7 / 6.6 和 5.0 / 6.7 个百分点。成功率上的差距尤其有意义,说明 LingBot-VLA-2.0 在完成完整任务轨迹方面更加稳健,而不只是取得部分进展。
解释
验算:37.0-30.3=6.7,13.3-6.7=6.6;67.5-62.5=5.0,40.0-33.3=6.7。 对“尤其有意义”的审视:OOD 下成功率的差距分别对应 15 次试验中 2 次对 1 次、6 次对 5 次,各只差 1 次成功。按二项分布估算,15 次试验、成功率约 40% 时的标准误约为 \sqrt{0.4\times0.6/15}\approx12.6 个百分点,6.7 个百分点的差距远在一个标准误之内。因此“成功率差距尤其有意义”的说法证据偏弱,更稳妥的读法是“方向一致地略优”。
原文
The refrigerator sorting task shows a larger drop from the in-domain to the out-of-distribution setting than the stove cleaning task. This is expected because the out-of-distribution refrigerator setting simultaneously changes both the initial robot pose and the manipulated object categories, requiring stronger object-level generalization and more precise long-horizon recovery. In contrast, the stove cleaning task mainly evaluates robustness to initial pose perturbations while preserving the task objects and scene structure. Overall, the results demonstrate that LingBot-VLA-2.0 achieves stronger long-horizon mobile manipulation capability and better generalization than \pi_{0.5} across both embodiments.
译文
冰箱分拣任务从域内到分布外的下降幅度比灶台清洁任务更大。这在意料之中,因为冰箱任务的分布外设置同时改变了机器人初始位姿和被操作物体类别,需要更强的物体级泛化以及更精确的长时程恢复能力。相比之下,灶台清洁任务主要评估对初始位姿扰动的鲁棒性,任务物体与场景结构保持不变。总体而言,结果表明 LingBot-VLA-2.0 在两种本体上都比 \pi_{0.5} 具备更强的长时程移动操作能力和更好的泛化能力。
解释
降幅对比:2.0 在冰箱任务上进度分下降 77.1-37.0=40.1(相对下降 52%),灶台任务下降 84.3-67.5=16.8(相对 20%)。作者的解释合理:物体换成未见类别后,抓取策略需要零样本迁移到新形状,失败会在 11 步长链中层层传递。但需要注意,这两个任务本体、场景都不同,降幅差异也可能部分源于任务本身的难度差异,而不只是扰动类型不同。 “长时程恢复”(long-horizon recovery):指某一步出现偏差(如没抓稳)后,后续能否自行纠正并继续,而不是一错到底。
原表 Table 7. Scoring criteria for the long-horizon mobile manipulation experiment tasks.
译:表 7 长时程移动操作实验任务的评分标准(括号内为分值)。
译:表 7 长时程移动操作实验任务的评分标准(括号内为分值)。
| Task | Scoring Criteria(原文 / 译文) |
| Sort objects into refrigerator 物品分拣入冰箱 | 1. Move from the initial position to the kitchen island (6). 从初始位置移动到厨房中岛台(6) 2. Pick up the drink from the table and place it into the basket (9). 从桌上拿起饮料放进篮子(9) 3. Pick up the first fruit from the table and place it into the basket (9). 拿起第一个水果放进篮子(9) 4. Pick up the second fruit from the table and place it into the basket (11). 拿起第二个水果放进篮子(11) 5. Pick up and lift the basket (8). 拿起并提起篮子(8) 6. Move to the front of the refrigerator (10). 移动到冰箱前(10) 7. Open the refrigerator door wide enough to place items inside (12). 把冰箱门打开到足以放入物品的程度(12) 8. Pick up the first fruit and place it into the refrigerator (9). 拿起第一个水果放进冰箱(9) 9. Pick up the second fruit and place it into the refrigerator (11). 拿起第二个水果放进冰箱(11) 10. Pick up the drink and place it into the refrigerator (9). 拿起饮料放进冰箱(9) 11. Close the refrigerator door (6). 关上冰箱门(6) |
| Stove Cleaning 灶台清洁 | 1. Move from the initial position to the front of the stove (8). 从初始位置移动到灶台前(8) 2. Pick up the black pot rack and place it on the left side of the table (16). 拿起黑色锅架放到桌子左侧(16) 3. Pick up the sponge (12). 拿起海绵(12) 4. Wipe off the white foam on the stove using the sponge (18). 用海绵擦掉灶台上的白色泡沫(18) 5. Transfer the sponge and place it on the right side of the stove (16). 把海绵移到灶台右侧放下(16) 6. Pick up the black rack and place it back on the stove (16). 拿起黑色架子放回灶台(16) 7. Pick up the black pot and place it on the left burner of the stove (14). 拿起黑锅放到灶台左侧灶眼上(14) |
表 7 解读
分值验算:冰箱任务 6+9+9+11+8+10+12+9+11+9+6=100;灶台任务 8+16+12+18+16+16+14=100。 任务结构:冰箱任务包含两次底盘移动(步骤 1、6)、三次桌面取放、一次提篮(需要双臂或单臂承重)、一次开门(铰接物体,分值最高 12)、三次放入冰箱、一次关门,共 11 步,横跨“导航–操作–导航–操作”多个阶段。灶台任务一次移动后连续 6 步操作,其中擦拭(18 分最高)是需要持续接触与往复运动的技能。 分值反映难度:第二个水果的取放分值(11)高于第一个(9),因为后放的物体空间更局促、篮子/冰箱里已有物品;开冰箱门(12)和擦拭泡沫(18)是各自任务中分值最高的步骤,图 8 也显示擦拭是灶台任务的瓶颈之一。
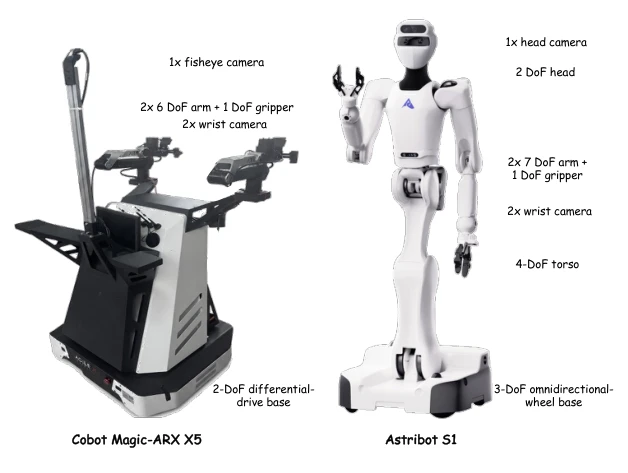
原图注:Figure 9. Illustration of the long-horizon mobile manipulation experiments platform.
译文图注:图 9:长时程移动操作实验平台示意图。图 9 解读
左:Cobot Magic-ARX X5——标注依次为:1 个鱼眼相机(装在立杆顶部,提供大视场全局视角);2 条 6 自由度机械臂,各带 1 自由度夹爪;2 个腕部相机;2 自由度差速驱动底盘(只能前进/后退和原地转向,不能横移)。 右:Astribot S1——1 个头部相机;2 自由度头部;2 条 7 自由度手臂 + 1 自由度夹爪;2 个腕部相机;4 自由度躯干;3 自由度全向轮底盘(可前后、左右平移及转向)。 与统一动作空间的对应:Astribot S1 的躯体自由度 4+2+3=9,与表 1 的 Body DoF = 9 一致,正好填满 55 维向量中腰 4D、头 2D、移动 3D 的全部槽位;Cobot Magic-ARX X5 的差速底盘只用移动槽位中的 2 维(前进速度与转向角速度),横移维度补零。 作用:说明两个测试平台的自由度结构差异很大(7 自由度 vs 6 自由度手臂、全向 vs 差速底盘、有无躯干和头),用来支撑“跨本体”这一说法。
6消融研究(Ablation Studies)
6.1动作空间(Action Space)
解释
本节实验设计(译者归纳):原文没有单独交代消融的实验配置。从图 10 的数字可以反推,所有消融共用一个“默认配置”:相对关节动作(relQpos)+ MeanStd 归一化 + L2 损失,它在 4 个任务上的结果为 Barcode 58.7、Scoop Rice 42.7、Ketchup 41.7、Microwave Bowl 76.8,平均 55.0。每组消融只改变一个因素:动作目标(绝对/相对)、动作空间(EEF/关节)、归一化方式(MinMax / Q01–Q99 / MeanStd)、损失函数(L1/L2)。4 个任务来自 GM-100:BM-107 扫条形码、BM-25 舀米、BM-82 挤番茄酱、BM-97 从微波炉取碗(评分标准见表 4)。原文未说明消融所用平台与试验次数;图中 76.8、43.8、53.6 等数值不是小样本下 k/n 形式的简单分数,可能是多次评测的平均值,或实为进度分,原文未加说明。
原文
Action target. For the action target, relative joint actions substantially outperform absolute joint actions, improving the average success rate from 33.7 to 55.0. This is supported by the action statistics in Fig. 12A. Across the four tasks, the standard deviation of
relQpos is only 31%–37% of that of absQpos; on the pooled distribution, the action standard deviation decreases from about 0.80 for absQpos to 0.28 for relQpos. Therefore, relative actions convert the prediction target from global joint-configuration regression into local motion regression, producing targets that are more centered and have lower variance.译文
动作目标。在动作目标上,相对关节动作明显优于绝对关节动作,将平均成功率从 33.7 提升到 55.0。图 12A 中的动作统计支持这一点:在四个任务上,
relQpos 的标准差仅为 absQpos 的 31%–37%;在合并分布上,动作标准差从 absQpos 的约 0.80 降到 relQpos 的 0.28。因此,相对动作把预测目标从全局关节构型回归转变为局部运动回归,产生更居中、方差更低的目标。解释
两种目标的定义:
absQpos(绝对关节位置)指动作块第 k 步的目标就是关节角 q_{t+k} 本身;relQpos(相对关节位置)指目标为 q_{t+k}-q_t,即相对当前关节状态的增量。 为什么相对更好:绝对关节角的取值范围由整个任务的工作空间决定(手臂可能在桌子左边,也可能在右边),而一个动作块(约 1–2 秒)内的增量通常很小、围绕 0 分布。模型只需学“从这里往哪儿挪一点”,不必记住“全局应该在哪”;当前状态已经作为输入给出,无需重复预测。 数字:标准差 0.80\to0.28,比值约 0.35,与图 12A 标注的 0.34\times 一致(四舍五入差异)。平均成功率提升 21.3 个百分点,是本节所有消融中差距最大的一项。 正文未讨论的例外:图 10 中挤番茄酱任务上绝对动作(55.0)反而优于相对动作(41.7)。可能的原因是该任务需要把瓶子举到盘子上方某个固定位置并保持姿态,绝对目标对这类“到达固定终点”的约束更直接。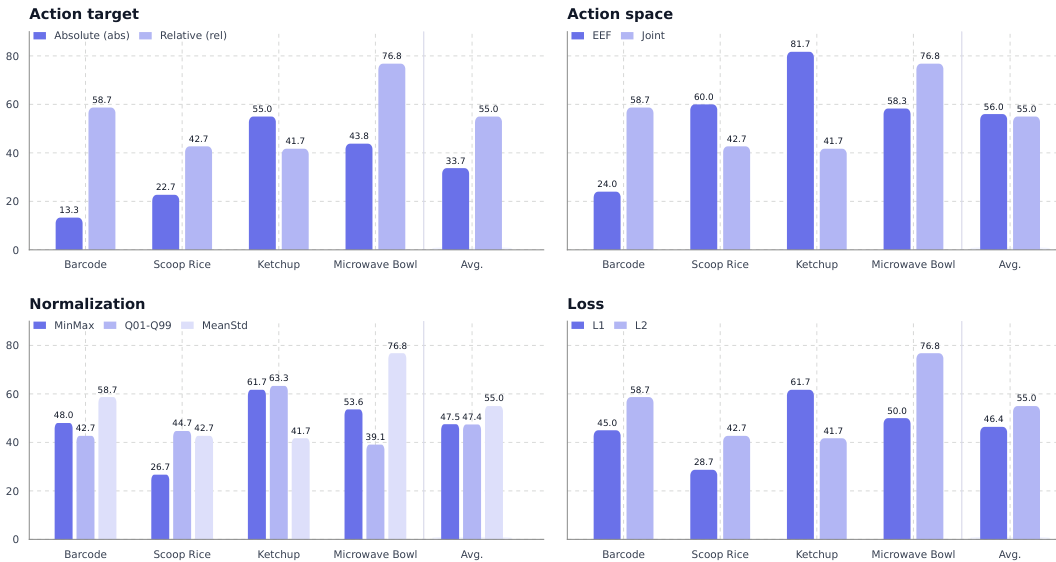
原图注:Figure 10. Results on the four GM-100 real-robot tasks.
译文图注:图 10:四个 GM-100 真机任务上的结果。图 10 解读
四个子图的横轴均为 4 个任务(Barcode 扫码、Scoop Rice 舀米、Ketchup 挤番茄酱、Microwave Bowl 微波炉取碗)及平均值(Avg.),纵轴为成功率(%)。每个子图比较一个设计选择:
^\dagger 默认配置(四组中数值完全相同)。表格为译者从图中读数整理,加粗为各组最高值。 平均值验算:abs (13.3+22.7+55.0+43.8)/4=33.7;EEF (24.0+60.0+81.7+58.3)/4=56.0;MinMax 190.0/4=47.5;Q01–Q99 189.8/4\approx47.4;L1 185.4/4\approx46.4,均与图中一致。读出的规律:
| 配置 | Barcode | Scoop Rice | Ketchup | Microwave Bowl | Avg. |
| Action target(动作目标) | |||||
| Absolute (abs) | 13.3 | 22.7 | 55.0 | 43.8 | 33.7 |
| Relative (rel)^\dagger | 58.7 | 42.7 | 41.7 | 76.8 | 55.0 |
| Action space(动作空间) | |||||
| EEF | 24.0 | 60.0 | 81.7 | 58.3 | 56.0 |
| Joint^\dagger | 58.7 | 42.7 | 41.7 | 76.8 | 55.0 |
| Normalization(归一化) | |||||
| MinMax | 48.0 | 26.7 | 61.7 | 53.6 | 47.5 |
| Q01–Q99 | 42.7 | 44.7 | 63.3 | 39.1 | 47.4 |
| MeanStd^\dagger | 58.7 | 42.7 | 41.7 | 76.8 | 55.0 |
| Loss(损失) | |||||
| L1 | 45.0 | 28.7 | 61.7 | 50.0 | 46.4 |
| L2^\dagger | 58.7 | 42.7 | 41.7 | 76.8 | 55.0 |
- 默认配置在平均值上胜过除 EEF 外的所有替代项,EEF 以 56.0 对 55.0 略胜。
- 挤番茄酱是一个“反常”任务:在每一组对比中,默认配置在该任务上都不是最好的——绝对动作 55.0、EEF 81.7、MinMax 61.7、Q01–Q99 63.3、L1 61.7 都高于默认的 41.7。这提示默认配置对该类接触丰富、需双手挤压的任务并不友好。
- 扫码任务对动作空间最敏感:关节 58.7 对 EEF 24.0。
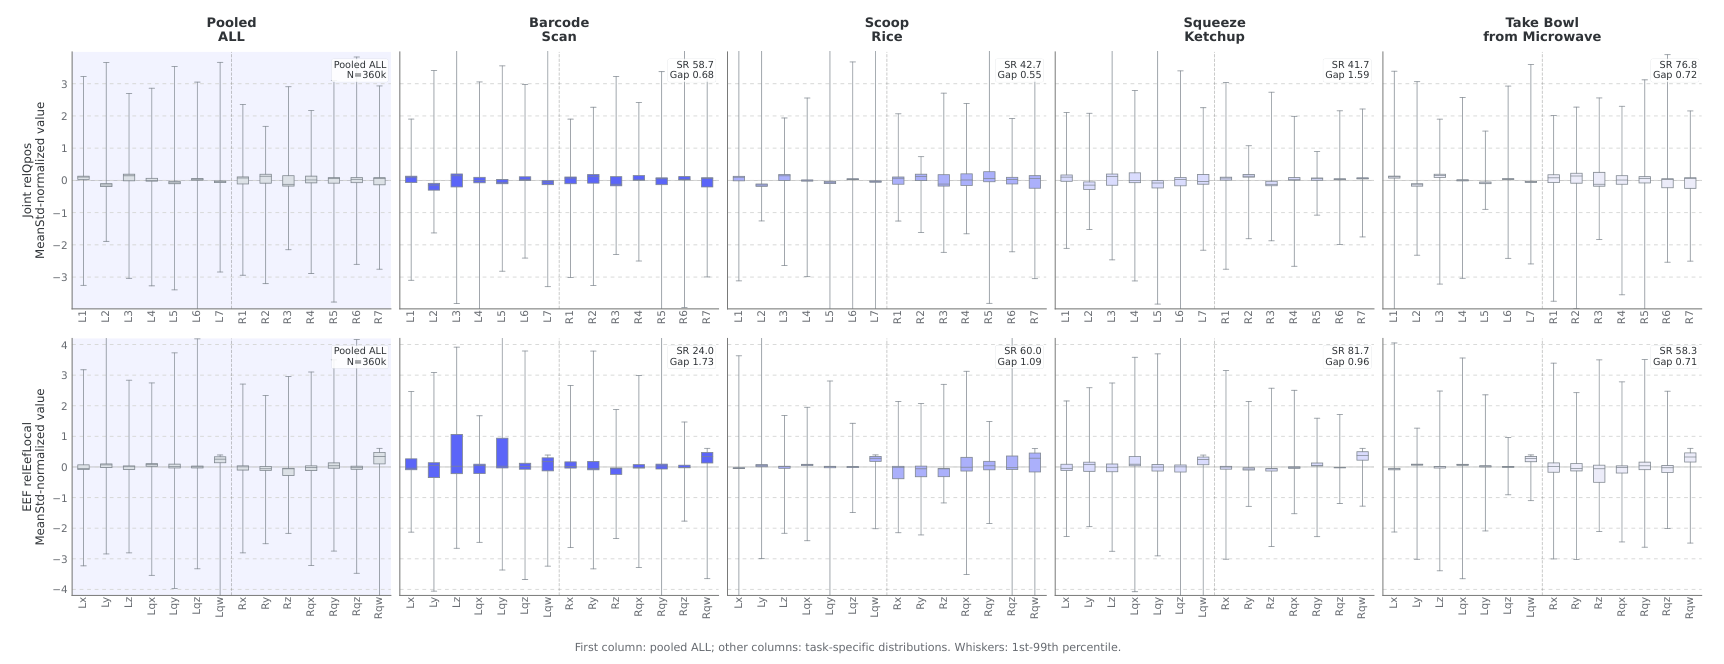
原图注:Figure 11. Per-dimension MeanStd-normalized action distributions for joint and EEF action spaces. The first column shows the pooled distribution over all four tasks, while the remaining columns show task-specific distributions. The gap measures task-to-pooled distribution alignment based on per-dimension median and IQR differences.
译文图注:图 11:关节与 EEF 两种动作空间下,经 MeanStd 归一化后的逐维动作分布。第一列为四个任务合并后的分布,其余各列为各任务自身的分布。gap(差距)基于逐维中位数与四分位距(IQR)的差异,衡量任务分布与合并分布的对齐程度。图 11 解读
布局:2 行 \times 5 列。上行为关节空间的相对动作
relQpos,横轴为 14 个维度 L1–L7(左臂 7 个关节)与 R1–R7(右臂);下行为 EEF 空间的局部相对位姿 relEefLocal,横轴为 Lx, Ly, Lz(左手位置)、Lqx, Lqy, Lqz, Lqw(左手四元数)及右手对应的 7 维。纵轴为 MeanStd 归一化后的数值。第 1 列(浅紫底)为合并分布(Pooled ALL,样本数 N = 360k),第 2–5 列依次为扫码、舀米、挤番茄酱、微波炉取碗。图元:每个维度一个箱线图,箱体为四分位距(IQR,25%–75% 分位),中间横线为中位数,须线延伸到第 1 与第 99 百分位(图下注:Whiskers: 1st–99th percentile)。箱体颜色越深表示该维度相对合并分布偏离越大。每个子图右上角标注该任务在该动作空间下的成功率(SR)和 gap。读数:关节空间 gap 为 0.68 / 0.55 / 1.59 / 0.72,对应 SR 58.7 / 42.7 / 41.7 / 76.8;EEF 空间 gap 为 1.73 / 1.09 / 0.96 / 0.71,对应 SR 24.0 / 60.0 / 81.7 / 58.3。可见现象:扫码任务在 EEF 空间中 Lz、Lqy 等维度的箱体明显偏离 0 且很宽(左手需要持续举高药盒并调整朝向),所以 gap 最大(1.73);四元数的 w 分量(Lqw、Rqw)在多个任务中略高于 0,这是四元数表示的固有特点(小旋转时 q_w\approx1,相对量不以 0 为中心)。整体上多数维度的箱体很窄、集中在 0 附近,而须线伸到 \pm3 左右,说明相对动作分布“中心尖、尾部长”,这也是后文讨论归一化方式的前提。 原文
Action space. For the action space, EEF and joint actions obtain similar average success rates, 56.0 and 55.0, respectively, but show different task-level preferences. To analyze this, Figure 11 compares the per-dimension MeanStd-normalized action distributions of each task against the pooled distribution over all four tasks. We additionally report a distribution-alignment gap, computed from the per-dimension median and IQR differences between each task and the pooled distribution; a smaller gap indicates that the task-specific action distribution is closer to the overall distribution.
译文
动作空间。在动作空间上,EEF 动作与关节动作的平均成功率相近,分别为 56.0 和 55.0,但表现出不同的任务级偏好。为分析这一点,图 11 将每个任务的逐维 MeanStd 归一化动作分布与四个任务合并后的分布进行比较。我们还报告一个分布对齐差距(gap),它由每个任务与合并分布之间逐维的中位数差异和 IQR 差异计算得到;gap 越小,说明该任务的动作分布越接近总体分布。
解释
两种动作空间:关节空间直接预测各关节角增量;EEF(末端执行器)空间预测手爪在笛卡尔空间中的位置与姿态增量,再由逆运动学换算成关节角。 gap 的直觉:模型在 4 个任务混合的数据上训练,归一化统计量(均值、标准差)由合并数据计算。若某任务的动作分布与合并分布差别很大,对该任务而言归一化后的目标就会偏离 0、尺度失衡,可能更难学。gap 的具体公式原文未给出,只说是逐维中位数差与 IQR 差的组合,可理解为 \frac{1}{D}\sum_d\big(|\mathrm{med}_d^{\text{task}}-\mathrm{med}_d^{\text{pool}}|+|\mathrm{IQR}_d^{\text{task}}-\mathrm{IQR}_d^{\text{pool}}|\big) 一类的度量(推测)。
原文
The results show that distribution alignment explains part, but not all, of the action-space behavior. For Barcode Scan, joint actions are much closer to the pooled distribution than EEF actions, with a gap of 0.68 versus 1.73, consistent with the large performance advantage of joint actions (58.7 vs. 24.0). For Squeeze Ketchup, the opposite trend appears: EEF actions have a smaller gap than joint actions (0.96 vs. 1.59) and achieve much higher success (81.7 vs. 41.7), suggesting that contact-rich endpoint motions are better represented in Cartesian EEF space.
译文
结果表明,分布对齐能解释动作空间表现的一部分,但不是全部。对于扫条形码,关节动作比 EEF 动作更接近合并分布,gap 为 0.68 对 1.73,这与关节动作的大幅性能优势(58.7 对 24.0)一致。对于挤番茄酱,则出现相反趋势:EEF 动作的 gap 小于关节动作(0.96 对 1.59),且成功率高得多(81.7 对 41.7),说明接触丰富的末端运动在笛卡尔 EEF 空间中表示得更好。
解释
这两个任务是“gap 能解释”的正例:gap 小的一方成功率高。挤番茄酱需要双手对瓶身施加挤压,关注的是手爪之间的相对位置与接触方向,这在笛卡尔空间里是简单的“两手相向靠近”,在关节空间里却是多个关节的复杂组合,所以 EEF 更合适。
原文
For Scoop Rice, however, EEF actions outperform joint actions despite a larger distribution gap, indicating that Cartesian motion regularity can outweigh pure distribution alignment. For Take Bowl from Microwave, the two gaps are nearly identical (0.71–0.72), while joint actions still perform better, suggesting that posture, reachability, and configuration-dependent constraints are more important than marginal action statistics. Overall, the best action space depends on both distributional alignment and the physical structure of the task.
译文
然而对于舀米,尽管 EEF 动作的分布差距更大,它仍然优于关节动作,说明笛卡尔空间中运动的规律性可以压过单纯的分布对齐。对于从微波炉取碗,两者的 gap 几乎相同(0.71–0.72),但关节动作依旧表现更好,说明姿态、可达性以及依赖构型的约束比边缘动作统计量更重要。总体而言,最佳动作空间既取决于分布对齐,也取决于任务的物理结构。
解释
这两个任务是“gap 解释不了”的反例:舀米(EEF gap 1.09 > 关节 0.55,但 EEF 60.0 > 关节 42.7)——舀、倒的动作在笛卡尔空间中是规整的轨迹(勺子平移 + 绕某轴翻转),EEF 表示更简单;微波炉取碗(gap 0.71 vs 0.72,但关节 76.8 > EEF 58.3)——手臂要伸进微波炉内部,空间狭窄,关节构型(例如肘部朝向)决定能否避开门框,而 EEF 表示不包含这种“冗余自由度”信息,逆运动学可能给出不合适的构型。 结论的意义:不存在普适最优的动作空间。“marginal action statistics(边缘动作统计量)”指只看每一维单独的分布,不考虑各维之间的联合关系和物理约束。2.0 的默认配置选择了关节空间,但 55 维统一向量中同时保留了关节与 EEF 两个字段,在不同数据源上可以灵活使用。
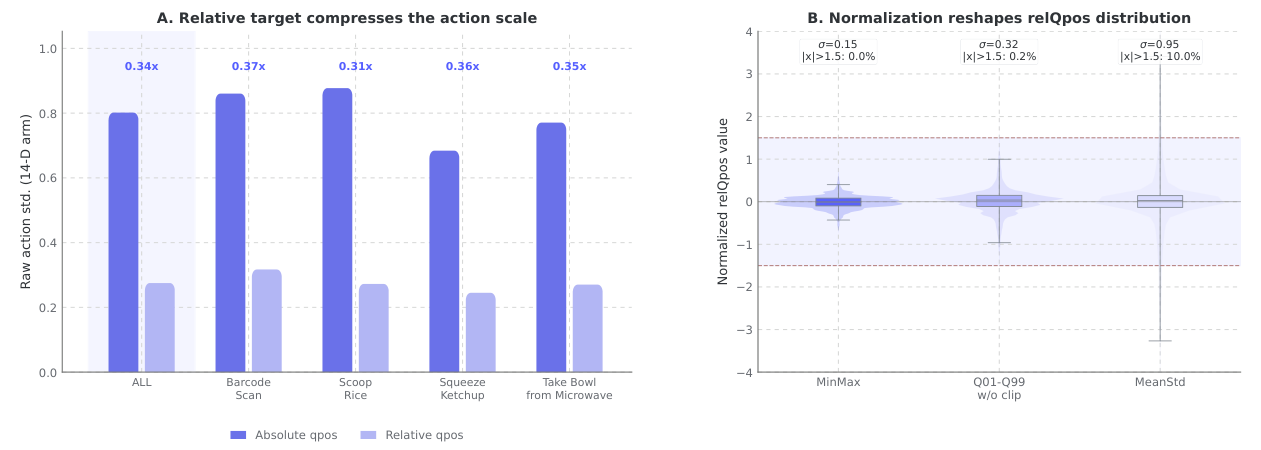
原图注:Figure 12. Action targets and normalization statistics for the four GM-100 tasks. Left:
译文图注:图 12:四个 GM-100 任务的动作目标与归一化统计。左:与 relQpos substantially reduces the action scale compared with absQpos. Right: normalization changes the effective dynamic range of MeanStd-normalized relQpos; Q01–Q99 is shown in the actual unclipped setting.absQpos 相比,relQpos 大幅缩小了动作尺度。右:不同归一化方式改变了 relQpos 归一化后的有效动态范围;Q01–Q99 按实际使用的不截断设置绘制。图 12 解读
左图 A “Relative target compresses the action scale(相对目标压缩了动作尺度)”:横轴为合并数据(ALL,浅紫底)及 4 个任务,纵轴为 14 维手臂动作的原始标准差。深色柱为绝对关节位置(Absolute qpos),浅色柱为相对关节位置(Relative qpos),上方蓝字为二者之比:ALL 0.34\times、扫码 0.37\times、舀米 0.31\times、挤番茄酱 0.36\times、微波炉取碗 0.35\times。绝对动作标准差约 0.68–0.87,相对动作约 0.24–0.32,即相对目标的波动只有绝对目标的约三分之一。右图 B “Normalization reshapes relQpos distribution(归一化重塑了 relQpos 分布)”:横轴为三种归一化方式 MinMax、Q01–Q99(w/o clip,不截断)、MeanStd,纵轴为归一化后的数值;每种方式画出小提琴图 + 箱线图,须线为 1%–99% 分位;两条水平虚线标出 \pm1.5。每列顶部标注:MinMax \sigma=0.15、|x|>1.5 占 0.0%;Q01–Q99 \sigma=0.32、占 0.2%;MeanStd \sigma=0.95、占 10.0%。可以直观看到 MinMax 的分布被压成一条窄缝,MeanStd 则铺开到约 [-3.2, 3.3]。作用:A 图解释为何相对动作更好(目标方差更小),B 图解释为何 MeanStd 更好(有效分辨率更高)。
原文
Normalization. For normalization, Figure 12B shows the normalized
relQpos distributions under the three schemes. MinMax compresses most samples into a narrow range: its normalized standard deviation is only 0.15, and the 1st–99th percentile interval is approximately [-0.42, 0.40]. This strong compression reduces the effective resolution of the action targets, which explains its lower average success rate of 47.5.译文
归一化。在归一化方面,图 12B 展示了三种方案下归一化后的
relQpos 分布。MinMax 把大多数样本压缩到一个很窄的区间内:其归一化后的标准差仅为 0.15,第 1–99 百分位区间约为 [-0.42, 0.40]。这种强烈压缩降低了动作目标的有效分辨率,这解释了它较低的平均成功率 47.5。解释
三种归一化公式: MinMax:\tilde{x}=2\frac{x-x_{\min}}{x_{\max}-x_{\min}}-1,把全体数据的最小、最大值映射到 \pm1; Q01–Q99:同上,但用第 1、第 99 百分位代替最小、最大值; MeanStd:\tilde{x}=(x-\mu)/\sigma,即 Z 分数标准化。 MinMax 的问题:相对动作分布“中心尖、尾部长”,最大/最小值由极少数极端样本决定。例如若中心样本大多在 \pm0.1 以内而极值达到 \pm2.5,MinMax 后中心样本只占 \pm0.04 的区间——98% 的数据挤在不到 5% 的数值范围里。对流匹配这类以单位高斯噪声为起点的生成模型而言,目标尺度远小于噪声尺度,网络必须分辨极小的差异,有效精度下降。
原文
Q01–Q99 increases the normalized standard deviation to 0.32 and expands the central mass to roughly [-0.96, 1.01]. Importantly, the actual implementation used here is not clipped; only about 0.2% of values fall outside [-1.5, 1.5]. Thus, its weakness is not information loss from clipping, but rather that the normalized targets remain much more compressed than under MeanStd. This explains why Q01–Q99 improves the central dynamic range over MinMax but still achieves a similar average success rate of 47.4.
译文
Q01–Q99 把归一化后的标准差提高到 0.32,并把中心质量扩展到约 [-0.96, 1.01]。需要强调的是,这里实际使用的实现并未截断;只有约 0.2% 的数值落在 [-1.5, 1.5] 之外。因此,它的弱点不在于截断造成的信息损失,而在于归一化后的目标仍比 MeanStd 下压缩得多。这解释了为什么 Q01–Q99 相比 MinMax 改善了中心动态范围,平均成功率却依然相近,为 47.4。
解释
为何特意说明“未截断”:Q01–Q99 归一化在 \pi_0 等工作中常见,通常还会把超出 [-1,1] 的值截断。作者排除了“截断丢掉了大幅纠正动作”这一解释,把问题归结为尺度仍偏小。 一个小矛盾:按定义,第 1、99 百分位应被映射到 \pm1,因而第 1–99 百分位区间应恰为 [-1,1];文中的 [-0.96, 1.01] 接近但不完全相等,可能是因为统计量按单个维度计算、而图中是 14 维合并后的分布。
原文
MeanStd provides the largest effective dynamic range, with normalized standard deviation 0.95 and a 1st–99th percentile interval of approximately [-3.22, 3.30]. Around 10.0% of samples lie outside |x| > 1.5, reflecting the long-tailed structure of the relative action distribution rather than clipping. By preserving these larger corrective motions, MeanStd achieves the best average success rate of 55.0.
译文
MeanStd 提供了最大的有效动态范围,归一化后的标准差为 0.95,第 1–99 百分位区间约为 [-3.22, 3.30]。约 10.0% 的样本落在 |x|>1.5 的范围之外,反映的是相对动作分布的长尾结构,而非截断。通过保留这些较大的纠正性动作,MeanStd 取得了最佳的平均成功率 55.0。
解释
标准差为何是 0.95 而不是 1:MeanStd 按每个维度各自计算均值与标准差,归一化后每维标准差应为 1;合并统计时若各维样本或计算口径略有差异,会得到 0.95 这样接近 1 的值。 长尾的含义:对标准正态分布,|x|>1.5 的概率约为 13%;这里为 10%,但第 1–99 百分位达到 \pm3.2(正态分布约为 \pm2.33),说明分布比正态更“尖峰厚尾”。这些尾部样本对应较大的纠正动作(如抓偏后的快速调整),MeanStd 让它们在数值上依然可分辨。 与流匹配的契合:MeanStd 后目标尺度与 \mathcal{N}(0,I) 噪声相当,这对从高斯噪声出发的流匹配是更自然的设置(这是译者的补充解释,原文未提及)。
原文
Loss function. For the loss function, L2 achieves the best average performance, improving over L1 from 46.4 to 55.0. Since most
relQpos targets are small continuous corrections around zero, L2 better fits the high-density region of the action distribution and encourages precise regression. L1 performs better on Squeeze Ketchup, consistent with its robustness to contact-rich or heavy-tailed motions, but underperforms on the other three tasks.译文
损失函数。在损失函数方面,L2 取得最佳平均性能,相比 L1 从 46.4 提升到 55.0。由于大多数
relQpos 目标是围绕零的小幅连续修正,L2 能更好地拟合动作分布的高密度区域,并促进精确回归。L1 在挤番茄酱任务上表现更好,这与它对接触丰富或重尾运动的鲁棒性相一致,但在其余三个任务上表现较差。解释
损失作用于何处:在流匹配框架下,这里的 L1/L2 应是速度场预测误差的范数(\|v_\theta-v\|_1 或 \|v_\theta-v\|_2^2),原文没有写明。 直觉:L2 的梯度与误差成正比,小误差时梯度也小,能“精细打磨”接近 0 的大量样本;L1 的梯度大小恒定,对离群值不敏感,但在误差很小时仍以固定步长更新,不易精确收敛。挤番茄酱任务再次成为例外(L1 61.7 对 L2 41.7),与前面几组对比一致:该任务似乎在各方面都偏好与默认配置相反的选择。
6.2双查询蒸馏的感知结果(Perceptual Results of Dual-query Distillation)
原文
We adopt LingBot-Depth and DINO-Video as the visual teacher models for distillation training. Despite perceptual results not being essential for action generation, integrating specific task queries allows the VLA to obtain visual perceptual outcomes during causal inference. As shown in Fig. 13, we present the causal perception results of LingBot-VLA 2.0, which validate the effectiveness of our model in distilling semantic priors and geometric cues.
译文
我们采用 LingBot-Depth 和 DINO-Video 作为蒸馏训练的视觉教师模型。尽管感知结果对动作生成并非必需,但引入特定的任务查询使 VLA 能在因果推理过程中获得视觉感知输出。如图 13 所示,我们展示了 LingBot-VLA 2.0 的因果感知结果,验证了我们的模型在蒸馏语义先验与几何线索方面的有效性。
解释
这一节证明了什么:它说明查询 token 确实学到了教师特征——经过投影模块后,能还原出与教师相近的深度图和 DINO 特征图,包括对未来帧的预测。 没有证明什么:这里没有“去掉蒸馏后成功率下降多少”的定量消融,也没有给出深度或特征预测误差的数值。因此“预测性动力学建模提升了动作性能”这一主张在本文中缺少直接的定量支持,只能从表 5 中 2.0 与 1.0 的整体差异间接推断(而这一差异还混有更换 VLM 主干、数据扩展等因素)。 副产品:推理时 VLA 可以“顺便”输出深度与语义特征图,可用于可视化调试或作为下游模块的输入。
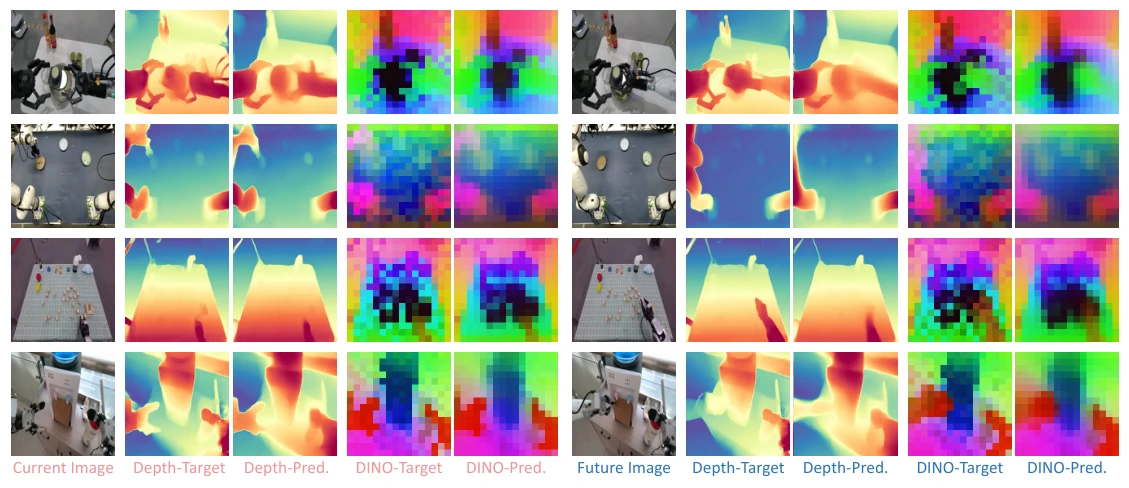
原图注:Figure 13. Causal perception results of LingBot-VLA 2.0 under visual distillation. Left: depth/DINO-Video-PCA ground truth and prediction for current image. Right: depth/DINO-Video-PCA ground truth and prediction for future image.
译文图注:图 13:视觉蒸馏下 LingBot-VLA 2.0 的因果感知结果。左:当前图像的深度 / DINO-Video-PCA 真值与预测。右:未来图像的深度 / DINO-Video-PCA 真值与预测。图 13 解读
布局:4 行为 4 个不同场景(双臂夹爪桌面操作、俯视桌面、带标记物的桌面、厨房微波炉场景)。每行左半 5 列为当前帧:Current Image(原始 RGB)、Depth-Target(教师深度)、Depth-Pred.(VLA 预测深度)、DINO-Target(教师 DINO-Video 特征的 PCA 伪彩色)、DINO-Pred.(预测特征);右半 5 列为对应的未来帧(Future Image 及其深度、DINO 的真值与预测)。 如何读:深度图中暖色(黄)近、冷色(红紫)远,或相反,取决于色表,关键是对比 Target 与 Pred. 的形状是否一致。DINO-PCA 图把高维特征投影到前 3 个主成分并映射为 RGB,颜色相同表示语义相近(例如夹爪、桌面、物体各成一色块)。 能读出的结论:(1) 深度预测整体形状与真值高度吻合,桌面平面梯度、夹爪轮廓都被还原,但边缘较模糊,细节较少;(2) DINO 特征预测还原了主要的色块分区,即主要物体与背景的语义分割结构,但比真值更平滑、块状更明显;(3) 未来帧预测也基本正确地反映了夹爪/物体位置的变化,说明未来查询确实编码了场景演化的信息。 局限:仅为若干定性样例,未报告定量指标,也未展示失败案例。
7结论(Conclusion)
原文
LingBot-VLA 2.0 narrows the gap between VLA foundation models and real-world robotic deployment by improving generalization, expanding whole-body action modeling, and strengthening temporal reasoning through predictive dynamics. With large-scale robot and egocentric pretraining data, LingBot-VLA 2.0 achieves improved performance on the GM-100 benchmark and demonstrates strong long-horizon mobile manipulation across multiple robotic platforms.
译文
LingBot-VLA 2.0 通过提升泛化能力、扩展全身动作建模,以及借助预测性动力学增强时间推理,缩小了 VLA 基础模型与真实世界机器人部署之间的差距。依托大规模机器人数据与第一视角预训练数据,LingBot-VLA 2.0 在 GM-100 基准上取得了更好的性能,并在多个机器人平台上展现出强大的长时程移动操作能力。
解释
结论与摘要基本一一对应,没有给出局限性或未来工作。综合全文,可以把证据强弱整理如下:
- 证据较充分:MoE 动作专家在等激活参数下优于稠密模型(图 7);相对关节动作、MeanStd 归一化、L2 损失的选择(图 10、图 12);DINO-Video 作为教师的表征质量(表 3)。
- 证据为整体性的:GM-100 与移动操作上相对 1.0 和 \pi_{0.5} 的提升(表 5、表 6),但无法区分数据扩展、更换 VLM 主干、MoE、蒸馏各自贡献了多少,且每格只有 10–15 次试验,部分差距在统计波动范围内。
- 缺少定量证据:双查询蒸馏对动作成功率的贡献(只有图 13 的定性可视化);人类第一视角数据对机器人任务的贡献(没有“去掉人类数据”的对照)。
原文
Acknowledgment. We thank Fangyi Xu, Ningyuan Huang, Haotian Liu, Jialiang Zheng, Liping Zhang, Weilun Yao, Shuai Wang, Linyu Su, Fan Fan, Bo Jiang, Jingmei Zhao, Shuai Zhou, Yinghao Xu and Haiwei Liang for help with data, evaluation experiments, training infrastructure, robot hardware, and robot software. We also gratefully acknowledge Ant Digital Technologies' Phecda Laboratory and Genrobot.ai Co., Ltd. for providing the egocentric data.
译文
致谢。作者感谢 14 位同事在数据、评测实验、训练基础设施、机器人硬件与软件方面提供的帮助(名单见原文)。作者还感谢蚂蚁数科(Ant Digital Technologies)天玑(Phecda)实验室与 Genrobot.ai 公司提供第一视角数据。
解释
致谢为人员名单,此处从简。值得注意的是,第一视角人类数据部分来自外部合作方(蚂蚁数科 Phecda 实验室与 Genrobot.ai),这也从侧面印证了作者团队隶属蚂蚁集团体系。