Liber-0:从 220 万小时人类经验中
涌现的多步操作零样本能力
Liber-0: Emergent Zero-Shot Capabilities in Multi-Step Manipulation
from 2.2 Million-Hour Human Experience
LiberAI 团队(BibTeX 署名 “Liberai Team”,页面未列出个人作者)
网页技术报告(博客形式,无 PDF / arXiv 版本)
来源:https://www.liberai.com/blog/liber0/
发布日期:页面未标注;据页面视频与图片文件名中的
中文逐段翻译与解释
整理日期:2026 年 11 月 7 日
涌现的多步操作零样本能力
Liber-0: Emergent Zero-Shot Capabilities in Multi-Step Manipulation
from 2.2 Million-Hour Human Experience
LiberAI 团队(BibTeX 署名 “Liberai Team”,页面未列出个人作者)
网页技术报告(博客形式,无 PDF / arXiv 版本)
来源:https://www.liberai.com/blog/liber0/
发布日期:页面未标注;据页面视频与图片文件名中的
20261104 推断约为 2026 年 11 月 4 日中文逐段翻译与解释
整理日期:2026 年 11 月 7 日
解释
阅读方式。沿用本工作区已完成译文的三联框:灰色框保留英文原文,蓝色框给出中文译文,橙色框解释概念、设计动机、数字验算和结论边界。原文是一篇网页技术博客,共 6 个正文章节(另有参考文献和 BibTeX),含 12 幅图和若干嵌入视频。12 幅图全部转为位图插入,并附原图注、译图注和绿色解读框。视频无法放进 PDF,因此每段视频取页面提供的封面帧(poster)作代表图,并在图注中注明“原文为视频”;首页总览视频和 9 个零样本演示视频也按同样方式处理。保留原文的章节和图号;原文引用沿用网页上的方括号编号 [1]–[12],参考文献列表保留英文,不翻译。原文没有公式,也没有表格,书中的表格都是译者为便于核对,从图中读出数字后重排的。解释框是本译稿的分析,不属于作者原文。
来源与许可。原文:https://www.liberai.com/blog/liber0/(2026-11-07 用 curl 抓取的静态 HTML,正文完整,未经 JS 渲染)。页面未声明任何开放许可,内容版权归 LiberAI 及原作者所有;本译稿仅供个人学习研究,不宜公开再分发。
来源与许可。原文:https://www.liberai.com/blog/liber0/(2026-11-07 用 curl 抓取的静态 HTML,正文完整,未经 JS 渲染)。页面未声明任何开放许可,内容版权归 LiberAI 及原作者所有;本译稿仅供个人学习研究,不宜公开再分发。
目录
导读1 引言(Introduction)2 模型(Model)3 LiberSense 手套与 LEO 机器人(LiberSense Glove & LEO Robot)3.1 LiberSense 手套:可扩展的动作锚定数据采集(LiberSense Glove: Scalable Action-Grounded Data Collection)3.2 LEO:让机器人的观测与运动对齐人类示范(LEO: Aligning Robot Observation and Motion with Human Demonstrations)4 把人类经验扩展为机器人技能(Scaling Human Experience into Robot Skills)4.1 不同数据源的规模律(Scaling Laws of Various Data Sources)4.2 机器人操作的零样本实验(Zero-Shot Experiments of Robot Manipulation)4.3 Liber-0 的分阶段预训练(Staged Pretraining of Liber-0)4.4 数据与基准(Data & Benchmarks)5 评估人到机器人的迁移(Evaluating Human-to-Robot Transfer)5.1 用更少的机器人数据训练(Training with Less Robot Data)5.2 从手套数据中学习新技能(Learning New Skills from Glove Data)5.3 形态规模律(Morphology Scaling Law)5.4 像人的本体适合人的技能(Human-like Embodiment for Human Skills)6 结论与未来方向(Conclusion and Future Directions)7 参考文献(References)8 BibTeX译者附注:原文数字核对与阅读提示汇总导读
本文解决的问题。互联网上有海量的人类活动视频,大语言模型靠“规模”成功,机器人领域自然希望复制这条路,但人类视频不能直接当机器人动作数据用。作者把障碍归为三道鸿沟:身体不同(本体鸿沟),从视频估计出来的手部姿态又噪又缺(动作监督鸿沟),摄像机视角和人手外观与机器人不同(视觉鸿沟)。Liber-0 是 LiberAI 发布的世界动作模型(WAM),它的回答是:用大规模人类视频学“世界怎么变化”,用自研数据手套采集的“视频 + 实测手部动作”给视频经验打上动作锚点,再把机器人本体做得尽量像人,从而把 220 万小时的人类经验转成可执行的机器人技能。方法的完整链条。模型侧是一个 Mixture-of-Transformers(语言、视觉、动作三个专家,通过多模态自注意力交互),同时预测未来画面和未来动作;状态、本体描述(“统一本体表示”)和带噪动作经一个共享的“物理编码器”送进动作专家;另外用 VQA、分割、图像编辑、视频理解做语义联合训练,多步任务可以外接 GPT-6 Astra 之类的推理智能体给出子目标。数据侧有三阶段预训练:阶段 1 只做视觉预测(不学动作);阶段 2 联合预测画面和动作;阶段 3 加大手套和遥操作数据的采样比例。硬件侧有两件东西:0.3 mm 厚、131 g 的 LiberSense 数据手套,配胸前第一人称相机和两个腕部相机;以及 LEO 机器人,它有三自由度手腕、细长前臂、可俯仰升降的腰部、灵巧手,相机布局与手套采集一致;从图 4 和视频截帧看,LEO 的灵巧手外面也套着与采集手套外观相近的米色手套。| 概念 | 本文中的具体含义 |
| 世界动作模型(WAM) | 同时预测未来视觉帧和未来动作的模型;视频预测可以利用无动作标签的数据,动作预测则受益于学到的物理先验。 |
| 手套数据(Glove) | LiberSense 手套采集的人类操作数据:21 关键点手部姿态与轨迹,配同步的第一人称视频和腕部视频。 |
| 动作锚点(action anchor) | 本文的比喻:手套数据带有真实测得的动作,把只有画面的海量人类视频“钉”到可执行的动作上。 |
| 统一本体表示 | 把人手与机器人的几何、运动学编码进同一空间,作为动作预测的条件(“把本体当上下文”)。 |
| PnP / Non-PnP | 抓取放置(pick-and-place)任务 / 其他操作(折叠、开合、按压、推拉等)。 |
| 进度分(progress score) | 0–100 分,按里程碑(接近、对准、抓取、搬运、松开、放稳等)给部分分,不等于成功率。 |
| kh | 千小时;10 kh = 1 万小时,2,000 kh = 200 万小时。 |
| 后训练(post-training) | 在预训练模型上再用机器人数据微调;“直接评估”指不做这一步。 |
| 零样本(任务级) | 评测任务没有专门采集过机器人示范;不等于模型从未见过类似动作。 |
| Astra-only | 直接让 GPT-6 Astra 当机器人策略(不用 Liber-0)的对照。 |
| Teleop | 机器人遥操作数据;在图 6 中与“跨本体机器人数据”分开列出。 |
1引言(Introduction)
原文
Liber-0
Emergent Zero-Shot Capabilities in Multi-Step Manipulation from 2.2 Million-Hour Human Experience
[Video: Liber-0 overview]
Emergent Zero-Shot Capabilities in Multi-Step Manipulation from 2.2 Million-Hour Human Experience
[Video: Liber-0 overview]
译文
Liber-0
从 220 万小时人类经验中涌现的多步操作零样本能力
[视频:Liber-0 总览]
从 220 万小时人类经验中涌现的多步操作零样本能力
[视频:Liber-0 总览]
页首总览视频(截取封面帧)。原文此处是一段发布视频(
liber0-launch-final-20261104.mp4),PDF 中只能放页面提供的封面帧。原图注:(No caption on the page; the video is embedded below the title, with the fallback text “Download Liber-0 overview”.)
解释
网页的标题区只有主标题、副标题和一段总览视频,没有作者列表、单位和日期;BibTeX 中署名为 “Liberai Team”,视频文件名带有
20261104,据此推断发布时间约为 2026 年 11 月 4 日。副标题里的三个关键词是全文的论点:涌现(作者认为零样本能力不是专门训练出来的,而是在大规模预训练后自然出现的)、多步操作(不只是抓取放置)、220 万小时人类经验(数据主体是人类视频,而不是机器人数据)。这里的“零样本”是任务级的,即测试任务没有专门采集过机器人示范,后文第 4.2 节会给出定义。 原文
Beyond reasoning, human intelligence relies on intuition to interact with the physical world—coordinating perception and movement, regulating force, and adapting to feedback without explicit deliberation. While AI has made remarkable progress in reasoning, developing comparable intuition for manipulation remains a fundamental challenge.
译文
除了推理,人类智能还依赖直觉与物理世界交互:协调感知与运动、调节力度、根据反馈随时调整,而无需显式的深思熟虑。AI 在推理方面已取得了显著进展,但为操作任务发展出类似的直觉,仍然是一项根本性的挑战。
解释
开篇把智能分成“推理”和“直觉”两种,类似认知科学里“系统 2 / 系统 1”的说法。作者的意思是:大语言模型解决了推理,但拿杯子时手指该用多大力、碰到阻力怎么调整这类“不用想就会做”的能力,语言模型并不具备。后文的实验设计正是围绕这一点:第 4.2 节让 GPT-6 Astra(擅长推理)直接控制机器人,结果在需要精确接触的任务上几乎全部失败;而 Liber-0 代表的“直觉”式策略在同样的任务上表现好得多。
原文
Traditionally, robot manipulation relies on demonstrations collected for specific robots and tasks, an approach that is costly and hard to scale [1]. Human experience offers a much broader range of physical interactions, much of it already captured as internet-scale video. Recent studies have demonstrated the value of learning from such data, with emerging evidence of favorable scaling trends [2], [3], [4].
译文
传统上,机器人操作依赖为特定机器人和特定任务采集的示范,这种方式成本高、难以扩展 [1]。人类经验涵盖的物理交互要广泛得多,其中很大一部分已经以互联网规模的视频形式被记录下来。近期的研究已经展示了从这类数据中学习的价值,并开始出现有利的规模扩展趋势的证据 [2]、[3]、[4]。
解释
[1] 是 DROID,一个大规模真实场景机器人操作数据集,代表“为机器人专门采集示范”这条路线:即便是 DROID 这样的大型协作项目,数据量也只有数万条轨迹、数百小时量级,远小于人类视频。[2]–[4] 是三项“从人类数据扩展”的近期工作:Dyna-2(号称 100 万小时的 WAM 规模律)、Light-O1(用人类动作预训练全身智能)和 EgoScale(用多样的第一人称人类数据扩展灵巧操作)。这一段的论证逻辑是:机器人数据贵,人类数据多,而且已有证据表明“更多人类数据 \to 更好的机器人表现”。下一段马上指出,这条路并不平坦。
原文
However, learning from human video is less straightforward than learning from text in large language models (LLMs). Human experience does not directly translate into executable robot actions, owing to three gaps:
- Embodiment Gap. Humans and robots differ in morphology, kinematics, and ranges of motion. The same manipulation objective can therefore require different movements across embodiments.
- Action-Supervision Gap. Hand poses and trajectories inferred from video can be noisy or incomplete due to occlusions, inaccurate depth, and estimation errors, limiting their reliability as supervision for precise manipulation [5].
- Visual Gap. Human recordings and robot observations differ in camera placement, viewpoint, and the appearance of hands and bodies, creating a visual distribution shift at deployment [6].
译文
然而,从人类视频中学习并不像大语言模型(LLM)从文本中学习那样直接。人类经验无法直接转化为机器人可执行的动作,原因在于三道鸿沟:
- 本体鸿沟(Embodiment Gap)。人与机器人在形态、运动学和运动范围上都不同,因此同一个操作目标在不同本体上可能需要不同的动作。
- 动作监督鸿沟(Action-Supervision Gap)。从视频推断出的手部姿态和轨迹会因遮挡、深度不准和估计误差而带有噪声或不完整,作为精确操作的监督信号并不可靠 [5]。
- 视觉鸿沟(Visual Gap)。人类录像与机器人观测在相机位置、视角以及手和身体的外观上都不同,部署时会造成视觉分布偏移 [6]。
解释
这三道鸿沟是全文的骨架,后面每个设计都对应其中一道。本体鸿沟举例:人的手腕能在前臂不动的情况下大幅旋转,而很多机械臂必须转动整条手臂才能实现同样的末端旋转,所以人类视频里的“转腕开旋钮”不能照搬。本文的对策是“统一本体表示”(第 2 节)和像人的 LEO 机器人(第 3.2 节)。动作监督鸿沟:LLM 的文本本身就是要预测的目标,而视频里只有像素,手的 3D 姿态需要用视觉算法估计,被物体挡住的手指、单目深度误差都会让估计结果不可靠。[5] DexCap 用动捕手套解决这一问题,本文的 LiberSense 手套(第 3.1 节)走的也是这条路。视觉鸿沟:网络视频是各种机位拍的,机器人相机则固定在头部或腕部,画面里的“手”也是金属或塑料的。[6] EgoMimic 用第一人称视频统一视角,本文则让手套采集和 LEO 的相机布局一致。
原文
These gaps motivate a central question: How can we turn large-scale physical experience from human activities into generalizable action capabilities?
译文
这些鸿沟引出一个核心问题:如何把来自人类活动的大规模物理经验转化为可泛化的动作能力?
解释
注意问题的措辞是“物理经验”转为“动作能力”。人类视频提供的是“世界会怎样变化”的经验(物体如何被推动、抽屉如何被拉开),而机器人需要的是“我的关节该怎么动”。世界动作模型的思路就是同时学这两者,让前者为后者提供先验。
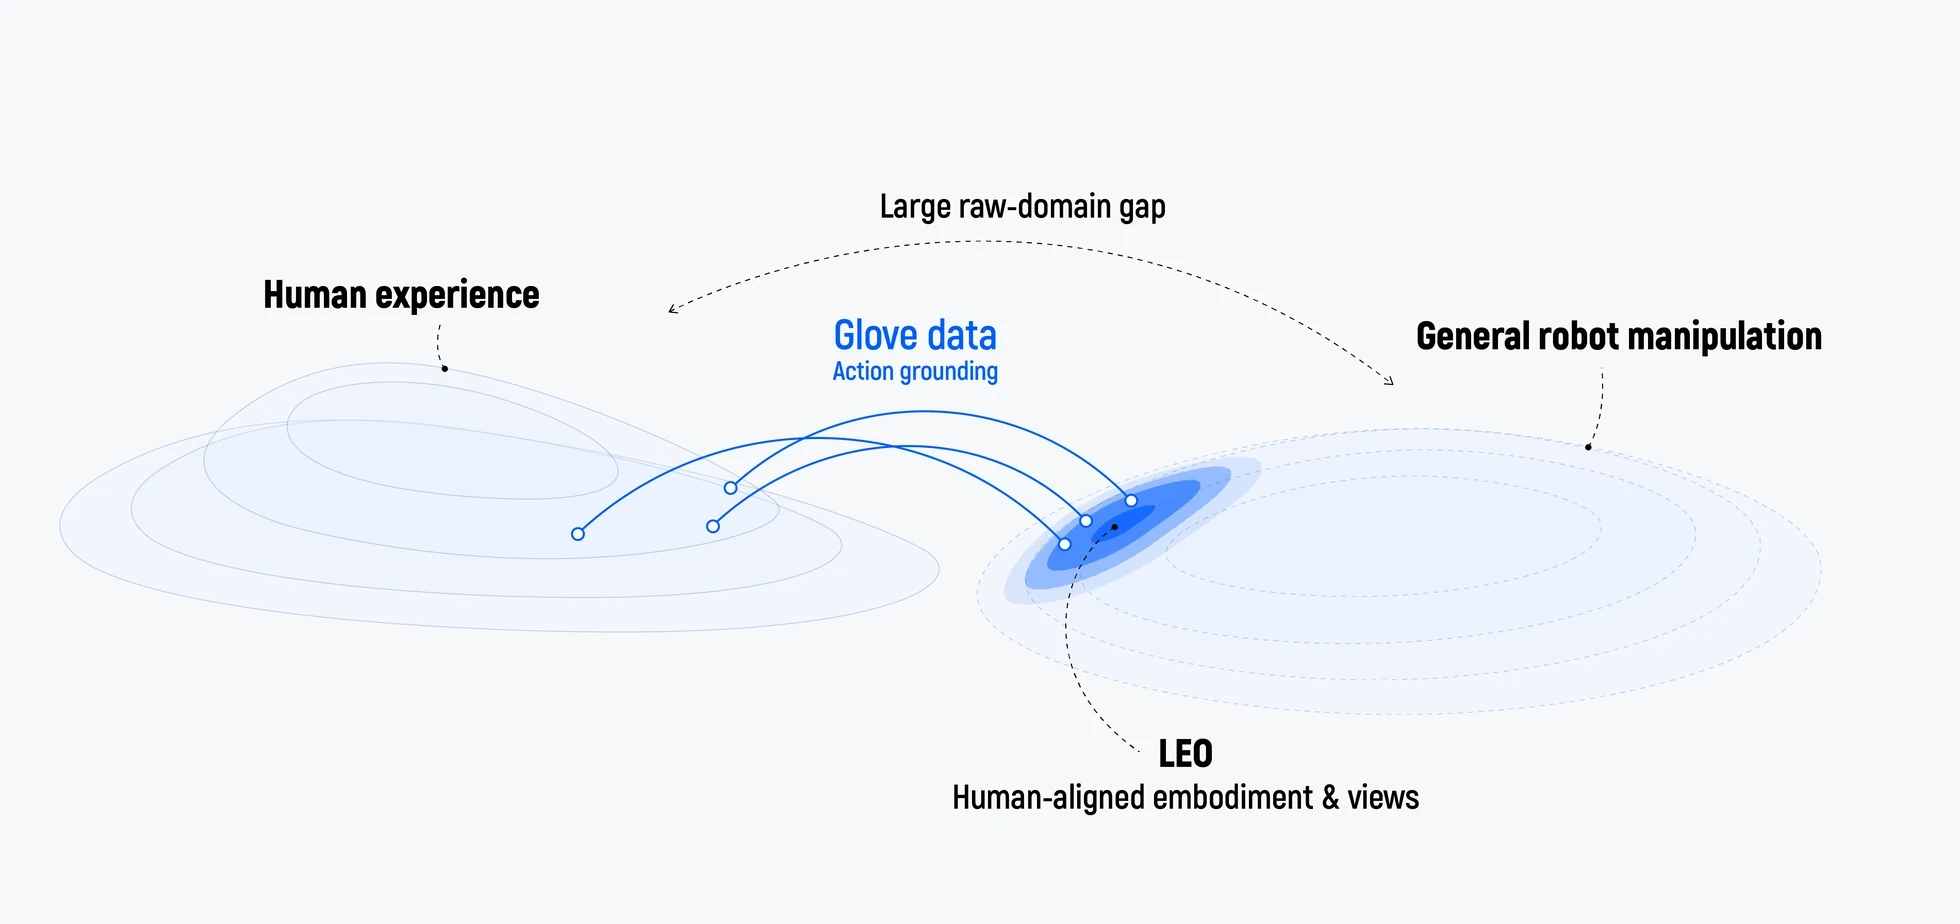
图 1:从人到机器人的迁移。人类经验与通用机器人操作之间差距的概念示意。LEO 位于更靠近人类经验的区域,而手套录制的数据为把人类操作技能迁移到机器人执行提供了一座以动作为基础的桥梁。
原图注:Figure 1. Human-to-robot transfer. Conceptual illustration of the gap between human experience and general robot manipulation. LEO occupies a region closer to human experience, while glove recordings provide an action-grounded bridge for transferring human manipulation skills to robot execution.
图 1 解读
这是一张纯概念图,没有坐标轴和数据。左边几层椭圆代表“人类经验”的分布,右边几层虚线椭圆代表“通用机器人操作”,两者之间的箭头标注“大的原始域差距”(large raw-domain gap),对应前文三道鸿沟。右侧分布靠左的深蓝色小区域是 LEO,标注为“与人对齐的本体和视角”,意思是 LEO 并不覆盖所有机器人,而是有意把自己放在机器人分布里最靠近人类的一角。连接两边的蓝色弧线是手套数据,标注为“动作锚定”(action grounding):每条弧线从人类经验中的一个点连到 LEO 区域中的一个点,表示手套数据提供了“这个人类动作对应那个机器人动作”的配对。整张图的论点是:与其让模型直接跨越整道鸿沟,不如一边用硬件把机器人往人这边挪,一边用手套数据架桥。
原文
To address these challenges, we introduce Liber-0, a World Action Model (WAM) pretrained on over 2.2 million hours of human experience. Our approach combines large-scale visual learning with action grounding and embodiment alignment, following three complementary design principles (Figure 1):
- Learn embodiment as context. A Unified Embodiment Representation (Section 2) encodes human and robot morphology and kinematics, conditioning action prediction on the executing body to support transfer across embodiments.
- Ground human video with measured action. LiberSense Glove system (Section 3.1) provides precise hand motions paired with human-perspective video, serving as action anchors that connect large-scale visual experience with executable actions through joint video-action learning.
- Bring robot observation and motion closer to human demonstrations. Our robot platform, LEO (Section 3.2), combines dexterous hands, articulated wrists and waist, and aligned camera configurations to reduce visual and kinematic differences between human experience and robot execution. Such a design further facilitates cross-embodiment transfer.
译文
为应对这些挑战,我们提出 Liber-0:一个在超过 220 万小时人类经验上预训练的世界动作模型(World Action Model,WAM)。我们的方法把大规模视觉学习与动作锚定、本体对齐结合起来,遵循三条互补的设计原则(图 1):
- 把本体当作上下文来学习。统一本体表示(Unified Embodiment Representation,第 2 节)编码人与机器人的形态和运动学,使动作预测以“由哪个身体执行”为条件,从而支持跨本体迁移。
- 用实测动作为人类视频锚定。LiberSense 手套系统(第 3.1 节)提供与人类视角视频配对的精确手部运动,作为动作锚点,通过视频—动作联合学习,把大规模视觉经验与可执行动作连接起来。
- 让机器人的观测和运动更接近人类示范。我们的机器人平台 LEO(第 3.2 节)结合了灵巧手、可活动的手腕和腰部,以及对齐的相机配置,以缩小人类经验与机器人执行之间的视觉和运动学差异。这样的设计进一步促进了跨本体迁移。
解释
三条原则与三道鸿沟一一对应:“本体当上下文”对付本体鸿沟(软件层面),“实测动作锚定”对付动作监督鸿沟,“机器人向人靠拢”同时对付视觉鸿沟和本体鸿沟(硬件层面)。世界动作模型是近一年兴起的路线:模型不只输出动作,还要预测未来画面。这样做的好处是,没有动作标签的视频也能用来训练“预测画面”这一半,学到的物理规律(物体怎么动、手怎么接触物体)再迁移给“预测动作”这一半。“220 万小时”是全部预训练数据的规模,后文图 5 显示其中网络人类视频约 2,000 kh(200 万小时),占绝大部分;手套数据在单源实验中最多只用了 10 kh,全量手套数据有多少,原文没有给出。另外,图 6 的数据配比里还有机器人数据,所以“220 万小时人类经验”是一个概括的说法,不是说预训练数据全部来自人类。
原文
Our experiments demonstrate the effectiveness of this approach at scale. Glove recordings exhibit particularly strong scaling in fine-grained manipulation, outperforming 200 times more Web Human Data on both PnP and Non-PnP benchmarks (Section 4.1). Combined with limited robot supervision, Glove data enables performance exceeding Robot-only training with 75% fewer robot demonstrations (Section 5.1), while also transferring manipulation skills absent from the robot-demonstration set (Section 5.2). Moreover, increasing human morphology diversity improves transfer even at a fixed data volume (Section 5.3). Together, these findings support our approach to action grounding and embodiment alignment, with the full staged pretraining recipe achieving the strongest overall benchmark performance (Section 4.3).
译文
我们的实验在规模上验证了这一方法的有效性。手套数据在精细操作上表现出特别强的规模扩展效应,在 PnP 和 Non-PnP 两类基准上都超过了时长为其 200 倍的网络人类数据(第 4.1 节)。与有限的机器人监督数据结合时,手套数据能在机器人示范减少 75% 的情况下超过纯机器人训练的表现(第 5.1 节),同时还能迁移机器人示范集中没有的操作技能(第 5.2 节)。此外,即使数据总量固定,提高人类形态的多样性也能改善迁移(第 5.3 节)。这些发现共同支持我们关于动作锚定和本体对齐的思路,而完整的分阶段预训练方案取得了最强的整体基准表现(第 4.3 节)。
解释
这一段是实验结论的预告,后文逐条兑现,这里先把数字对上。“200 倍”:10 kh 手套对 2,000 kh 网络视频,2000/10=200;PnP 67.9 对 64.6,Non-PnP 59.9 对 51.2(图 5)。“少 75% 机器人示范”:25% 机器人 + 100% 手套得 75.6,超过 100% 机器人的 72.8(图 8);需要注意前者的数据总量是 1.25 倍。“迁移示范集中没有的技能”:机器人只示范 PnP 时,Non-PnP 得分从 2.2 升到 54.6(图 9)。“固定数据量下增加多样性”:采集者从 1 人增加到 100 人,纯手套训练从 12.7 升到 40.1(图 11)。PnP 指抓取放置(pick-and-place),Non-PnP 指其余需要精细交互的操作,如折叠、开合、按压。
原文
Surprisingly, after pretraining, Liber-0 demonstrates task-level zero-shot manipulation (Section 4.2), executing tasks without robot demonstrations collected specifically for them. On 60 random tasks proposed by GPT-6, evaluated over 600 trials, Liber-0 achieves an overall success rate of 36.0%, including pick-and-place (PnP), short non-pick-and-place (Non-PnP), and challenging multi-step Non-PnP tasks (see below). These results suggest that action-grounded human experience offers a scalable foundation for generalizable robot manipulation.
译文
出人意料的是,预训练之后,Liber-0 表现出任务级零样本操作能力(第 4.2 节):它能执行没有专门为之采集过机器人示范的任务。在由 GPT-6 随机提出的 60 个任务、共 600 次试验上,Liber-0 的总体成功率为 36.0%,任务涵盖抓取放置(PnP)、较短的非抓取放置(Non-PnP)以及有挑战性的多步 Non-PnP 任务(见下方演示)。这些结果表明,经过动作锚定的人类经验为可泛化的机器人操作提供了一个可扩展的基础。
解释
“任务级零样本”的边界:它指评测任务本身没有对应的机器人示范,但模型在预训练中见过大量人类做类似事情的视频和手套数据,阶段 3 中还有 25% 的遥操作数据(图 6)。因此这里的零样本更接近“任务组合与场景层面的泛化”,而不是从未见过此类动作。验算:60 个任务每个试 10 次,共 600 次;第 4.2 节给出三档成功率 63.5%、34.0%、10.5%,各 200 次试验,即 127、68、21 次成功,合计 216 次,216/600=36.0\%,与此处一致。36.0% 这个总体数字主要由 PnP 拉高,多步任务只有一成成功,正文后文也承认这一点。“GPT-6 随机提出”的意思是任务由语言模型生成,避免作者挑选自己擅长的任务;但任务是否经过可执行性筛选(例如所需物体是否都在场),原文没有说明。
原文
Selected zero-shot demonstrations [More evaluation results \nearrow]
PnP: Cup placement; Pouch placement; Card placement.
Non-PnP: Object reorientation; Paper folding; Tissue extraction.
Challenging Multi-Step: Packing and storage; Seasoning and covering; Closing and wiping.
[Nine embedded videos]
PnP: Cup placement; Pouch placement; Card placement.
Non-PnP: Object reorientation; Paper folding; Tissue extraction.
Challenging Multi-Step: Packing and storage; Seasoning and covering; Closing and wiping.
[Nine embedded videos]
译文
精选零样本演示 [更多评测结果 \nearrow]
PnP:放置杯子;放置收纳袋;放置卡片。
Non-PnP:物体翻转调姿;折纸;抽取纸巾。
有挑战性的多步任务:打包收纳;加调料并盖盖;关闭并擦拭。
{九段嵌入视频}
PnP:放置杯子;放置收纳袋;放置卡片。
Non-PnP:物体翻转调姿;折纸;抽取纸巾。
有挑战性的多步任务:打包收纳;加调料并盖盖;关闭并擦拭。
{九段嵌入视频}
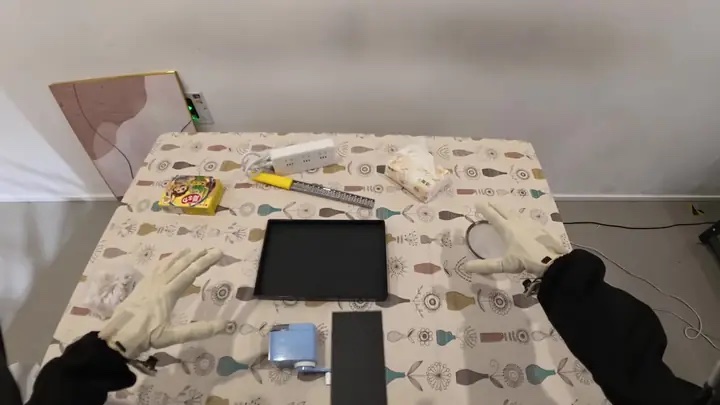
PnP:放置杯子
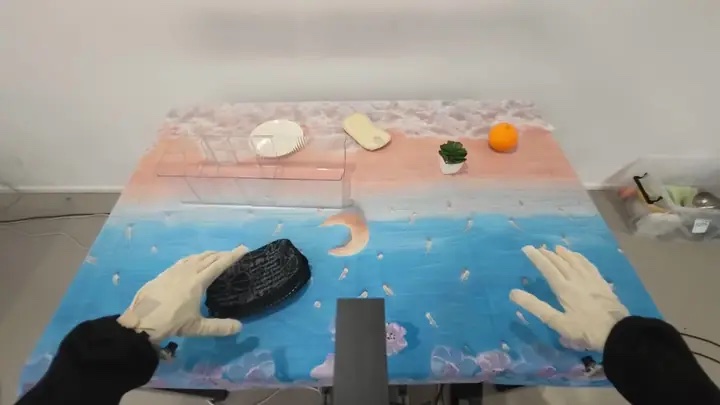
PnP:放置收纳袋
PnP:放置卡片
Non-PnP:物体翻转调姿
Non-PnP:折纸
Non-PnP:抽取纸巾
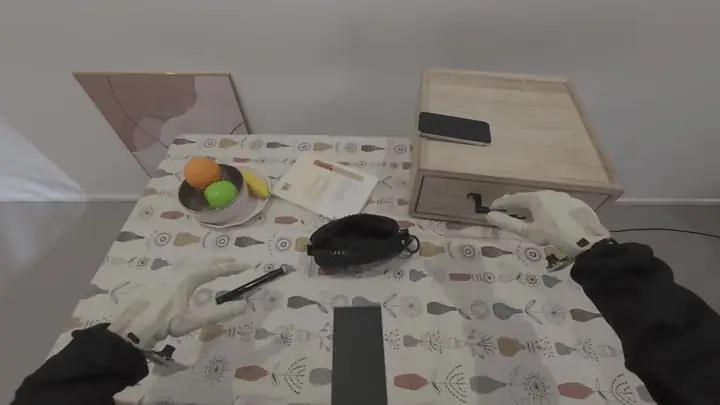
多步:打包收纳
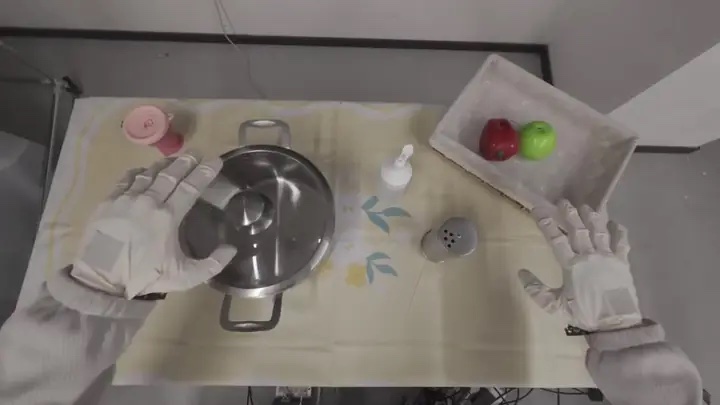
多步:加调料并盖盖
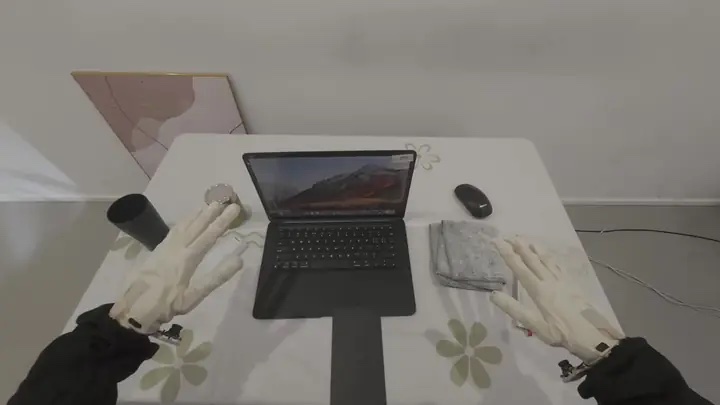
多步:关闭并擦拭
精选零样本演示(九段视频,各取封面帧)。原文为九段嵌入视频,分 PnP、Non-PnP、有挑战性的多步任务三组,每组三段;这里每段只截取页面提供的封面帧(720\times405)。
原图注:(Video captions on the page: Cup placement; Pouch placement; Card placement; Object reorientation; Paper folding; Tissue extraction; Packing and storage; Seasoning and covering; Closing and wiping.)
零样本演示截帧 解读
九张图都是 LEO 胸前相机的第一人称视角:画面下方是两只戴米色手套的机械手,前方是铺着图案桌布的桌面和日常物品(杯子、收纳袋、纸巾盒、木质抽屉柜等)。封面帧大多是任务开始前的初始场景,看不出执行过程,所以只能说明任务和场景的类型,不能作为成功的证据。例如“打包收纳”的初始画面里有果盘、笔、黑色收纳袋和带抽屉的木箱,与第 4.2 节视频 3 的任务(拉开抽屉、把笔放进黑色收纳袋、把收纳袋放进抽屉、关上抽屉)属于同一类。“更多评测结果”链接指向 https://reel.liberai.work/#/,本译稿没有抓取该站点。这些是作者精选的演示,总体成功率仍以第 4.2 节的 36.0% 为准。
原文
Beyond these zero-shot tasks, Liber-0's strong pretrained manipulation capabilities enable rapid adaptation to application-specific workflows, such as Boba tea preparation as shown in Video 1.
译文
除了这些零样本任务,Liber-0 强大的预训练操作能力还使它能够快速适应特定应用的工作流程,例如视频 1 所示的珍珠奶茶制作。
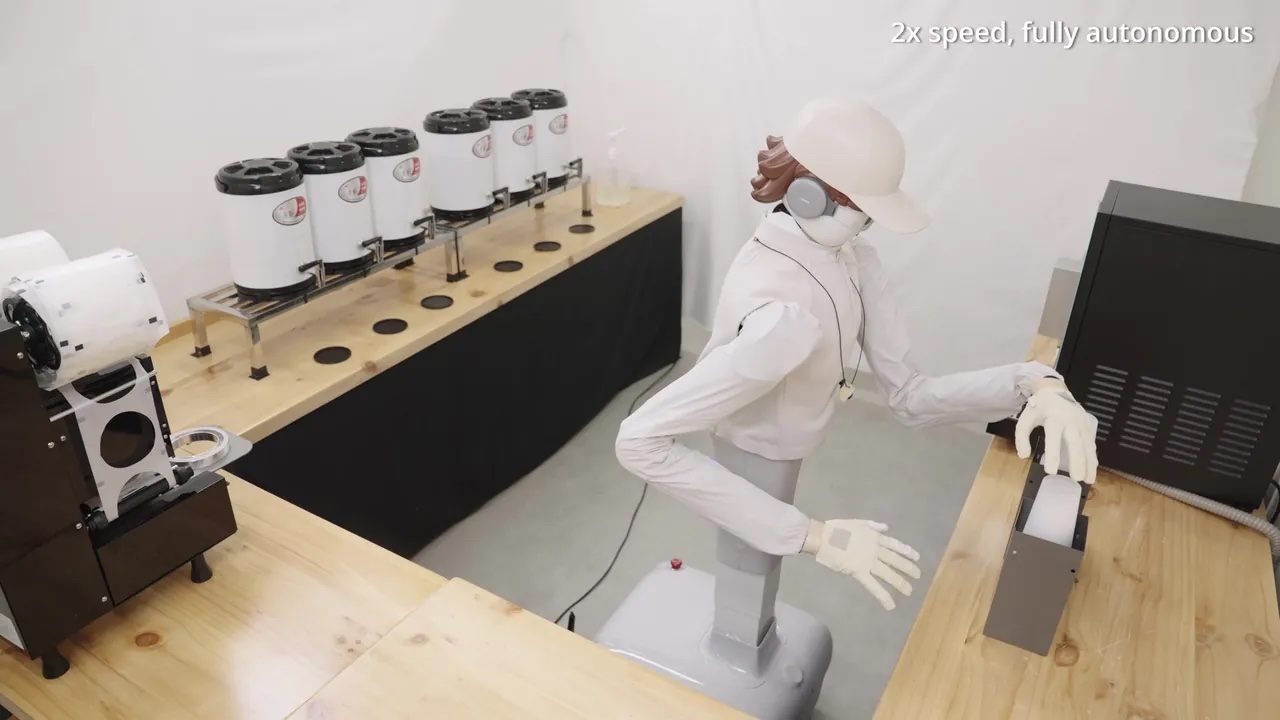
视频 1(截取封面帧)。使用 Liber-0 制作珍珠奶茶。自主执行。
原图注:Video 1. Boba tea preparation with Liber-0. Autonomous
视频 1 解读
原文是一段视频,标注“Autonomous”(自主执行,非遥操作)。这里的“快速适应”与前面的零样本不同:奶茶制作属于针对具体应用做了适配(后训练)的场景,原文没有交代用了多少条示范、训练了多久,所以“快速”无法量化。它的作用是展示长流程实际应用的潜力,不是严格的实验结果。
2模型(Model)
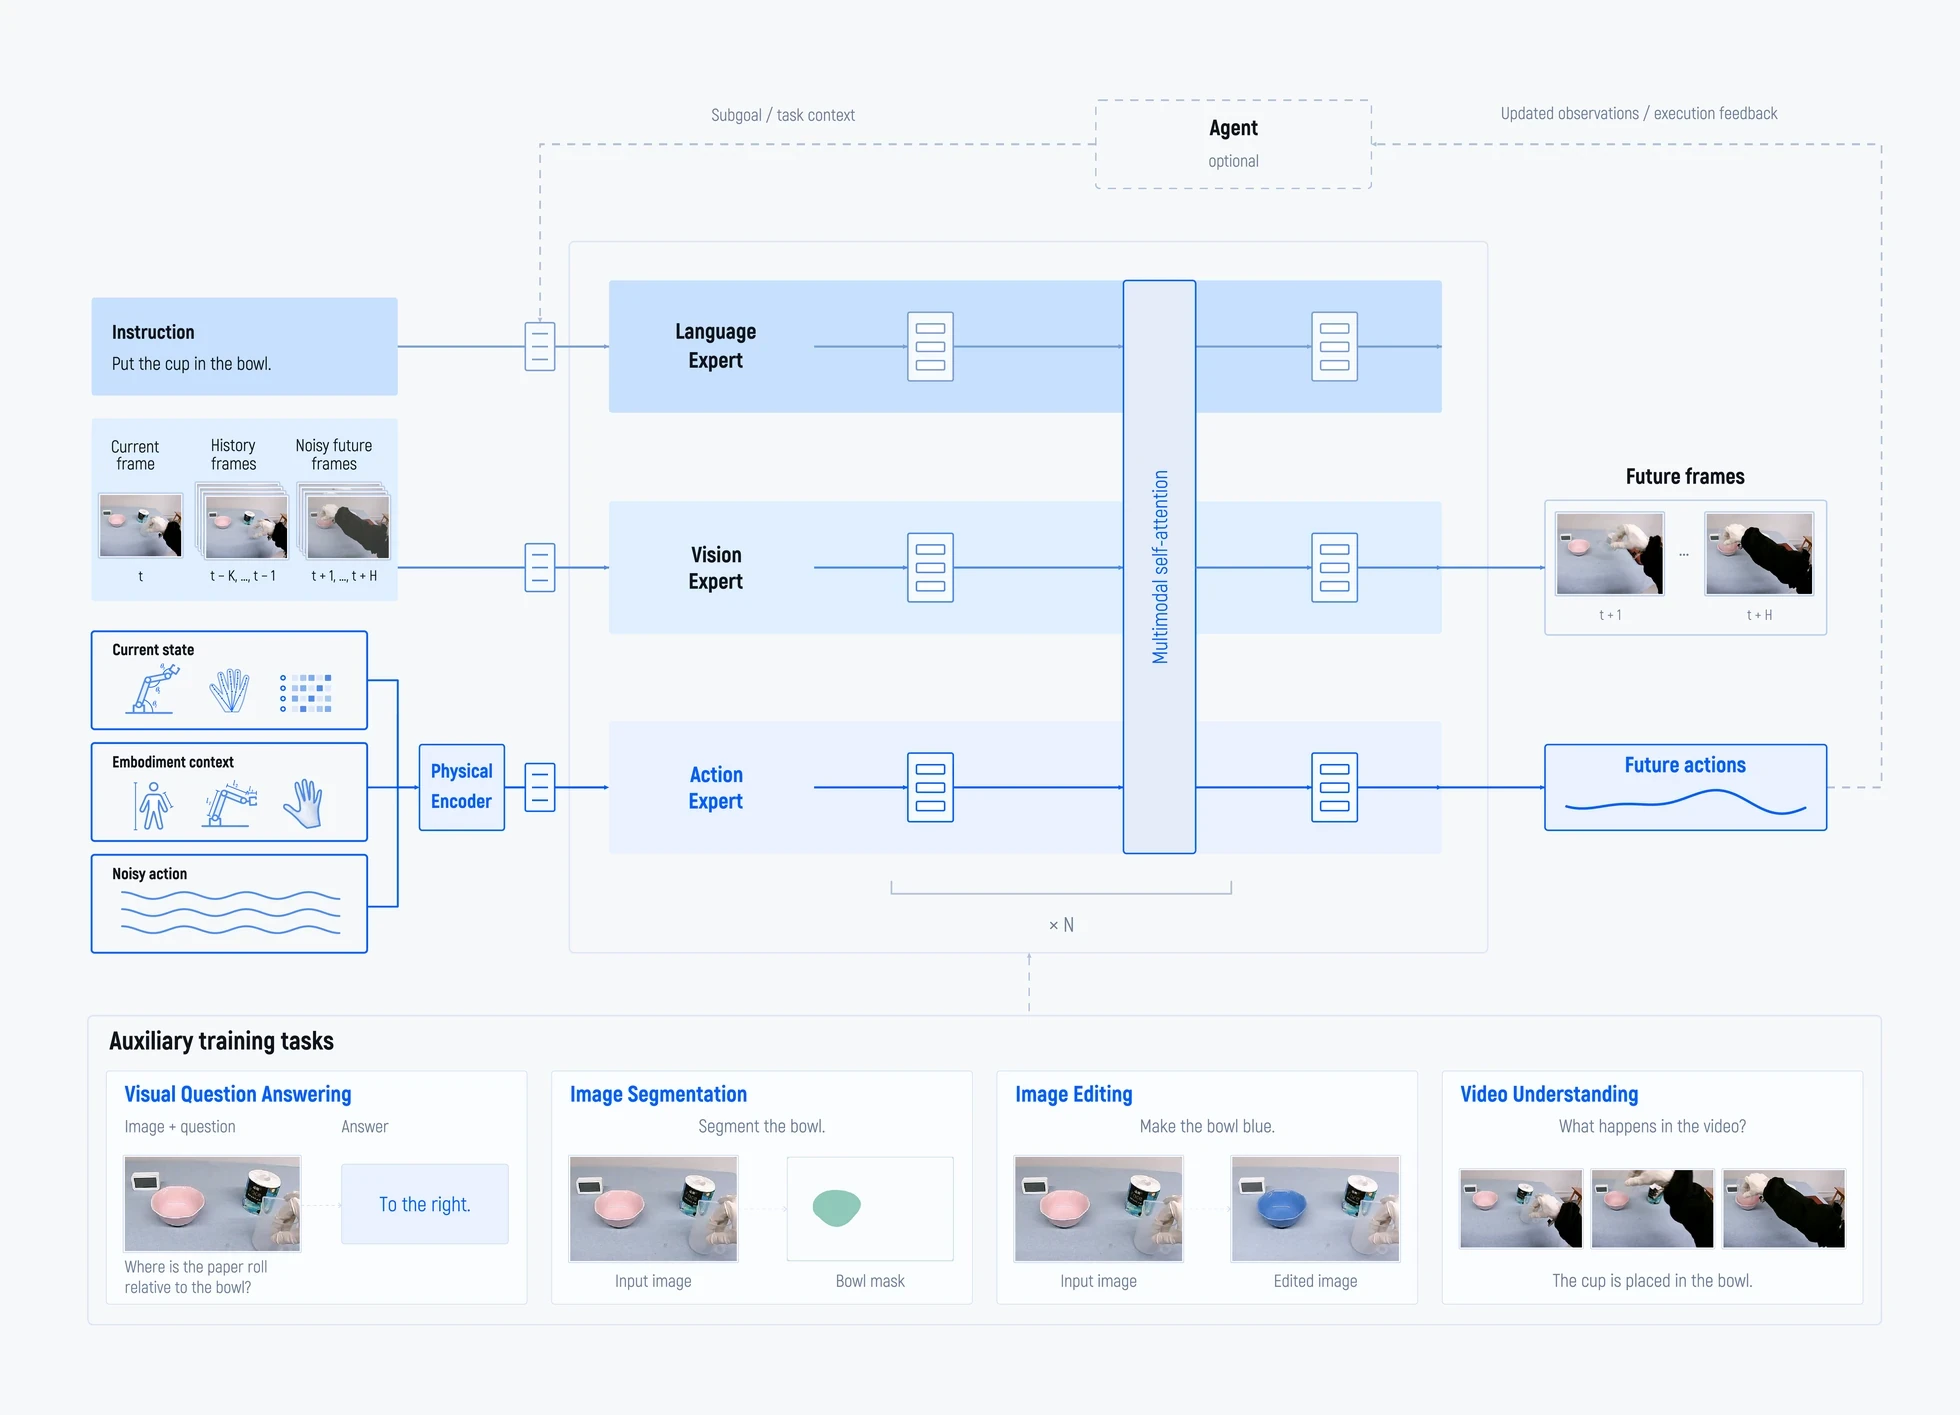
图 2:Liber-0 架构总览。语言、视觉和动作三个专家通过多模态注意力相互交互,联合预测未来帧和动作。一个共享的物理编码器(Physical Encoder)负责接入状态、本体上下文和带噪动作。
原图注:Figure 2. Overview of the Liber-0 architecture. Language, vision, and action experts interact through multimodal attention to jointly predict future frames and actions. A shared Physical Encoder incorporates state, embodiment context, and noisy actions.
图 2 解读
输入(左侧)分三路。第一路是语言指令,例如 “Put the cup in the bowl.”(把杯子放进碗里),送入语言专家。第二路是视觉:当前帧(时刻 t)、历史帧(t-K,\dots,t-1)和带噪的未来帧(t+1,\dots,t+H),送入视觉专家。未来帧以带噪形式输入,说明画面预测采用扩散或流匹配一类的去噪生成方式:训练时给真实未来帧加噪,让模型去噪。第三路是物理量:当前状态(图标为机械臂关节、手部关节和一组数值)、本体上下文(图标为人体、机械臂、人手,即统一本体表示)和带噪动作,三者经同一个物理编码器后送入动作专家。动作同样以带噪形式输入,说明动作也是用去噪方式生成的。中间是三个专家并列,各自有独立的参数(图中每个专家里的小方块代表 token 序列),中间那根竖条是多模态自注意力,三类 token 在这里互相“看见”;整个模块重复 N 层(“\times N”)。这就是 Mixture-of-Transformers(MoT)[8] 的做法:不同模态用不同的前馈层和投影矩阵,但在注意力层共享上下文。输出(右侧)是未来帧 t+1,\dots,t+H 和未来动作(一段动作曲线,即动作块)。图上方的虚线框是可选的智能体(Agent):它接收“更新后的观测 / 执行反馈”,向语言通路输出“子目标 / 任务上下文”,对应正文所说的外接 GPT-6 Astra 做多步规划。底部是四种辅助训练任务的示例,场景都是同一张桌面:视觉问答(问“卷纸相对碗在哪里?”答“在右边”)、图像分割(“分割出碗”,输出碗的掩码)、图像编辑(“把碗变成蓝色”)、视频理解(“视频里发生了什么?”答“杯子被放进了碗里”)。它们说明联合训练的数据与操作场景紧密相关,并不只是通用的图文数据。原文没有给出的信息:各专家的规模、视觉 token 化方式、K 和 H 的取值、生成目标是扩散还是流匹配、动作空间(关节角还是末端位姿)、推理时是否真的生成未来帧(还是只生成动作)。这些都影响对结果的理解,但网页报告没有交代。
原文
We begin by describing how Liber-0 addresses the challenges in learning from human experience: the lack of reliable action supervision and the differences in embodiment between humans and robots. As illustrated in Figure 2, our approach combines action-grounded pretraining with embodiment-conditioned learning, complemented by semantic co-training.
译文
我们首先说明 Liber-0 如何应对从人类经验中学习的挑战:缺乏可靠的动作监督,以及人与机器人之间的本体差异。如图 2 所示,我们的方法把以动作为锚的预训练与以本体为条件的学习结合起来,并辅以语义联合训练。
解释
本节只讲模型软件层面的三块内容,分别对应下面三段:动作锚定预训练(对应动作监督鸿沟)、本体当上下文(对应本体鸿沟)、语义联合训练(不对应某道鸿沟,用于补足“理解任务”的能力)。视觉鸿沟主要留给第 3 节的硬件去解决。
原文
Action-Grounded Pretraining. We adopt world-action modeling [7] to jointly predict future visual frames and actions. LiberSense Glove recordings provide action anchors by pairing human-perspective video with precisely measured hand motions, bridging the gap between large-scale human video and executable actions. Joint prediction allows visual learning to scale beyond action-annotated data while grounding action learning in measured motion. We implement this framework using a Mixture-of-Transformers architecture with dedicated language, vision, and action experts [8].
译文
动作锚定预训练。我们采用世界动作建模 [7],联合预测未来视觉帧和动作。LiberSense 手套录制的数据把人类视角视频与精确测量的手部运动配对,从而提供动作锚点,弥合大规模人类视频与可执行动作之间的差距。联合预测使视觉学习能够扩展到有动作标注的数据之外,同时让动作学习以实测运动为基础。我们用 Mixture-of-Transformers 架构实现这一框架,其中设有专门的语言、视觉和动作专家 [8]。
解释
为什么联合预测能“扩展到有动作标注的数据之外”:一条训练样本若有动作标签(手套、机器人数据),就同时监督画面和动作;若没有(网络视频),就只监督画面那一半,动作损失置零。这样 200 万小时的网络视频也能参与训练,学到的视觉动态通过共享注意力影响动作专家。[7] “World Action Models are Zero-shot Policies” 是这一思路的直接前作,标题中的“零样本策略”与本文副标题的“涌现零样本能力”遥相呼应。MoT [8] 来自多模态基础模型领域,是一种“稀疏”架构:参数按模态分开,计算量与参数量相当的稠密模型接近,但各模态互不干扰。在机器人领域,\pi_0 一类“VLM 主干 + 动作专家”的结构可以看作两专家的 MoT,本文再加了一个视觉生成专家。
原文
Embodiment as Context. The same manipulation objective may require different movements across bodies due to differences in morphology and kinematics. We introduce a Unified Embodiment Representation that encodes human and robot geometry and kinematics in a shared space. Conditioning action prediction on this representation allows Liber-0 to learn how movements vary across embodiments, supporting transfer from diverse human demonstrations to closely aligned robots.
译文
把本体当作上下文。由于形态和运动学不同,同一个操作目标在不同身体上可能需要不同的动作。我们引入统一本体表示,把人与机器人的几何和运动学编码到一个共享空间中。让动作预测以这一表示为条件,Liber-0 就能学习动作如何随本体变化,从而支持从多样的人类示范迁移到与之高度对齐的机器人上。
解释
直觉:与其把所有身体的动作强行映射到一个公共动作空间(例如统一成末端位姿),不如告诉模型“现在执行的是哪种身体、它长什么样”,让模型自己学会“同一意图在不同身体上怎么做”。类比 LLM 中的系统提示:同一个问题,提示“你是儿童老师”与“你是教授”,回答方式不同。这里“身体描述”就是动作生成的提示。这一设计也是第 5.3 节“采集者越多越好”的理论依据:如果模型见过很多种手(大小、掌宽不同),机器人手就可能落在已见过的手形之间,成为“插值”而不是“外推”。原文没有说明统一本体表示的具体形式(例如是关节链描述、手部网格参数,还是一个可学习的本体嵌入),也没有说明人手如何与 LEO 的灵巧手对应关节。
原文
Semantic Co-Training. Beyond physical dynamics, manipulation requires understanding task semantics, spatial relationships, and execution progress [9]. We therefore co-train Liber-0 on visual question answering (VQA), image segmentation, image editing, and video understanding. These objectives complement world-action learning with semantic and temporal understanding while preserving broad visual capabilities. For multi-step tasks, Liber-0 can optionally integrate with a reasoning agent, such as GPT-6 Astra, to plan intermediate goals and guide execution.
译文
语义联合训练。除了物理动态,操作还需要理解任务语义、空间关系和执行进度 [9]。因此我们让 Liber-0 在视觉问答(VQA)、图像分割、图像编辑和视频理解上联合训练。这些目标用语义和时间上的理解来补充世界动作学习,同时保留广泛的视觉能力。对于多步任务,Liber-0 可以选择性地接入一个推理智能体(例如 GPT-6 Astra),由它规划中间目标并指导执行。
解释
[9] 是 \pi_{0.5},它的关键经验是:机器人数据之外混入网络图文数据和高层子任务预测,可以显著提升开放世界泛化,并防止 VLM 主干在机器人数据上微调时遗忘语义知识。本文沿用这一做法,并多加了两个与“生成”有关的任务:图像编辑(训练“指令 \to 画面应如何变化”,正好与世界模型的画面预测相通)和视频理解(训练对时间顺序和执行进度的把握)。可选的推理智能体很重要:它意味着在多步任务上,Liber-0 可能由 Astra 拆成子目标后逐个执行。第 4.2 节零样本评测是否用了这一组合,原文没有明说,这会影响“Liber-0 对 Astra-only”比较的含义(见译者附注)。
3LiberSense 手套与 LEO 机器人(LiberSense Glove & LEO Robot)
原文
Apart from the learning framework, effective human-to-robot transfer also requires alignment at the hardware level. We develop two complementary systems: LiberSense Glove provides reliable action supervision when recording human demonstrations, while LEO Robot reduces the visual and kinematic differences between human experience and robot execution.
译文
除了学习框架,有效的人到机器人迁移还需要在硬件层面实现对齐。我们开发了两套互补的系统:LiberSense 手套在录制人类示范时提供可靠的动作监督,LEO 机器人则缩小人类经验与机器人执行之间的视觉和运动学差异。
解释
这一节是本文与多数纯算法 WAM 工作最大的区别:作者同时控制了“数据采集端”(手套)和“部署端”(机器人),从两头把人和机器人往一起拉。这也意味着结论在多大程度上依赖这套专用硬件是一个开放问题,第 5.4 节用另一台机器人(天机)做了部分对照。
3.1LiberSense 手套:可扩展的动作锚定数据采集(LiberSense Glove: Scalable Action-Grounded Data Collection)
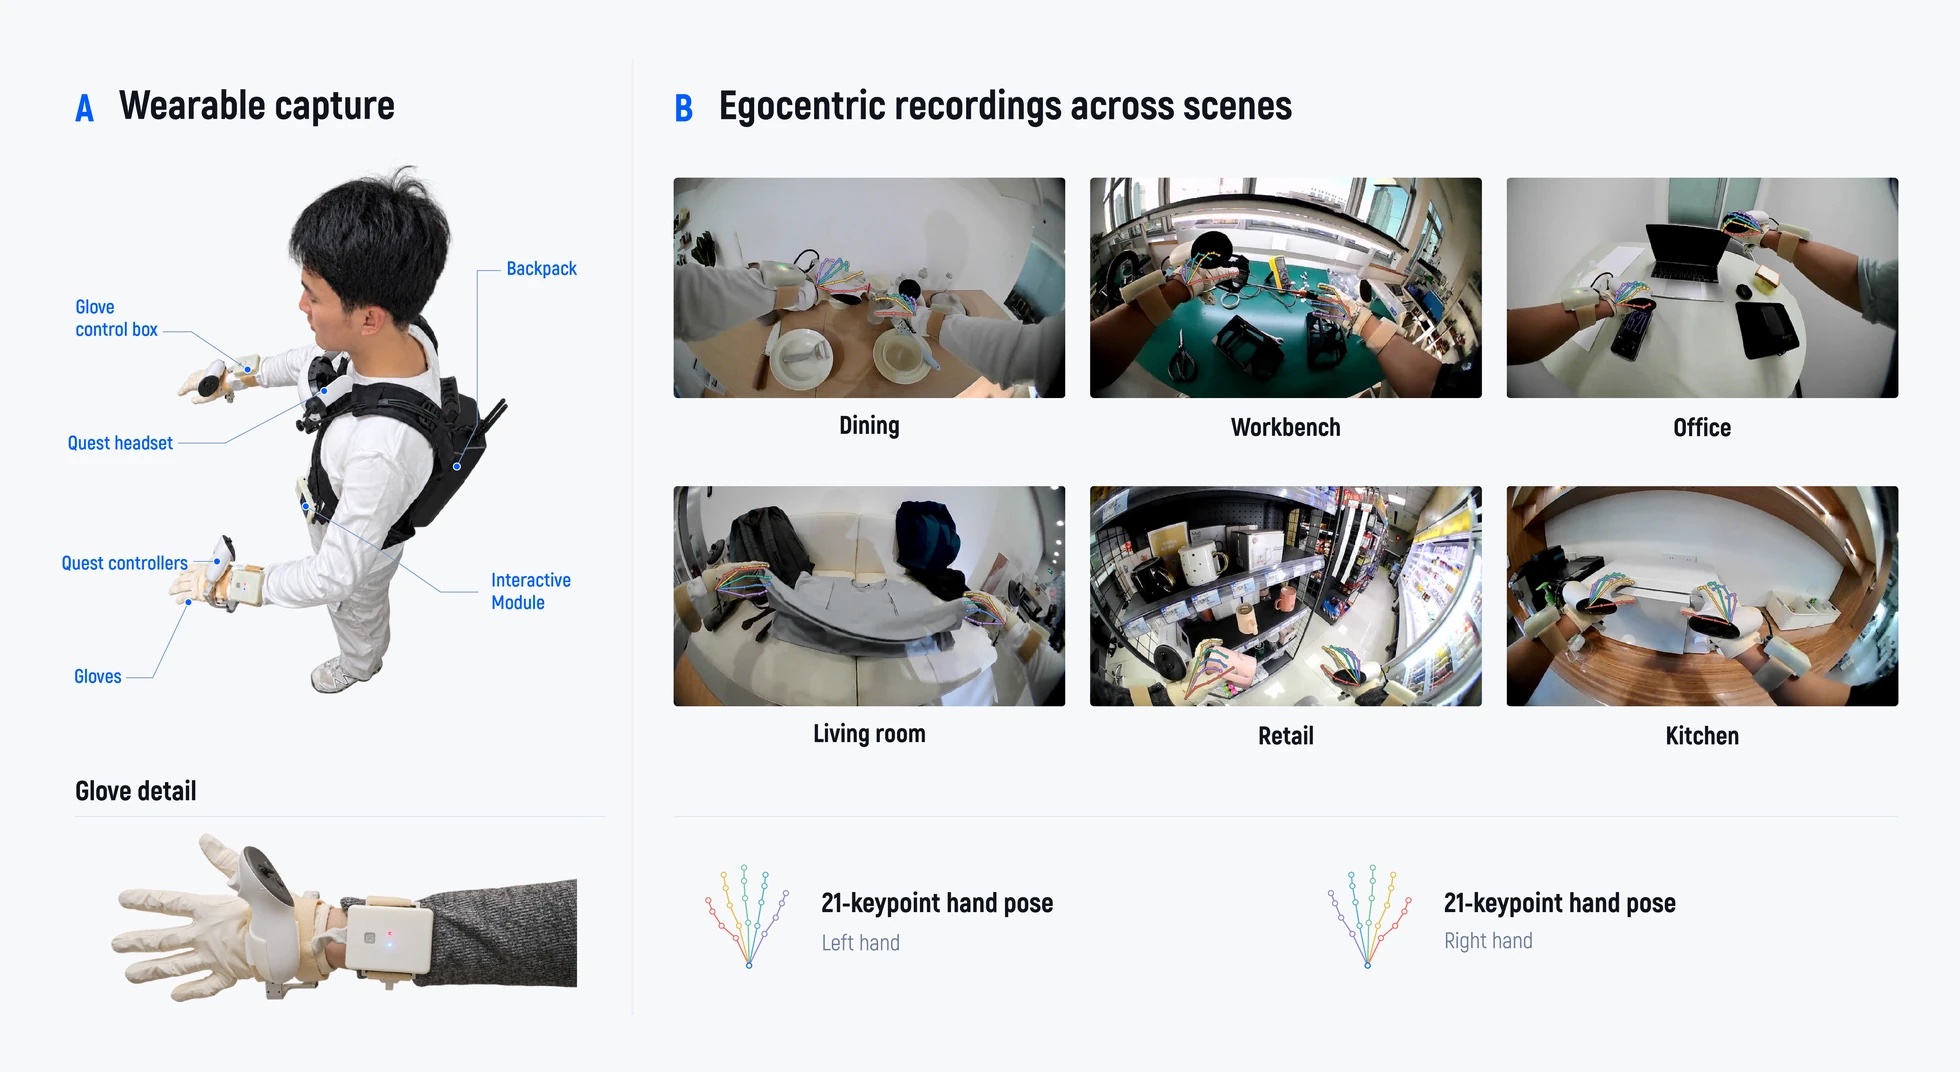
图 3:基于手套采集带动作锚点的人类经验。左:可穿戴采集装置和手套硬件。右:日常场景中的胸前视角录像示例,叠加了同步的左右手姿态。
原图注:Figure 3. Glove-based collection of action-grounded human experience. Left: the wearable capture setup and glove hardware. Right: example chest-view recordings across everyday scenes, with synchronized left- and right-hand pose overlays.
图 3 解读
A 部分“可穿戴采集”:采集者身穿白色连体服,背后有背包(Backpack,估计装计算与供电设备),胸前有交互模块(Interactive Module),头上(图中靠颈部位置)标有 Quest 头显(Quest headset),手腕上绑着 Quest 手柄(Quest controllers)和手套控制盒(Glove control box),手上戴着手套(Gloves)。Quest 头显和手柄很可能用于追踪手腕在空间中的 6 自由度位姿(手套本身测的是手指关节),但正文没有说明。下方“手套细节”特写:一只米色薄手套,腕部绑着白色控制盒和手柄。B 部分“跨场景的第一人称录像”:六个场景,依次为用餐(Dining)、工作台(Workbench)、办公室(Office)、客厅(Living room)、零售货架(Retail)、厨房(Kitchen),画面是鱼眼广角,手上叠加了彩色骨架线,即左右手各 21 个关键点的手部姿态(底部图例)。21 关键点是手部姿态估计的通用格式(手腕 1 个点,加五指各 4 个点)。这张图想说明两点:数据有实测的手部动作,且场景不限于实验室。
原文
LiberSense Glove is a lightweight wearable system for collecting human manipulation data with directly measured finger motion. Unlike rigid exoskeleton-based designs [10], it is only 0.3 mm thick and weighs 131 g. This design minimizes interference with finger movements and hand–object interaction, preserving the natural manipulation patterns we want the model to learn. Its skin-toned exterior also maintains visual similarity to bare hands commonly seen in egocentric video.
译文
LiberSense 手套是一套轻量的可穿戴系统,用于采集直接测量了手指运动的人类操作数据。与刚性外骨骼式的设计 [10] 不同,它只有 0.3 mm 厚、重 131 g。这样的设计把对手指运动和手—物交互的干扰降到最低,保留了我们希望模型学到的自然操作方式。它肤色的外观也保持了与第一人称视频中常见的裸手在视觉上的相似性。
解释
[10] DexUMI 用一个与机器人手同构的外骨骼套在人手上,好处是人手动作可以一一映射到机器人关节,坏处是笨重、改变了人的抓握方式。LiberSense 走的是另一头:尽量不改变人的动作,把“人手到机器人手”的映射交给模型(统一本体表示)去学。0.3 mm 和 131 g 的口径:0.3 mm 应指手套布料本身的厚度,131 g 是否包含腕部控制盒和 Quest 手柄,原文没有说;从图 3 看,腕部的附加设备体积并不小。“肤色外观”针对的是视觉鸿沟:网络视频里是裸手,戴黑色或金属手套会让画面分布偏离;而 LEO 的机械手也套上同色手套(图 4),三者外观趋于一致。
原文
The system synchronizes measured hand poses and trajectories with video from a first-person camera and two wrist-mounted cameras. By preserving the visual perspective and embodiment of human video while providing precise action supervision, these recordings serve as action anchors for large-scale human-data pretraining.
译文
该系统把测得的手部姿态和轨迹与一个第一人称相机及两个腕部相机的视频同步起来。这些录像既保留了人类视频的视觉视角和本体,又提供了精确的动作监督,因而成为大规模人类数据预训练的动作锚点。
解释
“一个第一人称相机 + 两个腕部相机”正好对应 LEO 的“胸前相机 + 两个腕部相机”(第 3.2 节),这是为了让手套数据在视觉输入上与机器人部署时一模一样。图 3 的示例画面标注为“胸前视角”(chest-view),所以这里的“第一人称相机”应理解为挂在胸前,而不是头戴。“动作锚点”的含义可以这样理解:网络视频里也有大量“人拉开抽屉”的画面,但没有精确的手部轨迹;手套数据里同样的画面配上了准确轨迹,模型在两者之间建立联系后,看到网络视频中类似的画面也能推断出合理的动作。
原文
Importantly, collection requires no robot on site, enabling low-cost, scalable demonstrations across diverse human morphologies, objects, tasks, and environments.
译文
重要的是,采集现场不需要机器人,因此可以低成本、可扩展地获取覆盖多样人类形态、物体、任务和环境的示范。
解释
这是手套相对遥操作的核心经济优势:遥操作需要一台机器人加一名操作员,机器人贵、难搬运,场景通常局限在实验室;手套采集只需要人和一套可穿戴设备,可以到真实的厨房、商店里去录(图 3 B)。“多样人类形态”这一点在第 5.3 节被单独验证。
3.2LEO:让机器人的观测与运动对齐人类示范(LEO: Aligning Robot Observation and Motion with Human Demonstrations)
原文
LEO is a robot platform we designed to minimize the visual and kinematic gap between human demonstrations and robot execution. It combines dexterous hands for fine-grained manipulation, a slim forearm structure with a human-like wrist, and an articulated waist that can reach various angles and heights.
译文
LEO 是我们设计的机器人平台,目的是把人类示范与机器人执行之间的视觉和运动学差距降到最小。它结合了用于精细操作的灵巧手、带有类人手腕的纤细前臂结构,以及可以达到不同角度和高度的可活动腰部。
解释
三个硬件要素各自对应人类示范中常见、而普通机械臂难以复现的动作:灵巧手对应手指的精细动作,类人手腕对应“手臂不动、只转手腕”,可活动腰部对应“弯腰去够低处的东西”。第 5.4 节的三个对比任务(拧旋钮、摆拖鞋、开抽屉)恰好分别考察这三点。
原文
LEO features three degrees of rotational freedom at the wrist, enabling a human-like range of wrist motion without moving the forearm. This enables precise rotational manipulation and hand placement in confined spaces. Its slim, human-like forearms further reduce collision risks, while an articulated waist extends the reachable workspace and enables the robot to reproduce bending and reaching motions commonly found in human demonstrations. Together, these designs make a broader range of human movements directly executable on LEO.
译文
LEO 的手腕具有三个旋转自由度,无需移动前臂即可实现与人相近的手腕活动范围。这使它能够进行精确的旋转操作,并在狭小空间内精确放置手部。纤细、类人的前臂进一步降低了碰撞风险,而可活动的腰部扩展了可达工作空间,使机器人能够复现人类示范中常见的弯腰和伸手动作。这些设计共同使更大范围的人类动作可以直接在 LEO 上执行。
解释
三个旋转自由度的手腕:人的手腕本身只有屈伸和桡尺偏两个自由度,前臂旋前/旋后提供第三个;许多 6/7 自由度机械臂的末端只有一两个腕部关节,要实现大角度转腕必须带动整条手臂,从而偏离人类示范的动作模式。LEO 把三个旋转集中在手腕,是为了让人手的姿态可以几乎直接对应过去。“直接可执行”是本节的关键词:人与机器人运动学越接近,手套数据中的动作越不需要模型“翻译”,迁移就越容易。
原文
Visual alignment is also built into data collection and deployment. The first-person and wrist-camera viewpoints used in glove collection closely match LEO's chest- and wrist-camera configuration. As shown in Video 2, human and robot observations capture hand–object interactions from similar perspectives, further reducing the distribution shift between pretraining and inference.
译文
视觉对齐同样被纳入了数据采集和部署之中。手套采集所用的第一人称视角和腕部相机视角,与 LEO 的胸前相机和腕部相机配置高度一致。如视频 2 所示,人和机器人的观测从相似的视角捕捉手—物交互,进一步减小了预训练与推理之间的分布偏移。
解释
这里把“视觉鸿沟”的解决方案落到具体配置上:相机挂的位置一样,画面构图就一样。需要注意,这种对齐只覆盖手套数据(以及 LEO 自己的遥操作数据),占预训练数据绝大部分的网络视频和公开第一人称数据(OpenEgo)的视角仍然各不相同。
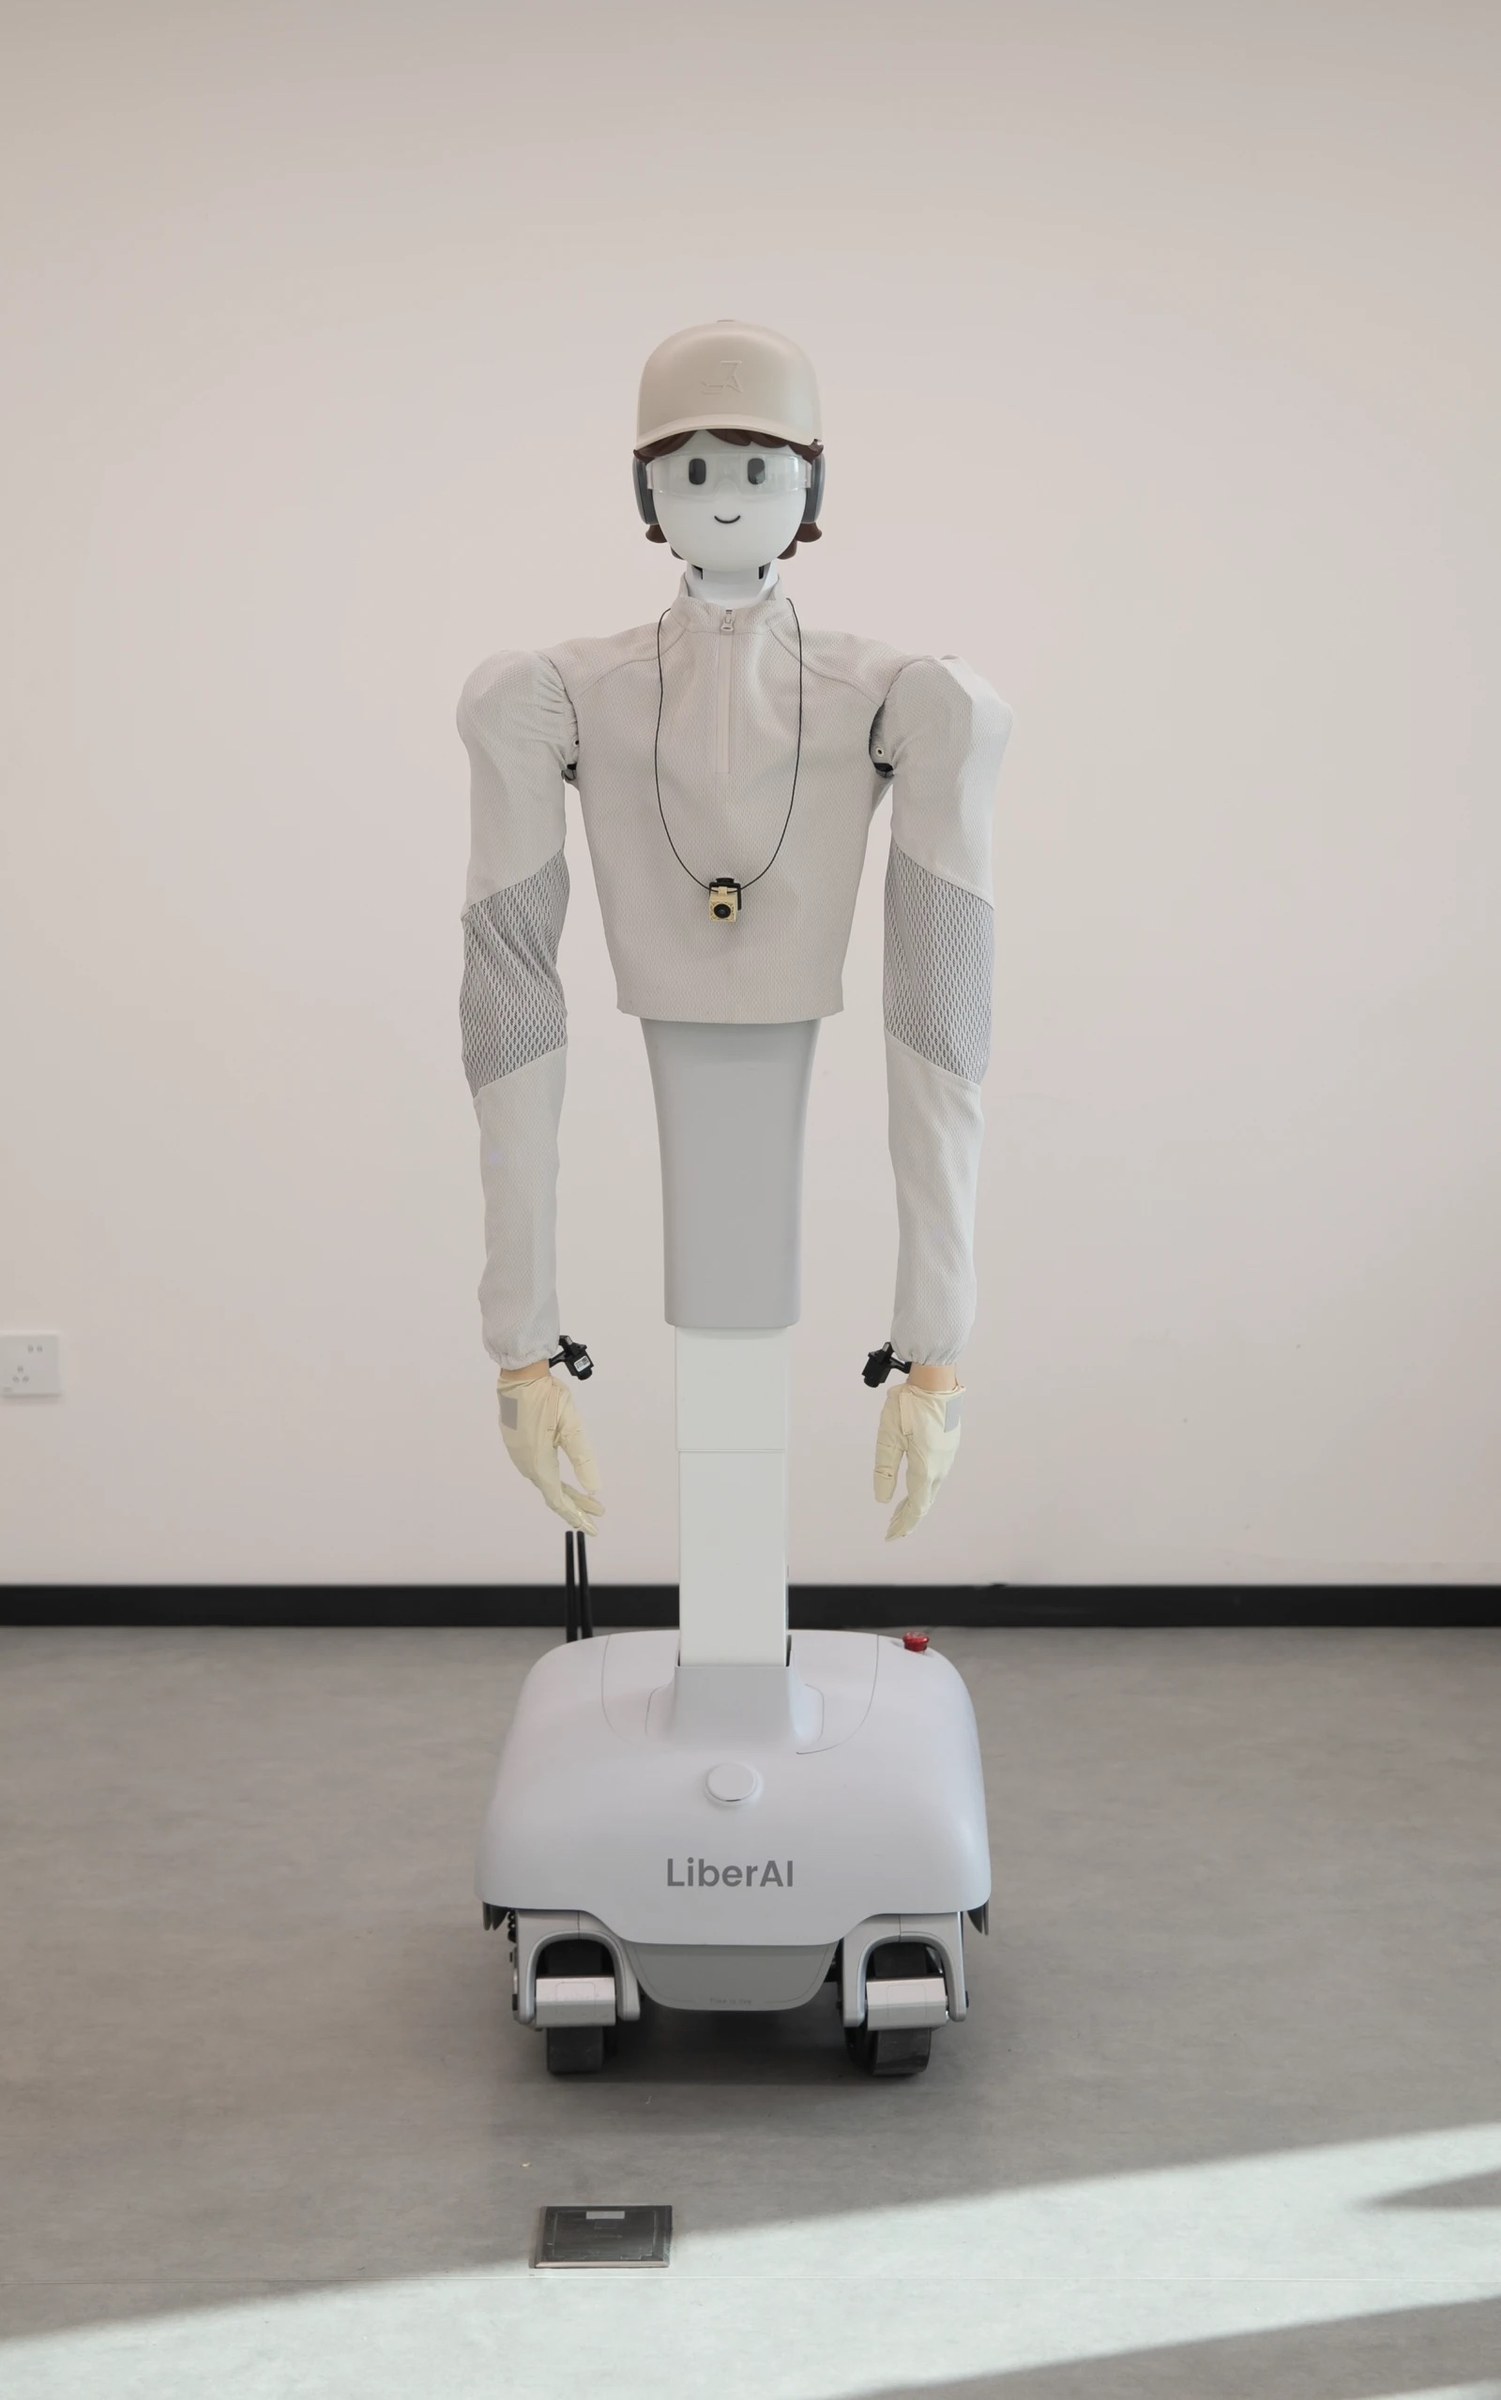
图 4:LEO 机器人平台。LEO 结合了灵巧手、灵活的手腕关节、可调节的腰部,以及与人类数据采集对齐的相机配置。
原图注:Figure 4. The LEO robot platform. LEO combines dexterous hands, flexible wrist articulation, an adjustable waist, and camera configurations aligned with human data collection.
图 4 解读
一张 LEO 的正面全身照。底部是带轮的移动底盘(印有 LiberAI 字样),中间是一根可升降的立柱(即“腰部”,从照片看由多段组成,可以调节高度和俯仰),上方是穿着浅灰色衣服的上半身和两条细长手臂,手上套着米色手套;头部是卡通化的面部,戴帽子和护目镜。胸前用挂绳吊着一个小相机,即正文所说的胸前相机,位置与手套采集者胸前的相机对应;两只手腕处各有一个小相机。整体外观刻意做得像穿着工作服的人,与“缩小视觉鸿沟”的设计意图一致。注意照片中的机器人带移动底盘,但本文所有实验都是桌面或近地面的操作,没有涉及移动。
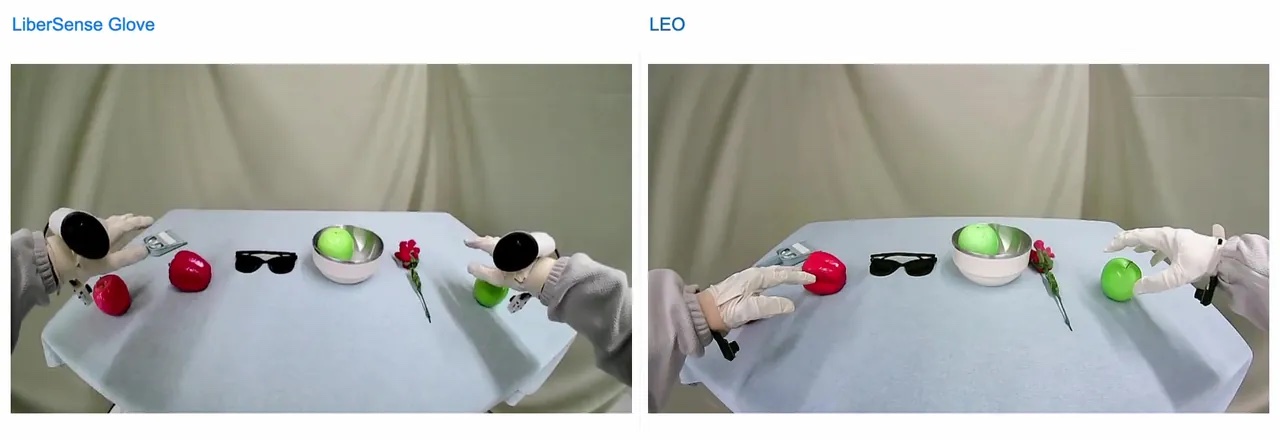
视频 2(截取封面帧)。人机对齐从采集阶段就开始了。并排展示的人类第一人称录像与 LEO 胸前相机观测,对手—物交互的视角高度一致。
原图注:Video 2. Human–robot alignment begins at collection. Side-by-side human first-person recordings and LEO chest-camera observations show closely matched views of hand–object interactions.
视频 2 解读
原文是一段并排对比视频,这里只有封面帧。左侧标注 “LiberSense Glove”,是人类戴手套采集时的胸前画面;右侧标注 “LEO”,是机器人胸前相机的画面。同一张铺浅蓝桌布的桌子上摆着红苹果、墨镜、装青苹果的不锈钢碗、一枝花等物品,两侧的视角、桌面构图和手的外观(米色手套)都很接近。但仔细看也有残余差异:人手腕上套着黑色环形的 Quest 手柄,机器人手腕上没有;人的手指更粗短,机械手的手指更细长。这是“视觉对齐”的直观证据,但只是定性展示,没有量化两种画面分布的差距。这些残余差异也提示:完全的视觉对齐并不存在,模型仍需对这些细节保持鲁棒。不过与网络视频和机器人画面之间的差异相比,这些差异已经很小。
4把人类经验扩展为机器人技能(Scaling Human Experience into Robot Skills)
原文
With the learning framework and hardware alignment in place, we turn to the central question of this work: can scaling human experience translate into generalizable robot manipulation skills? Our experiments reveal two key findings. First, action-grounded glove data exhibits particularly strong scaling, especially for fine-grained manipulation. Second, Liber-0 generalizes beyond predefined benchmarks to tasks without task-specific robot demonstrations, including challenging multi-step manipulation. We present these results before examining the training strategy and evaluation protocols.
译文
学习框架和硬件对齐都已就位,我们转向本工作的核心问题:扩大人类经验的规模,能否转化为可泛化的机器人操作技能?实验揭示了两个关键发现。第一,带动作锚点的手套数据表现出特别强的规模扩展效应,在精细操作上尤为明显。第二,Liber-0 能泛化到预定义基准之外、没有任务专属机器人示范的任务上,包括有挑战性的多步操作。我们先展示这些结果,再介绍训练策略和评测协议。
解释
本节的写法是“先结果、后方法”:4.1 和 4.2 是结果,4.3 才讲三阶段预训练,4.4 才讲数据和评测基准。读 4.1 时如果对“进度分”“PnP / Non-PnP 基准”有疑问,可以先跳到第 4.4 节。两个发现分别对应 4.1(规模律)和 4.2(零样本)。
4.1不同数据源的规模律(Scaling Laws of Various Data Sources)
原文
We first investigate how different data sources contribute to robot manipulation as data scales. We separately pretrain models on five sources: Glove, Cross-Embodiment Robot Data, OpenEgo, VendorEgo, and Web Human Data (Web in Figure 5), using 1, 2, 5, and 10 kh of data per source. For the Web, we additionally evaluate 100 kh and 2,000 kh. All models are post-trained on the same robot dataset and evaluated on 60 PnP and 16 Non-PnP tasks, using average progress scores as metrics.
译文
我们首先研究,随着数据规模增长,不同数据源对机器人操作的贡献如何。我们在五个数据源上分别预训练模型:手套(Glove)、跨本体机器人数据(Cross-Embodiment Robot Data)、OpenEgo、VendorEgo 和网络人类数据(Web Human Data,图 5 中记为 Web),每个数据源使用 1、2、5、10 kh(千小时)的数据。对于 Web,我们另外评测了 100 kh 和 2,000 kh。所有模型都在同一个机器人数据集上后训练,并在 60 个 PnP 任务和 16 个 Non-PnP 任务上评测,以平均进度分作为指标。
解释
实验设计:这是一个“单变量”实验,每次只换预训练数据源和数据量,后训练数据和评测集固定,因此不同曲线之间可以直接比较。五个数据源的含义见第 4.4 节:OpenEgo 是公开的第一人称数据集汇总,VendorEgo 是向供应商采购的第一人称操作录像,Web 是网络上的人类活动视频。规模:1 kh = 1,000 小时,10 kh = 1 万小时,2,000 kh = 200 万小时。评测规模:PnP 60 个任务、每任务 3 次,共 180 次试验;Non-PnP 16 个任务、每任务 6 次,共 96 次试验(第 4.4 节)。原文没有交代的口径:(1) 单源预训练是否走完三阶段流程、各训练多少步;(2) 没有实测动作的数据源(OpenEgo、VendorEgo、Web)在预训练时是否用视觉估计的手部姿态作为动作标签,还是只做画面预测;(3) 每个点是否只训练了一个种子。第 (2) 点决定了“手套胜过网络视频”究竟是在比较“实测动作对估计动作”还是“有动作对无动作”。
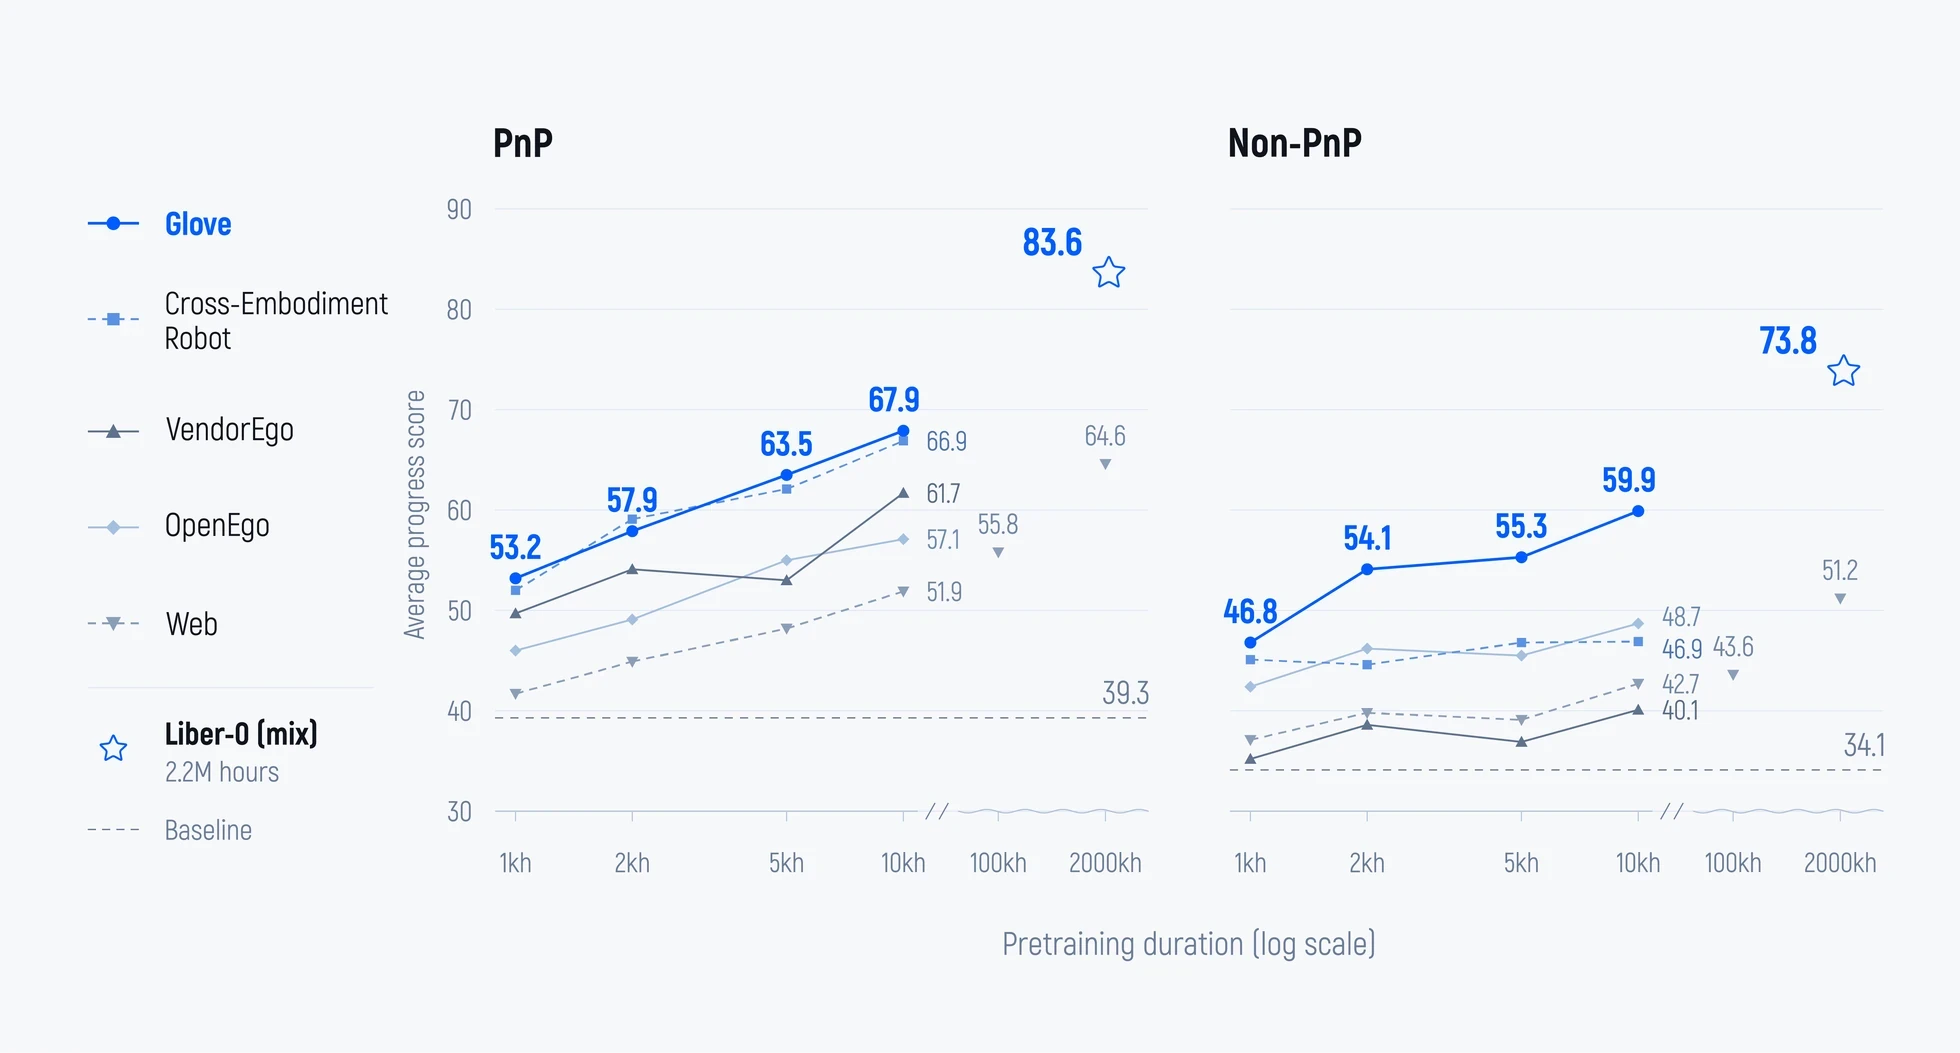
图 5:跨数据源扩展预训练数据。各数据源单独预训练、再在相同机器人数据上后训练之后的平均进度分。虚线表示不做数据源专属预训练的基线;星号表示采用完整分阶段预训练方案并经机器人后训练后的 Liber-0。
原图注:Figure 5. Scaling pretraining data across sources. Average progress scores after source-specific pretraining and post-training on the same robot data. Dashed lines indicate baselines without source-specific pretraining; stars show Liber-0 after the full staged pretraining recipe and robot post-training.
图 5 解读
坐标轴:横轴是预训练时长(对数刻度),刻度为 1、2、5、10 kh,之后有一个断轴符号“//”,接 100 kh 和 2,000 kh 两个点(只有 Web 有);纵轴是平均进度分(30–90)。左图是 PnP,右图是 Non-PnP。图例:实线圆点为 Glove(蓝色加粗,数字标在点上),方点虚线为跨本体机器人数据,三角实线为 VendorEgo,菱形实线为 OpenEgo,倒三角虚线为 Web;空心星号为 Liber-0(完整配方,2.2M 小时),灰色水平虚线为基线(PnP 39.3,Non-PnP 34.1)。读数(图上标注的数字整理在下表):Glove 在 PnP 上从 53.2 升到 67.9,在 Non-PnP 上从 46.8 升到 59.9,两条曲线都单调上升。跨本体机器人数据在 PnP 上紧贴 Glove(10 kh 时 66.9,2 kh 时甚至略高于 Glove 的 57.9),但在 Non-PnP 上几乎是平的(约 45 到 46.9)。VendorEgo 在 PnP 上有明显波动(2 kh 约 54,5 kh 约 53,10 kh 跳到 61.7),在 Non-PnP 上是最低的一条(10 kh 时 40.1)。Web 的 Non-PnP 从 10 kh 的 42.7 到 100 kh 的 43.6 几乎不动,到 2,000 kh 才升到 51.2。两颗星远高于所有曲线:PnP 83.6,Non-PnP 73.8。这张图支撑的论点:在 Non-PnP 上,Glove 是唯一一条与其他数据源明显拉开距离的曲线;在 PnP 上,有机器人动作的跨本体数据与 Glove 不相上下。也就是说,“精细操作需要可靠的动作监督”这一结论主要由右图支撑。
表 1:图 5 中标注数字的整理(平均进度分;“–”表示该点未标数字或未做实验)。
| PnP | Non-PnP | |||||
| 数据源 | 1 kh | 10 kh | 增益 | 1 kh | 10 kh | 增益 |
| Glove | 53.2 | 67.9 | +14.7 | 46.8 | 59.9 | +13.1 |
| 跨本体机器人 | 约 52 | 66.9 | 约 +15 | 约 45 | 46.9 | 约 +2 |
| VendorEgo | 约 50 | 61.7 | 约 +12 | 约 35 | 40.1 | 约 +5 |
| OpenEgo | 约 46 | 57.1 | 约 +11 | 约 42 | 48.7 | 约 +6 |
| Web | 约 42 | 51.9 | 约 +10 | 约 37 | 42.7 | 约 +5 |
| Web 100 kh / 2,000 kh | 55.8 / 64.6 | 43.6 / 51.2 | ||||
| 基线(无专属预训练) | 39.3 | 34.1 | ||||
| Liber-0(完整配方) | 83.6 | 73.8 | ||||
原表注:(原文无此表,由译者从图 5 读出;带“约”的数值是按纵轴目测的估计。)
表 1 解读
这张表把“规模增益”算成数字:从 1 kh 到 10 kh,PnP 上各数据源都有 10–15 分的增益,差别不大;Non-PnP 上只有 Glove 有 13.1 分,其余数据源只有 2–6 分。这正是下文第二条发现“PnP 与 Non-PnP 规模扩展模式不同”的定量依据。表中带“约”的数字是目测值,误差约 \pm1 分。
原文
Figure 5 summarizes the experimental results, from which we draw five key findings.
译文
图 5 汇总了实验结果,我们从中得出五个关键发现。
原文
All data sources show favorable scaling trends. Every evaluated source improves over the baseline without source-specific pretraining, which scores 39.3 on PnP and 34.1 on Non-PnP. Despite local fluctuations, performance generally improves as data increases, demonstrating that diverse sources of physical experience can contribute to robot manipulation.
译文
所有数据源都表现出有利的规模扩展趋势。每个被评测的数据源都优于不做数据源专属预训练的基线(PnP 39.3 分,Non-PnP 34.1 分)。尽管存在局部波动,性能总体上随数据量增加而提升,说明多种来源的物理经验都能为机器人操作做出贡献。
解释
“每个数据源都优于基线”在 Non-PnP 上有一个边缘情况:VendorEgo 在 1 kh 时约 35 分,只比基线 34.1 高约 1 分,在评测噪声范围内。“局部波动”主要指 VendorEgo 在 PnP 上 2 kh 到 5 kh 的下降,以及 Cross-Embodiment 和 OpenEgo 在 Non-PnP 上 2 kh 到 5 kh 的小幅下降。每个点 PnP 只有 180 次试验、Non-PnP 只有 96 次,若只跑了一次训练,1–2 分的起伏不宜过度解读。
原文
PnP and Non-PnP exhibit distinct scaling patterns. For sources other than Glove, additional data yields substantially smaller gains on Non-PnP than on PnP. Glove, by contrast, maintains strong scaling across both groups: increasing from 1 kh to 10 kh improves PnP by 14.7 points and Non-PnP by 13.1 points. This suggests that broad experience transfers more readily to object selection and relocation, while fine-grained manipulation depends more strongly on reliable, transferable motion supervision.
译文
PnP 与 Non-PnP 表现出不同的规模扩展模式。对于手套以外的数据源,增加数据在 Non-PnP 上带来的增益明显小于在 PnP 上。手套则在两组任务上都保持了强劲的扩展:从 1 kh 增加到 10 kh,PnP 提高 14.7 分,Non-PnP 提高 13.1 分。这表明,广泛的经验更容易迁移到选择物体和搬移物体上,而精细操作更依赖可靠、可迁移的运动监督。
解释
验算:67.9-53.2=14.7,59.9-46.8=13.1,与图 5 一致。解读:PnP 的难点主要在“认出要拿哪个、放到哪”,这是视觉语义问题,任何视频都能帮上忙;Non-PnP(折毛巾、拧旋钮、开眼镜盒)的难点在“手指怎么施力、手腕怎么转”,这些细节在没有实测动作的视频里很难学到。一个值得注意的反例是跨本体机器人数据:它有精确的机器人动作标签,在 Non-PnP 上却几乎不随规模增长。作者在下一条把原因归于“可迁移”:其他机器人(多为平行夹爪)的动作与 LEO 灵巧手的精细操作差别太大。
原文
Glove delivers the strongest performance, particularly on Non-PnP. On PnP, Glove and Cross-Embodiment Robot Data exhibit comparable scaling trends and generally outperform the other sources. On Non-PnP, Glove achieves both higher performance and stronger scaling gains, highlighting the effectiveness of action-grounded human data for precise and sustained manipulation.
译文
手套数据表现最强,在 Non-PnP 上尤为突出。在 PnP 上,手套数据和跨本体机器人数据的扩展趋势相当,并总体优于其他数据源。在 Non-PnP 上,手套数据的性能更高,规模增益也更大,凸显了带动作锚点的人类数据对精确、持续操作的作用。
解释
在 10 kh 处,Non-PnP 上 Glove(59.9)比第二名 OpenEgo(48.7)高出 11.2 分,而 PnP 上 Glove(67.9)只比跨本体机器人(66.9)高 1 分。所以“手套最强”的结论在 PnP 上很勉强,在 Non-PnP 上才是明确的。“持续操作”(sustained manipulation)指需要保持接触一段时间的操作,例如一边转动一边保持握持。
原文
Web-scale volume alone does not close the transfer gap. Scaling Web Human Data to 2,000 kh improves its scores to 64.6 on PnP and 51.2 on Non-PnP, both below the results obtained with only 10 kh of Glove recordings. Despite a 200-fold difference in duration, Glove transfers more effectively to robot manipulation. This contrast underscores the importance of combining broad visual experience with reliable action supervision and close human–robot alignment.
译文
仅靠网络规模的数据量无法弥合迁移差距。把网络人类数据扩展到 2,000 kh,其得分提升到 PnP 64.6、Non-PnP 51.2,但两者都低于只用 10 kh 手套录像所取得的结果。尽管时长相差 200 倍,手套数据向机器人操作的迁移效果仍然更好。这一对比强调了把广泛的视觉经验与可靠的动作监督、紧密的人机对齐相结合的重要性。
解释
验算:2000/10=200;PnP 67.9>64.6(差 3.3 分),Non-PnP 59.9>51.2(差 8.7 分)。如何理解这个数字:Web 从 10 kh 到 2,000 kh 增加了 200 倍数据,PnP 只从 51.9 升到 64.6(+12.7),Non-PnP 只从 42.7 升到 51.2(+8.5),折算到对数尺度上,数据每增加 10 倍只多约 4–5 分(Non-PnP 平均每个数量级约 3.7 分)。按这个趋势粗略外推,网络视频要在 Non-PnP 上追平 10 kh 手套数据(还差 8.7 分),还需要再增加两个多数量级的数据,即数亿小时,这已超出现实可得的规模。边界:这个比较说明“每小时数据的价值”相差悬殊,但并不说明网络视频没用。完整的 Liber-0 中网络视频仍是第一阶段的最大组成(图 6 中占 40%),作者的结论是二者互补,而不是用手套替代视频。
原文
The full Liber-0 recipe achieves the highest overall performance. Combining large-scale human video with action-grounded data through staged pretraining, Liber-0 reaches 83.6 on PnP and 73.8 on Non-PnP after robot post-training, substantially exceeding every single-source configuration. This result supports our strategy of combining complementary data sources rather than relying on a single source at increasing scale.
译文
完整的 Liber-0 方案取得了最高的整体性能。通过分阶段预训练把大规模人类视频与带动作锚点的数据结合起来,Liber-0 经机器人后训练后在 PnP 上达到 83.6 分、在 Non-PnP 上达到 73.8 分,明显超过所有单一数据源的配置。这一结果支持我们组合互补数据源的策略,而不是依赖不断扩大单一数据源的规模。
解释
83.6 比最好的单源结果(Glove 10 kh,67.9)高 15.7 分;73.8 比 59.9 高 13.9 分。需要注意的混杂因素:完整配方的数据总量(2.2M 小时,约为 Glove 10 kh 的 220 倍)、训练阶段数和训练步数都与单源实验不同,所以这个差距是“组合 + 更多数据 + 更长训练”的总效果,不能全部归功于“组合”本身。要严格证明“组合优于单源”,需要在总数据量相同的条件下比较,原文没有做这样的对照。
原文
Together, these results reveal complementary roles for visual coverage and motion supervision. Large-scale human video provides broad physical experience, while Glove recordings offer particularly effective supervision for transferring that experience into executable actions. These findings motivate our staged pretraining strategy, detailed in Section 4.3.
译文
这些结果共同揭示了视觉覆盖面与运动监督之间的互补作用。大规模人类视频提供广泛的物理经验,而手套录像为把这些经验转化为可执行动作提供了特别有效的监督。这些发现促成了我们的分阶段预训练策略,详见第 4.3 节。
解释
这一段把五个发现收束成一个“分工”:视频管“广”,手套管“准”。第 4.3 节的三阶段设计就是这一分工在时间上的体现:先用视频打底(阶段 1),再引入动作(阶段 2),最后加大手套和遥操作数据的比重(阶段 3)。
4.2机器人操作的零样本实验(Zero-Shot Experiments of Robot Manipulation)
原文
Beyond improvements on predefined benchmarks, the ultimate test of scalable pretraining is whether learned capabilities generalize to tasks without task-specific robot demonstrations.
译文
除了在预定义基准上的提升,对可扩展预训练的终极检验在于:学到的能力能否泛化到没有任务专属机器人示范的任务上。
解释
第 4.1 节的所有模型都在“同一个机器人数据集”上后训练,评测任务与后训练任务大概率有重叠,所以它衡量的是“预训练让学已知任务学得更好”。本节换一个问题:没有为某任务采集过任何机器人示范,模型能不能直接做。这是衡量“基础模型”是否名副其实的关键指标。
原文
To evaluate this, we test Liber-0 on 60 tasks proposed by GPT-6, independently of our internal scaling benchmarks. The suite covers three levels of difficulty: 20 PnP tasks, 20 short Non-PnP manipulation tasks, and 20 challenging multi-step Non-PnP tasks. Each task is evaluated over 10 trials, yielding 600 trials in total. The evaluated checkpoint has not been trained on robot demonstrations collected for these target tasks.
译文
为此,我们在由 GPT-6 提出的 60 个任务上测试 Liber-0,这些任务独立于我们内部的规模扩展基准。任务集涵盖三个难度等级:20 个 PnP 任务、20 个较短的 Non-PnP 操作任务和 20 个有挑战性的多步 Non-PnP 任务。每个任务评测 10 次,共 600 次试验。被评测的检查点没有在为这些目标任务采集的机器人示范上训练过。
解释
“被评测的检查点”是哪一个,原文没有明说:可能是阶段 3 预训练之后直接评估的模型(第 4.3 节称之为“直接评估”),也可能是在其他任务的机器人数据上后训练过的模型。两种情况下“零样本”的含义略有不同,前者更严格。另外,预训练数据中有 LEO 自己的遥操作数据(图 6 的 Teleoperation),这些数据是否包含与评测任务相似的任务(例如同样是“把杯子放到某处”),也会影响对“零样本”的理解。原文只保证“没有为这些目标任务专门采集示范”。
原文
Liber-0 achieves success rates of 63.5% on PnP, 34.0% on short Non-PnP, and 10.5% on challenging multi-step Non-PnP tasks, with an overall success rate of 36.0%. Notably, the model successfully executes some multi-step manipulation sequences without task-specific robot training, extending zero-shot execution beyond simple grasping and placement. Representative zero-shot trials are shown in Section 1.
译文
Liber-0 在 PnP 上的成功率为 63.5%,在较短的 Non-PnP 任务上为 34.0%,在有挑战性的多步 Non-PnP 任务上为 10.5%,总体成功率为 36.0%。值得注意的是,模型在没有任务专属机器人训练的情况下成功执行了一些多步操作序列,把零样本执行扩展到了简单抓取放置之外。具有代表性的零样本试验见第 1 节。
解释
验算:每档 20 个任务 \times 10 次 = 200 次。63.5\%\times200=127,34.0\%\times200=68,10.5\%\times200=21;合计 216/600=36.0\%,三档的简单平均 (63.5+34.0+10.5)/3=36.0\%,两种算法一致(因为三档试验数相同)。如何看待 10.5%:多步任务 200 次中成功 21 次,按二项分布,95% 置信区间大约是 7%–16%。成功率不高,但不是零,这正是作者用“涌现”一词的依据。还要注意这里的指标是成功率,与第 4.1 节的进度分不可比:内部基准上 PnP 进度分 83.6,与这里 PnP 成功率 63.5% 是两回事。
原文
We also evaluate GPT-6 Astra as a standalone robot policy on the 60 GPT-6-generated tabletop tasks, with three trials per task (180 trials in total). Astra-only achieves success rates of 8.3%, 5.0%, and 1.7% on PnP, short Non-PnP, and challenging multi-step Non-PnP tasks, respectively. Astra's average reasoning time per decision is 87.3 s, while the mean end-to-end completion time for successful tasks, including both reasoning and robot execution, is 17.8 min.
译文
我们还在这 60 个由 GPT-6 生成的桌面任务上,把 GPT-6 Astra 作为独立的机器人策略进行评测,每个任务 3 次试验(共 180 次)。Astra-only 在 PnP、较短 Non-PnP 和有挑战性的多步 Non-PnP 任务上的成功率分别为 8.3%、5.0% 和 1.7%。Astra 每次决策的平均推理时间为 87.3 s,而成功任务的平均端到端完成时间(包括推理和机器人执行)为 17.8 min。
解释
验算:每档 20 任务 \times 3 次 = 60 次。5/60=8.3\%,3/60=5.0\%,1/60=1.7\%,即三档分别成功 5、3、1 次,总体 9/180=5.0\%(原文没有给总体数字)。时间:17.8 min = 1,068 s,按每次决策 87.3 s 计,约相当于 12 次决策的推理时间(还没算执行时间),说明即使成功的任务也需要十来轮“看一眼、想一分半、动一下”。比较口径的不对等:Astra-only 每任务只试 3 次、Liber-0 试 10 次,前者的估计误差大得多;但两者成功率相差 7 倍以上,这一差距不会因试验次数不同而改变方向。至于 Astra 如何输出机器人动作(直接输出关节目标?调用运动基元?),原文只引用了 [11],没有说明,见下一段。
表 2:零样本任务集上的成功率(按原文数字整理)。
| 方法 | 每任务试验数 | PnP | 短 Non-PnP | 多步 Non-PnP | 总体 |
| Liber-0 | 10(共 600) | 63.5%(127/200) | 34.0%(68/200) | 10.5%(21/200) | 36.0% |
| Astra-only | 3(共 180) | 8.3%(5/60) | 5.0%(3/60) | 1.7%(1/60) | 5.0%^{*} |
原表注:(原文无此表,由译者根据正文数字整理;括号内的成功次数和带 ^{*} 的 Astra-only 总体成功率由译者反算,原文未给出。)
表 2 解读
两行的差距在所有难度上都很大,而且难度越高,Astra-only 越接近零。从比值看,PnP 上 Liber-0 约为 Astra-only 的 7.6 倍,短 Non-PnP 上约 6.8 倍,多步任务上约 6.2 倍。需要提醒的是,60 个任务由 GPT-6 生成、又用 GPT-6 Astra 来执行,任务的措辞对 Astra 应当不存在理解障碍,所以它的失败主要来自物理执行,而不是语言理解。
原文
In our evaluation, Astra-only struggles with contact-rich manipulation requiring precise alignment and controlled hand–object contact. Its successful behaviors are largely confined to coarse grasping and placement that tolerate imprecise motion. In the accompanying video, for example, it repeatedly fails at the initial drawer-opening step. Long control cycles further limit timely feedback correction, consistent with the latency issues discussed in [11].
译文
在我们的评测中,Astra-only 在需要精确对准和受控手—物接触的富接触操作上表现吃力。它的成功行为大多局限于能容忍不精确动作的粗略抓取和放置。例如在随附的视频中,它反复卡在第一步“拉开抽屉”上失败。过长的控制周期进一步限制了及时的反馈纠正,这与 [11] 中讨论的延迟问题一致。
解释
[11] “Astranomy” 是 NVIDIA 对“GPT-6 Astra 作为原生机器人策略”的实证研究。这一段的论点与引言开头呼应:推理能力强(Astra)不等于操作直觉强。失败原因有两个:一是空间精度不够,开抽屉需要手指准确勾住把手;二是控制频率太低,每 87 秒才决策一次,手一旦滑脱,要等一分多钟才能发现并纠正,而 Liber-0 这类策略每秒可以多次更新动作。本工作区的 RoboICL、VLM-as-Policy 译稿也讨论过前沿 VLM 直接控制机器人的能力边界,可对照阅读。
原文
We further explore object-level generalization through an interactive online simulation application. After post-training Liber-0 on 100 hours of simulated teleoperation data, users can upload custom objects and observe manipulation in simulation without additional object-specific training. This provides an open-ended complement to our fixed real-robot benchmarks.
译文
我们还通过一个交互式在线仿真应用来探索物体层面的泛化。在 100 小时的仿真遥操作数据上对 Liber-0 进行后训练后,用户可以上传自定义物体,并在仿真中观察它的操作,无需额外针对该物体训练。这为我们固定的真机基准提供了一个开放式的补充。
解释
在线仿真应用的地址是 https://sim.liberai.work/(本译稿未访问)。这是一个演示,而不是定量实验:原文没有报告在仿真中对多少物体、以什么指标进行了测试。它与真机零样本实验的区别是,这里泛化的是“没见过的物体”,任务类型可能是训练过的;而真机实验泛化的是“没有示范的任务”。结论一节说 Liber-0 能零样本泛化到“未见过的物体和任务”,其中“物体”这一半主要来自这个仿真演示。
原文
These results demonstrate that large-scale human experience, combined with action grounding and embodiment alignment, can support robot manipulation beyond the specific tasks represented in robot demonstrations.
译文
这些结果表明,大规模人类经验与动作锚定、本体对齐相结合,能够支持超出机器人示范所覆盖的特定任务之外的机器人操作。
解释
注意这里的因果说法比证据更强:本节只评测了完整的 Liber-0,没有做“去掉手套数据”或“去掉人类视频”的零样本消融,因此不能确定零样本能力具体来自人类经验、动作锚定还是本体对齐中的哪一部分。
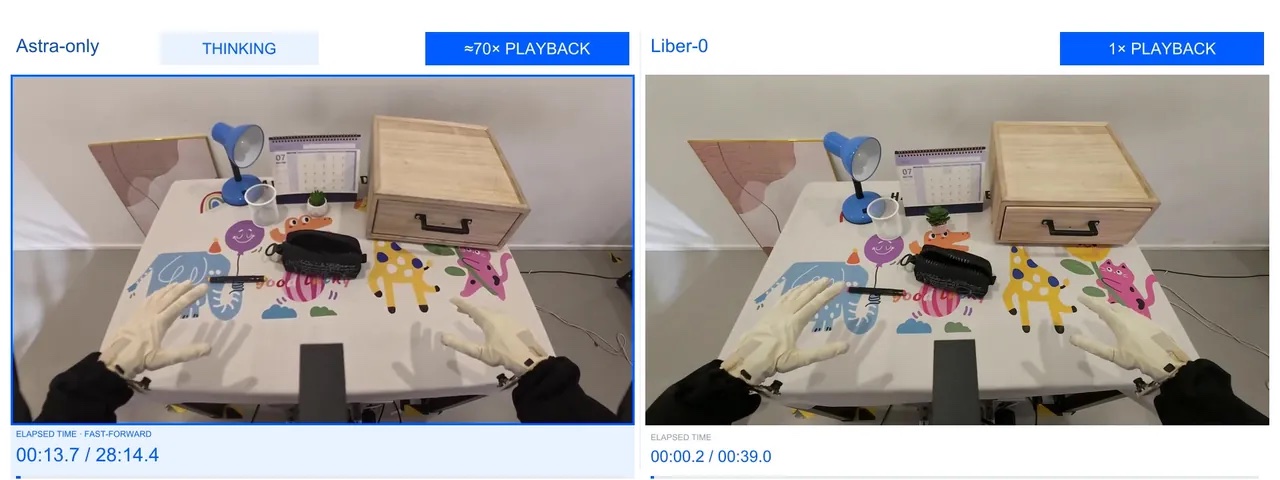
视频 3(截取封面帧)。Liber-0 与 Astra-only 在一个多步桌面任务上的对比。任务要求拉开抽屉、把笔放进黑色收纳袋、把收纳袋放进抽屉,再关上抽屉。Liber-0 完成了整个序列,而 Astra-only 一直在反复尝试第一步“拉开抽屉”。
原图注:Video 3. Liber-0 VS Astra-only on a multi-step tabletop task. The task requires opening a drawer, placing a pen in a black pouch, storing the pouch in the drawer, and closing it. Liber-0 completes the sequence, while Astra-only repeatedly attempts the initial drawer-opening step.
视频 3 解读
封面帧是左右并排的两个第一人称画面:左边 Astra-only,标注“THINKING”(思考中)和“约 70 倍速回放”,计时器显示 00:13.7 / 28:14.4;右边 Liber-0,标注“1 倍速回放”,计时器显示 00:00.2 / 00:39.0。也就是说,同一任务 Liber-0 用 39 秒完成,Astra-only 的视频长达 28 分钟(压缩 70 倍播放),并且最终没有完成。两边的场景相同:桌上有台灯、日历、笔、黑色收纳袋和带抽屉的木箱。这个例子同时体现了上文说的两个问题:Astra-only 精细接触能力不足(拉不开抽屉)、控制周期过长(28 分钟)。它是单个演示,定量结论仍以表 2 为准。
4.3Liber-0 的分阶段预训练(Staged Pretraining of Liber-0)
原文
Guided by the complementary strengths of different data sources, we pretrain Liber-0 on over 2.2 million hours of human experience using a three-stage strategy (Figure 6). Training progressively shifts from broad visual prediction toward action-grounded manipulation.
译文
根据不同数据源的互补优势,我们采用三阶段策略(图 6),在超过 220 万小时的人类经验上预训练 Liber-0。训练逐步从宽泛的视觉预测转向以动作为锚的操作。
解释
这种“先广后专”的课程式训练在大模型中很常见:LLM 先在海量网页文本上预训练,最后阶段(常称“退火”或“中期训练”)再提高高质量数据的比例。这里的“广”是视频,“专”是带动作的手套和遥操作数据。
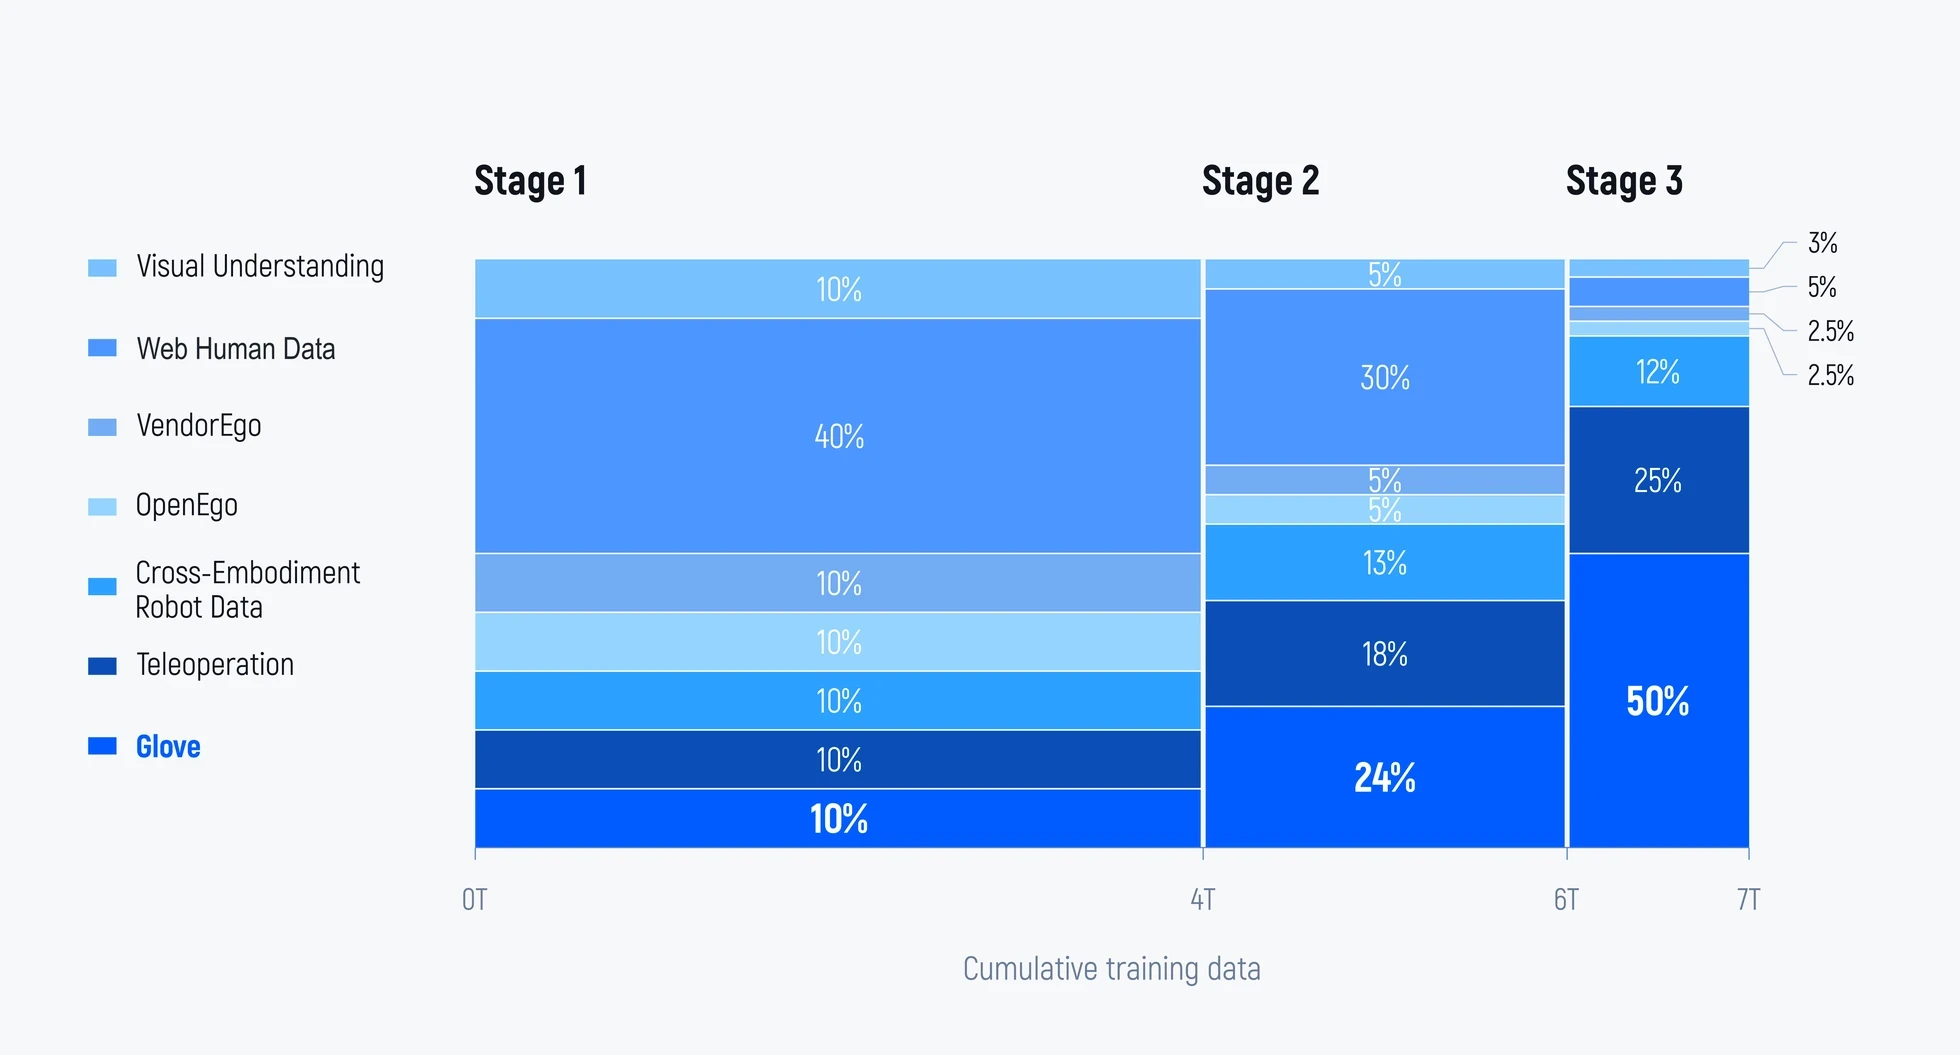
图 6:三个预训练阶段的数据采样配比。彩色条带表示各数据集的采样比例,阶段边界把通用视觉预测、世界—动作联合预训练和以操作为重点的预训练分开。Visual Understanding(视觉理解)指第 4.4 节介绍的通用视觉理解数据。
原图注:Figure 6. Data sampling mixtures across three pretraining stages. Colored bands indicate the sampling proportion of each dataset, and stage boundaries separate general visual prediction, joint world-action pretraining, and manipulation-focused pretraining. Visual Understanding denotes the general visual understanding data described in Section 4.4.
图 6 解读
横轴是累计训练数据量,刻度为 0T、4T、6T、7T;每个阶段的柱宽与该阶段的数据量成正比,即阶段 1 占 4T、阶段 2 占 2T、阶段 3 占 1T。原文没有说明“T”的单位,按惯例应是万亿(trillion)个 token。纵向的彩色条带是各数据源的采样比例,每个阶段加起来都是 100%(数字整理见表 3)。图例有七类:视觉理解、网络人类数据、VendorEgo、OpenEgo、跨本体机器人数据、遥操作(Teleoperation)和手套(Glove)。三个阶段的变化趋势一目了然:网络人类数据从 40% 降到 30% 再降到 5%;手套从 10% 升到 24% 再升到 50%;遥操作从 10% 升到 18% 再升到 25%。阶段 3 中“手套 + 遥操作”占了 75%,所有人类视频类数据(Web、VendorEgo、OpenEgo)合计只有 10%。值得注意的细节:(1) 阶段 1 已经包含了 10% 手套、10% 遥操作和 10% 跨本体机器人数据,但正文说阶段 1“没有动作训练目标”,所以这些数据在阶段 1 只用来训练画面预测。(2) 图中的“遥操作”是单独一类,第 4.4 节的训练数据清单里却没有单独介绍,推测是 LEO 自己的遥操作数据(见译者附注)。(3) 按 token 计,网络人类数据在阶段 1 约占 4\text{T}\times40\%=1.6\text{T},全程合计约 1.6+0.6+0.05=2.25\text{T};手套全程约 0.4+0.48+0.5=1.38\text{T}。考虑到网络视频有约 200 万小时、手套数据少得多,手套数据必然被重复采样了很多轮。
表 3:图 6 的数据配比整理(各阶段内的采样比例)。
| 数据源 | 阶段 1(0–4T) | 阶段 2(4–6T) | 阶段 3(6–7T) |
| 视觉理解(Visual Understanding) | 10% | 5% | 3% |
| 网络人类数据(Web Human Data) | 40% | 30% | 5% |
| VendorEgo | 10% | 5% | 2.5% |
| OpenEgo | 10% | 5% | 2.5% |
| 跨本体机器人数据 | 10% | 13% | 12% |
| 遥操作(Teleoperation) | 10% | 18% | 25% |
| 手套(Glove) | 10% | 24% | 50% |
| 合计 | 100% | 100% | 100% |
原表注:(原文无此表,由译者从图 6 读出。阶段 3 中 3%、5%、2.5%、2.5% 四个窄条在图中用引线标注,按图例颜色顺序对应视觉理解、网络、VendorEgo、OpenEgo。)
表 3 解读
三列各自加和都是 100%:阶段 1 为 10+40+10\times5=100,阶段 2 为 5+30+5+5+13+18+24=100,阶段 3 为 3+5+2.5+2.5+12+25+50=100。按 token 量换算各数据源的总采样量(阶段比例 \times 阶段 token 数):网络人类数据约 2.25T,手套约 1.38T,遥操作约 1.01T,跨本体机器人约 0.78T,视觉理解约 0.53T,VendorEgo 与 OpenEgo 各约 0.53T。可见按训练计算量计,手套数据仅次于网络视频,而它的原始时长远远小于网络视频。
原文
Stage 1: General Visual Prediction. We begin with visual prediction pretraining across diverse human activities, objects, and environments. At this stage, the model learns to predict future observations without an action-training objective. This establishes broad priors about object interactions and physical dynamics, providing a foundation for subsequent action learning.
译文
阶段 1:通用视觉预测。我们首先在多样的人类活动、物体和环境上进行视觉预测预训练。这一阶段,模型学习预测未来观测,不设动作训练目标。这为物体交互和物理动态建立了广泛的先验,为后续的动作学习打下基础。
解释
阶段 1 的模型本质上是一个“视频预测模型”(加上 10% 视觉理解任务)。它占全部训练量的 4/7(约 57%)。为什么不一开始就学动作?一种解释是,动作专家在随机初始化时输出的是噪声,过早和视觉一起训练可能干扰视觉表示的形成;先把“世界会怎么变”学扎实,再学“我该怎么动”,更稳定。由于没有动作目标,阶段 1 结束时模型不能直接控制机器人,所以图 7 中阶段 1 只有后训练后的结果,没有直接评估的点。
原文
Stage 2: Joint World-Action Pretraining. We then switch to joint prediction of future frames and actions. The training mixture combines the visual coverage of human video with motion supervision from glove and robot recordings, allowing the model to connect how an interaction unfolds with the actions that produce it. This stage brings visual prediction and action learning into a shared framework across diverse embodiments.
译文
阶段 2:世界—动作联合预训练。随后我们切换到联合预测未来帧和动作。训练配比把人类视频的视觉覆盖面与手套和机器人录像的运动监督结合起来,使模型能够把“交互如何展开”与“产生这一交互的动作”联系起来。这一阶段把视觉预测和动作学习纳入一个跨多种本体的共享框架。
解释
“把交互如何展开与产生它的动作联系起来”是世界动作模型的核心直觉:画面预测告诉模型“抽屉会被拉出来”,动作预测告诉模型“手要勾住把手往后拉”,两者在同一个网络里互相约束。阶段 2 中带动作的数据(手套、遥操作、跨本体机器人)合计占 24+18+13=55\%,人类视频类数据合计 40%,视觉理解 5%,两类数据大致各占一半。“跨多种本体”指人手、LEO 和其他机器人的动作都在这一阶段一起训练,统一本体表示在这里开始发挥作用。
原文
Stage 3: Manipulation-Focused Pretraining. In the final stage, we increase the sampling weight of Glove and teleoperation recordings. This shift places greater emphasis on precise motion and sustained interaction, building on the broad priors acquired in earlier stages to strengthen manipulation performance.
译文
阶段 3:以操作为重点的预训练。在最后阶段,我们提高手套和遥操作录像的采样权重。这一调整更加强调精确运动和持续交互,在前面阶段获得的广泛先验基础上增强操作性能。
解释
阶段 3 只占 1T(约 14%),但手套和遥操作合计占 75%。这一阶段与“后训练”的界限比较模糊:遥操作数据是 LEO 自己的机器人数据,阶段 3 实际上已经在大量学习目标机器人的动作。这也可以解释下文的发现:阶段 3 之后再做机器人后训练,增益很小。
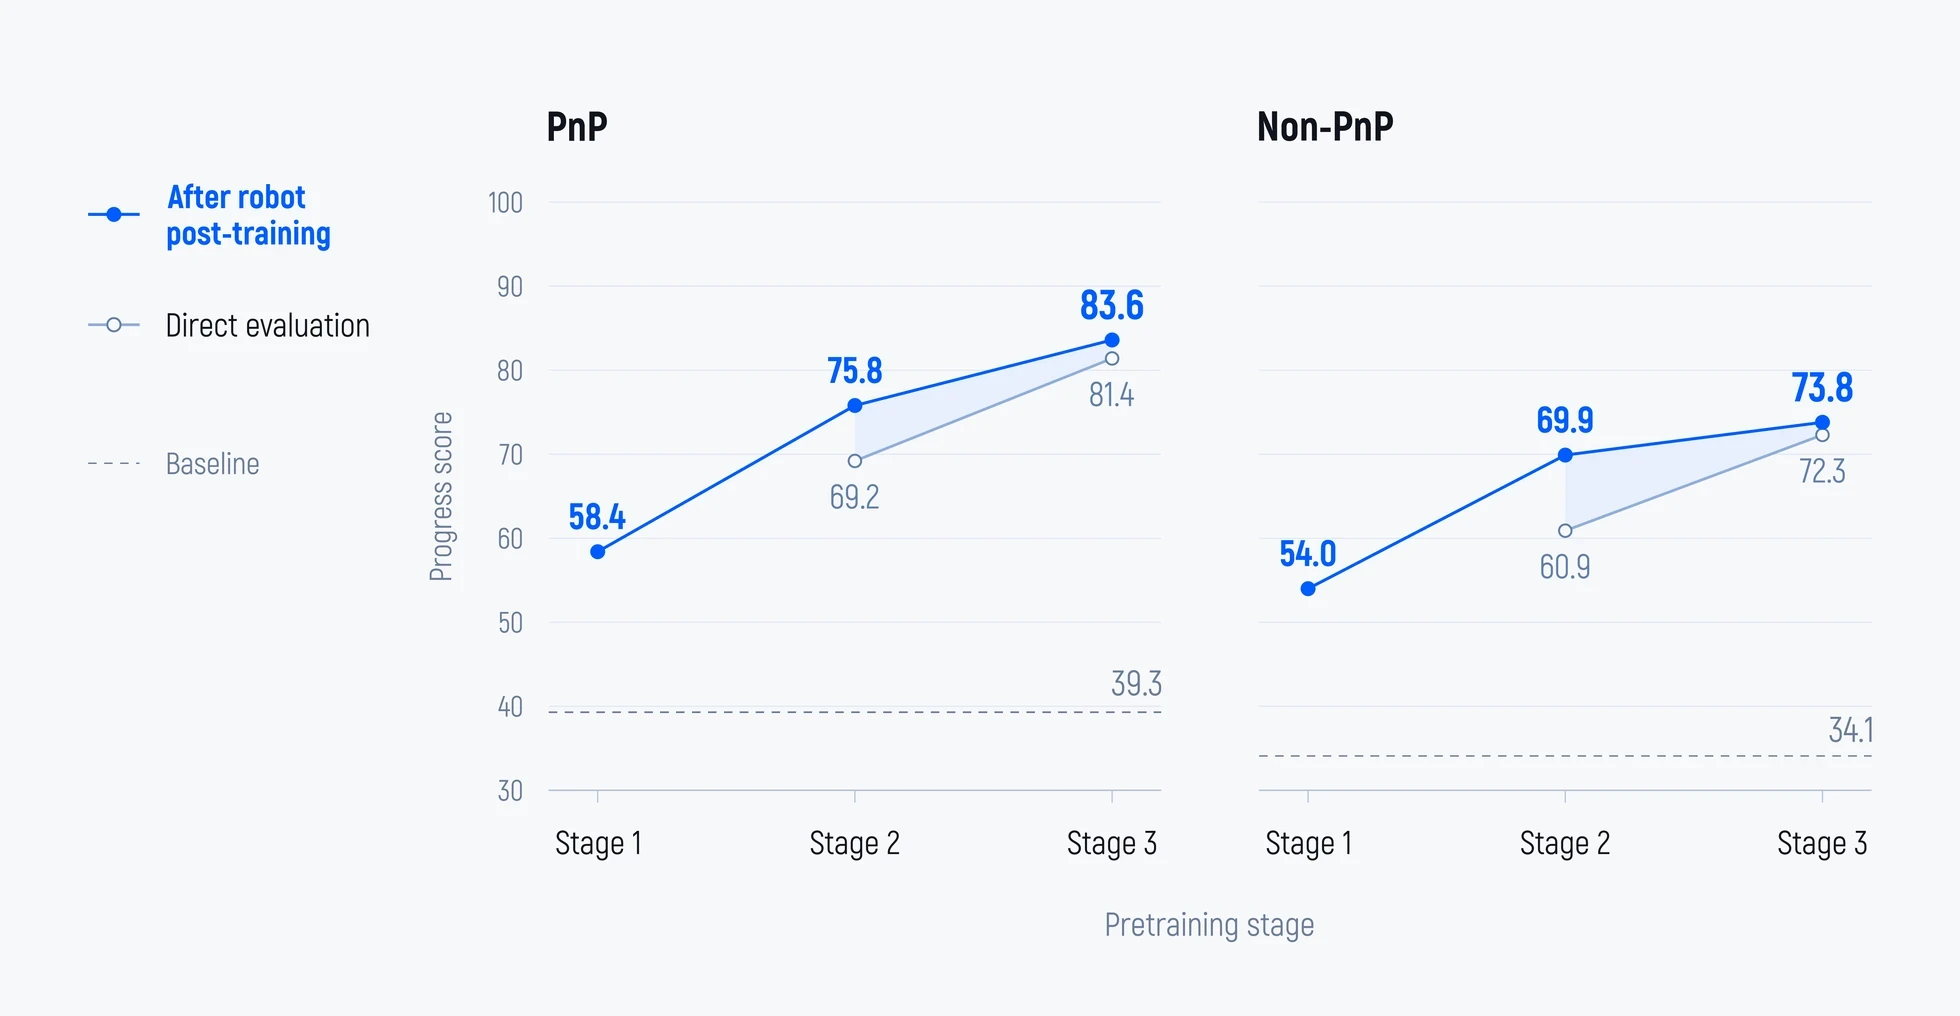
图 7:各预训练阶段的操作性能。图中给出三个阶段经机器人后训练后的 PnP 与 Non-PnP 进度分,以及阶段 2 和阶段 3 的直接评估结果。虚线沿用图 5 中的基线。
原图注:Figure 7. Manipulation performance across pretraining stages. PnP and Non-PnP progress scores are shown after robot post-training for all three stages and in direct evaluation for Stages 2 and 3. Dashed lines reproduce the baselines from Figure 5.
图 7 解读
横轴是预训练阶段,纵轴是进度分。实心圆点实线是“机器人后训练之后”,空心圆点浅色线是“直接评估”(预训练检查点不再微调,直接上机器人),两线之间的浅蓝色阴影就是后训练带来的增益。灰色虚线为图 5 的基线(39.3、34.1)。读数:PnP 后训练后为 58.4 \to 75.8 \to 83.6,直接评估为(无)\to 69.2 \to 81.4;Non-PnP 后训练后为 54.0 \to 69.9 \to 73.8,直接评估为(无)\to 60.9 \to 72.3。后训练增益:阶段 2 为 75.8-69.2=6.6(PnP)和 69.9-60.9=9.0(Non-PnP);阶段 3 为 83.6-81.4=2.2 和 73.8-72.3=1.5。阴影从左到右明显收窄,这就是正文“后训练的边际收益随预训练推进而下降”的图像证据。阶段 3 后训练后的 83.6 / 73.8 正是图 5 中的两颗星。一个值得注意的对比:阶段 1 后训练后的 PnP 58.4,低于图 5 中只用 10 kh 手套单源预训练的 67.9,也低于 2,000 kh 网络视频单源预训练的 64.6;Non-PnP 54.0 则高于 Web 2,000 kh 的 51.2,低于 Glove 10 kh 的 59.9。这再次说明,不学动作的纯视觉预训练对 PnP 的帮助有限。由于两类实验的训练设置未必相同,这一对比只能作为参考。
原文
As shown in Figure 7, performance improves across successive training stages in both direct evaluation (without additional robot post-training) and evaluation after robot post-training. By Stage 3, the pretrained checkpoint reaches progress scores of 81.4 on PnP and 72.3 on Non-PnP, with robot post-training further improving these scores to 83.6 and 73.8, respectively.
译文
如图 7 所示,无论是直接评估(不做额外的机器人后训练)还是机器人后训练之后的评估,性能都随训练阶段的推进而提升。到阶段 3,预训练检查点的进度分在 PnP 上达到 81.4,在 Non-PnP 上达到 72.3;机器人后训练把这两项分别进一步提高到 83.6 和 73.8。
解释
“直接评估”能达到 81.4 分,前提是阶段 3 的预训练数据中已有 25% 的 LEO 遥操作数据;这些数据与内部基准任务的关系(是否包含同类任务)原文没有交代。因此“预训练检查点直接可用”更准确的说法是:在混入大量目标机器人数据的预训练之后,检查点已经接近后训练的水平。
原文
Importantly, the additional benefit of robot post-training decreases as pretraining advances. At Stage 3, post-training adds only 2.2 points on PnP and 1.5 points on Non-PnP, suggesting that much of the manipulation capability present in post-training has already been acquired through pretraining. We have reason to expect that, in deployment, a properly pretrained model may significantly reduce the need for post-training.
译文
重要的是,随着预训练的推进,机器人后训练带来的额外收益在减小。在阶段 3,后训练只在 PnP 上增加 2.2 分、在 Non-PnP 上增加 1.5 分,说明后训练所能带来的操作能力大部分已经在预训练中获得。我们有理由预期,在实际部署中,一个充分预训练的模型可能会显著减少对后训练的需求。
解释
验算:83.6-81.4=2.2,73.8-72.3=1.5,与图 7 一致;阶段 2 的增益是 6.6 和 9.0,阶段 3 降为原来的约 1/3 和 1/6。结论边界:(1) 2.2 分和 1.5 分已接近评测噪声(PnP 180 次、Non-PnP 96 次试验),可以理解为“后训练几乎不再有帮助”,但不宜把具体数字看得太精确。(2) 这里的后训练数据与阶段 3 中的遥操作数据可能高度重叠,增益小也可能是因为“后训练的数据在预训练中已经见过”,而不完全是预训练带来了泛化。作者的措辞“有理由预期”“可能”是恰当的保留。
4.4数据与基准(Data & Benchmarks)
原文
Finally, we elaborate on the composition of the training data, as well as the evaluation benchmark used in the preceding experiments.
译文
最后,我们详细说明训练数据的构成,以及前述实验所用的评测基准。
原文
Training Data. Our pretraining corpus combines complementary sources of visual experience and motion supervision:
- Glove Data: Human manipulation recordings collected with LiberSense Glove, pairing measured hand poses and trajectories with synchronized first-person and wrist-camera video. The dataset covers diverse PnP and Non-PnP behaviors, human morphologies, objects, and environments.
- Cross-Embodiment Robot Data: Robot manipulation demonstrations spanning different embodiments, tasks, and environments, providing explicit robot action supervision.
- OpenEgo: Human egocentric video aggregated from public datasets, covering diverse activities and hand–object interactions.
- VendorEgo: Externally collected egocentric human manipulation recordings, offering more consistent demonstrations and motion patterns closer to robot execution.
- Web Human Data: Curated online human activity videos, providing broad coverage of objects, scenes, viewpoints, and physical interactions.
译文
训练数据。我们的预训练语料组合了视觉经验和运动监督两类互补的数据源:
- 手套数据:用 LiberSense 手套采集的人类操作录像,把测得的手部姿态和轨迹与同步的第一人称视频和腕部相机视频配对。数据集涵盖多样的 PnP 与 Non-PnP 行为、人类形态、物体和环境。
- 跨本体机器人数据:涵盖不同本体、任务和环境的机器人操作示范,提供明确的机器人动作监督。
- OpenEgo:从公开数据集汇集的人类第一人称视频,涵盖多样的活动和手—物交互。
- VendorEgo:外部采集的第一人称人类操作录像,示范更一致,运动模式也更接近机器人执行。
- 网络人类数据:经过筛选的网络人类活动视频,在物体、场景、视角和物理交互上覆盖广泛。
解释
五类数据大致按“动作监督的可靠性”从高到低、“覆盖面”从窄到宽排列。跨本体机器人数据应当包括 Open X-Embodiment、DROID、AgiBot World 一类公开数据集,原文没有列出具体名称。OpenEgo 可能包括 Ego4D、EPIC-KITCHENS、HOI4D 等公开第一人称数据集。VendorEgo 是外包采集的第一人称操作录像,比公开数据“更一致”,是因为采集方按统一规范录制桌面操作,动作更接近机器人要做的事。原文对各数据源的时长、来源名单和是否带估计的手部姿态标签都没有给出,只能从图 5 推断 Web 至少有 2,000 kh,其余四类至少各有 10 kh。遗漏:图 6 中单列的“遥操作”数据没有出现在这份清单里。
原文
To strengthen semantic, spatial, and temporal grounding capabilities, we additionally co-train on general visual understanding data, including:
- VQA: Image question-answering and captioning examples covering object recognition, scene description, and visual relationships. Task-conditioned subtask prediction examples pair overall instructions with current and historical observations to identify the active execution step, connecting task semantics with manipulation progress.
- Image Segmentation: Pixel-level segmentation examples providing spatial supervision over object regions and boundaries, grounding semantic labels in precise visual regions.
- Image Editing: Instruction-conditioned image editing examples linking language instructions to corresponding visual transformations, providing supervision for how intended changes should appear in the scene.
- Video Understanding: Video QA, dense captioning, and temporal grounding examples covering action sequences, event order, object-state changes, and execution progress. Video QA captures temporal and interaction-level understanding, dense captions describe successive interactions and their outcomes, and temporal grounding aligns language-described actions with corresponding video intervals [12]. Together, these tasks provide supervision for tracking interaction progress over time.
译文
为了加强语义、空间和时间上的落地能力,我们还在通用视觉理解数据上进行联合训练,包括:
- VQA:图像问答和图像描述样本,涵盖物体识别、场景描述和视觉关系。以任务为条件的子任务预测样本把总体指令与当前及历史观测配对,用于识别当前正在执行的步骤,把任务语义与操作进度联系起来。
- 图像分割:像素级分割样本,提供关于物体区域和边界的空间监督,把语义标签落实到精确的视觉区域上。
- 图像编辑:以指令为条件的图像编辑样本,把语言指令与相应的视觉变换联系起来,监督“预期的变化在场景中应当呈现为什么样子”。
- 视频理解:视频问答、密集描述和时间定位样本,涵盖动作序列、事件顺序、物体状态变化和执行进度。视频问答捕捉时间层面和交互层面的理解,密集描述刻画连续的交互及其结果,时间定位则把语言描述的动作与对应的视频区间对齐 [12]。这些任务共同为跟踪交互随时间的进展提供监督。
解释
四类任务各有分工:VQA 管“是什么、在哪、做到哪一步了”,其中子任务预测对多步任务尤其重要,它让模型在没有外部规划器时也能判断“抽屉已经打开,下一步该放笔了”;分割管“精确在哪里”;图像编辑管“做完之后应该是什么样”,与世界模型的画面预测天然相通;视频理解管“顺序和进度”。[12] 是 Qwen3-VL 技术报告,这里引用的是它在视频时间定位上的做法;原文没有说明 Liber-0 的语言 / 视觉专家是否由 Qwen3-VL 初始化。这些数据在图 6 中合称“视觉理解”,三个阶段分别占 10%、5%、3%。
视频 4(截取封面帧)。Liber-0 训练数据一瞥:超过 220 万小时的人类经验。人类和机器人操作录像,涵盖多样的物体、环境、行为和本体。
原图注:Video 4. A glimpse of Liber-0's training data: over 2.2M hours of human experience. Human and robot manipulation recordings spanning diverse objects, environments, behaviors, and embodiments.
视频 4 解读
原文是一段由大量小视频拼成的网格动画(文件名中的 “dynamic-data-grid” 和 “4k”),封面帧是 10\times10 共 100 个训练视频缩略图的拼贴,绝大多数是第一人称视角的双手操作画面,场景有桌面、厨房、货架、户外等;其中很多画面能看到手腕上的黑色环形 Quest 手柄和米色手套,即手套数据,也有裸手的画面,机器人画面在封面帧中很少。它只用于直观展示数据的多样性,不提供任何定量信息;具体的数据配比以图 6 为准。
原文
Benchmarks. Our internal scaling benchmarks evaluate two complementary categories of manipulation: pick-and-place (PnP), which probes object selection and placement across varied objects and scenes, and Non-PnP, which evaluates manipulation behaviors including precise hand–object interaction, object-state control, and multi-step action coordination. These tasks require the policy to adapt its movements to object geometry and mechanical constraints and achieve the intended final object configuration.
译文
基准。我们内部的规模扩展基准评测两类互补的操作:抓取放置(PnP),考察在不同物体和场景下对物体的选择和放置;以及 Non-PnP,评测的操作行为包括精确的手—物交互、物体状态控制和多步动作协调。这些任务要求策略根据物体几何形状和机械约束调整动作,并达到预期的最终物体状态。
解释
“物体状态控制”指改变物体本身的状态,例如把抽屉从关变成开、把毛巾从展开变成折好,区别于只改变物体位置的 PnP。“机械约束”指铰链、滑轨这类限制运动方向的结构:开抽屉必须沿滑轨拉,开眼镜盒必须绕铰链转,动作方向错了就会卡住。
原文
- Pick-and-Place (PnP). The PnP benchmark includes two 30-task sets: one using the existing object inventory and another using separately procured object instances spanning both familiar and additional categories. Each set contains 40 objects across five tabletop scenes, with eight objects present in each scene. Tasks require selecting the instructed object and placing it in, on, or next to a specified target. Each task is evaluated over three trials, testing object identification, grasping, and spatially specified placement under variations in object appearance and category.
- Non-PnP Manipulation. The Non-PnP benchmark comprises 16 tasks across six action families: folding, opening, closing, pressing, pulling, and pushing. Examples include folding a towel into a storage box, closing an eyeglass case, operating a drawer, and pressing a button on a scale. Some tasks combine these interactions with grasping and placement, requiring completion of the full manipulation sequence. Each task is evaluated over six trials, giving 96 trials per model.
译文
- 抓取放置(PnP)。PnP 基准包含两个各 30 个任务的任务集:一个使用现有的物体库存,另一个使用另行采购的物体实例,既有熟悉的类别,也有新增的类别。每个任务集包含分布在五个桌面场景中的 40 个物体,每个场景放 8 个物体。任务要求选出指令所指的物体,并把它放进、放到或放在指定目标旁边。每个任务评测三次,考察在物体外观和类别变化下的物体识别、抓取和按空间要求放置的能力。
- Non-PnP 操作。Non-PnP 基准由 16 个任务组成,分属六个动作族:折叠、打开、关闭、按压、拉和推。例子包括把毛巾折好放进收纳盒、合上眼镜盒、操作抽屉,以及按下秤上的按钮。部分任务把这些交互与抓取放置结合起来,要求完成整个操作序列。每个任务评测六次,每个模型共 96 次试验。
解释
验算:PnP 每个任务集 5\times8=40 个物体;两个任务集共 60 个任务,每任务 3 次,共 180 次试验。Non-PnP 16\times6=96 次,与原文一致。第二个 PnP 任务集使用另行采购的物体实例(同类不同个体,也包括新类别),相当于一个“物体外观泛化”测试,但原文把两个任务集的成绩合并报告,没有分开给出。统计精度:PnP 每个任务只有 3 次试验,Non-PnP 每个任务 6 次,单个任务的分数波动很大,基准的可靠性主要依靠任务数量取平均。
原文
Evaluation Metrics and Protocol. We report progress scores on a 0–100 scale to capture partial execution alongside complete task performance. PnP scoring tracks milestones including approach, alignment, grasping, transport, release, and stable placement. Non-PnP scoring assigns task-specific weights to completed action milestones. Initial configurations are restored using reference images or videos, and model comparisons use matched instructions and scene configurations.
译文
评测指标与协议。我们报告 0–100 分制的进度分,以便在完整完成任务之外也能体现部分执行的情况。PnP 的评分跟踪的里程碑包括接近、对准、抓取、搬运、松开和稳定放置。Non-PnP 的评分对已完成的动作里程碑赋予任务专属的权重。初始布置借助参考图像或视频复原,模型之间的比较使用相同的指令和场景布置。
解释
进度分与成功率的关系:PnP 有六个里程碑,若平均分配权重,一个“抓起来了但放歪了”的试验可以得到约 5/6 的分数。因此进度分系统性地高于成功率,而且对“差一点成功”更敏感,适合比较模型之间的细小差异。但它也有代价:各里程碑的权重是人为设定的(Non-PnP 是任务专属权重,原文没有公布),不同权重会改变绝对分数。复原初始布置用参考图像或视频,这是真机评测的常规做法,用于减少不同模型之间场景摆放的差异。
原文
Notably, these progress-based benchmarks are distinct from the GPT-6-proposed zero-shot task suite in Section 4.2, which reports task success rates rather than partial progress.
译文
需要指出,这些基于进度分的基准与第 4.2 节由 GPT-6 提出的零样本任务集是不同的,后者报告的是任务成功率,而不是部分进度。
解释
这句提醒很重要:本文出现了两套指标。第 4.1、4.3 节和第 5 节的所有数字都是进度分(0–100),只有第 4.2 节是成功率(%)。读者容易把“PnP 83.6”和“PnP 63.5%”放在一起比较,这是不对的,两者的任务集和指标都不同。
5评估人到机器人的迁移(Evaluating Human-to-Robot Transfer)
原文
The aforementioned results demonstrate that large-scale human experience can translate into robot manipulation capabilities. We now investigate what makes this transfer effective, examining how glove recordings reduce the need for robot demonstrations, enable new manipulation skills, and benefit from diversity and alignment across embodiments.
译文
前述结果表明,大规模人类经验可以转化为机器人操作能力。现在我们研究是什么让这种迁移有效:考察手套录像如何减少对机器人示范的需求、如何带来新的操作技能,以及如何从本体的多样性和对齐中获益。
解释
第 4 节回答“有没有用”,第 5 节回答“为什么有用、用在哪”。四个小节对应四个问题:5.1 手套能替代多少机器人数据,5.2 手套能否教会机器人没示范过的技能,5.3 采集者的多样性是否重要,5.4 机器人像不像人是否重要。前三个关于数据,最后一个关于硬件。注意本节各实验都是小规模的专项实验,评测任务从 3 个到 10 个不等,彼此不可直接比较,也不能与第 4 节的 76 任务基准比较。
5.1用更少的机器人数据训练(Training with Less Robot Data)
原文
We first investigate how effectively glove recordings can substitute for robot demonstrations. We consider two settings: combining increasing amounts of glove data with limited robot demonstrations (Glove + Limited Robot Data), and training on glove recordings alone (Glove-only). Robot-only training serves as the reference (Figure 8).
译文
我们首先研究手套录像能在多大程度上替代机器人示范。我们考虑两种设置:在有限的机器人示范上逐步增加手套数据(手套 + 有限机器人数据),以及只用手套录像训练(仅手套)。纯机器人训练作为参照(图 8)。
解释
这里的“训练”指策略训练阶段(相当于后训练)用什么数据,而不是第 4 节的大规模预训练。原文没有说明这些实验是否从 Liber-0 预训练检查点出发;如果是,那么“仅手套”也不是真正意义上的零机器人数据,因为预训练中已经包含 LEO 的遥操作数据。
原文
All configurations use the same number of training steps and are evaluated on eight tasks using LEO equipped with WUJI2 hands, with 10 trials per task (80 trials per configuration). The Robot and Glove data pools contain equal numbers of demonstrations.
译文
所有配置使用相同的训练步数,在配备 WUJI2 灵巧手的 LEO 上评测八个任务,每个任务 10 次试验(每种配置 80 次)。机器人数据池和手套数据池包含相同数量的示范。
解释
WUJI2 是这里唯一一处提到的灵巧手型号,从名称看可能是舞肌科技(Wuji)的灵巧手,原文没有给出厂商、自由度等参数。“相同训练步数”很关键:它排除了“数据多的配置训练得更久”这一混杂因素,但也意味着数据少的配置会重复更多轮。“两个数据池示范数相同”使得 100% 手套与 100% 机器人可以直接比较“每条示范的价值”。
原文
Learning with limited robot data. In the Glove + Limited Robot Data configuration, robot demonstrations are fixed at 25% of the Robot pool. Increasing Glove data from 25% to 50% and 100% raises progress from 61.2 to 68.4 and 75.6, respectively. The final configuration exceeds the 72.8 achieved by Robot-only training with the full Robot pool, while using 75% fewer robot demonstrations.
译文
在有限机器人数据下学习。在“手套 + 有限机器人数据”配置中,机器人示范固定为机器人数据池的 25%。把手套数据从 25% 增加到 50% 和 100%,进度分分别从 61.2 提高到 68.4 和 75.6。最后一种配置超过了用完整机器人数据池做纯机器人训练所得的 72.8 分,而所用的机器人示范少了 75%。
解释
验算:25% 机器人 + 100% 手套 = 75.6 > 100% 机器人 = 72.8,高 2.8 分;机器人示范用量 25\%,即少 75%。口径提醒:前者的示范总数是 0.25+1=1.25 倍数据池,后者是 1 倍,所以这并不是“同等数据量下手套更好”。更公平的同量对比是:25% 机器人 + 25% 手套(共 0.5 倍)得 61.2,50% 机器人(0.5 倍)得 66.9;25% 机器人 + 50% 手套(0.75 倍)得 68.4,而 0.75 倍机器人数据没有测。可见在相同示范数下,一条手套示范的价值低于一条机器人示范,手套的优势在于便宜、可以多采,而不是单条更有效。作者的措辞“少用 75% 机器人示范”是准确的,但读者不应把它理解成“手套比机器人数据更好”。
原文
Transfer from glove recordings alone. Under Glove-only training, using 50% of the Glove pool achieves a progress score of 49.4, approaching the 50.0 obtained with 25% of the Robot pool. Increasing Glove data to 100% further raises progress to 60.3, exceeding the 50.0 achieved by Robot-only training with 25% of the Robot pool.
译文
只用手套录像的迁移。在仅手套训练下,使用 50% 手套数据池可得 49.4 分,接近用 25% 机器人数据池所得的 50.0 分。把手套数据增加到 100%,进度分进一步提高到 60.3,超过了用 25% 机器人数据池做纯机器人训练所得的 50.0 分。
解释
换算比例:50% 手套 \approx 25% 机器人(49.4 对 50.0),即大约两条手套示范抵一条机器人示范。100% 手套(60.3)介于 25% 机器人(50.0)和 50% 机器人(66.9)之间,按线性插值,25\%+\frac{60.3-50.0}{66.9-50.0}\times25\%\approx40\%,即 100% 手套约相当于 40% 的机器人数据,折合约 2.5 条手套示范抵一条机器人示范,比 50% 手套时的“二换一”略差,说明手套数据也有边际递减。这一段第二句与第一句重复使用了 50.0 作为比较对象,只是在说“100% 手套超过 25% 机器人”,原文没有与 50% 机器人(66.9)对比,因为那样手套会落后。
原文
These results demonstrate that glove recordings can substantially reduce reliance on robot demonstrations, while supporting meaningful cross-embodiment transfer even without robot data in policy training. Together, they establish glove collection as a scalable alternative to increasing teleoperation data alone.
译文
这些结果表明,手套录像能够大幅降低对机器人示范的依赖,即使策略训练中没有机器人数据,也能支持有意义的跨本体迁移。综合来看,它们确立了手套采集作为一种可扩展的替代方案,而不是只能靠增加遥操作数据。
解释
这一结论的经济含义取决于两种数据的采集成本比。按上一段的换算,约两条手套示范抵一条机器人示范;只要一条遥操作示范的成本(机器人折旧、操作员、场地)超过两条手套示范,用手套就更划算。原文没有给出成本数据,但前文强调手套“现场不需要机器人”,可以推测成本比远大于 2。
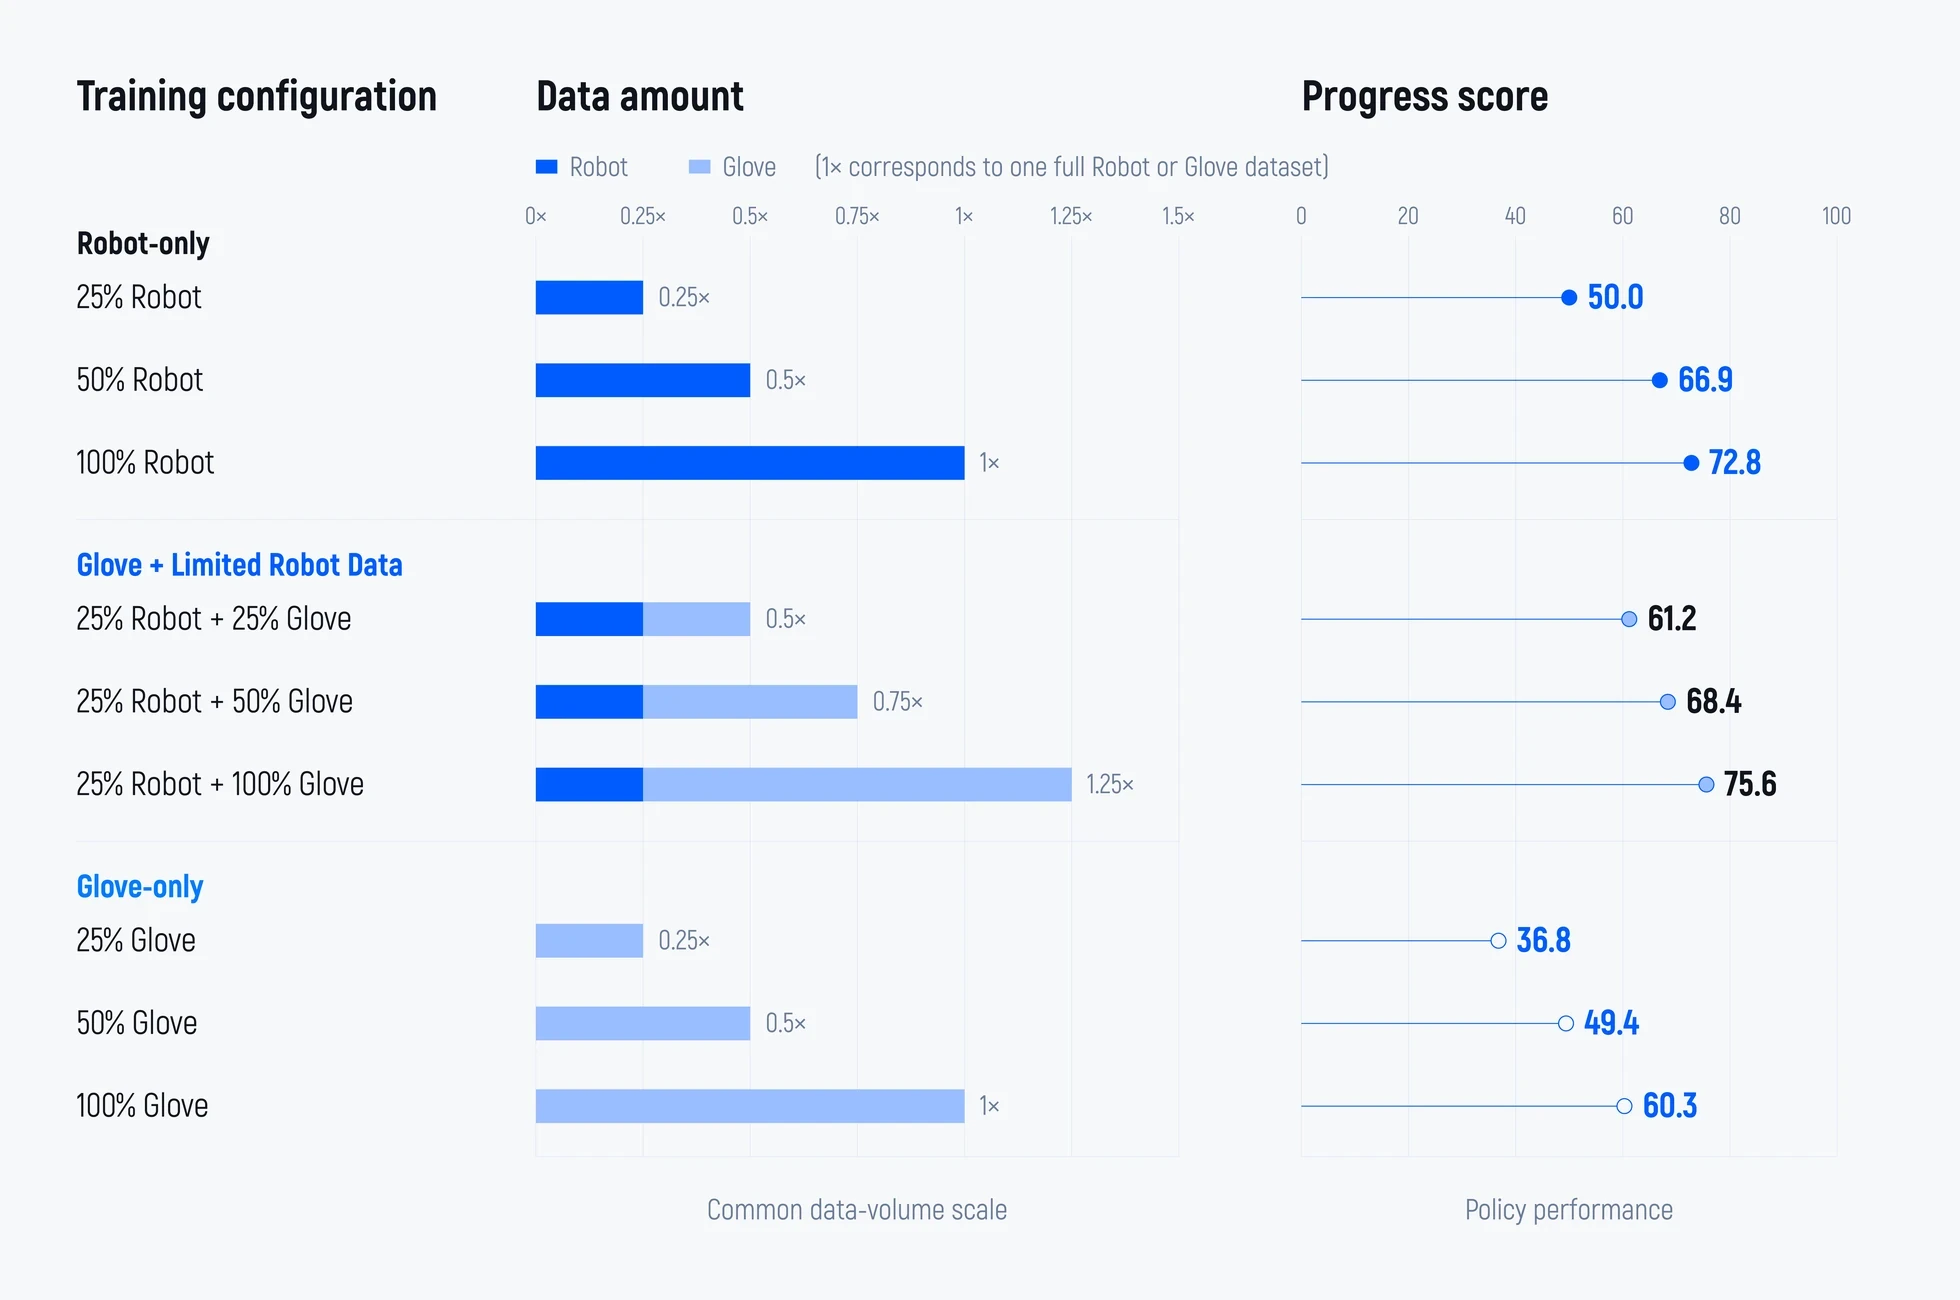
图 8:不同数据量下的手套到机器人迁移。纯机器人、手套 + 有限机器人数据、仅手套三种训练配置的平均进度分。
原图注:Figure 8. Glove-to-robot transfer with varying amounts of data. Average progress scores for Robot-only, Glove + Limited Robot Data, and Glove-only training configurations.
图 8 解读
图分三栏。左栏是训练配置,分三组:纯机器人(25%、50%、100% 机器人)、手套 + 有限机器人数据(25% 机器人 + 25% / 50% / 100% 手套)、仅手套(25%、50%、100% 手套)。中栏是数据量的条形图,深蓝为机器人、浅蓝为手套,横轴以“1\times = 一个完整的机器人或手套数据集”为单位,条形末端标注总量(0.25\times 到 1.25\times)。右栏是进度分(0–100),实心点为纯机器人,半填充点为混合配置,空心点为仅手套。全部数字:纯机器人 50.0 / 66.9 / 72.8;手套 + 有限机器人 61.2 / 68.4 / 75.6;仅手套 36.8 / 49.4 / 60.3。正文没有提到的一个数字是 25% 手套单独训练得 36.8 分。三组曲线都随数据量单调上升,纯机器人在 50% 之后增速放缓(+16.9 后只有 +5.9),混合配置的增速比较均匀(+7.2、+7.2),仅手套的增速最大(+12.6、+10.9),说明手套数据在这个范围内还远未饱和。同等总量的比较(中栏条形长度相同的行):0.5\times 时,50% 机器人 66.9 > 25%+25% 混合 61.2 > 50% 手套 49.4;1\times 时,100% 机器人 72.8 > 100% 手套 60.3。所以在相同示范数下,机器人数据始终最好;手套的价值在于以低成本增加总量。
5.2从手套数据中学习新技能(Learning New Skills from Glove Data)
原文
Beyond reducing robot data requirements, a more important question is whether glove recordings can teach robots skills absent from their robot demonstrations.
译文
除了减少对机器人数据的需求,一个更重要的问题是:手套录像能否教会机器人其机器人示范中没有的技能?
解释
5.1 节问的是“替代”(手套能不能顶替一部分机器人数据),本节问的是“扩展”(手套能不能带来机器人数据里根本没有的东西)。后者对规模化意义更大:如果每种新技能都必须先采机器人示范,扩展速度就受限于遥操作;如果手套能直接教会新技能,扩展速度就取决于手套采集。
原文
We investigate this by varying the PnP and Non-PnP coverage of the robot and glove data (Figure 9). Teleop PnP serves as the baseline, while Teleop All provides a reference trained on both PnP and Non-PnP robot demonstrations. We compare these with two mixed configurations: Teleop PnP + Glove Non-PnP, and Teleop PnP + Glove All. Each configuration is evaluated on four PnP and six Non-PnP tasks, with 10 trials per task.
译文
为此,我们改变机器人数据和手套数据对 PnP 与 Non-PnP 的覆盖范围(图 9)。Teleop PnP(只含 PnP 的遥操作数据)作为基线,Teleop All(同时含 PnP 和 Non-PnP 机器人示范)作为参照。我们把它们与两种混合配置比较:Teleop PnP + Glove Non-PnP,以及 Teleop PnP + Glove All。每种配置在四个 PnP 任务和六个 Non-PnP 任务上评测,每个任务 10 次试验。
解释
四种配置可以看作一个 2\times2 设计的一部分:机器人数据是否含 Non-PnP(Teleop All 对 Teleop PnP),手套数据含哪些(无 / 只 Non-PnP / 全部)。关键对比是“Teleop PnP”对“Teleop PnP + Glove Non-PnP”:两者的机器人数据完全相同(都没有 Non-PnP),差别只在于是否加入了手套的 Non-PnP 数据,所以 Non-PnP 上的提升可以干净地归因于手套数据。评测规模:PnP 40 次、Non-PnP 60 次。原文没有说明各配置的数据量是否相等,“Teleop All”的数据量显然多于“Teleop PnP”。
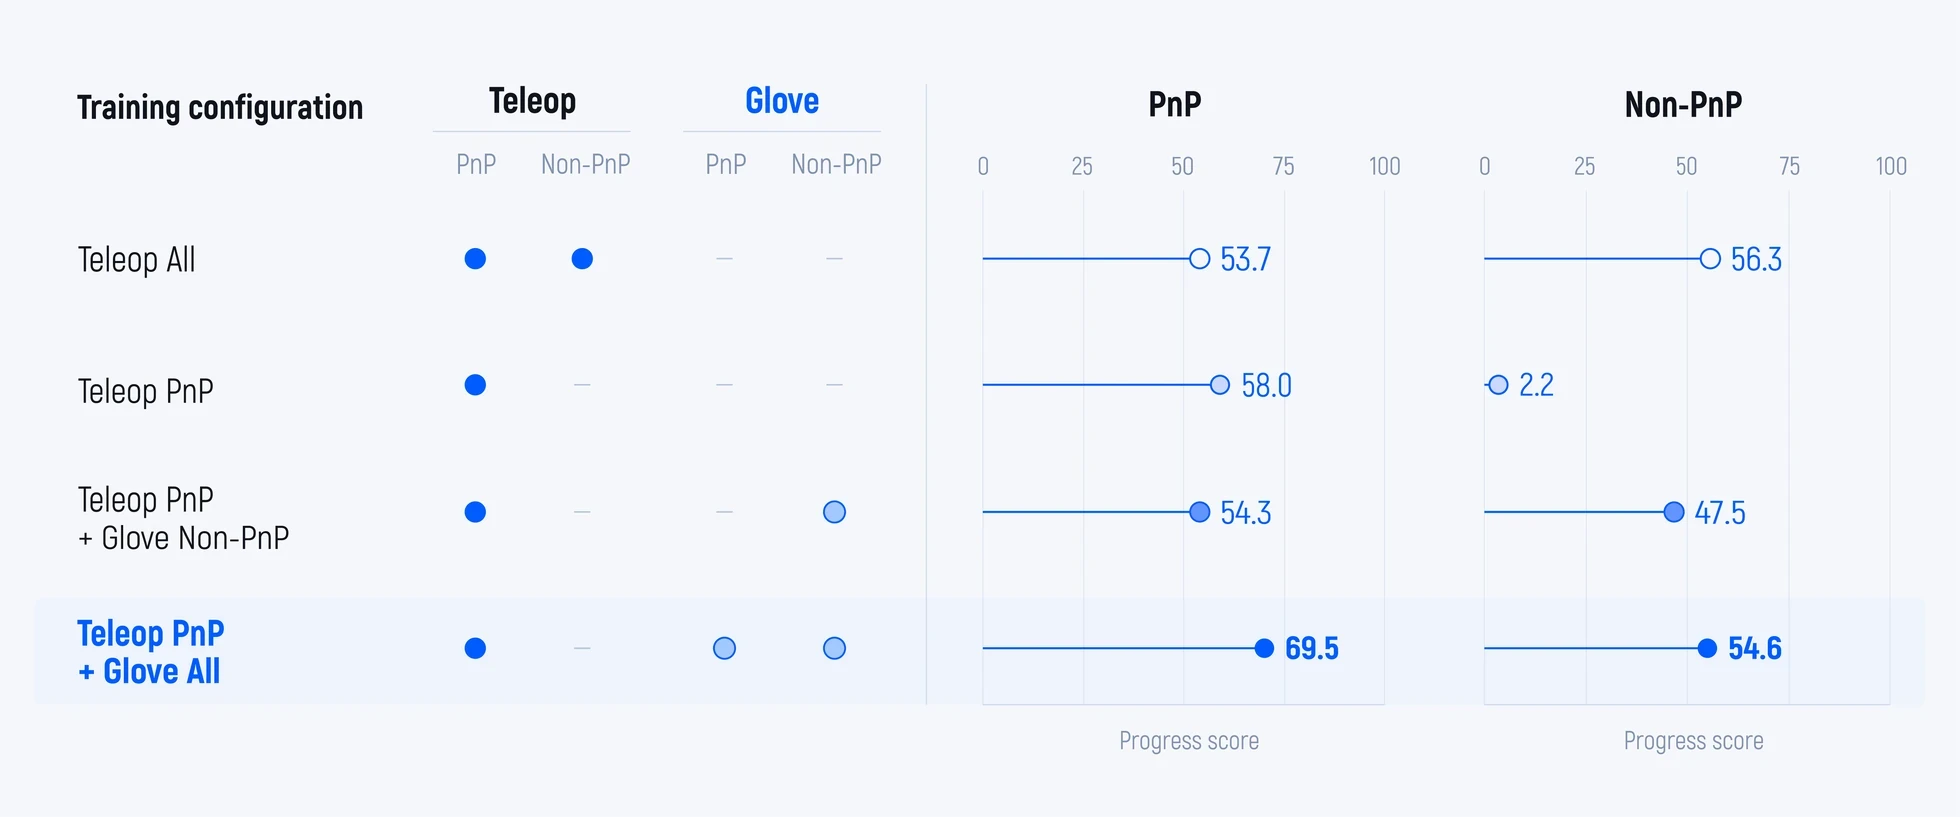
图 9:用手套数据扩展机器人技能。各训练配置改变机器人数据和手套数据中是否包含 PnP 与 Non-PnP 示范,两组任务的性能分别报告。Teleop 表示机器人遥操作数据;All 表示同时包含 PnP 和 Non-PnP 示范。
原图注:Figure 9. Expanding Robot Skills with Glove Data. Training configurations vary the inclusion of PnP and Non-PnP demonstrations in robot and glove data, with performance reported separately for both task groups. Teleop denotes robot teleoperation data; All includes both PnP and Non-PnP demonstrations.
图 9 解读
左半是配置矩阵:四行配置,四列分别是 Teleop 的 PnP、Non-PnP 和 Glove 的 PnP、Non-PnP,实心点表示包含该类数据,短横线表示不包含。右半是两组任务的进度分(0–100)。数字整理如下:
读法:Non-PnP 一列是本图的主角:2.2(没有任何 Non-PnP 数据,几乎完全不会)\to 47.5(加手套 Non-PnP)\to 54.6(加手套全部),逼近 56.3(机器人 Non-PnP 示范)。PnP 一列有一个正文没有讨论的现象:Teleop PnP 单独训练得 58.0,加入任何 Non-PnP 数据后 PnP 分都下降(Teleop All 53.7,加手套 Non-PnP 后 54.3),说明在固定训练步数下,新增技能会挤占已有技能的训练量,或者两类任务之间存在干扰;只有当手套也提供 PnP 数据时,PnP 分才跃升到 69.5,超过所有其他配置。
| 配置 | 遥操 PnP | 遥操 Non-PnP | 手套 PnP | 手套 Non-PnP | PnP 分 | Non-PnP 分 |
| Teleop All | ✓ | ✓ | – | – | 53.7 | 56.3 |
| Teleop PnP | ✓ | – | – | – | 58.0 | 2.2 |
| Teleop PnP + Glove Non-PnP | ✓ | – | – | ✓ | 54.3 | 47.5 |
| Teleop PnP + Glove All | ✓ | – | ✓ | ✓ | 69.5 | 54.6 |
原文
Two findings emerge from Figure 9:
译文
从图 9 中可以得出两个发现:
原文
First, aligned glove recordings transfer manipulation behaviors beyond robot demonstrations. When robot demonstrations cover only PnP tasks, adding Glove Non-PnP raises Non-PnP progress from 2.2 to 47.5. Using Glove All further increases it to 54.6, approaching the 56.3 achieved by Teleop All. These results suggest that high-quality motion supervision, combined with visual and embodiment alignment, makes fine-grained human manipulation experience transferable to robot execution, enabling behaviors absent from the robot-demonstration set.
译文
第一,对齐的手套录像能把机器人示范之外的操作行为迁移过来。当机器人示范只覆盖 PnP 任务时,加入手套 Non-PnP 数据使 Non-PnP 进度分从 2.2 提高到 47.5。使用全部手套数据则进一步提高到 54.6,接近 Teleop All 所得的 56.3。这些结果表明,高质量的运动监督加上视觉和本体对齐,使精细的人类操作经验能够迁移到机器人执行中,带来机器人示范集中所没有的行为。
解释
验算:47.5-2.2=45.3 分的提升完全来自手套数据;54.6/56.3\approx97\%,即手套能恢复机器人 Non-PnP 示范约 97% 的效果。2.2 分的含义:模型从没见过 Non-PnP 动作(至少在策略训练阶段没有),几乎拿不到任何里程碑分。边界:(1) 与 5.1 节一样,原文没有说明这些实验是否从 Liber-0 预训练检查点出发;如果是,预训练中已有大量手套和遥操作数据(包含 Non-PnP),那么 Teleop PnP 只得 2.2 分反而说明策略训练阶段的数据决定了模型“愿意做什么”。(2) 手套 Non-PnP 数据与评测的六个 Non-PnP 任务是否是同一批任务,原文没有说;若是同任务,这里的“新技能”是指“机器人没示范过、但人类示范过的任务”,而不是全新任务。
原文
Second, shared behaviors anchor transfer across embodiments. Expanding Glove Non-PnP to Glove All raises PnP progress from 54.3 to 69.5 and Non-PnP progress from 47.5 to 54.6. Shared PnP behaviors provide corresponding examples of manipulation under human and robot embodiments, helping the model relate human movements to robot actions and transfer additional skills.
译文
第二,共享的行为为跨本体迁移提供了锚点。把手套 Non-PnP 扩展为全部手套数据后,PnP 进度分从 54.3 提高到 69.5,Non-PnP 进度分从 47.5 提高到 54.6。共享的 PnP 行为提供了同一操作在人和机器人两种本体下的对应样例,帮助模型把人的动作与机器人的动作联系起来,从而迁移更多技能。
解释
验算:PnP +15.2,Non-PnP +7.1。机制的直觉:机器人和人都做过 PnP,模型就能对照着学“人这样动手,对应机器人那样动关节”,相当于一本“双语词典”;有了这本词典,人类独有的 Non-PnP 动作也能翻译得更准。这与机器翻译中“平行语料帮助零样本翻译”的道理相似。一个替代解释:Glove All 比 Glove Non-PnP 数据量更多,PnP 上的 15.2 分提升有一部分可能只是来自“PnP 数据更多”(手套 PnP 直接补充了 PnP 训练数据),原文没有在数据量相同的条件下控制这一点。
原文
These findings highlight a key advantage of action-grounded human pretraining: glove data can expand the robot's skill repertoire, rather than merely improving performance on skills already demonstrated by robots. Shared behaviors further facilitate this transfer by providing common ground across embodiments.
译文
这些发现凸显了以动作为锚的人类数据预训练的一个关键优势:手套数据能够扩充机器人的技能库,而不只是提升机器人已示范技能上的表现。共享的行为则通过在不同本体之间提供共同基础,进一步促进了这种迁移。
解释
这一结论给出了一个实用的数据采集策略:机器人只需采集少量“共同技能”(如 PnP)作为对照锚点,其余技能可以交给手套采集。这与第 4.2 节的零样本结果相互呼应:零样本是“连人类示范都可能没有针对该任务”,本节是“有人类示范、没有机器人示范”,泛化程度介于两者之间。
5.3形态规模律(Morphology Scaling Law)
原文
Human morphology varies in hand geometry, body proportions, and movement patterns, even when performing the same task (Figure 10). We investigate whether greater human embodiment diversity improves the model's cross-embodiment ability, independently of the total amount of training data.
译文
即使执行同一个任务,人的形态在手部几何、身体比例和运动方式上也各不相同(图 10)。我们研究:在训练数据总量不变的前提下,更高的人类本体多样性能否提升模型的跨本体能力。
解释
这一节检验第 2 节“把本体当上下文”的核心假设。如果模型真的在学“动作如何随身体变化”,那么见过的身体种类越多,学得越好,对新身体(机器人)的推断也越准。这与 LLM 中“数据多样性比数据量更重要”的经验类似。关键控制变量是总数据量不变:只改变“由多少人采集”。
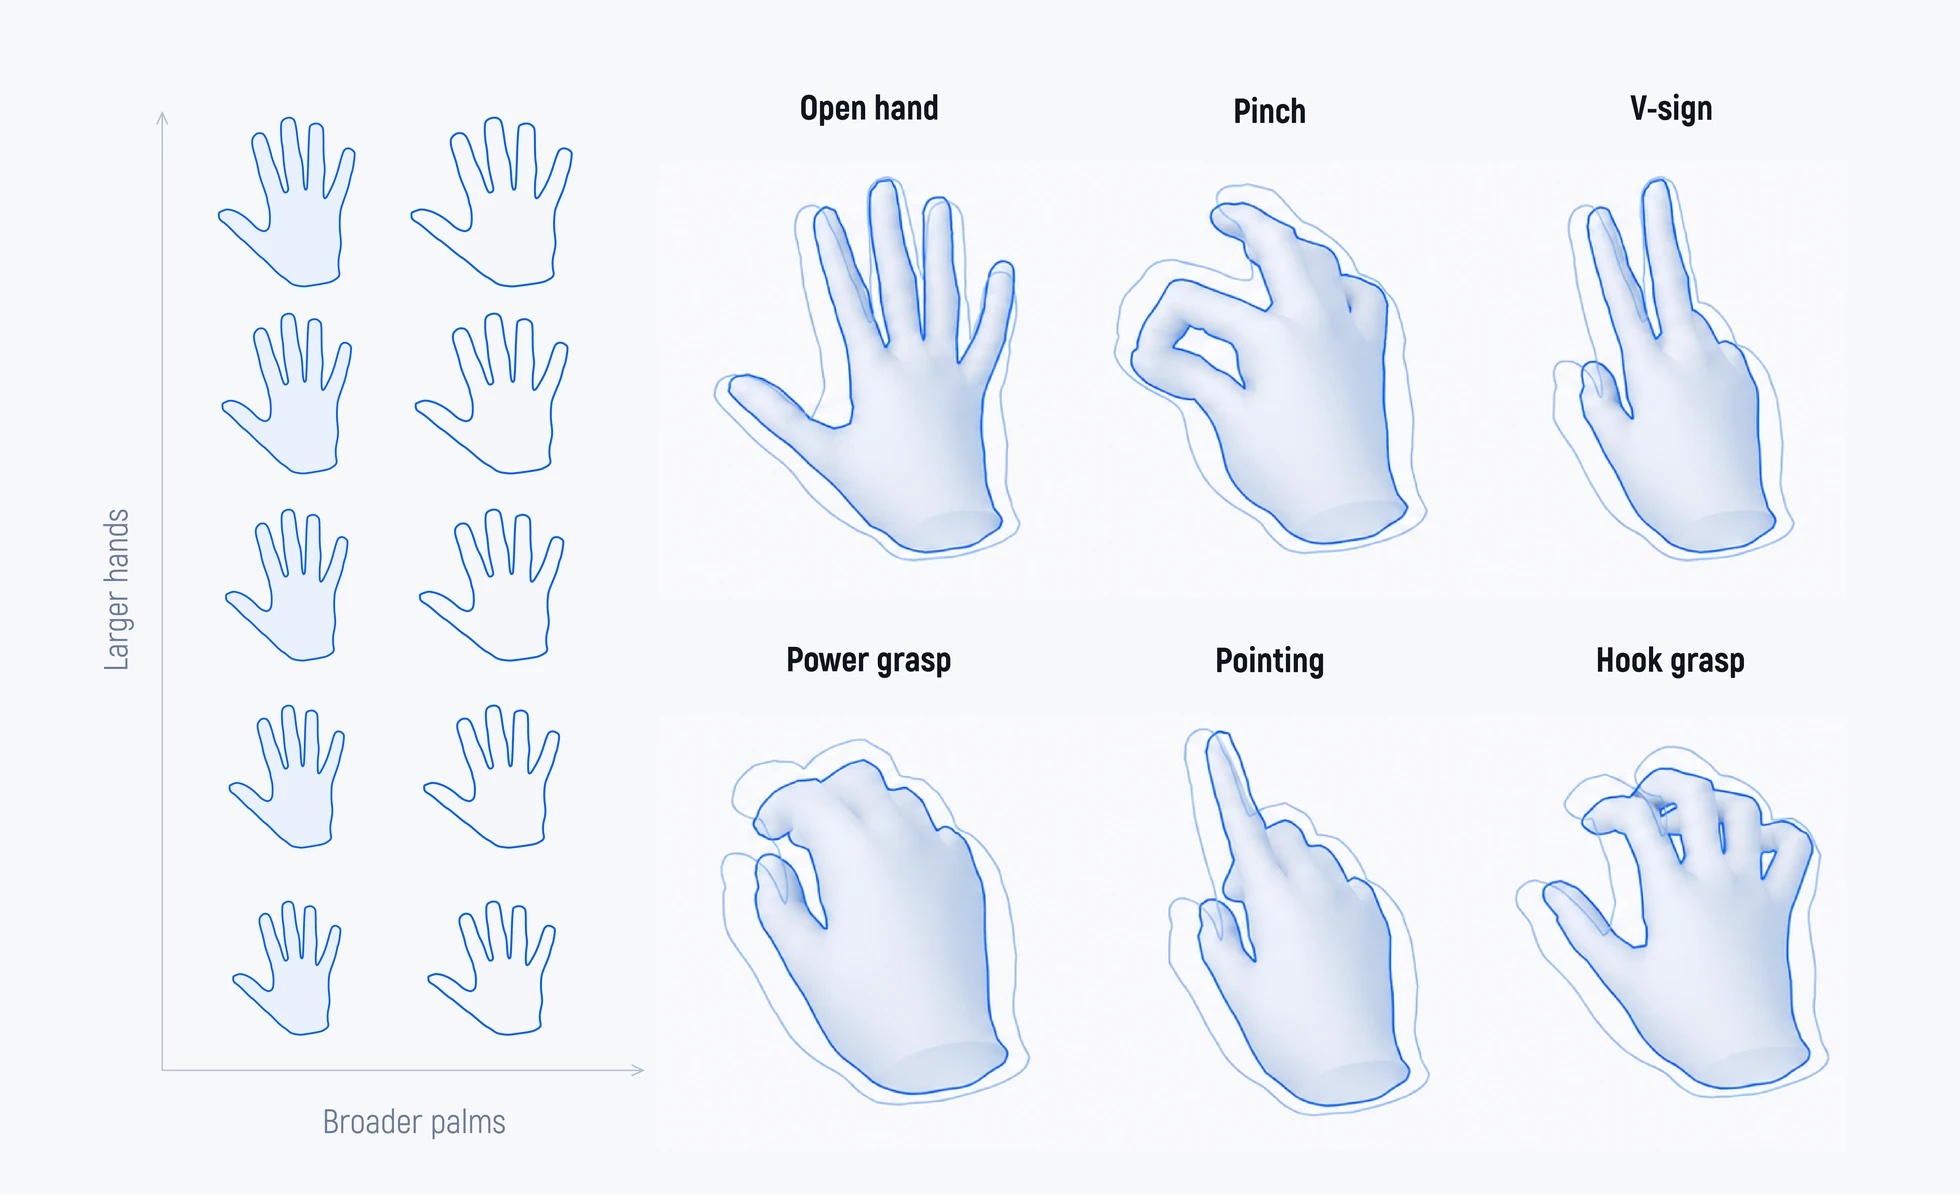
图 10:不同大小、掌宽和常见操作手势下的手形多样性。即使是名义上相同的手势,手部形态的差异也会造成不同的指尖布局,并可能导致不同的操作方式。
原图注:Figure 10. Hand-shape diversity across sizes, palm widths, and common manipulation poses. Even for the same nominal pose, differences in hand morphology produce distinct fingertip layouts and can lead to different manipulation patterns.
图 10 解读
左侧是一个二维示意:纵轴“手更大”(Larger hands),横轴“手掌更宽”(Broader palms),排列了 5\times2 共 10 个手掌轮廓,展示手的大小和掌宽两个维度上的变化。右侧是六种常见手势的三维手部模型:张开手(Open hand)、捏取(Pinch)、V 字手势(V-sign)、强力抓握(Power grasp)、指向(Pointing)、钩握(Hook grasp)。每个模型外围都有一圈浅色轮廓线,表示另一种手形做同一手势时的外轮廓,二者不重合,说明同一手势在不同手上的指尖位置不同。这张图是示意图,不是数据统计,原文没有报告采集者手形的实际分布。
原文
We vary the number of demonstrators while keeping the total number of glove episodes constant. Glove + Limited Robot Data combines glove recordings with a small, fixed set of robot demonstrations, while Glove-only uses glove recordings alone in policy training. Robot-only uses the corresponding robot demonstrations without glove recordings and serves as the reference. Both glove-based configurations use 1, 3, 10, 30, or 100 demonstrators. All demonstrator groups use the same collection tasks and environments. We evaluate all configurations on two PnP and four Non-PnP tasks.
译文
我们在保持手套示范回合总数不变的情况下改变示范者的人数。“手套 + 有限机器人数据”把手套录像与一小组固定的机器人示范结合,“仅手套”在策略训练中只使用手套录像。“纯机器人”使用对应的机器人示范、不含手套录像,作为参照。两种基于手套的配置分别使用 1、3、10、30 或 100 名示范者。所有示范者组使用相同的采集任务和环境。我们在两个 PnP 任务和四个 Non-PnP 任务上评测所有配置。
解释
设计要点:总回合数固定为 N,1 人时每人采 N 条,100 人时每人采 N/100 条;任务和环境也相同,所以唯一的变量是“谁的手”。原文未给出的信息:总回合数 N、每任务试验次数(因此无法估计误差)、“纯机器人”参照用的是那一小组固定的机器人示范,还是某个更大的机器人数据集。从图 11 看,“手套 + 有限机器人”在 1 人时(60.6)就已经高于纯机器人(51.8),如果纯机器人用的就是那一小组机器人示范,这个结果是合理的。
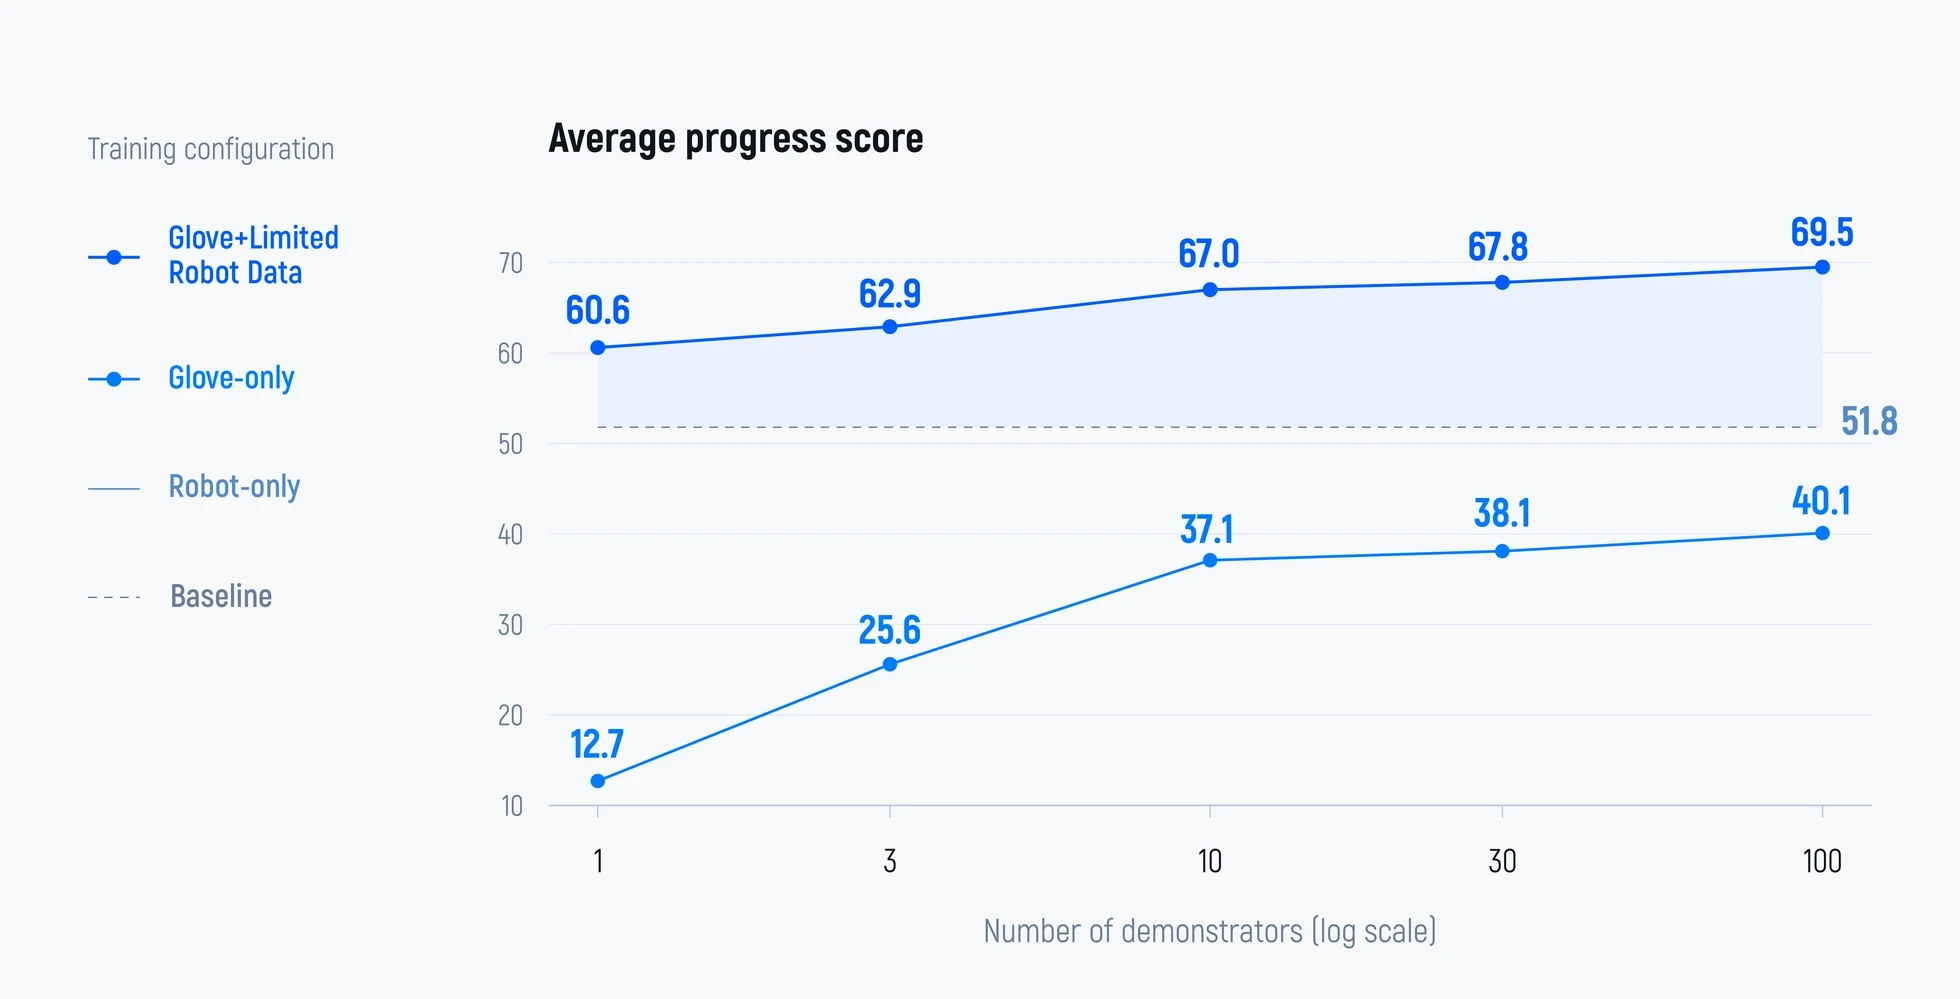
图 11:扩大人类形态的覆盖面。在手套示范回合总数固定的情况下,随示范者覆盖面增加的平均进度分。曲线比较“手套 + 有限机器人数据”与“仅手套”两种训练;参考线表示纯机器人参照。
原图注:Figure 11. Scaling human morphology coverage. Average progress scores with increasing demonstrator coverage at a fixed total number of glove episodes. Curves compare Glove + Limited Robot Data and Glove-only training; the reference line indicates the Robot-only reference.
图 11 解读
横轴是示范者人数(对数刻度:1、3、10、30、100),纵轴是平均进度分。上方曲线为“手套 + 有限机器人数据”:60.6、62.9、67.0、67.8、69.5;下方曲线为“仅手套”:12.7、25.6、37.1、38.1、40.1。水平虚线为纯机器人参照 51.8,上方曲线与参照线之间填充了浅蓝色。增长形态:两条曲线都在 1 到 10 人之间增长最快(上方 +6.4,下方 +24.4),10 人之后明显放缓(10 到 100 人上方只再 +2.5,下方只再 +3.0)。也就是说,“多样性规模律”在 10 人左右出现拐点,之后收益递减。仅手套从 1 人到 3 人就翻了一倍(12.7 \to 25.6),说明只用一个人的手训练时,模型严重过拟合于这只手的形态。图例的小矛盾:图例中同时列出了“Robot-only”(细实线)和“Baseline”(虚线)两项,但图中只有一条位于 51.8 的虚线,图注和正文都称它为纯机器人参照。图例中的“Robot-only”没有对应的线,可能是作图时遗留的图例项。
原文
As shown in Figure 11, performance improves consistently with demonstrator diversity. Increasing coverage from 1 to 100 demonstrators raises progress from 60.6 to 69.5 in the Glove + Limited Robot Data setting. The gain is more pronounced in Glove-only training, where progress increases from 12.7 to 40.1, narrowing the gap to the Robot-only reference of 51.8.
译文
如图 11 所示,性能随示范者多样性的增加而稳定提升。在“手套 + 有限机器人数据”设置下,把覆盖面从 1 名示范者增加到 100 名,进度分从 60.6 提高到 69.5。在仅手套训练中增益更为明显,进度分从 12.7 提高到 40.1,缩小了与纯机器人参照 51.8 之间的差距。
解释
验算:69.5-60.6=8.9;40.1-12.7=27.4,后者是前者的 3 倍多。与参照的差距从 51.8-12.7=39.1 缩小到 51.8-40.1=11.7,缩小了约 70%。为什么仅手套增益更大:有机器人数据时,模型可以从机器人示范中直接学到 LEO 的手该怎么动,手套多样性只是锦上添花;没有机器人数据时,模型必须从人手“推断”机器人手的动作,此时见过多少种手就至关重要。
原文
Importantly, these improvements occur without increasing the total number of glove episodes, suggesting that diversity in human embodiments provides valuable supervision beyond data volume alone. By learning how similar skills are executed across different human bodies, the model may better generalize to the target robot's morphology. This raises the possibility that sufficiently diverse human embodiments could make a closely aligned robot an interpolation target within the learned embodiment space, further reducing the need for robot-specific supervision.
译文
重要的是,这些提升是在不增加手套示范回合总数的情况下取得的,说明人类本体的多样性提供了超出数据量本身的有价值的监督。通过学习相似技能在不同人体上如何执行,模型可能更好地泛化到目标机器人的形态。这提出了一种可能性:足够多样的人类本体可以让一个与人高度对齐的机器人成为所学本体空间中的一个“插值目标”,从而进一步减少对机器人专属监督的需求。
解释
插值 vs 外推:机器学习模型在训练分布“内部”的预测(插值)通常比在“外部”的预测(外推)可靠得多。若采集者的手覆盖了从小到大、从窄到宽的各种形态,而 LEO 的手恰好落在这个范围内,那么对模型来说 LEO 只是“又一只没见过但介于已知之间的手”。这也解释了为什么 LEO 要做得像人:机器人越像人,越可能落在人类本体空间内部。一个混杂因素:示范者人数多了,带来的不只是手形多样性,还有动作习惯、操作策略、速度节奏的多样性。原文把收益归于“形态”多样性,但实验并没有把形态和行为风格分开,也可能主要是行为多样性在起作用。作者在这里用了“可能”“提出一种可能性”等谨慎的措辞。
5.4像人的本体适合人的技能(Human-like Embodiment for Human Skills)
原文
The hardware designs in Section 3 aim to make the motion patterns of humans directly accessible to robot execution. To study their contribution to skill transfer, we compare LEO with a platform equipped with Marvin M6 arms from Tianji, referred to as Tianji below. We focus on tasks requiring substantial wrist rotation, precise hand placement, and coordinated waist–arm movement.
译文
第 3 节的硬件设计旨在让人类的运动模式可以直接用于机器人执行。为了研究它们对技能迁移的贡献,我们把 LEO 与一个装有天机(Tianji)Marvin M6 机械臂的平台进行比较,下文称为“天机”。我们关注需要大幅手腕旋转、精确手部放置以及腰臂协调运动的任务。
解释
原文只说对照平台装有天机(Tianji)的 Marvin M6 机械臂,没有给出它的自由度、是否有可活动的腰部、手部用的是什么灵巧手、相机如何布置。从视频 5 的截帧看,天机平台的手也套着米色手套。由于任务被有意挑选为“需要大幅转腕、狭窄空间放手、弯腰”这三类恰好是 LEO 设计优势的动作,这个对比回答的是“在这些动作上像人的本体是否更好”,而不是“LEO 是否普遍优于天机”。
原文
We train separate policies using the same glove recordings and equal amounts of platform-specific teleoperation data. For each task, the same operator collects demonstrations on both platforms, keeping object initial positions, action sequences, and intended movement strategies as consistent as possible. This reduces variation in operator style and task setup when comparing the two embodiments.
译文
我们使用相同的手套录像和等量的平台专属遥操作数据,分别训练两个策略。对每个任务,由同一名操作员在两个平台上采集示范,尽量保持物体初始位置、动作顺序和预期的运动策略一致。这样在比较两种本体时,可以减少操作员风格和任务设置带来的差异。
解释
对照设计相当仔细:手套数据相同、遥操作数据量相同、操作员相同、初始布置相同。仍然存在的差异是:(1) 两个平台的遥操作质量可能不同,如果天机的运动学不适合这些任务,操作员在天机上采到的示范本身就更别扭、成功率更低;(2) 预训练数据中有 LEO 自己的遥操作数据(图 6),却未必有天机的数据,如果两个策略都从 Liber-0 出发,LEO 天然占优。原文没有讨论这两点。
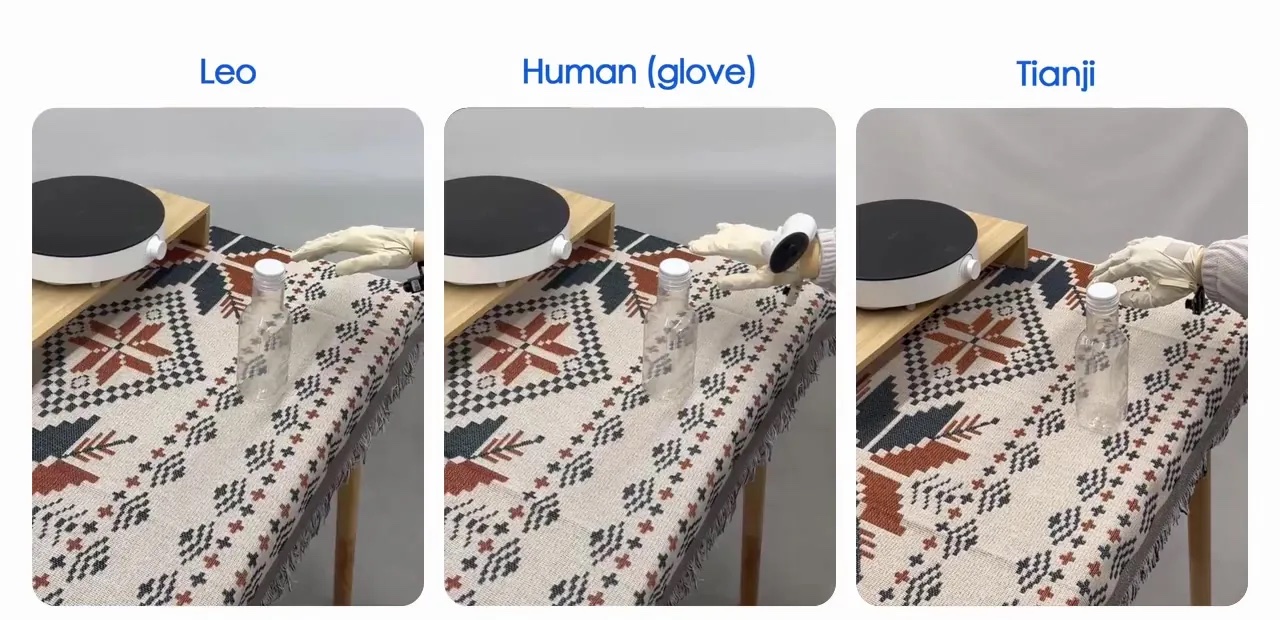
视频 5(截取封面帧)。人与机器人的运动模式。在拧旋钮、摆放拖鞋和拉开抽屉三个任务上比较 LEO、手套录制的人类示范和天机。LEO 的可活动手腕、可调节腰部和灵巧手使它能更紧密地遵循人的运动模式,从而更有效地迁移手套录制的操作技能。
原图注:Video 5. Human and robot movement patterns. Comparison of LEO, glove-recorded human demonstrations, and Tianji on knob turning, slipper arrangement, and drawer opening. LEO's articulated wrists, adjustable waist, and dexterous hands allow it to follow human movement patterns more closely, supporting more effective transfer of glove-recorded manipulation skills.
视频 5 解读
封面帧是三栏并排的第三人称画面,从左到右标注 Leo、Human (glove)、Tianji。场景是同一张铺着花纹桌布的桌子,上方木架上放着一个带白色旋钮的黑色电磁炉,桌上有一个透明塑料瓶。三栏中的手都戴米色手套,正伸向电磁炉的旋钮,对应“拧旋钮”任务的开始。中间的人手腕上可以看到 Quest 手柄。封面帧本身看不出运动模式的差别,差别要在视频的转腕过程中才能看到。原文 HTML 中,正文里“如视频 5 所示”的链接锚点指向
#figure-12,是页面的一个小错误。 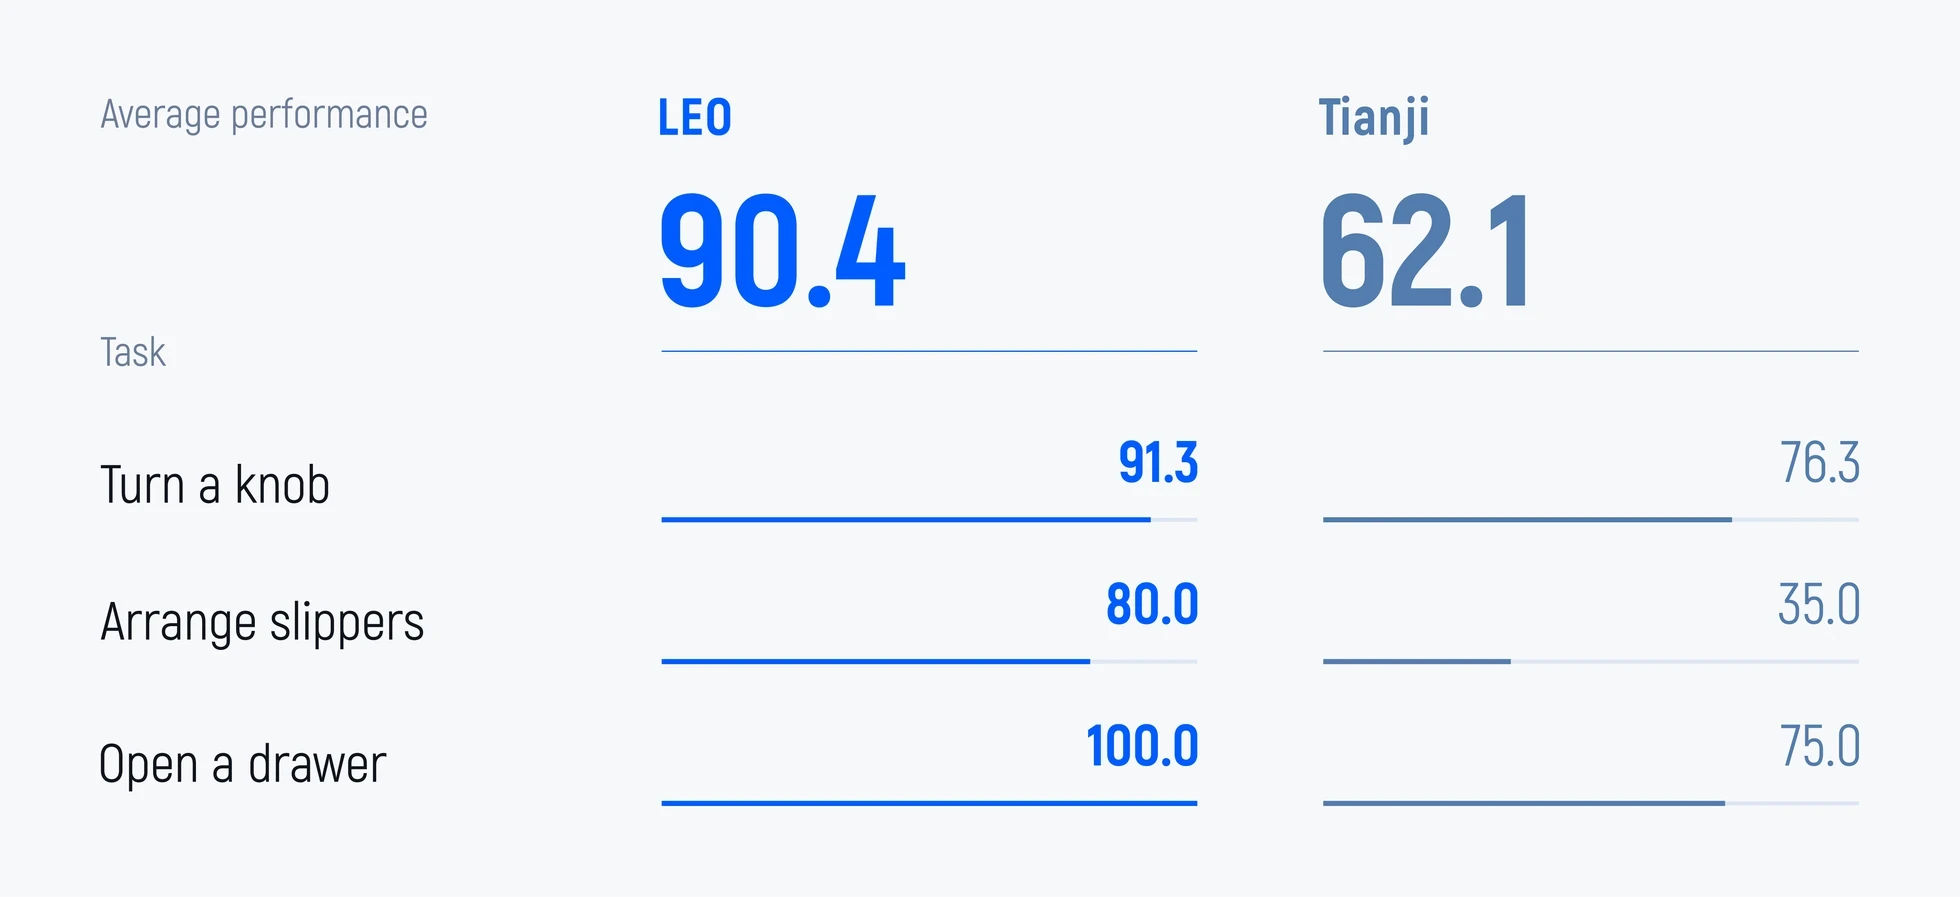
图 12:不同机器人本体上的操作性能。LEO 与天机在需要大幅手腕旋转、在狭小间隙中精确放置手指以及低位够取动作的任务上的平均进度分(0–100)。两个策略使用相同的手套录像和等量的平台专属遥操作数据。
原图注:Figure 12. Manipulation performance across robot embodiments. Average progress scores (0–100) of LEO and Tianji on tasks requiring large wrist rotations, precise finger placement under limited clearance, and low-reaching motions. Both policies use the same glove recordings and equal amounts of platform-specific teleoperation data.
图 12 解读
图分两列:LEO 和天机。顶部大号数字是三个任务的平均进度分:LEO 90.4,天机 62.1。下方三行是各任务的分数与进度条:拧旋钮(Turn a knob)LEO 91.3、天机 76.3;摆放拖鞋(Arrange slippers)LEO 80.0、天机 35.0;拉开抽屉(Open a drawer)LEO 100.0、天机 75.0。验算:(91.3+80.0+100.0)/3=90.43\approx90.4;(76.3+35.0+75.0)/3=62.1;差值 90.4-62.1=28.3,与正文一致。逐项差距:拧旋钮 +15.0,摆拖鞋 +45.0,开抽屉 +25.0。差距最大的是需要弯腰的摆拖鞋,这与“可活动腰部”这一 LEO 独有设计吻合:如果天机没有可俯仰的腰部,够取地面物体对它来说可能几乎无法完成,35 分大概只是拿到了接近、对准等前几个里程碑的分数。原文没有给出每个任务的试验次数。另外,原网页中此图的图片文件名为
figure-13,而图号为 Figure 12,属于页面制作中的小不一致,不影响内容。 原文
As illustrated in Video 5, the three tasks expose distinct movement requirements:
- Knob turning: large wrist rotations with a stable grasp. The fingers must remain engaged with the knob as the hand rotates. LEO's wrist articulation accommodates this motion with limited compensatory arm movement, allowing the policy to follow the turning pattern present in human demonstrations.
- Slipper arrangement: bending to reach objects near the floor. The robot must lower its upper body, extend its arms, and orient its fingers within a low workspace. LEO coordinates waist and arm movement to follow the human sequence of bending, reaching, grasping, and repositioning.
- Drawer opening: precise hand placement in confined spaces. The handle sits close to the tabletop, leaving little room for the hand and wrist. Humans typically approach with the palm facing forward and the wrist bent upward, then pull along the drawer's direction of travel. Reproducing this motion requires precise finger placement and dexterous wrist positioning to avoid collisions during grasping and pulling.
译文
如视频 5 所示,三个任务分别暴露了不同的运动需求:
- 拧旋钮:在稳定握持下大幅旋转手腕。手在旋转时,手指必须始终扣住旋钮。LEO 的手腕关节能以有限的手臂补偿动作完成这一运动,使策略能够遵循人类示范中的转动方式。
- 摆放拖鞋:弯腰够取靠近地面的物体。机器人必须降低上身、伸展手臂,并在低处的工作空间中调整手指朝向。LEO 协调腰部和手臂的运动,遵循人类“弯腰、伸手、抓取、重新摆放”的动作顺序。
- 拉开抽屉:在狭小空间中精确放置手部。把手紧挨着桌面,留给手和手腕的空间很小。人通常掌心朝前、手腕向上弯曲去接近把手,然后沿抽屉的滑动方向拉出。复现这一动作需要精确的手指放置和灵活的手腕定位,以免在抓取和拉动时发生碰撞。
解释
三个任务分别对应 LEO 的三项硬件设计:拧旋钮对应三自由度手腕,摆拖鞋对应可活动腰部,开抽屉对应纤细前臂加灵活手腕。“补偿性手臂运动”是理解第一项的关键:如果手腕转动范围不够,机械臂就要通过肩、肘的联动让末端旋转,这会改变手的位置,导致手指从旋钮上滑脱;而且这种运动模式在人类示范中不存在,手套数据就帮不上忙。这正是“运动学兼容性”影响迁移的机制:人类示范里的动作越能被机器人原样执行,手套数据的价值就越大。
原文
LEO outperforms Tianji on all three tasks, achieving an average progress score 28.3 points higher. These results illustrate the value of kinematic compatibility: when a robot can reproduce the movement patterns present in human demonstrations, the learned manipulation strategies can transfer more effectively into executable robot actions.
译文
LEO 在三个任务上都优于天机,平均进度分高出 28.3 分。这些结果说明了运动学兼容性的价值:当机器人能够复现人类示范中的运动模式时,学到的操作策略就能更有效地转化为可执行的机器人动作。
解释
验算:90.4-62.1=28.3,与图 12 一致。结论边界:这个实验的变量是“整台机器人”,LEO 与天机在手腕、腰部、前臂、灵巧手、相机布置上可能都不同,因此 28.3 分的差距是这些因素的总和,无法归因到单个设计。而且实验没有提供“不加手套数据时两个平台的差距”这一对照:如果不用手套数据,LEO 本身就比天机更适合这三个任务(例如因为有腰),那么差距的一部分只是硬件能力的差别,而不是“手套数据迁移得更好”。要严格证明“像人的本体让手套数据更有用”,需要比较两个平台上加入手套数据带来的增益,原文没有报告。
6结论与未来方向(Conclusion and Future Directions)
原文
We present Liber-0, a World Action Model pretrained on over 2.2 million hours of human experience. By combining large-scale human video with action grounding from LiberSense Glove, embodiment-conditioned learning, and human-aligned robot hardware, our approach enables human experience to be translated into executable robot skills at scale.
译文
我们提出了 Liber-0,一个在超过 220 万小时人类经验上预训练的世界动作模型。通过把大规模人类视频与来自 LiberSense 手套的动作锚定、以本体为条件的学习以及与人对齐的机器人硬件结合起来,我们的方法使人类经验能够被大规模地转化为可执行的机器人技能。
解释
这句话把全文的四个组成部分并列:数据(人类视频)、监督(手套)、模型(本体条件)、硬件(LEO)。值得注意的是,四者在实验中并没有被逐一消融:手套数据的作用有第 4.1、5.1–5.3 节支持,硬件的作用有第 5.4 节部分支持,而“统一本体表示”这一模型设计本身没有任何对照实验(例如去掉本体条件会怎样)。
原文
Our experiments demonstrate favorable scaling across diverse data sources, with glove recordings showing particularly strong gains when scaled up. Glove data also substantially reduces the need for robot demonstrations, enables the transfer of skills absent from robot training data, and benefits from greater human morphology diversity and closer robot–human kinematic alignment. Liber-0 further demonstrates zero-shot generalization to unseen objects and tasks, including challenging multi-step manipulation. Together, these findings support action grounding and embodiment alignment as complementary principles for scaling robot intelligence from human experience.
译文
我们的实验表明,多种数据源都表现出有利的规模扩展效应,其中手套录像在扩大规模时增益尤为显著。手套数据还能大幅减少对机器人示范的需求,使机器人训练数据中没有的技能得以迁移,并能从更高的人类形态多样性和更紧密的人机运动学对齐中获益。Liber-0 还展示了对未见物体和任务的零样本泛化能力,包括有挑战性的多步操作。这些发现共同支持把动作锚定和本体对齐作为从人类经验中扩展机器人智能的两条互补原则。
解释
这一段是对第 4、5 节的逐条回顾,每一句都能对应到一张图:规模扩展(图 5)、减少机器人示范(图 8)、迁移新技能(图 9)、形态多样性(图 11)、运动学对齐(图 12)、零样本(第 4.2 节)。其中“对未见物体”的零样本泛化只来自在线仿真演示(第 4.2 节末),真机零样本实验针对的是未示范的任务;“包括有挑战性的多步操作”对应的成功率是 10.5%。这些限定在结论中都被略去了。
原文
Toward richer physical supervision. While LiberSense Glove captures precise hand motions, physical interaction also depends on contact and force, which cannot always be inferred from motion alone. Incorporating tactile and force sensing could provide richer supervision for contact-intensive manipulation, including insertion, fastening, and deformable-object handling. The challenge is to capture these signals without compromising the lightweight design that enables scalable human data collection.
译文
走向更丰富的物理监督。LiberSense 手套虽然能捕捉精确的手部运动,但物理交互还取决于接触和力,而这些并不总能仅从运动中推断出来。引入触觉和力传感,可以为插入、紧固和可变形物体处理等接触密集型操作提供更丰富的监督。挑战在于,要在采集这些信号的同时,不损害支撑规模化人类数据采集的轻量化设计。
解释
这是一个诚实的局限说明:动作轨迹只告诉模型“手到了哪里”,不告诉它“用了多大力”。例如拧紧瓶盖,最后那一下的力度从轨迹上几乎看不出来。在手套上加装触觉或力传感器,通常会增加厚度、重量和布线,与 0.3 mm、131 g 的设计目标相冲突,所以作者把它列为“挑战”。
原文
Toward human experience with gloves at greater scale. Unlike robot teleoperation, glove collection does not require a robot at each site, making it possible to scale human manipulation data across increasingly diverse people, tasks, and everyday environments. Building on our existing collection framework, we envision expanding both the scale and diversity of human experience, approaching the breadth of interactions encountered in daily life. Combined with richer physical supervision, this offers a promising path toward more generalizable robot manipulation.
译文
走向更大规模的手套人类经验。与机器人遥操作不同,手套采集不需要在每个现场都配一台机器人,因而有可能在越来越多样的人、任务和日常环境中扩展人类操作数据的规模。在现有采集框架的基础上,我们设想同时扩大人类经验的规模和多样性,逼近日常生活中所遇到的交互的广度。再结合更丰富的物理监督,这为实现更具泛化能力的机器人操作提供了一条有前景的路径。
解释
这一段把第 4.1 节(手套数据规模扩展强劲,到 10 kh 仍未饱和)和第 5.3 节(采集者多样性在 100 人范围内仍有收益)的结论推向未来:继续扩大手套数据的规模和采集者数量。从图 5 看,手套数据只测到 10 kh,而网络视频已有 2,000 kh;如果手套数据能扩展到 100 kh 甚至更多且规模律保持,收益可能很可观。这也是本文隐含的商业逻辑:LiberAI 同时掌握了采集设备和配套的机器人。
7参考文献(References)
解释
参考文献列表不翻译,按原网页的编号保留英文条目,以便与正文中的 [1]–[12] 对应。其中 [2]、[3]、[11] 是公司或实验室的网页技术报告,不是论文。
原文
[1] Khazatsky et al. DROID: A Large-Scale In-the-Wild Robot Manipulation Dataset. RSS, 2024.
[2] Dyna Robotics. Dyna-2: A 1-Million-Hour Scaling Law for World-Action Models. Technical report, 2026.
[3] Light Origins. Light-O1: Scaling Whole-Body Intelligence with Human Action Pretraining. Technical report, 2026.
[4] Zheng et al. EgoScale: Scaling Dexterous Manipulation with Diverse Egocentric Human Data. arXiv:2602.16710, 2026.
[5] Wang et al. DexCap: Scalable and Portable Mocap Data Collection System for Dexterous Manipulation. RSS, 2024.
[6] Kareer et al. EgoMimic: Scaling Imitation Learning via Egocentric Video. arXiv:2410.24221, 2024.
[7] Ye et al. World Action Models are Zero-shot Policies. arXiv:2602.15922, 2026.
[8] Liang et al. Mixture-of-Transformers: A Sparse and Scalable Architecture for Multi-Modal Foundation Models. TMLR, 2025.
[9] Physical Intelligence et al. \pi_{0.5}: a Vision-Language-Action Model with Open-World Generalization. arXiv:2504.16054, 2025.
[10] Xu et al. DexUMI: Using Human Hand as the Universal Manipulation Interface for Dexterous Manipulation. CoRL, 2025.
[11] Yang, Khetan, and Zhang. Astranomy: An Empirical Study of GPT-6 Astra as a Native Robot Policy. NVIDIA technical report, 2026.
[12] Bai et al. Qwen3-VL Technical Report. arXiv:2511.21631, 2025.
[2] Dyna Robotics. Dyna-2: A 1-Million-Hour Scaling Law for World-Action Models. Technical report, 2026.
[3] Light Origins. Light-O1: Scaling Whole-Body Intelligence with Human Action Pretraining. Technical report, 2026.
[4] Zheng et al. EgoScale: Scaling Dexterous Manipulation with Diverse Egocentric Human Data. arXiv:2602.16710, 2026.
[5] Wang et al. DexCap: Scalable and Portable Mocap Data Collection System for Dexterous Manipulation. RSS, 2024.
[6] Kareer et al. EgoMimic: Scaling Imitation Learning via Egocentric Video. arXiv:2410.24221, 2024.
[7] Ye et al. World Action Models are Zero-shot Policies. arXiv:2602.15922, 2026.
[8] Liang et al. Mixture-of-Transformers: A Sparse and Scalable Architecture for Multi-Modal Foundation Models. TMLR, 2025.
[9] Physical Intelligence et al. \pi_{0.5}: a Vision-Language-Action Model with Open-World Generalization. arXiv:2504.16054, 2025.
[10] Xu et al. DexUMI: Using Human Hand as the Universal Manipulation Interface for Dexterous Manipulation. CoRL, 2025.
[11] Yang, Khetan, and Zhang. Astranomy: An Empirical Study of GPT-6 Astra as a Native Robot Policy. NVIDIA technical report, 2026.
[12] Bai et al. Qwen3-VL Technical Report. arXiv:2511.21631, 2025.
8BibTeX
原文
@article{liberai2026liber0,
author = {Liberai Team},
title = {Liber-0: Emergent Zero-Shot Capabilities in Multi-Step Manipulation from 2.2 Million-Hour Human Experience},
year = {2026},
url = {https://www.liberai.com/blog/liber0/}
}
author = {Liberai Team},
title = {Liber-0: Emergent Zero-Shot Capabilities in Multi-Step Manipulation from 2.2 Million-Hour Human Experience},
year = {2026},
url = {https://www.liberai.com/blog/liber0/}
}
解释
原网页给出的引用条目,作者署名为团队,没有个人名单,也没有期刊或 arXiv 编号,类型标为
@article。如需在论文中引用本报告,可直接使用这一条目。 译者附注:原文数字核对与阅读提示汇总
以下各条已在正文对应位置的解释框中说明,这里集中列出。总体而言,原文正文与图中的数字自洽:第 4.1 节的 14.7 / 13.1 分增益、200 倍时长比,第 4.2 节的 600 次与 180 次试验和各档成功率(反算为 127/68/21 次与 5/3/1 次成功,总体 36.0%),第 4.3 节的 2.2 / 1.5 分后训练增益,第 5.1–5.3 节引用的全部数值,图 6 各阶段配比之和(均为 100%),以及第 5.4 节的平均分与 28.3 分差值,按图中数据重算均一致。没有发现数值错误。需要注意的主要是对比口径、未交代的实验设置和网页本身的几处小瑕疵。| 位置 | 说明 |
| 全文 | 两套指标并存:第 4.1、4.3 节和第 5 节是 0–100 的进度分,只有第 4.2 节是成功率。“PnP 83.6”与“PnP 63.5%”不可比。 |
| 全文 | 网页报告没有给出模型规模、训练算力、动作空间、生成方式(扩散 / 流匹配)、统一本体表示的具体形式、各数据源的确切时长,以及多数实验的试验次数或种子数。 |
| 标题 / 引言 | “在 220 万小时人类经验上预训练”是概括说法;图 6 显示各阶段都混有跨本体机器人数据和遥操作数据(阶段 3 中二者合计 37%)。 |
| 图 5 / 第 4.1 节 | 单源预训练时,无实测动作的数据源(OpenEgo、VendorEgo、Web)是否使用估计的手部姿态作为动作标签,原文未说明;这决定了“手套胜过 200 倍网络视频”比较的是“实测对估计”还是“有动作对无动作”。 |
| 第 4.1 节第一条发现 | “每个数据源都优于基线”在 Non-PnP 上,VendorEgo 1 kh(约 35)只比基线 34.1 高约 1 分,处于噪声范围。 |
| 第 4.1 节第五条发现 | 完整配方(83.6 / 73.8)与单源配置的差距同时包含“数据组合”“数据量多约 220 倍”“三阶段训练”三个因素,不能全部归因于组合。 |
| 第 4.2 节 | 未说明零样本评测的检查点是预训练直接评估还是经过其他任务后训练;也未说明是否外接了 GPT-6 Astra 做多步规划(第 2 节称可选)。 |
| 第 4.2 节 | Astra-only 每任务 3 次试验,Liber-0 每任务 10 次;原文没有给 Astra-only 的总体成功率(按反算为 9/180 = 5.0%)。 |
| 第 4.2 节 / 第 6 节 | 结论说零样本泛化到“未见物体和任务”,但“未见物体”只有在线仿真演示,没有定量结果。 |
| 位置 | 说明(续) |
| 图 6 / 第 4.4 节 | 图 6 中单列的“遥操作”(Teleoperation,阶段 3 占 25%)在第 4.4 节的训练数据清单中没有介绍;推测为 LEO 自己的遥操作数据。横轴单位“T”未说明,按惯例应为万亿 token。 |
| 图 6 / 第 4.3 节 | 阶段 1 称“无动作训练目标”,但其配比中已含 10% 手套、10% 遥操作、10% 跨本体机器人数据,这些数据在阶段 1 只用于画面预测。 |
| 图 7 / 第 4.3 节 | 阶段 3 后训练增益小(2.2 / 1.5),可能部分因为阶段 3 中 25% 的遥操作数据与后训练数据重叠,而不完全是预训练的泛化。 |
| 图 7 vs 图 5 | 阶段 1 后训练后的 PnP 58.4 低于 Glove 10 kh 单源的 67.9 和 Web 2,000 kh 单源的 64.6;两类实验设置未必相同,仅供参考。 |
| 图 8 / 第 5.1 节 | “少用 75% 机器人示范却超过纯机器人”时,混合配置的示范总数为 1.25 倍,纯机器人为 1 倍;同等总量下机器人数据始终更好(0.5\times:66.9 对 61.2 对 49.4;1\times:72.8 对 60.3)。按插值,约 2–2.5 条手套示范抵一条机器人示范。 |
| 第 5.1–5.3 节 | 未说明策略训练是否从 Liber-0 预训练检查点出发;若是,“仅手套”并非完全没有机器人数据(预训练含 LEO 遥操作)。 |
| 图 9 / 第 5.2 节 | 正文未提:Teleop PnP 单独训练 PnP 得 58.0,加入任何 Non-PnP 数据后 PnP 下降(53.7、54.3),只有加入手套 PnP 后才升到 69.5。Glove All 与 Glove Non-PnP 的数据量不同,PnP 上 +15.2 分有一部分可能来自 PnP 数据增多。 |
| 图 11 / 第 5.3 节 | 图例同时列出“Robot-only”(实线)和“Baseline”(虚线),但图中只有一条 51.8 的虚线,图注称其为纯机器人参照,图例有遗留项。“纯机器人”参照所用数据量未说明。示范者增多同时带来形态和行为风格的多样性,实验未将二者分开。 |
| 图 12 / 第 5.4 节 | 任务专门挑选了 LEO 设计擅长的动作(转腕、弯腰、狭窄空间);没有报告不加手套数据时两平台的差距,因此 28.3 分无法完全归因于“手套数据迁移更好”。试验次数未报告。 |
| 网页制作 | 正文“如视频 5 所示”的链接锚点指向 #figure-12;图 12 的图片文件名为 figure-13。这些不影响内容。 |
| 发布信息 | 页面无作者名单和日期;BibTeX 署名 “Liberai Team”,视频文件名中的 20261104 提示发布于 2026 年 11 月 4 日前后。 |
sips 转为 PNG(图表)或 JPEG(照片)。15 段视频(总览、9 段零样本演示、视频 1–5)无法嵌入 PDF,均以页面自带的封面帧(poster)代替,封面帧多为视频开头画面,看不到执行过程,因此对视频的解读仅限于场景和图注所述内容。“更多评测结果”站点(https://reel.liberai.work/#/)和在线仿真应用(https://sim.liberai.work/)未抓取。