模仿者游戏:超越动作预测的
机器人模仿能力基准
The Imitator Game: Benchmarking Robot Imitative Ability Beyond Action Prediction
Xunzhe Zhou^{1,2,*,\dagger}, Yiyang Cai^{2,3,*}, Fengyi Wang^{2,3,*}, Ran Ju^{1,2,*}, Hanxiang Ren^{2,4},
Ruizhe Liu^{1}, Yu Zhang^{1}, Qian Luo^{1,2}, Feng Chen^{1}, Pei Zhou^{1,2}, Yi Ma^{1,2}, Yanchao Yang^{1,2,\ddagger}
^1香港大学 ^2TranscEngram ^3复旦大学 ^4浙江大学
^*共同第一作者 ^\dagger项目负责人 ^\ddagger通讯作者
arXiv:2608.22301v1 [cs.RO],2026 年 8 月 23 日提交(32 页,13 幅图,11 张表)
项目主页与 Imitator Arena:https://imitator-game.github.io
中文逐段翻译与解释
整理日期:2026 年 11 月 7 日
机器人模仿能力基准
The Imitator Game: Benchmarking Robot Imitative Ability Beyond Action Prediction
Xunzhe Zhou^{1,2,*,\dagger}, Yiyang Cai^{2,3,*}, Fengyi Wang^{2,3,*}, Ran Ju^{1,2,*}, Hanxiang Ren^{2,4},
Ruizhe Liu^{1}, Yu Zhang^{1}, Qian Luo^{1,2}, Feng Chen^{1}, Pei Zhou^{1,2}, Yi Ma^{1,2}, Yanchao Yang^{1,2,\ddagger}
^1香港大学 ^2TranscEngram ^3复旦大学 ^4浙江大学
^*共同第一作者 ^\dagger项目负责人 ^\ddagger通讯作者
arXiv:2608.22301v1 [cs.RO],2026 年 8 月 23 日提交(32 页,13 幅图,11 张表)
项目主页与 Imitator Arena:https://imitator-game.github.io
中文逐段翻译与解释
整理日期:2026 年 11 月 7 日
解释
阅读方式。沿用本工作区已完成译文的三联框:灰色框保留英文原文,蓝色框给出中文译文,橙色框解释概念、设计动机、数字核对和结论边界。图片使用原论文源码中的矢量图,表格完整重排,均附原注、译注和绿色解读框。保留原章节和图表编号(本文附录不重置图表编号,图 5–13、表 6–11 均在附录中);正文引用沿用原文的“作者,年份”格式,参考文献列表从略。解释框是本译稿的分析,不属于作者原文。
来源与许可。原论文:https://arxiv.org/abs/2608.22301v1;PDF:https://arxiv.org/pdf/2608.22301v1。本文以 arXiv 默认的非独占分发许可(arXiv.org perpetual, non-exclusive license)发布,不是知识共享许可;本译稿仅供个人学习研究,不宜公开再分发。英文内容以下载的 v1 源码及 PDF 为依据。
来源与许可。原论文:https://arxiv.org/abs/2608.22301v1;PDF:https://arxiv.org/pdf/2608.22301v1。本文以 arXiv 默认的非独占分发许可(arXiv.org perpetual, non-exclusive license)发布,不是知识共享许可;本译稿仅供个人学习研究,不宜公开再分发。英文内容以下载的 v1 源码及 PDF 为依据。
目录
导读摘要(Abstract)1 引言(Introduction)2 相关工作(Related Works)3 模仿者游戏(The Imitator Game)3.1 模仿者能力3.1.1 问题设定与场景分解3.1.2 四个模仿层级3.2 模仿者基准3.2.1 IG-10K:迄今最大的环境对齐人—机器人配对操作数据集3.2.2 模仿者竞技场与评测指标3.2.3 基线适配器4 实验(Experiments)4.1 实验设置4.2 Q1:哪种模仿接口最强?4.3 Q2:规模能否改善零样本迁移或少样本适应?4.4 Q3:层级在哪一级变难?5 结论(Conclusion)参考文献A 模仿者能力:补充细节(The Imitator Capability: Supporting Detail)A.1 场景分解细节A.2 四个层级:逐级细节与心理学依据B 模仿者基准:补充细节(The Imitator Benchmark: Supporting Detail)B.1 IG-10K 的采集与标注细节B.2 语料构造、数据划分以及仿真与真机的关系B.3 Imitator Arena:评分流程与指标定义B.4 基线适配细节C 附加实验结果(Additional Experimental Results)C.1 Q1:哪种模仿接口最强?C.2 Q1:冻结的视频编码器重要吗?C.3 Q2:预训练规模、零样本迁移与少样本适应C.4 Q2:规模收益是否只局限于特定层级?C.5 Q3:层级在哪里开始变难C.6 Q3:示范真的被用上了吗?C.7 两个评测通道、两个域之间在多大程度上一致?C.8 逐任务诊断D 掩码生成细节(Mask Generation Details)E MANO 手部姿态标注(MANO Hand Pose Annotation)F 基线实现细节(Baseline Implementation Details)F.1 UniSkillF.2 XSkillF.3 OpenVLAF.4 \pi_{0.5} 实现细节F.5 RDT-1B 实现细节F.6 GR00T 实现细节F.7 Video-VA(ACT、Diffusion Policy、VQ-BeT)实现细节G 失败模式与任务级诊断(Failure Modes and Task-Level Diagnostics)H 逐任务参考结果(Per-Task Reference Results)译者附注:原文数字核对与阅读提示汇总导读
本文要回答的问题。从人类视频学操作,现有方法多数停留在“轨迹层面”:抽取手部关键点或光流,重定向到机器人,再在几乎一样的场景里回放。人看别人泡茶,学到的却是“要泡一杯茶”这个意图,换了杯子、换了茶叶甚至没有茶包也能变通完成。本文不提出新策略,而是提出一个评测框架,度量机器人策略“看一段人类示范视频,再在自己的、与示范不同的场景里复现其意图”的能力,并找出现有方法在哪一级开始失效。三件产出。(1) The Imitator Game / Imitator Benchmark:把示范场景和执行场景的差异分为四级。L0 场景完全相同,复现轨迹即可;L1 物体相同但摆放不同,要达到相同的物体终态;L2 物体换成同类但外观或几何不同(茶包换成散茶),要完成同一语义任务;L3 物体换成功能不同的东西(没有茶,用抹茶粉冲调),要通过不同的可供性(affordance)实现同一意图。(2) IG-10K:环境对齐的人—机配对数据集,53 个基础任务、6 个领域、每个任务四个层级,真机 11.7K 对加仿真 10K 对,带深度、多视角、MANO 手姿、分割掩码和多层语言标注。(3) Imitator Arena:统一的评测平台,仿真中用手工谓词自动打分(SR、Sub-SR),仿真和真机中都可以做盲测 A/B 人评(人评成功率、0–10 分模仿质量 \overline Q、胜率 WR)。评测方式的关键约定。策略的输入只有示范视频 V 和自身观测 o_t,不告诉它当前是第几级,也没有目标谓词。语言条件的 VLA 看不了视频,平台用一个固定的描述器 T(V) 把视频转成详细文字。所有方法都冻结视觉或视觉语言骨干,只训练动作生成部分;因此比较的是“动作生成接口如何利用同一份示范”,不是“谁的表征微调得更好”。评测分三种设定:已见任务(Seen)、零样本迁移到未见任务(ZS)、未见任务各 10 条示范的少样本学习,又分为从头训练(Scr.)和 IG-10K 预训练后微调(P+FT)。| 概念 | 本文中的具体含义 |
| 示范场景 / 模仿者场景 | \mathcal S_{\text{demo}} 是人类录示范视频的场景,\mathcal S_{\text{imit}} 是机器人执行时所处的场景。 |
| 场景分解 | \mathcal S=(\{O_i=(A_i,G_i,S_i)\},P):每个物体的外观 A、几何 G、语义类别 S,加上整体空间布局 P。 |
| L0–L3 | 依次放松保持条件:全部保持 / 只改 P / 改 A 或 G 但保持 S / 连 S 也改。成功标准依次变为轨迹相似、物体终态相同、任务语义相同、意图相同。 |
| 功能替代 | L3 的核心:用语义和用法都不同的物体实现同一目的,例如“接一杯水”从茶壶换成水龙头。 |
| 配对回合 | IG-10K 的基本单位:一段人类示范视频,加上一个或多个机器人回合,二者的场景关系对应某一层级。 |
| T(V) | 平台侧固定的视频描述器,把示范视频转成详细文字,供只能读语言的 VLA 使用,人工校验过。 |
| SR / Sub-SR | 仿真自动指标:所有目标谓词都满足的回合比例;有序子目标阶段的平均完成比例。 |
| \mathrm{SR}_{\text{human}} / \overline Q / WR | Arena 人评指标:判为“成功”的比例;0–10 分五锚点模仿质量均分;盲测两两比较中的胜率。 |
| Seen / ZS / Scr. / P+FT | 已见任务;零样本迁移到未见任务;未见任务 10 条示范从头训练;IG-10K 预训练后用同样 10 条示范微调。 |
| \mathcal C_{15}\subset\mathcal C_{30}\subset\mathcal C_{45} | 嵌套的预训练语料,分别含 15、30、45 个任务,每任务 50 条配对示范。 |
| VLA / Skill / Video-VA | 三类基线:语言条件的大模型(GR00T-N1.6、RDT-1B、\pi_{0.5}、OpenVLA);人—机共享技能表征(XSkill、UniSkill);拼接冻结视频编码器特征的视觉运动策略(ACT、DP、VQ-BeT \times DINOv2 / SigLIP2 / VideoMAE)。 |
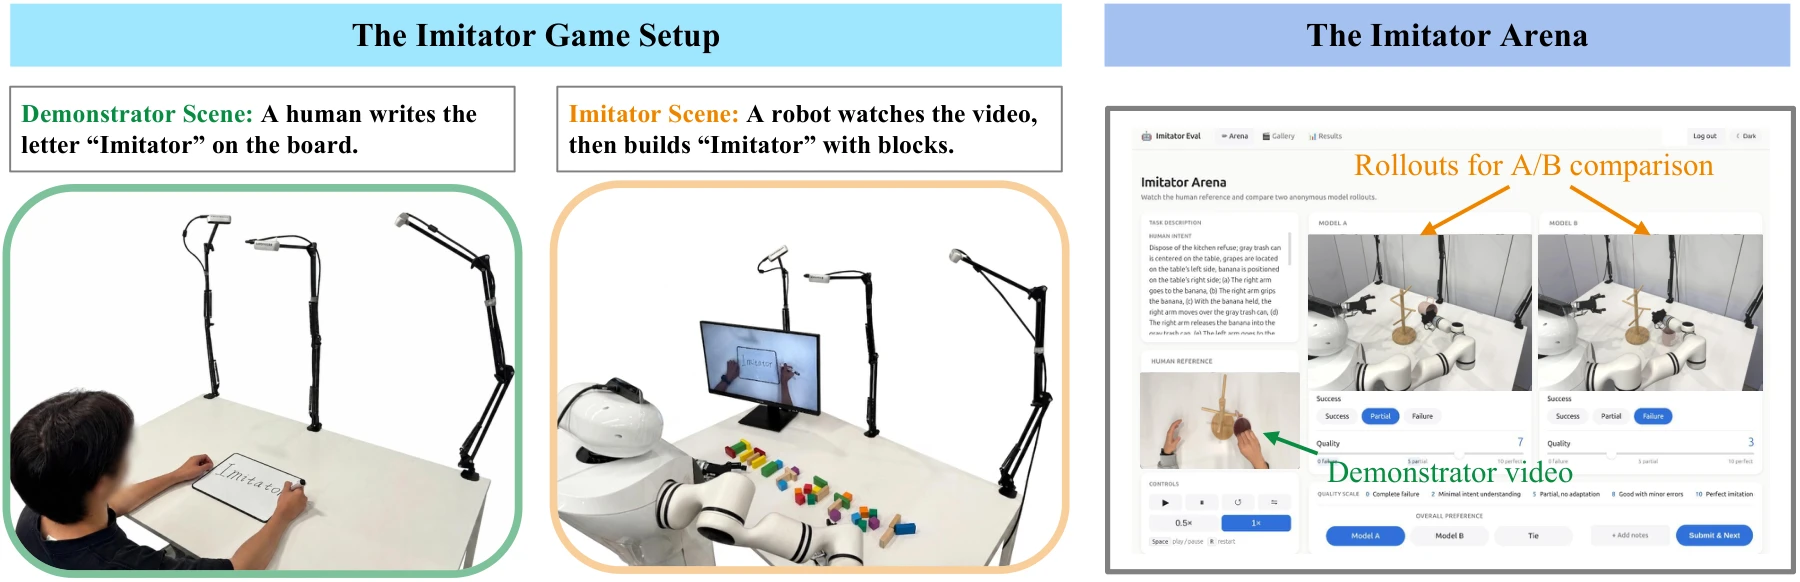
图 1:模仿者游戏(The Imitator Game)。(左)模仿者游戏的设置:人在示范者场景(Demonstrator Scene,绿色)中演示一个操作任务,机器人观看这段视频,然后在模仿者场景(Imitator Scene,橙色)中利用手头现有的任何物体,复现演示背后的意图。(右)评测平台 Imitator Arena:人类评估者把两个匿名模型的执行过程分别与示范视频对照,进行结构化的盲评 A/B 比较,判断哪一个模仿得更好。
原图注:The Imitator Game. (Left) The Imitator Game setup: a human demonstrates a manipulation task in the Demonstrator Scene (green), and a robot watches the video and reproduces the underlying intent in the Imitator Scene (orange) using whatever objects are available. (Right) The Imitator Arena evaluation platform: human evaluators can make structured blind A/B comparisons of how two anonymized model rollouts imitate against the demonstrator video.
图 1 解读
左半部分用一个具体例子说明整个基准的设定。绿色框是示范者场景:一个孩子在白板上写下单词“Imitator”。橙色框是模仿者场景:双臂机器人面前的显示器上播放这段示范视频,但桌上没有白板和笔,只有一堆彩色积木,机器人要用积木拼出“Imitator”。示范的动作(握笔书写)在新场景里根本无法照搬,能保留下来的只有“呈现出这个单词”这一目标。这个例子对应后文最难的 L3 层级(功能替换):物体的语义和用法都变了,机器人必须先理解意图,再换一种方式实现。右半部分是 Imitator Arena 的网页界面截图。左下角是示范视频(Demonstrator video),上方并排放着两个模型在同一任务、同一层级、同一回合下的执行录像(Rollouts for A/B comparison),模型名称对评估者隐藏。评估者对照示范视频,判断哪一边更好地复现了示范意图,并按评分细则打分。之所以需要人评,是因为“意图是否被复现”很难用自动规则判定,在真机上尤其如此(后文表 4 的真机成功率就是由人判定的)。这张图概括了论文的三个产物:任务设定(Imitator Game 及其 L0–L3 层级)、配对数据集(IG-10K,左侧这类人—机器人配对场景)和评测平台(Imitator Arena)。
摘要(Abstract)
原文
Humans imitate at the level of intent: given a demonstration, we infer its goal and carry it out with whatever tools, objects, and layouts are at hand. Current robot policies instead learn observation-to-action mappings from visual inputs and language instructions, without explicitly inferring the demonstrated task. Learning from human video thus remains largely trajectory-level: models can replay motions in near-identical scenes, but still struggle to imitate what the demonstrator intends rather than merely what they do. We introduce The Imitator Game, a four-level benchmark (L0–L3) that progressively widens the gap between the human demonstration and the robot's own scene, isolating where trajectory replay ceases to suffice and task understanding becomes necessary.
译文
人类在意图层面进行模仿:看到一次示范,我们会推断它的目标,再用手边现有的工具、物体和布局去完成它。当前的机器人策略则不同,它们从视觉输入和语言指令中学习“观测到动作”的映射,并不显式推断示范的是什么任务。因此,从人类视频中学习在很大程度上仍停留在轨迹层面:模型能在几乎相同的场景中重放动作,却仍难以模仿示范者想做什么,而只会模仿他们做了什么。我们提出模仿者游戏(The Imitator Game),这是一个四层级(L0–L3)的基准,它逐步拉大人类示范与机器人自身场景之间的差距,从而定位轨迹重放在哪一层开始失效、对任务的理解在哪一层变得必不可少。
解释
这段提出全文要区分的两种模仿。轨迹层模仿复制“做了什么”,即手的运动路径;意图层模仿复制“想做什么”,即动作要达成的目标。两者在示范场景和执行场景相同时没有区别,照着轨迹做自然就达成了目标;只有当场景变化、原轨迹失效时,差别才会显现。所以基准的设计思路是逐级拉大场景差距:差距小时轨迹重放够用,差距大到一定程度就只能依靠理解。哪一级开始“只靠重放不行了”,就是这个基准想测量的分界点。标题中的“Imitator Game”化用了图灵的“模仿游戏”(The Imitation Game),这里改为考察机器人能否像人一样模仿。
原文
We pair it with IG-10K, the largest environment-aligned paired human–robot dataset to date and the only one instantiated across all four levels in both real and simulated settings (20,000+ paired episodes, 50+ tasks, 6 domains), and Imitator Arena, an open platform for blind A/B human evaluation.
译文
与基准配套,我们构建了 IG-10K,它是迄今规模最大的环境对齐(environment-aligned)人—机器人配对数据集,也是唯一一个在真实和仿真两种设定下都覆盖全部四个层级的数据集(20,000 多个配对回合、50 多个任务、6 个领域);我们还构建了 Imitator Arena,一个用于盲评 A/B 人工评测的开放平台。
解释
环境对齐指每段人类示范视频都配有一个机器人回合,而这个机器人回合所在的场景与示范场景之间的关系是人为控制的(相同、重新摆放、换同类物体或换不同功能的物体),因此可以按层级系统地比较。一般的大规模机器人数据集只有机器人数据,或者人类视频与机器人数据来自互不相关的场景。规模数字需要分清口径。数据集名为“10K”,但这里写的是“20,000 多个配对回合”。按第 3.2.1 节,20K+ 由两部分组成:真机 11.7K 个配对回合(每个含一段人类视频和一段真机视频)加仿真 10K 个配对回合。名称里的“10K”与总数并不一致,可能取自仿真部分的 10K,论文没有解释这一命名。任务数也有两种口径:摘要说“50 多个任务”,指 6 个领域下的基础任务(第 3.2.1 节给出分领域数目 12+7+17+4+6+7=53);引言说“200 多个任务变体”,是 53 个基础任务各配 L0–L3 四个层级得到的 53\times4=212 个。另外,后文表 2 中 IG-10K 一行只列了 11.7k(真机部分),读者对比数据集规模时也应留意。
原文
Across nine state-of-the-art models, performance is stable from L0 to L2 but collapses at L3, identifying functional substitution – achieving the same intent through a different object affordance – as the decisive barrier to intent-level imitation. Human-video-conditioned models outperform caption-conditioned ones, yet every model falls below 13\% zero-shot success on unseen tasks; fine-tuning IG-10K-pretrained models with only 10 paired human-robot demonstrations yields large gains that grow with pretraining scale.
译文
在九个最先进的模型上,性能从 L0 到 L2 保持稳定,到 L3 则急剧下降。这表明功能替换(functional substitution),即通过不同的物体可供性(affordance)实现同一意图,是意图层模仿的决定性障碍。以人类视频为条件的模型优于以文字描述(caption)为条件的模型,但所有模型在未见任务上的零样本成功率都低于 13\%;用仅仅 10 条人—机器人配对示范对经 IG-10K 预训练的模型做微调,能带来大幅提升,并且提升幅度随预训练规模增大而增大。
解释
这段概括三条主要结论,分别对应第 4 节的 Q3、Q1、Q2。“九个模型”包括 4 个语言条件的 VLA(GR00T-N1.6、RDT-1B、\pi_{0.5}、OpenVLA)、2 个跨本体技能方法(XSkill、UniSkill)和 3 个视频条件的视觉—动作(VA)模型(ACT、Diffusion Policy、VQ-BeT)。后 3 个各搭配 DINOv2、SigLIP2、VideoMAE 三种冻结编码器,得到 9 个变体,所以引言中说的变体总数是 4+2+3\times3=15。可供性指物体能被如何使用,例如茶壶可以“倾倒”,水龙头可以“拧开出水”。L3 要求机器人意识到两者都能实现“往杯里加水”。“L3 处急剧下降”的程度。按表 5(真机、预训练+微调、四个代表模型),平均成功率在 L0/L1/L2/L3 上依次为 0.42、0.42、0.39、0.29(逐列验算:(0.44+0.53+0.37+0.33)/4\approx0.42,(0.28+0.29+0.33+0.25)/4\approx0.29),从约 0.41 降到 0.29,相对下降约 30%。用“collapse”(崩溃)来形容偏强。下降主要来自 XSkill(L2 为 0.56,L3 为 0.29);ACT/DINOv2 在 L2 和 L3 都是 0.33,并没有下降。“低于 13%”的口径。这句话只在仿真中近似成立:表 3 里零样本最好的是 VQ-BeT/DINOv2,SR 恰好为 0.13,是“等于”而不是“低于”13%。在真机人评的表 4 中,零样本成功率 XSkill 为 0.29、ACT/DINOv2 为 0.26,都明显高于 13%。所以“每个模型都低于 13%”不能推广到真机结果,引用时应限定为“仿真零样本”。最后一句说的是“少样本适应”:从零开始用 10 条示范训练(Scr.),与先在 IG-10K 上预训练再用同样 10 条示范微调(P+FT)相比,后者明显更好,且预训练任务数从 15 增加到 30、45 时,优势随之扩大。这说明配对预训练的价值主要体现在加快适应,而不是直接带来零样本能力。
1引言(Introduction)
原文
When people watch someone stir soup, they do not memorize a sequence of motions. They infer a goal-directed behavior: the soup needs to be stirred, with whatever is available. If the pot is moved, the spoon replaced with chopsticks, or the bowl exchanged for a wok, people adapt immediately while preserving the underlying intent. This form of goal-directed imitation (Tomasello, 2009) – reproducing the purpose of an action rather than its exact motion – is a hallmark of human and great-ape cognition.
译文
人们看别人搅汤时,并不会记住一串动作,而是推断出一种目标导向的行为:汤需要被搅动,手边有什么就用什么来搅。如果锅被挪了位置、勺子换成了筷子、碗换成了炒锅,人会立刻调整做法,同时保留背后的意图。这种目标导向模仿(goal-directed imitation)(Tomasello, 2009),即复现动作的目的而非其精确的运动,是人类和大型类人猿认知的标志性特征。
解释
开篇用“搅汤”这个日常例子,事先对应了后文的几个层级:锅被挪动对应 L1(空间布局变化),换成另一种锅(碗换成炒锅)大致对应 L2(同一类物体的外观或几何变化),勺子换成筷子则是用另一种工具完成同一动作。Tomasello 是研究人类文化学习的发展心理学家。他的观点是,人类(以及一定程度上的类人猿)模仿时复制的是“目的”,因此能在新条件下灵活变通。全文的出发点是把这种认知科学中的能力分级,变成机器人可测的指标。
原文
Robots do not yet share this ability. Most approaches for learning from human video rely on trajectory remapping: extracting hand keypoints or optical flow from a demonstration (Qin et al., 2022; Xu et al., 2023), retargeting the motion to robot actions, and replaying it in a closely matched scene (Sivakumar et al., 2022; Lepert et al., 2025). These methods are useful for bootstrapping robot behaviour, but they depend heavily on the demonstration and execution scenes remaining similar. Small changes in object placement, geometry, or available tools can already invalidate the demonstrated motion, even when the underlying task itself is unchanged.
译文
机器人目前还不具备这种能力。大多数从人类视频中学习的方法依赖轨迹重映射(trajectory remapping):从示范中提取手部关键点或光流(Qin et al., 2022; Xu et al., 2023),把这些运动重定向(retarget)为机器人动作,再在高度相似的场景中重放(Sivakumar et al., 2022; Lepert et al., 2025)。这些方法对于让机器人快速获得初始行为很有用,但它们严重依赖示范场景与执行场景保持相似。即使底层任务本身没有变,物体位置、几何形状或可用工具的微小变化,也足以让示范的运动失效。
解释
这段描述现有方法的基本流程:先从视频里“抠出”人手的运动(关键点或光流),再把人手运动映射到机器人的关节或末端执行器上(即重定向),最后在相同场景里照做。这条流程默认“同样的运动会带来同样的结果”,而这个前提只在场景几乎不变时成立。比如杯子往左挪了 10 厘米,原轨迹就会抓空。被引的工作中,DexMV(Qin et al., 2022)从人手视频中提取手部姿态用于灵巧手,Robotic Telekinesis(Sivakumar et al., 2022)把人手实时重定向到机器人手上,Phantom(Lepert et al., 2025)则把视频中的人手替换渲染成机器人夹爪。XSkill(Xu et al., 2023)其实是学习人—机器人共享技能表示的方法,这里把它和提取光流的方法归在一起引用,略显宽泛。
原文
The question we ask differs from that of prior work. Existing generalization benchmarks (Pumacay et al., 2024; Sedlacek et al., 2026) mainly evaluate robustness to perturbations of scenes encountered during training, while video-conditioned policies (Jain et al., 2024; Kim et al., 2025; Tang et al., 2025) are typically tested in-distribution, with only limited mismatch between the demonstration and execution environments. In contrast, we evaluate imitative ability: whether a policy can watch a human demonstration video and reproduce its intent in a previously unseen scene, even when the available objects differ substantially in placement, geometry, or function from those originally shown in the demonstration. The central challenge is not trajectory reproduction itself, but determining what aspects of the demonstrated behavior should still be preserved under a changed scene. This ability is ultimately what determines whether the large amount of human video already available online can serve as a practical supervision source for robot manipulation.
译文
我们提出的问题与以往工作不同。现有的泛化基准(Pumacay et al., 2024; Sedlacek et al., 2026)主要评估策略对训练时见过的场景施加扰动后的鲁棒性;而视频条件策略(Jain et al., 2024; Kim et al., 2025; Tang et al., 2025)通常在分布内测试,示范环境与执行环境之间只有有限的不匹配。与之不同,我们评估的是模仿能力(imitative ability):策略能否观看一段人类示范视频,并在一个此前未见过的场景中复现其意图,即使场景中可用物体的位置、几何形状或功能与示范中原本出现的物体有很大差异。核心难点不在于复现轨迹本身,而在于判断场景改变后,示范行为的哪些方面仍应保留。这种能力最终决定了网上已有的海量人类视频能否成为机器人操作的实用监督来源。
解释
这段把本文的问题与两类已有工作区分开。第一类是泛化基准,如 COLOSSEUM(Pumacay et al., 2024)对训练场景改颜色、纹理、光照、相机位置等,REALM(Sedlacek et al., 2026)也属于扰动式评测。它们问的是“场景变一点,策略还能不能完成同一个已知任务”,任务本身由语言或训练分布给定,不需要从视频里推断。第二类是视频条件策略,如 Vid2Robot(Jain et al., 2024)、UniSkill(Kim et al., 2025)以及基于运动线索的方法(Tang et al., 2025)。它们确实以视频为任务说明,但测试时示范场景和执行场景差别不大。本文的设定把两者结合起来,并把“示范与执行之间的差异”作为被控制的自变量。“判断哪些方面仍应保留”是关键:在 L1 中应保留“哪个物体最终到哪里”,而放弃具体轨迹;在 L3 中连具体物体也要放弃,只保留目的。最后一句点出动机:互联网上的人类视频拍摄环境与机器人所处环境几乎从不一致,只有具备意图层模仿能力,这些视频才能直接成为机器人的训练信号。
原文
Drawing on work in cultural learning (Tomasello, 2009) and goal-directed imitation (Meltzoff, 1995), we formulate this ability as four levels of increasing mismatch between the demonstration and the robot's own scene:
- L0 Scene-identical execution. The imitator scene matches the demonstration scene; the policy is expected to reproduce the demonstrated trajectory.
- L1 Spatial adaptation. Object identities are preserved but their spatial configuration differs; the policy must achieve the same object-level outcome through a different trajectory.
- L2 Visual-physical generalization. Task-relevant objects differ in appearance or geometry while preserving semantic role; the policy must generalize across visually or physically different instances of the same object category.
- L3 Intent-level transfer. The demonstrated object is replaced by one of different semantics or function (e.g., teapot \to water tap for “fill the cup”); the policy must infer the underlying intent and realize it through a different affordance structure.
译文
借鉴文化学习(Tomasello, 2009)和目标导向模仿(Meltzoff, 1995)方面的研究,我们把这种能力表述为四个层级,示范与机器人自身场景之间的不匹配程度逐级增大:
- L0 场景一致的执行(Scene-identical execution)。 模仿者场景与示范场景相同;期望策略复现示范的轨迹。
- L1 空间适应(Spatial adaptation)。 物体本身不变,但其空间布局不同;策略必须通过不同的轨迹达成相同的物体层面结果。
- L2 视觉—物理泛化(Visual-physical generalization)。 与任务相关的物体在外观或几何形状上不同,但语义角色保持不变;策略必须在同一物体类别中视觉或物理上不同的实例之间泛化。
- L3 意图层迁移(Intent-level transfer)。 示范中的物体被替换为语义或功能不同的物体(例如,对于“把杯子倒满”,茶壶 \to 水龙头);策略必须推断出背后的意图,并通过一种不同的可供性结构来实现它。
解释
四个层级的设计思路是每升一级就多放弃一样“可以照抄的东西”。L0 中轨迹、物体、布局都可以照抄,相当于重放。L1 中物体还是那些物体,但位置变了,轨迹不能照抄,要保留的是“某物最终到某处”这类物体层面的结果。L2 中物体换成同类的另一个实例(如另一只形状、颜色不同的杯子),连外观特征也不能照抄,策略需要按类别识别物体,并调整抓取方式以适应新的几何形状。L3 中物体换成不同类别、用法也不同的东西,“怎么操作”也不能照抄,只剩“为什么操作”可以保留。举例中的“茶壶换成水龙头”很能说明 L3 的难度:茶壶要“提起、倾斜、对准杯口”,水龙头要“把杯子放到出水口下、拧开开关”,两者几乎没有共同的动作成分,相同的只有“杯子里有了水”这个结果。Meltzoff(1995)的经典实验发现,18 个月大的婴儿看到成人尝试做某事但失败后,会去完成成人想做的事,而不是复制失败的动作,这是“意图层模仿”的发展心理学证据。各层级用的颜色(绿、蓝、黄、红)在后文的图表中保持一致。
原文
Contributions. We introduce the Imitator Benchmark, a four-level evaluation framework for robot video imitation that measures imitative capability under progressively increasing mismatch between demonstration and execution scenes. To support this benchmark, we construct IG-10K, the largest environment-aligned human–robot paired manipulation dataset to date, containing 20,000+ paired episodes, 200+ task variants, and 6 domains across both simulation and the real world. We further introduce Imitator Arena, an open platform for structured blind human evaluation of robot imitation behavior, and perform a systematic evaluation of 9 state-of-the-art models (15 trained variants spanning language-conditioned VLAs, cross-embodiment skill methods, and video-conditioned visuomotor policies) across multiple training scales and regimes.
译文
贡献。 我们提出模仿者基准(the Imitator Benchmark),这是一个面向机器人视频模仿的四层级评测框架,在示范场景与执行场景的不匹配程度逐步增大的条件下衡量模仿能力。为支撑该基准,我们构建了 IG-10K,它是迄今规模最大的环境对齐人—机器人配对操作数据集,包含 20,000 多个配对回合、200 多个任务变体和 6 个领域,覆盖仿真和真实世界。我们还提出 Imitator Arena,一个对机器人模仿行为进行结构化盲评人工评测的开放平台,并对 9 个最先进的模型(共 15 个训练变体,涵盖语言条件 VLA、跨本体技能方法和视频条件视觉运动策略)在多种训练规模和训练方式下进行了系统评测。
解释
贡献分为三项产物加一项评测。命名不统一:摘要称基准为“The Imitator Game”,这里称“the Imitator Benchmark”,结论又写作“The Imitator Game Benchmark”,三者指同一个东西。数字口径:“20,000 多个配对回合”是真机 11.7K 与仿真 10K 之和;“200 多个任务变体”是 50 多个基础任务各乘 4 个层级(53\times4=212),与摘要中的“50 多个任务”并不矛盾,只是计数单位不同。“6 个领域”是家居、超市、餐厅、物流、医院、实验室。9 个模型与 15 个变体:4 个 VLA(GR00T-N1.6、RDT-1B、\pi_{0.5}、OpenVLA)通过固定的视频描述器把示范视频转成文字提示;2 个技能方法(XSkill、UniSkill)学习人—机器人共享的技能表示;3 个视觉—动作方法(ACT、Diffusion Policy、VQ-BeT)各搭配 DINOv2、SigLIP2、VideoMAE 三种冻结视频编码器。合计 4+2+3\times3=15 个变体。“多种训练规模和训练方式”指预训练语料取 15、30、45 个任务三档,以及零样本、从零少样本训练、预训练加微调三种迁移设定(见第 4 节)。
2相关工作(Related Works)
原文
Learning manipulation from human video. Prior work learns from human videos by retargeting extracted hand or object poses (Qin et al., 2022; Sivakumar et al., 2022), following optical-flow or object-centric motion cues (Tang et al., 2025; Dan et al., 2025), inpainting human hands as robot grippers (Lepert et al., 2025), or filtering cross-embodiment actions (Dan et al., 2025). Skill-representation methods such as XSkill (Xu et al., 2023), UniSkill (Kim et al., 2025), RHyME (Kedia et al., 2025), and ImMimic (Liu et al., 2025) learn human-robot correspondences, and Vid2Robot (Jain et al., 2024) conditions control on a video prompt. However, these methods assume the robot scene is largely congruent with the demonstration and are evaluated in-distribution, without graded mismatch between the two.
译文
从人类视频中学习操作。 已有工作从人类视频中学习的方式包括:对提取出的手部或物体位姿做重定向(Qin et al., 2022; Sivakumar et al., 2022),跟随光流或以物体为中心的运动线索(Tang et al., 2025; Dan et al., 2025),把视频中的人手修补(inpainting)成机器人夹爪(Lepert et al., 2025),或对跨本体的动作进行筛选(Dan et al., 2025)。XSkill(Xu et al., 2023)、UniSkill(Kim et al., 2025)、RHyME(Kedia et al., 2025)和 ImMimic(Liu et al., 2025)等技能表示方法学习人与机器人之间的对应关系,Vid2Robot(Jain et al., 2024)则以一段视频提示作为控制的条件。然而,这些方法都假设机器人场景与示范大体一致,并且只在分布内评估,没有对两者之间的不匹配程度进行分级。
解释
这段把“从人类视频学操作”的工作分成两条路线。第一条是运动迁移,直接从视频里取出可执行的运动信号。DexMV(Qin et al., 2022)从人手视频估计三维手部和物体位姿,重定向到灵巧手上作为示范;Robotic Telekinesis(Sivakumar et al., 2022)用单目相机实时估计人手姿态并重定向到机械手;光流或物体中心的方法(Tang et al., 2025 等)不关心人手本身,而是追踪物体的运动轨迹,让机器人复现同样的物体运动;Phantom(Lepert et al., 2025)在视频里把人手抹掉,渲染成机器人夹爪,使人类视频在外观上像机器人数据;Dan et al.(2025)则对从人类视频中得到的动作做筛选,只保留机器人可行的部分。这一条路线天然绑定原场景的几何关系,场景一变,运动就不再适用。第二条是技能表示,不直接复制运动,而是学习一个人和机器人共享的“技能空间”。XSkill 用自监督学习把人和机器人视频片段映射到同一组技能原型上,执行时从人类视频中识别出技能序列,再交给机器人的技能条件策略去执行;UniSkill 从大规模跨本体视频中学习与本体无关的技能表示;RHyME 处理人和机器人执行风格不一致(例如速度、分段不同)时的对齐;ImMimic 研究如何用少量机器人数据结合人类视频进行跨域模仿。Vid2Robot 是端到端的视频条件策略,把一段示范视频编码后与机器人当前观测一起输入,直接输出动作。这条路线离“理解意图”更近,但正如本段最后一句所说,它们的评测场景与示范基本一致,没人系统地检验过“示范和执行场景差多远时会失效”。本文的 L0–L3 正好补上这一维度。后文实验中 XSkill 和 UniSkill 就是作为“技能方法”一族被评测的。
原文
Benchmarks and datasets for manipulation. Existing benchmarks study robustness, long-horizon reasoning, and generalization in robot manipulation. Benchmarks such as COLOSSEUM (Pumacay et al., 2024), RoboTwin 2.0 (Chen et al., 2025), and REALM (Sedlacek et al., 2026) perturb visual, physical, embodiment, or environment factors, while CALVIN (Mees et al., 2022), LIBERO (Liu et al., 2023), and VLABench (Zhang et al., 2025) focus on compositional language-conditioned tasks. Large-scale datasets including Open X-Embodiment (O'Neill et al., 2024), DROID (Khazatsky et al., 2024), BridgeData V2 (Walke et al., 2023), and FMB (Luo et al., 2025) instead emphasise diversity across tasks, scenes, and embodiments. In contrast, IG-10K pairs human demonstrations with progressively mismatched robot scenes, allowing direct evaluation of transfer from human video and intent-level imitation.
译文
操作任务的基准与数据集。 现有基准研究机器人操作中的鲁棒性、长时程推理和泛化。COLOSSEUM(Pumacay et al., 2024)、RoboTwin 2.0(Chen et al., 2025)和 REALM(Sedlacek et al., 2026)等基准对视觉、物理、本体或环境因素施加扰动,而 CALVIN(Mees et al., 2022)、LIBERO(Liu et al., 2023)和 VLABench(Zhang et al., 2025)侧重于组合式的语言条件任务。Open X-Embodiment(O'Neill et al., 2024)、DROID(Khazatsky et al., 2024)、BridgeData V2(Walke et al., 2023)和 FMB(Luo et al., 2025)等大规模数据集则强调任务、场景和本体的多样性。与之不同,IG-10K 把人类示范与不匹配程度逐级增大的机器人场景配对,从而能够直接评估从人类视频出发的迁移和意图层模仿。
解释
这段把已有资源分为三类,以突出 IG-10K 的定位。扰动式基准:COLOSSEUM 在 RLBench 任务上系统改变物体颜色、纹理、尺寸、光照、背景、相机位姿等 14 种因素;RoboTwin 2.0 是双臂仿真平台,通过大量域随机化生成数据;REALM 在真实感仿真中评估 VLA 对各类扰动的泛化。语言组合式基准:CALVIN 测试按语言指令连续完成多个子任务的长时程能力;LIBERO 按空间、物体、目标和长时程分成几个任务套件,研究终身学习中的知识迁移;VLABench 面向需要常识和推理的语言条件任务。这两类基准里,任务都是由语言直接告诉机器人的,机器人不需要从别人的演示中推断任务。大规模数据集:Open X-Embodiment 汇集了 20 多种机器人的数据,DROID 是在大量真实场景中采集的 Franka 遥操作数据,BridgeData V2 是 WidowX 低成本机械臂上的多任务数据,FMB(Functional Manipulation Benchmark)关注装配类的功能性操作。它们追求的是“多”,但基本只有机器人数据,没有与之场景对齐的人类示范。IG-10K 的区别在于它是成对且分级的:每段人类示范都配有机器人回合,而且机器人场景与示范场景的差距按 L0–L3 受控变化。这使研究者能把“模型在哪一级失败”归因到具体的差距类型上。后文表 2 并不与上面这些纯机器人数据集比较,而是与 MIME、BC-Z、RH20T 等含人类视频的数据集在环境对齐、仿真环境、多视角、手部位姿、语言标注等维度上逐项对比。其中 RH20T 有 110k 段片段,数量远多于 IG-10K 的真机 11.7k,但它不是环境对齐的;环境对齐的 MIME 只有 8.3k。所以“迄今最大”成立的前提是限定在“环境对齐”这一类数据集内。
原文
Robot manipulation models. Robot manipulation policies range from specialised visuomotor methods – such as ACT (Zhao et al., 2023), Diffusion Policy (Chi et al., 2025), and VQ-BeT (Lee et al., 2024) – to large-scale VLA and diffusion-based foundation models including OpenVLA (Kim et al., 2024; Kim et al., 2025), \pi_{0.5} (Black et al., 2024; Intelligence et al., 2025), the GR00T series (Bjorck et al., 2025), RDT-1B (Liu et al., 2025), and H-RDT (Bi et al., 2026). These systems have advanced language conditioning, action generation, cross-robot pretraining, and few-shot adaptation, but are typically evaluated on executing a specified task within the robot's own scene. In this work, we instead study whether a policy can infer and reproduce the demonstrated behaviour from a human video under mismatched execution conditions, where the robot scene may differ substantially from the demonstration itself.
译文
机器人操作模型。 机器人操作策略的范围很广,从专用的视觉运动方法,如 ACT(Zhao et al., 2023)、Diffusion Policy(Chi et al., 2025)和 VQ-BeT(Lee et al., 2024),到大规模的 VLA 和基于扩散的基础模型,包括 OpenVLA(Kim et al., 2024; Kim et al., 2025)、\pi_{0.5}(Black et al., 2024; Intelligence et al., 2025)、GR00T 系列(Bjorck et al., 2025)、RDT-1B(Liu et al., 2025)和 H-RDT(Bi et al., 2026)。这些系统推进了语言条件、动作生成、跨机器人预训练和少样本适应,但通常只在机器人自身场景中执行一个指定任务来评估。本文则研究:在执行条件不匹配、机器人场景可能与示范本身差异很大的情况下,策略能否从人类视频中推断并复现示范的行为。
解释
这段列出的模型大多就是第 4 节评测的对象,所以有必要简单交代各自的做法。视觉运动策略:ACT(Action Chunking with Transformers)用 CVAE 结构的 Transformer 一次预测一段未来动作(动作块),以减少误差累积;Diffusion Policy 把动作生成建模为去噪扩散过程,善于表达多模态动作分布;VQ-BeT 先用向量量化把连续动作离散成码本,再用 Transformer 像预测词元一样预测动作类别和残差偏移。这三者本身都不接收视频示范,本文给它们拼接一个由冻结视频编码器(DINOv2、SigLIP2 或 VideoMAE)得到的任务嵌入,使其变成视频条件策略。大模型:OpenVLA 在预训练视觉语言模型上把动作离散成词元来输出(Kim et al., 2025 是其微调改进版 OpenVLA-OFT);\pi_0/\pi_{0.5} 在视觉语言模型后接流匹配动作专家,\pi_{0.5} 进一步强调开放世界泛化;GR00T 是 NVIDIA 面向人形机器人的基础模型,采用“视觉语言模型 + 扩散动作头”的双系统结构;RDT-1B 是十亿参数级、面向双臂操作的扩散 Transformer;H-RDT 在 RDT 的基础上利用人类操作数据进行预训练。这些模型都以语言指令为任务说明,所以本文把示范视频先用固定的描述器转成文字,再喂给它们,这就是摘要所说的“以文字描述为条件的模型”。最后一句再次强调本文与它们的差异:这些模型的评测问的是“告诉你做什么,你能不能做好”,本文问的是“给你看别人怎么做,你能不能在不同的场景里做到同样的事”。注意 H-RDT 只在这里提及,并不在后文评测的 9 个模型之中。
3模仿者游戏(The Imitator Game)
原文
This section has two parts. Section 3.1 formalizes the imitator capability – the ability to infer and reproduce the behavior demonstrated in a human video – as a four-level hierarchy, where each level corresponds to a different degree of scene mismatch and the corresponding fidelity of imitation. Section 3.2 introduces the Imitator Benchmark: IG-10K, the largest environment-aligned human–robot paired dataset to date; Imitator Arena, a unified platform for simulation and real-world evaluation with both automated metrics and a human-evaluation interface; and the adaptation of three families of state-of-the-art baselines, each trained on IG-10K and evaluated in the Arena.
译文
本节分为两部分。第 3.1 节把模仿者能力(imitator capability),即从人类视频中推断并复现所示范行为的能力,形式化为一个四层级的层次结构:每个层级对应不同程度的场景失配(scene mismatch),以及与之相应的模仿保真度(fidelity of imitation)。第 3.2 节介绍模仿者基准(Imitator Benchmark),它包括:IG-10K,迄今规模最大的环境对齐人—机器人配对数据集;模仿者竞技场(Imitator Arena),一个同时支持仿真与真实世界评测、兼具自动指标和人工评测界面的统一平台;以及三类最先进基线方法的适配方案,每个基线都在 IG-10K 上训练,并在竞技场中评测。
解释
这是第 3 节的路线图。前半部分是“概念”:先回答“模仿得像”到底指什么,把它拆成四个可操作的层级;后半部分是“工具”:数据(IG-10K)、评测平台(Arena)、被测模型(三类基线的适配器)。两部分的连接点是:层级不由任务决定,而由“示范场景与机器人场景差多少”决定,所以数据集必须为同一段人类视频准备多种机器人场景,评测也必须能在不告诉模型、不告诉评审层级的前提下打分。“迄今最大”带有限定语环境对齐。从后面的表 2 看,RH20T 有 110k 段人类片段,规模远大于 IG-10K,但它的人类与机器人示范不在对应场景中;在标为环境对齐(✓)的数据集里,MIME 为 8.3k、H&R 为 2.6k、HRDexDB 为 1.4k,IG-10K 的 11.7k 真机配对确实最大。所以这个“最大”是在环境对齐这一子类里成立的,读者引用时应带上这个限定。
3.1模仿者能力
3.1.1问题设定与场景分解
原文
Problem setting. The imitator is given a human demonstration video V, recorded in some scene \mathcal{S}_{\text{demo}}. The task is defined implicitly by whatever is demonstrated in V – there is no separate task description, goal predicate, or symbolic specification. The imitator is then placed in its own scene \mathcal{S}_{\text{imit}}, where it receives observations o_t and must generate actions a_t that reproduce the demonstrated task as faithfully as \mathcal{S}_{\text{imit}} permits. Formally, an imitator policy is a mapping \pi\bigl(a_t \mid o_t, V\bigr); goal predicates are used only inside the evaluation platform for simulation scoring, never as policy input.
译文
问题设定。模仿者得到一段人类示范视频 V,它录制于某个场景 \mathcal{S}_{\text{demo}}。任务由 V 中示范的内容隐式定义,没有另外的任务描述、目标谓词(goal predicate)或符号化规约。随后,模仿者被放到它自己的场景 \mathcal{S}_{\text{imit}} 中,接收观测 o_t,并且必须生成动作 a_t,在 \mathcal{S}_{\text{imit}} 允许的范围内尽可能忠实地复现所示范的任务。形式上,模仿者策略是一个映射 \pi\bigl(a_t \mid o_t, V\bigr);目标谓词只在评测平台内部用于仿真打分,从不作为策略的输入。
解释
符号:V 是人类示范视频,\mathcal{S}_{\text{demo}} 是拍摄它的场景(下标 demo 即 demonstration),\mathcal{S}_{\text{imit}} 是机器人所在的场景(imit 即 imitator),o_t、a_t 是第 t 步的观测与动作。和常见的语言条件策略 \pi(a_t\mid o_t,\ell) 或目标条件策略 \pi(a_t\mid o_t,g) 相比,这里的条件变量换成了整段视频 V,“要做什么”需要模型自己从视频里读出来。这个设定有两个要点。其一,任务是隐式的:没有人告诉机器人“泡茶”或“把茶包放进杯子”,它要自己判断示范里哪些是要点、哪些是偶然细节。其二,保真度的上限由机器人自己的场景决定,即“在 \mathcal{S}_{\text{imit}} 允许的范围内尽可能忠实”。场景完全一样时应当连动作都照搬;场景里根本没有示范用到的物体时,只能退而复现意图。下文的四个层级就是把这句话细化。“目标谓词只用于评测”是为了防止信息泄漏:仿真里判定成功要用诸如“茶包在杯中”这类谓词,如果把它们喂给策略,任务就不再是“从视频推断”了。需要提前注意的是,第 3.2.2 节中语言条件的 VLA 会拿到由 V 转写的文字描述 T(V),其中包含任务意图和子任务序列。它在形式上仍然是 V 的函数,不违反这里的定义,但这份描述经过人工核对,等于把一部分“从视频推断任务”的工作交给了人类,这一点在比较不同模型时值得记住。
原文
Scene decomposition. We represent a scene as an object collection and its spatial configuration, \mathcal{S} = \bigl(\{O_i=(A_i, G_i, S_i)\}, P\bigr), where A_i, G_i, and S_i denote the appearance, geometry, and semantic category of object O_i, respectively, and P denotes the spatial configuration of the object collection. In our specific definition context, semantic categories are distinguished mainly by the general purposes of objects, and spatial configuration primarily concerns the initial placement of task-relevant objects at the start of the episode.
译文
场景分解。我们把一个场景表示为一个物体集合及其空间配置, \mathcal{S} = \bigl(\{O_i=(A_i, G_i, S_i)\}, P\bigr), 其中 A_i、G_i、S_i 分别表示物体 O_i 的外观(appearance)、几何(geometry)和语义类别(semantic category),P 表示该物体集合的空间配置(spatial configuration)。在我们的具体定义语境中,语义类别主要按物体的一般用途来区分,空间配置则主要指回合开始时任务相关物体的初始摆放。
解释
逐个符号:\mathcal{S} 是场景;\{O_i\} 是场景中任务相关物体的集合,i 为物体编号;每个物体由三元组描述:A_i 是外观(颜色、材质、纹理,比如陶瓷还是玻璃),G_i 是几何(形状和尺寸,比如有没有把手),S_i 是语义类别(它“是什么、拿来干什么”,比如“杯子”“茶”)。P 不属于任何单个物体,是整个集合的摆放方式,即每个物体放在哪里、朝向如何。注意记号上的重载:花体 \mathcal{S} 是场景,斜体 S_i 是语义类别,两者无关。这一分解的意义在于把场景差异拆成内在(物体自身的 A,G,S)和外在(物体之间的摆放 P)两部分。两个限定也值得留意。语义类别按“一般用途”划分,而不是按生物学或化学类属划分:茶包和散装茶叶都用来泡茶,算同一类;图 2 中的抹茶粉虽然本身也是一种绿茶,但它的用法是冲调而非浸泡,作者把它当作不同的类别。P 只管初始摆放,回合中物体被移动不算场景差异。
原文
The distinction between intrinsic object properties and extrinsic configuration is central to the hierarchy: changing P preserves object identity but changes where objects are placed, whereas changing (A,G,S) changes the behavior logic to accomplish the tasks shown in the demonstration scene. For the functional task objects in IG-10K, we use the operational assumption
S \text{ changes} \;\Longrightarrow\; G \text{ changes} \;\Longrightarrow\; A \text{ changes},
while the reverse directions do not generally hold. This assumption is not intended as a general ontology of objects; it is used to construct benchmark instances where each level transition is induced by one interpretable mismatch. It also implies that comparing P is meaningful only when demonstration and imitator scenes share a common object set. Edge cases are discussed in Appendix A.1. 译文
物体内在属性与外在配置之间的区分是这一层次结构的核心:改变 P 会保留物体的身份,只改变物体被放在哪里;而改变 (A,G,S) 则会改变完成示范场景中所示任务的行为逻辑。对于 IG-10K 中的功能性任务物体,我们采用如下操作性假设:
S \text{ 改变} \;\Longrightarrow\; G \text{ 改变} \;\Longrightarrow\; A \text{ 改变},
而反方向一般不成立。这一假设并不打算作为关于物体的一般本体论;它用于构造基准实例,使得每一次层级跃迁都由一种可解释的失配引起。它还意味着:只有当示范场景与模仿者场景共享同一个物体集合时,比较 P 才有意义。边界情形在附录 A.1 中讨论。 解释
蕴含链读作:语义类别变了,几何一定变;几何变了,外观一定变。它的逆否命题更直观:外观完全相同 \Rightarrow 几何相同 \Rightarrow 类别相同。换成集合语言,“类别改变”的物体对是“几何改变”的子集,后者又是“外观改变”的子集,三类改变是层层嵌套的。为什么反方向不成立。“A 变 \Rightarrow G 变”不成立:陶瓷杯换成同形状的玻璃杯,外观变了,几何没变。“G 变 \Rightarrow S 变”也不成立:无把手的茶杯换成带把手的马克杯,形状变了,但都是“杯子”。正向之所以成立,第二个箭头 G\Rightarrow A 几乎是定义性的,因为轮廓本身就是外观的一部分,形状不同看起来必然不同;第一个箭头 S\Rightarrow G 则是经验性的,对“按用途设计”的功能性物体大体成立(锤子和石头、茶包和抹茶粉形状都不同),但存在反例。附录 A.1 举了蜡做的香蕉(形状仍是香蕉,语义已是摆件)和做成杯子形状的烛台(几何是杯子,语义是烛台),这两例都违反 S\Rightarrow G。作者的处理是把这类“故意让形式与类别脱钩”的物体排除在 IG-10K 之外,所以这里明确称之为“操作性假设”,而不是普适真理。为什么要这条链。有了嵌套关系,场景差异就能按“最深一层改变了什么”排成一条线,不会出现交叉组合:没有内在改变(只可能改 P)\to 外观或几何改变但类别不变 \to 类别改变。每一步只多引入一种可解释的失配,这正是表 1 能排成四行而不是一张组合表格的原因。顺带一提,由于 G 变必然 A 变,表 1 中“A 或 G”这一列实际上等价于“A 是否改变”;把 A、G 合成一列,是因为它们的变化对应同一个保真度上限,即附录所说 L2 中“只改外观”和“外观、几何都改”两种子情形。为什么“只有物体集合相同时比较 P 才有意义”。P 描述的是“每个物体在哪里”,本质上是从物体到位姿的映射。比较两个映射,先要有物体之间的一一对应。物体集合相同时,对应关系就是恒等映射(这个茶包对应那个茶包),“茶包从右边挪到了前面”是一个定义良好的变化。物体一旦被替换,茶包的位置和一堆茶叶的位置就不再是同一个量的两个取值,问“P 变了没有”就失去意义。所以表 1 在 L2、L3 两行的 P 列填的是 n/a(不适用),而不是 \times(改变)。也可以从另一个角度理解这一选择:严格说,同类替换时仍能按类别人为建立对应(茶包对应茶叶),但到了 L2,保真度上限已经降到“语义任务”,既不要求轨迹相同,也不要求终态相同,摆放是否改变已经不影响评分标准,因此把它标为不适用不会丢失任何信息。附录 A.1 也据此指出,不存在“同时改变 P 和物体集合”的独立层级。
3.1.2四个模仿层级
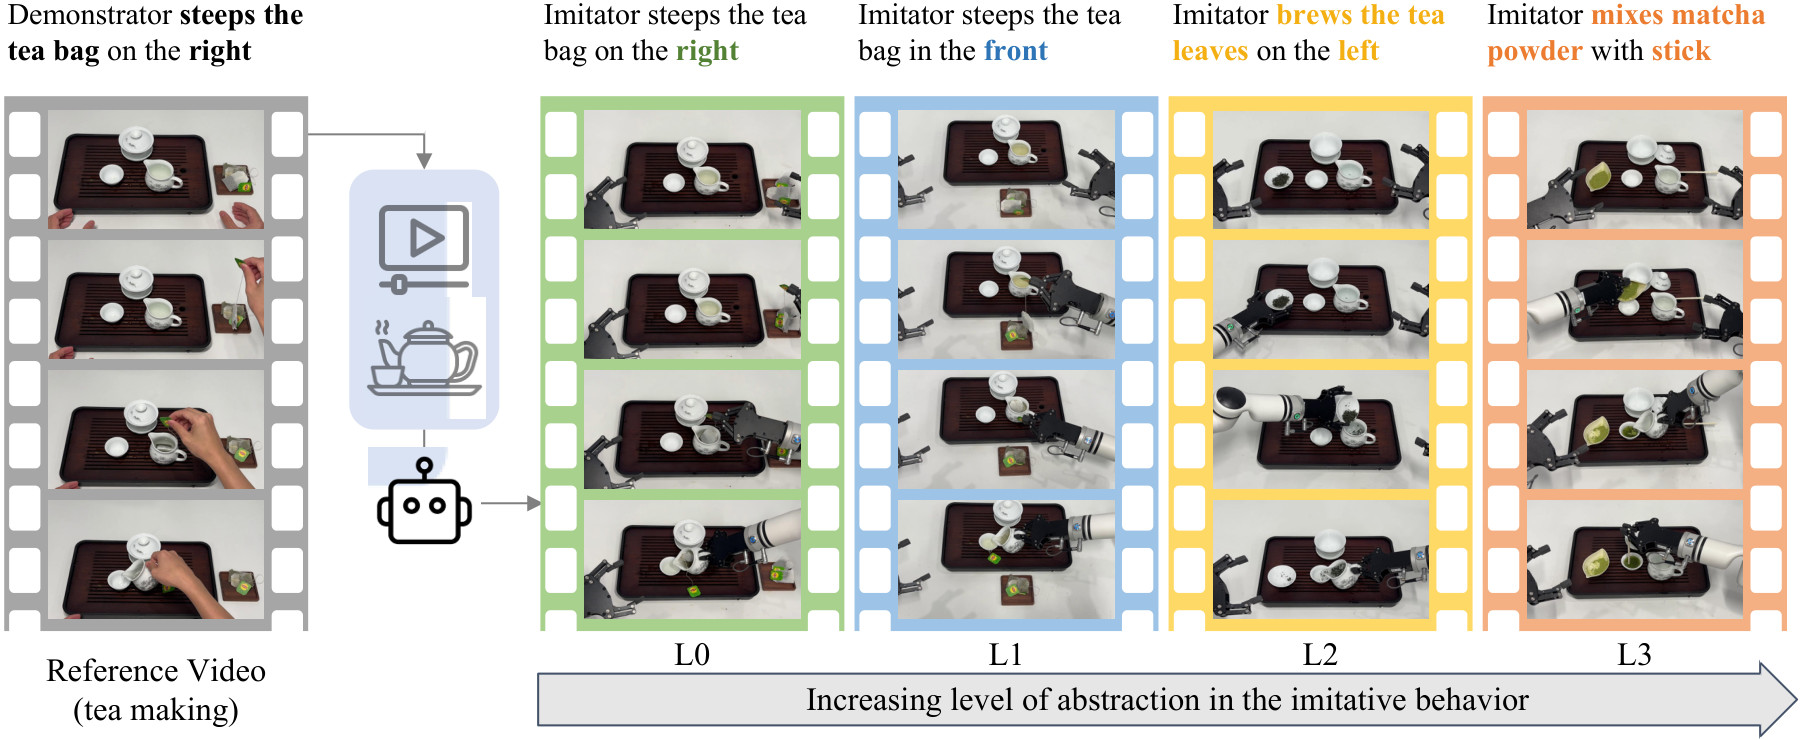
图 2:四个模仿层级,以同一段示范为例:一个人用浸泡茶包的方式泡茶(最左侧胶片)。从左到右,模仿者的场景与示范的差异越来越大,因而示范中能被原样照搬的部分越来越少。L0:物体和布局都相同;模仿者在右侧浸泡茶包,复现示范的动作。L1:布局被重新安排(茶包在前方而不是右侧),因此必须通过不同的轨迹达到相同的终态。L2:茶包被换成同种的散装茶叶,因此只有“泡茶”这一语义任务可以复现。L3:场景中没有茶,于是模仿者用现有的抹茶粉服务于同一意图,通过搅拌而不是浸泡完成。抽象程度从左到右递增。
原图注:Four levels of imitation, illustrated on a single demonstration: a human making tea by steeping a tea bag (leftmost filmstrip). Left to right, the imitator's scene diverges further from the demonstration, so less and less of the demonstration can still be copied exactly. L0: same objects and layout; the imitator steeps the tea bag on the right, reproducing the demonstrated motion. L1: the layout is rearranged (tea bag in front rather than on the right), so the same final state must be reached by a different trajectory. L2: the tea bag is replaced by loose tea leaves of the same kind, so only the semantic task “make tea” is reproducible. L3: no tea is present, so the imitator serves the same intent with the available matcha powder, mixing it rather than steeping. Abstraction increases left to right.
图 2 解读
版面:最左侧灰色胶片是人类参考视频(Reference Video,tea making),四帧俯视画面显示人手把放在托盘右侧的茶包拿起、放进杯中浸泡,上方标注“Demonstrator steeps the tea bag on the right”。中间的图标(视频、茶壶、机器人)表示“看视频 \to 理解 \to 交给机器人”。右侧四条彩色胶片是双臂机器人在四种场景中的执行:绿框 L0“Imitator steeps the tea bag on the right”,蓝框 L1“steeps the tea bag in the front”,黄框 L2“brews the tea leaves on the left”,橙框 L3“mixes matcha powder with stick”。底部箭头写着“Increasing level of abstraction in the imitative behavior”(模仿行为的抽象程度递增)。怎么读:四列对应表 1 的四行。L0 与示范在物体和位置上都一致,连“在右边”这个细节都照搬;L1 只把茶包挪到前方,物体身份没变,所以要求的是同样的终态(茶包泡在杯里),手臂轨迹必然不同;L2 把茶包换成同类的散茶(外观和几何都变,类别仍是“茶”),已无法达到“茶包在杯中”的终态,只能完成“泡茶”;L3 场景里没有茶,只有抹茶粉和搅拌棒,机器人要识别出示范的深层意图是“做一杯茶饮”,并改用搅拌这种完全不同的操作来实现。注意 L2 的描述中茶叶出现在“左侧”,说明 L2 场景的布局也变了,这正对应正文所说:物体集合一旦改变,P 不再单独计较。这张图是全文最直观的概念图,它说明同一段人类视频可以服务于四个层级,变的只是机器人一侧的场景(第 3.2.1 节的配对设计即依此而来)。值得一提的是,“抹茶粉是不是茶”在日常语义里有争议,作者把它归为不同类别,依据的是“一般用途”和使用方式(冲调与浸泡)。这说明 L2 与 L3 的边界依赖于人为的类别划分,基准中每个任务的替换方案是作者逐一设计的。
表 1:模仿者游戏的四个层级,表示为三个场景属性列上的保持模式。✓ = 在 \mathcal{S}_{\text{demo}} 与 \mathcal{S}_{\text{imit}} 之间保持不变;✗ = 改变;n/a = 不适用,因为物体集合已经改变,配置不存在恒等映射。最右列给出模仿者场景所允许的最高保真度。
| 层级 | P | A 或 G | S | 对模仿者期望的复现保真度 |
| L0(轨迹) | ✓ | ✓ | ✓ | 轨迹匹配:动作与 V 相似。 |
| L1(物体终态) | ✗ | ✓ | ✓ | 物体终态与 V 相同;轨迹可以不同。 |
| L2(语义任务) | n/a | ✗ | ✓ | 任务语义与 V 相同;终态不同。 |
| L3(可供性适配) | n/a | ✗ | ✗ | 意图相同,通过对可供性的重新利用来实现。 |
原表注:The four levels of the imitator game as preservation patterns across three scene-property columns. ✓ = preserved between \mathcal{S}_{\text{demo}} and \mathcal{S}_{\text{imit}}; \times = changed; n/a = not applicable, as the object set has changed and configuration has no identity mapping. The right column states the highest fidelity the imitator's scene permits.
表 1 解读
列的含义:P 列问“摆放是否保持”,“A 或 G”列问“任务相关物体在外观、几何上是否完全相同”,S 列问“每个任务相关物体的语义类别是否保持”,最后一列是在该场景下能要求模仿者达到的最高保真度。英文原表最后一列表头写“对模仿者期望的复现保真度”,图注却说“最高保真度”,两者是一回事:场景允许的上限,就是对模仿者的要求。行的结构:从上到下,“✗”从右往左逐列出现,而不是任意组合。L0 全部保持;L1 只有 P 改变;L2 物体本身变了(A 或 G 为 ✗),但类别不变;L3 连类别也变了。按上一段的蕴含链,S 改变必然伴随 G、A 改变,所以不存在“S 列为 ✗而 A 或 G 列为 ✓”的行;按“P 只在物体集合相同时可比”,L2、L3 的 P 列只能是 n/a。四行恰好穷尽了这两条规则允许的全部模式。最后一列的递进:L0 要求“动作像”,L1 要求“结果像”(每个物体的最终状态),L2 要求“做的是同一件事”,L3 要求“为了同一个目的”。要求越来越宽松,但模仿者需要的推理越来越深:L0 几乎可以靠视觉对齐后的轨迹复制完成,L3 则要从示范中抽出意图,再在新场景里找出能达到该意图的替代物体和动作。“可供性”(affordance)指物体能提供的动作可能性,例如石头可以“被握住并用来敲击”,因此能代替锤子。后文表 5 的真机结果显示,P+FT 设置下四个模型的平均成功率在 L0、L1、L2、L3 上依次为 0.42、0.42、0.39、0.29,下降集中在 L3,与这里“L3 需要最深推理”的设计意图一致。
原文
How closely the imitator can copy the demonstration is decided by its own scene \mathcal{S}_{\mathrm{imit}}. As \mathcal{S}_{\mathrm{imit}} diverges away from \mathcal{S}_{\mathrm{demo}} along (P,A,G,S), what can still be matched becomes less and less specific: first the exact motion, then the exact final state of each object, then only the task in the ordinary sense of the word, and finally only the purpose behind it. Table 1 defines this hierarchy as preservation patterns over P, A\text{-or-}G, and S; Figure 2 illustrates the progression on a single demonstration. We treat P as preserved when the motion shown in V would still work if it were replayed directly in \mathcal{S}_{\mathrm{imit}}, and as changed otherwise. The A\text{-or-}G column is preserved only when the task-relevant object set is intrinsically identical, and S is preserved when each task-relevant object keeps its semantic category. Thus, each \mathrm{L}{\to}\mathrm{L}{+}1 transition permits greater differences between the demonstration and the imitator scene, while correspondingly broadening the criterion for successful imitation. This gives the hierarchy a clear progression from matching actions, to reproducing object outcomes, to preserving semantic function, and ultimately to fulfilling the underlying intent. Additional examples and edge cases are deferred to Appendix A.2.
译文
模仿者能把示范复制到多接近,取决于它自己的场景 \mathcal{S}_{\mathrm{imit}}。随着 \mathcal{S}_{\mathrm{imit}} 沿 (P,A,G,S) 偏离 \mathcal{S}_{\mathrm{demo}},仍然能够匹配的内容变得越来越不具体:先是精确的动作,然后是每个物体的精确终态,再是日常意义上的“任务”,最后只剩任务背后的目的。表 1 把这一层次结构定义为 P、“A 或 G”和 S 上的保持模式;图 2 在同一段示范上展示了这种递进。如果把 V 中展示的动作直接在 \mathcal{S}_{\mathrm{imit}} 中重放仍然可行,我们就认为 P 保持不变,否则认为它改变了。“A 或 G”列只有在任务相关物体集合内在完全相同时才算保持;当每个任务相关物体都保留其语义类别时,S 算保持。因此,每一次 \mathrm{L}{\to}\mathrm{L}{+}1 的跃迁都允许示范与模仿者场景之间存在更大的差异,同时相应地放宽了模仿成功的判据。这使得该层次结构呈现出清晰的递进:从匹配动作,到复现物体结果,到保持语义功能,最终到实现潜在意图。更多示例和边界情形见附录 A.2。
解释
这段给出三列的判定规则,其中最值得注意的是 P 的定义是功能性的,而不是几何性的:不是“物体坐标差了几厘米”,而是“把示范里的动作原样重放还能不能成功”。这样定义的好处是避开了阈值问题:茶包挪了 1 厘米,若照原轨迹仍能抓到,就算 P 保持(仍是 L0);挪到另一侧,原轨迹抓空,就算 P 改变(L1)。代价是判定依赖于对“重放能否成功”的设想,而人手轨迹到机器人轨迹本身还需要重定向,所以这在实践中是由作者在构造场景时人为把关的,而不是一个可自动计算的量。“A 或 G”列要求物体集合“内在完全相同”,即同一批实物(或同一批仿真资产);S 列只要求类别相同。两者合起来,L2 的典型情形就是“换了一个同类的东西”。最后一句是这一层次结构的核心论点:场景差异越大,成功判据越宽。这和常见基准“越难的关卡要求越严”的逻辑相反,这里越高的层级反而越“宽容”,但宽容的代价是模仿者必须自己判断该放宽到哪一层。结合第 3.2.2 节可以看到,层级既不告诉模型,也不告诉人类评审,所以“该照搬多少”本身就是被测能力的一部分。例如在 L3 场景中,一个仍试图寻找茶包的策略,并不是在“更忠实”地模仿,而是没有理解示范。
3.2模仿者基准
原文
The benchmark comprises three reusable artifacts. IG-10K (Section 3.2.1) is the largest environment-aligned human-robot paired manipulation dataset to date, instantiated across all four levels of Table 1. Imitator Arena (Section 3.2.2) supports automated rule-based scoring in simulation and structured human evaluation. Baseline adapters (Section 3.2.3) let three different families of methods share the same input with human demonstration videos and robot observation. Using these we train or fine-tune nine state-of-the-art models, yielding fifteen trained variants, evaluated uniformly within the Arena.
译文
该基准由三个可复用的组件构成。IG-10K(第 3.2.1 节)是迄今最大的环境对齐人—机器人配对操作数据集,在表 1 的全部四个层级上都有实例。模仿者竞技场(第 3.2.2 节)支持仿真中基于规则的自动打分,以及结构化的人工评测。基线适配器(第 3.2.3 节)让三类不同的方法共享同一输入,即人类示范视频和机器人观测。借助这些组件,我们训练或微调了九个最先进的模型,得到十五个训练好的变体,并在竞技场中统一评测。
解释
“九个模型、十五个变体”的来历:第 3.2.3 节列出 VLA 四个(GR00T-N1.6、RDT-1B、\pi_{0.5}、OpenVLA)、技能类两个(XSkill、UniSkill)、视觉—动作类三个(ACT、Diffusion Policy、VQ-BeT),共 4+2+3=9 个模型。视觉—动作类每个动作头又分别搭配三种冻结视频编码器(DINOv2、SigLIP2、VideoMAE),得到 3\times3=9 个变体,因此变体总数为 4+2+9=15,数字能对上。三件“组件”分别解决数据从哪来、怎么评、拿谁来比,后文依次展开。
3.2.1IG-10K:迄今最大的环境对齐人—机器人配对操作数据集
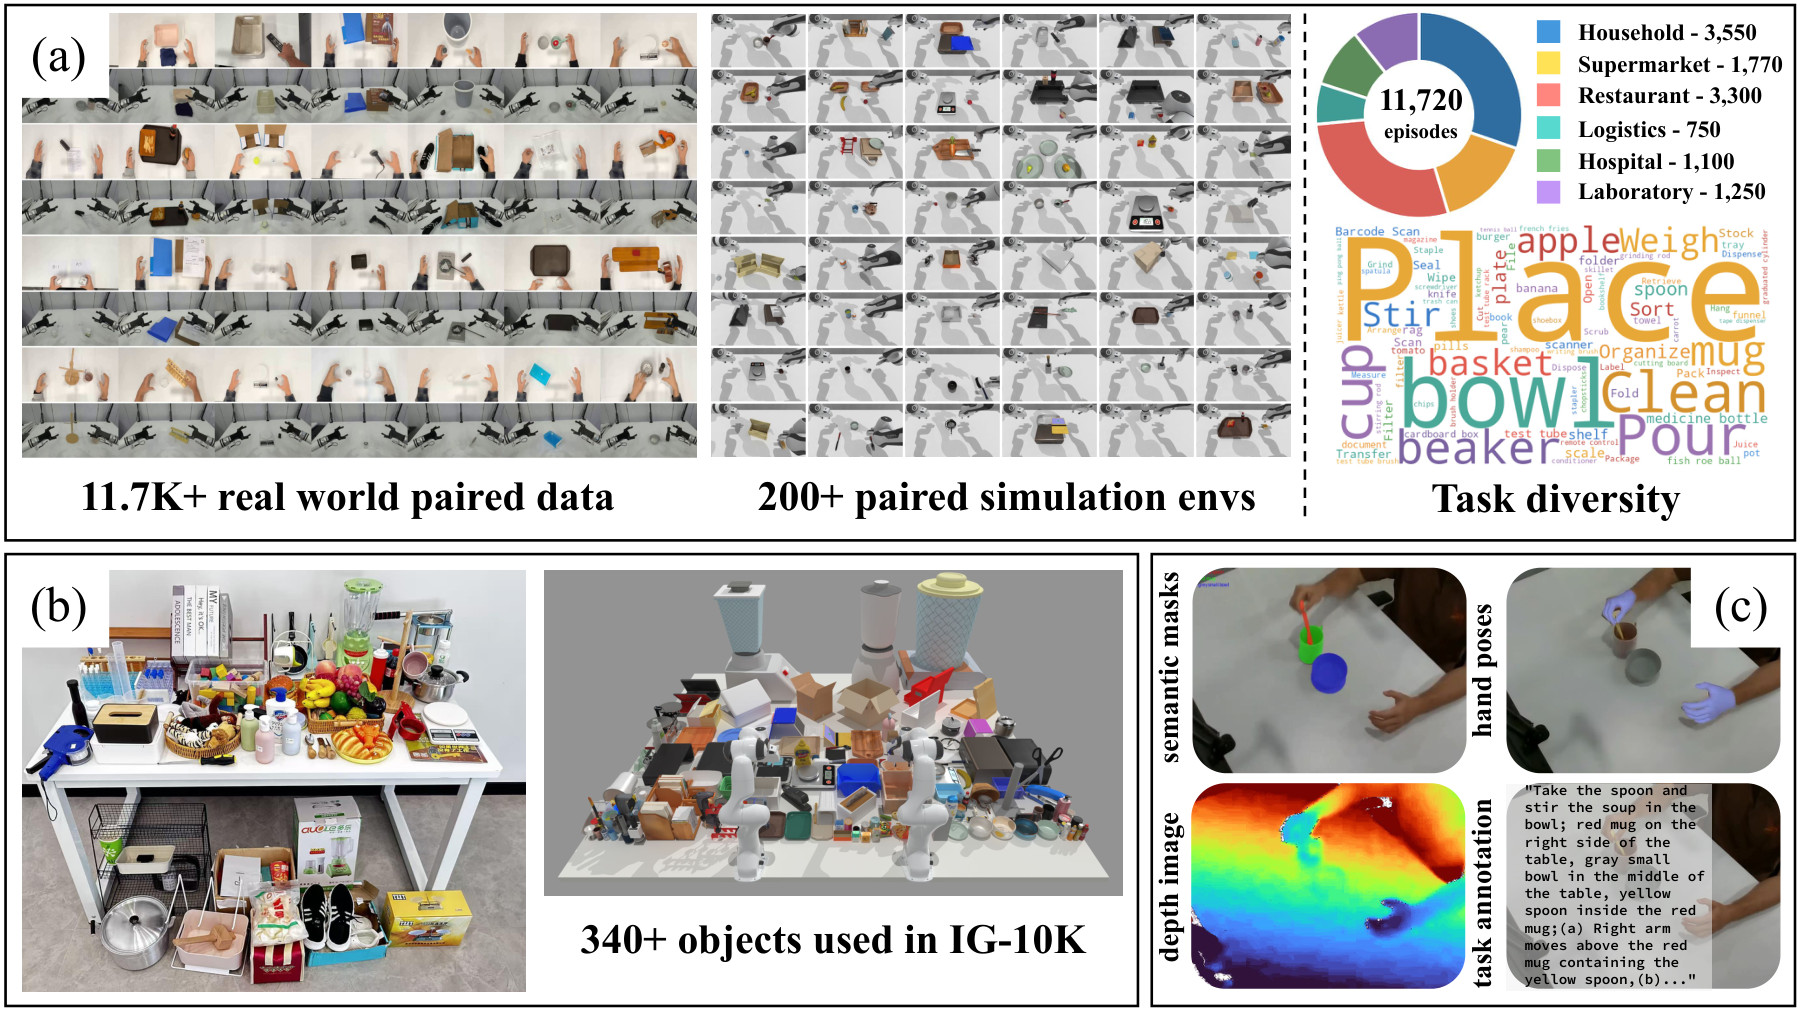
图 3:IG-10K 数据集。(a) IG-10K 包含 20{,}000+ 个配对回合:11.7K 个真实人—机器人配对回合(每个包含一段人类片段和一段对应的真机片段),以及 10K 个配对仿真回合。它们涵盖家居、超市、餐厅、物流、医院和实验室中的操作任务。拼图、环形图和词云概括了数据集的规模和任务多样性。(b) 物体图库展示了用于实例化 L0–L3 场景变化的真实与仿真资产。(c) 每个回合都随附密集的离线标注,包括语义掩码、手部位姿、深度图和语言描述。
原图注:The IG-10K dataset. (a) IG-10K contains 20{,}000+ paired episodes: 11.7K real human-robot paired episodes, each with one human clip and one corresponding real-robot clip, plus 10K paired simulation episodes. These span household, supermarket, restaurant, logistics, hospital, and laboratory manipulation tasks. The montage, donut chart, and word cloud summarize the dataset scale and task diversity. (b) The object gallery shows the real and simulated assets used to instantiate the L0–L3 scene variations. (c) Each episode is released with dense offline annotations, including semantic masks, hand poses, depth images, and language descriptions.
图 3 解读
(a) 规模与多样性。左块标“11.7K+ real world paired data”,每行左侧是人手操作画面,右侧是对应的机器人画面;中块标“200+ paired simulation envs”,是一组仿真场景缩略图;右块上方的环形图中心写“11,720 episodes”,按领域划分为:家居 3,550、超市 1,770、餐厅 3,300、物流 750、医院 1,100、实验室 1,250。验算:3550+1770+3300+750+1100+1250=11720,与 11.7K 一致,说明环形图统计的是真机配对,不含 10K 仿真配对。家居和餐厅两个领域合计 6,850,约占 58%。右块下方的词云中最显眼的动词和名词是 Place、bowl、Clean、Pour、cup、beaker、Stir、Weigh、Sort、apple、basket、mug,可以看出任务以桌面上的放置、倒、搅拌、称量和整理为主。(b) 物体图库。左图是摆满实物的桌子(水果、饮料、厨具、鞋盒、实验器皿等),右图是堆在两台 Franka 机械臂周围的仿真资产,标注“340+ objects used in IG-10K”。这些物体就是实现 L1–L3 场景替换的“道具库”:L2 需要同类异形或异观的替代物,L3 需要不同类别但可服务同一意图的物体。(c) 标注。四个小图分别是语义掩码(物体被涂成彩色)、手部位姿(MANO 手模型叠加在人手上)、深度图(伪彩色)和任务标注文本(例如“Take the spoon and stir the soup in the bowl ... Right arm moves above the red mug ...”,可见语言标注细到每只手臂的子动作)。一个口径问题。图注说 11.7K 真机配对“每个包含一段人类片段和一段真机片段”,而下一段又说同一段人类片段可以服务于其任务的四个层级。若后者成立,独立人类片段的数量应明显少于 11.7K;若每个层级都重新录制了人类片段,那么“同一片段服务四个层级”就只是可能性而非实际做法。表 2 把 IG-10K 的人类片段记为 11.7k,看起来是按配对数计数,而不是按独立视频计数。
原文
Paired-episode design. The atomic unit of IG-10K is a paired episode: a human demonstration video V in \mathcal{S}_{\text{demo}}, together with one or more robot episodes in scenes \mathcal{S}_{\text{imit}} whose relation to \mathcal{S}_{\text{demo}} instantiates one row of Table 1 – from a shared object set and configuration (L0), through rearrangement (L1) and same-category substitution (L2), intent-base functional substitution (L3). The levels are therefore decided by the demonstration-execution pairs, which is why the Arena supports fair level-agnostic comparison across anonymous policies for human evaluators (Section 3.2.2). Hence, level is not a property of a task: the same human clip can serve four levels of its task, and only the robot-side scene changes. At this stage, each task-level pair uses exactly one substitution pattern for equal supervision across levels. More variation is left to future versions of the benchmark.
译文
配对回合设计。IG-10K 的基本单元是配对回合(paired episode):一段在 \mathcal{S}_{\text{demo}} 中录制的人类示范视频 V,加上一个或多个在场景 \mathcal{S}_{\text{imit}} 中执行的机器人回合,\mathcal{S}_{\text{imit}} 与 \mathcal{S}_{\text{demo}} 的关系对应表 1 中的某一行:从共享物体集合与配置(L0),到重新摆放(L1)、同类替换(L2),再到基于意图的功能性替换(L3)。因此,层级由“示范—执行”配对决定,这也是竞技场能够为人类评审提供公平、与层级无关的匿名策略比较的原因(第 3.2.2 节)。由此可见,层级不是任务的属性:同一段人类片段可以服务于其任务的四个层级,变化的只有机器人一侧的场景。现阶段,每个“任务—层级”组合恰好使用一种替换方案,以使各层级获得同等的监督。更多变化留待基准的后续版本。
解释
为什么以“配对”为单位。层级描述的是两个场景之间的关系,单看机器人场景或单看人类视频都无法确定层级。所以数据的最小单位必须是“一段 V + 一个 \mathcal{S}_{\text{imit}} 中的执行”。这一设计带来两个后果。第一,同一段人类视频配上四种机器人场景,就得到同一任务的 L0–L3,四个层级的差别只来自机器人场景,示范内容完全相同,层级之间的比较因而是受控的。第二,在竞技场里,人类评审看到的两个 rollout 来自同一配对(同一 V、同一 \mathcal{S}_{\text{imit}}),层级自然相同,所以无需告诉评审层级,比较也是公平的,这就是“与层级无关”的含义。“一种替换方案”的取舍。L2、L3 的可能替换几乎无穷(茶包可以换成散茶、茶粉、茶饼……),作者每个任务每个层级只选一种。好处是四个层级的数据量和监督强度相当,层级间结果可比;代价是 L2、L3 的成绩可能更多反映“这一种替换”有多难,而不是该层级的平均难度。原文里“intent-base”应为“intent-based”,系笔误。
原文
Task suite and scale. IG-10K contains 50+ base tasks across six domains – Household (12), Supermarket (7), Restaurant (17), Logistics (4), Hospital (6), Laboratory (7), yielding 200+ task variants with four levels each suite, 50+ paired episodes each. Since the number of possible substitutions grows as the level rises with more mismatch, each task is paired with one substitution pattern per level at this stage for comparable comparison in levels. More variation is left to future versions of the benchmark. A few tasks omit L3 where substitution would be ill-defined or unsafe, e.g. hazardous-liquid handling in the laboratory. In total IG-10K provides 20,000+ paired episodes, released in
lerobot-0.5.0 format. 译文
任务集与规模。IG-10K 包含分布在六个领域中的 50 多个基础任务:家居(12)、超市(7)、餐厅(17)、物流(4)、医院(6)、实验室(7);每个任务有四个层级,共得到 200 多个任务变体,每个变体有 50 多个配对回合。由于失配越多、层级越高,可能的替换方式就越多,现阶段每个任务在每个层级只配一种替换方案,以便层级之间能够相互比较。更多变化留待基准的后续版本。少数任务在替换定义不清或不安全时省略了 L3,例如实验室中的危险液体操作。IG-10K 总共提供 20,000 多个配对回合,以
lerobot-0.5.0 格式发布。 解释
验算任务数与变体数。12+7+17+4+6+7=53 个基础任务,对应“50+”。若每个任务都有四个层级,应有 53\times4=212 个变体。附录的任务表列出了省略 L3 的任务共 6 个:物流的 H29(撕包装取样,定义不清)、医院的 H33(倒药液,危险)和 H36(放器械入托盘,定义不清)、实验室的 H38、H39、H43(均为危险)。因此实际变体数为 212-6=206,与“200+”吻合。正文只举了实验室的例子,但省略其实也发生在物流和医院。验算“每个变体 50+ 个配对回合”。若每个变体恰好 50 个回合,206 个变体共 10,300 个;按 212 个算是 10,600 个,与真机 11.7K、仿真 10K 两个数字都在同一量级。逐项看:真机 11720/206\approx56.9 个/变体,满足“50+”;仿真 10000/206\approx48.5 个/变体,略低于 50。再按图 3 环形图分领域核算真机数据(变体数为各领域任务数乘 4 再减去省略的 L3):家居 3550/48\approx74.0、超市 1770/28\approx63.2、餐厅 3300/68\approx48.5、物流 750/15=50.0、医院 1100/22=50.0、实验室 1250/24\approx52.1。各领域分布并不均匀,家居比餐厅多出约一半;餐厅领域平均不足 50,仿真整体平均也不足 50。所以“每个变体 50+”更像是一个约数或目标值,并非对每个变体都严格成立。“20,000+”则是 11.7\text{K}+10\text{K}\approx21.7\text{K} 的合计。其他要点。重复出现的“每层一种替换方案”与上一段相同,原文此处有重复。
lerobot 是 Hugging Face 的机器人数据格式,选它便于社区直接加载。 原文
Each episode is multi-view and richly annotated – 3D MANO hand pose, segmentation masks, and multi-abstraction language – placing IG-10K ahead of prior resources on the axes that matter for imitation (Table 2). Real data are teleoperated in VR on a dual-arm Realman platform, and simulated data on a dual-arm Franka in ManiSkill3 with OMPL-planned trajectories over hand-crafted waypoints; the two are kept as separate domains throughout, but share the data format, the human-to-robot pairing, and the task split. Simulated pairs reuse the real human clip of the same task and replace only the imitator scene; MANO hand pose is kept only for real-world human episodes. Collection platforms, assets, the camera rig, the annotation toolchain, and representative episodes (Figure 3 & Figure 5) are detailed in Appendix B.1.
译文
每个回合都是多视角的,并带有丰富的标注:3D MANO 手部位姿、分割掩码以及多层抽象的语言描述。这使 IG-10K 在对模仿而言最重要的几个维度上领先于已有资源(表 2)。真实数据在双臂 Realman 平台上通过 VR 遥操作采集;仿真数据则在 ManiSkill3 中的双臂 Franka 上采集,轨迹由 OMPL 在人工设计的路径点之间规划得到。两者始终作为独立的域,但共享数据格式、人到机器人的配对关系和任务划分。仿真配对复用同一任务的真实人类片段,只替换模仿者场景;MANO 手部位姿只为真实世界的人类回合保留。采集平台、资产、相机架、标注工具链以及代表性回合(图 3 和图 5)详见附录 B.1。
解释
术语:MANO 是常用的参数化人手模型,用几十个参数描述手的姿态和形状;ManiSkill3 是一个 GPU 并行的机器人操作仿真平台;OMPL(Open Motion Planning Library)是开源运动规划库,这里用来在人工给定的关键路径点之间自动规划无碰撞轨迹。“多层抽象的语言”指附录 B.1 中三层语言标注:每只手臂的子任务序列、语义任务描述和潜在意图,恰好与 L0/L1、L2、L3 的保真度相对应。仿真配对的含义。仿真中没有新录人类视频,而是拿真实世界里人做示范的视频,配上仿真里的机器人场景。这意味着在仿真中,即使是 L0,示范场景(真实桌面)与模仿场景(仿真渲染)在像素层面也并不相同,只是物体和摆放“明确对应”,这也是表 2 把“环境对齐”定义为“相同或明确对应”的原因。仿真模型因此还要额外跨越真实到仿真的视觉差异;附录 A.2 明确假设视觉前端对光照、视角等差异不敏感,并把这类差异排除在层级之外。此外,真机用 Realman 双臂,仿真用 Franka 双臂,两边的本体不同,这是论文把真机与仿真“始终作为独立的域”的又一原因:后文的结果不会把两者混在一起训练或比较。两处引用说明。这里的“图 3”即本节开头的数据集概览图;“图 5”在附录 B.1,展示真机采集平台与相机布置,并不在正文中。另外,“MANO 只保留给真实人类回合”与表 2 中 IG-10K 的“手部位姿 ✓”并不矛盾,因为所有人类片段(包括仿真配对所复用的)本来就是真实拍摄的。
表 2:IG-10K 与已有人—机器人配对操作数据集的对比。✓/✗ = 有/无;\Delta = 部分具备。环境对齐:人类与机器人示范共享相同或明确对应的任务场景、物体和设置(不要求帧级时间对齐)。仿真环境:为人类示范提供配对的、可交互的仿真环境(机器人渲染视频或离线轨迹不算)。
| 数据集 | 人类 片段 | 机器人 片段 | 任务 | 深度 | 环境 对齐 | 仿真 环境 | 多 视角 | 手部 位姿 | 语言 标注 | 分割 掩码 |
| MIME(Sharma et al., 2018) | 8.3k | 8.3k | 20 个任务族 | ✓ | ✓ | ✗ | ✓ | ✗ | ✗ | ✗ |
| BC-Z(Jang et al., 2022) | 18.7k | 25.9k | 100+ | ✗ | ✗ | ✗ | ✗ | ✗ | ✓ | ✗ |
| Vid2Robot(Jain et al., 2024) | 10k | 100k | 未知 | ✗ | \Delta | ✗ | ✗ | ✗ | ✗ | ✗ |
| RH20T(Fang et al., 2023) | 110k | 110k | 147 | ✓ | ✗ | ✗ | ✓ | ✗ | ✓ | ✗ |
| H&R(Xie et al., 2026) | 2.6k | 2.6k | 10 | ✗ | ✓ | ✗ | ✗ | ✗ | ✗ | ✗ |
| DexWild(Tao et al., 2025) | 9.3k | 1.4k | 5 个任务族 | ✗ | ✗ | ✗ | ✗ | ✓ | ✗ | ✗ |
| HRDexDB(Lim et al., 2026) | 1.4k | 1.4k | 抓取 | ✗ | ✓ | ✗ | ✓ | ✓ | ✗ | ✗ |
| IG-10K(本文) | 11.7k | 11.7k | 50 个任务 \times 4 个层级 | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
原表注:IG-10K in context vs. existing human-robot paired manipulation datasets. ✓/\times = present/absent; \Delta = partial. Env. aligned: human and robot demos share the same or explicitly corresponding task scene, objects, and setting (not necessarily frame-level timing). Sim. env.: a paired, interactive simulation environment for the human demos (robot-rendered videos or offline trajectories do not count).
表 2 解读
列的含义:前两列是人类片段和机器人片段的数量;“任务”列各数据集口径不一(任务族、任务数或任务类型);后七列是有无某种模态或属性。其中“环境对齐”和“仿真环境”是作者特别定义的两列,分别对应 IG-10K 的两个卖点:人与机器人在对应场景中示范(这是定义层级的前提),以及人类示范配有可交互的仿真环境(这是自动打分的前提)。读法:IG-10K 是唯一一行全部打勾的,尤其“仿真环境”和“分割掩码”两列只有它具备。规模上,RH20T(110k/110k)和 Vid2Robot(机器人 100k)都远大于 IG-10K,但它们的环境对齐为 ✗或 \Delta;在环境对齐为 ✓的数据集中,IG-10K 的 11.7k 高于 MIME 的 8.3k、H&R 的 2.6k 和 HRDexDB 的 1.4k,这就是“最大环境对齐数据集”说法的依据。DexWild 的人类片段远多于机器人片段(9.3k 对 1.4k),说明它不是一一配对的。口径上需注意的三点。其一,IG-10K 的人类片段记为 11.7k,与真机片段相同;但正文说仿真配对复用真机的人类片段,而且同一人类片段可服务四个层级,所以 11.7k 应理解为“真机配对数”,独立人类视频的数量可能更少;10K 仿真配对也没有计入这一列,否则机器人片段应约为 21.7k。其二,“任务”列写“50 个任务”,而正文写“50+”,附录任务表实际为 53 个基础任务,表中的 50 是取整写法。其三,“有/无”是按数据集整体判定的,例如 IG-10K 的手部位姿只针对人类片段,深度和分割掩码是否覆盖仿真回合,正文没有逐项说明。
3.2.2模仿者竞技场与评测指标
原文
Imitator Arena evaluates any policy following the imitator-game paradigm through two complementary score streams: automated goal-centric metrics in simulation, where the scene state is fully observable, and structured human preference judgments in both simulation and the real world.
译文
模仿者竞技场通过两条互补的评分渠道评测任何遵循模仿者游戏范式的策略:一是仿真中以目标为中心的自动指标,仿真里场景状态完全可观测;二是在仿真和真实世界中都可进行的结构化人类偏好判断。
解释
两条渠道的分工由“能否读到场景真值”决定。仿真里每个物体的位姿、容器里有什么都能直接查询,可以写成谓词自动判定;真实世界没有这种真值,只能靠人看录像。人评在仿真中也做,作用是与自动指标互相校验(附录 C 中有两条渠道一致性的分析)。所以真机结果只有人评,仿真结果两者都有,读后文表 3、表 4 时要注意二者口径不同。
原文
Unified interface. Every policy receives the same specification – the demonstration video V and the observation stream \{o_t\} – an generates a_t = \pi(V, o_t). Video-conditioned policies take these videos and images as they are; language-conditioned VLAs reach the demonstration videos through a platform-side step in which the Arena applies a fixed, deterministic captioner T(V) and supplies the result as language conditioning. To make it a fair comparison between VLAs and video-conditioned models, we keep captions dense and as informative as the video itself – task intent, object layout, and the per-arm sub-task sequence with its motions – and verify them by hand; see details in Appendix B.4. T is fixed across all VLA baselines, so comparisons can reflect VLA capacities rather than how V is captioned. Crucially, the episode level is never communicated to the policy: like a person watching the video, the imitator is not told how far its own scene has been changed, and has to work out from V and its observations how much of the demonstration is still reproducible.
译文
统一接口。每个策略接收相同的规约,即示范视频 V 和观测流 \{o_t\},并生成 a_t = \pi(V, o_t)。视频条件策略按原样接收这些视频和图像;语言条件的 VLA 则通过平台侧的一个步骤接触示范视频:竞技场用一个固定的、确定性的描述生成器(captioner)T(V) 处理视频,并把结果作为语言条件提供给模型。为了让 VLA 与视频条件模型之间的比较公平,我们让描述保持密集,信息量与视频本身相当(包括任务意图、物体布局,以及每只手臂的子任务序列及其动作),并逐条人工核对;细节见附录 B.4。T 在所有 VLA 基线之间保持固定,因此比较反映的是 VLA 的能力,而不是 V 被如何描述。关键在于,回合的层级从不告知策略:就像一个人看视频一样,模仿者不会被告知自己的场景被改动了多少,必须根据 V 和自己的观测判断示范中还有多少可以复现。
解释
接口统一的含义:所有模型拿到的原始信息相同,区别只在“怎么读 V”。视频模型直接读;VLA 只会读文字,所以平台先把视频转成文字。原文“an generates”应为“and generates”,系笔误。a_t=\pi(V,o_t) 与第 3.1.1 节的 \pi(a_t\mid o_t,V) 是同一个对象,前者写成确定性函数,后者写成条件分布。描述生成器 T 的公平性问题值得细看。正文称其“固定、确定性”,附录 B.4 说明它实际是“人工标注 + Qwen3-VL 增强”,用固定提示模板生成三层描述(每臂子任务序列、语义任务、潜在意图),且每条都经人工核对。这有两面性。一方面,文字是信息瓶颈:轨迹的细节(手从哪个方向接近、动作快慢)很难完整写进文字,这对需要“动作像”的 L0 不利。另一方面,描述里直接写出了“潜在意图”,这正是 L3 要求模仿者自己推断的东西,等于人类替 VLA 完成了一部分抽象推理,对 L3 可能有利。所以“信息量与视频相当”只是作者的设计目标,不能保证两类模型面对的推断难度相同。附录用纯人工描述替换后,\pi_{0.5} 的已见任务成功率只变化 0.01\pm0.05,这只说明“换一种描述来源”影响不大,不能说明“文字”与“视频”这两种通道等价。不告知层级是这一基准与普通多任务基准的关键区别:模型若被告知“这是 L3”,就会知道“别找茶包了,换个办法”,判断复现程度这一步就被省掉了。需要注意的是,描述 T(V) 描述的是示范场景(例如“把右边的茶包放进杯子”),而不是机器人场景,所以它本身不会泄露层级信息。
原文
Human evaluation. Human evaluation provides the level-sensitive scoring channel for both simulation and real-world rollouts. For each episode, evaluators view three synchronized videos: the demonstration V and two anonymized, randomly ordered rollouts from different models on the same imitator scene. The episode level is withheld, so evaluators judge what fidelity the scene permits from the demonstration–rollout pair itself with subjective human preference in imitative capability rather than from an explicit difficulty label. They answer three questions, worded the same way at every level: per-rollout task completion (success/partial/fail), per-rollout imitation quality q\in[0,10] on a fixed five-anchor rubric, and pairwise overall preference. These judgments yield \mathrm{SR}_{\mathrm{human}} (counting only success), mean imitation score \overline{Q}, and per-model win rate \mathrm{WR}.
译文
人工评测。人工评测为仿真和真实世界的 rollout 提供对层级敏感的评分渠道。对每个回合,评审观看三段同步播放的视频:示范 V,以及在同一模仿者场景中由不同模型产生、经过匿名处理并随机排序的两段 rollout。回合层级不告诉评审,因此评审根据“示范—rollout”这一对视频本身,凭对模仿能力的主观偏好来判断该场景允许怎样的保真度,而不是依据明确的难度标签。他们回答三个问题,每个层级的措辞都相同:每个 rollout 的任务完成度(success/partial/fail,即成功/部分完成/失败),每个 rollout 的模仿质量 q\in[0,10](按固定的五锚点评分标准打分),以及两者之间的总体偏好。这些判断得出 \mathrm{SR}_{\mathrm{human}}(只计 success)、平均模仿分 \overline{Q} 和每个模型的胜率 \mathrm{WR}。
解释
三个指标:\mathrm{SR}_{\mathrm{human}} 是被判为“成功”的 rollout 所占比例,“部分完成”不计入,与自动指标的硬判据一致;\overline{Q} 是 q 的平均,能给部分完成者部分分数,区分“差一点成功”和“完全乱做”;\mathrm{WR} 是两两比较中获胜的比例,附录 B.3 规定胜者得 1 分、平局各得 0.5 分、负者得 0 分,\mathrm{WR} 为一个模型在其参与的所有比较中的平均得分。五锚点评分标准(附录表 8)的锚点为 0(完全失败)、2(对意图有最低限度的理解)、5(部分模仿、没有适配)、8(模仿良好、有小错误)、10(完美模仿),评审可在相邻锚点之间取整数。注意 5 分锚点写的是“没有适配”,说明评分标准本身就把“能否根据场景调整做法”作为高分的条件。“对层级敏感”乍看与“不告诉评审层级”矛盾,其实不然:自动谓词只检查终态,无法判断 L0 的动作是否“像”;人类看着示范和 rollout,能自行判断这个场景下应该照搬到什么程度,并据此打分。层级信息蕴含在两段视频的差异中,只是没有作为标签给出。这一设计依赖评审对层级的直觉判断与作者的设计一致,例如在 L3 场景里,评审要能认出“用抹茶粉搅拌”是对“浸泡茶包”的合理模仿。
原文
Two designs guarantee the fairness and quality of human evaluation. First, an A/B screen pairs two rollouts only when they are directly comparable: rollouts are bucketed by transfer setting (seen, zero-shot, transfer) and, within a bucket, paired only when they share the same domain, task, level, and episode, so the two videos differ only in the policy. Second, each screen is answered by a single evaluator, which keeps judgments independent. Reliability comes from repetition in random evaluation pair rollouts. The bucketing protocol and formal aggregation rules are given in Appendix B.3.
译文
有两项设计保证人工评测的公平性和质量。第一,一个 A/B 评测界面只有在两个 rollout 可直接比较时才把它们配成一对:rollout 先按迁移设置(已见、零样本、迁移)分桶,在同一个桶内,只有当二者的域、任务、层级和回合都相同时才配对,因此两段视频的差别只在于策略。第二,每个评测界面只由一名评审作答,从而保证各判断相互独立。可靠性来自对随机抽取的评测配对进行重复评判。分桶协议和正式的汇总规则见附录 B.3。
解释
分桶规则。三个桶对应第 4.1 节的三种设置:“已见”(seen)是训练中见过的 5 个评测任务;“零样本”(zero-shot)是 5 个未见任务,直接用预训练检查点执行;“迁移”(transfer)是同样 5 个未见任务经少样本适配后的结果。按附录 B.3,“迁移”桶同时包含“预训练 + 微调”(P+FT)和“从零训练”(Scr)两种条件,二者被视为可以互相比较;同一模型在不同预训练规模(15/30/45 个任务)下的 rollout 也会在桶内互相配对。桶内配对还要求“域、任务、层级、回合”全同,其中“域”指仿真或真机,两者从不互相配对。这对胜率 \mathrm{WR} 的解读有直接影响,读后文表 4 前应先记住。每个界面恰好分出 1 分(1+0 或 0.5+0.5)。若一个封闭的比较池里有 m 个参与者,且每个参与者出场次数相同,那么所有参与者的 \mathrm{WR} 之和必然等于 m/2;真正守恒的是按出场次数加权的得分总和,只有出场次数相等时才化为“\mathrm{WR} 之和 =m/2”。用表 4(真机)核对:已见一列四个模型的 \mathrm{WR} 为 0.56+0.89+0.41+0.14=2.00,恰为 4/2,符合四个模型在桶内均衡循环比较的情形;P+FT 一列为 0.73+0.95+0.70+0.58=2.96,明显超过 2.0,若只是这四个模型互相比较,这是不可能的。这说明 P+FT 的 rollout 有相当一部分对手来自同一迁移桶中的 Scr rollout。Scr 一列之和为 0.50+0.52+0.24+0.24=1.50,两列合计 4.46,也不等于 8 个参与者均衡比较时的 4.0,说明两种条件的出场次数并不均衡(例如 P+FT 有三个规模版本而 Scr 只有一个,Scr rollout 被更频繁地拉来当对手)。因此,P+FT 列的 \mathrm{WR} 衡量的是“对一个混合了 Scr 与 P+FT 对手的池子的胜率”,它和已见列的 \mathrm{WR} 不在同一尺度上;表 4 中 \Delta\mathrm{WR}=\mathrm{WR}_{\text{P+FT}}-\mathrm{WR}_{\text{Scr}} 也部分来自二者直接对局,并不是两个独立测得的绝对水平之差。另外两处数字值得留意。其一,附录 B.3 称真机的 5,000 个界面分为已见 2,500 和迁移 2,500,没有零样本桶,但表 4 仍给出了真机零样本列的 \mathrm{WR}(0.04+0.50+0.42+0.25=1.21,也不等于 2.0),其来源不明。其二,附录 B.3 称仿真共 15,000 个比较界面,来自 36,000 个不同的 rollout,且“每个示范—rollout 对被评判 3–5 次”。但 15,000 个界面只有 2\times15000=30000 个 rollout 席位,少于 36,000,平均每个 rollout 连一次都轮不到;要让 36,000 个 rollout 各被评 3 次,至少需要 36000\times3/2=54000 个界面。真机为 2\times5000/4800\approx2.1 次,也低于 3。“可靠性来自重复”这一说法在数量上与附录给出的规模对不上。单评审设计的取舍:每个界面一人作答,判断彼此独立,也便于平台作为匿名公共排行榜运行;但这样无法计算同一界面上的评审一致性(如 Cohen's \kappa),附录承认这是后续扩展。共有 10 名志愿评审,人均承担约十分之一的工作量。
原文
Automated metrics. In simulation, two hand-crafted metrics provide fast, reproducible proxies for absolute success: the final success rate \mathrm{SR}, the fraction of episodes in which all task-relevant goal-state predicates hold at termination, and the denser sub-goal success rate \mathrm{Sub\text{-}SR}, the mean fraction of a task's ordered sub-goal phases completed. Both are level-agnostic, purely reflecting the task completion at the specific task and level. The comparison between each level is therefore fair since we didn't impose any hierarchical human priors for any level, and leaves the level-by-level view to the cross-level analysis. Formal definitions and per-task predicate construction are in Appendix B.3.
译文
自动指标。在仿真中,两个人工设计的指标为绝对成功提供快速、可复现的代理:最终成功率 \mathrm{SR},即回合结束时所有任务相关目标状态谓词都成立的回合所占比例;以及更密集的子目标成功率 \mathrm{Sub\text{-}SR},即一个任务按顺序排列的各子目标阶段中被完成部分的平均比例。两者都与层级无关,只反映在特定任务、特定层级上的任务完成情况。由于我们没有为任何层级施加层级化的人类先验,层级之间的比较因而是公平的,逐层的考察则留给跨层级分析。正式定义和逐任务的谓词构造见附录 B.3。
解释
两个指标:\mathrm{SR} 是二值的“全部目标谓词在结束时成立”;\mathrm{Sub\text{-}SR} 把任务拆成有序阶段(例如“抓起茶包 \to 放入杯中 \to 浸泡”),完成两步就得 2/3,对失败回合也能给出进度信息。“密集”即指此。“与层级无关”的确切含义与边界。它指的是计算方式在各层级相同:都只检查终态谓词,不因层级不同而改用不同的公式或额外奖励轨迹相似度。但有两点需要注意。第一,谓词本身是逐任务、逐层级人工构造的:L3 的谓词要写明“抹茶粉被搅拌进杯中的水里”算成功,这本身就是设计者对“意图”的判断。因此不同层级之间 \mathrm{SR} 的差异,混合了“模仿本身更难”和“该层谓词的严格程度”两种因素,“没有人类先验”的说法偏强。第二,由于自动指标只看终态,L0 所要求的“轨迹匹配”实际上并不被自动指标检验,L0 的 \mathrm{SR} 与 L1 一样只是终态判据;附录 A.2 也写明 L0 不用人工设计的轨迹距离指标。这也是人工评测被称为“对层级敏感”渠道的原因:动作是否“像”只能靠人看。
3.2.3基线适配器
原文
Three families of existing methods are evaluated under the same interface of Section 3.2.2, all receiving the same inputs (V, o_t) and trained or fine-tuned exclusively on IG-10K (Figure 7). Across all families, the video encoder or vision-language backbone is frozen, and only the action-generation module is trained. This keeps the adaptation budget comparable across methods and isolates how different policy architectures use the same human-video specification. As a result, the benchmark evaluates differences in action-generation interfaces rather than differences in large-scale representation adaptation. Full backbone fine-tuning is outside the scope of this comparison, since it would require substantially different optimization recipes, memory budgets, and training strategies across VLA, skill-based, and visuomotor models. Freezing also trades some accuracy for comparability and cost. In the engineering implementation, we cache the backbone activations, achieving orders-of-magnitude faster training at our evaluation scale.
译文
三类已有方法在第 3.2.2 节的同一接口下接受评测,它们都接收相同的输入(V、o_t),并且只在 IG-10K 上训练或微调(图 7)。在所有类别中,视频编码器或视觉—语言骨干网络都被冻结,只训练动作生成模块。这使各方法的适配预算保持可比,并能单独考察不同策略架构如何利用同一份人类视频规约。因此,本基准评测的是动作生成接口之间的差异,而不是大规模表征适配上的差异。完整的骨干网络微调不在本次比较的范围之内,因为在 VLA、基于技能的模型和视觉运动模型之间,这需要差别很大的优化方案、显存预算和训练策略。冻结也是用一部分精度换取可比性和更低的成本。在工程实现上,我们缓存骨干网络的激活值,在我们的评测规模下使训练速度提高了几个数量级。
解释
“图 7”指附录 B.4 中的适配示意图(三种范式如何接到统一接口 a_t=\pi(V,o_t) 上),不在正文中。冻结骨干、缓存激活的做法。骨干冻结后,同一段 V(以及离线数据中的每一帧观测)经过骨干得到的特征是固定的,可以预先算一次存下来,之后每个训练周期直接读取,不必再跑数十亿参数的前向和反向。附录 B.4 说明,整个实验网格是 15 个变体 \times 3 个语料规模,再加上少样本设置,不缓存就无法在合理成本内跑完。对比较公平性的影响。“可训练的部分相同”并不等于“起点相同”。按附录 B.4,VLA 训练的是预训练过的动作专家(例如 \pi_{0.5} 从公开的 DROID 检查点出发,自带大规模机器人数据学到的动作先验),而 ACT、Diffusion Policy、VQ-BeT 的动作头是从零训练的,XSkill、UniSkill 的技能表征也是在 IG-10K 上从零学的。此外,视觉—动作类只拿到一个由四帧均匀采样画面编码成的 256 维任务向量,VLA 拿到的是人工核对过的文字描述,技能类则检索技能原型,三者读取 V 的信息通道宽窄差别很大。所以“适配预算可比”是在可训练模块和训练算力层面成立的,各家带入的先验知识与信息通道并不对等。另一个工程上的副作用是:缓存观测激活意味着无法对输入图像做在线数据增强,而后者通常对视觉运动策略的泛化很重要。对结论边界的影响。作者自己说得很清楚:结论是关于“冻结表征 + 可训练动作头”这一方案下的动作生成接口差异。由此推出的,例如“某类模型在 L3 上表现差”,只能理解为“在其冻结表征之上只训练动作头时表现差”,不能直接推广到端到端微调后的同一模型。失败究竟来自表征里没有意图信息,还是动作头没能利用它,在这一设置下无法区分。附录提到早期解冻实验中各方都有“相近的提升”,但没有给出数字,因此冻结对各类模型的影响是否真的对称,目前只是定性说法。
原文
VLA models (GR00T-N1.6 (Bjorck et al., 2025), RDT-1B (Liu et al., 2025), \pi_{0.5} (Intelligence et al., 2025), OpenVLA (Kim et al., 2024)) are language-conditioned, so the fixed captioner T(V) of Section 3.2.2 supplies the prompt. Skill-based models (XSkill (Xu et al., 2023), UniSkill (Kim et al., 2025)) learn shared human-robot skill representations and act on the retrieved skill. Vision-action models (ACT (Zhao et al., 2023), Diffusion Policy (Chi et al., 2025), VQ-BeT (Lee et al., 2024)) gain video conditioning by concatenating a task embedding from one of three frozen encoders (DINOv2-ViT-L/14 (Oquab et al., 2023), SigLIP2-SO400M (Tschannen et al., 2025), VideoMAE-Large (Tong et al., 2022)) to the observation tokens. Per-family mechanisms, encoders, and recipes are in Appendix B.4.
译文
VLA 模型(GR00T-N1.6(Bjorck et al., 2025)、RDT-1B(Liu et al., 2025)、\pi_{0.5}(Intelligence et al., 2025)、OpenVLA(Kim et al., 2024))是语言条件的,因此由第 3.2.2 节的固定描述生成器 T(V) 提供提示词。基于技能的模型(XSkill(Xu et al., 2023)、UniSkill(Kim et al., 2025))学习人与机器人共享的技能表征,并根据检索到的技能执行动作。视觉—动作模型(ACT(Zhao et al., 2023)、Diffusion Policy(Chi et al., 2025)、VQ-BeT(Lee et al., 2024))通过把三种冻结编码器之一(DINOv2-ViT-L/14(Oquab et al., 2023)、SigLIP2-SO400M(Tschannen et al., 2025)、VideoMAE-Large(Tong et al., 2022))给出的任务嵌入拼接到观测 token 上,获得视频条件能力。各类别的具体机制、编码器和训练配方见附录 B.4。
解释
三类方法代表了“把人类视频变成机器人动作”的三种思路。VLA 走“视频 \to 文字 \to 动作”:先由人和 VLM 把视频说成话,再交给擅长听指令的大模型。技能类走“视频 \to 技能 \to 动作”:XSkill 用自监督对比学习和 Sinkhorn–Knopp 聚类从人和机器人视频中发现共享的技能原型,UniSkill 通过预测未来帧学习与本体无关的技能表征,再让策略按检索到的技能执行。视觉—动作类(原文缩写为 VA)走“视频 \to 向量 \to 动作”:用通用视觉编码器把视频压成一个向量,拼在观测后面,由 ACT(动作分块 Transformer)、Diffusion Policy(扩散生成动作)或 VQ-BeT(向量量化后的行为 Transformer)输出动作。三种编码器的差异也有讲究:DINOv2 是纯图像自监督特征,擅长空间和物体结构;SigLIP2 是图文对比学习特征,带语义;VideoMAE 是视频掩码自编码器,带时间动态。3 种编码器 \times 3 个动作头构成附录中考察的网格,可以分开回答“编码器重要还是动作头重要”。
原文
The protocol does not favor any kind of model. By spanning language-conditioned generation (VLA), cross-embodiment skill retrieval, and video-conditioned action regression (VA) through the same interface, on identical data and identical episodes, the Arena is insensitive to the architectural paradigm under test. Whether any current paradigm closes the gap between trajectory-level imitation at L0 and intent-level affordance adaptation at L3 is the empirical question taken up in Section 4.
译文
该协议不偏向任何一类模型。通过同一接口、在完全相同的数据和完全相同的回合上,覆盖语言条件生成(VLA)、跨本体技能检索和视频条件动作回归(VA),竞技场对所测试的架构范式不敏感。当前是否有某种范式能够弥合 L0 的轨迹级模仿与 L3 的意图级可供性适配之间的差距,正是第 4 节要回答的实证问题。
解释
这段是本节的收束,并引出第 4 节。“不偏向任何模型”成立的部分是:数据、评测回合、评分方式完全相同,层级对模型和评审都隐藏,人评匿名且随机左右顺序。但结合前面的分析,有两点使这一说法应打折扣理解。其一,“相同接口”之下,各范式读取 V 的方式本身是作者选定的适配(人工核对的文字描述、四帧 256 维向量、技能检索),这些转换的质量会直接影响结果,而它们并不对称:文字描述显式写出了意图,向量通道则丢失了大量时序细节。其二,冻结骨干使比较只涉及动作生成接口,预训练动作先验的差异仍然存在。因此更稳妥的读法是:在“冻结表征 + 作者设计的适配器”这一受控设置下,各范式之间的比较是公平的。至于“从 L0 到 L3 的差距”,后文表 5 的真机平均成功率从 L0 的 0.42 降到 L3 的 0.29,可以先作为预期。
4实验(Experiments)
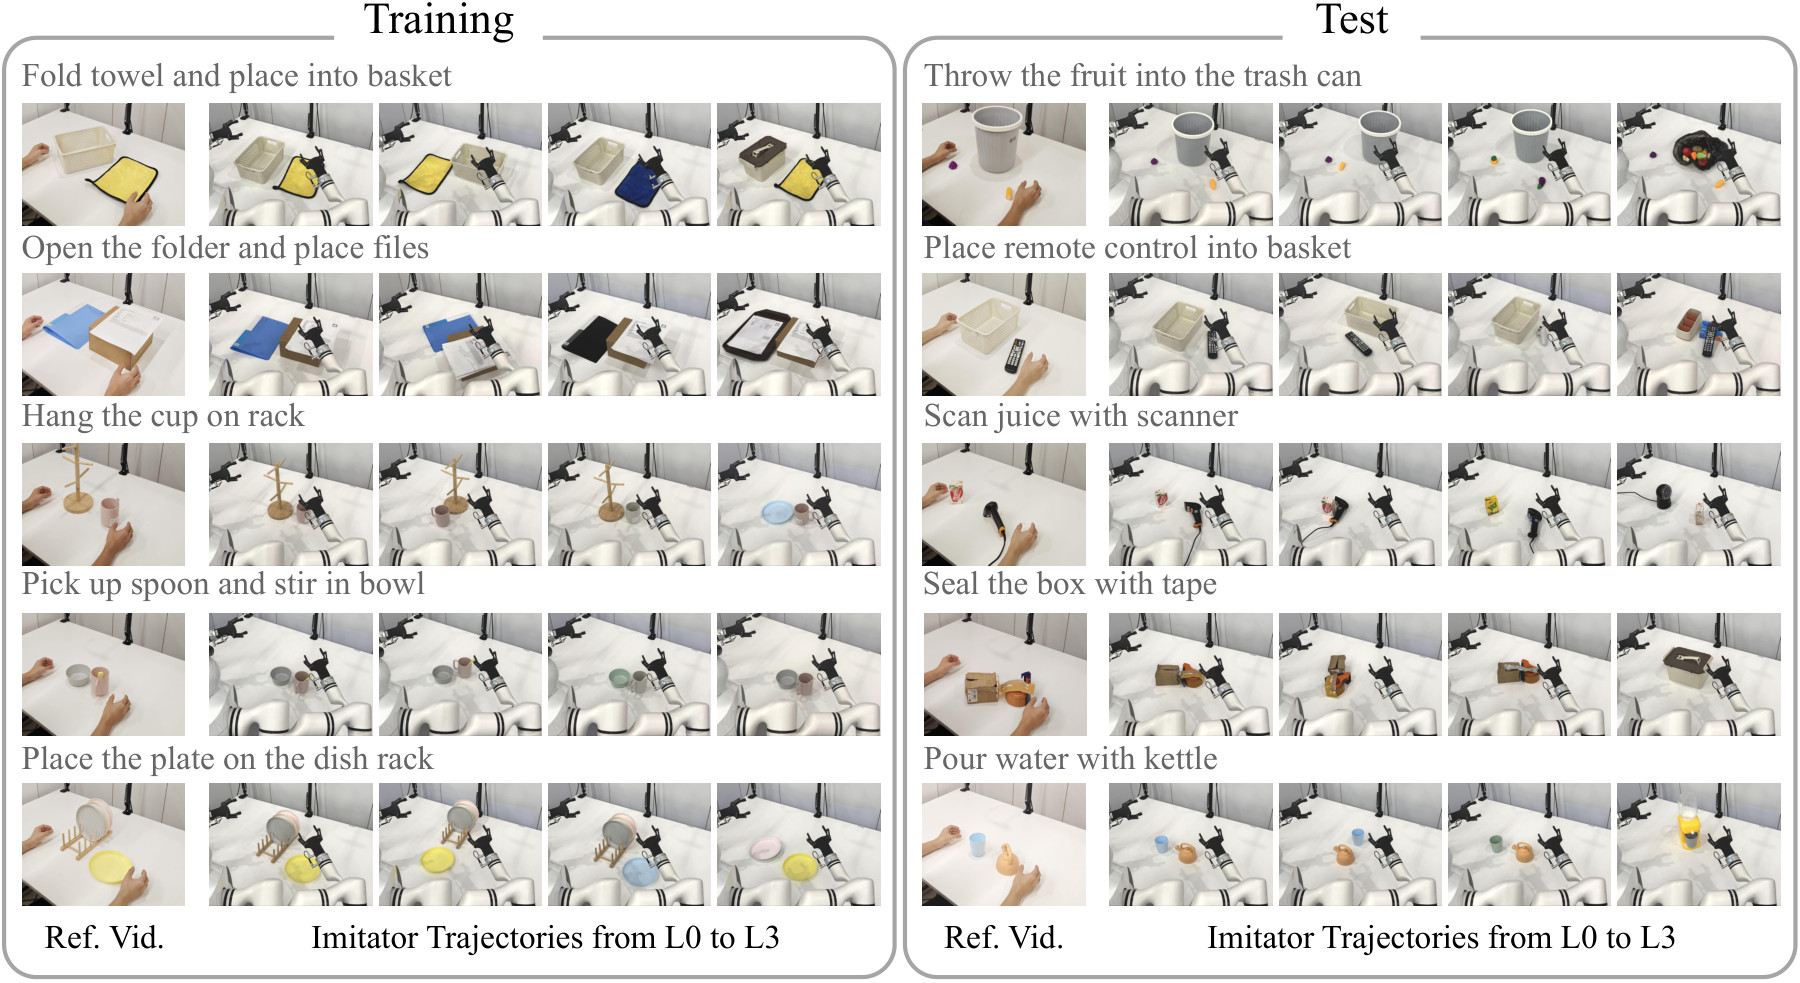
图 4:实验概览。评估覆盖训练任务(左)和留出的测试任务(右)。每个任务的第一幅图是人类参考视频,其后是场景失配程度从 L0 递增到 L3 时具有代表性的模仿者轨迹。真机评估包括已见任务模仿、未见任务的零样本迁移、少样本适应以及 Arena 人工评判。
原图注:The experiment. Evaluation spans training tasks (left) and held-out test tasks (right). For each task, the first image shows the human reference video, followed by representative imitator trajectories under increasing scene mismatch from L0 to L3. The real-world evaluation covers seen-task imitation, unseen zero-shot transfer, few-shot adaptation, and Arena human judgments.
图 4 解读
图分左右两个面板。左面板标题为 Training(训练任务,即后文的 seen 任务),五行依次是“叠毛巾并放入篮子”(Fold towel and place into basket)、“打开文件夹并放入文件”(Open the folder and place files)、“把杯子挂到架子上”(Hang the cup on rack)、“拿起勺子在碗里搅拌”(Pick up spoon and stir in bowl)、“把盘子放到碗碟架上”(Place the plate on the dish rack)。右面板标题为 Test(留出任务,即后文的 unseen 任务),五行依次是“把水果扔进垃圾桶”“把遥控器放进篮子”“用扫码器扫果汁”“用胶带封箱”“用水壶倒水”。每行最左一格(Ref. Vid.)是人手在桌面上操作的参考视频截图,其后四格是双臂机器人在 L0、L1、L2、L3 四个层级场景里的执行画面。以叠毛巾这一行为例:L0 与参考视频的物体和摆放相同;L1 把毛巾和篮子的位置调换;L2 把黄色毛巾换成同类但外观不同的蓝色毛巾;L3 则换成需要“改变用法”才能达成同一意图的物体(例如用不同的容器代替篮子)。这正是第 3 节定义的层级:从轨迹一致,到终态一致、语义一致,再到可供性(affordance)替代下的意图一致。这张图的作用是把下文的任务集合具体化。需要留意,图中左面板的任务名与 4.1 节正文列举的 seen 任务并不完全对得上:正文写的是“用细勺搅拌、叠毛巾、把杯子挂到架上、拿起一张纸、把盘子放进架子”,其中“拿起一张纸”(pick up a paper)在图里对应的是“打开文件夹并放入文件”。右面板的五个任务中,“用扫码器扫果汁”也很难归入正文所说的“单臂与双臂放置、倾倒以及一个铰接折叠任务”这几类(“封箱”大概对应“铰接折叠”)。这些属于原文描述上的小不一致,以图中的任务名为准更具体。
原文
We evaluate human-video imitation along three axes: (Q1) the relative strength of VLAs, video-skill methods, and video-conditioned visuomotor agents, (Q2) whether paired human–robot pretraining improves unseen-task transfer, and (Q3) where the L0–L3 hierarchy becomes difficult. Across simulation, real-world rollouts, and Imitator Arena judgments, we find that video-based methods provide the strongest seen-task imitation, paired pretraining mainly improves few-shot adaptation rather than direct zero-shot transfer, and L3 affordance substitution is the clearest bottleneck.
译文
我们沿三个维度评估从人类视频中模仿的能力:(Q1)VLA、视频技能方法和视频条件视觉运动智能体三者的相对强弱;(Q2)成对的人—机器人预训练能否改善向未见任务的迁移;(Q3)L0–L3 层级在哪一级变得困难。综合仿真、真机执行(rollout)和 Imitator Arena 的人工评判,我们发现:基于视频的方法在已见任务模仿上最强;成对预训练主要改善的是少样本适应,而不是直接的零样本迁移;L3 的可供性替代(affordance substitution)是最明显的瓶颈。
解释
这一段先把整节的三个问题和三个结论摆出来,后面 4.2、4.3、4.4 三个小节分别回答 Q1、Q2、Q3。三类被比较的方法对应第 3 节的统一接口 a_t=\pi(V,o_t):VLA 先把人类视频 V 用固定的描述器转成文字指令,再按语言条件生成动作;视频技能方法(XSkill、UniSkill)从视频里抽取跨本体的“技能”表示;视频条件视觉运动模型(论文称 Video-VA,即 ACT、Diffusion Policy、VQ-BeT 配上冻结的视频编码器)直接把视频嵌入拼进观测里回归动作。所以 Q1 本质上是在问:把人类示范交给机器人时,用“语言”作为中介好,还是直接用“视频”好。三个结论各有前提,读后文时值得对照。第一条“视频方法在已见任务上最强”在仿真里由 ACT/DINOv2(0.81)和 XSkill(0.79)支撑,真机由 XSkill 支撑;第二条“预训练主要帮少样本”来自 P+FT 与 Scr. 的差值 \Delta;第三条“L3 是瓶颈”只在真机 P+FT 设定下用 4 个模型的平均值论证,后文表 5 会显示这个结论主要由 XSkill 一个模型拉动。
4.1实验设置
原文
Tasks and protocol. We evaluate ten manipulation tasks across the L0–L3 hierarchy: five seen tasks from the training set, and five disjoint unseen tasks for zero-shot or few-shot transfer. The two evaluation groups are chosen to probe different things. The five seen tasks are the long-horizon or dexterous manipulation tasks – stirring with a thin spoon, folding a towel, hanging a mug on a rack, pick up a paper, placing plates in a rack – and ask how faithfully a model reproduces demanding learned behavior given a human reference. The five unseen tasks are relatively simpler and closer to atomic skills (single-arm and bimanual placement, pouring, and an articulated folding task), but their demonstrations, objects, and layouts never appear training set, so they ask whether a new skill can be acquired from the reference alone. Both groups are run at all four levels, giving 40 task–level pairs per domain.
译文
任务与协议。我们在 L0–L3 层级上评估十个操作任务:五个来自训练集的已见(seen)任务,以及五个与之不相交、用于零样本或少样本迁移的未见(unseen)任务。两组评估任务的选取目的不同。五个已见任务是长时程或需要灵巧操作的任务——用细勺搅拌、叠毛巾、把杯子挂到架子上、拿起一张纸、把盘子放进架子——考察的是给定人类参考时,模型能多忠实地复现有难度的、已学过的行为。五个未见任务相对简单,更接近原子技能(单臂与双臂放置、倾倒,以及一个铰接物体的折叠任务),但它们的示范、物体和布局从未出现在训练集中,因此考察的是能否仅凭参考视频习得一项新技能。两组任务都在全部四个层级上运行,每个域(domain)共有 40 个任务—层级组合。
解释
40 的来历是 10 个任务 \times 4 个层级 =40,仿真域和真机域各有一套。两组任务的设计有意“错位”:已见任务难但学过,考的是复现精度;未见任务简单但没学过,考的是习得能力。这样安排的好处是两种能力不会混在一起,坏处是已见与未见的分数不能直接相减来衡量“泛化损失”,因为任务难度本身就不同。原文“never appear training set”漏了介词 in,属笔误。任务名与图 4 的对应问题已在图 4 解读中说明。
原文
Episodes are balanced across levels; example clips are shown in Figure 4. Task evaluation perturbs object placements, so success requires robust imitation rather than fixed-layout replay. Simulation and the real-world robot scene are two separate domains in IG-10K, and each model is trained and evaluated inside one domain only. But the sim and real domains share the same human-to-robot pairing, the same pretraining task split, and the same model configurations.
译文
各层级的回合(episode)数量是均衡的;示例片段见图 4。评估时会扰动物体摆放,因此成功需要稳健的模仿,而不是固定布局下的回放。仿真和真实机器人场景是 IG-10K 中两个相互独立的域,每个模型只在一个域内训练和评估。但仿真域和真机域共享相同的人—机器人配对方式、相同的预训练任务划分和相同的模型配置。
解释
“扰动物体摆放”是为了堵住一个捷径:如果测试时物体位置和训练时一模一样,策略只要背下一条轨迹就能成功,这就测不出模仿能力。“两个独立的域”意味着本文没有做仿真到真机(sim-to-real)的迁移,仿真结果和真机结果是两次平行实验;之所以仍能对照,是因为两边的数据配对、任务划分和超参数一致。“回合均衡”保证了后面按层级求平均时,每个层级的权重相同,表 5 的各层级平均值恰好能还原表 4 的 P+FT 总体数字,可以作为这一点的旁证(见表 5 解读)。
原文
IG-10K pretraining & transfer. When using IG-10K pretraining, we pretrain on paired human-robot corpora of 15, 30, or 45 tasks (15 \subset 30 \subset 45, and each budget was assembled to hold motion, object, and scene diversity as comparable as possible, so the corpus size is the main thing to be considered in scaling), 50 demonstrations per task are included in pretraining and excluding all unseen tasks. The task splits are given in Appendix B.2. We evaluate seen tasks with models pre-trained on the three corpora.
译文
IG-10K 预训练与迁移。使用 IG-10K 预训练时,我们在包含 15、30 或 45 个任务的成对人—机器人语料上预训练(15 \subset 30 \subset 45;每档规模在组建时都尽量让动作、物体和场景的多样性保持可比,因此扩展实验中主要考虑的变量就是语料规模)。预训练中每个任务包含 50 条示范,并排除所有未见任务。任务划分见附录 B.2。已见任务用在这三档语料上预训练的模型分别评估。
解释
三档语料是嵌套的(15\subset30\subset45),所以从 15 到 45 的变化只是“加任务”,不会同时换掉原有任务,这让“规模越大是否越好”(Q2)的比较更干净。按每任务 50 条示范算,三档语料分别约有 750、1500、2250 条成对示范。按理已见任务应包含在最小的 15 任务语料里,否则对 15 任务模型而言它们就不算“已见”(原文未明说)。后面表 3 和表 4 的 Seen、ZS、P+FT 三列都是这三档规模的平均值,规模随参数变化的细节放在附录图 10 和表 9。
原文
For unseen tasks we evaluate three settings: zero-shot transfer (ZS), in which pre-trained models directly execute on unseen tasks without any further parameter updates; from-scratch few-shot learning (Scr.), in which models are trained only on 10 robot demonstrations of the five unseen tasks; and pre-train and fine-tune (P+FT), in which IG-10K-pre-trained models are fine-tuned on unseen tasks and 10 demonstrations per task. Every level receives the same amount of supervision.
译文
对未见任务,我们评估三种设定:零样本迁移(ZS),即预训练模型不做任何参数更新、直接在未见任务上执行;从头少样本学习(Scr.),即模型只用五个未见任务的 10 条机器人示范训练;预训练加微调(P+FT),即在 IG-10K 上预训练过的模型再用未见任务、每任务 10 条示范进行微调。每个层级获得的监督量相同。
解释
三种设定构成一组对照。ZS 只有预训练、没有目标任务数据;Scr. 只有目标任务数据、没有预训练;P+FT 两者都有。于是 P+FT 与 Scr. 之差 \Delta=\text{P+FT}-\text{Scr.} 衡量的是“预训练带来的净收益”,而 ZS 衡量的是“不给任何目标数据时,光看参考视频能做到多少”。Scr. 不涉及预训练,所以它没有 15/30/45 三档之分,表中的 Scr. 是单一数字。“10 robot demonstrations of the five unseen tasks”这句有歧义,既可读成五个任务共 10 条,也可读成每任务 10 条;P+FT 一句明确写了“每任务 10 条”,而对照实验应当用同样的数据,所以 Scr. 也应理解为每任务 10 条。“每个层级获得的监督量相同”是说微调数据在 L0–L3 之间均匀分配,否则某一层级的分数高低可能只是因为它分到了更多示范。
原文
Baselines & evaluation. We compare: (1) language-conditioned VLAs (GR00T-N1.6, RDT-1B, \pi_{0.5}, OpenVLA), (2) video-skill methods (XSkill, UniSkill), and (3) video-conditioned visuomotor models (ACT, Diffusion Policy, VQ-BeT) paired with DINOv2, SigLIP2, or VideoMAE encoders. Simulation evaluates all policies and variants using success rate (SR) and sub-goal success rate (Sub-SR).
译文
基线与评估。我们比较:(1)语言条件的 VLA(GR00T-N1.6、RDT-1B、\pi_{0.5}、OpenVLA);(2)视频技能方法(XSkill、UniSkill);(3)视频条件的视觉运动模型(ACT、Diffusion Policy、VQ-BeT),分别搭配 DINOv2、SigLIP2 或 VideoMAE 编码器。仿真中对所有策略及其变体都用成功率(SR)和子目标成功率(Sub-SR)评估。
解释
变体总数是 4+2+3\times3=15,这就是后文“15 个仿真变体”的来源。第三类的三个动作头与三个编码器两两交叉,可以把“动作生成方式”和“视频表示”两个因素分开看。三种编码器的性质不同:DINOv2 是自监督的图像特征,SigLIP2 是图文对比学习的图像特征,VideoMAE 是视频掩码重建得到的时空特征。按附录,所有这些编码器以及 VLA 的视觉—语言主干都是冻结的,只训练动作生成部分,目的是让各类方法的适应预算可比。Sub-SR 给部分完成的任务以分数(例如叠了毛巾但没放进篮子),比只看最终成败的 SR 更细,因此表 3 中 Sub 普遍高于 SR。
原文
Four representative models (\pi_{0.5}, XSkill, ACT/DINOv2, and DP/DINOv2) on a dual-arm platform are evaluated in the real world, with 5 trials per task-level pair against 10 trials in simulation. Imitator Arena further provides human success judgments, imitation score Q, and pairwise win rate (WR). Appendix Figure 13 provides the alignment and validation of the two evaluation metrics.
译文
在真实世界中,我们在一个双臂平台上评估四个代表性模型(\pi_{0.5}、XSkill、ACT/DINOv2 和 DP/DINOv2),每个任务—层级组合做 5 次试验,仿真中则为 10 次。Imitator Arena 进一步提供人工的成功判定、模仿分数 Q 和两两比较的胜率(WR)。附录图 13 给出了两种评估指标之间的对齐与验证。
解释
四个代表模型的选择覆盖了三类方法:\pi_{0.5} 代表 VLA,XSkill 代表技能方法,ACT 和 DP 代表 Video-VA(都用 DINOv2)。真机每个任务—层级组合只做 5 次,统计不确定性需要心里有数。以 P+FT 的某一层级为例,5 个未见任务 \times 5 次 \times 3 档规模 =75 次试验;表 5 里的每个数恰好都能写成 k/75(如 0.53\approx40/75、0.29\approx22/75),与此吻合。当 SR 在 0.4 附近时,二项分布的标准误约为 \sqrt{0.4\times0.6/75}\approx0.057,95\% 置信区间宽约 \pm0.11。也就是说,真机表格里相差 0.05 左右的两个数基本无法区分。仿真每组合 10 次、再乘 3 档规模,样本量是真机的两倍,但同样不宜过度解读 0.01\sim0.02 的差别。三个人工指标的含义在 3.2.2 节和附录 B.3 中定义:人工 SR 只把评审判为“成功”的执行计为成功(“部分完成”不算);Q\in[0,10] 是按五档锚点打的模仿质量分,表中的 \overline{Q} 是其平均;WR 来自盲测 A/B 比较,每屏偏好者得 1 分、平局各得 0.5 分,模型的 WR 是它参与的所有屏的平均得分。真机上没有自动指标,SR 只能来自人工判定。
4.2Q1:哪种模仿接口最强?
表 3:仿真结果。Seen、ZS 和 P+FT 为 \{15,30,45\} 三档任务规模上的平均值。Seen = 五个训练任务;ZS = 在未见任务上的零样本评估;Scr. = 不经 IG-10K 预训练、只用未见任务的 10 条示范从头训练;P+FT = 先在 IG-10K 上预训练,再用同样的 10 条示范微调;\Delta = \text{P+FT} - \text{Scr.};Sub = 子目标成功率。
| 已见(Seen) | ZS | Scr. | P+FT | \Delta | |||||||
| 模型 | SR | Sub | SR | Sub | SR | Sub | SR | Sub | SR | Sub | |
| VLA | OpenVLA (Kim et al., 2024) | 0.29 | 0.60 | 0.06 | 0.20 | 0.14 | 0.34 | 0.20 | 0.44 | +0.06 | +0.10 |
| RDT-1B (Liu et al., 2025) | 0.43 | 0.72 | 0.07 | 0.19 | 0.35 | 0.55 | 0.21 | 0.43 | -0.14 | -0.11 | |
| GR00T-N1.6 (Bjorck et al., 2025) | 0.51 | 0.81 | 0.03 | 0.17 | 0.21 | 0.49 | 0.67 | 0.79 | +0.46 | +0.31 | |
| \pi_{0.5} (Intelligence et al., 2025) | 0.73 | 0.89 | 0.09 | 0.22 | 0.80 | 0.86 | 0.85 | 0.91 | +0.05 | +0.04 | |
| Skill | UniSkill (Kim et al., 2025) | 0.75 | 0.89 | 0.07 | 0.17 | 0.27 | 0.46 | 0.59 | 0.76 | +0.32 | +0.30 |
| XSkill (Xu et al., 2023) | 0.79 | 0.91 | 0.10 | 0.25 | 0.35 | 0.51 | 0.73 | 0.82 | +0.38 | +0.31 | |
| Video-VA | DP/DINOv2 (Chi et al., 2025; Oquab et al., 2023) | 0.67 | 0.84 | 0.07 | 0.21 | 0.13 | 0.36 | 0.54 | 0.73 | +0.41 | +0.37 |
| DP/SigLIP2 (Tschannen et al., 2025) | 0.61 | 0.84 | 0.05 | 0.20 | 0.11 | 0.35 | 0.48 | 0.69 | +0.38 | +0.34 | |
| DP/VideoMAE (Tong et al., 2022) | 0.14 | 0.44 | 0.02 | 0.15 | 0.09 | 0.27 | 0.36 | 0.58 | +0.27 | +0.31 | |
| VQ-BeT/DINOv2 (Lee et al., 2024) | 0.52 | 0.76 | 0.13 | 0.27 | 0.35 | 0.53 | 0.23 | 0.43 | -0.12 | -0.10 | |
| VQ-BeT/SigLIP2 | 0.57 | 0.78 | 0.08 | 0.23 | 0.26 | 0.46 | 0.17 | 0.34 | -0.08 | -0.11 | |
| VQ-BeT/VideoMAE | 0.30 | 0.51 | 0.07 | 0.21 | 0.14 | 0.36 | 0.15 | 0.33 | +0.01 | -0.04 | |
| ACT/DINOv2 (Zhao et al., 2023) | 0.81 | 0.93 | 0.02 | 0.13 | 0.76 | 0.83 | 0.84 | 0.88 | +0.09 | +0.05 | |
| ACT/SigLIP2 | 0.79 | 0.93 | 0.03 | 0.12 | 0.65 | 0.78 | 0.80 | 0.86 | +0.15 | +0.08 | |
| ACT/VideoMAE | 0.72 | 0.88 | 0.04 | 0.14 | 0.63 | 0.76 | 0.82 | 0.87 | +0.19 | +0.12 | |
原表注:Simulation results. Seen, ZS, and P+FT are averaged over the \{15,30,45\} task scales. Seen = the five training tasks; ZS = zero-shot evaluation on unseen tasks; Scr. = trained from scratch on 10 demonstrations of the unseen task, without IG-10K pre-training; P+FT = IG-10K pre-trained and then fine-tuned on the same 10 demonstrations; \Delta = \text{P+FT} - \text{Scr.}; Sub = sub-goal success rate.
表 3 解读
结构。行按三类方法分组:VLA(4 个)、Skill(2 个)、Video-VA(3 个动作头 \times 3 个编码器 =9 个),共 15 个变体。列分五组,每组给 SR 与 Sub-SR 两个数:Seen 是已见任务上的表现,ZS、Scr.、P+FT 是未见任务在三种设定下的表现,\Delta 是 P+FT 减 Scr.。黄底加粗是组内最优,不是全表最优:例如 Seen 列里 \pi_{0.5} 的 0.73 在 VLA 组最高,但低于 Skill 组和 Video-VA 组的最优者。Video-VA 组在 ZS 列标出的是 VQ-BeT/DINOv2,在其余列标出的是 ACT/DINOv2。数字核对。逐行计算 P+FT - Scr.,\Delta 列全部对得上,只有若干项差 0.01(如 RDT-1B 的 Sub 为 0.43-0.55=-0.12,表中写 -0.11;GR00T 的 Sub 为 0.79-0.49=0.30,表中写 +0.31;ACT/DINOv2 的 SR 为 0.84-0.76=0.08,表中写 +0.09),这可以用“先用未四舍五入的值相减再取两位”解释,不构成矛盾。\Delta_{\text{SR}}>0 的变体有 12 个,三个负值是 RDT-1B(-0.14)、VQ-BeT/DINOv2(-0.12)和 VQ-BeT/SigLIP2(-0.08),与正文“15 个中有 12 个 P+FT 胜过 Scr.”一致。不过其中 VQ-BeT/VideoMAE 只是 +0.01,而且它的 Sub 差为 -0.04,算“胜出”相当勉强。主要读数。第一,Seen 列整体很高,最好的 ACT/DINOv2 达到 0.81,XSkill 与 ACT/SigLIP2 并列 0.79,UniSkill 0.75,而 VLA 中最好的 \pi_{0.5} 为 0.73。第二,ZS 列全部贴近地板:最高的 VQ-BeT/DINOv2 也只有 0.13,这就是摘要所说零样本“低于 13%”的出处(严格说最高值等于 0.13,而不是低于它)。第三,ZS 和 Seen 的排名几乎不相关:ACT/DINOv2 在 Seen 上第一,在 ZS 上只有 0.02,与 DP/VideoMAE 并列倒数第一;ACT 的三个变体 ZS 都只有 0.02–0.04。这说明 ACT 在训练任务上依赖的是对已见视频嵌入的拟合,一旦参考视频来自没见过的任务,冻结编码器给出的嵌入落在训练分布之外,动作头就不知道该做什么;同样用 DINOv2 嵌入的 VQ-BeT 反而在 ZS 上最好,说明零样本的瓶颈不只在编码器,也在动作头如何使用这个嵌入。第四,\pi_{0.5} 和 ACT 系的 Scr. 本来就很高(0.63–0.80),所以 \Delta 小;\Delta 大的是 Scr. 起点低的模型(GR00T、XSkill、UniSkill、DP 系),预训练的收益很大程度上取决于“不预训练时有多差”。
原文
Table 3 and 4 report the comprehensive performance in sim and real. The results suggest that video-based pipelines are stronger for seen-task imitation but pre-training matters in few-shot learning. In simulation, ACT/DINOv2 achieves the highest success rate (SR =0.81, Sub-SR =0.93), with XSkill and ACT/SigLIP2 close behind in seen-task evaluation; the strongest language-conditioned VLA, \pi_{0.5}, is lower (SR =0.73) in seen tasks but leads in few-shot adaptation (SR =0.80 in Scr. and SR =0.85 in P+FT). Appendix Figure 8 gives an intuitive view of comprehensive simulation model performance.
译文
表 3 和表 4 分别报告了仿真和真机上的综合性能。结果表明,基于视频的流程在已见任务模仿上更强,而预训练在少样本学习中很重要。在仿真中,ACT/DINOv2 的成功率最高(SR =0.81,Sub-SR =0.93),XSkill 和 ACT/SigLIP2 在已见任务评估中紧随其后;最强的语言条件 VLA \pi_{0.5} 在已见任务上较低(SR =0.73),但在少样本适应中领先(Scr. 中 SR =0.80,P+FT 中 SR =0.85)。附录图 8 直观展示了仿真中各模型的综合表现。
解释
这些数字都能在表 3 中逐一找到。“紧随其后”的 XSkill 和 ACT/SigLIP2 都是 0.79,比 ACT/DINOv2 只低 0.02,按每个设定约 600 次仿真试验(5 任务 \times 4 层级 \times 10 次 \times 3 档规模)估算,SR 在 0.8 附近的标准误约为 \sqrt{0.8\times0.2/600}\approx0.016,这个差距在统计上并不显著,所以更稳妥的说法是“三者并列第一梯队”。\pi_{0.5} 在少样本上领先的幅度也不大:P+FT 中 0.85 对 ACT/DINOv2 的 0.84;Scr. 中 0.80 对 0.76。一个值得注意的现象是:\pi_{0.5} 和 ACT 系在已见任务上表现相近,在少样本任务上也都很强,但前者是语言条件、后者是视频条件。这说明“视频接口更强”的结论主要体现在已见任务上,并且 VLA 内部差异很大(OpenVLA 已见只有 0.29),不能一概而论地说语言接口弱。
原文
In the real-world Arena, XSkill gives the strongest human-judged imitation among the representative models across all settings (SR =0.63 in Seen, SR =0.29 in ZS, SR =0.28 in Scr., SR =0.49 in P+FT), and video-based models constantly beat language-based models in Zero-shot transfer. Within Video-VA, DINOv2 and SigLIP2 are consistently stronger than VideoMAE (Appendix Figure 9), indicating that the video representation is also an important design choice.
译文
在真实世界的 Arena 中,XSkill 在所有设定下都给出了代表模型中最强的人工评判模仿表现(Seen 中 SR =0.63,ZS 中 SR =0.29,Scr. 中 SR =0.28,P+FT 中 SR =0.49),并且在零样本迁移中,基于视频的模型始终胜过基于语言的模型。在 Video-VA 内部,DINOv2 和 SigLIP2 始终强于 VideoMAE(附录图 9),这表明视频表示也是一个重要的设计选择。
解释
这段有三处说法比数据更绝对,对照表 3、表 4 可以看出。其一,“XSkill 在所有设定下最强”按 SR 成立,但按人工模仿分 \overline{Q} 并不成立:Scr. 中 \pi_{0.5} 的 \overline{Q}=5.52 高于 XSkill 的 5.40,ZS 中 ACT/DINOv2 的 \overline{Q}=5.44 高于 XSkill 的 5.24(表 4 自己也把这两格加粗给了别的模型)。而且 Scr. 中 XSkill 的 SR 0.28 只比 \pi_{0.5} 的 0.27 高 0.01,在每个设定只有一两百次真机试验的情况下,这种差距完全在噪声以内。其二,“视频模型在零样本上始终胜过语言模型”只在真机成立:真机 ZS 中 \pi_{0.5} 的 SR 仅 0.04,三种视频模型为 0.22–0.29。但在仿真 ZS 中,\pi_{0.5} 的 0.09 高于 DP/DINOv2 的 0.07、ACT/DINOv2 的 0.02 以及全部三个 ACT 变体,只是低于 XSkill(0.10)和 VQ-BeT/DINOv2(0.13)。原文没有说明这句话只针对真机。其三,“DINOv2 和 SigLIP2 始终强于 VideoMAE”用表 3 的 SR 逐列检查,有两处例外:ACT 的 ZS 中 VideoMAE 为 0.04,高于 DINOv2 的 0.02 和 SigLIP2 的 0.03;ACT 的 P+FT 中 VideoMAE 为 0.82,高于 SigLIP2 的 0.80。不过这两处差距都很小,而 DP 的已见任务(0.67/0.61 对 0.14)和 VQ-BeT 的已见任务(0.52/0.57 对 0.30)差距悬殊,所以大趋势成立。合理的解释是 DINOv2、SigLIP2 是逐帧的强语义图像特征,而这里的视频嵌入只取四帧,VideoMAE 的时空重建特征在这么少的帧上未必占优。
4.3Q2:规模能否改善零样本迁移或少样本适应?
原文
In simulation, paired pretraining mainly supports few-shot adaptation. Zero-shot performance remains near the floor across paradigms, with the best simulation result reaching only \mathrm{SR}=0.13. Current frameworks still struggle to generalize to unseen tasks without task-specific robot data. In contrast, P+FT improves few-shot learning for most models, with benefits growing with scale: from 15 to 45 pretraining tasks, P+FT success improves for 14 of 15 simulation variants (Appendix Figure 10), and P+FT wins over Scr. for 12 of the 15 simulation variants (Table 3).
译文
在仿真中,成对预训练主要支撑的是少样本适应。各类范式的零样本表现都停留在接近地板的水平,仿真中的最好结果也只有 \mathrm{SR}=0.13。现有框架在没有任务特定机器人数据的情况下,仍难以泛化到未见任务。相比之下,P+FT 改善了大多数模型的少样本学习,而且收益随规模增长:从 15 个预训练任务增加到 45 个时,15 个仿真变体中有 14 个的 P+FT 成功率提高(附录图 10),并且 15 个仿真变体中有 12 个的 P+FT 胜过 Scr.(表 3)。
解释
这里有两个不同的“计数”,不要混淆。“15 个中有 14 个提高”比较的是同一模型在不同预训练规模下的 P+FT,数据在附录图 10,正文表格只给三档平均,无法直接核对;“15 个中有 12 个胜过 Scr.”比较的是有无预训练,可以从表 3 的 \Delta 列直接数出(三个负值见表 3 解读)。前者说明“数据越多越容易适应”,后者说明“有预训练比没有好”,两者合起来才支撑“预训练主要帮少样本”的结论。零样本“接近地板”可以这样量化:表 3 的 ZS SR 中位数约为 0.07,15 个变体里只有 VQ-BeT/DINOv2(0.13)和 XSkill(0.10)达到 0.10。与之对照,P+FT 的中位数约为 0.54。也就是说,同样的预训练模型,只要再给每个任务 10 条机器人示范,成功率就能从个位数百分比跳到一半左右。这说明预训练学到的东西是“容易被少量数据激活的先验”,而不是“看一眼参考视频就能执行的能力”。
原文
In the real-world evaluation, all four representative models improve in the same way in few-shot adaptation, and the three video-conditioned ones also gain some zero-shot ability as the corpus grows, while the language-conditioned \pi_{0.5} does not (Appendix Figure 10). According to Appendix C.4, Table 9, P+FT success rises from 15 to 45 pre-training tasks at every one of L0–L3, in both domains. Robust zero-shot imitation from human video remains difficult, but more paired data does make a model easier to adapt.
译文
在真实世界评估中,四个代表模型在少样本适应上都以同样的方式提升;随着语料增大,三个视频条件模型还获得了一定的零样本能力,而语言条件的 \pi_{0.5} 没有(附录图 10)。根据附录 C.4 的表 9,在两个域中,从 15 个到 45 个预训练任务,P+FT 的成功率在 L0–L3 的每一级上都有提升。从人类视频进行稳健的零样本模仿仍然困难,但更多的成对数据确实让模型更容易适应。
解释
真机上的这条观察可以和表 4 对照:ZS 列中 \pi_{0.5} 的 SR 只有 0.04,而三个视频条件模型为 0.22–0.29,差距比仿真大得多。一个可能的解释是,\pi_{0.5} 的任务信息全部来自描述器把视频转成的文字,对未见任务来说,这段文字描述的是一个从未与动作对应过的指令,模型没有途径把它落到动作上;而视频嵌入至少保留了物体和手部运动的视觉线索。不过真机 ZS 表现仍远低于 P+FT,而且每档规模每层级只有 25 次试验(5 任务 \times 5 次),附录中“随规模提升零样本能力”的曲线需要结合误差来看。
4.4Q3:层级在哪一级变难?
原文
We analyze the hierarchy in the real-world P+FT setting, where policies receive task-specific adaptation and are judged by humans. Table 5 shows the main difficulty appears at L3. Averaged over the four representative models, SR is nearly stable from L0 to L2 (around 0.4) but drops to 0.29 at L3; the human imitation score follows suit, falling from about 6.2 on L0–L2 to 5.62 on L3. This drop is clearest for the strongest L0–L2 policy: XSkill holds SR \approx 0.53–0.57 through L2 but falls to 0.29 at L3, while other policies show a flatter profile from a lower operating point. Current policies therefore cope with a rearranged layout, and with a replacement object of the same kind, but not with an object that has to be used in a different way to reach the same end.
译文
我们在真实世界的 P+FT 设定下分析层级,因为在这一设定中策略得到了任务特定的适应,并由人来评判。表 5 显示,主要困难出现在 L3。对四个代表模型取平均,SR 从 L0 到 L2 几乎稳定(约 0.4),到 L3 降到 0.29;人工模仿分也随之下降,从 L0–L2 的约 6.2 降到 L3 的 5.62。这一下降在 L0–L2 上最强的策略身上最明显:XSkill 在 L2 之前保持 SR \approx 0.53–0.57,到 L3 却跌到 0.29,而其他策略从较低的工作点出发,曲线更平缓。因此,当前策略能应付重新排列的布局,也能应付同类的替换物体,却应付不了需要换一种用法才能达到同一目的的物体。
解释
选 P+FT 设定来分析层级是有道理的:ZS 下所有模型都接近失败,层级之间拉不开差距;Seen 的任务本身很难,难度会和层级混在一起。P+FT 下各模型有中等水平的成功率,层级效应最容易显现。平均值可以从表 5 验算:L0 为 (0.44+0.53+0.37+0.33)/4=0.4175\approx0.42,L1 为 1.66/4\approx0.42,L2 为 1.55/4\approx0.39,L3 为 (0.28+0.29+0.33+0.25)/4=0.2875\approx0.29;\overline{Q} 依次为 6.26、6.22、6.17、5.62,与表中一致。但“L3 是瓶颈”这一结论主要由 XSkill 拉动。若把 XSkill 去掉,其余三个模型的平均 SR 依次为 0.38、0.36、0.33、0.29,是一条缓慢下降的曲线,L2 到 L3 只降了 0.04,并没有明显的断崖。逐个看:ACT/DINOv2 的 L3(0.33)与 L2(0.33)相同,\overline{Q} 甚至从 5.77 升到 5.83;DP/DINOv2 从 0.29 降到 0.25;\pi_{0.5} 从 0.37 降到 0.28,但它的 L1(0.35)已经低于 L2,层级曲线本身就不单调。只有 XSkill 从 0.56 跌到 0.29,下降 0.27。按每个层级 75 次试验估算,这个差值的标准误约为 \sqrt{0.56\times0.44/75+0.29\times0.71/75}\approx0.078,下降约为 3.5 个标准误,是可信的;而其他模型 L2 到 L3 的变化都在一个标准误左右,不能确定是真实下降。所以更准确的说法是:L3 对“在低层级上做得最好的模型”打击最大,把它拉回到与其他模型相同的水平(四个模型 L3 的 SR 都集中在 0.25–0.33),而不是所有模型都在 L3 断崖式下跌。最后一句的结论对应层级定义:L1 只换布局,L2 换成同类物体(几何、外观不同但用法相同),L3 则要求用不同的可供性完成同一意图,例如没有勺子时用别的工具搅拌。XSkill 的技能原型是从视频运动中聚类出来的,同类物体的运动模式相近,所以 L1、L2 不受影响;L3 需要改变动作方式,从示范里检索出的技能就不再适用,这可以解释它在 L3 的暴跌。
表 4:真实世界 Arena 结果,同时包含已见任务表现和未见任务迁移。Seen、ZS 和 P+FT 为 \{15,30,45\} 三档任务规模上的平均值。各设定含义同表 3。\overline{Q} = 按附录 B.3 的 0–10 评分细则给出的人工模仿分均值;WR = 盲测 A/B 比较中的胜率。真机上没有自动指标,因此这里的 SR 是人工的成功判定。
| 已见(Seen) | ZS | Scr. | P+FT | \Delta | |||||||||||
| 模型 | SR | \overline{Q}\uparrow | WR \uparrow | SR | \overline{Q}\uparrow | WR \uparrow | SR | \overline{Q}\uparrow | WR \uparrow | SR | \overline{Q}\uparrow | WR \uparrow | SR | \overline{Q}\uparrow | WR \uparrow |
| \pi_{0.5} (Intelligence et al., 2025) | 0.51 | 6.87 | 0.56 | 0.04 | 2.34 | 0.04 | 0.27 | 5.52 | 0.50 | 0.36 | 5.89 | 0.73 | +0.09 | +0.37 | +0.23 |
| XSkill (Xu et al., 2023) | 0.63 | 7.49 | 0.89 | 0.29 | 5.24 | 0.50 | 0.28 | 5.40 | 0.52 | 0.49 | 6.72 | 0.95 | +0.21 | +1.32 | +0.43 |
| ACT/DINOv2 (Zhao et al., 2023; Oquab et al., 2023) | 0.49 | 6.70 | 0.41 | 0.26 | 5.44 | 0.42 | 0.22 | 5.38 | 0.24 | 0.35 | 5.88 | 0.70 | +0.13 | +0.50 | +0.46 |
| DP/DINOv2 (Chi et al., 2025) | 0.39 | 6.19 | 0.14 | 0.22 | 4.96 | 0.25 | 0.22 | 5.32 | 0.24 | 0.31 | 5.77 | 0.58 | +0.09 | +0.45 | +0.34 |
原表注:Real-world Arena results combining seen performance and unseen transfer. Seen, ZS, and P+FT are averaged over the \{15,30,45\} task scales. Settings as in Table 3. \overline{Q} = mean human imitation score on the 0–10 rubric of Appendix B.3; WR = win rate in blind A/B comparisons. On hardware there is no automated metric, so SR here is the human success judgment.
表 4 解读
结构。四行是四个代表模型,列分五组,每组三个人工指标:SR(人工判定的成功率)、\overline{Q}(0–10 的模仿质量分均值)、WR(盲测 A/B 胜率)。加粗为每列最优,下划线为次优,这次是在四个模型之间比较,不再按方法类别分组。\Delta 依然是 P+FT 减 Scr.,逐项验算全部吻合,例如 XSkill 的 \overline{Q} 为 6.72-5.40=1.32,ACT/DINOv2 的 WR 为 0.70-0.24=0.46。四个模型的 \Delta 全为正,即真机上预训练对四者都有帮助,这比仿真里 15 个中 12 个为正更整齐。读数。Seen 列中 XSkill 三项全第一(SR 0.63、\overline{Q} 7.49、WR 0.89),\pi_{0.5} 三项全第二,两个 Video-VA 模型反而落后,这与仿真中 ACT/DINOv2 居首不同,说明仿真排名不能直接外推到真机。ZS 列中 \pi_{0.5} 的 \overline{Q} 只有 2.34,远低于其他模型的 5 分左右,说明它在未见任务上往往连动作方向都不对,而不只是没完成。真机 ZS 的最高 SR 是 XSkill 的 0.29,远高于仿真 ZS 的最高值 0.13,所以摘要中“零样本低于 13%”只是仿真的数字。至于“XSkill 在所有设定下都最强”,按 SR 成立,按 \overline{Q} 有两处例外(Scr. 中 \pi_{0.5} 5.52 高于 5.40,ZS 中 ACT/DINOv2 5.44 高于 5.24),见 4.2 节第二段的解释。WR 不能跨列比较。WR 是一个相对指标:每屏只比较两个执行,总分为 1(偏好者得 1,平局各得 0.5)。如果同一列的模型参与的屏数大致相同,那么这一列 WR 的总和应约等于“参赛者数 / 2”。Seen 列四个模型的和为 0.56+0.89+0.41+0.14=2.00,正好等于 4/2,符合四个模型两两比较的结构。但 ZS 列的和是 0.04+0.50+0.42+0.25=1.21,P+FT 列的和是 0.73+0.95+0.70+0.58=2.96,都偏离 2。P+FT 列偏高可以由附录 B.3 的分桶规则解释:A/B 比较只在同一“桶”内进行,三个桶是 seen、zero-shot 和 transfer,而 Scr. 与 P+FT 同属 transfer 桶,互相配对。于是 P+FT 的高 WR 很大程度上来自“打赢了未预训练的 Scr. 版本”,Scr. 的 WR 则被压低(Scr. 列之和只有 1.50)。两列合计 1.50+2.96=4.46,接近 8 个参赛者对应的 4.0,剩余偏差可以用参赛屏数不均来解释(P+FT 有三档规模,可能参与的屏更多)。以上是根据分桶规则所做的推断,原文没有给出各模型的参与屏数。ZS 列则较难解释。平局会把 1 分平分给两边,并不改变每屏的总分,所以“平局较多”不能让总和低于 2。更关键的是,附录 B.3 写明真机的 5000 个 A/B 屏只分成 2500 个 seen 和 2500 个 transfer,没有 zero-shot 屏(仿真才有 3000 个 zero-shot 屏)。按这一说法,真机 ZS 列的 WR 不知从何而来,其总和 1.21 也不符合两两比较的结构。这是原文的一处不一致,ZS 列的 WR 最好只作参考。统计不确定性。Seen、ZS、P+FT 每格约为 5 任务 \times 4 层级 \times 5 次 \times 3 档规模 =300 次试验,SR 在 0.3–0.5 时标准误约 0.027–0.029;Scr. 若只跑一次则只有 100 次,标准误约 0.045。因此 Scr. 列中 0.27、0.28、0.22、0.22 之间的差距大多不显著,Seen 列中 ACT/DINOv2 的 0.49 与 \pi_{0.5} 的 0.51 也无法区分。
表 5:真实世界 P+FT 按层级的成功情况。\mathrm{SR} 和人工模仿分 \overline{Q},由真实世界“预训练 + 微调”的试验计算,并在 \{15,30,45\} 三档任务规模上取平均。对应的折线图见附录图 12。
| L0 | L1 | L2 | L3 | |||||
| 模型 | SR | \overline{Q}\uparrow | SR | \overline{Q}\uparrow | SR | \overline{Q}\uparrow | SR | \overline{Q}\uparrow |
| \pi_{0.5} (Intelligence et al., 2025) | 0.44 | 6.27 | 0.35 | 5.77 | 0.37 | 5.97 | 0.28 | 5.57 |
| XSkill (Xu et al., 2023) | 0.53 | 6.80 | 0.57 | 7.20 | 0.56 | 7.23 | 0.29 | 5.63 |
| ACT/DINOv2 (Zhao et al., 2023; Oquab et al., 2023) | 0.37 | 6.00 | 0.37 | 5.90 | 0.33 | 5.77 | 0.33 | 5.83 |
| DP/DINOv2 (Chi et al., 2025) | 0.33 | 5.97 | 0.37 | 6.00 | 0.29 | 5.70 | 0.25 | 5.43 |
| 平均 | 0.42 | 6.26 | 0.42 | 6.22 | 0.39 | 6.17 | 0.29 | 5.62 |
原表注:Real-world P+FT success by hierarchy level. \mathrm{SR} and human imitation score \overline{Q}, computed from real-world pretrain+finetune trials and averaged over the \{15,30,45\}-task scales. The corresponding line plot is Appendix Figure 12.
表 5 解读
结构。行是四个代表模型加一行平均,列是 L0–L3 四个层级,每个层级给 SR 和 \overline{Q}。所有数都来自真机 P+FT 设定,即表 4 的 P+FT 列按层级拆开。原文这张表是嵌在正文旁的窄表(wraptable),这里改为普通浮动表。与表 4 的一致性。由于各层级的回合数相同,每个模型四个层级的平均值应当等于表 4 中它的 P+FT 数字。逐一验算:\pi_{0.5} 的 SR 为 (0.44+0.35+0.37+0.28)/4=0.36,\overline{Q} 为 23.58/4\approx5.90(表 4 为 0.36、5.89);XSkill 为 1.95/4\approx0.49、26.86/4\approx6.72(表 4 为 0.49、6.72);ACT/DINOv2 为 1.40/4=0.35、23.50/4\approx5.88(表 4 为 0.35、5.88);DP/DINOv2 为 1.24/4=0.31、23.10/4\approx5.78(表 4 为 0.31、5.77)。两表完全对得上,最后一位的差异来自四舍五入。此外,表中每个 SR 都可以写成 k/75(每层级 5 任务 \times 5 次 \times 3 档规模),例如 0.53 对应 40/75,0.29 对应 22/75,与 4.1 节所述的试验次数相符。读数。平均行验证了正文的 0.42、0.42、0.39、0.29 和 6.26、6.22、6.17、5.62。XSkill 在 L0–L2 上明显领先(SR 0.53–0.57,\overline{Q} 6.80–7.23),到 L3 跌到与其他模型同一水平(0.29、5.63)。ACT/DINOv2 是唯一在 L3 上 SR 最高(0.33)、且从 L2 到 L3 没有下降的模型,它在 L3 的 \overline{Q}(5.83)也是四者中最高。如 4.4 节解释所述,平均值从 L2 到 L3 的下降(0.39\to0.29)有大约 0.27/4\approx0.07 来自 XSkill 一个模型,“L3 是普遍瓶颈”的说法需要打折扣;不过四个模型在 L3 上都没有超过 0.33,说明 L3 至少是一个所有模型都无法突破的“天花板”。
5结论(Conclusion)
原文
The Imitator Game Benchmark studies robot video imitation under progressively increasing mismatch between the human demonstration and the robot's own scene. To support this setting, we introduce IG-10K, a large-scale environment-aligned human–robot paired dataset spanning four levels of imitation, together with Imitator Arena for structured human evaluation of imitation behavior. Our experiments across multiple policy families and training regimes show that current systems transfer poorly to unseen tasks without task-specific robot data, and struggle when imitation requires functional substitution and intent-level adaptation.
译文
模仿者游戏基准(The Imitator Game Benchmark)研究的是:在人类示范与机器人自身场景之间的不匹配逐步增大的条件下,机器人如何进行视频模仿。为支撑这一设定,我们提出了 IG-10K,一个覆盖四个模仿层级的大规模环境对齐人—机器人配对数据集,以及用于对模仿行为进行结构化人工评测的 Imitator Arena。我们在多种策略家族和训练方式上的实验表明:没有针对具体任务的机器人数据时,现有系统向未见任务的迁移很差;当模仿需要功能替换和意图层面的适应时,它们也难以应对。
解释
这段回顾全文的设定、产物和两条核心发现。第一条“没有任务相关机器人数据时迁移很差”对应 Q2 的零样本结果:仿真里零样本成功率最高只有 0.13(VQ-BeT/DINOv2);而一旦给出 10 条目标任务示范并在 IG-10K 预训练的基础上微调,成绩就明显上升。第二条“难以应对功能替换”对应 Q3 和表 5:四个代表模型的平均真机成功率从 L0–L2 的约 0.4 降到 L3 的 0.29。这两条发现指向同一件事:模型学到的主要是“在见过的物体和用法上执行”,而不是“从视频里读出目的”。另外,这里的基准名称又换成了“The Imitator Game Benchmark”,与摘要的“The Imitator Game”、引言的“the Imitator Benchmark”指的是同一个东西。
原文
These suggest that intent-level imitation is unlikely to arrive as a by-product of scaling either the corpus or the action head only, and that the productive direction is an interface that keeps the demonstration available as evidence about purpose – affordance-aware object grounding, explicit goal inference, or intermediate representations that survive object substitution – rather than as a specification to be transcribed once and executed. IG-10K, Imitator Arena, and the L0–L3 protocol are released so that such interfaces can be measured on the rung where they would actually differ.
译文
这些结果表明,意图层模仿不太可能仅仅作为扩大语料规模或扩大动作头的副产品出现。更有成效的方向是设计一种接口,把示范作为关于目的的证据始终保留下来,比如可供性感知的物体定位(affordance-aware object grounding)、显式的目标推断,或者在物体被替换后依然有效的中间表示,而不是把示范当作一份只转写一次、随后照着执行的规格说明。我们公开 IG-10K、Imitator Arena 和 L0–L3 协议,以便在这类接口真正会拉开差距的那一级台阶上对它们进行衡量。
解释
这段从实验结果引出研究方向。“把示范当作只转写一次的规格说明”指当前几类基线的共同做法:VLA 把视频经描述器转成一句文字,技能方法把视频转成技能序列,视觉—动作模型把视频压缩成一个固定的任务嵌入。之后策略只看这份“转写结果”去执行,原视频中关于“为什么这样做”的信息在转写时就丢掉了。作者主张让策略在执行中能持续回看示范,把它当作推断目的的证据。三个具体方向各有所指:可供性感知的物体定位是识别新场景中哪个物体能起到示范中物体的作用(如水龙头能起到茶壶“出水”的作用);显式目标推断是先从视频里推断出终态目标,再规划如何达成;对物体替换稳健的中间表示是找到一种不随具体物体改变的任务描述。需要注意“扩大语料或动作头都不够”这句话的证据强度。语料规模这一侧有一定实验支撑:仿真中预训练任务数从 15 增到 45,零样本成绩仍接近地板;不过第 4.2 节也提到,真机上三个视频条件模型的零样本能力会随语料增大而有所提高(只有语言条件的 \pi_{0.5} 没有),所以“扩大语料无用”的说法并不绝对。但动作头这一侧,论文冻结了所有骨干网络、只训练动作生成模块,比较的是不同类型的动作头,并没有做系统的“动作头规模”扩展实验。所以后半句更像是作者的推断,而不是被直接检验过的结论。“在真正会拉开差距的那一级台阶上”是指:L0–L2 的任务原则上可以靠轨迹调整或同类物体泛化来完成,一种新接口是否真的理解了意图,主要要在 L3 上才看得出来。
原文
Limitations. IG-10K remains finite and manually designed, leaving broader scaling and more open-ended transfer substitutions to future work. Each task–level pair currently carries a single substitution pattern, which buys comparability across levels at the cost of not measuring variance over substitutions, and the hierarchy grades scene mismatch while holding the demonstrator–robot embodiment gap approximately fixed. Finite assets and rule-based planned motion further bias the simulated L3 substitution results. The evaluated policies are adapted to the Imitator Game rather than designed for intent-level human-video imitation, the best suitable framework for the Imitator Game remains an open question. Current models will fail in cases mainly in unseen zero-shot generalization tasks and functional substitution, we will discuss it in Appendix G.
译文
局限性。 IG-10K 的规模仍然有限,且由人工设计,更大规模的扩展和更开放的迁移替换留待未来工作。目前每个“任务—层级”组合只对应一种替换方式:这保证了不同层级之间的可比性,代价是无法衡量结果随替换方式不同而产生的方差。此外,该层级体系对场景不匹配进行分级,但把示范者与机器人之间的本体差距大致固定不变。有限的资产和基于规则规划的运动也会使仿真中 L3 替换的结果产生偏差。被评测的策略是经过适配后用于模仿者游戏的,而不是专为意图层人类视频模仿设计的,最适合模仿者游戏的框架是什么仍是一个开放问题。当前模型主要在未见任务的零样本泛化和功能替换上失败,我们将在附录 G 中讨论。
解释
作者列出五点局限,每点都对应前文某个设计选择。其一,数据有限且人工设计:53 个基础任务、每级一个替换都是人挑的,覆盖不了真实世界中千变万化的替换方式。其二,每个任务—层级只有一种替换:比如“倒水”任务的 L3 只用“茶壶换水龙头”这一种。这样各层级的比较是“一对一”的,但无法回答“换成别的不同功能物体,成绩会不会差很多”。因此表 5 中 L3 的 0.29 应理解为在这一组具体替换上的结果,带有未被估计的方差。其三,本体差距固定:示范者始终是人手,执行者始终是同一款双臂机器人(真机为 Realman,仿真为 Franka)。L0–L3 只改变场景,不改变“人手与夹爪”之间的差距,所以本基准不衡量对本体差异的泛化。其四,仿真 L3 有偏:仿真数据由 ManiSkill3 中 OMPL 规划的轨迹生成,物体资产也有限,L3 中的替换物和操作方式受限于可用资产和规则化的运动规划,可能与真实操作的分布不同。其五,基线并非为此设计:所有基线都冻结骨干、只训练动作模块,并通过描述器、技能检索或拼接嵌入等方式“改装”以接受视频输入,它们的失败不一定代表这类架构在原理上做不到。最后一句指向附录 G(失败模式与任务级诊断),那里会按任务分析模型在零样本和功能替换上的典型错误。这一段原文的最后两句有语法问题(逗号直接连接两个独立句子,并用了“will fail”这种将来时),翻译时按意思理顺了。
参考文献
参考文献列表从略,见原文。A模仿者能力:补充细节(The Imitator Capability: Supporting Detail)
A.1场景分解细节
原文
This appendix expands the scene decomposition of Section 3.1.1. Recall that a demonstration is recorded in \mathcal{S}_{\text{demo}} and the robot acts in \mathcal{S}_{\text{imit}}. We write a scene as \mathcal{S}=(\{O_i\},P), where P denotes the spatial configuration, and each task-relevant object O_i=(A_i,G_i,S_i) has appearance A_i, geometry G_i, and semantic category S_i. The appendix clarifies when P is comparable across the two scenes and how the benchmark uses the construction rule S \!\Rightarrow\! G \!\Rightarrow\! A to define the level hierarchy.
译文
本附录展开第 3.1.1 节的场景分解。回顾一下:示范录制于场景 \mathcal{S}_{\text{demo}},机器人则在场景 \mathcal{S}_{\text{imit}} 中行动。我们把一个场景记作 \mathcal{S}=(\{O_i\},P),其中 P 表示空间布局(spatial configuration),每个与任务相关的物体 O_i=(A_i,G_i,S_i) 具有外观 A_i、几何形状 G_i 和语义类别 S_i。本附录说明两个场景之间的 P 何时可以比较,以及基准如何利用构造规则 S \!\Rightarrow\! G \!\Rightarrow\! A 来定义层级体系。
解释
这段只是回顾记号。整个基准的核心思路是把“示范场景”和“模仿场景”之间的差异拆成四个可独立讨论的维度:布局 P(物体放在哪里)、外观 A(颜色、材质、纹理)、几何 G(形状、尺寸)和语义类别 S(这个东西“是什么”,正文第 3.1.1 节说明类别主要按物体的一般用途区分)。前三者属于物体的“内在属性”,P 则是整个物体集合的属性。构造规则 S \Rightarrow G \Rightarrow A 应读作“改变的蕴含链”:语义类别变了,几何必然也变;几何变了,外观必然也变。例如把锤子换成石头(S 变),形状一定不同(G 变),看起来也一定不同(A 变)。反方向不成立:只换外观(陶瓷杯换成同形状的玻璃杯)不必改变形状和类别。这条链使得“改变”只能沿 A \to A{+}G \to A{+}G{+}S 的方向逐级累积,层级才能排成一条线,而不是一个需要穷举组合的格子。下面两个小节分别讨论 P 的可比性和这条链的例外。
原文
When is P a meaningful comparison dimension? The spatial configuration P is only a meaningful comparison dimension between \mathcal{S}_{\text{demo}} and \mathcal{S}_{\text{imit}} when the two scenes share the same object set. Once the objects differ, there is nothing to line up one-to-one: a teapot's pose and a water tap's pose are not two values of the same quantity, so P is not “different” – the question simply does not arise. This is why, in the level table of Section 3.1.2, the P column is marked “n/a” and not “\times” at the levels where the object set has changed. For the same reason there is no level that changes P and the object set at once: such a level could not be described in these terms at all.
译文
P 何时是有意义的比较维度? 只有当两个场景共享同一个物体集合时,空间布局 P 才是 \mathcal{S}_{\text{demo}} 与 \mathcal{S}_{\text{imit}} 之间有意义的比较维度。一旦物体不同,就没有东西可以一一对应:茶壶的位姿和水龙头的位姿并不是同一个量的两个取值,所以谈不上 P“不同”——这个问题根本不成立。正因如此,在第 3.1.2 节的层级表中,物体集合发生变化的那些层级,其 P 列标为“n/a”而不是“\times”。出于同样的原因,不存在同时改变 P 和物体集合的层级:这样的层级根本无法用这些术语来描述。
解释
这段回答一个容易被质疑的设计细节:正文表 1 中 L2、L3 的 P 列为什么写“n/a”(不适用),而不是“\times”(已改变)。比较布局的前提是存在一个“物体对应关系”:示范里的杯子对应模仿场景里的哪个杯子,再看它是否被挪了位置。如果模仿场景中的物体已经换掉,例如示范用茶壶倒水,模仿场景只有水龙头,那么“茶壶的位置”和“水龙头的位置”就不是同一变量的两次取值,比较无从谈起。需要注意,L2 中的替换物(玻璃茶壶替换陶瓷茶壶)其实仍然可以凭语义类别一一对应,严格说它们的位置是可以比较的。作者在这里采取的是一个更简化的约定:只要物体在内在属性上不完全相同,就不再把布局作为一个独立维度来分级。最后一句因此有一个推论:层级表里没有“既挪位置又换物体”这一格,并不是遗漏,而是在这套记号下这种组合不被单独定义。实际的 L2/L3 场景里物体位置当然也可能与示范不同,只是不计入层级判定。
原文
Edge cases of the implication chain. The assumption S \!\Rightarrow\! G \!\Rightarrow\! A has rare counterexamples in which semantic category and physical form come apart – a wax banana (the semantics of “banana” without its edibility or, depending on construction, its exact geometry), or a decorative object shaped like a cup that is in fact a candle holder (the geometry of a cup with the semantics of a candle holder). In such cases the conventional link between category and form is deliberately broken for ornamental or deceptive purposes. We treat these as out of scope for benchmark instances: every task-relevant object in IG-10K is a functional exemplar of its semantic category, so that the chain holds, and object-substitution levels can be defined by a single intrinsic change. We list these cases to state the assumption precisely; none of them occurs in IG-10K at this stage.
译文
蕴含链的边界情形。 假设 S \!\Rightarrow\! G \!\Rightarrow\! A 存在少数反例,此时语义类别与物理形态相互脱离——比如蜡制香蕉(具有“香蕉”的语义,却没有其可食用性,而且视制作方式而定,也未必有完全相同的几何形状),或者一件形似杯子、实为烛台的装饰品(具有杯子的几何形状,却是烛台的语义)。在这些情况下,类别与形态之间的惯常联系被出于装饰或欺骗的目的刻意打破。我们把这些情形排除在基准实例之外:IG-10K 中每个与任务相关的物体都是其语义类别的功能性样例,因此蕴含链成立,物体替换类的层级可以由单一的内在属性变化来定义。我们列出这些情形只是为了把假设陈述准确;现阶段 IG-10K 中没有出现任何此类情形。
解释
蕴含链 S\Rightarrow G\Rightarrow A 的直觉是“东西的类别决定了它的形状,形状又决定了它的样子”。反例分两类。第一类是“语义相同而功能不同”:蜡香蕉在视觉和形状上都是香蕉,按语义算同类,却不能吃,用途完全不同。第二类是“几何相同而语义不同”:杯子形的烛台,G 与杯子一样,S 却变了,这直接违反了“S 变则 G 必变”。如果允许这类物体进入基准,就会出现 L2(同类换物)与 L3(异类换物)无法区分的格子。作者的处理方式是把数据集限制为“功能性样例”(functional exemplar),即每件物体都是其类别中实际能用的典型代表。这样每一级的升级只需要改变一个内在属性(A、或 A{+}G、或 S 连带 G 和 A),层级边界清晰。值得一提的是,蜡香蕉这种“外形对、功能错”的物体恰恰是检验意图理解的好素材,作者把它留在范围之外,意味着当前基准不考察“识破伪装物”的能力。
A.2四个层级:逐级细节与心理学依据
原文
This appendix expands Section 3.1.2 with the full per-level scene relations and worked examples, the L2 appearance-only sub-case, the correspondence to developmental-psychology constructs, and the relationship of our scene-mismatch hierarchy to embodiment-gap hierarchies.
译文
本附录对第 3.1.2 节加以展开,给出完整的逐级场景关系与实例、L2 的“仅外观变化”子情形、与发展心理学概念的对应关系,以及我们的场景失配层级与本体差距(embodiment gap)层级之间的关系。
解释
这是 A.2 的导读。下面每一级都按同样的四个栏目展开:场景关系(两个场景在 P,A,G,S 上的保持或改变模式)、场景允许什么(在这种差异下,示范中的哪些东西仍然可以被复现)、对模仿者的评判标准,以及实例。这种写法把“场景差异”与“成功标准”绑定:场景差异越大,能要求复现的内容就越抽象。
原文
L0 – Trajectory imitation. Scene relation. The object set is intrinsically identical (A and G preserved on every task-relevant object) and P is preserved in the operational sense of Section 3.1.2–the trajectory implicit in V would still succeed in \mathcal{S}_{\text{imit}}. What the scene permits. The demonstrated end-effector motion and object motion remain feasible. What the imitator is graded on. The rollout should preserve the demonstrated motion pattern as closely as the shared scene permits, while the benchmark still scores the episode through the Arena judgments and task-completion metrics rather than a hand-designed trajectory-distance metric. Example. Same teapot and cup in the same positions; the imitator pours along essentially the demonstrated motion.
译文
L0——轨迹模仿。场景关系:物体集合在内在属性上完全相同(每个与任务相关的物体都保持 A 和 G),且 P 在第 3.1.2 节的操作性意义上保持不变——即 V 中隐含的轨迹在 \mathcal{S}_{\text{imit}} 中仍会成功。场景允许什么:示范中的末端执行器运动和物体运动仍然可行。对模仿者的评判:执行过程应在共享场景允许的范围内尽可能贴近示范的运动模式;不过基准仍通过 Arena 的人工判断和任务完成指标为该回合打分,而不是采用人工设计的轨迹距离指标。实例:同一把茶壶和同一个杯子放在相同位置;模仿者基本沿着示范的动作倒茶。
解释
V 是人类示范视频。L0 是最“宽松”的场景、最“严格”的复现:所有东西都没变,所以理想的模仿就是照着做一遍。这里“P 保持”采用的是操作性定义:不要求物体坐标逐毫米相同,只要把示范的动作原样重放仍能成功,就算布局未变。这个定义回避了“位置差多少才算变”的阈值问题。一个值得注意的设计选择是:虽然 L0 名为“轨迹模仿”,评分却不计算机器人轨迹与人手轨迹的距离,而是沿用 Arena 盲评和任务完成率。原因在于人与机器人本体不同(人手对双臂机器人),轨迹距离本身就不好定义;把评分统一为“结果与人工判断”,也使 L0 到 L3 的分数在口径上可比。代价是 L0 实际上并不严格检验“是否沿示范轨迹运动”,只有人类评审在主观上会把动作相似性考虑进去。
原文
L1 – Object end-state imitation. Scene relation. The object set is intrinsically identical but P has changed – a literal replay of the trajectory implicit in V would no longer succeed. What the scene permits. The demonstrated trajectory is no longer correct, but exactly the same objects can be brought to exactly the same final states. What the imitator is graded on. Match of final object states with V; trajectory similarity is not rewarded. Example. Same teapot and cup, but the cup has moved to the opposite side of the table; the imitator should still leave the cup full of water.
译文
L1——物体终态模仿。场景关系:物体集合在内在属性上完全相同,但 P 改变了——逐字重放 V 中隐含的轨迹将不再成功。场景允许什么:示范的轨迹不再正确,但完全相同的物体可以被带到完全相同的最终状态。对模仿者的评判:物体最终状态与 V 的吻合程度;轨迹相似性不计分。实例:同一把茶壶和同一个杯子,但杯子被挪到了桌子的另一侧;模仿者仍应让杯子里盛满水。
解释
L1 只动了布局。此时照搬示范轨迹会“倒在空处”,所以模仿者必须把示范理解为“让杯子装满水”这样一个关于物体终态的目标,再根据新布局重新规划动作。这对应心理学里的仿效(emulation,见下文 appA-10 的解释):复现结果,而不复现过程。“轨迹相似性不计分”说明在 L1 上一个绕远路但最终倒满水的策略与紧贴示范路线的策略得分相同。正文第 4 节的结果显示多数模型从 L0 到 L1 成功率基本持平,说明当前策略对单纯的布局变化已有一定适应能力。
原文
L2 – Semantic-task imitation. Scene relation. At least one task-relevant object has changed in A (and possibly G); each substitution preserves the object's semantic category C. What the scene permits. Because the objects differ, the precise final states of V are not reproducible (a handled mug is not a handleless cup), but the semantic task – “make a cup of tea,” “set the table,” “stir the soup” – remains well-defined. What the imitator is graded on. Completion of the semantic task implied by V, judged at an abstraction that survives object substitution. Example. The demonstrator pours from a ceramic teapot into a handleless cup; the imitator's scene has a glass teapot and a handled mug, and the expected behavior is still “pour tea from the teapot into the mug.”
译文
L2——语义任务模仿。场景关系:至少有一个与任务相关的物体在 A 上(也可能在 G 上)发生了变化;每次替换都保持物体的语义类别 C。场景允许什么:由于物体不同,V 中精确的最终状态无法复现(带把的马克杯并不是无把的杯子),但语义任务——“泡一杯茶”“摆好餐桌”“搅拌汤”——仍然有明确定义。对模仿者的评判:是否完成了 V 所隐含的语义任务,判断所用的抽象层次要在物体替换后仍然成立。实例:示范者用陶瓷茶壶往无把杯里倒茶;模仿者的场景中是玻璃茶壶和带把马克杯,期望的行为仍然是“从茶壶往马克杯里倒茶”。
解释
L2 开始“换物体”,但只在同类之内换。成功标准随之从“物体终态”上移到“语义任务”:倒进马克杯和倒进无把杯,终态在几何上不可能完全一样,但“往杯子里倒茶”这件事是一样的。这里的“抽象层次要在替换后仍成立”是关键:评判者不能问“杯子是否到了某个坐标”,而要问“茶是否被倒进了容器”。记号问题:这里把语义类别写作 C,而 A.1 和正文第 3.1.1 节一直把它记作 S_i(O_i=(A_i,G_i,S_i))。下文 L3 段同样用 C。两者指同一个量,属于原文前后记号不统一,阅读时把 C 当成 S 即可。之所以可能改写成 C,大概是为了避免与场景记号 \mathcal{S} 混淆,但原文并未说明。
原文
The L2 appearance-only sub-case. Within L2 it is sometimes useful to distinguish the sub-case in which only A changes while G is preserved (a ceramic cup replaced by a glass cup of identical shape) from the sub-case in which both A and G change (the cup replaced by a mug of different shape). The first isolates a pure perceptual invariance – the policy must recognize that two visually different objects play the same functional role – while the second additionally demands that the policy adapt its grasp and motion to a different shape. We report both sub-cases where a task admits them, but treat them as a single L2 level for headline metrics because both share the same fidelity ceiling: the semantic task rather than per-object final states.
译文
L2 的“仅外观变化”子情形。在 L2 内部,有时需要区分两种子情形:一种是只改变 A 而保持 G(陶瓷杯换成形状完全相同的玻璃杯),另一种是 A 和 G 都改变(杯子换成形状不同的马克杯)。前者单独考察纯粹的感知不变性——策略必须认识到两个外观不同的物体扮演着相同的功能角色;后者还要求策略根据不同的形状调整抓取和运动。在任务允许时我们会分别报告这两种子情形,但在主要指标中把它们视为同一个 L2 层级,因为二者的保真度上限相同:都是语义任务,而不是每个物体的最终状态。
解释
这段解释了为什么正文表 1 把“A 或 G”合成一列。两种子情形难度来源不同:“只换外观”考的是视觉编码器能否忽略颜色材质的变化(感知层面),“连形状一起换”还考控制层面的抓取适应。照理可以拆成两级,但作者的分级原则是按保真度上限(fidelity ceiling)划分,即“这个场景最多还允许复现示范的什么”。两种子情形下能复现的都只到语义任务为止,所以归为一级。严格说,“只换外观、形状不变”时,最终状态其实是可以精确复现的(同形状的玻璃杯完全可以被放到同一位置、盛同样多的水),这样它的上限应该与 L1 相同,而不是 L2。原文说二者“共享同一上限”在这一点上不太严密;更准确的说法是,作者为了让层级只依赖“物体集合是否在内在属性上相同”这一个判据,而把所有换物情形都放进了 L2。附录 B.1 末尾说明了这两种子情形如何通过受控替换构造出来。
原文
L3 – Affordance-adapted imitation. Scene relation. At least one task-relevant object changes in semantic category C; under our benchmark construction this also changes geometry G and appearance A. What the scene permits. The object-specific execution shown in V is no longer directly reproducible, but the underlying purpose can still be served by selecting an object in \mathcal{S}_{\text{imit}} whose affordance can be adapted to the same end. What the imitator is graded on. Achievement of an action that satisfies the underlying intent of V via affordance adaptation, assessed by human evaluators in the Arena (Section 3.2.2); neither trajectory nor specific final states are expected to resemble V. Examples. (i) The demonstrator drives a nail with a hammer; the imitator's scene contains no hammer but a stone, and the expected behavior is to use the stone as a hammer. (ii) The demonstrator steeps a tea bag to make a hot drink; the imitator's scene contains no tea bag but an instant drink powder, so the expected behavior is to make a drink by mixing rather than steeping.
译文
L3——可供性适配模仿。场景关系:至少有一个与任务相关的物体的语义类别 C 发生了改变;按照我们的基准构造方式,这也会改变几何 G 和外观 A。场景允许什么:V 中针对特定物体的执行方式已无法直接复现,但仍可以在 \mathcal{S}_{\text{imit}} 中选择一个其可供性(affordance)能被改用于同一目的的物体,来实现背后的目的。对模仿者的评判:是否通过可供性适配完成了满足 V 背后意图的动作,由 Arena 中的人类评审评估(第 3.2.2 节);既不要求轨迹也不要求具体的最终状态与 V 相似。实例:(i) 示范者用锤子钉钉子;模仿者的场景里没有锤子,只有一块石头,期望的行为是把石头当锤子用。(ii) 示范者用浸泡茶包的方式做一杯热饮;模仿者的场景里没有茶包,只有速溶饮料粉,所以期望的行为是用冲调而不是浸泡的方式做一杯饮料。
解释
可供性(affordance)是心理学家 J. J. Gibson 提出的概念,指物体相对于行动者所“提供”的行动可能:石头坚硬、有重量、可握持,因此“可供”敲击;杯子中空、开口朝上,因此“可供”盛装。L3 要求模仿者识别出示范背后的目的(钉进钉子、做出热饮),再在新场景中找到具有相应可供性的替代物,必要时还要改变操作方式(从“浸泡”改成“搅拌冲调”)。这已经不是复现动作或结果,而是复现意图。由于成功标准是“是否满足意图”,无法写成自动指标,因此 L3 依赖 Arena 中的人类盲评。L3 与 L2 的分界正是语义类别是否改变:L2 换的是“另一个杯子”,L3 换的是“不是杯子但能当杯子用的东西”。正文的主要发现之一就是:各模型在 L0–L2 上表现大致平稳,到 L3 显著下滑(四个代表模型平均成功率从约 0.4 降到 0.29),说明“功能替换”是当前策略的关键瓶颈。
原文
Correspondence to developmental-psychology constructs. The four fidelity levels take operational inspiration from a hierarchy of social-learning constructs: surface-motor copying without attribution of instrumental efficacy (“mimicking” in Tomasello's sense (Whiten et al., 2004; Tomasello, 2009)), end-state emulation (Wood, 1996; Tomasello, 2009; Whiten et al., 2009), goal-directed (intentional) imitation (Meltzoff, 1995; Tomasello, 2009; Gergely et al., 2002), and analogical transfer of an observed practice to functionally equivalent means (Brown, 1989; Chen et al., 2000; Byrne and Russon, 1998). We adopt these as labels for our hierarchy of replication fidelities rather than as claims about the cognitive mechanisms operating in our system, and in particular do not claim that our system attributes mental states. The four levels are our synthesis: to our knowledge, no single published taxonomy enumerates exactly these four, and the framing builds on Tomasello's mimicking/emulation/imitation distinction and Byrne and Russon's (Byrne and Russon, 1998) program-level imitation. What we actually measure is simpler than any of these constructs: as the robot's scene moves further from the demonstration, what an imitator can still reproduce becomes less and less specific.
译文
与发展心理学概念的对应。四个保真度层级在操作上借鉴了一组社会学习(social learning)概念的层级:不归因于工具效用的表层动作复制(Tomasello 意义上的“模仿动作”(mimicking)(Whiten et al., 2004; Tomasello, 2009)),终态仿效(end-state emulation)(Wood, 1996; Tomasello, 2009; Whiten et al., 2009),目标导向的(有意图的)模仿(Meltzoff, 1995; Tomasello, 2009; Gergely et al., 2002),以及把观察到的做法类比迁移到功能等价的手段上(Brown, 1989; Chen et al., 2000; Byrne and Russon, 1998)。我们只把这些概念用作复现保真度层级的标签,并不是在断言我们的系统中运行着相应的认知机制,尤其不声称我们的系统会归因心理状态。这四个层级是我们自己的综合:据我们所知,没有任何一种已发表的分类法恰好列举了这四种,我们的框架建立在 Tomasello 对模仿动作/仿效/模仿的区分以及 Byrne 和 Russon(Byrne and Russon, 1998)的程序级模仿之上。我们实际测量的东西比上述任何概念都更简单:随着机器人的场景与示范渐行渐远,模仿者仍能复现的内容变得越来越不具体。
解释
这段把 L0–L3 与发展心理学和比较心理学中四个经典概念一一对应,下面按层级逐个说明。L0 对应“模仿动作”(mimicking)。Tomasello 在区分各种社会学习时,把只复制动作外形、却不理解该动作为何能产生结果的行为称为 mimicking。“不归因于工具效用”(without attribution of instrumental efficacy)是要点:学习者并不认为“这个动作导致了那个结果”,只是照样子做。这与 L0 的“沿示范轨迹重放”在形式上相同。L1 对应“仿效”(emulation)。emulation 与 imitation 的区分是比较心理学的核心议题。仿效指学习者注意到示范造成的环境结果(例如盒子被打开、杯子装满了水),然后用自己的方式达成同一结果,而不在意示范者用了什么动作;模仿则指复现示范者的动作或行为策略本身。经典证据来自黑猩猩与儿童的对比:Whiten 等人的“人工果实”实验发现,黑猩猩倾向于仿效(直接用最省事的方法取出食物),儿童则更忠实地复现示范者的具体操作,甚至复现多余步骤(“过度模仿”)。L1 中布局改变、轨迹失效,模仿者只能复现物体终态,正是仿效的结构。L2 对应“目标导向的(有意图的)模仿”。Meltzoff 1995 年的“行为再演”(behavioral re-enactment)实验中,18 个月大的婴儿观看成人尝试某个动作却失败(例如想把哑铃玩具的两端拉开却手滑了),婴儿随后做出的是成人想做的动作(成功拉开),而不是成人实际做出的失败动作。这说明婴儿读取的是意图而非表面动作。Gergely 等人 2002 年的“理性模仿”实验进一步显示:成人用额头按亮灯,若其双手被毯子裹住,婴儿多改用手按;若双手空闲,婴儿更多照用额头,说明婴儿会推断“为什么用这种方式”。Tomasello 的文化学习(cultural learning)理论把这种理解他人意图并据此学习的能力视为人类文化传承的基础:人类能区分“他想达成什么”和“他碰巧怎么做”,从而在不同条件下复现同一目的。L2 中物体换成同类不同款,模仿者要抓住的是“泡茶”“摆桌”这一层目标,与这一构念对应。L3 对应“类比迁移”与“程序级模仿”。Brown(1989)及 Chen 等人(2000)研究儿童的类比问题解决:儿童能把一个情境中学到的解法迁移到表面不同、结构相同的问题上(例如把“用工具够远处玩具”的方法迁移到另一套不同工具上)。Byrne 和 Russon 1998 年提出的程序级模仿(program-level imitation)区别于“动作级模仿”(action-level imitation):前者复制的是行为的层级结构和组织方式(先做什么、后做什么、为了什么),具体动作细节则由学习者用自己的手段填充,他们以大猩猩加工荨麻等植物的复杂取食技巧为例。L3 中用石头代替锤子、以冲调代替浸泡,就是保留行为的“程序”和目的,替换掉具体的物体与手段。作者随即做了两点限定。其一,这些概念只作为标签使用,并不声称机器人策略中真的存在意图归因等认知机制;机器人在 L2 上成功不等于它“理解了意图”。其二,这四级划分是作者自己的综合,心理学文献中并没有恰好这四级的现成分类法(例如 Tomasello 的经典三分只有 mimicking、emulation、imitation 三类)。最后一句点明实际测量的对象:场景失配程度与可复现内容的具体程度之间的单调关系。这是一个可操作的工程定义,比心理学构念本身更窄。
原文
Relationship to embodiment-gap hierarchies. Our hierarchy is orthogonal to embodiment-gap hierarchies such as RHyME's (Kedia et al., 2025), which grade the mismatch between the demonstrator's body and the robot's body while holding the scene fixed. The Imitator Game holds the demonstrator–robot embodiment gap approximately fixed and instead grades the scene-level mismatch between \mathcal{S}_{\text{demo}} and \mathcal{S}_{\text{imit}}. We likewise assume a visual front-end invariant to lighting and viewpoint variation between V and the imitator's observations, treating these as out of scope rather than as additional levels. The two axes – embodiment gap and scene-level mismatch – are complementary, and combining them is a natural direction for future benchmarks.
译文
与本体差距层级的关系。我们的层级与 RHyME(Kedia et al., 2025)等本体差距层级相互正交:后者在保持场景固定的前提下,对示范者身体与机器人身体之间的失配进行分级。模仿者游戏则把示范者与机器人之间的本体差距大致固定,转而对 \mathcal{S}_{\text{demo}} 与 \mathcal{S}_{\text{imit}} 之间的场景级失配进行分级。我们同样假设视觉前端对 V 与模仿者观测之间的光照和视角变化具有不变性,把这些因素视为超出范围,而不是额外的层级。本体差距与场景级失配这两条轴是互补的,把二者结合起来是未来基准的一个自然方向。
解释
从人类视频学习机器人技能,存在两类不同的“差距”。本体差距(embodiment gap)指“谁在做”:人手有五指、臂长和关节活动范围都与机器人不同。RHyME 一类工作按示范者与机器人在动作风格、速度、操作方式上的差异大小分级,但让两者在同一场景中完成同一任务。场景失配指“在哪里做、用什么做”:本文固定示范者(人)和模仿者(双臂机器人)不变,只改变物体布局和物体本身。“正交”意味着两条轴可以独立变化,可以想象一张二维表,横轴是本体差距、纵轴是 L0–L3,现有工作各自只覆盖其中一行或一列。“视觉前端不变性”是另一个被明确排除的因素:人类视频与机器人观测之间的光照、相机视角差异被假设由视觉编码器吸收,而不另设层级。这与 B.1 中统一采用 ZED2i 自我视角相机作为模型输入的做法一致,部分减小了视角差异。需要注意本体差距只是“大致”固定:人与机器人之间的差距本身仍然很大,这一差距在所有层级中都存在,因而 L0 的成功率也远未到顶。
B模仿者基准:补充细节(The Imitator Benchmark: Supporting Detail)
B.1IG-10K 的采集与标注细节
原文
This appendix expands Section 3.2.1 with the full task suite, the data-collection platforms and acquisition parameters, the sensing rig, and the multi-modal annotation toolchain. Figure 3 shows representative paired episodes, the object assets, and the offline annotation layers; Figure 5 shows the collection rig.
译文
本附录对第 3.2.1 节加以展开,给出完整的任务集、数据采集平台与采集参数、传感装置以及多模态标注工具链。图 3 展示了有代表性的配对回合、物体资产和离线标注层;图 5 展示了采集装置。
解释
附录 B 对应正文的“基准”部分(数据集 IG-10K、Arena 评测平台、基线模型)。B.1 先讲数据:用什么设备采、采了多少、有哪些任务、附带哪些标注。图 3 是正文中的数据集总览图(配对回合拼图、物体图库和标注示例),图 5 是本附录新增的采集现场照片。
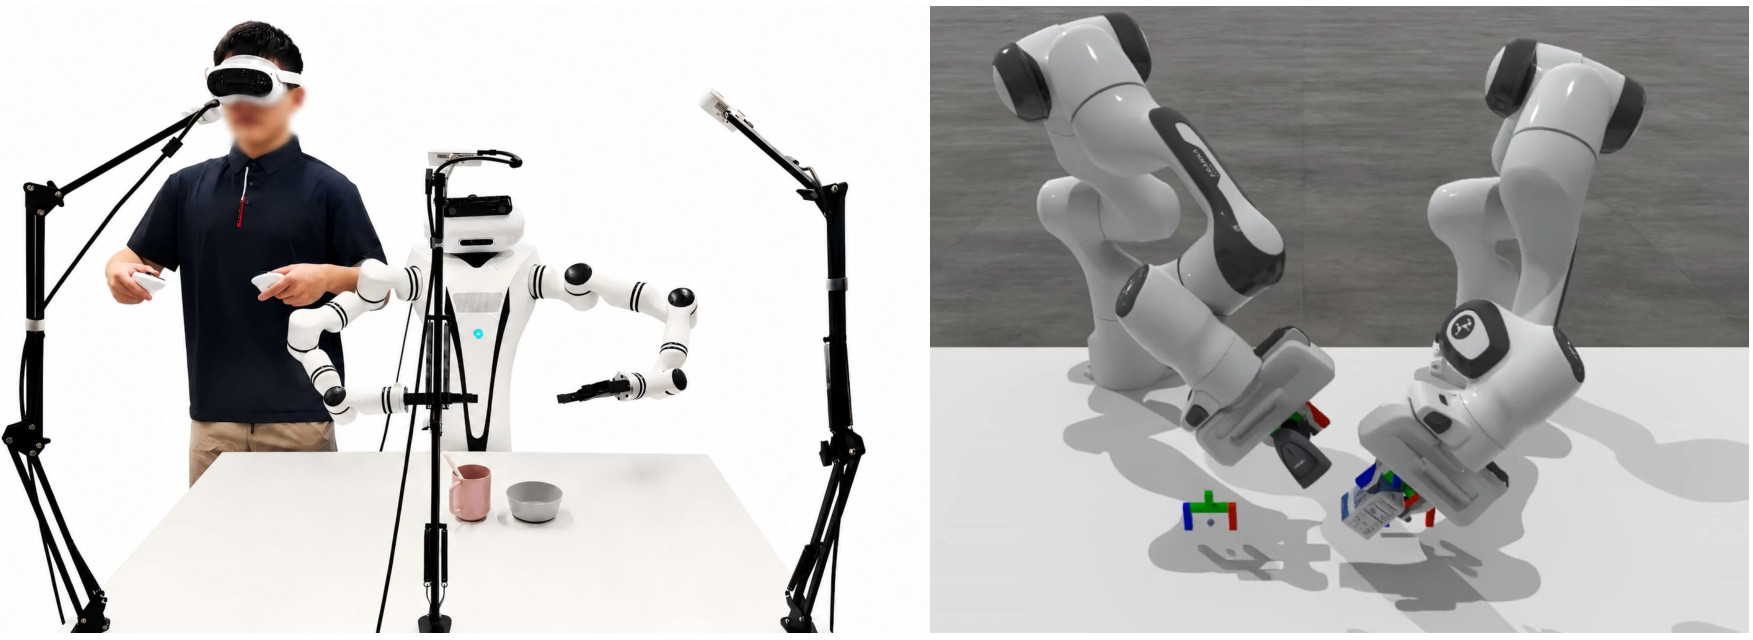
图 5:IG-10K 数据采集。(左)真实世界数据通过 VR 遥操作在双臂机器人平台上采集,视觉数据由三台第三视角 RealSense 相机和一台朝前的 ZED2i RGB 相机记录。(右)仿真数据通过手工设计的运动规划路点采集,轨迹由 OMPL 规划。
原图注:IG-10K data collection. (left) The real-world data are collected with VR teleoperation on a dual-arm robot platform, with visual data recorded by three third-view RealSense cameras and one front-facing ZED2i RGB camera. (right) simulation data are collected with handcrafted motion-planning waypoints and trajectories planned using OMPL.
图 5 解读
左图是真实数据的采集现场:操作员戴 VR 头显、手持控制器,站在双臂人形上身机器人(Realman 平台)前方,桌上摆着任务物体(图中是一个杯子和一个碗);机器人两侧和上方的支架上固定着相机。遥操作时机器人的双臂实时跟随操作员双手运动,从而产生机器人片段;同一场景下人类亲手完成任务的视频则构成配对的人类片段。右图是仿真环境(ManiSkill3)中的双臂 Franka 机械臂,桌面上的彩色坐标轴标记应是运动规划用的路点或目标位姿的可视化,机械臂沿 OMPL(Open Motion Planning Library,开源运动规划库)在路点之间规划出的无碰撞轨迹运动。这张图支撑的论点是 IG-10K 的“环境对齐”:人类示范与机器人执行在同一个物理或仿真场景、同一套相机配置下录制,因此人机两段视频之间唯一的系统性差别是执行者本身(以及 L1–L3 中刻意引入的场景变化)。图注把 ZED2i 称为“朝前的”(front-facing),而下文“传感装置”一段称它为“广角自我视角(ego-centric)相机”;二者描述的应是同一台相机,读者可理解为“从机器人头部位置朝前拍摄的主视角相机”。
原文
Data collection. Real-robot data are collected on a dual-arm Realman platform, teleoperated via VR, with full joint angles and 6-DoF end-effector poses recorded at a control frequency of 30 Hz. Simulation data are collected on a dual-arm Franka in ManiSkill3, with assets drawn from YCB, PartNet-Mobility, RoboTwin, and Sketchfab; trajectories are planned by OMPL from hand-crafted waypoints. Of the 20{,}000+ paired episodes in total, 11.7K are real human-robot paired episodes and 10K are paired simulation episodes. Each real paired episode contains one human clip and one corresponding real-robot clip; the simulation episodes provide paired interactive environments with fully observable automated metrics. Per task–level pair we collect 50 paired episodes on average.
译文
数据采集。真实机器人数据在双臂 Realman 平台上通过 VR 遥操作采集,以 30 Hz 的控制频率记录完整的关节角和 6 自由度末端执行器位姿。仿真数据在 ManiSkill3 中的双臂 Franka 上采集,资产取自 YCB、PartNet-Mobility、RoboTwin 和 Sketchfab;轨迹由 OMPL 根据手工设计的路点规划。在总计 20{,}000+ 个配对回合中,11.7K 个是真实的人—机器人配对回合,10K 个是配对的仿真回合。每个真实配对回合包含一段人类片段和一段对应的真实机器人片段;仿真回合则提供带有完全可观测自动指标的配对交互环境。每个“任务—层级”组合平均采集 50 个配对回合。
解释
真实与仿真两条采集线分工不同。真实数据靠人类遥操作,动作自然但成本高;仿真数据靠“手工路点 + 运动规划器”自动生成,可以大量复制,并且仿真器能直接读出物体状态(杯中是否有水、物体是否到位),从而给出完全可观测的自动指标,不必依赖人工评判。资产库中 YCB 是常用的日常物体扫描模型集,PartNet-Mobility 提供带关节的可动物体(抽屉、盖子),RoboTwin 是双臂操作仿真基准的资产,Sketchfab 是在线 3D 模型平台。30 Hz 是遥操作数据常见的记录频率;6 自由度位姿指三维位置加三维姿态。数字核对。11.7\text{K}+10\text{K}=21.7\text{K},与“20,000+”一致。按表 6,共有 53 个基础任务,其中 6 个省略 L3,所以“任务—层级”组合数为 53\times4-6=206,与正文“200+ 任务变体”一致。若每个组合平均 50 个配对回合,总数约为 206\times50\approx10.3\text{K},只有 21.7K 的一半左右。若把真实与仿真分开算,真实约 11{,}700/206\approx57、仿真约 10{,}000/206\approx49,各自都接近 50。因此“平均 50 个”更可能指每个数据源(真实或仿真)内部的每组合数量,原文没有讲清口径;正文第 3.2.1 节的说法是“每个 50+ 个配对回合”,与此处“平均 50 个”也略有出入。另外,数据集名为 IG-10K,而总回合数是 20K+,名称中的“10K”与哪一部分对应原文未作说明。
原文
Sensing rig. All human, real-world robot, and simulation scenes are captured by a wide-angle ZED2i ego-centric camera together with three RealSense third-person cameras (left-frontal, top-down, right-frontal), all providing RGB-depth vision. For model input we standardize on the ZED2i RGB stream for compatibility with the diverse pre-training setups of the baseline families (Section 3.2.3); the remaining views and the depth channels are retained in the released data for use by future methods.
译文
传感装置。所有人类场景、真实机器人场景和仿真场景都由一台广角 ZED2i 自我视角(ego-centric)相机和三台 RealSense 第三人称相机(左前方、俯视、右前方)拍摄,所有相机都提供 RGB-深度视觉。在模型输入上,我们统一使用 ZED2i 的 RGB 流,以兼容各类基线模型多样的预训练设置(第 3.2.3 节);其余视角和深度通道保留在发布的数据中,供未来的方法使用。
解释
四台相机都是 RGB-D(彩色加深度)。仿真场景中的“相机”是虚拟相机,原文说仿真也由同样四路相机拍摄,可推断其摆放与真实装置相对应,但原文没有给出具体位姿。只用一路 ZED2i 彩色图作为模型输入,是因为参评的 VLA、跨本体技能方法和视觉运动策略在预训练时大多只接收单路 RGB 图像,统一输入可以让不同模型在同等条件下比较;代价是多视角和深度信息在本文的评测中没有被利用。这也与附录 A.2 末尾的假设相呼应:人类视频与机器人观测来自同一台相机、同一视角,视角差异被基本消除。
原文
Task suite. Table 6 lists all 50+ base tasks by domain, together with the levels at which each is instantiated. A task omits L3 only where affordance substitution would be semantically ill-defined or physically unsafe; the omitted cases and their justification are noted in the table.
译文
任务集。表 6 按领域列出全部 50 余个基础任务,以及每个任务在哪些层级上有实例。只有当可供性替换在语义上定义不清或在物理上不安全时,任务才会省略 L3;省略的情形及其理由在表中注明。
解释
“基础任务”(base task)指一个固定的示范意图,例如“往杯中倒水”;每个基础任务在 L0–L3 各配一种场景变化,构成“任务变体”。表 6 的核对结果见表后的解读框。
表 6:IG-10K 任务集。按领域列出全部基础任务及每个任务有实例的层级(✓ 表示有,– 表示省略)。各领域任务数:家居 12、超市 7、餐厅 17、物流 4、医院 6、实验室 7。
| 编号 | 任务(中文) | 英文原名 | L0 | L1 | L2 | L3 | 备注 |
| 家居(Household,12) | |||||||
| * H1 | 在碗中搅汤 | Stir Soup in Bowl | ✓ | ✓ | ✓ | ✓ | |
| H2 | 把书放回书架 | Return Book to Shelf | ✓ | ✓ | ✓ | ✓ | |
| H3 | 叠衣服放入篮中 | Fold Clothes into Basket | ✓ | ✓ | ✓ | ✓ | |
| H4 | 把遥控器放回盒中 | Return Remote to Box | ✓ | ✓ | ✓ | ✓ | |
| H5 | 把杂志放进文件夹 | Put Magazine in Folder | ✓ | ✓ | ✓ | ✓ | |
| H6 | 把沐浴露放回置物架 | Return Body Wash to Holder | ✓ | ✓ | ✓ | ✓ | |
| H28 | 把鞋放进鞋盒 | Put Shoes in Shoe Box | ✓ | ✓ | ✓ | ✓ | |
| H35 | 把刷子放到支架上 | Place Brush on Stand | ✓ | ✓ | ✓ | ✓ | |
| H49 | 叠毛巾放入篮中 | Fold Towel into Basket | ✓ | ✓ | ✓ | ✓ | |
| H50 | 用榨汁机榨汁 | Juice with Juicer | ✓ | ✓ | ✓ | ✓ | |
| H57 | 把杯子挂到杯架上 | Hang Cup on Rack | ✓ | ✓ | ✓ | ✓ | |
| H58 | 用螺丝刀固定木块 | Fix Wood with Screwdriver | ✓ | ✓ | ✓ | ✓ | |
| 超市(Supermarket,7) | |||||||
| * H7 | 把苹果放进篮子 | Put Apple in Basket | ✓ | ✓ | ✓ | ✓ | |
| H8 | 把水果分拣到各个篮子 | Sort Fruits into Baskets | ✓ | ✓ | ✓ | ✓ | |
| H9 | 在秤上称苹果 | Weigh Apple on Scale | ✓ | ✓ | ✓ | ✓ | |
| H10 | 把薯片摆上货架 | Stock Chips on Shelf | ✓ | ✓ | ✓ | ✓ | |
| H11 | 整理货架上的商品 | Organize Items on Shelf | ✓ | ✓ | ✓ | ✓ | |
| H12 | 把水果装进购物袋 | Pack Fruits in Shopping Bag | ✓ | ✓ | ✓ | ✓ | |
| H13 | 扫描饮料条形码 | Scan Beverage Barcode | ✓ | ✓ | ✓ | ✓ | |
| 餐厅(Restaurant,17) | |||||||
| * H14 | 把盘子放进碗碟架 | Place Plates in Rack | ✓ | ✓ | ✓ | ✓ | |
| H15 | 切胡萝卜 | Chop Carrot | ✓ | ✓ | ✓ | ✓ | |
| H16 | 在盘中摆放水果 | Arrange Fruits on Plate | ✓ | ✓ | ✓ | ✓ | |
| H17 | 给汉堡加酱 | Add Sauce to Burger | ✓ | ✓ | ✓ | ✓ | |
| H18 | 清洗炊具 | Wash Cookware | ✓ | ✓ | ✓ | ✓ | |
| H19 | 餐后擦桌子 | Wipe Table After Meal | ✓ | ✓ | ✓ | ✓ | |
| H20 | 往杯中倒水 | Pour Water into Cup | ✓ | ✓ | ✓ | ✓ | |
| H21 | 倒掉厨余垃圾 | Discard Food Waste | ✓ | ✓ | ✓ | ✓ | |
| H22 | 用勺子转移食物 | Transfer Food with Spoon | ✓ | ✓ | ✓ | ✓ | |
| H23 | 称量食材 | Weigh Ingredients | ✓ | ✓ | ✓ | ✓ | |
| H24 | 装订文件 | Staple Documents | ✓ | ✓ | ✓ | ✓ | |
| H25 | 在碗中搅拌食材 | Stir Ingredients in Bowl | ✓ | ✓ | ✓ | ✓ | |
| H45 | 过滤液体 | Filter Liquid | ✓ | ✓ | ✓ | ✓ | |
| H46 | 把食物装盒 | Pack Food in Box | ✓ | ✓ | ✓ | ✓ | |
| H47 | 摆放餐具 | Set Tableware | ✓ | ✓ | ✓ | ✓ | |
| H48 | 揭开锅盖查看 | Open Lid to Inspect Pot | ✓ | ✓ | ✓ | ✓ | |
| H56 | 把汉堡放进餐盘 | Place Burger in Meal Tray | ✓ | ✓ | ✓ | ✓ | |
| 物流(Logistics,4) | |||||||
| * H26 | 分拣并封装货物 | Sort and Seal Goods | ✓ | ✓ | ✓ | ✓ | |
| H27 | 识别条码并放置 | Identify Barcode and Place | ✓ | ✓ | ✓ | ✓ | |
| H29 | 撕开包装取样 | Tear Packaging for Sample | ✓ | ✓ | ✓ | – | 定义不清(ill-defined) |
| H30 | 封箱打包 | Seal and Pack Box | ✓ | ✓ | ✓ | ✓ | |
| 医院(Hospital,6) | |||||||
| * H31 | 分拣药品 | Sort Medications | ✓ | ✓ | ✓ | ✓ | |
| H32 | 归档医疗文件 | File Medical Documents | ✓ | ✓ | ✓ | ✓ | |
| H33 | 倒药液 | Pour Medication Liquid | ✓ | ✓ | ✓ | – | 危险(hazardous) |
| H34 | 把药片放进药盒 | Put Pills in Pill Box | ✓ | ✓ | ✓ | ✓ | |
| H36 | 把器械放进托盘 | Place Instruments in Tray | ✓ | ✓ | ✓ | – | 定义不清(ill-defined) |
| H37 | 清洁容器口 | Clean Container Opening | ✓ | ✓ | ✓ | ✓ | |
| 实验室(Laboratory,7) | |||||||
| * H38 | 在烧杯中搅拌液体 | Stir Liquid in Beaker | ✓ | ✓ | ✓ | – | 危险(hazardous) |
| H39 | 倾倒液体试剂 | Pour Liquid Reagent | ✓ | ✓ | ✓ | – | 危险(hazardous) |
| H40 | 称量固体材料 | Weigh Solid Material | ✓ | ✓ | ✓ | ✓ | |
| H41 | 过滤溶液 | Filter Solution | ✓ | ✓ | ✓ | ✓ | |
| H42 | 清洗实验器皿 | Wash Laboratory Vessels | ✓ | ✓ | ✓ | ✓ | |
| H43 | 打开容器盖 | Open Container Lid | ✓ | ✓ | ✓ | – | 危险(hazardous) |
| H44 | 研磨固体物质 | Grind Solid Substance | ✓ | ✓ | ✓ | ✓ | |
原表注:The IG-10K task suite. All base tasks by domain, with the levels at which each is instantiated (✓ present, – omitted). Per-domain counts: Household 12, Supermarket 7, Restaurant 17, Logistics 4, Hospital 6, Laboratory 7.
表 6 解读
表中每一行是一个基础任务,“编号”沿用原文的 H 编号,L0–L3 四列表示该任务是否在对应层级上有实例,“备注”给出省略 L3 的理由。原表把领域写在左侧的合并单元格中,这里改为分组标题行,以便跨页排版;英文任务名保留原文的小型大写字体。任务数核对。逐行计数:家居 12 个(H1–H6、H28、H35、H49、H50、H57、H58),超市 7 个(H7–H13),餐厅 17 个(H14–H25 共 12 个,加 H45–H48、H56),物流 4 个(H26、H27、H29、H30),医院 6 个(H31–H34、H36、H37),实验室 7 个(H38–H44),与表注和正文第 3.2.1 节给出的 12、7、17、4、6、7 完全一致,合计 12+7+17+4+6+7=53 个,符合“50+ 个基础任务”的说法。编号从 H1 排到 H58,其中 H51–H55 这 5 个编号没有出现(58-5=53),可能是开发过程中被剔除的任务。编号与领域并不严格对应,例如 H28、H35 归在家居,夹在物流和医院编号之间。另有一处归类值得留意:“装订文件”(H24)被归入餐厅领域,看起来更像办公或物流任务,原文未作解释。层级覆盖核对。所有 53 个任务都有 L0、L1、L2 实例;省略 L3 的有 6 个:物流的 H29“撕开包装取样”(定义不清),医院的 H33“倒药液”(危险)和 H36“把器械放进托盘”(定义不清),实验室的 H38“在烧杯中搅拌液体”、H39“倾倒液体试剂”和 H43“打开容器盖”(均为危险)。其中 4 个标为危险、2 个标为定义不清,实验室领域占了一半,与正文“如实验室中的危险液体操作”的举例一致。由此得到 53\times4-6=206 个任务—层级组合,即正文所说的“200+ 个任务变体”。不过,正文第 3.2.1 节数据集对比表中写的是“50 tasks with 4 levels”,而实际上有 6 个任务没有 L3,这一表述略有夸大。省略理由的一致性。“定义不清”的直觉是:撕包装取样、放置手术器械这类任务的目的与特定物体绑定得很紧,很难找到“不同类别但能达成同一目的”的替代物而不显得牵强。“危险”的直觉是:用一个非标准容器去倒药液或化学试剂,可能洒漏、污染或产生安全问题。但这一标准在表内并不完全一致:实验室的 H41“过滤溶液”同样涉及液体却保留了 L3,餐厅的 H48“揭开锅盖查看”与被判为危险的 H43“打开容器盖”动作类似却保留了 L3,医院的 H37“清洁容器口”也保留了 L3。合理的解释是危险性取决于具体液体或容器内容(化学试剂、药物),而非动作本身,但原表只给了一个词作为理由,读者无法逐一验证。
原文
Multi-modal annotation. Each video carries three annotation layers. (i) Language: structured descriptions of the demonstrated task at three levels of abstraction–per-arm sub-task sequence, semantic task description, and underlying intent–authored by human annotators and augmented with Qwen3-VL. These three abstraction levels are precisely what the VLA captioner of Section 3.2.3 consumes. (ii) Hand pose: 3D MANO hand pose estimated by WiLoR (per-view; see Appendix E). (iii) Segmentation: semantic segmentation masks from Grounded-SAM-2, conditioned on per-video object inventories. The mask layer is an offline annotation produced for analysis and future training objectives rather than a component of the scoring pipeline; its generation procedure and quality control are described separately in Appendix D.
译文
多模态标注。每段视频带有三层标注。(i) 语言:对所示范任务在三个抽象层次上的结构化描述——逐臂的子任务序列、语义任务描述和背后的意图——由人工标注员撰写,并借助 Qwen3-VL 加以扩充。这三个抽象层次正是第 3.2.3 节中 VLA 描述生成器(captioner)所使用的输入。(ii) 手部姿态:由 WiLoR 估计的 3D MANO 手部姿态(逐视角估计;见附录 E)。(iii) 分割:由 Grounded-SAM-2 生成的语义分割掩码,以每段视频的物体清单为条件。掩码层是为分析和未来的训练目标而生成的离线标注,并不是评分流程的组成部分;其生成流程和质量控制在附录 D 中单独描述。
解释
三种语言描述的抽象层次与 L0–L3 的保真度阶梯大致对齐:逐臂子任务序列(如“左臂拿起茶壶、右臂扶住杯子、左臂倾倒”)接近动作层,适合 L0/L1;语义任务描述(“往杯中倒茶”)对应 L2;背后的意图(“准备一杯热饮”)对应 L3。正文第 3.2.3 节中,以语言为条件的 VLA 基线并不直接看人类视频,而是先由一个视觉语言模型把人类视频“转述”成文字,再把文字交给 VLA;这里的三层标注就是该转述器要生成的目标格式。MANO 是常用的参数化手部网格模型,用少量形状和姿态参数描述手的三维形态;WiLoR 是从单张图像估计 MANO 手部姿态的方法,“逐视角”指在每路相机上分别估计。Grounded-SAM-2 把开放词汇检测(Grounding DINO)与 SAM 2 分割结合起来,“以物体清单为条件”是指先告诉它这段视频里有哪些物体名称,再由它去找、去分割。作者特别强调掩码不参与评分,是为了避免评分依赖一个本身可能出错的自动标注流程。
原文
Constructing the L2 sub-cases. The appearance-only and shape-changing sub-cases of L2 (Appendix A.2) are built by controlled substitution. For the appearance-only sub-case we replace a task-relevant object with one of the same semantic category and the same geometry but different appearance (e.g. a ceramic cup and a glass cup sharing a mesh up to material), isolating perceptual invariance. For the shape-changing sub-case we additionally vary geometry within the category (e.g. a handleless cup and a handled mug), so the policy must also adapt grasp and motion.
译文
构造 L2 子情形。L2 的“仅外观变化”与“形状变化”两种子情形(附录 A.2)通过受控替换构造。对于仅外观变化的子情形,我们把一个与任务相关的物体替换为语义类别相同、几何形状相同但外观不同的物体(例如共用同一网格、只是材质不同的陶瓷杯和玻璃杯),从而单独考察感知不变性。对于形状变化的子情形,我们还在类别内部改变几何形状(例如无把杯和带把马克杯),因此策略还必须调整抓取和运动。
解释
“共用同一网格、只是材质不同”是在仿真中最容易精确实现的方式:同一个三维网格模型换一套材质贴图,几何完全一致,只有 A 变化,满足“仅外观”的严格定义。真实世界中要找到形状严格相同、材质不同的两个杯子更难,原文没有说明真实数据如何保证几何一致,这意味着“仅外观”子情形可能主要来自仿真部分。这一段与附录 A.2 中的子情形定义一一对应,前者讲“为什么要区分”,这里讲“怎么造出来”。正文和附录在报告主要指标时把两者合并为 L2。
原文
L3-omitted tasks. A small number of tasks omit L3 where affordance substitution would be semantically ill-defined or unsafe; these are marked in Table 6, the laboratory hazardous-liquid cases being the canonical example.
译文
省略 L3 的任务。少数任务在可供性替换会造成语义定义不清或不安全时省略了 L3;这些任务已在表 6 中标出,实验室中的危险液体操作是其中的典型例子。
解释
按表 6,省略 L3 的共 6 个任务(H29、H33、H36、H38、H39、H43),占 53 个基础任务的约 11%。“危险液体”在严格意义上只能对应 H33(药液)、H38(烧杯中搅拌液体)和 H39(液体试剂)三项,H43“打开容器盖”被标为危险大概是因为容器中装的是试剂。由于 L3 少了这 6 个任务,在比较 L3 与 L0–L2 的平均成功率时,参与平均的任务集合并不完全相同;被省略的恰好是“难以找到替代物”或“风险高”的任务,若把它们纳入,L3 的表现可能更差。原文没有讨论这一任务集合不一致对层级间比较的影响。
B.2语料构造、数据划分以及仿真与真机的关系
原文
This appendix expands the split description of Section 3.2.1 and states exactly which data are used to pre-train the models evaluated in Section 4.
译文
本附录展开第 3.2.1 节中关于数据划分的描述,并明确说明第 4 节所评测的模型究竟用哪些数据做预训练。
解释
这是一段导引。正文第 3.2.1 节只用一两句话交代了“15/30/45 任务嵌套语料”和“5 个已见、5 个未见评测任务”,第 4 节的规模实验(Q2)又依赖这个划分,所以作者把细节集中放到这里。读本节时要抓住三件事:仿真和真机两套数据怎样分开又怎样对齐;三个预训练语料怎样嵌套;评测任务怎样分成已见和未见。
原文
Two domains, one experimental structure. Simulation and the real world are separate domains. The embodiments differ (dual-arm Franka in ManiSkill3 versus dual-arm Realman), and the visual sensor statistics differ, so we never mix the two corpora: simulation models are trained on simulation data and evaluated in simulation, real-world models are trained on real data and evaluated on hardware. Everything else is held common. Both domains use the same model configurations and hyper-parameters, the same input/output interface (the ZED2i RGB stream as input; dual-arm 7-DoF joint commands plus gripper as output), and the same
lerobot data format, so a single training codebase produces both sets of variants. Both use the same human-to-robot pairing: one human demonstration video is paired with the robot episodes of the corresponding task, and the same human clip serves all four levels of that task. Both use the same task split, listed below. A small number of real tasks have no simulated counterpart, because the required objects or contact behaviors are not reproducible with our simulation assets; these are the only points at which the two domains' corpora differ, and the 15/30/45 nesting and the seen/unseen assignment are preserved in each domain. Simulated paired episodes do not use a separately recorded human demonstration. A simulated episode reuses the real human clip recorded for the same task, with only the imitator scene replaced by its simulated counterpart. MANO hand pose is provided only for real human clips. 译文
两个域,同一套实验结构。仿真和真实世界是两个相互独立的域。两者的本体(embodiment)不同(ManiSkill3 中的双臂 Franka 与真机上的双臂 Realman),视觉传感器的统计特性也不同,因此我们从不混用两套语料:仿真模型用仿真数据训练、在仿真中评测,真机模型用真实数据训练、在硬件上评测。除此之外的一切都保持一致。两个域使用相同的模型配置和超参数、相同的输入/输出接口(输入为 ZED2i 的 RGB 视频流;输出为双臂各 7 自由度的关节指令加夹爪指令),以及相同的
lerobot 数据格式,因此同一套训练代码即可产出两组模型变体。两个域采用相同的人—机配对方式:一段人类示范视频与对应任务的机器人回合配对,并且同一段人类视频服务于该任务的全部四个等级。两个域还使用相同的任务划分(见下文)。少数真实任务没有仿真对应,因为所需的物体或接触行为无法用我们的仿真资产复现;这是两个域的语料唯一不同之处,而 15/30/45 的嵌套关系以及已见/未见的分配在每个域内都保持不变。仿真配对回合并不另外录制人类示范:一个仿真回合复用为同一任务录制的真实人类视频,只是把模仿者(imitator)场景换成其仿真版本。MANO 手部姿态只为真实人类视频提供。 解释
这一段讲清了仿真与真机的关系:它们是平行的两套实验,而不是“仿真预训练 + 真机微调”的 sim-to-real 关系。分开的理由是本体和相机都不同,混在一起训练会把“域差异”这个额外变量带进来,干扰对模仿能力本身的比较。除了数据来源,其余变量(模型结构、超参数、接口、数据格式、配对方式、任务划分)全部对齐,所以两个域的结论可以相互印证。“同一段人类视频服务于全部四个等级”很关键:在 L0–L3 四个等级中,示范 V 本身不变,变的只是模仿者面对的场景(L0 同场景,L1 布局改变,L2 物体换成同类,L3 需要功能替代)。这样,四个等级之间的性能差异只能归因于场景错配程度,而不是示范视频的质量差异。同理,仿真回合直接复用真实人类视频,意味着在仿真里模型看到的是“真实的人手 + 仿真的机器人场景”,这本身带有一个视觉域跨度;MANO 手部姿态(参数化手模型给出的关节角)只在真实视频上有,仿真没有额外的手部标注。口径上的一个疑点:作者说少数真实任务没有仿真对应,又说“15/30/45 的嵌套和已见/未见分配在每个域内都保持”。如果缺失的任务落在表 7 的 45 个任务之内,那么仿真里的 \mathcal C_{45} 就不足 45 个任务;如果它们在 45 个之外(正文说共有 50+ 个基础任务,45+5=50,多出来的可能正是这些仅真机任务),则两个域的语料其实完全相同。原文没有说清属于哪种情况。
表 7:预训练语料与未见任务划分。三个语料是嵌套的:30 任务语料在 15 任务语料的基础上加入所列任务,45 任务语料又在 30 任务语料的基础上加入它自己的一组。粗体标出五个已见评测任务。五个未见任务不出现在任何语料中。
| 语料 | 任务 |
| \mathcal{C}_{15} | StirSpoon, PlaceClothBasket, PlaceMagazineFolder, PickWash, PlaceChipsRack, PlaceFruitBox, PlacePlateRack, CutFruit, PlaceFileFolder, PlaceBrushRest, CleanCup, GrindFood, LiftLidFromSkillet, FoldTowel, PlaceMugRack |
| \mathcal{C}_{30}(新增) | PlaceCommodityRack, PourKetchupFries, WipePot, CleanDesk, TransFood, PickTennisBallGolfBall, PickPillToRegions, PourLiquidCup, PlaceCupPlate, PutCubeOnScale, PourCup, PutBox, KnifeBowlFork, PressJuicer, PlaceScrewdriver |
| \mathcal{C}_{45}(新增) | PlaceBookBookcase, PickAppleBasket, PickAppleBananaToBaskets, PickAppleToScale, PickFruitsToPlate, PlaceFoodScale, PressStapler, ScanPillBottle, PlaceShoeBox, OpenBox, PlacePillBox, PourLiquidMug, OpenLiquidCap, PourLiquidFilter, PlaceBurgerTray |
| 未见 | PickRemoteControl, ScanMilkBox, PourKettle, PickFood, FoldBox |
原表注:Pre-training corpora and the unseen split. The three corpora are nested; the 30-task corpus adds the listed tasks to the 15-task corpus, and the 45-task corpus adds its own to the 30-task corpus. Bold marks the five seen evaluation tasks. The five unseen tasks appear in no corpus.
表 7 解读
读法。表的每一行是一组任务。第一行 \mathcal C_{15} 是最小语料的全部 15 个任务;第二、三行只列“新增”的 15 个任务,因此 \mathcal C_{30} 等于第一、二行之和,\mathcal C_{45} 等于前三行之和。我逐一数过,三行恰好各 15 个任务,没有重复,嵌套关系 \mathcal C_{15}\subset\mathcal C_{30}\subset\mathcal C_{45} 成立。最后一行是 5 个未见任务,不属于任何语料。任务名是代码中的标识符,基本上就是“动作 + 物体 + 目标位置”,例如 PlaceMugRack 是把杯子挂到杯架上,PourKetchupFries 是往薯条上挤番茄酱。已见与未见任务。五个粗体的已见任务全部取自 \mathcal C_{15},所以无论用哪个规模的语料预训练,它们都在训练集中;这保证了已见任务上的规模比较是公平的(不会出现“小语料没见过这个任务”的情况)。按 B.2 正文的描述,它们与任务名的对应是:
未见任务的五类技能在原文里是按“单臂放置、双臂扫描、双臂放置、倾倒、铰接折叠”的顺序列出的,与表中顺序不同,上面的对应是按任务名推断的。回合数核对。表 7 本身只列任务成员,不给回合数,所以只能按文字推算。本节最后一段说“每个任务—等级对(task–level pair)有 50 条预训练示范”,那么每个任务有 4\times50=200 条,\mathcal C_{15},\mathcal C_{30},\mathcal C_{45} 分别为 3{,}000、6{,}000、9{,}000 条机器人回合(每个域)。而正文第 4.1 节写的是“每个任务 50 条示范”,按这种读法则是 15\times50=750、1{,}500、2{,}250 条,相差 4 倍。用数据集总量交叉检验:仿真部分共约 10K 配对回合,若 50 个基础任务(45 个语料任务 + 5 个未见任务)\times 4 个等级 \times 50 条,恰好是 10{,}000,与“每个任务—等级对 50 条”吻合。因此我判断正确口径是每个任务—等级对 50 条,正文的“每个任务 50 条”是不严谨的说法。
| 组别 | 任务名 | 描述(原文措辞) |
| 已见 | StirSpoon | 用细勺搅拌(stirring with a thin spoon) |
| 已见 | FoldTowel | 叠毛巾 |
| 已见 | PlaceMugRack | 把杯子挂到杯架上 |
| 已见 | PlaceFileFolder | 把文件放入文件夹(filing a folder) |
| 已见 | PlacePlateRack | 把盘子放进碗碟架 |
| 未见 | PickRemoteControl | 单臂放置(推断) |
| 未见 | ScanMilkBox | 双臂扫描(推断) |
| 未见 | PickFood | 双臂放置(推断) |
| 未见 | PourKettle | 倾倒 |
| 未见 | FoldBox | 铰接物体的折叠 |
原文
Nested pre-training corpora. The three pre-training corpora are nested, \mathcal{C}_{15} \subset \mathcal{C}_{30} \subset \mathcal{C}_{45}, and were assembled so that motion types, manipulated objects, scene domains, and horizon lengths stay as diverse as each budget permits. The intent is that corpus scale is the variable that changes between them, rather than diversity or task character; scaling results (Section 4.3) should be read against this construction. The five unseen tasks are excluded from all three corpora. Table 7 lists the membership.
译文
嵌套的预训练语料。三个预训练语料是嵌套的,\mathcal{C}_{15} \subset \mathcal{C}_{30} \subset \mathcal{C}_{45};组建时让动作类型、被操作物体、场景领域和任务时长在每个预算下都尽可能多样。这样做的意图是:语料之间变化的变量是规模,而不是多样性或任务性质;规模实验的结果(第 4.3 节)应当结合这一构造来解读。五个未见任务被排除在全部三个语料之外。各语料的成员见表 7。
解释
嵌套设计是规模实验的标准做法:大语料包含小语料的全部任务,所以从 15 到 45 的性能变化只能来自“多出来的任务”,不会因为换掉了某些任务而混入别的因素。作者同时强调每个规模都尽量保持多样性,目的是让“规模”成为唯一的主变量。但要注意,这只是组建时的意图,原文没有给出量化的多样性指标来证明三个语料的多样性真的相当;45 个任务和 15 个任务在绝对多样性上必然不同(更多任务本身就意味着更多物体和动作),所以“规模”与“多样性”实际上不可能完全分离。读第 4.3 节的规模曲线时,应理解为“更大且尽量同样分散的任务集合”的效应。
原文
Seen and unseen evaluation tasks. Evaluation uses five seen tasks drawn from \mathcal{C}_{15} and five unseen tasks. The seen tasks are the long-horizon or dexterous members of the corpus – stirring with a thin spoon, folding a towel, hanging a mug on a rack, filing a folder, and placing plates in a rack – and test how faithfully a model reproduces demanding learned behavior given a human reference. The unseen tasks are individually simpler and closer to atomic skills (single-arm placement, bimanual scanning, bimanual placement, pouring, and an articulated folding task), but their demonstrations, objects, and layouts are absent from every corpus, so they test acquisition of a new skill from the reference alone rather than recall. Both groups are evaluated at all four levels, giving 40 task–level pairs per domain, with 10 trials per pair in simulation and 5 on hardware.
译文
已见与未见评测任务。评测使用取自 \mathcal{C}_{15} 的五个已见任务和五个未见任务。已见任务是语料中时程较长或需要灵巧操作的成员——用细勺搅拌、叠毛巾、把杯子挂到杯架上、把文件放入文件夹、把盘子放进碗碟架——它们检验模型在给定人类参考时能多忠实地复现已经学过的高难度行为。未见任务单个来看更简单、更接近原子技能(单臂放置、双臂扫描、双臂放置、倾倒,以及一个铰接物体的折叠任务),但它们的示范、物体和布局都不在任何语料中,因此检验的是仅凭参考视频习得新技能的能力,而不是回忆。两组任务都在全部四个等级上评测,每个域共 40 个任务—等级对;仿真中每对试验 10 次,真机上 5 次。
解释
两组任务考察的东西不同:已见任务难但学过,考“复现得有多忠实”;未见任务简单但没学过,考“能否从一段视频里学会新东西”。这种“难而熟 vs. 易而新”的搭配,使得两组结果不能直接比数值高低,但能分别反映记忆复现和泛化习得。试验量推算:每个域 5+5=10 个任务 \times 4 个等级 =40 个任务—等级对。仿真中每对 10 次,则一个模型在一种设置下,已见部分有 20\times10=200 个回合,未见部分也是 200 个;真机每对 5 次,相应为 100 个。B.3 中给出的总回合数(仿真 36{,}000、真机 4{,}800)可以由此推回,见 B.3 的解释。另外,正文第 4.1 节把第四个已见任务写成“pick up a paper”(拿起一张纸),这里写的是“filing a folder”,任务名为 PlaceFileFolder,两处措辞不一致,应以这里和表 7 为准。
原文
Substitution patterns and supervision per task–level pair. Each task–level pair uses exactly one substitution pattern. The number of possible substitutions grows as the level rises, so allowing more of them at L3 than at L0 would mean comparing how varied the substitutions are instead of how well the policies handle them. Each pair receives 50 pre-training demonstrations, collected with small position variations for robustness. Supervision is therefore equal across levels, and the 10 few-shot demonstrations are not a budget divided among the four levels. Broadening the substitution patterns per level is left to future versions of IG-10K.
译文
每个任务—等级对的替换模式与监督量。每个任务—等级对只使用一种替换模式。可能的替换方式随等级升高而增多,如果允许 L3 比 L0 拥有更多替换方式,比较的就变成了替换的多样程度,而不是策略应对替换的能力。每个任务—等级对有 50 条预训练示范,采集时加入了小幅的位置扰动以提高鲁棒性。因此各等级获得的监督量相同,而 10 条少样本示范也不是一份在四个等级之间分摊的预算。扩展每个等级的替换模式留给 IG-10K 的后续版本。
解释
“替换模式”指在某个等级下,模仿者场景相对示范场景具体改了什么。例如“泡茶”任务:L1 的替换是把茶包从右边挪到前面,L2 是把茶包换成散茶叶,L3 是没有茶,需要用别的东西实现同一意图。L0 几乎只有“完全不改”一种可能,而 L3 理论上有无数种功能替代方式;如果 L3 采集了很多种替代,模型在 L3 上的表现就会同时受“替代有多杂”影响。作者把每个等级固定为一种模式,是为了让等级之间只差“错配程度”这一个变量,代价是每个等级的覆盖面很窄,模型可能只是记住了这一种替换。监督量方面,每个任务—等级对 50 条,各等级相同。最后一句“10 条少样本示范不是在四个等级间分摊的预算”的意思是:少样本适配时每个等级各有 10 条,而不是 10 条分给四个等级(每级 2–3 条)。也就是说一个未见任务共有 4\times10=40 条适配示范。正文第 4.1 节写作“每个任务 10 条示范”,与此处的“每个任务—等级对 10 条”口径不同;与上面 50 条示范的情况一样,正文的说法容易引起误读。
B.3Imitator Arena:评分流程与指标定义
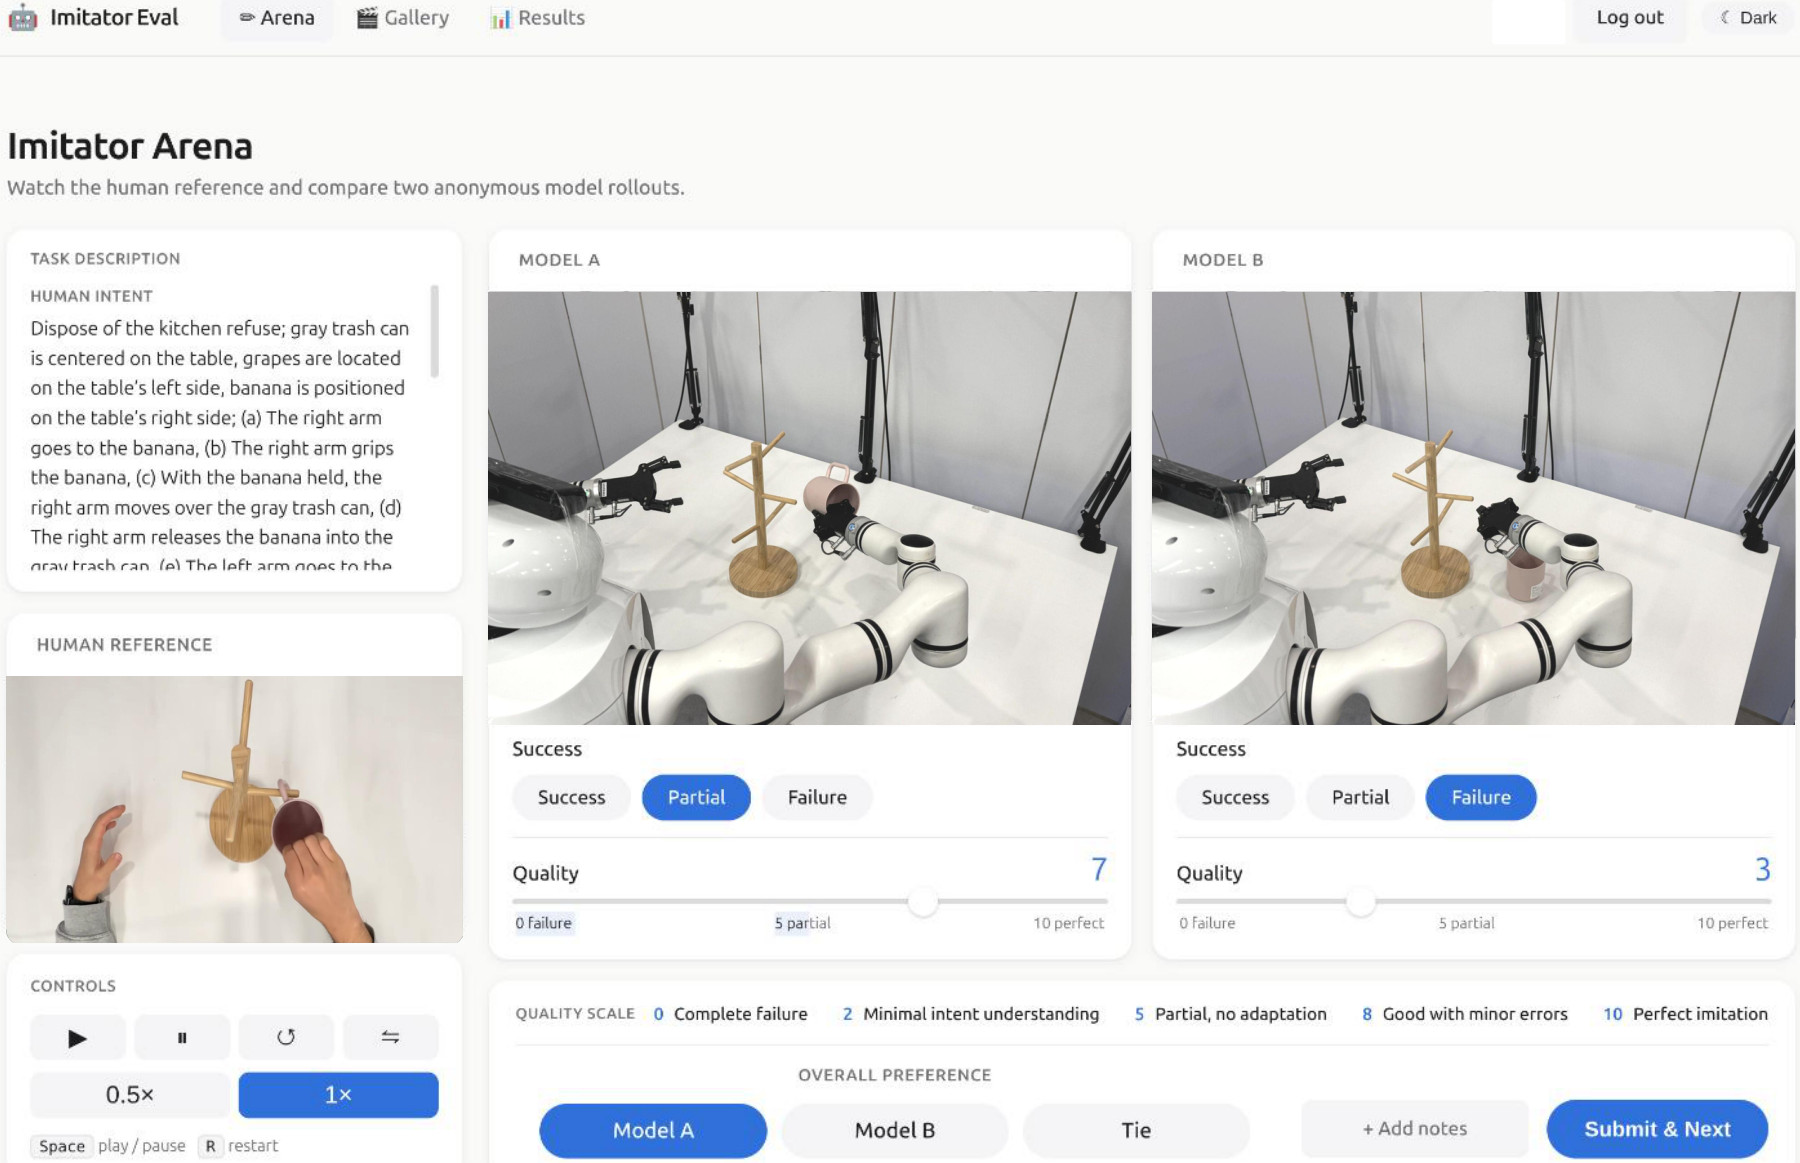
图 6:Imitator Arena。网页界面左侧显示任务描述和人类参考视频,右侧是来自同一模仿者场景的两条匿名模型执行录像。人类评估者对每条录像判断任务完成情况(成功/部分/失败),在固定的 0–10 量表上给出模仿质量分,并给出整体的成对偏好或平局判断。等级标签和模型身份都被隐藏,使评估集中在对示范意图的模仿上。
原图注:The Imitator Arena. The web interface shows the task description and human reference video on the left, and two anonymized model rollouts from the same imitator scene. Human evaluators judge each rollout for task completion (SUCCESS/PARTIAL/FAILURE), assign an imitation-quality score on a fixed 0–10 scale, and make an overall pairwise preference or tie decision. Level labels and model identities are hidden to focus evaluation on imitation of the demonstrated intent.
图 6 解读
这是评测平台的截图。左栏从上到下依次是:任务描述(TASK DESCRIPTION / HUMAN INTENT,用文字写明场景布局和每只手臂的分步动作,截图中的例子是“处理厨余垃圾”:灰色垃圾桶在桌子中央,葡萄在左边、香蕉在右边,右臂抓起香蕉移到垃圾桶上方再松开……),人类参考视频(HUMAN REFERENCE),以及播放控制(播放/暂停、重播、0.5 倍和 1 倍速)。右侧并排是 MODEL A 和 MODEL B 两条机器人录像,各自下方有“Success / Partial / Failure”三选一按钮和一个 0–10 的质量滑块;截图里 A 被标为 Partial、质量 7,B 被标为 Failure、质量 3。底部一行印着质量量表的五个锚点(0 完全失败、2 对意图理解极少、5 部分模仿且无适应、8 良好模仿但有小错误、10 完美模仿,即表 8),再下方是整体偏好的三个按钮 Model A / Model B / Tie,以及“添加备注”和“提交并进入下一条”。这张图对应正文第 3.2.2 节的“三个问题”:每条录像各答一次完成情况和质量分,每个界面再答一次成对偏好。界面上不出现等级(L0–L3)和模型名,评估者只能根据示范视频本身判断“这个场景下怎样算好的模仿”。值得注意的是,截图左上的任务描述讲的是“扔厨余垃圾”,而人类参考视频和两条机器人录像都是“把杯子挂到木质杯架上”(PlaceMugRack 一类的场景),文字与视频不属于同一个任务;这很可能只是界面演示时拼接的截图,不影响对评测流程的理解,但严格说是图中的一处不一致。
原文
This appendix expands Section 3.2.2 with the platform and annotation protocol, the imitation-quality rubric, the pairwise-comparison protocol, the full execution-and-scoring procedure, the formal metric definitions with a worked per-task example, and annotation reliability.
译文
本附录展开第 3.2.2 节,依次介绍平台与标注协议、模仿质量评分细则、成对比较协议、完整的执行与评分流程、带有单任务实例的形式化指标定义,以及标注可靠性。
解释
本节的结构是:先讲人类评测怎么做(平台、细则、配对),再讲自动指标怎么算(SR、Sub-SR),最后用 PourKettle 举例。注意引言里提到的“标注可靠性”并没有单独成段,相关内容(每对示范—录像被重复评判 3–5 次)其实写在下一段“平台与标注协议”之中。
原文
Platform and annotation protocol. Imitator Arena is a web platform on which each annotation screen presents three time-synchronized videos–the demonstration V and two anonymized, randomly ordered rollouts on the same imitator scene–and collects the three judgments of Section 3.2.2. Annotation is carried out by a pool of 10 human evaluators who divide the workload roughly evenly, so that each annotation screen is judged by one human evaluator and each human evaluator contributes approximately one tenth of the total. The evaluators are volunteers with no involvement in the project; no crowdsourcing platform was used, participation was voluntary and uncompensated by task, and no personal data were collected, so the study raises no additional ethical concerns. Restricting a screen to a single evaluator is what keeps judgments independent and lets the platform double as an anonymous public leaderboard, and reliability is obtained by repetition rather than by co-annotation of a screen: screens are drawn at random from the eligible pool, so at the study's volume each demonstration–rollout pair is judged 3–5 times, by different evaluators, on independently sampled screens. Supporting multiple annotators per screen, and reporting an explicit inter-annotator agreement statistic alongside the qualification pass, is a planned extension of the platform. In total the human study comprises 15{,}000 pairwise comparisons in simulation and 5{,}000 on real hardware, drawn from 36{,}000 distinct simulation rollouts and 4{,}800 distinct real-world rollouts (the per-bucket breakdown is given below). Model identities and imitation levels are never shown, and the left/right order of the two rollouts is randomized to control position bias.
译文
平台与标注协议。Imitator Arena 是一个网页平台,每个标注界面同时呈现三段时间同步的视频——示范 V,以及在同一模仿者场景上的两条匿名且随机排序的执行录像(rollout)——并收集第 3.2.2 节中的三项判断。标注由 10 名人类评估者组成的评估池完成,他们大致平均分担工作量:每个标注界面由一名评估者判断,每名评估者贡献约十分之一的总量。评估者是与本项目无关的志愿者;没有使用众包平台,参与是自愿的、不按任务计酬,也没有收集个人数据,因此本研究不涉及额外的伦理问题。将每个界面限定为单人评判,既保证了判断彼此独立,也让平台可以兼作匿名的公开排行榜;可靠性则通过重复评判而非多人共同标注同一界面来获得:界面从符合条件的候选池中随机抽取,因此在本研究的标注量下,每一对示范—录像会在独立抽取的不同界面上、由不同评估者评判 3–5 次。支持每个界面多名标注者,并在资格审核之外报告明确的标注者间一致性统计量,是平台计划中的扩展。人类研究总计包含仿真中的 15{,}000 次成对比较和真机上的 5{,}000 次,分别取自 36{,}000 条不同的仿真录像和 4{,}800 条不同的真实录像(各桶的细分见下文)。模型身份和模仿等级从不显示,两条录像的左右顺序随机化,以控制位置偏差。
解释
这一段交代人类评测的“人、量、控偏差”。人:10 名与项目无关的志愿者,每个界面只有一人打分;可靠性不靠多人同时标一个界面,而靠同一条录像被随机抽到多次、由不同人评判。控偏差:隐藏模型名和等级,随机左右顺序。作者也承认目前没有报告标注者间一致性(如 Cohen's \kappa),这是一个明显的不足。录像总数可以由 B.2 推出来:仿真中 15 个模型变体、3 个语料规模,每种设置下已见或未见部分各 200 个回合,若 4 种设置(Seen、ZS、Scr.、P+FT)都按 3 个规模计,则 15\times3\times4\times200=36{,}000;真机 4 个模型,4\times3\times4\times100=4{,}800。两个数恰好都对上,但这意味着从头训练(Scr.)的模型也被算了 3 次。Scr. 不经过预训练,与语料规模无关,所以这可能是每个规模各跑了一次(例如不同随机种子),原文没有解释;如果 Scr. 只算一次,总数应是 30{,}000 和 4{,}000。“每对评判 3–5 次”与总量对不上。每个界面包含两条录像,所以仿真 15{,}000 个界面只提供 30{,}000 次“录像出场”,平均到 36{,}000 条录像上不足 1 次;真机 5{,}000 个界面提供 10{,}000 次出场,平均到 4{,}800 条录像上约 2.1 次。按下文的分桶数字再细算:真机已见桶 2{,}500 个界面对 1{,}200 条录像,约 4.2 次,符合 3–5 次;但真机迁移桶 5{,}000 次出场分给 2{,}400 条录像只有约 2.1 次,而真机零样本桶根本没有界面(见下文)。仿真中三个桶分别只有约 1.3、0.67、0.67 次。因此“3–5 次”最多只对真机已见桶成立,与总量自相矛盾;同样,“\mathrm{SR}_{\text{human}} 和 \overline Q 在全部 36{,}000 条仿真录像上计算”也不可能,因为至少有一部分录像从未出现在任何界面上。
原文
Quality rubric. The per-rollout imitation-quality score q \in [0,10] (question (2) of Section 3.2.2) is collected on a fixed anchored scale displayed on every annotation screen, so that scores are comparable across human evaluators, models, and levels. Human evaluators are shown the five anchors of Table 8 and may assign any integer in [0,10], interpolating between adjacent anchors. The same rubric is applied identically at all levels: it is the demonstration V, not a level label, that defines what a faithful imitation is, consistent with the level being withheld from the human evaluator.
译文
质量评分细则。每条录像的模仿质量分 q \in [0,10](第 3.2.2 节中的问题 (2))在一个带固定锚点的量表上收集,该量表显示在每个标注界面上,使分数在不同评估者、模型和等级之间可比。评估者看到的是表 8 中的五个锚点,可以给出 [0,10] 内的任意整数,在相邻锚点之间插值。同一套细则在所有等级上完全相同地使用:界定“忠实模仿”的是示范 V 本身,而不是等级标签,这与评估者看不到等级的做法一致。
解释
锚定量表(anchored scale)是主观评分中常用的校准手段:给几个关键分值配上文字描述,让不同人对“5 分”有大致相同的理解。这里五个锚点 0、2、5、8、10 并不等距,低分段(0–2)区分“完全失败”和“稍微理解意图”,中段 5 是“部分模仿但不做适应”,高分段 8–10 区分小错误与完美。评估者打 6 分,就表示介于“部分模仿、无适应”和“良好模仿、有小错误”之间、更接近前者。“同一细则用于所有等级”有一个隐含难点:在 L3,忠实模仿意味着用替代物完成意图,而不是照搬动作;评估者不知道等级,只能自己从示范与场景的差异中推断“这里应该怎么适应”。锚点 5 明确写了“无适应”,说明作者希望把“照搬动作但不适应场景”压在中间分,而把会适应的执行推向 8–10。
表 8:模仿质量评分细则。向人类评估者展示的五个固定锚点,用于每条录像的分数 q \in [0,10](问题 (2))。中间的整数在相邻锚点之间插值。
| 分数 | 锚点 | 英文原文 |
| 0 | 完全失败 | Complete failure |
| 2 | 对意图的理解极少 | Minimal intent understanding |
| 5 | 部分模仿,无适应 | Partial imitation, no adaptation |
| 8 | 良好模仿,有小错误 | Good imitation with minor errors |
| 10 | 完美模仿 | Perfect imitation |
原表注:Imitation-quality rubric. The five fixed anchors shown to human evaluators for the per-rollout score q \in [0,10] (question (2)). Intermediate integers interpolate between adjacent anchors.
表 8 解读
表只有两列内容:分数和对应的文字锚点(我们加了一列英文原文便于对照)。读这张表时要结合正文表 3、表 4 中的 \overline Q:例如真机已见任务上 XSkill 的 \overline Q=7.49,大致落在“良好模仿、有小错误”附近;零样本时 \pi_{0.5} 的 \overline Q=2.34,接近“对意图理解极少”。同时 \pi_{0.5} 的零样本人类成功率只有 0.04,说明 \overline Q 确实在成功率接近零时仍能区分失败的程度,这正是作者引入质量分的理由。由于锚点不等距,\overline Q 的差值不宜按线性刻度解读:从 5 到 8 是从“不适应”到“基本做好”的质变,而从 0 到 2 只是从“完全没反应”到“略有意图”。
原文
Pairwise-comparison protocol. An A/B screen pairs two rollouts only when they are directly comparable, which we enforce by bucketing every evaluation rollout by its transfer setting and pairing only within a bucket. The three buckets are seen (the five seen evaluation tasks), zero-shot (the five unseen tasks executed directly from a pre-trained checkpoint), and transfer (the same five unseen tasks after few-shot adaptation, comprising both the pre-train+fine-tune and the from-scratch conditions, which are therefore mutually comparable); the three settings are defined in Section 4.1. Within a bucket, two rollouts are paired only when they share the same task, level, and episode, so the two videos differ only in the policy that produced them; rollouts from the same model at different pre-training scales (15/30/45) are comparable and are paired within the bucket. Simulation and real-world rollouts are never paired with each other, as they originate from distinct visual and dynamical domains; pairing is therefore confined to a single (domain, setting, task, level, episode) cell, and because the Arena randomizes which rollout is shown as A versus B, a pair is unordered. In simulation, where all baselines are evaluated, this yields 15{,}000 annotated screens–6{,}000 seen, 6{,}000 transfer, and 3{,}000 zero-shot. On real hardware four models are evaluated; the 5{,}000 real-world screens are therefore split 2{,}500 seen and 2{,}500 transfer.
译文
成对比较协议。A/B 界面只把可以直接比较的两条录像配成一对。为此,我们按迁移设置把每条评测录像分桶,并且只在桶内配对。三个桶分别是:已见(五个已见评测任务)、零样本(五个未见任务,直接用预训练检查点执行)和迁移(同样五个未见任务在少样本适配之后,既包括“预训练+微调”条件,也包括“从头训练”条件,因此这两者可以相互比较);三种设置的定义见第 4.1 节。在一个桶内,两条录像只有在任务、等级和回合(episode)都相同时才配对,这样两段视频之间唯一的差别就是生成它们的策略;同一模型在不同预训练规模(15/30/45)下的录像也被视为可比,同样在桶内配对。仿真录像与真实录像从不相互配对,因为它们来自不同的视觉和动力学域;因此配对被限制在单个(域、设置、任务、等级、回合)单元格内。又因为 Arena 会随机决定哪条录像显示为 A、哪条显示为 B,所以一对录像是无序的。在评测了全部基线的仿真中,这产生了 15{,}000 个已标注界面——已见 6{,}000、迁移 6{,}000、零样本 3{,}000。真机上评测了四个模型;因此 5{,}000 个真机界面被分为已见 2{,}500 和迁移 2{,}500。
解释
这是理解胜率 WR 的关键段落。分桶的逻辑是“只比可比的东西”:零样本模型没见过任务数据,拿它和微调过的模型比显然不公平,所以单独成桶;而从头训练(Scr.)和预训练+微调(P+FT)都用了同样的 10 条/等级适配示范,区别只在有没有 IG-10K 预训练,因此放在同一个“迁移”桶里比,正好回答“预训练有没有用”。桶内还要求同任务、同等级、同回合(即同一个初始场景),这是一种配对设计,排除了场景难度差异。一个配对单元格里有哪些录像?以真机迁移桶为例:4 个模型,每个模型有 Scr. 的录像和 P+FT 在 15/30/45 三个规模下的录像。按原文“同一模型不同规模也可配对”,候选对可以是“XSkill-P+FT-45 对 \pi_{0.5}-Scr.”,也可以是“XSkill-P+FT-15 对 XSkill-P+FT-45”。一个直接的矛盾:按本段,真机只有已见和迁移两个桶,没有零样本桶;但正文表 4 在真机 ZS 一栏给出了 SR、\overline Q 和 WR 三项人类评测结果。既然 SR_\text{human} 和 \overline Q 都是在标注界面上逐条录像收集的(见下一段),没有界面就不应有这些数,更不应有 WR。原文没有交代真机 ZS 结果从何而来。
原文
Execution and scoring. For each evaluation episode the platform rolls out the policy until the task terminates or a fixed horizon is reached, and records the full trajectory and the final scene state. Two scoring streams are then produced. The first is the per-rollout absolute-success judgment: in simulation, where the scene state is fully observable, it is scored by the final and sub-goal success rates defined below (fast, reproducible, and suited to large-scale evaluation) and additionally by Arena human evaluation, so that the two can be cross-validated; on real hardware no automated metric is available and the Arena human judgment is the sole source. This judgment is the per-rollout task-completion question (question (1) of Section 3.2.2), recorded on a three-way scale (success / partial / fail), together with the quality score q. The second stream is pairwise human preference, collected in both regimes as described above. The metrics built from these two streams are defined next.
译文
执行与评分。对每个评测回合,平台执行策略直到任务终止或达到固定时长上限,并记录完整轨迹和最终场景状态。随后产生两路评分。第一路是逐条录像的绝对成功判断:在场景状态完全可观测的仿真中,它由下文定义的最终成功率和子目标成功率来计分(快速、可复现,适合大规模评测),并另外由 Arena 人类评估打分,以便二者交叉验证;在真机上没有可用的自动指标,Arena 的人类判断是唯一来源。这一判断就是逐条录像的任务完成问题(第 3.2.2 节问题 (1)),以三级量表(成功 / 部分 / 失败)记录,同时记录质量分 q。第二路是成对的人类偏好,在两种情形下都按上文所述收集。由这两路评分构建的指标定义如下。
解释
两路评分可以这样理解:第一路是“绝对分”,每条录像单独打(仿真里由程序判定 + 人工判定,真机里只有人工);第二路是“相对分”,两条录像比较谁更好。绝对分回答“做成了没有、做得多像”,相对分回答“谁比谁好”,后者对评分尺度的个体差异不敏感(一个打分偏严的评估者,在 A/B 选择上仍能给出一致的排序)。仿真中两种绝对分并存,所以可以检验人类判断与程序判断是否一致,这是附录图 13 所做的对齐验证的基础。
原文
Human success rate, mean quality, and win rate. The human success rate is the fraction of rollouts judged success; a partial verdict does not count toward success, matching the hard criterion of the automated \mathrm{SR} below. Over a set of judged rollouts \mathcal{R},
\mathrm{SR}_{\text{human}} \;=\; \frac{1}{|\mathcal{R}|} \sum_{r \in \mathcal{R}} \mathbf{1}\!\bigl[\text{verdict}(r) = \text{success}\bigr], \qquad \overline{Q} \;=\; \frac{1}{|\mathcal{R}|} \sum_{r \in \mathcal{R}} q_r ,
both computed over distinct rollouts (36{,}000 in simulation, 4{,}800 on real hardware), so \overline{Q} admits partial credit and separates failures that the binary success question collapses. For the pairwise preference question, each annotated screen awards 1 to the preferred rollout, 0.5 to each rollout on a tie, and 0 to the other; a model's win rate \mathrm{WR} is its mean awarded score over all screens in which it participates. Because pairing respects the (domain, setting, task, level) structure above, \mathrm{SR}_{\text{human}}, \overline{Q}, and \mathrm{WR} can all be resolved by level post hoc even though the level is hidden from human evaluators at judgment time. 译文
人类成功率、平均质量分与胜率。人类成功率是被判为成功的录像所占的比例;部分的判定不计入成功,这与下文自动指标 \mathrm{SR} 的硬标准一致。对一组被评判的录像 \mathcal{R},
\mathrm{SR}_{\text{human}} \;=\; \frac{1}{|\mathcal{R}|} \sum_{r \in \mathcal{R}} \mathbf{1}\!\bigl[\text{verdict}(r) = \text{success}\bigr], \qquad \overline{Q} \;=\; \frac{1}{|\mathcal{R}|} \sum_{r \in \mathcal{R}} q_r ,
二者都在互不相同的录像上计算(仿真 36{,}000 条,真机 4{,}800 条)。因此 \overline{Q} 允许给部分分,能把二元成功问题所合并在一起的各种失败区分开。对于成对偏好问题,每个已标注界面给被偏好的录像记 1 分,平局时两条录像各记 0.5 分,另一条记 0 分;一个模型的胜率 \mathrm{WR} 是它在所参与的全部界面上所得分数的平均值。由于配对遵循上述(域、设置、任务、等级)结构,尽管评判时对评估者隐藏了等级,\mathrm{SR}_{\text{human}}、\overline{Q} 和 \mathrm{WR} 都可以事后按等级拆分。 解释
符号。\mathcal R 是参与统计的录像集合,|\mathcal R| 是其条数;\mathbf 1[\cdot] 是指示函数,条件成立取 1,否则取 0;\text{verdict}(r) 是录像 r 的三级判定;q_r 是它的质量分。\mathrm{SR}_\text{human} 就是“判为成功的条数 / 总条数”,\overline Q 就是质量分的算术平均。小例子:4 条录像判定为成功、部分、部分、失败,质量分 9、6、4、1,则 \mathrm{SR}_\text{human}=1/4=0.25,\overline Q=20/4=5.0。两条“部分”在 SR 里都算 0,但在 \overline Q 里分别贡献 6 和 4,这就是“部分分”的含义。原文没有说明一条录像被评判多次(3–5 次)时如何合并,例如是先对多次判定取平均还是取多数票。WR 的定义要点。(i) 每个界面总共发出 1 分:胜者 1、负者 0,或平局各 0.5。平局不算 0,而是算半胜。(ii) 一个模型的 WR 是“它所参与的界面的平均得分”,即按参与次数归一化,而不是按总界面数归一化。(iii) 配对只在桶内进行,迁移桶同时包含 Scr. 和 P+FT。由定义推出的守恒关系。设桶内共有 S 个界面,第 i 个参赛者参与 n_i 次、胜率为 \mathrm{WR}_i。每个界面发出 1 分、占用两个参赛名额,所以 \sum_i n_i\,\mathrm{WR}_i=S,\sum_i n_i=2S,即按参与次数加权的平均 WR 恒等于 0.5,与平局多少无关。若各参赛者参与次数相同,则 k 个参赛者的 WR 之和恰为 k/2。用正文表 4(真机)检验。已见栏四个模型的 WR 为 0.56+0.89+0.41+0.14=2.00,恰好等于 4/2,与“4 个模型在同一桶内、参与次数相同、平局各记 0.5”完全一致(表中值是 3 个规模的平均,若 12 个“模型\times规模”参赛者参与次数相同,其和为 6,按规模平均后仍为 2)。ZS 栏之和为 0.04+0.50+0.42+0.25=1.21<2。如果按定义平局各记 0.5,一个只含这 4 个模型的封闭桶在参与次数相同时之和必为 2;要得到 1.21,要么参与次数极不均衡,要么平局被当作双方都记 0(那么约有 (2-1.21)/2\approx40\% 的界面是平局,这在大多数录像都失败的零样本设置下倒也合理)。但后一种解释与原文“平局各记 0.5”的定义直接冲突,而且已见栏恰好等于 2.00 又意味着已见桶内一个平局都没有,两种处理不可能同时成立。更根本的是,上一段已说明真机没有零样本桶,ZS 栏的 WR 在原文协议下根本无从产生。迁移桶的情况。P+FT 栏之和为 0.73+0.95+0.70+0.58=2.96>2。如果 P+FT 自成一个封闭的 4 模型桶,其和最多为 2(把平局记 0 只会让它更小),所以 2.96 说明 P+FT 的录像确实大量地与桶外的对手——也就是 Scr. 的录像——比较并赢下了它们。这一点支持 Scr. 与 P+FT 同在一个迁移桶里,与本段定义一致,也使表 4 中 \Delta\mathrm{WR}=\mathrm{P{+}FT}-\mathrm{Scr.}(0.73-0.50=0.23 等,四行都对得上)有了“同场竞技”的含义。可是,把两栏合起来看,8 个参赛者之和为 1.50+2.96=4.46,而参与次数相同时应为 8/2=4.00。多出的 0.46 不可能由平局规则解释(平局记 0 只会让和变小),只能来自参与次数不均衡。按守恒关系,设每个 Scr. 条目参与 n_s 次、每个 P+FT 条目参与 n_p 次,则 1.50\,n_s+2.96\,n_p=0.5\times4\,(n_s+n_p),解得 n_s\approx1.92\,n_p,即每个模型的 Scr. 录像被抽中的次数要接近 P+FT 录像(三个规模合计)的两倍。可是按原文“从候选池随机抽取界面”,一个单元格里每个模型有 1 条 Scr. 录像和 3 条 P+FT 录像(3 个规模),随机抽取时 P+FT 被抽中的次数应当更多,而不是更少;即使按总录像数推断 Scr. 也跑了 3 次,二者也应大致相当,此时和应为 4.00。因此,表 4 迁移桶的 WR 数值与本段的定义和配对协议无法相互吻合,原文对 WR 的实际计算方式(是否按规模分别归一化、是否另有参照对手等)没有交代清楚。最后一句“可事后按等级拆分”的意思是:等级虽然不给评估者看,但每个界面的录像都带着(任务、等级)标签,统计时可以只取 L3 的界面算 L3 的 WR,附录 C 中的逐等级分析(如第 C.5 节“层级在哪里变难”)正是这样得到的。
原文
Final success rate. For each episode a binary success predicate checks whether all task-relevant goal states are satisfied at termination. Aggregated over the evaluation set \mathcal{E},
\mathrm{SR} \;=\; \frac{1}{|\mathcal{E}|} \sum_{e \in \mathcal{E}} \mathbf{1}\!\bigl[\text{all task-relevant goal-state predicates hold in } e\bigr].
\mathrm{SR} is a hard, binary criterion: an episode either satisfies all goal predicates or it does not. The phase definitions and success predicates are hand-crafted per task to reflect that task's goal states and intermediate milestones. 译文
最终成功率。对每个回合,一个二值的成功谓词检查在终止时所有与任务相关的目标状态是否都得到满足。在评测集 \mathcal{E} 上汇总,
\mathrm{SR} \;=\; \frac{1}{|\mathcal{E}|} \sum_{e \in \mathcal{E}} \mathbf{1}\!\bigl[\text{回合 } e \text{ 中所有与任务相关的目标状态谓词均成立}\bigr].
\mathrm{SR} 是一个硬性的二值标准:一个回合要么满足全部目标谓词,要么不满足。阶段定义和成功谓词按任务手工设计,以反映该任务的目标状态和中间里程碑。 解释
\mathcal E 是评测回合的集合(例如仿真中一个模型在已见任务上的 200 个回合),“谓词”就是一个判真假的条件,比如“杯子挂在杯架上”。所有谓词取逻辑与,任一不满足即记 0。注意判定发生在终止时:过程中做成过、最后又弄掉了,也算失败。这与下文 Sub-SR 记录“过程峰值”的做法正好相反。
原文
Sub-goal success rate. Each task is decomposed into M ordered sub-goal phases. For each phase j the tracker records the peak value of the corresponding shaped sub-reward over the episode horizon, and the phase is counted as completed when that peak exceeds a fixed threshold. Letting m_e \le M denote the number of completed phases in episode e,
\mathrm{Sub\text{-}SR} \;=\; \frac{1}{|\mathcal{E}|} \sum_{e \in \mathcal{E}} \frac{m_e}{M}.
\mathrm{Sub\text{-}SR} measures the fraction of the task pipeline the policy executes and serves as a continuous proxy for imitation depth when \mathrm{SR} is near zero. 译文
子目标成功率。每个任务被分解为 M 个有序的子目标阶段。对每个阶段 j,跟踪器记录对应的塑形子奖励(shaped sub-reward)在整个回合时长内的峰值,当该峰值超过一个固定阈值时,该阶段被计为完成。记 m_e \le M 为回合 e 中完成的阶段数,
\mathrm{Sub\text{-}SR} \;=\; \frac{1}{|\mathcal{E}|} \sum_{e \in \mathcal{E}} \frac{m_e}{M}.
\mathrm{Sub\text{-}SR} 衡量策略执行了任务流程中的多大比例,在 \mathrm{SR} 接近零时可作为模仿深度的连续代理指标。 解释
符号。M 是任务的阶段数,m_e 是回合 e 完成的阶段数,m_e/M 是该回合的完成比例,Sub-SR 是它在所有回合上的平均。“塑形子奖励”是强化学习里常用的连续奖励,例如“夹爪到把手的距离越近,奖励越高”;跟踪器取它在整个回合中的最大值,与阈值比较。“有序”是否要求按顺序完成?按字面定义,不要求。“有序”只描述任务在设计上的先后结构(先接近、再抓取……),而计数规则是对每个阶段各自独立地看峰值是否过阈值,再数有几个阶段过了;定义里没有“第 j 阶段必须在第 j-1 阶段之后发生”或“只计连续完成的前缀”这样的条件。所以 m_e 是“达标阶段的个数”,不是“按顺序走到了第几步”。实际上,很多塑形奖励本身带有前置条件(例如“倾倒”要求水壶在杯子上方倾斜,这物理上已经蕴含了抓起和搬运),因此在大多数情况下两种口径给出的结果相同;但原文没有明说,严格地讲,一个跳过某阶段却达成后续阶段的回合,在这个定义下也能拿到部分分。峰值规则的后果。因为取的是整个回合中的峰值,所以“抓起来又掉了”的回合仍然算完成了“抓取”阶段,这正是它作为“过程深度”指标的用意:它奖励做到过的部分,而 SR 只看终态。小例子:M=4,三个回合分别完成 4、2、0 个阶段,则 SR 为 1/3\approx0.33(假设只有第一个回合终态全部达标),Sub-SR 为 (1+0.5+0)/3=0.5。正文表 3 中 ACT/DINOv2 的 SR =0.81、Sub-SR =0.93,就体现了 Sub-SR 恒不低于 SR 的关系(只要成功回合的所有阶段都达标)。
原文
Scope of the automated metrics. Both metrics apply uniformly across all levels as general task-completion indicators, which is why the simulation experiments report them as a single overall score rather than per level; the per-level fidelity view is the responsibility of the Arena human evaluation. We do not define a trajectory-similarity metric because the human–robot embodiment gap leaves a trajectory-level predicate without an unambiguous reference, so \mathrm{SR} and \mathrm{Sub\text{-}SR} are the sole automated proxies. On real hardware neither automated metric is used, and all absolute success judgments come from Arena human evaluation.
译文
自动指标的适用范围。两个指标作为通用的任务完成指标,在所有等级上统一适用,这也是仿真实验把它们报告为一个总体分数而不是按等级报告的原因;按等级的忠实度视角由 Arena 人类评估负责。我们不定义轨迹相似度指标,因为人与机器人之间的本体差异使得轨迹层面的谓词缺乏一个无歧义的参照,因此 \mathrm{SR} 和 \mathrm{Sub\text{-}SR} 是仅有的自动代理指标。真机上两个自动指标都不使用,所有绝对成功判断都来自 Arena 人类评估。
解释
这段说明了自动指标的局限。SR 和 Sub-SR 只看“任务是否完成”,不看“完成得像不像示范”。在 L0 这样的同场景等级,忠实模仿理应包括动作方式相似,但作者没有轨迹相似度指标:人手和双臂机器人结构不同,人的手腕轨迹不能直接拿来和机械臂末端轨迹比。于是“像不像”完全交给人类评估。这也解释了为什么正文表 3(仿真)只报总体 SR/Sub-SR,而按等级的分析主要依靠人类的 \overline Q 和 WR。
原文
Worked example: predicate and phases for PourKettle. To make the hand-crafted predicates concrete, we give the full specification for one task. The PourKettle goal predicate is the conjunction of a fill condition and a spill condition,
\text{success} \;=\; \bigl[\text{liquid in cup} \ge \tau_{\text{fill}}\bigr] \;\wedge\; \bigl[\text{liquid spilled} \le \tau_{\text{spill}}\bigr],
with thresholds \tau_{\text{fill}}=20 and \tau_{\text{spill}}=20 on the simulated liquid volume. The task decomposes into M=4 ordered sub-goal phases–reach (gripper within \epsilon of the kettle handle), grasp (stable contact, kettle lifted), transport (kettle spout positioned above the cup), and pour (kettle tilted past the pour angle while above the cup)–each with a shaped sub-reward whose peak is thresholded as in the \mathrm{Sub\text{-}SR} definition. 译文
实例:PourKettle 的谓词与阶段。为了让手工设计的谓词更具体,我们给出一个任务的完整规格。PourKettle(用水壶倒水)的目标谓词是一个注满条件与一个洒出条件的合取,
\text{success} \;=\; \bigl[\text{杯中液体量} \ge \tau_{\text{fill}}\bigr] \;\wedge\; \bigl[\text{洒出液体量} \le \tau_{\text{spill}}\bigr],
其中阈值 \tau_{\text{fill}}=20、\tau_{\text{spill}}=20,作用于仿真的液体量。该任务被分解为 M=4 个有序子目标阶段——接近(夹爪距水壶把手在 \epsilon 以内)、抓取(稳定接触且水壶被提起)、搬运(壶嘴位于杯子上方)和倾倒(在杯子上方时水壶倾斜超过倾倒角)——每个阶段都有一个塑形子奖励,其峰值按 \mathrm{Sub\text{-}SR} 的定义做阈值判断。 解释
\wedge 表示逻辑“与”:杯中至少有 \tau_\text{fill} 的液体,且洒到外面的不超过 \tau_\text{spill},两条同时满足才算成功。这样设计是为了排除两种“投机”:只倒不准(洒一桌但杯里也有一点)和完全不倒。原文没有给出液体量的单位(可能是仿真中的粒子数或毫升),也没有给出 \epsilon 和倾倒角的具体数值,所以“20”的绝对意义无法判断,只能看出注满与洒出用了同一个数值门槛。结合 Sub-SR:若一个回合把水壶提起并移到杯子上方,但始终没有倾斜,则完成了接近、抓取、搬运三个阶段,m_e/M=3/4=0.75,而 SR 记 0。若倾倒了但洒出超过 20,则四个阶段都过了,Sub-SR 记 1,SR 仍为 0。后一种情况说明 Sub-SR =1 并不等于成功。PourKettle 是五个未见任务之一,所以这个例子描述的正是零样本和少样本设置下的评分方式。
B.4基线适配细节
原文
This appendix expands Section 3.2.3 with the per-family mechanisms, encoders, and training recipes. The video encoder or vision–language backbone is frozen and only the action-generation module is trained on IG-10K paired data, following each method's original recipe except where the imitator-game interface requires adaptation. Figure 7 shows how each family is wired up to be called with the reference videos and robot observation; the full per-model hyperparameters are in Appendix F.
译文
本附录展开第 3.2.3 节,介绍各个方法族的机制、编码器和训练方案。视频编码器或视觉—语言主干被冻结,只有动作生成模块在 IG-10K 配对数据上训练;除了模仿者游戏的接口需要适配之处,均遵循各方法原本的训练方案。图 7 展示了每个方法族如何接线,以便用参考视频和机器人观测来调用;每个模型的完整超参数见附录 F。
解释
统一接口是 a_t=\pi(V,o_t):输入示范视频 V 和当前机器人观测 o_t,输出当前动作 a_t。三个方法族原本的条件输入各不相同(语言、技能、视频),本节说明如何把它们都改造成“吃一段人类视频”的形式。“冻结编码器、只训动作头”是贯穿全节的统一约束,下文最后两段解释了这样做的理由。
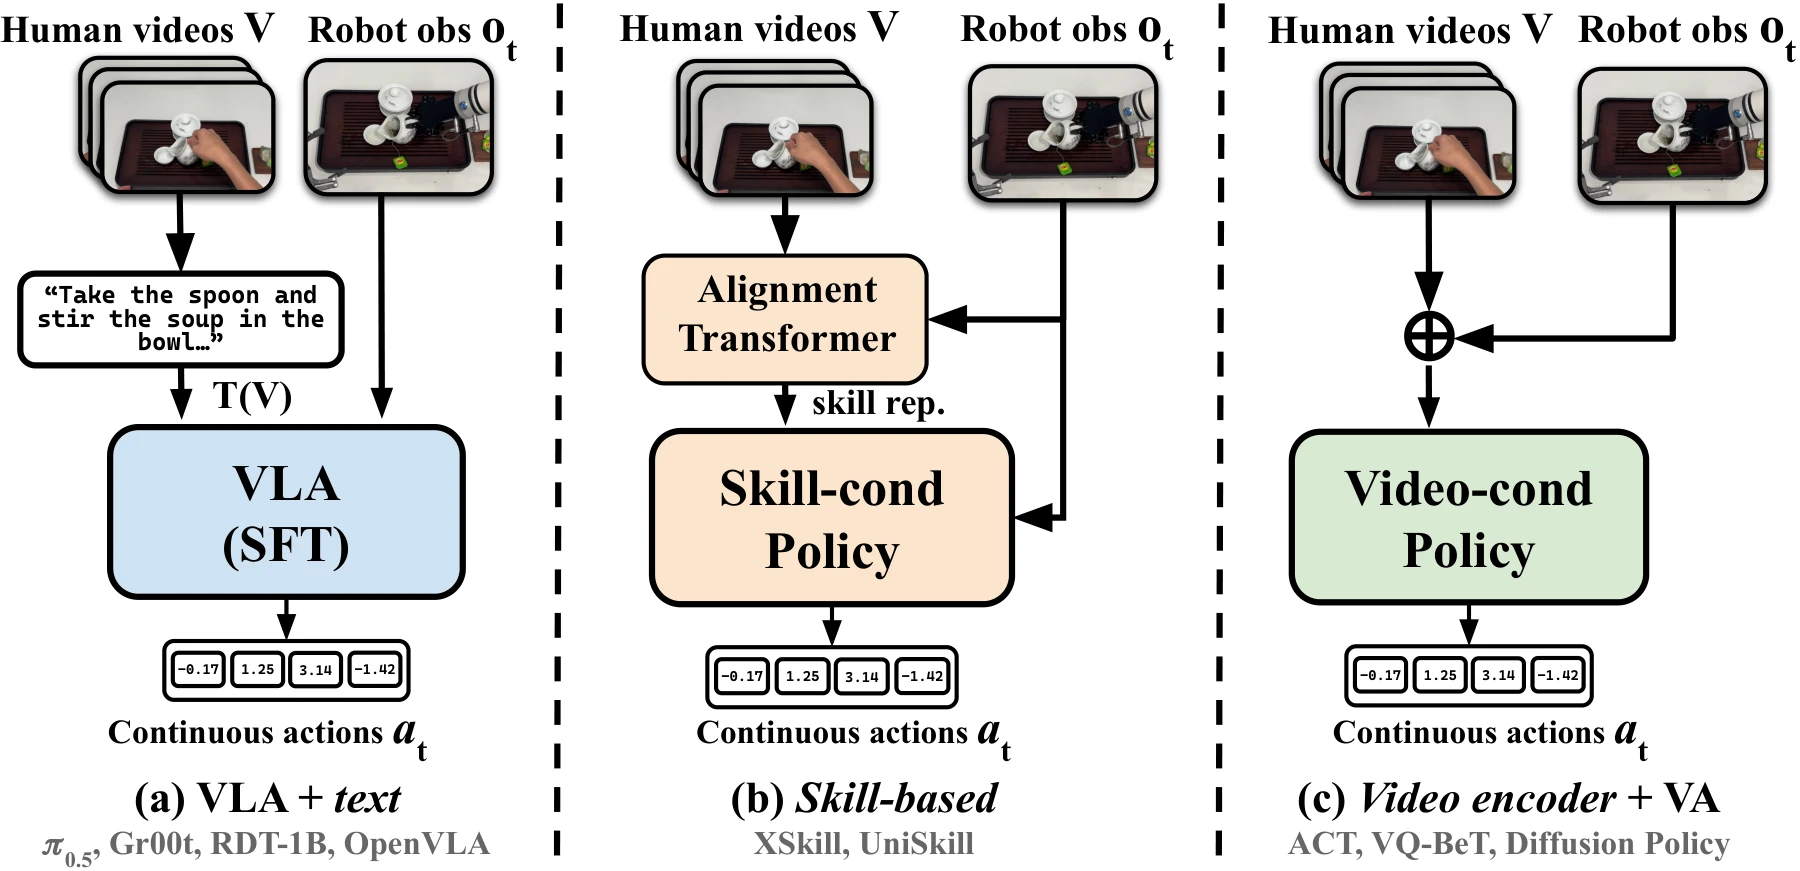
图 7:把三种范式适配到统一的控制接口 a_t = \pi(V, o_t)。在所有方法族中主干都被冻结,只有动作头在 IG-10K 上训练。(a) VLA + 文本:一个固定的描述器 T 把 V 转换成语言提示,输入冻结的视觉—语言主干。(b) 基于技能:一个冻结的编码器从 V 中提取跨本体的技能表示,由一个以技能为条件的策略根据检索到的技能索引执行动作。(c) 视频编码器 + VA:一个冻结的编码器把 V 映射为任务嵌入,与观测 token 拼接后送入 ACT、Diffusion Policy 或 VQ-BeT。
原图注:Adapting three paradigms to a unified control interface a_t = \pi(V, o_t). Across all families the backbone is frozen and only the action head is trained on IG-10K. (a) VLA + text: a fixed captioner T converts V to a language prompt for a frozen vision–language backbone. (b) Skill-based: a frozen encoder extracts a cross-embodiment skill representation from V, and a skill-conditioned policy acts on the retrieved skill index. (c) Video encoder + VA: a frozen encoder maps V to a task embedding concatenated with the observation tokens for ACT, Diffusion Policy, or VQ-BeT.
图 7 解读
三栏并列,顶部都是同样的两路输入:人类视频 V(一叠视频帧)和机器人观测 o_t;底部都输出连续动作 a_t(图中用一串数值方块表示)。区别在中间如何把 V 变成条件。(a) VLA + 文本(蓝色,对应 \pi_{0.5}、GR00T、RDT-1B、OpenVLA):V 先经描述器 T 变成一句文字,例如图中的“Take the spoon and stir the soup in the bowl…”,再与 o_t 一起送入 VLA(标注为 SFT,即监督微调)。视频信息在这里被压缩成了语言,动作细节、物体位置等可能丢失。(b) 基于技能(橙色,对应 XSkill、UniSkill):V 经过一个“对齐 Transformer”得到技能表示(skill rep.),与 o_t 一起送入以技能为条件的策略。(c) 视频编码器 + VA(绿色,对应 ACT、VQ-BeT、Diffusion Policy):V 的嵌入与 o_t 的嵌入直接相加/拼接(图中的 \oplus),送入以视频为条件的策略。这张图是正文各方法比较的“接线图”:三个族的差别本质上是“示范信息以什么形式传给动作头”——语言、离散/连续技能、还是原始视频嵌入。正文的结论“视频条件的方法在已见任务和零样本上优于语言条件的方法”,可以从这里找到直观解释:(a) 中的语言瓶颈丢掉了最多的信息。另外,图注写技能策略作用于“检索到的技能索引”,这适用于 XSkill(离散原型),但 UniSkill 学的是连续的技能表示(见下文),图注的说法对 UniSkill 不够准确。
原文
VLA family. The four VLA backbones (Bjorck et al., 2025; Liu et al., 2025; Intelligence et al., 2025; Kim et al., 2024) are language-conditioned, so the demonstration is first passed through the fixed captioner T(V) \to \ell, implemented via human annotation augmented with Qwen3-VL, which emits the per-arm sub-task sequence, the semantic task description, and the underlying intent–the same three abstraction levels carried as language annotation in IG-10K (Appendix B.1). The description \ell is supplied as the language prompt and the action head is trained while the VLM backbone remains frozen. T is held fixed across all VLA baselines so that performance differences reflect the action heads rather than the captioner; concretely, T applies a single frozen prompt template to Qwen3-VL and emits the three abstraction levels in a fixed format, with no per-model tuning. A caption that was uniformly poor would pull every VLA down together, so we checked the caption channel itself in two ways. First, the captions carry the same information as the video: they state the task intent, the object layout, and the per-arm sub-task sequence together with its motions, and every caption is checked by a human annotator. Second, we test T directly by replacing the VLM-augmented captions with the purely human-written ground-truth annotations of IG-10K and re-evaluating \pi_{0.5}: seen-task \mathrm{SR} changes by 0.01 \pm 0.05 across the three corpus scales, i.e. within noise. We did not search over caption styles, so it is still possible that shorter prompts suit small corpora better; a fuller ablation is future work.
译文
VLA 族。四个 VLA 主干(Bjorck et al., 2025; Liu et al., 2025; Intelligence et al., 2025; Kim et al., 2024)都以语言为条件,因此示范先经过固定的描述器(captioner)T(V) \to \ell。T 的实现方式是人工标注辅以 Qwen3-VL,输出每只手臂的子任务序列、语义任务描述和潜在意图——与 IG-10K 中作为语言标注携带的三个抽象层次相同(附录 B.1)。描述 \ell 作为语言提示输入,训练动作头,而 VLM 主干保持冻结。T 在所有 VLA 基线之间保持固定,使性能差异反映的是动作头而不是描述器;具体来说,T 对 Qwen3-VL 使用单一的冻结提示模板,以固定格式输出三个抽象层次,不针对任何模型做调整。如果描述普遍很差,就会把所有 VLA 一起拉低,因此我们从两方面检查了描述这条通道本身。第一,描述与视频携带相同的信息:它们陈述任务意图、物体布局以及每只手臂的子任务序列及其动作,并且每条描述都经过人工标注者检查。第二,我们直接检验 T:用 IG-10K 中纯人工撰写的真值标注替换 VLM 辅助生成的描述,重新评测 \pi_{0.5},结果已见任务的 \mathrm{SR} 在三个语料规模上的变化为 0.01 \pm 0.05,即在噪声范围内。我们没有搜索不同的描述风格,所以仍有可能更短的提示更适合小语料;更完整的消融留待未来工作。
解释
四个引用按通常的文献对应依次是 GR00T(Bjorck)、RDT-1B(Liu)、\pi_{0.5}(Physical Intelligence)和 OpenVLA(Kim)。VLA 只接受文字指令,所以必须先把视频“翻译”成文字,这就是 T(V)\to\ell。三个抽象层次从细到粗是:逐臂子任务(“右臂抓香蕉、移到垃圾桶上方……”)、语义任务(“扔厨余”)、意图(“清理桌面”),图 6 左上角的任务描述就是这种格式。作者对“语言瓶颈是否不公平地压低了 VLA”做了两项检查:描述内容足够详细且经人工核验;用纯人工描述替换后 \pi_{0.5} 的 SR 几乎不变。但第二项检查只能说明“VLM 辅助描述和人工描述一样好”,不能说明“文字和视频携带同样多的信息”;第一项则只是定性陈述。所以 VLA 族的劣势中有多少来自语言瓶颈本身,这里并没有被排除。另外,T 是“人工标注辅以 Qwen3-VL”,意味着测试时描述也依赖人工参与,这对 VLA 来说其实是一种额外的帮助,而在实际部署中未必能获得。
原文
Skill-based family. XSkill (Xu et al., 2023) discovers a set of cross-embodiment skill prototypes from unlabeled human and robot videos via self-supervised contrastive learning with Sinkhorn–Knopp clustering, and conditions a diffusion policy on the prototype index retrieved for the current observation. UniSkill (Kim et al., 2025) instead learns embodiment-agnostic skill representations through future-frame prediction (Inverse and Forward Skill Dynamics), which removes the need for domain alignment and allows skill transfer from human videos to robot policies trained solely on robot data. Both are trained from scratch on IG-10K, with the skill-conditioned policy stage trained with a frozen video extractor.
译文
基于技能的方法族。XSkill(Xu et al., 2023)通过结合 Sinkhorn–Knopp 聚类的自监督对比学习,从无标注的人类视频和机器人视频中发现一组跨本体的技能原型(skill prototype),并以针对当前观测检索到的原型索引为条件来驱动一个扩散策略。UniSkill(Kim et al., 2025)则通过未来帧预测(逆向与前向技能动力学,Inverse and Forward Skill Dynamics)学习与本体无关的技能表示,这样就不再需要域对齐,并允许把技能从人类视频迁移到仅用机器人数据训练的机器人策略上。两者都在 IG-10K 上从头训练,其中以技能为条件的策略阶段在冻结的视频特征提取器下训练。
解释
这两种方法原本就是为“看人类视频学技能”设计的,所以适配改动最少。XSkill 的思路是把人和机器人的视频片段映射到同一个嵌入空间,再用 Sinkhorn–Knopp 算法(一种把样本均匀分配到各个簇的最优传输算法)聚成若干“技能原型”,人做“抓”和机器人做“抓”会落到同一个原型上;执行时由原型编号驱动扩散策略。UniSkill 不做显式聚类,而是让模型从“当前帧 + 技能表示”预测未来帧(前向动力学)、从“当前帧 + 未来帧”反推技能表示(逆向动力学),这样学到的技能表示只编码“发生了什么变化”,与执行者是人还是机器人无关。需要注意的一处表述差异:本节开头和图 7 说“主干冻结、只训动作头”,而这里说两者都在 IG-10K 上从头训练,只有第二阶段(技能条件策略)是在冻结的视频提取器下训练。也就是说,技能编码器本身是在 IG-10K 上学出来的,并非预训练好的通用编码器;“冻结”只针对第二阶段。这与 VLA 族使用外部大规模预训练主干的情况不同,读正文比较时应留意。
原文
VA family. The action-generation backbones (Zhao et al., 2023; Chi et al., 2025; Lee et al., 2024) are adapted by extracting a task representation from V with one of three frozen video encoders–DINOv2-ViT-L/14 (Oquab et al., 2023), SigLIP2-SO400M (Tschannen et al., 2025), or VideoMAE-Large (Tong et al., 2022)–and concatenating the video embedding to the robot observation embedding at every inference step. The encoder is frozen and shared across all three backbones, and only the action head is trained from scratch, giving the three-encoder \times three-head grid evaluated in Section 4.
译文
VA 族。动作生成主干(Zhao et al., 2023; Chi et al., 2025; Lee et al., 2024)的适配方式是:用三种冻结视频编码器之一——DINOv2-ViT-L/14(Oquab et al., 2023)、SigLIP2-SO400M(Tschannen et al., 2025)或 VideoMAE-Large(Tong et al., 2022)——从 V 中提取任务表示,并在每个推理步把视频嵌入拼接到机器人观测嵌入上。编码器被冻结,并在三个主干之间共享,只有动作头从头训练,由此得到第 4 节中评测的“三种编码器 \times 三种动作头”网格。
解释
VA(video-action)族的三个动作头是 ACT(Zhao,基于 Transformer 的动作块预测)、Diffusion Policy(Chi,扩散生成动作)和 VQ-BeT(Lee,向量量化后的行为 Transformer)。三种编码器代表三种不同的视觉预训练方式:DINOv2 是图像自监督(擅长空间、几何特征),SigLIP2 是图文对比学习(偏语义),VideoMAE 是视频掩码重建(带时间信息)。3\times3=9 个组合,加上 4 个 VLA 和 2 个技能方法,正好是下文提到的 15 个训练变体。“在每个推理步拼接”意味着示范视频的嵌入是一个固定的条件向量,整个回合都附在观测上;由于编码器冻结,V 的嵌入只需算一次。正文中表现最好的 ACT/DINOv2 就出自这个网格。
原文
Why the task encoder is frozen. Freezing the video encoder or vision-language backbone is a comparability-versus-cost trade-off, and we tested the alternative before adopting it. In early runs we unfroze the task-related encoders – the video encoder for the skill and VA families, the VLM backbone for the VLA family – and observed comparable gains on both sides, giving no evidence that freezing penalizes the VLA family in particular. Unfreezing, however, forecloses caching: with a frozen task encoder the encoding of V can be computed once and reused across epochs, which at the scale of our grid (15 trained variants \times three corpus scales, plus few-shot regimes) is an orders-of-magnitude difference in training cost and is what makes the full comparison feasible. We therefore freeze the task encoder in every family and train only the action head, with comparable trainable-parameter counts, and treat a fully unfrozen comparison – and a quantitative estimate of how much end-to-end adaptation adds per family – as future work.
译文
为什么冻结任务编码器。冻结视频编码器或视觉—语言主干是在可比性与成本之间的权衡,我们在采用这一做法之前测试过另一种选择。在早期实验中,我们解冻了与任务相关的编码器——技能族和 VA 族的视频编码器、VLA 族的 VLM 主干——观察到两边获得了相当的提升,没有证据表明冻结会特别不利于 VLA 族。然而,解冻就无法使用缓存:任务编码器冻结时,V 的编码只需计算一次,就能在各个训练轮次中复用;在我们的实验网格规模下(15 个训练变体 \times 三个语料规模,再加上少样本设置),这在训练成本上是数量级的差别,也正是它使完整的比较变得可行。因此我们在每个方法族中都冻结任务编码器、只训练动作头,各模型的可训练参数量相当;完全解冻的比较,以及对端到端适配在各方法族中能带来多少增益的定量估计,留作未来工作。
解释
这一段回应一个潜在质疑:VLA 的强项正是端到端微调大模型,冻结主干会不会故意削弱它?作者的回答是早期实验里解冻对各族的提升“相当”,但没有给出任何数字,所以这只是定性的保证。冻结的真正理由是成本:冻结后每段示范视频的特征可以预先算好存起来(缓存),训练时只跑小的动作头。粗算一下实验量:15 个变体 \times 3 个规模 =45 次预训练,再加 Scr. 和 P+FT 的少样本训练,且仿真与真机各一套;如果每次都要反向传播穿过数亿参数的视觉主干,代价确实会高出很多。“可训练参数量相当”是为了让比较集中在“条件信息的形式”上,而不是模型容量。
原文
Training configuration. All variants are trained on IG-10K under matched compute and a common optimizer schedule, with only the action-generation module updated.
译文
训练配置。所有变体都在 IG-10K 上、在匹配的计算量和统一的优化器调度下训练,只更新动作生成模块。
解释
这是对公平性的最后一句说明:除了条件形式和动作头结构,训练预算和优化设置也对齐。具体的学习率、批量大小、训练步数等见附录 F 的逐模型超参数。原文“匹配的计算量”没有说明是按 GPU 小时、训练步数还是样本数匹配;对于参数量不同的动作头,这几种口径给出的结果并不相同。
C附加实验结果(Additional Experimental Results)
原文
This appendix is organized around the three questions of Section 4, and every figure answers exactly one of them. Q1 – which imitation interface is strongest? Figure 8 compares the three paradigms in simulation and under blind human preference, and Figure 9 isolates the frozen video encoder inside the Video-VA family. Q2 – does scale help zero-shot transfer or few-shot adaptation? Figure 10 reports P+FT scaling and the per-model gain, and Figure 11 resolves the same experiment by hierarchy level. Q3 – where does the hierarchy become hard? Figure 12 contrasts the clean real-world coarse-to-fine decline with the non-monotone simulation profile, and Table 10 checks that the demonstration is what specifies the task in the first place. Figure 13 then asks how far the automated and human scores, and the simulated and physical domains, can stand in for one another; the per-task numbers behind all of these aggregates are in Table 11.
译文
本附录围绕第 4 节的三个问题组织,每张图只回答其中一个问题。 Q1:哪种模仿接口最强?图 8 在仿真中、并借助盲评人类偏好比较三种范式;图 9 单独考察 Video-VA 家族内部的冻结视频编码器。 Q2:规模能否帮助零样本迁移或少样本适应?图 10 报告 P+FT 随规模的变化及每个模型的增益;图 11 把同一实验按层级拆开。 Q3:层级在哪里开始变难?图 12 对比真机上清晰的由粗到细(coarse-to-fine)下降与仿真中的非单调曲线;表 10 检验任务究竟是不是由示范来指定的。随后图 13 探讨自动评分与人类评分、仿真域与物理域在多大程度上可以相互替代。所有这些汇总数字背后的逐任务结果见表 11。
解释
这一段是附录 C 的“目录”。正文第 4 节只有三张表(表 3 仿真、表 4 真机、表 5 真机分层级),大量支撑性的证据被挪到这里:Q1 对应 C.1、C.2,Q2 对应 C.3、C.4,Q3 对应 C.5、C.6,C.7 讨论评测本身是否可信,C.8 指向逐任务的全量参考表(表 11,在附录 H)。需要提前提醒的一点是:开头说图 13 会回答“仿真域与物理域能否相互替代”,但读完 C.7 会发现,图 13 只比较了同一批仿真回合上的自动评分与人评,并没有给出任何仿真对真机的定量一致性指标。仿真与真机的关系只在 C.2(编码器排序)和 C.4、C.5(分层级曲线)中有定性讨论,而且 C.5 恰恰显示两域在层级难度上不一致。
原文
Two scoring channels appear throughout and are always named. The automated channel is the simulated success predicate, reported as \mathrm{SR} and \mathrm{Sub\text{-}SR}; the Arena channel is human judgment, reported as \mathrm{SR}_{\mathrm{human}}, the imitation score \overline{Q} on the 0–10 rubric of Appendix B.3, and the blind A/B win rate \mathrm{WR}. The Arena runs on both domains: on the simulated rollouts, where it can be compared against the automated channel directly, and on hardware, where there is no automated predicate and every reported \mathrm{SR} is therefore a human verdict. Throughout, simulation numbers are averaged over the \{15,30,45\} corpus scales as in the body, and the Video-VA family is shown at its DINOv2 backbone unless noted.
译文
全文出现两个评分通道(scoring channel),并且每次都会注明。自动通道是仿真中的成功判定谓词(success predicate),报告为 \mathrm{SR} 和 \mathrm{Sub\text{-}SR};Arena 通道是人类判断,报告为 \mathrm{SR}_{\mathrm{human}}、按附录 B.3 的 0–10 分细则给出的模仿分 \overline{Q},以及盲评 A/B 胜率 \mathrm{WR}。Arena 在两个域上都运行:在仿真回合上,它可以直接与自动通道比较;在真机上没有自动判定谓词,因此所报告的每个 \mathrm{SR} 都是人类的判定。除非另有说明,仿真数字都与正文一样在 \{15,30,45\} 三个语料规模上取平均,Video-VA 家族默认展示其 DINOv2 骨干版本。
解释
读附录 C 的图时,最重要的是分清每个数字来自哪个通道。仿真里同一批回合(rollout)有两套分数:程序判定的 SR/Sub-SR,和人看录像给出的 \mathrm{SR}_{\mathrm{human}}/\overline{Q}/WR;真机只有后者。所以“真机 SR”与“仿真 SR”不仅是不同的域,也是不同的打分者,两者直接比数值并不严格。“在三个规模上取平均”意味着表 3、表 4 里的一个数字,背后是 15、30、45 任务三个预训练检查点各自评测后的均值。以仿真为例,每个任务–层级组合评测 10 次,一个模型的 Seen 成绩就由 3\times5\times4\times10=600 个回合构成,每个层级 150 个回合;真机每组合只评测 5 次,每个模型每层级为 3\times5\times5=75 个回合。这个样本量在后面判断差异是否显著时会用到。另外,“Video-VA 默认用 DINOv2”只适用于部分图(如图 13);图 8、图 10(b) 实际上画出了全部 9 个 Video-VA 变体。
C.1Q1:哪种模仿接口最强?
原文
Figure 8 unpacks the headline ranking of Section 4.2 along three axes. Panel (a) places all fifteen trained variants on the (\mathrm{seen\text{-}SR},\,\mathrm{P{+}FT\text{-}SR}) plane, both axes automated. The two video-conditioned families cluster in the upper right, while the VLA family stretches along the diagonal from OpenVLA (0.29) to \pi_{0.5} (0.73); seen-task strength and few-shot adaptability are correlated but not interchangeable, and the variants furthest above the diagonal (GR00T, \pi_{0.5}) adapt better than their seen-task score would predict.
译文
图 8 从三个角度拆解第 4.2 节的总体排名。子图 (a) 把全部 15 个训练变体放在 (\mathrm{seen\text{-}SR},\,\mathrm{P{+}FT\text{-}SR}) 平面上,两个坐标都来自自动通道。两个以视频为条件的家族聚集在右上方,而 VLA 家族沿对角线从 OpenVLA(0.29)一直延伸到 \pi_{0.5}(0.73)。已见任务上的强弱与少样本适应能力相关,但不能互相替代;位于对角线上方最远的变体(GR00T、\pi_{0.5})的适应能力好于其已见任务分数所能预示的水平。
解释
横轴是“把学过的任务做好”的能力,纵轴是“用 10 条示范学会新任务”的能力。若两者完全由同一种“模型强弱”决定,点会排成一条线;实际散布说明它们是两种不同能力。核对“对角线上方最远”:按表 3,各点到对角线的纵向距离(P+FT - Seen)为 GR00T 0.67-0.51=+0.16,\pi_{0.5} 0.85-0.73=+0.12,ACT/VideoMAE +0.10。但 DP/VideoMAE 为 0.36-0.14=+0.22,才是离对角线上方最远的点(图中左侧孤立的绿色三角)。作者没有提它,可能是因为它的 Seen 分数极低(编码器与 DP 搭配失效,见 C.2),高出对角线主要是 Seen 太差而不是适应能力特别强。所以正文的说法在“有意义的模型”范围内成立,但严格按图读并不准确。
原文
Panel (b) shows why a family-level bar chart would mislead. Inside the VLA family the variants span 0.29–0.73 and inside Video-VA they span 0.14–0.81, so for two of the three families the spread within the family is wider than the widest gap between any two family means (family means 0.49, 0.77, 0.57; widest gap 0.28). Video-Skill is by far the tightest: its two members behave alike, which is what makes it predictable, not necessarily what makes it best.
译文
子图 (b) 说明了为什么按家族画柱状图会产生误导。VLA 家族内部各变体分布在 0.29–0.73,Video-VA 家族内部分布在 0.14–0.81;因此在三个家族中的两个里,家族内部的离散程度都超过了任意两个家族均值之间的最大差距(家族均值为 0.49、0.77、0.57,最大差距为 0.28)。Video-Skill 是迄今最紧凑的:它的两个成员表现相近,这让它的表现可预测,但并不一定意味着它最好。
解释
验算:按表 3 的 Seen SR,VLA 均值 (0.29+0.43+0.51+0.73)/4=0.49;Video-Skill (0.75+0.79)/2=0.77;Video-VA 九个变体之和为 5.13,均值 0.57。最大家族差 0.77-0.49=0.28;VLA 内部极差 0.44、Video-VA 内部极差 0.67,都大于 0.28,结论成立。这段的用意是给“范式之争”降温:同一家族内,选哪个具体模型、配哪个编码器,造成的差距比换一个家族还大。Video-Skill 之所以紧凑,一部分原因是它只有两个成员(UniSkill 0.75、XSkill 0.79),样本少本身就会让极差偏小。
原文
Panel (c) shows that the ordering is not an accident of how the automated predicate is written. Under blind A/B judgment in the simulation Arena – the same rollouts, scored by people instead of by the predicate – win rate gives the same family ranking (Video-Skill 0.64, Video-VA 0.50, VLA 0.42), with ACT/DINOv2 the single most preferred variant (\mathrm{WR}=0.82, \overline{Q}=8.1).
译文
子图 (c) 表明,这一排序并不是自动判定谓词写法的偶然产物。在仿真 Arena 中进行盲评 A/B 判断(同样的回合,改由人而不是谓词来打分)时,胜率给出相同的家族排序(Video-Skill 0.64、Video-VA 0.50、VLA 0.42),其中 ACT/DINOv2 是最受偏好的单个变体(\mathrm{WR}=0.82,\overline{Q}=8.1)。
解释
验算:按图 8(c) 各变体的 WR,Video-Skill (0.65+0.64)/2=0.645;VLA (0.62+0.56+0.33+0.19)/4=0.425;Video-VA 九个变体之和 4.57,均值 0.508。三个家族均值与正文一致(Video-VA 严格四舍五入应为 0.51,差别可忽略)。人评与自动评分给出同样的家族排序,这是“自动指标没有偏向某个家族”的一个佐证;更系统的通道一致性检验见 C.7。需要注意的是,WR 是“与同一任务、层级、回合下其他模型的成对比较中获胜的比例”,所以它是相对指标:当参赛模型集合变化时,同一模型的 WR 会变。
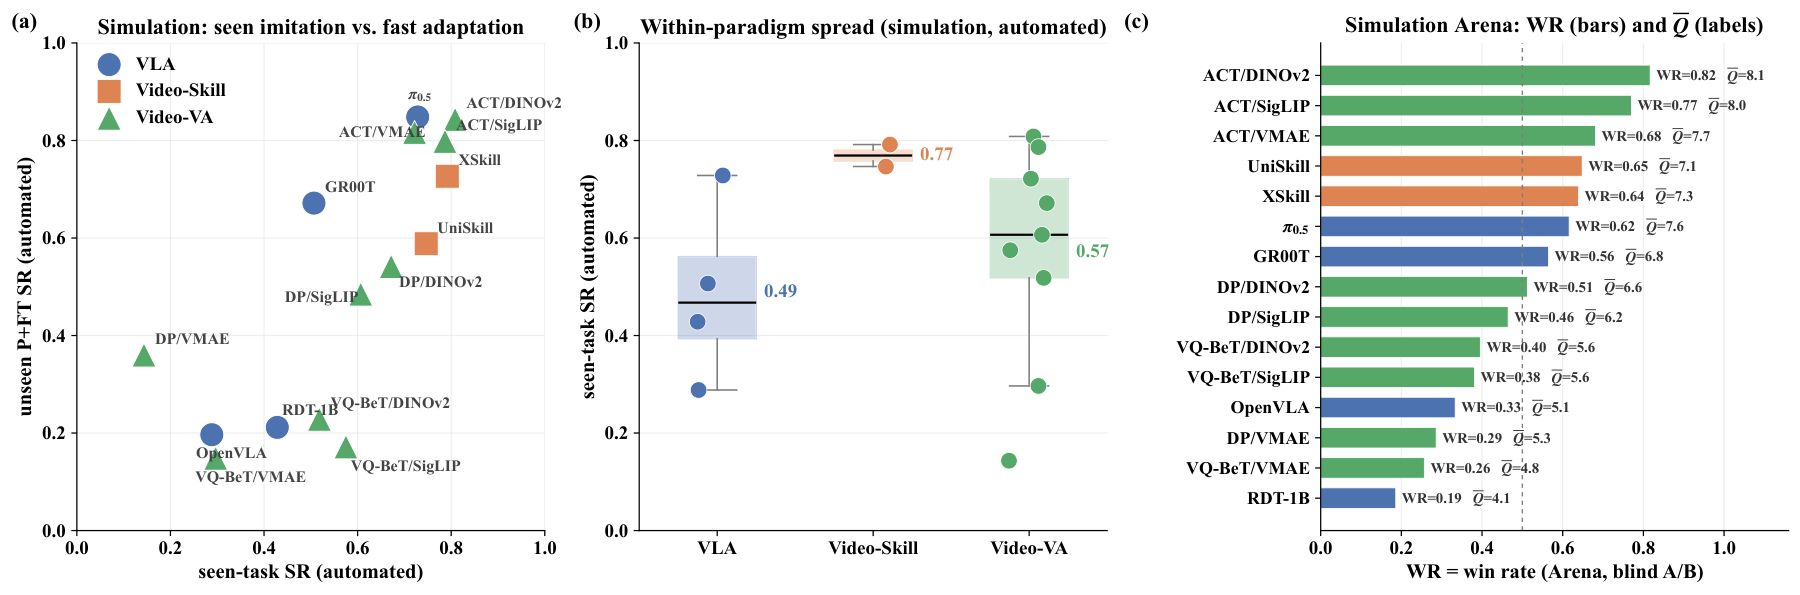
图 8:Q1:哪种模仿接口最强。(a) 每个训练变体在 (\mathrm{seen\text{-}SR},\,\mathrm{P{+}FT\text{-}SR}) 平面上的位置,自动通道;视频家族聚集在右上方,而 VLA 家族沿对角线展开。(b) 各范式内部已见任务 \mathrm{SR}(自动)的分布;对 VLA 和 Video-VA 而言,家族内部离散程度超过家族间的最大差距,Video-Skill 最为紧凑。(c) 仿真 Arena,人类通道。条形长度为盲评 A/B 胜率 \mathrm{WR};每个条形旁的标签给出该变体的 \mathrm{WR} 及其平均模仿分 \overline{Q},后者是另一个量,并未画成条形。在同一批回合上,人类通道重现了自动通道在子图 (a)(b) 中给出的排序。
原图注:Q1: which imitation interface is strongest. (a) Each trained variant on the (\mathrm{seen\text{-}SR},\,\mathrm{P{+}FT\text{-}SR}) plane, automated channel; the video families cluster upper-right while the VLA family stretches along the diagonal. (b) Distribution of seen-task \mathrm{SR} (automated) within each paradigm; the within-family spread exceeds the widest between-family gap for VLA and Video-VA, and Video-Skill is the tightest. (c) Simulation Arena, human channel. Bar length is the blind A/B win rate \mathrm{WR}; the label beside each bar gives that variant's \mathrm{WR} together with its mean imitation score \overline{Q}, which is a separate quantity and is not plotted. The human channel reproduces the ranking that the automated channel gives in panels (a,b) on the same rollouts.
图 8 解读
子图 (a) 是散点图,横轴为已见任务 SR,纵轴为未见任务 P+FT SR,均为自动通道、三个规模平均,坐标与表 3 的 Seen SR、P+FT SR 两列逐一对应。蓝色圆点为 VLA,橙色方块为 Video-Skill,绿色三角为 Video-VA。右上角挤着 ACT 三个变体(Seen 0.72–0.81,P+FT 0.80–0.84)、\pi_{0.5}(0.73, 0.85)和 XSkill(0.79, 0.73);左下角是 OpenVLA、RDT-1B 和三个 VQ-BeT 变体,它们的 P+FT 都只有 0.15–0.23。图上没有画出对角线,读者可以自己想象 y=x:GR00T、\pi_{0.5}、DP/VideoMAE 在线上方,UniSkill(0.75, 0.59)、VQ-BeT/SigLIP2(0.57, 0.17)、RDT-1B(0.43, 0.21)在线下方较远。这说明“已见任务做得好”的模型不一定“学新任务快”,VQ-BeT/SigLIP2 是最明显的反例。子图 (b) 是箱线图叠加散点:每个点是一个变体的 Seen SR,箱体为四分位距,箱内黑线是中位数,旁边的彩色数字(0.49、0.77、0.57)是均值。两者在 VLA(中位数约 0.47)和 Video-VA(中位数 0.61)上并不相同,阅读时不要混淆。Video-VA 下方那个孤立点 0.14 就是 DP/VideoMAE,它把家族均值拉低了约 0.05。子图 (c) 是横向条形图,横轴为仿真 Arena 中的盲评 A/B 胜率,虚线标出 0.5(与对手平均打平)。15 个变体按 WR 从高到低排列,前三名都是 ACT(0.82、0.77、0.68),末尾是 RDT-1B(0.19,\overline{Q}=4.1)。\overline{Q} 与 WR 大体同序,但不完全一致:\pi_{0.5} 的 \overline{Q}=7.6 高于 XSkill 的 7.3 和 UniSkill 的 7.1,WR 却低于这两者,说明“绝对打分”和“两两比较谁更好”捕捉到的东西不完全相同。一个口径疑点:图 8(c) 中 15 个变体的 \overline{Q} 简单平均约为 6.4,而图 13(b) 中仿真已见任务上的 Arena \overline{Q} 在各层级约为 6.7–7.5。由此推测,图 8(c) 的 WR 与 \overline{Q} 可能是在已见、零样本、迁移三个桶上合并统计的(零样本回合的分数很低,会拉低均值),但图注只写了“仿真 Arena”,没有说明统计口径。
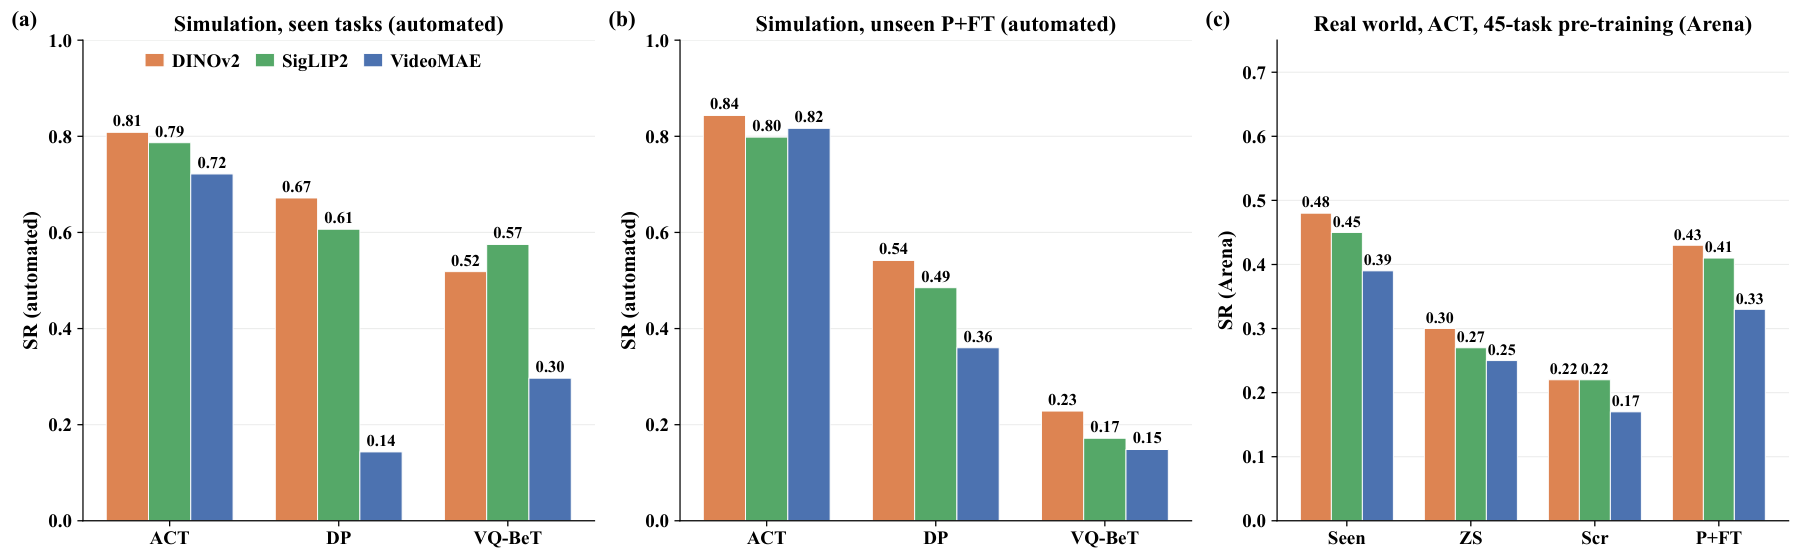
图 9:Q1:冻结的视频编码器。三种 Video-VA 动作头与三种冻结编码器交叉组合的成功率;两个仿真子图为自动通道,真机子图为 Arena 通道。真机上与 ACT 搭配运行的视频编码器只在 45 任务预训练规模下进行了实验。
原图注:Q1: the frozen video encoder. Success rate for the three Video-VA action heads crossed with the three frozen encoders; the two simulation panels are the automated channel and the real-world panel is the Arena channel. Video encoders run with ACT on real-world hardware were only at the 45-task pre-training scale.
图 9 解读
三个子图都是分组柱状图,橙、绿、蓝三色分别代表 DINOv2、SigLIP2、VideoMAE 编码器。子图 (a) 为仿真已见任务 SR,横轴是三种动作头(ACT、DP、VQ-BeT),数值与表 3 的 Seen SR 完全一致。最醒目的是 DP/VideoMAE 只有 0.14,而 DP/DINOv2 为 0.67。VQ-BeT 上的顺序是 SigLIP2(0.57)高于 DINOv2(0.52),所以“DINOv2 \ge SigLIP2”只对 ACT 和 DP 成立。子图 (b) 为仿真未见任务 P+FT SR:ACT 三个编码器几乎拉平(0.84/0.80/0.82,VideoMAE 反而第二),DP 仍是 0.54/0.49/0.36,VQ-BeT 整体都很低(0.23/0.17/0.15)。图中 DP/SigLIP2 标为 0.49,而表 3 为 0.48,相差 0.01,应是四舍五入来源不同。子图 (c) 为真机,只用 ACT,只用 45 任务的预训练检查点,横轴是四种设定(Seen、ZS、Scr、P+FT),纵轴为 Arena 判定的 SR。DINOv2 在四种设定上都最高或并列最高(0.48、0.30、0.22、0.43),VideoMAE 都最低(0.39、0.25、0.17、0.33)。可以与其他图表交叉核对:ACT/DINOv2 的真机 ZS 0.30 与图 10(c) 中 45 任务点一致;Scr 0.22 与表 4 一致(从零训练与预训练规模无关)。与正文结论的关系:正文第 4.2 节说“DINOv2 与 SigLIP2 一致地强于 VideoMAE”,这在 (a)(c) 中成立,但在 (b) 的 ACT 上不成立(VideoMAE 0.82 高于 SigLIP2 0.80)。更重要的是,图 9 显示编码器的影响强烈依赖于动作头,这正是 C.2 要强调的“交互作用”。
C.2Q1:冻结的视频编码器重要吗?
原文
Because every Video-VA variant receives its task specification through a frozen encoder, the encoder is a design choice of for its action head. Figure 9 separates the two. On seen tasks (panel a, automated) the encoder ordering for ACT is DINOv2 \ge SigLIP2 > VideoMAE (0.81/0.79/0.72), but the size of the effect depends on which action head it is paired with: VideoMAE costs ACT 0.09 SR and costs Diffusion Policy 0.53 (0.67 \to 0.14), which is close to total failure. Encoder and action head therefore cannot be chosen independently.
译文
由于每个 Video-VA 变体都通过一个冻结编码器接收任务说明,编码器是与其动作头搭配的一项设计选择(原文此句有语病)。图 9 把两者分开考察。在已见任务上(子图 a,自动通道),ACT 的编码器排序为 DINOv2 \ge SigLIP2 > VideoMAE(0.81/0.79/0.72),但效应的大小取决于与之搭配的动作头:VideoMAE 让 ACT 损失 0.09 的 SR,却让 Diffusion Policy 损失 0.53(0.67\to0.14),几乎完全失败。因此,编码器与动作头不能独立选择。
解释
Video-VA 的结构是“冻结视频编码器把示范视频压成任务嵌入 + 可训练的动作头根据嵌入和当前观测输出动作”。编码器不参与训练,所以示范里的任务信息能否被动作头读出,取决于嵌入的形态是否适合这个动作头。验算:0.81-0.72=0.09,0.67-0.14=0.53,与正文一致。一种可能的解释(原文未给出)是:DINOv2、SigLIP2 是图像级编码器,逐帧特征里保留了物体位置等空间细节;VideoMAE 是视频掩码自编码器,表征更偏时序运动、空间细节较粗。ACT 用 Transformer 对条件做注意力,较能从粗糙的嵌入中提取信息;DP 的扩散去噪对条件信号的质量更敏感,一旦条件含糊就容易输出平均化的动作。原句“the encoder is a design choice of for its action head”多了一个 “of”,意思大致是“编码器是需要配合动作头来做的设计选择”。
原文
After few-shot adaptation (panel b, automated), the gap almost closes for ACT (0.84/0.80/0.82) but not for DP or VQ-BeT: ten demonstrations can make up for a poor task embedding only when the action head is already strong.
译文
经过少样本适应后(子图 b,自动通道),ACT 上的差距几乎消失(0.84/0.80/0.82),DP 和 VQ-BeT 上却没有:只有当动作头本身已经很强时,十条示范才能弥补较差的任务嵌入。
解释
P+FT 时模型在新任务的 10 条机器人示范上微调,动作头可以直接从这些示范中学到“这个任务该怎么动”,对任务嵌入的依赖随之减弱。ACT 三个编码器之间的极差从 Seen 时的 0.09 缩到 0.04;DP 仍有 0.18(0.54 对 0.36),VQ-BeT 有 0.08,但 VQ-BeT 的绝对水平太低(不到 0.25),差距小主要是因为大家都差。注意排序在 ACT 上也变了:VideoMAE(0.82)超过了 SigLIP2(0.80),这样小的差异在每层级 150 个回合的样本量下很难说显著。
原文
Panel (c) replicates the ablation on hardware, where the scores are Arena human verdicts. DINOv2, SigLIP2, and VideoMAE were run on hardware with ACT only at the 45-task pre-training scale. At this matched scale the hardware ordering reproduces the simulation ordering in every regime: VideoMAE is last everywhere, and the two image-level encoders are close to each other, align with the simulation results.
译文
子图 (c) 在真机上复现了这一消融,其中的分数是 Arena 的人类判定。DINOv2、SigLIP2 和 VideoMAE 只在 45 任务预训练规模下与 ACT 一起在真机上运行。在这一匹配的规模下,真机上的排序在每种设定中都重现了仿真中的排序:VideoMAE 处处垫底,两个图像级编码器彼此接近,与仿真结果一致。
解释
这段有两处说得过满。其一,“匹配的规模”并不匹配:真机只用了 45 任务检查点,而图 9(a)(b) 的仿真数字按附录 C 开头的约定是三个规模的平均。其二,“在每种设定中都重现了仿真排序”不严格成立。在 P+FT 上,仿真 ACT 的顺序是 DINOv2 0.84 > VideoMAE 0.82 > SigLIP2 0.80,真机却是 DINOv2 0.43 > SigLIP2 0.41 > VideoMAE 0.33。在零样本上,表 3 中仿真 ACT 的 ZS SR 为 DINOv2 0.02、SigLIP2 0.03、VideoMAE 0.04,顺序恰好与真机(0.30/0.27/0.25)相反,只不过仿真零样本整体处在地板水平,本就无法排序。能站得住的结论是:在真机上,VideoMAE 在四种设定中都最差,两个图像级编码器接近。这与仿真已见任务上的排序一致,但不能说成“处处复现”。
C.3Q2:预训练规模、零样本迁移与少样本适应
原文
Figure 10 is the evidence behind the scaling claim of Section 4.3. Panel (a) plots P+FT success against corpus size in both domains – automated in simulation, Arena on hardware. All three paradigms improve, in simulation and on hardware alike, and by 45 tasks every family's P+FT curve lies above the scratch baseline for its own domain (sim 0.35, averaged over all 15 variants; real 0.25, averaged over the four representative models). The gain therefore comes from the paired corpus, not from the ten few-shot demonstrations, which both conditions receive.
译文
图 10 是第 4.3 节规模结论背后的证据。子图 (a) 画出两个域中 P+FT 成功率随语料规模的变化:仿真为自动通道,真机为 Arena 通道。三种范式在仿真和真机上都有提升;到 45 个任务时,每个家族的 P+FT 曲线都位于本域的 scratch(从零训练)基线之上(仿真 0.35,为全部 15 个变体的平均;真机 0.25,为四个代表模型的平均)。由于两种条件都使用同样的十条少样本示范,增益因此来自配对语料,而不是来自这十条示范。
解释
验算 scratch 基线:表 3 中 15 个变体的 Scr. SR 之和为 5.24,均值 0.349\approx0.35;表 4 中四个代表模型的 Scr. SR 为 0.27、0.28、0.22、0.22,均值 0.2475\approx0.25,与图中两条灰色水平线一致。这个论证的两处弱点。第一,比较对象是“家族的 P+FT”对“全体变体的 scratch 均值”,而不是每个模型对它自己的 scratch。家族平均会掩盖个体:按表 3,RDT-1B、VQ-BeT/DINOv2、VQ-BeT/SigLIP2 三个变体即使在三个规模平均后,P+FT 仍低于自己的 Scr.(\Delta 为 -0.14、-0.12、-0.08)。图 10(b) 显示 VQ-BeT/DINOv2 从 15 到 45 任务的增益最大(+0.21),但它的三规模平均 P+FT 只有 0.23,推算到 45 任务时大约为 0.34,仍未超过自己的 Scr. 0.35。可见“规模越大越好”和“预训练优于从零训练”是两个不同的结论。第二,“到 45 个任务时”这一限定很关键:真机 Video-VA 曲线在 15 任务时约为 0.25,与真机 scratch 线基本重合,此时预训练还没有带来增益。“增益来自配对语料而非十条示范”的逻辑是:P+FT 与 Scr. 都用同样的 10 条示范,两者之差只能归于预训练。这个推理是对的,但它说明的是“预训练有用”,并不能区分“配对的人–机器人视频”和“单纯更多的机器人数据”各自贡献了多少,因为论文没有做“只用机器人数据预训练”的对照。
原文
Panel (b) resolves this per model. Going from 15 to 45 pre-training tasks raises \Delta\mathrm{SR} for 18 of the 19 trained variants across the two domains (14/15 in simulation, 4/4 on hardware). We read this as a limit of its skill-dynamics stage, though with one data point we cannot separate that from noise.
译文
子图 (b) 按模型拆开来看。从 15 个预训练任务增加到 45 个,两个域合计 19 个训练变体中有 18 个的 \Delta\mathrm{SR} 上升(仿真 14/15,真机 4/4)。我们把这一例外解读为其技能动力学(skill-dynamics)阶段的局限,不过只有一个数据点,我们无法把它与噪声区分开。
解释
原文缺了一句。“We read this as a limit of its skill-dynamics stage”中的 “this” 和 “its” 没有先行词,显然删掉了一句点名例外模型的话。从图 10(b) 可以读出,唯一的负值是 UniSkill(-0.09);UniSkill 先学习跨具身的“技能动力学”表征,再据此生成动作,这与“skill-dynamics stage”相符。术语提醒:这里的 \Delta\mathrm{SR} 是图 10(b) 横轴所写的“45 任务 P+FT - 15 任务 P+FT”,与表 3、表 4 中的 \Delta(P+FT - Scr.)不是同一个量。原句“raises \Delta\mathrm{SR}”的意思其实是“\Delta\mathrm{SR} 为正”,即 P+FT 成功率上升。与正文第 4.3 节的对照:正文说“P+FT 成功率在 15 个仿真变体中有 14 个提升”,与此处一致。不过 14 个提升中有几个幅度很小:\pi_{0.5}、ACT/DINOv2、OpenVLA 都是 +0.04,ACT/VideoMAE 是 +0.02。按仿真每个模型 P+FT 评测 200 个回合(5 个未见任务 \times 4 层级 \times 10 次)计算,SR 在 0.5 附近时单个检查点的标准误约为 \sqrt{0.25/200}\approx0.035,两点之差的标准误约 0.05。因此 +0.02 到 +0.04 的变化在统计上与 0 无法区分,UniSkill 的 -0.09 也只在边缘显著。“14/15”这一计数比实际证据显得更强。另外,最强的模型(\pi_{0.5}、ACT/DINOv2)增益最小,可能是因为它们在 15 任务时已接近上限。
原文
Panel (c) reports what the aggregate hides. On hardware, zero-shot success on unseen tasks rises steadily with corpus size for all three video-conditioned models (XSkill 0.24 \to 0.33, ACT/DINOv2 0.22 \to 0.30, DP/DINOv2 0.19 \to 0.25), but stays at about 0.04 for \pi_{0.5} at every scale. More paired human-robot video therefore buys zero-shot ability only for policies that watch the video itself; passing the same demonstration through a caption first does not turn extra pre-training into transfer.
译文
子图 (c) 报告了汇总数字所掩盖的东西。在真机上,三个以视频为条件的模型在未见任务上的零样本成功率都随语料规模稳定上升(XSkill 0.24\to0.33,ACT/DINOv2 0.22\to0.30,DP/DINOv2 0.19\to0.25),而 \pi_{0.5} 在每个规模上都停留在约 0.04。因此,更多的配对人–机器人视频只为那些直接观看视频本身的策略带来零样本能力;先把同一段示范转换成文字描述(caption),并不能把额外的预训练转化为迁移能力。
解释
\pi_{0.5} 是语言条件的 VLA,在本基准中它看不到示范视频,只能读到由示范视频生成的固定文字描述 T(V)。对一个从未见过的任务,一句文字描述很难传达“哪个物体、放到哪里、怎么动”的细节;而视频条件模型可以直接从画面里读出这些信息。交叉核对:三个视频模型的三点曲线与表 4 的三规模平均 ZS 相符(XSkill 中间点推算为 3\times0.29-0.24-0.33=0.30,ACT 为 0.26,DP 为 0.22,都是单调的)。四个模型在 15 任务时的均值 (0.24+0.22+0.19+0.04)/4=0.1725,正好等于表 9 真机 ZS 在 15 任务时四个层级的均值 (0.18+0.18+0.14+0.19)/4;45 任务时两者都是 0.23,数据内部自洽。结论边界:这是真机结果,每个模型每个规模只有 5\times4\times5=100 个回合,SR 在 0.25 附近时标准误约 0.04,因此单个模型 0.08–0.09 的涨幅大约是两倍标准误,三个模型方向一致才使结论较为可信。仿真中的零样本则全部处在地板水平(表 3 ZS 最高 0.13),没有观察到同样的规模效应,见图 11(a)。
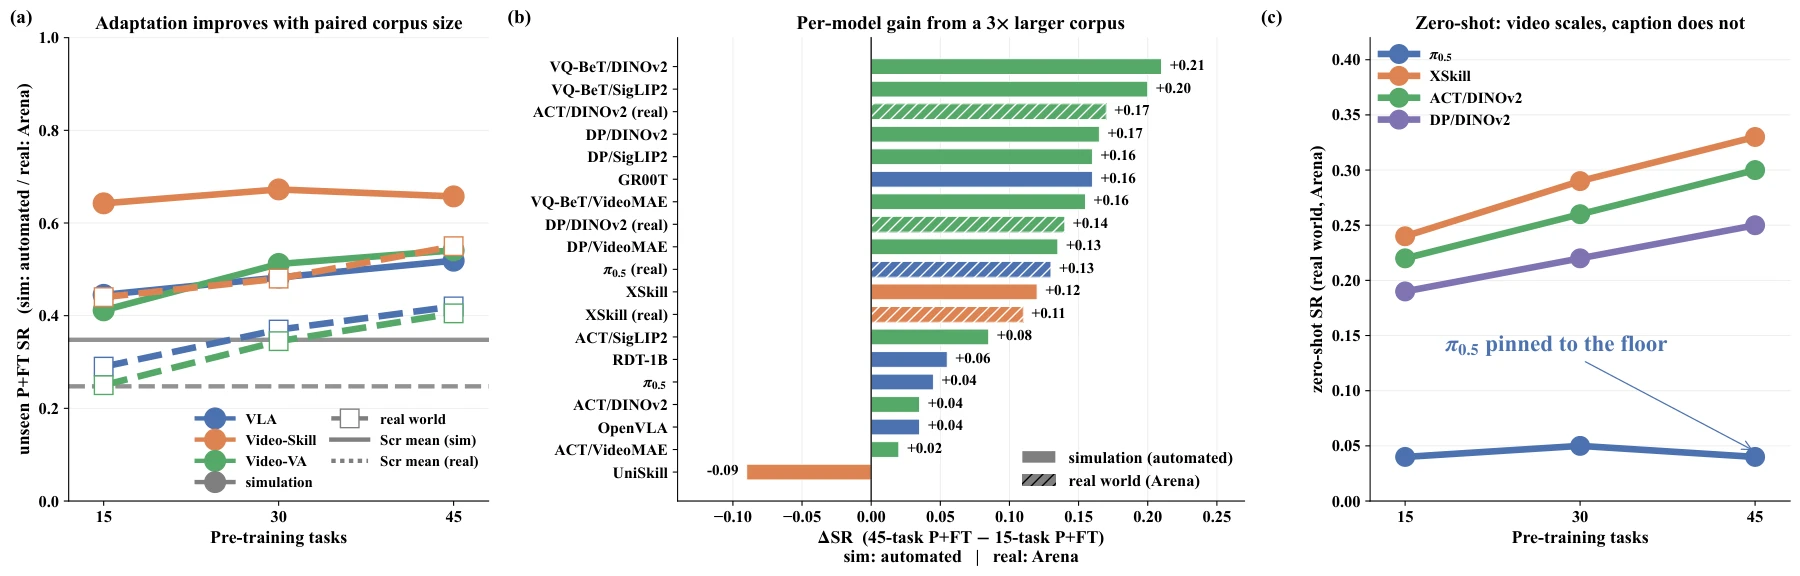
图 10:Q2:扩大配对预训练语料的规模。(a) P+FT \mathrm{SR} 随语料规模的变化,仿真(实线,自动通道)与真机(虚线,Arena);两条灰色水平线分别是两个域的 scratch 均值(仿真取全部 15 个变体,真机取四个代表模型),计算口径与表 3 和表 4 的 Scr. 列相同。(b) 从 15 到 45 个预训练任务时,每个模型的 \Delta\mathrm{SR};真机模型用斜线填充,为 Arena 数字。19 个变体中有 18 个为正。(c) 真机未见任务零样本(Arena)随规模的变化:三个视频条件模型单调提升,而以文字描述为条件的 \pi_{0.5} 一直停留在地板水平。
原图注:Q2: scaling the paired pre-training corpus. (a) P+FT \mathrm{SR} vs. corpus size, simulation (solid, automated) and real world (dashed, Arena); the two grey horizontal lines are the scratch mean for each domain – simulation over all 15 variants, real world over the four representative models – computed on the same basis as the Scr. columns of Table 3 and Table 4. (b) Per-model \Delta\mathrm{SR} from 15 to 45 pre-training tasks; real-world models are hatched and are Arena numbers. Positive for 18 of 19 variants. (c) Real-world unseen zero-shot (Arena) vs. scale: the three video-conditioned models improve monotonically while the caption-conditioned \pi_{0.5} stays at the floor.
图 10 解读
子图 (a) 横轴为预训练任务数(15、30、45),纵轴为未见任务 P+FT SR。实线带实心圆是仿真的家族均值,虚线带空心方块是真机;颜色区分家族(蓝 VLA、橙 Video-Skill、绿 Video-VA)。灰色实线 0.35 是仿真 scratch 均值,灰色虚线 0.25 是真机 scratch 均值。仿真中 Video-Skill 最高但几乎是平的(约 0.64\to0.67\to0.66,30 到 45 任务甚至略降);VLA 约 0.45\to0.52;Video-VA 约 0.41\to0.54,涨幅最大。真机中三个家族分别只对应一两个模型:VLA 即 \pi_{0.5}(约 0.29\to0.42),Video-Skill 即 XSkill(约 0.44\to0.55,在 45 任务处与仿真曲线几乎重合),Video-VA 是 ACT 与 DP 的平均(约 0.25\to0.41)。按变体数加权后,仿真三个家族在 15 任务时的均值为 (4\times0.45+2\times0.64+9\times0.41)/15\approx0.45,与表 9 中仿真 P+FT 在 15 任务时四个层级的均值 (0.52+0.48+0.34+0.47)/4=0.45 一致;45 任务时两者都约为 0.55。真机侧同样吻合(15 任务约 0.31,45 任务约 0.445)。子图 (b) 是横向条形图,横轴为 45 任务与 15 任务 P+FT SR 之差,纯色为仿真变体,斜线为真机模型。从上到下:VQ-BeT/DINOv2 +0.21、VQ-BeT/SigLIP2 +0.20、ACT/DINOv2(真机)+0.17、DP/DINOv2 +0.17,……,ACT/VideoMAE +0.02,最后是唯一的负值 UniSkill -0.09。仿真 15 个增益的均值约为 1.50/15=0.10,与表 9 中仿真 P+FT 从 0.45 到 0.55 的变化一致。一个值得注意的反差是:增益最大的 VQ-BeT 变体恰恰是 P+FT 绝对水平最低、且不如 scratch 的变体(见上文解释),而 \pi_{0.5}、ACT/DINOv2 等最强变体的增益只有 +0.04。子图 (c) 横轴同 (a),纵轴为真机零样本 SR。橙(XSkill)、绿(ACT/DINOv2)、紫(DP/DINOv2)三条线平行上升,蓝线 \pi_{0.5} 为 0.04/0.05/0.04,被标注为“pinned to the floor”。这张小图是全文“视频条件优于语言条件”在零样本迁移上最直接的证据。
C.4Q2:规模收益是否只局限于特定层级?
原文
The body averages over corpus scales for compactness. Figure 11 resolves the zero-shot and P+FT settings by level and scale in both domains, and Table 9 gives the same numbers. Three readings follow. First, in every panel except simulation zero-shot, success improves monotonically or near-monotonically from 15 to 45 pre-training tasks at every level: the benefit is not confined to the easy end of the hierarchy.
译文
为了简洁,正文在各语料规模上取了平均。图 11 在两个域中把零样本和 P+FT 两种设定同时按层级和规模拆开,表 9 给出相同的数字。由此可以得出三点解读。第一,除仿真零样本之外,在每个子图中,成功率从 15 到 45 个预训练任务都在每个层级上单调或近似单调地提升:收益并不局限于层级中容易的那一端。
解释
对照正文第 4.3 节:正文写“根据表 9,P+FT 成功率从 15 到 45 个预训练任务在 L0–L3 每一层、两个域中都上升”。按表 9 逐项核对,比较两个端点时这一说法成立:仿真 P+FT 四个层级分别为 0.52\to0.62、0.48\to0.58、0.34\to0.41、0.47\to0.59;真机 P+FT 为 0.34\to0.48、0.35\to0.45、0.31\to0.49、0.23\to0.36。但中间并非处处单调:仿真 L1 从 30 到 45 任务是 0.59\to0.58,真机 L1 为 0.45\to0.45。这正是此处说“单调或近似单调”的原因,正文的表述略为简化。这里的“容易的一端”指 L0(同场景)和 L1(布局变化)。如果规模收益只出现在 L0/L1,就说明更多预训练只是让模型更熟练地“复读”,而不是更好地理解意图。真机 L3 涨幅为 +0.13,与 L0 的 +0.14 相当,说明规模对意图层级也有帮助。
原文
Second, simulation zero-shot (panel a) sits at the floor throughout (\mathrm{SR} \le 0.14) and its level ordering moves around without a readable pattern. We draw no conclusion from it, and do not use it to rank encoders or paradigms.
译文
第二,仿真零样本(子图 a)始终处于地板水平(\mathrm{SR}\le0.14),其层级排序来回变动,看不出可解读的规律。我们不从中得出任何结论,也不用它来给编码器或范式排序。
解释
这是一个诚实的处理。按表 9,仿真零样本在 L0、L1 上随规模反而下降(L0 0.08\to0.06\to0.06,L1 0.14\to0.09\to0.07),L3 先降后升(0.03\to0.01\to0.04)。若用它来论证规模效应,结论会是负面的。作者明确将其视为噪声,理由是数值过低:表 9 中每个仿真格子是 15 个变体的平均,每个变体在单一规模、单一层级上只有 5\times10=50 个回合,SR 在 0.05 左右时,单个变体的标准误约 0.03,与格子之间的差别同量级。需要指出的是,“地板水平”本身就是一个结论:在仿真中,没有任何一个模型能仅凭人类示范视频完成未见任务。
原文
Third, the L3 curve behaves differently in the two domains. In the real world (panel d) it improves with scale (0.23 \to 0.36) while remaining a clear band below L0–L2 at every scale, i.e. more paired pre-training helps at the intent level but does not close the intent-level gap. In simulation (panel b) L2 rather than L3 is the depressed level, for the construction reason analyzed in Section C.5.
译文
第三,L3 曲线在两个域中的表现不同。在真机上(子图 d),它随规模提升(0.23\to0.36),但在每个规模上都明显低于 L0–L2 一截,也就是说,更多的配对预训练在意图层级上有帮助,但并不能弥合意图层级的差距。在仿真中(子图 b),被压低的是 L2 而不是 L3,原因在于第 C.5 节分析的构造方式。
解释
验算:真机 P+FT 各规模下 L3 与 L0–L2 最低值的差距为:15 任务 0.23 对 0.31,30 任务 0.28 对 0.37,45 任务 0.36 对 0.45,差距稳定在 0.08–0.09,“没有弥合”成立。把表 9 真机 P+FT 在三个规模上取平均,得到 L0 0.42、L1 0.42、L2 0.39、L3 0.29,与正文表 5 最后一行完全一致。两域层级结论的差异:正文第 4.4 节的“L3 是瓶颈”来自真机 P+FT(表 5),仿真 P+FT 给出的却是“L2 最难、L3 与 L0/L1 相当”(三规模平均为 L0 0.58、L1 0.55、L2 0.37、L3 0.54)。作者的处理是:承认仿真 L3 结果偏乐观,并用构造原因解释(C.5 末段,以及第 5 节局限性中“有限资产与基于规则的规划运动使仿真 L3 替换结果有偏”)。还有一点作者没有提:真机零样本(子图 c)也没有 L3 瓶颈。表 9 中真机 ZS 的 L3 在 15 和 45 任务时都是四个层级中最高的(0.19、0.25),三规模平均 L3 为 0.223,略高于 L0 的 0.213。因此“L3 最难”在真机上也只在 Seen 和 P+FT 两种设定下成立。一个可能的解释是零样本整体只有 0.2 左右,各层级都还没学会,层级差异被淹没。
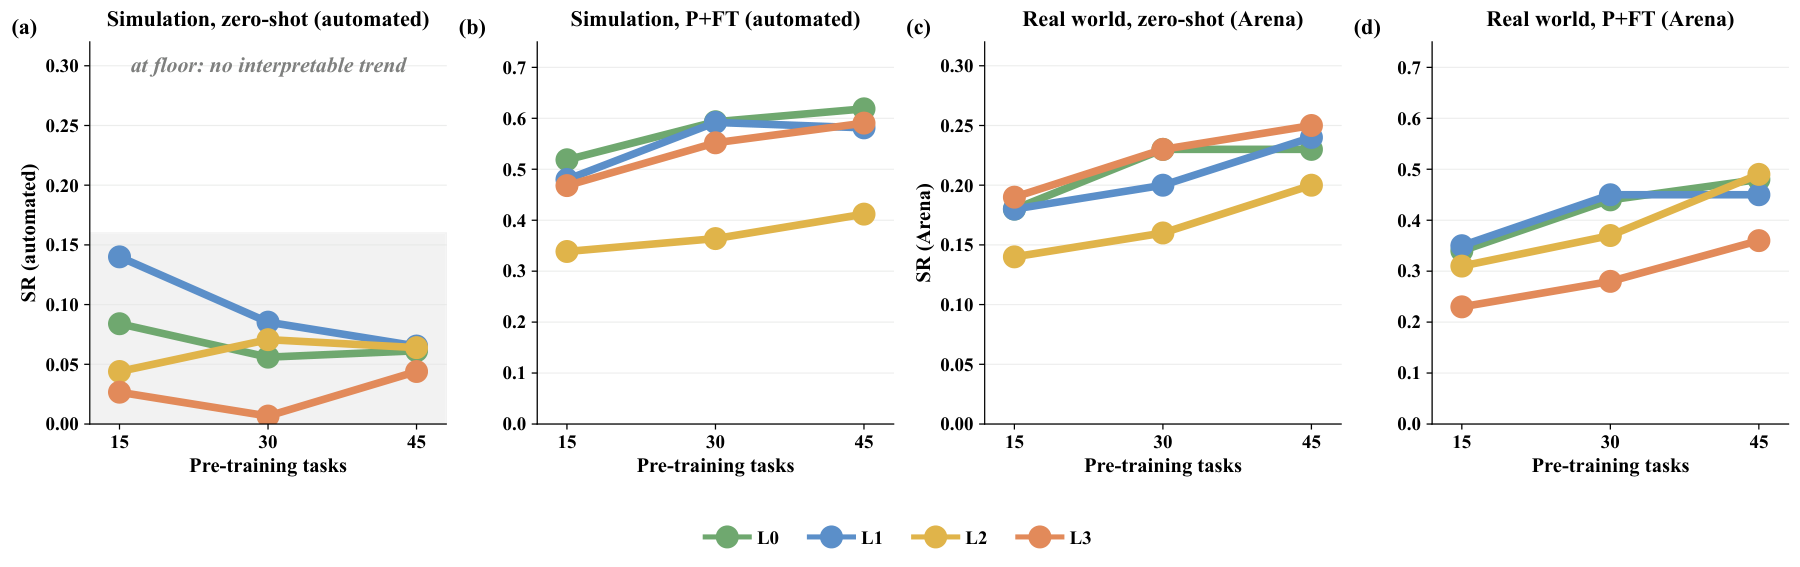
图 11:Q2:按层级拆分的规模效应。未见任务成功率随预训练任务数的变化,按层级分别绘制:(a) 仿真零样本,(b) 仿真 P+FT,(c) 真机零样本,(d) 真机 P+FT。仿真曲线为全部 15 个训练变体的平均;真机曲线为四个代表模型的平均。注意各列的 y 轴范围不同。
原图注:Q2: scaling resolved by hierarchy level. Unseen-task success against the number of pre-training tasks, separately per level, for (a) simulation zero-shot, (b) simulation P+FT, (c) real-world zero-shot and (d) real-world P+FT. Simulation curves average all 15 trained variants; real-world curves average the four representative models. Note the different y ranges for each columns.
图 11 解读
四个子图横轴都是预训练任务数(15/30/45),四种颜色对应四个层级:绿 L0、蓝 L1、黄 L2、红 L3。各点数值与表 9 逐一对应。(a) 仿真零样本,y 轴 0–0.3,灰色底纹标注“at floor: no interpretable trend”。最高点是 L1 在 15 任务时的 0.14,随后降到 0.07;L3 在 30 任务时几乎为 0。四条线交叉缠绕。(b) 仿真 P+FT,y 轴 0–0.7。L0、L1、L3 三条线挤在一起,从约 0.5 升到约 0.6;黄色 L2 单独掉在下方(0.34\to0.41),与其他层级相差约 0.15–0.2。这就是“仿真中 L2 被压低”的直观来源。(c) 真机零样本,y 轴 0–0.3。四条线都上升,黄色 L2 最低,红色 L3 反而在最上方。(d) 真机 P+FT,y 轴 0–0.7。红色 L3 始终在最下方(0.23\to0.28\to0.36);黄色 L2 在 15、30 任务时居中,45 任务时跃升到 0.49,成为最高。比较 (b) 和 (d):两域“最难的层级”不同,仿真是 L2,真机是 L3。比较 (c) 和 (d):真机的 L3 瓶颈只在微调后出现,零样本时并不存在。这两点都提示,“L3 最难”是一个依赖设定的结论。图注提醒零样本列与 P+FT 列的 y 轴范围不同(0.3 对 0.7),不要把 (a)(c) 中的“陡峭”误读为大幅变化。
表 9:按层级和预训练规模划分的成功率。未见任务的零样本(ZS)和预训练+微调(P+FT)成功率,按层级和预训练任务数(15/30/45)拆分。仿真数字为全部 15 个训练变体的平均;真机数字为四个代表模型的平均。仿真列为自动通道,真机列为 Arena 通道。这些就是图 11 中画出的数字。
| Sim ZS (auto.) | Sim P+FT (auto.) | Real ZS (Arena) | Real P+FT (Arena) | |||||||||
| Level | 15 | 30 | 45 | 15 | 30 | 45 | 15 | 30 | 45 | 15 | 30 | 45 |
| L0 | 0.08 | 0.06 | 0.06 | 0.52 | 0.59 | 0.62 | 0.18 | 0.23 | 0.23 | 0.34 | 0.44 | 0.48 |
| L1 | 0.14 | 0.09 | 0.07 | 0.48 | 0.59 | 0.58 | 0.18 | 0.20 | 0.24 | 0.35 | 0.45 | 0.45 |
| L2 | 0.04 | 0.07 | 0.06 | 0.34 | 0.36 | 0.41 | 0.14 | 0.16 | 0.20 | 0.31 | 0.37 | 0.49 |
| L3 | 0.03 | 0.01 | 0.04 | 0.47 | 0.55 | 0.59 | 0.19 | 0.23 | 0.25 | 0.23 | 0.28 | 0.36 |
原表注:Success rate by hierarchy level and pre-training scale. Unseen-task zero-shot (ZS) and pre-train+fine-tune (P+FT) success, resolved by level and by the number of pre-training tasks (15/30/45). Simulation numbers average all 15 trained variants; real-world numbers average the four representative models. Simulation columns are the automated channel, real-world columns the Arena channel. These are the numbers plotted in Figure 11.
表 9 解读
表分四个列组,每组三列对应 15、30、45 个预训练任务;四行对应 L0–L3。与正文表 3、表 4、表 5 的一致性:把每列组的 12 个数先在层级上、再在规模上平均,可以还原正文的汇总数。仿真 ZS 总均值为 0.0625,表 3 中 15 个变体 ZS SR 的均值为 0.93/15=0.062;仿真 P+FT 总均值 0.508,表 3 P+FT 均值 7.64/15=0.509;真机 ZS 总均值 0.2025,表 4 四个模型 ZS 均值 (0.04+0.29+0.26+0.22)/4=0.2025;真机 P+FT 各层级的三规模平均(0.42/0.42/0.39/0.29)与表 5 最后一行完全相同。数据内部是自洽的。关键读数:仿真 P+FT 的 L2 行在每个规模上都是该列最低值,真机 P+FT 的 L3 行在每个规模上都是该列最低值,两域的“最难层级”不同。真机 ZS 列组中,L3 行在 15、45 任务时都是该列最高值,这一点正文和附录都没有讨论。
C.5Q3:层级在哪里开始变难
原文
Figure 12 lays out four panels in a single row – real world (Seen, P+FT) then simulation (Seen, P+FT) – success rate on the primary axis and a completion-quality score on the secondary axis in every panel. In panel (a), success is flat from L0 to L2 (0.54/0.55/0.54) and drops at L3 (0.39); \overline{Q} follows the same shape (6.97/7.12/ 7.07 \to 6.09). XSkill is strongest at every level (0.64/0.69/0.63/0.57) and still loses ground at L3.
译文
图 12 把四个子图排成一行:先是真机(Seen、P+FT),再是仿真(Seen、P+FT)。每个子图的主坐标轴是成功率,副坐标轴是完成质量分数。在子图 (a) 中,成功率从 L0 到 L2 保持平稳(0.54/0.55/0.54),在 L3 下降(0.39);\overline{Q} 呈现同样的形状(6.97/7.12/7.07\to6.09)。XSkill 在每个层级上都最强(0.64/0.69/0.63/0.57),但在 L3 上同样有所退步。
解释
验算:四个层级的 SR 均值 (0.54+0.55+0.54+0.39)/4=0.505,等于表 4 中四个模型 Seen SR 的均值 (0.51+0.63+0.49+0.39)/4=0.505;\overline{Q} 层级均值 27.25/4=6.81,也等于表 4 Seen \overline{Q} 的均值。XSkill 四个层级的均值 2.53/4=0.63,与表 4 一致。这一段补充了正文没有展示的事实:真机 L3 的下降不仅出现在 P+FT(表 5),在已见任务上同样存在,而且更明显(0.54\to0.39,降幅 0.15)。已见任务是模型训练过的五个任务,L3 只是把其中的物体换成功能不同的替代物。即使是熟悉的任务,一旦物体用法变了,成功率也明显下降。XSkill 的 L3 降幅(0.06–0.12)比平均降幅小,说明它在已见任务上对功能替换相对稳健。
原文
In panel (b), success is flat from L0 to L2 (0.42/0.42/0.39) and drops at L3 (0.29). XSkill carries the drop (\mathrm{SR}\approx0.53–0.57 through L2, falling to 0.29 at L3; \overline{Q} 7.2\to5.6), while the other three models sit in a comparatively narrow \overline{Q}\approx5.4–6.3 band at every level. Current policies cope with a rearranged layout, or a replacement object of the same kind, but not with an object that has to be handled differently.
译文
在子图 (b) 中,成功率从 L0 到 L2 保持平稳(0.42/0.42/0.39),在 L3 下降(0.29)。这一下降主要由 XSkill 造成(其 SR 在 L2 之前约为 0.53–0.57,到 L3 降至 0.29;\overline{Q} 从 7.2 降到 5.6),而另外三个模型在每个层级上都处于一个相对较窄的 \overline{Q}\approx5.4–6.3 区间。当前的策略能应对重新排列的布局,或同类的替换物体,但应付不了需要换一种方式操作的物体。
解释
这一段与正文第 4.4 节的表 5 内容相同。验算:按表 5,其余三个模型的 \overline{Q} 最低为 DP 在 L3 的 5.43,最高为 \pi_{0.5} 在 L0 的 6.27,“5.4–6.3”成立。“XSkill 造成了下降”值得细看。四个模型在 L2\toL3 的 SR 降幅分别为:\pi_{0.5} 0.09、XSkill 0.27、ACT 0、DP 0.04,平均降幅 0.10 中有约 2/3 来自 XSkill。所以“L3 是瓶颈”在真机 P+FT 上主要是一个模型的现象:ACT 在 L2、L3 完全持平(0.33/0.33),DP 和 \pi_{0.5} 的降幅也不大。正文的措辞(“这一下降对 L0–L2 最强的策略最为明显”)比摘要式的“L3 是主要难点”更准确。样本量方面,每个模型每层级只有 75 个回合(3 规模 \times 5 任务 \times 5 次),SR 在 0.3–0.5 时标准误约 0.05–0.06。XSkill 的 0.27 降幅是显著的,其他模型 0.04–0.09 的降幅则不显著。结尾一句对应层级定义:L1 改变布局,L2 换成同类物体(例如换一个不同外观的杯子),L3 换成功能不同、需要不同操作方式的物体。
原文
In panel (c), the all-model curve is non-monotone: it dips at L2 and rebounds at L3 (0.62/0.57/0.48/0.63), and the VLA family peaks at L3 above its own L0 value (0.55/0.42/0.36/0.62). The per-family Sub-SR curves show the identical dip-then-rebound shape (VLA 0.81/0.70/0.68/0.83, Video-Skill 0.92/0.89/0.89/0.91, Video-VA 0.79/0.77/0.72/0.78), so the effect is not confined to one paradigm or to the binary predicate. Figure 13(b) reproduces this shape on the same rollouts under Arena scoring, so it is not an artifact of the automated channel.
译文
在子图 (c) 中,全体模型的曲线是非单调的:它在 L2 下陷,在 L3 回升(0.62/0.57/0.48/0.63);VLA 家族在 L3 达到峰值,甚至高于它自己在 L0 的数值(0.55/0.42/0.36/0.62)。各家族的 Sub-SR 曲线呈现完全相同的“先下陷后回升”形状(VLA 0.81/0.70/0.68/0.83,Video-Skill 0.92/0.89/0.89/0.91,Video-VA 0.79/0.77/0.72/0.78),因此这一效应既不局限于某一种范式,也不局限于二值判定谓词。图 13(b) 在同一批回合上用 Arena 评分重现了这一形状,所以它也不是自动通道造成的假象。
解释
验算:“全体模型”是 15 个变体的等权平均,即按家族成员数加权(VLA 4、Video-Skill 2、Video-VA 9)。用图 12(c) 读出的家族 SR,L0 为 (4\times0.55+2\times0.83+9\times0.61)/15=0.62,L3 为 (4\times0.62+2\times0.72+9\times0.61)/15=0.63,与正文一致;四个层级的均值 0.575 等于表 3 Seen SR 的均值。各家族 Sub-SR 的层级均值(VLA 0.755、Video-Skill 0.90、Video-VA 0.765)也与表 3 Seen Sub 的家族均值一致。“相同形状”说得过满。从图 12(c) 读,Video-Skill 的SR曲线是单调下降的(约 0.83/0.78/0.74/0.72),没有 L3 回升;它的 Sub-SR(0.92/0.89/0.89/0.91)在 L1、L2 持平,L3 只回升 0.02,几乎是平的。真正呈现“L2 下陷、L3 回升”的是 VLA 和 Video-VA。表 10 的 “original” 行提供了个体层面的旁证:ACT/DINOv2 在 L3 达到 0.88,高于其 L0 的 0.87;XSkill 则是 0.87/0.85/0.77/0.68 单调下降;\pi_{0.5} 在 L3(0.69)也没有回升,VLA 家族的回升来自其他 VLA 成员。所以更准确的说法是:非单调效应出现在多数变体中,但并非“每个范式都相同”。
原文
In panel (d), the L2 dip recurs (0.58/0.55\to0.37) with a partial rebound at L3 (0.54) that stays below L0, unlike panel (c). The pattern holds by family (VLA 0.52/0.55/0.33/0.53, Video-Skill 0.77/0.68/0.42/0.75, Video-VA 0.56/0.53/0.38/0.49) and in Sub-SR (VLA 0.72/0.74/0.41/0.70, Video-Skill 0.89/0.84/0.55/0.89, Video-VA 0.73/0.71/0.46/0.65), so the L2 dip is a property of the simulated L2 condition itself rather than of the seen/unseen split.
译文
在子图 (d) 中,L2 下陷再次出现(0.58/0.55\to0.37),L3 有部分回升(0.54),但与子图 (c) 不同,回升后仍低于 L0。这一模式在各家族中都成立(VLA 0.52/0.55/0.33/0.53,Video-Skill 0.77/0.68/0.42/0.75,Video-VA 0.56/0.53/0.38/0.49),在 Sub-SR 上也成立(VLA 0.72/0.74/0.41/0.70,Video-Skill 0.89/0.84/0.55/0.89,Video-VA 0.73/0.71/0.46/0.65)。因此,L2 下陷是仿真 L2 条件本身的属性,而不是由已见/未见的划分造成的。
解释
验算:按变体数加权,L0 为 (4\times0.52+2\times0.77+9\times0.56)/15=0.577,L2 为 (4\times0.33+2\times0.42+9\times0.38)/15=0.372,L3 为 0.535,与表 9 仿真 P+FT 的三规模平均(0.577/0.553/0.370/0.537)一致;各家族 SR 均值(VLA 0.4825、Video-Skill 0.655、Video-VA 0.49)也与表 3 P+FT 列的家族均值一致。论证逻辑是:已见任务(c)和未见任务(d)是两组不同的任务,却在 L2 上同样下陷,所以原因不在任务选择,而在仿真里“L2 是怎么构造的”。L2 下陷在 (d) 中比在 (c) 中深得多(相对 L1,家族 SR 在 L2 的降幅为 0.15–0.26,而 (c) 中只有 0.04–0.12),这一点作者没有解释。一种可能是:微调只有 10 条示范,若 L2 换了执行手臂(见下一段),少量示范很难覆盖另一只手臂的运动。
原文
Why L2 dips in simulation. Two construction choices explain it. First, the simulated L2 condition also swaps which arm performs the manipulation – deliberately, to remove any motion-level shortcut, since L1 already moves the objects and L3 already changes what has to be done. Second, the simulation asset pool is finite and its motions are rule-based, so on simple pick-and-place tasks a substituted L3 object can often still be handled with roughly the strategy seen in training. Hardware offers no such shortcut: a functionally different object differs in mass, shape and how it must be gripped, and the robot has to adapt for real. This is why the body reports the simulation aggregate without splitting it by level, and reads the per-level picture from the Arena instead.
译文
仿真中 L2 为何下陷。有两个构造上的选择可以解释这一点。第一,仿真中的 L2 条件还会交换执行操作的手臂。这是有意为之,目的是消除任何动作层面的捷径,因为 L1 已经移动了物体,L3 已经改变了要做的事情。第二,仿真资产库是有限的,其运动是基于规则的,因此在简单的抓取–放置任务上,替换后的 L3 物体往往仍可以用与训练时大致相同的策略来处理。真机上没有这样的捷径:功能不同的物体在质量、形状和抓握方式上都不同,机器人必须真正做出适应。这就是为什么正文报告仿真结果时只给汇总数字、不按层级拆分,而改从 Arena 中读取分层级的情况。
解释
这两点分别解释“L2 为什么特别难”和“L3 为什么不够难”,合起来造成仿真中 L2 低、L3 高的反常形状。第一点(换手臂):双臂机器人在 L2 中要用另一只手臂完成任务。即使示范里的意图完全读懂了,动作头也必须在运动层面泛化到镜像的手臂,这对以模仿动作轨迹为主的策略是额外的难度,而且这种难度与“同类物体替换”这一层级定义本身无关。结果是仿真 L2 测量的是“物体替换 + 换手臂”的混合效应,层级之间不再是单一变量的递进。读者应当注意,这个设计细节在正文的层级定义中并不显眼,却决定了仿真分层级曲线的形状。第二点(资产有限、运动基于规则):仿真的示范和机器人轨迹由脚本化的运动规划生成,物体只是从有限的资产库里换一个。在简单的抓取–放置任务中,把“杯子”换成功能不同但形状相近的物体,规则化的抓取策略往往照样能用,于是 L3 在仿真里退化成接近 L0/L1 的难度。真机上的功能替换物在质量、形状、抓握点上都真实不同,策略无法沿用旧动作。这正是第 5 节局限性中“有限资产与基于规则的规划运动使仿真 L3 替换结果有偏”的具体含义:偏差的方向是高估仿真 L3 的成功率。对论文结构的影响:正文第 4.4 节只用真机 P+FT 讨论层级难度,原因就在这里。但这也意味着,“L3 是瓶颈”这一核心结论只建立在真机 4 个模型、每层级每模型 75 个回合的人评数据上,而且主要由 XSkill 一个模型的降幅驱动(见上文)。仿真中的 15 个变体、规模大得多的数据,在层级问题上被作者主动放弃了。
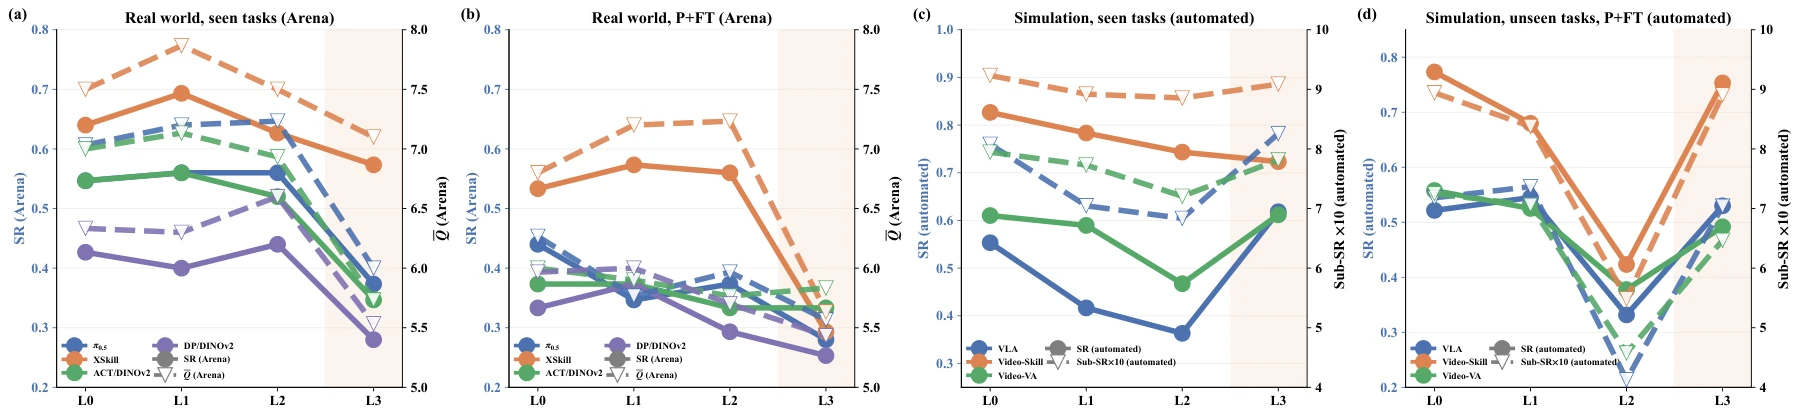
图 12:Q3:分层级的成功率与完成质量。(a) 真机已见任务 \mathrm{SR}(Arena,左轴,实线)在 L0–L3 上的变化,每个代表模型一条曲线;每个模型的模仿分 \overline{Q}(右轴,虚线,同色,同样来自 Arena)叠加在图上。(b) 真机 P+FT 的 \mathrm{SR} 和 \overline{Q}(Arena),布局同 (a)。(c) 仿真已见任务 \mathrm{SR}(自动通道,左轴,实线),按范式家族绘制;每个家族的 Sub-SR\times10(右轴,虚线,同色,同样来自自动通道)叠加在图上。(d) 仿真未见任务 P+FT 的 \mathrm{SR} 和 Sub-SR\times10(自动通道),布局同 (c)。
原图注:Q3: per-level success and completion quality. (a) Real-world seen-task \mathrm{SR} (Arena, left axis, solid) across L0–L3, one curve per representative model; each model's imitation score \overline{Q} (right axis, dashed, same color, also Arena) is overlaid. (b) Real-world P+FT \mathrm{SR} and \overline{Q} (Arena), same layout as (a). (c) Simulation seen-task \mathrm{SR} (automated, left axis, solid) by paradigm family; each family's Sub-SR\times10 (right axis, dashed, same color, also automated) is overlaid. (d) Simulation unseen-task P+FT \mathrm{SR} and Sub-SR\times10 (automated), same layout as (c).
图 12 解读
四个子图横轴都是 L0–L3,L3 处有浅橙色底纹,标示“意图层级”。实线和实心圆为左轴的成功率,虚线和空心倒三角为右轴的质量分数,同一模型或家族用同一种颜色。(a) 真机已见任务:左轴 0.2–0.8,右轴 \overline{Q} 5–8。四个模型分别为蓝 \pi_{0.5}(约 0.55/0.56/0.56/0.37)、橙 XSkill(0.64/0.69/0.625/0.57)、绿 ACT/DINOv2(约 0.545/0.56/0.52/0.35)、紫 DP/DINOv2(约 0.43/0.40/0.44/0.28)。除 XSkill 外,三个模型在 L3 都下降了约 0.16–0.19。虚线 \overline{Q} 同样在 L3 普遍下降,XSkill 的 \overline{Q} 在 L1 达到约 7.8 的峰值。(b) 真机 P+FT:数值与正文表 5 一一对应。橙色 XSkill 在 L2\toL3 断崖式下跌(0.56\to0.29),其 \overline{Q} 从约 7.2 跌到 5.6;其余三条实线挤在 0.25–0.45 之间,变化平缓,ACT 在 L2、L3 持平于 0.33。(c) 仿真已见任务:左轴 0.3–1.0,右轴 Sub-SR\times10(4–10),按家族绘制。蓝色 VLA 实线从 0.55 跌到 0.36(L2),再跳回 0.62(L3);绿色 Video-VA 为 0.61/0.59/0.47/0.61;橙色 Video-Skill 为 0.83/0.78/0.74/0.72,单调下降。虚线(Sub-SR)中 VLA 与 Video-VA 都呈 V 形,Video-Skill 几乎是平的。(d) 仿真未见任务 P+FT:左轴 0.2–0.85。三个家族在 L2 都形成深 V 形,Video-Skill 从 0.68 掉到 0.42,再回到 0.75;VLA 的 Sub-SR 在 L2 跌到约 4.1(即 0.41),是全图最低点。整体读法:左两幅(真机)呈“L0–L2 平、L3 下降”的形状,右两幅(仿真)呈“L2 下陷、L3 回升”的形状。附录 C 开头所说的“真机清晰的由粗到细下降与仿真非单调曲线的对比”,指的就是这一左一右的反差。
表 10:示范替换的合理性检查(仿真,已见任务,45 任务检查点,自动通道)。作为条件的示范为正确示范(original)时,与换成相似任务或无关任务的视频时的成功率对比,模仿者场景保持不变。
| ACT/DINOv2 | DP/DINOv2 | |||||||||
| Demo video | L0 | L1 | L2 | L3 | Avg | L0 | L1 | L2 | L3 | Avg |
| original | 0.87 | 0.77 | 0.72 | 0.88 | 0.81 | 0.72 | 0.66 | 0.59 | 0.71 | 0.67 |
| similar | 0.32 | 0.29 | 0.32 | 0.32 | 0.31 | 0.02 | 0.05 | 0.01 | 0.04 | 0.03 |
| unrelated | 0.34 | 0.28 | 0.39 | 0.19 | 0.30 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 |
| \pi_{0.5} | XSkill | |||||||||
| Demo video | L0 | L1 | L2 | L3 | Avg | L0 | L1 | L2 | L3 | Avg |
| original | 0.85 | 0.67 | 0.70 | 0.69 | 0.73 | 0.87 | 0.85 | 0.77 | 0.68 | 0.79 |
| similar | 0.09 | 0.18 | 0.09 | 0.23 | 0.15 | 0.47 | 0.41 | 0.05 | 0.29 | 0.31 |
| unrelated | 0.01 | 0.00 | 0.00 | 0.02 | 0.01 | 0.39 | 0.23 | 0.03 | 0.27 | 0.23 |
原表注:Demonstration-swap sanity check (simulation, seen tasks, 45-task checkpoints, automated channel). Success rate when the conditioning demonstration is the correct one (original) versus a video of a similar or an unrelated task, with the imitator scene unchanged.
表 10 解读
表分上下两块,每块两个模型;每个模型五列,为 L0–L3 及四层平均。三行分别是:给正确示范(original)、给相似任务的示范(similar)、给无关任务的示范(unrelated)。关键是理解“成功”的口径:场景和判定谓词都没变,“成功”始终指完成原任务。因此在 similar/unrelated 两行中,成功率越高,说明模型越是在忽略示范、仅凭场景“认出”任务并照做;一个真正依赖示范的模仿者,在这两行应接近 0。各模型的读数(替换后保留原成功率的比例):DP/DINOv2 为 4% 和 0%,几乎完全依赖示范;\pi_{0.5} 为 21% 和 1%,换成无关描述后完全失效,换成相似描述时还能完成部分原任务;ACT/DINOv2 为 38% 和 37%,XSkill 为 39% 和 29%,即使给了完全无关的视频,仍有约三到四成的原任务能完成。ACT 在 similar 与 unrelated 两行几乎相同(0.31 对 0.30),说明它的残余成功与示范内容无关,来自场景本身;XSkill 的 similar 比 unrelated 高 0.08,说明相似示范中共享的操作结构对它有一定帮助。层级细节:XSkill 在 L2 的替换成功率几乎为 0(0.05、0.03),而 L0、L1、L3 都在 0.23–0.47。这与 C.5 所说的“仿真 L2 交换了执行手臂”吻合:当执行手臂改变后,仅凭场景无法推断该用哪只手,模型必须从示范中读取,示范一换就失败。ACT 在 L2 却没有这一现象(unrelated 0.39,反而是它最高的一格),原因不明。数字疑点:(1)original 行的平均值 0.81、0.67、0.73、0.79 与表 3 的 Seen SR 完全相同,而表 3 是三个规模的平均,此表的标题却说用的是“45 任务检查点”。两者同时成立的可能性很小,更可能是 original 行直接沿用了三规模平均值。(2)按第 4.1 节的协议,仿真每个任务–层级评测 10 次,单个检查点每层级只有 5\times10=50 个回合,SR 只能取 0.02 的整数倍;但表中大量出现 0.87、0.77、0.01、0.05、0.09、0.23 等奇数百分位的值,与单检查点 50 回合不符。这进一步说明此表的统计口径与标题不一致,或评测次数多于正文所述。
C.6Q3:示范真的被用上了吗?
原文
A policy that had simply memorized its training tasks could reproduce much of Section 4.2 without reading the conditioning video at all, since the imitator scene alone often identifies the task. We test this on the five seen tasks with the 45-task checkpoints: at inference we replace the conditioning demonstration V with a video of a different IG-10K task, leaving the simulated imitator scene, the robot and every other input untouched, and re-run the evaluation at all four levels.
译文
一个只是记住了训练任务的策略,完全不读作为条件的视频,也能复现第 4.2 节的大部分结果,因为单凭模仿者场景往往就能认出是哪个任务。我们在五个已见任务上用 45 任务检查点检验这一点:推理时,把作为条件的示范 V 替换成另一个 IG-10K 任务的视频,保持仿真模仿者场景、机器人以及其他所有输入不变,在全部四个层级上重新评测。
解释
这是整个基准最关键的对照实验之一。Imitator Game 的前提是“任务由示范指定”,但已见任务是模型训练过的。比如桌上有勺子和碗,场景本身就暗示了“搅拌”,模型可能根本不看示范,直接执行记忆中的动作。如果是这样,表 3 中已见任务的高分衡量的就是“场景识别 + 动作回放”,而不是“模仿”。实验设计是:保持一切不变,只把示范换掉。若成功率大幅下降,说明策略确实在用示范;若下降不明显,说明策略更多依赖场景本身而非示范。结果解读(原文在本节只描述了设置,没有给出结果讨论;以下根据表 10 补充):四个模型在替换后成功率都明显下降,平均从 0.75 降到 similar 的 0.20、unrelated 的 0.135,说明总体上示范确实在起作用,已见任务的分数并非纯粹的记忆。但依赖程度差异很大:DP/DINOv2 与 \pi_{0.5} 几乎完全依赖示范(或其文字描述);ACT/DINOv2 与 XSkill 在给了无关视频时仍能完成约 0.3 和 0.23 的原任务,这部分成功只能来自场景记忆。换句话说,表 3 中 ACT/DINOv2 已见任务 0.81 的最高分里,大约 0.30 可以在不看示范的情况下获得。ACT/DINOv2 与 XSkill 恰好是已见任务上最强的两个模型,这提示“已见任务高分”部分来自对场景的过拟合。结论边界:只测了 4 个模型、5 个已见任务,每个原任务只配了一个 similar 和一个 unrelated 替换视频,没有重复替换来估计方差;也没有衡量模型在替换后是否执行了被替换的任务(场景中通常不具备完成它的条件)。另外,此实验没有在未见任务上做,而未见任务恰恰最需要示范来指定任务。
原文
In the similar regime the replacement shares broad manipulation structure with the original (StirSpoon\toGrindFood, FoldTowel\toPlaceClothBasket, PlaceMugRack\toPlaceCommodityRack, PlaceFileFolder\toPlaceMagazineFolder, PlacePlateRack\toPlaceBookBookcase); in the unrelated regime it shares nothing (OpenBox, PickWash, PlaceBrushRest, PlaceScrewdriver, ScanPillBottle, assigned in that order).
译文
在相似设定中,替换视频与原示范在大的操作结构上相同(StirSpoon\toGrindFood,FoldTowel\toPlaceClothBasket,PlaceMugRack\toPlaceCommodityRack,PlaceFileFolder\toPlaceMagazineFolder,PlacePlateRack\toPlaceBookBookcase);在无关设定中,两者毫无共同之处(依次分配为 OpenBox、PickWash、PlaceBrushRest、PlaceScrewdriver、ScanPillBottle)。
解释
相似对的设计逻辑是“动作模式相近、目标不同”:用勺子搅拌对研磨食物(都是手持工具做圆周或往复运动),把杯子挂到架子上对把商品放到架子上,把文件放进文件夹对把杂志放进文件夹,等等。“依次分配”指无关视频按顺序对应五个原任务:StirSpoon\toOpenBox,FoldTowel\toPickWash,PlaceMugRack\toPlaceBrushRest,PlaceFileFolder\toPlaceScrewdriver,PlacePlateRack\toScanPillBottle。如果模型从示范中读取的是“动作模式”,similar 设定下的成功率应明显高于 unrelated。表 10 中只有 XSkill(0.31 对 0.23)和 \pi_{0.5}(0.15 对 0.01)表现出这一差别。\pi_{0.5} 的差别尤其说明问题:它读的是文字描述,“研磨食物”与“搅拌”在语言上相近,模型仍会去拿勺子做类似动作;“打开盒子”则完全把它引向别处。
C.7两个评测通道、两个域之间在多大程度上一致?
原文
The benchmark reports two score streams and two domains, and Figure 13 quantifies how far each can substitute for the other. Panel (a) plots the automated predicate against the Arena judgment on the identical simulation rollouts. The two agree closely: r = 0.858 for \mathrm{SR} vs. \mathrm{SR}_{\mathrm{human}} and r = 0.861 for \mathrm{Sub\text{-}SR} vs. \overline{Q} when the same cells are resolved by level. The automated metric is therefore a faithful, cheap proxy for the human judgment in simulation, which is what licenses running the full 15-variant grid automatically.
译文
本基准报告两条评分流和两个域,图 13 量化了它们彼此能在多大程度上相互替代。子图 (a) 在完全相同的仿真回合上,把自动判定谓词与 Arena 判断对照画出。两者高度一致:\mathrm{SR} 与 \mathrm{SR}_{\mathrm{human}} 的相关系数 r=0.858;把相同的格子按层级拆开时,\mathrm{Sub\text{-}SR} 与 \overline{Q} 的相关系数 r=0.861。因此,在仿真中自动指标是人类判断的一个可靠且廉价的替代,这也是我们可以用自动方式跑完全部 15 个变体网格的依据。
解释
样本量与相关系数的含义:图 13(a) 中每个点是一个(变体,设定)格子,颜色区分 Seen、ZS、Scr、P+FT 四种设定,15 个变体 \times 4 种设定,约 60 个点(零样本的点在原点附近大量重叠)。每个格子背后约有 200–600 个回合,人评端每个回合–示范对被 3–5 名不同评估者分别判断(附录 B.3),每个评分屏只有一人,论文没有报告评估者之间的一致性统计量。r=0.861 的“按层级拆开”没有对应的图,点数也未说明(若是 60 个格子再乘 4 个层级,则约 240 个点)。结论边界:第一,r 是把四种设定混在一起算的。零样本格子全部挤在 (0\sim0.13,\ 0\sim0.12),Seen/P+FT 格子集中在 0.5–0.9,设定之间的巨大差距本身就会把相关系数抬高。在同一设定内部,两个通道的一致性要差得多:例如 Seen 中 RDT-1B(自动 0.43、人评约 0.12)和 GR00T(自动 0.51、人评约 0.72)偏离对角线约 0.2–0.3;Scr 中有一个点自动约 0.35、人评为 0。因此,这个 r 能证明“两个通道对好坏的大致判断一致”,但不能证明“在相近的模型之间,自动指标能替代人评来排序”。第二,人评把 partial 计为失败,口径比自动 SR 更严。从图 13(b) 看,人评 SR 在 L0–L2 普遍比自动 SR 低约 0.02–0.04。第三,这一检验只在仿真内部进行,并不能推出“仿真结果可以替代真机结果”。
原文
Panel (b) resolves the same agreement by hierarchy level, on the seen-task rollouts: the automated \mathrm{SR} and Arena \mathrm{SR}_{\mathrm{human}} curves, and separately the automated Sub-SR and Arena \overline{Q} curves, both dip at L2 and both reproduce the L3 rebound (Section C.5).
译文
子图 (b) 在已见任务的回合上按层级拆分同一种一致性:自动 \mathrm{SR} 与 Arena \mathrm{SR}_{\mathrm{human}} 两条曲线,以及另一组自动 Sub-SR 与 Arena \overline{Q} 两条曲线,都在 L2 下陷,也都重现了 L3 的回升(第 C.5 节)。
解释
这段的作用是排除一种质疑:仿真中“L2 下陷、L3 回升”会不会是判定谓词写得有问题(例如 L3 的成功条件写得太宽松)?如果是谓词的问题,人看录像时应该不会给 L3 高分。结果是人评也显示 L3 回升,说明 L3 回合在人看来也确实完成了。但要注意这个检验能排除什么、不能排除什么。它排除的是“谓词误判”;C.5 给出的原因是“仿真 L3 任务本身构造得偏容易”(资产有限、运动规则化),这属于任务设计问题,人评同样无法发现,因为人看到的回合确实成功了。因此图 13(b) 支持“仿真 L3 回升是真实发生的”,但不能说明仿真 L3 衡量的是意图层级的模仿能力。关于“两个域”:本节标题和附录 C 开头都承诺要量化“仿真域与物理域能否互相替代”,但正文和图 13 都只处理了评分通道这一半,没有给出任何仿真对真机的一致性指标。用表 3、表 4 中两域共有的四个代表模型(\pi_{0.5}、XSkill、ACT/DINOv2、DP/DINOv2)可以自行计算两域 SR 的皮尔逊相关系数:Seen 为 0.71,ZS 为 -0.29,Scr 为 0.16,P+FT 为 0.23。每组只有 4 个点,统计意义很弱,但足以说明两域的模型排序在 Seen 以外的设定上基本不一致:例如 \pi_{0.5} 在仿真 Scr、P+FT 中排第一,在真机中则低于 XSkill。再加上 C.4、C.5 中两域“最难层级”不同(仿真 L2,真机 L3),合理的结论是:仿真可以用来大规模比较模型在已见任务上的能力,但在迁移与层级难度上不能替代真机。
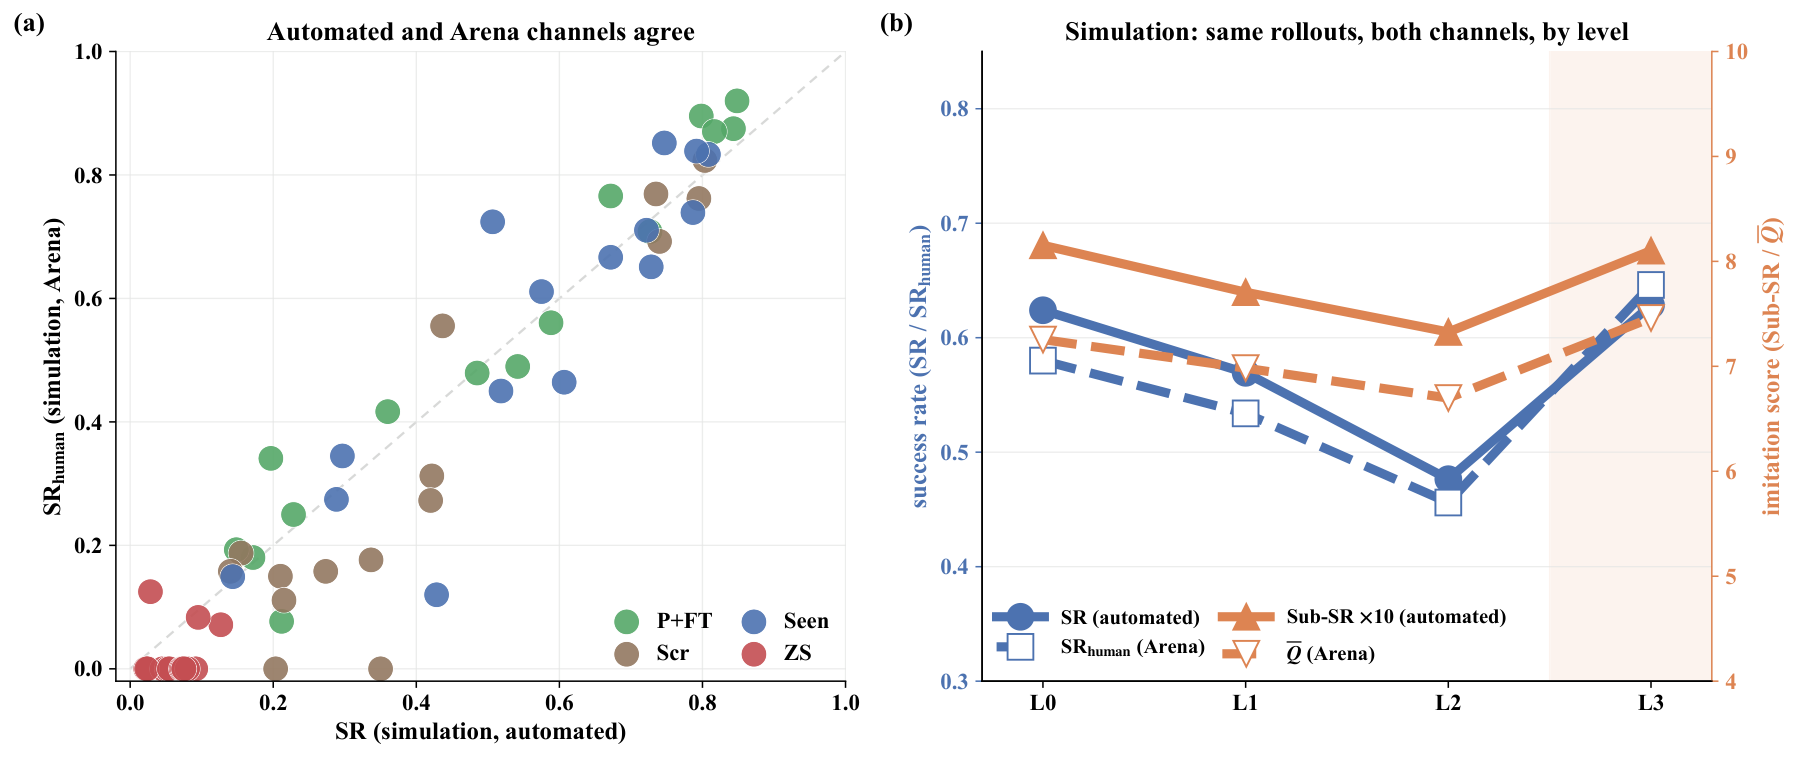
图 13:评测通道的有效性。(a) 对完全相同的仿真回合进行自动评分与 Arena 评分的比较(x:自动 \mathrm{SR};y:Arena \mathrm{SR}_{\mathrm{human}})。虚线为 y=x。(b) 同样两个通道在已见任务回合上按层级拆分(左轴:自动 \mathrm{SR} 与 Arena \mathrm{SR}_{\mathrm{human}};右轴:自动 Sub-SR\times10 与 Arena \overline{Q})。
原图注:Validity of the evaluation channels. (a) Automated vs. Arena scoring of the identical simulation rollouts (x: automated \mathrm{SR}; y: Arena \mathrm{SR}_{\mathrm{human}}). Dashed line is y=x. (b) The same two channels, resolved by hierarchy level on the seen-task rollouts (left axis: automated \mathrm{SR} and Arena \mathrm{SR}_{\mathrm{human}}; right axis: automated Sub-SR\times10 and Arena \overline{Q}).
图 13 解读
子图 (a) 是散点图,横轴为仿真自动 SR,纵轴为同一批回合的人评 SR,灰色虚线为 y=x。四种颜色代表四种设定:绿 P+FT、蓝 Seen、棕 Scr、红 ZS。红点几乎全部挤在左下角(自动 0.02–0.13,人评 0–0.12),蓝点和绿点沿对角线分布在 0.15–0.92,棕点分布最散。肉眼可见的离群点有:蓝点(0.43, 0.12),横坐标对应表 3 中 RDT-1B 的 Seen SR,人评远低于自动评分,这与 RDT-1B 在图 8(c) 中 WR 垫底(0.19)一致;蓝点(0.51, 0.72),对应 GR00T,人评明显更高;棕点(0.35, 0.00)和(0.20, 0.00),自动判为成功三成而人评全部判失败。点整体略偏在对角线下方,与人评把“部分完成”计为失败一致。子图 (b) 横轴 L0–L3,L3 加浅橙底纹。蓝色实线(自动 SR)为 0.62/0.57/0.48/0.63,与图 12(c) 的全体模型曲线相同;蓝色虚线(人评 SR)约为 0.58/0.53/0.455/0.645,在 L0–L2 比自动 SR 低 0.02–0.04,在 L3 略高。橙色实线(自动 Sub-SR\times10)约为 8.15/7.7/7.3/8.1;橙色虚线(人评 \overline{Q})约为 7.25/7.0/6.7/7.45。四条曲线都是 V 形,最低点都在 L2。它支持的结论:(a) 支持“自动指标是人评的廉价替代”,(b) 支持“仿真层级曲线的非单调性不是谓词造成的假象”。它不涉及仿真与真机的比较。
C.8逐任务诊断
原文
Beyond the ten seen/unseen tasks used for cross-model comparison in the main text, we also report a full-coverage sanity check: DP and ACT trained on the complete IG-10K simulation corpus (all 50 tasks, 50 demonstrations each, all 200 task–level variants) and evaluated on every task. The purpose is not to compare these two models against the others, but to confirm that the ten selected tasks are representative of the wider pool – i.e., that the benchmark's difficulty comes from the L0–L3 hierarchy itself rather than from an unrepresentative or favorably chosen task subset – and to leave future work a reference that is not limited to the ten tasks used elsewhere in the paper. The full per-task reference is Table 11 in Appendix H.
译文
除了正文中用于跨模型比较的十个已见/未见任务之外,我们还报告一项全覆盖的合理性检查:在完整的 IG-10K 仿真语料上训练 DP 和 ACT(全部 50 个任务,每个任务 50 条示范,全部 200 个任务–层级变体),并在每个任务上评测。目的不是把这两个模型与其他模型比较,而是确认所选的十个任务能代表更大的任务池,也就是说,基准的难度来自 L0–L3 层级本身,而不是来自一个不具代表性或被刻意挑选的任务子集;同时也为后续工作留下一份不局限于本文其他部分所用十个任务的参考。完整的逐任务参考见附录 H 的表 11。
解释
50\times4=200,即 50 个任务各有 L0–L3 四个层级变体。这一检查回应的是一种常见质疑:评测用的十个任务会不会是挑出来的、恰好让某种结论成立的子集?如果在全部 50 个任务上,DP 和 ACT 的分层级曲线与在十个任务上的形状相近,就说明十个任务具有代表性。需要注意两点。第一,这里训练用的是全部 50 个任务,与正文中“15/30/45 任务预训练、五个未见任务排除在外”的协议不同,所以表 11 中的数字不能直接与表 3 对比。第二,本节只给出了目的,具体结论(十个任务是否真的具有代表性、仿真全量任务是否也呈现 L2 下陷)要到附录 H 的表 11 才能核对。
D掩码生成细节(Mask Generation Details)
原文
The segmentation masks in IG-10K are produced as an offline preprocessing step rather than as part of the policy input or the benchmark scoring pipeline. They serve as an additional object-centric annotation layer of the dataset for analysis, dataset inspection, and future training objectives.
译文
IG-10K 中的分割掩码是作为离线预处理步骤生成的,既不是策略输入的一部分,也不进入基准的评分流程。它们是数据集额外的一层以物体为中心(object-centric)的标注,用于分析、数据集检查以及未来的训练目标。
解释
这一段先给掩码定位:它只是“附带标注”。正文所有基线的输入都只有 ZED2i 的 RGB 帧(加上人类视频或其文本描述),成功率也由仿真谓词或人工判定给出,都不读取掩码。所以掩码质量好坏不会影响表 3、表 4 的任何数字。作者特意说明这一点,是为了避免读者误以为某些基线借助了物体级先验。至于“未来的训练目标”,指的是有了逐帧物体掩码之后,可以做以物体为中心的表征学习、辅助分割损失,或者把人类视频和机器人视频中的同一物体对齐。这些都是数据集的扩展用途,本文没有使用。
原文
Text-conditioned mask proposal. We use a Grounded-SAM-2 based pipeline to generate the masks. For each task, annotators manually inspect episodes and summarize the relevant objects for human, robot, and simulation. The object list is converted into text prompts for GroundingDINO, which proposes object boxes for each camera episode using task-specific box and text confidence thresholds. These boxes are then passed to SAM-2 to produce the corresponding video masks for that episode. The procedure therefore combines human-curated object prompts with open-vocabulary detection and video segmentation.
译文
文本条件的掩码提议。我们使用基于 Grounded-SAM-2 的流程生成掩码。对每个任务,标注员人工查看各条片段(episode),分别为人类、机器人和仿真三类数据归纳出相关物体。物体清单被转换成 GroundingDINO 的文本提示,GroundingDINO 按任务特定的框置信度阈值和文本置信度阈值,为每个相机的每条片段提出物体框。这些框随后传给 SAM-2,生成该片段对应的视频掩码。因此,这一流程把人工整理的物体提示与开放词汇检测和视频分割结合在了一起。
解释
Grounded-SAM-2 是两个现成模型的串联。第一步是 GroundingDINO,一个开放词汇(open-vocabulary)检测器:输入图像和一段文字(如“spoon . bowl . cup”),它输出与文字短语对应的边界框。“开放词汇”的意思是类别不限于训练时的固定标签集,任何能用文字描述的物体都可以尝试检测。第二步是 SAM-2(Segment Anything Model 2),它接受框之类的提示,输出像素级掩码,并能在视频中沿时间传播,所以只需在起始帧给框,就能得到整段视频的掩码序列。人工归纳物体清单这一步并非可有可无。同一任务在 L2、L3 层级会换物体(例如 L3 用功能替代物),人类视频、真机和仿真场景中的物体外观也不同,所以提示词要按任务、按数据来源分别写,否则检测器会漏检或检错。这里的“任务特定阈值”和下一段的“统一默认值”在口径上有些出入,见下一段解释。
原文
Filtering and quality control. GroundingDINO detections are filtered by box and text confidence thresholds. In our runs we use conservative defaults of
box_threshold=0.35 and text_threshold=0.25. We additionally render mask overlays on sampled camera episodes for visual inspection, run audit scripts to detect empty or missing episode-camera masks, and manually filter problematic results before treating the masks as part of the released annotation set. 译文
过滤与质量控制。GroundingDINO 的检测结果按框置信度和文本置信度阈值过滤。在我们的运行中,采用保守的默认值
box_threshold=0.35 和 text_threshold=0.25。此外,我们在抽样的相机片段上渲染掩码叠加图进行目视检查,运行审计脚本检测空的或缺失的“片段—相机”掩码,并在把掩码纳入发布的标注集之前人工剔除有问题的结果。 解释
GroundingDINO 的两个阈值含义不同。
box_threshold 作用在每个候选框的最大匹配得分上,低于 0.35 的框直接丢弃,用来控制“这里到底有没有物体”;text_threshold 作用在框与提示中每个词元的匹配得分上,低于 0.25 的词不作为该框的标签,用来控制“这个框对应哪个物体名”。0.35/0.25 恰好是 GroundingDINO 官方示例的默认值。作者称之为“保守”,是指宁可漏检也不要误检,漏掉的部分再由审计脚本(检测空掩码或缺失掩码)和人工复查补救。口径上的小问题:上一段说检测使用“任务特定的”阈值,这一段又说运行中用统一的默认值 0.35/0.25。合理的解读是默认值适用于大多数任务,个别任务另行调整,但原文没有说明哪些任务、调成了多少。由于掩码不参与评测,这一点不影响主要结论。 EMANO 手部姿态标注(MANO Hand Pose Annotation)
原文
MANO hand pose annotations in IG-10K are auto-generated and serve as auxiliary hand annotations.
译文
IG-10K 中的 MANO 手部姿态标注是自动生成的,作为辅助性的手部标注。
解释
MANO 是最常用的参数化手部模型:用少量参数(全局朝向、15 个关节的旋转、10 维形状系数)驱动一个带骨骼的手部网格,可以输出 778 个顶点的网格和关节位置。“自动生成”说明这些标注来自估计模型,没有经过动捕或人工校正,因此只是“辅助”标注,精度有限。和掩码一样,正文的基线都没有使用 MANO 标注。另据附录 B,MANO 只为真实人类视频提供,仿真片段复用真实人类视频,所以同样有对应的 MANO 标注来源,但机器人侧没有。
原文
Per-view WiLoR estimation. We estimate MANO-style hand poses with WiLoR on multi-view RGB videos. The camera streams are synchronized at the episode timestep level. Each view is processed independently, and predictions are stored separately for the left and right hands.
译文
逐视角 WiLoR 估计。我们在多视角 RGB 视频上用 WiLoR 估计 MANO 形式的手部姿态。各相机流在片段时间步的层面上同步。每个视角独立处理,左手和右手的预测分开存储。
解释
WiLoR 是一个单目 RGB 手部重建模型:先用检测器找出手并判断左右,再对裁剪出的手部图像块回归 MANO 参数和一个弱透视相机。它对每张图独立工作,不需要标定。这里的关键限制是“每个视角独立处理”。多相机数据通常可以通过三角化把各视角的 2D 关键点融合成一个世界坐标下的 3D 手,或者做多视角联合优化。本文没有这样做,原因在下一段:没有标定的相机外参。所以同一时刻、同一只手在不同相机下会有各自独立的一组 MANO 估计,彼此之间没有强制一致。“在时间步层面同步”只保证不同相机的第 t 帧对应同一时刻,不涉及空间对齐。
原文
For frame t, camera c, and hand side h \in \{\mathrm{left}, \mathrm{right}\}, we store
\theta^{g}_{t,c,h} \in \mathbb{R}^{3}, \quad \theta^{p}_{t,c,h} \in \mathbb{R}^{45}, \quad \beta_{t,c,h} \in \mathbb{R}^{10},
where \theta^{g} is the MANO global orientation, \theta^{p} contains the 15 articulated MANO joint rotations, and \beta denotes MANO shape coefficients. Rotations are stored in axis-angle form. We additionally store \tau_{t,c,h} \in \mathbb{R}^{3}, \quad f_{t,c,h} \in \mathbb{R}^{2}, \quad J_{t,c,h} \in \mathbb{R}^{21 \times 3},
where \tau is the full-image camera translation converted from WiLoR's crop-level camera prediction, f is the focal length used for projection, and J denotes the 21 predicted 3D hand keypoints. Missing detections are stored as zero-valued placeholders with an invalid flag. Since calibrated camera extrinsics are unavailable, we do not transform estimates into a shared world coordinate frame; the annotations should be interpreted as per-view MANO estimates. 译文
对第 t 帧、相机 c、手侧 h \in \{\mathrm{left}, \mathrm{right}\},我们存储
\theta^{g}_{t,c,h} \in \mathbb{R}^{3}, \quad \theta^{p}_{t,c,h} \in \mathbb{R}^{45}, \quad \beta_{t,c,h} \in \mathbb{R}^{10},
其中 \theta^{g} 是 MANO 全局朝向,\theta^{p} 包含 MANO 的 15 个关节旋转,\beta 表示 MANO 形状系数。旋转以轴角(axis-angle)形式存储。我们还额外存储 \tau_{t,c,h} \in \mathbb{R}^{3}, \quad f_{t,c,h} \in \mathbb{R}^{2}, \quad J_{t,c,h} \in \mathbb{R}^{21 \times 3},
其中 \tau 是由 WiLoR 的裁剪图级相机预测换算得到的全图相机平移,f 是投影所用的焦距,J 表示预测的 21 个 3D 手部关键点。缺失的检测以零值占位并附带无效标志存储。由于没有标定的相机外参,我们不把估计变换到统一的世界坐标系中;这些标注应理解为逐视角的 MANO 估计。 解释
逐个看符号。下标 t,c,h 分别是帧、相机、左右手,每个组合存一套参数。\theta^{g}\in\mathbb{R}^3 是整只手(腕部根节点)相对相机的朝向,用轴角表示:向量的方向是旋转轴,长度是旋转角(弧度)。\theta^{p}\in\mathbb{R}^{45} 是手指姿态,MANO 的手部骨架除腕部外有 15 个关节(5 根手指各 3 个),每个关节一个 3 维轴角,15\times3=45。\beta\in\mathbb{R}^{10} 是形状系数,即 PCA 形状空间的前 10 个主成分,决定手的大小、手指粗细和长短,与姿态无关。\tau\in\mathbb{R}^3 是手在相机坐标系下的平移。WiLoR 是在裁剪出的手部小图上预测弱透视相机参数(缩放 s 和平面平移 t_x,t_y)的,要放回整幅图像,就得结合裁剪框的位置和大小,以及假定的焦距,换算成全透视下的 3D 平移,这就是“由裁剪图级预测换算得到”的含义。f\in\mathbb{R}^2 是 (f_x,f_y),即换算和投影时使用的焦距。由于没有真实标定,这个焦距通常是按图像尺寸设定的经验值,因此 \tau 的深度分量只是近似。J\in\mathbb{R}^{21\times3} 是 21 个 3D 关键点:MANO 本身的 16 个关节(腕部加 15 个)再加 5 个指尖顶点,这是手部姿态估计中通行的 21 点格式。最后两句是使用上的提醒。检测失败的帧不删除,而是填零并打无效标记,这样所有相机、所有帧的数组长度一致,使用者要先按标记过滤。没有相机外参,就无法把不同视角的估计放进同一个世界坐标系,也就做不了多视角三角化或融合。所以同一时刻不同相机给出的 \theta^{g}、\tau 各在自己的相机坐标系里,不能直接比较或平均。
原文
Shape-stabilized keypoints. To reduce temporal jitter caused by frame-wise MANO shape estimation, we compute an episode-level mean MANO shape \bar{\beta}_{c,h} from valid detections and use it only to recompute the stored 3D keypoints,
\bar{J}_{t,c,h} = \mathrm{MANO}_{J} \left( \theta^{g}_{t,c,h}, \theta^{p}_{t,c,h}, \bar{\beta}_{c,h} \right),
while keeping other MANO parameters unchanged. 译文
形状稳定化的关键点。为减少逐帧估计 MANO 形状所带来的时间抖动,我们用有效检测计算片段级的平均 MANO 形状 \bar{\beta}_{c,h},并且只用它重新计算所存储的 3D 关键点:
\bar{J}_{t,c,h} = \mathrm{MANO}_{J} \left( \theta^{g}_{t,c,h}, \theta^{p}_{t,c,h}, \bar{\beta}_{c,h} \right),
其他 MANO 参数保持不变。 解释
动机:一个人的手形在一条片段内不会变,但 WiLoR 每帧独立估计 \beta,结果会在帧间轻微跳动,表现为手指忽长忽短,关键点 J 随之抖动。解决办法是对同一相机 c、同一只手 h,在整条片段所有有效帧上对 \beta 取平均得到 \bar\beta_{c,h}(注意下标里没有 t,它在时间上是常数),再把每帧的姿态 \theta^{g}_{t,c,h},\theta^{p}_{t,c,h} 和这个固定形状一起送入 MANO 前向运动学。\mathrm{MANO}_J(\cdot) 表示 MANO 模型输出关节位置的那一部分:先由形状生成静息手网格和骨长,再按各关节旋转做蒙皮和运动学链变换,最后取出 21 个关键点。“只用它重算关键点、其他参数不变”意味着存储的逐帧 \beta_{t,c,h} 仍是原始估计,被替换的只是 J。这样做最保守:既给下游一个时间上更平滑的关键点序列,又保留原始估计以便复现或另作处理。不过原文没有说明 \bar J 是覆盖原来的 J 还是另存一份。按“recompute the stored 3D keypoints”的字面意思,更可能是覆盖。另外,形状平均只能消除骨长带来的抖动,姿态参数本身的帧间抖动并未做时间平滑。平均也只在单个视角内进行,不同相机得到的 \bar\beta 仍可能略有差异。
F基线实现细节(Baseline Implementation Details)
原文
All baselines use the same IG-10K task splits, ZED2i RGB stream, and 16-dimensional dual-arm joint-position/gripper action space. For unseen-task transfer, both scratch and pre-train+fine-tune use the same 10 robot demonstrations per task.
译文
所有基线使用相同的 IG-10K 任务划分、相同的 ZED2i RGB 视频流,以及相同的 16 维双臂“关节位置/夹爪”动作空间。在未见任务迁移中,从头训练(scratch)和预训练加微调(pre-train+fine-tune)都使用每个任务同样的 10 条机器人示范。
解释
这一段是所有基线共享的“公平性前提”。16 维动作空间就是附录 B 所说的双臂各 7 个关节位置指令,再加左右各 1 维夹爪(2\times7+2=16)。统一输入(只用 ZED2i 一路 RGB)、统一动作空间、统一示范数,是为了让表 3、表 4 的差异主要归因于“如何读取人类示范”这一接口,而不是归因于数据量或传感器配置。下面 F.1–F.7 逐个说明每个基线在这个统一框架下做了哪些适配:哪些模块冻结、哪些训练、动作块多长、优化器和学习率是多少。读这些细节时要注意,各模型的训练预算并不完全对齐,例如训练轮数和批大小各不相同,这在后面会逐一指出。
F.1UniSkill
原文
We keep the two-stage UniSkill pipeline: skill-dynamics learning followed by a skill-conditioned diffusion policy. To align different human and robot execution speeds, the robot-side IDM transition uses
robot_frame_gap=35. Stage 1 trains the UniSkill dynamics modules with 10-frame, 30 Hz clips, batch size 192, AdamW, learning rate 1{\times}10^{-5}, cosine decay, 500 warmup steps, and bfloat16 precision, while the VAE, text encoder, and depth estimator remain frozen. Stage 2 trains the policy with observation horizon 2, prediction horizon 16, action horizon 8, batch size 128, AdamW, learning rate 1{\times}10^{-4}, DDPM diffusion with 100 steps, and alignment loss weight 1.0. 译文
我们保留 UniSkill 的两阶段流程:先学习技能动力学,再训练以技能为条件的扩散策略。为对齐人类和机器人不同的执行速度,机器人侧的 IDM 转移使用
robot_frame_gap=35。第一阶段训练 UniSkill 的动力学模块:10 帧、30 Hz 的片段,批大小 192,AdamW,学习率 1{\times}10^{-5},余弦衰减,500 步预热,bfloat16 精度;VAE、文本编码器和深度估计器保持冻结。第二阶段训练策略:观测时域 2,预测时域 16,动作时域 8,批大小 128,AdamW,学习率 1{\times}10^{-4},100 步的 DDPM 扩散,对齐损失权重 1.0。 解释
UniSkill 的思路是从两帧之间的变化中学出与“具身形态无关”的技能表示。第一阶段用逆动力学模型(IDM, inverse dynamics model)把“当前帧到未来帧”的变化编码成技能向量,同时训练一个前向模型,用当前帧加技能向量去预测未来帧(这里借用了图像生成模型的 VAE 潜空间,所以 VAE 冻结;深度估计器提供额外的几何线索,也冻结)。第二阶段的扩散策略以这个技能向量为条件输出机器人动作,测试时把人类视频的片段编码成技能向量,驱动机器人。
robot_frame_gap=35 是本文的关键适配。人做一个动作通常比机器人快得多,同一个“技能片段”在人类视频里可能只跨几帧,在机器人视频里却要跨几十帧。在 30 Hz 下,35 帧约 1.2 秒,即机器人侧用间隔 35 帧的两帧来构造 IDM 的输入对,使一个技能向量覆盖的“动作量”与人类侧大致相当。三个时域参数的含义是:策略看最近 2 帧观测,一次预测未来 16 步动作,实际执行其中前 8 步后重新规划,这是 Diffusion Policy 的标准设定。对齐损失权重 1.0 指人类与机器人技能表示之间的对齐项与主损失等权。 F.2XSkill
原文
We preserve XSkill's two-stage prototype-learning and prototype-conditioned policy structure, replacing offline prototype labels with prototypes extracted from paired IG-10K clips. Stage 1 uses 30-frame clips split by
slide=3 into 4-frame windows, 128 prototypes, batch size 128, Adam, initial learning rate 2{\times}10^{-4}, OneCycleLR with maximum learning rate 4{\times}10^{-4}, temperature 0.1, and 3 Sinkhorn iterations. Stage 2 snaps each human video to 30 prototype tokens and trains a DDPM policy with observation horizon 4, prediction horizon 16, action horizon 8, batch size 128, AdamW, learning rate 1{\times}10^{-4}, cosine decay, 500 warmup steps, and 60 diffusion steps. At evaluation time, the robot-side prototype is computed from 4 frames sampled from the recent observation history. 译文
我们保留 XSkill 的两阶段结构,即原型学习加以原型为条件的策略,只是把离线原型标签换成从 IG-10K 配对片段中提取的原型。第一阶段使用 30 帧的片段,按
slide=3 切分成 4 帧窗口;原型数 128,批大小 128,Adam,初始学习率 2{\times}10^{-4},OneCycleLR 调度(最大学习率 4{\times}10^{-4}),温度 0.1,Sinkhorn 迭代 3 次。第二阶段把每段人类视频“吸附”为 30 个原型词元,并训练一个 DDPM 策略:观测时域 4,预测时域 16,动作时域 8,批大小 128,AdamW,学习率 1{\times}10^{-4},余弦衰减,500 步预热,60 步扩散。评估时,机器人侧的原型由最近观测历史中采样的 4 帧计算。 解释
XSkill 的核心是一组共享的“技能原型”,可以理解为 128 个聚类中心。人类和机器人的短视频窗口都被编码后分配到这些原型上。分配用 Sinkhorn-Knopp 算法求解一个带均匀分布约束的最优传输问题,迫使每个原型都被使用,避免所有样本塌缩到同一个原型(这是 SwAV 类自监督方法的做法)。温度 0.1 控制分配的软硬程度,越小越接近 one-hot;3 次 Sinkhorn 迭代是常用的轻量设置。原 XSkill 依赖无配对数据上的自监督对齐,这里换成 IG-10K 的人机配对片段来提取原型,利用了数据集“同一任务人机配对”的结构。第二阶段的“吸附”是指把人类视频切成窗口,每个窗口取最近的原型,于是整段视频变成 30 个离散原型词元组成的“技能计划”,策略按这个计划执行。评估时,机器人用最近 4 帧算出自己当前所处的原型,用来判断执行到了计划的哪一步。这种离散技能序列的设计,与附录 G 中“XSkill 通常能保持示范的动作顺序”的观察是吻合的。一个小的不清楚之处:30 帧按步长 3 切 4 帧窗口,得到的窗口数 (30-4)/3+1 不是整数(约 9.7),所以末尾要么截断、要么补齐,原文没有说明。“30 个原型词元”与“30 帧片段”数字相同,但前者指整段人类视频被重采样成的词元数,两者不是一回事。
F.3OpenVLA
原文
We initialize from
openvla/openvla-7b and keep the 7B vision-language backbone frozen. The human video is converted into the fixed caption T(V), and only the OFT-style (Kim et al., 2025) continuous action head and proprioceptive projector are trained for our 16-DoF dual-arm action space. To reduce training cost, we precompute action-token hidden states with shape (256,4096) per sample and add proprioception through an output-side projector before the action head. The action horizon is 16; training uses AdamW, learning rate 1{\times}10^{-4}, bfloat16 autocast, batch size 256, and 10 epochs across all three pre-training scales (45/30/15 tasks). Transfer runs also use 10 epochs with batch size 512. 译文
我们从
openvla/openvla-7b 初始化,并冻结 7B 的视觉—语言主干。人类视频被转换为固定的文字描述 T(V),只训练 OFT 风格(Kim et al., 2025)的连续动作头和本体感知投影器,以适配我们的 16 自由度双臂动作空间。为降低训练成本,我们为每个样本预先计算形状为 (256,4096) 的动作词元隐状态,并在动作头之前通过一个输出侧投影器加入本体感知。动作时域为 16;训练使用 AdamW,学习率 1{\times}10^{-4},bfloat16 自动混合精度,批大小 256,在三种预训练规模(45/30/15 个任务)下都训练 10 轮。迁移实验同样训练 10 轮,批大小 512。 解释
OpenVLA 原本把动作离散成词元,一步只输出一个动作。OFT(Optimized Fine-Tuning)是其后续工作提出的改法:换成连续回归的动作头,并行输出一整段动作块。这里只训练这个动作头和本体感知投影器,7B 主干完全冻结。冻结主干带来一个工程上的便利:给定图像和文字描述,主干输出是确定的,可以离线算好存起来。(256,4096) 就是每个样本缓存的隐状态,大致对应 256 个视觉块词元的位置,4096 是 Llama-2-7B 的隐层宽度。训练时只需在缓存上跑一个小动作头,成本降低几个数量级。代价是不能做在线图像增强,本体感知也只能在主干之后(“输出侧”)拼进来,无法参与视觉—语言的联合推理。这可能是 OpenVLA 在表 3 中成绩最低(Seen SR 0.29)的原因之一:可训练部分只是一个读出头,主干特征从未见过本文的双臂场景。另外,人类视频对 VLA 只以 T(V) 的形式出现(附录 C 的固定字幕器),所以 VLA 系基线从未“看到”人类动作本身,这是正文比较“视频接口与语言接口”时的设定。
F.4\pi_{0.5} 实现细节
原文
We adapt the public \pi_{0.5}-DROID checkpoint. The PaliGemma vision-language prefix remains frozen, and the trainable modules are the action-expert branch, action projections, and time-conditioning MLPs. Inputs are the ZED2i RGB frame resized to 224{\times}224, normalized dual-arm state, and the fixed caption T(V). The model predicts 50-step continuous action chunks and is trained with the standard flow-matching objective. All pretraining runs use 10 epochs, AdamW, peak learning rate 3{\times}10^{-5} with cosine decay to 3{\times}10^{-6}, 1000 warmup steps, batch size 16, bfloat16 precision, and 10 denoising steps at inference.
译文
我们改造公开的 \pi_{0.5}-DROID 检查点。PaliGemma 视觉—语言前缀保持冻结,可训练模块为动作专家(action expert)分支、动作投影层和时间条件 MLP。输入是缩放到 224{\times}224 的 ZED2i RGB 帧、归一化的双臂状态和固定字幕 T(V)。模型预测 50 步的连续动作块,用标准的流匹配(flow-matching)目标训练。所有预训练运行都训练 10 轮,AdamW,峰值学习率 3{\times}10^{-5},余弦衰减到 3{\times}10^{-6},1000 步预热,批大小 16,bfloat16 精度,推理时去噪 10 步。
解释
标题说明:这一小节的标题在 LaTeX 源文件中用了带可选参数的写法(目录项写作“Pi0.5 implementation details”),对照原 PDF 第 30 页,排出的标题是“F.4 \pi_{0.5} implementation details”,本节标题据此译出。\pi_{0.5} 由两部分组成:一个 PaliGemma 视觉—语言模型作为“前缀”,读入图像和文字;一个较小的“动作专家”Transformer 通过注意力读取前缀的特征,用流匹配生成连续动作块。流匹配的做法是:训练时在真实动作块和高斯噪声之间线性插值,让网络预测从噪声指向数据的速度场;推理时从噪声出发,沿预测的速度场积分 10 步,得到动作块。时间条件 MLP 负责把插值时间 \tau\in[0,1] 注入网络。DROID 检查点是在 DROID 单臂 Franka 数据上微调过的版本,与本文的双臂场景并不相同,所以动作投影层需要重新训练。50 步动作块是 \pi_0 系列的默认长度,比其他基线的 16 步长得多。批大小 16 也远小于其他基线的 128–256,原文没有解释,推测是显存限制。尽管如此,\pi_{0.5} 在仿真的少样本设定中表现最好(表 3:Scr. 0.80、P+FT 0.85),这说明它的预训练动作先验很强。但它的零样本 SR 只有 0.09,附录 G 中真机零样本也最不稳定,可见强大的动作先验并不能替代对人类示范本身的理解。
F.5RDT-1B 实现细节
原文
We initialize from the public RDT-1B checkpoint and use the fixed caption T(V) as language input. SigLIP-SO400M/14 and T5-v1.1-XXL are frozen, with text features cached when possible. We train LoRA adapters in the RDT Transformer and condition adaptors for language, image, state, and action tokens; the base RDT weights remain frozen. Actions are mapped into the original RDT unified action space with a validity mask, using a 16-step horizon and 30 Hz control-frequency token. Training uses LoRA rank 576, alpha 1152, dropout 0.05, batch size 128, gradient accumulation 4, AdamW, learning rate 1{\times}10^{-4}, cosine schedule with 500 warmup steps, and bfloat16 precision. All pretraining runs use 10 epochs.
译文
我们从公开的 RDT-1B 检查点初始化,并以固定字幕 T(V) 作为语言输入。SigLIP-SO400M/14 和 T5-v1.1-XXL 冻结,尽可能缓存文本特征。我们在 RDT Transformer 中训练 LoRA 适配器,并训练语言、图像、状态和动作词元的条件适配器;RDT 的基础权重保持冻结。动作被映射到 RDT 原有的统一动作空间并附带有效性掩码,使用 16 步时域和 30 Hz 的控制频率词元。训练使用 LoRA 秩 576、alpha 1152、dropout 0.05,批大小 128,梯度累积 4,AdamW,学习率 1{\times}10^{-4},余弦调度并带 500 步预热,bfloat16 精度。所有预训练运行都训练 10 轮。
解释
RDT-1B 是一个 10 亿参数的扩散 Transformer 双臂策略。它的一个特点是“统一动作空间”:预先定义一个 128 维的槽位表,把不同机器人的关节、末端位姿、夹爪等量分别放进固定的槽位,用不到的槽位由有效性掩码屏蔽,这样不同形态的数据可以混合训练。这里就是把本文的 16 维动作填进相应的槽位。控制频率也作为一个条件词元输入(30 Hz),让模型知道动作的时间尺度。LoRA 的做法是在冻结的权重矩阵旁加一个低秩增量 \Delta W=BA,只训练 A,B;alpha/rank 决定增量的缩放,这里 1152/576=2。秩 576 对 LoRA 来说异常大(常见是 8–64)。RDT 的隐层宽度约为 2048,秩 576 已经接近全量微调的表达能力,所以“基础权重冻结”实际上并没有带来多少容量限制,原文没有解释这个选择。有效批大小为 128\times4=512。RDT-1B 在表 3 中出现了 P+FT 低于 Scr. 的负迁移(\Delta=-0.14),可能与预训练阶段只训 10 轮、适配容量和数据规模不匹配有关,但原文没有给出分析。
F.6GR00T 实现细节
原文
We adapt GR00T-N1.6-3B with the Eagle vision-language backbone frozen. The fixed caption T(V), current ZED2i RGB frame, and dual-arm proprioception condition a 16-step action chunk. We train the flow-matching DiT action expert together with embodiment-specific state/action encoders, decoder, action position embedding, and action-side normalization layers. For all pretraining runs, GR00T is trained for 10 epochs with AdamW, learning rate 1{\times}10^{-4}, weight decay 1{\times}10^{-5}, cosine schedule with 0.05 warmup ratio, batch size 256, bfloat16 precision, and 4 denoising steps at inference. Dataset statistics are recomputed for the
NEW_EMBODIMENT normalization before each run. 译文
我们改造 GR00T-N1.6-3B,冻结其 Eagle 视觉—语言主干。固定字幕 T(V)、当前 ZED2i RGB 帧和双臂本体感知共同作为条件,生成 16 步动作块。我们训练基于流匹配的 DiT 动作专家,同时训练与具身形态相关的状态/动作编码器、解码器、动作位置嵌入和动作侧归一化层。所有预训练运行中,GR00T 训练 10 轮,AdamW,学习率 1{\times}10^{-4},权重衰减 1{\times}10^{-5},余弦调度且预热比例为 0.05,批大小 256,bfloat16 精度,推理时去噪 4 步。每次运行前,都会为
NEW_EMBODIMENT 归一化重新计算数据集统计量。 解释
GR00T 的结构与 \pi_{0.5} 类似,也是“冻结的视觉—语言模型 + 流匹配动作头”,区别是动作头为 DiT(Diffusion Transformer),并且为每种具身形态配一套独立的状态/动作编码器和解码器。
NEW_EMBODIMENT 是 GR00T 代码中为新机器人预留的形态标签,选用它意味着这些形态相关的模块都要从头学,归一化用的均值、方差或分位数也要按本文数据重新统计。每次运行前重算,是因为 15/30/45 三种规模的语料中动作分布不同。推理只去噪 4 步,比 \pi_{0.5} 的 10 步少,追求的是实时性。GR00T 在表 3 中的特点很突出:零样本 SR 只有 0.03(所有模型中最低之一),但预训练后微调的增益最大(\Delta=+0.46,P+FT 0.67 对 Scr. 0.21)。一种解释是,形态相关模块和归一化完全依赖本文数据来学,IG-10K 预训练恰好为这些模块提供了足够的数据;而在 10 条示范的从头训练中,这些模块严重欠拟合。 F.7Video-VA(ACT、Diffusion Policy、VQ-BeT)实现细节
原文
ACT, Diffusion Policy, and VQ-BeT are conditioned on a cached task embedding z \in \mathbb{R}^{256} extracted from four uniformly sampled frames of the human video. We evaluate DINOv2-ViT-L/14, SigLIP2-SO400M, and VideoMAE-Large as frozen encoders, with a one-layer adapter trained with the policy. ACT injects z as an additional Transformer decoder token and uses L1 reconstruction plus KL loss (\lambda_{\mathrm{KL}}=10), action horizon 24, batch size 256, AdamW, learning rate 1{\times}10^{-4}, and 100 epochs. Diffusion Policy concatenates z into the global FiLM conditioning vector and uses a DDPM 1D UNet with action horizon 16, 100 train/inference diffusion steps, batch size 256, AdamW, learning rate 1{\times}10^{-4}, and 100 epochs. VQ-BeT prepends a projected z token to the observation sequence; its VQ-VAE is trained for 100 epochs on robot action chunks, then the GPT policy is trained for 100 epochs with batch size 256 and learning rate 1{\times}10^{-4}.
译文
ACT、Diffusion Policy 和 VQ-BeT 都以一个缓存的任务嵌入 z \in \mathbb{R}^{256} 为条件,它由人类视频中均匀采样的四帧提取得到。我们评估 DINOv2-ViT-L/14、SigLIP2-SO400M 和 VideoMAE-Large 三种冻结编码器,并配一个与策略一起训练的单层适配器。ACT 把 z 作为一个额外的 Transformer 解码器词元注入,使用 L1 重建损失加 KL 损失(\lambda_{\mathrm{KL}}=10),动作时域 24,批大小 256,AdamW,学习率 1{\times}10^{-4},训练 100 轮。Diffusion Policy 把 z 拼接进全局 FiLM 条件向量,使用 DDPM 一维 UNet,动作时域 16,训练和推理均为 100 步扩散,批大小 256,AdamW,学习率 1{\times}10^{-4},训练 100 轮。VQ-BeT 把投影后的 z 词元前置到观测序列之前;其 VQ-VAE 先在机器人动作块上训练 100 轮,然后 GPT 策略以批大小 256、学习率 1{\times}10^{-4} 训练 100 轮。
解释
这一组基线的共同点是:人类视频被压缩成一个 256 维的任务向量 z。做法是均匀抽 4 帧,送入冻结的图像或视频编码器,再经一个可训练的单层适配器投影到 256 维。三种编码器代表三类表征:DINOv2 是纯视觉自监督(擅长物体和几何),SigLIP2 是图文对比预训练(带语义),VideoMAE 是视频掩码重建(带时序)。正文发现 DINOv2 和 SigLIP2 明显强于 VideoMAE(例如表 3 中 DP/VideoMAE 的 Seen SR 只有 0.14),说明只有 4 帧时,视频模型的时序优势发挥不出来,而物体和场景的辨识更重要。三种策略注入 z 的方式各不相同。ACT 是基于条件 VAE 的 Transformer:训练时有一个编码器把真实动作块压缩成风格变量,KL 项把它约束到先验分布,\lambda_{\mathrm{KL}}=10 是 ACT 原文的默认值;z 作为额外词元进入解码器,与图像特征一起被注意力读取。Diffusion Policy 用 FiLM(逐通道仿射调制)把条件注入 UNet 的每一层,z 直接拼进这个条件向量。VQ-BeT 先用残差 VQ-VAE 把动作块离散化,再让 GPT 预测离散码,z 作为序列的第一个词元。训练预算也要注意:这三种模型都训练 100 轮,而 VLA 系只训练 10 轮。考虑到 VLA 有大规模预训练、Video-VA 是从头训练(编码器冻结),这个差异有其合理性,但“同等预算”下的比较并不严格成立。另外,ACT 的动作时域是 24,与其他模型的 16 也不相同。
原文
Evaluation. At inference, each video-conditioned policy encodes V once at episode start, while VLA policies reuse the fixed caption T(V). Simulation uses the rollout horizons and predicates in Appendix B.3, with 10 trials per task–level pair across all 15 variants; real-world evaluation uses \pi_{0.5}, XSkill, ACT/DINOv2, and DP/DINOv2 with 5 trials per task–level pair. Both domains evaluate the same 40 task–level pairs (Appendix B.2).
译文
评估。推理时,每个以视频为条件的策略在片段开始时对 V 编码一次,而 VLA 策略复用固定字幕 T(V)。仿真使用附录 B.3 中的回合时长和判定谓词,对全部 15 个变体,每个“任务—层级”组合各做 10 次试验;真机评估使用 \pi_{0.5}、XSkill、ACT/DINOv2 和 DP/DINOv2,每个“任务—层级”组合各做 5 次试验。两个域评估的是同样的 40 个“任务—层级”组合(附录 B.2)。
解释
“编码一次”意味着人类示范在整个回合中是静态的条件:策略不会随执行进度回看示范的不同部分(XSkill 例外,它的原型序列和当前原型匹配,相当于隐式地跟踪进度)。“15 个变体”是表 3 的 15 行:4 个 VLA、2 个技能方法、3 种策略 \times 3 种编码器。40 个组合是 10 个任务(5 个已见、5 个未见)乘 4 个层级。按此计算,每种设定只涉及其中 20 个组合(已见设定用 5 个已见任务,ZS、Scr.、P+FT 用 5 个未见任务),所以仿真中一个模型在一种规模、一种设定下有 20\times10=200 次试验,真机为 20\times5=100 次。表 3、表 4 的 Seen、ZS、P+FT 列还要在 15/30/45 三种规模上平均,所以这些格子背后的试验数要再乘以 3(Scr. 不涉及预训练规模,没有这个乘数)。真机每组合只有 5 次,单个组合的 SR 粒度是 0.2,所以表 4、表 5 中 0.05 量级的差异需要谨慎解读。
G失败模式与任务级诊断(Failure Modes and Task-Level Diagnostics)
原文
Real-world rollouts expose failure modes that are partly hidden by binary success rates.
译文
真机回合暴露出的失败模式,有一部分被二值的成功率掩盖了。
解释
这一句点明本附录的用途:表 4、表 5 只给出“成功/失败”的比例,同样是失败,有的是根本没找到物体,有的是抓到了却放错地方,二者在 SR 中没有区别。下面按模型、按任务、按未见迁移、按仿真逐任务四个角度,把这些失败拆开来看。这些描述是定性的,来自对回放视频的人工检查,原文没有给出每种失败模式的计数或比例。先给出一个阅读时有用的对照。附录 G 用的是真机任务名,附录 H 用的是仿真任务代号。根据附录 B 的任务表和正文 4.1 节对评测任务的描述,可以推断出如下对应关系(译者推断,原文未逐一列出):已见任务为 Stir Soup in Bowl \leftrightarrow StirSpoon、Fold Towel into Basket \leftrightarrow FoldTowel、Hang Cup on Rack \leftrightarrow PlaceMugRack、File Medical Documents \leftrightarrow PlaceFileFolder、Place Plates in Rack \leftrightarrow PlacePlateRack;未见任务为 Return Remote to Box \leftrightarrow PickRemoteControl、Scan Beverage Barcode \leftrightarrow ScanMilkBox、Pour Water into Cup \leftrightarrow PourKettle、Discard Food Waste \leftrightarrow PickFood、Seal and Pack Box \leftrightarrow FoldBox。
原文
Model-level patterns. XSkill produces the most consistent real-world behavior among the evaluated models. On seen tasks, its rollouts usually preserve the demonstrated action sequence and tolerate moderate object-placement changes; on unseen tasks it also shows useful partial transfer, but the records still contain failures from insufficient lift, premature gripper closure, or failure to release at the target. ACT/DINOv2 and DP/DINOv2 are less uniform. Their successful rollouts often follow the correct high-level subtask order, but many failures come from contact timing: the gripper closes before reaching the object, does not descend far enough, or releases too early/too late. \pi_{0.5} is the least stable in zero-shot real-world transfer. Its seen-task and fine-tuned runs can complete some tasks, but unseen zero-shot records repeatedly show arm jitter, early closure, and left-gripper non-closure, so its language-conditioned interface does not by itself give reliable physical transfer.
译文
模型层面的规律。在参评模型中,XSkill 在真机上的行为最为一致。在已见任务上,它的回合通常能保持示范的动作顺序,并能容忍中等程度的物体摆放变化;在未见任务上,它也表现出有用的部分迁移,但记录中仍有因抬升不足、夹爪过早闭合或未能在目标处松开而导致的失败。ACT/DINOv2 和 DP/DINOv2 的表现不那么均匀。它们的成功回合往往遵循正确的高层子任务顺序,但许多失败来自接触时机:夹爪在到达物体之前就闭合、下降不够深,或者松开得过早/过晚。\pi_{0.5} 在真机零样本迁移中最不稳定。它的已见任务和微调运行能完成部分任务,但未见任务的零样本记录中反复出现手臂抖动、过早闭合和左夹爪不闭合,因此它的语言条件接口本身并不能带来可靠的物理迁移。
解释
这一段给表 4 的数字配上了“行为画像”。XSkill 的 SR 在各设定下都最高(Seen 0.63、ZS 0.29、P+FT 0.49),这里的解释是它的离散原型序列(见附录 F.2)把示范切成有序的技能步骤,所以动作顺序最稳定,失败主要出在执行的最后几厘米,如抬不够高、没松手。ACT 和 DP 能学会“先做什么后做什么”,但接触时机不准。它们只有一个从 4 帧压缩出来的静态任务向量 z(附录 F.7),里面并没有“何时闭合夹爪”的细粒度信息,这类时序细节只能靠 10 条机器人示范去学,自然校准不足。\pi_{0.5} 的问题最具诊断意义。它的零样本 SR 只有 0.04(表 4),失败表现为手臂抖动和夹爪不闭合,这已经不是“理解错任务”,而是低层控制失调。语言描述 T(V) 能告诉模型“把遥控器放回盒子”,却无法提供抓取点、抓取高度这类物理细节;在没见过的任务上,动作专家缺少可依赖的先验,就会输出不稳定的动作。这与正文的结论一致:在零样本迁移上,视频接口始终优于语言接口。
原文
Task-level patterns. The clearest real-world failure cases are tasks where a small contact error destroys the rest of the rollout. Stir Soup in Bowl fails frequently because the spoon is thin and slips or is never fully captured. Discard Food Waste is difficult across models because it combines small/deformable food items, bimanual coordination, and precise release; many failures are left-gripper non-closure or no release after grasp. Scan Beverage Barcode similarly stresses grasp stability on the scanner or beverage, and several models reach the object but fail to close or hold the gripper. Hang Cup on Rack is a height-sensitive placement task: policies often grasp the mug but fail to lift high enough or align with the rack. By contrast, Place Plates in Rack, File Medical Documents, Fold Towel into Basket, and Seal and Pack Box show more coherent behavior, because the required grasps and placements are wider-tolerance and less dependent on exact gripper contact.
译文
任务层面的规律。真机上最典型的失败出现在这样一类任务中:一个小的接触误差就会毁掉回合的其余部分。Stir Soup in Bowl(在碗中搅汤)经常失败,因为勺子很细,会滑脱或根本没被完全抓住。Discard Food Waste(倒掉厨余)对各个模型都很难,因为它同时涉及细小/可变形的食物、双臂协调和精确松手;许多失败是左夹爪没闭合,或抓取后没有松开。Scan Beverage Barcode(扫描饮料条码)同样考验对扫描枪或饮料的抓握稳定性,好几个模型够到了物体却没能闭合或保持夹爪闭合。Hang Cup on Rack(把杯子挂到架上)是一个对高度敏感的放置任务:策略常常抓起了杯子,却抬得不够高或没对准挂架。相比之下,Place Plates in Rack(把盘子放入碗架)、File Medical Documents(归档病历)、Fold Towel into Basket(叠毛巾放入篮中)和 Seal and Pack Box(封箱打包)表现得更连贯,因为它们所需的抓取和放置容差更大,对夹爪的精确接触依赖更小。
解释
这一段的归因线索是“容差”:失败集中在需要精确接触的任务上,例如细勺、小块食物、扫描枪、挂钩高度,而与任务语义难度关系不大。这说明真机上的瓶颈有相当一部分在低层操作,而不在“看懂示范”。与附录 H 的仿真逐任务结果对照,会发现仿真与真机的难度排序并不一致。StirSpoon 在仿真中也是最难的任务之一(DP 17.5%、ACT 55.0%),这一点两边吻合。但 Hang Cup on Rack 在真机上难,对应的 PlaceMugRack 在仿真中却很容易(85.0%/95.0%);Scan Beverage Barcode 在真机上难,ScanMilkBox 在仿真中几乎满分(97.5%/100%);反过来,Fold Towel into Basket 在真机上“较连贯”,FoldTowel 在仿真中 DP 只有 37.5%。附录 C 已经指出,仿真的资产有限、运动是基于规则的,接触物理也被简化,所以“抓不稳、夹爪没闭合”这类失败在仿真中不容易出现。这也提醒读者,仿真 SR 和真机 SR 衡量的难点不完全相同。(注意表 11 的训练设定与正文不同,见附录 H 的说明,这里只作定性对照。)
原文
Unseen transfer. The unseen tasks should be read as evidence of partial generalization, not solved real-world imitation. Return Remote to Box is representative: several policies can localize and grasp the remote, and performance is often reasonable at L0–L2, but L3 exposes the missing affordance adaptation–the object is grasped with a plausible motion but placed at the wrong location, not lifted high enough, or released before reaching the substitute container. Pour Water into Cup also improves with adaptation, but failures still arise from missing the handle or closing before contact. The released rollout metadata stores task, level, model, corpus scale, setting, episode identifier, and video path, so each qualitative failure mode can be traced to representative rollouts in the benchmark release. These cases suggest that the models learn task-relevant visual and motion priors from IG-10K, while the few-shot real-world data are still too small to calibrate precise grasp points, release timing, and level-specific affordance substitutions.
译文
未见任务迁移。未见任务上的结果应被理解为部分泛化的证据,而不是真机模仿已被解决。Return Remote to Box(把遥控器放回盒子)很有代表性:好几个策略能定位并抓起遥控器,在 L0–L2 上的表现通常尚可,但 L3 暴露出缺失的可供性(affordance)适应:物体以合理的动作被抓起,却被放到错误的位置、抬得不够高,或者在到达替代容器之前就被松开。Pour Water into Cup(往杯中倒水)在适应后同样有所提升,但仍会因没抓到把手或在接触前就闭合而失败。发布的回合元数据记录了任务、层级、模型、语料规模、设定、片段编号和视频路径,因此每一种定性的失败模式都能追溯到基准发布中有代表性的回合。这些案例表明,模型从 IG-10K 中学到了与任务相关的视觉和运动先验,但少样本的真机数据仍然太少,不足以校准精确的抓取点、松手时机和各层级特有的可供性替代。
解释
这一段是正文 4.4 节结论“L3 可供性替代是最明显的瓶颈”在单个任务上的具体体现。L3 的定义(正文表 1)是:物体集合和物体本身都换了,连场景语义 S 也变了,只保留“底层意图”,需要用功能替代物达成同样的目的。以遥控器任务为例,L3 中原来的收纳盒可能被换成一个形状、高度都不同的替代容器。模型在 L0–L2 能做对,说明它已经学会“抓起遥控器并放进某个容器”。到了 L3 却放错位置、抬得不够高或提前松手,说明它执行的仍是示范中那个容器所对应的轨迹,没有根据替代物的形状和功能重新规划放置点。失败的位置也有讲究:抓取这一半通常没有问题,出错几乎都在“放”这一半,也就是与替代物交互的部分。这正对应正文表 5 的数字:四个模型平均 SR 在 L0–L2 约为 0.39–0.42,到 L3 降到 0.29;最强的 XSkill 从 0.53–0.57 跌到 0.29。最后一句把原因归于少样本数据量:10 条示范既要教会模型新任务,又要覆盖四个层级各自的可供性替代,数量显然不够。作者把这一点作为改进方向,而不是声称方法本身无法做到。
原文
Simulation per-task view. Table 11 gives the same diagnosis at larger scale. Tasks such as FoldBox, GrindFood, PlaceMugRack, and PickRemoteControl have high mean success, indicating that the policies can often infer the object and intended task. Yet the per-level breakdown is more informative than the mean: for PickRemoteControl, both DP and ACT remain strong through L0–L2, while L3 drops, matching rollouts where the remote can be found or grasped but the changed target relation is not executed correctly. Lower-scoring tasks such as PlaceCupPlate, PlaceFoodScale, and PlaceCommodityRack require tighter spatial alignment and contact geometry, so failures are better interpreted as insufficient manipulation coverage and calibration rather than a complete absence of task understanding.
译文
仿真逐任务视角。表 11 在更大规模上给出了同样的诊断。FoldBox、GrindFood、PlaceMugRack 和 PickRemoteControl 等任务的平均成功率很高,说明策略往往能推断出目标物体和预期任务。然而,按层级的细分比平均值更有信息量:对 PickRemoteControl,DP 和 ACT 在 L0–L2 上都保持很强,而在 L3 下降,这与“遥控器能被找到或抓起,但改变后的目标关系没有被正确执行”的回合相吻合。得分较低的任务,如 PlaceCupPlate、PlaceFoodScale 和 PlaceCommodityRack,需要更严格的空间对齐和接触几何,因此这些失败更应解释为操作覆盖和校准不足,而不是完全缺乏对任务的理解。
解释
核对表 11 的数字。四个“高均值”任务的 DP/ACT 均值分别为 FoldBox 100.0/100.0、GrindFood 100.0/90.0、PlaceMugRack 85.0/95.0、PickRemoteControl 85.0/95.0,与文字相符。PickRemoteControl 的层级细分为 DP 100/100/100/40、ACT 100/100/100/80,L3 确实下降,但 ACT 只从 100 降到 80,幅度不大,“both … L3 drops”对 DP 很明显,对 ACT 则较温和。有两点需要提醒读者。第一,作者挑出的“低分任务”(PlaceCupPlate 40.0/45.0、PlaceFoodScale 37.5/65.0、PlaceCommodityRack 37.5/72.5)并不是表中得分最低的。更低的有 PourLiquidCup(5.0/5.0,两个模型几乎全败)、WipePot(27.5/25.0)、StirSpoon(17.5/55.0)和 PlaceScrewdriver(DP 27.5),原文对这些任务没有讨论。第二,也是更重要的一点:在表 11 的全部 50 个任务上,L3 并不是仿真中最难的层级。对 50 个任务按层级取平均,DP 为 L0 65.6、L1 67.2、L2 60.0、L3 63.4,ACT 为 80.8、82.0、68.4、68.2。DP 最低的是 L2,ACT 的 L2 与 L3 基本持平。另外,L2 恰好为 0 的任务有 DP 7 个、ACT 8 个(如 CutFruit、OpenBox、PourKettle、PressJuicer、PlaceMagazineFolder、WipePot,两个模型同时为 0),这种“整格为 0”的模式更像是仿真 L2 场景构造本身的问题。这与附录 C 的说明一致:仿真 L2 同时交换了执行操作的手臂,形成 L2 低谷;仿真 L3 的替代物往往仍能用训练时的策略处理,形成 L3 回升。正因为如此,正文对“L3 是瓶颈”的论证依据的是真机 Arena 结果(表 5),而不是仿真。所以本段“表 11 在更大规模上给出同样的诊断”只在个别任务(如 PickRemoteControl)上成立;从整体看,仿真逐任务表并不能独立支撑 L3 瓶颈的结论。
H逐任务参考结果(Per-Task Reference Results)
原文
Per-task reference results for simulation success rate. Each cell reports success rate (%) over 10 evaluation episodes for the corresponding task and imitation level.
译文
仿真成功率的逐任务参考结果。每个单元格给出对应任务和模仿层级在 10 个评估回合上的成功率(%)。
解释
附录 H 在原文中只有表 11 一张表,没有正文段落,上面的原文框即表 11 的原表注。表的来历见附录 C 的“逐任务诊断”一节:这是一次“全覆盖”的完整性检查,只用 DP 和 ACT 两个模型,在完整的 IG-10K 仿真语料上训练(全部 50 个任务、每个任务 50 条示范、全部 200 个“任务—层级”变体),再在每个任务上评测。作者的目的不是比较模型,而是证明正文选出的 10 个评测任务在整个任务池中具有代表性,即基准的难度来自 L0–L3 层级本身,而不是来自一个特意挑选的任务子集;同时为后续工作留一份覆盖全部任务的参考。读表前要注意,这个设定与正文表 3 有三点不同。其一,训练集包含全部 50 个任务,因此正文中的 5 个“未见”任务在这里也参与了训练,不再是未见任务。其二,只训练一次,没有 15/30/45 三种规模,也不涉及零样本或微调。其三,原文没有说明这里的 DP 和 ACT 用的是哪种视觉编码器(正文有 DINOv2、SigLIP2、VideoMAE 三种)。下表中的中文任务名为译者根据代号意译;标记 ^{\mathrm{S}}、^{\mathrm{U}} 也是译者所加,分别表示正文中的 5 个已见评测任务和 5 个未见评测任务,原表中没有这些标记。
表 11:仿真成功率的逐任务参考结果。每个单元格为对应任务与模仿层级在 10 个评估回合上的成功率(%)。
| 任务代号 | 中文译名 | DP | ACT | 均值 | |||||||
| L0 | L1 | L2 | L3 | L0 | L1 | L2 | L3 | DP | ACT | ||
| CleanCup | 清洗杯子 | 40 | 50 | 20 | 100 | 30 | 30 | 70 | 90 | 52.5 | 55.0 |
| CleanDesk | 清理桌面 | 10 | 60 | 40 | 60 | 80 | 100 | 100 | 100 | 42.5 | 95.0 |
| CutFruit | 切水果 | 100 | 50 | 0 | 100 | 100 | 100 | 0 | 100 | 62.5 | 75.0 |
| FoldBox | 折叠纸箱^{\mathrm{U}} | 100 | 100 | 100 | 100 | 100 | 100 | 100 | 100 | 100.0 | 100.0 |
| FoldTowel | 叠毛巾^{\mathrm{S}} | 60 | 40 | 10 | 40 | 100 | 100 | 100 | 80 | 37.5 | 95.0 |
| GrindFood | 研磨食物 | 100 | 100 | 100 | 100 | 90 | 100 | 100 | 70 | 100.0 | 90.0 |
| KnifeBowlFork | 摆放刀、碗、叉 | 0 | 60 | 60 | 90 | 100 | 100 | 80 | 50 | 52.5 | 82.5 |
| LiftLidFromSkillet | 揭开平底锅盖 | 0 | 80 | 80 | 100 | 100 | 100 | 100 | 100 | 65.0 | 100.0 |
| OpenBox | 打开盒子 | 100 | 90 | 0 | 100 | 100 | 100 | 0 | 100 | 72.5 | 75.0 |
| OpenLiquidCap | 拧开瓶盖 | 60 | 50 | 70 | 50 | 90 | 60 | 90 | 0 | 57.5 | 60.0 |
| PickAppleBananaToBaskets | 苹果、香蕉分别入篮 | 50 | 100 | 50 | 100 | 90 | 90 | 50 | 50 | 75.0 | 70.0 |
| PickAppleBasket | 苹果放入篮中 | 70 | 70 | 100 | 80 | 100 | 90 | 100 | 100 | 80.0 | 97.5 |
| PickAppleToScale | 苹果放上秤 | 40 | 90 | 40 | 80 | 90 | 10 | 90 | 80 | 62.5 | 67.5 |
| PickFood | 拾取食物^{\mathrm{U}} | 40 | 100 | 10 | 90 | 100 | 70 | 30 | 90 | 60.0 | 72.5 |
| PickFruitsToPlate | 水果放到盘中 | 90 | 90 | 100 | 50 | 20 | 40 | 100 | 0 | 82.5 | 40.0 |
| PickPillToRegions | 药片分区放置 | 40 | 60 | 50 | 10 | 90 | 90 | 70 | 80 | 40.0 | 82.5 |
| PickRemoteControl | 拾取遥控器^{\mathrm{U}} | 100 | 100 | 100 | 40 | 100 | 100 | 100 | 80 | 85.0 | 95.0 |
| PickTennisBallGolfBall | 拾取网球和高尔夫球 | 90 | 90 | 90 | 100 | 60 | 80 | 70 | 50 | 92.5 | 65.0 |
| PickWash | 拿取沐浴露 | 70 | 100 | 30 | 80 | 90 | 100 | 60 | 90 | 70.0 | 85.0 |
| PlaceBookBookcase | 书放回书架 | 100 | 100 | 90 | 90 | 100 | 80 | 100 | 30 | 95.0 | 77.5 |
| PlaceBrushRest | 刷子放上支架 | 90 | 70 | 100 | 100 | 80 | 100 | 100 | 100 | 90.0 | 95.0 |
| PlaceBurgerTray | 汉堡放入餐盘 | 80 | 90 | 80 | 70 | 90 | 80 | 90 | 70 | 80.0 | 82.5 |
| PlaceChipsRack | 薯片上架 | 90 | 80 | 100 | 80 | 70 | 70 | 70 | 100 | 87.5 | 77.5 |
| PlaceClothBasket | 衣物放入篮中 | 100 | 100 | 80 | 10 | 100 | 100 | 90 | 90 | 72.5 | 95.0 |
| PlaceCommodityRack | 商品上架 | 40 | 50 | 30 | 30 | 100 | 100 | 90 | 0 | 37.5 | 72.5 |
| PlaceCupPlate | 杯子放到盘上 | 40 | 20 | 70 | 30 | 50 | 60 | 70 | 0 | 40.0 | 45.0 |
| PlaceFileFolder | 文件放入文件夹^{\mathrm{S}} | 80 | 70 | 100 | 80 | 80 | 80 | 60 | 100 | 82.5 | 80.0 |
| PlaceFoodScale | 食物放上秤 | 40 | 20 | 90 | 0 | 60 | 100 | 100 | 0 | 37.5 | 65.0 |
| PlaceFruitBox | 水果装盒 | 80 | 20 | 90 | 30 | 70 | 30 | 90 | 60 | 55.0 | 62.5 |
| PlaceMagazineFolder | 杂志放入文件夹 | 80 | 100 | 0 | 70 | 100 | 100 | 0 | 70 | 62.5 | 67.5 |
| PlaceMugRack | 杯子挂上杯架^{\mathrm{S}} | 100 | 70 | 80 | 90 | 100 | 100 | 80 | 100 | 85.0 | 95.0 |
| PlacePillBox | 药片放入药盒 | 80 | 70 | 60 | 30 | 100 | 60 | 80 | 70 | 60.0 | 77.5 |
| PlacePlateRack | 盘子放入碗架^{\mathrm{S}} | 90 | 40 | 30 | 80 | 100 | 90 | 50 | 80 | 60.0 | 80.0 |
| PlaceScrewdriver | 放置螺丝刀 | 30 | 20 | 30 | 30 | 100 | 80 | 40 | 100 | 27.5 | 80.0 |
| PlaceShoeBox | 鞋子放入鞋盒 | 90 | 90 | 60 | 100 | 100 | 100 | 90 | 90 | 85.0 | 95.0 |
| PourCup | 倒入杯中 | 10 | 100 | 100 | 90 | 100 | 100 | 100 | 100 | 75.0 | 100.0 |
| PourKetchupFries | 给薯条挤番茄酱 | 50 | 50 | 100 | 30 | 100 | 100 | 80 | 60 | 57.5 | 85.0 |
| PourKettle | 用水壶倒水^{\mathrm{U}} | 90 | 80 | 0 | 80 | 100 | 90 | 0 | 100 | 62.5 | 72.5 |
| PourLiquidCup | 液体倒入杯中 | 10 | 0 | 0 | 10 | 10 | 10 | 0 | 0 | 5.0 | 5.0 |
| PourLiquidFilter | 液体倒入滤器 | 60 | 60 | 20 | 50 | 100 | 100 | 90 | 90 | 47.5 | 95.0 |
| PourLiquidMug | 液体倒入马克杯 | 60 | 10 | 100 | 20 | 0 | 90 | 70 | 0 | 47.5 | 40.0 |
| PressJuicer | 按压榨汁机 | 60 | 80 | 0 | 100 | 20 | 100 | 0 | 100 | 60.0 | 55.0 |
| PressStapler | 按压订书机 | 100 | 70 | 100 | 90 | 50 | 90 | 40 | 40 | 90.0 | 55.0 |
| PutBox | 放入盒中 | 100 | 90 | 90 | 10 | 100 | 90 | 100 | 100 | 72.5 | 97.5 |
| PutCubeOnScale | 方块放上秤 | 100 | 90 | 90 | 60 | 100 | 100 | 100 | 70 | 85.0 | 92.5 |
| ScanMilkBox | 扫描牛奶盒^{\mathrm{U}} | 100 | 100 | 100 | 90 | 100 | 100 | 100 | 100 | 97.5 | 100.0 |
| ScanPillBottle | 扫描药瓶 | 90 | 50 | 90 | 10 | 100 | 100 | 90 | 0 | 60.0 | 72.5 |
| StirSpoon | 用勺搅拌^{\mathrm{S}} | 20 | 0 | 40 | 10 | 50 | 50 | 40 | 80 | 17.5 | 55.0 |
| TransFood | 转移食物 | 50 | 90 | 30 | 30 | 60 | 90 | 0 | 20 | 50.0 | 42.5 |
| WipePot | 擦拭锅具 | 10 | 0 | 0 | 100 | 20 | 0 | 0 | 80 | 27.5 | 25.0 |
原表注:Per-task reference results for simulation success rate. Each cell reports success rate (%) over 10 evaluation episodes for the corresponding task and imitation level.
表 11 解读
读法。每行是一个仿真任务,共 50 行,按代号字母排序。DP 和 ACT 各有 L0–L3 四列,每格是 10 个回合中成功的百分比,所以只可能是 0、10、…、100。最后两列“均值”是该模型在本任务四个层级上的算术平均。我们逐行核对了 50 行,两列均值都等于四个层级的平均,没有发现计算错误。全部 50 个任务、200 个格子的总体平均为 DP 64.05%、ACT 74.85%,ACT 整体更强,在 50 个任务中有 36 个均值高于 DP(2 个持平)。层级规律。对 50 个任务按层级取平均,DP 为 L0 65.6、L1 67.2、L2 60.0、L3 63.4,ACT 为 80.8、82.0、68.4、68.2。两点值得注意。第一,仿真中最明显的下降在 L2 而不在 L3,DP 的 L3 甚至高于 L2。L2 整格为 0 的任务有 DP 7 个、ACT 8 个,L3 整格为 0 的 DP 只有 1 个(PlaceFoodScale)、ACT 有 8 个。这与附录 C 对“仿真 L2 低谷、L3 回升”的解释一致:仿真 L2 同时交换了执行手臂,而仿真 L3 的替代物往往仍可用训练时的策略处理。第二,单个任务在层级之间的波动很大,例如 WipePot 的 DP 为 10/0/0/100,CutFruit 为 100/50/0/100。每格只有 10 个回合,一格的 95% 置信区间宽达约 \pm30 个百分点,所以不宜对单个格子做过多解读。与正文表 3 的抽查对照。表 11 只包含 DP 和 ACT,没有 \pi_{0.5} 和 XSkill,因此无法与正文中 \pi_{0.5} Seen SR =0.73、XSkill Seen SR =0.79 对照。下面取正文 5 个已见任务(StirSpoon、FoldTowel、PlaceMugRack、PlaceFileFolder、PlacePlateRack,表中标 ^{\mathrm{S}}),按正文口径对 5 个任务 \times 4 个层级的 20 个格子取平均。ACT 为 (55.0+95.0+95.0+80.0+80.0)/5=81.0\%,与表 3 中 ACT/DINOv2 的 Seen SR =0.81 完全相同,与 ACT/SigLIP2 的 0.79 也接近。DP 为 (17.5+37.5+85.0+82.5+60.0)/5=56.5\%,低于表 3 中 DP/DINOv2 的 0.67 和 DP/SigLIP2 的 0.61,与 DP/VideoMAE 的 0.14 相差更远。5 个未见任务(标 ^{\mathrm{U}})的平均为 DP 81.0%、ACT 88.0%,远高于表 3 的零样本结果(DP/DINOv2 0.07、ACT/DINOv2 0.02),也高于 P+FT(0.54、0.84)。这些差异主要来自口径不同,不能算作矛盾。表 3 的 Seen 列是在 15/30/45 三种预训练规模上分别训练、评测后再取平均,ZS、P+FT 列针对的是训练中从未出现过的任务。表 11 则是在全部 50 个任务上一次性训练,没有规模平均,“未见”任务也在训练集里,所以它们在这里实际上是已见任务,88% 这样的高分并不说明零样本能力。ACT 的 81.0% 与表 3 的 0.81 恰好相等,可能只是巧合,原文也没有说明两者是否共享模型或回合。DP 相差约 10 个百分点,说明在更大、更杂的 50 任务语料上训练,DP 对这 5 个已见任务的表现反而下降,其中 FoldTowel(37.5)和 StirSpoon(17.5)拉低最多。此外,原文没有说明表 11 中 DP 和 ACT 使用哪种编码器,这也妨碍了严格对照。对论文论点的作用。作者用这张表说明正文选取的 10 个任务具有代表性。从数字看,5 个已见任务的 ACT 均值 81.0% 略高于全部 50 个任务的 74.85%,DP 的 56.5% 则低于 64.05%,所以已见任务既不是特别简单,也不是特别难,大致落在任务池的中段,这支持了“未刻意挑选有利子集”的说法。但这张表本身不能支撑“L3 是瓶颈”:仿真逐任务结果的主要低谷在 L2。L3 瓶颈的证据来自真机 Arena(正文表 5)以及附录 G 中定性的失败分析。
译者附注:原文数字核对与阅读提示汇总
以下各条已在正文对应位置的解释框中说明,这里集中列出。总体而言,主表之间的数字是自洽的:表 3 和表 4 的 \Delta 列等于 P+FT 减 Scr.(仿真个别格有 \pm0.01 的舍入差);P+FT 胜过 Scr. 的仿真变体确为 12/15;表 5 各模型四个层级的平均值与表 4 的 P+FT 一致,平均行正确;表 9 在三个规模上的平均正好等于表 5 最后一行;图 12 按变体数加权后能还原表 3。问题主要集中在三处:措辞比数据更强,人评胜率的统计协议与表格对不上,以及若干规模口径没有交代清楚。| 位置 | 说明 |
| 摘要 | “every model falls below 13% zero-shot success”:表 3 仿真零样本最高为 VQ-BeT/DINOv2 的 0.13,是等于而非低于;表 4 真机人评中 XSkill 为 0.29、ACT/DINOv2 为 0.26。此话只对仿真近似成立。 |
| 摘要 / 第 4.4 节 | “collapses at L3”偏强。表 5 平均 SR 从 0.42/0.42/0.39 降到 0.29,降幅约 30%,其中约 2/3 来自 XSkill(0.56 \to 0.29);去掉 XSkill 后三模型 L2 \to L3 只降 0.04,ACT/DINOv2 的 L2 与 L3 同为 0.33。真机每个任务—层级只做 5 次试验,SR 在 0.4 附近时标准误约 0.057。 |
| 附录 C.5 / 表 11 | 仿真中最难的是 L2(多个任务整格为 0),L3 反而回升;作者归因于仿真 L2 同时换了执行手臂,以及有限资产和规则运动使 L3 替代物仍可用旧策略完成。附录 G 称表 11 “给出同样诊断”,但 50 任务的层级均值低谷在 L2 而非 L3。真机零样本时 L3 反而是最高层级,原文未提。 |
| 命名与规模 | 名为 IG-10K,实为真机 11.7K 配对 + 仿真 10K 配对。基础任务 53 个,其中 6 个省略 L3(H29、H33、H36、H38、H39、H43,分布在物流、医院、实验室,正文只举了实验室的例子),任务—层级组合 206 个。真机每组合约 56.9 回合,仿真约 48.5,“每组合 50+”并不普遍成立。表 2 写“50 tasks with 4 levels”。“迄今最大”只在环境对齐的数据集中成立(RH20T 有 110k 片段但不对齐)。 |
| 附录 B.2 / 第 4.1 节 | “每任务 50 条示范”与“每任务—层级 50 条”两种口径并存;仿真约 10K 回合 \approx 50 任务 \times 4 级 \times 50,支持后者。少样本的“10 条示范”同样存在口径问题。 |
| 表 4 / 附录 B.3:胜率 | 按 B.3 定义(平局各记 0.5,同桶内配对),同一桶内按出场次数加权的平均 WR 恒为 0.5。Seen 列四模型之和为 2.00,与定义一致;P+FT 列之和 2.96 >2,与“Scr. 和 P+FT 同在 transfer 桶”一致,但两列合计 4.46 \ne4.00,需要 Scr. 的出场次数约为 P+FT 的 1.9 倍,与随机抽取的协议相反。WR 不宜跨列比较。 |
| 表 4 / 附录 B.3:零样本 | B.3 写明真机 5,000 个 A/B 界面只分 seen 和 transfer 两桶,没有 zero-shot 桶,表 4 却给出真机 ZS 的 SR、\overline Q、WR,且 WR 之和为 1.21。按原文协议这一栏无从产生。 |
| 附录 B.3:评判次数 | “每个 rollout 评 3–5 次”与总量矛盾:仿真 15,000 个界面只有 30,000 个出场位,少于 36,000 个 rollout;真机平均约 2 次。36,000 =15\times3\times4\times200 意味着与规模无关的 Scr. 也按三个规模各跑了一次。 |
| 第 4.2 节 | “XSkill 在真机所有设定最强”按 SR 成立,按 \overline Q 不成立(Scr. 中 \pi_{0.5} 5.52 > 5.40,ZS 中 ACT 5.44 > 5.24)。“视频模型零样本始终胜过语言模型”只在真机成立,仿真 ZS 中 \pi_{0.5} 0.09 高于 DP/DINOv2 和全部 ACT 变体。“DINOv2/SigLIP2 始终强于 VideoMAE”有例外(ACT 的 ZS 和 P+FT)。 |
| 第 4.3 节 / 图 10 | “15 个仿真变体中 14 个提升”成立(唯一负值为 UniSkill -0.09),但若干变体只涨 0.02–0.04,在噪声内。“每一层、两个域都上升”只在比较 15 与 45 两个端点时成立,中间不单调。C.3 的 \DeltaSR 指“45 任务减 15 任务”,与表 3、表 4 的 \Delta 含义不同;C.3 有一句缺先行词,从图看指 UniSkill。 |
| 表 10 / 附录 C.6 | 标题称用 45 任务检查点,但“original”行与表 3 的三规模平均 Seen SR 完全相同;单检查点每格 50 回合时 SR 应为 0.02 的倍数,表中却有 0.87、0.01、0.23。结果本身有意义:DP 和 \pi_{0.5} 几乎完全依赖示范,ACT 和 XSkill 拿到无关视频仍完成约 30% 和 23%,这部分来自对场景的记忆。原文未讨论结果。 |
| 附录 C.7 | r=0.858 约基于 60 个点,且四种设定混在一起计算,设定间的大差距会抬高相关;标题承诺的“仿真与真机能否互相替代”没有给出定量指标(按共有的四个模型自算:Seen 0.71,ZS -0.29,Scr. 0.16,P+FT 0.23,每组仅 4 点)。评估者间一致性未报告。 |
| 附录 C.1 / C.2 | 离对角线最远的点是 DP/VideoMAE(+0.22),不是原文所说的 GR00T 和 \pi_{0.5}。C.2 称真机“在匹配规模下重现仿真排序”,但仿真是三规模平均、真机只有 45 任务,P+FT 和 ZS 的排序也不一致。图 9(b) DP/SigLIP2 标 0.49,表 3 为 0.48。 |
| 第 3.2.2 节 / 附录 B.4 | 正文称描述器 T(V) “固定、确定性”,附录说实为人工标注加 Qwen3-VL 增强并逐条核对。描述直接写出意图,可能有利于 VLA 在 L3 上的表现。 |
| 第 3.2.3 节 / 附录 B.4 | “冻结骨干”并不对称:VLA 的动作专家是预训练过的,Video-VA 动作头和技能模型在 IG-10K 上从零训练;Video-VA 只拿到 4 帧编码成的任务向量;缓存激活后无法做在线增强。VLA 训 10 轮、Video-VA 训 100 轮;\pi_{0.5} 批大小 16、RDT 的 LoRA 秩 576 未加解释。结论只适用于“冻结表征 + 动作头”这一设置。 |
| 表 11 / 附录 H | 只含 DP 和 ACT,且在全部 50 个任务上一次性训练,正文的未见任务也在训练集中,不能与表 3 的零样本结果比较;所用编码器未说明。 |
| 其他 | 场景分解记号在 A.2 中由 S 变为 C;自动指标 SR 只看终态,L0 的“轨迹匹配”只能靠人评检验;Sub-SR 不要求按顺序完成,且取峰值,抓起后掉落也算完成该阶段;附录 D 的阈值前后说法不一;正文的已见任务“pick up a paper”在附录和图 4 中对应放文件夹任务;图 5 图注称 ZED2i 为 front-facing,正文称 ego-centric;基准名称在摘要、引言、结论中三处不统一。 |