Ego2Robot:基于第一人称人类数据的
可扩展机器人数据合成
Ego2Robot: Scalable Robot Data Synthesis from Egocentric Human Data
Ye Wang^{1,2,*}, Pei Lin^{2,3,4,*}, Xiong-Hui Chen^{2,*}, Haoqi Yuan^{2}, Zhixuan Liang^{2}, Yiyang Huang^{2},
Anzhe Chen^{2}, Zixing Lei^{2}, Jie Zhang^{2}, Tao Zhang^{1}, Haoyang Li^{2}, Tong Zhang^{2},
Chenxi Xiao^{3}, Ziyuan Jiao^{4,5}, Qin Jin^{1,\dagger}
^1中国人民大学 AIM3 实验室 ^2阿里巴巴 Qwen 团队 ^3上海科技大学
^4北京通用人工智能研究院(BIGAI) ^5北京航空航天大学
^*共同第一作者 ^\dagger通讯作者
arXiv:2608.02580v1 [cs.RO],2026 年 8 月 3 日提交(23 页,9 幅图,5 张表)
项目主页:https://www-ye.github.io/ego2robot_blog/
中文逐段翻译与解释
整理日期:2026 年 11 月 7 日
可扩展机器人数据合成
Ego2Robot: Scalable Robot Data Synthesis from Egocentric Human Data
Ye Wang^{1,2,*}, Pei Lin^{2,3,4,*}, Xiong-Hui Chen^{2,*}, Haoqi Yuan^{2}, Zhixuan Liang^{2}, Yiyang Huang^{2},
Anzhe Chen^{2}, Zixing Lei^{2}, Jie Zhang^{2}, Tao Zhang^{1}, Haoyang Li^{2}, Tong Zhang^{2},
Chenxi Xiao^{3}, Ziyuan Jiao^{4,5}, Qin Jin^{1,\dagger}
^1中国人民大学 AIM3 实验室 ^2阿里巴巴 Qwen 团队 ^3上海科技大学
^4北京通用人工智能研究院(BIGAI) ^5北京航空航天大学
^*共同第一作者 ^\dagger通讯作者
arXiv:2608.02580v1 [cs.RO],2026 年 8 月 3 日提交(23 页,9 幅图,5 张表)
项目主页:https://www-ye.github.io/ego2robot_blog/
中文逐段翻译与解释
整理日期:2026 年 11 月 7 日
解释
阅读方式。沿用本工作区已完成译文的三联框:灰色框保留英文原文,蓝色框给出中文译文,橙色框解释概念、公式、设计动机、数字验算和结论边界。图片使用原论文源码中的矢量图和原始位图,表格完整重排,均附原注、译注和绿色解读框。保留原章节、公式和图表编号(附录图表与正文连续编号)。原文使用数字引用(如 [1, 2]);由于参考文献列表从略,原文框和译文框中的引用改写为“作者,年份”格式,由
来源与许可。原论文:https://arxiv.org/abs/2608.02580v1;PDF:https://arxiv.org/pdf/2608.02580v1。本文以 arXiv 默认的非独占分发许可(arXiv.org perpetual, non-exclusive license)发布,不是知识共享许可;本译稿仅供个人学习研究,不宜公开再分发。英文内容以下载的 v1 源码及 PDF 为依据。
work/prep.py 根据原文编译生成的 aux 文件自动解析。原文中被 \iffalse 注释掉的旧版文字未收录。解释框是本译稿的分析,不属于作者原文。来源与许可。原论文:https://arxiv.org/abs/2608.02580v1;PDF:https://arxiv.org/pdf/2608.02580v1。本文以 arXiv 默认的非独占分发许可(arXiv.org perpetual, non-exclusive license)发布,不是知识共享许可;本译稿仅供个人学习研究,不宜公开再分发。英文内容以下载的 v1 源码及 PDF 为依据。
目录
导读摘要(Abstract)1 引言(Introduction)2 相关工作(Related Work)机器人数据扩展与从人类数据中学习机器人学习中的数据增广机器人泛化基准3 Ego2Robot 流水线(Ego2Robot Pipeline)1. 动作对齐(Action Alignment)2. 视觉对齐(Visual Alignment)3. 质量筛选(Quality Curation)4 评测框架(Evaluation Framework)5 实验(Experiments)5.1 实验设置(Experimental Setup)5.2 主要结果(Main Results)5.3 消融实验(Ablation Studies)5.4 真机实验(Real Robot Experiments)6 局限性(Limitations)7 结论(Conclusion)A Ego2Robot 流水线细节(Ego2Robot Pipeline Details)A.1 手部姿态估计(路径 B)A.2 子任务切分(路径 B)A.3 动作对齐细节A.4 视觉对齐细节A.5 质量筛选细节A.6 颜色随机化A.7 支持的机器人形态B 评测框架细节(Evaluation Framework Details)B.1 扰动参数B.2 任务列表B.3 评测协议B.4 EBench 桌面任务C 模型结构细节(Model Architecture Details)C.1 结构化提示C.2 相机坐标系相对 EEFC.3 流匹配D 训练细节(Training Details)D.1 预训练D.2 预训练数据D.3 微调D.4 消融配置E 真机实验细节(Real Robot Experiment Details)E.1 平台与任务E.2 数据E.3 第一人称玩耍视频到 Ego2R 的可视化E.4 计分F 补充实验结果(Additional Experimental Results)F.1 与 Pi0.5 的比较F.2 逐任务结果译者附注:原文数字核对与阅读提示汇总导读
本文解决的问题。VLA 模型的泛化受限于机器人数据的规模和多样性,而第一人称人类操作视频又多又便宜,场景和物体丰富,但画面里是人手,动作是五指手的运动,不能直接当作机器人数据用。Phantom 等前作已经证明,把人手轨迹换算成机械臂末端轨迹、并在画面里把人手换成渲染的机械臂,可以训练出单任务策略。本文要回答的是:把这种“重定向 + 渲染”做到上万小时、十几种机械臂,作为 VLA 的预训练数据,能否提升分布外泛化,具体提升哪一类泛化。方法的完整链条。(1) 输入:带手部标注的第一人称数据集(路径 A,约 1,940 小时),或无标注视频(路径 B,用 WiLoR + DynHaMR 估计手部姿态,用 Qwen3.5 切分子任务)。(2) 动作对齐:从拇指、食指、中指和手腕的关键点构造一个虚拟二指夹爪的位置、朝向和开口宽度,再做平滑和速度对齐。(3) 视觉对齐:SAM 3 分割人手臂,ProPainter 修补背景,网格搜索一个让整条轨迹都可达的机器人基座位姿,MuJoCo 逐帧解 IK 并渲染机械臂,按深度合成回画面。对 15 种机械臂各做一遍,并随机染色。(4) 三级筛选:几何/物理检查、统计离群检查、VLM 语义一致性检查。(5) 动作统一表示为相机坐标系下的相对末端位移(7 维),使人类数据、合成数据和各种机器人数据能共用一个动作空间。(6) 用 Qwen3.5-4B + 流匹配 DiT 的 VLA,按不同比例混合合成数据与 6,565 小时机器人数据预训练,再在 RoboTwin、EBench 和真机上微调评测。| 概念 | 本文中的具体含义 |
| 第一人称(egocentric)视频 | 头戴相机拍摄的人手操作视频,视角接近人眼,通常没有腕部视角。 |
| 重定向(retargeting) | 把人手关键点换算成机械臂末端(夹爪)的位置、朝向和开口宽度。 |
| 虚拟指尖 / TCP | 虚拟指尖 = 0.7 食指尖 + 0.3 中指尖;TCP 是拇指尖与虚拟指尖的中点,即夹爪“抓取点”。 |
| 视觉对齐 | 抹掉画面中的人手臂,渲染并合成一只机械臂,使视频看起来像机器人在操作。 |
| 基座位姿搜索 | 为每段轨迹、每种机械臂网格搜索一个基座位置和朝向,使关键帧上的 IK 可行率最高,并让工作距离接近 65% 臂展。 |
| 深度感知合成 | 臂身直接覆盖,夹爪逐像素比较渲染深度与估计的场景深度,处理遮挡。 |
| L1 / L2 / L3 筛选 | 流水线内部的几何物理检查 / 数据集统计离群检查 / VLM 判断合成视频与任务描述是否相符。 |
| Ego2R | Ego2Robot 合成数据的简称;配比 1:3、1:1、3:1 指 Ego2R 与机器人数据的采样比例。 |
| 相机坐标系相对 EEF 动作 | 每步动作是末端在相机坐标系中的位移、旋转向量和夹爪开合,共 7 维。 |
| Clean / Randomized | RoboTwin 2.0 的无扰动设置 / 背景、光照、桌高、杂物同时随机的捆绑扰动设置。 |
| 解耦扰动 | 每次只施加一种扰动(11 种),按视觉、场景、本体、任务四个维度汇总。 |
| 零样本跨本体 | 只在 Aloha-Agilex 上微调,直接换成 ARX、UR5、Franka 测试。 |
| Ego Play | 真机实验中在部署场景随手录制的人手玩耍视频,经路径 B 转换后用于微调。 |
摘要(Abstract)
原文
Learning generalizable robot manipulation policies requires large-scale and diverse demonstration data. Egocentric human manipulation videos offer rich scene and task diversity, and prior work has shown that retargeting and rendering such videos into robot-format data can yield effective per-task policies at small scale. However, whether this approach can provide pretraining benefits for vision-language-action models at scale remains unexplored.
译文
学习可泛化的机器人操作策略需要大规模、多样化的示范数据。第一人称(egocentric)的人类操作视频在场景和任务上都非常丰富;已有工作表明,把这类视频重定向(retarget)并渲染成机器人格式的数据,可以在小规模上训练出有效的单任务策略。然而,这种做法能否在大规模下为视觉—语言—动作(vision-language-action,VLA)模型带来预训练收益,目前尚无研究。
解释
摘要第一部分交代问题。机器人数据贵、少、场景单一,人类第一视角视频便宜、多、场景丰富,但视频里是人手,不是机器人。“重定向并渲染”指两步操作:把人手的运动换算成机器人末端执行器(夹爪)的运动,再在画面里抹掉人手、画上一只机器人手臂,让视频看起来像机器人在操作。Phantom、EgoMimic 等前作做过这件事,但只在几个任务、几十小时量级上训练单任务策略。本文要回答的是另一个问题:把这种合成数据做到上万小时,用来预训练通用 VLA,是否仍然有用,对哪类泛化有用。
原文
We present Ego2Robot, a scalable pipeline that converts egocentric human manipulation videos into robot training data through action retargeting, robot-arm visual synthesis, and multi-level quality curation. Ego2Robot supports both curated datasets and in-the-wild videos, producing 18,561 hours of robot training data spanning 15 robot morphologies, making it the largest ego-to-robot dataset to date. To evaluate generalization, we extend RoboTwin2.0 with disentangled perturbation axes covering visual appearance, scene layout, embodiment morphology, and task semantics. Experiments show that joint pretraining on Ego2Robot-synthesized and robot data consistently improves out-of-distribution generalization across multiple perturbation types, with benefits validated on real-robot deployment. Project page: https://www-ye.github.io/ego2robot_blog/
译文
我们提出 Ego2Robot,一条可扩展的流水线,通过动作重定向、机械臂视觉合成和多级质量筛选,把第一人称人类操作视频转换为机器人训练数据。Ego2Robot 既支持经过整理的数据集,也支持野外(in-the-wild)视频,共生成了覆盖 15 种机器人形态、总计 18,561 小时的机器人训练数据,是迄今规模最大的“第一人称到机器人”(ego-to-robot)数据集。为评估泛化能力,我们扩展了 RoboTwin2.0,加入相互解耦的扰动维度,涵盖视觉外观、场景布局、本体形态和任务语义。实验表明,用 Ego2Robot 合成数据与机器人数据联合预训练,能在多种扰动类型下稳定提升分布外(out-of-distribution,OOD)泛化,其收益也在真实机器人部署中得到验证。项目主页:https://www-ye.github.io/ego2robot_blog/
解释
本文有三个产出:一条数据合成流水线、一个 18,561 小时的数据集、一套“解耦”的评测协议。18,561 小时怎么来的需要先弄清:原始人类视频约 1,940 小时,每段视频为 15 种机械臂各渲染一遍,再经过筛选,得到 18,561 小时,约为原始量的 9.6 倍。附录 D 的消融配置显示每种形态约 1,237 小时,15 种恰好是 15\times1237.4\approx18{,}561。也就是说,这 18,561 小时里不同的人类操作内容只有约 1,237 小时,其余是同一段操作换成不同机械臂外观和运动学的版本。“最大”是按合成后的时长计算的。“解耦扰动”指每次只改变一个因素(例如只换背景,或只换机器人),这样才能判断合成数据究竟帮了哪种泛化。原版 RoboTwin 2.0 的 “Randomized” 设置把多种扰动同时打开,只给一个总分。
原文
Keywords: Robot Data Synthesis, Egocentric Data, Generalization Evaluation
译文
关键词:机器人数据合成,第一人称数据,泛化评测
1引言(Introduction)
原文
Recent vision-language-action (VLA) models (Zitkovich et al., 2023; Kim et al., 2024; Black et al., 2024; Physical Intelligence et al., 2025; Bjorck et al., 2025) have demonstrated impressive progress in robot manipulation through large-scale robot demonstration pretraining. However, the generalization ability of these systems remains fundamentally constrained by the scale and diversity of available robot data. Despite major efforts such as Open X-Embodiment (O'Neill et al., 2024), DROID (Khazatsky et al., 2024), and AgibotWorld (Bu et al., 2025), collecting robot demonstrations remains expensive, labor-intensive, and limited by hardware availability, teleoperation cost, and restricted interaction diversity (Chi et al., 2024; Zhao et al., 2023; Wu et al., 2024).
译文
近期的视觉—语言—动作(VLA)模型(Zitkovich et al., 2023; Kim et al., 2024; Black et al., 2024; Physical Intelligence et al., 2025; Bjorck et al., 2025)通过大规模机器人示范预训练,在机器人操作上取得了令人瞩目的进展。然而,这些系统的泛化能力从根本上受限于可用机器人数据的规模和多样性。尽管已有 Open X-Embodiment(O'Neill et al., 2024)、DROID(Khazatsky et al., 2024)和 AgibotWorld(Bu et al., 2025)等大型数据工作,采集机器人示范依然昂贵、费人力,并受制于硬件可得性、遥操作成本和有限的交互多样性(Chi et al., 2024; Zhao et al., 2023; Wu et al., 2024)。
解释
第一段是常见的“数据瓶颈”论证。五个 VLA 引用依次是 RT-2、OpenVLA、\pi_0、\pi_{0.5}、GR00T N1。三个数据集中,DROID 和 AgibotWorld 后来也被本文用作“纯机器人数据”的预训练来源(附录 D)。最后一组引用是 UMI(手持夹爪采集)、ACT/ALOHA(低成本双臂遥操作)和 GELLO(低成本遥操作设备),代表“降低采集成本”的路线。作者的意思是,即便降低了单条示范的成本,机器人数据在场景和任务上仍然单调。
原文
Egocentric human videos offer a compelling alternative. Compared with robot teleoperation, human hand interactions can be collected at massive scale across diverse objects, environments, and task variations (Hoque et al., 2025; Punamiya et al., 2026). These videos capture rich manipulation priors that are difficult to obtain with robots alone. However, directly converting egocentric videos into robot training data remains challenging due to the substantial gap between human and robot embodiments. One promising direction is to retarget hand motions to robot kinematics and visually replace human arms with rendered robot embodiments, which has shown strong per-task results at small scale (Lepert et al., 2025; Kareer et al., 2025). Whether large-scale ego2robot-synthesized data can serve as effective pretraining data for robot policies, particularly for improving out-of-distribution generalization, remains largely unexplored.
译文
第一人称人类视频提供了一个很有吸引力的替代来源。与机器人遥操作相比,人手交互可以在各种物体、环境和任务变体上大规模采集(Hoque et al., 2025; Punamiya et al., 2026)。这些视频蕴含了丰富的操作先验,单靠机器人很难获得。然而,由于人与机器人本体之间存在巨大差距,把第一人称视频直接转换为机器人训练数据仍然困难。一个有前景的方向是把手部运动重定向到机器人运动学上,并在画面中用渲染出的机器人本体替换人的手臂;这种做法已在小规模、单任务上取得了很好的效果(Lepert et al., 2025; Kareer et al., 2025)。大规模的 ego2robot 合成数据能否作为机器人策略的有效预训练数据,特别是能否提升分布外泛化,在很大程度上仍未被探索。
解释
这里的两个数据来源 EgoDex(苹果,用 Vision Pro 采集,带 3D 手部姿态标注)和 EgoVerse 后来都被本文作为原始素材。本体差距(embodiment gap)有两层:视觉上,画面里是人手而不是机械臂;动作上,人手有 20 多个自由度,机械臂是 6–7 个关节加一个二指夹爪,可达范围和速度也不同。Phantom(Lepert et al., 2025)是“重定向 + 渲染”路线的直接前身;EgoMimic(Kareer et al., 2025)则把人和机器人的手臂都遮挡掉(masking),用统一的视觉输入联合训练。作者把自己的定位放在“规模”和“分布外泛化”两点上。
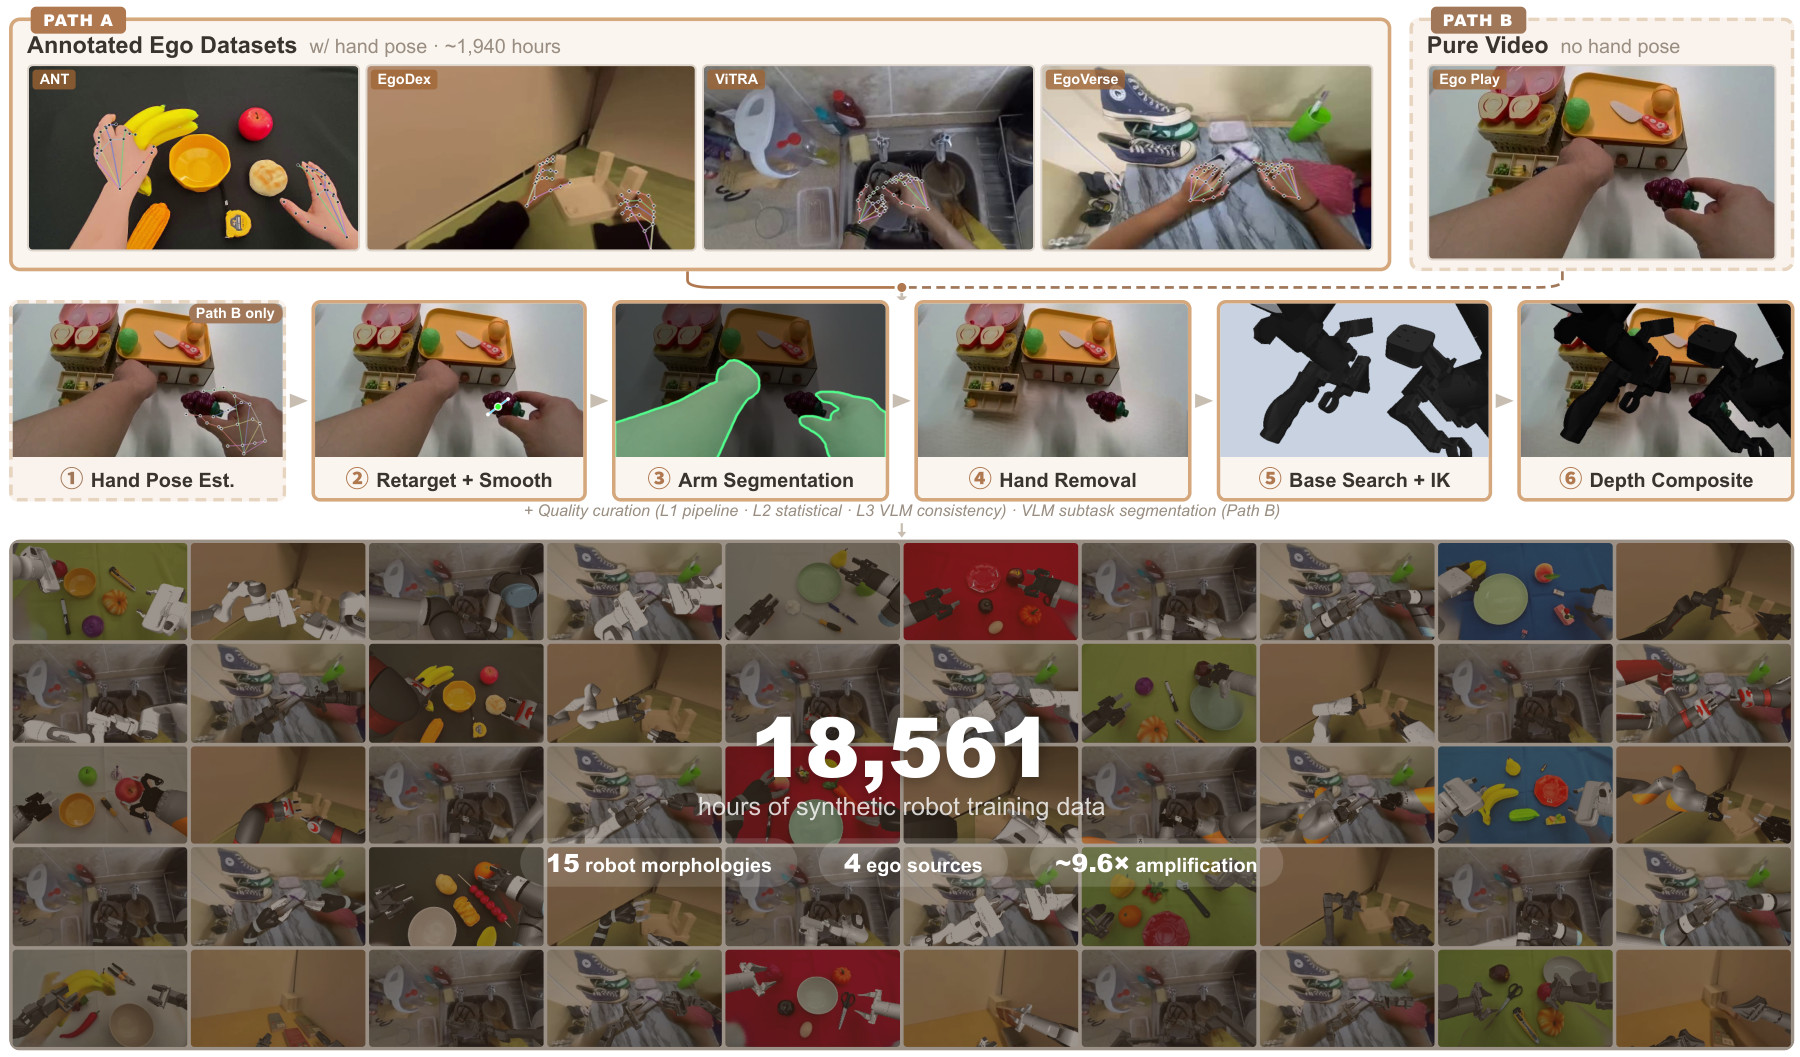
图 1:Ego2Robot 流水线。通过动作对齐、视觉对齐和质量筛选,把第一人称视频转换为覆盖 15 种形态、共 18,561 小时的机器人训练数据。
原图注:Ego2Robot pipeline. Converting egocentric video into 18,561h robot training data across 15 morphologies through action alignment, visual alignment, and quality curation.
图 1 解读
第一行是两条输入路径。左边的 Path A 是带手部姿态标注的第一人称数据集,共约 1,940 小时,包括 ANT(作者自采的桌面抓放数据,手上画有关键点)、EgoDex、ViTRA 和 EgoVerse 四个来源。右边虚线框里的 Path B 是没有手部姿态的纯视频,例子是 “Ego Play”,即真机实验中随手录制的玩耍视频。第二行是六个处理步骤,以同一个场景(桌上有水果、刀和托盘)为例:(1) 手部姿态估计(虚线框,表示只有 Path B 需要);(2) 重定向并平滑,手上出现一个小的夹爪坐标系;(3) 手臂分割,绿色高亮的是人的手臂掩码;(4) 抹除人手,画面只剩背景和物体;(5) 搜索机器人基座位姿并解逆运动学,灰底上是渲染出的两只黑色机械臂;(6) 深度感知合成,把机械臂叠回修补后的场景。两行之间的小字注明还有质量筛选(L1 流水线内部、L2 统计、L3 VLM 一致性)和 Path B 的 VLM 子任务切分。第三行是结果样例的拼贴墙,同一批场景配上了不同颜色、不同型号的机械臂。中间的大字给出三个数字:18,561 小时合成数据、15 种机器人形态、4 个第一人称来源,以及“约 9.6 倍放大”。验算:18{,}561/1{,}940\approx9.57。如果不做任何筛选,15 种形态应当放大 15 倍;9.6 倍说明平均每种形态保留了约 64% 的时长,与附录 D 中“单形态约 1,237 小时”一致(1237/1940\approx0.64)。
原文
In this work, we investigate ego-to-robot synthesis as a scalable paradigm for robot policy pretraining. Our key hypothesis is that, despite embodiment differences, egocentric manipulation videos contain transferable interaction regularities that can complement robot data if properly aligned. Based on this observation, we propose Ego2Robot, an end-to-end pipeline that converts egocentric human manipulation data into embodiment-specific robot training data through action alignment, visual alignment, and multi-level quality curation (Figure 1). The pipeline supports both annotated ego datasets and pure ego videos, and processes approximately 1,940 hours of egocentric video from four diverse sources across 15 robot morphologies, producing 18,561 hours of effective robot training data, to the best of our knowledge the largest ego-to-robot dataset to date.
译文
在本工作中,我们把“第一人称到机器人”的合成作为一种可扩展的机器人策略预训练范式加以研究。我们的核心假设是:尽管本体不同,第一人称操作视频中包含可迁移的交互规律,只要对齐得当,就能补充机器人数据。基于这一观察,我们提出 Ego2Robot,一条端到端的流水线,通过动作对齐、视觉对齐和多级质量筛选,把第一人称人类操作数据转换为特定本体的机器人训练数据(图 1)。该流水线既支持带标注的第一人称数据集,也支持纯第一人称视频;它处理了来自四个不同来源、约 1,940 小时的第一人称视频,覆盖 15 种机器人形态,生成了 18,561 小时的有效机器人训练数据。据我们所知,这是迄今规模最大的 ego-to-robot 数据集。
解释
“可迁移的交互规律”(transferable interaction regularities)是全文的核心假设:例如“先接近、再闭合、再抬起”的抓取节奏,物体放进容器的大致轨迹,双手配合的时序。这些规律不依赖于操作者是人还是机器人。“对齐”分两种:动作对齐让人手轨迹变成机械臂能执行的末端位姿序列;视觉对齐让画面里出现机械臂而不是人手,从而缩小训练图像与机器人部署时图像的差距。注意“1,940 小时视频”和“18,561 小时数据”不是同一口径,后者是按形态复制后的时长,见摘要处的解释。
原文
To evaluate whether ego2robot-synthesized data improves robot generalization, we further introduce a disentangled evaluation protocol built on RoboTwin2.0 (Chen et al., 2025). Unlike prior evaluations that aggregate multiple distribution shifts into a single score, our protocol decouples perturbations across four axes: visual appearance, scene layout, embodiment morphology, and task semantics. This enables fine-grained analysis of where pretraining with a combination of robot and ego2robot-synthesized data provides benefits and whether the gains arise from visual robustness, embodiment transfer, or semantic generalization.
译文
为评估 ego2robot 合成数据能否提升机器人的泛化能力,我们进一步在 RoboTwin2.0(Chen et al., 2025)之上提出一套解耦的评测协议。以往的评测把多种分布偏移合并为一个分数,而我们的协议沿四个维度分别施加扰动:视觉外观、场景布局、本体形态和任务语义。这样就能细致地分析,机器人数据与 ego2robot 合成数据联合预训练究竟在哪些方面带来收益,收益来自视觉鲁棒性、本体迁移,还是语义泛化。
解释
RoboTwin 2.0 是一个双臂仿真基准(默认机器人为 Aloha-Agilex),有 50 个任务,原本提供 “Clean”(无扰动)和 “Randomized”(背景、光照、桌高、杂物同时随机)两种设置。作者的做法是把 Randomized 拆开,每次只打开一个扰动,再新增摄像机偏移、机器人颜色、换机器人、换物体、换说法等维度,详见第 4 节和图 2。这样做的价值在于归因:如果合成数据只提升了“换背景”而没有提升“换机器人”,就说明它主要起视觉增广作用。
原文
Extensive experiments show that ego2robot-synthesized data consistently improves out-of-distribution performance and provides complementary value to robot data. In particular, the gains are most pronounced under visual, embodiment, and semantic perturbations, suggesting that large-scale ego2robot-synthesized data primarily improves invariance and cross-distribution robustness rather than merely increasing trajectory coverage.
译文
大量实验表明,ego2robot 合成数据能稳定提升分布外性能,并为机器人数据提供互补价值。尤其是在视觉、本体和语义扰动下收益最为明显,这说明大规模 ego2robot 合成数据主要提升的是不变性和跨分布鲁棒性,而不只是增加轨迹覆盖。
解释
这一段先给出结论。读第 5 节时可以对照检查:视觉维度上,1:1 配比在背景、光照、颜色三项上分别提升 3.7、7.6、6.4 个百分点;本体维度上 ARX 提升 7.1、UR5 最多提升 11.2,但 Franka 反而下降;语义维度上未见物体提升约 10–11 个点。“稳定提升”需要打折扣:1:3 配比在多数列上基本持平甚至略降,见表 1、表 2。“而不只是增加轨迹覆盖”是一种解释,文中没有直接实验去区分“不变性”和“覆盖”这两种机制。
原文
Our contributions are as follows: (1) We propose Ego2Robot, a complete ego-to-robot synthesis pipeline with action alignment, visual alignment, and multi-level quality curation, supporting 15 robot morphologies. (2) We construct the largest ego-to-robot dataset to date, containing 18,561 hours of synthesized robot training data generated from diverse egocentric video sources. (3) We introduce a disentangled generalization benchmark that separates visual, scene, embodiment, and semantic perturbations for fine-grained evaluation of robot policy robustness. (4) We demonstrate that combining ego2robot-synthesized data with pure robot data improves generalization performance, particularly under out-of-distribution shifts.
译文
我们的贡献如下:(1) 提出 Ego2Robot,一条完整的 ego-to-robot 合成流水线,包含动作对齐、视觉对齐和多级质量筛选,支持 15 种机器人形态。(2) 构建了迄今最大的 ego-to-robot 数据集,包含由多种第一人称视频来源生成的 18,561 小时合成机器人训练数据。(3) 提出一个解耦的泛化基准,把视觉、场景、本体和语义扰动分开,用于细粒度地评估机器人策略的鲁棒性。(4) 证明把 ego2robot 合成数据与纯机器人数据结合,能提升泛化性能,尤其是在分布外偏移下。
解释
四项贡献分别是工具、数据、评测和结论。前三项是工程性的;第四项是科学结论,它的证据强度取决于第 5 节的实验设计。值得提前注意两点。其一,所有预训练都只跑 200K 步、约 1,920 万帧,远小于数据集总帧数(见第 5.1 节的解释),所以实验检验的是“混入合成数据”的效果,而不是“用满 18,561 小时”的效果。其二,各配置只报告单次运行的结果,没有误差条。
2相关工作(Related Work)
机器人数据扩展与从人类数据中学习
原文
Robot Data Scaling and Learning from Human Data. Scaling robot demonstration data is central to generalizable manipulation. Large-scale robot datasets (O'Neill et al., 2024; Khazatsky et al., 2024; Bu et al., 2025) and portable collection systems (Zhao et al., 2023; Wu et al., 2024; Chi et al., 2024; Shafiullah et al., 2023; Pei et al., 2026) have expanded available demonstrations, but diversity remains constrained by collection cost and hardware scalability. Human manipulation videos provide a broader alternative, motivating work on visual pretraining (Nair et al., 2022; Radosavovic et al., 2023; Ma et al., 2022), reward learning (Chen et al., 2021), motion priors (Wang et al., 2023), and point tracking (Xu et al., 2024; Ren et al., 2025), though these methods still rely on robot data to bridge embodiment gaps.
译文
机器人数据扩展与从人类数据中学习。扩大机器人示范数据的规模是实现可泛化操作的核心。大规模机器人数据集(O'Neill et al., 2024; Khazatsky et al., 2024; Bu et al., 2025)和便携式采集系统(Zhao et al., 2023; Wu et al., 2024; Chi et al., 2024; Shafiullah et al., 2023; Pei et al., 2026)扩充了可用的示范,但多样性仍受采集成本和硬件可扩展性的制约。人类操作视频提供了更广的替代来源,催生了视觉预训练(Nair et al., 2022; Radosavovic et al., 2023; Ma et al., 2022)、奖励学习(Chen et al., 2021)、运动先验(Wang et al., 2023)和点跟踪(Xu et al., 2024; Ren et al., 2025)等方向的工作,但这些方法仍依赖机器人数据来弥合本体差距。
解释
这一段把“用人类视频”的已有方法归为间接路线。视觉预训练(R3M、MVP、VIP)只用人类视频学一个图像编码器;奖励学习(DVD)从视频里学“任务完成得怎么样”;MimicPlay 学高层的运动规划;点跟踪(Im2Flow2Act 等)从视频里提取物体或点的运动轨迹作为中间表示。它们的共同点是:人类视频只提供某种表示或先验,真正的动作仍要靠机器人数据来学,所以仍然需要相当数量的机器人示范。
原文
More direct approaches leverage human data for robot policy learning. One line of work co-trains on egocentric or human video alongside robot data (Kareer et al., 2025; Zheng et al., 2026; Luo et al., 2025; Luo et al., 2026; Li et al., 2025), while another converts human demonstrations into robot-format data through retargeting and rendering (Lepert et al., 2025; Zhang et al., 2026) or embodiment masking (Kareer et al., 2025). However, the retarget-and-render approach has only been studied at limited scale or for individual tasks. Our work scales it to 18,561 hours across 15 robot morphologies and systematically evaluates its benefit for VLA pretraining and out-of-distribution generalization.
译文
更直接的方法则把人类数据用于机器人策略学习。一类工作把第一人称或人类视频与机器人数据联合训练(Kareer et al., 2025; Zheng et al., 2026; Luo et al., 2025; Luo et al., 2026; Li et al., 2025);另一类则通过重定向和渲染(Lepert et al., 2025; Zhang et al., 2026)或本体遮罩(Kareer et al., 2025),把人类示范转换成机器人格式的数据。然而,“重定向 + 渲染”的方法只在有限规模或单个任务上被研究过。我们的工作把它扩展到 15 种机器人形态、18,561 小时,并系统地评估它对 VLA 预训练和分布外泛化的收益。
解释
直接路线又分两支。第一支是联合训练:EgoScale、Being-H0 系列、ViTRA(Li et al., 2025)等把人手动作当作一种“本体”,直接和机器人数据一起训练,不改动画面。注意 ViTRA 也是本文的原始数据来源之一。第二支是本文所属的“转换”:把人类数据改造成机器人数据的样子再训练,包括渲染(Phantom、EasyMimic)和遮罩(EgoMimic)。两支的区别在于,联合训练让模型自己去弥合人和机器人的差距,转换则在数据层面先把差距缩小。本文的增量主要是规模(18,561 小时、15 种形态)和系统化的泛化评测,方法上与 Phantom 一脉相承。
机器人学习中的数据增广
原文
Data Augmentation for Robot Learning. Data augmentation expands training diversity without additional robot collection. Simulation-based methods (Mandlekar et al., 2023; Nasiriany et al., 2024) generate synthetic demonstrations in digital twins, while cross-embodiment methods including RoviAug (Chen et al., 2024), Mirage (Chen et al., 2024) and OXE-AugE (Ji et al., 2025) bridge robot-to-robot visual gaps through inpainting and image editing. Unlike these approaches, our work extends augmentation to the substantially larger ego-to-robot domain gap, leveraging egocentric human videos to synthesize training data for 15 robot morphologies and systematically evaluating generalization across multiple perturbation axes.
译文
机器人学习中的数据增广。数据增广无需额外采集机器人数据即可扩大训练多样性。基于仿真的方法(Mandlekar et al., 2023; Nasiriany et al., 2024)在数字孪生中生成合成示范;跨本体方法,包括 RoviAug(Chen et al., 2024)、Mirage(Chen et al., 2024)和 OXE-AugE(Ji et al., 2025),则通过图像修补和图像编辑来弥合机器人与机器人之间的视觉差距。与这些方法不同,我们的工作把增广推广到差距大得多的第一人称到机器人领域,利用第一人称人类视频为 15 种机器人形态合成训练数据,并沿多个扰动维度系统地评估泛化。
解释
MimicGen 从少量人类示范出发,在仿真里把物体位置随机化并自动生成新轨迹;RoboCasa 是厨房场景的大规模仿真。RoviAug 和 Mirage 处理的是“从 A 机器人到 B 机器人”的迁移:把源图像里的 A 机械臂抠掉、补背景、再画上 B 机械臂。OXE-AugE 把这种做法批量用到 Open X-Embodiment 上。本文流水线的视觉部分(分割、修补、渲染合成)与 RoviAug 和 Mirage 几乎同构,区别在于源端是人手,不存在“源机器人基座位置”,因此需要第 3 节的基座位姿搜索。
机器人泛化基准
原文
Benchmarks for Robot Generalization. Existing manipulation benchmarks such as RoboTwin (Mu et al., 2025; Chen et al., 2025), LIBERO (Liu et al., 2023), CALVIN (Mees et al., 2022), RLBench (James et al., 2020), and SIMPLER (Li et al., 2024) evaluate policy generalization under bundled perturbations, making it difficult to attribute failures to specific factors. ManiSkill2/3 (Gu et al., 2023; Tao et al., 2024) and RoboCasa (Nasiriany et al., 2024) support multiple robot configurations but lack standardized cross-embodiment evaluation.
译文
机器人泛化基准。现有的操作基准,如 RoboTwin(Mu et al., 2025; Chen et al., 2025)、LIBERO(Liu et al., 2023)、CALVIN(Mees et al., 2022)、RLBench(James et al., 2020)和 SIMPLER(Li et al., 2024),都在捆绑的扰动下评估策略的泛化,难以把失败归因到具体因素上。ManiSkill2/3(Gu et al., 2023; Tao et al., 2024)和 RoboCasa(Nasiriany et al., 2024)支持多种机器人配置,但缺少标准化的跨本体评测。
解释
“捆绑扰动”(bundled perturbations)指一次评测里同时改变多个因素,最后只看一个总成功率。例如 RoboTwin 2.0 的 Randomized 设置同时改背景、光照、桌高并加入杂物,分数下降时无法判断是哪个因素造成的。ManiSkill 和 RoboCasa 虽然能换机器人,但没有规定“在 A 上训练、在 B 上测试”的标准协议。
原文
Recent decomposed benchmarks, including Colosseum (Pumacay et al., 2024), LIBERO-Plus (Fei et al., 2025), and LIBERO-PRO (Zhou et al., 2025), separate perturbation axes and show that VLA models degrade substantially under individual shifts, but remain limited to single-arm settings. RoboTwin 2.0 (Chen et al., 2025) and EBench (Shanghai AI Laboratory, 2026) evaluate dual-arm manipulation yet still primarily report bundled results. We extend RoboTwin2.0 with independent perturbation axes spanning visual appearance, scene layout, embodiment, and task semantics, while jointly supporting dual-arm and cross-embodiment evaluation.
译文
近期的分解式基准,包括 Colosseum(Pumacay et al., 2024)、LIBERO-Plus(Fei et al., 2025)和 LIBERO-PRO(Zhou et al., 2025),把各扰动维度分开,并表明 VLA 模型在单项偏移下就会大幅退化,但它们仅限于单臂场景。RoboTwin 2.0(Chen et al., 2025)和 EBench(Shanghai AI Laboratory, 2026)评测双臂操作,但主要仍报告捆绑结果。我们在 RoboTwin2.0 上扩展出相互独立的扰动维度,涵盖视觉外观、场景布局、本体和任务语义,同时支持双臂和跨本体评测。
解释
Colosseum 在 RLBench 上设置了 14 种可独立控制的扰动;LIBERO-Plus 和 LIBERO-PRO 分别把 LIBERO 分解为 7 个和 4 个维度(工作区的 StarVLA、ODE Policy 译稿中都用到了 LIBERO-plus)。作者声称的空位是“双臂 + 分解 + 跨本体”三者同时具备。EBench 是上海人工智能实验室的一个移动操作基准,本文只用了其中 7 个桌面任务,看中的是它的摄像机位置更高、更接近第一人称视角。
3Ego2Robot 流水线(Ego2Robot Pipeline)
原文
Given egocentric videos depicting human hand manipulation, our pipeline produces embodiment-specific robot training data through three stages: action alignment, visual alignment, and quality curation (Figure 1). Action alignment converts hand poses into robot end-effector trajectories via retargeting and temporal smoothing. Visual alignment replaces human arms with rendered robot arms through arm segmentation, hand removal, robot base pose search with IK solving, and depth-aware rendering. Quality curation then filters samples at the trajectory, frame, and episode levels.
译文
给定描绘人手操作的第一人称视频,我们的流水线通过三个阶段生成特定本体的机器人训练数据:动作对齐、视觉对齐和质量筛选(图 1)。动作对齐通过重定向和时间平滑,把手部姿态转换为机器人末端执行器轨迹。视觉对齐依次进行手臂分割、人手抹除、机器人基座位姿搜索与逆运动学(IK)求解、深度感知渲染,用渲染出的机械臂替换人的手臂。质量筛选则在轨迹、帧和片段(episode)三个层级上过滤样本。
解释
三个阶段各自解决一个问题。动作对齐回答“机器人该怎么动”:输出每一帧夹爪在相机坐标系中的位置、朝向和开口宽度。视觉对齐回答“画面应该长什么样”:输出一段看起来是机械臂在操作的视频。质量筛选回答“哪些结果能用”:剔除检测失败、运动学不可达、画面穿帮或语义不符的片段。逆运动学(inverse kinematics,IK)指已知末端位姿、反求各关节角。
原文
The pipeline supports two input paths: Path A accepts ego datasets with existing hand pose annotations, while Path B processes unannotated videos by first estimating hand poses via WiLoR (Potamias et al., 2025; Si et al., 2026) per-frame reconstruction and DynHaMR (Yu et al., 2025) temporal optimization. For long videos, we adopt Qwen3.5 (Qwen Team, 2026) to segment continuous recordings into discrete subtasks with natural language descriptions. After hand pose estimation, both paths share a unified pipeline that generates training data for any of 15 supported robot morphologies in parallel.
译文
流水线支持两条输入路径:路径 A 接收已有手部姿态标注的第一人称数据集;路径 B 处理无标注视频,先用 WiLoR(Potamias et al., 2025; Si et al., 2026)逐帧重建、再用 DynHaMR(Yu et al., 2025)做时间优化,估计手部姿态。对于长视频,我们用 Qwen3.5(Qwen Team, 2026)把连续录像切分为带自然语言描述的离散子任务。完成手部姿态估计后,两条路径共用一条统一的流水线,可并行地为 15 种受支持的机器人形态中的任意一种生成训练数据。
解释
路径 A 用于 EgoDex 这类用头显采集、自带 3D 手部关键点的数据;路径 B 用于普通相机拍的视频,需要先从像素里估计出手的 3D 姿态。WiLoR 是单帧的手部检测与 MANO 参数回归模型(MANO 是常用的参数化手部网格模型);单帧估计会抖动、左右手会混淆,DynHaMR 在整段序列上联合优化,让手的轨迹在时间上连贯。Qwen3.5 在这里充当“视频标注员”,把一段几分钟的玩耍视频切成“把苹果放进碗里”这样的子任务并写出指令,为 VLA 训练提供语言条件。细节见附录 A.1、A.2。
1. 动作对齐(Action Alignment)
原文
1. Action Alignment. The action alignment stage converts hand poses into parallel-gripper end-effector trajectories through retargeting and temporal smoothing.Hand-to-Gripper Retargeting. For each frame with a detected hand, we extract a compact gripper representation from the 21 hand keypoints. We define a virtual fingertip as a weighted blend of the index and middle finger tips:
\mathbf{p}_\text{vf} = 0.7 \cdot \mathbf{p}_\text{index} + 0.3 \cdot \mathbf{p}_\text{middle}(1)
The tool center point (TCP) and gripper opening width are: \mathbf{p}_\text{tcp} = \frac{\mathbf{p}_\text{thumb} + \mathbf{p}_\text{vf}}{2}, \quad w = \|\mathbf{p}_\text{thumb} - \mathbf{p}_\text{vf}\|(2)
译文
1. 动作对齐。动作对齐阶段通过重定向和时间平滑,把手部姿态转换为平行夹爪的末端执行器轨迹。手到夹爪的重定向。对每个检测到手的帧,我们从 21 个手部关键点中提取一个紧凑的夹爪表示。我们把虚拟指尖定义为食指指尖和中指指尖的加权混合:
\mathbf{p}_\text{vf} = 0.7 \cdot \mathbf{p}_\text{index} + 0.3 \cdot \mathbf{p}_\text{middle}(1)
工具中心点(tool center point,TCP)和夹爪开口宽度为: \mathbf{p}_\text{tcp} = \frac{\mathbf{p}_\text{thumb} + \mathbf{p}_\text{vf}}{2}, \quad w = \|\mathbf{p}_\text{thumb} - \mathbf{p}_\text{vf}\|(2)
解释
把五指手压缩成二指夹爪。二指夹爪只有两片钳口,于是把拇指当作一片钳口,把食指和中指合成另一片。\mathbf p_\text{index}、\mathbf p_\text{middle}、\mathbf p_\text{thumb} 分别是食指、中指、拇指指尖的 3D 坐标(MANO 的 21 个关键点包括手腕 1 个、每根手指 4 个)。权重 0.7/0.3 偏向食指,因为人做精细捏取时主要用拇指和食指,中指起辅助作用;混入一点中指可以减少单个关键点估计误差的影响。TCP 是两片钳口的中点,也就是夹爪“抓住东西的位置”,机器人轨迹跟踪的就是这个点。w 是两钳口的距离,作为夹爪开合指令。例如拇指与虚拟指尖相距 6 cm,就对应夹爪开到 60 mm;附录表 3 列出各机械臂的夹爪行程(如 Panda 为 0–80 mm),文中没有说明超出行程时如何截断。
原文
The grasp orientation is a right-handed orthonormal frame \mathbf{R} = [\mathbf{x}\ \mathbf{y}\ \mathbf{z}]. The grasp axis \mathbf{z} lies along the jaw line (thumb tip to virtual fingertip); together with the wrist-to-fingertip direction \mathbf{d} = \mathbf{p}_\text{vf} - \mathbf{p}_\text{wrist} it spans the jaw plane, whose normal is the gripper-normal axis \mathbf{y}; the approach axis \mathbf{x} completes the frame:
\mathbf{z} = \frac{s\,(\mathbf{p}_\text{thumb} - \mathbf{p}_\text{vf})}{w}, \quad \mathbf{y} = \frac{\mathbf{z} \times \mathbf{d}}{\|\mathbf{z} \times \mathbf{d}\|}, \quad \mathbf{x} = \mathbf{y} \times \mathbf{z}(3)
where s = +1 for the right hand and s = -1 for the left hand, so that \mathbf{z} points consistently regardless of handedness and both hands map to the same gripper frame. The three axes are: \mathbf{x} – approach direction, \mathbf{y} – gripper normal (perpendicular to the jaw plane), \mathbf{z} – grasp axis (along the jaw line). 译文
抓取朝向是一个右手正交坐标系 \mathbf{R} = [\mathbf{x}\ \mathbf{y}\ \mathbf{z}]。抓取轴 \mathbf{z} 沿钳口连线(从拇指指尖到虚拟指尖);它与手腕到指尖的方向 \mathbf{d} = \mathbf{p}_\text{vf} - \mathbf{p}_\text{wrist} 一起张成钳口平面,该平面的法向就是夹爪法向轴 \mathbf{y};接近轴 \mathbf{x} 补全坐标系:
\mathbf{z} = \frac{s\,(\mathbf{p}_\text{thumb} - \mathbf{p}_\text{vf})}{w}, \quad \mathbf{y} = \frac{\mathbf{z} \times \mathbf{d}}{\|\mathbf{z} \times \mathbf{d}\|}, \quad \mathbf{x} = \mathbf{y} \times \mathbf{z}(3)
其中右手取 s = +1,左手取 s = -1,这样无论左右手,\mathbf{z} 的指向都保持一致,两只手映射到同一个夹爪坐标系。三个轴分别是:\mathbf{x}——接近方向,\mathbf{y}——夹爪法向(垂直于钳口平面),\mathbf{z}——抓取轴(沿钳口连线)。 解释
如何从三个点构造一个旋转矩阵。已知三个点(拇指尖、虚拟指尖、手腕),可以得到两个方向:钳口连线 \mathbf z 和“手腕指向指尖”的 \mathbf d。两者一般不垂直,所以用叉乘做格拉姆—施密特式的正交化:\mathbf y=\mathbf z\times\mathbf d 垂直于两者所在的平面(钳口平面),归一化后作为第二个轴;\mathbf x=\mathbf y\times\mathbf z 落在钳口平面内且垂直于 \mathbf z,大致沿 \mathbf d 的方向,也就是手指伸出的方向,即夹爪“伸过去接近物体”的方向。由于 \mathbf y,\mathbf z 是单位正交向量,\mathbf x 自动是单位向量,且 \mathbf x\times\mathbf y=\mathbf z,构成右手系。\mathbf z 除以 w 是为了归一化,因为 w 恰好是 \mathbf p_\text{thumb}-\mathbf p_\text{vf} 的长度。符号 s 的作用。左手和右手是镜像的:右手拇指在一侧,左手拇指在另一侧。如果不翻转,左右手同样的抓取姿势会得到绕接近轴相差 180° 的两个夹爪朝向。二指夹爪本身是对称的,翻转 180° 物理上等价,但对学习来说是两个截然不同的旋转标签,会让同一动作出现两种表示。乘以 s=-1 把左手的 \mathbf z 反向,两只手就得到一致的表示。附录 A.3 还给出了退化情况的处理:当 w<1 cm 或 \mathbf z 与 \mathbf d 几乎平行时,叉乘接近零向量,此时冻结为上一帧的有效朝向。
原文
Temporal Smoothing. Per-frame hand detection introduces high-frequency noise. We apply Savitzky-Golay filtering to positions and widths, and Gaussian-weighted SLERP to orientations, producing smooth trajectories while preserving motion structure.Action Speed Alignment. Egocentric hand manipulation exhibits significantly higher action speeds than robot teleoperation data. To align the speed distributions, we apply per-source frame subsampling during training: ANT and EgoDex are downsampled to 60% of their original frame rate (\sim1.7\times slower), EgoVerse to 45% (\sim2.2\times slower), and ViTRA to 25% (\sim4\times slower).
译文
时间平滑。逐帧的手部检测会引入高频噪声。我们对位置和宽度使用 Savitzky-Golay 滤波,对朝向使用高斯加权的球面线性插值(SLERP),在保留运动结构的同时得到平滑的轨迹。动作速度对齐。第一人称的手部操作速度明显高于机器人遥操作数据。为了对齐速度分布,我们在训练时对各来源做逐来源的帧下采样:ANT 和 EgoDex 降到原帧率的 60%(约慢 1.7 倍),EgoVerse 降到 45%(约慢 2.2 倍),ViTRA 降到 25%(约慢 4 倍)。
解释
Savitzky-Golay 滤波在一个滑动窗口内用低阶多项式做最小二乘拟合,取中心点的拟合值;它比简单的滑动平均更能保住峰值和拐点,适合位置轨迹。旋转不能直接对四元数各分量做平均(结果不再是单位四元数,还有 q 与 -q 表示同一旋转的问题),所以用 SLERP(球面线性插值)按高斯权重在单位球面上加权平均。参数见附录 A.3(窗口 21 帧、多项式 3 阶、\sigma=10 帧)。速度对齐的口径需要仔细理解。人手完成一次抓放可能只要 1 秒,遥操作的机械臂往往要 3–4 秒。如果直接把人类视频按原帧率当作机器人控制步,模型学到的每步动作幅度会偏大。“降到 60% 帧率,约慢 1.7 倍”中,1/0.6\approx1.67、1/0.45\approx2.2、1/0.25=4,数字自洽。但字面上,“保留 60% 的帧”再按原来的步长使用,每步位移会变大,动作看起来更快;只有把保留下来的帧重新标定为更长的时间间隔(或者理解为对轨迹做时间上的拉伸插值),动作才会“变慢”。原文没有说明具体做法,读者应理解其意图是“让合成数据每个控制步的位移与机器人数据相当”。ViTRA 需要放慢 4 倍,说明这个来源里的人手动作尤其快,或者其原始帧率较低。这一段在下面“3. 质量筛选”中又几乎逐字重复了一遍。
2. 视觉对齐(Visual Alignment)
原文
2. Visual Alignment. Visual alignment transforms ego video from depicting human hands to showing a robot arm operating in the same scene.Arm Segmentation. We employ SAM 3 (Carion et al., 2025) to segment human arm regions in each frame, providing temporally consistent masks across frames.Hand Removal. With the arm masks, ProPainter (Zhou et al., 2023) performs temporally consistent video inpainting to remove the human arms and reconstruct the background.
译文
2. 视觉对齐。视觉对齐把第一人称视频从“人手在操作”变为“机械臂在同一场景中操作”。手臂分割。我们用 SAM 3(Carion et al., 2025)在每一帧中分割出人的手臂区域,得到跨帧时间一致的掩码。人手抹除。有了手臂掩码后,ProPainter(Zhou et al., 2023)进行时间一致的视频修补(inpainting),抹去人的手臂并重建背景。
解释
SAM 3 是 Meta 的“可提示分割”模型的第三代,支持用文本提示(附录里用的是 “person”)在视频中跟踪并分割目标。ProPainter 是视频修补模型,它利用光流把其他帧里露出来的背景“搬”到被遮挡的区域,因此比逐帧图像修补更连贯,不会闪烁。这两步之后得到一段“没有人手”的视频:物体会自己移动,像被隐形的手操纵一样,下一步再把机械臂画进去。修补质量直接决定合成数据的视觉可信度,作者在局限性一节也承认,遮挡严重或光照复杂时可能留下伪影。
原文
Robot Base Pose Search. A fundamental challenge in converting ego videos to robot data is determining the robot base placement. Unlike robot-to-robot transfer where a source base position is available, egocentric hand trajectories are embodiment-free: there is no physical robot base to reference. We must find a base pose \mathbf{T}_\text{base} = (\mathbf{t}, \mathbf{R}) \in SE(3) such that the retargeted trajectory remains kinematically feasible for the target robot morphology.
译文
机器人基座位姿搜索。把第一人称视频转换为机器人数据的一个根本难点,是确定机器人基座放在哪里。在机器人到机器人的迁移中,源机器人的基座位置是已知的;而第一人称的手部轨迹与本体无关,没有可参照的物理机器人基座。我们必须找到一个基座位姿 \mathbf{T}_\text{base} = (\mathbf{t}, \mathbf{R}) \in SE(3),使重定向后的轨迹对目标机器人形态在运动学上可行。
解释
这是本文流水线中最“机器人化”的一步。人的肩膀在相机后上方,手臂可以从任意角度伸进画面;机械臂则固定在某个基座上,可达范围是以基座为中心、半径约为臂展的一个球壳。SE(3) 是三维刚体位姿(平移 \mathbf t 加旋转 \mathbf R)构成的群。基座放得太远,轨迹够不着;太近,机械臂要折叠,容易自碰撞或处于奇异位形;朝向不对,某些末端姿态无解。因此要为每段轨迹、每种机械臂单独找一个“让整条轨迹都可达”的基座位姿。
原文
We formulate this as an optimization over base placements. Given a trajectory of N target end-effector poses \{\mathbf{T}_i^\text{ee}\}_{i=1}^{N} and a robot with maximum reach r_\text{max}, we seek:
\mathbf{T}_\text{base}^* = \arg\max_{\mathbf{T}_\text{base}} \frac{1}{|\mathcal{K}|} \sum_{k \in \mathcal{K}} \mathbb{1}\left[\text{IK}(\mathbf{T}_\text{base}^{-1} \mathbf{T}_k^\text{ee}) \text{ is feasible}\right](4)
where \mathcal{K} \subset \{1, \dots, N\} is a set of representative keyframes selected to cover the spatial extremes of the trajectory (positions with maximum displacement or orientation change), and \text{IK}(\cdot) denotes an inverse kinematics solver in MuJoCo (Todorov et al., 2012; Zakka, 2026). Candidate base placements are generated via grid search around the trajectory centroid, constrained by the per-morphology kinematic reach r_\text{max}. Each candidate is validated by solving IK at all keyframes, and the placement with the highest feasibility rate is selected. This search is performed independently for each of the 15 robot morphologies, as different arm lengths and joint configurations require different base placements for the same trajectory. 译文
我们把它表述为一个关于基座摆放的优化问题。给定由 N 个目标末端执行器位姿组成的轨迹 \{\mathbf{T}_i^\text{ee}\}_{i=1}^{N} 和一个最大臂展为 r_\text{max} 的机器人,我们求解:
\mathbf{T}_\text{base}^* = \arg\max_{\mathbf{T}_\text{base}} \frac{1}{|\mathcal{K}|} \sum_{k \in \mathcal{K}} \mathbb{1}\left[\text{IK}(\mathbf{T}_\text{base}^{-1} \mathbf{T}_k^\text{ee}) \text{ 可行}\right](4)
其中 \mathcal{K} \subset \{1, \dots, N\} 是一组有代表性的关键帧,选取它们是为了覆盖轨迹的空间极值(位移最大或朝向变化最大的位置);\text{IK}(\cdot) 表示 MuJoCo(Todorov et al., 2012; Zakka, 2026)中的逆运动学求解器。候选基座摆放通过在轨迹质心周围做网格搜索生成,并受各形态运动学臂展 r_\text{max} 的约束。每个候选都在所有关键帧上求解 IK 进行验证,选出可行率最高的摆放。这一搜索对 15 种机器人形态分别独立进行,因为不同的臂长和关节构型需要为同一条轨迹选择不同的基座摆放。 解释
公式 (4) 逐项看。\mathbf T_k^\text{ee} 是第 k 个关键帧的目标末端位姿,表示在相机(或世界)坐标系中;左乘 \mathbf T_\text{base}^{-1} 把它变换到机器人基座坐标系,这正是 IK 求解器需要的输入。\mathbb 1[\cdot] 是指示函数,可解为 1、不可解为 0;求和再除以关键帧数 |\mathcal K|,得到“可行率”,取值在 0 到 1 之间。\arg\max 表示在所有候选基座中选可行率最高的。为什么只检查关键帧。对每个候选都在全部 N 帧上解 IK 太慢,于是只挑覆盖轨迹“边界”的帧(离得最远、转得最多的位置)。如果这些极端位置都可达,中间帧大概率也可达。附录 A.4 给出实际规模:每只手臂约有 7\times7\times5 个位置乘以 3\times5\times3 个朝向,共 11,025 个候选,关键帧最多 20 个。附录中的打分函数还额外加了一项“臂展惩罚”,鼓励机械臂工作在约 65% 臂展处,这一点正文公式没有体现。Mink(Zakka, 2026)是基于 MuJoCo 的微分 IK 库。
原文
Inverse Kinematics and Rendering. Given the optimized base placement, IK is solved frame-by-frame in MuJoCo. The robot is rendered from the original camera viewpoint.Depth-Aware Compositing. The robot is rendered from the camera viewpoint and composited into the inpainted scene using depth ordering:
I_\text{final}(u,v) = \begin{cases} I_\text{robot}(u,v) & \text{if } D_\text{robot}(u,v) < D_\text{scene}(u,v) \land M_\text{robot}(u,v) = 1 \\ I_\text{inpaint}(u,v) & \text{otherwise} \end{cases}(5)
where D_\text{scene} is obtained from depth sensors or estimated via monocular depth. This process is applied independently for each of 15 robot morphologies (Panda, UR5e, ARX-L5, xArm7, Sawyer, Kinova Gen3, IIWA, Jaco, FR3, UR10e, ViperX, WidowX, Piper, YAM, Aloha-Agilex), generating parallel training streams from each ego video. 译文
逆运动学与渲染。在优化得到的基座摆放下,在 MuJoCo 中逐帧求解 IK。机器人从原始相机视角进行渲染。深度感知合成。机器人从相机视角渲染后,按深度次序合成到修补后的场景中:
I_\text{final}(u,v) = \begin{cases} I_\text{robot}(u,v) & \text{若 } D_\text{robot}(u,v) < D_\text{scene}(u,v) \land M_\text{robot}(u,v) = 1 \\ I_\text{inpaint}(u,v) & \text{否则} \end{cases}(5)
其中 D_\text{scene} 来自深度传感器,或由单目深度估计得到。这一过程对 15 种机器人形态(Panda、UR5e、ARX-L5、xArm7、Sawyer、Kinova Gen3、IIWA、Jaco、FR3、UR10e、ViperX、WidowX、Piper、YAM、Aloha-Agilex)分别独立进行,从每段第一人称视频生成多路并行的训练数据流。 解释
公式 (5) 是逐像素的“遮挡判断”。(u,v) 是像素坐标;I_\text{robot}、D_\text{robot}、M_\text{robot} 分别是渲染出的机器人彩色图、深度图和掩码(该像素是否属于机器人);I_\text{inpaint} 是修补后的背景图,D_\text{scene} 是场景深度。只有当像素属于机器人、且机器人在该处比场景更靠近相机时,才显示机器人;否则显示背景。这样,当夹爪伸到碗的后面时,碗沿会正确地挡住夹爪,画面才有真实的前后关系。一个细节矛盾。附录 A.4 说明实际实现并不对整只机械臂做深度比较:臂身总是直接覆盖在场景上(理由是臂身位于相机和工作区之间,不会被物体挡住),只有夹爪部分做逐像素的深度比较,而且在原手部掩码区域内跳过比较。正文公式 (5) 是简化版。还要注意,修补后的场景深度 D_\text{scene} 是对原视频(有人手)还是修补后视频估计的,原文没有说明;如果用原视频,人手处的深度会是手的深度,这可能正是附录中“手部掩码内不做比较”的原因。所谓“并行训练流”,是同一段人类视频被复制为 15 份,每份里是不同的机械臂,因此 15 份共享相同的场景、物体和操作意图。
3. 质量筛选(Quality Curation)
原文
3. Quality Curation. We apply three-level quality filtering. L1 (Pipeline-internal): frames with IK failures, self-collisions, action outliers, or insufficient workspace coverage are flagged during processing. L2 (Statistical): trajectories with extreme action values, sudden discontinuities, or excessive invalid frame ratios are removed. L3 (VLM Consistency): a vision-language model (Qwen Team, 2026) audits synthesized videos for semantic consistency between rendered robot actions and original manipulation intents.
译文
3. 质量筛选。我们采用三级质量过滤。L1(流水线内部):在处理过程中标记出 IK 失败、自碰撞、动作离群或工作空间覆盖不足的帧。L2(统计):剔除动作值极端、存在突变或无效帧比例过高的轨迹。L3(VLM 一致性):用一个视觉语言模型(Qwen Team, 2026)审查合成视频,检查渲染出的机器人动作与原始操作意图在语义上是否一致。
解释
三级筛选由粗到细、由规则到语义。L1 是几何和物理检查,在生成时顺手完成:机械臂够不着、和自己撞了、跟踪误差超过 5 cm,就把该帧标为无效。L2 是对整个数据集做统计,找出数值上离谱的帧和片段,例如由手部检测跳变造成的瞬间“瞬移”;无效帧超过 60% 的片段整段丢弃。L3 让 Qwen3.5 看合成后的视频和任务描述,判断“机器人是不是真的在做描述里的事”,例如描述说“把杯子放进篮子”,画面里夹爪却根本没碰杯子,就丢弃。具体阈值和提示词见附录 A.5。原文没有报告每一级各筛掉了多少数据。
原文
We apply the pipeline to four egocentric sources: ANT (7h, our in-house pick-and-place dataset with hand pose annotations), EgoDex (Hoque et al., 2025) (732h), ViTRA (Li et al., 2025) (249h), and EgoVerse (Punamiya et al., 2026) (954h), totaling \sim1,940 hours of annotated ego data. Because egocentric hand manipulation moves considerably faster than robot teleoperation, we subsample frames per source during training to match the robot speed distribution: ANT and EgoDex to 60% of their original frame rate (\sim1.7\times slower), EgoVerse to 45% (\sim2.2\times slower), and ViTRA to 25% (\sim4\times slower).
译文
我们把流水线应用于四个第一人称数据来源:ANT(7 小时,我们自采的带手部姿态标注的抓放数据集)、EgoDex(Hoque et al., 2025)(732 小时)、ViTRA(Li et al., 2025)(249 小时)和 EgoVerse(Punamiya et al., 2026)(954 小时),共计约 1,940 小时带标注的第一人称数据。由于第一人称的手部操作明显快于机器人遥操作,我们在训练时对各来源做帧下采样以匹配机器人的速度分布:ANT 和 EgoDex 降到原帧率的 60%(约慢 1.7 倍),EgoVerse 降到 45%(约慢 2.2 倍),ViTRA 降到 25%(约慢 4 倍)。
解释
验算:7+732+249+954=1{,}942 小时,与“约 1,940 小时”一致。这里的四个来源都走路径 A(已有手部姿态),路径 B 只在真机实验的“玩耍视频”上使用。EgoVerse 和 EgoDex 合计占 87%,后面的预训练采样权重也以这两者为主(各 40%,见图 7)。后半段关于速度对齐的文字与前文“动作速度对齐”一段几乎完全相同,属于原文的重复。
原文
After processing across 15 robot morphologies and quality curation, this yields 18,561 hours of synthetic robot training data. Each sample consists of a robot-composited video frame, the corresponding camera-frame EEF action, camera parameters, and a text instruction. Because egocentric videos are captured with diverse, unknown camera placements, a world-frame action representation would require per-video calibration and produce incompatible action spaces across sources. Camera-frame relative EEF actions express end-effector displacements in the observer's coordinate frame, naturally unifying data from different camera setups and robot morphologies.
译文
经过 15 种机器人形态的处理和质量筛选后,共得到 18,561 小时的合成机器人训练数据。每个样本包括一帧合成了机器人的视频画面、对应的相机坐标系末端执行器(EEF)动作、相机参数和一条文本指令。由于第一人称视频由各种未知的相机摆放拍摄,世界坐标系下的动作表示需要逐视频标定,而且不同来源的动作空间互不兼容。相机坐标系下的相对 EEF 动作在观察者自身的坐标系中表示末端执行器的位移,自然地统一了来自不同相机配置和机器人形态的数据。
解释
动作表示是能把异构数据放在一起训练的关键。机器人数据通常用关节角或“基座坐标系下的末端位姿”作为动作,但第一人称视频里没有真实的基座,头戴相机还在不停移动,“世界坐标系”很难定义。作者选择相机坐标系下的相对末端位移:每一步动作是“夹爪相对上一时刻、在当前相机视角下移动了多少、转了多少”,再加一维夹爪开合,共 7 维(附录 C.2)。这种表示与“画面中看到的运动方向”直接对应:画面里向右移就是动作的 +x,与机器人型号和基座位置无关。代价是模型需要在部署时知道相机外参,才能把相机坐标系的动作转回机器人基座坐标系执行。附录 C 提到相机内外参会通过 mRoPE 注入模型。
4评测框架(Evaluation Framework)
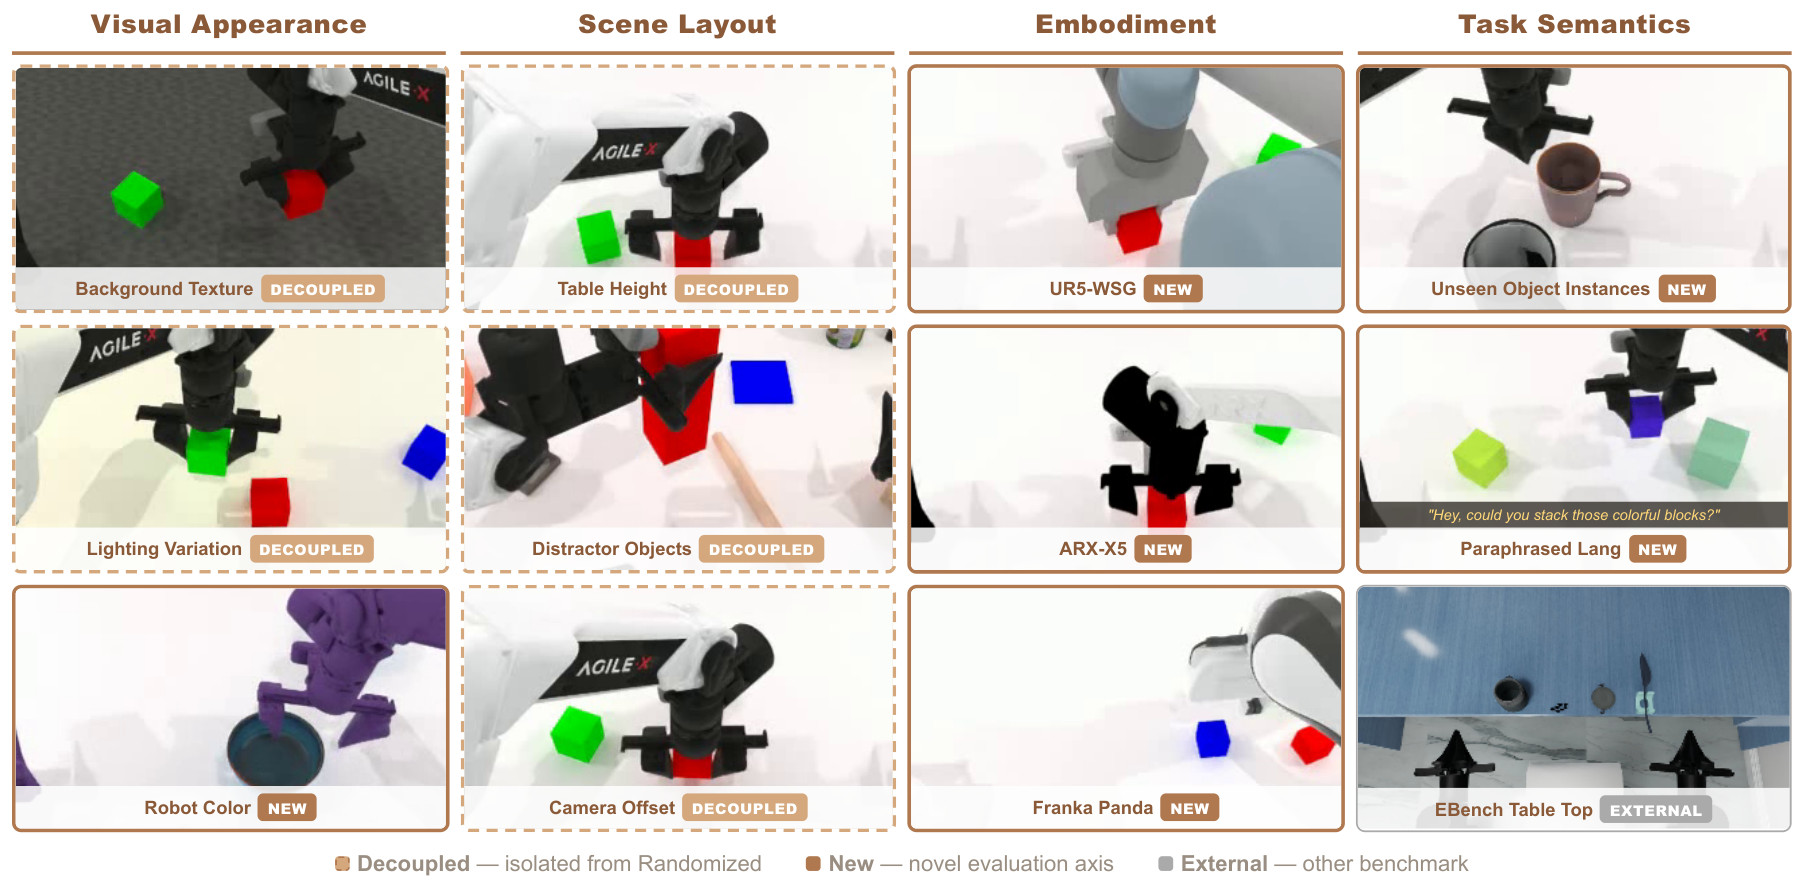
图 2:评测框架。四个泛化维度,共 12 种评测设置。虚线边框:从捆绑随机化中解耦出来、可单独测试的设置。实线边框:新引入的评测维度。灰色边框:外部基准(EBench)。
原图注:Evaluation framework. Four generalization dimensions with 12 evaluation settings. Dashed borders: settings decoupled from bundled randomization for independent testing. Solid borders: newly introduced evaluation axes. Gray border: external benchmark (EBench).
图 2 解读
图分四列,每列是一个泛化维度,每格是一种测试设置的仿真截图(默认机器人是 Aloha-Agilex,臂上印有 “AGILE X”)。视觉外观:背景纹理(深色地面纹理)、光照变化(画面偏黄)、机器人颜色(机械臂被染成紫色)。场景布局:桌面高度、干扰物(桌上多了红色长方体、蓝色方块和木棍)、相机偏移。本体:UR5-WSG、ARX-X5、Franka Panda 三种替换机器人。任务语义:未见过的物体实例(一只没见过的杯子)、换说法的语言指令(截图中的指令是 “Hey, could you stack those colorful blocks?”),以及外部基准 EBench 的桌面任务(相机明显更高,俯视整个桌面)。图例三种标签:浅棕色 Decoupled 表示原本就在 RoboTwin 的 Randomized 中、本文把它单独拆出来的设置(背景、光照、桌高、干扰物);深棕色 New 表示本文新增的维度(机器人颜色、三种换机器人、未见物体、换说法);灰色 External 表示外部基准。注意“相机偏移”在图中标为 Decoupled(虚线框),但附录 B.1 把它列为新引入的维度,两处说法不一致。数一数:视觉 3 + 场景 3 + 本体 3 + 语义 2 = 11 种 RoboTwin 设置,再加 EBench 共 12 种,与图注吻合。
原文
Understanding which generalization dimensions benefit from ego2robot-synthesized data—and which are limited by domain gaps—requires evaluation granularity that existing benchmarks do not provide. Current protocols such as RoboTwin 2.0 (Chen et al., 2025) apply multiple perturbation factors simultaneously, producing a single aggregate OOD metric that conflates visual, spatial, embodiment, and semantic shifts.
译文
要弄清哪些泛化维度能从 ego2robot 合成数据中获益、哪些受限于领域差距,需要现有基准无法提供的评测粒度。RoboTwin 2.0(Chen et al., 2025)等现有协议同时施加多种扰动因素,只给出一个综合的 OOD 指标,把视觉、空间、本体和语义上的偏移混在一起。
解释
动机与引言第四段相同。合成数据有明确的“强项”和“偏置”:它带来大量真实场景的视觉多样性和多种机械臂外观,但视角是头戴相机、没有腕部相机,动作是规则化的近似,没有真实接触。因此可以预期它在某些维度有帮助、在另一些维度没有帮助,只有分开测才能看清。
原文
We extend RoboTwin 2.0 with 11 independent perturbation settings and camera-frame relative EEF support, and complement it with EBench (Shanghai AI Laboratory, 2026), which provides 7 precision tabletop tasks in Isaac Sim with a higher-mounted head camera closer to the egocentric perspective. The extension covers four generalization dimensions as shown in Figure 2:
译文
我们为 RoboTwin 2.0 扩展了 11 种独立的扰动设置,并加入对相机坐标系相对 EEF 动作的支持;同时用 EBench(Shanghai AI Laboratory, 2026)作为补充,它在 Isaac Sim 中提供 7 个精细的桌面任务,头部相机安装得更高,更接近第一人称视角。扩展覆盖四个泛化维度,如图 2 所示:
解释
“加入相机坐标系相对 EEF 支持”是一项必要的工程改动:RoboTwin 原本以关节角或基座坐标系的末端位姿作为动作接口,为了让用相机坐标系动作预训练的模型能在其中微调和评测,需要在仿真里实现坐标变换。EBench 的作用是检验一个假设:如果合成数据的“俯视视角偏置”是一种劣势,那么在相机更高、视角更接近的基准上,合成数据的收益应当更大。
原文
(1) Visual Appearance—independent control of background texture, lighting, and robot color. Background and lighting are decoupled from the original bundled randomization for isolated testing. Robot color applies random hue shifts to all robot links, testing visual invariance to embodiment appearance changes not seen during training. (2) Scene Layout—table height variation (\pm4cm), distractor objects, and camera viewpoint offset (\pm5cm), all decoupled for independent evaluation. These spatial perturbations probe robustness to physical arrangement changes common in real-world deployment.
译文
(1) 视觉外观——独立控制背景纹理、光照和机器人颜色。背景和光照从原有的捆绑随机化中解耦出来,单独测试。机器人颜色对所有机器人连杆施加随机色相偏移,测试对训练中未见过的本体外观变化的视觉不变性。(2) 场景布局——桌面高度变化(\pm4 cm)、干扰物体和相机视点偏移(\pm5 cm),全部解耦以便独立评测。这些空间扰动考察策略对真实部署中常见的物理布置变化的鲁棒性。
解释
机器人颜色这一项与合成数据的构造直接相关:附录 A.6 写明,Ego2Robot 渲染每只机械臂时会在 HSV 空间随机取色(色相 H\sim U(0,1) 覆盖整个色环)。也就是说,预训练数据里已经大量出现过各种颜色的机械臂,而评测正好测“换颜色”。这一项上的提升有相当一部分可以归为“训练时做了同类数据增广”,而不一定是人类视频本身的贡献。桌高 \pm4 cm 和相机偏移 \pm5 cm 都是小幅扰动,主要检验策略是否过度依赖绝对的像素位置。
原文
(3) Embodiment—replacing the default Aloha-Agilex with UR5-WSG, ARX-X5, and Franka Panda for zero-shot cross-embodiment evaluation, with initial end-effector poses aligned via IK to ensure consistent starting conditions. This tests whether the camera-frame action representation generalizes across morphologically distinct robots without embodiment-specific fine-tuning.
译文
(3) 本体——把默认的 Aloha-Agilex 替换为 UR5-WSG、ARX-X5 和 Franka Panda,进行零样本跨本体评测;初始末端执行器位姿通过 IK 对齐,以保证起始条件一致。这检验相机坐标系动作表示能否在形态不同的机器人之间泛化,而无需针对特定本体的微调。
解释
零样本跨本体:微调只用 Aloha-Agilex 的示范,测试时直接换成另一种机械臂,不再训练。之所以可能,是因为动作是“相机坐标系下的末端位移”,与关节结构无关,由各机器人自己的 IK 把末端指令转成关节角。但视觉上,模型看到的机械臂外观完全不同,运动学上各臂的可达范围、关节限位也不同。这里“UR5-WSG”是 UR5 配 WSG 夹爪;值得注意的是,预训练合成数据中已经包含 UR5e、Panda、FR3 和 ARX-L5 的渲染,所以对模型来说这些外观并非完全陌生,“零样本”指的是微调阶段没见过。
原文
(4) Task Semantics—50 tasks evaluated with object instances unseen during that task's training, and 505 paraphrased natural language instructions that rephrase commands in colloquial form. This probes generalization to novel object appearances and robustness to linguistic variation. This decomposition enables precise attribution of generalization gains to specific perturbation types. Further details are provided in the Appendix.
译文
(4) 任务语义——50 个任务使用该任务训练中未见过的物体实例进行评测,另有 505 条以口语化方式改写指令的换说法自然语言指令。这考察对新物体外观的泛化和对语言变化的鲁棒性。这种分解使我们能够把泛化收益精确地归因到具体的扰动类型。更多细节见附录。
解释
未见物体:例如训练时“把瓶子放到垫子上”用的是某一种瓶子,测试时换一个同类别但外观或几何不同的瓶子。附录 B.1 中这 50 个测试任务的名称(如 move_bottle_pad、place_mug_basket)与原 50 个训练任务并不相同,图 9 也把这一项标为 “New Tasks”,所以它实际上同时改变了物体和“物体—目标”组合,比正文所说的“仅换物体实例”更难。505 条换说法指令约为每个任务 10 条,由人工和大语言模型生成。
5实验(Experiments)
5.1实验设置(Experimental Setup)
原文
Model Architecture. We adopt a VLA architecture with Qwen3.5-4B as the vision-language backbone and a Diffusion Transformer (DiT) action head. The model predicts 32-step action chunks in camera-frame relative end-effector representation with 8 diffusion steps.
译文
模型结构。我们采用一个 VLA 结构,以 Qwen3.5-4B 作为视觉语言骨干,配一个扩散 Transformer(Diffusion Transformer,DiT)动作头。模型以相机坐标系相对末端执行器表示预测 32 步的动作块,扩散步数为 8。
解释
这是当前主流的“VLM 骨干 + 生成式动作头”结构,与 GR00T N1、StarVLA 中的 Qwen-GR00T 变体同类。“动作块”(action chunk)指一次预测未来 32 步的动作。“8 个扩散步”的口径:附录 C.3 写明动作头实际用的是流匹配(flow matching),训练时每个样本采样 8 个噪声时刻(附录 D.1 写作 “8 diffusion steps/forward”),推理时用 4 步欧拉积分。正文这里的 “8 diffusion steps” 指的是训练时的做法,不是推理步数。另外,RoboTwin 微调时动作块长度改为 20、每 16 步重新规划(附录 D.3),与这里的 32 步不同。
原文
Training Protocol. All pretraining runs use identical hyperparameters: 8 GPUs, batch size 12/GPU, learning rate 1\text{e-5}\rightarrow1\text{e-6} with cosine decay, bf16, 200K steps. Since all configurations train for the same number of steps with the same batch size, each setting processes an identical number of training samples (\sim19.2M frames), ensuring fair comparison regardless of dataset size. Finetuning loads pretrained weights with ColorJitter augmentation for 50K steps.
译文
训练协议。所有预训练运行使用相同的超参数:8 张 GPU,每卡批大小 12,学习率从 1\times10^{-5} 余弦衰减到 1\times10^{-6},bf16 精度,200K 步。由于所有配置以相同的批大小训练相同的步数,每种设置处理的训练样本数都相同(约 1,920 万帧),因此无论数据集大小如何,比较都是公平的。微调加载预训练权重,使用 ColorJitter 增广,训练 50K 步。
解释
验算:200{,}000\times8\times12=19{,}200{,}000,与“约 1,920 万帧”一致。学习率是骨干的;附录 D.1 说明动作头的学习率是它的 10 倍。这个数字揭示了实验的真实规模。18,561 小时的视频,若按 30 fps 计约有 18{,}561\times3600\times30\approx20 亿帧,加上约 6,565 小时的机器人数据(约 7 亿帧)。而每次预训练只看 1,920 万个样本,在 1:1 配比下合成数据只占其中约 960 万帧,即不到合成数据总帧数的 1%(即使原始帧率只有 10 fps,也不到 2%)。因此,本文的实验比较的是“在相同计算预算下,把一部分样本换成合成数据”的效果,并没有检验“把 18,561 小时全部用上”会怎样。“无论数据集大小都公平”的说法成立,但代价是数据集规模本身这个变量没有被真正测试。图 3 中形态数从 1 增加到 15(时长从 1,237 小时增加到 18,561 小时)带来的提升,也应当理解为多样性的提升,而不是看到的数据量增加,因为样本总数始终相同。
原文
Pretraining Data. We compare four configurations: (i) robot-only (DROID (Khazatsky et al., 2024) + AgibotWorld (Bu et al., 2025) + InternData (Tian et al., 2025), \sim6,565h), and (ii–iv) Ego2Robot-synthesized data (abbreviated Ego2R) mixed with robot data at 1:3, 3:1, and 1:1 ratios.Finetuning and Evaluation. All models are finetuned on RoboTwin's 50 clean-setting tasks (50 demonstrations per task) and evaluated under each perturbation setting with 50 episodes per task. EBench models are finetuned separately on its training set. For real-robot evaluation, we test on an ARX ACone platform across 5 long-horizon manipulation tasks. More details are provided in the Appendix.
译文
预训练数据。我们比较四种配置:(i) 纯机器人数据(DROID(Khazatsky et al., 2024)+ AgibotWorld(Bu et al., 2025)+ InternData(Tian et al., 2025),约 6,565 小时);(ii–iv) Ego2Robot 合成数据(简称 Ego2R)与机器人数据分别按 1:3、3:1 和 1:1 的比例混合。微调与评测。所有模型都在 RoboTwin 的 50 个 Clean 设置任务上微调(每个任务 50 条示范),并在每种扰动设置下对每个任务评测 50 个回合。EBench 的模型在其训练集上单独微调。真机评测在 ARX ACone 平台上进行,共 5 个长时程操作任务。更多细节见附录。
解释
配比的含义是 Ego2R : 机器人数据的采样比例,例如 1:3 表示每个批次里约 25% 的样本来自合成数据,3:1 表示约 75%。三个机器人数据集中,DROID 是 Franka 单臂真机数据,AgibotWorld 是智元人形双臂真机数据,InternData 是仿真生成数据(含 Franka、人形和 Aloha),其中 InternData 里有 Aloha 本体,与 RoboTwin 的默认机器人一致,这对纯机器人基线是有利的。评测规模:50 个任务 \times 50 回合 =2{,}500 个回合,二值成功。对一个约 50% 的总体成功率,若把回合视为独立,标准误约为 \sqrt{0.5\times0.5/2500}=1\%;但各任务的成功率差别很大,加上训练本身的随机性(每种配置只训练一次),实际的不确定性要大于 1 个百分点。下文表中 1–3 个点的差异应谨慎解读。另需注意,表 5 中许多单任务成功率是奇数(如 77.0、93.0),每任务 50 回合时成功率只能是 2% 的整数倍,说明部分结果的回合数或统计方式与此处描述不同(见译者附注)。
5.2主要结果(Main Results)
表 1:主要结果。RoboTwin2.0 和 EBench 上的成功率(%)。括号内为相对纯机器人数据(Robot-only)的变化,绿色表示提升超过 5 个百分点。
| 预训练数据 | RoboTwin | 分维度(RoboTwin) | EBench | ||||
| Clean | Rand | 视觉 | 场景 | 本体 | 任务 | 平均 | |
| Robot-only | 62.2 | 50.9 | 61.4 | 52.9 | 23.8 | 46.2 | 39.6 |
| Ego2R+Robot (1:3) | 61.4 (-0.8) | 51.0 (+0.1) | 61.2 (-0.2) | 52.5 (-0.4) | 21.9 (-1.9) | 49.5 (+3.3) | 47.4 (+7.8) |
| Ego2R+Robot (3:1) | 64.1 (+1.9) | 49.2 (-1.7) | 62.7 (+1.3) | 54.3 (+1.4) | 28.2 (+4.4) | 51.6 (+5.4) | 51.7 (+12.1) |
| Ego2R+Robot (1:1) | 68.1 (+5.9) | 53.5 (+2.6) | 67.3 (+5.9) | 56.9 (+4.0) | 27.2 (+3.4) | 54.1 (+7.9) | 49.8 (+10.2) |
原表注:Main results. Success rates (%) on RoboTwin2.0 and EBench. Green = gain >5% vs. Robot-only.
表 1 解读
列:Clean 和 Rand 是 RoboTwin 原有的两种设置(无扰动、捆绑随机化),各为 50 个任务的平均成功率;中间四列是新增的分维度结果,每列是表 2 中对应几项的平均(附录 B.3 给出定义:视觉 = 背景、光照、颜色三项均值,场景 = 桌高、杂物、相机三项均值,本体 = ARX、UR5、Franka 三项均值,任务 = 物体、语言两项均值);最后一列是 EBench 7 个任务的平均。行:四种预训练配置,微调和评测方式完全相同。核对:用表 2 的数字重算分维度均值,全部吻合。例如 Robot-only 的视觉 (66.6+58.2+59.4)/3=61.4,本体 (44.1+20.2+7.0)/3=23.8;1:1 的任务 (39.6+68.5)/2=54.05\approx54.1。用表 5 的 50 个任务重算 Clean 和 Rand 的平均,多数一致,只有两处差 0.1:1:3 的 Rand 应为 50.92(表中 51.0),3:1 的 Clean 应为 64.04(表中 64.1)。读法:1:1 在七列中的五列最高;3:1 在本体和 EBench 两列最高;1:3 几乎处处与基线持平,只在 EBench 上提升明显。值得注意的是 1:3 和 3:1 在 Rand 上都没有提升(+0.1、-1.7),只有 1:1 提升 2.6 个点,因此“合成数据稳定提升 OOD”主要依赖 1:1 这一行。配比与效果的关系并不单调(1:3 弱、3:1 和 1:1 强,且两者各有胜负),原文没有讨论原因。EBench 上三种配比都提升 7.8–12.1 个点,是全表最一致的收益。
表 2:分扰动细分结果。括号内为相对纯机器人数据的变化,绿色表示提升超过 5 个百分点。
| 预训练数据 | 视觉 | 场景 | 本体 | 任务 | |||||||
| 背景 | 光照 | 颜色 | 桌高 | 杂物 | 相机 | ARX | UR5 | Franka | 物体 | 语言 | |
| Robot-only | 66.6 | 58.2 | 59.4 | 60.1 | 48.3 | 50.4 | 44.1 | 20.2 | 7.0 | 29.3 | 63.1 |
| Ego2R+Robot (1:3) | 65.0 (-1.6) | 58.3 (+0.1) | 60.3 (+0.9) | 58.6 (-1.5) | 49.3 (+1.0) | 49.6 (-0.8) | 43.7 (-0.4) | 17.6 (-2.6) | 4.5 (-2.5) | 36.8 (+7.5) | 62.2 (-0.9) |
| Ego2R+Robot (3:1) | 65.5 (-1.1) | 60.9 (+2.7) | 61.8 (+2.4) | 62.0 (+1.9) | 49.2 (+0.9) | 51.6 (+1.2) | 47.6 (+3.5) | 31.4 (+11.2) | 5.6 (-1.4) | 40.0 (+10.7) | 63.1 (+0.0) |
| Ego2R+Robot (1:1) | 70.3 (+3.7) | 65.8 (+7.6) | 65.8 (+6.4) | 62.4 (+2.3) | 52.0 (+3.7) | 56.3 (+5.9) | 51.2 (+7.1) | 25.0 (+4.8) | 5.3 (-1.7) | 39.6 (+10.3) | 68.5 (+5.4) |
原表注:Per-perturbation breakdown. Change vs. Robot-only. Green = gain >5%.
表 2 解读
列是 11 种单项扰动,按四个维度分组;行与表 1 相同。所有括号内的差值经核对均正确。三个值得注意的现象。第一,部分“扰动”设置的成功率高于无扰动的 Clean:Robot-only 的背景一项为 66.6,高于其 Clean 的 62.2;语言一项 63.1 也略高于 Clean。1:1 的背景一项 70.3 同样高于其 Clean 的 68.1。按理说加扰动只会让任务更难,这说明不同设置之间存在相当的评测噪声(或不同设置下的初始状态采样不同),也提示表中几个点以内的差异未必可靠。第二,Franka 一列在所有合成数据配置下都下降(7.0 降到 4.5–5.6),尽管预训练合成数据里包含 Panda 和 FR3 两种 Franka 系机械臂的渲染,DROID 和 InternData 中也有 Franka 真机或仿真数据。第三,1:1 与 3:1 各有所长:1:1 在视觉、场景和语言上全面领先,3:1 在 UR5(31.4 对 25.0)和未见物体上略好。正文在介绍此表时说测试条件“沿视觉、场景、本体三个维度分解”,但表中实际有四个维度(还包括任务)。
原文
Table 1 shows the success rates of models pretrained with different mixing ratios of Ego2Robot data and real-robot data. Table 2 further compares these models on the extended benchmark, where the test conditions are decomposed along three dimensions: visual appearance, scene, and embodiment. From these results, we draw the following conclusions:Co-training improves OOD generalization. Ego2R+Robot (1:1) leads in five of seven columns, reaching 53.5% on RoboTwin Randomized (+2.6 over robot-only) while maintaining 68.1% on Clean. The 1:3 ratio yields marginal gains, whereas 3:1 and 1:1 produce substantial improvements.
译文
表 1 给出了用不同比例混合 Ego2Robot 数据和真机数据预训练的模型的成功率。表 2 进一步在扩展基准上比较这些模型,其测试条件沿三个维度分解:视觉外观、场景和本体。根据这些结果,我们得出以下结论:联合训练提升 OOD 泛化。Ego2R+Robot (1:1) 在七列中的五列领先,在 RoboTwin Randomized 上达到 53.5%(比纯机器人数据高 2.6 个点),同时在 Clean 上保持 68.1%。1:3 配比的收益很小,而 3:1 和 1:1 带来了显著提升。
解释
“七列中的五列”核对无误:1:1 在 Clean、Rand、视觉、场景、任务五列最高,本体和 EBench 两列由 3:1 领先。“维持 68.1%”的措辞不太准确,68.1 比基线的 62.2 高了 5.9 个点,是提升而非“保持”。Clean 的提升说明合成数据不只是帮助 OOD,也提升了分布内的表现,这本身就是一个有意思的结果。至于“3:1 带来显著提升”,在 Rand 一列上并不成立(-1.7),3:1 的优势集中在本体、任务和 EBench 上。
原文
Visual appearance benefits most. Table 2 shows that 1:1 improves on all three visual factors: background (+4) and lighting (+8) from the scene diversity in egocentric videos, and robot color (+6) from multi-morphology rendering across 15 configurations.Scene layout shows moderate gains. Camera offset robustness improves by +6 at 1:1, as egocentric videos naturally exhibit diverse head poses and viewpoints.
译文
视觉外观收益最大。表 2 显示,1:1 在全部三项视觉因素上都有提升:背景(+4)和光照(+8)得益于第一人称视频的场景多样性,机器人颜色(+6)得益于 15 种配置的多形态渲染。场景布局收益中等。在 1:1 配比下,相机偏移的鲁棒性提升 6 个点,因为第一人称视频天然包含多样的头部姿态和视角。
解释
这里的数字是取整后的:背景 +3.7、光照 +7.6、颜色 +6.4、相机 +5.9。“视觉收益最大”从维度均值看是 +5.9(表 1),而任务维度是 +7.9,所以按均值,任务语义的收益其实更大,作者的排序依据不明确。对颜色一项,正文归因于“15 种形态渲染”,但如第 4 节解释所述,附录 A.6 还对每只渲染出的机械臂做了全色环的随机染色,这是更直接的原因。这些归因(场景多样性 \to 背景和光照、头部运动 \to 相机偏移)都是合理的推测,但文中没有做针对性的消融去验证。
原文
Embodiment transfer benefits from multi-morphology data. ARX improves from 44 to 51 (1:1), and UR5 peaks at 31 (3:1), directly benefiting from exposure to 15 morphologies during pretraining. Franka remains below 7%, reflecting its large kinematic gap from the training embodiment.Task semantics improve consistently. Unseen object generalization improves from 29% to 40% (+11 at 3:1) due to diverse object interactions in egocentric video. Paraphrased instruction robustness reaches 69% at 1:1, benefiting from broader instruction diversity.
译文
本体迁移得益于多形态数据。ARX 从 44 提升到 51(1:1),UR5 最高达到 31(3:1),直接得益于预训练时接触了 15 种形态。Franka 仍低于 7%,反映出它与训练本体之间存在较大的运动学差距。任务语义稳定提升。未见物体上的泛化从 29% 提升到 40%(3:1 时 +11),得益于第一人称视频中多样的物体交互。换说法指令的鲁棒性在 1:1 时达到 69%,得益于更广泛的指令多样性。
解释
本体:ARX 系列与默认的 Aloha-Agilex 尺寸最接近(表 3 中 ARX-L5 臂展 0.855 m,Aloha-Agilex 为 0.853 m,二者都是 6 自由度小臂),所以基线就有 44%;UR5 和 Franka 臂展更长、关节构型不同,基线分别只有 20% 和 7%。“Franka 仍低于 7%”的说法不严谨:基线恰为 7.0%,加入合成数据后反而降到 4.5–5.6%,即合成数据对 Franka 没有帮助,甚至有轻微损害。这与“得益于接触 15 种形态”的解释不完全相符,因为 Panda 和 FR3 就在这 15 种之中。任务语义:“稳定提升”对未见物体成立(三种配比都提升 7.5–10.7 个点),对换说法指令不成立(1:3 为 -0.9,3:1 为 0.0,只有 1:1 为 +5.4)。“69%”是 68.5 的取整。合成数据的语言指令来自数据集自带标注或 VLM 生成,确实比 RoboTwin 的模板化指令更口语化,这为换说法上的收益提供了一个合理的解释。
原文
EBench confirms gains under higher viewpoint. EBench's higher-mounted camera is closer to the egocentric perspective. The 3:1 ratio achieves the best EBench score (51.7, +12.1 over robot-only), suggesting co-training benefits are amplified when the viewpoint bias partially matches.
译文
EBench 证实了更高视角下的收益。EBench 的相机安装得更高,更接近第一人称视角。3:1 配比在 EBench 上取得最好成绩(51.7,比纯机器人数据高 12.1 个点),这表明当视角偏置部分匹配时,联合训练的收益会被放大。
解释
这是全文最大的单项提升,而且三种配比在 EBench 上都提升了 7.8 到 12.1 个点,比 RoboTwin 上的结果一致得多。合成数据比例最高的 3:1 收益最大,与“视角匹配时合成数据更有用”的解释相符。不过 EBench 与 RoboTwin 的差别不只是相机高度,还有仿真器(Isaac Sim 对 SAPIEN)、任务类型(精细的插装、拧螺母)和每任务 400 条示范的微调量,因此“视角匹配”只是可能的原因之一。
5.3消融实验(Ablation Studies)
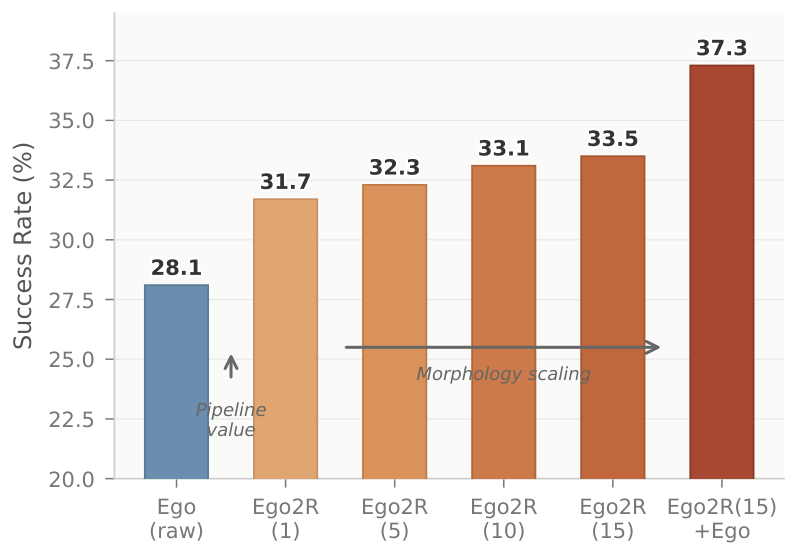
图 3:流水线的价值与形态数量的扩展。RoboTwin Randomized 上的成功率。
原图注:Pipeline value and embodiment scaling. Success rate on RoboTwin Randomized.
图 3 解读
横轴是六种只用第一人称来源数据预训练的配置(都不含机器人数据,之后同样在 RoboTwin Clean 上微调),纵轴是 RoboTwin Randomized 的成功率。纵轴从 20% 起,视觉上会放大差距。蓝色柱 “Ego (raw)” 是不经渲染的原始人类视频(28.1%);橙色系的 “Ego2R (1/5/10/15)” 是用 1、5、10、15 种形态渲染的合成数据(31.7、32.3、33.1、33.5%);最右的深红柱是 15 种形态的合成数据再加上原始人类视频(37.3%)。竖箭头标注 “Pipeline value”(流水线的价值,即 raw 到 Ego2R(1) 的提升),横箭头标注 “Morphology scaling”(形态数量的扩展)。怎么读这些增量。流水线带来 +3.6;形态从 1 增到 15 只再加 +1.8,而且 5 \to 10 \to 15 每步只有 0.4–0.8 个点,在评测噪声范围内;最大的一跳是“加回原始人类视频”,+3.8。作为参照,纯机器人数据预训练的 Randomized 成功率是 50.9%(表 1),比这里最好的 37.3% 高 13.6 个点,说明合成数据不能替代真实机器人数据,只能作为补充。另外,各配置的总训练样本数相同,横轴越往右,每小时数据被看到的次数越少,因此这里比较的是数据多样性,而不是数据量。
原文
Figure 3 isolates the pipeline's contribution using ego-only pretraining (without any robot data).Pipeline alignment is essential. Raw ego co-training achieves only 28.1% on RoboTwin Randomized. Processing through our pipeline (Ego2R with a single morphology) improves this to 31.7%, a +3.6 gain that validates the visual and action alignment stages.
译文
图 3 用仅含第一人称来源的预训练(不含任何机器人数据)来单独考察流水线的贡献。流水线的对齐至关重要。原始第一人称数据的联合训练在 RoboTwin Randomized 上只达到 28.1%。经过我们的流水线处理(单一形态的 Ego2R)后提升到 31.7%,+3.6 的增益验证了视觉对齐和动作对齐两个阶段的作用。
解释
“原始第一人称数据”具体是什么?附录 D.4 说它是“经过流水线质量筛选但没有机器人渲染”的第一人称视频,约 1,940 小时。画面里仍是人手;动作标签应当是重定向后的相机坐标系末端动作(否则无法与其他数据共用动作头),但原文没有明说。因此 raw 与 Ego2R(1) 的差别主要是视觉对齐(人手换成机械臂)以及基座搜索和 IK 带来的运动学可行性筛选,动作对齐的贡献并没有被单独分离出来。此外,正文用了 “co-training” 一词,但这组实验明确不含机器人数据,用词不当。还有一个口径差异:Ego2R(1) 只有约 1,237 小时,少于 raw 的 1,940 小时,而“经过质量筛选”的 raw 数据恰好还是 1,940 小时(与处理前的总量相同),二者的筛选口径不清楚。
原文
More morphologies help. Increasing from 1 to 15 morphologies steadily improves performance (31.7\rightarrow33.5). Adding raw ego data alongside the 15-morphology Ego2R data yields a further jump to 37.3%—the raw ego data effectively acts as a 16th “morphology” with slightly different visual appearance and action distribution, further enriching the pretraining diversity.
译文
更多形态有帮助。形态从 1 种增加到 15 种,性能稳步提升(31.7\rightarrow33.5)。在 15 种形态的 Ego2R 数据之外再加入原始第一人称数据,成绩进一步跃升到 37.3%——原始第一人称数据实际上相当于第 16 种“形态”,其视觉外观和动作分布略有不同,进一步丰富了预训练的多样性。
解释
“稳步提升”在趋势上成立,但幅度很小(共 +1.8,单步不到 1 个点),且是单次运行。作者把 raw 数据解释为“第 16 种形态”,这个解释有意思但也引出一个反问:如果加入一种“形态”(人手)带来 +3.8,而从 1 种机械臂加到 15 种只带来 +1.8,那么人手外观带来的多样性似乎比 14 种额外机械臂更有价值。一种可能是,15 种机械臂渲染之间的差异主要在外观,场景、物体和操作意图完全相同,而人手画面没有修补伪影,保留了原始视频的真实性。原文没有讨论这种可能性。
5.4真机实验(Real Robot Experiments)
原文
We evaluate on an ARX ACone platform across five long-horizon tasks (Figure 5): putting fruits into a basket, putting blocks into a drawer, folding a towel, sweeping trash into a bin, and inserting a screw. For each task, we collect 20 teleoperated demonstrations. Additionally, we record egocentric play videos of hand manipulation (approximately 7 minutes per scene) and process them through our Ego2Robot pipeline to generate ACone-specific synthetic demonstrations.
译文
我们在 ARX ACone 平台上评测五个长时程任务(图 5):把水果放进篮子、把积木放进抽屉、叠毛巾、把垃圾扫进垃圾桶、插入螺丝。每个任务采集 20 条遥操作示范。此外,我们录制了人手操作的第一人称玩耍视频(每个场景约 7 分钟),并经 Ego2Robot 流水线处理,生成 ACone 专用的合成示范。
解释
ARX ACone 是一台双臂平台,每臂 6 自由度、平行夹爪,有头部相机和两个腕部相机,控制频率 15 Hz(附录 E.1)。这里出现了第二种使用合成数据的方式:前面是用大规模 Ego2R 数据做预训练,这里是在部署场景里随手录 7 分钟“玩耍”视频(Ego Play,不需要按任务示范,只是在场景里随意摆弄物体),转换成 ACone 的合成示范后用于微调。这走的是路径 B:视频没有手部标注,需要 WiLoR、DynHaMR 估计手部姿态,Qwen3.5 切分子任务。附录 E.2 给出总量:5 个场景共约 35 分钟视频,生成 675 条合成片段。
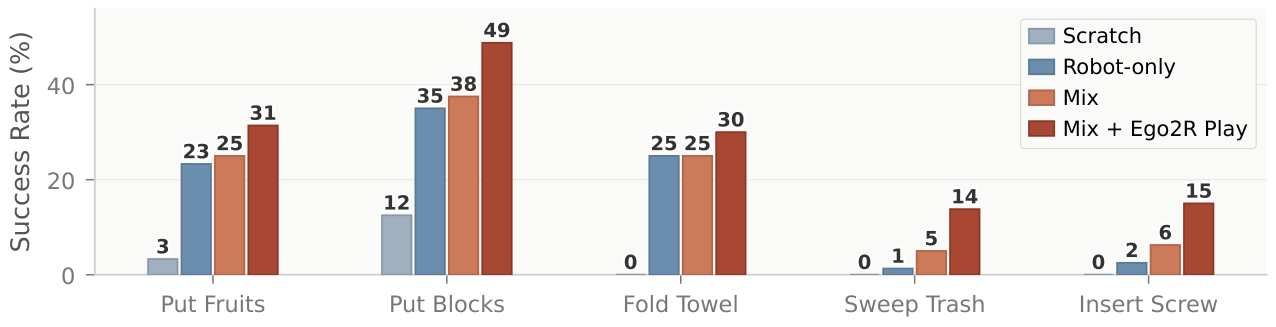
图 4:真机结果。ARX ACone 平台上五个任务的成功率(%)。
原图注:Real robot results. Success rates (%) on five tasks on the ARX ACone platform.
图 4 解读
五组柱子对应五个任务,每组四根柱:浅灰色 Scratch(不预训练,直接在示范上训练)、蓝色 Robot-only(纯机器人数据预训练后微调)、浅红色 Mix(Ego2R+Robot 1:1 预训练后微调)、深红色 Mix + Ego2R Play(同样的预训练,微调时再按 1:1 混入玩耍视频合成的数据)。纵轴虽写“成功率”,实际是附录表 4 定义的分步得分(每完成一个子步骤得相应分数,满分 100,取 20 次试验的平均)。数字:放水果 3/23/25/31,放积木 12/35/38/49,叠毛巾 0/25/25/30,扫垃圾 0/1/5/14,插螺丝 0/2/6/15。四种配置逐级递增(叠毛巾的 Robot-only 与 Mix 持平)。绝对分数普遍不高,最好的放积木也只有 49 分;扫垃圾和插螺丝两项,不用玩耍数据微调时几乎为零。Scratch 这一组在正文中没有被提及,正文只说“比较三种配置”。它说明大规模预训练本身带来的收益(例如放积木 12 \to 35)远大于合成数据带来的额外收益。一处取整疑点:放水果每步 33.3 分、20 次试验,平均分只能是约 1.67k 的形式(k 为全部试验完成的子步骤总数),31 不在其中(相邻值是 30.0 和 31.7),可能是计分方式另有细节,或试验次数不是 20。
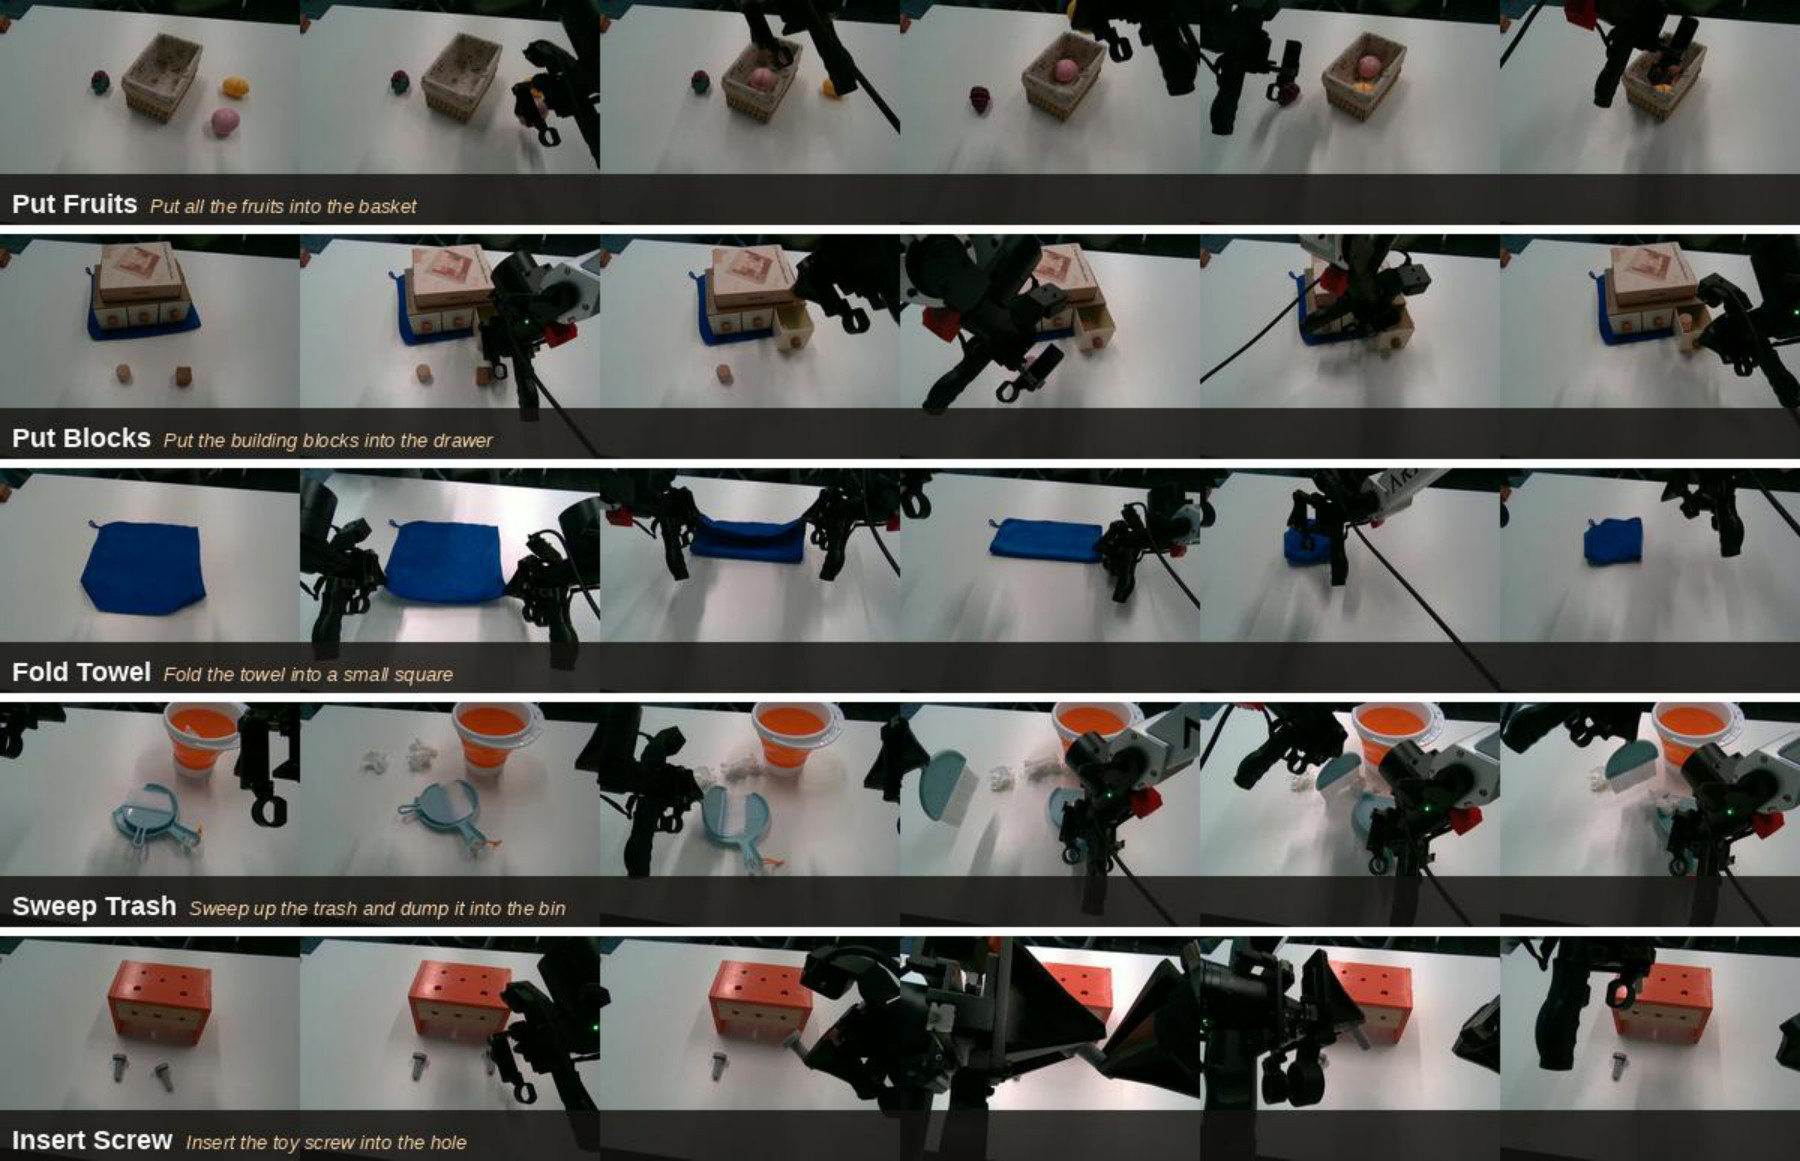
图 5:真机执行过程。ARX ACone 平台上五个评测任务的关键帧。
原图注:Real robot rollouts. Key frames from five evaluation tasks on the ARX ACone platform.
图 5 解读
每行一个任务,从左到右六个关键帧,都是头部相机视角,画面下方的深色条写着任务名和语言指令。放水果(Put all the fruits into the basket):依次把粉色桃子、黄色水果、深色草莓放进篮子。放积木(Put the building blocks into the drawer):拉开小抽屉、放入两块木块、再推回。叠毛巾(Fold the towel into a small square):两只手配合把蓝毛巾对折两次。扫垃圾(Sweep up the trash and dump it into the bin):拿起扫帚把纸团扫进簸箕,再倒进橙色桶。插螺丝(Insert the toy screw into the hole):双手交接玩具螺丝并插入橙色盒子的孔里。这些任务都需要多个子步骤和双手配合,对应附录表 4 的分步计分。
原文
We compare three configurations (Figure 4): Robot-only uses robot-only pretraining and finetunes on teleoperated demonstrations; Mix uses Ego2R+Robot (1:1) pretraining with the same demonstrations; Mix + Ego2R Play finetunes on teleoperated demonstrations mixed 1:1 with the pipeline-converted ego-play (Ego2R) data.
译文
我们比较三种配置(图 4):Robot-only 用纯机器人数据预训练,再在遥操作示范上微调;Mix 用 Ego2R+Robot(1:1)预训练,使用同样的示范微调;Mix + Ego2R Play 在微调时把遥操作示范与经流水线转换的第一人称玩耍数据(Ego2R)按 1:1 混合。
解释
三种配置构成一个递进的对照:Robot-only \to Mix 只改变预训练数据,检验大规模合成数据预训练的作用;Mix \to Mix + Ego2R Play 只改变微调数据,检验现场录制的少量玩耍视频的作用。第二个对照里,微调数据从 100 条示范增加到“100 条示范 + 675 条合成片段”,总数据量也增加了,所以收益中有一部分可能来自“更多的场景内数据”,而不全是“人类视频”的特殊价值。原文没有设置“额外 675 条遥操作”这样的对照,当然那样的对照成本很高,正是本方法想避免的。
原文
Mix + Ego2R Play achieves the best results across all five tasks, with the largest gains on Put Blocks (+14 over Robot-only) and Insert Screw (+13), demonstrating that casually recorded egocentric videos can be converted into effective training signal via our pipeline. Mix pretraining alone already improves over Robot-only, and Ego2R Play data provides further consistent gains.
译文
Mix + Ego2R Play 在全部五个任务上都取得最好结果,提升最大的是放积木(比 Robot-only 高 14)和插螺丝(高 13),这表明随手录制的第一人称视频可以通过我们的流水线转换为有效的训练信号。仅用 Mix 预训练就已优于 Robot-only,而 Ego2R Play 数据带来了进一步的稳定提升。
解释
核对:49-35=14,15-2=13,正确。扫垃圾的提升也有 13 分(14-1),与插螺丝相当。“仅用 Mix 预训练就已优于 Robot-only”在叠毛巾上不成立(25 对 25),其余四项分别高 2、3、4、4 分;在每任务 20 次试验、分步计分的条件下,这样的差距很难与随机波动区分。Ego2R Play 带来的提升(5–14 分)更明显。整体而言,真机实验支持“现场玩耍视频经转换后有用”,对“大规模合成数据预训练有用”的支持较弱。
6局限性(Limitations)
原文
Our work has several limitations that point to future research directions. First, retargeting maps hand poses to parallel-jaw grippers, discarding fine-grained finger articulation. Extending to dexterous multi-finger hands could broaden the range of transferable skills. Second, visual alignment relies on inpainting and depth-aware compositing, which may introduce artifacts under heavy occlusion or complex lighting. Improving rendering fidelity, e.g., with generative models, could further reduce the visual domain gap. Finally, our evaluation is limited to the task scope of RoboTwin2.0 (Chen et al., 2025). Extending to broader tasks and embodiment configurations would strengthen generality.
译文
我们的工作有若干局限,也指明了未来的研究方向。第一,重定向把手部姿态映射为平行夹爪,丢弃了精细的手指关节运动。扩展到灵巧多指手,可以扩大可迁移技能的范围。第二,视觉对齐依赖图像修补和深度感知合成,在严重遮挡或复杂光照下可能产生伪影。提高渲染保真度(例如借助生成模型)可以进一步缩小视觉领域差距。最后,我们的评测仅限于 RoboTwin2.0(Chen et al., 2025)的任务范围。扩展到更广泛的任务和本体配置将增强结论的普适性。
解释
三条局限都很中肯。第一条意味着人类视频中最有价值的部分之一,即灵巧的手指操作,被压缩成了“开/合”一个标量。第二条涉及渲染画面的真实感:合成画面里机械臂和物体之间没有真实的接触,物体是“被隐形的手”移动的,机械臂只是覆盖在上面。第三条之外,还可以补充几点作者没有提到的:实验均为单次运行、无误差条;预训练只用了合成数据集的很小一部分(见第 5.1 节解释);动作表示依赖相机外参,第一人称视频的相机标定质量会影响动作标签。
7结论(Conclusion)
原文
We presented Ego2Robot, a scalable pipeline that converts egocentric hand manipulation videos into robot training data across 15 morphologies. The disentangled evaluation we constructed reveals that ego2robot-synthesized data complements robot data, with gains most pronounced under visual, embodiment, and semantic perturbations. On real robots, combining ego2robot-synthesized data with a small number of demonstrations enables effective multi-task deployment. We hope this work encourages leveraging the vast supply of human manipulation video for scalable robot learning.
译文
我们提出了 Ego2Robot,一条可扩展的流水线,能把第一人称手部操作视频转换为覆盖 15 种形态的机器人训练数据。我们构建的解耦评测表明,ego2robot 合成数据与机器人数据互补,在视觉、本体和语义扰动下收益最为明显。在真实机器人上,把 ego2robot 合成数据与少量示范结合,能实现有效的多任务部署。我们希望这项工作能鼓励人们利用海量的人类操作视频来实现可扩展的机器人学习。
解释
结论与引言一致。需要补充的边界是:“本体”维度的收益只在 ARX 和 UR5 上成立,Franka 反而下降;“有效的多任务部署”中,最好的任务得分也不到 50 分。参考文献列表从略,见原文。
Ego2Robot 附录(Ego2Robot Appendix)
解释
原文附录开头有一个附录目录(A 流水线细节、B 评测框架细节、C 模型结构细节、D 训练细节、E 真机实验细节、F 补充实验结果),本译稿的总目录已包含这些条目,这里不再重复。附录的图表编号与正文连续(表 3–5、图 6–9),公式编号也接着正文的 (5) 继续。
AEgo2Robot 流水线细节(Ego2Robot Pipeline Details)
A.1手部姿态估计(路径 B)
原文
Per-Frame Reconstruction. WiLoR (Potamias et al., 2025) performs per-frame hand detection and regresses MANO parameters (\boldsymbol{\theta}, \boldsymbol{\beta}, \mathbf{t}), yielding 21 keypoints \{\mathbf{p}_j\}_{j=0}^{20} and a hand mesh per frame. Detections are filtered by a SAM 3-generated hand mask: frames where more than 80% of projected keypoints fall outside the mask are discarded.
译文
逐帧重建。WiLoR(Potamias et al., 2025)逐帧检测手部并回归 MANO 参数 (\boldsymbol{\theta}, \boldsymbol{\beta}, \mathbf{t}),每帧得到 21 个关键点 \{\mathbf{p}_j\}_{j=0}^{20} 和一个手部网格。检测结果用 SAM 3 生成的手部掩码过滤:若超过 80% 的投影关键点落在掩码之外,该帧被丢弃。
解释
MANO 用三组参数描述一只手:\boldsymbol\theta 是各关节的旋转(姿态),\boldsymbol\beta 是形状(手的胖瘦长短),\mathbf t 是整体平移。由这些参数可以生成手部网格,并得到 21 个关键点(编号 0 到 20)。用 SAM 3 掩码交叉验证是一种“两个模型互相印证”的简单做法:WiLoR 认为这里有只手,但它的关键点投影回图像后大部分不在 SAM 3 分割出的区域内,说明检测有误。
原文
Cross-Frame Association. WiLoR uses a YOLO-based hand detector that outputs bounding boxes and initial left/right labels. To build temporally consistent tracks, the frame with the highest combined left+right detection score serves as the seed. From the seed, we propagate bidirectionally: at each frame, each new detection is assigned to the hand whose previous wrist position is nearest in image space (\ell_2 distance). When multiple detections compete for the same hand, the highest-scoring one is kept. After association, a jump filter removes frames where the 3D wrist velocity exceeds \max(4 \times \text{median velocity}, 0.003\,\text{m/frame}), indicating misdetections.
译文
跨帧关联。WiLoR 使用基于 YOLO 的手部检测器,输出边界框和初始的左/右手标签。为了建立时间上一致的轨迹,以左右手检测分数之和最高的帧作为种子。从种子帧出发双向传播:在每一帧,把每个新检测分配给“上一帧手腕位置在图像空间中距离最近”(\ell_2 距离)的那只手。当多个检测竞争同一只手时,保留分数最高的那个。关联完成后,用一个跳变过滤器去掉 3D 手腕速度超过 \max(4 \times \text{速度中位数}, 0.003\,\text{m/帧}) 的帧,这些帧被视为误检。
解释
单帧检测器给出的左右手标签经常出错(例如手只露出一部分时),所以不直接相信标签,而是用“最近邻跟踪”保证同一只手在相邻帧里身份不变。从“最可信的帧”开始向前后两个方向传播,可以避免从一个不确定的帧开始而一路错下去。跳变过滤器的阈值是“速度中位数的 4 倍”与一个下限中的较大者。下限 0.003 m/帧在 30 fps 下约为 9 cm/s,比正常手部运动慢得多,所以实际起作用的通常是“4 倍中位数”这一项,下限只防止在几乎静止的片段里误删正常帧。
原文
Temporal Optimization. DynHaMR (Yu et al., 2025) refines the tracks by jointly optimizing MANO pose and shape parameters across the full sequence, minimizing:
\mathcal{L}_\text{dyn} = \mathcal{L}_\text{data} + \lambda_\text{smooth} \mathcal{L}_\text{smooth} + \lambda_\text{bio} \mathcal{L}_\text{bio}(6)
where \mathcal{L}_\text{data} enforces consistency with per-frame WiLoR estimates, \mathcal{L}_\text{smooth} penalizes acceleration in wrist position and finger joint angles, and \mathcal{L}_\text{bio} enforces biomechanical joint limits. The depth of reconstructed hands is constrained to [0.05, 0.4] m from the camera. 译文
时间优化。DynHaMR(Yu et al., 2025)在整个序列上联合优化 MANO 的姿态和形状参数来精修轨迹,最小化:
\mathcal{L}_\text{dyn} = \mathcal{L}_\text{data} + \lambda_\text{smooth} \mathcal{L}_\text{smooth} + \lambda_\text{bio} \mathcal{L}_\text{bio}(6)
其中 \mathcal{L}_\text{data} 约束结果与逐帧的 WiLoR 估计一致,\mathcal{L}_\text{smooth} 惩罚手腕位置和手指关节角的加速度,\mathcal{L}_\text{bio} 施加生物力学上的关节限位。重建出的手与相机的距离被约束在 [0.05, 0.4] m 之内。 解释
公式 (6) 是典型的“数据项 + 正则项”结构。数据项让优化结果不偏离观测;平滑项惩罚加速度(二阶差分),使轨迹不抖;生物力学项防止手指弯成人做不到的角度。\lambda_\text{smooth}、\lambda_\text{bio} 是权重,原文没有给出取值。单目估计手的深度很不准,所以加了一个硬约束:手离相机 5 到 40 cm。这个范围对头戴相机拍桌面操作是合理的,但它也意味着手伸得更远(例如够桌子另一头)时,深度会被截断,相应的动作标签可能失真。
原文
Gap Handling. When hand detections are missing for consecutive frames, we apply gap-specific interpolation. Large gaps (>10 frames) are filled with the robot's home configuration, with smooth blending transitions at the gap boundaries. The blend length is n = \max(5, \min(90, \lceil 0.6 n_\text{pos} + 0.4 n_\text{rot} \rceil)) frames, where n_\text{pos} = \Delta p / 3.25\,\text{mm} and n_\text{rot} = \Delta \theta / 1.08^\circ are the number of frames needed at fixed blend speeds to cover the displacement. Small gaps (\leq10 frames) use linear position interpolation + SLERP.
译文
缺失段处理。当连续多帧没有检测到手时,按缺失段长度采用不同的插值。长缺失段(>10 帧)用机器人的初始(home)构型填充,并在缺失段边界处平滑过渡。过渡长度为 n = \max(5, \min(90, \lceil 0.6 n_\text{pos} + 0.4 n_\text{rot} \rceil)) 帧,其中 n_\text{pos} = \Delta p / 3.25\,\text{mm}、n_\text{rot} = \Delta \theta / 1.08^\circ 分别是以固定过渡速度走完位移和转角所需的帧数。短缺失段(\leq10 帧)使用位置线性插值加 SLERP。
解释
手离开画面(例如去拿画面外的东西)时没有观测。短暂丢失就插值补上;长时间丢失则让机械臂“回到初始姿态”,这与机器人数据中常见的“回零位”行为一致。过渡帧数由两部分加权:位置要以每帧 3.25 mm 的速度走完 \Delta p,旋转要以每帧 1.08° 转完 \Delta\theta,按 0.6/0.4 加权后限制在 5 到 90 帧之间。举例:手最后出现的位置离初始位置 20 cm、转角差 45°,则 n_\text{pos}=200/3.25\approx61.5、n_\text{rot}=45/1.08\approx41.7,n=\lceil0.6\times61.5+0.4\times41.7\rceil=\lceil53.6\rceil=54 帧,在 30 fps 下约 1.8 秒。这些填充帧是人为构造的,不是人的真实动作,后续质量筛选是否会把它们标为无效,原文没有说明。
A.2子任务切分(路径 B)
原文
For long continuous recordings, we pre-split videos at 60-second boundaries. Each clip is sent to a VLM (Qwen3.5 (Qwen Team, 2026)) along with the following prompt template:You are watching a first-person manipulation video ({duration}s).
Task: "{task_desc}"
Segment this video by complete task goals. Each subtask should be an independent, complete objective.
Write a SHORT English action instruction (5–12 words) for each subtask.
Output ONLY a JSON array: [{"description":..., "start_time":..., "end_time":...}, ...]The VLM returns subtask boundaries and natural language descriptions that serve as training instructions.
Task: "{task_desc}"
Segment this video by complete task goals. Each subtask should be an independent, complete objective.
Write a SHORT English action instruction (5–12 words) for each subtask.
Output ONLY a JSON array: [{"description":..., "start_time":..., "end_time":...}, ...]The VLM returns subtask boundaries and natural language descriptions that serve as training instructions.
译文
对于长时间的连续录像,我们先按 60 秒的边界把视频预切分。每个片段与下面的提示模板一起发送给 VLM(Qwen3.5(Qwen Team, 2026)):你正在观看一段第一人称操作视频({duration} 秒)。
任务:“{task_desc}”
请按完整的任务目标切分这段视频。每个子任务都应是一个独立、完整的目标。
为每个子任务写一条简短的英文动作指令(5–12 个词)。
只输出一个 JSON 数组:[{"description":..., "start_time":..., "end_time":...}, ...]VLM 返回子任务的边界和自然语言描述,这些描述用作训练指令。
任务:“{task_desc}”
请按完整的任务目标切分这段视频。每个子任务都应是一个独立、完整的目标。
为每个子任务写一条简短的英文动作指令(5–12 个词)。
只输出一个 JSON 数组:[{"description":..., "start_time":..., "end_time":...}, ...]VLM 返回子任务的边界和自然语言描述,这些描述用作训练指令。
解释
提示词中的
{duration} 和 {task_desc} 是占位符,分别填入片段时长和该视频已有的整体任务描述。要求输出 JSON,便于程序解析。按 60 秒硬切分有一个副作用:跨越切分点的子任务会被截成两半,原文没有说明如何处理。指令限定为“5–12 个英文单词”,与 RoboTwin 等数据集的指令长度大致相当。 A.3动作对齐细节
原文
Handedness Sign. The sign s in the grasp-axis definition (Equation 3) is determined by the hand's left/right identity: s = +1 for the right hand and s = -1 for the left hand, so that the grasp axis \mathbf{z} points consistently regardless of handedness and both hands map to the same gripper frame. The wrist-to-fingertip vector \mathbf{d} = \mathbf{p}_\text{vf} - \mathbf{p}_\text{wrist} that forms the gripper-normal axis \mathbf{y} is taken directly from the MANO keypoints.Degenerate Orientation. When the thumb tip and virtual fingertip nearly coincide (gripper width w < 0.01 m), the grasp orientation degenerates; we freeze it to the last valid estimate. The same fallback is applied when \mathbf{z} and \mathbf{d} are nearly parallel (\|\mathbf{z} \times \mathbf{d}\| \approx 0).
译文
左右手符号。抓取轴定义(公式 3)中的符号 s 由手的左右身份决定:右手 s = +1,左手 s = -1,这样无论左右手,抓取轴 \mathbf{z} 的指向都保持一致,两只手映射到同一个夹爪坐标系。用于构成夹爪法向轴 \mathbf{y} 的手腕到指尖向量 \mathbf{d} = \mathbf{p}_\text{vf} - \mathbf{p}_\text{wrist} 直接取自 MANO 关键点。朝向退化。当拇指指尖与虚拟指尖几乎重合(夹爪宽度 w < 0.01 m)时,抓取朝向退化;此时将其冻结为最后一个有效估计。当 \mathbf{z} 与 \mathbf{d} 几乎平行(\|\mathbf{z} \times \mathbf{d}\| \approx 0)时,采用同样的回退策略。
解释
第一段与正文第 3 节的说明重复。第二段处理公式 (3) 的两种奇异情况:w\to0 时 \mathbf z 的分母趋于零,方向由噪声决定;\mathbf z\parallel\mathbf d 时叉乘为零,\mathbf y 无法定义。第一种情况恰好是“捏紧”的时刻,也就是抓取发生的时刻,这时冻结朝向是合理的,因为手在抓住物体的瞬间朝向通常不再大幅变化。但这也意味着当人用拇指和食指紧紧捏住细小物体时,夹爪朝向停留在捏合前一刻的估计上。
原文
Velocity Filtering. Per-frame detection jumps are removed by a velocity filter. For position velocity v_t = \|\mathbf{p}_t - \mathbf{p}_{t-1}\|, the threshold is:
\tau_t = \max\!\bigl(5 \cdot \text{median}(\{v_s\}_{s}), \; 0.9 / \text{fps}\bigr)(7)
An analogous threshold with floor 10.0/\text{fps} rad/frame is used for rotational velocity. Frames exceeding \tau_t are replaced by interpolation from neighbors. The procedure is iterated for 2 rounds. 译文
速度过滤。逐帧检测的跳变由一个速度过滤器去除。对位置速度 v_t = \|\mathbf{p}_t - \mathbf{p}_{t-1}\|,阈值为:
\tau_t = \max\!\bigl(5 \cdot \text{median}(\{v_s\}_{s}), \; 0.9 / \text{fps}\bigr)(7)
旋转速度使用类似的阈值,下限为 10.0/\text{fps} rad/帧。超过 \tau_t 的帧用相邻帧插值替换。该过程迭代 2 轮。 解释
这一步作用在重定向之后的夹爪轨迹上,与 A.1 中针对手腕的跳变过滤器是两个不同的环节。公式 (7) 中 v_t 是相邻两帧 TCP 的位移(米/帧),阈值取“整段中位速度的 5 倍”与“0.9 m/s 换算到每帧”中的较大者。下限 0.9/\text{fps} 的单位是 m/帧,即 0.9 m/s;旋转下限 10/\text{fps} rad/帧即 10 rad/s(约 573°/s)。二者都远高于正常手部运动,只有明显的“瞬移”才会被判为跳变。迭代两轮是因为第一轮替换后,原本被大跳变掩盖的较小跳变可能显现出来。\tau_t 带下标 t,但公式右边与 t 无关(中位数在整段上计算),下标是多余的。
原文
Temporal Smoothing. Position and gripper width: Savitzky-Golay filter, window \min(21, n), polynomial order \min(3, \text{window}{-}1). Orientation: Gaussian-weighted SLERP, \sigma{=}10 frames, kernel size 21. Adjacent quaternions are hemisphere-corrected (q_t \to -q_t when q_t \cdot q_{t-1} < 0) before interpolation.
译文
时间平滑。位置和夹爪宽度:Savitzky-Golay 滤波,窗口 \min(21, n),多项式阶数 \min(3, \text{窗口}{-}1)。朝向:高斯加权 SLERP,\sigma{=}10 帧,核大小 21。插值前对相邻四元数做半球校正(当 q_t \cdot q_{t-1} < 0 时令 q_t \to -q_t)。
解释
n 是轨迹长度,窗口取 21 与 n 的较小值,是为了处理很短的片段;多项式阶数不能超过窗口长度减一。半球校正:四元数 q 和 -q 表示同一个旋转,如果相邻两帧的四元数恰好落在相反的半球(点积为负),直接插值会绕远路转近 360°。把其中一个取反,保证插值走最短路径。高斯核 \sigma=10 帧、核宽 21 帧(约 \pm1\sigma),在 30 fps 下相当于约 0.7 秒的平滑窗口,是比较强的平滑。
A.4视觉对齐细节
原文
Arm Segmentation. SAM 3 (Carion et al., 2025) uses the text prompt “person” with the middle frame as prompt anchor for temporal propagation. Long videos are processed in 400-frame chunks with 50-frame overlap; masks in overlap regions are merged via bitwise-OR. Post-processing: (i) gaps \leq 3 frames are filled by interpolating neighboring masks; (ii) frames with mask area < 50\% of the local median (window 11) are replaced by the nearest valid mask; (iii) morphological close with 5{\times}5 elliptical kernel.Hand Removal. ProPainter (Zhou et al., 2023) runs at fp16 with neighbor_length\,{=}\,10, ref_stride\,{=}\,10, subvideo_length\,{=}\,80, mask_dilation\,{=}\,4, RAFT iterations\,{=}\,20.
译文
手臂分割。SAM 3(Carion et al., 2025)使用文本提示 “person”,以中间帧作为时间传播的提示锚点。长视频按 400 帧一段、相邻段重叠 50 帧处理;重叠区域的掩码按位取“或”合并。后处理包括:(i) 不超过 3 帧的缺口用相邻帧掩码插值填补;(ii) 掩码面积小于局部中位数(窗口 11)50% 的帧,用最近的有效掩码替换;(iii) 用 5{\times}5 椭圆核做形态学闭运算。人手抹除。ProPainter(Zhou et al., 2023)以 fp16 运行,参数为 neighbor_length\,{=}\,10、ref_stride\,{=}\,10、subvideo_length\,{=}\,80、mask_dilation\,{=}\,4、RAFT 迭代次数\,{=}\,20。
解释
文本提示用 “person” 而不是 “hand”,是因为要抹掉的是整条手臂(包括袖子),第一人称视角下画面里出现的“人”只有手臂。分段处理是为了控制显存,重叠部分取并集宁多勿少,宁可多抹一点背景,也不留下手臂残影。后处理的三步分别处理“短暂丢失”“突然变小”(分割漏掉一部分)和“掩码有小洞或锯齿”。ProPainter 的参数中,neighbor_length 和 ref_stride 决定从多远的帧借背景信息,mask_dilation=4 表示把掩码向外扩 4 像素以覆盖边缘,RAFT 是计算光流的网络。这些都是工程参数,便于复现。
原文
Base Pose Search. The optimization objective is defined in Equation 4. Here we detail the candidate generation and scoring. Candidates are generated in the camera coordinate frame with offsets scaled by reach r:
- Lateral (left-right): r \times \{0.3, 0.4, 0.5, 0.6, 0.8, 1.0, 1.2\} (7 levels, sign-flipped per arm)
- Forward-backward: r \times \{-0.1, 0.0, 0.1, 0.3, 0.5, 0.7, 0.9\} (7 levels)
- Vertical: r \times \{0.4, 0.2, 0.0, -0.2, -0.4\} (5 levels)
- Orientation: pitch \{30^\circ, 45^\circ, 60^\circ\} \times yaw \{-45^\circ, -20^\circ, 0^\circ, 20^\circ, 45^\circ\} \times roll \{-15^\circ, 0^\circ, 15^\circ\}
译文
基座位姿搜索。优化目标见公式 4。这里详细说明候选的生成和打分。候选在相机坐标系中生成,偏移量按臂展 r 缩放:
- 横向(左右):r \times \{0.3, 0.4, 0.5, 0.6, 0.8, 1.0, 1.2\}(7 档,左右臂取相反符号)
- 前后:r \times \{-0.1, 0.0, 0.1, 0.3, 0.5, 0.7, 0.9\}(7 档)
- 竖直:r \times \{0.4, 0.2, 0.0, -0.2, -0.4\}(5 档)
- 朝向:俯仰 \{30^\circ, 45^\circ, 60^\circ\} \times 偏航 \{-45^\circ, -20^\circ, 0^\circ, 20^\circ, 45^\circ\} \times 横滚 \{-15^\circ, 0^\circ, 15^\circ\}
解释
候选规模:位置 7\times7\times5=245 个,朝向 3\times5\times3=45 个,每只手臂共 245\times45=11{,}025 个候选。偏移按臂展缩放,使同一套网格对 0.79 m 的 WidowX 和 1.63 m 的 UR10e 都适用。横向偏移最小也有 0.3r,且左右臂符号相反,保证双臂基座分居相机两侧,模仿人的左右肩。注意正文说网格是“围绕轨迹质心”生成的,而这里写的是“在相机坐标系中”生成,原点到底是相机还是轨迹质心,两处说法不一致。三条剔除规则的含义:基座离相机太近会挡住视野或与“头部”冲突;轨迹点超过 0.9r 接近臂展极限、容易不可达或处于奇异位形;离基座太近(8 cm 以内)机械臂需要折叠到几乎不可能的姿态。
原文
Surviving candidates are scored by:
S = \text{FR}(\mathbf{T}_\text{base}) - 5.0 \cdot |\bar{\rho} - 0.65|(8)
where \text{FR} is the IK feasibility rate over up to 20 keyframes (using the mink IK solver, quadprog backend, 100 iterations, 10^{-5} threshold). The second term is a reach penalty: \bar{\rho} = \frac{1}{|\mathcal{K}|}\sum_{k} \|\mathbf{T}_\text{base}^{-1}\mathbf{p}_k^\text{ee}\| / r is the average end-effector distance from the base normalized by the kinematic reach r, and the penalty is minimized when \bar{\rho} = 0.65, encouraging the robot to operate at 65% of its maximum reach to retain kinematic margin for manipulation. We independently screen the top-5 candidates per arm, then jointly verify all 25 left–right combinations to select the final base placement. 译文
保留下来的候选按下式打分:
S = \text{FR}(\mathbf{T}_\text{base}) - 5.0 \cdot |\bar{\rho} - 0.65|(8)
其中 \text{FR} 是在至多 20 个关键帧上的 IK 可行率(使用 mink IK 求解器,quadprog 后端,100 次迭代,阈值 10^{-5})。第二项是臂展惩罚:\bar{\rho} = \frac{1}{|\mathcal{K}|}\sum_{k} \|\mathbf{T}_\text{base}^{-1}\mathbf{p}_k^\text{ee}\| / r 是末端执行器到基座的平均距离按运动学臂展 r 归一化后的值,当 \bar{\rho} = 0.65 时惩罚最小,鼓励机器人在其最大臂展的 65% 处工作,为操作保留运动学余量。我们先对每只手臂独立筛选出前 5 个候选,再对全部 25 种左右组合进行联合验证,选出最终的基座摆放。 解释
公式 (8) 与正文公式 (4) 的关系:正文只最大化可行率 FR,这里多了一项惩罚。两项的量级:FR 在 0 到 1 之间;若平均归一化距离 \bar\rho=0.45,惩罚为 5\times0.2=1.0,足以抵消全部可行率。所以权重 5.0 很大,实际上是在“可行率接近”的候选里优先选工作距离约为 65% 臂展的那个。举例:候选 A 的 FR=1.0、\bar\rho=0.85,得分 1-5\times0.2=0;候选 B 的 FR=0.95、\bar\rho=0.66,得分 0.95-0.05=0.90,B 胜出。\mathbf p_k^\text{ee} 是第 k 个关键帧末端位置(齐次坐标),左乘 \mathbf T_\text{base}^{-1} 后取范数,即末端到基座的距离。双臂组合:两只手臂先各自选前 5 名,再枚举 5\times5=25 种组合联合检查,大概是为了排除两臂基座或手臂相互碰撞的组合(L1 筛选中有“双臂交叉接触”这一条)。
原文
Depth-Aware Compositing. The main text (Equation 5) presents a unified depth-ordering rule. In practice, we separate the robot into arm body and gripper regions using MuJoCo's per-geom segmentation masks. The arm body mask (\texttt{robot\_mask}{=}1 \wedge \texttt{gripper\_mask}{=}0) is always composited onto the inpainted scene, since the arm is positioned between the camera and the workspace and is never occluded by scene objects. The gripper mask (\texttt{gripper\_mask}{=}1) undergoes per-pixel depth comparison: a gripper pixel at (u,v) is hidden when the scene depth D_\text{scene}(u,v) < D_\text{sim}(u,v) and the pixel is not within the dilated hand mask region, where D_\text{scene} is estimated by Depth Anything V3 and D_\text{sim} is rendered by MuJoCo.
译文
深度感知合成。正文(公式 5)给出的是统一的深度排序规则。实际上,我们利用 MuJoCo 逐几何体的分割掩码,把机器人分成臂身和夹爪两个区域。臂身掩码(\texttt{robot\_mask}{=}1 \wedge \texttt{gripper\_mask}{=}0)总是直接合成到修补后的场景上,因为臂身位于相机与工作区之间,不会被场景物体遮挡。夹爪掩码(\texttt{gripper\_mask}{=}1)则逐像素比较深度:当场景深度 D_\text{scene}(u,v) < D_\text{sim}(u,v) 并且该像素不在膨胀后的手部掩码区域内时,位于 (u,v) 的夹爪像素被隐藏。其中 D_\text{scene} 由 Depth Anything V3 估计,D_\text{sim} 由 MuJoCo 渲染。
解释
这里解释了为什么实际实现比公式 (5) 复杂。单目深度估计在物体边缘和细小结构上误差很大,如果对整条机械臂都做深度比较,臂身上会出现被“错误遮挡”的破洞。由于第一人称视角下手臂从相机附近伸向桌面,臂身确实几乎总在物体前面,直接覆盖是一种稳妥的简化。夹爪才是真正会伸到物体后面或里面的部分(例如伸进碗里),所以只对它做深度判断。“不在手部掩码内”这一条件的意义:原视频中人手所在的位置正是夹爪应该出现的位置,而修补后这一区域的背景是“编造”的,它的深度估计不可靠(尤其如果深度是在原视频上估计的,这里测到的是人手本身的深度)。所以在原手部区域内,夹爪一律显示,不做遮挡判断。
原文
The hand mask is dilated with a 5{\times}5 kernel (1 iteration) before compositing to prevent revealing inpainted boundaries along the original arm contour. The final overlay is:
I_\text{out}(u,v) = \begin{cases} I_\text{sim}(u,v) & \text{if } (u,v) \in M_\text{arm} \cup M_\text{gripper\_vis} \\ I_\text{inpaint}(u,v) & \text{otherwise} \end{cases}(9)
where M_\text{gripper\_vis} = M_\text{gripper} \setminus \{(u,v) : D_\text{scene} < D_\text{sim} \wedge (u,v) \notin M_\text{hand}\}. 译文
合成前用 5{\times}5 的核(1 次迭代)对手部掩码做膨胀,以免沿原手臂轮廓暴露出修补的边界。最终的叠加为:
I_\text{out}(u,v) = \begin{cases} I_\text{sim}(u,v) & \text{若 } (u,v) \in M_\text{arm} \cup M_\text{gripper\_vis} \\ I_\text{inpaint}(u,v) & \text{否则} \end{cases}(9)
其中 M_\text{gripper\_vis} = M_\text{gripper} \setminus \{(u,v) : D_\text{scene} < D_\text{sim} \wedge (u,v) \notin M_\text{hand}\}。 解释
公式 (9) 用集合语言重写了上一段:最终显示仿真渲染像素的区域,是“臂身掩码”与“可见的夹爪掩码”的并集。可见夹爪掩码等于全部夹爪像素,减去“场景比夹爪更近、且不在手部掩码内”的那些像素(\setminus 表示集合差)。I_\text{sim} 即正文公式 (5) 中的 I_\text{robot},两处记号不统一。“防止暴露修补边界”这句话的含义并不直观:手部掩码膨胀后,“不做遮挡判断、夹爪一律显示”的区域变大,夹爪更容易完整地盖住原手臂轮廓附近的修补痕迹。不过,如果渲染出的机械臂比人的手臂细,修补边界仍可能露在外面,这时只能依赖修补本身的质量。
A.5质量筛选细节
原文
L1 (Pipeline-internal). A frame is valid when: (i) hand detected, (ii) IK tracking error < 0.05 m, (iii) rendered robot visible (>0 pixels), (iv) no self-collision (MuJoCo contact check). Additional invalidation: bimanual cross-arm contacts > 1 or robot mask > 70\% of image area.Stability Erosion. Short valid runs (< \lfloor 0.3 \times \text{fps} \rfloor frames) sandwiched between invalid regions are eroded to invalid.
译文
L1(流水线内部)。一帧有效的条件是:(i) 检测到手;(ii) IK 跟踪误差 < 0.05 m;(iii) 渲染出的机器人可见(像素数 >0);(iv) 无自碰撞(MuJoCo 接触检查)。额外的无效判定:双臂之间的交叉接触多于 1 处,或机器人掩码超过图像面积的 70%。稳定性腐蚀。夹在无效区域之间的短有效段(少于 \lfloor 0.3 \times \text{fps} \rfloor 帧)被腐蚀为无效。
解释
IK 跟踪误差是 IK 解出的末端位置与目标位置之差,5 cm 是相当宽松的容差,意味着机械臂可能离人手的真实位置有几厘米偏差,而画面里物体仍在人手原本操作的位置。这种偏差在合成画面中表现为“夹爪没碰到物体,物体却动了”。“机器人掩码超过 70% 画面”多发生在机械臂离相机太近时,画面几乎被手臂占满,没有训练价值。稳定性腐蚀借用了形态学“腐蚀”的说法:在 30 fps 下,短于 9 帧(0.3 秒)的有效片段如果前后都是无效帧,就整体判为无效,因为这么短的片段既学不到完整动作,又很可能是误检。
原文
L2 (Statistical). Two post-hoc statistical filters are applied: (i) Q1/Q99 filter: for each action dimension, per-dataset Q1 and Q99 statistics are computed (excluding previously invalidated frames). Frames falling outside [\text{Q1} - 3(\text{Q99}-\text{Q1}),\; \text{Q99} + 3(\text{Q99}-\text{Q1})] are flagged. (ii) Sudden-change filter: for each step, residual, acceleration, and jerk are computed on state/action trajectories. Steps exceeding per-dimension thresholds (computed from the dataset's distribution) are flagged. After both filters, episodes whose total invalid frame ratio exceeds 60% are discarded entirely.
译文
L2(统计)。应用两个事后的统计过滤器:(i) Q1/Q99 过滤:对每个动作维度,按数据集计算 Q1 和 Q99 统计量(不计此前已判为无效的帧)。落在 [\text{Q1} - 3(\text{Q99}-\text{Q1}),\; \text{Q99} + 3(\text{Q99}-\text{Q1})] 之外的帧被标记。(ii) 突变过滤:对每一步,在状态/动作轨迹上计算残差、加速度和加加速度。超过各维度阈值(由数据集分布计算)的步被标记。两个过滤器之后,无效帧总比例超过 60% 的片段被整段丢弃。
解释
Q1、Q99 指第 1 和第 99 百分位数(不是常说的第一四分位数)。这个区间的构造仿照了箱线图的“四分位距”规则,但尺度大得多:两端各再向外扩 3 倍的 Q1–Q99 跨度,总宽度是 Q1–Q99 跨度的 7 倍。只有极端离谱的值(通常来自检测错误或坐标变换错误)才会落在外面,正常的大动作不会被误删。突变过滤用残差(与平滑轨迹的偏差)、加速度和加加速度(jerk,三阶导数)来捕捉“轨迹上的尖刺”。最后的 60% 阈值意味着一个片段即使有一多半帧无效也可能被保留,被标记的帧在训练时大概会被跳过或屏蔽,原文没有明说。
原文
L3 (VLM Consistency). A VLM (Qwen3.5) audits each synthesized video for semantic consistency. The video is sampled at 4 fps and sent along with the subtask description. The prompt is:You are evaluating whether a manipulation video matches its text description.
This is a ROBOT manipulation dataset. "Hand" refers to the robot's gripper/end-effector.
Many tasks use FAKE or SIMULATED objects as stand-ins for real objects. This is EXPECTED.
Task Description: {description}
Determine if the robot's actions match the described task.
Flag MAJOR MISMATCHES: wrong action type, wrong object category, wrong target location, or failed execution.
Be tolerant of: fake/toy objects, minor appearance variations, small spatial deviations, different grasping approaches.
Respond in JSON: {"is_consistent": true/false, "confidence": 0.0-1.0, "reasoning": "..."}Episodes judged inconsistent are discarded.
This is a ROBOT manipulation dataset. "Hand" refers to the robot's gripper/end-effector.
Many tasks use FAKE or SIMULATED objects as stand-ins for real objects. This is EXPECTED.
Task Description: {description}
Determine if the robot's actions match the described task.
Flag MAJOR MISMATCHES: wrong action type, wrong object category, wrong target location, or failed execution.
Be tolerant of: fake/toy objects, minor appearance variations, small spatial deviations, different grasping approaches.
Respond in JSON: {"is_consistent": true/false, "confidence": 0.0-1.0, "reasoning": "..."}Episodes judged inconsistent are discarded.
译文
L3(VLM 一致性)。一个 VLM(Qwen3.5)审查每段合成视频的语义一致性。视频以 4 fps 采样,与子任务描述一起发送。提示词为:你正在评估一段操作视频是否与其文字描述相符。
这是一个机器人操作数据集。“手”指机器人的夹爪/末端执行器。
许多任务使用假的或仿真的物体来代替真实物体,这是预期之内的。
任务描述:{description}
判断机器人的动作是否与所描述的任务相符。
标记重大不符:动作类型错误、物体类别错误、目标位置错误或执行失败。
对以下情况保持宽容:假的或玩具物体、轻微的外观差异、小的空间偏差、不同的抓取方式。
以 JSON 回答:{"is_consistent": true/false, "confidence": 0.0-1.0, "reasoning": "..."}被判定为不一致的片段被丢弃。
这是一个机器人操作数据集。“手”指机器人的夹爪/末端执行器。
许多任务使用假的或仿真的物体来代替真实物体,这是预期之内的。
任务描述:{description}
判断机器人的动作是否与所描述的任务相符。
标记重大不符:动作类型错误、物体类别错误、目标位置错误或执行失败。
对以下情况保持宽容:假的或玩具物体、轻微的外观差异、小的空间偏差、不同的抓取方式。
以 JSON 回答:{"is_consistent": true/false, "confidence": 0.0-1.0, "reasoning": "..."}被判定为不一致的片段被丢弃。
解释
提示词有两处值得注意的设计。其一,告诉模型“手”指机器人夹爪,避免 VLM 因为画面里没有人手而判为不符。其二,明确要求对“假物体、玩具”保持宽容,因为 ANT、EgoVerse 等数据中常用塑料水果、玩具等道具,VLM 容易把“塑料苹果”判为“不是苹果”。4 fps 采样是在成本和时间分辨率之间的折中。模型还输出 confidence(置信度),但原文只说“判为不一致即丢弃”,没有说明是否使用置信度阈值。
A.6颜色随机化
原文
Each rendered robot undergoes deterministic color randomization in HSV space: H \sim U(0, 1), S \sim U(0.3, 1), V \sim U(0.4, 1), applied uniformly across all links.
译文
每个渲染出的机器人都在 HSV 空间进行确定性的颜色随机化:H \sim U(0, 1)、S \sim U(0.3, 1)、V \sim U(0.4, 1),统一施加于所有连杆。
解释
HSV 是色相(Hue)、饱和度(Saturation)、明度(Value)。H 在 [0,1) 上均匀采样,覆盖整个色环;饱和度和明度设下限,避免出现过灰或过暗、看不清的机械臂。“确定性”的意思应当是随机种子由片段决定,同一片段每次生成的颜色相同,便于复现。这一条与评测直接相关:评测中的“机器人颜色”扰动是对所有连杆做随机色相偏移,与这里的数据增广几乎同构。因此表 2 中颜色一项的提升(1:1 时 +6.4),很大程度上可以归因于这项增广,而不是正文所说的“多形态渲染”。纯机器人数据配置没有对应的颜色增广,对比并不完全对等。
A.7支持的机器人形态
原文
Table 3 lists the 15 morphologies. Figure 6 shows the 3D models of all 15 robots.
译文
表 3 列出了 15 种形态。图 6 展示了全部 15 种机器人的 3D 模型。
表 3:支持的机器人形态。
| 机器人 | 自由度 | 夹爪行程(mm) | 臂展(m) |
| Panda | 7 | 0–80 | 1.272 |
| Kinova Gen3 | 7 | 0–85 | 1.337 |
| IIWA | 7 | 0–85 | 1.411 |
| Sawyer | 7 | 14–79 | 1.420 |
| FR3 | 7 | 0–80 | 1.272 |
| xArm7 | 7 | 0–85 | 1.290 |
| UR5e | 6 | 0–85 | 1.236 |
| UR10e | 6 | 0–85 | 1.627 |
| Jaco | 6 | 0–125 | 1.200 |
| ViperX | 6 | 15–87 | 0.911 |
| WidowX | 6 | 11–55 | 0.787 |
| ARX-L5 | 6 | 0–88 | 0.855 |
| Piper | 6 | 0–70 | 0.883 |
| YAM | 6 | 4–75 | 0.866 |
| Aloha-Agilex | 6 | 7–102 | 0.853 |
原表注:Supported robot morphologies.
表 3 解读
列:自由度(DOF,关节数)、夹爪开口行程(最小到最大,单位毫米)、臂展(基座 r 的取值,用于基座搜索中的网格缩放和剔除规则)。行:前 6 种是 7 自由度的冗余机械臂(Franka 的 Panda 与 FR3、Kinova Gen3、KUKA IIWA、Rethink Sawyer、UFactory xArm7),后 9 种是 6 自由度机械臂,其中 UR5e、UR10e、Jaco 是工业或协作臂,ViperX、WidowX、ARX-L5、Piper、YAM、Aloha-Agilex 是常用于低成本双臂遥操作的小型臂(臂展都在 0.79–0.91 m)。两点观察。第一,Panda 与 FR3 的三项参数完全相同(FR3 是 Panda 的后继型号),二者在合成数据里几乎是同一种形态的两个外观版本。第二,表中臂展普遍大于厂商的标称值,例如 Panda 标称约 0.855 m(表中 1.272),UR5e 标称约 0.85 m(表中 1.236),UR10e 标称约 1.30 m(表中 1.627)。这里的数值可能是按模型中连杆长度累加并计入夹爪得到的上界,而不是实际可达半径。由于基座搜索中的偏移和剔除规则都按 r 缩放,臂展偏大会让基座倾向于放得更远,再由 IK 可行率去纠正。原文没有说明臂展的定义。
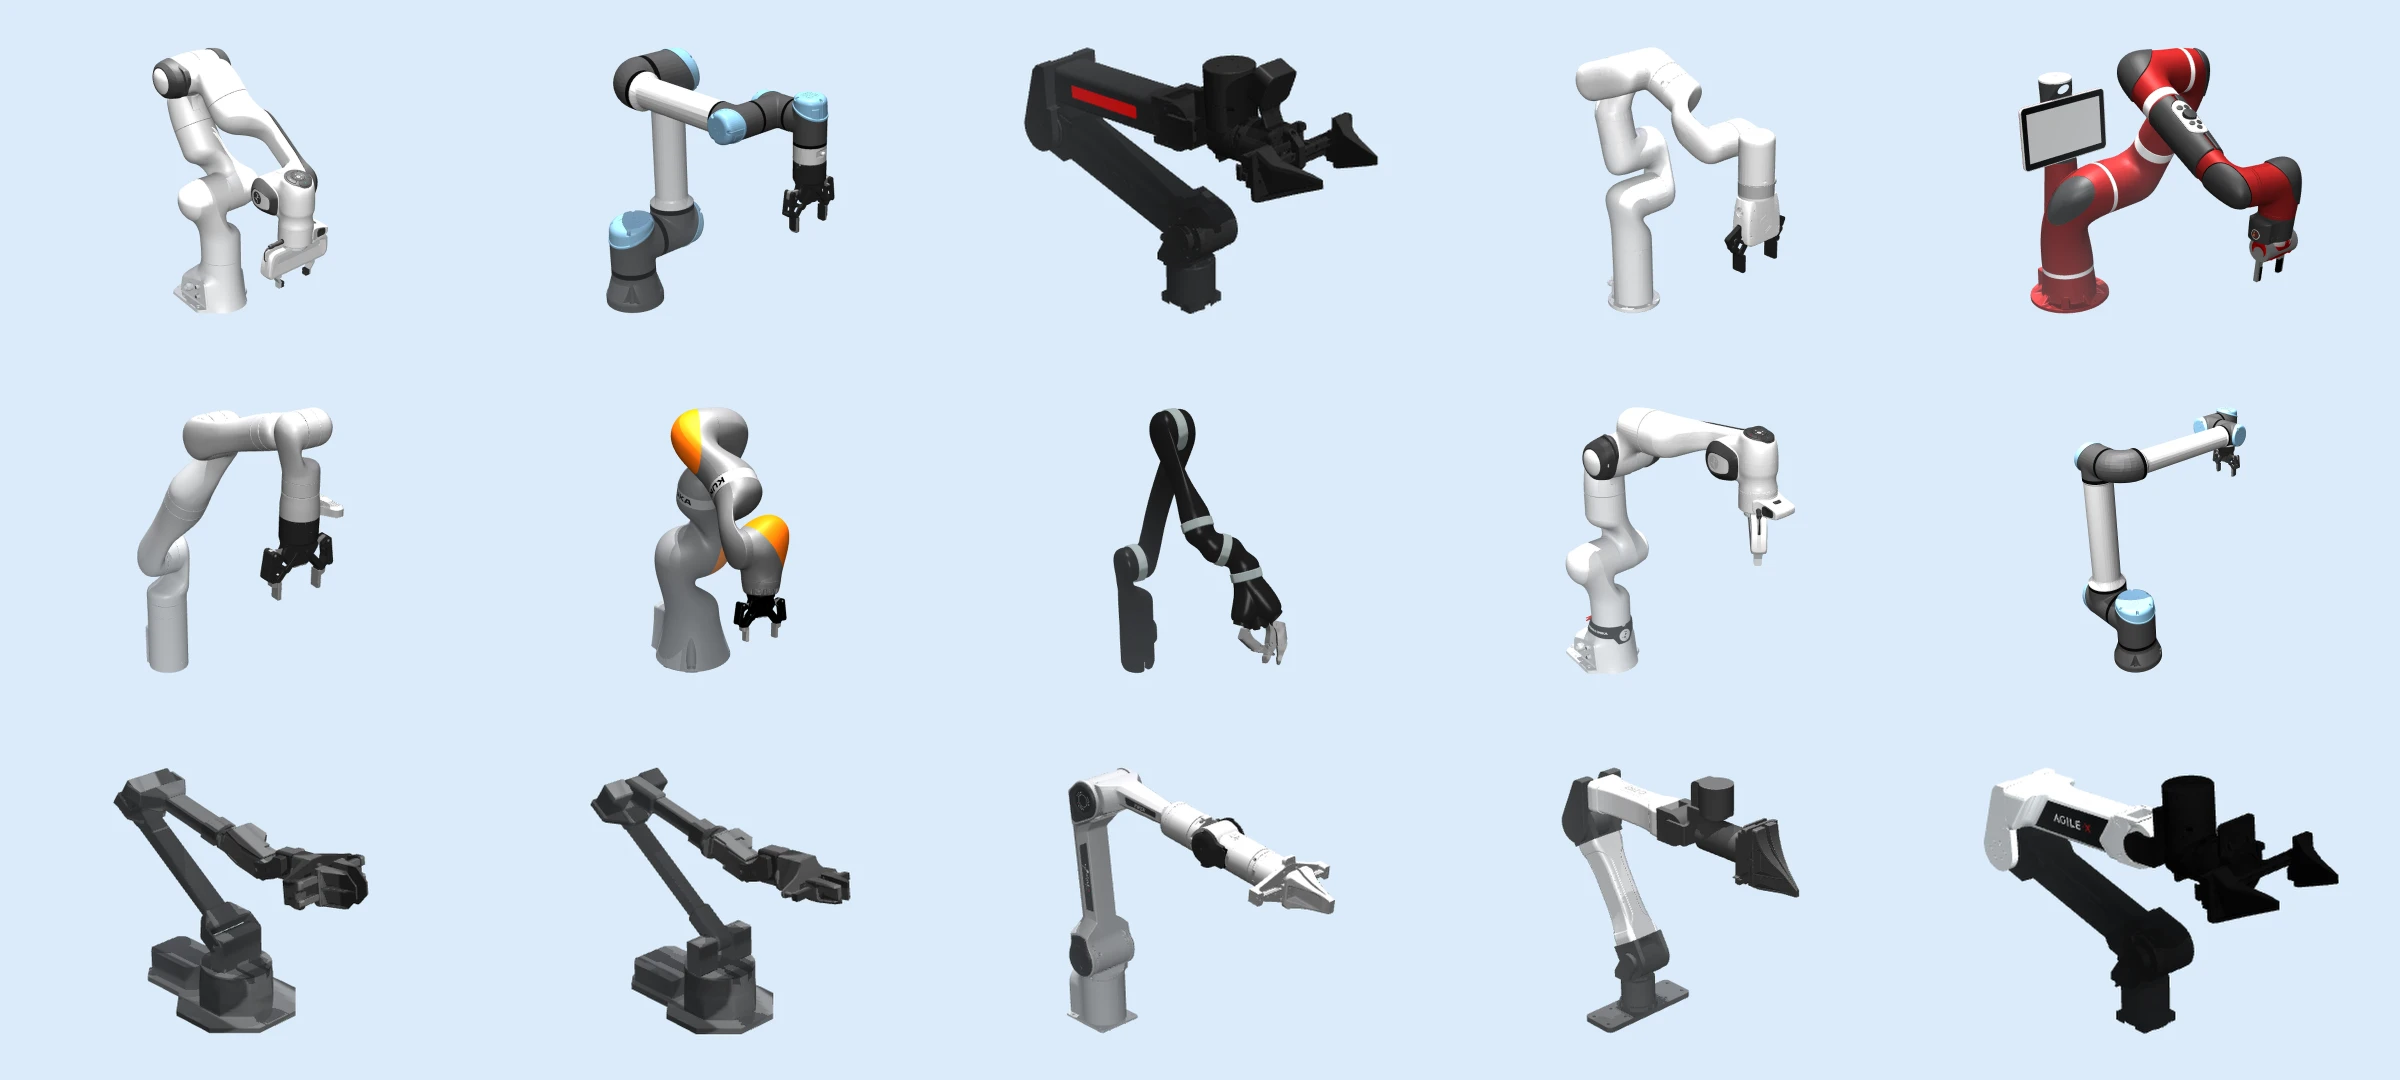
图 6:支持的 15 种机器人形态。全部 15 种机器人的 3D 模型。
原图注:15 supported robot morphologies. 3D models of all 15 robots.
图 6 解读
浅蓝底上排成 3 行 \times 5 列的 15 个机械臂渲染模型,都是 MuJoCo 中使用的模型。图中没有标注型号,从外观可以辨认出几种:白色、关节处带灰色的 Franka 系(Panda/FR3);黑白相间、关节带浅蓝色环的 UR 系列;红色、带显示屏“头部”的 Sawyer;白色臂身、橙色关节的 KUKA IIWA;全黑色、细长的 Kinova Jaco;底行深灰色的 ViperX/WidowX 等小型臂,以及右下角带 “AGILE X” 字样的 Aloha-Agilex。这些模型之间外观差异很大(颜色、粗细、连杆形状),合成数据正是借此让模型见过多种机械臂外观。
B评测框架细节(Evaluation Framework Details)
B.1扰动参数
原文
Randomized (standard OOD). The original RoboTwin 2.0 setting simultaneously applies background texture replacement, lighting randomization, table height offset, and clutter. We decouple these into independent axes below, and additionally introduce Camera Offset, Robot Color, Paraphrased Instructions, and Unseen Objects as new evaluation dimensions.Visual Appearance: Background. Table and floor textures replaced with randomly sampled textures from a library. Lighting. Light positions and intensities randomized. Robot Color. Uniform hue shift from [0^\circ, 360^\circ) applied to all robot links.Scene Layout: Table Height. Vertical offset \pm4 cm. Clutter. 3–5 distractor objects with random poses. Camera Offset. Head camera displaced up to 5 cm per axis.
译文
Randomized(标准 OOD)。RoboTwin 2.0 原有的这一设置同时施加背景纹理替换、光照随机化、桌面高度偏移和杂物。我们把它们拆成下面的独立维度,并额外引入相机偏移、机器人颜色、换说法指令和未见物体作为新的评测维度。视觉外观:背景。桌面和地面纹理替换为从纹理库中随机采样的纹理。光照。光源位置和强度随机化。机器人颜色。对所有机器人连杆施加从 [0^\circ, 360^\circ) 中均匀采样的色相偏移。场景布局:桌面高度。竖直偏移 \pm4 cm。杂物。3–5 个随机位姿的干扰物体。相机偏移。头部相机在每个轴上最多偏移 5 cm。
解释
这里明确了哪些是“拆分”、哪些是“新增”:背景、光照、桌高、杂物四项来自原 Randomized;相机偏移、颜色、换说法、未见物体四项是新增;本体三项也是新增。与图 2 对照,相机偏移在图中被画成虚线框(“解耦”),与这里“新引入”的说法不一致。各扰动的强度都不大(桌高 \pm4 cm、相机每轴 \le5 cm),说明本文关注的是策略对“小幅但真实存在”的变化是否鲁棒。
原文
Task Semantics: Paraphrased Instructions. 505 colloquially rephrased commands (human + LLM generated). Unseen Objects. 50 new tasks with object instances not present in the finetuning demonstrations (same category, different appearance/geometry), spanning seven manipulation families:
译文
任务语义:换说法指令。505 条口语化改写的指令(人工和大语言模型生成)。未见物体。50 个新任务,所用物体实例不在微调示范中出现(类别相同,外观或几何不同),涵盖七个操作类别:
原文
- Move-to-pad/pot (10): move bottle pad, move cup pad, move bowl pad, move cup pot, move bottle pot, move mug pot, move apple pot, move seal pot, move pillbottle pot, move bowl pot
- Place-in-basket (11): place soap basket, place mug basket, place perfume basket, place teabox basket, place toycar basket, place apple basket, place bottle basket, place cup basket, place coffeebox basket, place saucecan basket, place hamburg basket
- Place-on-stand (4): place cup stand, place mug stand, place bottle stand, place apple stand
- Place-on-scale (3): place bottle scale, place cup scale, place mug scale
- Put-in-cabinet (3): put apple cabinet, put seal cabinet, put bowl cabinet
- Bimanual place-A-to-B (12): place cup left bottle, place mug right apple, place bottle left cup, place seal right mug, place mug left cup, place apple left mug, place bottle right apple, place seal left cup, place mug left bottle, place apple right cup, place cup right seal, place bottle left apple
- Move-away (7): move cup away, move bottle away, move apple away, move mug away, move seal away, move bowl away, move pillbottle away
译文
- 移到垫子/锅上(10 个):瓶、杯、碗移到垫子上;杯、瓶、马克杯、苹果、印章、药瓶、碗移到锅上。
- 放进篮子(11 个):肥皂、马克杯、香水、茶叶盒、玩具车、苹果、瓶子、杯子、咖啡盒、酱料罐、汉堡放进篮子。
- 放到支架上(4 个):杯子、马克杯、瓶子、苹果。
- 放到秤上(3 个):瓶子、杯子、马克杯。
- 放进柜子(3 个):苹果、印章、碗。
- 双臂把 A 放到 B 旁(12 个):如“把杯子放到瓶子左边”“把马克杯放到苹果右边”等 12 种物体与方位组合。
- 移开(7 个):杯子、瓶子、苹果、马克杯、印章、碗、药瓶。
解释
核对:10+11+4+3+3+12+7=50,与“50 个新任务”一致。这些任务都是对原 50 个训练任务中某些任务的“换物体”变体,例如训练集里有 move_can_pot(把罐子移到锅上)、move_pillbottle_pad、place_bread_basket、place_object_stand、place_a2b_left/right、move_playingcard_away 等,测试时把物体换成杯子、瓶子、苹果等。所以每个测试任务的动作模式是见过的,变化的是物体及物体—目标组合。这也解释了为什么这一项的绝对成功率(约 30–40%)明显低于其他维度。有一处措辞不一致:正文第 4 节说是“50 个任务使用该任务训练中未见过的物体实例”,似乎指原 50 个任务换物体;这里则是“50 个新任务”,任务名与训练任务都不相同。图 9 也把这一项标为 “New Tasks”。
原文
Embodiment: Cross-Embodiment Transfer. The default embodiment is Aloha-Agilex, loaded as a single dual-arm URDF. For zero-shot cross-embodiment evaluation, we replace it with ARX-X5, UR5-WSG, or Franka Panda. Each alternative embodiment is loaded as two independent single-arm URDFs positioned symmetrically about the workspace center, with inter-arm base distances of 0.6 m (ARX-X5), 0.59 m (UR5-WSG), and 0.65 m (Franka) to accommodate different arm lengths. Initial EEF poses are aligned via IK, and all three camera extrinsics (head camera + two wrist cameras) are aligned across embodiments to ensure consistent starting conditions in the camera-frame action space.
译文
本体:跨本体迁移。默认本体是 Aloha-Agilex,以一个双臂 URDF 加载。进行零样本跨本体评测时,我们把它替换为 ARX-X5、UR5-WSG 或 Franka Panda。每种替代本体以两个独立的单臂 URDF 加载,关于工作区中心对称摆放,两臂基座间距分别为 0.6 m(ARX-X5)、0.59 m(UR5-WSG)和 0.65 m(Franka),以适应不同的臂长。初始末端执行器位姿通过 IK 对齐,三个相机(头部相机和两个腕部相机)的外参在各本体之间也保持一致,以保证在相机坐标系动作空间中起始条件相同。
解释
URDF 是描述机器人连杆和关节的标准文件格式。这里的关键是“相机外参对齐”:由于动作是在相机坐标系中表示的,只要相机位置不变、初始末端位姿相同,那么对模型来说同一个动作序列在不同机器人上意味着同样的末端运动,差别只在于画面里机械臂的外观和各自 IK 能否执行。腕部相机也对齐,意味着腕部相机相对夹爪的安装位置被人为设成相同,这比真实的跨本体部署要理想化。三种机器人中,两臂基座间距 0.59–0.65 m 差别不大,但 UR5 和 Franka 的臂更长、更重,在 Aloha 尺度的桌面上可能更容易出现关节限位或碰撞问题,这也许是它们成功率低的原因之一。
B.2任务列表
原文
The 50 tasks: adjust bottle, beat block hammer, blocks ranking rgb, blocks ranking size, click alarmclock, click bell, dump bin bigbin, grab roller, handover block, handover mic, hanging mug, lift pot, move can pot, move pillbottle pad, move playingcard away, move stapler pad, open laptop, open microwave, pick diverse bottles, pick dual bottles, place a2b left, place a2b right, place bread basket, place bread skillet, place burger fries, place can basket, place cans plasticbox, place container plate, place dual shoes, place empty cup, place fan, place mouse pad, place object basket, place object scale, place object stand, place phone stand, place shoe, press stapler, put bottles dustbin, put object cabinet, rotate qrcode, scan object, shake bottle, shake bottle horizontally, stack blocks three, stack blocks two, stack bowls three, stack bowls two, stamp seal, turn switch.Step limits per task range from 400 (e.g., click bell, adjust bottle) to 1700 (put bottles dustbin), with most tasks at 400. Complex multi-step tasks use higher limits: open microwave 1500, blocks ranking 1200, stack blocks three 1200, stack bowls 900–1200, hanging mug 900, stack blocks two / handover block 800, place cans plasticbox 800. New/unseen tasks default to 1000 steps.
译文
50 个任务为:adjust bottle, beat block hammer, blocks ranking rgb, blocks ranking size, click alarmclock, click bell, dump bin bigbin, grab roller, handover block, handover mic, hanging mug, lift pot, move can pot, move pillbottle pad, move playingcard away, move stapler pad, open laptop, open microwave, pick diverse bottles, pick dual bottles, place a2b left, place a2b right, place bread basket, place bread skillet, place burger fries, place can basket, place cans plasticbox, place container plate, place dual shoes, place empty cup, place fan, place mouse pad, place object basket, place object scale, place object stand, place phone stand, place shoe, press stapler, put bottles dustbin, put object cabinet, rotate qrcode, scan object, shake bottle, shake bottle horizontally, stack blocks three, stack blocks two, stack bowls three, stack bowls two, stamp seal, turn switch。各任务的步数上限从 400(如 click bell、adjust bottle)到 1700(put bottles dustbin)不等,大多数任务为 400。复杂的多步任务使用更高的上限:open microwave 1500,blocks ranking 1200,stack blocks three 1200,stack bowls 900–1200,hanging mug 900,stack blocks two 和 handover block 800,place cans plasticbox 800。新任务和未见任务默认 1000 步。
解释
这 50 个就是 RoboTwin 2.0 的标准任务集,任务名直译即可理解,例如 beat_block_hammer(用锤子敲方块)、blocks_ranking_rgb(按红绿蓝排列方块)、handover_mic(双手交接麦克风)、hanging_mug(把杯子挂到架子上)、shake_bottle_horizontally(水平摇瓶子)、stamp_seal(盖章)。各任务的单项结果见附录表 5。步数上限是一个回合的最长仿真步数,超时即判失败;上限越高,策略有越多机会纠错重试。未见物体任务统一给 1000 步,比同类的原任务(多为 400 步)宽松得多,这在一定程度上降低了这一维度的难度。
B.3评测协议
原文
50 episodes/task, binary success. Aggregates: Visual = mean(BG, Light, Robot Color); Scene = mean(Height, Clutter, Camera); Embodiment = mean(ARX, UR5, Franka); Task = mean(Obj, Lang).
译文
每个任务 50 个回合,二值成功判定。汇总指标:视觉 = mean(背景, 光照, 机器人颜色);场景 = mean(桌高, 杂物, 相机);本体 = mean(ARX, UR5, Franka);任务 = mean(物体, 语言)。
解释
这给出了表 1 中分维度列的计算方式,已用表 2 的数字核对无误(见表 1 解读)。各维度均值是对子项的简单平均,没有按任务数加权;“任务”维度只有两项,其中“物体”一项用的是 50 个新任务,“语言”一项用的是原 50 个任务换说法,两者的任务集不同。“每任务 50 回合、二值成功”与表 5 中大量奇数成功率不符,见译者附注。
B.4EBench 桌面任务
原文
EBench (Shanghai AI Laboratory, 2026) provides 7 table-top tasks in Isaac Sim: collect coffee beans, flip cup & collect cookies, frame against pen holder, install gear, peg in hole, put glass in glass box, tighten nut. Camera is higher than RoboTwin, closer to the egocentric perspective.
译文
EBench(Shanghai AI Laboratory, 2026)在 Isaac Sim 中提供 7 个桌面任务:收集咖啡豆、翻杯并收集饼干、把相框靠在笔筒上、安装齿轮、插销入孔、把玻璃杯放进玻璃盒、拧紧螺母。其相机比 RoboTwin 更高,更接近第一人称视角。
解释
与 RoboTwin 的任务相比,EBench 的任务更强调精细操作(插销、装齿轮、拧螺母),接触和对准的要求更高。图 2 右下角的截图显示了它的视角:相机高高地俯视整张桌面,两只夹爪从画面下方伸入,确实更像人低头看桌面的视角。正文把 EBench 上的较大收益归因于视角匹配,但任务性质的差别同样可能起作用。
C模型结构细节(Model Architecture Details)
原文
The Qwen3.5-4B vision-language backbone processes multi-view RGB images (2–3 views per timestep) and a structured text prompt, producing a sequence of hidden states \mathbf{H} \in \mathbb{R}^{L \times d} that jointly encode visual and linguistic information. Camera intrinsics \mathbf{K} \in \mathbb{R}^{3 \times 3} and extrinsics \mathbf{T}_{wc} \in SE(3) are injected into the visual features via mRoPE positional encodings, enabling the model to reason about the 3D spatial relationship between the camera and the scene. The DiT action head conditions on \mathbf{H} through cross-attention: a context generator compresses \mathbf{H} into conditioning features \mathbf{C} using 8 learnable query tokens, and the DiT layers attend to \mathbf{C} when predicting 32-step action chunks via flow matching (8 training / 4 inference steps).
译文
Qwen3.5-4B 视觉语言骨干处理多视角 RGB 图像(每个时间步 2–3 个视角)和一个结构化文本提示,输出一个联合编码视觉和语言信息的隐状态序列 \mathbf{H} \in \mathbb{R}^{L \times d}。相机内参 \mathbf{K} \in \mathbb{R}^{3 \times 3} 和外参 \mathbf{T}_{wc} \in SE(3) 通过 mRoPE 位置编码注入视觉特征,使模型能推理相机与场景之间的三维空间关系。DiT 动作头通过交叉注意力以 \mathbf{H} 为条件:一个上下文生成器用 8 个可学习的查询 token 把 \mathbf{H} 压缩为条件特征 \mathbf{C},DiT 各层在通过流匹配预测 32 步动作块时关注 \mathbf{C}(训练 8 步 / 推理 4 步)。
解释
L 是序列长度,d 是隐藏维度。多视角:机器人数据通常有头部相机加两个腕部相机(3 个视角),而合成数据只有头戴相机一个视角;“2–3 个视角”说明不同来源的视角数不同,缺失的视角大概用填充或掩码处理,原文没有说明。mRoPE 是 Qwen 系列的多维旋转位置编码,原本用来编码图像块的二维位置和时间;把相机内外参也编进位置编码,是让模型知道每个像素对应的空间射线方向,这对理解相机坐标系下的动作很重要。\mathbf T_{wc} 的下标约定是“相机到世界”的变换。8 个查询 token 的设计类似 Q-Former 或 Perceiver 的压缩,把可能上千个隐状态压缩成 8 个向量,减少 DiT 的计算量。
C.1结构化提示
原文
The text input follows a two-field format:embodiment: {type}_{model}
instruction: {task description}
instruction: {task description}
embodiment encodes data source and robot model: robot_aloha (real robot), h2r_arx (Ego2R with ARX), human_ego (raw ego). Dropped to “None” with 15% probability during training. instruction is never dropped. 译文
文本输入采用两字段格式:embodiment: {type}_{model}
instruction: {task description}
instruction: {task description}
embodiment 字段编码数据来源和机器人型号:robot_aloha(真实机器人)、h2r_arx(以 ARX 渲染的 Ego2R 数据)、human_ego(原始第一人称数据)。训练时该字段以 15% 的概率被替换为 “None”。instruction 字段从不丢弃。 解释
这是“本体提示”(embodiment prompt):在语言输入里明确告诉模型当前数据来自哪种本体,模型就可以为不同本体学习略有差别的行为,而不必从画面中猜。
h2r 是 human-to-robot 的缩写。以 15% 概率丢弃,相当于无分类器引导中的条件丢弃,让模型在不知道本体时也能工作,这对零样本跨本体评测(测试时换成没见过的机器人)是有用的。注意举例中的 robot_aloha 被标为“真实机器人”,但 RoboTwin 中的 Aloha 是仿真的,这里的 “real robot” 应理解为“机器人来源的数据”,与“合成”相对。 C.2相机坐标系相对 EEF
原文
Each action step is 7-dim: 3D position delta \Delta\mathbf{p}, 3D rotation delta \Delta\boldsymbol{\omega} (rotation vector), 1D gripper. Given the EEF-to-camera transformation \mathbf{T}_{ce} = \mathbf{T}_{wc}^{-1} \mathbf{T}_{we} with rotation component \mathbf{R}_{ce}, base-frame deltas are transformed:
\Delta\mathbf{p}_{cc} = \mathbf{R}_{ce}\, \Delta\mathbf{p}_{ee}, \quad \Delta\mathbf{R}_{cc} = \mathbf{R}_{ce}\, \Delta\mathbf{R}_{ee}\, \mathbf{R}_{ce}^\top(10)
This naturally unifies data from different camera setups and robot morphologies without explicit extrinsic calibration, as described in Section 3. 译文
每个动作步是 7 维的:3 维位置增量 \Delta\mathbf{p}、3 维旋转增量 \Delta\boldsymbol{\omega}(旋转向量)和 1 维夹爪。给定 EEF 到相机的变换 \mathbf{T}_{ce} = \mathbf{T}_{wc}^{-1} \mathbf{T}_{we},其旋转部分为 \mathbf{R}_{ce},基座坐标系下的增量按下式变换:
\Delta\mathbf{p}_{cc} = \mathbf{R}_{ce}\, \Delta\mathbf{p}_{ee}, \quad \Delta\mathbf{R}_{cc} = \mathbf{R}_{ce}\, \Delta\mathbf{R}_{ee}\, \mathbf{R}_{ce}^\top(10)
如第 3 节所述,这无需显式的外参标定,就能自然地统一来自不同相机配置和机器人形态的数据。 解释
记号:\mathbf T_{ab} 表示“把 b 坐标系中的量变换到 a 坐标系”的变换,w、c、e 分别是世界、相机、末端执行器坐标系。\mathbf T_{ce}=\mathbf T_{wc}^{-1}\mathbf T_{we}:先把末端坐标系变换到世界,再从世界变换到相机,得到“末端在相机坐标系中的位姿”,其旋转部分 \mathbf R_{ce} 把末端坐标系中的向量转到相机坐标系。公式 (10) 的含义:\Delta\mathbf p_{ee} 是在末端坐标系中表示的位移,左乘 \mathbf R_{ce} 就得到同一位移在相机坐标系中的表示。旋转增量用共轭变换:若末端朝向按 \mathbf R_{t+1}=\mathbf R_t\,\Delta\mathbf R_{ee} 更新(右乘,即在末端自身坐标系中旋转),则在相机坐标系中有 \mathbf R_{ce}\Delta\mathbf R_{ee}=(\mathbf R_{ce}\Delta\mathbf R_{ee}\mathbf R_{ce}^\top)\mathbf R_{ce},即 \Delta\mathbf R_{cc} 是在相机坐标系中左乘施加的同一个旋转。验证正确。一处记号矛盾:文字说被变换的是“基座坐标系下的增量”(base-frame deltas),但公式用的是 \mathbf R_{ce},下标也是 ee。如果增量真的在基座坐标系中,应当用相机相对基座的旋转 \mathbf R_{cb},而不是 \mathbf R_{ce}。按公式本身,增量应当是在末端坐标系中表示的。此外,“无需显式外参标定”的说法也需要限定:计算 \mathbf T_{ce} 本身需要相机外参 \mathbf T_{wc},上一段还说外参会通过 mRoPE 输入模型。对第一人称视频,手部姿态本来就是在相机坐标系中估计的,可以直接得到 \mathbf T_{ce},不需要标定;对机器人数据则需要已知的相机外参。所以“免标定”只对第一人称数据成立。
C.3流匹配
原文
Given clean actions \mathbf{a}_0 and noise \boldsymbol{\epsilon} \sim \mathcal{N}(\mathbf{0}, \mathbf{I}), the noised sample at t \in [0,1]:
\mathbf{a}_t = (1-t)\,\mathbf{a}_0 + t\,\boldsymbol{\epsilon}(11)
Training objective: \mathcal{L} = \mathbb{E}_{t, \mathbf{a}_0, \boldsymbol{\epsilon}} \left\| \mathbf{v}_\theta(\mathbf{a}_t, t, \mathbf{c}) - (\boldsymbol{\epsilon} - \mathbf{a}_0) \right\|^2(12)
where \mathbf{c} is the visual-language conditioning. Inference uses 4 Euler steps (\Delta t {=} 1/4). 译文
给定干净动作 \mathbf{a}_0 和噪声 \boldsymbol{\epsilon} \sim \mathcal{N}(\mathbf{0}, \mathbf{I}),时刻 t \in [0,1] 的加噪样本为:
\mathbf{a}_t = (1-t)\,\mathbf{a}_0 + t\,\boldsymbol{\epsilon}(11)
训练目标为: \mathcal{L} = \mathbb{E}_{t, \mathbf{a}_0, \boldsymbol{\epsilon}} \left\| \mathbf{v}_\theta(\mathbf{a}_t, t, \mathbf{c}) - (\boldsymbol{\epsilon} - \mathbf{a}_0) \right\|^2(12)
其中 \mathbf{c} 是视觉语言条件。推理使用 4 步欧拉法(\Delta t {=} 1/4)。 解释
这是标准的直线路径(rectified flow)流匹配,约定 t=0 是数据、t=1 是噪声(与 \pi_0 的约定相同,与部分文献相反)。公式 (11) 在数据和噪声之间做线性插值;对 t 求导得 \mathrm d\mathbf a_t/\mathrm dt=\boldsymbol\epsilon-\mathbf a_0,这正是公式 (12) 中网络 \mathbf v_\theta 要回归的目标速度。推理时从 \mathbf a_1=\boldsymbol\epsilon 出发,沿 -\mathbf v_\theta 方向积分到 t=0:\mathbf a_{t-\Delta t}=\mathbf a_t-\Delta t\,\mathbf v_\theta(\mathbf a_t,t,\mathbf c),4 步即 t=1\to0.75\to0.5\to0.25\to0。这里的 \mathbf c 即前文的条件特征 \mathbf C。工作区的 ODE Policy 译稿对流匹配有更详细的介绍。正文第 5.1 节称其为“扩散步”,二者在此语境下指同一个动作头。
D训练细节(Training Details)
D.1预训练
原文
8\timesA100 GPUs, batch 12/GPU, backbone lr 10^{-5}{\to}10^{-6} cosine (5K warmup), action head lr 10\times (10^{-4}{\to}10^{-5}), AdamW (\beta_1{=}0.9, \beta_2{=}0.95), bf16, ZeRO-1, 200K steps (\sim19.2M frames), 8 diffusion steps/forward. No image augmentation.
译文
8 张 A100 GPU,每卡批大小 12,骨干学习率从 10^{-5} 余弦衰减到 10^{-6}(5K 步预热),动作头学习率为其 10 倍(10^{-4}{\to}10^{-5}),AdamW(\beta_1{=}0.9, \beta_2{=}0.95),bf16,ZeRO-1,200K 步(约 1,920 万帧),每次前向 8 个扩散步。不做图像增广。
解释
ZeRO-1 是 DeepSpeed 的优化器状态分片,节省显存。“每次前向 8 个扩散步”原文没有详细说明,常见的实现是:VLM 骨干对一个样本只算一次,动作头则对同一个样本采样 8 个不同的噪声时刻 t 分别计算损失,这样能以很小的额外代价获得更多的动作头训练信号(GR00T 等也采用类似做法)。与推理时的“4 步欧拉”是两回事。全局批大小只有 96,对于一个 4B 参数的 VLA 来说偏小。预训练不做图像增广,而微调时加 ColorJitter,这意味着预训练阶段视觉多样性完全来自数据本身,这也是合成数据的视觉收益能被观察到的前提。
D.2预训练数据
原文
Robot data comprises three sources: DROID (Khazatsky et al., 2024) (\sim511 h) provides real-world teleoperated demonstrations across diverse objects and scenes with a Franka arm. AgibotWorld (Bu et al., 2025) (\sim2,404 h) is a large-scale real teleoperation dataset covering 180 manipulation tasks on humanoid platforms. InternData (Tian et al., 2025) (\sim3,650 h) provides simulation-generated demonstrations across Franka, humanoid, and Aloha embodiments. Together these total \sim6,565 h.
译文
机器人数据包括三个来源:DROID(Khazatsky et al., 2024)(约 511 小时)提供在 Franka 机械臂上、涵盖多样物体和场景的真实遥操作示范。AgibotWorld(Bu et al., 2025)(约 2,404 小时)是一个大规模真实遥操作数据集,在人形平台上覆盖 180 个操作任务。InternData(Tian et al., 2025)(约 3,650 小时)提供在 Franka、人形和 Aloha 本体上仿真生成的示范。三者合计约 6,565 小时。
解释
核对:511+2404+3650=6{,}565 小时,一致。纯机器人数据中超过一半(InternData)是仿真数据,而且包含 Aloha 本体,与 RoboTwin 的默认机器人和仿真风格接近,这对在 RoboTwin 上评测的纯机器人基线是有利的。从图 7 的采样权重看,InternData 占 50%、AgibotWorld 占 45%、DROID 只占 5%。
原文
Ego2R data is derived from four egocentric sources (ANT 7 h, EgoDex 732 h, ViTRA 249 h, EgoVerse 954 h, totaling \sim1,940 h before processing) rendered across 15 morphologies, yielding 18,561 h after pipeline processing and quality curation. The mixing ratios (1:3, 3:1, 1:1 Ego2R-to-Robot) are implemented via per-source sampling weights; all configurations process the same total number of frames. Figure 7 shows the per-source sampling weights used within each group.
译文
Ego2R 数据来自四个第一人称来源(ANT 7 小时、EgoDex 732 小时、ViTRA 249 小时、EgoVerse 954 小时,处理前合计约 1,940 小时),经 15 种形态渲染,在流水线处理和质量筛选后得到 18,561 小时。混合比例(Ego2R 对机器人数据 1:3、3:1、1:1)通过逐来源的采样权重实现;所有配置处理的总帧数相同。图 7 给出了每组内部各来源的采样权重。
解释
“通过采样权重实现”说明配比是按样本概率而非按数据时长确定的:无论数据集多大,1:1 就是每个批次里一半样本来自 Ego2R。结合第 5.1 节的计算,200K 步里 Ego2R 的样本数在 1:3、1:1、3:1 下分别约为 480 万、960 万、1,440 万帧,都只是合成数据总帧数的一小部分。
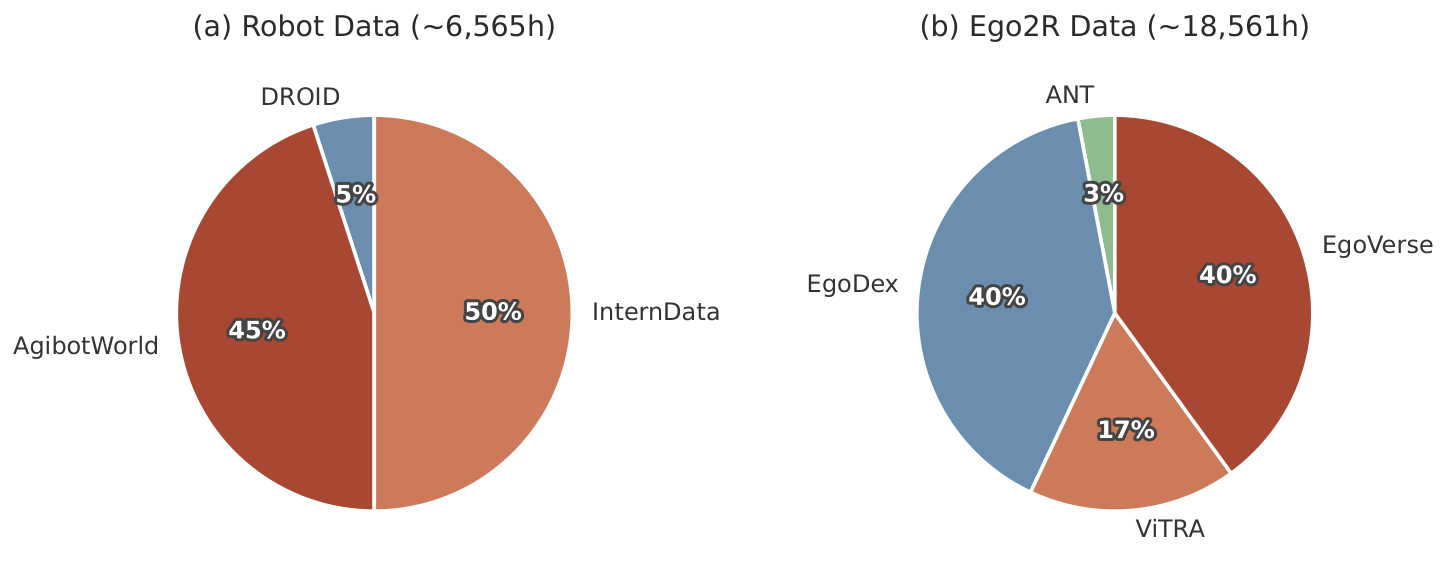
图 7:预训练数据构成。扇区表示各来源的采样权重(训练混合比例);子图标题给出数据总量。(a) 机器人数据(约 6,565 小时)。(b) Ego2R(约 18,561 小时)。
原图注:Pretraining data composition. Slices show per-source sampling weights (training mix); panel titles give the total data volume. (a) Robot (\sim6,565 h). (b) Ego2R (\sim18,561 h).
图 7 解读
两个饼图分别是机器人数据组和 Ego2R 组内部的采样权重;组与组之间的比例由 1:3、1:1、3:1 决定。(a) 机器人数据:InternData 50%、AgibotWorld 45%、DROID 5%。(b) Ego2R:EgoDex 40%、EgoVerse 40%、ViTRA 17%、ANT 3%。与数据时长对比:机器人组中三者的时长占比分别约为 55.6%、36.6%、7.8%,采样权重与之大致相当,DROID 略被降权。Ego2R 组按原始时长计,EgoDex 占 37.7%、EgoVerse 49.1%、ViTRA 12.8%、ANT 0.4%;采样权重把 EgoVerse 从约 49% 降到 40%,把 ViTRA 和 ANT 提了上来,其中只有 7 小时的 ANT 被放大到 3%,约是其时长占比的 8 倍。ANT 是作者自采的桌面抓放数据,场景最接近机器人桌面任务,提高它的权重是合理的选择,但这意味着这 7 小时数据被重复采样了很多次。
D.3微调
原文
All finetuning runs load pretrained weights. 8\timesA100 GPUs, batch 12/GPU, backbone lr 10^{-5}{\to}10^{-6} cosine (5K warmup), action head lr 10\times (10^{-4}{\to}10^{-5}), AdamW (\beta_1{=}0.9, \beta_2{=}0.95), bf16, ZeRO-2, ColorJitter, 8 diffusion steps/forward.RoboTwin Clean. 50 tasks \times 50 demos (2,500 episodes), 50K steps, chunk 20, replan every 16.EBench Table Top. 7 table-top tasks \times 400 demos (2,800 episodes), 50K steps, chunk 32.Real robot. See Section E for data details. 1:1 teleop-to-Ego2R mixing ratio, 50K steps, chunk 32.
译文
所有微调运行都加载预训练权重。8 张 A100 GPU,每卡批大小 12,骨干学习率从 10^{-5} 余弦衰减到 10^{-6}(5K 步预热),动作头学习率为其 10 倍(10^{-4}{\to}10^{-5}),AdamW(\beta_1{=}0.9, \beta_2{=}0.95),bf16,ZeRO-2,ColorJitter,每次前向 8 个扩散步。RoboTwin Clean。50 个任务 \times 50 条示范(2,500 个回合),50K 步,动作块长 20,每 16 步重新规划。EBench 桌面任务。7 个桌面任务 \times 400 条示范(2,800 个回合),50K 步,动作块长 32。真实机器人。数据细节见附录 E。遥操作数据与 Ego2R 数据按 1:1 混合,50K 步,动作块长 32。
解释
核对:50\times50=2{,}500,7\times400=2{,}800,正确。微调 50K 步、全局批 96,即看 480 万个样本,相对于 2,500 条示范是很多轮,模型会充分拟合微调数据。RoboTwin 微调把动作块从预训练的 32 步改成 20 步、每 16 步重新规划(即执行 16 步后丢掉剩余 4 步重新预测),而 EBench 和真机仍用 32 步,正文第 5.1 节的“32 步动作块”并不适用于 RoboTwin 实验。“真实机器人”一行写的是遥操作对 Ego2R 1:1,这只对应图 4 中 “Mix + Ego2R Play” 一种配置,其余配置只用遥操作数据微调。
D.4消融配置
原文
The ablation (Figure 3) uses only ego-sourced data (raw ego or Ego2R) for pretraining, excluding real robot data, to isolate the pipeline's contribution:
- Raw ego (\sim1,940 h): egocentric video after pipeline quality filtering but without robot rendering.
- Ego2R, 1 morphology (\sim1,237 h): pipeline-processed, ARX-L5 only.
- Ego2R, 5 morphologies (\sim6,187 h): Aloha-Agilex, ARX-L5, FR3, ViperX, xArm7.
- Ego2R, 10 morphologies (\sim12,374 h): Aloha-Agilex, ARX-L5, FR3, IIWA, Jaco, Piper, UR5e, ViperX, YAM, xArm7.
- Ego2R, 15 morphologies (\sim18,561 h): all 15.
- Ego2R (15) + Raw ego (\sim20,501 h): 15-morphology Ego2R plus raw egocentric data.
译文
消融实验(图 3)的预训练只使用第一人称来源的数据(原始第一人称数据或 Ego2R),不含真实机器人数据,以单独考察流水线的贡献:
- 原始第一人称数据(约 1,940 小时):经过流水线质量过滤、但没有机器人渲染的第一人称视频。
- Ego2R,1 种形态(约 1,237 小时):经流水线处理,仅 ARX-L5。
- Ego2R,5 种形态(约 6,187 小时):Aloha-Agilex、ARX-L5、FR3、ViperX、xArm7。
- Ego2R,10 种形态(约 12,374 小时):Aloha-Agilex、ARX-L5、FR3、IIWA、Jaco、Piper、UR5e、ViperX、YAM、xArm7。
- Ego2R,15 种形态(约 18,561 小时):全部 15 种。
- Ego2R(15)+ 原始第一人称数据(约 20,501 小时):15 种形态的 Ego2R 加上原始第一人称数据。
解释
时长的规律:1{,}237\times5=6{,}185,\times10=12{,}370,\times15=18{,}555,与表中 6,187、12,374、18,561 只差几小时,说明每种形态的时长几乎相同,约 1,237.4 小时。这有两个推论:一是基座搜索和 IK 对不同机械臂的成功率差不多(否则臂展小的 WidowX 应当丢掉更多片段),或者筛选主要发生在与形态无关的环节(手部检测、VLM 一致性);二是 18,561 小时中独立的人类操作内容只有约 1,237 小时。18{,}561+1{,}940=20{,}501,最后一项核对无误。一处口径疑问:原始第一人称数据被描述为“经过流水线质量过滤”,但时长仍是处理前的 1,940 小时,而经过处理的单形态 Ego2R 只剩 1,237 小时(约 64%)。要么 raw 数据其实没有经过同等的过滤,要么 36% 的损失全部来自与渲染有关的环节(IK 不可行、自碰撞等)。原文没有说明。形态的选择:1 种形态选的是 ARX-L5,与 RoboTwin 的 Aloha-Agilex 尺寸几乎相同;5 种和 10 种都包含 Aloha-Agilex 本身。因此即便是“1 种形态”,合成数据的机械臂也与下游评测的机器人非常接近,这有利于 Ego2R 相对于 raw 的比较。
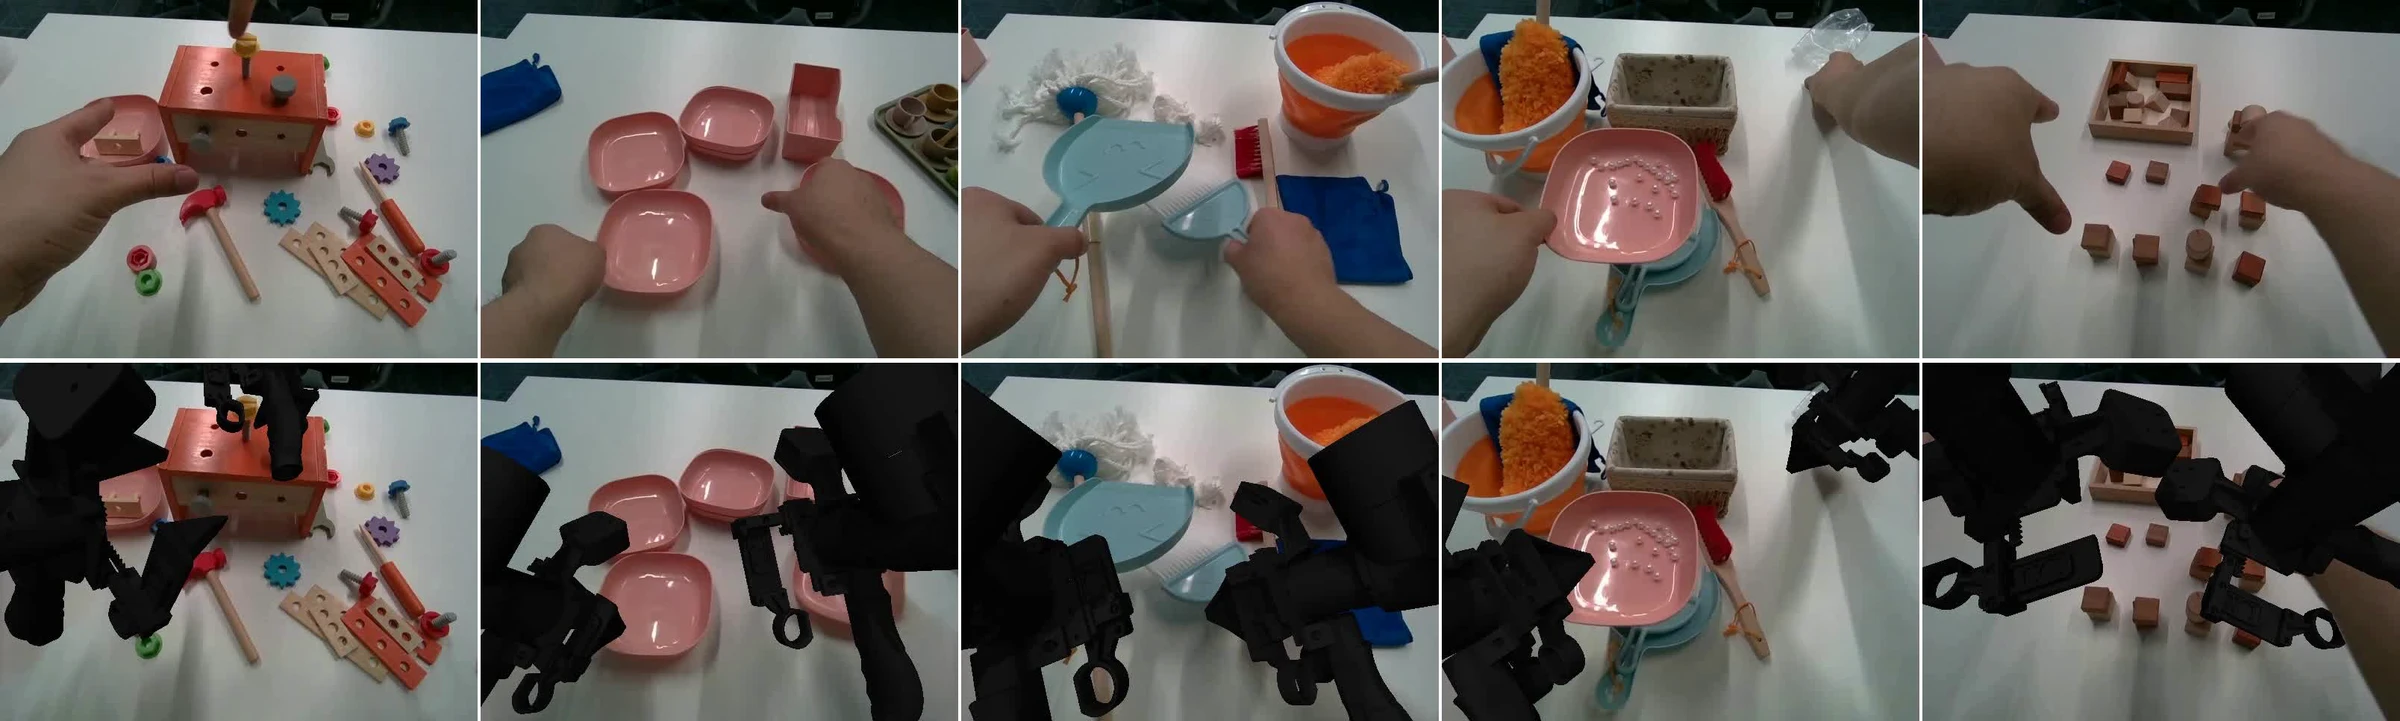
图 8:真实场景中的第一人称玩耍视频 \to Ego2R 合成。上:原始的第一人称人类操作。下:Ego2R 流水线输出,叠加了 ACone 机器人。
原图注:Ego play \to Ego2R synthesis on real-world scenes. Top: original egocentric human manipulation. Bottom: Ego2R pipeline output with ACone robot overlay.
图 8 解读
五列是五个真机场景的样例(画面中可以看到玩具工具盒、粉色餐盘与蓝色毛巾、扫帚簸箕与橙色桶、木块与盒子等物体),上行是人手随意摆弄物体的原始帧,下行是同一帧经过流水线后的结果:人手被抹去,换成黑色的 ACone 双臂。可以看到几个特点:合成的机械臂很粗大,占据了画面相当大的面积,常常遮住被操作的物体;第一列和第五列中两只手臂几乎同时出现在画面中央;渲染的夹爪位置与原人手位置大致对应。这类画面与真实部署时头部相机看到的 ACone 手臂外观一致,这正是 “Mix + Ego2R Play” 在真机上有效的原因之一。原文没有给出这些合成片段在质量筛选中的保留率。
E真机实验细节(Real Robot Experiment Details)
E.1平台与任务
原文
ARX ACone dual-arm (6-DOF/arm, parallel gripper, head + two wrist RGB cameras, 15 Hz control, Replan every 32 steps).
- Put Fruits (3 steps): place 3 fruits into a basket.
- Put Blocks (4 steps): open drawer, place 2 blocks, close drawer.
- Fold Towel (2 steps): two sequential folds.
- Sweep Trash (4 steps): pick broom, sweep, dump, return broom.
- Insert Screw (4 steps): bimanual handover and insertion of 2 screws.
译文
ARX ACone 双臂平台(每臂 6 自由度,平行夹爪,头部和两个腕部 RGB 相机,15 Hz 控制,每 32 步重新规划)。
- 放水果(3 步):把 3 个水果放进篮子。
- 放积木(4 步):打开抽屉,放入 2 块积木,关上抽屉。
- 叠毛巾(2 步):先后折叠两次。
- 扫垃圾(4 步):拿起扫帚,扫,倒掉,放回扫帚。
- 插螺丝(4 步):双手交接并插入 2 颗螺丝。
解释
15 Hz 控制、每 32 步重新规划,意味着每个动作块执行约 2.1 秒才重新看一次图像,这对需要实时纠错的任务(如插螺丝)是不利的,可能也是这些任务得分低的原因之一。步骤数决定了表 4 中每步的分值。放积木和插螺丝的“4 步”是如何拆分的(例如“放 2 块积木”算一步还是两步),原文没有细说:按“开抽屉、放积木 1、放积木 2、关抽屉”计正好 4 步;插螺丝按“交接、插入”各两颗计也是 4 步。
E.2数据
原文
20 teleop demos per task (100 total) + \sim35 min ego play video across 5 scenes. Ego play processed via Path B (WiLoR, DynHaMR, Qwen3.5, Ego2R) to generate 675 ACone synthetic episodes. Teleop and Ego2R data are mixed at a 1:1 ratio during finetuning.
译文
每个任务 20 条遥操作示范(共 100 条),另有 5 个场景共约 35 分钟的第一人称玩耍视频。玩耍视频经路径 B(WiLoR、DynHaMR、Qwen3.5、Ego2R)处理,生成 675 条 ACone 合成片段。微调时遥操作数据与 Ego2R 数据按 1:1 混合。
解释
效率对比:35 分钟视频生成 675 条片段,平均每条约 3 秒,说明 Qwen3.5 把玩耍视频切得很碎,每条大概是一个“抓起—放下”之类的单步动作,而遥操作示范是完整的多步任务。“1:1 混合”是按采样概率:100 条长示范与 675 条短片段各占一半样本。录制 35 分钟玩耍视频的成本远低于 675 条遥操作,这正是作者想传达的实用价值。
E.3第一人称玩耍视频到 Ego2R 的可视化
原文
Figure 8 shows representative frames from the ego play data and corresponding Ego2R synthesis. The top row shows the original egocentric human manipulation; the bottom row shows the pipeline output with the robot (ACone) overlaid onto the inpainted scene.
译文
图 8 展示了玩耍视频的代表性帧及其对应的 Ego2R 合成结果。上行是原始的第一人称人类操作;下行是流水线的输出,机器人(ACone)被叠加到修补后的场景上。
解释
图 8 在原文中排在附录 E 的开头之前,本译稿放在附录 D 末尾,与原文位置一致。图的解读见上。
E.4计分
原文
Sub-step partial scoring (Table 4), 100 points per task, 20 trials.
译文
按子步骤给部分分(表 4),每个任务满分 100 分,共 20 次试验。
表 4:真机计分。
| 任务 | 第 1 步 | 第 2 步 | 第 3 步 | 第 4 步 |
| 放水果 | 33.3 | 33.3 | 33.3 | — |
| 放积木 | 25 | 25 | 25 | 25 |
| 叠毛巾 | 50 | 50 | — | — |
| 扫垃圾 | 25 | 25 | 25 | 25 |
| 插螺丝 | 25 | 25 | 25 | 25 |
原表注:Real robot scoring.
表 4 解读
每个任务按步骤平均分配 100 分。图 4 中的“成功率”实为 20 次试验的平均得分。分步计分会抬高看起来的“成功率”:例如叠毛巾得 25 分,可能是一半试验完成了第一次折叠、都没完成第二次,而完整完成任务的比例可能接近零。原文没有报告完整完成率。放水果每步 33.3 分,三步合计 99.9 分,大概按 100 分处理。
F补充实验结果(Additional Experimental Results)
F.1与 Pi0.5 的比较
原文
Pi0.5 (Physical Intelligence et al., 2025) is evaluated under the same RoboTwin EEF settings (OpenPI framework, camera-frame relative EEF). Pi0.5 uses a different backbone and pretraining data. Figure 9 reports results. Ego2R+Robot (1:1) outperforms the Robot-only baseline across nearly all settings.
译文
Pi0.5(Physical Intelligence et al., 2025)在相同的 RoboTwin EEF 设置下评测(使用 OpenPI 框架,相机坐标系相对 EEF 动作)。Pi0.5 使用不同的骨干和预训练数据。图 9 给出了结果。Ego2R+Robot (1:1) 在几乎所有设置下都优于纯机器人数据基线。
解释
\pi_{0.5} 在这里是一个“外部参照”:它是公开的强 VLA,用 OpenPI 官方代码,在 RoboTwin 上以同样的动作表示微调。由于骨干和预训练数据都不同,它与本文模型的比较只能说明本文的基础模型处于什么水平,不能说明合成数据的作用。注意本段最后一句比较的是 Ego2R+Robot 与 Robot-only,与 \pi_{0.5} 无关,图 9 中这两组数据与表 2 相同。“几乎所有设置”的例外是 Franka(5 对 7)。
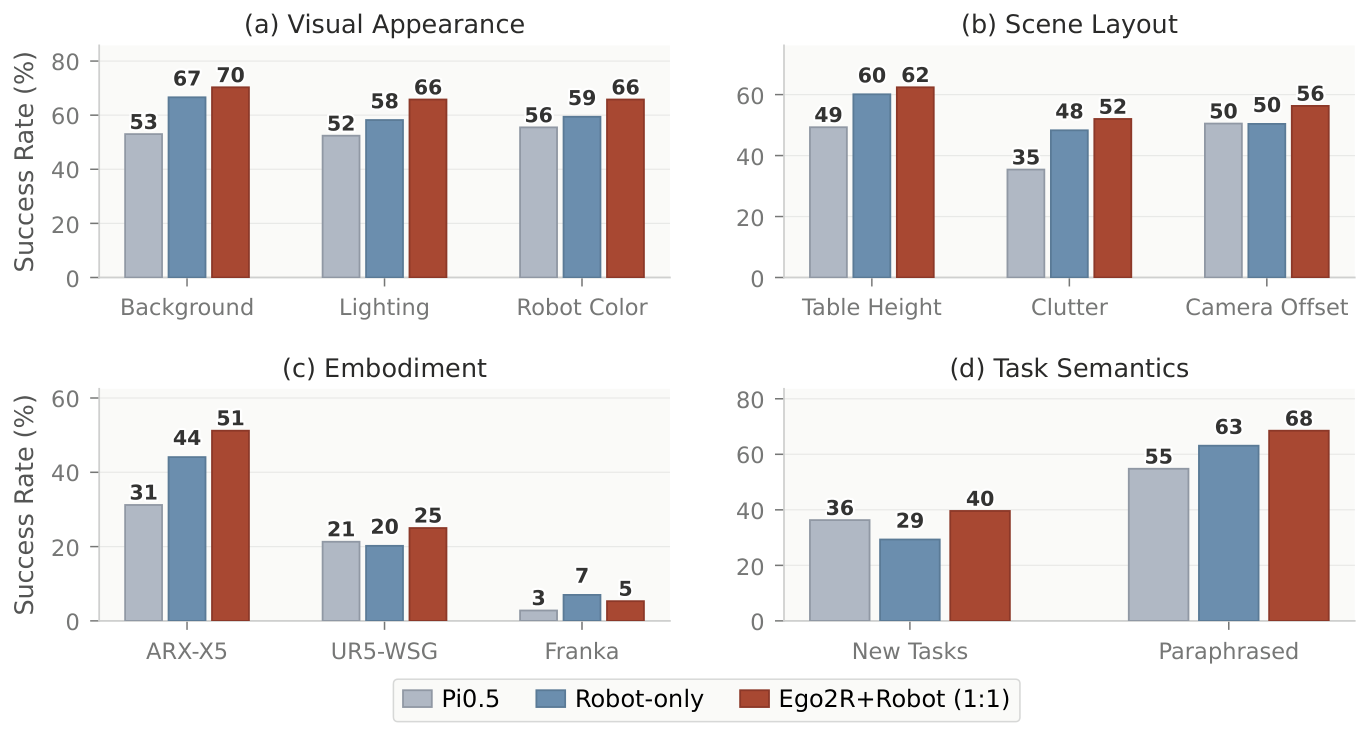
图 9:与 Pi0.5 的比较,覆盖各 RoboTwin 设置。
原图注:Comparison with Pi0.5 across RoboTwin settings.
图 9 解读
四个子图对应四个维度,每组三根柱:灰色 Pi0.5、蓝色 Robot-only、红色 Ego2R+Robot (1:1),柱上数字为取整后的成功率(%)。(a) 视觉:背景 53/67/70,光照 52/58/66,颜色 56/59/66。(b) 场景:桌高 49/60/62,杂物 35/48/52,相机偏移 50/50/56。(c) 本体:ARX-X5 31/44/51,UR5-WSG 21/20/25,Franka 3/7/5。(d) 任务语义:新任务 36/29/40,换说法 55/63/68。后两组数字与表 2 一致(取整)。值得注意的两点。第一,\pi_{0.5} 在“新任务”(未见物体)上为 36%,高于本文的纯机器人基线(29%),在 UR5 上也略高(21 对 20),说明在这两项上 \pi_{0.5} 更强的预训练本身就带来了泛化,Ego2R 的作用是让本文模型追上并略超过它。第二,\pi_{0.5} 在视觉和场景单项扰动下的成绩(35–56%)远高于它在捆绑的 Randomized 设置下的 27.7%(表 5),说明多种扰动叠加时性能下降非常剧烈,这本身也印证了把扰动分开测量的必要性。图中把未见物体一项标为 “New Tasks”,与正文“Unseen Object Instances”的叫法不同。
F.2逐任务结果
原文
Table 5 reports per-task success rates on all 50 RoboTwin tasks under Clean and Randomized settings for five models: Pi0.5 and four of our models.
译文
表 5 给出五个模型在全部 50 个 RoboTwin 任务上、Clean 和 Randomized 两种设置下的逐任务成功率:Pi0.5 和我们的四个模型。
表 5:RoboTwin 逐任务结果(含 Pi0.5)(成功率,%)。C = Clean,R = Randomized;粗体为同一设置下五个模型中的最高值。
| 任务 | Pi0.5 | Robot-only | Ego2R (1:3) | Ego2R (3:1) | Ego2R (1:1) | |||||
| C | R | C | R | C | R | C | R | C | R | |
| adjust_bottle | 62.0 | 18.0 | 94.0 | 77.0 | 92.0 | 79.0 | 100.0 | 72.0 | 89.0 | 91.0 |
| beat_block_hammer | 48.0 | 16.0 | 63.0 | 27.0 | 64.0 | 56.0 | 57.0 | 18.0 | 65.0 | 71.0 |
| blocks_ranking_rgb | 74.0 | 16.0 | 56.0 | 60.0 | 64.0 | 63.0 | 49.0 | 43.0 | 78.0 | 60.0 |
| blocks_ranking_size | 32.0 | 0.0 | 30.0 | 22.0 | 46.0 | 21.0 | 43.0 | 7.0 | 52.0 | 16.0 |
| click_alarmclock | 44.0 | 56.0 | 96.0 | 93.0 | 100.0 | 87.0 | 100.0 | 85.0 | 100.0 | 100.0 |
| click_bell | 32.0 | 40.0 | 100.0 | 95.0 | 100.0 | 94.0 | 100.0 | 93.0 | 100.0 | 100.0 |
| dump_bin_bigbin | 72.0 | 70.0 | 54.0 | 73.0 | 72.0 | 69.0 | 81.0 | 76.0 | 86.0 | 72.0 |
| grab_roller | 94.0 | 46.0 | 98.0 | 71.0 | 68.0 | 48.0 | 91.0 | 64.0 | 89.0 | 63.0 |
| handover_block | 16.0 | 0.0 | 5.0 | 2.0 | 18.0 | 4.0 | 39.0 | 9.0 | 36.0 | 9.0 |
| handover_mic | 26.0 | 4.0 | 69.0 | 13.0 | 86.0 | 34.0 | 83.0 | 17.0 | 97.0 | 23.0 |
| hanging_mug | 10.0 | 4.0 | 14.0 | 16.0 | 14.0 | 9.0 | 12.0 | 9.0 | 10.0 | 10.0 |
| lift_pot | 8.0 | 2.0 | 93.0 | 28.0 | 84.0 | 14.0 | 95.0 | 44.0 | 93.0 | 44.0 |
| move_can_pot | 28.0 | 0.0 | 47.0 | 50.0 | 30.0 | 40.0 | 42.0 | 85.0 | 47.0 | 65.0 |
| move_pillbottle_pad | 60.0 | 44.0 | 63.0 | 60.0 | 68.0 | 69.0 | 41.0 | 67.0 | 74.0 | 82.0 |
| move_playingcard_away | 90.0 | 52.0 | 74.0 | 58.0 | 88.0 | 92.0 | 88.0 | 42.0 | 92.0 | 63.0 |
| move_stapler_pad | 22.0 | 6.0 | 23.0 | 19.0 | 34.0 | 21.0 | 30.0 | 13.0 | 43.0 | 31.0 |
| open_laptop | 68.0 | 20.0 | 77.0 | 61.0 | 74.0 | 56.0 | 64.0 | 46.0 | 75.0 | 58.0 |
| open_microwave | 26.0 | 8.0 | 77.0 | 59.0 | 42.0 | 29.0 | 37.0 | 32.0 | 50.0 | 25.0 |
| pick_diverse_bottles | 56.0 | 18.0 | 60.0 | 37.0 | 58.0 | 53.0 | 71.0 | 50.0 | 70.0 | 50.0 |
| pick_dual_bottles | 82.0 | 14.0 | 91.0 | 59.0 | 80.0 | 77.0 | 83.0 | 55.0 | 97.0 | 54.0 |
| place_a2b_left | 60.0 | 10.0 | 40.0 | 55.0 | 58.0 | 42.0 | 54.0 | 48.0 | 73.0 | 44.0 |
| place_a2b_right | 58.0 | 14.0 | 42.0 | 49.0 | 52.0 | 41.0 | 53.0 | 51.0 | 64.0 | 53.0 |
| place_bread_basket | 68.0 | 44.0 | 75.0 | 55.0 | 72.0 | 64.0 | 76.0 | 59.0 | 79.0 | 62.0 |
| place_bread_skillet | 86.0 | 46.0 | 76.0 | 41.0 | 76.0 | 50.0 | 80.0 | 61.0 | 87.0 | 53.0 |
| place_burger_fries | 90.0 | 78.0 | 96.0 | 83.0 | 98.0 | 81.0 | 97.0 | 88.0 | 96.0 | 88.0 |
| place_can_basket | 40.0 | 0.0 | 49.0 | 25.0 | 38.0 | 9.0 | 34.0 | 15.0 | 34.0 | 16.0 |
| place_cans_plasticbox | 94.0 | 74.0 | 90.0 | 68.0 | 54.0 | 68.0 | 97.0 | 59.0 | 70.0 | 59.0 |
| place_container_plate | 96.0 | 58.0 | 86.0 | 76.0 | 92.0 | 79.0 | 93.0 | 73.0 | 93.0 | 81.0 |
| place_dual_shoes | 54.0 | 12.0 | 50.0 | 30.0 | 34.0 | 27.0 | 35.0 | 17.0 | 35.0 | 19.0 |
| place_empty_cup | 74.0 | 56.0 | 73.0 | 74.0 | 86.0 | 83.0 | 88.0 | 78.0 | 88.0 | 66.0 |
| place_fan | 36.0 | 30.0 | 48.0 | 54.0 | 48.0 | 24.0 | 41.0 | 50.0 | 39.0 | 46.0 |
| place_mouse_pad | 18.0 | 0.0 | 41.0 | 34.0 | 22.0 | 36.0 | 30.0 | 25.0 | 29.0 | 33.0 |
| place_object_basket | 24.0 | 4.0 | 65.0 | 50.0 | 76.0 | 28.0 | 77.0 | 51.0 | 69.0 | 48.0 |
| place_object_scale | 58.0 | 44.0 | 38.0 | 46.0 | 40.0 | 33.0 | 52.0 | 45.0 | 40.0 | 47.0 |
| place_object_stand | 94.0 | 40.0 | 70.0 | 75.0 | 80.0 | 77.0 | 87.0 | 71.0 | 82.0 | 82.0 |
| place_phone_stand | 40.0 | 4.0 | 65.0 | 49.0 | 48.0 | 63.0 | 70.0 | 61.0 | 75.0 | 45.0 |
| place_shoe | 64.0 | 24.0 | 84.0 | 84.0 | 78.0 | 84.0 | 63.0 | 58.0 | 75.0 | 76.0 |
| press_stapler | 42.0 | 32.0 | 86.0 | 71.0 | 82.0 | 62.0 | 76.0 | 70.0 | 83.0 | 62.0 |
| put_bottles_dustbin | 14.0 | 2.0 | 25.0 | 20.0 | 42.0 | 32.0 | 41.0 | 19.0 | 50.0 | 39.0 |
| put_object_cabinet | 22.0 | 0.0 | 41.0 | 20.0 | 30.0 | 19.0 | 39.0 | 36.0 | 43.0 | 29.0 |
| rotate_qrcode | 50.0 | 2.0 | 31.0 | 17.0 | 54.0 | 16.0 | 54.0 | 36.0 | 69.0 | 37.0 |
| scan_object | 62.0 | 38.0 | 62.0 | 37.0 | 66.0 | 46.0 | 66.0 | 46.0 | 56.0 | 33.0 |
| shake_bottle | 96.0 | 72.0 | 91.0 | 75.0 | 88.0 | 89.0 | 99.0 | 75.0 | 96.0 | 87.0 |
| shake_bottle_horizontally | 98.0 | 74.0 | 98.0 | 81.0 | 84.0 | 87.0 | 99.0 | 84.0 | 97.0 | 92.0 |
| stack_blocks_three | 68.0 | 16.0 | 14.0 | 23.0 | 14.0 | 28.0 | 10.0 | 13.0 | 28.0 | 23.0 |
| stack_blocks_two | 80.0 | 56.0 | 75.0 | 70.0 | 82.0 | 75.0 | 77.0 | 56.0 | 95.0 | 61.0 |
| stack_bowls_three | 38.0 | 36.0 | 50.0 | 41.0 | 40.0 | 43.0 | 48.0 | 50.0 | 47.0 | 45.0 |
| stack_bowls_two | 82.0 | 44.0 | 76.0 | 78.0 | 66.0 | 73.0 | 73.0 | 67.0 | 72.0 | 72.0 |
| stamp_seal | 32.0 | 2.0 | 35.0 | 42.0 | 46.0 | 30.0 | 34.0 | 30.0 | 44.0 | 42.0 |
| turn_switch | 56.0 | 40.0 | 55.0 | 42.0 | 40.0 | 42.0 | 53.0 | 41.0 | 50.0 | 48.0 |
| 平均 | 54.9 | 27.7 | 62.2 | 50.9 | 61.4 | 51.0 | 64.1 | 49.2 | 68.1 | 53.5 |
原表注:Per-task results on RoboTwin including Pi0.5 (success rate %).
表 5 解读
列:五个模型,每个模型两列(Clean、Randomized)。行:RoboTwin 的 50 个任务,最后一行是平均值,也就是表 1 中的 Clean 和 Rand 两列。核对平均值:用 50 行重新计算,Pi0.5 为 54.88/27.72,Robot-only 为 62.22/50.90,1:3 为 61.36/50.92,3:1 为 64.04/49.20,1:1 为 68.02/53.50。与表中数字相比,1:3 的 Rand 应为 50.9(表中 51.0),3:1 的 Clean 应为 64.0(表中 64.1),其余一致。两处都只差 0.1,可能来自取整前的原始数据,但与表中给出的数字不符。粗体标注经核对均为各设置下的最大值。回合数与成功率的颗粒度:正文和附录 B.3 说每个任务评测 50 个回合,那么成功率只能是 2% 的整数倍(偶数)。Pi0.5 两列和 1:3 的 Clean 列全是偶数,符合这一点;但其余七列中都有约一半的数值是奇数(例如 Robot-only 的 adjust_bottle Rand 为 77.0、1:1 的 beat_block_hammer Rand 为 71.0)。这说明这些列的回合数不是 50(可能是 100),或是多次评测的平均。不同模型、不同列的评测回合数可能不同,原文没有说明。逐任务的波动很大:例如 open_microwave 的 Clean,Robot-only 为 77,三个 Ego2R 配置只有 37–50;place_cans_plasticbox 的 Clean,1:3 为 54、3:1 为 97、1:1 为 70。相邻配比之间单任务相差 30–40 个点并不少见,说明单次运行的结果受随机性影响很大,平均值上 1–3 个点的差异尤其需要谨慎对待。1:1 相对 Robot-only,在 Clean 上 33 个任务持平或更好,Randomized 上 29 个任务持平或更好,优势是整体性的,但并非一边倒。Pi0.5 的特点:Clean 平均 54.9,比本文的纯机器人基线低 7.3 个点,Randomized 则低 23.2 个点(27.7 对 50.9);它在 stack_blocks_three(68 对 10–28)、place_dual_shoes、place_object_stand 等任务上明显更好,但在 lift_pot(8 对 84–95)、click_bell 等任务上差得多。本文基础模型在 RoboTwin 上整体强于 \pi_{0.5},部分原因可能是本文在 OpenPI 框架之外做了更充分的调参,或者 InternData 中包含与 RoboTwin 相近的 Aloha 仿真数据。
译者附注:原文数字核对与阅读提示汇总
以下各条已在正文对应位置的解释框中说明,这里集中列出。总体而言,本文的主要数字是自洽的:表 1 的分维度均值可由表 2 精确重算,表 1、表 2 中的全部差值正确,数据时长(7+732+249+954\approx1{,}940;511+2{,}404+3{,}650=6{,}565;18{,}561+1{,}940=20{,}501)、训练样本数(200\text{K}\times96=19.2M)、未见物体任务数(50)和真机得分差值(+14、+13)都能对上。需要注意的主要是数据规模的口径、评测的统计可靠性和若干正文与附录的描述不一致。| 位置 | 说明 |
| 摘要 / 引言 / 附录 D.4 | 18,561 小时 = 15 种形态 \times 约 1,237 小时;独立的人类操作内容只有约 1,237 小时(约为原始 1,940 小时的 64%)。“最大数据集”是按渲染后时长计算的。 |
| 第 5.1 节 / 附录 D.1 | 每次预训练只看约 1,920 万个样本,按 30 fps 估算不到合成数据总帧数的 1%;实验检验的是固定计算预算下的混合效果,并未检验用满 18,561 小时。 |
| 第 3 节 | “降到 60% 帧率,约慢 1.7 倍”:字面上抽帧会让每步位移变大、动作变快,原文未说明如何实现“变慢”。该段在第 3 节中重复出现两次。 |
| 第 3 节 / 附录 A.4 | 正文公式 (4) 只最大化 IK 可行率,附录公式 (8) 另有权重为 5 的臂展惩罚;正文说候选围绕轨迹质心生成,附录说在相机坐标系中生成。正文公式 (5) 对整只机器人做深度比较,附录说明臂身总是直接覆盖、只有夹爪做比较。 |
| 附录 A.6 / 第 4 节 | 合成数据对每只机械臂做全色环随机染色,而评测的“机器人颜色”扰动正是随机色相偏移;颜色一项的提升(+6.4)很可能主要来自这项增广,正文却归因于多形态渲染。 |
| 图 2 / 附录 B.1 | 相机偏移在图 2 中标为“解耦”(虚线框),附录 B.1 则把它列为新引入的维度。 |
| 第 4 节 / 附录 B.1 / 图 9 | 未见物体一项:正文说是“50 个任务换用未见物体实例”,附录列出的是 50 个名称不同的新任务,图 9 标为 “New Tasks”;新任务步数上限 1000,比多数原任务(400)宽松。 |
| 第 5.1 节 / 附录 C、D | 正文称“8 个扩散步”、“32 步动作块”;附录显示动作头为流匹配,训练每样本 8 个噪声时刻、推理 4 步欧拉;RoboTwin 微调实际用 20 步动作块、每 16 步重规划。 |
| 第 5.2 节 | 介绍表 2 时说分解为“视觉、场景、本体三个维度”,表中实际有四个维度(含任务)。“Franka 仍低于 7%”:基线恰为 7.0%,加入合成数据后降到 4.5–5.6%。“维持 68.1% Clean”实为提升 5.9 个点。 |
| 表 1 / 表 5 | 用表 5 重算平均值:1:3 的 Rand 为 50.92(表中 51.0),3:1 的 Clean 为 64.04(表中 64.1),各差 0.1。 |
| 表 5 / 附录 B.3 | 声称每任务 50 回合,成功率应为 2% 的整数倍;Pi0.5 两列和 1:3 的 Clean 列确实全为偶数,但其余七列约一半为奇数,回合数或统计方式与描述不符。 |
| 表 2 | Robot-only 的背景(66.6)和语言(63.1)两项扰动成绩高于其无扰动的 Clean(62.2),1:1 的背景(70.3)也高于其 Clean(68.1),提示评测噪声不小;所有结果均为单次运行,没有误差条。 |
| 第 5.3 节 / 附录 D.4 | 消融称 “raw ego co-training”,但该组实验不含机器人数据;raw 数据被描述为“经过质量过滤”,时长却仍是处理前的 1,940 小时。raw 与 Ego2R(1) 的差别主要是视觉对齐,动作对齐的贡献没有单独分离。 |
| 图 3 | 形态从 1 到 15 共提升 1.8 个点(单步 0.4–0.8),而加入未经渲染的原始视频提升 3.8 个点;纵轴从 20% 起,视觉上放大了差距。 |
| 图 4 / 第 5.4 节 | 图中有 Scratch 组,正文只说比较三种配置;Mix 相对 Robot-only 在叠毛巾上持平(25 对 25),并非全部提升。纵轴“成功率”实为分步得分;放水果的 31 分与 20 次试验、每步 33.3 分的颗粒度(30.0 或 31.7)不符。 |
| 附录 C.2 | 公式 (10) 的文字说变换的是“基座坐标系增量”,公式却用 \mathbf R_{ce} 和下标 ee(应为末端坐标系增量);“无需外参标定”只对第一人称数据成立,机器人数据计算 \mathbf T_{ce} 仍需相机外参。 |
| 附录 C.1 | robot_aloha 被注为“真实机器人”,但 RoboTwin 中的 Aloha 是仿真本体。 |
| 附录 A.7 / 表 3 | 表中臂展普遍大于厂商标称值(如 Panda 1.272 m,标称约 0.855 m),定义未说明;Panda 与 FR3 参数完全相同。 |